


بعد أن نقل الفريق الذي نتابعه في هذه المرحلة أول أجهزته إلى Proxmox، ظهرت قائمة طويلة من الخدمات الصغيرة التي كانت كل منها جهازاً افتراضياً في VMware: سيرفر DNS داخلي، وسيرفر للمراقبة، وموقع Wiki للفريق، وخدمة لإرسال التنبيهات، وسيرفر Proxy للتحديثات. وكل واحدة منها تحتاج بضع مئات من الميجابايتات، ولكن كل جهاز افتراضي يحمل معه نواة كاملة وذاكرة محجوزة ووقت إقلاع، وعندما جمع أحد الزملاء الأرقام وجد أن هذه الخدمات تأخذ من السيرفر أضعاف ما تحتاجه فعلاً. وهنا سأل المدير السؤال المتوقع: سمعنا أن Proxmox يشغل Containers أيضاً، فهل نستطيع أن نضع هذه الخدمات فيها؟ وهل هي آمنة مثل الأجهزة الافتراضية؟ وكم نوفر بالضبط؟
وقد شرحنا الفرق المبدئي بين الجهاز الافتراضي والـ Container في المحاكاة الافتراضية Virtualization، ورأينا هناك أن الـ Container يشارك نواة المضيف. وهذا المقال عن LXC داخل Proxmox تحديداً، بمختبر على نفس السيرفر الذي بنينا عليه الشبكات والتخزين. وسوف نناقش في هذا المقال ما يلي:
- ما هو LXC، ولماذا يسميه Proxmox Container للنظام، وما الفرق بينه وبين Docker.
- الفرق الحقيقي بين Unprivileged وPrivileged، كما يظهر في خريطة المستخدمين وفي ملفات المضيف.
- القوالب Templates، وإنشاء Container على ZFS وعلى LVM-thin، ومشكلة systemd التي واجهناها في أول تشغيل.
- حدود المعالج والذاكرة بالأرقام: ماذا حدث عندما تجاوز برنامج حده.
- المجلدات المشتركة Bind Mounts ومشكلة الصلاحيات التي تواجه كل من يستخدمها لأول مرة.
- Container مقابل جهاز افتراضي بالأرقام: الإقلاع والذاكرة والقرص، ومتى تختار كلاً منهما.
ما هو LXC في Proxmox؟ System Containers
LXC، واختصاره Linux Containers، مشروع يشغل نظام Linux كاملاً داخل Container على نواة المضيف، بنفس أدوات النواة التي يعتمد عليها Docker: مساحات الأسماء Namespaces التي تجعل الـ Container يرى ملفاته وشبكته وقائمة عملياته فقط، ومجموعات التحكم cgroups التي تحد ما يأخذه من المعالج والذاكرة. والفرق بينه وبين Docker ليس في التقنية، وإنما في الفكرة: Docker يشغل تطبيقاً واحداً في كل Container، أما LXC فيشغل نظاماً كاملاً، فيه systemd كأول عملية، وفيه SSH وcron وسجلات النظام، وتحدثه بالأمر apt مثل أي سيرفر. ولهذا يسمي فصل الـ Containers في توثيق Proxmox هذا النوع Containers للنظام System Containers. والصورة التالية تبين الفرق:
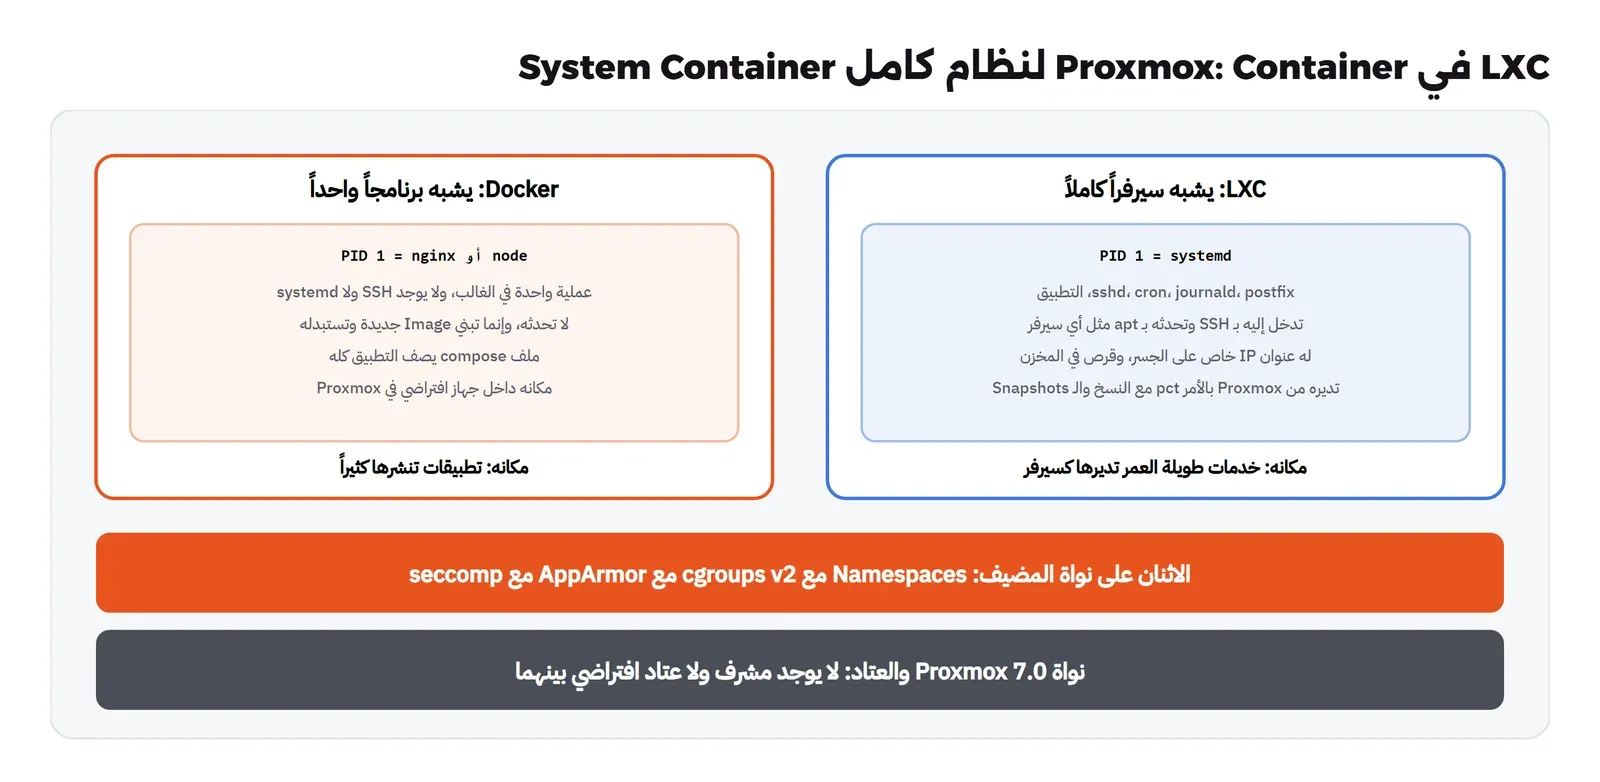
ويقول التوثيق إن هدف Containers Proxmox أن تعطيك مزايا الجهاز الافتراضي دون تكلفته الإضافية، ويذكر أيضاً أن Proxmox VE أضاف دعماً تجريبياً Technology Preview لإنشاء Container من Image بصيغة OCI، أي نفس صيغة Images الخاصة بـ Docker، فيحولها إلى LXC. ولكن التوثيق نفسه يقول إن الحالات التي تحتاج أقصى عزل والنقل الحي Live Migration ما زال الأنسب لها تشغيل الـ Containers داخل جهاز افتراضي، وهذا هو الشكل الذي ننصح به لتطبيقات Docker كما في دليل تثبيت Docker على Ubuntu. ولاحظ عبارة النقل الحي، فالـ Container في Proxmox لا ينتقل إلى سيرفر آخر وهو يعمل، وإنما يتوقف ثم يبدأ على السيرفر الآخر، وهذه أول نقطة تحسبها قبل أن تنقل إليه خدمة لا تحتمل التوقف.
Unprivileged أم Privileged؟ من هو root داخل الـ Container؟
عندما تنشئ Container في Proxmox يسألك سؤالاً واحداً يحدد أمانه أكثر من أي إعداد آخر: Unprivileged أم لا؟ والجواب الافتراضي Unprivileged، ولكن لفهم السبب أنشأنا Container من كل نوع، وطلبنا من كل منهما أن يعرض خريطة المستخدمين، ثم نظرنا إلى أول عملية فيه من المضيف:
for i in 401 402; do
  pct exec $i -- cat /proc/self/uid_map
  pct exec $i -- id
  ps -o user:8,pid,cmd -p $(lxc-info -n $i -p -H)
done
-- ct401
0 100000 65536
uid=0(root) gid=0(root) groups=0(root)
USER PID CMD
100000 17731 /sbin/init
-- ct402
0 0 4294967295
uid=0(root) gid=0(root) groups=0(root)
USER PID CMD
root 18258 /sbin/initفي المخرج أعلاه لاحظ التالي:
- داخل الاثنين أنت
rootبرقم 0، ولا يوجد فرق يراه من يعمل داخل الـ Container. - خريطة
ct401تقول: المستخدمون من 0 إلى 65535 داخل الـ Container يقابلهم في المضيف المستخدمون من 100000 فما فوق، وهذا ما تفعله مساحة أسماء المستخدمين User Namespace. ولذلك تظهر أول عملية فيه في المضيف باسم المستخدم100000، وهو مستخدم ليس له أي صلاحية على السيرفر. - خريطة
ct402تقابل كل مستخدم بنفسه: 0 يقابل 0، ولذلك أول عملية فيه في المضيف هيrootحقيقي.
والصورة التالية تبين المعنى العملي:
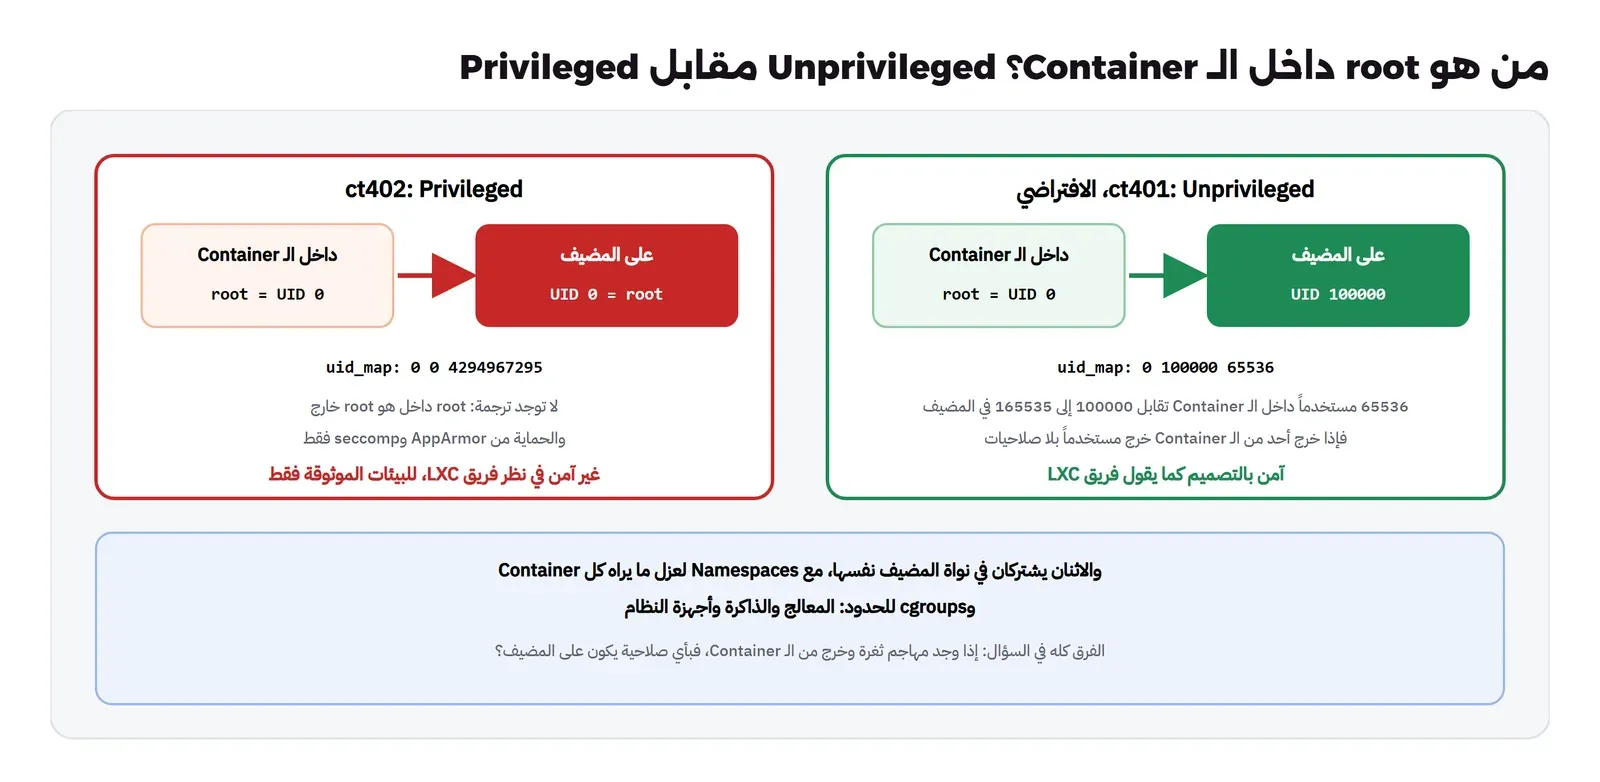
وهذا هو جوهر الفرق، فكل Container يشارك نواة المضيف، وأي ثغرة في النواة أو في LXC قد تسمح لعملية بالخروج منه. فإذا خرجت من Container بنوع Unprivileged فهي على المضيف مستخدم برقم 100000 لا يملك شيئاً، أما إذا خرجت من Privileged فهي root على السيرفر وكل أجهزته. ولذلك يقول التوثيق إن فريق LXC يعتبر الـ Containers من نوع Unprivileged آمنة بالتصميم، وإن أي خروج منها يكون ثغرة عامة في النواة وليس مشكلة في LXC، أما Privileged فيعتبرها الفريق غير آمنة، ولا يعامل طرق الخروج منها على أنها ثغرات تستحق رقم CVE وإصلاحاً سريعاً، وبالتالي لا تستخدمها إلا في بيئة تثق بكل من يصل إليها. وفي Privileged تعتمد الحماية كلها على AppArmor الذي يمنع استدعاءات خطيرة مثل mount، وعلى فلاتر seccomp، والتوثيق يحذر من تعطيل AppArmor لأي Container في الإنتاج.
ومتى يكون Privileged مقبولاً إذن؟ في حالات قليلة يعرفها من يحتاجها: هوم لاب لا يصل إليه أحد غيرك، أو خدمة قديمة تحتاج تركيب أنظمة ملفات شبكية من داخلها ولا تستطيع نقلها الآن، أو تجربة قصيرة تحذفها بعد ساعة. وحتى في هذه الحالات اسأل نفسك أولاً: هل يكفي جهاز افتراضي صغير؟ فالجهاز الافتراضي يعطيك نفس الحرية داخل نظامه، مع حدود العتاد الافتراضي بينه وبين السيرفر، وثمنه بضع مئات من الميجابايتات من الذاكرة فقط، كما سوف نقيس بالأرقام في آخر هذا المقال.
القوالب Templates: من أين يأتي النظام؟
الـ Container لا يثبت من ملف ISO مثل الجهاز الافتراضي، وإنما يبدأ من قالب Template، وهو أرشيف مضغوط فيه نظام ملفات كامل لتوزيعة جاهزة. ويوفر Proxmox قوالب رسمية لأشهر التوزيعات، وقوالب جاهزة لتطبيقات من TurnKey Linux، والأمر pveam يديرها:
pveam update
pveam available --section system | grep -E "debian-13|alpine-3.2"
pveam download local debian-13-standard_13.6-1_amd64.tar.zst
system alpine-3.22-default_20250617_amd64.tar.xz amd64
system alpine-3.23-default_20260116_amd64.tar.xz amd64
system alpine-3.24-default_20260714_amd64.tar.xz amd64
system debian-13-standard_13.6-1_amd64.tar.zst amd64
download of 'http://download.proxmox.com/images/system/debian-13-standard_13.6-1_amd64.tar.zst' to '/var/lib/vz/template/cache/debian-13-standard_13.6-1_amd64.tar.zst' finishedوالقالب هنا 130 ميجابايت لنظام Debian 13 كامل، وقالب Alpine الذي استخدمناه في مقال الشبكات 3.3 ميجابايت فقط. وعند التنزيل يتحقق pveam من الهاش المنشور مع القالب، كما رأيت في مقال الشبكات عندما طبع checksum verified. والقالب يحفظ في المخزن local لأنه ملف، وتستطيع أن تضعه في أي مخزن من نوع Directory أو NFS يسمح بالمحتوى vztmpl.
قالبك أنت: Container جاهز تنسخ منه
القالب الرسمي نقطة بداية، ولكن الفريق لا يريد أن يكرر نفس الخطوات على كل Container جديد: ضبط المنطقة الزمنية، وإضافة مفاتيح SSH، وتفعيل التحديثات الأمنية التلقائية، وتثبيت عميل المراقبة. والحل الذي يقدمه Proxmox أن تجهز Container واحداً بكل ذلك، ثم تحوله إلى قالب بالأمر pct template، فيصبح للقراءة فقط ولا يعمل، ثم تنسخ منه بالأمر pct clone كل Container جديد. وعلى مخزن يدعم الـ Snapshots مثل ZFS يكون النسخ المرتبط Linked Clone شبه فوري، لأن النسخة الجديدة تبدأ من Snapshot للقالب ولا تأخذ مساحة إلا لما يتغير فيها، بنفس فكرة النسخ عند الكتابة التي قسناها في مقال التخزين. وهذه نفس الطريقة التي يستخدمها مقال قوالب Proxmox مع cloud-init للأجهزة الافتراضية، والفرق أن الـ Container لا يحتاج cloud-init، لأن Proxmox يكتب الاسم والشبكة داخله مباشرة عند كل تشغيل. وتذكر شيئاً واحداً: القالب الذي جهزته بنفسك يتقادم، فالحزم فيه من يوم تجهيزه، لذلك أعد بناءه كل فترة، أو اجعل أول ما يفعله كل Container جديد تحديث حزمه.
إنشاء Container على ZFS ثم على LVM-thin
أنشأنا Container من كل نوع، الأول Unprivileged على مخزن ZFS والثاني Privileged على LVM-thin، بنفس المواصفات: معالجان و512 MiB وقرص 4 GiB، على الشبكة المعزولة natnet التي بنيناها في مقال الشبكات:
T=local:vztmpl/debian-13-standard_13.6-1_amd64.tar.zst
pct create 401 $T --hostname ct-unpriv --cores 2 --memory 512 --swap 0 --rootfs tank:4 --unprivileged 1 \
  --password LabOnly-Ct-2026 --net0 name=eth0,bridge=natnet,ip=10.50.0.41/24,gw=10.50.0.1 --nameserver 10.0.2.3
pct create 402 $T --hostname ct-priv --cores 2 --memory 512 --swap 0 --rootfs local-lvm:4 --unprivileged 0 \
  --password LabOnly-Ct-2026 --net0 name=eth0,bridge=natnet,ip=10.50.0.42/24,gw=10.50.0.1 --nameserver 10.0.2.3
cat /etc/pve/lxc/401.conf
zfs list -o name,used,refer -r tank; zfs get -H refquota tank/subvol-401-disk-0
lvs pve | grep 402
create 401 (unprivileged, ZFS): 38474 ms
create 402 (privileged, LVM-thin): 27787 ms
arch: amd64
cores: 2
hostname: ct-unpriv
memory: 512
nameserver: 10.0.2.3
net0: name=eth0,bridge=natnet,gw=10.50.0.1,hwaddr=BC:24:11:2A:64:25,ip=10.50.0.41/24,type=veth
ostype: debian
rootfs: tank:subvol-401-disk-0,size=4G
swap: 0
unprivileged: 1
tank/subvol-401-disk-0 314M 314M
tank/subvol-401-disk-0 refquota 4G local
vm-402-disk-0 pve Vwi-aotz-- 4.00g data 16.03في المخرج أعلاه لاحظ التالي:
- ملف الإعداد قصير وواضح، وكل سطر فيه يقابل خياراً في الأمر، وهذا الملف في
/etc/pve/lxc/داخل نظام ملفات العنقود مثل ملفات الأجهزة الافتراضية. - على ZFS أصبح قرص الـ Container مجموعة بيانات
subvol-401-disk-0بحدrefquotaقدره 4G، وليست قرصاً كتلياً، كما شرحنا في مقال التخزين، وهي تأخذ 314 MiB، أي حجم النظام بعد فك القالب. - على LVM-thin أصبح قرصاً كتلياً رقيقاً بحجم 4 GiB عليه نظام ملفات ext4، وامتلاؤه 16.03%، أي قرابة 657 MiB، وهو أكبر من ZFS لأن نظام الملفات نفسه وبياناته الوصفية داخل القرص.
- الإنشاء أخذ 28 إلى 38 ثانية، وأغلبها فك القالب المضغوط، ولا يوجد تثبيت ولا أسئلة.
ماذا يحدث عند pct start؟
قبل أن نصل إلى المشكلة التي واجهناها، من المفيد أن تعرف ما يفعله Proxmox عندما تضغط Start، لأن كل مشكلة في الـ Containers تقع في خطوة من هذه الخطوات. فالأمر يشغل على المضيف عملية lxc-start، ورأيناها في قائمة العمليات أثناء النسخ الاحتياطي باسم /usr/bin/lxc-start -F -n 401، وهي التي تجهز كل شيء بالترتيب: تركب قرص الـ Container من المخزن، وتنشئ مساحات الأسماء الجديدة للعمليات والشبكة ونظام الملفات والمستخدمين، وتطبق خريطة المستخدمين إذا كان Unprivileged، وتنشئ مجموعة cgroup باسم lxc/401 بالحدود التي في الإعداد، وتنشئ زوج veth وتضع طرفه في الجسر، وتحمل ملف AppArmor الخاص بالـ Containers وفلاتر seccomp، ثم تكتب إعداد الشبكة واسم السيرفر داخل نظام الملفات، وأخيراً تشغل /sbin/init، أي systemd، كأول عملية داخل الـ Container. ومن هنا يبدأ systemd إقلاع النظام كأنه على سيرفر، ولكن دون نواة ولا BIOS ولا أجهزة، فيشغل خدماته فقط. وبالتالي فإذا فشل الـ Container في البدء فالسجل الذي تريده هو سجل lxc-start، وتحصل عليه بالأمر pct start 401 --debug، وإذا بدأ وفشلت خدماته فالمشكلة داخل النظام نفسه، وتراها بالأمر systemctl --failed داخله كما سوف نرى الآن.
مشكلة: systemd 257 مع الخيار nesting
عند تشغيل الاثنين ظهر تحذير لم نكن نتوقعه، ثم وصل النظام داخل الاثنين إلى حالة degraded بدل running:
WARN: Systemd 257 detected. You may need to enable nesting.
start 401 to systemd ready: 35975 ms (degraded)
start 402 to systemd ready: 112404 ms (degraded)
وعند السؤال عن الخدمات الفاشلة كانت القائمة طويلة في الـ Container من نوع Privileged، وأقصر في Unprivileged:
pct exec 402 -- systemctl --failed --no-legend
pct exec 401 -- systemctl --failed --no-legend
● dev-hugepages.mount loaded failed failed Huge Pages File System
● dev-mqueue.mount loaded failed failed POSIX Message Queue File System
● run-lock.mount loaded failed failed Legacy Locks Directory /run/lock
● tmp.mount loaded failed failed Temporary Directory /tmp
● nftables.service loaded failed failed nftables
● postfix.service loaded failed failed Postfix Mail Transport Agent (main/default instance)
● systemd-logind.service loaded failed failed User Login Management
● systemd-networkd.service loaded failed failed Network Configuration
● systemd-networkd.socket loaded failed failed Network Service Netlink Socket
---
● dev-mqueue.mount loaded failed failed POSIX Message Queue File System
● run-lock.mount loaded failed failed Legacy Locks Directory /run/lock
● tmp.mount loaded failed failed Temporary Directory /tmpوالسبب أن الإصدارات الحديثة من systemd تعزل خدماتها بنفسها بنفس أدوات الـ Containers، فتحاول أن تركب أنظمة ملفات خاصة وتنشئ مساحات أسماء داخل الـ Container، وAppArmor يمنعها لأنها في نظره تركيب أنظمة ملفات من داخل Container. وتوثيق Proxmox يذكر هذا صراحة في وصف الخيار nesting: السماح بالتداخل، وهو مطلوب أيضاً لكي يعزل systemd خدماته، مع ملاحظة أنه يكشف للـ Container محتوى procfs وsysfs من المضيف، وأنه الأنسب مع Unprivileged. لذلك فعلناه على الـ Container من نوع Unprivileged:
pct stop 401; pct set 401 --features nesting=1; pct start 401
pct exec 401 -- systemctl is-system-running
start 401 nesting=1: 99201 ms (running)وأصبح النظام running دون أي خدمة فاشلة. ولاحظ أن الخدمات الفاشلة في Privileged كانت أكثر، ومنها الشبكة systemd-networkd والدخول systemd-logind، والسبب أن AppArmor يشدد القيود على Privileged لأنه الحماية الوحيدة فيه. ولا ننصح بتفعيل nesting على Privileged، لأن كشف procfs وsysfs لـ root حقيقي على المضيف يفتح باباً لا تريده، وهذا سبب آخر لتجنب Privileged.
حدود المعالج والذاكرة: cgroups بالأرقام
الحدود في الـ Container ليست مثل الجهاز الافتراضي، فلا يوجد عتاد افتراضي يحصر الـ Container في عدد معالجات أو حجم ذاكرة، وإنما مجموعات تحكم cgroups في النواة، والتوثيق يقول إن Proxmox VE 9 يستخدم الإصدار الثاني cgroup v2 فقط بعد أن أزال الإصدار الأول كاملاً. والخيارات الثلاثة التي تحتاجها:
cores: عدد المعالجات التي يراها الـ Container، وينفذه Proxmox بمجموعةcpusetتحدد على أي أنوية تعمل عملياته.cpulimit: سقف لوقت المعالج، فالقيمة 0.5 تعني نصف معالج مهما كان عدد الأنوية، والقيمة 0 تعني دون سقف.cpuunits: وزن نسبي عندما تتنافس الـ Containers على المعالج، والافتراضي 100 مع cgroup v2، فالـ Container بوزن 200 يأخذ ضعف الآخر عند التنافس فقط، ولا يحده شيء عندما يكون المعالج متاحاً.
وقسنا الحدين الأهم. فللذاكرة، شغلنا داخل ct401 بحد 512 MiB برنامجاً يحجز 64 MiB في كل خطوة، وللمعالج شغلنا حلقة لا تنتهي لمدة 10 ثوان مع سقف 0.5 ثم دونه، وقرأنا ما استهلكته من ملفات cgroup على المضيف نفسه:
cat /sys/fs/cgroup/lxc/401/memory.max
pct exec 401 -- free -m | head -2
pct exec 401 -- python3 -c "
import time
b=[]
for i in range(1,20):
    b.append(bytearray(64*1024*1024)); print('allocated', i*64, 'MiB', flush=True); time.sleep(0.2)
"; echo "exit=$?"
grep -E "oom_kill|^oom " /sys/fs/cgroup/lxc/401/memory.events
dmesg | grep -i "memory cgroup out of memory" | tail -1

pct set 401 --cpulimit 0.5; cat /sys/fs/cgroup/lxc/401/cpu.max
s1=$(awk '/usage_usec/{print $2}' /sys/fs/cgroup/lxc/401/cpu.stat)
pct exec 401 -- timeout 10 sh -c "while :; do :; done"
s2=$(awk '/usage_usec/{print $2}' /sys/fs/cgroup/lxc/401/cpu.stat); echo "cpu used in 10 s wall: $(( (s2-s1)/1000 )) ms"
grep -E "nr_throttled|throttled_usec" /sys/fs/cgroup/lxc/401/cpu.stat
536870912
total used free shared buff/cache available
Mem: 512 15 495 0 1 496
allocated 64 MiB
allocated 128 MiB
allocated 192 MiB
allocated 256 MiB
allocated 320 MiB
allocated 384 MiB
allocated 448 MiB
exit=137
oom 3
oom_kill 2
[ 3279.314209] Memory cgroup out of memory: Killed process 21141 (python3) total-vm:538944kB, anon-rss:495564kB, file-rss:4008kB, shmem-rss:0kB, UID:100000 pgtables:1028kB oom_score_adj:0
50000 100000
cpu used in 10 s wall: 5143 ms
nr_throttled 186
throttled_usec 9651781
no limit: cpu used in 10 s wall: 10186 msوالصورة التالية تلخص الحدين:
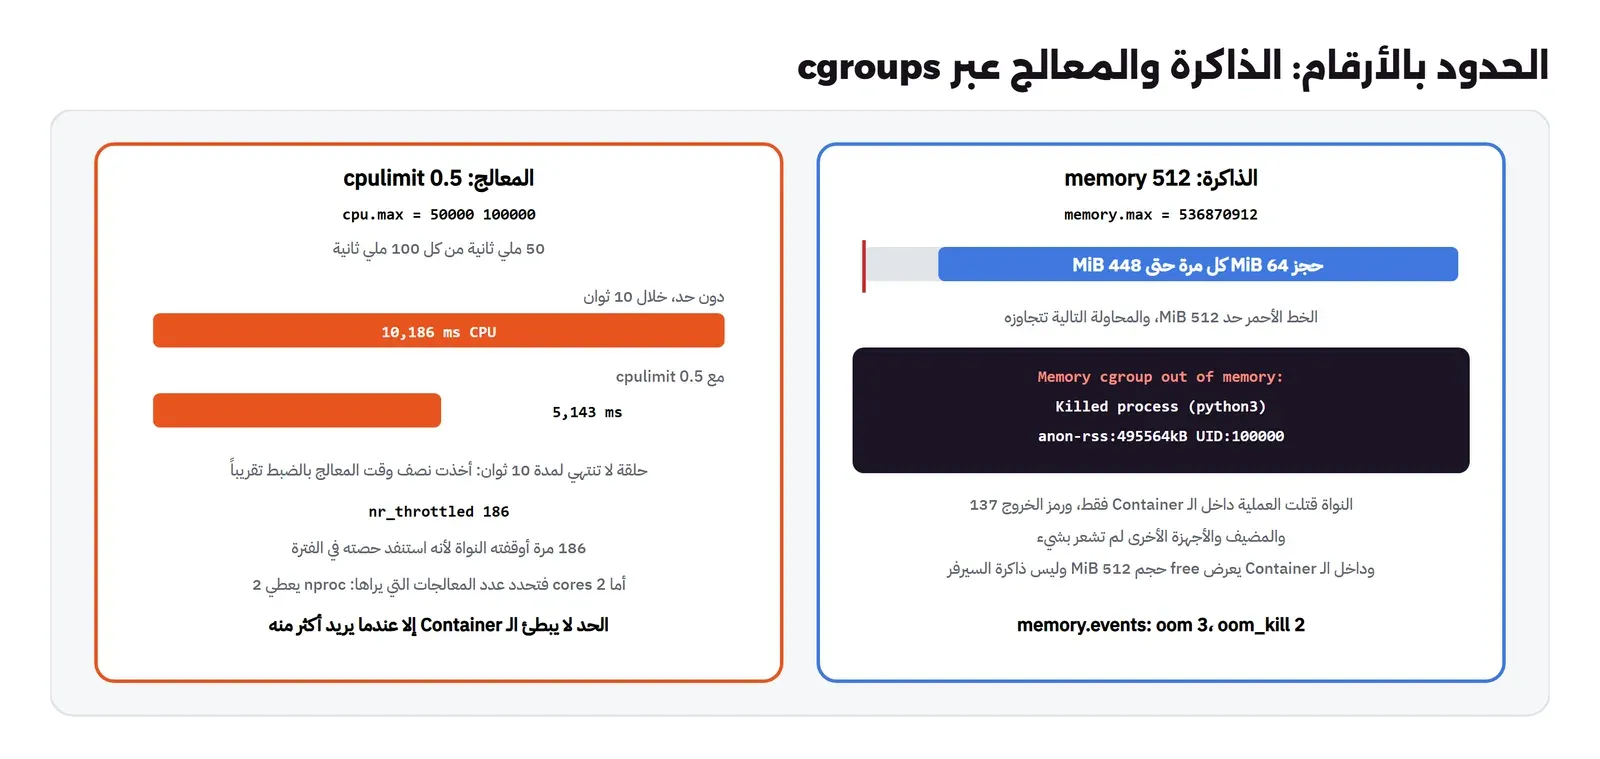
وفيما يلي ما تقوله الأرقام:
- الـ Container يرى حده هو: الأمر
freeداخله عرض 512 MiB وليس 6 GiB، ذاكرة السيرفر، والسبب أن Proxmox يشغل مع LXC خدمة lxcfs التي تعرض للـ Container ملفات مثل/proc/meminfoمحسوبة من حدوده. وهذا مهم لأن برامج كثيرة، مثل قواعد البيانات وJava، تحسب حجم ذاكرتها المؤقتة من الذاكرة التي تراها، فلو رأت ذاكرة السيرفر كاملة لحجزت أكثر من حدها ثم قتلت. - تجاوز الذاكرة يقتل داخل الحد فقط: عندما حاول البرنامج حجز 512 MiB تدخل قاتل الذاكرة OOM Killer الخاص بمجموعة الـ Container، فقتل
python3وحده، ورمز الخروج 137 يعني أنه قتل بالإشارة 9. ولاحظUID:100000في رسالة النواة: النواة ترى العملية بمستخدمها الحقيقي على المضيف. والسيرفر والأجهزة الأخرى لم تشعر بشيء، وهذه هي فائدة الحد الصارم. - سقف المعالج دقيق: مع
cpulimit 0.5كتب Proxmox فيcpu.maxالقيمتين50000 100000، أي 50 ملي ثانية من كل 100، فأخذت الحلقة 5.1 ثانية من وقت المعالج في 10 ثوان، وأوقفتها النواة 186 مرة عندما استنفدت حصتها، ودون السقف أخذت 10.2 ثانية، أي معالجاً كاملاً.
ولاحظ الفرق المهم عن الجهاز الافتراضي هنا: في الجهاز الافتراضي الذاكرة محجوزة لنظامه، ونظامه هو الذي يقرر كيف يستخدمها، أما في الـ Container فالذاكرة التي لا يستخدمها تبقى للمضيف وباقي الأجهزة، فحد 512 MiB لـ Container يستخدم 40 MiB يعني أن 470 MiB متاحة لغيره، وهذا مصدر التوفير الذي سأل عنه المدير.
المجلدات المشتركة Bind Mounts مع مشكلة الصلاحيات
الحاجة الأكثر شيوعاً مع الـ Containers أن يرى مجلداً من المضيف، مثل مجلد وسائط على مجمع ZFS كبير، أو مجلد NFS ركبه المضيف. وهذا اسمه Bind Mount، ويكتب في إعداد الـ Container بالخيار mp0، والتوثيق يضع له تحذيرات واضحة: استخدم مجلدات مخصصة لذلك مثل /mnt/bindmounts، ولا تقم أبداً بربط مجلدات النظام مثل / أو /var أو /etc لأنه خطر أمني كبير، ومسار المصدر يجب ألا يحتوي روابط رمزية Symlinks، ومحتوى هذه المجلدات لا تنسخه vzdump مع الـ Container. وأنشأنا مجلداً فيه ملف من المضيف، وربطناه في الـ Container بنوعيه:
mkdir -p /mnt/bindmounts/shared; echo "from host" > /mnt/bindmounts/shared/host.txt
for i in 401 402; do pct set $i -mp0 /mnt/bindmounts/shared,mp=/shared; pct reboot $i; done
for i in 401 402; do pct exec $i -- ls -ln /shared; pct exec $i -- sh -c "echo from ct$i > /shared/ct$i.txt"; done
ls -ln /mnt/bindmounts/shared
-- ct401 sees:
-rw-r--r-- 1 65534 65534 10 Nov 4 08:53 host.txt
sh: 1: cannot create /shared/ct401.txt: Permission denied
write FAILED
-- ct402 sees:
-rw-r--r-- 1 0 0 10 Nov 4 08:53 host.txt
write ok
-- host sees:
-rw-r--r-- 1 0 0 11 Nov 4 11:58 ct402.txt
-rw-r--r-- 1 0 0 10 Nov 4 11:53 host.txtوهذه هي المشكلة التي تواجه كل من يستخدم Bind Mount لأول مرة. فالملف ملك root على المضيف، أي المستخدم 0، وفي الـ Container من نوع Unprivileged لا يقابل المستخدم 0 في المضيف أي مستخدم داخله، لأن الخريطة تبدأ من 100000، فيعرض الـ Container الملف باسم 65534، وهو المستخدم nobody، ويرفض الكتابة في المجلد حتى من root داخله. أما الـ Container من نوع Privileged فكتب مباشرة، والملف الذي كتبه ظهر على المضيف ملكاً لـ root الحقيقي. والصورة التالية تبين الحالتين:
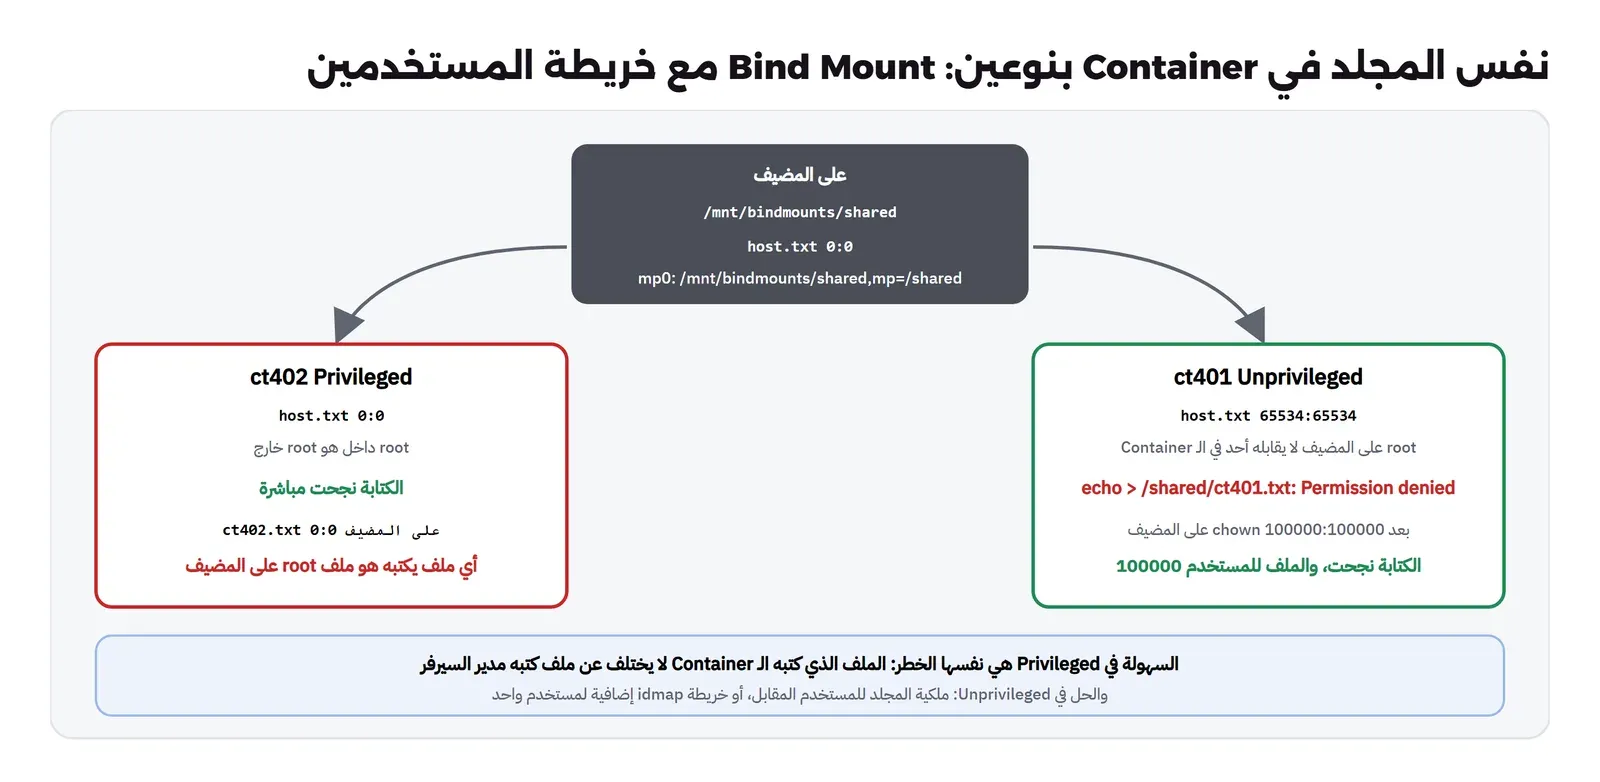
والحل الأبسط أن تجعل ملكية المجلد للمستخدم الذي يقابل root داخل الـ Container، أي 100000:
chown 100000:100000 /mnt/bindmounts/shared
pct exec 401 -- sh -c "echo from ct401 > /shared/ct401.txt"
ls -ln /mnt/bindmounts/shared
write ok
-rw-r--r-- 1 100000 100000 11 Nov 4 11:59 ct401.txt
-rw-r--r-- 1 0 0 11 Nov 4 11:58 ct402.txt
-rw-r--r-- 1 0 0 10 Nov 4 11:53 host.txtوبنفس المنطق، إذا كان التطبيق داخل الـ Container يعمل بمستخدم رقمه 1000، فملفاته على المضيف تحمل الرقم 101000، فاجعل ملكية المجلد لهذا الرقم. وإذا احتجت أن يكتب مستخدم حقيقي على المضيف ومستخدم داخل الـ Container على نفس الملفات بنفس الرقم، فالحل خريطة إضافية lxc.idmap في إعداد الـ Container تستثني هذا المستخدم من الإزاحة، ويشرحها دليل Unprivileged LXC containers في wiki الخاص بـ Proxmox، وهي أعقد قليلاً ولكنها أفضل بكثير من التحويل إلى Privileged لمجرد أن الصلاحيات لا تعمل، وهو أشيع خطأ نراه في المنتديات. ولاحظ أيضاً شيئاً صغيراً في المخرج: الملف نفسه يظهر بالوقت 11:53 على المضيف و08:53 داخل الـ Container، والسبب أن القالب يأتي بالمنطقة الزمنية UTC والمضيف على توقيت السعودية، فاضبط المنطقة الزمنية داخل كل Container حتى لا تختلط عليك أوقات السجلات.
ماذا لو اخترت Privileged لتتجنب كل هذا؟ What If
قد يتساءل البعض بعد المشكلات السابقة: إذا كان Privileged يكتب في المجلدات مباشرة، ولا يحتاج خرائط، ويعمل معه كل شيء تقريباً، فلماذا لا نستخدمه ونرتاح؟ والإجابة في السطر ct402.txt 0:0 من المخرج السابق: أي عملية داخل هذا الـ Container تكتب في أي مجلد مربوط تكتب بصلاحية root الحقيقية على السيرفر. فلو كان المجلد المربوط فيه سكربتات يشغلها المضيف، أو إعدادات خدمة على المضيف، فإن اختراق تطبيق ويب صغير داخل الـ Container يصبح تعديلاً لملفات root على السيرفر، دون أن يحتاج المهاجم أي ثغرة في النواة. ثم أضف إلى ذلك ما رأيناه في قسم المستخدمين: أي ثغرة خروج من Container بنوع Privileged تعطي root على السيرفر وكل أجهزته، وفريق LXC نفسه لا يعدها ثغرة تستحق إصلاحاً عاجلاً. لذلك فالقاعدة: Unprivileged دائماً، ولا تقم بالتحويل إلى Privileged لحل مشكلة صلاحيات، وإذا احتاج التطبيق صلاحيات عميقة في النواة، مثل تحميل وحدات أو تشغيل Docker بكل مزاياه أو الوصول المباشر إلى أجهزة، فمكانه جهاز افتراضي.
Container مقابل جهاز افتراضي بالأرقام
والآن السؤال الأخير للمدير: كم نوفر؟ أنشأنا جهازاً افتراضياً vm501 بنفس مواصفات ct401: معالجان و512 MiB، ونظام Debian 13 من Image السحابة الرسمية على نفس مخزن ZFS ونفس الشبكة، ثم شغلنا كل واحد منهما مرتين وقسنا الوقت من أمر التشغيل حتى يرد على ping، وحتى يصل systemd داخله إلى نهاية الإقلاع:
a=$(ms); pct start 401; until ping -c1 -W1 10.50.0.41 >/dev/null 2>&1; do sleep 0.2; done; b=$(ms)
until pct exec 401 -- systemctl is-system-running | grep -qE "running|degraded"; do sleep 0.5; done; c=$(ms)
a=$(ms); qm start 501; until ping -c1 -W1 10.50.0.51 >/dev/null 2>&1; do sleep 0.2; done; b=$(ms)
until ssh [email protected] "systemctl is-system-running" | grep -qE "running|degraded"; do sleep 1; done; c=$(ms)
run 1 CT 401 start->ping: 50585 ms
run 1 CT 401 start->systemd ready: 60497 ms
run 1 VM 501 start->ping: 430021 ms
run 1 VM 501 start->systemd ready: 708932 ms
run 2 CT 401 start->ping: 63006 ms
run 2 CT 401 start->systemd ready: 103947 ms
run 2 VM 501 start->ping: 467882 ms
run 2 VM 501 start->systemd ready: 508306 ms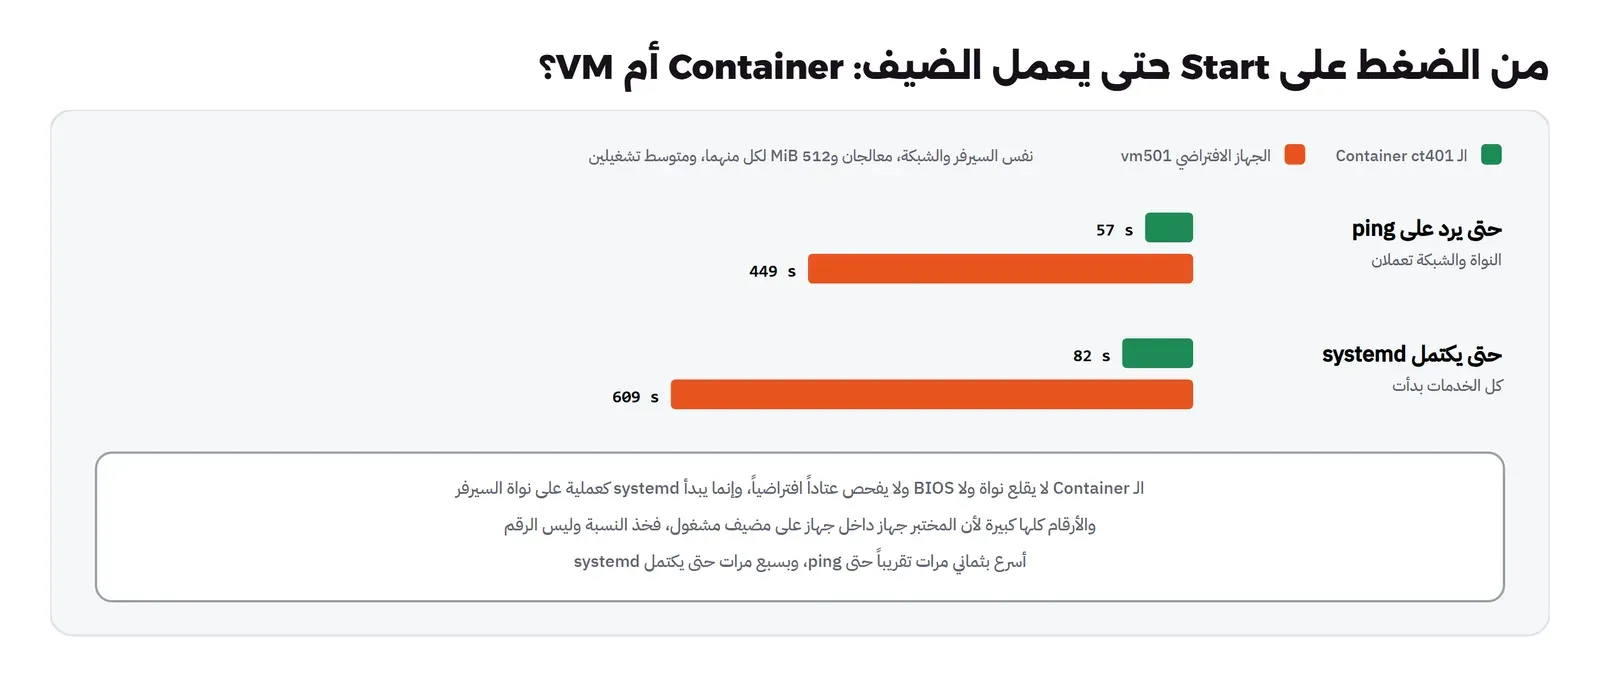
والأرقام نفسها كبيرة جداً، وهذا متوقع في مختبرنا: Proxmox يعمل داخل جهاز افتراضي، والجهاز vm501 جهاز داخل جهاز داخل WSL2، والمضيف كان يشغل في نفس الوقت أعمالاً أخرى، وعلى سيرفر حقيقي يقلع الـ Container في ثوان والجهاز في أقل من دقيقة. ولكن النسبة هي ما يعنينا: الـ Container رد على ping أسرع بقرابة ثماني مرات، ووصل إلى نهاية الإقلاع أسرع بقرابة سبع مرات، والسبب أنه لا يقلع BIOS ولا نواة ولا يكتشف عتاداً، وإنما يبدأ systemd كعملية على نواة تعمل أصلاً. ثم قسنا ما يأخذه كل منهما من السيرفر بعد الإقلاع وهو خامل:
cat /sys/fs/cgroup/lxc/401/memory.current
awk '/VmRSS/{print $2}' /proc/$(cat /var/run/qemu-server/501.pid)/status
zfs list -o name,used,refer tank/subvol-401-disk-0 tank/vm-501-disk-0
pct exec 401 -- ps -e --no-headers | wc -l
ssh [email protected] "ps -e --no-headers | wc -l; free -m | head -2; uname -r"
pct exec 401 -- uname -r
CT401 memory.current: 16113664
VM501 qemu RSS kB: 296132
NAME USED REFER
tank/subvol-401-disk-0 315M 315M
tank/vm-501-disk-0 714M 714M
14
104
total used free shared buff/cache available
Mem: 464 86 288 0 102 377
6.12.115+deb13.1-cloud-amd64
7.0.14-26-pve| القياس | Container ct401 | جهاز افتراضي vm501 |
|---|---|---|
| الذاكرة التي يأخذها من السيرفر وهو خامل | 16 MiB | 289 MiB لعملية QEMU |
| الذاكرة التي يراها النظام داخله | 512 MiB | 464 MiB، والباقي للنواة والعتاد الافتراضي |
| عدد العمليات داخله | 14 | 104، ومنها خيوط النواة |
| القرص على ZFS | 315 MiB | 714 MiB |
| النواة | 7.0.14-26-pve، نواة المضيف | 6.12.115+deb13.1، نواة خاصة به |
| من التشغيل حتى ping، متوسط تشغيلين | 57 ثانية | 449 ثانية |
وأهم سطر في الجدول هو الأول: الـ Container خامل يأخذ 16 MiB، والجهاز الافتراضي خامل يأخذ 289 MiB، أي قرابة 18 ضعفاً، والسبب أن الجهاز الافتراضي يحمل نواة كاملة وذاكرة مؤقتة لنظام ملفاته وعملية QEMU نفسها، بينما الـ Container مجموعة عمليات عادية. فإذا كان لدى الفريق عشرون خدمة صغيرة، فالفرق بين تشغيلها في Containers وفي أجهزة افتراضية قرابة 5 GiB من الذاكرة الخاملة وحدها، قبل أن تعمل الخدمات أصلاً. والقرص أيضاً أقل من النصف، لأن القالب لا يحمل نواة ولا أدوات إقلاع ولا تعريفات.
وقد يتساءل البعض: لماذا يأخذ الجهاز الافتراضي الخامل 289 MiB وهو لا يفعل شيئاً، والنظام داخله يقول إنه يستخدم 86 MiB فقط؟ والإجابة في طبقتين من الذاكرة لا يراهما النظام داخله. فالأولى هي الذاكرة المؤقتة لنظام الملفات، وهي 102 MiB في سطر buff/cache، لأن النظام الضيف يحتفظ بما قرأه من قرصه أثناء الإقلاع، وهذه الذاكرة من وجهة نظر المضيف صفحات لمسها الضيف فأصبحت محجوزة له، ولا يعيدها المضيف إلا إذا طلبها Ballooning. والثانية هي عملية QEMU نفسها بمحاكاة الأجهزة وخيوطها، كما رأينا في المقال الأول من المرحلة. أما الـ Container فذاكرته المؤقتة لنظام الملفات هي ذاكرة المضيف المؤقتة نفسها، يتشاركها مع كل الـ Containers ويستطيع المضيف أن يحررها متى احتاج، فلا يحسب على الـ Container إلا ما تحجزه عملياته فعلاً. وهذا هو المعنى العملي لعبارة «Container أخف من الجهاز الافتراضي»: ليس أن تطبيقك يعمل أسرع في الحساب، فالحساب في الحالتين على المعالج نفسه بسرعة قريبة من العتاد، وإنما أن الثمن الثابت لكل نسخة، أي النواة والذاكرة المؤقتة والإقلاع، يختفي تقريباً.
الـ Snapshots مع النسخ الاحتياطي للـ Container
بعد أن انتهينا من تجربة المجلد المربوط أردنا أن نأخذ Snapshot للـ Container قبل تحديثه، كما يفعل أي مدير قبل أي تغيير، فكانت النتيجة هذه:
pct snapshot 401 before-upgradesnapshot feature is not availableوالـ Container على ZFS الذي يدعم الـ Snapshots كما قسنا في مقال التخزين، فلماذا؟ والسبب المجلد المربوط mp0: الـ Snapshot في Proxmox يجب أن يشمل كل أقراص الـ Container، والمجلد المربوط ليس قرصاً يديره المخزن، فلا يمكن أخذ Snapshot له، وبالتالي يرفض Proxmox الطلب كله. ثم حذفنا mp0 بالأمر pct set 401 --delete mp0 والـ Container يعمل، وجربنا مرة أخرى فرفض بنفس الرسالة، والسبب هذه المرة ظهر في الأمر pct pending:
del mp0: /mnt/bindmounts/shared,mp=/sharedأي أن الحذف معلق Pending حتى يعاد تشغيل الـ Container، لأن LXC لا يستطيع فصل نقطة تركيب من Container يعمل. وبعد إعادة التشغيل نجح الأمر:
thaw guest filesystem
pct snapshot after reboot without mp0: 19957 ms
tank/subvol-401-disk-0@before-upgrade     0B   315M
ولاحظ السطر thaw guest filesystem، فـ Proxmox يجمد نظام ملفات الـ Container لحظة أخذ الـ Snapshot حتى يكون متسقاً، ثم يذيبه. والدرس العملي: إذا كنت تعتمد على الـ Snapshots قبل التحديثات، فلا تضع مجلدات مربوطة في نفس الـ Container، وضع البيانات المشتركة على نقطة تركيب يديرها المخزن، أي قرص إضافي mp0: tank:4 بدل مسار من المضيف، فهذه تدخل في الـ Snapshot وفي النسخة الاحتياطية.
أما النسخ الاحتياطي فنجح والمجلد المربوط موجود، وهذا ما قاله vzdump:
vzdump 401 --mode snapshot --compress zstd --storage localINFO: Starting Backup of VM 401 (lxc)
INFO: including mount point rootfs ('/') in backup
INFO: excluding bind mount point mp0 ('/shared') from backup (not a volume)
INFO: backup mode: snapshot
INFO: creating vzdump archive '/var/lib/vz/dump/vzdump-lxc-401-2026_11_04-12_18_56.tar.zst'
INFO: Total bytes written: 579543040 (553MiB, 580KiB/s)
INFO: archive file size: 160MB
INFO: Finished Backup of VM 401 (00:16:33)وفيما يلي ما يقوله المخرج:
excluding bind mount point mp0: ما حذر منه التوثيق، فالمجلد المربوط لم ينسخ، والنسخة الاحتياطية للـ Container لا تحمل بيانات/shared.backup mode: snapshot: لم يتوقف الـ Container أثناء النسخ، فقد أخذvzdumpSnapshot مؤقتاً وركبه في/mnt/vzsnap0ونسخ منه.- 553 MiB من الملفات أصبحت أرشيفاً بحجم 160 MB بضغط zstd، والنسخة نفسها أخذت أكثر من 16 دقيقة بسرعة 580 KiB في الثانية، وهذا بطء المختبر المتداخل، ولاحظ أن الأرشيف هنا ملف
tarعادي يقرأ ملفات الـ Container واحداً واحداً، بخلاف نسخ الأجهزة الافتراضية التي تقرأ القرص كتلة كتلة، ولذلك يتأثر زمن نسخ الـ Containers بعدد الملفات أكثر من حجمها.
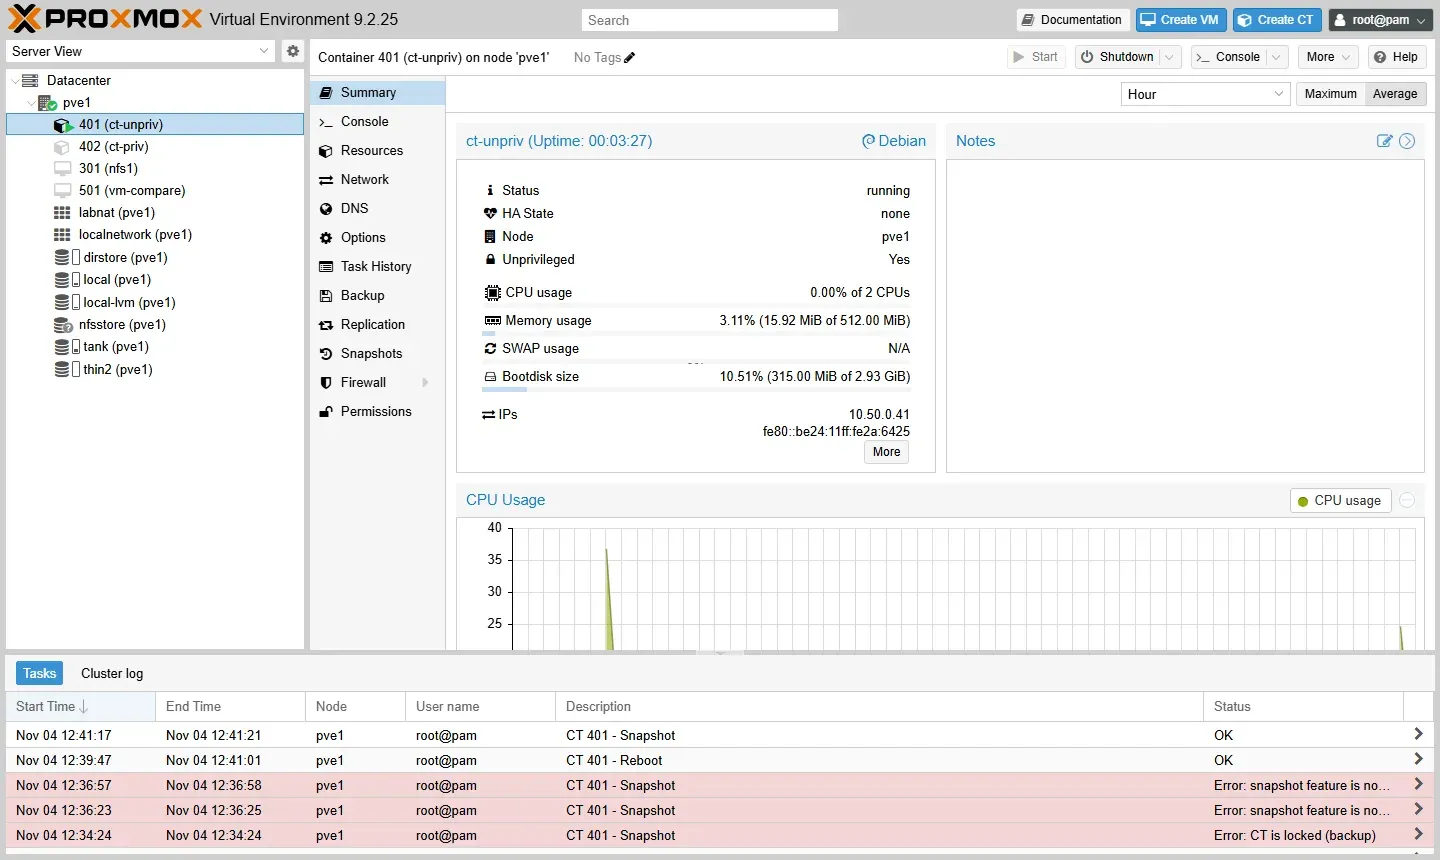
والصورتان التاليتان من صفحة الـ Container في الواجهة بعد هذه التجارب، وفي الأولى لاحظ استهلاك الذاكرة 15.92 MiB من 512 MiB، وفي قائمة المهام أسفل الصورتين محاولات الـ Snapshot الفاشلة التي شرحناها:
الشبكة في الـ Container: veth مع الجسر
من ناحية الشبكة لا يوجد فرق يذكر بين الـ Container والجهاز الافتراضي في Proxmox، وهذا من أجمل ما فيه. فكل بطاقة في الـ Container زوج veth: طرف داخل الـ Container باسم eth0، وطرف على المضيف باسم مثل veth401i0 يتصل بنفس الجسر الذي تختاره، مع نفس خيارات الوسم tag وtrunks والجدار الناري التي شرحناها في مقال الشبكات، ويظهر في الشبكة بعنوان MAC خاص به كأي جهاز. والفرق الوحيد أن Proxmox يكتب إعداد الشبكة داخل الـ Container بنفسه عند كل تشغيل، فالعنوان والبوابة وسيرفر DNS في سطر net0 وفي nameserver، وهو يعرف طريقة الإعداد في كل توزيعة يدعمها، مثل ملفات /etc/network/interfaces في Debian، ولا يحتاج cloud-init. وبالتالي إذا غيرت العنوان من الواجهة فلا تعدله داخل الـ Container يدوياً، لأن Proxmox يعيد كتابته عند التشغيل التالي. ولاحظ أن تحذير الوسم الذي رأيناه في مقال الشبكات ينطبق هنا تماماً: الـ Container دون وسم على جسر واع بالـ VLAN يستطيع أن ينشئ بطاقة VLAN بنفسه ويدخل أي شبكة على الجسر، وقد فعلنا ذلك هناك من Container فعلاً.
الإدارة اليومية: pct enter مع push ثم resize
الـ Container يدار مثل السيرفر، ولكن Proxmox يعطيك طرقاً مختصرة لا توجد مع الأجهزة الافتراضية، لأن المضيف يرى ملفاته وعملياته مباشرة:
pct enter 401: يفتح Shell داخل الـ Container كـ root دون SSH ودون كلمة مرور، وهو ما استخدمناه في كل الأوامر أعلاه عبرpct execالذي ينفذ أمراً واحداً ويرجع. وهذا يعني أيضاً أن أي شخص لديه root على المضيف لديه root على كل الـ Containers، وهذا طبيعي، ولكن تذكره عند توزيع الصلاحيات.pct pushوpct pull: ينسخان ملفاً من المضيف إلى الـ Container أو العكس، مع الانتباه إلى الملكية كما في قسم المجلدات المربوطة.pct resize: يكبر قرص الـ Container وهو يعمل. وعلى ZFS لم يكن التكبير إلا تغيير الحد، فبعدpct resize 401 rootfs +2Gأصبحrefquotaبقيمة 6G دون أي عملية على نظام الملفات، وداخل الـ Container عرضdfحجماً أصغر من 6G لأن المجمع نفسه أصغر من ذلك، فالمساحة المتاحة الحقيقية هي الأقل بين الحد والمساحة الحرة في المجمع. وعلى LVM-thin يكبر Proxmox القرص ونظام الملفات عليه معاً.- التحديثات: تحدث نظام الـ Container بالأمر
aptمن داخله كما تحدث أي سيرفر، أما النواة فلا تحدث داخله، لأنها نواة المضيف، وتحديثها يعني تحديث Proxmox نفسه وإعادة تشغيله، وهذا يوقف كل الـ Containers على السيرفر معاً.
تمرير الأجهزة إلى الـ Container Device Passthrough
من أشهر استخدامات LXC في الهوم لاب تشغيل سيرفر وسائط مثل Jellyfin مع بطاقة الرسومات للتحويل Transcoding، والسبب أن الـ Container يستطيع أن يستخدم جهازاً من المضيف دون تمرير PCI كامل كما في الجهاز الافتراضي، فتستطيع عدة Containers أن تتشارك نفس البطاقة. ويوفر Proxmox لذلك الخيار dev0 في إعداد الـ Container، ويأخذ مسار الجهاز في المضيف مثل /dev/dri/renderD128، مع خيارات uid وgid وmode لتحديد ملكيته داخل الـ Container، وdeny-write لمنع الكتابة. ولاحظ أنك هنا تفتح باباً من الـ Container إلى تعريف جهاز في نواة المضيف، وأي ثغرة في ذلك التعريف تصبح طريقاً محتملاً للخروج، لذلك مرر أقل ما تحتاجه، والأفضل جهاز للقراءة والتحويل فقط مثل renderD128، وليس كل مجلد /dev/dri.
نقل الـ Container بين السيرفرات Migration
ذكرنا في البداية أن الـ Container لا ينتقل وهو يعمل، وهذا يستحق تفصيلاً لأن الفريق القادم من VMware اعتاد على vMotion. فالتوثيق يشرح أن النقل بين سيرفرات العنقود إما دون تشغيل Offline، أو بإعادة التشغيل Restart Migration بالخيار --restart مع الأمر pct migrate، وفيها يطفئ Proxmox الـ Container، وينتظر حتى 180 ثانية افتراضياً ثم يقتله إذا لم يتوقف، ثم ينقله وينشئه على السيرفر الآخر ويشغله. أي أن كل نقل يعني توقف الخدمة لمدة الإطفاء والنقل والإقلاع، وعلى مخزن مشترك يكون النقل نفسه سريعاً لأن القرص لا ينسخ، وعلى مخزن محلي يأخذ وقت نسخ القرص كاملاً. وبالتالي فالخدمات التي تحتاج أن تبقى أثناء صيانة السيرفرات إما أن تعمل في أجهزة افتراضية على مخزن مشترك، أو أن تكون مكررة في أكثر من Container على أكثر من سيرفر خلف موزع طلبات، وهذا هو الحل الأفضل في الحالتين كما شرحنا في مفاهيم التوفر العالي.
قائمة تقوية للـ Containers Hardening
بعد كل ما سبق نستطيع أن نكتب قائمة قصيرة يطبقها الفريق على كل Container قبل أن يضع عليه خدمة حقيقية، ولكل بند منها سبب رأيناه في هذا المقال:
- Unprivileged دائماً: لأن الخروج من الـ Container عندها يعطي المستخدم 100000 وليس root، ولأن فريق LXC يعامل ثغراته كثغرات حقيقية.
- أقل ما يلزم من الخيارات
features:nestingللتوزيعات الحديثة فقط، ولا تفعلkeyctlأوmknodأوfuseإلا لسبب محدد تعرفه، لأن كل خيار منها يفتح للـ Container جزءاً من النواة كان مغلقاً. - AppArmor مفعل: لا تضع
lxc.apparmor.profile = unconfinedفي أي Container إنتاجي مهما كانت المشكلة التي تحلها، فالتوثيق يحذر من ذلك صراحة. - حد للذاكرة والمعالج: رأينا أن الحد يحمي الجيران دون أن يبطئ الـ Container في عمله العادي.
- وسم VLAN وجدار ناري على البطاقة: نفس قواعد الأجهزة الافتراضية، فالـ Container على الشبكة جهاز مثل غيره.
- مجلدات مربوطة من مكان مخصص بملكية محسوبة: من
/mnt/bindmountsوما يشبهه، وبالرقم المقابل للمستخدم، دون مجلدات النظام. - تحديث النظام داخل كل Container: فـ Proxmox يحدث نواة المضيف، ولكن الحزم داخل كل Container مسؤوليتك، والتحديثات الأمنية التلقائية فيه مثل أي سيرفر، كما في تأمين خادم VPS من أول دخول.
وماذا عن Docker داخل LXC؟
هذا من أكثر الأسئلة تكراراً، والإجابة المختصرة: ممكن، ولا ننصح به للإنتاج. فالتوثيق يذكر في وصف الخيار keyctl أنه مطلوب لتشغيل Docker داخل Container من نوع Unprivileged، ومعه nesting، ويشرح أن تفعيل keyctl يجعلك تختار بين Docker وsystemd-networkd داخل نفس الـ Container. ثم تأتي مشكلات أخرى من طبقتين من الـ Containers فوق نواة واحدة: نظام تخزين Docker فوق نظام ملفات الـ Container، والشبكات المتداخلة، والتحديثات التي تغير سلوك AppArmor أو systemd فتوقف Docker بعد تحديث السيرفر. والتوثيق نفسه، كما ذكرنا في البداية، يقول إن الحالات التي تحتاج أقصى عزل والنقل الحي يناسبها تشغيل الـ Containers داخل جهاز افتراضي. لذلك القاعدة العملية: خدمات النظام الصغيرة مثل DNS والمراقبة والـ Proxy في LXC، وتطبيقات Docker في جهاز افتراضي واحد أو أكثر، كما في مقالات Docker في الموقع.
LXC أم جهاز افتراضي؟ Decision Table
| الحالة | الأنسب | السبب |
|---|---|---|
| خدمة Linux صغيرة طويلة العمر: DNS، Proxy، مراقبة، Wiki | LXC بنوع Unprivileged | إقلاع في ثوان، وذاكرة بقدر الاستخدام، وإدارة مثل السيرفر |
| نظام غير Linux، أو نواة مختلفة، أو وحدات نواة خاصة | جهاز افتراضي | الـ Container يشارك نواة المضيف ولا يغيرها |
| تطبيقات Docker | جهاز افتراضي فيه Docker | دون طبقتين من الـ Containers ودون خيارات تضعف العزل |
| خدمة لا تحتمل التوقف عند الصيانة | جهاز افتراضي على مخزن مشترك | النقل الحي متاح للأجهزة الافتراضية فقط |
| عملاء أو فرق لا تثق ببعضها | جهاز افتراضي | حدود العتاد الافتراضي أقوى من حدود النواة المشتركة |
| تطبيق يحتاج وصولاً مباشراً إلى بطاقة أو جهاز | جهاز افتراضي مع تمرير PCI، أو LXC مع حذر شديد | تمرير الأجهزة إلى Container يحتاج صلاحيات تضعف العزل |
أخطاء شائعة Common Mistakes
- التحويل إلى Privileged لحل مشكلة صلاحيات: الحل ملكية المجلد للرقم المقابل أو خريطة
lxc.idmap، وليس root حقيقياً داخل الـ Container. - نسيان
nestingمع توزيعات حديثة: systemd يفشل في عزل خدماته، فيصل النظام إلىdegraded، ومنها الشبكة أحياناً. - ربط مجلدات النظام: لا تربط
/أو/etcأو/varفي أي Container، واستخدم مجلدات مخصصة. - الافتراض أن النسخ الاحتياطي يشمل المجلدات المربوطة:
vzdumpلا ينسخ محتواها، فانسخها بطريقة أخرى. - Container دون حد ذاكرة مناسب: تطبيق يتسرب منه الذاكرة يقتل داخل حده، وهذا جيد، بشرط أن يكون الحد معقولاً وأن تراقب رسائل OOM.
- الاعتماد على النقل الحي: الـ Container يتوقف ثم يبدأ عند نقله، فخطط للصيانة على هذا الأساس.
- المنطقة الزمنية: القالب يأتي بتوقيت UTC، فاضبطه حتى تتطابق السجلات.
حذف المختبر Cleanup
for i in 401 402; do pct stop $i; pct destroy $i; done
qm stop 501; qm destroy 501
rm -rf /mnt/bindmounts/shared
الخلاصة Summary
وصلنا لنهاية الموضوع، وهذا ما يكتبه الفريق للمدير:
- LXC في Proxmox Container لنظام كامل فيه systemd وSSH، على نواة المضيف، وتديره مثل السيرفر، ويختلف عن Docker في الفكرة وليس في التقنية.
- Unprivileged يجعل root داخله المستخدم 100000 على المضيف، وPrivileged يجعله root حقيقياً، والفرق كله يظهر عند أي خروج من الـ Container أو أي مجلد مربوط.
- القوالب الحديثة تحتاج
nesting=1حتى يعمل systemd دون خدمات فاشلة. - تجاوز حد الذاكرة قتل البرنامج داخل الـ Container وحده، وسقف 0.5 أعطى نصف معالج بالضبط، والـ Container يرى حدوده لا ذاكرة السيرفر.
- المجلد المربوط يحتاج ملكية بالرقم المقابل في Unprivileged، ولا تحول إلى Privileged لحل ذلك، وهو يمنع الـ Snapshots ولا يدخل في النسخة الاحتياطية، فضع البيانات المهمة على قرص يديره المخزن.
- الـ Container الخامل أخذ 16 MiB من ذاكرة السيرفر مقابل 289 MiB للجهاز الافتراضي بنفس المواصفات، وقرصه أقل من النصف، وإقلاعه أسرع بسبع إلى ثماني مرات، وهذا هو التوفير الذي يبحث عنه من يشغل عشرات الخدمات الصغيرة، بشرط ألا تحتاج نقلاً حياً أو نواة خاصة أو عزلاً أقوى من النواة المشتركة.
وفي المقال القادم بإذن الله نخرج من Proxmox قليلاً لنرى KVM على سيرفر Linux عادي مع libvirt، حتى تعرف ما الذي يضيفه Proxmox فوقه.
 دليلالمحاكاة الافتراضية Virtualization: من Hypervisor إلى KVMماذا يحدث داخل المعالج عندما يعمل نظام كامل فوق نظام آخر، ومتى تختار جهازاً افتراضياً ومتى يكفيك Container، مع قياس حقيقي لنفس الجهاز مع KVM أو دونه.
 دليلالتخزين في Proxmox: ZFS أو LVM-thin أو NFS، ومتى Ceph؟بنينا أربعة مخازن على سيرفر Proxmox واحد وقسنا ما يأخذه القرص والـ Snapshot من كل منها، ثم ملأنا مخزناً رقيقاً عمداً لنرى ما يحدث للأجهزة عندما نعدها بأكثر مما نملك.
 دليلتأمين Proxmox VE: الصلاحيات، 2FA، الجدار الناري، التحديثاتست طبقات تحمي سيرفر Proxmox بعد التثبيت، جربنا كل واحدة منها بحركة حقيقية من داخل الشبكة وخارجها.
 دليلتثبيت Docker Engine وCompose على Ubuntuكيف تثبت Docker على Ubuntu من المستودع الرسمي، وتضبطه من البداية حتى لا يمتلئ القرص أو تنكشف منافذك للإنترنت.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة الدليل وتنفيذ المختبر على Proxmox VE 9.2 (pve-manager 9.2.25، النواة 7.0.14-26)، مع القالب debian-13-standard_13.6-1 وجهاز Debian 13 من Image السحابة للمقارنة.


