


في VMware كان جواب سؤال «أين تعيش أقراص الأجهزة؟» واحداً عند أغلب الفرق: مخزن Datastore بنظام VMFS على وحدة تخزين SAN مشتركة، وكل السيرفرات تراه. وعندما بدأ الفريق الذي نتابعه في هذه المرحلة يخطط للانتقال إلى Proxmox VE، وجد في صفحة Storage قائمة طويلة من الخيارات: ZFS وLVM وLVM-thin وDirectory وNFS وCIFS وCeph وiSCSI، وكل منتدى ينصح بخيار مختلف. فبعضهم يقول إن ZFS هو الخيار الوحيد المعقول، وآخر يقول إن LVM-thin أسرع، وثالث يقول إن أي عنقود جاد يحتاج Ceph. والأسئلة التي طرحها مدير الفريق كانت عملية: إذا أعطينا جهازاً قرصاً بحجم 500 GB فهل يأخذ 500 GB من المخزن من أول يوم؟ وكم يأخذ الـ Snapshot؟ وماذا يحدث إذا وعدنا الأجهزة بمساحة أكبر مما عندنا؟ ومتى نحتاج Ceph فعلاً؟
وقد شرحنا الفرق العام بين التخزين الكتلي وتخزين الملفات في أنواع التخزين، وشرحنا ZFS من الداخل في ZFS للمبتدئين، فلن نعيد ذلك هنا. وهذا المقال عن التخزين داخل Proxmox تحديداً، بمختبر على نفس سيرفر المختبر الذي ثبتناه في مقال التثبيت، أضفنا إليه خمسة أقراص وبنينا عليه أربعة مخازن، ثم قسنا كل شيء بالأرقام. وسوف نناقش في هذا المقال ما يلي:
- ما هو المخزن Storage في Proxmox، والفرق بين المخزن المحلي والمشترك، وبين الكتلي والملفات.
- بناء أربعة مخازن: ZFS بمرآة، وLVM-thin، ومجلد Directory بصيغة qcow2، وNFS من سيرفر آخر، ومشكلتان واجهناهما.
- التخصيص المرن Thin Provisioning بالأرقام: قرص 8 GiB، كم أخذ من كل مخزن بعد كل خطوة.
- الـ Snapshots من الداخل، وكم تأخذ من المساحة، وكيف يعمل الرجوع Rollback.
- ماذا يحدث فعلاً عندما يمتلئ مخزن LVM-thin وعليه أقراص وعدناها بأكثر من حجمه.
- متى يستحق Ceph تعقيده، وما البدائل لعنقود صغير.
ماذا يعني المخزن في Proxmox؟ Storage
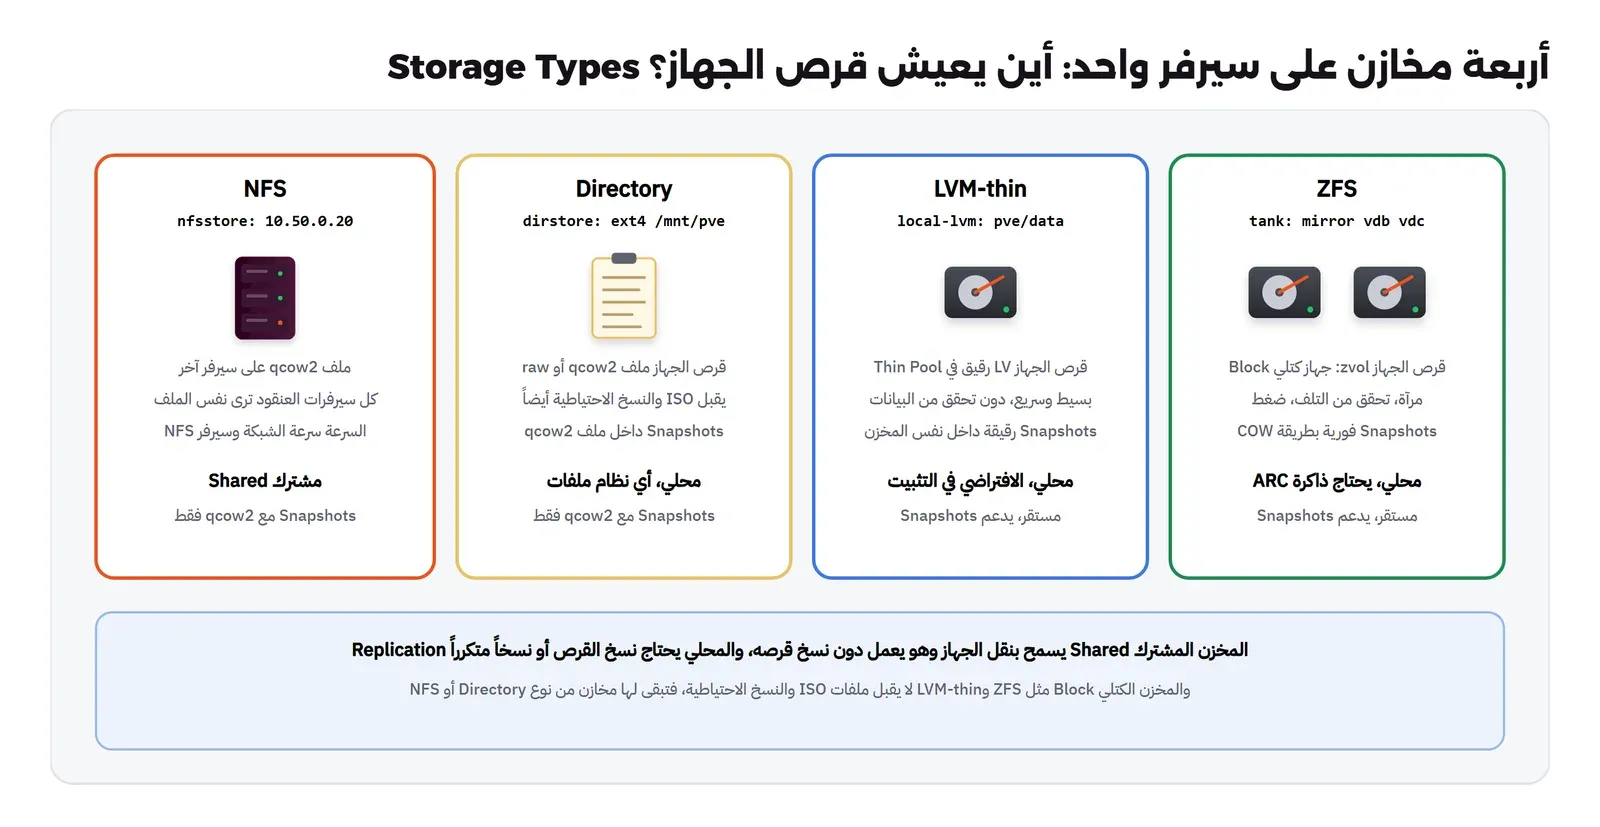
المخزن Storage في Proxmox هو أي مكان يحفظ فيه السيرفر شيئاً من أشيائه: أقراص الأجهزة الافتراضية Disk Images، وأقراص الـ Containers، وملفات ISO، وقوالب الـ Containers، والنسخ الاحتياطية Backups. وكل مخزن له سطر في ملف واحد هو /etc/pve/storage.cfg، وهذا الملف داخل نظام ملفات العنقود، أي أن كل سيرفرات العنقود ترى نفس قائمة المخازن. ولكل مخزن نوع Plugin يحدد كيف يتعامل Proxmox معه، وقائمة محتوى Content تحدد ما يسمح بوضعه فيه. وفي فصل التخزين في التوثيق جدول بكل الأنواع وثلاث خصائص لكل نوع، وهي الخصائص التي تحدد اختيارك:
- المستوى Level: مخازن الملفات File Level مثل Directory وNFS تحفظ القرص ملفاً بصيغة qcow2 أو raw، وتقبل أيضاً ملفات ISO والنسخ الاحتياطية. ومخازن الكتل Block Level مثل LVM-thin تعطي كل قرص جهازاً كتلياً مستقلاً، ولا تقبل إلا أقراص الأجهزة والـ Containers. أما ZFS فيصنفه الجدول في الاثنين، لأن أقراص الأجهزة عليه zvol كتلية، وأقراص الـ Containers مجلدات Datasets.
- المشاركة Shared: المخزن المشترك مثل NFS وCeph تراه كل السيرفرات في نفس الوقت، فتنقل الجهاز من سيرفر إلى آخر وهو يعمل دون أن تنسخ قرصه، أما المحلي مثل ZFS وLVM-thin فالقرص على سيرفر واحد، ونقله يعني نسخه.
- الـ Snapshots: ZFS وLVM-thin وCeph تدعمها في كل الحالات، أما Directory وNFS فتدعمها فقط عندما يكون القرص بصيغة qcow2، والسبب أن الـ Snapshot هنا تنفذه صيغة الملف نفسها وليس المخزن.
والصورة التالية تبين المخازن الأربعة التي بنيناها في المختبر:
من VMFS إلى Proxmox: ماذا يقابل ماذا؟
الفريق القادم من VMware يسأل أولاً عن وحدة SAN التي اشتراها قبل سنوات: هل تذهب إلى المخزن؟ والإجابة لا، ولكن طريقة استخدامها تختلف. ففي VMware كان كل LUN يحمل نظام ملفات VMFS العنقودي، وكل سيرفر يقرأ ويكتب فيه ملفات الأقراص بنفسه. أما في Proxmox فلا يوجد نظام ملفات عنقودي يقابل VMFS، والطريقة التي يشرحها التوثيق للوحدات المشتركة عبر iSCSI أو Fibre Channel أو SAS هي LVM عادي، أي غير رقيق، فوق الـ LUN، فيقسمه إلى أقراص كتلية لكل جهاز، وتراه كل السيرفرات مع Multipath في الغالب. وكان القيد التاريخي لهذا الإعداد أنه لا يدعم الـ Snapshots، ثم أضاف Proxmox VE 9 ما يسميه التوثيق Snapshots كسلسلة أقراص Volume Chain، حيث يكون لكل Snapshot قرص منفصل فوق القرص الأصلي، وهو ما يجعل الوحدات المشتركة القديمة خياراً معقولاً بعد الانتقال. والجدول التالي يلخص المقابلات:
| في VMware | المقابل في Proxmox VE | ملاحظة |
|---|---|---|
| Datastore بنظام VMFS على SAN | LVM مشترك فوق LUN من iSCSI أو FC | Snapshots كسلسلة أقراص منذ الإصدار 9 |
| Datastore من NFS | مخزن NFS | نفس الفكرة، والقرص ملف qcow2 أو raw |
| vSAN | Ceph داخل العنقود | تخزين موزع على أقراص السيرفرات نفسها |
| Datastore محلي | ZFS أو LVM-thin محلي | مع Replication في ZFS لنسخة على سيرفر آخر |
| ملف VMDK | قرص raw أو qcow2 | أداة الاستيراد تحوله، وسوف نشرحها في مقال الانتقال من VMware |
المختبر Lab: أربعة مخازن على سيرفر واحد
أضفنا إلى سيرفر المختبر خمسة أقراص virtio بحجم 4 GiB لكل منها، وكل قرص ملف qcow2 رقيق على المضيف، وأعطيناها أرقاماً تسلسلية حتى نعرفها داخل Proxmox:
NAME                  SIZE SERIAL  TYPE
vda                    64G         disk
vdb                     4G ST-B    disk
vdc                     4G ST-C    disk
vdd                     4G ST-D    disk
vde                     4G ST-E    disk
vdf                     4G ST-F    disk
ثم أنشأنا المخازن الثلاثة المحلية بالواجهة البرمجية، وهي نفس ما يفعله زر Create في صفحات Disks ثم ZFS وLVM-Thin وDirectory في الواجهة:
pvesh create /nodes/pve1/disks/zfs --name tank --raidlevel mirror --devices /dev/vdb,/dev/vdc \
  --ashift 12 --compression lz4 --add_storage 1
pvesh create /nodes/pve1/disks/lvmthin --name thin2 --device /dev/vdd --add_storage 1
pvesh create /nodes/pve1/disks/directory --name dirstore --device /dev/vdf --filesystem ext4 --add_storage 1
zpool status tank
cat /etc/pve/storage.cfg
# /sbin/zpool create -o ashift=12 tank mirror /dev/vdb /dev/vdc
# /sbin/zfs set compression=lz4 tank
# systemctl enable [email protected]
Volume group "thin2" successfully created
Thin pool volume with chunk size 64.00 KiB can address at most <15.88 TiB of data.
# /sbin/mkfs -t ext4 /dev/vdf1
Created symlink '/etc/systemd/system/multi-user.target.wants/mnt-pve-dirstore.mount' -> '/etc/systemd/system/mnt-pve-dirstore.mount'.
pool: tank
state: ONLINE
NAME STATE READ WRITE CKSUM
tank ONLINE 0 0 0
mirror-0 ONLINE 0 0 0
vdb ONLINE 0 0 0
vdc ONLINE 0 0 0
zfspool: tank
pool tank
content images,rootdir
mountpoint /tank
nodes pve1
lvmthin: thin2
thinpool thin2
vgname thin2
content images,rootdir
nodes pve1
dir: dirstore
path /mnt/pve/dirstore
content iso,rootdir,vztmpl,snippets,images,backup
is_mountpoint 1
nodes pve1في المخرج أعلاه لاحظ التالي:
- الأسطر التي تبدأ بـ
#هي الأوامر الحقيقية التي نفذها Proxmox، وهذا مفيد إذا أردت أن تعرف ما يحدث خلف الزر:zpool createمعashift=12، أي كتل بحجم 4 KiB تناسب الأقراص الحديثة، ثم تفعيل الضغط lz4. - المخازن الثلاثة عليها
nodes pve1، أي أنها محلية لهذا السيرفر، وفي عنقود لن تظهر على غيره. - مخزن المجلد عليه
is_mountpoint 1، وهذه حماية مهمة: Proxmox لا يكتب في المجلد إلا إذا كان القرص مركباً فعلاً، وإلا فلو فشل تركيب القرص لكتبت الأجهزة والنسخ الاحتياطية في قرص النظام دون أن تنتبه حتى يمتلئ.
سيرفر NFS في جهاز افتراضي
المخزن الرابع يحتاج سيرفر NFS خارج Proxmox، ففي شركة حقيقية يكون جهاز NAS أو سيرفر تخزين كما شرحنا في الفرق بين NAS وSAN. وفي المختبر شغلناه في جهاز افتراضي صغير من Alpine Linux على شبكة معزولة من نوع Simple Zone، وهي نفس الشبكة التي شرحناها في مقال الشبكات، ثم أضفناه مخزناً:
apk add nfs-utils
echo "/srv/nfs 10.50.0.1(rw,no_root_squash,sync,no_subtree_check)" > /etc/exports
rc-service nfs start

# on pve1
pvesm add nfs nfsstore --server 10.50.0.20 --export /srv/nfs --content images,backup --options vers=4.2
mount | grep nfsstore
10.50.0.20:/srv/nfs on /mnt/pve/nfsstore type nfs4 (rw,relatime,vers=4.2,rsize=65536,wsize=65536,namlen=255,hard,fatal_neterrors=none,proto=tcp,timeo=600,retrans=2,sec=sys,clientaddr=10.50.0.1,local_lock=none,addr=10.50.0.20)ولاحظ في سطر /etc/exports أننا سمحنا لعنوان سيرفر Proxmox وحده، ومع no_root_squash، والسبب أن Proxmox يكتب ملفات الأقراص بصلاحية root، وبدون هذا الخيار يحول سيرفر NFS طلبات root إلى مستخدم بلا صلاحيات فتفشل الكتابة. ولهذا السبب نفسه لا تجعل التصدير مفتوحاً لكل الشبكة. وفي مخرج mount لاحظ الخيار hard، وهو الافتراضي، ويعني أن العميل يعيد المحاولة إلى ما لا نهاية إذا لم يرد السيرفر بدل أن يعيد خطأ، وهذا ما تريده لأقراص الأجهزة حتى لا تتلف أنظمة ملفاتها عند انقطاع قصير، ولكنه يعني أيضاً أن الأجهزة تتجمد كلها إذا توقف سيرفر NFS.
وفي الطريق واجهتنا مشكلة صغيرة تستحق الذكر: الأمر apk add nfs-utils رد بأن الحزمة غير موجودة، مع أن الشبكة تعمل. والسبب أن Image السحابة من Alpine لم تطبق سيرفر DNS الذي كتبناه في إعداد cloud-init في Proxmox، فلم يوجد الملف /etc/resolv.conf أصلاً، ففشل تنزيل فهرس الحزم بخطأ مؤقت، وظهر الفشل بعدها على أنه حزمة غير موجودة. لذلك إذا رأيت خطأ «no such package» في جهاز جديد فتحقق من DNS أولاً بالأمر apk update وقراءة رسائله، قبل أن تبحث عن اسم الحزمة.
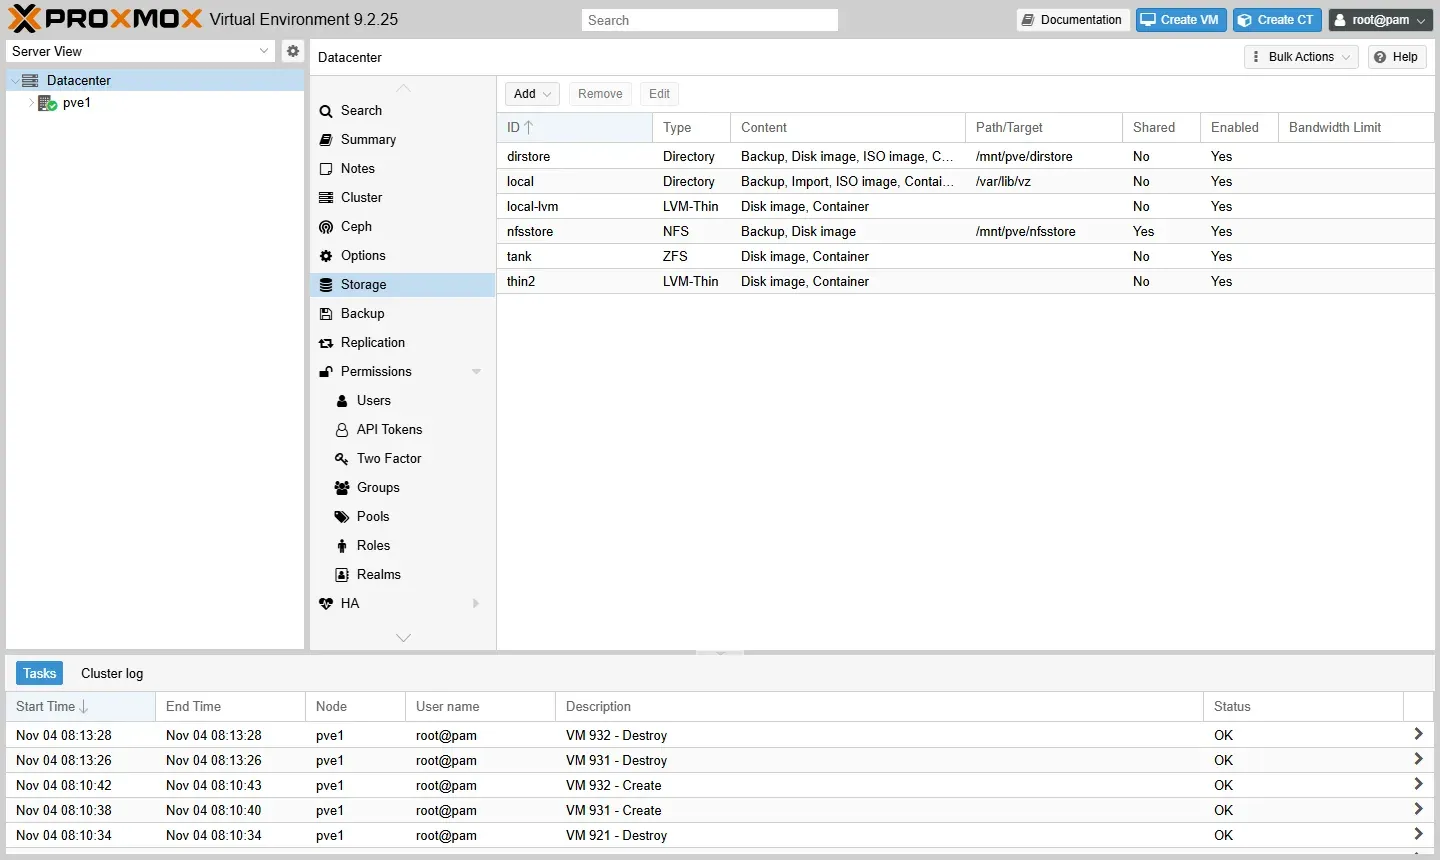
والصورة التالية من صفحة Storage في Datacenter بعد إضافة المخازن الأربعة:
ZFS: مرآة مع تحقق من البيانات
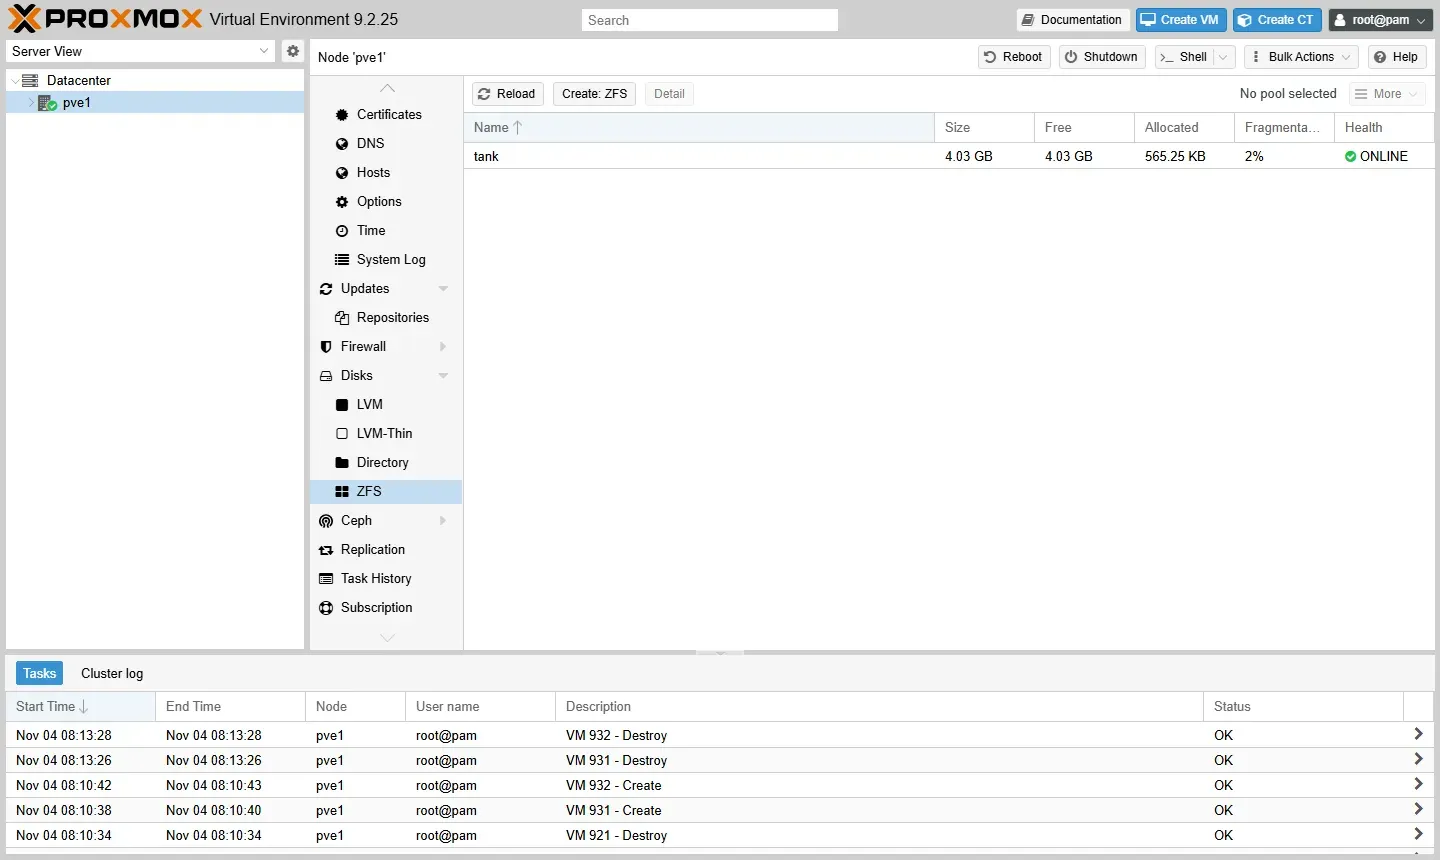
ZFS في Proxmox هو الخيار الذي يعطيك أكثر شيء في طبقة واحدة: مرآة أو RAIDZ دون وحدة RAID، وتحقق من سلامة كل كتلة عند قراءتها، وضغط، وSnapshots فورية، ونسخ القرص إلى سيرفر آخر بشكل دوري. والصورة التالية من صفحة ZFS في السيرفر:
ذاكرة ARC: أين تذهب ذاكرة السيرفر؟
ثمن ZFS الأول هو الذاكرة، فهو يحتفظ في الذاكرة بما يقرؤه كثيراً في ذاكرة مؤقتة اسمها ARC. وينص توثيق ZFS في Proxmox على أن المثبت منذ الإصدار 8.1 يحدد ARC بنسبة 10% من ذاكرة السيرفر بحد أقصى 16 GiB، ويكتب ذلك في ملف /etc/modprobe.d/zfs.conf، وكانت القيمة قبل ذلك هي قيمة ZFS الافتراضية، أي نصف الذاكرة أو أكثر. وفي مختبرنا:
cat /etc/modprobe.d/zfs.conf
grep -E "^(size|c_max|c_min) " /proc/spl/kstat/zfs/arcstats
options zfs zfs_arc_max=409993216
c_min 4 260167040
c_max 4 409993216
size 4 2346440والرقم 409,993,216 بايت هو 10% من 4 GiB، أي ذاكرة السيرفر وقت التثبيت، وليس 8 GiB التي يعمل بها الآن، لأن الملف كتب مرة واحدة أثناء التثبيت ولا يتغير إذا زدت الذاكرة. وهذه ملاحظة مهمة لمن يضيف ذاكرة إلى سيرفر بعد تثبيته. ويعطي التوثيق قاعدة تقريبية: 2 GiB أساساً ثم 1 GiB لكل TiB من مساحة التخزين، فمجمع بحجم 8 TiB يحتاج قرابة 10 GiB للـ ARC، وتقليلها كثيراً يبطئ القراءة.
مشكلة: قرص ZFS يحجز حجمه كاملاً Thick Provisioning
عندما أنشأنا أول جهاز بقرص 8 GiB على المجمع tank، وحجمه قرابة 3.6 GiB، توقعنا أن ينجح الأمر لأن ZFS يدعم التخصيص المرن، ولكن النتيجة كانت كما يلي:
qm create 902 --name st-tank --memory 128 --scsi0 tank:8unable to create VM 902 - zfs error: cannot create 'tank/vm-902-disk-0': out of spaceولمعرفة السبب أنشأنا قرصاً أصغر بحجم 2 GiB ونظرنا إلى خصائصه:
NAME                VOLSIZE   USED  REFER  REFRESERV
tank                      -  2.03G    96K       none
tank/vm-905-disk-0       2G  2.03G    56K      2.03G
القرص لم يكتب فيه شيء، فالبيانات الحقيقية REFER هي 56 KiB فقط، ولكن USED يقول 2.03 GiB، والسبب في العمود الأخير: refreservation، أي أن ZFS حجز حجم القرص كاملاً من المجمع عند إنشائه. وهذا هو السلوك الافتراضي لمخزن ZFS في Proxmox، ولا يتغير إلا بخيار Thin provision في إعداد المخزن، أي sparse:
pvesm set tank --sparse 1وبعده نجح إنشاء قرص 8 GiB على مجمع بحجم 3.6 GiB. وقد يتساءل البعض: أيهما أفضل؟ والإجابة أن الحجز الكامل هو الاختيار الآمن، لأنه يضمن أن كل جهاز يجد المساحة التي وعد بها، فلا يتوقف عن الكتابة في منتصف الليل، والتخصيص المرن يوفر المساحة ولكنه ينقل المسؤولية إليك في مراقبة الامتلاء، كما سوف نرى في قسم What If.
بعد إنشاء المجمع: Scrub مع المراقبة
إنشاء مجمع ZFS بمرآة لا يعني أن بياناتك محمية للأبد، فالمرآة تحميك من تعطل قرص كامل، والتحقق من الكتل يكتشف التلف الصامت عندما تقرأ الكتلة، ولكن الكتلة التي لا يقرؤها أحد قد تتلف في القرصين دون أن يعرف أحد. لذلك يحتاج المجمع فحصاً دورياً اسمه Scrub، يقرأ كل كتلة في المجمع ويقارنها بالهاش المحفوظ معها، ويصلح التالف من النسخة الأخرى. وحزمة ZFS في Proxmox، المبنية على Debian، تجدول Scrub شهرياً لكل المجمعات في الملف /etc/cron.d/zfsutils-linux، في الأحد الثاني من كل شهر، ومعه TRIM في الأحد الأول، فتأكد أن هذا الملف موجود ولم يعطله أحد. ثم الأهم: من يقرأ النتيجة؟ فالأمر zpool status الذي رأيته أعلاه يعرض لكل قرص عدادات READ وWRITE وCKSUM، وأي رقم غير الصفر فيها علامة على قرص يبدأ في التعطل، وProxmox يرسل تنبيهات ZFS عبر خدمة ZED إلى بريد المدير الذي كتبته في التثبيت، بشرط أن يكون البريد يصل فعلاً. ومجمع بحالة DEGRADED لأسابيع لأن رسائله تذهب إلى بريد لا يقرؤه أحد يعني أنك تعمل دون مرآة وأنت تظن أنك محمي. ولذلك أضف حالة المجمع إلى المراقبة كما في دليل المراقبة، وسوف نبني ذلك عملياً في مقال مراقبة Proxmox من هذه المرحلة. وأخيراً اختيار ashift=12 الذي رأيته في الأمر: هو حجم أصغر كتلة يكتبها ZFS على القرص، 2 أس 12 أي 4 KiB، ولا يتغير بعد إنشاء المجمع، والقيمة الأصغر على قرص حديث يكتب كتلاً بحجم 4 KiB تجعل كل كتابة صغيرة قراءة ثم تعديلاً ثم كتابة داخل القرص، وهذا يبطئه.
LVM-thin: البسيط الافتراضي
LVM-thin هو ما يضعه المثبت على قرص النظام باسم local-lvm في التثبيت بنظام ext4 أو xfs، وفكرته مخزن رقيق Thin Pool داخل مجموعة أقراص LVM، ولكل قرص جهاز LV رقيق لا يأخذ من المخزن إلا ما كتب فيه. وهو أبسط من ZFS ولا يحتاج ذاكرة ARC، ولكنه لا يتحقق من سلامة البيانات ولا يضغط ولا يدعم النسخ الدوري إلى سيرفر آخر، فإذا كان تحته قرص واحد فلا يوجد ما يحميك من تلفه إلا النسخ الاحتياطي، وإذا أردت مرآة فضعها تحته بوحدة RAID من العتاد.
وفي المختبر لاحظنا شيئاً لم نتوقعه عندما أنشأنا thin2 على قرص بحجم 4 GiB:
vgs thin2; lvs -a thin2 VG #PV #LV #SN Attr VSize VFree
thin2 1 1 0 wz--n- <4.00g 1.12g
LV VG Attr LSize Pool Origin Data% Meta%
[lvol0_pmspare] thin2 ewi------- 1.00g
thin2 thin2 twi-a-tz-- 892.00m 0.00 1.57
[thin2_tdata] thin2 Twi-ao---- 892.00m
[thin2_tmeta] thin2 ewi-ao---- 1.00gمن 4 GiB بقي للبيانات 892 MiB فقط. فالمخزن الرقيق يحتاج قسماً للبيانات الوصفية Metadata، وهو هنا 1 GiB، ونسخة احتياطية منه بنفس الحجم lvol0_pmspare يستخدمها LVM عند إصلاح البيانات الوصفية، ثم ترك 1.12 GiB حرة في المجموعة. وعلى قرص بحجم 4 TB هذه النسبة لا تذكر، ولكنها تذكير بأن حجم القرص ليس حجم المخزن، فراجع lvs بعد الإنشاء. ولاحظ أيضاً عمود Meta%، فامتلاء البيانات الوصفية مشكلة مستقلة عن امتلاء البيانات، ويجب أن تراقب الاثنين.
التخصيص المرن بالأرقام Thin Provisioning
الآن نجيب عن أول سؤال للمدير بالأرقام. كتبنا سكربتاً ينشئ على كل مخزن جهازاً بقرص 8 GiB، ثم يكتب في القرص 256 MiB من بيانات عشوائية لا تضغط بالأداة qemu-io مباشرة على القرص، ثم يأخذ Snapshot، ثم يكتب 128 MiB جديدة فوق أول جزء من البيانات، ثم يرجع إلى الـ Snapshot، ثم يحذفه ويرسل أمر Discard على البيانات كلها، ويقيس بعد كل خطوة ما أخذه القرص فعلاً من المخزن. والسكربت كاملاً في مجلد lab/، وهذا جزؤه الأساسي:
qm create $i --name st-$S --memory 128 --scsi0 $S:8$F
V=$(qm config $i | sed -n 's/^scsi0: \([^,]*\),.*/\1/p'); DEV=$(pvesm path $V)
qemu-io -f $FMT -c "write -s /tmp/rand256 0 256M" $DEV
qm snapshot $i s1
qemu-io -f $FMT -c "write -s /tmp/rand128 0 128M" $DEV
qm rollback $i s1
qm delsnapshot $i s1
qemu-io -f $FMT -c "discard 0 256M" $DEV
وهذه النتائج لمخزن ZFS بعد تفعيل sparse:
-- after allocating 8G
tank/vm-921-disk-0       8G    56K    56K    28K
-- write 256 MiB random
tank/vm-921-disk-0       8G   257M   257M   257M
-- snapshot
tank/vm-921-disk-0          8G   257M   257M   257M
tank/vm-921-disk-0@s1       8G     0B   257M      -
-- overwrite first 128 MiB
tank/vm-921-disk-0          8G   386M   257M   385M
tank/vm-921-disk-0@s1       8G   129M   257M      -
-- rollback
tank/vm-921-disk-0          8G   257M   257M   257M
tank/vm-921-disk-0@s1       8G     8K   257M      -
-- delete snapshot + discard 256 MiB
tank/vm-921-disk-0       8G    56K    56K    28K
وهذه لملف qcow2 على المجلد، ونتائج NFS مطابقة لها تقريباً:
-- after allocating 8G
virtual size: 8 GiB (8589934592 bytes)
disk size: 1.45 MiB
-- write 256 MiB random
disk size: 257 MiB
-- snapshot
ID      TAG               VM_SIZE                DATE        VM_CLOCK     ICOUNT
1       s1                    0 B 2026-11-04 08:02:49  0000:00:00.000          0
-- overwrite first 128 MiB
disk size: 386 MiB
-- rollback
disk size: 257 MiB
-- delete snapshot + discard 256 MiB
disk size: 1.45 MiB
أما LVM-thin فلا يعرض lvs امتلاء كل Snapshot على حدة عندما يكون غير مفعل، لذلك قسناه بنسبة امتلاء المخزن الرقيق data نفسه، وحجمه 24.25 GiB:
-- after allocating 8G
  data             <24.25g 2.74   active
-- write 256 MiB random
  data             <24.25g 3.77   active
-- overwrite first 128 MiB
  data                  <24.25g 4.29   active
  snap_vm-912-disk-0_s1   8.00g
-- rollback
  Logical volume "vm-912-disk-0" created.
  data                  <24.25g 3.77   active
-- delete snapshot + discard 256 MiB
  data             <24.25g 2.74   active
والفرق من 2.74% إلى 3.77% يساوي 1.03% من 24.25 GiB، أي قرابة 256 MiB، ومن 3.77% إلى 4.29% يساوي قرابة 128 MiB. والصورة التالية تجمع المخازن الأربعة:
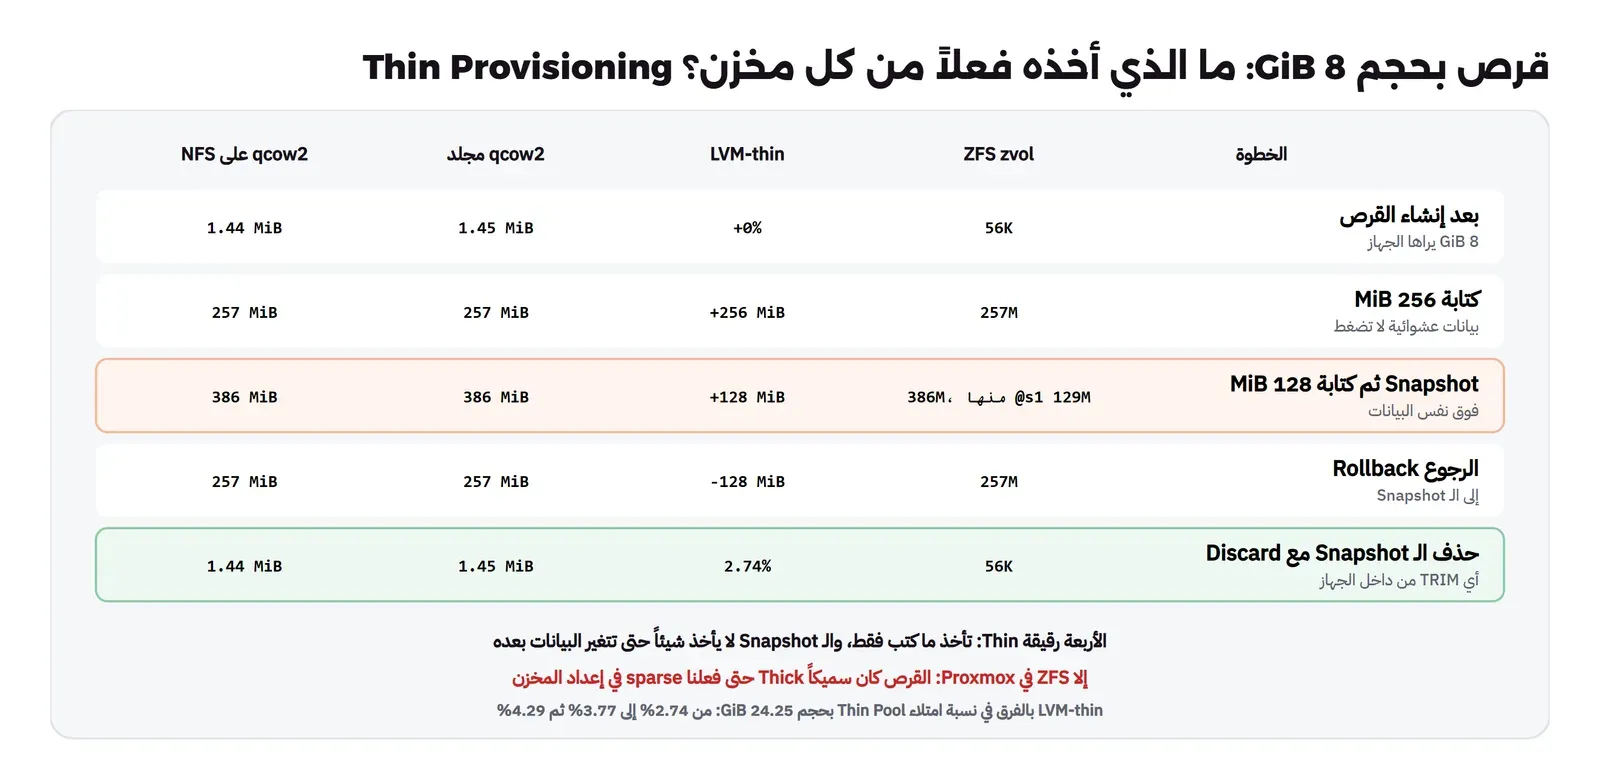
وفيما يلي ما تقوله هذه الأرقام:
- القرص الفارغ لا يأخذ شيئاً تقريباً: 56 KiB في ZFS و1.45 MiB في qcow2، وهي البيانات الوصفية للقرص، والجهاز نفسه يرى 8 GiB. وبالتالي فجواب سؤال المدير: قرص 500 GB لا يأخذ 500 GB من أول يوم، إلا في ZFS دون
sparse. - الكتابة تأخذ حجمها: 256 MiB من بيانات عشوائية أخذت 257 MiB في كل المخازن، والضغط lz4 في ZFS لم يوفر شيئاً لأن البيانات العشوائية لا تضغط، ونسبة الضغط بقيت
1.00x. ومع بيانات حقيقية مثل السجلات وقواعد البيانات النصية يوفر الضغط أكثر. - الحذف داخل الجهاز لا يعيد المساحة وحده: عادت المساحة فقط بعد أمر Discard، وداخل جهاز حقيقي يأتي هذا الأمر من نظام الملفات عندما تحذف ملفات، بشرط أن يكون خيار Discard مفعلاً على قرص الجهاز كما في دليل إنشاء أول جهاز افتراضي، وأن يرسله النظام بالأمر
fstrimأو بخيار التركيبdiscard. ودون ذلك يبقى القرص يكبر حتى يصل إلى حجمه الكامل مع الوقت، حتى لو كان الجهاز نصف فارغ من الداخل.
الـ Snapshots من الداخل: Copy-on-Write
لاحظ في النتائج أن الـ Snapshot لحظة إنشائه أخذ 0 بايت في ZFS، ولم يغير حجم ملف qcow2، ثم أخذ 129 MiB بعد أن كتبنا 128 MiB. والسبب أن المخازن الثلاثة تعمل بنفس الفكرة، واسمها النسخ عند الكتابة Copy-on-Write، والصورة التالية تبينها:
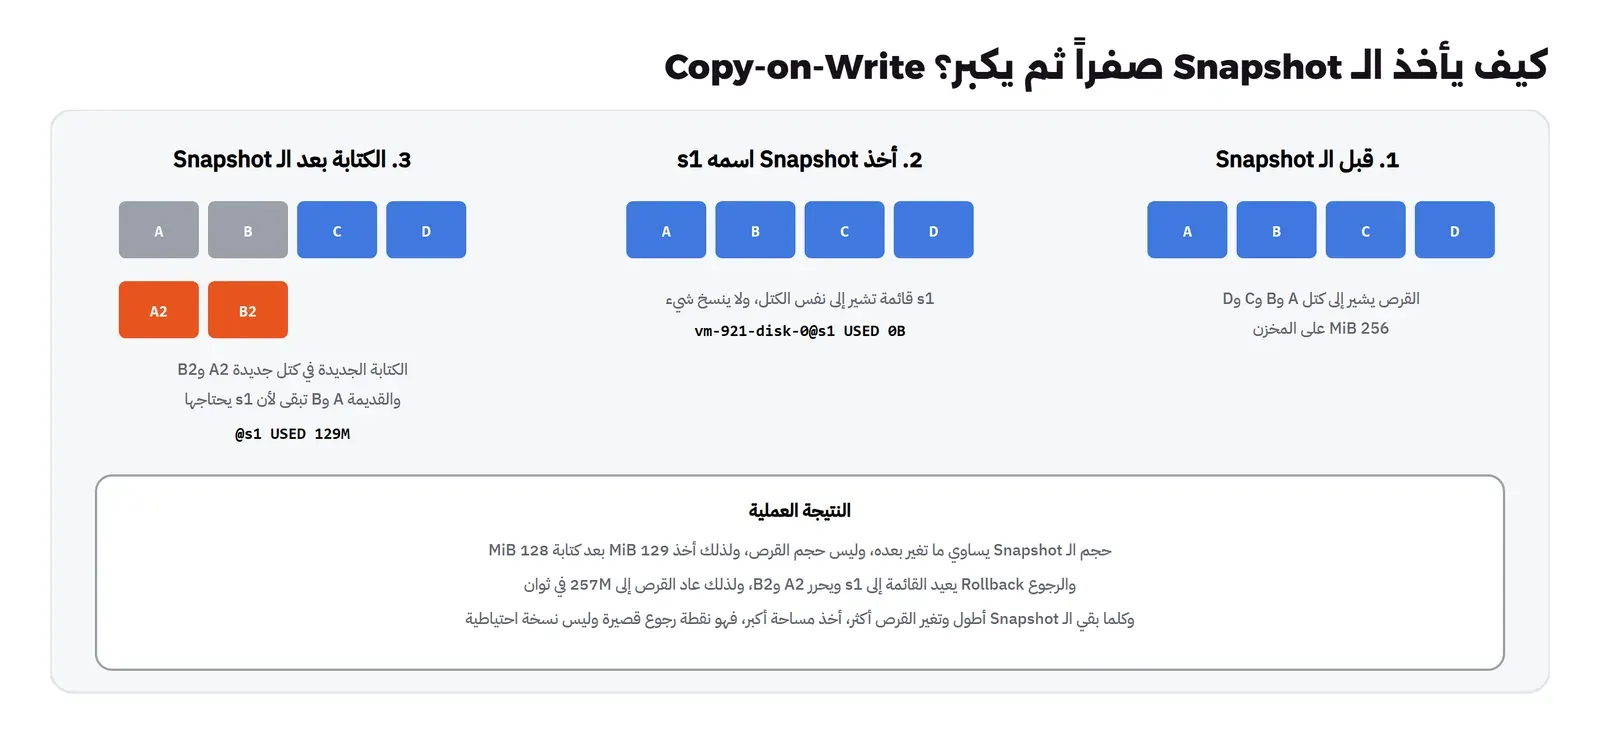
وهذه الفكرة تفسر ثلاثة أشياء عملية:
- إنشاء الـ Snapshot سريع: احتاج الأمر
qm snapshotبين ثانيتين وأربع ثوان على كل المخازن في مختبرنا، وأغلب هذا الوقت في Proxmox نفسه من قفل الإعداد وحفظه، وليس في المخزن، والوقت لا يكبر مع حجم القرص. - الـ Snapshot يكبر مع الزمن: قاعدة بيانات تكتب 20 GB يومياً، وعليها Snapshot عمره شهر، يعني قرابة 600 GB محجوزة من أجل نقطة رجوع لا يتذكرها أحد. لذلك احذف الـ Snapshots بعد أن ينجح التحديث الذي أخذتها من أجله.
- الـ Snapshot ليس نسخة احتياطية: لأنه يشير إلى نفس الكتل على نفس الأقراص، فإذا تلف المجمع ضاع الجهاز ونقاط رجوعه معاً، والنسخ الاحتياطي الحقيقي على مخزن آخر كما في قاعدة 3-2-1.
ولاحظ في نتائج LVM-thin أن الرجوع كتب Logical volume "vm-912-disk-0" created، أي أن Proxmox حذف القرص الحالي وأنشأ قرصاً جديداً من الـ Snapshot باسمه، وهذا يختلف عن ZFS الذي يرجع القرص نفسه في مكانه بالأمر zfs rollback. والنتيجة للمستخدم واحدة، ولكن الفرق يظهر في قيد مهم في ZFS: الرجوع ممكن فقط إلى أحدث Snapshot، فإذا كان لديك s1 ثم s2 وأردت الرجوع إلى s1 فيجب حذف s2 أولاً، وهذا قيد في ZFS نفسه يذكره توثيق Proxmox.
تحذير التوثيق عن Snapshots صيغة qcow2
في مختبرنا كانت الأقراص صغيرة والأجهزة متوقفة، فأخذ الـ Snapshot على المجلد وNFS بين ثانيتين وأربع ثوان مثل غيره. ولكن التوثيق يضع ملاحظة مهمة بجوار جدول المخازن: الـ Snapshots الداخلية في qcow2 توقف الجهاز العامل أثناء إنشائها وحذفها، والعملية ليست فعالة، وأداؤها سيئ بشكل خاص على مخازن الشبكة مثل NFS، ومع أقراص بمئات الـ GiB قد تأخذ دقائق وأحياناً ساعات. ونصيحة التوثيق نفسها: إذا كان إعدادك من هذا النوع فأنشئ الـ Snapshots واحذفها والجهاز متوقف، وتوقع مدة طويلة. والسبب أن الصيغة تحتاج أن تحدث جداول الكتل داخل الملف نفسه، وعلى NFS كل تحديث طلب يذهب عبر الشبكة وينتظر الرد. لذلك إذا كانت الـ Snapshots جزءاً يومياً من عملك، كأخذ Snapshot قبل كل تحديث، فضع الأجهزة على ZFS أو LVM-thin أو Ceph، واترك qcow2 على NFS للأجهزة التي لا تحتاجها كثيراً.
صيغة القرص: raw أم qcow2؟
على المخازن الكتلية مثل ZFS وLVM-thin لا يوجد خيار، فالقرص كتلي raw، والمخزن نفسه هو الذي يعطيك التخصيص المرن والـ Snapshots. أما على Directory وNFS فتختار بين raw وqcow2. والصيغة raw ملف بنفس ترتيب القرص، بايت مقابل بايت، فلا يوجد بين الجهاز والقرص أي طبقة ترجمة، وهي الأسرع والأبسط، ولكنها لا تدعم الـ Snapshots، والتخصيص المرن فيها يعتمد على أن نظام الملفات تحتها يدعم الملفات المتفرقة Sparse Files. أما qcow2 فهي صيغة QEMU نفسها، وفيها جدول يربط كل كتلة في القرص الافتراضي بمكانها في الملف، وهذا الجدول هو ما يعطيها التخصيص المرن والـ Snapshots الداخلية والضغط الاختياري، وثمنه طبقة ترجمة إضافية في كل قراءة وكتابة. وبالتالي فالقاعدة العملية: على مجلد أو NFS اختر qcow2 إذا احتجت Snapshots، وraw إذا كان الأداء أهم ولديك نسخ احتياطي منتظم، وعلى ZFS أو LVM-thin لا تفكر في الصيغة أصلاً.
إعدادات القرص في الجهاز: Cache مع Discard
نوع المخزن نصف القصة، والنصف الآخر في إعداد قرص الجهاز نفسه. فالخيار Cache افتراضياً none في Proxmox، أي أن QEMU لا يستخدم ذاكرة المضيف المؤقتة للكتابة، فإذا قال للجهاز إن الكتابة تمت فهي على المخزن فعلاً، وهذا هو الخيار الآمن للأجهزة التي تعمل عليها قواعد بيانات. أما writeback فيجعل الكتابة أسرع لأنها تذهب إلى ذاكرة المضيف أولاً، ولكن انقطاع الكهرباء عن السيرفر عندها قد يضيع ما لم يكتب بعد، والجهاز يظن أنه كتب. وخيار Discard الذي شرحناه في نتائج المختبر هو ما يجعل حذف الملفات داخل الجهاز يعيد المساحة إلى المخزن الرقيق، وخيار IO thread يعطي القرص خيطاً مستقلاً في QEMU كما شرحنا في المقال الأول من المرحلة. وكل هذه الخيارات تجدها في تبويب Disks عند إنشاء الجهاز، وتستطيع تغييرها لاحقاً، ولكن تغيير Cache أو IO thread يحتاج إيقاف الجهاز وتشغيله حتى يطبق.
ماذا يحدث عندما يمتلئ Thin Pool؟ What If
التخصيص المرن يسمح بأن تعد الأجهزة بمساحة أكبر من المخزن، ويسمى هذا الإفراط في التخصيص Overcommit، وهو مريح ما دام مجموع ما كتب فعلاً أقل من المخزن. فماذا يحدث عندما لا يكون؟ استخدمنا المخزن الصغير thin2 بحجم 892 MiB، وأنشأنا عليه قرصين بحجم 2 GiB لكل منهما، أي 4 GiB موعودة على مخزن أقل من 1 GiB، ثم كتبنا 512 MiB في الأول و512 MiB في الثاني:
qm create 931 --name full-a --memory 128 --scsi0 thin2:2
qm create 932 --name full-b --memory 128 --scsi0 thin2:2
qemu-io -f raw -c "write -s /tmp/rand256 0 256M" -c "write -s /tmp/rand256 256M 256M" /dev/thin2/vm-931-disk-0
lvs --noheadings -o lv_name,data_percent thin2/thin2
qemu-io -f raw -c "write -s /tmp/rand256 0 256M" -c "write -s /tmp/rand256 256M 256M" /dev/thin2/vm-932-disk-0
lvs --noheadings -o lv_name,data_percent,lv_attr thin2
dmesg | grep thin
wrote 268435456/268435456 bytes at offset 0
wrote 268435456/268435456 bytes at offset 268435456
thin2 57.40
qemu-io: Failed flush for '/dev/thin2/vm-932-disk-0' during close: Input/output error
wrote 268435456/268435456 bytes at offset 0
write failed: Input/output error
rc=0 after 67 s
thin2 100.00 twi-aotzD-
vm-931-disk-0 25.00 Vwi-a-tz--
vm-932-disk-0 18.55 Vwi-a-tz--
[13000.450476] device-mapper: thin: 252:8: reached low water mark for data device: sending event.
[13000.615185] device-mapper: thin: 252:8: switching pool to out-of-data-space (queue IO) mode
[13063.195527] device-mapper: thin: 252:8: switching pool to out-of-data-space (error IO) mode
Nov 04 08:10:40 pve1 dmeventd[326]: Monitoring thin pool thin2-thin2-tpool.
Nov 04 08:11:20 pve1 dmeventd[326]: WARNING: Thin pool thin2-thin2-tpool data is now 100.00% full.والصورة التالية ترتب ما حدث على خط زمني:
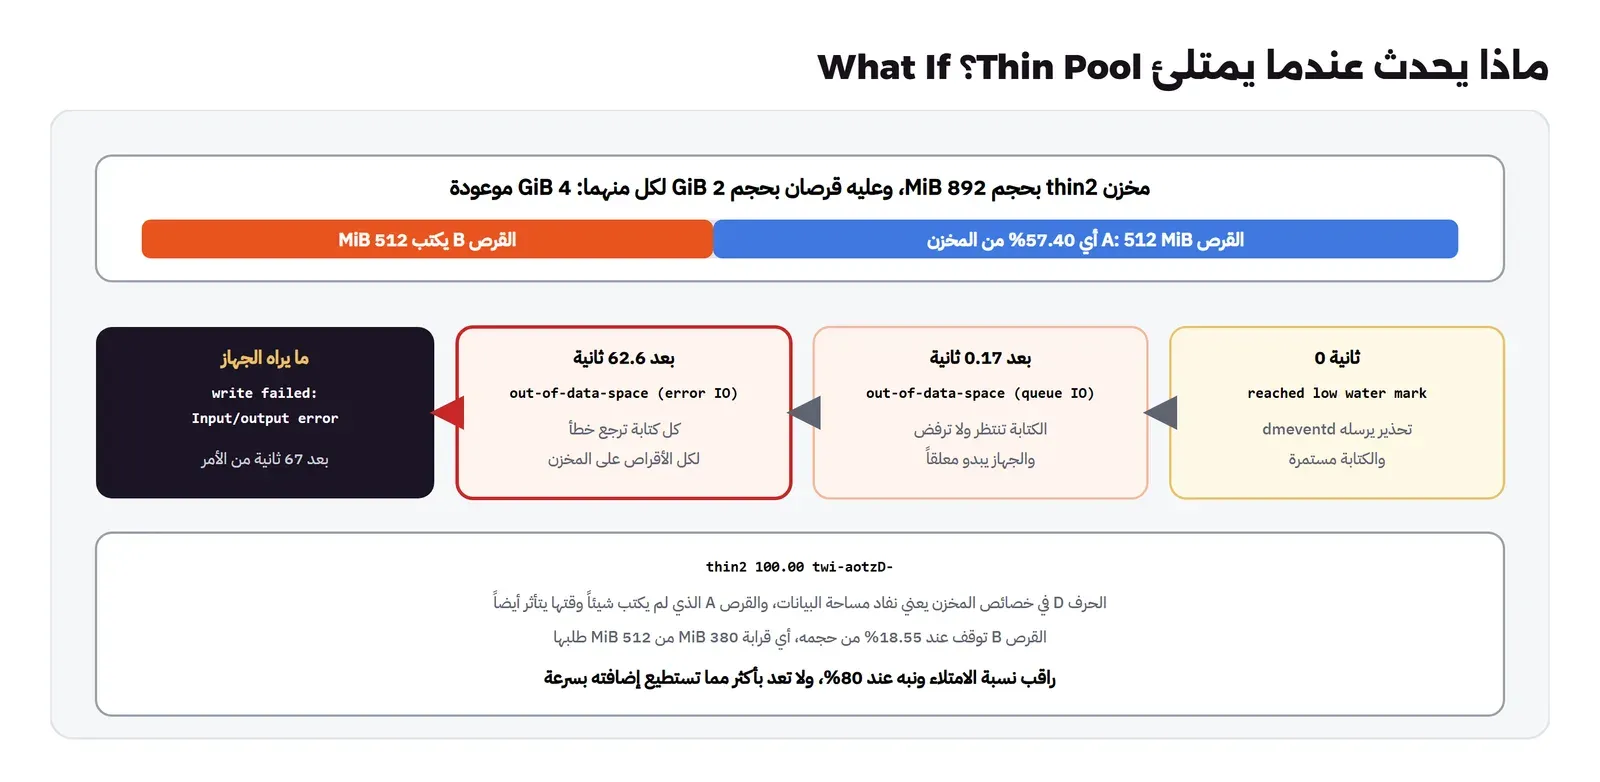
وفيما يلي ما يقوله المخرج:
- التحذير جاء متأخراً: رسالة
low water markظهرت قبل الامتلاء بأقل من ربع ثانية، فهي لا تعطيك وقتاً لتفعل شيئاً، وإنما هي حدث يستخدمه LVM للتوسيع التلقائي إذا كان مضبوطاً وكانت في المجموعة مساحة حرة. - دقيقة من الانتظار: عند الامتلاء لم ترفض النواة الكتابة فوراً، وإنما انتقلت إلى وضع
queue IOوأوقفت الكتابات في الطابور قرابة 62.6 ثانية، على أمل أن يضيف أحد مساحة، ثم انتقلت إلىerror IO. وداخل جهاز افتراضي حقيقي هذه الدقيقة تبدو تجمداً كاملاً للتطبيق، ثم تأتي أخطاء الكتابة. - الضرر يصيب الجميع: المخزن الممتلئ يرفض الكتابة لكل الأقراص عليه، ومنها القرص الأول الذي لم يكن يكتب شيئاً وقتها، أي أن جهازاً واحداً كتب أكثر من حصته أوقف كل الأجهزة على المخزن. والحرف
Dفي نهايةtwi-aotzD-يعني أن المخزن نفدت مساحة بياناته.
والحل ليس في تجنب التخصيص المرن، فهو مفيد جداً، وإنما في أن تتعامل معه كقرض: راقب نسبة امتلاء كل مخزن رقيق ونسبة بياناته الوصفية، ونبه عند 80% كما شرحنا في التنبيهات Alerting، واترك في مجموعة الأقراص مساحة حرة تستطيع أن توسع بها المخزن بسرعة، ولا تعد بأكثر مما تستطيع إضافته قبل أن يمتلئ. والأمر نفسه في ZFS مع sparse: المجمع الممتلئ يرفض الكتابة لكل من عليه.
كيف تحسب المساحة قبل أن تعد بها؟ Capacity Planning
لنأخذ مثالاً بالأرقام حتى يصبح القرار حساباً وليس إحساساً. لنفرض أن مخزناً رقيقاً حجمه 2 TB، وأنك أنشأت عليه 30 جهازاً بقرص 100 GB لكل منها، أي 3 TB موعودة على 2 TB موجودة، ونسبة الإفراط 1.5. وفي يوم المراجعة كانت الأجهزة تستخدم من الداخل 40% من أقراصها في المتوسط، أي قرابة 1.2 TB، ومعها Snapshots تحجز 150 GB، فالمخزن ممتلئ بنسبة قرابة 68%. هذا وضع مقبول اليوم، ولكن السؤال الصحيح ليس «كم الامتلاء الآن؟» وإنما «متى يمتلئ؟»: إذا كان الاستخدام يزيد 30 GB في الأسبوع فالمخزن يصل إلى 80% بعد قرابة ثمانية أسابيع، ويمتلئ تماماً بعد قرابة عشرين أسبوعاً، وهذا هو الوقت الذي أمامك لشراء الأقراص وتركيبها. لذلك راقب معدل الزيادة وليس الرقم الحالي فقط، واجعل التنبيه على الوقت المتبقي حتى الامتلاء، وأدوات مثل Prometheus تحسبه لك بدالة توقع خطية. وتذكر شيئين يفسدان هذا الحساب: جهاز واحد ينسخ قاعدة بيانات كبيرة أو يملأ قرصه بالسجلات يستطيع أن يأخذ في ساعة ما توقعت أن يأخذه الجميع في شهر، والـ Snapshot المنسي يكبر بصمت مع كل كتابة. ولهذا تختار جهات كثيرة الحجز الكامل لأجهزة قواعد البيانات المهمة، والتخصيص المرن لباقي الأجهزة.
وماذا عن السرعة؟ Performance
قد تتوقع هنا جدول سرعات يقول أي المخازن أسرع، ولم نضعه عمداً، والسبب أن مختبرنا لا يصلح لذلك: الأقراص الخمسة ملفات qcow2 على نفس القرص في المضيف، وProxmox نفسه يعمل داخل جهاز افتراضي، والمضيف مشغول بأعمال أخرى، فاختلفت أوقات الكتابة نفسها بين تشغيلين على نفس المخزن من 6.5 ثانية إلى 54 ثانية. والذي يمكن قوله بثقة من المختبر: الكتابة على NFS أخذت 11 ثانية لـ 256 MiB مقابل ثانيتين على المجلد المحلي في نفس التشغيل، لأن كل كتابة تمر بالشبكة ثم بسيرفر NFS الذي يكتب على قرصه بخيار sync قبل أن يرد. أما المقارنة الحقيقية بين ZFS وLVM-thin فاجعلها على عتادك أنت بأداة مثل fio، وبنمط كتابة يشبه أجهزتك، فقاعدة بيانات تكتب كتلاً صغيرة مع fsync تختلف تماماً عن سيرفر ملفات يقرأ ملفات كبيرة.
وماذا عن أقراص الـ Containers؟ Container Volumes
كل ما قسناه كان لأقراص الأجهزة الافتراضية، أما الـ Containers فتخزن بطريقة مختلفة قليلاً حسب المخزن، والمحتوى الذي يسمح بها اسمه rootdir في storage.cfg. فعلى LVM-thin يحصل كل Container على قرص كتلي رقيق عليه نظام ملفات ext4 بحجم ثابت، أي أن داخله يشبه قرص الجهاز الافتراضي. أما على ZFS فيحصل على مجموعة بيانات Dataset، وهي مجلد له حد أقصى Quota، وليس قرصاً بحجم ثابت، وهذا يعني أن تكبير قرص الـ Container أو تصغيره تغيير رقم في الإعداد، وأن المضيف يستطيع أن يقرأ ملفاته مباشرة من /tank/subvol-… دون تركيب أي قرص، وأن الضغط وSnapshots الـ ZFS تعمل على مستوى الملفات. ولهذا يفضل كثيرون ZFS للـ Containers تحديداً، وسوف نرى ذلك عملياً في مقال LXC القادم. أما مخزن المجلد فيحفظ الـ Container ملفاً بصيغة raw فيه نظام ملفات، ويصلح للتجارب أكثر من الإنتاج.
أين تذهب النسخ الاحتياطية؟ Backup Storage
لاحظ أن المخازن الكتلية في الجدول لا تقبل النسخ الاحتياطية، فأداة vzdump تكتب ملفاً مضغوطاً لكل نسخة، والملف يحتاج مخزن ملفات. وفي التثبيت الافتراضي هذا المخزن هو local، أي المجلد /var/lib/vz على قرص النظام نفسه، وهذا أسوأ مكان للنسخ الاحتياطية على الإطلاق، لأن تعطل قرص النظام يأخذ معه الأجهزة ونسخها معاً، والنسخ تملأ قرص النظام حتى يتوقف السيرفر. لذلك اجعل مخزن النسخ الاحتياطية خارج السيرفر: مخزن NFS من NAS مختلف كما فعلنا في المختبر بالمحتوى backup، أو الأفضل Proxmox Backup Server الذي ينسخ ما تغير فقط ويحذف التكرار بين النسخ، وسوف نخصص له مقالاً في هذه المرحلة. ثم طبق ما شرحناه في النسخة خارج السيرفر، فنسخة على NAS في نفس الغرفة لا تحميك من حريق أو سرقة.
متى يستحق Ceph تعقيده؟
كل المخازن المحلية تشترك في نقطة ضعف واحدة: إذا توقف السيرفر توقفت أقراصه معه، والجهاز لا يستطيع أن يعمل على سيرفر آخر حتى يعود الأول أو تستعيد نسخة احتياطية. وهنا يأتي Ceph، وقد شرحناه في Ceph للمبتدئين: تخزين موزع يحفظ كل كتلة على ثلاثة سيرفرات افتراضياً، وProxmox يثبته ويديره من واجهته فيصبح كل سيرفر في العنقود سيرفر أجهزة وسيرفر تخزين معاً، وهذا ما يسمى Hyper-Converged. ولكن توثيق Ceph في Proxmox واضح في متطلباته:
- ثلاثة سيرفرات على الأقل، ويفضل أن تكون متطابقة.
- نواة معالج على الأقل لكل خدمة من خدمات Ceph، وأكثر لكل قرص NVMe سريع.
- 8 GiB من الذاكرة لكل قرص OSD للأداء الجيد، والافتراضي 4 GiB، مع هامش لعمليات الاستعادة التي تستهلك أكثر.
- شبكة بسرعة 10 Gbps على الأقل لـ Ceph وحده، والسبب أن حركة الاستعادة بعد سقوط قرص قد تزاحم شبكة Corosync الحساسة للتأخير فتؤثر على العنقود كله.
والصورة التالية تضع Ceph بجوار البديلين الأبسط لعنقود صغير:
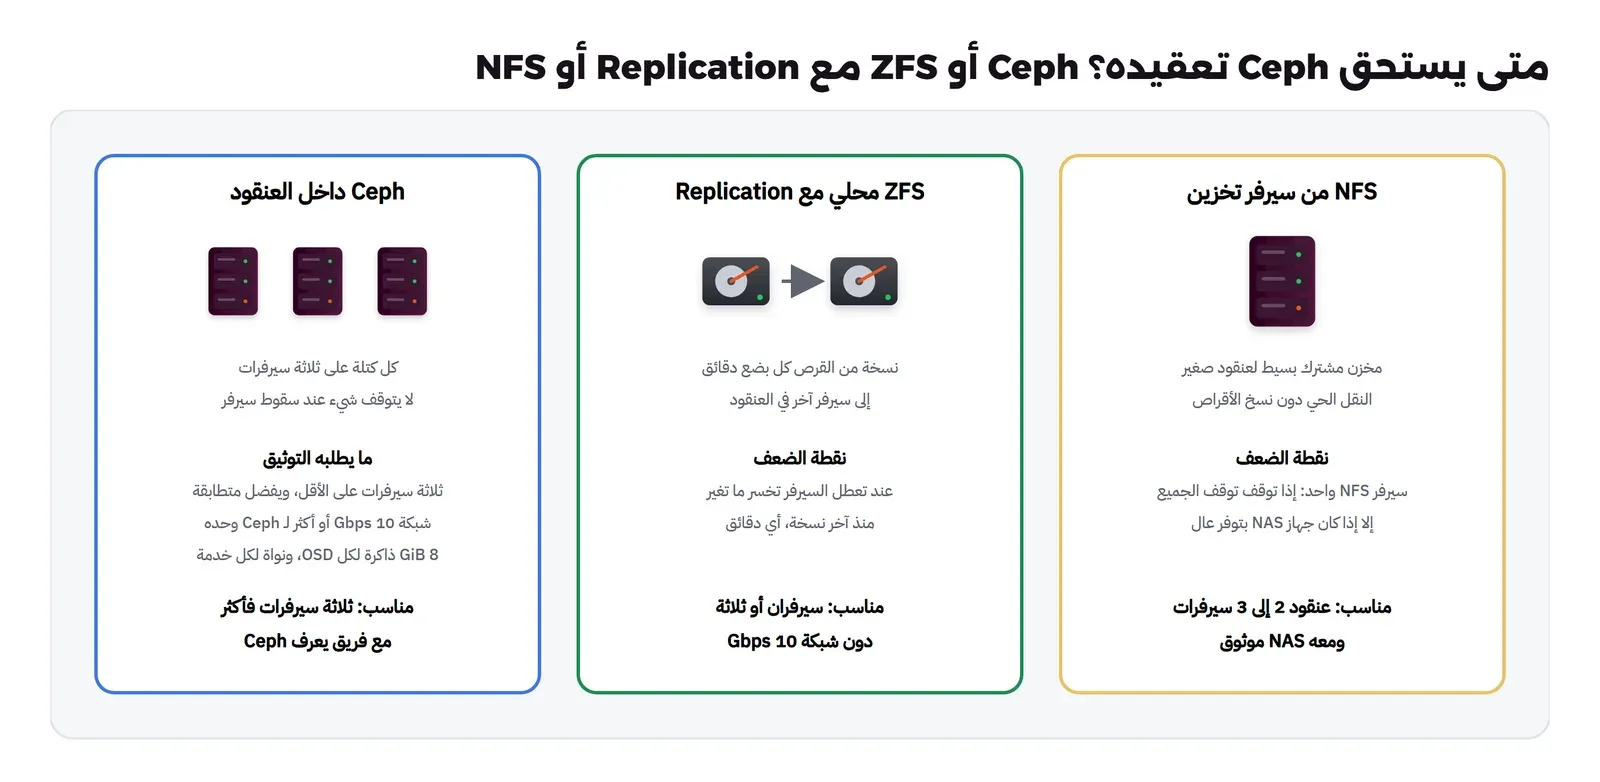
والبديل الذي يغفل عنه كثيرون هو النسخ الدوري للتخزين Storage Replication مع ZFS، ويشرح توثيق Storage Replication أنه ينسخ قرص الجهاز إلى سيرفر آخر في العنقود كل فترة، وأقلها دقيقة واحدة، بنسخ ما تغير فقط. فإذا سقط السيرفر يعمل الجهاز على الآخر من آخر نسخة، ويقول التوثيق صراحة إن هذا يعني احتمال خسارة البيانات بين آخر نسخ ولحظة السقوط. وبالتالي فالسؤال الذي يحسم اختيارك: كم دقيقة من البيانات تستطيع أن تخسر؟ إذا كان الجواب بضع دقائق، فسيرفران مع ZFS وReplication أبسط وأرخص بكثير من ثلاثة سيرفرات مع Ceph. وإذا كان الجواب صفراً، وعندك ثلاثة سيرفرات وشبكة 10 Gbps وفريق مستعد لتعلم Ceph، فهنا يستحق تعقيده. وسوف نعود إلى هذا الاختيار عملياً في مقال عنقود Proxmox والتوفر العالي من هذه المرحلة، مع مفاهيم التوفر العالي.
وإذا كنت تقارن Ceph بأنظمة تخزين موزعة أخرى قبل أن تقرر، فقد قارناه بالبديل الأشهر في Ceph أم GlusterFS. ولاحظ أن Ceph في Proxmox يعطيك أيضاً CephFS، وهو نظام ملفات موزع تستطيع أن تضع عليه ملفات ISO والقوالب فتراها كل السيرفرات، وهذه ميزة صغيرة تختصر عليك نسخ نفس ملف ISO إلى كل سيرفر.
قرص النظام نفسه: ext4 أم ZFS؟
كل ما سبق عن المخازن التي تضع عليها الأجهزة، ولكن قرار قرص النظام يأتي قبلها في شاشة المثبت كما شرحنا في مقال التثبيت. فإذا كان في السيرفر قرصان للنظام دون وحدة RAID، فاختيار ZFS بمرآة RAID1 في المثبت يعطيك نظاماً يستمر في العمل إذا تعطل أحد القرصين، ويعطيك مخزناً باسم local-zfs بدل local-lvm على نفس المرآة. والمثبت في هذه الحالة يجهز قسم إقلاع على كل قرص ويديرها بأداة proxmox-boot-tool، فيقلع السيرفر من أي من القرصين. أما إذا كان في السيرفر قرص نظام واحد، أو وحدة RAID من العتاد، فالخيار الافتراضي ext4 مع LVM-thin أبسط وكاف، ثم تضع مخزن الأجهزة الكبير على أقراص أخرى بالنوع الذي اخترته من الجدول التالي.
أي مخزن تختار؟ Decision Table
| الحالة | المخزن المناسب | السبب |
|---|---|---|
| سيرفر واحد بقرصين أو أكثر دون وحدة RAID | ZFS بمرآة أو RAIDZ | حماية من تعطل قرص وتحقق من التلف وضغط وSnapshots في طبقة واحدة |
| سيرفر بوحدة RAID من العتاد | LVM-thin، كما في التثبيت الافتراضي | الحماية من الوحدة، وZFS لا يتوافق معها |
| سيرفر بذاكرة قليلة | LVM-thin | لا يحتاج ذاكرة ARC |
| ملفات ISO والقوالب والنسخ الاحتياطية | Directory أو NFS | المخازن الكتلية لا تقبلها |
| عنقود صغير يحتاج نقلاً حياً | NFS من NAS موثوق، أو ZFS مع Replication | مشترك دون تعقيد، أو نسخ دوري بخسارة دقائق |
| ثلاثة سيرفرات فأكثر، دون نقطة تعطل واحدة | Ceph | كل كتلة على ثلاثة سيرفرات، بشرط الشبكة والذاكرة |
أخطاء شائعة Common Mistakes
- الافتراض أن ZFS رقيق: رأينا أن مخزن ZFS في Proxmox يحجز حجم القرص كاملاً حتى تفعل
sparse، فقد يرفض إنشاء جهاز والمجمع شبه فارغ. - التخصيص المرن دون مراقبة: المخزن الممتلئ يجمد كل أجهزته دقيقة ثم يرفض كتاباتها، فراقب البيانات والبيانات الوصفية معاً.
- نسيان Discard: دونه لا يعود ما حذفته داخل الجهاز إلى المخزن، ويكبر القرص حتى حجمه الكامل.
- Snapshots قديمة: كل Snapshot يحجز كل ما تغير بعده، فاحذفها بعد انتهاء التحديث.
- مخزن مجلد دون
is_mountpoint: إذا فشل تركيب القرص كتبت الأجهزة في قرص النظام حتى يمتلئ. - ARC بقيمة التثبيت بعد زيادة الذاكرة: الملف
/etc/modprobe.d/zfs.confلا يتغير وحده، فعدله إذا زدت الذاكرة أو التخزين كثيراً. - النسخ الاحتياطية على المخزن
local: قرص النظام نفسه، فإذا تعطل ضاعت الأجهزة ونسخها معاً، وإذا امتلأ بالنسخ توقف السيرفر، فاجعل مخزن النسخ خارج السيرفر من اليوم الأول. - اختيار المخزن قبل معرفة الحاجة: لا تبدأ بالسؤال «أي مخزن هو الأفضل؟» وإنما بالأسئلة: هل أحتاج نقلاً حياً؟ وكم دقيقة من البيانات أستطيع أن أخسر؟ وكم قرصاً في السيرفر وهل عليها وحدة RAID؟ فالإجابات تختار المخزن عنك تقريباً.
- Ceph على شبكة 1 Gbps مشتركة: يعمل في البداية، ثم تأتي أول عملية استعادة فتبطئ كل شيء وقد تؤثر على العنقود.
حذف المختبر Cleanup
for i in 301 901 903 904 912 931 932; do qm stop $i 2>/dev/null; qm destroy $i 2>/dev/null; done
pvesm remove nfsstore; pvesm remove dirstore; pvesm remove thin2; pvesm remove tank
zpool destroy tank; vgremove -y thin2; umount /mnt/pve/dirstore
systemctl disable --now mnt-pve-dirstore.mount
الخلاصة Summary
وصلنا لنهاية الموضوع، وهذا ما يكتبه الفريق للمدير:
- المخزن في Proxmox سطر في
storage.cfgبنوع ومحتوى، والفرق المهم بين محلي ومشترك، وبين كتلي يقبل الأقراص فقط وملفات يقبل كل شيء. - قرص 8 GiB أخذ 56 KiB إلى 1.45 MiB وهو فارغ، ثم ما كتب فيه فقط، في ZFS مع
sparseوLVM-thin وqcow2 على مجلد أو NFS، أما ZFS دونsparseفيحجز الحجم كاملاً. - الـ Snapshot يبدأ من صفر ويكبر بما يتغير بعده، فأخذ 129 MiB بعد كتابة 128 MiB، والرجوع أعاد القرص في ثوان، ولكنه ليس نسخة احتياطية.
- المخزن الرقيق الممتلئ جمد الكتابة 62.6 ثانية ثم رفضها بخطأ I/O لكل الأقراص عليه، فراقبه ونبه قبل أن يمتلئ.
- Ceph لثلاثة سيرفرات فأكثر مع شبكة 10 Gbps وذاكرة كافية، وقبل ذلك ZFS مع Replication أو NFS من NAS موثوق.
- الوحدات المشتركة القديمة من أيام VMware تبقى مفيدة بعد الانتقال عبر LVM مشترك فوق الـ LUN، ومع Snapshots كسلسلة أقراص منذ الإصدار 9، والنسخ الاحتياطية مكانها دائماً خارج السيرفر وليس على المخزن local.
وفي المقال القادم بإذن الله ننتقل إلى الـ Containers في Proxmox: LXC، والفرق بين Unprivileged وPrivileged، ونقيس ما توفره مقارنة بالجهاز الافتراضي.
 دليلZFS للمبتدئين: كيف يحمي بياناتك من التلف الصامتكيف يكتشف ZFS التلف الصامت ويصلحه، وكيف ترتب الأقراص في Pool يتحمل العطل وتستعيد ملفاتك من Snapshots.
 دليلCeph للمبتدئين: تخزين موزع يتحمل تعطل السيرفراتكيف يوزع Ceph البيانات على عدة سيرفرات ويعيد نسخها وحده عندما يتعطل قرص، ومتى يكون أكبر من حاجتك.
 دليلأنواع التخزين وواجهة S3: أين تضع بيانات تطبيقك؟أين تضع قاعدة البيانات وملفات المستخدمين والنسخ الاحتياطية، ولماذا يناسب كلاً منها نوع مختلف من التخزين.
 دليلالنسخ الاحتياطي بقاعدة 3-2-1 واختبار الاستعادةكيف تحدد كم بيانات تقبل أن تخسر، وتبني نسخاً لا يستطيع المخترق حذفها، وتتأكد أنك تستطيع استعادتها فعلاً.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة الدليل وتنفيذ المختبر على Proxmox VE 9.2 (pve-manager 9.2.25، النواة 7.0.14-26، ZFS 2.4.4)، مع سيرفر NFS من Alpine 3.22 بالإصدار NFS 4.2.


