


بعد أسابيع من استخدام القوالب في شركة البرمجيات التي تتابعها مقالات هذا المسار، أصبح المطورون ينشئون سيرفرات التجربة بأنفسهم في ثوان، وأصبح على سيرفر Proxmox VE الواحد عشرات النسخ المرتبطة، وكلها على تجمع تخزين رقيق LVM-thin واحد. وفي مقال القوالب رأينا التحذير الذي يطبعه LVM عند كل نسخة: مجموع أحجام الأقراص أكبر من التجمع نفسه. وهذا مقبول ما دام أحد ينتبه إلى نسبة الامتلاء، والسؤال الذي طرحه مدير الفريق كان بسيطاً: من سوف ينتبه؟ وكيف نعرف أن التجمع سيمتلئ قبل أن تتوقف الأجهزة كلها عن الكتابة في اللحظة نفسها؟ وكيف نعرف أن السيرفر نفسه سقط إذا حدث ذلك في الليل؟
والإجابة الأولى التي يعطيها الجميع: «الرسوم موجودة في الواجهة». وهذا صحيح، فصفحة Summary في Proxmox فيها رسوم للمعالج والذاكرة والقرص والشبكة، ولكن الرسوم لا تنبه أحداً، ولا يفتحها أحد في الثالثة فجراً. وقد شرحنا في دليل المراقبة ماذا تراقب في البنية كلها، وبنينا في Prometheus مع لوحات Grafana نظام المقاييس نفسه، وفي التنبيهات Alerting متى توقظ أحداً. وهذا المقال يصل Proxmox بهذا النظام: من أين تأتي المقاييس، وما الذي فيها، وما الذي ليس فيها، ثم أربعة تنبيهات جربناها بأحداث حقيقية على مختبر يعمل فيه Proxmox VE 9.2، ومنها تنبيه سقوط السيرفر نفسه وما حدث معه من مفاجأة. وسوف نناقش في هذا المقال ما يلي:
- ماذا تراقب في سيرفر Proxmox تحديداً، وما الذي لا تراه من Proxmox ويجب أن تراه من داخل الأجهزة.
- الرسوم المدمجة RRD: ما تحفظه، وبأي دقة، ولماذا لا تكفي.
- ثلاث طرق لإخراج المقاييس: الرسوم المدمجة، والسحب Pull عبر prometheus-pve-exporter، والدفع Push عبر خادم المقاييس Metric Server بـ OpenTelemetry.
- أربع ملاحظات في مخرج المصدر تغير طريقة كتابة الاستعلامات، منها القالب الذي يبدو جهازاً ساقطاً.
- لوحة Grafana مكتوبة كملف، ومشكلة حقيقية في تحميلها.
- أربعة تنبيهات بأحداث حقيقية: جهاز متوقف، وتخزين يمتلئ، وجهاز دون نسخة احتياطية، وسيرفر ساقط، ورسائل «انتهت المشكلة» التي وصلت والسيرفر ساقط.
ماذا تراقب في سيرفر Proxmox؟ What to Monitor
سيرفر Proxmox ليس سيرفراً عادياً يكفي فيه المعالج والذاكرة والقرص، لأن عليه طبقتين: السيرفر نفسه، والأجهزة التي تعيش عليه. وكل طبقة لها أسئلة مختلفة. والجدول التالي يلخص ما نراه مهماً في سيرفر مثل سيرفر قصتنا، ومن أين يأتي كل رقم:
| السؤال | المقياس | المصدر |
|---|---|---|
| هل السيرفر حي؟ | هل يرد الـ API، أو هل وصلت مقاييسه مؤخراً | Proxmox |
| هل سيمتلئ التخزين؟ | المستخدم من كل مخزن Storage، واتجاهه | Proxmox |
| هل الأجهزة المهمة تعمل؟ | حالة كل جهاز، مع خيار التشغيل عند الإقلاع onboot | Proxmox |
| هل لكل جهاز نسخة احتياطية؟ | الأجهزة التي لا تغطيها أي مهمة نسخ | Proxmox |
| هل السيرفر مضغوط؟ | المعالج والذاكرة وضغط الموارد PSI | Proxmox |
| هل القرص داخل الجهاز ممتلئ؟ | مساحة أنظمة الملفات داخل كل جهاز | داخل الجهاز (node_exporter) |
| هل التطبيق يعمل؟ | الإشارات الذهبية Golden Signals وفحص التوفر | التطبيق والخارج |
ولاحظ السطر قبل الأخير: Proxmox يعرف حجم قرص الجهاز، ولكنه لا يعرف كم امتلأ نظام الملفات داخله، والسبب أنه يرى القرص ككتل، ولا يرى الملفات التي كتبها النظام الضيف، وسوف نرى ذلك بالأرقام في مخرج المصدر. لذلك مراقبة Proxmox لا تغني عن مراقبة كل جهاز من داخله، كما شرحنا في مقال Prometheus، وإنما تضيف إليها ما لا يراه الجهاز: التخزين المشترك، والسيرفر الذي يحمل الجميع، والأجهزة المتوقفة التي لا ترسل شيئاً لأنها متوقفة.
من أين تأتي الأرقام أصلاً؟ pvestatd
قبل أن نختار طريقة لإخراج المقاييس، من المفيد أن نعرف من يجمعها داخل Proxmox. تقول صفحة pvestatd إن هذه الخدمة تسأل عن حالة الأجهزة والمخازن والـ Containers على فترات منتظمة، وترسل النتيجة إلى كل سيرفرات العنقود. أي أن كل سيرفر يجمع حالة ما عليه فقط، ثم ينشرها عبر نظام ملفات العنقود، فيعرف كل سيرفر حالة الجميع، وهذا هو السبب في أنك تستطيع أن تفتح واجهة أي سيرفر في العنقود فترى كل الأجهزة على كل السيرفرات.
وهذه الحقيقة تحدد ثلاثة أشياء في المراقبة. الأول أن كل طرق الإخراج تقرأ في النهاية من المصدر نفسه، فالرسوم والواجهة البرمجية وخادم المقاييس كلها تعرض ما جمعته pvestatd، والفرق بينها في الشكل والوجهة وليس في الأرقام. والثاني أن سؤال سيرفر واحد في العنقود عبر الواجهة البرمجية يعطيك حالة العنقود كله، وهذا ما يفعله المصدر عندما تطلب cluster=1، فلا تحتاج إلى مصدر لكل سيرفر، ولكن إذا سقط السيرفر الذي تسأله فقدت رؤية الجميع، لذلك اجعل الهدف عنوان أكثر من سيرفر، أو عنواناً عائماً أمام العنقود. والثالث أن الخدمة نفسها قد تتعطل، فإذا رأيت في الواجهة علامات استفهام رمادية على الأجهزة فهذا يعني غالباً أن pvestatd لا تحدث الحالة، والسيرفر نفسه يعمل، وهذا عطل تراه في المراقبة على شكل أرقام ثابتة لا تتغير، وليس على شكل سقوط.
الرسوم المدمجة RRD: ما تحفظه وما لا تحفظه
كل سيرفر Proxmox يشغل خدمة pvestatd التي تجمع حالة السيرفر والأجهزة والمخازن كل بضع ثوان، وتكتبها في ملفات RRD، أي قواعد بيانات دائرية Round Robin Database حجمها ثابت لا يكبر مع الزمن، لأنها تختصر البيانات القديمة إلى متوسطات. وهذه الملفات هي مصدر الرسوم في صفحة Summary، كما في الصورة التالية:
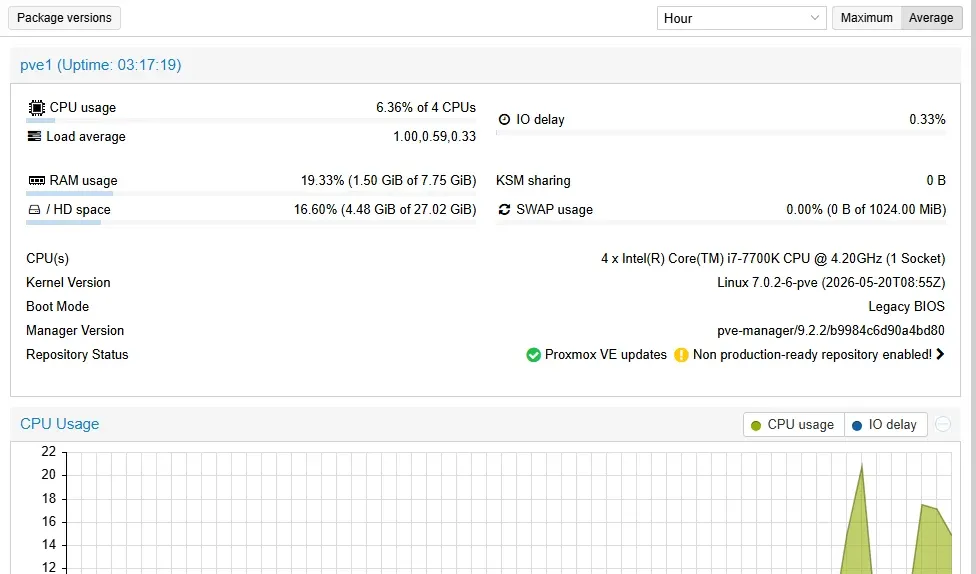
وتستطيع أن تقرأ البيانات نفسها من سطر الأوامر بالأمر pvesh get /nodes/pve1/rrddata، وقد قرأناها بكل المدد المتاحة لنعرف كم تحفظ بالضبط:
60 points
['arcsize', 'cpu', 'iowait', 'loadavg', 'maxcpu', 'memavailable', 'memtotal', 'memused', 'netin', 'netout',
 'pressurecpusome', 'pressureiofull', 'pressureiosome', 'pressurememoryfull', 'pressurememorysome',
 'roottotal', 'rootused', 'swaptotal', 'swapused', 'time']
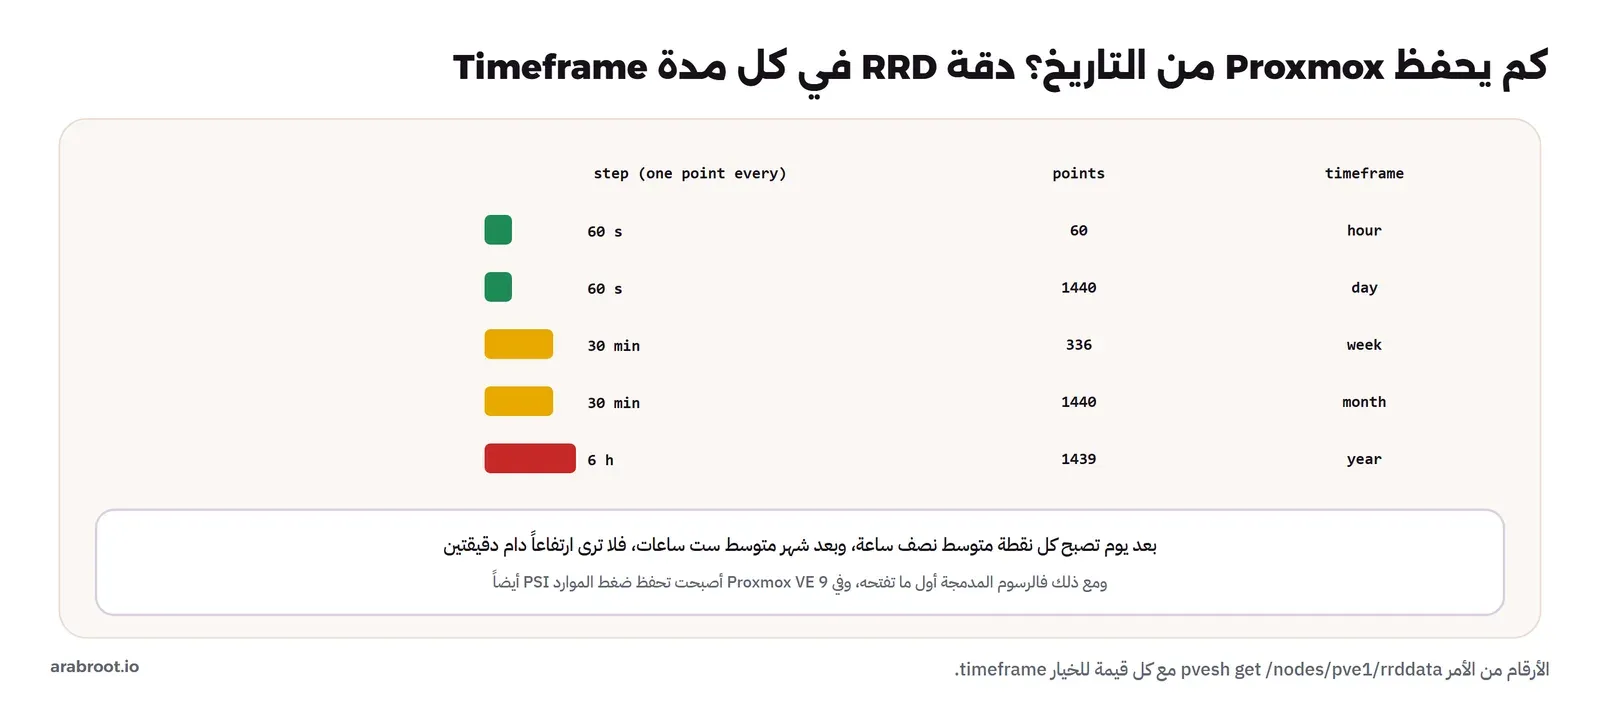
hour 60 points, step 60 s
day 1440 points, step 60 s
week 336 points, step 1800 s
month 1440 points, step 1800 s
year 1439 points, step 21600 s
pve-node-9.0
pve-storage-9.0
pve-vm-9.0
18M	/var/lib/rrdcached/db/
في المخرج أعلاه لاحظ التالي:
- آخر يوم محفوظ بدقة نقطة كل دقيقة، وبعده نقطة كل نصف ساعة حتى شهر، ثم نقطة كل ست ساعات لسنة، وهذا يطابق ما تذكره ملاحظات إصدار Proxmox VE 9.0 التي زادت الدقة وأضافت نقطة كل أسبوع لعشر سنوات.
- الحقول التي تبدأ بـ pressure هي معلومات ضغط الموارد Pressure Stall Information، وتقول ملاحظات الإصدار نفسها إنها أضيفت في 9.0 للسيرفر وللأجهزة، وهي تقيس الوقت الذي انتظرت فيه العمليات المعالج أو الذاكرة أو القرص، وهذا أدق في كشف الضغط من نسبة استخدام المعالج وحدها.
- كل الملفات 18 ميجابايت، وأسماء المجلدات فيها رقم الإصدار 9.0، لأن صيغة الملفات تغيرت في هذا الإصدار.
فلماذا لا تكفي؟ لثلاثة أسباب. الأول أنها لا تنبه، فلا يوجد في Proxmox مكان تكتب فيه «أرسل لي رسالة إذا تجاوز التخزين 80%». والثاني أن الدقة تنخفض بعد يوم، فإذا سألك أحد بعد أسبوع لماذا كانت الأنظمة بطيئة يوم الثلاثاء بين الثانية والثانية وخمس دقائق، فالرسم لن يجيبك. والثالث أنها في Proxmox وحده، فلا تستطيع أن تضعها بجانب مقاييس التطبيق وقاعدة البيانات في لوحة واحدة، وهذه هي الفكرة كلها في بوابة المراقبة الواحدة.
كيف تقرأ ضغط الموارد؟ Pressure Stall Information
نسبة استخدام المعالج تخبرك كم كان المعالج مشغولاً، ولكنها لا تخبرك هل انتظر أحد. فسيرفر عند 90% قد يكون سليماً تماماً لأن كل عملية تأخذ دورها دون تأخير، وسيرفر عند 60% قد يكون بطيئاً لأن الأجهزة تنتظر القرص. وهنا يفيدك ضغط الموارد، وتشرح وثائق نواة Linux عن PSI أن له نوعين لكل مورد: some، وهو نسبة الوقت الذي كانت فيه عملية واحدة على الأقل تنتظر المورد، وfull، وهو نسبة الوقت الذي كانت فيه كل العمليات غير الخاملة تنتظره معاً، وفي هذه الحالة تضيع دورات المعالج فعلاً، وتسمي الوثائق العمل الذي يقضي فيها وقتاً طويلاً بأنه في حالة Thrashing.
والقاعدة العملية أن تنظر في الحقل pressureiofull عندما يشتكي أحد من البطء، فإذا كان مرتفعاً فالمشكلة في القرص وليست في المعالج، وإضافة أنوية للجهاز لن تحل شيئاً. والحقل pressurememoryfull المرتفع يعني أن السيرفر يقضي وقته في استعادة الذاكرة، وهذا أول علامة على أنك وزعت على الأجهزة ذاكرة أكثر مما يحتمل السيرفر. ولاحظ أن هذه الحقول لم تظهر في مقاييس المصدر ولا في مقاييس OpenTelemetry التي وصلت إلى Prometheus في المختبر، فهي اليوم في الرسوم المدمجة وفي rrddata، وإذا أردتها في Prometheus فـ node_exporter على السيرفر يقرؤها من /proc/pressure مباشرة.
ثلاث طرق لإخراج المقاييس: Pull أو Push
لكي تصل مقاييس Proxmox إلى Prometheus لديك طريقتان رئيسيتان، والفرق بينهما هو الفرق الذي شرحناه في مقال Prometheus بين السحب Pull والدفع Push:
- السحب: برنامج صغير اسمه prometheus-pve-exporter يسأل الواجهة البرمجية API في Proxmox، ويترجم الإجابة إلى صيغة Prometheus، وPrometheus يسأله كل 15 ثانية. والمشروع مفتوح المصدر من مجتمع Prometheus، وكان أحدث إصدار منه يوم التجربة 3.11.0.
- الدفع: Proxmox نفسه يرسل المقاييس إلى خادم خارجي، وتسمى هذه الميزة خادم المقاييس الخارجي External Metric Server، وتدعم بحسب الوثائق ثلاثة أنواع: Graphite وInfluxDB وOpenTelemetry، والأخير أضيف في Proxmox VE 9.0 كما في ملاحظات الإصدار. وPrometheus من الإصدار 3 يستقبل OpenTelemetry مباشرة، فلا تحتاج إلى برنامج وسيط.
وجربنا الطريقتين على السيرفر نفسه وإلى Prometheus واحد، والصورة التالية تبين المسارات الثلاثة:
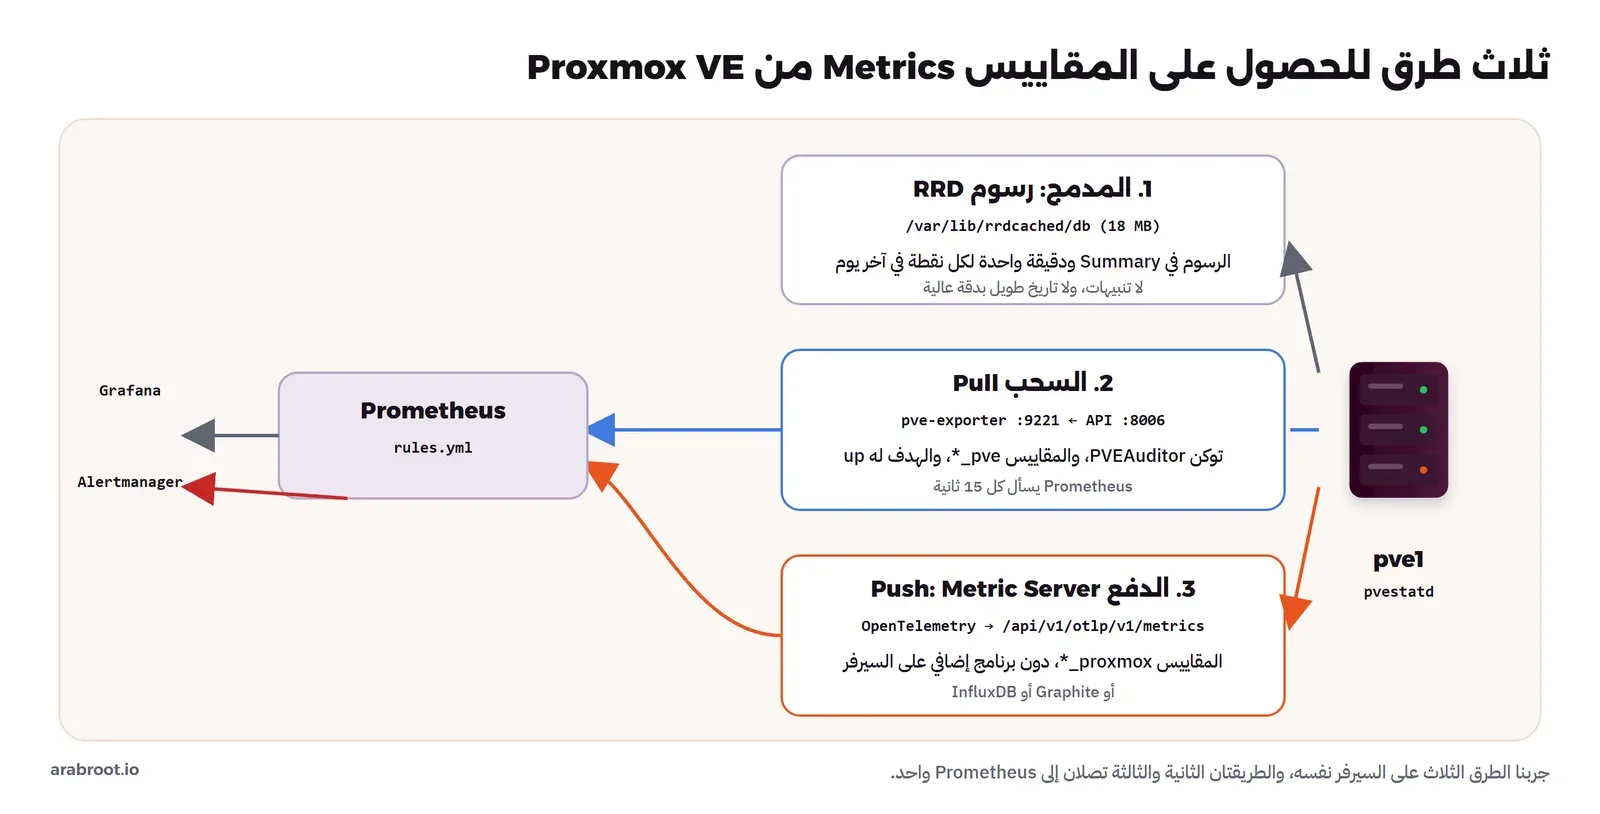
وفي المختبر شغلنا prometheus-pve-exporter وPrometheus 3.13.4 وAlertmanager 0.34.2 وGrafana 13.3.0 في Containers على جهاز المراقبة، ومستقبل Webhook صغيراً بـ Python يطبع كل تنبيه يصل مع وقته، حتى نقيس متى وصل كل تنبيه بالثانية.
وProxmox نفسه في المختبر يعمل كجهاز افتراضي بـ QEMU مع KVM، على شبكة 10.10.10.0/24 تمثل شبكة الإدارة، وعليه الجهاز web-03 الذي يعمل عليه nginx من مقالات المسار السابقة، والجهاز alice-test الذي أنشأته المطورة في مقال التأمين، والقالب 9000. واخترنا أن تكون كل أدوات المراقبة على جهاز منفصل عن Proxmox، وليس داخل جهاز على السيرفر نفسه، والسبب أننا أردنا أن نطفئ السيرفر في آخر التجربة ونرى ما يصل، وهذا مستحيل إذا كانت المراقبة تسقط معه. وهذا الترتيب نفسه هو ما ننصح به في الإنتاج: المراقبة في مكان لا يشارك السيرفر الذي تراقبه في الكهرباء أو الشبكة أو التخزين، ولو كان سيرفراً صغيراً رخيصاً في موقع آخر.
السحب Pull: prometheus-pve-exporter
توكن للقراءة فقط Read-only Token
المصدر يحتاج إلى دخول إلى الواجهة البرمجية، وقد شرحنا في مقال تأمين Proxmox في هذا المسار لماذا لا تعطي أداة كلمة مرور مستخدم، فأنشأنا مستخدماً خاصاً، ودور PVEAuditor للقراءة فقط، وتوكناً بفصل الصلاحيات Privilege Separation، وأعطينا التوكن نفسه الدور، لأن التوكن بفصل الصلاحيات لا يملك شيئاً حتى تعطيه:
pveum user add prometheus@pve --comment "pve-exporter, read only"
pveum acl modify / --users prometheus@pve --roles PVEAuditor
pveum user token add prometheus@pve exporter --privsep 1 --comment "prometheus-pve-exporter on the monitoring host"
pveum acl modify / --tokens "prometheus@pve!exporter" --roles PVEAuditor
ثم كتبنا إعداد المصدر، وقيمة التوكن تظهر مرة واحدة عند إنشائه:
# pve.yml : prometheus-pve-exporter, read-only API token (privsep, PVEAuditor on /)
default:
  user: prometheus@pve
  token_name: exporter
  token_value: <shown once when the token is created>
  verify_ssl: false   # lab only: self-signed certificate
والسطر الأخير للمختبر فقط، لأن الشهادة موقعة من سلطة Proxmox الداخلية، أما في الإنتاج فأعط المصدر شهادة السلطة أو استخدم شهادة موثوقة عبر ACME، والسبب أن إيقاف التحقق يعني أن أي جهاز في الطريق يستطيع أن ينتحل شخصية السيرفر ويأخذ التوكن.
إعداد Prometheus: Multi-target Exporter
المصدر من النوع الذي يسمى Multi-target، أي أنه لا يراقب سيرفراً ثابتاً، وإنما يأخذ عنوان السيرفر في الطلب نفسه، وبالتالي يستطيع مصدر واحد أن يخدم عدة عناقيد. وهذا يجعل إعداد Prometheus مختلفاً قليلاً:
scrape_configs:
  - job_name: pve
    metrics_path: /pve
    params:
      module: [default]
      cluster: ["1"]
      node: ["1"]
    static_configs:
      - targets: ["10.10.10.11"]     # the Proxmox VE node (API on 8006)
    relabel_configs:
      - source_labels: [__address__]
        target_label: __param_target
      - source_labels: [__param_target]
        target_label: instance
      - target_label: __address__
        replacement: localhost:9221  # the exporter
في الإعداد أعلاه لاحظ التالي:
- الهدف المكتوب 10.10.10.11 هو السيرفر، ولكن Prometheus لا يتصل به، وإنما تنقله أول قاعدة إلى المعامل target في الطلب، والقاعدة الثالثة تجعل الاتصال الفعلي إلى المصدر على localhost:9221.
- القاعدة الثانية تجعل التسمية instance هي عنوان السيرفر وليس عنوان المصدر، وهذا مهم في التنبيهات، فرسالة «السيرفر 10.10.10.11 لا يرد» أوضح من «localhost:9221 لا يرد».
cluster: "1"يطلب مقاييس العنقود، أي كل الأجهزة والمخازن، وnode: "1"يطلب مقاييس السيرفر نفسه مثل الإصدار والاشتراك وحالة onboot.
ماذا يخرج المصدر؟ Exporter Output
سألنا المصدر بأنفسنا، فرجع 223 سطراً، وهذه أهمها:
pve_up{id="node/pve1"} 1.0
pve_up{id="qemu/108"} 1.0
pve_up{id="qemu/120"} 0.0
pve_up{id="qemu/9000"} 0.0
pve_up{id="storage/pve1/local-lvm"} 1.0
pve_disk_size_bytes{id="storage/pve1/local-lvm"} 2.6839351296e+10
pve_disk_usage_bytes{id="storage/pve1/local-lvm"} 1.441273164e+09
pve_disk_usage_bytes{id="qemu/108"} 0.0
pve_cpu_usage_ratio{id="/pool/dev-pool"} 0.592613472392341
pve_cpu_usage_ratio{id="qemu/108"} 0.592613472392341
pve_cpu_usage_ratio{id="node/pve1"} 0.343452082288008
pve_onboot_status{id="qemu/108",node="pve1",type="qemu"} 1.0
pve_guest_info{id="qemu/9000",name="tpl-debian13",node="pve1",tags="",template="1",type="qemu"} 1.0
pve_not_backed_up_total{id="cluster/pve1"} 3.0
pve_not_backed_up_info{id="qemu/108"} 1.0
pve_version_info{release="9.2",repoid="b9984c6d90a4bd80",version="9.2.2"} 1.0
pve_subscription_status{id="node/pve1",status="notfound"} 1.0
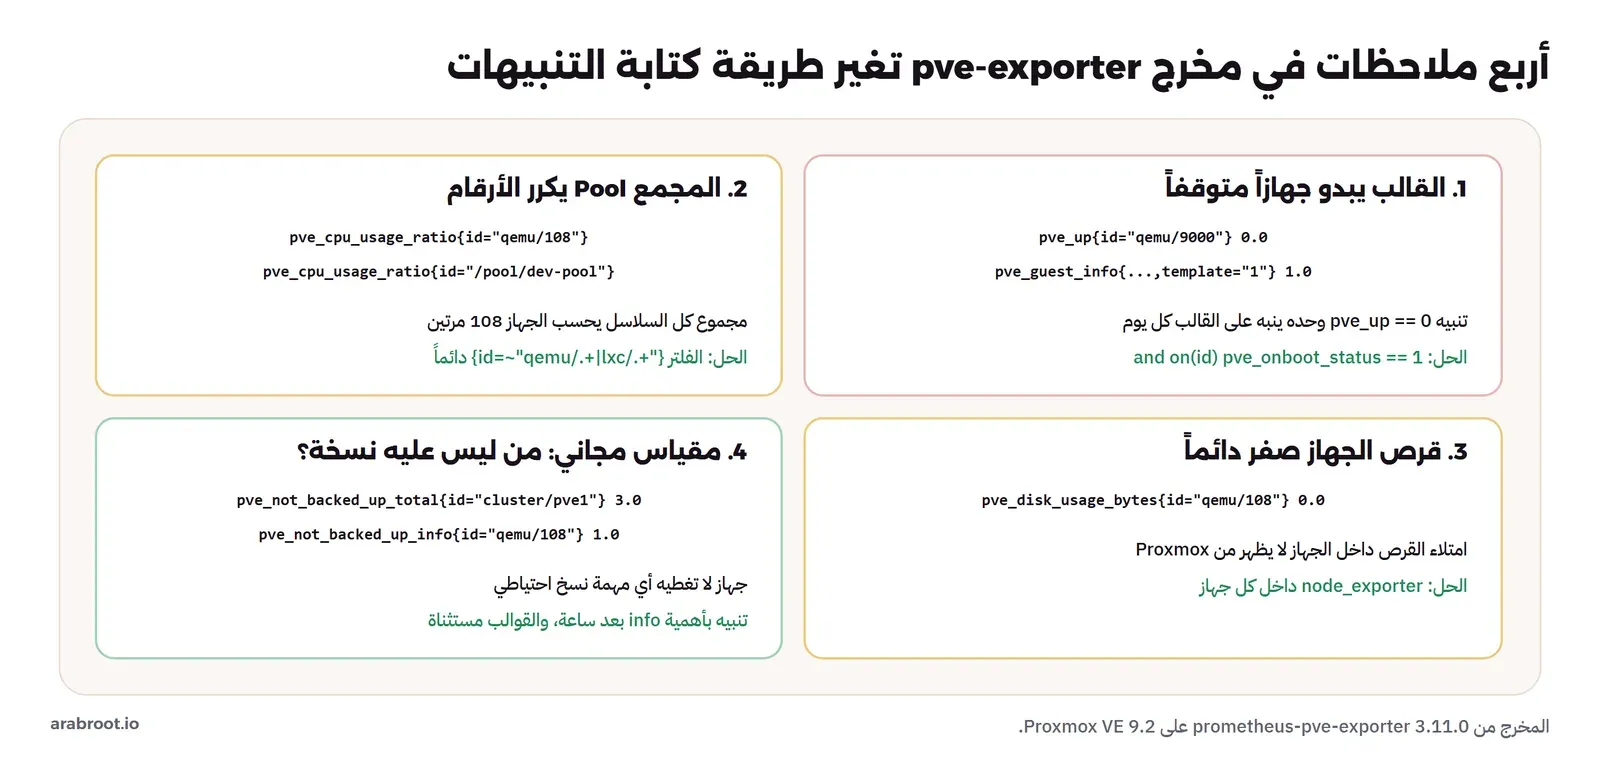
كل المقاييس تحمل التسمية id التي تعرف الشيء بنوعه ورقمه، مثل qemu/108 وstorage/pve1/local-lvm، والأسماء المقروءة في مقياس منفصل pve_guest_info تربطه بالاستعلام عند الحاجة. وفي هذا المخرج أربع ملاحظات غيرت طريقة كتابتنا للتنبيهات:
- القالب يبدو جهازاً متوقفاً:
pve_up{id="qemu/9000"}قيمته 0، لأن القالب لا يعمل أبداً. فتنبيه بسيط مثلpve_up == 0سوف ينبه على كل قالب كل يوم، وبعد أسبوع يتجاهل الفريق التنبيه كله. والحل أن تنبه فقط على الأجهزة التي يجب أن تعمل، وأفضل مؤشر على ذلك هو الخيار onboot، فالجهاز الذي ضبطته ليعمل مع إقلاع السيرفر يجب أن يكون يعمل، والجهاز الذي لم تضبطه قد يكون متوقفاً عمداً مثل alice-test. - المجمع Pool يكرر الأرقام: الجهاز 108 عضو في المجمع dev-pool الذي أنشأناه في مقال التأمين، فظهر استخدامه للمعالج مرتين، مرة باسمه ومرة باسم المجمع. فإذا جمعت كل السلاسل بالأمر sum فسوف تحسب كل جهاز في مجمع مرتين. والحل أن تحدد النوع دائماً في الاستعلام بالفلتر
{id=~"qemu/.+|lxc/.+"}. - قرص الجهاز صفر دائماً:
pve_disk_usage_bytes{id="qemu/108"}صفر، والوصف في المصدر نفسه يقول إنه المساحة المستخدمة من قرص الجهاز، ولكن Proxmox لا يعرفها للأجهزة الافتراضية، وهذا ما ذكرناه في القسم الأول: امتلاء القرص داخل الجهاز لا يظهر من Proxmox. - مقياس مجاني للنسخ الاحتياطي:
pve_not_backed_up_infoيظهر لكل جهاز لا تغطيه أي مهمة نسخ احتياطي، وكان في المختبر ثلاثة، لأننا لم ننشئ أي مهمة بعد. وهذا من أهم المقاييس في السيرفر كله، لأن الجهاز الذي أنشأه مطور وأصبح فجأة مهماً للعميل هو بالضبط الجهاز الذي لا ينسخه أحد.
الدفع Push: Metric Server مع OpenTelemetry
الطريقة الثانية لا تحتاج أي برنامج إضافي، فخدمة pvestatd التي تكتب ملفات RRD تستطيع أن ترسل القيم نفسها إلى خادم خارجي. وأضفنا خادم مقاييس من نوع OpenTelemetry يرسل إلى Prometheus مباشرة، بعد أن شغلنا Prometheus بالخيار --web.enable-otlp-receiver الذي يفتح فيه نقطة استقبال OTLP كما في دليل Prometheus لـ OpenTelemetry:
pvesh create /cluster/metrics/server/prom-otlp --type opentelemetry \
  --server 10.10.10.1 --port 9090 --otel-protocol http --otel-path /api/v1/otlp/v1/metrics
opentelemetry: prom-otlp
server 10.10.10.1
otel-path /api/v1/otlp/v1/metrics
otel-protocol http
port 9090هذا محتوى الملف /etc/pve/status.cfg بعد الأمر، وهو في نظام ملفات العنقود، أي أن كل سيرفرات العنقود سوف ترسل إلى الخادم نفسه دون أن تعدها واحداً واحداً. وبعد أقل من دقيقة ظهرت في Prometheus مقاييس جديدة تبدأ بـ proxmox، منها:
proxmox_node_cpustat_iowait_seconds_total
proxmox_node_memory_memused_bytes
proxmox_node_uptime_seconds
proxmox_storage_used_bytes
proxmox_storage_total_bytes
proxmox_vm_cpu_percent
proxmox_vm_mem_bytes
proxmox_vm_uptime_seconds
proxmox_node_blockstat_user_bavail_seconds

proxmox_storage_used_bytes{job="proxmox-ve",node="pve1",storage="local-lvm"} 1449324969
target_info{job="proxmox-ve",proxmox_cluster="single-node",proxmox_node="pve1",service_version="9.2.2/b9984c6d90a4bd80"} 1
في المخرج أعلاه لاحظ التالي:
- التسميات هنا أوضح من المصدر: node وstorage وvmid وname في كل سلسلة، فلا تحتاج إلى ربط مع مقياس info لترى اسم الجهاز.
- Prometheus يضيف لاحقة الوحدة إلى اسم المقياس من وحدة OpenTelemetry، وبعض الوحدات القادمة من Proxmox لا تناسب معناها، فالمقياس
proxmox_node_blockstat_user_bavail_secondsيتحدث عن كتل متاحة في القرص وليس عن ثوان، لذلك اقرأ معنى المقياس من اسمه الأصلي ولا تثق باللاحقة. - المقياس target_info يحمل اسم العنقود والسيرفر والإصدار، وهذه طريقة OpenTelemetry في وصف مصدر البيانات Resource.
- لا يوجد هنا مقياس up، لأن Prometheus لم يسأل أحداً، وإنما استقبل ما وصل، وهذا الفرق سوف يظهر بوضوح في تجربة سقوط السيرفر.
وإذا كانت لديك أصلاً منصة InfluxDB أو Graphite فالطريقة نفسها تعمل معها، والوثائق تشرح إعداد InfluxDB عبر UDP أو عبر واجهة HTTP في الإصدار 2، مع ملاحظة مهمة: Graphite وInfluxDB عبر UDP لا يخبرانك إذا ضاعت الرسائل في الطريق، لأن UDP لا يؤكد الوصول.
ما لا يراه مقياس التخزين: Thin Pool Metadata
مقياس التخزين في المصدر وفي خادم المقاييس للمخزن local-lvm هو نسبة البيانات Data في التجمع الرقيق، ولكن التجمع الرقيق في LVM فيه جزء ثان لا يظهر هنا، وهو البيانات الوصفية Metadata، أي الجداول التي تحفظ أين تقع كتل كل قرص رقيق وكل لقطة. وكل نسخة مرتبطة وكل Snapshot تضيف إلى هذه الجداول، فقد يمتلئ جزء البيانات الوصفية والبيانات نفسها في منتصفها، والنتيجة واحدة: التجمع يتوقف عن الكتابة. وفي المختبر كان الجزءان كما يلي بالأمر lvs بعد بناء القالب:
  LV                VG  Attr       LSize   Pool Origin Data%  Meta%
  data              pve twi-aotz-- <25.00g             3.73   1.61
والنسبة الثانية Meta% منخفضة في سيرفر جديد، ولكنها لا تصل إلى Prometheus من Proxmox. والحل البسيط أن يقرأها node_exporter على سيرفر Proxmox نفسه عبر ملف نصي يكتبه سكربت مجدول كل دقيقة، فيما يسمى Textfile Collector، أو أن تضعها في فحص يومي إذا كان السيرفر لا ينشئ لقطات كثيرة. والمهم أن تعرف أنها موجودة، لأن من يراقب Data% وحدها سوف يفاجأ يوماً بتجمع متوقف وهو عند 60%.
وهذا يقودنا إلى قاعدة عامة في مراقبة Proxmox: المصدر يعطيك ما في الواجهة البرمجية، والواجهة البرمجية تعطيك ما تعرضه الواجهة، ولا شيء أكثر. فحالة أقراص السيرفر الفعلية SMART، وصحة RAID، وحرارة المعالج، والبيانات الوصفية في التجمع، كلها تحتاج node_exporter على السيرفر نفسه، وتقول وثائق إدارة النظام إن الخدمة smartd تعمل افتراضياً وترسل بريداً إلى root عندما تجد مشكلة في قرص، وهذا البريد لن يقرأه أحد إذا لم تضبط وجهته.
إشعارات Proxmox نفسه Notifications
وهناك مصدر ثالث للتنبيهات لا علاقة له بـ Prometheus، وهو نظام الإشعارات المدمج في Proxmox. فبحسب وثائق الإشعارات يرسل Proxmox أحداثاً عند نجاح النسخ الاحتياطي أو فشله، وعند فشل مهمة النسخ المتماثل Replication، وعند عزل سيرفر في العنقود Fencing، وعند توفر تحديثات للنظام، ولكل حدث نوع type وأهمية severity، مثل vzdump بأهمية info عند النجاح وerror عند الفشل. وتصل هذه الأحداث إلى أهداف Targets من نوع البريد أو SMTP أو Gotify أو Webhook، وتوجهها قواعد مطابقة Matchers بحسب النوع والأهمية، والإعداد كله في /etc/pve/notifications.cfg.
والفرق بين هذا النظام وPrometheus أن الإشعارات تخبرك بحدث وقع، مثل «فشلت مهمة النسخ الليلة»، بينما Prometheus يخبرك بحالة مستمرة، مثل «هذا الجهاز لا تغطيه أي مهمة نسخ». وتحتاج الاثنين، لأن مهمة نسخ لم تعمل أصلاً لا ترسل إشعار فشل، والجهاز الذي لم يضف إلى أي مهمة لن يفشل نسخه أبداً. والنصيحة العملية أن توجه إشعارات Proxmox إلى المكان نفسه الذي تصل إليه تنبيهات Alertmanager، عبر هدف Webhook أو بريد الفريق نفسه، حتى لا يكون للمناوب مكانان يراقبهما، وأن تجعل قاعدة مطابقة لأهمية error ترسل فوراً، وتترك info للملخص اليومي.
لوحة Grafana ككود Dashboard as Code
كما في مقال Prometheus، كتبنا اللوحة ملفاً، ومعها مصدر البيانات Data Source، حتى تكون في المستودع ويعيد أي شخص بناءها. ملف مصدر البيانات:
apiVersion: 1
datasources:
  - name: Prometheus
    uid: prom
    type: prometheus
    url: http://localhost:9090
    isDefault: true
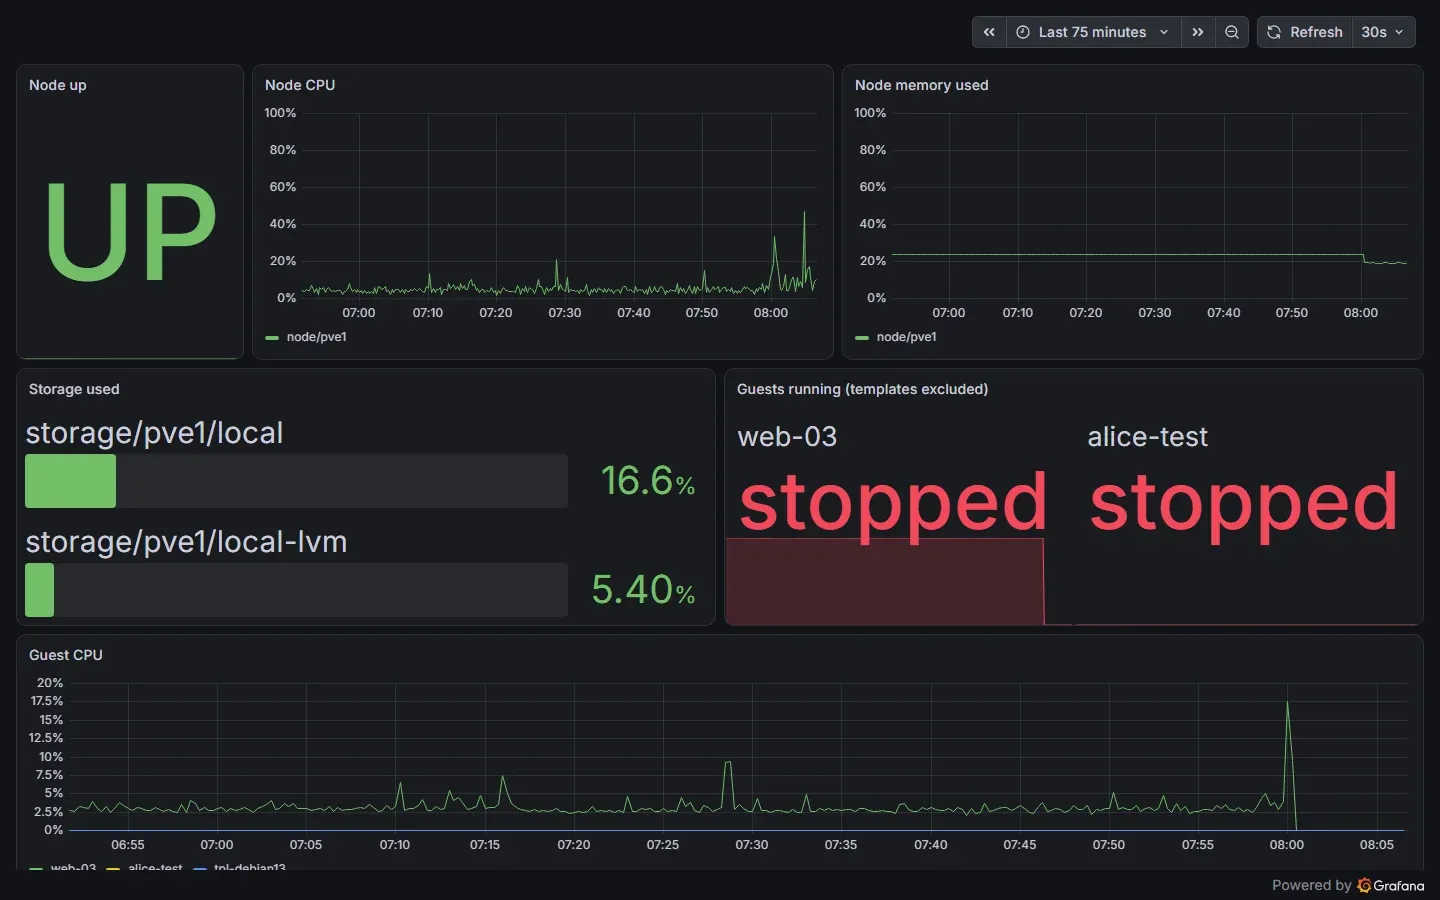
واللوحة فيها ست لوحات فرعية Panels، وأهم ما فيها الاستعلامات نفسها:
Node up            pve_up{id=~"node/.+"}
Node CPU           pve_cpu_usage_ratio{id=~"node/.+"}
Node memory used   pve_memory_usage_bytes{id=~"node/.+"} / pve_memory_size_bytes
Storage used       pve_disk_usage_bytes{id=~"storage/.+"} / pve_disk_size_bytes
Guests running     pve_up{id=~"qemu/.+|lxc/.+"} * on(id) group_left(name) pve_guest_info{template="0"}
Guest CPU          pve_cpu_usage_ratio{id=~"qemu/.+|lxc/.+"} * on(id) group_left(name) pve_guest_info
لاحظ في استعلام الأجهزة العاملة أننا ضربنا pve_up في pve_guest_info مع الشرط template="0"، فالضرب في 1 لا يغير القيمة، ولكنه يجلب التسمية name من المقياس الثاني، ويستبعد القوالب في الوقت نفسه. وفي اللوحة الأخيرة لم نستبعد القوالب، لأن معالجها صفر على أي حال.
المشكلة: اللوحة لم تظهر Provisioning
شغلنا Grafana وفتحنا قائمة اللوحات فكانت فارغة، والواجهة البرمجية رجعت []. وفي سجل Grafana وجدنا السبب:
logger=provisioning.dashboard level=error msg="can't read dashboard provisioning files from directory"
  path=/etc/grafana/provisioning/dashboards error="open /etc/grafana/provisioning/dashboards: no such file or directory"
والسبب أننا ربطنا المجلد في الـ Container قبل أن ننشئ مجلده الفرعي على جهاز المختبر، فرأت Grafana المجلد الأب دون المجلد الفرعي، ولم تعد تفحصه بعد إنشائه. وبعد أن أعدنا إنشاء الـ Container ظهر في السجل finished to provision dashboards وظهرت اللوحة. والدرس أن Grafana لا تتوقف ولا تفشل عندما لا تجد ملفات اللوحات، وإنما تكتب سطراً في السجل وتكمل، فاجعل في نشر المراقبة نفسها فحصاً بسيطاً بعد التشغيل، مثل طلب /api/search والتأكد أن اللوحة موجودة. والصورة التالية للوحة بعد ساعة من البيانات، وفيها الجهاز web-03 متوقف أثناء التجربة التالية:
قواعد التنبيه Alert Rules
كتبنا القواعد في ملف واحد، وفحصناه بالأداة promtool قبل التشغيل، وهي تفحص صيغة الملف والاستعلامات:
groups:
  - name: proxmox
    rules:
      - alert: PveNodeUnreachable
        expr: up{job="pve"} == 0
        for: 1m
        labels: {severity: critical}

      - alert: PveGuestDown
        expr: (pve_up{id=~"qemu/.+|lxc/.+"} == 0) and on(id) (pve_onboot_status == 1)
        for: 1m
        labels: {severity: warning}

      - alert: PveStorageAlmostFull
        expr: pve_disk_usage_bytes{id=~"storage/.+"} / pve_disk_size_bytes > 0.80
        for: 5m
        labels: {severity: warning}

      - alert: PveStorageFillsIn24h
        expr: |
          predict_linear(pve_disk_usage_bytes{id=~"storage/.+"}[10m], 24 * 3600)
            > on(id) pve_disk_size_bytes
        for: 2m
        labels: {severity: warning}

      - alert: PveGuestNotBackedUp
        expr: (pve_not_backed_up_info == 1) unless on(id) (pve_guest_info{template="1"})
        for: 1h
        labels: {severity: info}

      # push path (Proxmox VE metric server, OpenTelemetry): there is no "up", so alert on silence
      - alert: PveNodeStoppedPushing
        expr: absent_over_time(proxmox_node_uptime_seconds{node="pve1"}[2m])
        for: 1m
        labels: {severity: critical}
Checking /m/rules.yml
SUCCESS: 5 rules foundوالملف المختصر أعلاه بلا سطور annotations للوضوح، وهي في ملف المختبر الكامل، وأضفنا القاعدة السادسة بعد الفحص. وفي القواعد لاحظ التالي:
- للتخزين قاعدتان: الأولى على النسبة 80%، والثانية على الاتجاه بالدالة predict_linear، التي تأخذ ما حدث في آخر عشر دقائق وتمده خطاً مستقيماً 24 ساعة إلى الأمام. والثانية هي التي تهم في التخزين الرقيق، لأن التجمع قد يكون عند 40% ويمتلئ في ساعتين إذا بدأ أحد ينسخ قاعدة بيانات كبيرة إلى جهاز تجربة.
- تنبيه النسخ الاحتياطي بمدة ساعة وبأهمية info، لأن الجهاز الجديد يحتاج وقتاً حتى يضيفه أحد إلى مهمة النسخ، ولا يستحق أن يوقظ أحداً، ومكانه ملخص يومي كما شرحنا في مقال التنبيهات.
- لكل طريقة تنبيه سقوط خاص بها، لأن السحب يعطيك up والدفع لا يعطيك شيئاً.
وAlertmanager يرسل كل التنبيهات إلى مستقبل Webhook في المختبر، مع رسائل الحل أيضاً بالخيار send_resolved، وفي الإنتاج يكون المستقبل البريد أو Slack أو نظام المناوبة.
التجربة: أربعة أحداث حقيقية Alert Lab
بعد ساعة من التشغيل كان أول تنبيه قد وصل وحده، دون أن نفعل شيئاً:
02:53:29 FIRING PveGuestNotBackedUp - qemu/108 is not covered by any backup job
02:53:29 FIRING PveGuestNotBackedUp - qemu/120 is not covered by any backup job
أي جهاز الويب وجهاز التجربة الذي أنشأته alice، أما القالب 9000 فلم يظهر لأن القاعدة تستثني القوالب. والأوقات في سجل المستقبل بالتوقيت العالمي UTC، أي قبل توقيت السعودية بثلاث ساعات. ثم بدأنا الأحداث.
جهاز مهم يتوقف Guest Down
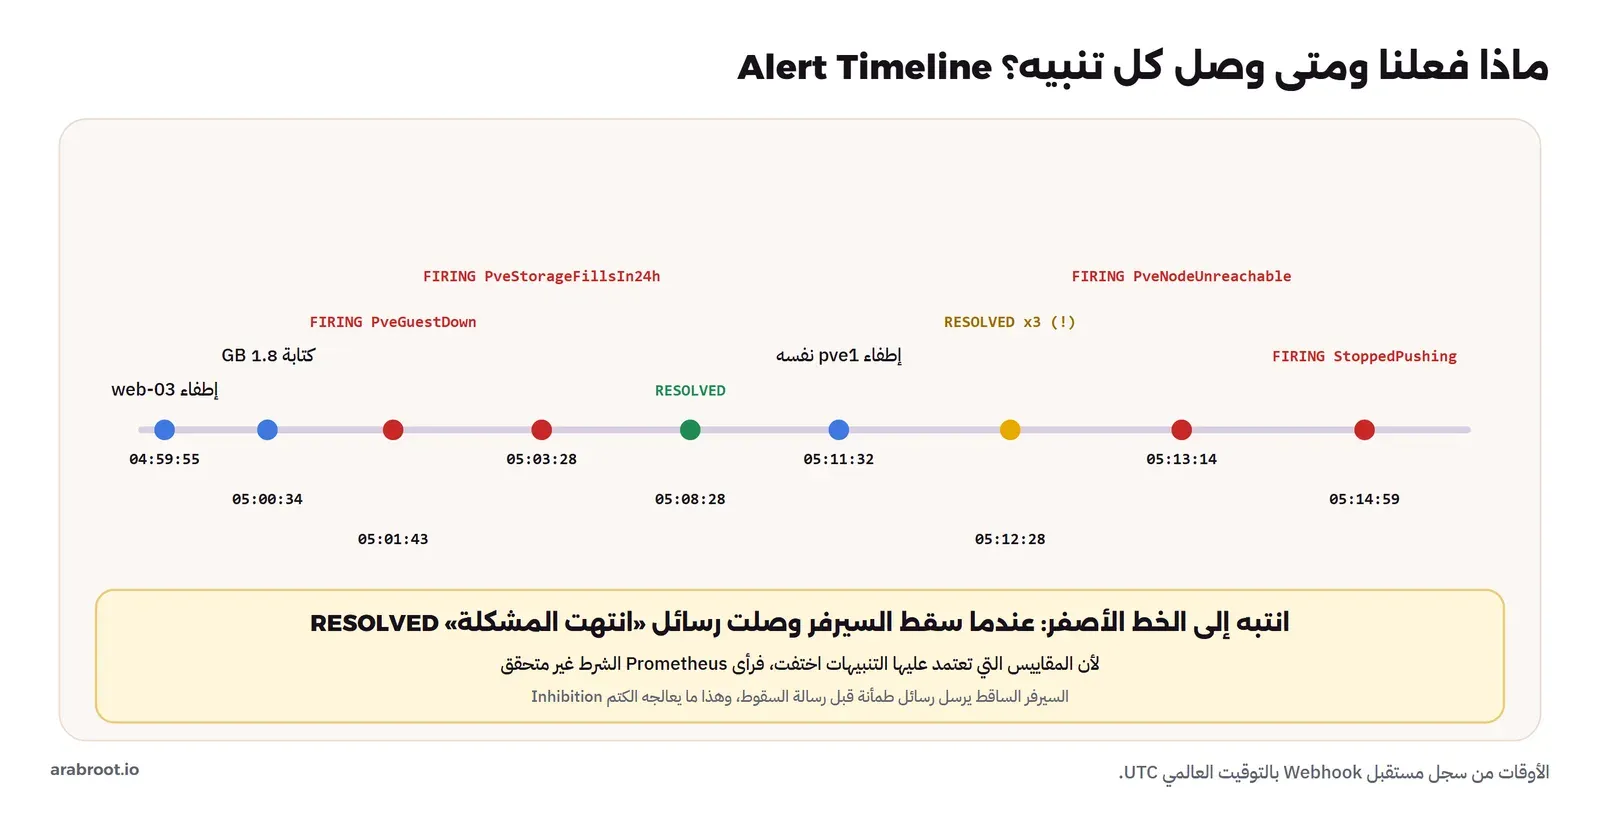
أطفأنا web-03 الذي ضبطه onboot على 1، الساعة 04:59:55 بالتوقيت العالمي، فوصل التنبيه الساعة 05:01:43، أي بعد دقيقة و48 ثانية: دورة سحب، ثم دقيقة كاملة هي مدة for، ثم انتظار Alertmanager لتجميع التنبيهات group_wait عشر ثوان. أما alice-test المتوقف منذ ساعات فلم ينبه عليه أحد، لأن onboot فيه صفر، وهذا بالضبط ما نريده.
تخزين يمتلئ بسرعة Storage Filling
لم نرد أن نملأ التجمع فعلاً، فأنشأنا قرصاً رقيقاً مؤقتاً وكتبنا فيه 600 ميجابايت كل دقيقة ثلاث مرات، وهذا يشبه جهازاً ينسخ إليه أحد ملفات كبيرة:
lvcreate -q -V 10G -T pve/data -n labfill
for i in 1 2 3; do
  dd if=/dev/zero of=/dev/pve/labfill bs=1M count=600 seek=$(( (i-1)*600 )) oflag=direct status=none
  date +%T; lvs --noheadings -o data_percent pve/data; sleep 60
done
### fill: start 08:00:34
data 5.40
08:00:40 7.74
08:01:44 10.08
08:02:48 12.43التجمع انتقل من 5.40% إلى 12.43% فقط، أي بعيداً جداً عن 80%، ومع ذلك وصل تنبيه الاتجاه الساعة 05:03:28 بالتوقيت العالمي، أي بعد ثلاث دقائق من بداية الكتابة: storage/pve1/local-lvm will be full within 24 hours at the current rate. وعندما حذفنا القرص المؤقت توقف الاتجاه، فوصلت رسالة الحل RESOLVED الساعة 05:08:28. وهذا هو الفرق بين القاعدتين: النسبة تخبرك بما حدث، والاتجاه يخبرك بما سيحدث إذا استمر الحال، والتخزين الرقيق يحتاج الثانية أكثر من الأولى.
ولكن انتبه إلى وجهها الآخر: الاتجاه يتأثر بأي كتابة كبيرة مؤقتة، مثل نسخ احتياطي يكتب ملفاً مؤقتاً ثم يحذفه، فإذا كانت نافذة الدالة قصيرة جداً فسوف تنبه على كل عملية من هذا النوع. لذلك جربنا بعشر دقائق لأن التجربة قصيرة، أما في الإنتاج فاجعل النافذة ساعة أو ست ساعات، ومدة for أطول، وانظر في سجل التنبيهات بعد أسبوع لترى هل أصاب أم أزعج.
ماذا لو سقط السيرفر نفسه؟ What If
أطفأنا pve1 كله الساعة 05:11:32 بالتوقيت العالمي، وكان المتوقع أن يصل تنبيه السقوط وحده، ولكن هذا ما وصل بالترتيب:
05:12:28 RESOLVED PveGuestNotBackedUp - qemu/108 is not covered by any backup job
05:12:28 RESOLVED PveGuestNotBackedUp - qemu/120 is not covered by any backup job
05:12:43 RESOLVED PveGuestDown - qemu/108 is set to start on boot but is not running
05:13:14 FIRING PveNodeUnreachable - Proxmox node 10.10.10.11 does not answer the exporter
05:14:59 FIRING PveNodeStoppedPushing - pve1 has not pushed any metrics for 2 minutes
أي أن أول ثلاث رسائل بعد سقوط السيرفر كانت رسائل طمأنة: «الجهاز 108 لم يعد متوقفاً»، و«الأجهزة أصبح لها نسخ احتياطية». والسبب أن هذه القواعد تعتمد على مقاييس اختفت كلها عندما سقط السيرفر، فالاستعلام لم يعد يرجع أي نتيجة، وPrometheus يعامل الاستعلام الذي لا يرجع شيئاً كشرط غير متحقق، فيعلن أن المشكلة انتهت. وتخيل المناوب الذي يرى في الثالثة فجراً رسالة «انتهت مشكلة الجهاز 108»، ثم يعود إلى النوم قبل أن تصل رسالة السقوط بثلاثين ثانية.
والإصلاح في Alertmanager نفسه، بالكتم Inhibition الذي شرحناه في مقال التنبيهات: إذا كان تنبيه سقوط السيرفر يعمل، فاكتم كل التنبيهات الأخرى عن السيرفر نفسه. وهذا يحتاج تسمية مشتركة بين التنبيهات، مثل node، تضيفها في القواعد، ثم قاعدة كتم كما في وثائق Alertmanager:
inhibit_rules:
  - source_matchers: [alertname =~ "PveNodeUnreachable|PveNodeStoppedPushing"]
    target_matchers: [severity =~ "warning|info"]
    equal: [node]
ولاحظ أن الكتم يمنع الرسائل الجديدة عن التنبيهات المكتومة، ولكن رسالة الحل التي تصل قبل أن يبدأ تنبيه السقوط لا يكتمها شيء، كما حدث هنا بالضبط، فرسائل الحل وصلت قبل تنبيه السقوط بنصف دقيقة. لذلك الحل الكامل يجمع ثلاثة أشياء: الكتم، ومدة for أقصر لتنبيه السقوط من غيره، وأن تقرأ رسائل الحل في المناوبة دائماً مع حالة السيرفر نفسه وليس وحدها.
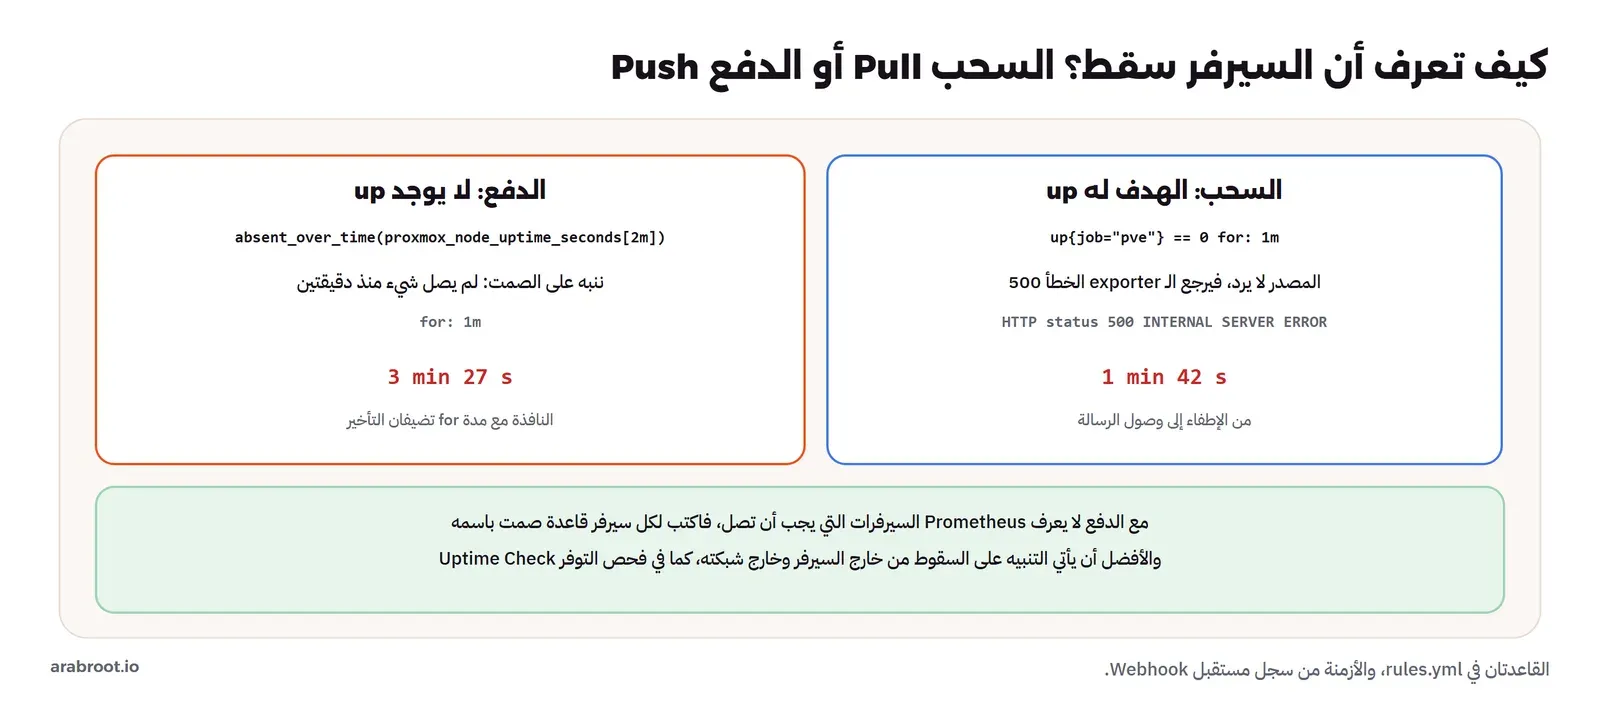
وأما التنبيهان على السقوط نفسه فقد وصلا بفارق واضح. السحب أعطى خطأ واضحاً، فالمصدر رجع 500 لأنه لم يصل إلى الواجهة البرمجية:
"lastError":"server returned HTTP status 500 INTERNAL SERVER ERROR"
requests.exceptions.ConnectionError: HTTPSConnectionPool(host='10.10.10.11', port=8006): Max retries exceeded with url: /api2/json/cluster/status
فوصل التنبيه بعد دقيقة و42 ثانية. أما الدفع فلا يعرف Prometheus فيه أن عليه أن ينتظر شيئاً، فاعتمدنا على الدالة absent_over_time التي تصبح صحيحة عندما لا تصل أي قيمة خلال النافذة، فوصل التنبيه بعد ثلاث دقائق و27 ثانية: نافذة دقيقتين ثم دقيقة for. والصورتان التاليتان تلخصان التجربة كلها:
والسؤال الذي يبقى بعد هذه التجربة: من ينبهك إذا سقط سيرفر المراقبة نفسه؟ والإجابة ليست سيرفر مراقبة ثانياً يراقب الأول ثم ثالثاً يراقب الثاني، وإنما فحص بسيط من خارج البنية كلها، يتأكد كل دقيقة أن Prometheus يرد، وأن تنبيه Watchdog الذي يعمل دائماً ما زال يصل، فإذا توقف وصوله فهذا هو التنبيه، كما شرحنا في مقال التنبيهات.
والصورة التالية من صفحة التنبيهات في Prometheus أثناء التجربة، قبل إطفاء السيرفر:
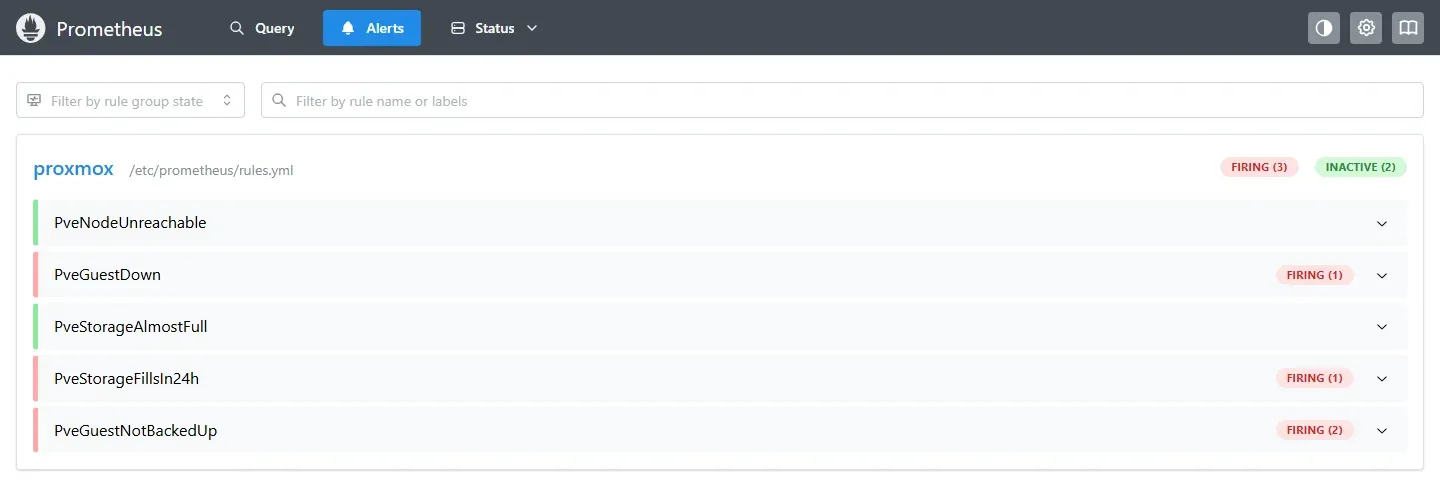
ماذا يتغير في العنقود؟ Cluster Monitoring
المختبر سيرفر واحد، ولكن أغلب ما فيه ينطبق على العنقود مع ثلاث إضافات. الأولى أن تنبيه السقوط يصبح على مستويين: سيرفر في العنقود سقط، وهذا يظهر في المصدر لأن السيرفرات الأخرى تعرف أنه لا يرد، فيصبح pve_up{id="node/..."} صفراً، والعنقود كله لا يرد، وهذا يظهر في up للهدف. والثانية أن التوفر العالي HA يضيف مقياساً لحالة كل جهاز يديره، pve_ha_state، وتنبيهاً مهماً على الجهاز الذي بقي في حالة خطأ بعد محاولة نقله. والثالثة أن تكرار البيانات بين العقد Replication، إذا استخدمته، له مقاييس في المصدر مثل عدد المحاولات الفاشلة ووقت آخر مزامنة ناجحة، وهذه تستحق تنبيهاً، لأن تكراراً متوقفاً منذ يومين يعني أن الجهاز لو انتقل الآن فسوف يعود بيانات عمرها يومان.
وتذكر ملاحظات إصدار Proxmox VE 9.1 تحسينات على نقطة في الواجهة البرمجية اسمها /cluster/metrics/export مخصصة لجمع المقاييس بطريقة السحب، وهذا يعني أن Proxmox يتجه إلى أن يوفر بنفسه ما يفعله المصدر اليوم، فتابع ملاحظات الإصدارات قبل أن تبني على المصدر بنية كبيرة.
من يستقبل كل تنبيه؟ Severity Routing
ستة تنبيهات لا تستحق كلها أن توقظ أحداً، والتقسيم الذي اعتمدناه في القواعد كان كما يلي، وهو تطبيق مباشر لما في مقال التنبيهات:
| التنبيه | الأهمية severity | أين يذهب | لماذا |
|---|---|---|---|
| PveNodeUnreachable، PveNodeStoppedPushing | critical | المناوب فوراً | كل الأجهزة على السيرفر متأثرة |
| PveGuestDown | warning | قناة الفريق | جهاز واحد، وقد يكون إطفاؤه مقصوداً |
| PveStorageFillsIn24h | warning | قناة الفريق، ويرتفع إذا قصر الوقت | أمامك ساعات لتتصرف |
| PveStorageAlmostFull | warning | قناة الفريق | النسبة وحدها لا تعني خطراً قريباً |
| PveGuestNotBackedUp | info | الملخص اليومي | يحتاج قراراً وليس استجابة |
ولاحظ أن تنبيه الاتجاه يستحق مستوى ثانياً: الامتلاء خلال 24 ساعة warning، والامتلاء خلال ساعتين critical، لأن الأولى تعطيك الصباح لتتصرف، والثانية لا تعطيك إلا الآن. وتستطيع أن تكتب القاعدتين بالدالة نفسها مع مدة مختلفة، وأن تكتم الأولى بالثانية حتى لا تصل رسالتان عن الشيء نفسه.
السحب أم الدفع؟ Decision Table
| السؤال | السحب: pve-exporter | الدفع: Metric Server |
|---|---|---|
| برنامج إضافي؟ | نعم، مصدر وتوكن | لا، إعداد في Proxmox فقط |
| كشف سقوط السيرفر | تلقائي عبر up | قاعدة صمت لكل سيرفر |
| الأجهزة دون نسخ احتياطي | نعم، pve_not_backed_up_info | لم نجده في المقاييس المرسلة |
| onboot وحالة الاشتراك والإصدار | نعم | الإصدار في target_info |
| التسميات | id واحد، والاسم بالربط مع info | node وvmid وname في كل سلسلة |
| من يفتح الاتصال | المراقبة إلى Proxmox على 8006 | Proxmox إلى المراقبة |
والسطر الأخير مهم في الشبكات المقسمة: إذا كانت شبكة الإدارة لا تقبل اتصالات من شبكة المراقبة، فالدفع يحترم هذا الاتجاه، وإذا كانت المراقبة في شبكة لا يصلها Proxmox فالسحب هو الممكن. والاختيار الذي نقترحه لسيرفر مثل سيرفر قصتنا هو السحب، لأنه يعطيك كشف السقوط ومقياس النسخ الاحتياطي دون عمل إضافي، ثم أضف الدفع إذا أردت مقاييس ضغط الموارد بدقة أعلى، أو إذا كانت لديك منصة OpenTelemetry أصلاً. وفي الحالتين لا تجعل Prometheus على سيرفر Proxmox نفسه أو على جهاز داخله، والسبب أنه سوف يسقط مع السيرفر الذي يراقبه، وأضف فحص توفر من الخارج كما في فحص التوفر Uptime Checks، حتى يعرف أحد أن المراقبة نفسها سقطت.
المراقبة نفسها هدف: Monitoring Security
كل ما بنيناه في هذا المقال يفتح أبواباً جديدة، ومن المهم أن تعرفها قبل أن تنقله إلى الإنتاج. الباب الأول هو المصدر نفسه: يسمع على المنفذ 9221 دون أي كلمة مرور، وأي شخص يصل إليه يستطيع أن يطلب منه مقاييس أي سيرفر Proxmox يعرف توكنه، ويرى أسماء كل الأجهزة وأحجامها وحالتها والإصدار وحالة الاشتراك، وهذه خريطة جاهزة لمن يخطط لهجوم. لذلك اجعله يسمع على العنوان المحلي أو على شبكة المراقبة فقط، ولا تنشره على منفذ عام.
والباب الثاني هو نقطة استقبال OTLP في Prometheus: عندما فعلنا الخيار --web.enable-otlp-receiver أصبح Prometheus يقبل الكتابة من أي جهاز يصل إلى المنفذ 9090، وهذا يعني أن جهازاً مخترقاً في الشبكة يستطيع أن يرسل أرقاماً كاذبة باسم سيرفرك، مثل تخزين فارغ دائماً، فلا يصل تنبيه الامتلاء أبداً. لذلك اجعل المنفذ مفتوحاً لعناوين سيرفرات Proxmox فقط بالجدار الناري، أو ضع أمامه Reverse Proxy يطلب مصادقة، كما شرحنا في قسم الأمان في مقال Prometheus.
والباب الثالث هو التوكن: صلاحية PVEAuditor للقراءة فقط، ولكنها على المسار /، أي أنها تقرأ إعدادات كل شيء، ومنها إعدادات الشبكة والمخازن وقائمة المستخدمين. وهذا مقبول لأداة مراقبة، ولكنه يعني أن ملف pve.yml سر، فلا تضعه في المستودع كما هو، وإنما ضع فيه مكاناً فارغاً واحقن القيمة عند النشر، كما فعلنا في ملف المختبر المنشور مع هذا المقال، وضع للتوكن تاريخ انتهاء وجدده دورياً.
أخطاء شائعة Common Mistakes
- الاكتفاء برسوم Summary: لا تنبه أحداً، وتفقد دقتها بعد يوم.
- pve_up == 0 دون شرط: ينبه على كل قالب وكل جهاز متوقف عمداً، فيتعلم الفريق تجاهل التنبيه كله.
- sum على كل السلاسل: الأجهزة في المجمعات تحسب مرتين. فلتر النوع دائماً.
- الاعتماد على Proxmox لامتلاء الأقراص داخل الأجهزة: القيمة صفر دائماً للأجهزة الافتراضية. ضع node_exporter داخل كل جهاز.
- نسبة 80% وحدها للتخزين الرقيق: التجمع يمتلئ بسرعة من نسبة منخفضة. أضف قاعدة الاتجاه.
- الدفع دون قاعدة صمت: السيرفر الساقط لا يرسل شيئاً، ولا ينبه أحد.
- رسائل الحل دون كتم: السيرفر الساقط يرسل «انتهت المشكلة» قبل «سقط».
- توكن المصدر بصلاحيات كاملة أو كلمة مرور root: PVEAuditor بفصل الصلاحيات يكفي.
- Prometheus على السيرفر نفسه: يسقط مع ما يراقبه.
قائمة تحقق Checklist
- مصدر pve-exporter بتوكن PVEAuditor بفصل الصلاحيات، وشهادة موثوقة دون verify_ssl: false.
- أو خادم مقاييس OpenTelemetry مع قاعدة صمت لكل سيرفر.
- تنبيه سقوط السيرفر، وتنبيه أجهزة onboot المتوقفة، دون القوالب.
- تنبيه للتخزين بالنسبة وآخر بالاتجاه، خاصة لتجمعات LVM-thin.
- تنبيه يومي للأجهزة التي لا تغطيها أي مهمة نسخ احتياطي.
- قاعدة كتم تربط تنبيهات السيرفر الساقط بتنبيهات أجهزته.
- لوحة Grafana في المستودع، وفحص بعد النشر أنها حملت فعلاً.
- node_exporter داخل الأجهزة المهمة، وفحص توفر من خارج الشبكة.
- Prometheus وAlertmanager خارج سيرفر Proxmox الذي يراقبانه.
تدريب عملي Practice
- شغل المصدر على سيرفرك بتوكن PVEAuditor، واكتب استعلاماً يعرض أكبر ثلاثة أجهزة استخداماً للذاكرة بأسمائها، دون أن تحسب المجمعات مرتين.
- أضف قاعدتي الاتجاه للتخزين بمستويين، ثم انسخ ملفاً كبيراً إلى جهاز تجربة، وراقب أيهما وصل ومتى.
- أطفئ سيرفر Proxmox في نافذة صيانة مخططة، واقرأ كل رسالة وصلت بالترتيب، ثم أضف قاعدة الكتم وكرر التجربة.
الخلاصة Summary
- الرسوم المدمجة في Proxmox VE 9 تحفظ نقطة كل دقيقة ليوم ثم متوسطات، ومعها ضغط الموارد PSI، ولكنها لا تنبه.
- السحب عبر prometheus-pve-exporter يعطيك up للسيرفر، وحالة onboot، ومقياس الأجهزة دون نسخ احتياطي.
- الدفع عبر Metric Server بـ OpenTelemetry يصل إلى Prometheus مباشرة دون برنامج إضافي، ولكنه يصمت عندما يسقط السيرفر.
- القالب يبدو جهازاً متوقفاً، والمجمع يكرر الأرقام، وقرص الجهاز صفر من Proxmox.
- تنبيه الاتجاه كشف تجمعاً يمتلئ وهو عند 12% فقط، بعد ثلاث دقائق من بداية الكتابة.
- عندما سقط السيرفر وصلت ثلاث رسائل «انتهت المشكلة» قبل رسالة السقوط، والكتم مع مدد for مدروسة يعالج ذلك.
والتنبيه على الأجهزة التي ليس لها نسخة احتياطية هو بداية المقال التالي في هذا المسار: Proxmox Backup Server، حيث تختفي هذه التنبيهات واحداً واحداً. وإلى أن يصدر، فالأساس في النسخ الاحتياطي بقاعدة 3-2-1.
 دليلدليل المراقبة Monitoring: ماذا تراقب في سيرفراتك وتطبيقاتك؟خريطة واحدة لكل ما يجب أن يراقبه الفريق على سيرفراته وتطبيقاته، من القرص والشهادات والنسخ الاحتياطي إلى الأحداث الأمنية والثغرات، مع الأداة والتنبيه لكل منطقة.
 دليلمقاييس السيرفرات Metrics: Prometheus مع لوحات Grafanaنجمع مقاييس المعالج والذاكرة والقرص والـ Containers مع Prometheus، ونتنبأ بموعد امتلاء القرص قبل أن يحدث، ونبني لوحة Grafana محفوظة ككود في Git.
 دليلالتنبيهات Alerting: ماذا تنبه عليه ومتى توقظ أحداً؟نبني مع Alertmanager تنبيهات تصل فيها المشكلة الواحدة في رسالة واحدة، والعاجل فوراً والروتيني في ملخص صباحي، ونجرب كل قرار بالثواني.
 دليلفحص التوفر Uptime Checks: من يراقب سيرفر المراقبة؟نفحص الموقع والشهادة وRedis من الخارج مع Blackbox Exporter وUptime Kuma، ونكشف النسخ الاحتياطي الذي توقف بصمت، ونتأكد أن أحداً يراقب سيرفر المراقبة نفسه.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة المقال، وتنفيذ التجربة على Proxmox VE 9.2 (pve-manager 9.2.2) داخل QEMU 10.0.13 مع KVM، مع prometheus-pve-exporter 3.11.0 (prompve/prometheus-pve-exporter:3.11.0) وPrometheus 3.13.4 (prom/prometheus:v3.13.4) وAlertmanager 0.34.2 (prom/alertmanager:v0.34.2) وGrafana 13.3.0 (grafana/grafana:13.3.0)، والوثائق الرسمية كما كانت في 4 نوفمبر 2026.


