إذا فتحت صفحة الأسعار عند مزود سحابي اليوم فسوف تجد بجانب السيرفرات المعتادة بمعالجات Intel وAMD سيرفرات أخرى مكتوب بجانبها Arm64 أو Graviton أو Ampere، وغالباً تكون أرخص قليلاً لنفس عدد الأنوية ونفس الذاكرة، وقد تسأل نفسك: هل تعمل خدماتي عليها كما هي؟ ولماذا تبني شركة مثل Amazon معالجاً خاصاً بها أصلاً؟ ونفس المعمارية موجودة في الجوال الذي في جيبك، وفي جهاز Mac الذي اشتراه زميلك ثم اشتكى أن Docker Image بناها على جهازه لا تعمل على سيرفر الشركة، وفي لوحة Raspberry Pi التي تشغل عليها خدماتك المنزلية. فكيف وصلت معمارية صممت لحاسب مدرسي بريطاني في الثمانينات إلى الجوال ثم إلى أكبر مراكز البيانات في العالم؟
وقد شرحنا في مقال كيف يعمل المعالج من الداخل أن x86-64 وARM64 لغتان مختلفتان للآلة، ورأينا نفس الدالة مترجمة لكل منهما، وفي مقال Hello World من الداخل رأينا رسالة exec format error عندما يصل الملف إلى معالج لا يفهمه. أما معنى معمارية مجموعة التعليمات ISA بالتفصيل، والفرق بين CISC وRISC، فلهما مقالان في نفس مرحلة المعالجات:
 دليلمعمارية المعالج ISA: لماذا لا يعمل برنامج x86 على ARM؟نترجم نفس برنامج C لثلاث معماريات ونقرأ تعليماته سطراً سطراً، لنفهم ما الذي يجعل الملف التنفيذي يعمل على معالج ويرفضه معالج آخر.
 دليلCISC أم RISC: ما الفرق الحقيقي بين x86 وARM وRISC-V؟نقيس حجم الكود وعدد التعليمات المنفذة لنفس البرامج على x86-64 وARM64 وRISC-V، ونرى ما بقي من نقاش CISC وRISC وما لم يعد صحيحاً.
وهذا المقال لا يكرر ما فيهما، وإنما يتحدث عن ARM نفسها كشركة ونموذج عمل وعائلات من الأنوية، وأين تجدها اليوم، وماذا يعني ذلك لك كمطور أو مدير سيرفرات. وسوف نناقش في هذا المقال ما يلي:
- لماذا لا تصنع Arm أي معالج، وكيف تربح من كل جوال يباع في العالم تقريباً.
- الفرق بين ترخيص المعمارية Architecture License وترخيص النواة Core License، وما الذي حدث عندما اختلفت Arm مع Qualcomm على هذا الفرق.
- عائلات الأنوية Cortex وNeoverse، وأين تعمل كل واحدة منها.
- Apple Silicon والذاكرة الموحدة Unified Memory، بصورة حقيقية للوحة Mac mini.
- ARM في السيرفرات: AWS Graviton بأجياله الخمسة وما قالته AWS عن كل جيل بتاريخه، ثم Ampere وGoogle Axion وMicrosoft Cobalt.
- Windows على ARM وكيف يشغل برامج x86 القديمة.
- مختبر حقيقي: نقرأ Image تدعم ثماني معماريات، ونبني Image خاصة بنا لـ arm64 بطريقتين، ثم نقيس كم يكلف تشغيل نفس العمل تحت المحاكاة.
- قائمة تحقق قبل نقل خدمة إلى سيرفر ARM، وجدول قرار.
ما هي ARM؟ شركة لا تصنع المعالجات
أول ما يجب أن تعرفه أن كلمة ARM تطلق على شيئين: الشركة البريطانية Arm Holdings، ومعمارية مجموعة التعليمات التي تملكها هذه الشركة. والشركة لا تملك مصنعاً واحداً للرقاقات ولا تبيع معالجاً واحداً باسمها في المتجر، وإنما تبيع شيئاً أقرب إلى المخطط الهندسي: المعمارية نفسها، أو تصميم نواة جاهزة، ثم تأخذ نسبة صغيرة على كل شريحة تباع وفيها هذا التصميم. والتشبيه الأقرب هو مكتب هندسي يبيع مخططات بيت جاهز لشركات المقاولات، فكل مقاول يبني البيت بمواده وعماله، ويضيف إليه ما يريد، ثم يدفع للمكتب مبلغاً عن كل بيت يبيعه.
وبدأت القصة في 1985 عندما صنعت شركة Acorn البريطانية أول شريحة باسم ARM1 لحاسبها المدرسي، والحرفان الأولان وقتها اختصار لـ Acorn RISC Machine، ثم في 1990 خرجت شركة مستقلة اسمها Advanced RISC Machines Ltd من شراكة بين Acorn وApple وVLSI Technology، كما في صفحة تاريخ Arm الرسمية. وأول منتج كبير بنته Apple على المعمارية كان جهاز Newton المحمول في 1993، ولم ينجح تجارياً، وتروي نفس الصفحة أن هذا الفشل بالذات هو الذي دفع Arm إلى نموذج ترخيص التصميمات بدلاً من صناعة الشرائح. ومن هذه البداية أخذت المعمارية شخصيتها: أداء معقول بأقل طاقة ممكنة، لأنها صممت لأجهزة تعمل بالبطارية، وتصميم بسيط يسهل على الشركات الأخرى أن تبني حوله.
وقد يتساءل البعض: إذا كانت الشركة لا تصنع شيئاً، فكيف أصبحت معماريتها في كل مكان؟ والإجابة في نموذج العمل نفسه: الشركة التي تصنع جوالاً تحتاج شريحة فيها معالج ومودم وبطاقة رسومات ومتحكم ذاكرة ومعالج صوت، وكلها على قطعة سيليكون واحدة، وهذا ما نسميه نظاماً على شريحة System on a Chip، واختصاراً SoC. وتصميم معالج حديث من الصفر يكلف سنوات ومئات المهندسين، أما إذا أخذت نواة جاهزة من Arm فسوف تركز على ما يميز منتجك، وبالتالي أصبحت Arm هي الخيار الافتراضي لكل من يصنع SoC للأجهزة المحمولة، ثم انتقلت مع هذه الشركات إلى السيارات والتلفزيونات والراوترات، ثم إلى الحاسب المحمول والسيرفر.
والصورة التالية تبين أهم المحطات من أول شريحة إلى اليوم، والتواريخ كلها من إعلانات الشركات التي سوف نذكرها في المقال:
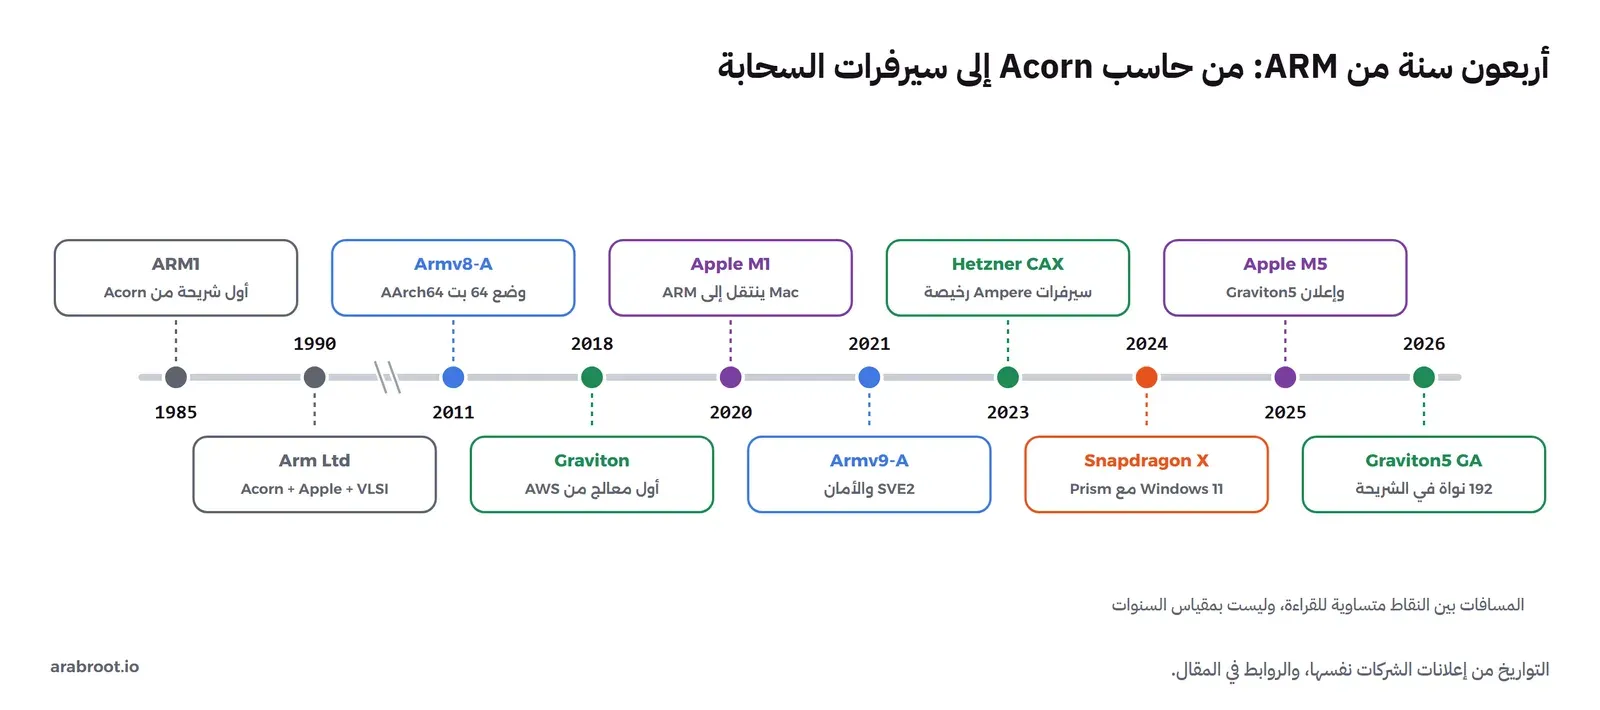
لاحظ في الخط الزمني أن المسافة بين 1990 و2011 طويلة جداً، وفي هذه السنوات كانت ARM في كل جوال تقريباً ولكنها كانت معمارية 32 بت، ولم يكن أحد يفكر فيها للسيرفر. والمحطة التي غيرت ذلك هي Armv8-A في 2011، لأنها أضافت وضع 64 بت اسمه AArch64 بمجموعة تعليمات جديدة و31 مسجلاً عاماً، وهو الذي يسميه Linux aarch64 ويسميه Docker arm64، وبدونه لا يمكن لسيرفر أن يخاطب أكثر من 4 GB من الذاكرة لكل برنامج. وكل ما بعد 2011 في الخط الزمني هو ثمرة هذا القرار.
كيف تبيع Arm تصميماتها؟ ترخيص المعمارية وترخيص النواة
الشركة التي تريد أن تصنع شريحة ARM أمامها طرق مختلفة، والفرق بينها هو مقدار ما تأخذه جاهزاً من Arm ومقدار ما تصممه بنفسها، والصورة التالية تبينها:
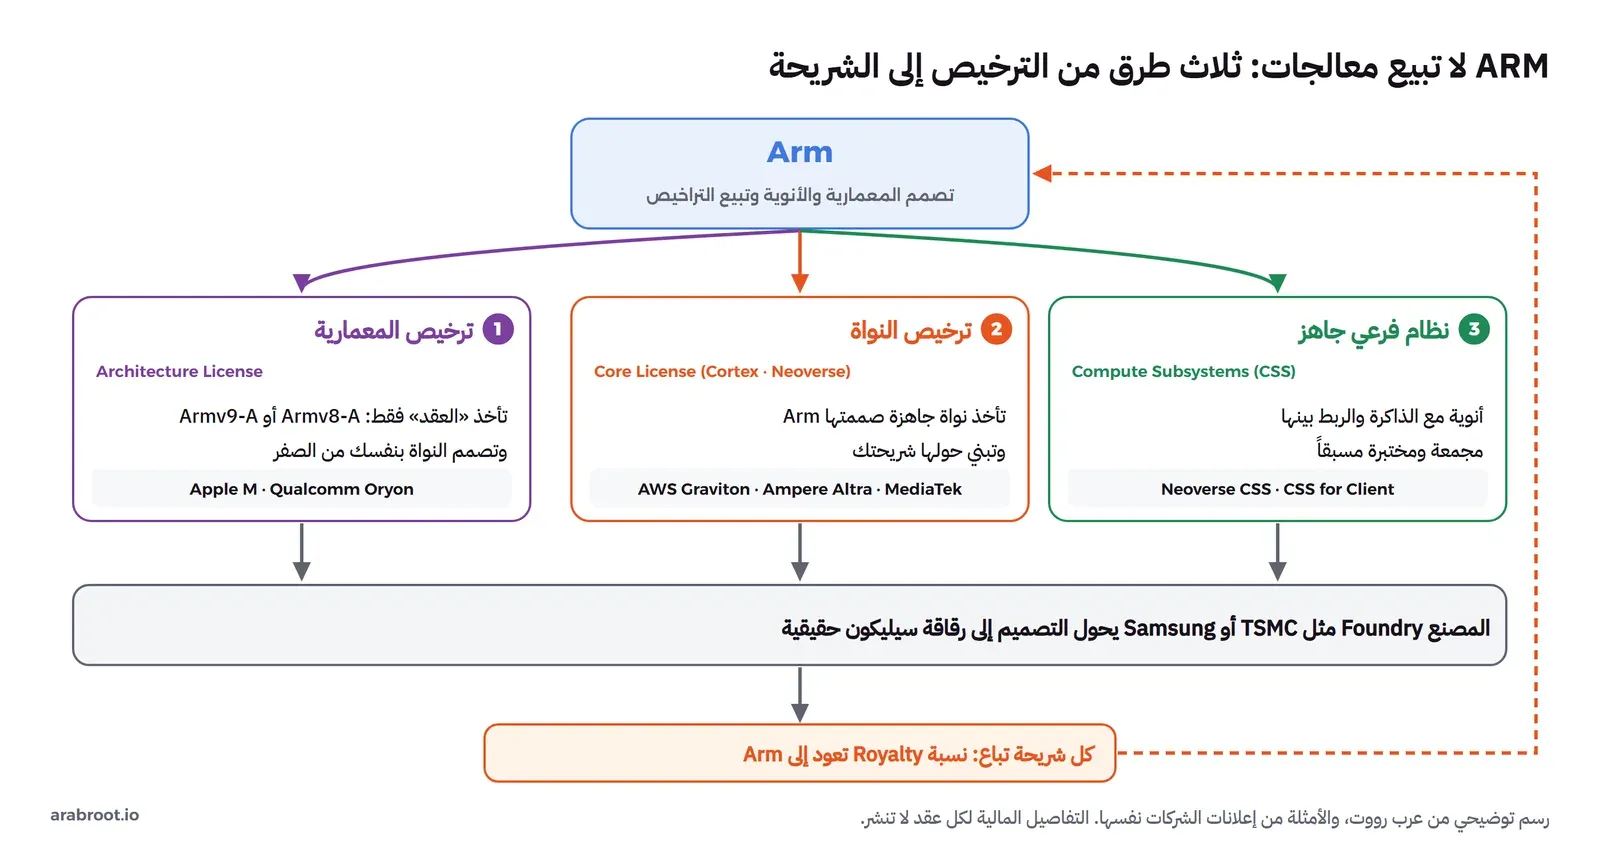
في الصورة أعلاه لاحظ التالي:
- ترخيص المعمارية Architecture License: تأخذ الشركة «العقد» فقط، أي مواصفات Armv8-A أو Armv9-A: ما هي التعليمات وكيف تعمل المسجلات والذاكرة والصلاحيات، ثم تصمم النواة بنفسها من الصفر بشرط أن تنفذ هذا العقد كما هو. وهذا ما تفعله Apple في معالجات M وA، وما فعلته Qualcomm في أنوية Oryon. والميزة هنا أنك تتحكم في كل تفصيلة داخل النواة، والثمن أنك تحتاج فريقاً كبيراً وسنوات من العمل، ولذلك عدد الشركات التي تعمل بهذه الطريقة قليل.
- ترخيص النواة Core License: تأخذ الشركة تصميم نواة كاملة صممته Arm، مثل Cortex-A76 أو Neoverse V2، وتبني حولها بقية الشريحة: عدد الأنوية، وحجم ال Cache، ومتحكمات الذاكرة، والواجهات. وهذه طريقة أغلب الشركات، ومنها AWS في معالجات Graviton، وAmpere في Altra، وMediaTek وغيرها في الجوالات.
- الأنظمة الفرعية الجاهزة Compute Subsystems: واختصاراً CSS، وهي خطوة أبعد من النواة: مجموعة أنوية مع الربط بينها وواجهات الذاكرة مجمعة ومختبرة مسبقاً، بحيث يختصر صاحب الشريحة شهوراً من عمل الدمج والاختبار.
- المصنع Foundry: في كل الطرق لا تصنع Arm الرقاقة، وإنما ترسل الشركة تصميمها النهائي إلى مصنع مثل TSMC أو Samsung، وهذا موضوع مقال صناعة الرقاقة في آخر هذه المرحلة.
- الإتاوة Royalty: مع الرسوم التي تدفع مقدماً للترخيص، تأخذ Arm نسبة عن كل شريحة تباع وفيها تصميمها.
وطريقة الدفع نفسها تغيرت مع الوقت، فبجانب العقد التقليدي، أي رسوم مقدمة ثم إتاوة عن كل شريحة، تقدم Arm اشتراكاً سنوياً اسمه Arm Total Access يعطي الشركة أغلب أنوية Cortex وNeoverse، وبرنامجاً اسمه Arm Flexible Access تجرب فيه الشركات الصغيرة الأنوية مجاناً أو برسوم قليلة ولا تدفع رسوم الترخيص إلا عند التصنيع، كما في شرح Arm لنماذج الترخيص المنشور في نوفمبر 2023، ومن الأمثلة التي تذكرها Arm أن Raspberry Pi صممت متحكمها RP2 عبر هذا البرنامج. والأرقام المالية لكل عقد لا تنشر، فلا تثق في أي مقال يعطيك نسبة الإتاوة بالضبط.
عندما يصبح الفرق بين الترخيصين قضية في المحكمة
قد يبدو الفرق بين ترخيص المعمارية وترخيص النواة تفصيلاً قانونياً لا يهم المطور، ولكن أكبر نزاع في تاريخ Arm كان بالضبط على هذا الفرق.
والنواة التي كانت محل النزاع هي نفسها التي تعمل اليوم في شرائح Snapdragon X التي سوف نتحدث عنها في قسم Windows، فالقضية لم تكن نظرية: كان يمكن أن تمنع جيلاً كاملاً من الحواسب المحمولة من الوصول إلى السوق.
عائلات الأنوية: Cortex-A وR وM ثم Neoverse
عندما تقرأ مواصفات شريحة وتجد فيها اسماً مثل Cortex-A76 فهذه نواة من تصميم Arm أخذتها الشركة بترخيص النواة، والحرف بعد Cortex يخبرك أين تعمل هذه النواة، كما في صفحة أنوية Arm:
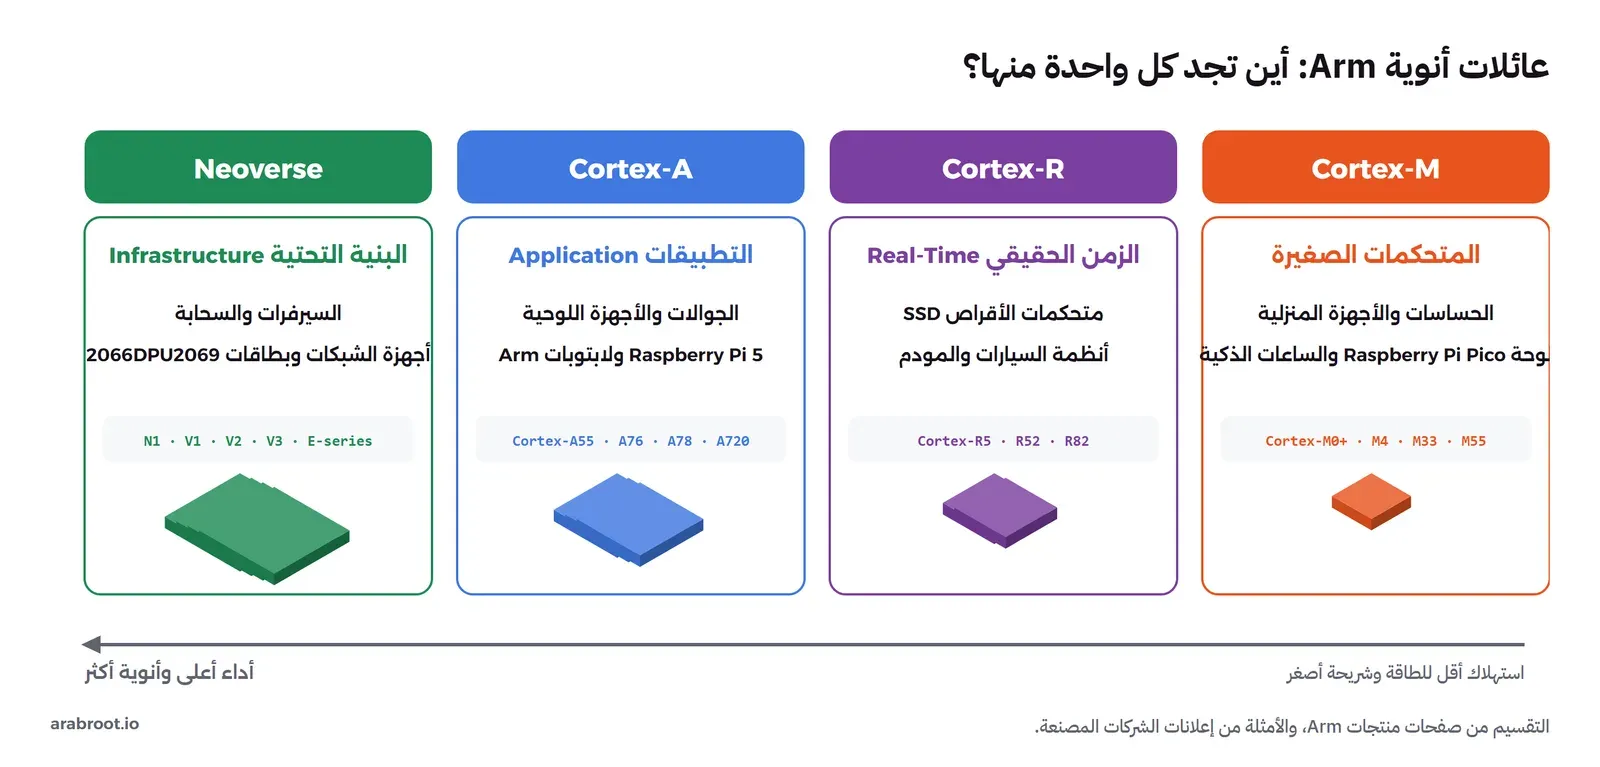
- Cortex-M للمتحكمات الدقيقة Microcontrollers: أنوية صغيرة جداً بلا نظام تشغيل كامل غالباً، في الحساسات والساعات وأجهزة المنزل الذكي، وقد رأيناها في مسار الإلكترونيات في مقال Raspberry Pi مقابل المتحكم الدقيق.
- Cortex-R للزمن الحقيقي Real-Time: أنوية تضمن أن الاستجابة تحدث في وقت محدد دائماً، وتجدها داخل متحكم قرص SSD في جهازك وفي أنظمة السيارات والمودم، ولن تتعامل معها مباشرة غالباً.
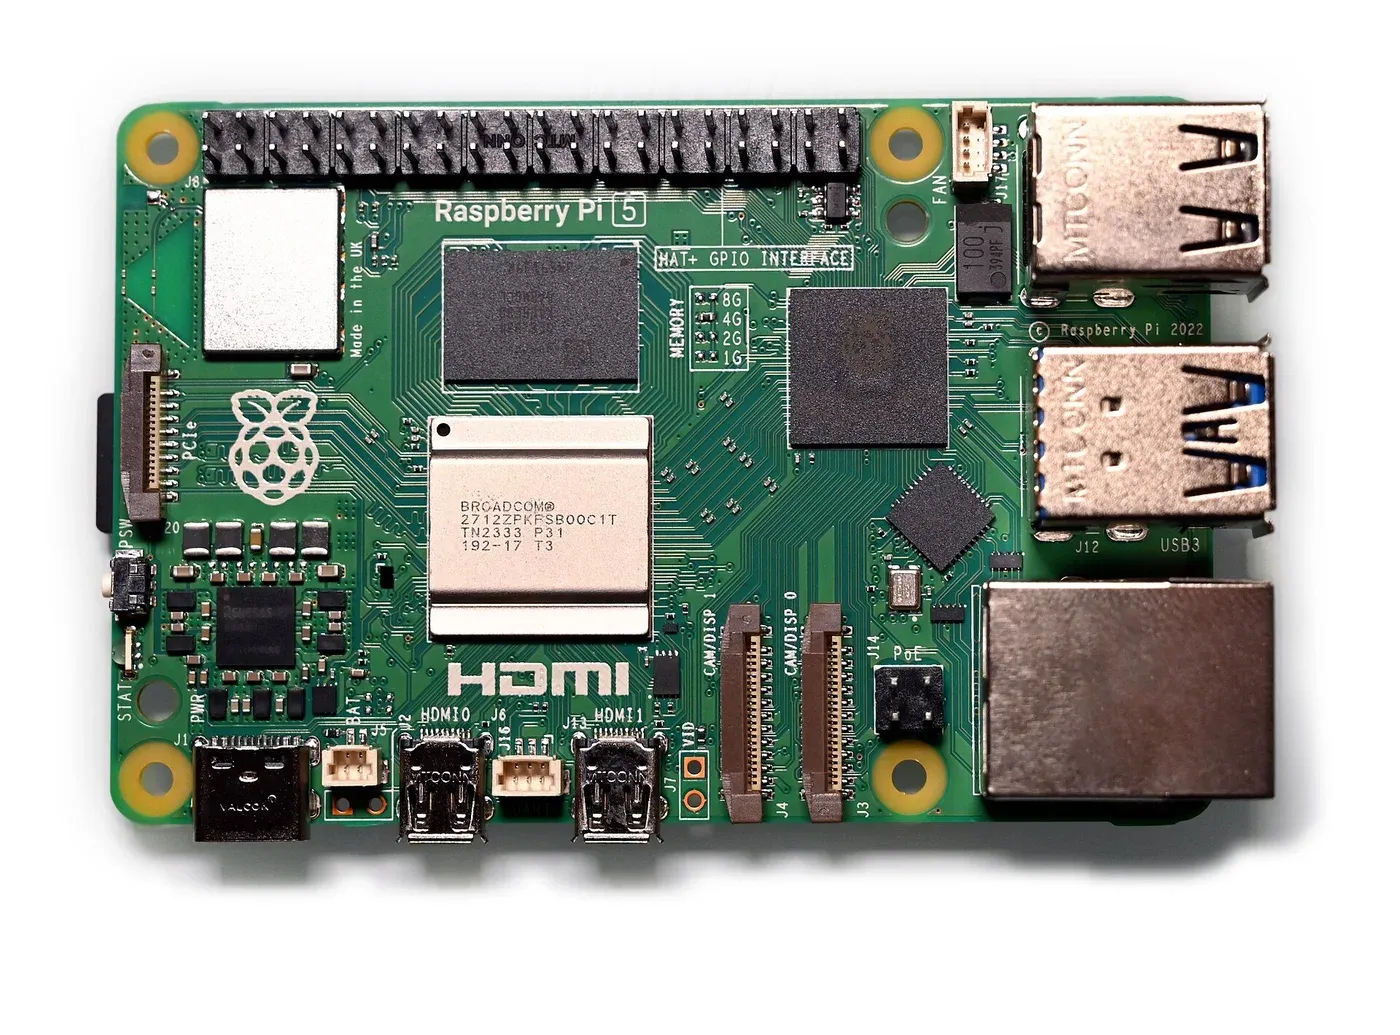
- Cortex-A للتطبيقات Application: الأنوية التي تشغل نظام تشغيل كاملاً مثل Android وLinux، وهي في الجوالات وفي Raspberry Pi 5 التي تحمل أربع أنوية Cortex-A76 كما في النشرة الرسمية للوحة.
- Neoverse للبنية التحتية Infrastructure: العائلة التي صممتها Arm للسيرفرات وأجهزة الشبكات، وفيها ثلاثة خطوط: V للأداء الأعلى لكل نواة، وN للتوازن بين الأداء والاستهلاك وعدد الأنوية، وE للأجهزة الصغيرة في أطراف الشبكة، كما في صفحة Neoverse.
والصورة التالية للوحة Raspberry Pi 5، وهي أقرب جهاز ARM يمكن أن تشتريه وتضعه على مكتبك اليوم، والشريحة المعدنية في وسطها هي BCM2712 من Broadcom بأنويتها الأربع:
وفي الجوالات الحديثة لن تجد نوعاً واحداً من الأنوية، وإنما خليطاً: أنوية كبيرة سريعة لما تحتاجه الآن، وأنوية صغيرة موفرة لما يعمل في الخلفية، ونظام التشغيل ينقل البرنامج بينها. وهذه الفكرة بدأت عند Arm باسم big.LITTLE، ثم انتقلت إلى Apple في أنوية الأداء P وأنوية الكفاءة E، ثم إلى Intel نفسها في معالجاتها الهجينة، وهذا موضوع مقال عائلات Intel وAMD في نفس المرحلة.
Apple Silicon: عندما انتقل Mac إلى ARM
في نوفمبر 2020 أعلنت Apple معالج M1 وأول أجهزة Mac به، كما في إعلان Apple، وكانت هذه ثالث مرة تغير فيها Apple معالج Mac: من Motorola 68k إلى PowerPC في التسعينات، ثم إلى Intel في 2006، ثم إلى تصميمها الخاص على ARM. وApple صاحبة ترخيص معمارية، فهي لا تأخذ أنوية Cortex، وإنما تصمم أنويتها بنفسها منذ معالجات iPhone، وM1 في الحقيقة امتداد لنفس الخط الذي بدأ في الجوال، والصورة التالية تبين ذلك حرفياً:
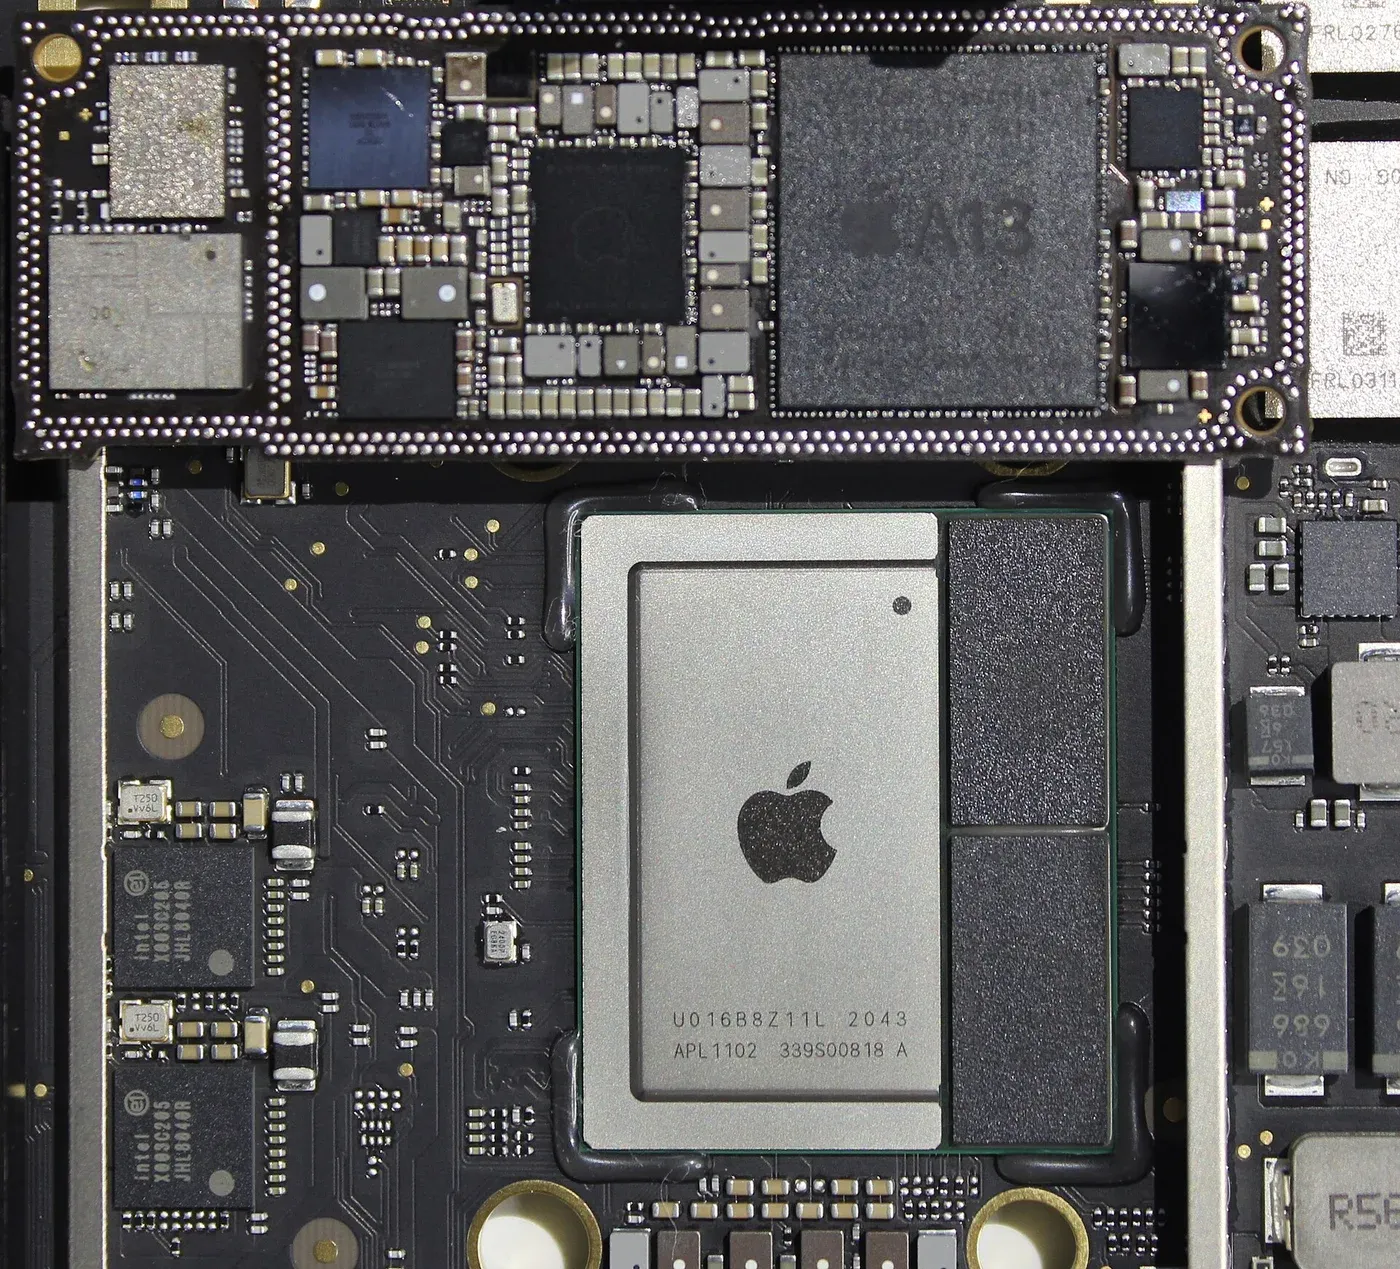
في الصورة أعلاه لاحظ التالي:
- الغلاف الفضي المكتوب عليه APL1102: هذا هو M1، ويضم الأنوية وبطاقة الرسومات ووحدة الذكاء الاصطناعي Neural Engine ومتحكمات الذاكرة في رقاقة واحدة.
- المستطيلان الأسودان على يمينه: شريحتا الذاكرة LPDDR داخل نفس الغلاف، وليستا شرائح منفصلة على اللوحة كما في الحاسب العادي، ولذلك لا يمكنك زيادة ذاكرة أي Mac بمعالج M بعد الشراء.
- شريحة A13 في الأعلى: معالج iPhone 11 من نفس العائلة، وحجمها قريب، والفرق الأساسي في عدد الأنوية وفي أن ذاكرة الجوال مركبة فوق المعالج نفسه.
الذاكرة الموحدة Unified Memory: ما الذي تغير فعلاً؟
في الحاسب التقليدي مع بطاقة رسومات منفصلة يوجد مكانان للذاكرة: ذاكرة المعالج على اللوحة الأم، وذاكرة البطاقة VRAM على البطاقة نفسها، وأي بيانات يريد المعالج أن تعمل عليها البطاقة يجب أن تنسخ أولاً عبر ناقل PCIe. أما في Apple Silicon فكل الأنوية، أنوية المعالج وأنوية الرسومات وNeural Engine، تقرأ وتكتب في نفس الذاكرة، وهذا ما تسميه Apple الذاكرة الموحدة Unified Memory، والصورة التالية تقارن بين الحالتين:
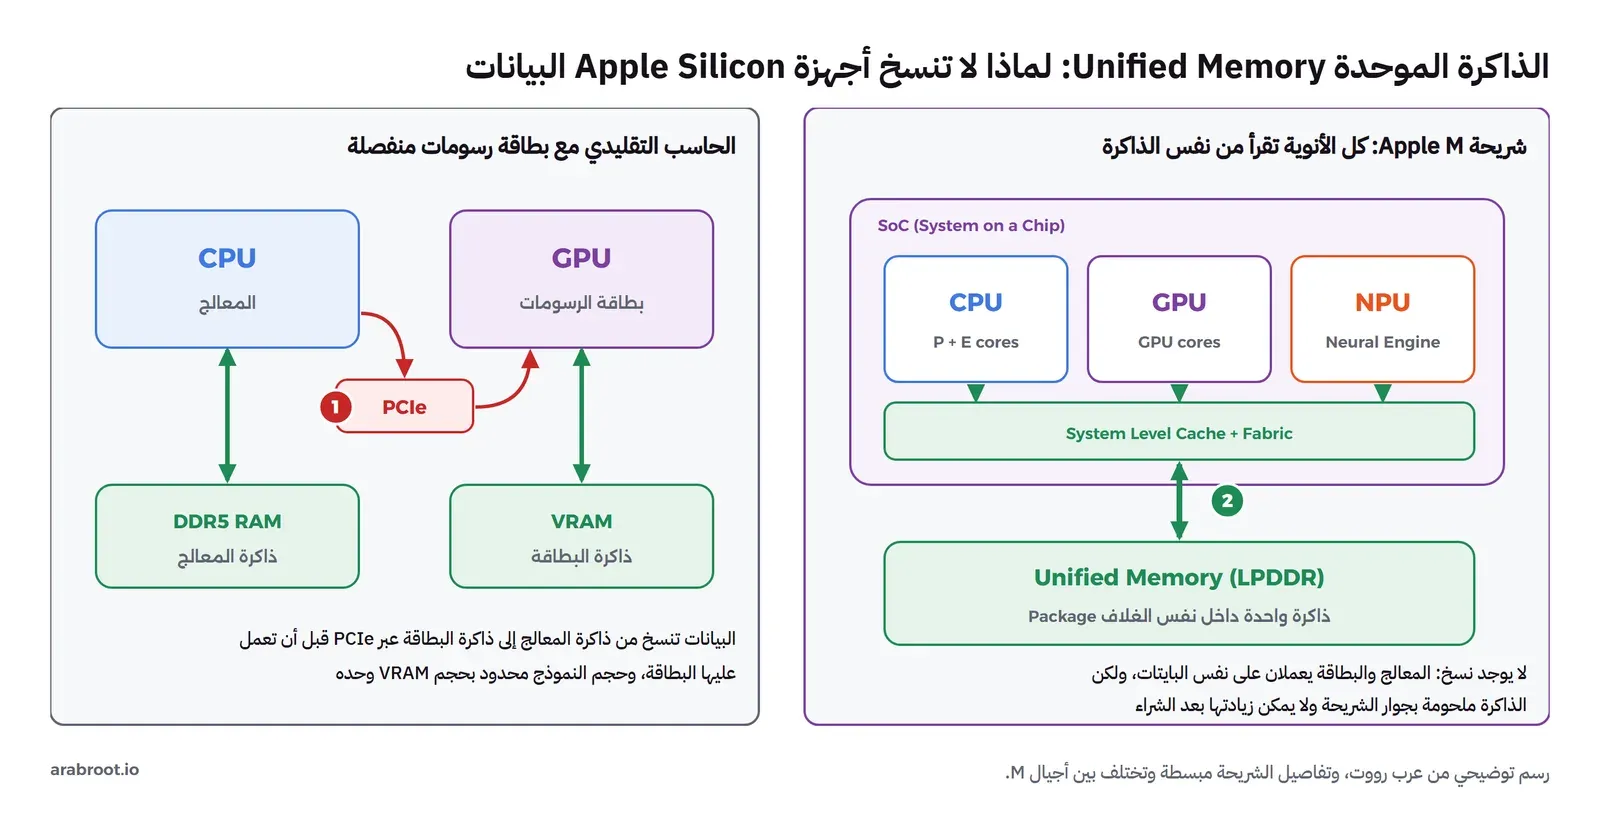
وهذه الفكرة لها أثر عملي واضح عند تشغيل نماذج اللغة على الجهاز، لأن جهاز Mac بذاكرة 64 GB يستطيع أن يعطي أغلبها للرسومات، بينما أكبر بطاقة رسومات منزلية عادة أقل من ذلك بكثير، وقد شرحنا هذا بالأرقام في مقال تشغيل نماذج اللغة على جهازك. ولكن لاحظ الوجه الآخر: الذاكرة الموحدة ليست سحراً، فعرض النطاق Bandwidth مشترك بين كل الأنوية، وحجمها يحدد مرة واحدة يوم الشراء، وبطاقة رسومات منفصلة قوية ما زالت أسرع في التدريب والأعمال الثقيلة.
واستمرت Apple في نفس الخط حتى أعلنت M5 في أكتوبر 2025، كما في إعلان M5، وتركيزها في هذا الجيل على تسريع الذكاء الاصطناعي داخل أنوية الرسومات نفسها. أما كيف شغل Mac برامج Intel القديمة طوال سنوات الانتقال فهو موضوع Rosetta 2، وله مقاله الخاص في هذه المرحلة.
ARM في السيرفرات: لماذا بنت AWS معالجاً خاصاً بها؟
قبل 2018 كانت محاولات ARM في السيرفرات تجارب صغيرة لم تقنع أحداً، والسبب ليس المعمارية وإنما كل ما حولها: البرامج مبنية لـ x86 فقط، وأدوات البناء لا تعرف ARM، وأحد لا يريد أن يكون أول من يجرب. والذي غير ذلك أن مزوداً سحابياً كبيراً قرر أن يبني معالجه بنفسه ويتحمل كلفة التجربة، وهو AWS.
والسبب الأساسي اقتصادي: AWS تشتري ملايين المعالجات، وكل واط توفره في كل سيرفر يتضاعف في الكهرباء والتبريد ومساحة مراكز البيانات، وكل نسبة تدفعها لشركة معالجات هي نسبة تستطيع أن تحتفظ بها. وقد كتبنا عن طريقة التفكير هذه في قصة James Hamilton، الذي قاد في AWS قرارات مثل بناء الشرائح الخاصة. وفي نوفمبر 2018 أطلقت AWS أول جيل باسم Graviton في أجهزة A1، كما في إعلان أجهزة A1، ثم توالت الأجيال كما في الصورة التالية:
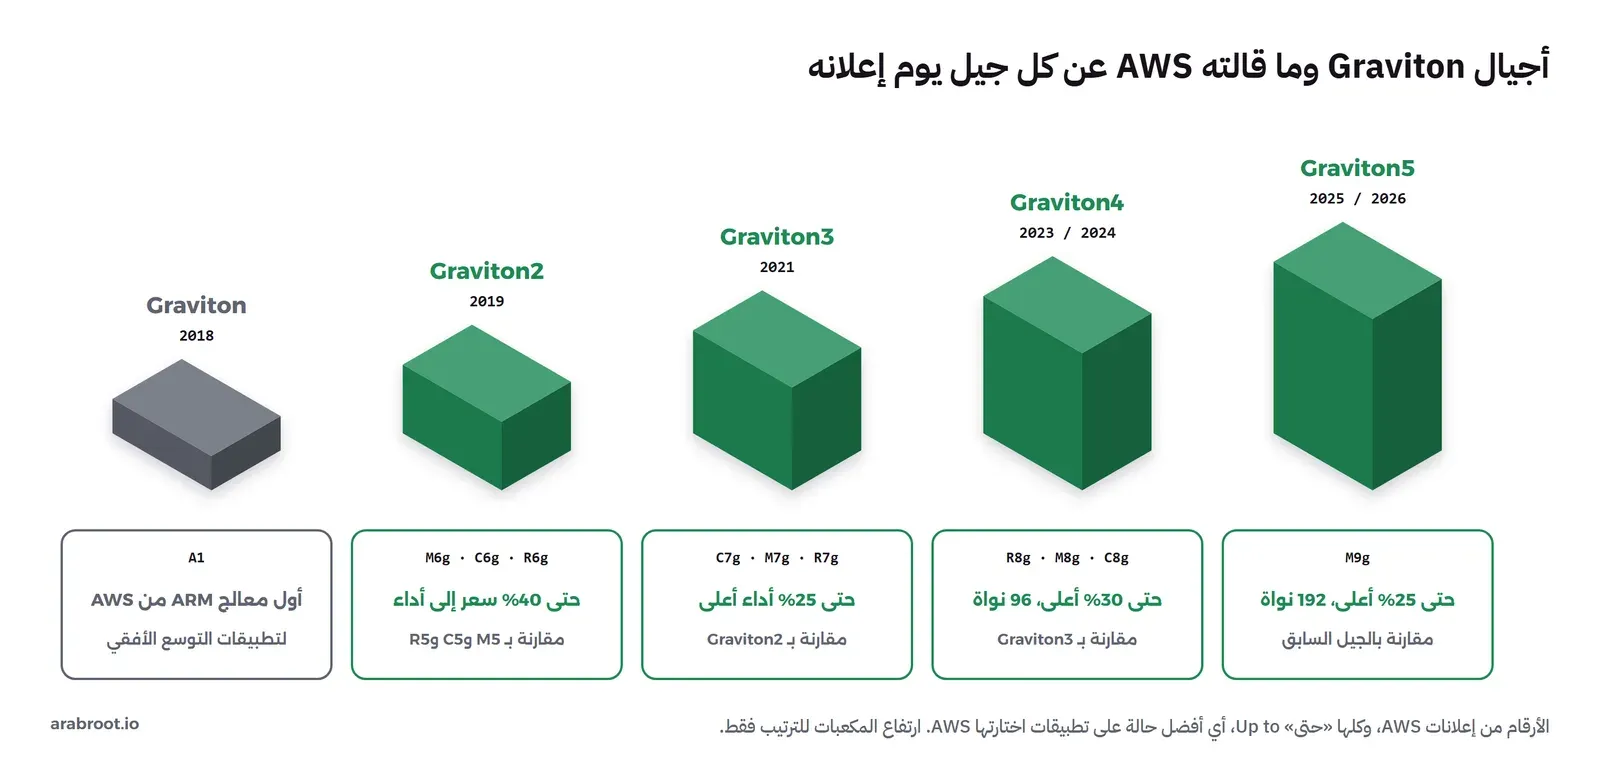
والأرقام في الصورة كلها من AWS نفسها، وفيما يلي كل جيل بتاريخ إعلانه ومصدره:
- Graviton2، ديسمبر 2019: أعلنت AWS أجهزة M6g وC6g وR6g وقالت إنها تعطي حتى 40% أفضل في السعر إلى الأداء مقارنة بأجهزة M5 وC5 وR5 بمعالجات x86، وهذا الجيل هو الذي جعل ARM خياراً جاداً في السحابة.
- Graviton3، نوفمبر 2021: في أجهزة C7g، وتقول صفحة C7g إنه يعطي حتى 25% أداء حسابياً أعلى من Graviton2، وحتى ضعف الأداء في الأرقام العشرية والتشفير.
- Graviton4، أعلن في نوفمبر 2023 وتوفر للجميع في يوليو 2024: في أجهزة R8g، ويقول إعلان AWS إنه أسرع حتى 30% من Graviton3، وحتى 40% في قواعد البيانات و45% في تطبيقات Java الكبيرة.
- Graviton5، أعلن في ديسمبر 2025: في أجهزة M9g، وفيه 192 نواة في الشريحة الواحدة، ويقول بيان Amazon إنه يعطي حتى 25% أداء أعلى من الجيل السابق، وإن أكثر من نصف سعة المعالجات الجديدة التي أضافتها AWS للسنة الثالثة على التوالي كانت Graviton، وإن 98% من أكبر ألف عميل لـ EC2 استخدموه.
واليوم تقول صفحة Graviton إن أجهزته قد تكلف حتى 20% أقل من أجهزة x86 المشابهة، وتستهلك حتى 60% أقل من الطاقة لنفس الأداء. وكلمة «حتى» Up to في كل هذه الأرقام مهمة جداً، لأنها أفضل حالة على تطبيقات اختارتها AWS، وتطبيقك قد يكون أسرع أو أبطأ، ولذلك القاعدة الوحيدة هنا: لا تنقل خدمة إلى ARM لأن الرقم في الإعلان كبير، وإنما شغل تطبيقك نفسه على الجهازين وقارن الكلفة الشهرية لنفس الأداء.
وماذا عن بقية المزودين؟ Ampere وAxion وCobalt
بعد نجاح Graviton لم يعد السؤال هل تصلح ARM للسيرفر، وإنما من يبني الشريحة:
- Ampere Computing: شركة تبيع معالجات ARM للسيرفرات لأي مزود أو شركة، وأشهرها Altra بأنوية Neoverse N1 ثم AmpereOne بأنوية من تصميمها، كما في صفحة معالجات Ampere. وهذه المعالجات هي التي تقف خلف أغلب سيرفرات ARM عند المزودين الأصغر، ومنها سيرفرات CAX عند Hetzner التي أطلقت في أبريل 2023 بمعالجات Ampere Altra وأسعار تبدأ من بضعة يوروهات في الشهر، وهي أسهل طريقة لتجربة سيرفر ARM حقيقي إذا كنت تستضيف خدماتك بنفسك.
- Google Axion: أعلنته Google في أبريل 2024 بأنوية Neoverse V2، وقالت في إعلانها إنه يعطي حتى 50% أداء أعلى وحتى 60% كفاءة أفضل في الطاقة من أجهزة x86 المماثلة من نفس الجيل.
- Microsoft Azure Cobalt 100: معالج صممته Microsoft، وتوفرت أجهزته للجميع في أكتوبر 2024 بحتى 96 vCPU، وقالت في إعلانها إنه أسرع حتى 1.4 مرة من أجهزة ARM السابقة عندها.
لاحظ النمط هنا: كل مزود سحابي كبير صار عنده معالج ARM خاص به، وكلها مبنية على أنوية Neoverse أو على ترخيص المعمارية، وهذا يعني أن البرنامج الذي تبنيه لـ linux/arm64 مرة واحدة يعمل على كل هذه السيرفرات دون تعديل، لأنها كلها تنفذ نفس العقد Armv8-A أو Armv9-A.
Windows على ARM: كيف يعمل البرنامج القديم؟
كان Windows آخر من وصل، لأن مكتبة برامجه الضخمة كلها x86، ومستخدم Windows لا يقبل جهازاً لا يشغل برنامجه القديم. والمحاولات الأولى مثل Windows RT في 2012 فشلت لهذا السبب بالذات، فلم يكن يشغل إلا تطبيقات المتجر. والذي تغير في 2024 شيئان: شرائح Snapdragon X من Qualcomm بأنوية Oryon، وهي النواة التي كانت محل النزاع مع Arm، ومحاكي جديد اسمه Prism في Windows 11 24H2.
ويقول توثيق Microsoft في صفحة المحاكاة على Arm إن Prism يترجم كتل تعليمات x86 إلى ARM64 أثناء التشغيل، ويحفظ الكتل المترجمة لكل ملف حتى لا يترجمها مرة أخرى، وإنه يعمل لكود المستخدم فقط ولا يشغل التعريفات Drivers، فأي جزء يعمل في النواة يجب أن يكون مبنياً لـ ARM64. وهذا يفسر المشكلة التي يواجهها أغلب من يشتري جهاز Windows على ARM: البرنامج العادي يعمل، ولكن برنامج الحماية أو الطابعة القديمة أو أداة VPN التي تحتاج تعريفاً خاصاً قد لا تعمل إطلاقاً. وتقدم Microsoft أيضاً صيغة اسمها ARM64EC تسمح للمطور أن ينقل برنامجه إلى ARM جزءاً بعد جزء، بحيث يعمل الكود الأصلي والكود المحاكى في نفس العملية. أما كيف تترجم Prism وRosetta 2 وQEMU التعليمات من الداخل فهذا موضوع مقال المحاكاة والترجمة الثنائية في هذه المرحلة.
المختبر: Image لعدة معماريات ثم كلفة المحاكاة
الآن ننتقل من الكلام إلى التجربة، والسؤال العملي الذي يهم أغلب القراء هو: إذا كان جهازي x86-64 وسيرفري ARM، أو العكس، فكيف أبني وأشغل Docker Images للمعماريتين، وكم يكلفني تشغيل نسخة ARM على جهاز x86 للتجربة؟ وسوف نعمل على جهاز Windows 11 بمعالج Intel Core i7-7700K وDocker Desktop بالإصدار 29.8.0، ونحتاج ملفاً واحداً بلغة C هو bench.c، وهو برنامج صغير يقوم بعملين معروفين: الأول hash يحسب دالة الهاش FNV-1a على بيانات ثابتة من عدد من الميغابايتات، والثاني sort يرتب ملايين الأرقام بالدالة qsort من مكتبة C، وفي الحالتين يطبع النتيجة والزمن، والنتيجة نفسها يجب أن تكون متطابقة على كل المعماريات:
// bench.c: the same CPU work for every architecture.
// usage: ./bench sort N   -> sorts N pseudo-random ints with qsort
//        ./bench hash MB  -> FNV-1a hash over MB megabytes
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <stdint.h>
#include <time.h>

static uint64_t s = 88172645463325252ull;
static uint64_t xorshift(void) { s ^= s << 13; s ^= s >> 7; s ^= s << 17; return s; }
static int cmp(const void *a, const void *b) { int x = *(const int *)a, y = *(const int *)b; return (x > y) - (x < y); }
static double now(void) { struct timespec t; clock_gettime(CLOCK_MONOTONIC, &t); return t.tv_sec + t.tv_nsec / 1e9; }

int main(int argc, char **argv) {
    if (argc < 3) { fprintf(stderr, "usage: %s sort|hash N\n", argv[0]); return 1; }
    long n = atol(argv[2]);
    double t0 = now();
    if (strcmp(argv[1], "sort") == 0) {
        int *a = malloc(n * sizeof *a);
        for (long i = 0; i < n; i++) a[i] = (int)(xorshift() & 0x7fffffff);
        qsort(a, n, sizeof *a, cmp);
        printf("sort n=%ld first=%d last=%d", n, a[0], a[n - 1]);
    } else {
        size_t len = 1 << 20;
        unsigned char *buf = malloc(len);
        for (size_t i = 0; i < len; i++) buf[i] = (unsigned char)xorshift();
        uint64_t h = 1469598103934665603ull;
        for (long r = 0; r < n; r++)
            for (size_t i = 0; i < len; i++) { h ^= buf[i]; h *= 1099511628211ull; }
        printf("hash mb=%ld h=%016llx", n, (unsigned long long)h);
    }
    printf(" time=%.3fs\n", now() - t0);
    return 0;
}
الخطوة الأولى: Image واحدة وثماني نسخ
قبل أن نبني شيئاً، لنرى كيف تتعامل Docker Hub مع المعماريات المختلفة، والأمر docker buildx imagetools inspect يقرأ وصف ال Image من السجل Registry دون أن يسحبها، كما في توثيق الأمر:
docker buildx imagetools inspect debian:trixie-slim | head -12والمخرج سوف يكون كما يلي:
Name:      docker.io/library/debian:trixie-slim
MediaType: application/vnd.oci.image.index.v1+json
Digest:    sha256:a72b4433de1cf7d6bae0c4cee74d0547f58601a643b3375f070c51600d63b6b2

Manifests:
  Name:        docker.io/library/debian:trixie-slim@sha256:7378260c0a098d27ac206225db5e7d92b8c7c84ea7afccc86eeb513756bbd392
  MediaType:   application/vnd.oci.image.manifest.v1+json
  Platform:    linux/amd64
  Annotations:
    org.opencontainers.image.created:         2026-11-04T00:00:00Z
    org.opencontainers.image.revision:        373f61a386722a989c79f0c11f23fcf379b56e94
    org.opencontainers.image.source:          https://github.com/debuerreotype/docker-debian-artifacts.git
في المخرج أعلاه لاحظ التالي:
MediaType: ...image.index.v1+json: الاسمdebian:trixie-slimلا يشير إلى Image واحدة، وإنما إلى فهرس Image Index، وهو قائمة فيها نسخة لكل معمارية.Digestالأول: بصمة الفهرس كله، فإذا ثبت Image في ملف Compose بهذه البصمة فأنت تثبت كل النسخ معاً، وكل جهاز يأخذ نسخته منها.Manifests: كل عنصر تحتها هو Image حقيقية لمعمارية واحدة، ولها بصمتها الخاصة، وأولها هناlinux/amd64.
والمخرج الكامل طويل لأن كل نسخة معها تفاصيلها، ولذلك نطلب منه سطراً واحداً لكل نسخة بالخيار --format:
docker buildx imagetools inspect debian:trixie-slim --format '{{range .Manifest.Manifests}}{{.Platform.OS}}/{{.Platform.Architecture}}{{if .Platform.Variant}}/{{.Platform.Variant}}{{end}} {{printf "%.19s" .Digest}} {{.Size}}{{println}}{{end}}'والمخرج سوف يكون كما يلي:
linux/amd64  sha256:7378260c0a09  1021
unknown/unknown  sha256:00f161b6f42d  562
linux/arm/v5  sha256:3148a36a9464  1037
unknown/unknown  sha256:d4156c85ddbf  562
linux/arm/v7  sha256:ced25bc1bff2  1037
unknown/unknown  sha256:0daca73b59e8  562
linux/arm64/v8  sha256:24a01011d10e  1041
unknown/unknown  sha256:cd72e82358d3  562
linux/386  sha256:2f17e429fd40  1017
unknown/unknown  sha256:ccb838adb3ad  562
linux/ppc64le  sha256:89ff4dab6f05  1025
unknown/unknown  sha256:935d67e0ffc5  562
linux/riscv64  sha256:8262446fd210  1025
unknown/unknown  sha256:df0c51c6bc45  562
linux/s390x  sha256:31622eb35d6c  1021
unknown/unknown  sha256:a30d41da52f2  562
في المخرج أعلاه لاحظ التالي:
- ثماني معماريات حقيقية لنفس الاسم:
amd64لحاسبك وأغلب السيرفرات، وarm64/v8لـ Graviton وAmpere وMac وRaspberry Pi 5، وarm/v5وarm/v7لأجهزة ARM القديمة بـ 32 بت، و386لـ x86 القديم، وppc64leوs390xلسيرفرات IBM، وriscv64التي سوف نعود إليها في مقال RISC-V. unknown/unknownبعد كل نسخة: ليست معمارية غريبة، وإنما شهادة البناء Attestation لكل نسخة، وفيها معلومات عن طريقة بنائها، ولا يشغلها Docker أبداً.- العمود الأخير هو حجم ملف الوصف Manifest بالبايت وليس حجم ال Image، فالوصف صغير جداً وال Layers نفسها في مكان آخر.
والصورة التالية تلخص ما رأيناه، ومعه الجزء الذي سوف نبنيه في الخطوات القادمة:
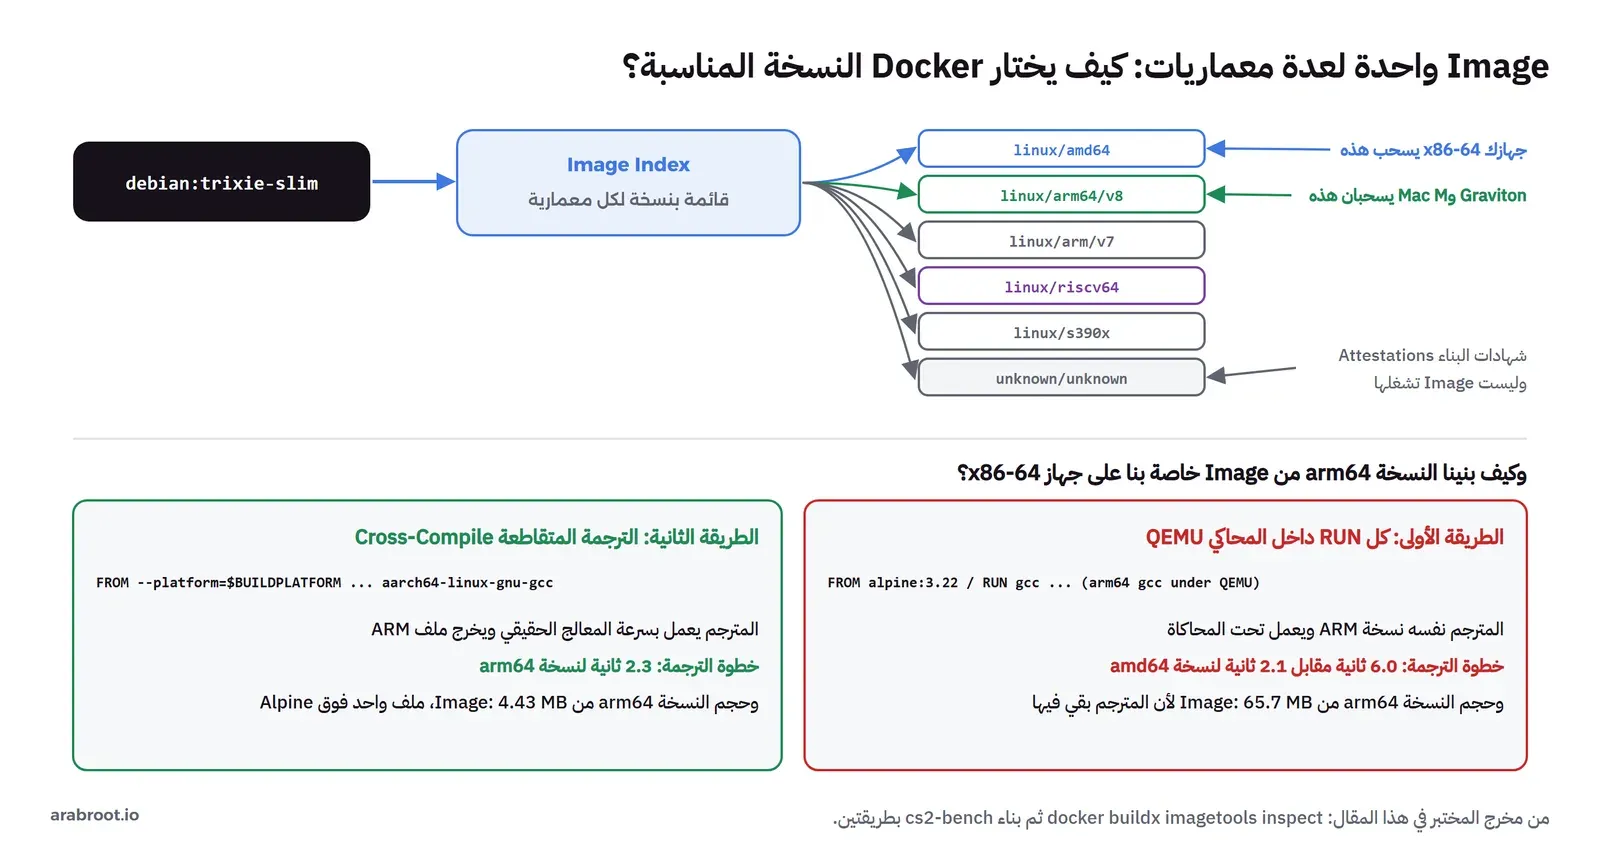
وهذا يجيب عن سؤال يطرحه كثيرون: لماذا يعمل الأمر docker pull debian:trixie-slim على Mac M وعلى Graviton وعلى حاسبي دون أن أحدد شيئاً؟ لأن Docker يقرأ الفهرس ويأخذ النسخة التي تطابق معمارية الجهاز، وإذا لم يجد نسخة مطابقة توقف برسالة خطأ، أو أخذ نسخة أخرى إذا طلبتها أنت بالخيار --platform.
الخطوة الثانية: نشغل Container لـ arm64 على جهاز x86-64
نطلب الآن نسخة arm64 من Alpine صراحة على جهاز معالجه x86-64:
docker run --rm --platform linux/arm64 alpine:3.22 uname -mوالمخرج سوف يكون كما يلي:
exec /bin/uname: exec format errorوهذه مشكلة واجهناها فعلاً في هذا المختبر، مع أن قائمة docker buildx ls كانت تقول إن المنصة linux/arm64 مدعومة. والسبب أن Docker سحب نسخة arm64 فعلاً، ولكن النواة لم تجد من يشغل ملفات ARM، لأن جدول binfmt_misc في النواة لم يكن فيه محاكي ARM مسجلاً، وهذا الجدول هو الذي يقول للنواة: «إذا وجدت ملف ELF لمعالج ARM فسلمه إلى المحاكي QEMU». وقد شرحنا هذا الجدول وما يحدث داخله في مقال معمارية المعالج ISA المذكور في أول المقال، والحل الذي يذكره توثيق Docker للبناء لعدة منصات هو تسجيل المحاكيات بالأداة tonistiigi/binfmt:
docker run --privileged --rm tonistiigi/binfmt:qemu-v10.0.4 --install arm64,riscv64والمخرج سوف يكون كما يلي:
installing: arm64 OK
installing: riscv64 OK
{
  "supported": [
    "linux/amd64",
    "linux/amd64/v2",
    "linux/amd64/v3",
    "linux/arm64",
    "linux/riscv64",
    "linux/386"
  ],
  "emulators": [
    "python3.11",
    "qemu-aarch64",
    "qemu-riscv64"
  ]
}
في المخرج أعلاه لاحظ أن supported صارت تضم linux/arm64 وlinux/riscv64، وأن قائمة emulators فيها qemu-aarch64 وqemu-riscv64، وأما المدخل python3.11 فهو تسجيل آخر كان موجوداً في الجدول قبلنا ولا علاقة له بالمعالجات، وهذا يذكرك بأن هذا الجدول مشترك على مستوى النواة كلها، فما يسجله Container بصلاحيات كاملة يراه كل Container آخر. وتحتاج الصلاحية --privileged هنا بالذات لأن الأداة تكتب في جدول النواة، فلا تقم بتشغيل Images مجهولة بهذه الصلاحية، والسبب أنها تستطيع أن تفعل بالنواة ما تشاء. والآن نعيد نفس الأمر ونطلب معه أول سطور /proc/cpuinfo:
docker run --rm --platform linux/arm64 alpine:3.22 sh -c 'uname -m; head -8 /proc/cpuinfo'والمخرج سوف يكون كما يلي:
aarch64
processor	: 0
model name	: ARMv8 Processor rev 0 (v8l)
BogoMIPS	: 100.00
Features	: fp asimd aes pmull sha1 sha2 crc32 atomics fphp asimdhp cpuid asimdrdm jscvt fcma lrcpc dcpop sha3 sm3 sm4 asimddp sha512 sve asimdfhm dit uscat ilrcpc flagm sb paca pacg dcpodp sve2 sveaes svepmull svebitperm svesha3 svesm4 flagm2 frint svei8mm svef32mm svef64mm svebf16 i8mm bf16 rng bti mte mte3 sme smei16i64 smef64f64 smei8i32 smef16f32 smeb16f32 smef32f32 smefa64 mops hbc
CPU implementer	: 0x00
CPU architecture: 8
CPU variant	: 0x0
CPU part	: 0x051
في المخرج أعلاه لاحظ التالي:
aarch64: البرنامجunameنفسه ملف ARM، وهو يرى نفسه على معالج ARM، مع أن الجهاز الحقيقي Intel، لأن المحاكي يترجم كل تعليمة قبل تنفيذها.Features: قائمة طويلة جداً من امتدادات ARM، ومنهاsveوsve2للمتجهات وsmeللمصفوفات وmteلوسم الذاكرة. ولا يوجد معالج حقيقي يباع اليوم فيه كل هذه الامتدادات معاً، وإنما هذا هو النموذجmaxفي QEMU، أي «كل ما يعرف المحاكي أن يقلده».CPU implementer: 0x00: في المعالج الحقيقي يكون هذا رقم الشركة المصممة، مثل0x41لـ Arm نفسها أو0x61لـ Apple، والصفر هنا علامة أخرى على أنه معالج غير موجود.
والدرس العملي من هذه النقطة: إذا اختبرت برنامجك تحت المحاكاة ونجح فهذا يثبت أن البناء صحيح، ولا يثبت أن البرنامج سوف يعمل على كل سيرفر ARM، لأن برنامجاً مبنياً ليستخدم sve2 مثلاً سوف يعمل هنا ويتوقف على Graviton2 الذي لا يملك هذا الامتداد.
الخطوة الثالثة: نبني Image خاصة بنا لـ amd64 وarm64 بطريقتين
الطريقة الأولى، وهي الأسهل والأكثر انتشاراً، أن تكتب Dockerfile عادياً وتطلب من buildx أن يبنيه للمنصتين، فتنفذ كل خطوة RUN في نسخة arm64 داخل المحاكي:
# Every RUN here executes on the target architecture: on an x86-64 machine the arm64 build runs under QEMU.
FROM alpine:3.22
RUN apk add --no-cache gcc musl-dev
WORKDIR /src
COPY bench.c .
RUN gcc -O2 -static -o /usr/local/bin/bench bench.c
ENTRYPOINT ["bench"]
ونبنيه بالأمر التالي، والخيار --load يضع النسختين في Docker المحلي، وهذا يعمل لأن Docker Desktop يستخدم مخزن containerd الذي يحفظ أكثر من معمارية لنفس الاسم:
time docker buildx build --no-cache --progress=plain --platform linux/amd64,linux/arm64 -f Dockerfile.emu -t cs2-bench:emu --load .ومن المخرج الطويل نأخذ أسطر الخطوات التي تهمنا:
#8 [linux/amd64 2/5] RUN apk add --no-cache gcc musl-dev
#8 DONE 105.9s
#9 [linux/arm64 2/5] RUN apk add --no-cache gcc musl-dev
#9 DONE 106.0s
#14 [linux/amd64 5/5] RUN gcc -O2 -static -o /usr/local/bin/bench bench.c
#14 DONE 2.1s
#15 [linux/arm64 5/5] RUN gcc -O2 -static -o /usr/local/bin/bench bench.c
#15 DONE 6.0s
#16 DONE 38.7s
real	2m56.547s
في المخرج أعلاه لاحظ التالي:
- خطوة
apk addأخذت نفس الوقت تقريباً في النسختين، لأن أغلب وقتها تحميل الحزم من الإنترنت، وهي مقيدة بالشبكة وليس بالمعالج. - خطوة
gccأخذت 2.1 ثانية في نسخة amd64 و6.0 ثانية في نسخة arm64، أي نحو ثلاثة أضعاف، لأن المترجم نفسه برنامج ARM يعمل داخل المحاكي. وهذا ملف C واحد صغير، أما مشروع كبير بمئات الملفات أو تثبيت حزم Python تحتاج ترجمة أو بناء مشروع Rust فقد يتحول فيه الفرق من ثوان إلى ساعة كاملة.
والطريقة الثانية هي الترجمة المتقاطعة Cross-Compilation: نجعل مرحلة البناء تعمل على معمارية الجهاز نفسه، وهو ما يسميه Docker $BUILDPLATFORM، ونستخدم فيها مترجماً يعمل على x86-64 ويخرج ملفات ARM، ثم ننسخ الملف الناتج إلى Image نهائية للمعمارية المطلوبة:
# syntax=docker/dockerfile:1
# The build stage runs on the machine's own architecture ($BUILDPLATFORM) and cross-compiles for $TARGETARCH.
FROM --platform=$BUILDPLATFORM debian:trixie-slim AS build
ARG TARGETARCH
RUN apt-get update && apt-get install -y --no-install-recommends \
      gcc libc6-dev gcc-aarch64-linux-gnu libc6-dev-arm64-cross && rm -rf /var/lib/apt/lists/*
WORKDIR /src
COPY bench.c .
RUN case "$TARGETARCH" in \
      amd64) CC=gcc ;; \
      arm64) CC=aarch64-linux-gnu-gcc ;; \
      *) echo "unsupported $TARGETARCH"; exit 1 ;; \
    esac && $CC -O2 -static -o /bench bench.c

FROM alpine:3.22
COPY --from=build /bench /usr/local/bin/bench
ENTRYPOINT ["bench"]
في الملف أعلاه لاحظ التالي:
FROM --platform=$BUILDPLATFORM: مرحلة البناء تؤخذ دائماً بمعمارية الجهاز الذي يبني، وبالتالي لا يعمل فيها أي شيء داخل المحاكي.ARG TARGETARCH: متغير يملؤه buildx تلقائياً بالمعمارية المطلوبة في كل مرة،amd64ثمarm64، فنختار المترجم المناسب بالأمرcase.-static: نبني ملفاً ثابتاً لا يحتاج مكتبات من النظام، ولذلك نستطيع أن ننسخه إلى Alpine مع أننا بنيناه على Debian.FROM alpine:3.22في المرحلة الأخيرة: هذه المرحلة تؤخذ بمعمارية الهدف، ولا يوجد فيهاRUNواحد، فلا تحتاج المحاكي أصلاً.
ونبنيه بنفس الطريقة:
time docker buildx build --no-cache --progress=plain --platform linux/amd64,linux/arm64 -f Dockerfile.cross -t cs2-bench:cross --load .والأسطر المهمة من المخرج:
#12 DONE 147.7s
#13 [linux/amd64->arm64 build 2/5] RUN apt-get update && apt-get install -y --no-install-recommends       gcc libc6-dev gcc-aarch64-linux-gnu libc6-dev-arm64-cross && rm -rf /var/lib/apt/lists/*
#13 DONE 147.7s
#18 [linux/amd64 build 5/5] RUN case "amd64" in       amd64) CC=gcc ;;       arm64) CC=aarch64-linux-gnu-gcc ;;       *) echo "unsupported amd64"; exit 1 ;;     esac && $CC -O2 -static -o /bench bench.c
#18 DONE 2.0s
#19 [linux/amd64->arm64 build 5/5] RUN case "arm64" in       amd64) CC=gcc ;;       arm64) CC=aarch64-linux-gnu-gcc ;;       *) echo "unsupported arm64"; exit 1 ;;     esac && $CC -O2 -static -o /bench bench.c
#19 DONE 2.3s
#22 DONE 14.7s
real	3m20.831s
في المخرج أعلاه لاحظ التالي:
[linux/amd64->arm64 build ...]: هذه هي العلامة التي تبحث عنها، فهي تعني أن الخطوة تعمل على amd64 من أجل هدف arm64، أي دون محاكاة.- الترجمة لـ arm64 أخذت 2.3 ثانية مقابل 6.0 ثانية في الطريقة الأولى، وهو نفس زمن الترجمة لـ amd64 تقريباً.
- الزمن الكلي أطول هنا لأن تحميل المترجم المتقاطع وحزمه من Debian أخذ 147 ثانية، وهذه كلفة تدفعها مرة واحدة ثم تحفظها ذاكرة البناء Build Cache، وأما فرق الترجمة فتدفعه في كل بناء.
والآن لنقارن ال Images الناتجة بالأمر التالي، والخيار --tree يبين كل نسخة تحت الاسم:
docker image ls --tree cs2-benchوالمخرج سوف يكون كما يلي:
IMAGE                ID             DISK USAGE   CONTENT SIZE   EXTRA
cs2-bench:cross      5645366d2e11       18.3MB         8.57MB
├─ linux/amd64       6142b366860f       13.9MB         4.13MB
└─ linux/arm64       063e14c24b1a       4.43MB         4.43MB

cs2-bench:emu        53b0a1e968c6        319MB          134MB
├─ linux/amd64       e6532015fec0        253MB         68.7MB
└─ linux/arm64       eae686f3fe94       65.7MB         65.7MB
في المخرج أعلاه لاحظ أن النسخة arm64 من الطريقة الثانية 4.43 MB فقط لأنها Alpine وفوقها ملف واحد، بينما النسخة arm64 من الطريقة الأولى 65.7 MB لأن المترجم GCC وكل حزمه بقيت داخلها، وهذا ليس عيباً في المحاكاة وإنما في الملف نفسه، فالطريقة الصحيحة في الحالتين هي البناء على مراحل Multi-stage، ولكن الطريقة الثانية تجبرك عليه. وتلاحظ أيضاً أن نسخة amd64 في cs2-bench:cross تأخذ 13.9 MB على القرص مع أن محتواها 4.13 MB، لأن Docker فك طبقاتها لتكون جاهزة للتشغيل على هذا الجهاز، أما نسخة arm64 فمحفوظة فقط ولم تفك.
الخطوة الرابعة: كم تكلف المحاكاة؟
نشغل البرنامج الآن من نفس ال Image بنسختيها، ثلاث مرات لكل عمل، والملف واحد في المحتوى ولكن نسخة arm64 تعمل داخل المحاكي:
for p in amd64 arm64; do
  for i in 1 2 3; do docker run --rm --platform linux/$p cs2-bench:cross hash 200; done
  for i in 1 2 3; do docker run --rm --platform linux/$p cs2-bench:cross sort 5000000; done
done
والمخرج سوف يكون كما يلي، الثلاثة الأولى من كل مجموعة لـ amd64 ثم arm64:
hash mb=200 h=46ddfd31d041d963 time=0.224s
hash mb=200 h=46ddfd31d041d963 time=0.232s
hash mb=200 h=46ddfd31d041d963 time=0.251s
sort n=5000000 first=24 last=2147483240 time=0.715s
sort n=5000000 first=24 last=2147483240 time=0.746s
sort n=5000000 first=24 last=2147483240 time=0.765s
hash mb=200 h=46ddfd31d041d963 time=0.995s
hash mb=200 h=46ddfd31d041d963 time=1.630s
hash mb=200 h=46ddfd31d041d963 time=1.853s
sort n=5000000 first=24 last=2147483240 time=14.612s
sort n=5000000 first=24 last=2147483240 time=16.931s
sort n=5000000 first=24 last=2147483240 time=13.414s
في المخرج أعلاه لاحظ التالي:
- قيمة الهاش
h=46ddfd31d041d963متطابقة في كل المرات، وأول وآخر رقم بعد الترتيب متطابقان أيضاً، وهذا هو المعنى العملي لكلمة «نفس البرنامج»: النتيجة واحدة بالبايت على المعماريتين. - الهاش أبطأ تحت المحاكاة بنحو سبعة أضعاف، والترتيب أبطأ بنحو عشرين ضعفاً. والسبب أن حلقة الهاش بسيطة: تحميل بايت وعمليتان، فيترجمها المحاكي مرة ثم يعيد تشغيلها، أما الترتيب فيستدعي الدالة
cmpعبر مؤشر ملايين المرات، وفيه مقارنات وتفرعات كثيرة، وكل تفرع غير مباشر يعيد المحاكي إلى البحث عن الكود المترجم الذي يناسب العنوان الجديد. - زمن نسخة arm64 يتغير بين التشغيلات أكثر بكثير من زمن نسخة amd64، لأن المحاكي يتأثر أكثر بما يحدث على الجهاز في نفس اللحظة، ولذلك لا تحكم على أداء برنامج من تشغيل واحد تحت المحاكاة.
وبرنامجنا الصغير ليس كل القصة، فلنجرب أداتين حقيقيتين يستخدمهما كل سيرفر، وهما ضغط البيانات بـ zstd والتشفير بـ OpenSSL، في Container من Alpine بالنسختين:
for p in amd64 arm64; do
  echo "### linux/$p"
  docker run --rm --platform linux/$p alpine:3.22 sh -c 'apk add -q --no-cache openssl zstd >/dev/null
    for i in 1 2 3; do zstd -b3 -i5 2>&1 | tr "\r" "\n" | grep -o "x3.352.*MB/s" | tail -1; done
    for i in 1 2; do
      openssl speed -seconds 3 -bytes 16384 sha256 2>/dev/null | tail -1
      openssl speed -seconds 3 -bytes 16384 -evp aes-128-gcm 2>/dev/null | tail -1
    done'
done
والمخرج سوف يكون كما يلي:
### linux/amd64
x3.352),  125.3 MB/s,  672.1 MB/s
x3.352),  121.0 MB/s
x3.352),  128.9 MB/s,  726.2 MB/s
sha256          440406.30k
AES-128-GCM    4297992.87k
sha256          381454.43k
AES-128-GCM    4181169.49k
### linux/arm64
x3.352),   24.1 MB/s,   94.8 MB/s
x3.352),   18.7 MB/s,   57.7 MB/s
x3.352),   21.5 MB/s,   81.4 MB/s
sha256           81980.28k
AES-128-GCM      63974.57k
sha256           82853.89k
AES-128-GCM      72685.38k
في المخرج أعلاه لاحظ التالي:
x3.352: نسبة الضغط واحدة على المعماريتين، فالخوارزمية لا تتغير، وإنما السرعة فقط. والرقم الأول بعدها سرعة الضغط والثاني سرعة فك الضغط، وفي السطر الثاني من amd64 لم يطبع zstd رقم فك الضغط في السطر الأخير لأن الأمرgrepالتقط سطر تقدم قبل نهاية القياس، وهذه من مشاكل قراءة مخرج أداة تحدث شاشتها بالرمز\r.sha256: الأرقام بالكيلوبايت في الثانية، أي نحو 440 MB/s على المعالج الحقيقي مقابل 82 MB/s تحت المحاكاة.AES-128-GCM: أكثر من 4 GB/s على المعالج الحقيقي مقابل نحو 64 MB/s، أي أبطأ بأكثر من ستين ضعفاً، وهذا أكبر فرق في كل التجربة.
والصورة التالية تجمع النتائج كلها بعدد مرات البطء، وأخذنا الوسيط Median في برنامجنا وأول قياس كامل في الأداتين:
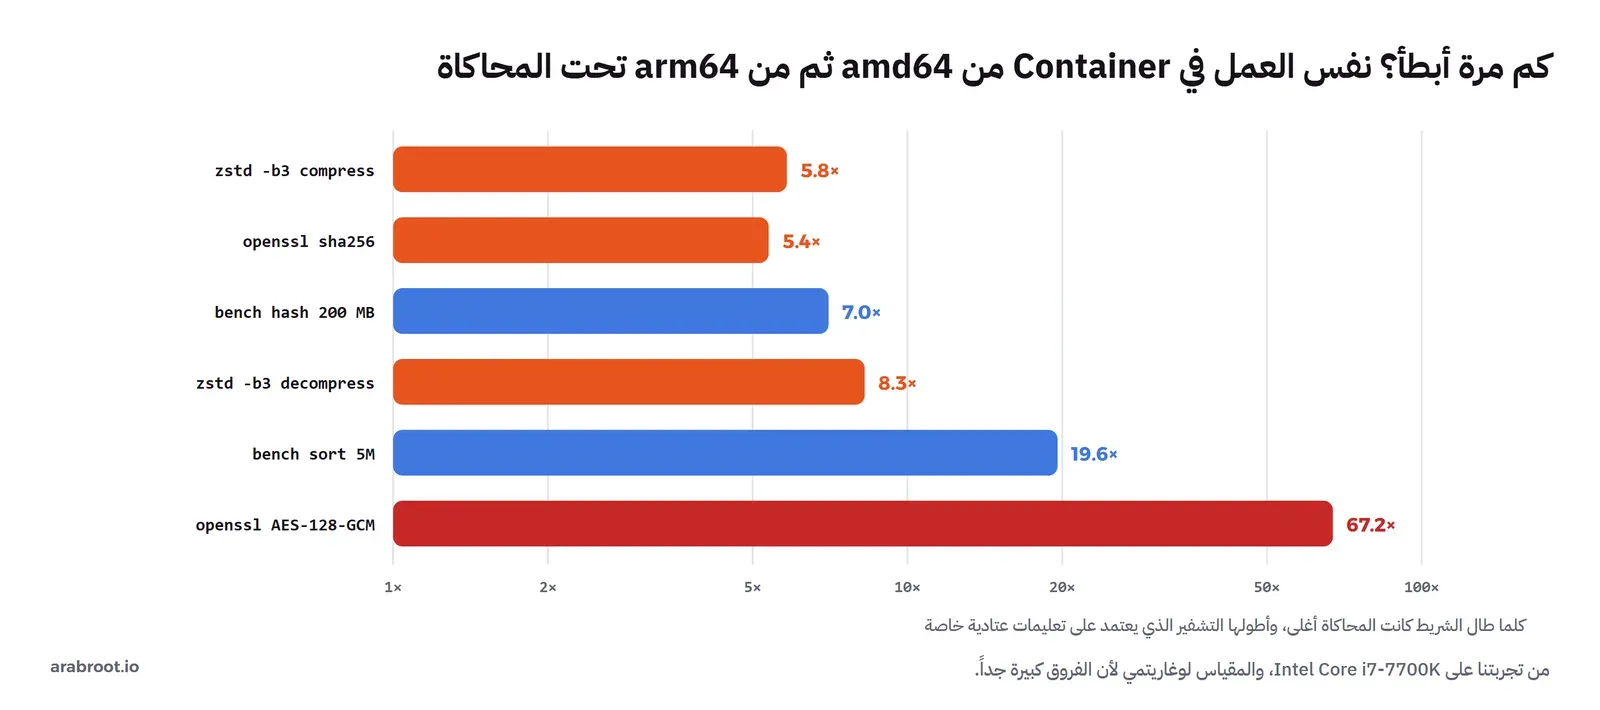
وقد يتساءل البعض: لماذا كان التشفير بالذات بهذا البطء؟ والإجابة أن معالج i7-7700K فيه تعليمات خاصة لـ AES اسمها AES-NI، فتشفير كتلة كاملة يحتاج بضع تعليمات فقط، ونسخة OpenSSL لـ ARM تستخدم بدورها تعليمات التشفير الخاصة بـ ARM التي رأيناها في قائمة Features باسم aes وpmull، ولكن المحاكي لا يملك طريقة لتحويل تعليمة ARM للتشفير إلى تعليمة Intel للتشفير مباشرة، فينفذ كل واحدة منها بدالة مساعدة مكتوبة بلغة C، وبالتالي يتحول ما كان تعليمة عتادية إلى عشرات أو مئات التعليمات العادية. والقاعدة التي تخرج بها: كلما اعتمد البرنامج على تعليمات خاصة بالمعالج، مثل التشفير والمتجهات SIMD، كانت المحاكاة أغلى.
ماذا يحدث إذا طلبت معمارية غير موجودة في ال Image؟
بنينا cs2-bench:cross لمعماريتين فقط، فلنطلب منها نسخة ثالثة:
docker run --rm --platform linux/riscv64 cs2-bench:cross hash 1والمخرج سوف يكون كما يلي:
Unable to find image 'cs2-bench:cross' locally
docker: Error response from daemon: pull access denied for cs2-bench, repository does not exist or may require 'docker login'

Run 'docker run --help' for more information
والرسالة مضللة إذا قرأتها بسرعة، فال Image موجودة محلياً بنفس الاسم، ولكن Docker يبحث عن الاسم مع المعمارية معاً، ولما لم يجد نسخة riscv64 حاول أن يسحبها من Docker Hub، ولما لم يجد مستودعاً بهذا الاسم هناك أعطى خطأ صلاحيات. فإذا رأيت هذه الرسالة لاسم تعرف أنه موجود، فأول ما تتحقق منه هو المعمارية: هل بنيت ال Image لمعمارية الجهاز الذي يشغلها؟ والأمر التالي يجيب مباشرة:
docker image inspect --platform linux/arm64 cs2-bench:cross --format '{{.Os}}/{{.Architecture}}'والمخرج سوف يكون linux/arm64، ونفس الأمر مع linux/riscv64 يفشل لأن النسخة غير موجودة.
قبل أن تنقل خدمة إلى سيرفر ARM
بعد كل ما سبق قد تتساءل: هل أنقل خدماتي إلى ARM؟ والإجابة أن أغلب ما يعمل على سيرفر Linux اليوم يعمل على ARM دون تغيير، ولكن «أغلب» ليست «كل»، والمشاكل تأتي من أماكن محددة:
- ال Images الجاهزة: أغلب Images الرسمية في Docker Hub متعددة المعماريات مثل
debianالتي رأيناها، ولكن Images صغيرة يصنعها أشخاص أو شركات قد تكون لـ amd64 فقط، فاقرأ فهرس كل Image تستخدمها بالأمرimagetools inspectقبل أن تشتري السيرفر. - اللغات المترجمة إلى Bytecode: برامج Java و.NET وPython وNode.js تعمل كما هي، لأن الآلة الافتراضية نفسها مبنية لـ ARM، والمشكلة تأتي فقط من المكتبات التي فيها جزء مكتوب بـ C أو C++ ولا يوجد لها ملف جاهز لـ arm64، فتحاول الأداة ترجمتها أثناء التثبيت وتفشل إذا لم يكن المترجم موجوداً.
- Go وRust: الترجمة المتقاطعة فيهما سهلة جداً، وبرنامج Go الخالص يكفيه أن تضع
GOARCH=arm64. - البرامج التجارية المغلقة: وكلاء المراقبة والحماية وقواعد البيانات التجارية قد لا تملك نسخة ARM، أو تملكها بترخيص مختلف.
- البناء في CI: إذا كان خط البناء يعمل على x86-64 ويبني نسخة arm64 تحت المحاكاة فسوف يبطئ كما رأينا، والحل الترجمة المتقاطعة أو أجهزة بناء ARM حقيقية، وقد أصبحت متاحة مجاناً للمستودعات العامة في GitHub Actions منذ أغسطس 2025، ثم للمستودعات الخاصة منذ يناير 2026، وإذا كنت تبني على خادمك فقد شرحنا ذلك في دليل Gitea Actions.
أخطاء شائعة وأفكار غير صحيحة
- «ARM تعني بطيئاً أو للجوال فقط»: هذه فكرة من قبل 2018، وأسرع حواسب Mac وأكبر معالجات AWS اليوم ARM، فالمعمارية لا تحدد السرعة وإنما التصميم الذي ينفذها.
- بناء Image على Mac M ورفعها إلى سيرفر x86 دون
--platform: سوف تبني نسخة arm64 فقط لأنها معمارية جهازك، فابن بالخيار--platform linux/amd64,linux/arm64أو بمعمارية السيرفر صراحة. - الحكم على أداء ARM من تجربة محاكاة: رأينا بطئاً بين خمس مرات وسبعين مرة، وكله كلفة المحاكي وليس المعالج.
- تصديق رقم «حتى 40%» كما هو: أرقام المزودين أفضل حالة على تطبيقات اختاروها، فقس تطبيقك قبل أن تحسب التوفير.
- بناء نسخة arm64 داخل المحاكي في كل Pipeline: مقبول لمشروع صغير، ومكلف جداً لمشروع كبير، فاستخدم الترجمة المتقاطعة أو جهاز بناء ARM.
- افتراض أن كل سيرفرات ARM متطابقة: المعمارية واحدة، ولكن الامتدادات تختلف بين Graviton2 وGraviton4 مثلاً، فلا تبن بخيارات تخص جيلاً أحدث من السيرفر الذي سوف يعمل عليه البرنامج.
- شراء جهاز Windows على ARM لعمل يحتاج تعريفاً خاصاً: المحاكي Prism لا يشغل التعريفات، فتأكد من وجود نسخة ARM64 من أي برنامج يعمل في النواة.
متى تختار ARM؟ جدول قرار Decision Table
| حالتك | الاختيار الأنسب | والسبب |
|---|---|---|
| خدمات ويب وقواعد بيانات مفتوحة المصدر في Containers | جرب ARM | أغلب ال Images متعددة المعماريات والسعر غالباً أقل لنفس الأداء |
| برنامج تجاري مغلق لا يوجد له نسخة arm64 | ابق على x86-64 | تشغيله تحت المحاكاة على سيرفر ARM أبطأ بكثير ولا يدعمه صاحبه |
| خط CI يبني لـ arm64 ويأخذ وقتاً طويلاً | ترجمة متقاطعة أو جهاز بناء ARM | المحاكاة جعلت الترجمة عندنا ثلاثة أضعاف لملف واحد صغير |
| تشغيل نماذج لغة محلياً على جهاز شخصي | Mac بمعالج M وذاكرة كبيرة | الذاكرة الموحدة تعطي الرسومات أغلب الذاكرة |
| خادم منزلي صغير قليل الاستهلاك | Raspberry Pi 5 أو Mini PC | قارن الاستهلاك والسعر وتوفر ال Images قبل الشراء |
| تحتاج اختبار برنامج ARM على جهاز x86 دون أداء | المحاكاة عبر binfmt وQEMU | تكفي لاختبار صحة البناء ولا تصلح لقياس الأداء |
وإذا كنت تقارن الكلفة الكلية لسيرفر في السحابة أو في البيت فارجع إلى مقال كيف تختار خادماً افتراضياً VPS ومقال حساب تكلفة الكهرباء.
قائمة تحقق Checklist قبل نقل خدمة إلى ARM
- قرأت فهرس كل Image تستخدمها بالأمر
docker buildx imagetools inspectوتأكدت من وجودlinux/arm64. - بنيت Images الخاصة بك للمعماريتين بالخيار
--platform، ويفضل بالترجمة المتقاطعة. - تأكدت أن المكتبات التي فيها كود C في مشروعك لها ملفات جاهزة لـ arm64.
- شغلت تطبيقك على سيرفر ARM حقيقي، وليس تحت المحاكاة، وقست الأداء بضغط Load يشبه الواقع.
- قارنت الكلفة الشهرية لنفس الأداء وليس لنفس عدد الأنوية.
- تأكدت أن وكلاء المراقبة والنسخ الاحتياطي والحماية تعمل على ARM.
- جعلت خط CI يبني ويختبر النسختين في كل تغيير، حتى لا تكتشف المشكلة يوم النشر.
تدريب عملي
- اختر ثلاث Images تستخدمها في خادمك واقرأ فهرس كل واحدة بالأمر
imagetools inspect، واكتب المعماريات التي تدعمها. - ابن
bench.cبالطريقتين من ملفات المختبر، ثم غير الطريقة الأولى لتصبح على مرحلتين وقارن حجم ال Image مرة أخرى. - شغل
openssl speed -evp aes-128-gcmفي Container من arm64 ثم من amd64 على جهازك، وتوقع النسبة قبل أن ترى النتيجة.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- Arm لا تصنع معالجات، وإنما تبيع المعمارية أو تصميم النواة وتأخذ نسبة عن كل شريحة، ولذلك تجد معماريتها في الجوال والسيارة والسيرفر.
- ترخيص المعمارية يعطي حرية تصميم النواة كما تفعل Apple وQualcomm، وترخيص النواة يعطي تصميماً جاهزاً كما في Graviton وAmpere، والفرق بينهما كان قضية استمرت سنوات بين Arm وQualcomm.
- Cortex-M للمتحكمات، وCortex-R للزمن الحقيقي، وCortex-A للتطبيقات، وNeoverse للسيرفرات.
- Apple Silicon نقل Mac إلى ARM في 2020، والذاكرة الموحدة تجعل كل الأنوية تعمل على ذاكرة واحدة لا يمكن زيادتها بعد الشراء.
- Graviton وصل إلى الجيل الخامس بـ 192 نواة، وكل مزود سحابي كبير عنده معالج ARM، والبرنامج المبني لـ arm64 يعمل عليها كلها.
- الاسم الواحد في Docker يحمل نسخة لكل معمارية، والترجمة المتقاطعة أسرع وأنظف من البناء داخل المحاكي.
- المحاكاة على جهاز x86 كانت أبطأ بين خمس مرات وسبعين مرة حسب العمل، فهي للاختبار وليست لقياس الأداء.
وفي نفس مرحلة المعالجات نكمل بإذن الله إلى RISC-V، المعمارية المفتوحة التي لا يملكها أحد، ثم إلى المحاكاة والترجمة الثنائية لنفهم ما الذي يفعله QEMU وRosetta 2 بالضبط، ثم إلى قصة x86 وعائلات Intel وAMD:
 دليلRISC-V: المعمارية المفتوحة وهل تغير سوق المعالجات؟ما الذي يعنيه أن تكون معمارية المعالج مفتوحة، وكيف تقرأ امتدادات RISC-V وملفاتها التعريفية، مع مختبر يقلع Debian كاملاً على RISC-V داخل QEMU.
 دليلالمحاكاة Emulation والترجمة الثنائية: QEMU وRosetta 2نفتح محاكي QEMU ونرى كيف تتحول تعليمات ARM إلى تعليمات x86 ونقيس كلفة كل خطوة، ثم نقارن ذلك بما تفعله Rosetta 2 وWindows Prism.
 دليلقصة x86: من Intel 8086 إلى x86-64 الذي صممته AMDكيف وصلت معمارية معالج 16 بت من 1978 إلى أغلب سيرفرات اليوم، ولماذا ما زال معالجك يقلع كأنه 8086، مع قطاع إقلاع يصعد الأوضاع الثلاثة أمامك.
 دليلعائلات Intel وAMD: كيف تقرأ اسم المعالج وجيله؟نفك أسماء معالجات Intel وAMD من المصادر الرسمية، ثم نقرأ معالجاً حقيقياً بأدوات Windows وLinux ونفك هويته الرقمية التي لا تتغير مع الاسم.
 دليلكيف يعمل المعالج CPU من الداخل ولماذا يهمك ذلكنتابع تعليمة واحدة داخل نواة المعالج، ونرى لماذا يصبح نفس الكود أبطأ بعشر مرات عندما تغير ترتيب المرور على البيانات.
 دليلماذا يحدث عندما تشغل برنامج Hello World؟نتتبع برنامج C صغيراً من المحرر إلى الشاشة، فترى كل طبقة يمر بها في الجهاز حتى تظهر الجملة أمامك.
سجل التحديثات
- 16 نوفمبر 2026: كتابة المقال، وتنفيذ التجارب على Windows 11 مع معالج Intel Core i7-7700K وDocker Desktop بالإصدار 29.8.0 وbuildx 0.37.1: قراءة فهرس debian:trixie-slim، وتسجيل QEMU 10.0.4 عبر tonistiigi/binfmt، وبناء cs2-bench لـ amd64 وarm64 بالمحاكاة وبالترجمة المتقاطعة (GCC 14.2 من Debian 13)، وقياس bench.c وzstd 1.5.7 وOpenSSL 3.5.9 من Alpine 3.22، مع صورتين حقيقيتين من Wikimedia Commons ورسوم من عرب رووت.