

في مقال أنواع قواعد البيانات ذكرنا أن قواعد المستندات Document Databases تحفظ كل سجل كمستند JSON كامل بدل صفوف موزعة على جداول، وأن MongoDB أشهرها. والسؤال الذي يأتي بعد ذلك عملي جداً: متى يكون هذا الشكل أفضل من جدول في PostgreSQL أو MySQL، ومتى يتحول إلى مشكلة بعد سنة من الإنتاج؟ والمشكلة الحقيقية مع MongoDB ليست في تثبيته، فهو يعمل بأمر واحد، وإنما في تصميم المستندات، لأن الخطأ في التصميم لا يظهر في الأسبوع الأول، وإنما عندما يكبر مستند واحد حتى يرفضه السيرفر.
وسوف نناقش في هذا المقال ما يلي:
- نموذج المستندات Document Model، والتضمين Embedding أم الإشارة Referencing.
- الفهارس Indexes والتجميع Aggregation والمعاملات Transactions.
- مجموعة النسخ Replica Set والانتخاب عند توقف السيرفر الرئيسي.
- رخصة SSPL وماذا تعني لك إذا كنت تستضيف MongoDB بنفسك، وFerretDB كبديل مفتوح وما حالته اليوم.
- تجربة عملية: Replica Set بثلاثة سيرفرات، ومليون طلب، وانتقال تلقائي، ثم خطأ التصميم المشهور: المصفوفة التي تكبر بلا حد Unbounded Array، بأرقام حقيقية.
نموذج المستندات: الطلب كله في مكان واحد
في قاعدة علائقية Relational يكون الطلب الواحد صفاً في جدول الطلبات، ومنتجاته صفوفاً في جدول آخر، والعميل صفاً في جدول ثالث، وعندما تقرأ الطلب تجمعها بـ JOIN. أما في MongoDB فالطلب مستند واحد بصيغة BSON (وهي JSON ثنائي فيه أنواع إضافية مثل التاريخ والأرقام العشرية Decimal128)، وفيه المنتجات كمصفوفة، وقد يكون فيه جزء من بيانات العميل. والمستندات تحفظ في مجموعات Collections بدل الجداول، ولا يوجد مخطط Schema يفرضه السيرفر إلا إذا طلبت أنت ذلك بقواعد التحقق Schema Validation. والصورة التالية تبين الفرق:
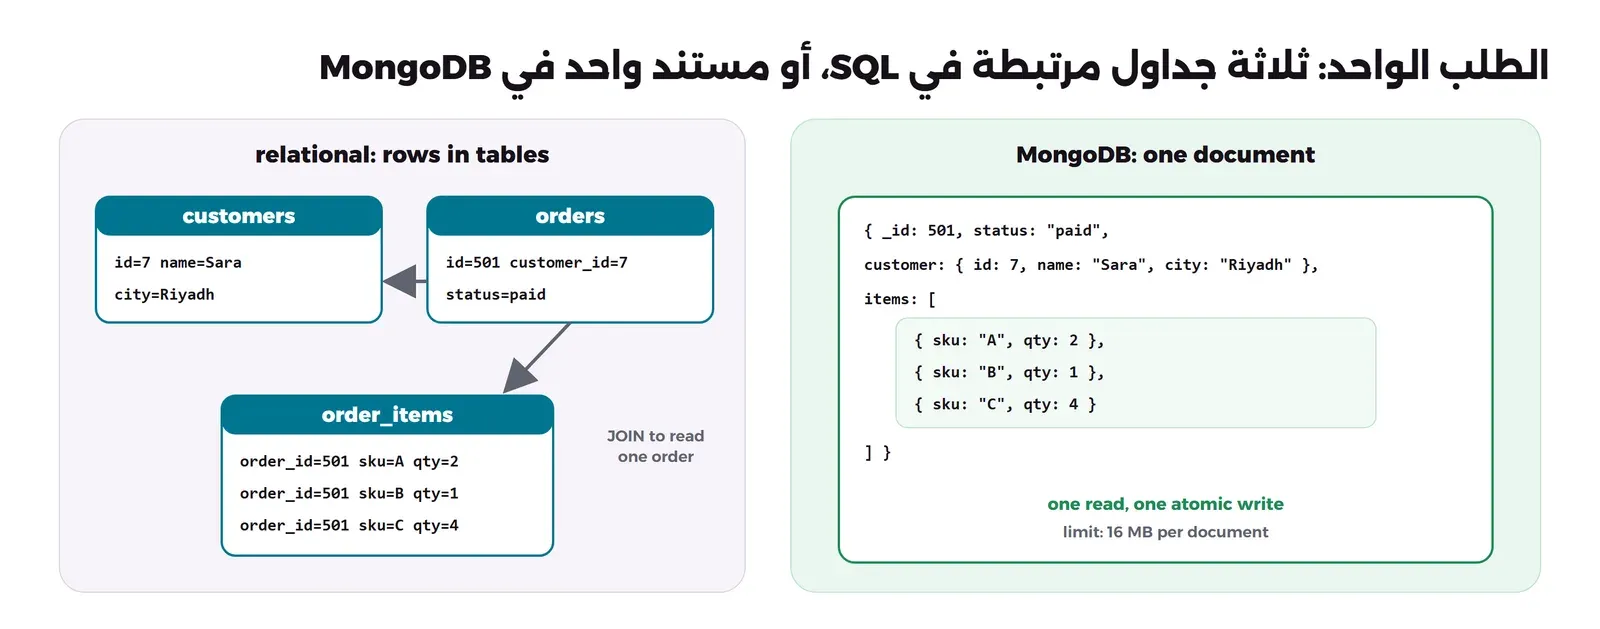
والفائدة هنا واضحة: قراءة واحدة تعطيك الطلب كله، وكتابة واحدة على المستند ذرية Atomic دائماً، فإما أن يتغير كله أو لا شيء، ولذلك يقول توثيق المعاملات نفسه إن التصميم الجيد للمستندات يقلل حاجتك للمعاملات على أكثر من مستند. وأما الثمن فهو أن نفس المعلومة قد تتكرر في أكثر من مستند (اسم العميل في كل طلب)، وأن السيرفر لا يمنعك من حفظ مستند ناقص أو بحقل مكتوب بشكل خاطئ إلا إذا أضفت قواعد التحقق، وأن للمستند الواحد حداً أقصى 16 MB بحسب صفحة الحدود، وهذا الحد بالذات هو موضوع الجزء الأخير من التجربة.
وقد يتساءل البعض: إذا كان PostgreSQL يحفظ JSON في عمود JSONB، فلماذا MongoDB أصلاً؟ والإجابة أن PostgreSQL يكفيك في حالات كثيرة كما بينا في قسم JSONB في مقال PostgreSQL لكل شيء، وMongoDB يتميز عندما يكون التطبيق كله مبنياً على مستندات تتغير حقولها كثيراً، ويحتاج التوزيع على عدة سيرفرات Sharding مدمجاً، وفريقك يكتب بالفعل بلغة المستندات.
التضمين Embedding أم الإشارة Referencing؟
هذا هو القرار الأهم في تصميم أي مجموعة، والتوثيق يشرح الطريقتين في صفحتي التضمين والإشارة:
- التضمين Embedding: تضع البيانات المرتبطة داخل المستند نفسه، مثل منتجات الطلب أو عنوان الشحن. ويناسبك عندما تقرأ البيانات معاً دائماً، وعندما يكون عددها محدوداً ومعروفاً (طلب فيه عشرات المنتجات وليس ملايين).
- الإشارة Referencing: تضع في المستند رقم المستند الآخر فقط، مثل
customer_id، وتقرأ الآخر باستعلام آخر أو بالمرحلة$lookup. ويناسبك عندما يكون الطرف الآخر كبيراً أو يتغير وحده أو يكبر بلا حد، مثل تعليقات منشور أو قراءات جهاز.
والقاعدة العملية سؤال واحد: هل لهذه المصفوفة حد أعلى تعرفه؟ إذا كانت الإجابة لا، فلا تقم بتضمينها، والسبب أن المستند سوف يكبر مع الوقت حتى يصل إلى 16 MB، وقبل ذلك بكثير سوف تصبح قراءته وكتابته أبطأ في كل مرة، وهذا ما يسميه التوثيق نمطاً سيئاً Anti-pattern في صفحة المصفوفات بلا حد Unbounded Arrays، وسوف نراه بالأرقام في التجربة.
الفهارس والتجميع Aggregation
الفهارس في MongoDB تعمل بنفس الفكرة التي شرحناها في مقال الفهارس: شجرة B-tree على حقل أو أكثر، وبدونها يقرأ السيرفر المجموعة كلها COLLSCAN، ومعها يقرأ الفهرس IXSCAN ثم المستندات المطابقة فقط. والفرق أنك تستطيع أن تفهرس حقلاً داخل مستند متداخل مثل customer.id أو حقلاً داخل مصفوفة، وأن الأمر explain("executionStats") يعطيك عدد المستندات التي قرأها السيرفر، وهو الرقم الذي تراقبه دائماً.
أما التقارير فتكتب بخط التجميع Aggregation Pipeline، وهو سلسلة مراحل كل واحدة تأخذ مخرج التي قبلها: $match للتصفية، و$group للتجميع، و$sort للترتيب، و$lookup للربط بمجموعة أخرى. ومن يعرف SQL سوف يجد أن $match هو WHERE و$group هو GROUP BY، مع فرق مهم: ضع $match في أول الخط دائماً، لأن الفهرس لا يستخدم إلا في المراحل الأولى.
المعاملات Transactions
كل كتابة على مستند واحد ذرية دائماً. وإذا احتجت أن تغير أكثر من مستند معاً، مثل إنقاص المخزون وإنشاء الطلب، فMongoDB يدعم المعاملات على أكثر من مستند منذ الإصدار 4.0 في Replica Set ومنذ 4.2 في العنقود الموزع Sharded Cluster، ولكن التوثيق يقول بوضوح إن المعاملة الموزعة أغلى من الكتابة على مستند واحد، وإنها ليست بديلاً عن التصميم الجيد. ولاحظ أن المعاملات تحتاج Replica Set ولا تعمل على سيرفر منفرد، وهذا أحد أسباب أن تجربتنا تبدأ بثلاثة سيرفرات حتى على جهاز واحد. وأما مشاكل الأقفال والتعارض بين المعاملات فشرحناها في مقال الأقفال.
مجموعة النسخ Replica Set
شرحنا أشكال العناقيد بشكل عام في مقال عناقيد قواعد البيانات، وMongoDB من القواعد التي يأتي فيها النسخ والانتقال مدمجين: ثلاثة سيرفرات (أو أكثر بعدد فردي)، واحد منها رئيسي Primary يستقبل الكتابة، والباقي ثانوية Secondary تنسخ سجل العمليات oplog منه. وعندما يتوقف الرئيسي يصوت الباقون وينتخبون رئيساً جديداً، والمكتبة Driver في التطبيق تكتشف ذلك وترسل الكتابة إلى الجديد، والتوثيق يقول إن الوقت المتوسط حتى ينتخب رئيس جديد لا يتجاوز في العادة 12 ثانية بالإعدادات الافتراضية، كما في صفحة الانتخاب. والصورة التالية تبين ما حدث في التجربة:
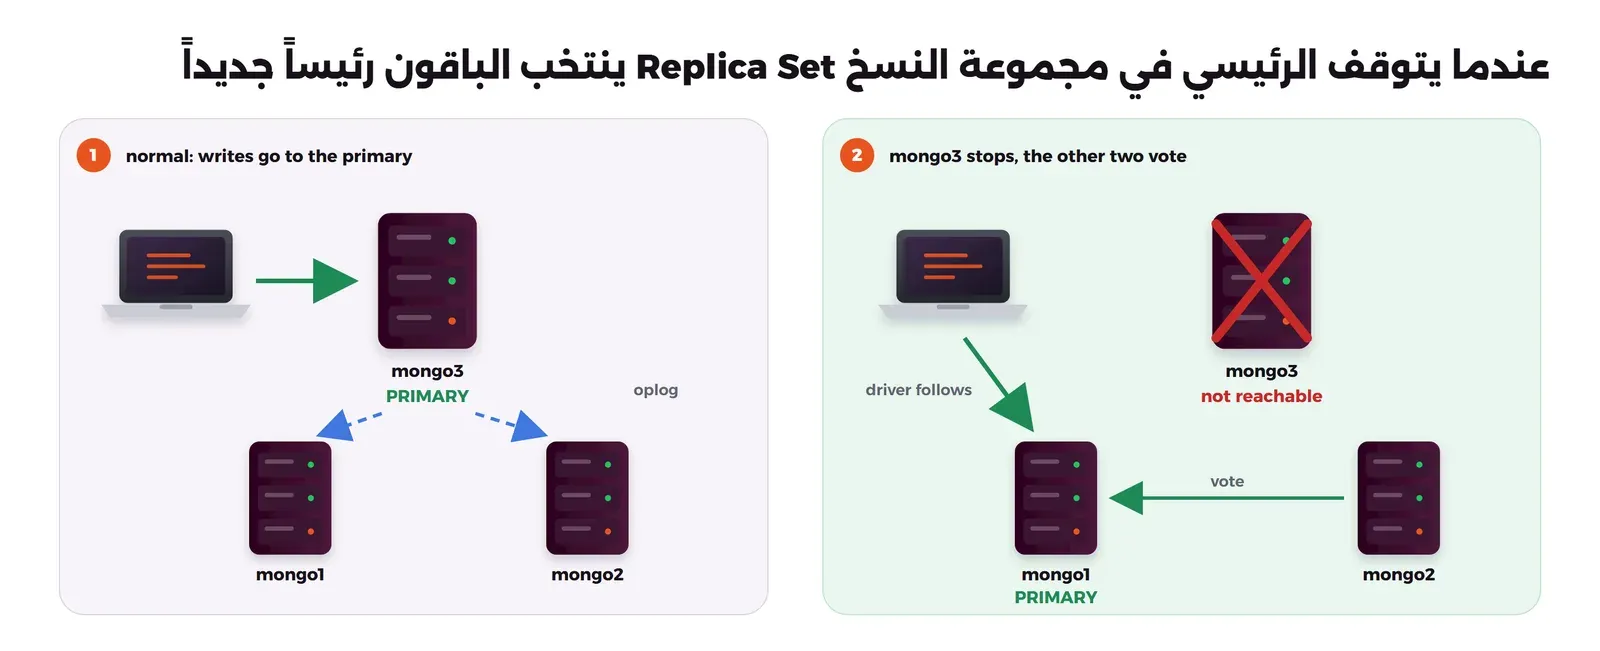
ولاحظ أن الكتابة الافتراضية Write Concern هي w: "majority" في أغلب الحالات بحسب صفحة Write Concern، أي أن السيرفر لا يؤكد الكتابة إلا بعد أن تصل إلى أغلب الأعضاء، ولذلك ما يؤكد لك لا يضيع عندما يتوقف الرئيسي. وإذا وضعت حكماً Arbiter بدل العضو الثالث فقد تتغير هذه القيمة الافتراضية إلى w: 1 كما في جدول الصفحة نفسها، فلا تقم بذلك إلا إذا كنت تعرف ما تخسره.
رخصة SSPL: ماذا تعني لمن يستضيف بنفسه؟
منذ 16 أكتوبر 2018 أصبح MongoDB Community Server تحت رخصة Server Side Public License بدل AGPL، والإصدارات التي قبل ذلك التاريخ بقيت تحت AGPL. والشرط الذي صنعت الرخصة من أجله هو القسم 13: إذا قدمت وظيفة MongoDB نفسها كخدمة للآخرين، أي MongoDB كخدمة مدارة، فعليك أن تنشر كود الخدمة كلها، من واجهات الإدارة إلى النسخ الاحتياطي والمراقبة والاستضافة. والسبب المعلن أن الشركات السحابية كانت تبيع MongoDB كخدمة دون أن تساهم فيه.
فهل يؤثر هذا عليك؟ بحسب نفس صفحة الأسئلة: إذا استخدمت MongoDB قاعدة بيانات لتطبيقك، حتى لو كان تطبيقاً تبيعه كخدمة SaaS، فلا يوجد عليك شرط القسم 13، واستخدامه داخل شركتك أو لشركاتك التابعة لا يعتبر تقديماً لطرف ثالث. ولكن هناك ثلاث نتائج عملية يجب أن تعرفها:
- منظمة OSI لا تعتبر SSPL رخصة مفتوحة المصدر كما في بيانها، ولذلك نصنفها في رخص المصدر المتاح.
- لن تجد حزمة
mongodb-serverفي مستودعات Debian، فالتثبيت يكون من مستودع MongoDB نفسه أو من ال Docker Image الرسمي، وأنت تعتمد على الشركة في التحديثات الأمنية. - إذا كانت شركتك تبيع استضافة قواعد بيانات لعملائها، فهذه بالضبط الحالة التي كتبت الرخصة من أجلها، واسأل محامياً قبل أن تبدأ.
FerretDB: بديل مفتوح، وما حالته اليوم؟
FerretDB مشروع تحت رخصة Apache 2.0 يستقبل اتصالات بروتوكول MongoDB ويحولها إلى أوامر على PostgreSQL، ومنذ الإصدار 2.0 يعتمد على إضافة DocumentDB، وهي إضافة تحت رخصة MIT بدأتها Microsoft ثم انضمت إلى Linux Foundation في 25 أغسطس 2025 بمشاركة شركات منها AWS وGoogle وSupabase. والفكرة جذابة: تطبيقك يتكلم بلغة MongoDB، والبيانات في PostgreSQL الذي تعرف نسخه ومراقبته.
أما الحالة اليوم كما رأيناها في المستودع في أكتوبر 2026: آخر إصدار من FerretDB هو 2.7.0 في 10 نوفمبر 2025، وبعده لا توجد في الفرع الرئيسي إلا تحديثات للمكتبات حتى فبراير 2026، أما DocumentDB نفسه فنشط جداً ووصل إلى الإصدار المرشح v1.0-RC2 في 9 أكتوبر 2026. لذلك إذا أردت هذا الطريق فراقب المشروعين قبل أن تعتمد عليه، وشغلنا عليه نفس سكربتات التجربة كما سوف ترى في قسم FerretDB في التجربة.
تجربة عملية: Replica Set ومليون طلب
سوف نشغل MongoDB 8.0.32 (الإصدار 8.0 مدعوم حتى أكتوبر 2029، وصدر 9.0 في نهاية سبتمبر 2026) بثلاثة أعضاء على Docker Engine 29.8.0، ونحمل نفس مليون طلب الذي حملناه في تجربة MySQL وMariaDB، ونشغل نفس الأسئلة، ثم نوقف الرئيسي، ثم نكسر التصميم عن قصد. والأرقام للتوضيح فقط على جهاز تطوير بثمانية أنوية و32 GB، وليست قياس أداء.
تشغيل الأعضاء الثلاثة
الملف compose.yaml:
# A three-member MongoDB replica set (ArabRoot lab). Only the first member is published, on 127.0.0.1.
#   docker compose -p lab-mongo up -d
name: lab-mongo
x-mongo: &mongo
  image: mongo:8.0.32
  command: ["mongod", "--replSet", "rs0", "--bind_ip_all"]
services:
  mongo1:
    <<: *mongo
    container_name: lab-mongo-1
    hostname: mongo1
    ports: ["127.0.0.1:27117:27017"]
    volumes: ["./:/lab:ro", "m1:/data/db"]
  mongo2:
    <<: *mongo
    container_name: lab-mongo-2
    hostname: mongo2
    volumes: ["m2:/data/db"]
  mongo3:
    <<: *mongo
    container_name: lab-mongo-3
    hostname: mongo3
    volumes: ["m3:/data/db"]
volumes:
  m1:
  m2:
m3:الآن نقوم بتشغيلها وربطها في مجموعة واحدة:
docker compose -p lab-mongo up -d
docker exec lab-mongo-1 mongosh --quiet --eval 'rs.initiate({_id:"rs0",members:[{_id:0,host:"mongo1:27017"},{_id:1,host:"mongo2:27017"},{_id:2,host:"mongo3:27017"}]})'
docker exec lab-mongo-1 mongosh --quiet --eval 'rs.status().members.map(m=>({name:m.name,state:m.stateStr}))'
والمخرج سوف يكون كما يلي:
[
  { name: 'mongo1:27017', state: 'SECONDARY' },
  { name: 'mongo2:27017', state: 'SECONDARY' },
  { name: 'mongo3:27017', state: 'PRIMARY' }
]
ولاحظ أن الرئيسي هنا mongo3 وليس الأول، فالانتخاب يقرر ذلك، ولهذا يتصل التطبيق دائماً بسلسلة اتصال فيها كل الأعضاء واسم المجموعة: mongodb://mongo1,mongo2,mongo3/shop?replicaSet=rs0، وليس بعنوان سيرفر واحد.
تحميل مليون طلب
نستخدم نفس المولد gen_orders.py من تجربة MySQL، ونحمل الملف بالأداة mongoimport مع تحديد نوع كل حقل:
python gen_orders.py
time docker exec lab-mongo-1 mongoimport --uri "mongodb://mongo1,mongo2,mongo3/shop?replicaSet=rs0" \
  --collection orders --type csv --columnsHaveTypes \
  --fields "_id.int64(),customer_id.int32(),country.string(),status.string(),amount.decimal(),created_at.date_go(2006-01-02 15:04:05)" \
  --file /lab/orders.csv --numInsertionWorkers 4
والمخرج:
2026-10-11T05:25:59.336+0000	1000000 document(s) imported successfully. 0 document(s) failed to import.

real	0m59.424s
نفس الأسئلة بلغة MongoDB
الملف queries.js يسأل نفس الأسئلة الثلاثة: المبيعات المدفوعة لكل دولة، وطلبات عميل واحد قبل الفهرس وبعده، وطلبات يوم واحد، ثم حجم المجموعة:
// The same three questions as the SQL labs, timed three times each (ArabRoot lab).
//   docker exec lab-mongo-1 mongosh --quiet "mongodb://mongo1,mongo2,mongo3/shop?replicaSet=rs0" /lab/queries.js
const t = (label, fn) => { for (let i = 0; i < 3; i++) { const s = Date.now(); fn(); print(`${label}: ${Date.now() - s} ms`); } };
const byCountry = () => db.orders.aggregate([
  { $match: { status: 'paid' } },
  { $group: { _id: '$country', orders: { $sum: 1 }, revenue: { $sum: '$amount' } } },
  { $sort: { revenue: -1 } }
]).toArray();
t('revenue by country', byCountry);
printjson(byCountry().slice(0, 3));
const one = () => db.orders.find({ customer_id: 4242 }).toArray();
const ex = (q) => { const e = db.orders.find(q).explain('executionStats'); return { stage: e.queryPlanner.winningPlan.stage === 'FETCH' ? 'FETCH+' + e.queryPlanner.winningPlan.inputStage.stage : e.queryPlanner.winningPlan.stage, docsExamined: e.executionStats.totalDocsExamined, ms: e.executionStats.executionTimeMillis }; };
print('before index:'); printjson(ex({ customer_id: 4242 }));
db.orders.createIndex({ customer_id: 1 }); db.orders.createIndex({ created_at: 1 });
print('after index:'); printjson(ex({ customer_id: 4242 }));
t('one customer', one);
t('one day', () => db.orders.countDocuments({ created_at: { $gte: ISODate('2025-07-01'), $lt: ISODate('2025-07-02') } }));
const s = db.orders.stats();
print(`count=${s.count} dataSize=${(s.size / 1048576).toFixed(0)}MB storageSize=${(s.storageSize / 1048576).toFixed(0)}MB indexes=${(s.totalIndexSize / 1048576).toFixed(0)}MB`);
والمخرج سوف يكون كما يلي (اختصرنا نتيجة التجميع إلى أول دولة):
revenue by country: 2472 ms
revenue by country: 2140 ms
revenue by country: 2252 ms
  { _id: 'SA', orders: 87916, revenue: Decimal128('39867208.77') },
before index:
{ stage: 'COLLSCAN', docsExamined: 1000000, ms: 1077 }
after index:
{ stage: 'FETCH+IXSCAN', docsExamined: 12, ms: 31 }
one customer: 4 ms
one customer: 14 ms
one customer: 3 ms
one day: 25 ms
one day: 20 ms
one day: 13 ms
count=1000000 dataSize=108MB storageSize=36MB indexes=46MB
في المخرج أعلاه لاحظ التالي:
- نتيجة التجميع مطابقة لـ MySQL وMariaDB حتى آخر هللة: 87916 طلباً و39867208.77 للسعودية، والسبب أننا حفظنا المبلغ كـ Decimal128 وليس كرقم عشري تقريبي Double.
- بدون فهرس قرأ السيرفر مليون مستند ليجد 12، وبالفهرس قرأ 12 فقط، وهذا هو الرقم
docsExaminedالذي تراقبه في كل استعلام بطيء. - حجم البيانات قبل الضغط 108 MB، وعلى القرص 36 MB فقط، والسبب أن محرك WiredTiger يضغط المجموعات افتراضياً بـ snappy كما في صفحة WiredTiger.
معاملة على مجموعتين
الملف transaction.js يشتري آخر قطعة في المخزون مرتين: الأولى يجب أن تنجح، والثانية يجب أن تلغى كلها دون أن يبقى طلب بلا مخزون:
// Two collections changed together or not at all (ArabRoot lab).
const s = db.getMongo().startSession();
const inv = s.getDatabase('shop').inventory, ord = s.getDatabase('shop').orders;
db.inventory.drop(); db.inventory.insertOne({ _id: 'sku-1', stock: 1 });
const buy = (id) => {
  s.startTransaction({ writeConcern: { w: 'majority' } });
  try {
    const r = inv.updateOne({ _id: 'sku-1', stock: { $gte: 1 } }, { $inc: { stock: -1 } });
    if (r.modifiedCount !== 1) throw new Error('out of stock');
    ord.insertOne({ _id: id, customer_id: 7, country: 'SA', status: 'paid', amount: NumberDecimal('50'), created_at: new Date() });
    s.commitTransaction(); print(`order ${id}: committed`);
  } catch (e) { s.abortTransaction(); print(`order ${id}: aborted (${e.message})`); }
};
buy(2000001); buy(2000002);
printjson({ stock: db.inventory.findOne().stock, order2000002: db.orders.countDocuments({ _id: 2000002 }) });
والمخرج:
order 2000001: committed
order 2000002: aborted (out of stock)
{
  stock: 0,
  order2000002: 0
}
نوقف الرئيسي
الآن نوقف mongo3 وهو الرئيسي، ونكتب كل بضع ثوان بنفس سلسلة الاتصال:
U="mongodb://mongo1,mongo2,mongo3/shop?replicaSet=rs0"
docker stop lab-mongo-3
for i in 1 2 3 4 5 6; do sleep 2; docker exec lab-mongo-1 mongosh --quiet $U --eval 'const s=Date.now(); db.orders.insertOne({_id: 3000000+'$i', status:"paid"}); print(new Date().toISOString().slice(11,19)+" insert ok, primary="+db.hello().primary+" ("+(Date.now()-s)+" ms)")'; done
docker exec lab-mongo-1 mongosh --quiet $U --eval 'rs.status().members.map(m=>m.name+" "+m.stateStr).join("\n")'
والمخرج سوف يكون كما يلي (توقف mongo3 الساعة 05:27:14 بتوقيت UTC):
05:27:18 insert ok, primary=mongo1:27017 (308 ms)
05:27:24 insert ok, primary=mongo1:27017 (47 ms)
05:27:33 insert ok, primary=mongo1:27017 (123 ms)
05:27:39 insert ok, primary=mongo1:27017 (145 ms)
05:27:46 insert ok, primary=mongo1:27017 (39 ms)
05:27:52 insert ok, primary=mongo1:27017 (26 ms)
mongo1:27017 PRIMARY
mongo2:27017 SECONDARY
mongo3:27017 (not reachable/healthy)
أول كتابة بعد أربع ثوان نجحت على الرئيسي الجديد mongo1. ولاحظ أن docker stop إيقاف مرتب، فالرئيسي يتنحى Step Down بنفسه قبل أن يتوقف، أما إذا انقطعت الكهرباء عنه فالأعضاء ينتظرون مهلة الانتخاب (10 ثوان افتراضياً) قبل أن يبدؤوا، ولذلك خطط لتطبيقك على أن الكتابة قد تتوقف عشر ثوان أو أكثر، والمكتبات الحديثة تعيد المحاولة مرة واحدة تلقائياً Retryable Writes.
نكسرها: تعليقات بلا حد داخل المنشور
لنفرض أن لدينا مدونة، وقمنا بالحل البسيط: كل منشور مستند، وتعليقاته مصفوفة داخله، فهذا يبدو منطقياً لأننا نعرض المنشور مع تعليقاته دائماً. والملف unbounded.js يضيف تعليقات بحجم 1 KB تقريباً إلى منشور واحد، ويقيس بعد كل دفعة حجم المستند، ووقت إضافة تعليق واحد، ووقت قراءة المنشور، ويفعل نفس الشيء مع التصميم الآخر: مجموعة مستقلة للتعليقات مع فهرس على post_id والوقت:
// Break it: comments embedded in one post document until the 16 MB limit, against comments in their own collection.
//   docker exec lab-mongo-1 mongosh --quiet "mongodb://mongo1,mongo2,mongo3/blog?replicaSet=rs0" /lab/unbounded.js
db.posts.drop(); db.comments.drop();
db.comments.createIndex({ post_id: 1, at: -1 });
const text = 'x'.repeat(1000);                       // a 1 KB comment
const comment = (i) => ({ user: 'user' + (i % 500), text, at: new Date(), likes: 0 });
db.posts.insertOne({ _id: 1, title: 'popular post', comments: [] });
const ms = (fn, n = 20) => { const s = Date.now(); for (let i = 0; i < n; i++) fn(); return ((Date.now() - s) / n).toFixed(1); };
let total = 0;
print('comments | post size | push 1 (ms) | read post (ms) | separate: insert 1 (ms) | separate: last 20 (ms)');
for (const target of [1000, 4000, 8000, 12000, 15000, 16000, 17000]) {
  const add = target - total, batch = [];
  for (let i = 0; i < add; i++) batch.push(comment(total + i));
  try { db.posts.updateOne({ _id: 1 }, { $push: { comments: { $each: batch } } }); }
  catch (e) { print(`${target}: push failed: ${e.codeName || ''} ${e.message.slice(0, 120)}`); break; }
  db.comments.insertMany(batch.map(c => ({ ...c, post_id: 1 })));
  total = target;
  const size = db.posts.aggregate([{ $match: { _id: 1 } }, { $project: { s: { $bsonSize: '$$ROOT' } } }]).next().s;
  const push1 = ms(() => db.posts.updateOne({ _id: 1 }, { $push: { comments: comment(0) } }), 5); total += 5;
  db.comments.insertMany([0, 1, 2, 3, 4].map(i => ({ ...comment(i), post_id: 1 })));
  const read = ms(() => db.posts.findOne({ _id: 1 }), 5);
  const ins = ms(() => db.comments.insertOne({ ...comment(0), post_id: 2 }), 5);
  const last = ms(() => db.comments.find({ post_id: 1 }).sort({ at: -1 }).limit(20).toArray(), 5);
  print(`${total} | ${(size / 1048576).toFixed(2)} MB | ${push1} | ${read} | ${ins} | ${last}`);
}
والمخرج سوف يكون كما يلي:
comments | post size | push 1 (ms) | read post (ms) | separate: insert 1 (ms) | separate: last 20 (ms)
1005 | 1.01 MB | 8.2 | 14.0 | 5.6 | 3.0
4005 | 4.05 MB | 24.4 | 65.8 | 8.0 | 3.6
8005 | 8.11 MB | 56.8 | 73.4 | 6.2 | 3.0
12005 | 12.16 MB | 64.2 | 151.4 | 6.0 | 3.8
15005 | 15.21 MB | 74.4 | 336.4 | 24.4 | 4.0
16000: push failed:  BSONObj size: 17009423 (0x1038B0F) is invalid. Size must be between 0 and 16793600(16MB) First element: _id: 1
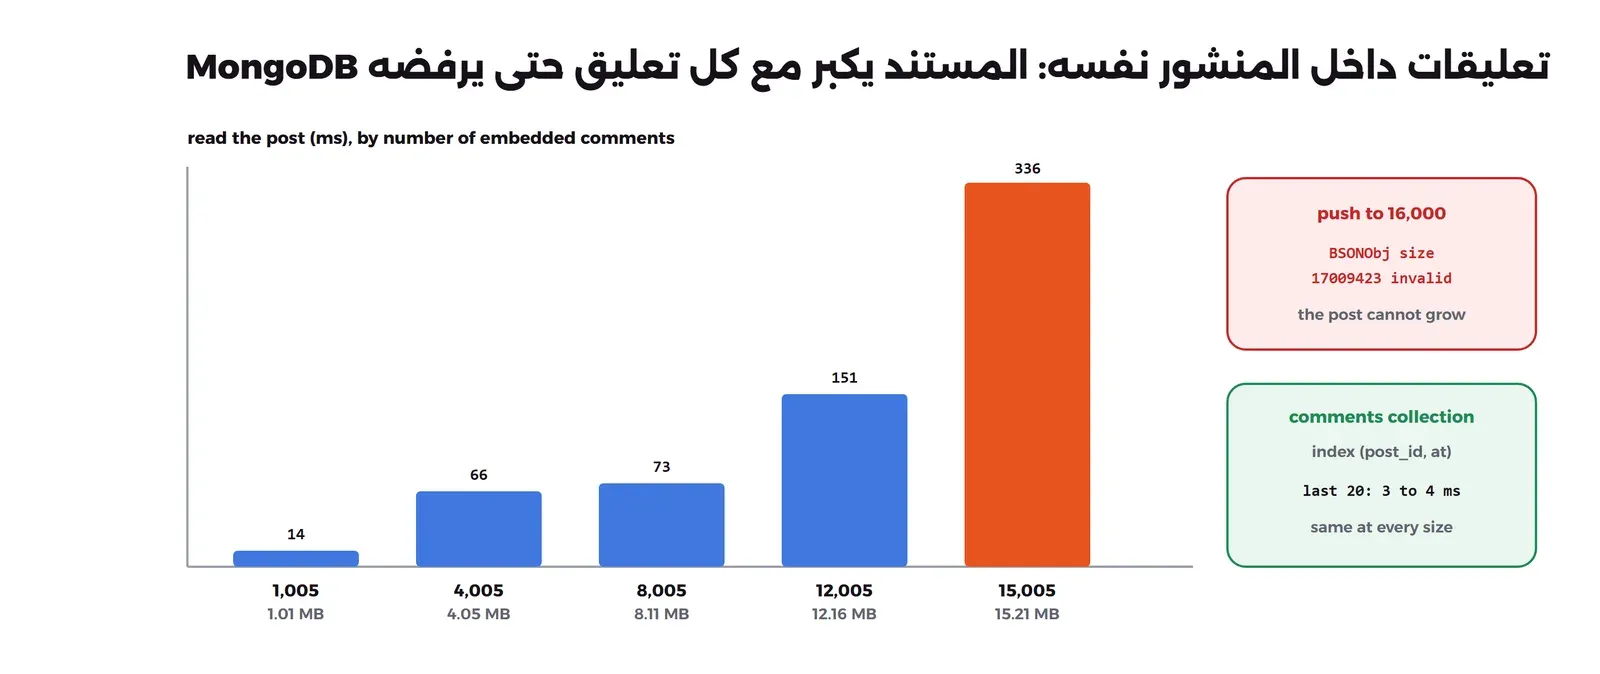
والصورة التالية تبين نفس الأرقام:
في المخرج أعلاه لاحظ التالي:
- قراءة المنشور كبرت من 14 ملي ثانية إلى 336، أي 24 ضعفاً، والسبب أن كل قراءة للمنشور تنقل كل التعليقات حتى لو كانت الصفحة تعرض آخر عشرين فقط.
- إضافة تعليق واحد كبرت من 8.2 إلى 74.4 ملي ثانية، أي أن الكتابة الصغيرة أصبحت أثقل كلما كبر المستند.
- عند الدفعة التي كانت سترفع المستند إلى 17009423 بايت رفض السيرفر الكتابة كلها، وهذا يعني في الإنتاج أن أشهر منشور عندك هو الذي يتوقف عن قبول التعليقات، وفي أسوأ وقت.
- في التصميم الثاني بقيت قراءة آخر عشرين تعليقاً بين 3 و4 ملي ثانية مهما كبر العدد، لأن الفهرس يقرأ عشرين مستنداً فقط.
والحل الصحيح إذن مجموعة مستقلة للتعليقات كما في التجربة، أو نمط المجموعة الجزئية Subset Pattern الذي تذكره صفحة المصفوفات بلا حد: تضع في المنشور عدداً صغيراً ثابتاً من التعليقات للعرض السريع، والباقي في مجموعة مستقلة، مع ثمن تكرار البيانات عند تعديلها.
نفس السكربتات على FerretDB
للمقارنة شغلنا FerretDB 2.7.0 على PostgreSQL 17 مع إضافة DocumentDB، وهو نفس الإعداد الموجود في توثيق FerretDB مع ربط المنفذ بالعنوان 127.0.0.1، وحملنا نفس مليون طلب بنفس أمر mongoimport:
# FerretDB 2 on PostgreSQL with the DocumentDB extension, to run the same scripts (ArabRoot lab).
#   docker compose -p lab-mongo-ferret -f compose-ferretdb.yaml up -d
name: lab-mongo-ferret
services:
  postgres:
    image: ghcr.io/ferretdb/postgres-documentdb:17-0.107.0-ferretdb-2.7.0
    container_name: lab-mongo-ferret-pg
    environment:
      POSTGRES_USER: lab
      POSTGRES_PASSWORD: lab-pass
      POSTGRES_DB: postgres
    volumes: ["pg:/var/lib/postgresql/data"]
  ferretdb:
    image: ghcr.io/ferretdb/ferretdb:2.7.0
    container_name: lab-mongo-ferret-app
    environment:
      FERRETDB_POSTGRESQL_URL: postgres://lab:lab-pass@postgres:5432/postgres
    ports: ["127.0.0.1:27217:27017"]
  tools:
    image: mongo:8.0.32
    container_name: lab-mongo-ferret-tools
    command: ["sleep", "infinity"]
    volumes: ["./:/lab:ro"]
volumes:
  pg:
والنتائج كانت كما يلي:
1000000 document(s) imported successfully. 0 document(s) failed to import.
real	0m28.966s
revenue by country: 1765 ms
revenue by country: 1894 ms
revenue by country: 1797 ms
one customer, no index: 855 ms
plan: Bitmap Heap Scan Bitmap Index Scan customer_id_1
one customer: 5 ms
one day: 19 ms
storageSize=166MB indexes=124MB
ولكن المعاملة من الملف transaction.js لم تعمل، والمخرج كان:
CommandNotFound 59 no such command: 'commitTransaction'في المخرج أعلاه لاحظ التالي:
- الاستعلامات العادية والتجميع والفهارس عملت دون أي تغيير في السكربت، والأمر
explainأعاد خطة PostgreSQL نفسها (Bitmap Index Scan) بدل خطة MongoDB، ولذلك تعطل الجزء منqueries.jsالذي يقرأ شكل خطة MongoDB. - المعاملات على أكثر من مستند غير مدعومة في هذا الإصدار، فإذا كان تطبيقك يعتمد عليها فFerretDB لا يناسبه اليوم.
- الحجم على القرص 166 MB للبيانات و124 MB للفهارس، مقابل 36 MB و46 MB في MongoDB مع الضغط.
حذف المختبر
docker compose -p lab-mongo down -v
docker compose -p lab-mongo-ferret -f compose-ferretdb.yaml down -v
rm orders.csv
النسخ الاحتياطي والمراقبة
- النسخ الاحتياطي: الأداة
mongodumpمع الخيار--oplogتعطيك نسخة متسقة من Replica Set، وهي مناسبة لقواعد صغيرة ومتوسطة، وللكبيرة خذ Snapshot من قرص عضو ثانوي. وفي كل الحالات طبق قاعدة 3-2-1 واختبار الاستعادة، فالعضوان الثانويان ليسا نسخة احتياطية، لأن الحذف بالخطأ ينسخ إليهما خلال ثانية. - الذاكرة: ذاكرة WiredTiger الافتراضية هي الأكبر بين 50% من (الذاكرة ناقص 1 GB) و256 MB، فإذا شغلت أكثر من عضو على نفس الجهاز كما في المختبر فحدد
--wiredTigerCacheSizeGBلكل واحد، والسبب أن كل عضو يحسب الذاكرة كأنه وحده. وفي التجربة استهلك كل عضو قرابة 0.9 إلى 1 GB بعد التحميل. - المراقبة: راقب تأخر الأعضاء الثانوية Replication Lag من
rs.printSecondaryReplicationInfo()، والاستعلامات البطيئة من سجل Profiler، وعددdocsExaminedفي الاستعلامات المهمة.
متى يناسبك MongoDB ومتى لا يناسبك؟
نقاط القوة: مستندات تطابق كائنات الكود دون طبقة تحويل، وحقول تتغير دون Migration، وReplica Set وانتقال تلقائي مدمجان ويعملان من أول يوم كما رأينا، وتوزيع على عدة سيرفرات Sharding مدمج عندما تحتاجه، وضغط جيد على القرص.
نقاط الضعف: الرخصة SSPL ليست مفتوحة المصدر ولا تجده في مستودعات التوزيعات، والعلاقات الكثيرة بين البيانات أصعب من SQL، والمعاملات موجودة ولكنها أغلى، والسيرفر لا يحمي شكل البيانات إلا إذا أضفت قواعد التحقق، وأخطاء التصميم مثل المصفوفة بلا حد لا تظهر إلا متأخراً.
- يناسبك: كتالوج منتجات بخصائص تختلف من منتج لآخر، ومحتوى وصفحات CMS، وبيانات أحداث وسجلات بأشكال متنوعة، وتطبيق فريقه يعرف MongoDB جيداً.
- لا يناسبك: نظام مالي أو محاسبي فيه علاقات ومعاملات كثيرة كما في مقال تصميم قواعد البيانات، وتقارير تحليلية ثقيلة (ClickHouse أنسب كما في مقال ClickHouse)، وأي حالة يكفيك فيها عمود JSONB في PostgreSQL الذي تشغله أصلاً.
والمقارنة الكاملة مع PostgreSQL وMySQL على نفس البيانات في مقال PostgreSQL أم MySQL أم MongoDB؟.
أخطاء شائعة
- مصفوفة بلا حد داخل مستند: تعليقات أو قراءات أو سجلات، والنتيجة رأيناها: قراءة أبطأ 24 مرة ثم رفض الكتابة عند 16 MB.
- سيرفر منفرد في الإنتاج: بلا انتقال تلقائي ولا معاملات، فابدأ بـ Replica Set من ثلاثة أعضاء حتى لو كانت البيانات صغيرة.
- الاتصال بعنوان عضو واحد: عندما يتغير الرئيسي يفشل التطبيق، فاستخدم سلسلة الاتصال بكل الأعضاء واسم المجموعة.
- تشغيل MongoDB دون مصادقة على منفذ مفتوح: قم بتفعيل المصادقة وملف المفتاح، واربط المنفذ بالشبكة الداخلية فقط.
- حفظ المبالغ كرقم Double: احفظها Decimal128 كما في التجربة، حتى تطابق المجاميع ما في نظام المحاسبة.
- اعتبار الأعضاء الثانوية نسخة احتياطية: الحذف ينسخ إليها فوراً.
الخلاصة
- MongoDB يحفظ كل سجل مستنداً كاملاً، والكتابة على المستند الواحد ذرية، والحد الأقصى للمستند 16 MB.
- ضع داخل المستند ما تقرؤه معاً وله حد معروف، واستخدم الإشارة لما يكبر بلا حد، وفي التجربة كبرت قراءة المنشور من 14 إلى 336 ملي ثانية ثم رفض السيرفر الكتابة عند قرابة 16 ألف تعليق، وبقيت المجموعة المستقلة بين 3 و4 ملي ثانية.
- على مليون طلب أعطى التجميع نفس أرقام MySQL، والفهرس خفض المستندات المقروءة من مليون إلى 12، والضغط جعل 108 MB على القرص 36 MB.
- Replica Set بثلاثة أعضاء انتخب رئيساً جديداً وكتبنا عليه بعد أربع ثوان من الإيقاف المرتب.
- SSPL لا تؤثر على استخدامه قاعدة بيانات لتطبيقك، ولكنها ليست رخصة مفتوحة، وFerretDB بديل مفتوح على PostgreSQL ما زال دون معاملات وتطويره بطيء منذ نهاية 2025.
 دليلأنواع قواعد البيانات ومتى تختار كل نوعالفرق بين قواعد البيانات العلائقية والمستندات والمفتاح والقيمة وغيرها، وأي الأسئلة تجيب عنها كل عائلة بسهولة.
 دليلPostgreSQL لكل شيء: متى يكفيك ومتى تحتاج غيره؟كم عملاً يستطيع PostgreSQL واحد أن يقوم به في شركتك الناشئة قبل أن تحتاج Redis أو Elasticsearch، وما الإشارة التي تقول لك إن الوقت قد حان.
 دليلعناقيد قواعد البيانات Database Clustering ومتى تحتاجهاماذا تعني كلمة Cluster في كل قاعدة بيانات، ومتى تحتاج نسخاً أو انتقالاً تلقائياً، ومتى يكفيك سيرفر واحد مع نسخ احتياطية جيدة.
 دليلPostgreSQL أم MySQL أم MongoDB؟مقارنة عادلة بين أشهر ثلاث قواعد بيانات على نفس البيانات، وأسئلة بسيطة تساعدك على اختيار ما يناسب مشروعك.
 دليلواجهات إدارة قواعد البيانات: pgAdmin وAdminer وCloudBeaverكيف تختار واجهة ويب لإدارة قاعدة بياناتك وتشغلها، ولماذا يجب ألا تصل إليها من الإنترنت إلا عبر باب واحد محمي.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، والتجربة على MongoDB 8.0.32 وFerretDB 2.7.0 مع postgres-documentdb 17-0.107.0 في Docker Engine 29.8.0، والمعلومات من توثيق MongoDB وصفحة أسئلة SSPL ومستودعي FerretDB وDocumentDB كما قرأناها في 11 أكتوبر 2026.