تبدأ مشروعك الأول بإطار عمل حديث، فتكتب كلاساً اسمه Order وفيه الحقول، وتكتب order.customer.name في القالب Template فيظهر اسم العميل، ولا تكتب سطراً واحداً من SQL، والصفحة تعمل بسرعة على جهازك وفيها عشرة طلبات تجريبية. وبعد ستة أشهر يصبح في الجدول عشرون ألف طلب، وتصبح صفحة «آخر الطلبات» تحتاج ثانية كاملة، وعندما تفتح سجل قاعدة البيانات تجد أن الصفحة الواحدة أرسلت 251 استعلاماً. ثم تقرأ في منتدى أن ال ORM هو سبب كل المشاكل وأن المحترفين يكتبون SQL بأيديهم، وتقرأ في منتدى آخر أن كتابة SQL يدوياً تضييع للوقت وخطر أمني. والحقيقة أن كلا الرأيين صحيح في حالات وخاطئ في غيرها، والمشكلة أن أغلب من يستخدم ORM لا يعرف ما الذي يرسله إلى قاعدة البيانات نيابة عنه.
وقد شرحنا في مقال تصميم قواعد البيانات مشكلة N+1 في فقرة واحدة، وكتبنا في خدمة Python الحقيقية الاستعلامات بأيدينا مع psycopg دون ORM، وهذا المقال يجيب عن السؤال الذي بينهما: كيف يتكلم تطبيقك مع قاعدة البيانات، وما الذي يفعله ال ORM فعلاً، ومتى يوفر عليك الوقت، ومتى تكتب SQL مباشرة.
وسوف نناقش في هذا المقال ما يلي:
- ما هو ال ORM ولماذا وجد، ومشكلة عدم التوافق بين الكائنات والجداول Object-Relational Impedance Mismatch.
- الطبقات الأربع بين كودك وقاعدة البيانات: من المكتبة المباشرة Driver إلى ال ORM الكامل، ونمطا Active Record وData Mapper.
- كيف يعمل ال ORM من الداخل: الجلسة Session، وخريطة الهوية Identity Map، ووحدة العمل Unit of Work، والتحميل الكسول Lazy Loading.
- تجربة عملية على متجر فيه 20 ألف طلب: نفس الصفحة بخمس طرق بين SQL مباشرة وSQLAlchemy، مع عد الاستعلامات من pg_stat_statements، وماذا يحدث عندما تكون قاعدة البيانات على سيرفر آخر.
- الإضافة الجماعية Bulk Insert والتقارير، حيث تكسب SQL المباشرة بفارق كبير.
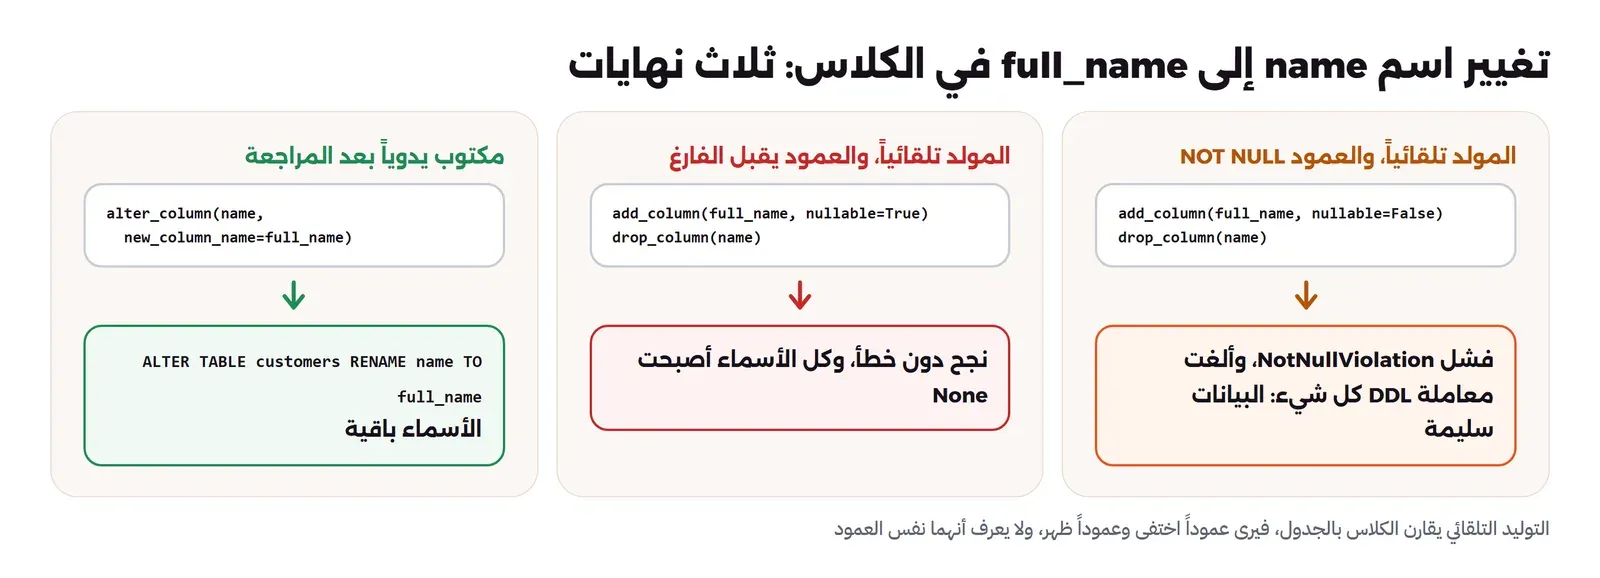
- الترحيل Migrations مع Alembic، وكيف حول توليد الترحيل التلقائي إعادة تسمية عمود إلى حذف بيانات.
ما هو الـ ORM؟ ولماذا وجد أصلاً؟
ال ORM اختصار Object-Relational Mapping، أي الربط بين الكائنات والجداول: مكتبة تأخذ صفوف قاعدة البيانات العلائقية وتحولها إلى كائنات Objects في لغتك، وتأخذ التغييرات على الكائنات وتحولها إلى جمل INSERT وUPDATE وDELETE. والتشبيه الأقرب أنه مترجم فوري بين شخصين يتكلم كل منهما لغة مختلفة: كودك يفكر بكائنات لها حقول ومراجع إلى كائنات أخرى وقوائم، وقاعدة البيانات تفكر بجداول وصفوف ومفاتيح أجنبية ومجموعات تختارها بشرط.
والمشكلة أن اللغتين لا تتطابقان، ولهذا اسم معروف هو عدم التوافق بين الكائنات والجداول Object-Relational Impedance Mismatch. فالكائن له هوية Identity في الذاكرة، والصف له مفتاح أساسي، وقد يكون في الذاكرة كائنان لنفس الصف. والكائن يصل إلى غيره بمرجع، مثل order.customer، والجدول يصل بمفتاح أجنبي وجملة JOIN. والكائن قد يرث من كلاس آخر، والجداول لا تعرف الوراثة. وأخطر فرق أن الكود يتنقل بين الكائنات واحداً واحداً، أما قاعدة البيانات فتعمل أفضل ما يكون عندما تطلب منها مجموعة كاملة في جملة واحدة. وقد كتب Ted Neward سنة 2006 مقالاً مشهوراً بعنوان The Vietnam of Computer Science شبه فيه محاولات حل هذه المشكلة بالكامل بالحرب التي يدخلها الطرف بهدف واضح ثم يغرق فيها خطوة بعد خطوة، ورد عليه Martin Fowler سنة 2012 في مقال OrmHate بأن ال ORM يحل جزءاً كبيراً من العمل المتكرر، وأن المشكلة في من يتوقع منه أن يخفي قاعدة البيانات تماماً.
وقد يتساءل البعض: إذا كانت المشكلة صعبة إلى هذا الحد، فلماذا يستخدم أغلب المطورين ORM؟ والإجابة أنه يوفر أشياء حقيقية: يكتب عنك الجمل المتكررة لإضافة وتعديل كل جدول، ويمرر القيم كمعاملات Parameters فيحميك من حقن SQL Injection، ويحول الأنواع بين اللغة وقاعدة البيانات مثل التواريخ والأرقام العشرية، ويتابع ما تغير في الكائنات فيرسل التعديل المطلوب فقط، ويعطيك مكاناً واحداً تصف فيه الجداول تبنى منه الترحيلات Migrations. والسؤال الصحيح ليس «ORM أم لا»، وإنما «أين يتوقف دوره وأين تأخذ أنت القرار».
من SQL مباشرة إلى ORM كامل: أربع طبقات
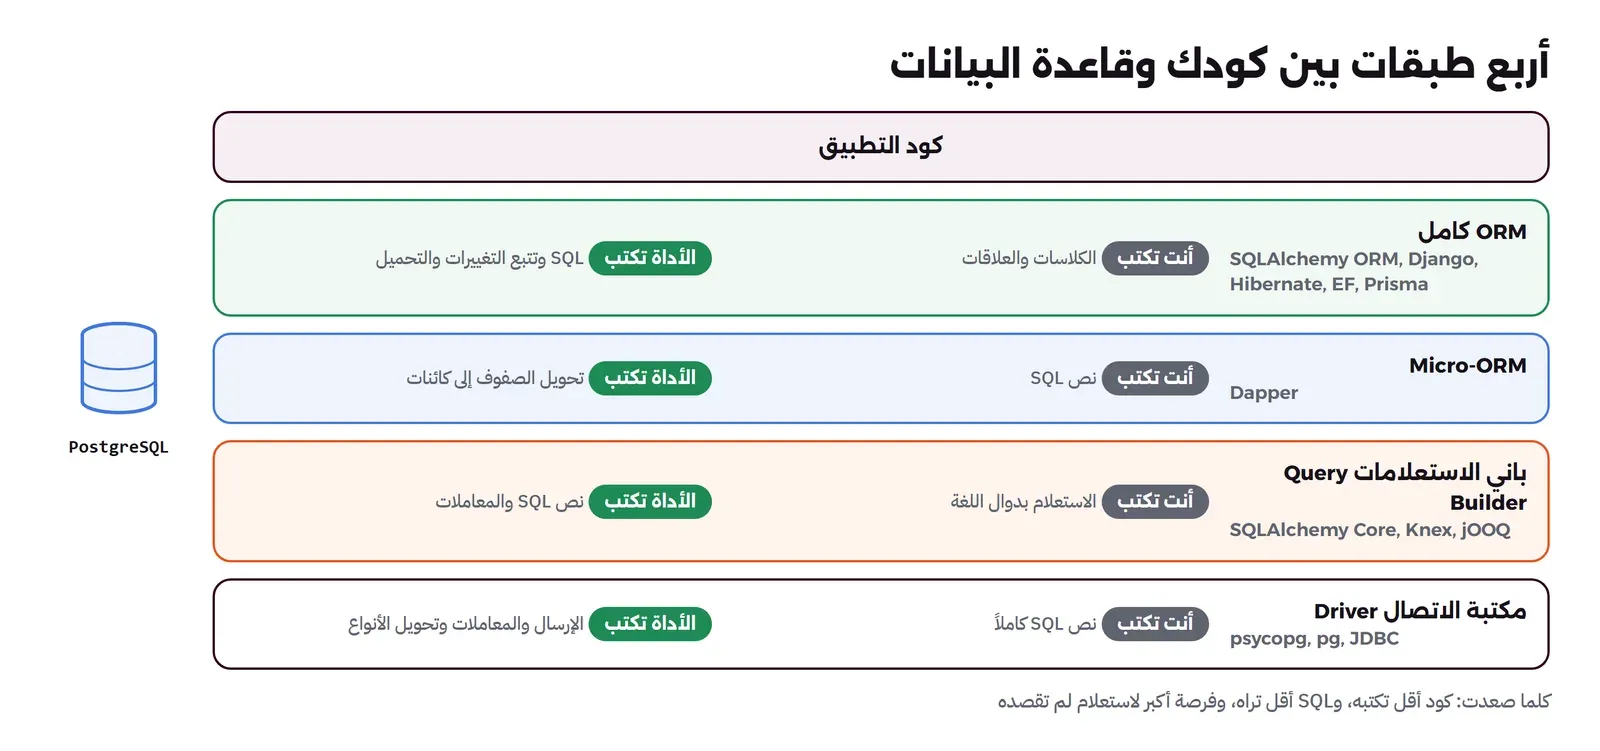
الكلام عن «ORM أم SQL» يخفي أن بينهما درجات، وكل لغة فيها أدوات من كل درجة:
- مكتبة الاتصال المباشرة Driver: ترسل نص SQL الذي كتبته، وتعيد الصفوف كقوائم أو قواميس. مثل psycopg في Python، وpg في Node.js، وJDBC في Java. أنت تكتب كل شيء، وترى كل شيء.
- باني الاستعلامات Query Builder: تكتب الاستعلام بدوال اللغة بدلاً من النص، فيبني الجملة ويمرر المعاملات، ولكنه لا يعرف شيئاً عن الكائنات. مثل SQLAlchemy Core وKnex وjOOQ.
- ال Micro-ORM: تكتب SQL بنفسك، وهو يحول الصفوف إلى كائنات فقط، دون علاقات ولا تتبع تغييرات. وأشهرها Dapper في .NET، وسوف نرى قصته بعد قليل.
- ال ORM الكامل: يصف الجداول والعلاقات ككلاسات، ويولد SQL، ويتابع التغييرات، ويحمل العلاقات عند الحاجة. مثل Hibernate وEntity Framework وDjango ORM وActive Record في Rails وSQLAlchemy ORM وPrisma.
وكلما صعدت في هذه الطبقات كتبت كوداً أقل، ورأيت SQL أقل، وزادت فرصة أن يحدث شيء لم تقصده. والصورة التالية تبين الطبقات وما يأخذه كل منها عنك:
نمط Active Record أم نمط Data Mapper؟
وصف Martin Fowler في كتاب Patterns of Enterprise Application Architecture سنة 2002 الطريقتين اللتين بنيت عليهما أغلب أدوات ORM. ففي نمط Active Record يعرف الكائن نفسه كيف يحفظ نفسه، فتكتب order.save()، والكلاس يمثل الجدول والكائن يمثل الصف، وهذا هو أسلوب Rails وDjango وLaravel Eloquent، وهو سريع في البداية ومناسب عندما يشبه منطقك الجداول. وفي نمط Data Mapper يكون الكائن عادياً لا يعرف شيئاً عن قاعدة البيانات، وطبقة منفصلة هي التي تقرأ وتكتب، فتضيف الكائن إلى جلسة Session وتؤكد الجلسة، وهذا هو أسلوب SQLAlchemy ORM وHibernate وEntity Framework. والفرق ليس شكلياً، فالنمط الثاني يجعل اختبار منطق العمل دون قاعدة بيانات أسهل، ويناسب ما شرحناه في مقال الاقتران والتماسك عن إخفاء القرارات خلف حدود واضحة، ولكنه يحتاج أن تفهم مفهوماً جديداً هو الجلسة.
كيف يعمل ال ORM من الداخل؟
سوف نستخدم SQLAlchemy 2 مثالاً لأنه يعرض الطبقات بوضوح، ولكن المفاهيم نفسها موجودة في Hibernate وEntity Framework بأسماء قريبة، وهي أربعة.
الربط Mapping: الكلاس يصف الجدول
تكتب كلاساً لكل جدول، وتصف كل عمود بنوعه وقيوده، وكل علاقة بالجدول الآخر. ومن هذا الوصف يعرف ال ORM كيف يبني جملة SELECT، وكيف يحول كل صف إلى كائن، وكيف ينشئ الجداول نفسها. والعلاقة مثل Order.customer ليست عموداً في الجدول، وإنما وصف لكيفية الوصول إلى الصف الآخر عبر المفتاح الأجنبي customer_id.
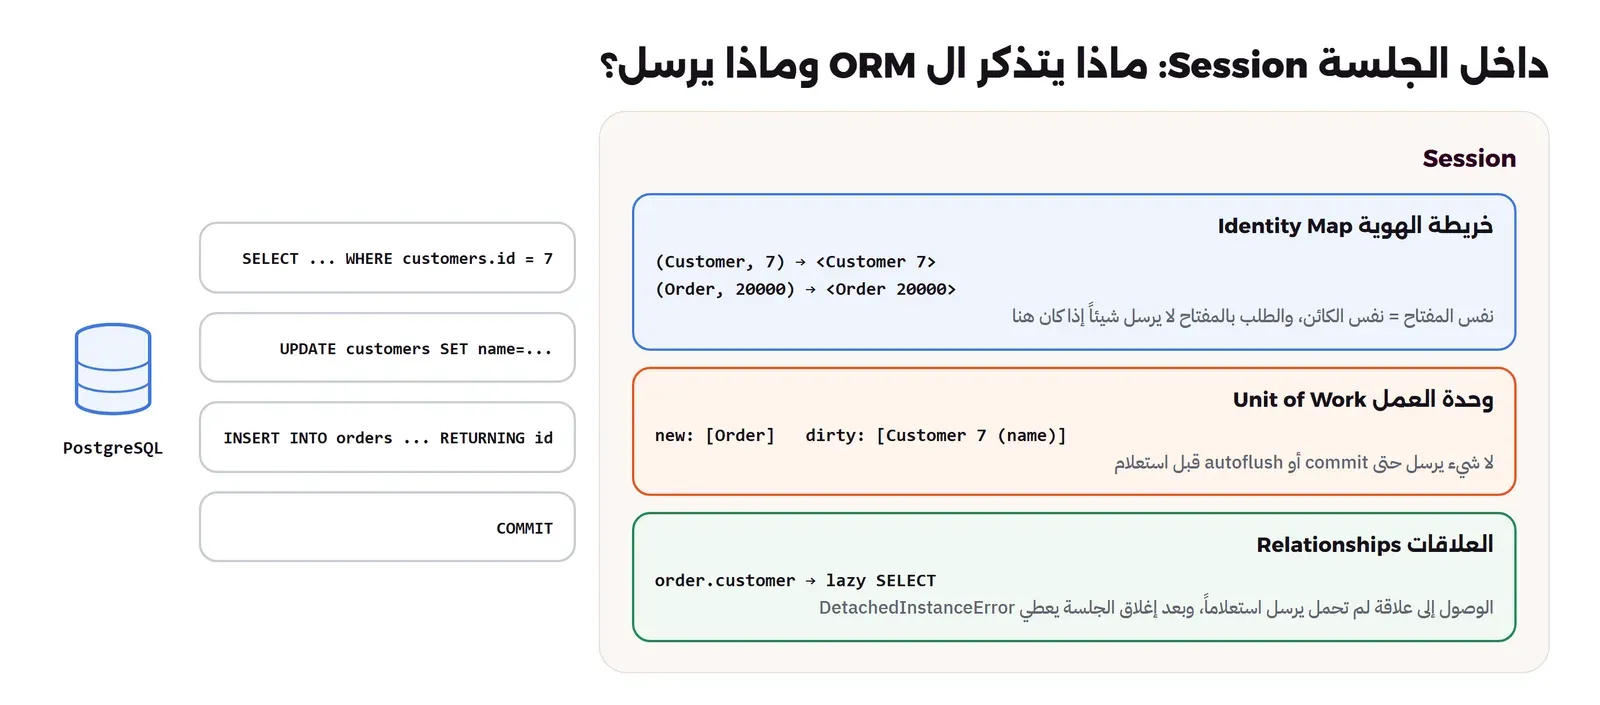
خريطة الهوية Identity Map
داخل الجلسة الواحدة يحتفظ ال ORM بقاموس من المفتاح الأساسي إلى الكائن، وهذا هو نمط Identity Map. فإذا طلبت العميل رقم 7 مرتين حصلت على نفس الكائن في الذاكرة، وإذا طلبته بالمفتاح الأساسي وهو موجود في القاموس فلن يرسل أي استعلام. وهذا يمنع أن يكون في الذاكرة نسختان من نفس الصف بقيمتين مختلفتين، ويوفر استعلامات، ولكنه يعني أيضاً أن الجلسة الطويلة قد تعطيك بيانات قديمة لم تقرأها من قاعدة البيانات منذ فترة.
وحدة العمل Unit of Work
عندما تغير حقلاً في كائن، لا يرسل ال ORM شيئاً فوراً، وإنما يسجل أن الكائن تغير، وعندما تؤكد الجلسة يحسب كل التغييرات ويرسلها بالترتيب الصحيح داخل معاملة واحدة، فيضيف العميل قبل طلبه لأن الطلب يحتاج مفتاحه. وهذا هو نمط Unit of Work. ومعه سلوك يفاجئ الكثيرين اسمه الإرسال التلقائي Autoflush: إذا نفذت استعلاماً والجلسة فيها تغييرات لم ترسل، أرسلها ال ORM أولاً حتى يرى الاستعلام بياناتك الجديدة.
التحميل الكسول Lazy Loading والتحميل المسبق Eager Loading
عندما تقرأ طلباً لا يحمل ال ORM عميله وأصنافه معه، وإنما ينتظر حتى تكتب order.customer، ثم يرسل استعلاماً في تلك اللحظة، وهذا هو التحميل الكسول، وهو الافتراضي في SQLAlchemy وDjango وRails وHibernate لأغلب العلاقات. وهو مريح لأنك لا تحمل ما لا تحتاجه، ولكنه يخفي الاستعلام داخل سطر يبدو كقراءة حقل عادي، فإذا كان السطر داخل حلقة على خمسين طلباً أصبح خمسين استعلاماً. والبديل هو التحميل المسبق Eager Loading: أن تخبر ال ORM مسبقاً أنك سوف تحتاج العلاقة، فيحملها مع الاستعلام الأول بجملة JOIN، أو باستعلام ثان واحد لكل الطلبات. والصورة التالية تبين أين تقع هذه المفاهيم:
تجربة عملية Lab: متجر فيه 20 ألف طلب
سوف نبني متجراً صغيراً على PostgreSQL 18.6 فيه 2000 عميل و300 منتج و20 ألف طلب و60 ألف صنف في الطلبات، ونكتب نفس الصفحة بخمس طرق، ثم نقيس ما يصل إلى قاعدة البيانات بإضافة pg_stat_statements التي تسجل كل استعلام وعدد مرات تنفيذه ووقته داخل قاعدة البيانات. وكل الملفات في مجلد lab مع المقال.
التجهيز Setup
docker network create sw2-net
docker run -d --name sw2-pgorm --network sw2-net -e POSTGRES_PASSWORD=lab -e POSTGRES_DB=shop postgres:18.6 \
  -c shared_preload_libraries=pg_stat_statements -c pg_stat_statements.track=all
docker exec sw2-pgorm psql -U postgres -d shop -c "CREATE EXTENSION pg_stat_statements"
docker build -t sw2-orm:lab .
FROM python:3.13.18-slim
RUN apt-get update && apt-get install -y --no-install-recommends iproute2 && rm -rf /var/lib/apt/lists/* \
&& pip install --no-cache-dir "psycopg[binary]==3.3.6" SQLAlchemy==2.1.9 alembic==1.20.1
WORKDIR /labوالجداول موصوفة ككلاسات في الملف models.py بأسلوب SQLAlchemy 2 الذي يكتب نوع كل حقل بـ Mapped[...]:
"""The shop schema as SQLAlchemy 2 ORM classes (Data Mapper style)."""
import os
from datetime import datetime
from decimal import Decimal

from sqlalchemy import ForeignKey, Numeric, String, create_engine
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column, relationship

DB_HOST = os.environ.get("DB_HOST", "sw2-pgorm")      # sw2-proxy:5433 adds network latency
DB_URL = f"postgresql+psycopg://postgres:lab@{DB_HOST}/shop"


class Base(DeclarativeBase):
    pass


class Customer(Base):
    __tablename__ = "customers"
    id: Mapped[int] = mapped_column(primary_key=True)
    name: Mapped[str] = mapped_column(String(80))
    email: Mapped[str] = mapped_column(String(120), unique=True)
    orders: Mapped[list["Order"]] = relationship(back_populates="customer")


class Product(Base):
    __tablename__ = "products"
    id: Mapped[int] = mapped_column(primary_key=True)
    name: Mapped[str] = mapped_column(String(80))
    price: Mapped[Decimal] = mapped_column(Numeric(10, 2))


class Order(Base):
    __tablename__ = "orders"
    id: Mapped[int] = mapped_column(primary_key=True)
    customer_id: Mapped[int] = mapped_column(ForeignKey("customers.id"), index=True)
    created_at: Mapped[datetime]
    status: Mapped[str] = mapped_column(String(20), default="new")
    customer: Mapped[Customer] = relationship(back_populates="orders")
    items: Mapped[list["OrderItem"]] = relationship(back_populates="order")


class OrderItem(Base):
    __tablename__ = "order_items"
    id: Mapped[int] = mapped_column(primary_key=True)
    order_id: Mapped[int] = mapped_column(ForeignKey("orders.id"), index=True)
    product_id: Mapped[int] = mapped_column(ForeignKey("products.id"))
    qty: Mapped[int]
    unit_price: Mapped[Decimal] = mapped_column(Numeric(10, 2))
    order: Mapped[Order] = relationship(back_populates="items")
    product: Mapped[Product] = relationship()


def engine(echo=False):
    return create_engine(DB_URL, echo=echo)
ثم ننشئ الجداول من هذه الكلاسات بالسكربت setup.py مع echo=True الذي يطبع كل جملة يرسلها ال ORM، ونملؤها بالملف seed.sql عبر psql:
docker run --rm --network sw2-net -v "$PWD:/lab" sw2-orm:lab python setup.py
docker exec -i sw2-pgorm psql -U postgres -d shop < seed.sql
وهذا جزء من مخرج setup.py لجدول الطلبات:
CREATE TABLE orders (
	id SERIAL NOT NULL,
	customer_id INTEGER NOT NULL,
	created_at TIMESTAMP WITHOUT TIME ZONE NOT NULL,
	status VARCHAR(20) NOT NULL,
	PRIMARY KEY (id),
	FOREIGN KEY(customer_id) REFERENCES customers (id)
)
2026-11-18 09:31:13,982 INFO sqlalchemy.engine.Engine CREATE INDEX ix_orders_customer_id ON orders (customer_id)
لاحظ أن ال ORM حول Mapped[int] مع primary_key=True إلى SERIAL، وأن كل حقل بلا | None أصبح NOT NULL، وأن index=True على المفتاح الأجنبي أنشأ فهرساً، وهذا مهم، لأن PostgreSQL لا ينشئ فهرساً على المفتاح الأجنبي تلقائياً، وبدونه سوف يقرأ كل تحميل لعميل أو أصناف الجدول كله. ولاحظ أيضاً أن العمود created_at لا فهرس عليه، وسوف نعود إلى ذلك.
وأول تشغيل لملء البيانات من داخل Python بالدالة exec_driver_sql فشل بالخطأ incomplete placeholder: '%'، لأن psycopg يعتبر علامة % في نص الجملة بداية معامل، وفي ملف البيانات العملية % لباقي القسمة. والحل إما أن تكتب %%، أو كما فعلنا أن ترسل الملف عبر psql، وهي مشكلة صغيرة ولكنها تذكير بأن كل طبقة بينك وبين قاعدة البيانات لها قواعدها.
ما الذي تفعله الجلسة Session؟
السكربت session_demo.py يجرب المفاهيم الأربعة السابقة ويطبع كل جملة SQL ترسل:
"""What the Session does for you: identity map, unit of work, autoflush, and the detached object."""
import logging, sys

from sqlalchemy import func, select
from sqlalchemy.orm import Session

from models import Customer, Order, engine

eng = engine()
with eng.connect():                     # connect once quietly (version checks)
    pass
logging.basicConfig(format="   SQL> %(message)s", stream=sys.stdout)
logging.getLogger("sqlalchemy.engine").setLevel(logging.INFO)

print("1) identity map: the same row is the same object")
with Session(eng) as s:
    a = s.get(Customer, 7)
    b = s.scalars(select(Customer).where(Customer.email == "[email protected]")).one()
    c = s.get(Customer, 7)                       # already in the map: no SQL at all
    print("   a is b:", a is b, "| a is c:", a is c)

print("2) unit of work: changes wait in the session until commit")
with Session(eng) as s:
    cust = s.get(Customer, 7)
    cust.name = "Customer Seven"
    s.add(Order(customer=cust, created_at=func.now(), status="new"))
    print("   pending:", len(s.new), "new,", len(s.dirty), "dirty")
    s.commit()

print("3) autoflush: a query sends your pending changes first")
with Session(eng) as s:
    s.get(Customer, 8).name = "Customer Eight"
    n = s.scalar(select(func.count()).select_from(Customer).where(Customer.name.like("% Eight")))
    print("   count:", n)
    s.rollback()

print("4) the object outlives its session")
logging.getLogger("sqlalchemy.engine").setLevel(logging.WARNING)
with Session(eng) as s:
    order = s.get(Order, 20000)
try:
    print(len(order.items))
except Exception as e:
    print("  ", type(e).__name__ + ":", e)
والمخرج سوف يكون كما يلي:
1) identity map: the same row is the same object
   SQL> BEGIN (implicit)
   SQL> SELECT customers.id, customers.name, customers.email
FROM customers
WHERE customers.id = %(pk_1)s::INTEGER
   SQL> [generated in 0.00035s] {'pk_1': 7}
   SQL> SELECT customers.id, customers.name, customers.email
FROM customers
WHERE customers.email = %(email_1)s::VARCHAR
   SQL> [generated in 0.00044s] {'email_1': '[email protected]'}
   a is b: True | a is c: True
   SQL> ROLLBACK
2) unit of work: changes wait in the session until commit
   SQL> BEGIN (implicit)
   SQL> SELECT customers.id, customers.name, customers.email
FROM customers
WHERE customers.id = %(pk_1)s::INTEGER
   SQL> [cached since 0.02556s ago] {'pk_1': 7}
   pending: 1 new, 1 dirty
   SQL> UPDATE customers SET name=%(name)s::VARCHAR WHERE customers.id = %(customers_id)s::INTEGER
   SQL> [generated in 0.00029s] {'name': 'Customer Seven', 'customers_id': 7}
   SQL> INSERT INTO orders (customer_id, created_at, status) VALUES (%(customer_id)s::INTEGER, now(), %(status)s::VARCHAR) RETURNING orders.id
   SQL> [generated in 0.00030s] {'customer_id': 7, 'status': 'new'}
   SQL> COMMIT
3) autoflush: a query sends your pending changes first
   SQL> BEGIN (implicit)
   SQL> SELECT customers.id, customers.name, customers.email
FROM customers
WHERE customers.id = %(pk_1)s::INTEGER
   SQL> [cached since 0.05625s ago] {'pk_1': 8}
   SQL> UPDATE customers SET name=%(name)s::VARCHAR WHERE customers.id = %(customers_id)s::INTEGER
   SQL> [cached since 0.02933s ago] {'name': 'Customer Eight', 'customers_id': 8}
   SQL> SELECT count(*) AS count_1
FROM customers
WHERE customers.name LIKE %(name_1)s::VARCHAR
   SQL> [generated in 0.00033s] {'name_1': '% Eight'}
   count: 1
   SQL> ROLLBACK
4) the object outlives its session
   DetachedInstanceError: Parent instance <Order at 0x7fd2aab5f390> is not bound to a Session; lazy load operation of attribute 'items' cannot proceed (Background on this error at: https://sqlalche.me/e/21/bhk3)
في المخرج أعلاه لاحظ التالي:
- في الجزء الأول طلبنا العميل 7 ثلاث مرات، بالمفتاح ثم بالبريد ثم بالمفتاح، فأرسل ال ORM استعلامين فقط، والثلاثة نفس الكائن. فالاستعلام بالبريد ذهب إلى قاعدة البيانات لأن ال ORM لا يعرف مسبقاً أي صف يطابق البريد، ولكنه عندما وصل الصف وجده في الخريطة فأعطاك نفس الكائن، أما الطلب الثالث بالمفتاح فلم يرسل شيئاً.
- في الجزء الثاني لم يرسل تغيير الاسم ولا إضافة الطلب أي جملة حتى
commit، ثم أرسلهما بالترتيب داخل معاملة واحدة، ولاحظ أن UPDATE فيه عمودnameفقط، أي ما تغير فعلاً، وأن INSERT انتهى بـRETURNING orders.idليعرف المفتاح الذي أنشأته قاعدة البيانات. - في الجزء الثالث أرسل الاستعلام
countتغيير الاسم قبله تلقائياً، وهذا هو Autoflush، ثم ألغينا كل شيء بـrollback. وهذا السلوك مفيد عادة، ولكنه قد يرسل تعديلاً لم يكتمل بعد فيخالف قيداً في مكان لا تتوقعه. - في الجزء الرابع أغلقنا الجلسة ثم طلبنا أصناف الطلب، فرفض ال ORM بالخطأ
DetachedInstanceError، لأن الكائن لم يعد مرتبطاً بجلسة يمكنها أن ترسل استعلام التحميل الكسول. وهذا من أكثر الأخطاء شيوعاً في تطبيقات الويب، عندما تغلق الدالة جلستها وتعيد الكائن إلى القالب أو إلى طبقة أخرى، والحل أن تحمل ما تحتاجه مسبقاً قبل أن تغلق الجلسة، أو أن تعيد بيانات جاهزة وليس كائنات ORM.
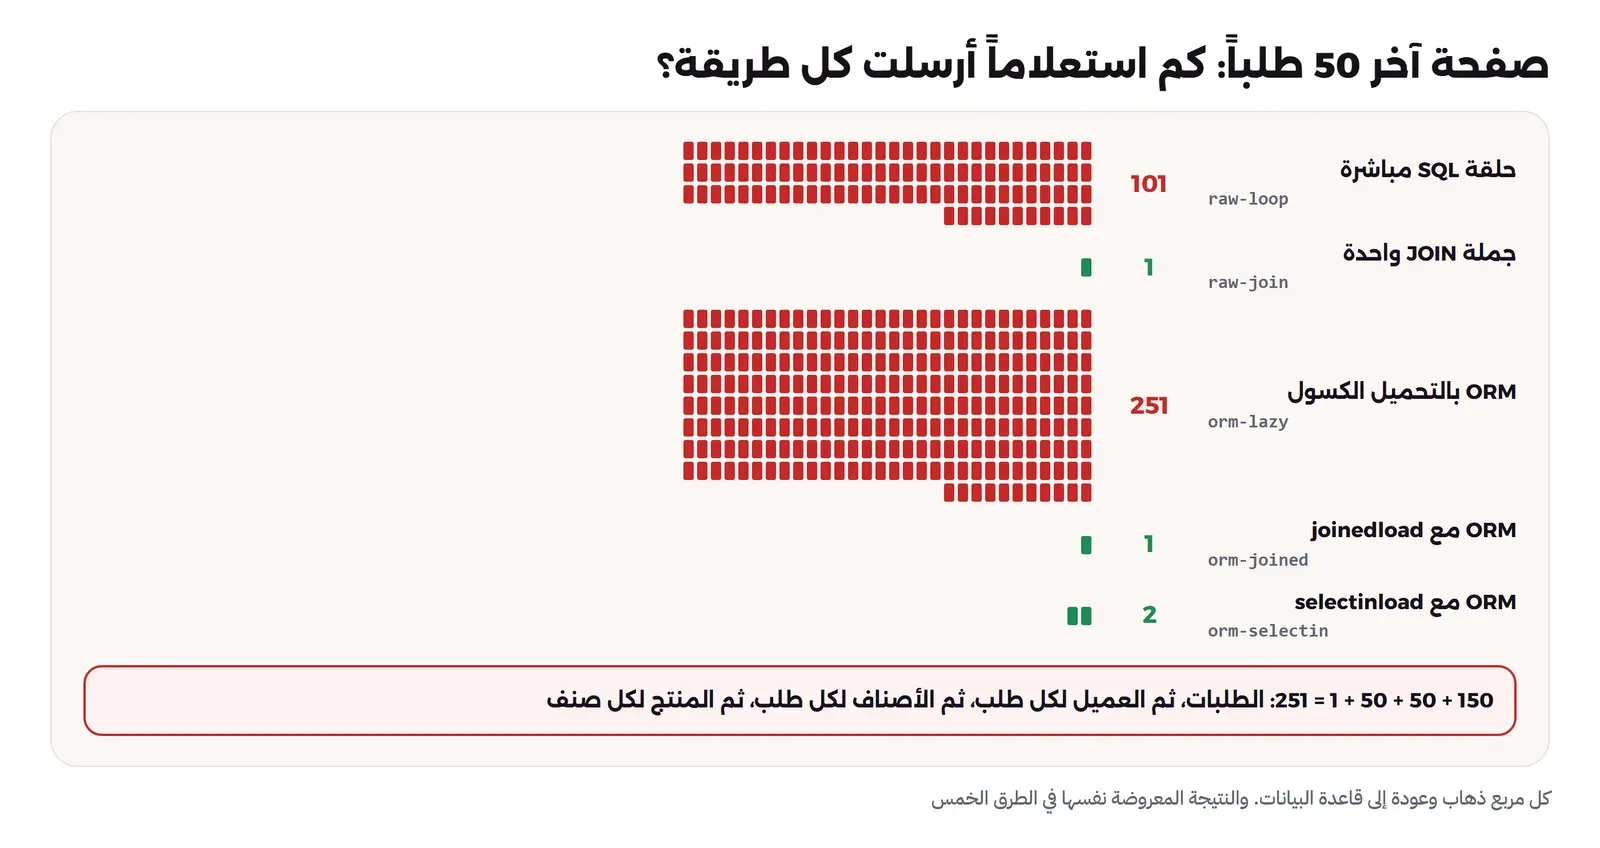
صفحة آخر الطلبات بخمس طرق: مشكلة N+1 بالأرقام
الصفحة تعرض آخر 50 طلباً، ولكل طلب اسم العميل والأصناف بأسماء المنتجات والمجموع. والسكربت page.py يكتبها بخمس طرق: حلقة SQL مباشرة تسأل عن كل طلب، وجملة JOIN واحدة، وال ORM بالتحميل الكسول الافتراضي، ثم مع joinedload، ثم مع selectinload. ويشغل كل طريقة عشرين مرة ويأخذ الوسيط Median، ويعد استعلامات تشغيل واحد من pg_stat_statements، ويتأكد أن النتيجة نفسها في الخمس:
"""The "latest orders" page five ways. For each: queries sent, median time over 20 runs.
usage: python page.py [variant ...]"""
import statistics, sys, time

import psycopg
from sqlalchemy import event, select
from sqlalchemy.orm import Session, joinedload, selectinload

from models import DB_HOST, Order, OrderItem, engine

PAGE = 50
eng = engine()
queries = 0


@event.listens_for(eng, "before_cursor_execute")
def count(conn, cursor, statement, params, context, executemany):
    global queries
    queries += 1


def render(rows):
    """what the template needs: order id, customer name, lines, total"""
    return [(o_id, name, sorted(lines), sum(q * p for _, q, p in lines)) for o_id, name, lines in rows]


# ---------- raw SQL with psycopg ----------
host, _, port = DB_HOST.partition(":")
pg = psycopg.connect(host=host, port=port or 5432, dbname="shop", user="postgres", password="lab", autocommit=True)


def raw_loop():
    out = []
    with pg.cursor() as cur:
        cur.execute("SELECT id, customer_id FROM orders ORDER BY created_at DESC LIMIT %s", (PAGE,))
        for o_id, c_id in cur.fetchall():
            cur.execute("SELECT name FROM customers WHERE id = %s", (c_id,))
            name = cur.fetchone()[0]
            cur.execute("""SELECT p.name, i.qty, i.unit_price FROM order_items i
                           JOIN products p ON p.id = i.product_id WHERE i.order_id = %s""", (o_id,))
            out.append((o_id, name, cur.fetchall()))
    return render(out)


def raw_join():
    with pg.cursor() as cur:
        cur.execute("""
            SELECT o.id, c.name, p.name, i.qty, i.unit_price
            FROM (SELECT id, customer_id, created_at FROM orders ORDER BY created_at DESC LIMIT %s) o
            JOIN customers c   ON c.id = o.customer_id
            JOIN order_items i ON i.order_id = o.id
            JOIN products p    ON p.id = i.product_id
            ORDER BY o.created_at DESC, i.id""", (PAGE,))
        pages = {}
        for o_id, name, product, qty, price in cur.fetchall():
            pages.setdefault((o_id, name), []).append((product, qty, price))
    return render([(o, n, lines) for (o, n), lines in pages.items()])


# ---------- the ORM ----------
def orm(*options):
    def page():
        with Session(eng) as s:
            stmt = select(Order).order_by(Order.created_at.desc()).limit(PAGE).options(*options)
            orders = s.scalars(stmt).unique().all()   # unique(): see the joinedload error
            return render([(o.id, o.customer.name,
                            [(i.product.name, i.qty, i.unit_price) for i in o.items]) for o in orders])
    return page


VARIANTS = {
    "raw-loop": raw_loop,
    "raw-join": raw_join,
    "orm-lazy": orm(),
    "orm-joined": orm(joinedload(Order.customer), joinedload(Order.items).joinedload(OrderItem.product)),
    "orm-selectin": orm(joinedload(Order.customer), selectinload(Order.items).joinedload(OrderItem.product)),
}

names = sys.argv[1:] or list(VARIANTS)
first = None
for name in names:
    fn = VARIANTS[name]
    fn()                                  # warm up: connections, statement caches
    times = []
    for _ in range(20):
        t0 = time.perf_counter()
        result = fn()
        times.append((time.perf_counter() - t0) * 1000)
    # count the queries of one run as the database saw them (pg_stat_statements)
    pg.execute("SELECT pg_stat_statements_reset()")
    fn()
    n = pg.execute("""SELECT coalesce(sum(calls), 0) FROM pg_stat_statements
                      WHERE query ILIKE 'select%' AND query NOT ILIKE '%pg_stat_statements%'""").fetchone()[0]
    first = first or result
    same = "same result" if result == first else "DIFFERENT result"
    print(f"{name:13} queries={n:4}  median={statistics.median(times):7.2f} ms  {same}")
docker run --rm --network sw2-net -v "$PWD:/lab" sw2-orm:lab python page.pyوالمخرج سوف يكون كما يلي:
raw-loop      queries= 101  median=  49.50 ms  same result
raw-join      queries=   1  median=  14.56 ms  same result
orm-lazy      queries= 251  median= 688.68 ms  same result
orm-joined    queries=   1  median=  28.15 ms  same result
orm-selectin  queries=   2  median=  56.96 ms  same result
الطريقة الكسولة أرسلت 251 استعلاماً لصفحة واحدة: استعلام للطلبات، ثم 50 للعملاء، و50 لأصناف كل طلب، و150 لمنتجات الأصناف، أي 1 + 50 + 50 + 150. وهذه هي مشكلة N+1، ولاحظ أنها ليست مشكلة ORM فقط، فالحلقة المباشرة raw-loop المكتوبة بـ SQL يدوياً أرسلت 101 استعلام بنفس المنطق. والمخرج التالي يبين أول استعلامات الطريقة الكسولة كما يطبعها SQLAlchemy لطلبين فقط بالسكربت sql_seen.py:
=========== lazy
BEGIN (implicit)
SELECT orders.id, orders.customer_id, orders.created_at, orders.status
FROM orders ORDER BY orders.created_at DESC
 LIMIT %(param_1)s::INTEGER
[generated in 0.00029s] {'param_1': 2}
SELECT customers.id, customers.name, customers.email
FROM customers
WHERE customers.id = %(pk_1)s::INTEGER
[generated in 0.00049s] {'pk_1': 1}
SELECT order_items.id, order_items.order_id, order_items.product_id, order_items.qty, order_items.unit_price
FROM order_items
WHERE %(param_1)s::INTEGER = order_items.order_id
[generated in 0.00030s] {'param_1': 20000}
SELECT products.id, products.name, products.price
FROM products
WHERE products.id = %(pk_1)s::INTEGER
[generated in 0.00037s] {'pk_1': 218}
SELECT products.id, products.name, products.price
FROM products
WHERE products.id = %(pk_1)s::INTEGER
[cached since 0.007166s ago] {'pk_1': 235}
SELECT products.id, products.name, products.price
FROM products
WHERE products.id = %(pk_1)s::INTEGER
[cached since 0.01515s ago] {'pk_1': 252}
SELECT customers.id, customers.name, customers.email
FROM customers
WHERE customers.id = %(pk_1)s::INTEGER
[cached since 0.03219s ago] {'pk_1': 82}
SELECT order_items.id, order_items.order_id, order_items.product_id, order_items.qty, order_items.unit_price
FROM order_items
WHERE %(param_1)s::INTEGER = order_items.order_id
[cached since 0.05716s ago] {'param_1': 19999}
SELECT products.id, products.name, products.price
FROM products
WHERE products.id = %(pk_1)s::INTEGER
[cached since 0.0563s ago] {'pk_1': 187}
SELECT products.id, products.name, products.price
FROM products
WHERE products.id = %(pk_1)s::INTEGER
[cached since 0.05849s ago] {'pk_1': 204}
SELECT products.id, products.name, products.price
FROM products
WHERE products.id = %(pk_1)s::INTEGER
[cached since 0.06048s ago] {'pk_1': 221}
ROLLBACK
## order 20000 for Customer 1: Product 218, Product 235, Product 252
## order 19999 for Customer 82: Product 187, Product 204, Product 221
=========== selectin
BEGIN (implicit)
SELECT orders.id, orders.customer_id, orders.created_at, orders.status, customers_1.id AS id_1, customers_1.name, customers_1.email
FROM orders LEFT OUTER JOIN customers AS customers_1 ON customers_1.id = orders.customer_id ORDER BY orders.created_at DESC
 LIMIT %(param_1)s::INTEGER
[generated in 0.00029s] {'param_1': 2}
SELECT order_items.order_id, order_items.id, order_items.product_id, order_items.qty, order_items.unit_price, products_1.id, products_1.name, products_1.price
FROM order_items LEFT OUTER JOIN products AS products_1 ON products_1.id = order_items.product_id
WHERE order_items.order_id IN (%(primary_keys_1)s::INTEGER, %(primary_keys_2)s::INTEGER)
[generated in 0.00043s] {'primary_keys_1': 20000, 'primary_keys_2': 19999}
ROLLBACK
## order 20000 for Customer 1: Product 218, Product 235, Product 252
## order 19999 for Customer 82: Product 187, Product 204, Product 221
=========== joined
BEGIN (implicit)
SELECT anon_1.id, anon_1.customer_id, anon_1.created_at, anon_1.status, customers_1.id AS id_1, customers_1.name, customers_1.email, products_1.id AS id_2, products_1.name AS name_1, products_1.price, order_items_1.id AS id_3, order_items_1.order_id, order_items_1.product_id, order_items_1.qty, order_items_1.unit_price
FROM (SELECT orders.id AS id, orders.customer_id AS customer_id, orders.created_at AS created_at, orders.status AS status
FROM orders ORDER BY orders.created_at DESC
 LIMIT %(param_1)s::INTEGER) AS anon_1 LEFT OUTER JOIN customers AS customers_1 ON customers_1.id = anon_1.customer_id LEFT OUTER JOIN order_items AS order_items_1 ON anon_1.id = order_items_1.order_id LEFT OUTER JOIN products AS products_1 ON products_1.id = order_items_1.product_id ORDER BY anon_1.created_at DESC
[generated in 0.00038s] {'param_1': 2}
ROLLBACK
## order 20000 for Customer 1: Product 218, Product 235, Product 252
## order 19999 for Customer 82: Product 187, Product 204, Product 221
كل سطر o.customer.name أو i.product.name في القالب أصبح استعلاماً، وكلمة cached since تعني أن SQLAlchemy لم يحتج أن يبني نص الجملة مرة أخرى، ولكنه ما زال يرسلها وينتظر ردها. وفي نفس الملف ترى طريقة selectinload: استعلام للطلبات مع العملاء بـ LEFT OUTER JOIN، ثم استعلام واحد للأصناف والمنتجات بشرط order_id IN (...) لكل الطلبات معاً. أما joinedload فجملة واحدة، ولاحظ أن SQLAlchemy كان ذكياً فوضع LIMIT داخل استعلام فرعي على الطلبات قبل JOIN، لأن LIMIT بعد JOIN مع الأصناف كان سوف يقطع الأصناف وليس الطلبات.
والآن السؤال المهم: هل الوقت ضاع في قاعدة البيانات؟ السكربت pgss.sh يشغل الصفحة الكسولة مرة ويسأل pg_stat_statements عن وقت التنفيذ داخل قاعدة البيانات:
 calls | total_ms | mean_ms |                            query
-------+----------+---------+--------------------------------------------------------------
   150 |    12.05 |   0.080 | SELECT products.id, products.name, products.price FROM produ
     1 |     6.13 |   6.126 | SELECT orders.id, orders.customer_id, orders.created_at, ord
    50 |     2.23 |   0.045 | SELECT order_items.id, order_items.order_id, order_items.pro
    50 |     1.88 |   0.038 | SELECT customers.id, customers.name, customers.email FROM cu
(4 rows)
مجموع الوقت الذي عملته قاعدة البيانات لكل الاستعلامات الـ 251 حوالي 22 مللي ثانية، والصفحة احتاجت 688 مللي ثانية. أي أن أكثر من 95% من الوقت لم يكن في تنفيذ SQL، وإنما في الذهاب والعودة عبر الشبكة Round Trip لكل استعلام، وفي عمل ال ORM نفسه لكل استعلام: بناء مفتاح التخزين المؤقت، وإرسال المعاملات، وتحويل الصف إلى كائن. ولذلك إذا نظرت إلى قائمة الاستعلامات البطيئة في قاعدة البيانات فلن تجد هذه المشكلة أبداً، فكل استعلام فيها يأخذ أقل من عشر مللي ثانية، والطريقة الوحيدة لتراها أن تعد الاستعلامات لكل طلب HTTP. ولاحظ أيضاً سطر الطلبات نفسه: 6 مللي ثانية لاستعلام واحد، لأن الترتيب على created_at بلا فهرس يجبر قاعدة البيانات على قراءة الطلبات كلها وترتيبها، وهذا موضوع مقال الفهارس وليس ال ORM.
مشكلة ظهرت في الطريق: unique() مع joinedload
عند أول تشغيل لطريقة joinedload على الأصناف فشل السكربت بالخطأ التالي، ونعيد إنتاجه بالسكربت unique_error.py:
    raise sa_exc.InvalidRequestError(
    ...<3 lines>...
    )
sqlalchemy.exc.InvalidRequestError: The unique() method must be invoked on this Result, as it contains results that include joined eager loads against collections
والسبب أن JOIN مع قائمة الأصناف يعيد كل طلب ثلاث مرات، مرة مع كل صنف، وفي SQLAlchemy 2 لم يعد ال ORM يحذف التكرار بصمت كما في الإصدارات القديمة، وإنما يطلب منك أن تكتب .unique() صراحة حتى تعرف أن الصفوف مكررة. وهذا تذكير بأن joinedload على قائمة يضاعف عدد الصفوف التي تنقل من قاعدة البيانات، فطلب فيه مئة صنف مع عميل فيه عشرون حقلاً يعني نقل حقول العميل مئة مرة، ولذلك توصي صفحة تحميل العلاقات في توثيق SQLAlchemy بـ selectinload للقوائم وjoinedload للعلاقة التي تعيد كائناً واحداً، مثل عميل الطلب.
كيف يولد ال ORM جملة SQL؟ التخزين المؤقت للجمل Statement Caching
قد يتساءل البعض: إذا كان ال ORM يبني نص الجملة من الكلاسات في كل مرة، أليس هذا مكلفاً؟ والإجابة أن SQLAlchemy يمر بثلاث مراحل. في الأولى تكتب الاستعلام كتعبير Expression في Python، مثل select(Order).where(...)، وهو شجرة من الكائنات وليس نصاً. وفي الثانية يحول المترجم Compiler هذه الشجرة إلى نص بلهجة قاعدة البيانات Dialect، فيكتب %(param_1)s::INTEGER لـ psycopg ويضيف LIMIT بطريقة PostgreSQL. وهذه المرحلة مكلفة نسبياً، لذلك يحسب SQLAlchemy لكل تعبير مفتاحاً من شكله دون القيم، ويحفظ النص المترجم في ذاكرة مؤقتة، وهذا معنى العبارتين generated in وcached since في المخرج أعلاه. وفي الثالثة تأخذ مكتبة الاتصال النص والقيم، وpsycopg 3 نفسه يحول الجملة إلى جملة مجهزة Prepared Statement في السيرفر بعد أن تتكرر خمس مرات على نفس الاتصال، فلا يعيد PostgreSQL تحليلها وتخطيطها في كل مرة. والنتيجة أن كلفة ال ORM لكل استعلام صغيرة، ولكنها ليست صفراً، فهي بضعة أجزاء من المللي ثانية لبناء المفتاح وتحويل الصفوف إلى كائنات، وعندما تضربها في 251 تصبح جزءاً واضحاً من زمن الصفحة كما رأيت.
كيف تمنع N+1 قبل أن يصل إلى الإنتاج Production؟
عد الاستعلامات بعد أن تبطؤ الصفحة علاج متأخر، والأفضل أن يفشل الكود في بيئة التطوير عندما ينسى أحد التحميل المسبق. وفي SQLAlchemy هناك خيار raiseload الذي يحول أي تحميل كسول إلى خطأ، فتحدد في الاستعلام ما تريد تحميله، وكل ما عداه ممنوع. والسكربت guards.py يجربه، ويجرب معه مسألة أخرى سوف نعود إليها:
"""Two guards: make lazy loading fail loudly, and let SQL do the arithmetic."""
import logging, sys

from sqlalchemy import select
from sqlalchemy.orm import Session, raiseload, selectinload

from models import Order, Product, engine

eng = engine()
print("1) raiseload: a forgotten relationship becomes an error, not 50 hidden queries")
with Session(eng) as s:
    orders = s.scalars(select(Order).order_by(Order.id).limit(3)
                       .options(selectinload(Order.items), raiseload("*"))).all()
    print("   items loaded:", [len(o.items) for o in orders])
    try:
        print(orders[0].customer.name)
    except Exception as e:
        print("  ", type(e).__name__ + ":", e)

logging.basicConfig(format="   SQL> %(message)s", stream=sys.stdout)
logging.getLogger("sqlalchemy.engine").setLevel(logging.INFO)
print("2) p.price + 1 computed in Python: the new value is sent")
with Session(eng) as s:
    p = s.get(Product, 1)
    p.price = p.price + 1
    s.flush(); s.rollback()
print("3) Product.price + 1 as an SQL expression: the database adds")
with Session(eng) as s:
    p = s.get(Product, 1)
    p.price = Product.price + 1
    s.flush(); s.rollback()
1) raiseload: a forgotten relationship becomes an error, not 50 hidden queries
items loaded: [3, 3, 3]
InvalidRequestError: 'Order.customer' is not available due to lazy='raise'
2) p.price + 1 computed in Python: the new value is sent
SQL> BEGIN (implicit)
SQL> SELECT products.id, products.name, products.price
FROM products
WHERE products.id = %(pk_1)s::INTEGER
SQL> [generated in 0.00027s] {'pk_1': 1}
SQL> UPDATE products SET price=%(price)s WHERE products.id = %(products_id)s::INTEGER
SQL> [generated in 0.00024s] {'price': Decimal('373.76'), 'products_id': 1}
SQL> ROLLBACK
3) Product.price + 1 as an SQL expression: the database adds
SQL> BEGIN (implicit)
SQL> SELECT products.id, products.name, products.price
FROM products
WHERE products.id = %(pk_1)s::INTEGER
SQL> [cached since 0.01932s ago] {'pk_1': 1}
SQL> UPDATE products SET price=(products.price + %(price_1)s::INTEGER) WHERE products.id = %(products_id)s::INTEGER
SQL> [generated in 0.00022s] {'price_1': 1, 'products_id': 1}
SQL> ROLLBACKفي الجزء الأول حملنا الأصناف بـ selectinload ومنعنا كل ما عداها بـ raiseload("*")، فعندما وصل الكود إلى customer.name فشل فوراً برسالة واضحة بدلاً من خمسين استعلاماً مخفياً. ويمكن أن تجعل هذا هو السلوك الافتراضي لعلاقة بكتابة lazy="raise" في تعريفها. وفي الأدوات الأخرى أفكار مماثلة: strict_loading في Rails، وassertNumQueries في اختبارات Django الذي يفشل الاختبار إذا تغير عدد الاستعلامات، وفي أي أداة يمكنك أن تعد الاستعلامات في اختبار التكامل لكل Endpoint وتضع لها حداً أعلى.
أما الجزءان الثاني والثالث فيبينان شيئاً يربط ال ORM بالمعاملات: عندما تكتب p.price = p.price + 1 يحسب Python القيمة الجديدة ويرسلها كرقم ثابت 373.76، فإذا عدلت معاملة أخرى السعر بين القراءة والتأكيد ضاع تعديلها، وهذا هو التحديث المفقود Lost Update بالضبط. وعندما تكتب p.price = Product.price + 1، أي بعمود الكلاس وليس بقيمة الكائن، يرسل ال ORM التعبير نفسه price = (products.price + 1) فتحسب قاعدة البيانات القيمة الجديدة من آخر قيمة مؤكدة. والفرق سطر واحد، والسطر الأول هو ما يكتبه أغلب المطورين لأنه يبدو طبيعياً في لغة البرمجة. ولـ SQLAlchemy أيضاً خيار version_id_col يضيف عمود نسخة ويجعل كل UPDATE مشروطاً به، وهو القفل المتفائل Optimistic Locking، وسوف نقيس هذه الطرق كلها تحت التنافس في مقال المعاملات ومستويات العزل.
ماذا لو كانت قاعدة البيانات على سيرفر آخر؟ What If
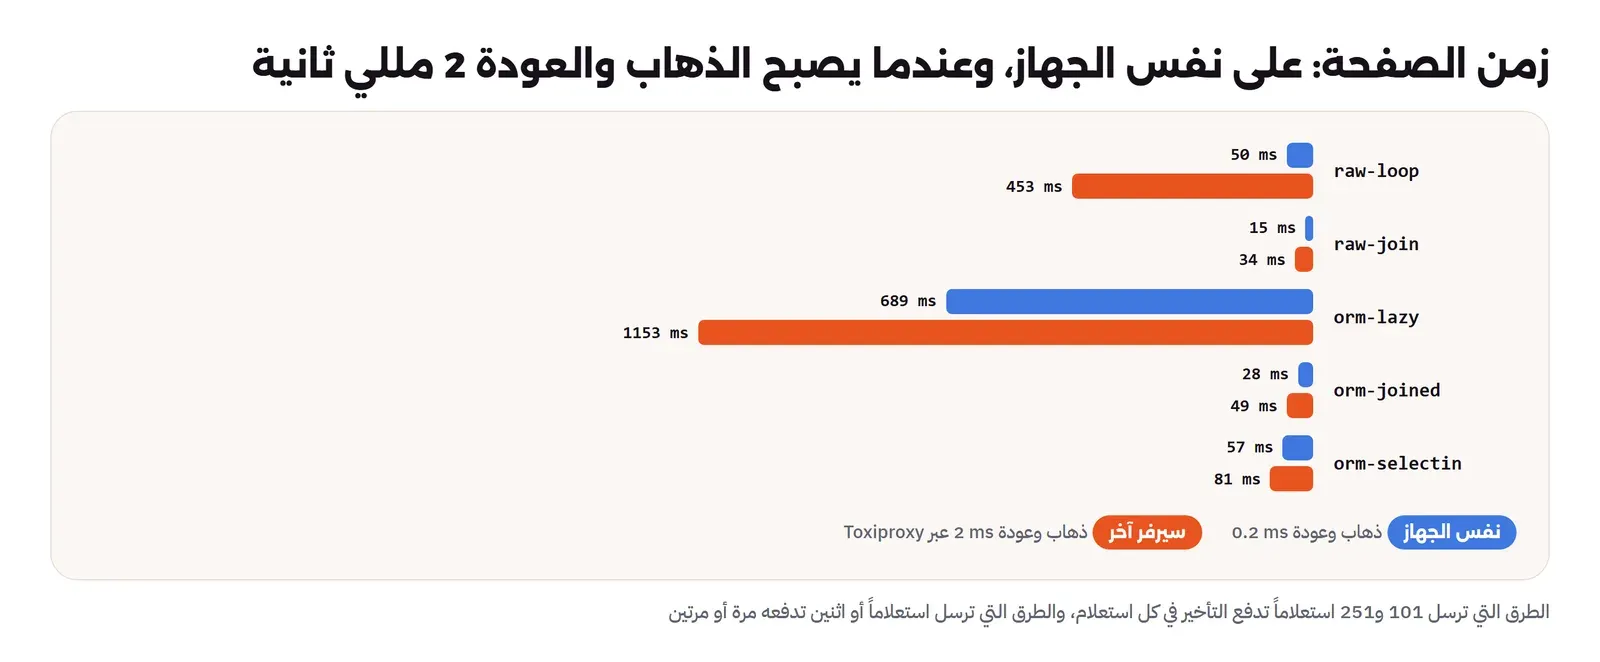
في التجربة السابقة كان التطبيق وقاعدة البيانات على نفس الجهاز، والذهاب والعودة يحتاج حوالي 0.2 مللي ثانية، أما في الإنتاج فقاعدة البيانات غالباً على سيرفر آخر أو خدمة مدارة في منطقة أخرى. وأول محاولة لمحاكاة ذلك كانت بالأمر tc qdisc add dev eth0 root netem delay 1ms داخل ال Container، فرفض بالرسالة Specified qdisc kind is unknown، لأن نواة Docker Desktop لا تحتوي وحدة netem. فاستخدمنا أداة Toxiproxy من Shopify، وهي Proxy صغير يقف بين التطبيق وقاعدة البيانات ويضيف تأخيراً لكل رد، بالسكربت latency.sh:
#!/bin/sh
# the database "on another server": Toxiproxy in front of PostgreSQL adds 1 ms to every answer
docker run -d --name sw2-proxy --network sw2-net sw2-toxiproxy:2.12.0 > /dev/null
sleep 2
docker exec sw2-proxy /toxiproxy-cli create -l 0.0.0.0:5433 -u sw2-pgorm:5432 pg
docker exec sw2-proxy /toxiproxy-cli toxic add -t latency -a latency=1 pg
docker run --rm --network sw2-net -v "$PWD:/lab" -e DB_HOST=sw2-proxy:5433 sw2-orm:lab \
  python -c "import psycopg,time; c=psycopg.connect('host=sw2-proxy port=5433 dbname=shop user=postgres password=lab'); t=time.perf_counter(); [c.execute('SELECT 1') for _ in range(100)]; print(f'round trip: {(time.perf_counter()-t)*10:.2f} ms')"
docker run --rm --network sw2-net -v "$PWD:/lab" -e DB_HOST=sw2-proxy:5433 sw2-orm:lab python page.py
Created new proxy pg
Added downstream latency toxic 'latency_downstream' on proxy 'pg'
round trip: 2.05 ms
raw-loop queries= 101 median= 452.55 ms same result
raw-join queries= 1 median= 34.02 ms same result
orm-lazy queries= 251 median=1153.43 ms same result
orm-joined queries= 1 median= 49.30 ms same result
orm-selectin queries= 2 median= 80.67 ms same resultأصبح الذهاب والعودة حوالي 2 مللي ثانية، وهو رقم واقعي لسيرفرين في نفس مركز البيانات أو قريب منه، فارتفعت الحلقة المباشرة من 50 إلى 453 مللي ثانية، والطريقة الكسولة إلى أكثر من ثانية، بينما زادت الطرق التي ترسل استعلاماً أو اثنين بحوالي 20 مللي ثانية فقط. أي أن N+1 مشكلة تكبر مع المسافة بين التطبيق وقاعدة البيانات، وقد لا تراها أبداً على جهازك، ثم تظهر في الإنتاج فقط. والصورة التالية تجمع الحالتين:
الإضافة الجماعية Bulk Insert: أربع طرق لعشرين ألف صف
الحالة الثانية التي يخطئ فيها الاستخدام البسيط لل ORM هي إدخال كمية كبيرة، مثل استيراد ملف CSV فيه عشرون ألف عميل. والسكربت bulk.py يجرب أربع طرق:
"""Insert 20,000 new customers four ways and time each."""
import io, time

import psycopg
from sqlalchemy import delete, insert
from sqlalchemy.orm import Session

from models import Customer, engine

N, START = 20_000, 100_000
eng = engine()
rows = lambda base: [{"id": base + i, "name": f"Bulk {i}", "email": f"bulk{base + i}@example.com"} for i in range(N)]


def clean():
    with Session(eng) as s:
        s.execute(delete(Customer).where(Customer.id >= START)); s.commit()


def orm_one_by_one(base):          # what a loop over a CSV file often looks like
    with Session(eng) as s:
        for r in rows(base):
            s.add(Customer(**r)); s.commit()


def orm_add_all(base):
    with Session(eng) as s:
        s.add_all([Customer(**r) for r in rows(base)]); s.commit()


def core_insert(base):
    with eng.begin() as conn:
        conn.execute(insert(Customer), rows(base))


def copy(base):
    with psycopg.connect("host=sw2-pgorm dbname=shop user=postgres password=lab") as pg:
        with pg.cursor().copy("COPY customers (id, name, email) FROM STDIN") as cp:
            for r in rows(base):
                cp.write_row((r["id"], r["name"], r["email"]))


for i, fn in enumerate([orm_one_by_one, orm_add_all, core_insert, copy]):
    clean()
    t0 = time.perf_counter()
    fn(START + i * N)
    print(f"{fn.__name__:15} {time.perf_counter() - t0:6.2f} s")
clean()
orm_one_by_one 198.41 s
orm_add_all 3.19 s
core_insert 1.42 s
copy 1.68 sفي المخرج أعلاه لاحظ التالي:
- الإضافة مع تأكيد بعد كل صف احتاجت أكثر من ثلاث دقائق، لأن كل
commitمعاملة مستقلة تنتظر حتى يكتب PostgreSQL سجل WAL على القرص، أي عشرون ألف كتابة متزامنة على القرص. وهذا هو الشكل الذي يكتبه كثيرون في حلقة على ملف. - add_all ثم تأكيد واحد احتاج حوالي 3 ثوان، أي أسرع بستين مرة، لأن SQLAlchemy 2 يجمع الإضافات في جمل INSERT متعددة القيم، وهي ميزة اسمها insertmanyvalues.
- Core insert مع قائمة قواميس كان أسرع بمرتين من add_all، لأنه لا ينشئ كائنات ولا يتابع تغييراتها.
- COPY عبر psycopg، كما في توثيق النسخ، كان في نفس المستوى تقريباً هنا، ويتفوق عادة مع الملايين، لأنه يرسل البيانات كتدفق واحد دون جمل SQL.
والدرس ليس أن ال ORM بطيء، فالفرق بين الطريقة الأولى والثانية ستون ضعفاً وكلاهما ORM، وإنما أن عدد المعاملات وعدد الرحلات إلى قاعدة البيانات أهم من الأداة.
التقارير Reports: لا تجمع في Python ما تستطيع قاعدة البيانات جمعه
الحالة الثالثة تقرير الإيرادات الشهرية. والسكربت report.py يحسبه بثلاث طرق: بتحميل كل الطلبات وأصنافها ككائنات ثم الجمع في Python، وبجملة GROUP BY مكتوبة بتعبيرات SQLAlchemy، وبنص SQL مباشر:
"""Revenue per month: load the objects and add them up in Python, or let SQL do it."""
import time, tracemalloc
from collections import defaultdict

from sqlalchemy import extract, func, select, text
from sqlalchemy.orm import Session, joinedload

from models import Order, OrderItem, engine

eng = engine()


def in_python():
    totals = defaultdict(int)
    with Session(eng) as s:
        for o in s.scalars(select(Order).options(joinedload(Order.items))).unique():
            totals[o.created_at.strftime("%Y-%m")] += sum(i.qty * i.unit_price for i in o.items)
    return sorted(totals.items())


def orm_group_by():
    month = func.to_char(Order.created_at, "YYYY-MM")
    stmt = (select(month, func.sum(OrderItem.qty * OrderItem.unit_price))
            .join(Order.items).group_by(month).order_by(month))
    with Session(eng) as s:
        return [tuple(r) for r in s.execute(stmt)]


RAW = text("""
    SELECT to_char(o.created_at, 'YYYY-MM') AS month, sum(i.qty * i.unit_price) AS revenue
    FROM orders o JOIN order_items i ON i.order_id = o.id
    GROUP BY 1 ORDER BY 1""")


def raw_sql():
    with eng.connect() as conn:
        return [tuple(r) for r in conn.execute(RAW)]


results = {}
for fn in (in_python, orm_group_by, raw_sql):
    tracemalloc.start()
    t0 = time.perf_counter()
    results[fn.__name__] = fn()
    dt = time.perf_counter() - t0
    peak = tracemalloc.get_traced_memory()[1] / 2**20
    tracemalloc.stop()
    print(f"{fn.__name__:13} {dt * 1000:8.1f} ms  peak memory {peak:6.1f} MiB  months={len(results[fn.__name__])}")
print("same totals:", results["in_python"] == results["orm_group_by"] == results["raw_sql"])
print("first rows:", results["raw_sql"][:2])
in_python 15010.5 ms peak memory 144.7 MiB months=7
orm_group_by 147.6 ms peak memory 0.1 MiB months=7
raw_sql 109.6 ms peak memory 0.0 MiB months=7
same totals: True
first rows: [('2026-01', Decimal('862482.25')), ('2026-02', Decimal('779278.08'))]الطريقة الأولى احتاجت 15 ثانية و145 ميغابايت من الذاكرة لإنشاء ثمانين ألف كائن ثم رميها، والطريقتان الأخريان احتاجتا أقل من 150 مللي ثانية وذاكرة لا تذكر، والنتيجة نفسها في الثلاث. ولاحظ أن الطريقة الثانية ما زالت داخل SQLAlchemy، أي أن الحل ليس ترك الأداة، وإنما أن تطلب منها جملة تجمع في قاعدة البيانات بدلاً من كائنات. وفرق الأربعين مللي ثانية بين الثانية والثالثة في هذا التشغيل لا يهم، وأغلبه من تحويل التعبير إلى نص في أول استدعاء.
الترحيل Migrations مع Alembic: إعادة تسمية عمود حذفت البيانات
عندما يتغير الكلاس يجب أن يتغير الجدول، والأداة المرافقة لـ SQLAlchemy لذلك هي Alembic، وهي تقارن الكلاسات بقاعدة البيانات وتولد ملف ترحيل فيه دالة upgrade ودالة downgrade. والسكربت migrate.sh يبدأ من قاعدة بيانات فارغة اسمها shopmig، فيولد الترحيل الأول ويطبقه ويضيف عميلين، ثم يغير اسم الحقل name في الكلاس إلى full_name ويولد ترحيلاً ثانياً:
#!/bin/sh
# Alembic from zero on an empty database (shopmig), then a column rename. Runs inside the lab container.
set -e
rm -rf /work && mkdir /work && cd /work
sed 's#/shop"#/shopmig"#' /lab/models.py > models.py
echo "== alembic init";        alembic init migrations | tail -1
sed -i 's#^sqlalchemy.url = .*#sqlalchemy.url = postgresql+psycopg://postgres:lab@sw2-pgorm/shopmig#' alembic.ini
sed -i 's#^target_metadata = None#import sys; sys.path.insert(0, "/work")\nfrom models import Base\ntarget_metadata = Base.metadata#' migrations/env.py
echo "== first revision";      alembic revision --autogenerate -m "initial tables" 2>&1 | grep -E "Detected|Generating"
echo "== upgrade";             alembic upgrade head 2>&1 | grep -E "Running"
psql_() { python -c "import psycopg,sys; c=psycopg.connect('host=sw2-pgorm dbname=shopmig user=postgres password=lab',autocommit=True); r=c.execute(sys.argv[1]); print(r.fetchall() if r.description else r.statusmessage)" "$1"; }
psql_ "INSERT INTO customers (name, email) VALUES ('Sara', '[email protected]'), ('Omar', '[email protected]')"
echo "== rename name -> full_name in the model, then autogenerate"
sed -i 's/    name: Mapped\[str\] = mapped_column(String(80))\n    email/X/' models.py
python - <<'PY'
s = open("models.py").read()
s = s.replace('class Customer(Base):\n    __tablename__ = "customers"\n    id: Mapped[int] = mapped_column(primary_key=True)\n    name:',
              'class Customer(Base):\n    __tablename__ = "customers"\n    id: Mapped[int] = mapped_column(primary_key=True)\n    full_name:')
open("models.py", "w").write(s)
PY
alembic revision --autogenerate -m "rename customer name" 2>&1 | grep -E "Detected|Generating"
f=$(ls migrations/versions/*rename_customer_name.py)
echo "== what autogenerate wrote (upgrade)"; sed -n '/^def upgrade/,/^def downgrade/p' $f | grep -vE '^\s*$|^def downgrade'
echo "== upgrade with the generated file"; alembic upgrade head 2>&1 | grep -E "Running|Error|error|violat|null" | head -4 || true
psql_ "SELECT id, name, email FROM customers ORDER BY id"
echo "== the fix: alter_column instead of drop + add"
python - "$f" <<'PY'
import re, sys
p = sys.argv[1]; s = open(p).read()
up = s[s.index("def upgrade"):s.index("def downgrade")]
fixed = '''def upgrade() -> None:
    """Upgrade schema."""
    op.alter_column("customers", "name", new_column_name="full_name")


'''
down = s[s.index("def downgrade"):]
fixed_down = '''def downgrade() -> None:
    """Downgrade schema."""
    op.alter_column("customers", "full_name", new_column_name="name")
'''
open(p, "w").write(s.replace(up, fixed).replace(down, fixed_down))
PY
echo "== the SQL it will run (offline mode)"; alembic upgrade head --sql 2>/dev/null | grep -E "^ALTER|^UPDATE alembic"
alembic upgrade head 2>&1 | grep -E "Running"
psql_ "SELECT id, full_name, email FROM customers ORDER BY id"
echo "== downgrade one step"; alembic downgrade -1 2>&1 | grep -E "Running"
psql_ "SELECT id, name FROM customers ORDER BY id"
cp -r migrations /lab/out/alembic-run
== alembic init
Please edit configuration/connection/logging settings in /work/alembic.ini before proceeding.
== first revision
INFO [alembic.autogenerate.compare.tables] Detected added table 'customers'
INFO [alembic.autogenerate.compare.tables] Detected added table 'products'
INFO [alembic.autogenerate.compare.tables] Detected added table 'orders'
INFO [alembic.autogenerate.compare.constraints] Detected added index 'ix_orders_customer_id' on '('customer_id',)'
INFO [alembic.autogenerate.compare.tables] Detected added table 'order_items'
INFO [alembic.autogenerate.compare.constraints] Detected added index 'ix_order_items_order_id' on '('order_id',)'
Generating /work/migrations/versions/5b750f95633c_initial_tables.py ... done
== upgrade
INFO [alembic.runtime.migration] Running upgrade -> 5b750f95633c, initial tables
INSERT 0 2
== rename name -> full_name in the model, then autogenerate
INFO [alembic.ddl.postgresql] Detected sequence named 'orders_id_seq' as owned by integer column 'orders(id)', assuming SERIAL and omitting
INFO [alembic.ddl.postgresql] Detected sequence named 'products_id_seq' as owned by integer column 'products(id)', assuming SERIAL and omitting
INFO [alembic.ddl.postgresql] Detected sequence named 'order_items_id_seq' as owned by integer column 'order_items(id)', assuming SERIAL and omitting
INFO [alembic.ddl.postgresql] Detected sequence named 'customers_id_seq' as owned by integer column 'customers(id)', assuming SERIAL and omitting
INFO [alembic.autogenerate.compare.tables] Detected added column 'customers.full_name'
INFO [alembic.autogenerate.compare.tables] Detected removed column 'customers.name'
Generating /work/migrations/versions/a9d19f1488f3_rename_customer_name.py ... done
== what autogenerate wrote (upgrade)
def upgrade() -> None:
"""Upgrade schema."""
# ### commands auto generated by Alembic - please adjust! ###
op.add_column('customers', sa.Column('full_name', sa.String(length=80), nullable=False))
op.drop_column('customers', 'name')
# ### end Alembic commands ###
== upgrade with the generated file
INFO [alembic.runtime.migration] Running upgrade 5b750f95633c -> a9d19f1488f3, rename customer name
psycopg.errors.NotNullViolation: column "full_name" of relation "customers" contains null values
op.add_column('customers', sa.Column('full_name', sa.String(length=80), nullable=False))
sqlalchemy.exc.IntegrityError: (psycopg.errors.NotNullViolation) column "full_name" of relation "customers" contains null values
[(1, 'Sara', '[email protected]'), (2, 'Omar', '[email protected]')]
== the fix: alter_column instead of drop + add
== the SQL it will run (offline mode)
ALTER TABLE customers RENAME name TO full_name;
UPDATE alembic_version SET version_num='a9d19f1488f3' WHERE alembic_version.version_num = '5b750f95633c';
INFO [alembic.runtime.migration] Running upgrade 5b750f95633c -> a9d19f1488f3, rename customer name
[(1, 'Sara', '[email protected]'), (2, 'Omar', '[email protected]')]
== downgrade one step
INFO [alembic.runtime.migration] Running downgrade a9d19f1488f3 -> 5b750f95633c, rename customer name
[(1, 'Sara'), (2, 'Omar')]في المخرج أعلاه لاحظ التالي:
- الترحيل الأول اكتشف الجداول الأربعة والفهرسين، وملفه في
lab/out/alembic-run/versionsمع المقال. - في الترحيل الثاني لم يفهم Alembic أننا غيرنا الاسم، وإنما رأى عموداً جديداً
full_nameوعموداً محذوفاًname، فكتبadd_columnثمdrop_column. وتوثيق Alembic يقول ذلك صراحة في قسم ما الذي لا يكتشفه التوليد التلقائي: تغيير اسم جدول أو عمود يظهر كحذف وإضافة. - فشل التطبيق لأن العمود الجديد
NOT NULLوالجدول فيه صفوف لا قيمة لها فيه، ولأن PostgreSQL ينفذ تعديلات الجداول DDL داخل معاملة، ألغي الترحيل كله وبقيت البيانات كما كانت، وهذا ما يظهر في السطر الذي بعد الخطأ. - بعد أن استبدلنا الدالتين بـ
alter_columnأعطانا الوضع Offline بالخيار--sqlالجملة التي سوف تنفذ قبل تنفيذها:ALTER TABLE customers RENAME name TO full_name، وبقي سارة وعمر بأسمائهما، ثم رجعdowngradeالاسم كما كان.
وماذا لو كان الحقل الجديد يقبل القيمة الفارغة، أي Mapped[str | None]؟ السكربت migrate_whatif.sh يعيد نفس الخطوات على قاعدة بيانات جديدة بهذا التغيير فقط:
INSERT 0 2
INFO  [alembic.autogenerate.compare.tables] Detected added column 'customers.full_name'
INFO  [alembic.autogenerate.compare.tables] Detected removed column 'customers.name'
INFO  [alembic.runtime.migration] Running upgrade a81057c439cb -> ada3bb897c81, rename customer name
[(1, None, '[email protected]'), (2, None, '[email protected]')]
هنا نجح الترحيل دون أي خطأ، وأصبح اسم كل العملاء None، أي أن الترحيل المولد حذف عموداً كاملاً من البيانات بصمت. ولهذا القاعدة الأولى مع أي أداة ترحيل تلقائي، في Alembic أو Django أو Prisma أو Entity Framework: اقرأ ملف الترحيل المولد قبل تطبيقه كما تقرأ أي كود، وشغل --sql أو ما يقابله لترى الجمل الفعلية، وجربه على نسخة من بيانات الإنتاج قبل الإنتاج. أما تعديل الجداول الكبيرة دون توقف الخدمة فموضوع أكبر من هذا المقال.
الجلسة في تطبيق الويب Session per Request: من يفتحها ومن يغلقها؟
كل ما سبق كان في سكربتات قصيرة، أما في تطبيق ويب فالسؤال العملي هو أين تبدأ الجلسة وأين تنتهي، والإجابة الشائعة في كل الأطر هي جلسة لكل طلب Session per Request: يفتح الإطار جلسة عند وصول طلب HTTP، ويمررها إلى الكود الذي يحتاجها، ثم يؤكدها إذا انتهى الطلب بنجاح أو يلغيها إذا حدث استثناء، ثم يغلقها. وهذا ما تفعله الاعتمادية Depends(get_session) في FastAPI، وما يفعله Django تلقائياً لكل طلب، وما يفعله Spring بالعلامة @Transactional. والسبب أن الطلب الواحد وحدة عمل طبيعية: إما أن ينجح كله، أو لا يترك أثراً نصفياً في قاعدة البيانات.
ولهذا النمط ثلاث نتائج يجب أن تعرفها. الأولى أن الجلسة تأخذ اتصالاً من مجمع الاتصالات Connection Pool طوال مدة المعاملة، فإذا كان الطلب ينتظر داخل المعاملة خدمة خارجية بطيئة، مثل بوابة دفع أو إرسال بريد، بقي الاتصال مشغولاً، ومع عدد قليل من هذه الطلبات ينفد المجمع، وقد شرحنا حجم المجمع وكلفة الاتصال في مقال Connection Pooling. والثانية أن الكائنات لا يجب أن تخرج من الطلب، فلا تحفظها في ذاكرة مؤقتة عامة ولا ترسلها إلى مهمة خلفية Background Job، وإنما أرسل المفتاح وتقرأ المهمة الكائن في جلستها. والثالثة أن التحويل إلى JSON في نهاية الطلب قد يصل إلى علاقات لم تحملها، فيحدث N+1 في طبقة العرض بعد أن ظننت أن الاستعلام انتهى، أو يحدث DetachedInstanceError إذا كانت الجلسة قد أغلقت قبل التحويل. ولذلك الأفضل أن تحول النتيجة إلى كائنات بيانات بسيطة، مثل نماذج Pydantic أو DTO، داخل الطبقة التي تملك الجلسة، وأن يكون هذا التحويل هو الحد الذي لا يعبره ال ORM.
وبعض الفرق تضع فوق ال ORM طبقة اسمها المستودع Repository، فيها دوال مثل orders.latest(limit=50) تخفي الاستعلام وتحدد التحميل المسبق في مكان واحد. وهذه الطبقة مفيدة عندما تكون الاستعلامات نفسها قراراً تريد أن تجمعه وتختبره، كما يقترح Domain-Driven Design، ولكنها تصبح عبئاً إذا كانت مجرد غلاف يعيد كتابة دوال ال ORM نفسها بأسماء أخرى، فالقاعدة نفسها التي رأيناها مع الواجهات في مقال الاقتران: أضف الطبقة عندما تخفي قراراً يحتمل أن يتغير.
متى تكتب SQL مباشرة؟
من التجربة ومن تجارب الفرق التي تستخدم ORM لسنوات، هذه الحالات التي تكسب فيها SQL المكتوبة يدوياً، أو على الأقل باني الاستعلامات:
- التقارير والتحليل: التجميع ودوال النوافذ Window Functions والجمل WITH، وقد شرحناها في الجزء الثالث من تعلم SQL، وكثير منها يمكن كتابته بتعبيرات ال ORM ولكنه يصبح أصعب قراءة من SQL نفسها.
- العمليات الجماعية: الإضافة والتعديل والحذف لآلاف الصفوف بجملة واحدة، مثل
UPDATE ... WHEREأوCOPYأوINSERT ... ON CONFLICT. - ميزات قاعدة البيانات الخاصة: البحث النصي، وJSONB، و
SKIP LOCKEDلطوابير المهام، وRETURNINGالمعقد، والدوال المخزنة. - المسار الساخن Hot Path: الاستعلام الذي يعمل آلاف المرات في الثانية، حيث كل مللي ثانية من عمل ال ORM تتضاعف.
- الاستعلام الذي يحتاج خطة محددة: عندما تحتاج أن تكتب الجملة بطريقة معينة لكي يستخدم المخطط Planner الفهرس الصحيح.
وفي كل هذه الحالات لا تترك ال ORM كله، وإنما اكتب الجملة نصاً داخل نفس الأداة، مثل text() في SQLAlchemy أو raw() في Django أو $queryRaw في Prisma، فتبقى في نفس الاتصال والمعاملة. والقاعدة التي لا تتغير: مرر القيم كمعاملات Parameters دائماً، ولا تبن النص بدمج قيم المستخدم، كما في المثال التالي، والسبب شرحناه بالتجربة في فقرة حقن SQL:
# wrong: the value becomes part of the SQL text
conn.execute(text(f"SELECT * FROM customers WHERE email = '{email}'"))
# right: the value travels separately as a parameter
conn.execute(text("SELECT * FROM customers WHERE email = :email"), {"email": email})نفس المفاهيم في اللغات الأخرى
كل ما رأيته في SQLAlchemy له مقابل في الأدوات الأخرى، والجدول التالي يجمع أسماء التحميل المسبق في أشهرها، حتى تعرف ما تبحث عنه في توثيق أداتك:
| الأداة | النمط | التحميل المسبق لعلاقة كائن واحد | التحميل المسبق لقائمة |
|---|---|---|---|
| SQLAlchemy (Python) | Data Mapper | joinedload | selectinload |
| Django ORM (Python) | Active Record | select_related | prefetch_related |
| Active Record (Rails) | Active Record | includes أو eager_load | includes أو preload |
| Prisma (Node.js) | مولد كلاينت من ملف Schema | include | include |
| Entity Framework Core (.NET) | Data Mapper | Include | Include مع AsSplitQuery |
| Hibernate / JPA (Java) | Data Mapper | JOIN FETCH | @BatchSize أو JOIN FETCH |
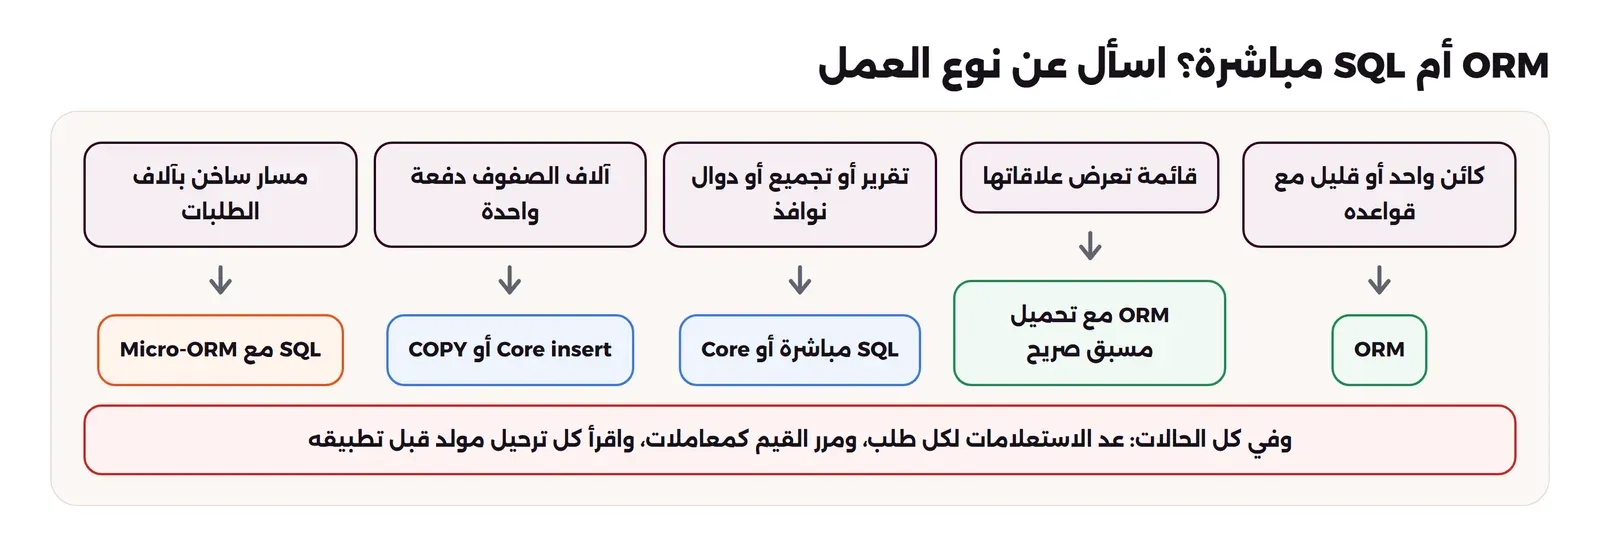
ORM أم SQL مباشرة؟ جدول القرار
| العمل | الأنسب | والسبب |
|---|---|---|
| إضافة وتعديل وحذف كائن واحد مع قواعده | ORM | يكتب الجمل المتكررة، ويتابع التغييرات، ويمرر المعاملات بأمان |
| صفحة تعرض قائمة مع علاقاتها | ORM مع تحميل مسبق صريح | استعلام أو اثنان بدلاً من N+1، دون أن تكتب JOIN بيدك |
| تقرير، تجميع، دوال نوافذ | SQL مباشرة أو باني الاستعلامات | التجميع في قاعدة البيانات، والنص أوضح من التعبيرات المتداخلة |
| استيراد آلاف الصفوف | Core insert أو COPY | لا تحتاج كائنات ولا تتبع تغييرات، والمعاملة واحدة |
| مسار ساخن بآلاف الطلبات في الثانية | SQL مباشرة أو Micro-ORM | عمل ال ORM لكل استعلام يتضاعف مع عدد الطلبات |
| تغيير الجداول | أداة ترحيل مع مراجعة كل ملف | التوليد التلقائي لا يفرق بين إعادة التسمية والحذف |
والصورة التالية تجمع الجدول في قرار واحد:
أخطاء شائعة Common Mistakes
- الاعتماد على التحميل الكسول في القوائم: كل سطر
obj.relationداخل حلقة قد يكون استعلاماً، فحدد التحميل المسبق في كل استعلام يعرض قائمة. - البحث عن N+1 في قائمة الاستعلامات البطيئة: كل استعلام فيها سريع، والمشكلة في عددها، فعد الاستعلامات لكل طلب HTTP.
- joinedload على كل شيء: على القوائم يضاعف الصفوف المنقولة، والأنسب selectinload أو ما يقابله.
- تأكيد بعد كل صف في الاستيراد: رأيت الفرق ستين ضعفاً، فاجمع في معاملة واحدة أو دفعات.
- إعادة كائنات ORM بعد إغلاق الجلسة: ينتهي بـ DetachedInstanceError أو باستعلامات مخفية في القالب، فحول النتيجة إلى بيانات جاهزة قبل إغلاق الجلسة.
- تطبيق الترحيل المولد دون قراءته: إعادة التسمية تصبح حذفاً، والنوع قد يتغير بطريقة لم تقصدها.
- بناء نص SQL بدمج القيم داخل text() أو raw(): هنا يفقد ال ORM حمايته من الحقن تماماً.
- نسيان الفهارس لأن ال ORM أنشأ الجداول: ال ORM ينشئ ما وصفته فقط، والترتيب على
created_atفي التجربة بقي بلا فهرس. - جلسة واحدة طويلة العمر: خريطة الهوية تكبر وتعطيك بيانات قديمة، فاجعل الجلسة بعمر الطلب الواحد.
قائمة تحقق Checklist
- أعرف أي طبقة أستخدم: Driver أم باني استعلامات أم Micro-ORM أم ORM كامل، ولماذا.
- سجل الاستعلامات مفعل في بيئة التطوير، وأعد الاستعلامات لكل صفحة أو Endpoint، وعندي حد أعلى في الاختبارات.
- كل استعلام يعرض قائمة يحدد تحميل العلاقات صراحة.
- pg_stat_statements أو ما يقابله مفعل في الإنتاج، وأنظر إلى عدد الاستدعاءات وليس الوقت فقط.
- التقارير والتجميع في قاعدة البيانات، والاستيراد بإضافة جماعية في معاملة واحدة.
- الجلسة بعمر الطلب، ولا تخرج كائنات ORM من الطبقة التي فتحت الجلسة.
- كل SQL مكتوبة يدوياً تمرر القيم كمعاملات.
- كل ملف ترحيل مولد يقرأ ويراجع، وأشغل وضع
--sqlقبل التطبيق، وأجربه على نسخة من البيانات. - الفهارس على المفاتيح الأجنبية وأعمدة الترتيب والبحث موصوفة في الكلاسات.
حذف المختبر Cleanup
docker rm -f sw2-pgorm sw2-proxy
docker network rm sw2-net
docker rmi sw2-orm:lab
ماذا تقرأ بعد ذلك؟ Next Steps
هذا المقال في مرحلة قواعد البيانات بعد مقال التصميم والتطبيع، وبعده يأتي ما يرسله ال ORM داخل المعاملة: ما الذي تراه معاملتك من تعديلات غيرها، وكيف تمنع بيع المقعد مرتين. ومعه الفهارس التي تجعل الاستعلام الواحد سريعاً، ومجمع الاتصالات الذي يجعل الاتصال نفسه رخيصاً.
 دليلتصميم قواعد البيانات: التطبيع Normalization ومتى تتخلى عنهلماذا يفشل الجدول الواحد الكبير، وكيف تقسمه إلى جداول لا تناقض نفسها، وما الذي يتغير عندما تكبر البيانات.
 دليلالمعاملات Transactions ومستويات العزل: ماذا يحمي كل مستوى؟ما الذي يمنعه كل مستوى عزل فعلاً في PostgreSQL وMySQL، بسبع ظواهر شغلناها على جلستين وألف وستمئة حجز متزامن، وكيف تكتب كوداً لا يبيع المقعد مرتين.
 دليلالفهارس Indexes: لماذا تسرع الاستعلام وكيف تقرأ EXPLAINكيف يبحث PostgreSQL داخل الفهرس، ومتى يتجاهله، وكم يكلفك كل فهرس عند الكتابة، وكيف تقرأ خطة EXPLAIN سطراً سطراً.
 دليلConnection Pooling: لماذا الاتصال بقاعدة البيانات مكلفلماذا تظهر رسالة too many clients عندما تزيد نسخ تطبيقك، وكيف يحل مجمع الاتصالات وPgBouncer هذه المشكلة.
 دليلتعلم SQL (3): CTE ودوال النوافذ والمعاملاتكيف تكتب استعلامات أوضح بجمل WITH ودوال النوافذ، وتحمي بياناتك بالمعاملات ومستويات العزل ومن حقن SQL.
 دليلخدمة حقيقية بـ Python: FastAPI مع PostgreSQL والاختبارات Testsبنينا خدمة طلبات لمتجر صغير بـ FastAPI وPostgreSQL 17، بضريبة محسوبة بالهللة وقفل للمخزون اختبرناه بعشرين طلباً متوازياً، ثم قسنا الـ Docker Image وزمن البدء والذاكرة وwrk.
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- ال ORM يربط الكائنات بالجداول، ويوفر الجمل المتكررة والمعاملات الآمنة وتتبع التغييرات، ولكنه لا يلغي الفرق بين التنقل بين الكائنات والعمل على المجموعات.
- بين SQL المباشرة وال ORM الكامل طبقات: باني الاستعلامات وال Micro-ORM، واختر الطبقة لكل عمل وليس للمشروع كله.
- الجلسة فيها خريطة هوية ووحدة عمل وإرسال تلقائي وتحميل كسول، ومعرفة هذه الأربعة تفسر أغلب ما يفاجئك.
- في التجربة أرسلت الصفحة الكسولة 251 استعلاماً، وعملت قاعدة البيانات 22 مللي ثانية من 688، وعندما أصبح الذهاب والعودة 2 مللي ثانية تجاوزت الثانية، وselectinload أو joinedload أعاداها إلى استعلام أو اثنين.
- الإضافة مع تأكيد لكل صف كانت أبطأ بستين مرة من add_all، وتقرير بكائنات احتاج 15 ثانية مقابل 110 مللي ثانية بـ GROUP BY.
- امنع N+1 قبل الإنتاج بـ
raiseloadأو ما يقابله، وبحد أعلى لعدد الاستعلامات في الاختبارات، واكتب التعديل الحسابي كتعبير SQL مثلProduct.price + 1حتى لا يضيع تعديل معاملة أخرى. - الجلسة بعمر الطلب، والمعاملة قصيرة لا تنتظر خدمات خارجية، والكائنات تتحول إلى بيانات بسيطة قبل أن تخرج من الطبقة التي تملك الجلسة.
- Alembic حول إعادة التسمية إلى حذف وإضافة، ففشل مرة وحذف الأسماء بصمت مرة، فاقرأ كل ترحيل مولد قبل تطبيقه.
سجل التحديثات Changelog
- 18 نوفمبر 2026: كتابة المقال، وتنفيذ التجارب على Docker Engine 29.8.0 مع PostgreSQL 18.6 (postgres:18.6) وPython 3.13.18 وSQLAlchemy 2.1.9 وAlembic 1.20.1 وpsycopg 3.3.6 وToxiproxy 2.12.0.