


وصلت الخدمة الصغيرة التي بدأناها في هذه المرحلة إلى اليوم الذي تنتظره كل شركة ناشئة تبيع القهوة والتمور عبر الإنترنت: الواجهة الجديدة جاهزة، وتحتاج API حقيقياً للطلبات بدل السكربتات التي كتبناها في المقالات السابقة. والمطلوب من الفريق واضح: قائمة المنتجات، وإنشاء طلب يحسب ضريبة القيمة المضافة بالهللة ويخصم المخزون، وعرض طلب سابق، مع اختبارات تشتغل في CI، وDocker Image تنشر على سيرفر صغير. وفي المقال السابق رأينا كيف باعت الخيوط عشرين كيساً من مخزون عشرة، والفريق لا يريد أن يتكرر ذلك في الإنتاج، ولا يريد أن يعرف بالمشكلة من عميل غاضب أو من محاسب يجد في آخر الشهر فرقاً بين الفواتير والمخزن.
وهذا المقال الرابع في مرحلة لغة Python للمطورين، ونبني فيه الخدمة المشتركة التي نبنيها بنفس المواصفات في كل لغات المسار، بالإطار الأشهر في Python لهذا النوع من الخدمات وهو FastAPI، مع PostgreSQL 17 والمكتبة psycopg. وفكرة المقارنة بين اللغات على نفس الخدمة شرحناها في مقال كيف تختار لغة البرمجة لمشروعك، وتصميم الـ API نفسه في مقال كيف تصمم API، أما هنا فالتركيز على الطريقة التي يكتب بها مطور Python هذه الخدمة اليوم، وما يكلفه ذلك بالأرقام. وسوف نناقش في هذا المقال ما يلي:
- المواصفات المشتركة والجداول، ولماذا اخترنا FastAPI وpsycopg من بين الخيارات المتاحة.
- هيكل المشروع بـ uv، ودالة الضريبة بالهللة، والتحقق من المدخلات بـ Pydantic وتحويل 422 إلى 400.
- إنشاء الطلب في معاملة واحدة Transaction مع قفل الصفوف
FOR UPDATE، ولماذا نرتب الصفوف قبل قفلها. - الاختبارات: اختبارات الوحدة، واختبارات التكامل على PostgreSQL حقيقي، واختبار عشرين طلباً متوازياً، وماذا يحدث إذا أزلنا القفل.
- الـ Dockerfile متعدد المراحل، ومشكلة جعلت زمن البدء أكثر من ضعفين وحلها بسطر واحد.
- القياس: حجم الـ Image، وزمن البدء، والذاكرة، وwrk مرتين، مع تحفظ صريح على ضجيج الجهاز، ثم تحسين مجمع الاتصالات بـ autocommit.
المواصفات المشتركة Shared Spec: نفس الخدمة في كل لغة
لكي تكون المقارنة بين اللغات عادلة، تبنى الخدمة في كل لغة من نفس المواصفات بالضبط، والجداول نفسها في PostgreSQL 17، والملف schema.sql في الخدمة كما يلي:
CREATE TABLE IF NOT EXISTS products (
    id            serial PRIMARY KEY,
    name_ar       text NOT NULL,
    price_halalas int  NOT NULL CHECK (price_halalas >= 0),
    stock         int  NOT NULL CHECK (stock >= 0)
);

CREATE TABLE IF NOT EXISTS orders (
    id            serial PRIMARY KEY,
    created_at    timestamptz DEFAULT now(),
    total_halalas int NOT NULL
);

CREATE TABLE IF NOT EXISTS order_items (
    order_id      int REFERENCES orders (id),
    product_id    int REFERENCES products (id),
    qty           int CHECK (qty > 0),
    price_halalas int
);

INSERT INTO products (name_ar, price_halalas, stock)
SELECT * FROM (VALUES ('قهوة عربية', 4500, 50), ('تمر سكري', 990, 10), ('هيل', 1500, 30)) AS seed
WHERE NOT EXISTS (SELECT 1 FROM products);
في الجداول أعلاه لاحظ التالي:
- كل المبالغ أعداد صحيحة بالهللة، فلا يوجد عمود
numericولاfloat، وهذا القرار الذي بنيناه منذ المقال الأول: الحساب بالأعداد الصحيحة لا يخطئ في التمثيل، وهو نفسه في كل اللغات. - قيد
CHECK (stock >= 0)خط دفاع أخير في قاعدة البيانات نفسها، وسوف نرى في تجربة «ماذا لو» أنه منع البيع الزائد في حالة، ولم يمنعه في حالة أخرى. - الجدول
order_itemsيحفظ سعر المنتج وقت الطلب فيprice_halalas، لأن السعر فيproductsقد يتغير غداً، والفاتورة يجب أن تبقى كما كانت. - جملة
INSERT ... WHERE NOT EXISTSتضيف المنتجات الثلاثة فقط إذا كان الجدول فارغاً، فيمكن تشغيل الملف عند كل بدء للخدمة دون أن تتكرر المنتجات.
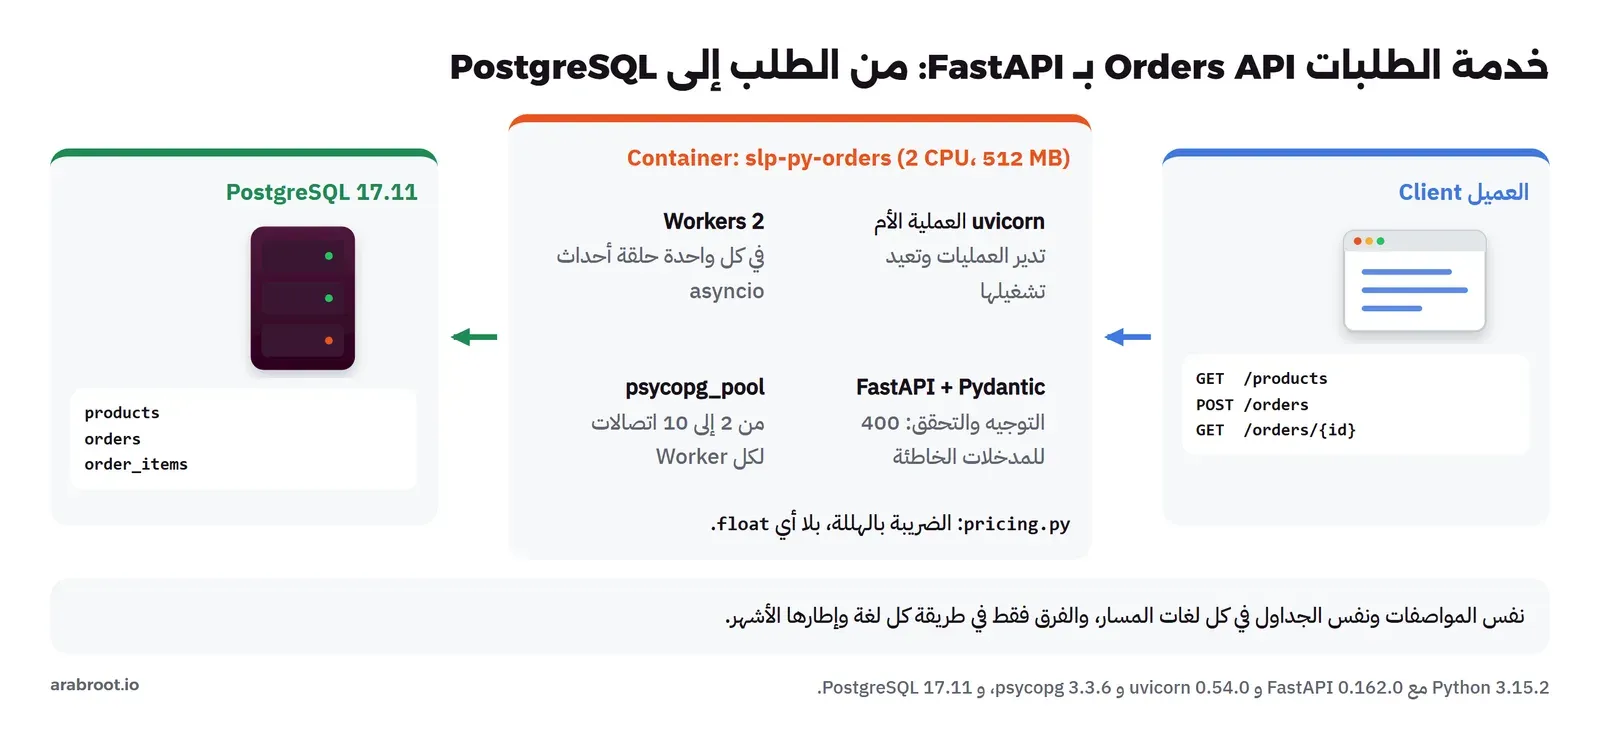
والواجهة ثلاث نقاط: GET /products يرجع قائمة المنتجات، وPOST /orders يستقبل {"items": [{"product_id", "qty"}]} وينشئ الطلب في معاملة واحدة، ويرد بـ 409 إذا لم يكف المخزون وبـ 400 إذا كانت المدخلات خاطئة، وGET /orders/{id} يعرض طلباً. والضريبة 15% كما تطبقها هيئة الزكاة والضريبة والجمارك، تحسب بالهللة مع التقريب لأعلى عند النصف، والمثال الذي يجب أن تمر به كل لغة: ثلاثة أكياس تمر بسعر 9.90 ريال تعطي 29.70 ريالاً، والضريبة 4.455 تصبح 4.46، والإجمالي 34.16 ريالاً.
لماذا FastAPI مع psycopg؟ الخيارات Options قبل القرار
في Python أكثر من طريق لبناء هذه الخدمة، والاختيار يبدأ من نموذج التزامن الذي رأيناه في المقال السابق. فإطار Django مع Django REST Framework هو الأقدم والأكمل، ومعه لوحة إدارة ونظام ترحيل Migrations ومستخدمون جاهزون، وهو الخيار الأنسب عندما تكون الخدمة تطبيقاً كاملاً بشاشات إدارة، ولكنه ثقيل لخدمة من ثلاث نقاط. وFlask خفيف وبسيط ولكنه متزامن في أصله، وكل طلب يحجز Thread أو عملية. أما FastAPI فهو اليوم الإطار الأكثر استعمالاً للخدمات الجديدة من هذا النوع، لأنه يبنى على ASGI أي الواجهة غير المتزامنة لسيرفرات Python، ويقرأ تلميحات الأنواع Type Hints في الدوال ليتحقق من المدخلات ويكتب توثيق OpenAPI تلقائياً، والتوثيق في موقع FastAPI. وهذه النقطة الأخيرة هي ما يربطه بالمقال الثاني من المرحلة: التلميحات التي لا يفحصها CPython عند التشغيل تتحول هنا إلى تحقق حقيقي على حدود الخدمة عبر مكتبة Pydantic.
وأما الوصول إلى قاعدة البيانات فالخيارات أيضاً كثيرة: SQLAlchemy هو الـ ORM الأشهر ويستحق أن تتعلمه للمشاريع الكبيرة، وasyncpg مكتبة غير متزامنة سريعة جداً ولكن لها واجهة خاصة بها، وpsycopg هو المكتبة التاريخية لـ PostgreSQL في Python، والإصدار الثالث منه يدعم الطريقتين المتزامنة وغير المتزامنة بنفس الواجهة، ومعه مجمع اتصالات Connection Pool في الحزمة psycopg_pool، والتوثيق في موقع psycopg. واخترناه هنا مع SQL مكتوب يدوياً بدون ORM، والسبب أن الخدمة المشتركة تقارن اللغات، والـ SQL نفسه يجب أن يكون واضحاً ومتطابقاً في كل اللغات، والقفل FOR UPDATE بالذات يجب أن يكون ظاهراً في الكود وليس مخفياً داخل مكتبة.
هيكل المشروع Project Layout والاعتماديات
المشروع بنفس التخطيط الذي رأيناه في المقال الأول، أي src layout مع uv، والملف pyproject.toml كما يلي:
[project]
name = "orders"
version = "0.1.0"
description = "Orders API for a small store (ArabRoot languages track)"
requires-python = ">=3.15"
dependencies = [
    "fastapi==0.162.0",
    "uvicorn[standard]==0.54.0",
    "psycopg[binary]==3.3.6",
    "psycopg-pool==3.3.3",
]

[dependency-groups]
dev = [
    "pytest==9.2.0",
    "anyio==4.15.1",
    "httpx==0.28.1",
    "asgi-lifespan==2.1.0",
    "ruff==0.17.3",
    "mypy==2.4.1",
]

[build-system]
requires = ["uv_build>=0.13.6,<0.14.0"]
build-backend = "uv_build"

[tool.pytest.ini_options]
testpaths = ["tests"]

[tool.ruff]
line-length = 120

[tool.ruff.lint]
select = ["E", "F", "I", "UP", "B"]
ignore = ["EXE002"]
في الملف أعلاه لاحظ التالي:
- كتبنا الإصدارات بـ
==في الاعتماديات المباشرة لأن هذه خدمة وليست مكتبة يستعملها آخرون، والملفuv.lockيثبت فوقها 42 حزمة بالهاش كما قال الأمرuv lock:Resolved 42 packages. uvicorn[standard]يضيف uvloop وhttptools، وهما إضافتان مكتوبتان بـ C تسرعان حلقة الأحداث وقراءة HTTP، وقبل أن نختار هذه النسخة تأكدنا أن لهما ملفات جاهزة Wheels لـ Python 3.15 على PyPI، وكذلكpsycopg[binary]وpydantic-core، لأن غياب Wheel لإصدار جديد يعني أن pip سوف يحاول بناء المكتبة من المصدر داخل الـ Docker Image، ويحتاج مترجم C أو Rust.- القسم
[tool.ruff.lint]فيه القواعد صراحة كما نصحنا في المقال الأول، ومعهاignore = ["EXE002"]بسبب صلاحيات الملفات القادمة من Windows، ورفعنا طول السطر إلى 120 بعد أول تشغيل في CI كما سوف نرى في قسم الاختبارات.
والشجرة كاملة كما يلي:
service/
├── Dockerfile
├── pyproject.toml
├── uv.lock
├── src/orders/
│   ├── __init__.py
│   ├── app.py         # FastAPI: routes, validation, transaction
│   ├── pricing.py     # VAT and totals in integer halalas
│   └── schema.sql
└── tests/
    ├── test_pricing.py   # unit
    └── test_api.py       # integration, real PostgreSQL 17
دالة الضريبة VAT بالهللة
أصغر ملف في الخدمة وأهمها، لأنه الجزء الذي إذا أخطأ فيه أحد دفع العميل أو المتجر الفرق:
VAT_PERCENT = 15


def vat_halalas(subtotal: int, percent: int = VAT_PERCENT) -> int:
    """VAT rounded half up to the nearest halala: 2970 * 15% = 445.5 -> 446."""
    if subtotal < 0:
        raise ValueError("subtotal must not be negative")
    return (subtotal * percent + 50) // 100


def order_total(lines: list[tuple[int, int]]) -> tuple[int, int, int]:
    """lines = [(price_halalas, qty), ...] -> (subtotal, vat, total)."""
    subtotal = sum(price * qty for price, qty in lines)
    vat = vat_halalas(subtotal)
    return subtotal, vat, subtotal + vat
والمعادلة (subtotal * percent + 50) // 100 هي التقريب لأعلى عند النصف بالأعداد الصحيحة: الضريبة الحقيقية على 2970 هللة هي 445.5 هللة، وإضافة 50 قبل القسمة على 100 تجعل كل ما كان نصفاً أو أكثر يعبر إلى الهللة التالية، فتصبح 446. ولاحظ أن الدالة ترفض المبلغ السالب صراحة، والسبب أن // في Python تقرب نحو سالب ما لا نهاية كما رأينا في المقال الأول، فالمعادلة نفسها تعطي نتيجة خاطئة للمبالغ السالبة، ومبلغ سالب هنا يعني خطأً برمجياً في مكان آخر يجب أن يظهر فوراً وليس أن يمر. وإذا احتاج المتجر يوماً إلى الاسترجاع Refund فمكانه دالة منفصلة بقاعدة تقريب يحددها المحاسب، وليس تمرير رقم سالب إلى نفس الدالة.
التحقق Validation بـ Pydantic: من 422 إلى 400
في FastAPI تكتب شكل المدخلات ككلاس من Pydantic، والإطار يتحقق من جسم الطلب قبل أن يصل إلى دالتك:
class Item(BaseModel):
    product_id: Annotated[StrictInt, Field(gt=0)]
    qty: Annotated[StrictInt, Field(gt=0, le=1000)]


class OrderIn(BaseModel):
    items: Annotated[list[Item], Field(min_length=1, max_length=50)]


@app.exception_handler(RequestValidationError)
async def bad_input(request: Request, exc: RequestValidationError) -> JSONResponse:
    # FastAPI answers 422 by default; the shared spec of the track asks for 400.
    errors = [{"loc": list(e["loc"]), "msg": e["msg"]} for e in exc.errors()]
    return JSONResponse({"error": "bad_input", "details": errors}, status_code=400)
وفي هذا الجزء قراران يستحقان الشرح:
- استعملنا
StrictIntبدلint، والسبب أن Pydantic يعمل افتراضياً في الوضع المتساهل Lax Mode، فيقبل النص"3"ويحوله إلى العدد 3، وهذا يبدو مريحاً، ولكنه يعني أن الخدمة تقبل مدخلات لم تعد بها، ويصعب بعدها أن تغير السلوك دون أن يتعطل عملاء يعتمدون عليه. والوضع الصارم موضح في توثيق Pydantic للوضع الصارم، وهو نفس الدرس الذي رأيناه في المقال الثاني مع الدالة التي استقبلت"3"فكررت النص 990 مرة. - FastAPI يرد افتراضياً بالرمز 422 Unprocessable Entity عندما يفشل التحقق، والمواصفات المشتركة للمسار تطلب 400، ولذلك أضفنا معالجاً للاستثناء
RequestValidationErrorيحول الرد، كما يشرح دليل معالجة الأخطاء في FastAPI. وكلا الرمزين مقبول في عالم الـ API، والمهم أن تختار واحداً وتلتزم به في كل الخدمات.
إنشاء الطلب في معاملة واحدة Transaction
الآن نصل إلى قلب الخدمة، الدالة التي تنشئ الطلب. والقاعدة فيها أن كل ما يخص الطلب يحدث في معاملة واحدة: إما أن يخصم المخزون ويكتب الطلب وأسطره معاً، أو لا يحدث شيء منها:
@app.post("/orders", status_code=201)
async def create_order(order: OrderIn, request: Request) -> dict:
    wanted: Counter[int] = Counter()
    for item in order.items:
        wanted[item.product_id] += item.qty
    ids = sorted(wanted)
    async with request.app.state.pool.connection() as conn:
        async with conn.transaction():
            # Lock the rows in id order: two orders never wait for each other in a cycle.
            cur = await conn.execute(
                "SELECT id, price_halalas, stock FROM products WHERE id = ANY(%s) ORDER BY id FOR UPDATE", (ids,)
            )
            rows = {r["id"]: r for r in await cur.fetchall()}
            missing = [pid for pid in ids if pid not in rows]
            if missing:
                raise HTTPException(400, {"error": "unknown_product", "product_ids": missing})
            for pid in ids:
                if wanted[pid] > rows[pid]["stock"]:
                    raise OutOfStock(pid, wanted[pid], rows[pid]["stock"])
            subtotal, vat, total = order_total([(rows[p]["price_halalas"], wanted[p]) for p in ids])
            for pid in ids:
                await conn.execute("UPDATE products SET stock = stock - %s WHERE id = %s", (wanted[pid], pid))
            cur = await conn.execute(
                "INSERT INTO orders (total_halalas) VALUES (%s) RETURNING id, created_at", (total,)
            )
            head = await cur.fetchone()
            async with conn.cursor() as c:
                await c.executemany(
                    "INSERT INTO order_items (order_id, product_id, qty, price_halalas) VALUES (%s, %s, %s, %s)",
                    [(head["id"], pid, wanted[pid], rows[pid]["price_halalas"]) for pid in ids],
                )
    return {
        "id": head["id"],
        "created_at": head["created_at"].isoformat(),
        "items": [{"product_id": p, "qty": wanted[p], "price_halalas": rows[p]["price_halalas"]} for p in ids],
        "subtotal_halalas": subtotal,
        "vat_halalas": vat,
        "total_halalas": total,
    }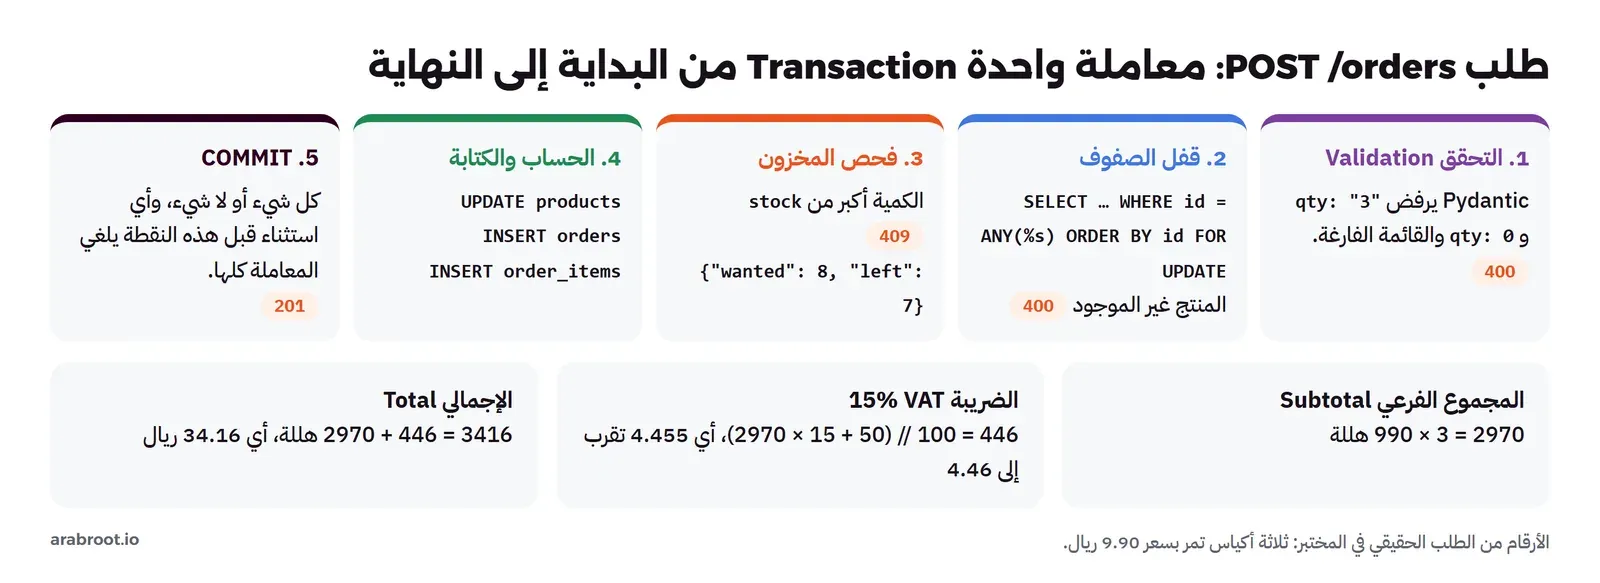
في الكود أعلاه لاحظ التالي:
- جمعنا الكميات بـ
Counterلكل منتج قبل أي شيء، فإذا أرسل العميل نفس المنتج في سطرين صار سطراً واحداً، ولا نقفل نفس الصف مرتين أو نفحص المخزون لكل سطر على حدة. - الكتلة
async with conn.transaction()تبدأ المعاملة، وتنفذCOMMITإذا خرجت الكتلة بنجاح، وROLLBACKإذا خرج منها أي استثناء، ولذلك يكفي أن نرميOutOfStockأوHTTPExceptionلكي يلغى كل شيء، ولا يوجد مسار في الكود يخصم المخزون دون أن يكتب الطلب. FOR UPDATEيقفل صفوف المنتجات حتى نهاية المعاملة، فأي طلب آخر يريد نفس المنتج ينتظر عند نفس السطر حتى ينتهي الأول، ثم يقرأ المخزون بعد الخصم، والتفاصيل في توثيق الأقفال في PostgreSQL.- الجزء
ORDER BY idمعFOR UPDATEليس للترتيب في الرد، وإنما لترتيب القفل نفسه: طلب فيه قهوة وتمر وطلب فيه تمر وقهوة يقفلان الصفوف بنفس الترتيب، فلا يمسك كل واحد صفاً وينتظر الآخر. وهذا هو نفس إصلاح الجمود Deadlock الذي رأيناه بالأقفال في المقال السابق، ولكن في قاعدة البيانات. - الحساب كله بالأعداد الصحيحة من
order_total، والرد يرجع المجموع الفرعي والضريبة والإجمالي منفصلة، لكي لا يحسب العميل الضريبة بنفسه بطريقة مختلفة.
أما مجمع الاتصالات فينشأ مرة واحدة عند بدء كل عملية، في دالة lifespan التي يستدعيها FastAPI عند البدء والإيقاف كما في توثيق أحداث البدء والإيقاف:
@asynccontextmanager
async def lifespan(app: FastAPI):
    pool = AsyncConnectionPool(
        DATABASE_URL, min_size=2, max_size=10, open=False, kwargs={"row_factory": dict_row, "autocommit": True}
    )
    await pool.open(wait=True)
    async with pool.connection() as conn, conn.transaction():
        # Several workers start together: one advisory lock keeps them from creating the tables twice.
        await conn.execute("SELECT pg_advisory_xact_lock(4242)")
        await conn.execute(files("orders").joinpath("schema.sql").read_text(encoding="utf-8"))
    app.state.pool = pool
    yield
    await pool.close()
والخيار "autocommit": True لم يكن في النسخة الأولى، وأضفناه بعد قياس سوف نشرحه في قسم القياس. والسطر الذي فيه pg_advisory_xact_lock جاء من التفكير في ما يحدث عند البدء: uvicorn يشغل عمليتين في نفس اللحظة، وكل واحدة تنفذ CREATE TABLE IF NOT EXISTS، و«إذا لم يكن موجوداً» ليست ذرية بين جلستين، فقد تحاول الجلستان إنشاء نفس الجدول معاً فتفشل إحداهما بخطأ تكرار في جداول النظام. والقفل الاستشاري Advisory Lock قفل باسم رقمي تختاره أنت، كما في توثيق دوال الإدارة، فالعملية الثانية تنتظر حتى تنتهي الأولى من إنشاء الجداول. وفي مشروع أكبر لا تنشئ الجداول من التطبيق أصلاً، وإنما من أداة ترحيل Migrations مثل Alembic تعمل مرة واحدة قبل نشر الإصدار الجديد.
لماذا async def وليس def عادية؟
كل الدوال في الخدمة معرفة بـ async def، وقد يتساءل القادم من Flask: هل هذا ضروري؟ والإجابة أن FastAPI يقبل الشكلين، ولكنه يعاملهما بطريقتين مختلفتين كما يشرح دليل التزامن في FastAPI: الدالة async def تعمل مباشرة في حلقة الأحداث، والدالة العادية def يرسلها الإطار إلى مجمع خيوط Thread Pool لكي لا تحجز الحلقة. وهذا تطبيق مباشر لما قسناه في المقال السابق: إذا كتبت دالة async def واستدعيت فيها مكتبة متزامنة مثل psycopg بالطريقة المتزامنة أو requests، فسوف تحجز الحلقة كلها حتى يرجع الاستعلام، وكل الطلبات الأخرى في نفس العملية تنتظر، تماماً كما انتظر النبض أكثر من ثانية في تجربة حلقة الأحداث. ولذلك القاعدة في FastAPI بسيطة: إذا كانت كل الاستدعاءات داخل الدالة غير متزامنة ومعها await فاكتبها async def، وإذا كان فيها أي مكتبة متزامنة فاكتبها def عادية واترك الإطار يرسلها إلى الخيوط، ولا تخلط بين الطريقتين في نفس الدالة. واخترنا هنا الطريق غير المتزامن كاملاً لأن psycopg 3 يقدم AsyncConnectionPool بنفس الواجهة، فكل استعلام عليه await يعطي الحلقة فرصة لخدمة طلب آخر.
الخدمة تعمل: الطلبات Requests الحقيقية وردودها
بعد تشغيل الخدمة في Container على نفس شبكة PostgreSQL أرسلنا لها الطلبات التالية بـ curl من Container آخر، وهذا المخرج كما جاء:
$ curl http://orders:8000/products
[{"id":1,"name_ar":"قهوة عربية","price_halalas":4500,"stock":50},{"id":2,"name_ar":"تمر سكري","price_halalas":990,"stock":10},{"id":3,"name_ar":"هيل","price_halalas":1500,"stock":30}]
HTTP 200

$ curl -X POST http://orders:8000/orders -H Content-Type: application/json -d {"items":[{"product_id":2,"qty":3}]}
{"id":1,"created_at":"2026-10-31T09:26:19.663831+00:00","items":[{"product_id":2,"qty":3,"price_halalas":990}],"subtotal_halalas":2970,"vat_halalas":446,"total_halalas":3416}
HTTP 201

$ curl http://orders:8000/orders/1
{"id":1,"created_at":"2026-10-31T09:26:19.663831+00:00","items":[{"product_id":2,"qty":3,"price_halalas":990}],"subtotal_halalas":2970,"vat_halalas":446,"total_halalas":3416}
HTTP 200

$ curl -X POST http://orders:8000/orders -H Content-Type: application/json -d {"items":[{"product_id":2,"qty":8}]}
{"error":"out_of_stock","product_id":2,"wanted":8,"left":7}
HTTP 409

$ curl -X POST http://orders:8000/orders -H Content-Type: application/json -d {"items":[{"product_id":2,"qty":"3"}]}
{"error":"bad_input","details":[{"loc":["body","items",0,"qty"],"msg":"Input should be a valid integer"}]}
HTTP 400

$ curl -X POST http://orders:8000/orders -H Content-Type: application/json -d {"items":[{"product_id":99,"qty":1}]}
{"detail":{"error":"unknown_product","product_ids":[99]}}
HTTP 400

$ curl http://orders:8000/orders/999
{"detail":{"error":"not_found","order_id":999}}
HTTP 404
الطلب الأول أعطى الأرقام المطلوبة في المواصفات بالضبط: 2970 و446 و3416 هللة، والمخزون نزل من 10 إلى 7 كما ظهر في رد 409 الذي قال إن المتبقي 7 عندما طلبنا 8. والنص "3" رفض بـ 400 مع مكان الخطأ في الجسم ["body","items",0,"qty"]، وهذا ما أعطاه StrictInt. ولاحظ عيباً حقيقياً في الردود يجب أن تعرفه: أخطاء HTTPException جاءت داخل مفتاح detail، بينما أخطاء التحقق والمخزون جاءت في أعلى الرد، لأن الأولى بشكل FastAPI الافتراضي والأخرى بالمعالجات التي كتبناها. والعميل يحتاج شكلاً واحداً للخطأ في كل الحالات، فالإصلاح الصحيح أن تكتب معالجاً لـ HTTPException أيضاً، أو أن تستعمل شكل application/problem+json المعياري في كل الأخطاء.
ما تعطيك إياه FastAPI مجاناً: توثيق OpenAPI
لأن FastAPI يقرأ أنواع المدخلات والمخرجات من الكود، فهو يكتب وصف الـ API بمعيار OpenAPI تلقائياً، ويعرضه في صفحة تفاعلية على المسار /docs. وهذا ما رجع من الخدمة نفسها:
{"openapi":"3.1.0","info":{"title":"orders","version":"0.1.0"},"paths":{"/products":{"get":{"summary":"List Products","operationId":"list_products_products_get","responses":{"200":{"description":"Successful Response", …
GET /docs -> HTTP 200
والوصف فيه الكلاس OrderIn بكل قيوده، أي أن الواجهة الأمامية أو خدمة أخرى تستطيع أن تولد منه كود العميل أو تتحقق من طلباتها قبل إرسالها. ولكن لاحظ أن رد GET /products موصوف كقائمة كائنات بلا شكل، لأن الدالة ترجع list[dict]، فالتوثيق لا يعرف الحقول. والحل أن تعرف كلاساً للرد مثل Product وتكتبه كنوع الإرجاع، فيصبح التوثيق دقيقاً، ويتحقق FastAPI من الرد نفسه قبل إرساله، وثمن ذلك عمل إضافي في كل طلب، وهذا قرار يستحق أن تقيسه في خدمتك. وفي الإنتاج فكر هل تريد صفحة /docs مفتوحة للجميع، فهي تعرض كل نقاط الـ API لأي أحد، ويمكن إيقافها بالمعامل docs_url=None.
الاختبارات Tests: الوحدة والتكامل والتوازي
اختبارات الوحدة Unit Tests لدالة الضريبة لا تحتاج قاعدة بيانات، وفيها حالة المواصفات وحالات حدود التقريب:
def test_three_bags_of_dates():
    # 9.90 SAR x 3 = 29.70, VAT 4.455 -> 4.46, total 34.16
    assert order_total([(990, 3)]) == (2970, 446, 3416)


@pytest.mark.parametrize(
    ("subtotal", "vat"),
    [(0, 0), (1, 0), (3, 0), (4, 1), (10, 2), (100, 15), (2970, 446), (4500, 675)],
)
def test_vat_rounds_half_up(subtotal, vat):
    assert vat_halalas(subtotal) == vat
والحالتان 3 و4 هما حد التقريب: ضريبة 3 هللات هي 0.45 هللة فتصبح صفراً، وضريبة 4 هللات هي 0.6 فتصبح هللة واحدة، ومثلها 10 هللات تعطي 1.5 فتصبح 2، وهذه الحالات الصغيرة هي التي تكشف خطأ التقريب قبل أن يظهر في فاتورة حقيقية.
أما اختبارات التكامل Integration Tests فتعمل على PostgreSQL 17 حقيقي في Container، والتطبيق نفسه يعمل داخل عملية الاختبار عبر httpx.ASGITransport، أي أن الطلبات لا تمر بشبكة وإنما تستدعي تطبيق ASGI مباشرة، كما في توثيق النقل في httpx، والمكتبة asgi-lifespan تشغل دالة lifespan لكي ينشأ مجمع الاتصالات والجداول:
@pytest.fixture
async def client():
    with psycopg.connect(DB, autocommit=True) as conn:
        conn.execute("DROP TABLE IF EXISTS order_items, orders, products")
    async with LifespanManager(app):
        transport = httpx.ASGITransport(app=app)
        async with httpx.AsyncClient(transport=transport, base_url="http://test") as c:
            yield c


async def test_insufficient_stock_is_409(client):
    r = await client.post("/orders", json={"items": [{"product_id": 2, "qty": 11}]})
    assert r.status_code == 409
    assert r.json() == {"error": "out_of_stock", "product_id": 2, "wanted": 11, "left": 10}


async def test_twenty_parallel_orders_for_stock_ten(client):
    async def buy():
        return (await client.post("/orders", json={"items": [{"product_id": 2, "qty": 1}]})).status_code

    codes = await asyncio.gather(*[buy() for _ in range(20)])
    assert sorted(codes) == [201] * 10 + [409] * 10
    stock = {p["id"]: p["stock"] for p in (await client.get("/products")).json()}
    assert stock[2] == 0
والاختبار الأخير هو اختبار التوازي المطلوب في المواصفات: عشرون طلباً معاً على التمر السكري ومخزونه عشرة، والمطلوب عشرة ردود 201 وعشرة 409 بالضبط، والمخزون صفر في النهاية. وهذه الطلبات متوازية فعلاً على مستوى قاعدة البيانات رغم أنها في حلقة أحداث واحدة، لأن كل طلب يأخذ اتصالاً مختلفاً من المجمع، وكل اتصال جلسة مستقلة في PostgreSQL تنتظر القفل وحدها.
لماذا ASGITransport وليس سيرفراً حقيقياً في الاختبار؟
اختبارات التكامل هنا تستدعي التطبيق داخل نفس العملية، فلا يوجد uvicorn ولا منفذ ولا شبكة بين الاختبار والخدمة، والسبب ثلاثة أشياء: أنها أسرع لأن الطلب لا يمر بـ TCP، وأنها لا تحتاج أن تنتظر سيرفراً يبدأ وتجد له منفذاً حراً في CI، وأن الأخطاء تظهر في الاختبار مع Traceback كامل بدل رد 500 مجهول. وثمن ذلك أن الاختبار لا يرى ما يحدث في الطبقات التي تحت التطبيق: إعداد uvicorn وعدد العمليات والـ Docker Image نفسها، ولذلك لا تكفي هذه الاختبارات وحدها، فالطلبات التي أرسلناها بـ curl إلى الـ Container الحقيقي وقياس wrk هما الفحص الذي يكمل الصورة. وفي مشروع حقيقي يكون هذا الفحص اختبار دخان Smoke Test صغيراً في خط النشر: يشغل الـ Image الجديدة مع قاعدة بيانات مؤقتة، ويرسل الطلبات الأساسية، ولا يسمح بالنشر إذا فشل أي منها.
ولاحظ أن قاعدة البيانات في الاختبار حقيقية وليست بديلاً في الذاكرة مثل SQLite، والسبب أن أهم ما نختبره، أي FOR UPDATE والقيود والمعاملات المتوازية، سلوك خاص بـ PostgreSQL لا تقلده قاعدة أخرى، فاختبار ينجح على SQLite لا يقول شيئاً عن القفل في الإنتاج.
أول تشغيل في CI: ما الذي وجدته أدوات الفحص Linters؟
شغلنا الأدوات الثلاث داخل Container على نفس شبكة PostgreSQL بالملف run-tests.sh:
pip install --root-user-action=ignore -q uv==0.13.6
cp -r /src /tmp/s && cd /tmp/s
uv sync --locked -q
echo "### ruff"; uv run ruff check src tests && uv run ruff format --check src tests || true
echo "### mypy"; uv run mypy src --ignore-missing-imports || true
echo "### pytest"; uv run pytest -v 2>&1 | tail -25
وفي أول تشغيل كان الإعداد بطول السطر الافتراضي، فأعطى ruff ثلاثاً وعشرين ملاحظة كلها E501 Line too long، أغلبها أسطر SQL، وأعطى mypy خطأً واحداً:
src/orders/app.py:73: error: Need type annotation for "wanted"  [var-annotated]
Found 1 error in 1 file (checked 3 source files)
والخطأ صحيح، فالسطر wanted = Counter() لا يقول لـ mypy ماذا سوف يعد، فأصلحناه إلى wanted: Counter[int] = Counter(). وأما الأسطر الطويلة فقرار فريق وليس خطأ، فجمل SQL تقرأ أفضل في سطر واحد، ولذلك رفعنا الحد إلى 120 وشغلنا ruff format مرة واحدة ليوحد التنسيق. والتشغيل النهائي كما يلي:
### ruff
All checks passed!
5 files already formatted
### mypy
Success: no issues found in 3 source files
### pytest
tests/test_api.py::test_products_seeded PASSED                           [  5%]
tests/test_api.py::test_order_total_and_stock PASSED                     [ 10%]
tests/test_api.py::test_bad_input_is_400[payload0] PASSED                [ 15%]
tests/test_api.py::test_bad_input_is_400[payload1] PASSED                [ 20%]
tests/test_api.py::test_bad_input_is_400[payload2] PASSED                [ 25%]
tests/test_api.py::test_bad_input_is_400[payload3] PASSED                [ 30%]
tests/test_api.py::test_bad_input_is_400[payload4] PASSED                [ 35%]
tests/test_api.py::test_insufficient_stock_is_409 PASSED                 [ 40%]
tests/test_api.py::test_unknown_order_is_404 PASSED                      [ 45%]
tests/test_api.py::test_twenty_parallel_orders_for_stock_ten PASSED      [ 50%]
tests/test_pricing.py::test_three_bags_of_dates PASSED                   [ 55%]
tests/test_pricing.py::test_vat_rounds_half_up[0-0] PASSED               [ 60%]
tests/test_pricing.py::test_vat_rounds_half_up[1-0] PASSED               [ 65%]
tests/test_pricing.py::test_vat_rounds_half_up[3-0] PASSED               [ 70%]
tests/test_pricing.py::test_vat_rounds_half_up[4-1] PASSED               [ 75%]
tests/test_pricing.py::test_vat_rounds_half_up[10-2] PASSED              [ 80%]
tests/test_pricing.py::test_vat_rounds_half_up[100-15] PASSED            [ 85%]
tests/test_pricing.py::test_vat_rounds_half_up[2970-446] PASSED          [ 90%]
tests/test_pricing.py::test_vat_rounds_half_up[4500-675] PASSED          [ 95%]
tests/test_pricing.py::test_negative_subtotal_is_a_bug PASSED            [100%]

============================= 20 passed in 11.05s ==============================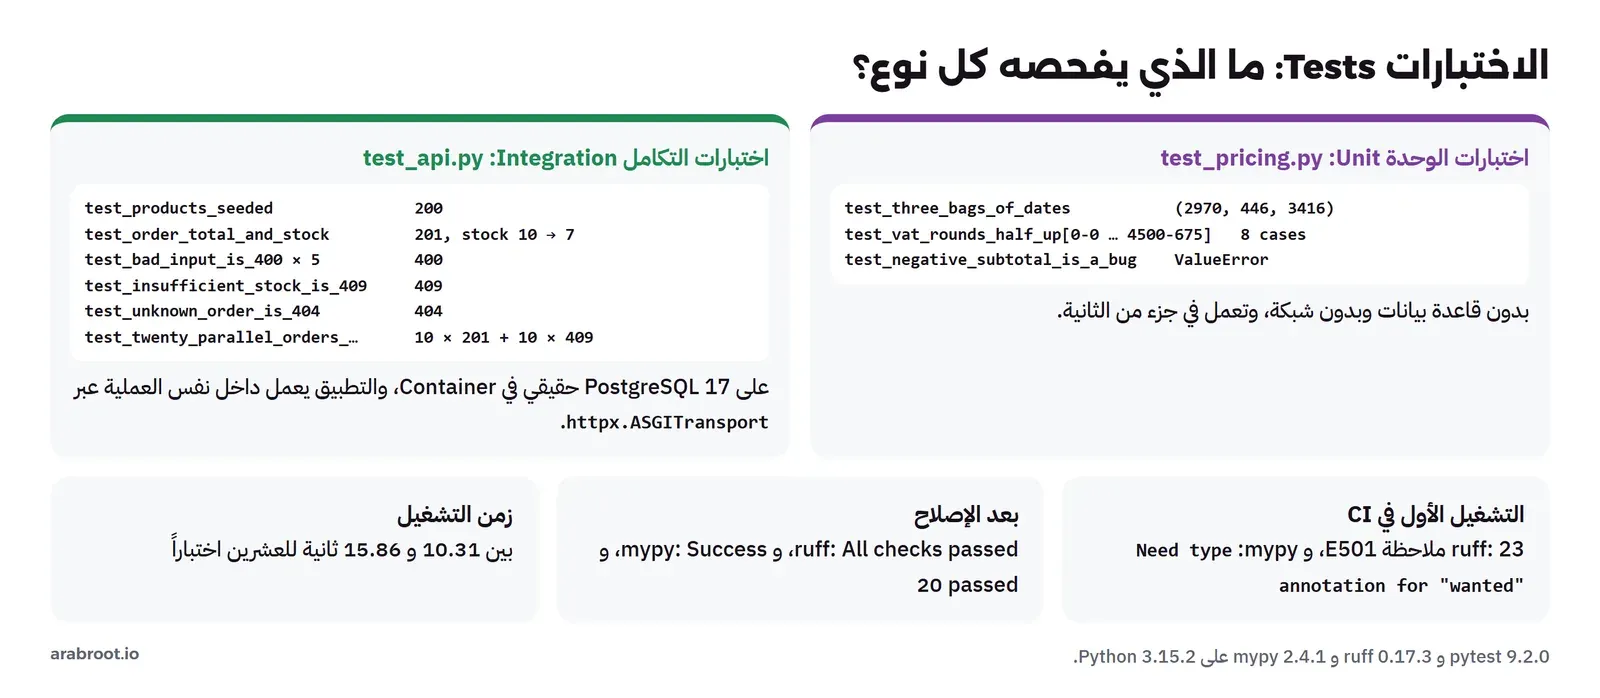
وقد شرحنا أنواع الاختبارات ومتى تكتب كل نوع في مقال أنواع الاختبارات، والنقطة التي نضيفها هنا أن اختبار التوازي لا يكتب في كل مشروع، ولكنه في أي خدمة فيها مخزون أو رصيد هو أهم اختبار في المجموعة كلها، لأنه الوحيد الذي يكشف خطأً لا يظهر أبداً عندما يجرب المطور الخدمة بنفسه طلباً بعد طلب.
ماذا لو What If: أزلنا FOR UPDATE من الاستعلام؟
لكي نرى قيمة القفل بالأرقام شغلنا نفس اختبار التوازي على نسختين معدلتين من الكود، كل واحدة في نسخة مؤقتة داخل الـ Container دون أن نلمس الكود الأصلي. النسخة الأولى حذفت FOR UPDATE فقط، وأبقت الخصم النسبي SET stock = stock - %s:
sed -i 's/ ORDER BY id FOR UPDATE/ ORDER BY id/' src/orders/app.py
uv run pytest -q tests/test_api.py::test_twenty_parallel_orders_for_stock_ten
E psycopg.errors.CheckViolation: new row for relation "products" violates check constraint "products_stock_check"
E DETAIL: Failing row contains (2, تمر سكري, 990, -1).
1 failed in 11.93sبدون القفل قرأت الطلبات العشرون المخزون 10 تقريباً في نفس الوقت، ومرت كلها من فحص المخزون في Python، ثم وصلت إلى UPDATE. ولأن الخصم نسبي، فقاعدة البيانات نفسها تنفذ كل UPDATE على أحدث قيمة للصف بعد أن ينتهي من قبله، فخصمت عشر مرات بنجاح، وفي المرة الحادية عشرة كانت النتيجة -1، فرفضها القيد CHECK (stock >= 0). وهذا يعني أن القيد منع البيع الزائد، ولكن العميل الحادي عشر حصل على خطأ 500 من الخدمة بدل رسالة 409 واضحة، والسجل امتلأ بأخطاء تبدو كأنها خلل في قاعدة البيانات.
والنسخة الثانية أسوأ، وهي الكود الذي يكتبه كثيرون دون أن ينتبهوا: بدون FOR UPDATE، والمخزون الجديد محسوب في Python من القيمة التي قرأناها:
sed -i 's/ ORDER BY id FOR UPDATE/ ORDER BY id/' src/orders/app.py
sed -i 's/"UPDATE products SET stock = stock - %s WHERE id = %s", (wanted\[pid\], pid)/"UPDATE products SET stock = %s WHERE id = %s", (rows[pid]["stock"] - wanted[pid], pid)/' src/orders/app.py
E assert [201, 201, 20...201, 201, ...] == [201, 201, 20...201, 201, ...]
E At index 10 diff: 201 != 409
1 failed in 14.22s
orders_for_dates | stock_left
------------------+------------
20 | 6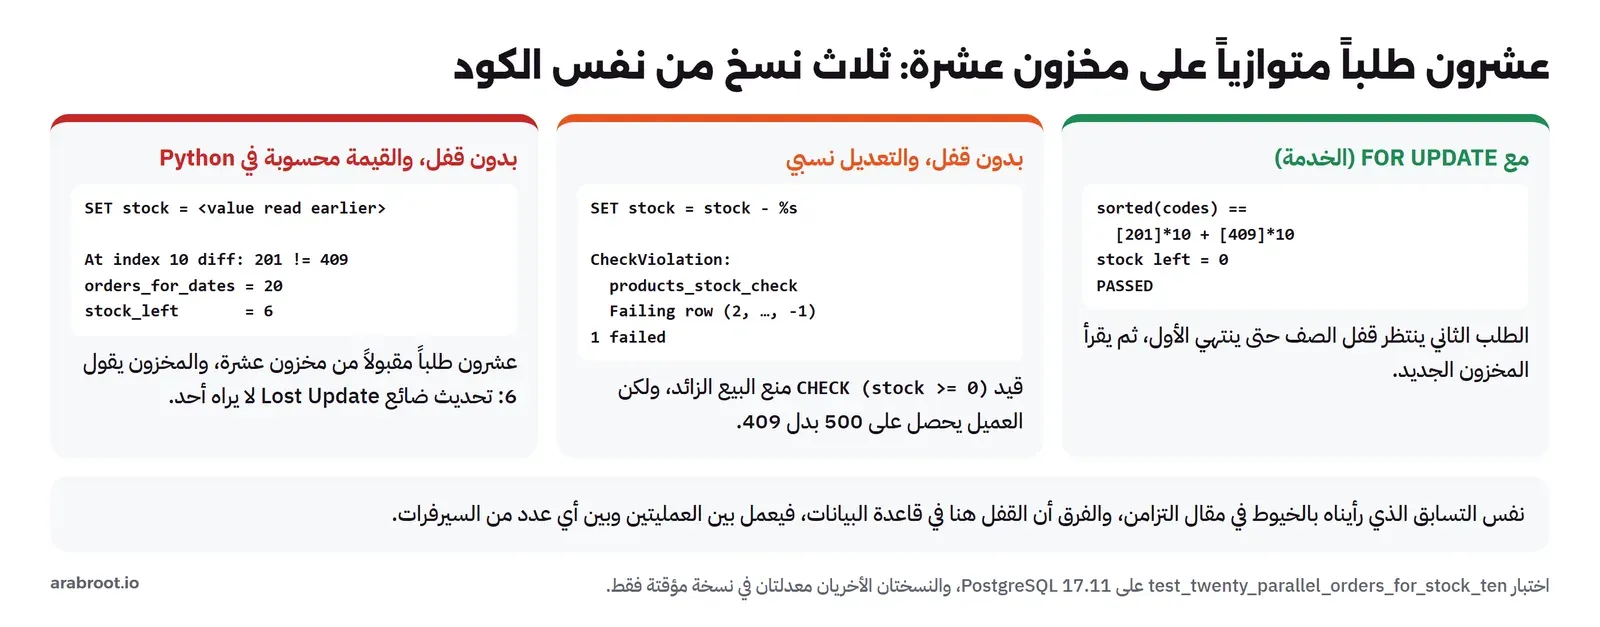
هذه المرة قبلت الخدمة عشرين طلباً كاملة من مخزون عشرة، والاستعلام المباشر بعد الاختبار قال إن هناك عشرين سطراً للتمر في order_items، والمخزون 6 وليس صفراً ولا سالباً، فالقيد لم يعترض لأن أي قيمة كتبت كانت موجبة. وهذا هو التحديث الضائع Lost Update: كل طلب كتب «المخزون الذي قرأته ناقص واحد» فوق ما كتبه غيره، ولا يوجد أي خطأ في السجل، والمشكلة تظهر فقط عندما يذهب العامل إلى المخزن ولا يجد البضاعة. وسبب ذلك أن المستوى الافتراضي لعزل المعاملات في PostgreSQL هو Read Committed، وهو لا يمنع هذا النمط من تلقاء نفسه كما يشرح توثيق عزل المعاملات، فإما أن تقفل الصفوف بـ FOR UPDATE كما فعلنا، أو أن تجعل التعديل شرطياً مثل UPDATE ... SET stock = stock - %s WHERE id = %s AND stock >= %s وتفحص عدد الصفوف المتأثرة، أو أن ترفع مستوى العزل وتعيد المحاولة عند الفشل.
الـ Dockerfile متعدد المراحل Multi-stage
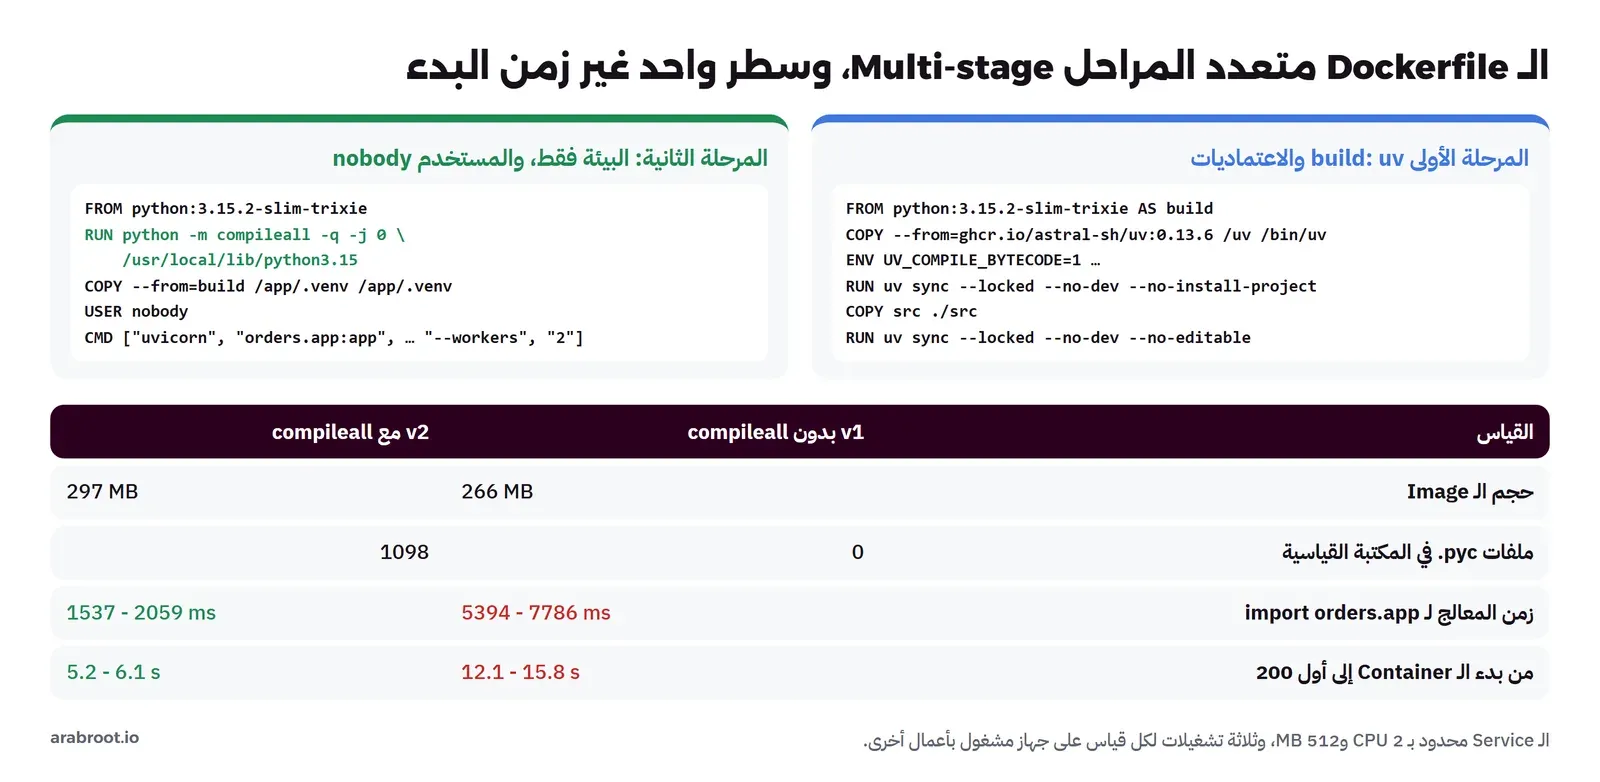
الـ Image الخاصة بالخدمة تبنى على مرحلتين: الأولى فيها uv تثبت الاعتماديات من uv.lock في بيئة افتراضية، والثانية تأخذ البيئة فقط بدون uv وبدون ملفات البناء، وتعمل بمستخدم غير root. وهذا هو الشكل الذي يوصي به دليل uv مع Docker:
# syntax=docker/dockerfile:1
# Stage 1: resolve and install the locked dependencies and the app into /app/.venv, compiled to .pyc.
FROM python:3.15.2-slim-trixie AS build
COPY --from=ghcr.io/astral-sh/uv:0.13.6 /uv /bin/uv
ENV UV_COMPILE_BYTECODE=1 UV_LINK_MODE=copy UV_PYTHON_DOWNLOADS=never
WORKDIR /app
COPY pyproject.toml uv.lock ./
RUN uv sync --locked --no-dev --no-install-project
COPY src ./src
RUN uv sync --locked --no-dev --no-editable

# Stage 2: the same Python, only the virtual environment, no uv, no compilers, not root.
FROM python:3.15.2-slim-trixie
# The official image ships the standard library without .pyc files, and "nobody" cannot write them:
# without this line every start compiles the stdlib again.
RUN python -m compileall -q -j 0 /usr/local/lib/python3.15
COPY --from=build /app/.venv /app/.venv
ENV PATH="/app/.venv/bin:$PATH" PYTHONUNBUFFERED=1
USER nobody
EXPOSE 8000
CMD ["uvicorn", "orders.app:app", "--host", "0.0.0.0", "--port", "8000", "--workers", "2", "--no-access-log"]
في الملف أعلاه لاحظ التالي:
- الأمر
uv syncمكرر مرتين، الأولى بـ--no-install-projectبعد نسخ ملفي الاعتماديات فقط، والثانية بعد نسخ الكود، والسبب أن Docker يحفظ كل خطوة في طبقة Layer، فإذا عدلت سطراً فيapp.pyلا يعيد تنزيل الاعتماديات، وإنما يبدأ من خطوة نسخ الكود. UV_COMPILE_BYTECODE=1يترجم كل الحزم إلى ملفات.pycوقت البناء، و--no-editableيثبت المشروع نفسه كحزمة عادية داخل البيئة بدل رابط إلى مجلدsrc، فالمرحلة الثانية لا تحتاج الكود المصدري.- العمليتان
--workers 2بعدد المعالجات المتاحة للـ Container، كما شرحنا في المقال السابق: كل عملية لها حلقة أحداث، والعمليات تستعمل المعالجات التي لا يستطيع الـ GIL استعمالها. - السطر
compileallلم يكن موجوداً في النسخة الأولى، والقسم التالي يشرح لماذا أضفناه.
مشكلة واجهناها: زمن البدء Cold Start تجاوز 12 ثانية
عندما قسنا زمن البدء أول مرة جاءت الأرقام كبيرة جداً، فأعدنا القياس من داخل شبكة Docker بـ Container صغير يسأل الخدمة كل 20 ميلي ثانية حتى يحصل على أول رد 200، ونقارن وقته بوقت بدء الـ Container في docker inspect، وسجل uvicorn مع الوقت يبين أين ذهب الوقت:
run 2: container StartedAt -> first 200: 12084 ms
   2026-10-31T09:10:50.707934901Z INFO:     Uvicorn running on http://0.0.0.0:8000 (Press CTRL+C to quit)
   2026-10-31T09:10:58.422643904Z INFO:     Started server process [11]
   2026-10-31T09:10:58.742874743Z INFO:     Application startup complete.
   2026-10-31T09:10:58.759489002Z INFO:     Started server process [10]
   2026-10-31T09:10:59.014357446Z INFO:     Application startup complete.
بين سطر «Uvicorn running» وبدء العمليتين حوالي ثماني ثوان، وفي هذه الفترة تبدأ كل عملية مفسراً جديداً وتستورد التطبيق. فقسنا زمن import orders.app وحده، فكان حوالي خمس ثوان. وتذكرنا ما رأيناه في المقال الأول: الـ Image الرسمية تأتي بالمكتبة القياسية بدون ملفات .pyc، وفي ذلك المقال كان المفسر يكتبها بعد أول تشغيل فتسرع المرات التالية، أما هنا فالخدمة تعمل بالمستخدم nobody الذي لا يملك صلاحية الكتابة في /usr/local/lib/python3.15، فيترجم المفسر كل وحدة من المكتبة القياسية في الذاكرة عند كل بدء ثم يرميها. وأضفنا سطر compileall كما في الملف أعلاه، وبنينا الإصدار الثاني، ثم قسنا الاستيراد في الإصدارين بالتناوب ثلاث مرات. ولأن الجهاز كان مشغولاً بأعمال أخرى أعطى الزمن الفعلي أرقاماً متقلبة، فقسنا زمن المعالج معه كما تعلمنا في المقال السابق:
image v1 import orders.app: wall 5646 ms, cpu 5394 ms
image v2 import orders.app: wall 1555 ms, cpu 1537 ms
image v1 import orders.app: wall 7823 ms, cpu 7786 ms
image v2 import orders.app: wall 2039 ms, cpu 1946 ms
image v1 import orders.app: wall 6627 ms, cpu 6500 ms
image v2 import orders.app: wall 2076 ms, cpu 2059 ms
زمن المعالج نزل من بين 5.4 و7.8 ثانية إلى بين 1.5 و2.1 ثانية، أي أن ثلاثة أرباع زمن الاستيراد كانت ترجمة المكتبة القياسية في كل مرة. وقياس البدء الكامل على الإصدار الثاني:
run 1: container StartedAt -> first 200: 5748 ms
run 2: container StartedAt -> first 200: 6094 ms
run 3: container StartedAt -> first 200: 5164 ms
من 12.1 إلى 15.8 ثانية في الإصدار الأول إلى 5.2 إلى 6.1 ثانية في الثاني، والثمن 31 ميجابايت في حجم الـ Image، من 266 إلى 297 ميجابايت. وهذه أرقام عالية في المطلق بسبب انشغال الجهاز وقت القياس، فقد أخذ import json وحده 40 ميلي ثانية في نفس الفترة بينما يأخذ عادة بضع ميلي ثوان، ولكن الفرق بين الإصدارين ثابت في كل التشغيلات. والدرس العام: إذا كانت خدمتك تعمل بمستخدم غير root، وهذا ما يجب أن يكون، فترجم المكتبة القياسية وكل اعتمادياتك وقت البناء، وإلا دفعت ثمن الترجمة في كل بدء، وهو ثمن يظهر بقوة عند التوسع التلقائي حين تبدأ نسخ جديدة تحت ضغط.
القياس Benchmark: الحجم والذاكرة والطلبات في الثانية
القياسات المطلوبة في المواصفات المشتركة كلها على Container محدود بمعالجين و512 ميجابايت، والملف measure.sh يشغل الخدمة وينتظر 15 ثانية بعد البدء ثم يقرأ الذاكرة، ثم يشغل wrk مرتين من Container آخر على نفس الشبكة، والأداة wrk تفتح 50 اتصالاً على خيطين وتكرر الطلب 15 ثانية:
docker run -d --name slp-py-orders --network slp-py-svc --network-alias orders --cpus 2 --memory 512m \
  -e DATABASE_URL=postgresql://shop:shop@pg:5432/shop slp-py-orders:2
docker stats --no-stream --format '{{.Name}} {{.MemUsage}} {{.CPUPerc}}' slp-py-orders
docker run --rm --network slp-py-svc slp-py-wrk:1 -t2 -c50 -d15s --latency http://orders:8000/products
والمخرج للإصدار الثاني كما يلي:
### image size
slp-py-orders:2 297MB
### idle memory (15 s after startup)
slp-py-orders 120.1MiB / 512MiB 0.49%
### wrk run 1
  2 threads and 50 connections
  Thread Stats   Avg      Stdev     Max   +/- Stdev
    Latency   112.10ms   54.22ms 493.15ms   71.24%
    Req/Sec   226.55     91.75   596.00     71.97%
  Latency Distribution
     50%  104.48ms
     75%  141.35ms
     90%  181.83ms
     99%  280.54ms
  6759 requests in 15.02s, 2.11MB read
Requests/sec:    450.08
### wrk run 2
  2 threads and 50 connections
  Thread Stats   Avg      Stdev     Max   +/- Stdev
    Latency    86.20ms   35.75ms 261.38ms   68.24%
    Req/Sec   291.09    100.80   656.00     67.35%
  Latency Distribution
     50%   81.38ms
     75%  108.76ms
     90%  134.88ms
     99%  188.29ms
  8720 requests in 15.06s, 2.72MB read
Requests/sec:    579.17
### memory after load
slp-py-orders 122.3MiB / 512MiB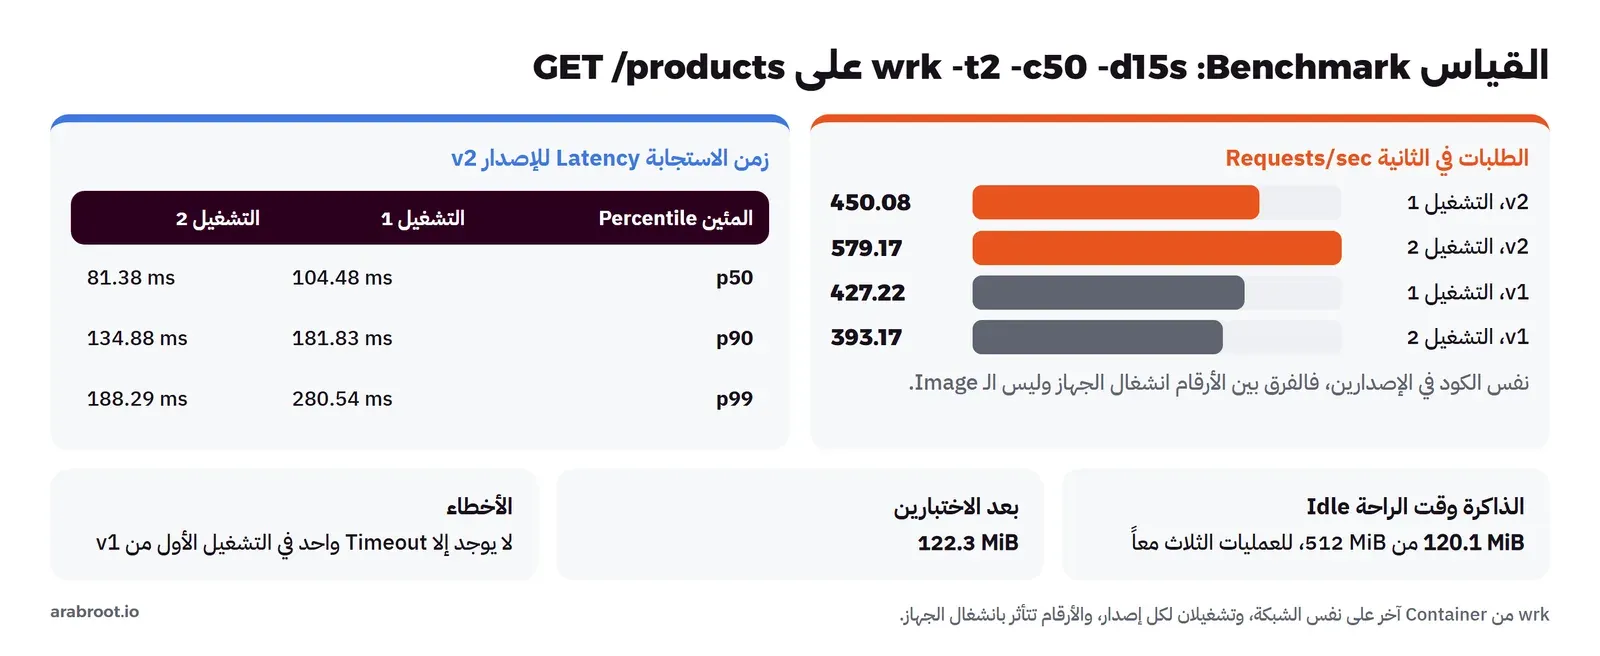
في المخرج أعلاه لاحظ التالي:
- الخدمة أعطت 450 و579 طلباً في الثانية في التشغيلين، والإصدار الأول بنفس الكود أعطى 427 و393، فالفرق بين التشغيلات أكبر من الفرق بين الإصدارين، وهذا متوقع لأن
compileallيؤثر في البدء وليس في الطلبات. ولذلك لا تقرأ هذه الأرقام على أنها سرعة Python المطلقة، وإنما كترتيب حجم على جهاز مشترك مشغول، والمقارنة العادلة بين اللغات تكون على نفس الجهاز في نفس الظروف. - كل طلب
GET /productsيأخذ اتصالاً من المجمع وينفذ استعلاماً حقيقياً على PostgreSQL ويحول ثلاثة صفوف إلى JSON، فالرقم يقيس الطريق كله وليس الإطار وحده. - زمن الاستجابة p50 بين 81 و104 ميلي ثانية مع خمسين اتصالاً، وهذا يعني أن الطلبات تنتظر دورها في الحلقتين أكثر مما تنتظر قاعدة البيانات، وp99 بين 188 و281 ميلي ثانية، والمئين Percentile شرحناه في مقال اختبار الضغط Load Testing.
- الذاكرة وقت الراحة 120.1 ميجابايت للعمليات الثلاث معاً: العملية الأم وعمليتا الـ Workers، وكل Worker حوالي 75 ميجابايت كما ظهر في
/procداخل الـ Container في القياس الأول، وبعد اختبارين من خمس عشرة ثانية بقيت 122.3، أي أن الذاكرة لم تكبر مع الطلبات.
وقد يتساءل البعض: هل هذه الأرقام جيدة؟ والإجابة أنها تعتمد على الحاجة وليس على المقارنة: المتجر في أكثر ساعاته ازدحاماً لا يقترب من عشرات الطلبات في الثانية، وخدمة واحدة بمعالجين تكفيه بفارق كبير، وإذا احتاج أكثر فإضافة عملية أو Container أرخص من إعادة كتابة الخدمة بلغة أخرى. أما إذا كانت الخدمة نفسها تحت ضغط كبير دائم وكل ميلي ثانية من المعالج تكلف مالاً، فهنا تبدأ المقارنة بين اللغات تهم، وهذا ما نفعله في مقالات المسار.
مجمع الاتصالات Connection Pool وتحسين autocommit
كل عملية من العمليتين تفتح مجمع اتصالات من 2 إلى 10، فالخدمة كلها تفتح بين 4 و20 اتصالاً بقاعدة البيانات، والحد الافتراضي في PostgreSQL هو max_connections = 100 كما أعطاه الأمر SHOW max_connections. وهذا الحساب هو أول ما تفعله قبل أن تزيد عدد العمليات أو عدد نسخ الخدمة: عشر نسخ من الخدمة بعمليتين وعشرة اتصالات لكل عملية تعني 200 اتصال، أي ضعف الحد، وسوف تبدأ الاتصالات الجديدة بالفشل في أسوأ لحظة، أي تحت الضغط. وعندما تنفد اتصالات المجمع نفسه ينتظر الطلب الجديد اتصالاً يتحرر حتى 30 ثانية افتراضياً بحسب توثيق psycopg_pool، ثم يفشل، فاختر حجم المجمع ومهلة الانتظار بحيث يفشل الطلب بسرعة ورسالة واضحة بدل أن يعلق نصف دقيقة.
وعندما فحصنا الاتصالات أثناء تشغيل wrk على النسخة الأولى ظهر شيء لم نتوقعه:
### connections from the service while idle
4
### connections during wrk (sampled after 5 s)
idle|7
idle in transaction|6
وقت الراحة كانت الاتصالات أربعة، أي min_size=2 في كل عملية كما هو متوقع، ولكن أثناء الضغط ظهرت ستة اتصالات في حالة idle in transaction، رغم أن GET /products لا يفتح أي معاملة في الكود. والسبب أن psycopg يعمل افتراضياً بدون autocommit، أي أن أول استعلام على الاتصال يبدأ معاملة ضمنية بـ BEGIN، وتبقى المعاملة مفتوحة حتى يعيد المجمع الاتصال وينفذ ROLLBACK، كما يشرح توثيق المعاملات في psycopg. فكل طلب قراءة بسيط كان يدفع ثمن رحلتين إضافيتين إلى قاعدة البيانات، ويبقي معاملة مفتوحة أطول من اللازم. والحل أن نفتح الاتصالات بـ autocommit=True، وأما إنشاء الطلب فيبقى في معاملة صريحة لأن conn.transaction() يبدأ معاملة حقيقية حتى في هذا الوضع، وقد تأكدنا من ذلك بتشغيل الاختبارات العشرين على النسخة الجديدة فنجحت كلها، ومنها اختبار التوازي. ثم قسنا النسختين بالتناوب على نفس الجهاز، كل نسخة مرة في كل جولة:
round 1 image v2: Requests/sec:    526.56  p50 89.53ms  p99 221.78ms
round 1 image v3: Requests/sec:    682.20  p50 63.37ms  p99 199.93ms
round 2 image v2: Requests/sec:    698.27  p50 64.86ms  p99 225.74ms
round 2 image v3: Requests/sec:   1118.16  p50 38.02ms  p99 122.82ms
في الجولتين كانت النسخة مع autocommit أسرع، بزيادة بين 30% و60% في الطلبات في الثانية، وزمن p50 أقل بوضوح، والتقلب بين الجولتين نفسه كبير بسبب الجهاز، ولذلك قسنا بالتناوب بدل أن نشغل نسخة كاملة ثم الأخرى. وقياس النسخة النهائية بنفس measure.sh أعطى 657.24 و642.61 طلباً في الثانية، والذاكرة 120.2 ميجابايت وقت الراحة و122.6 بعد الضغط. وهذا مثال على أن أكبر تحسين في خدمة حقيقية غالباً لا يأتي من تغيير اللغة أو الإطار، وإنما من فهم ما يحدث بين الخدمة وقاعدة البيانات.
ما الذي ينقص هذه الخدمة قبل الإنتاج Production؟
الخدمة كما بنيناها تحقق المواصفات المشتركة، ولكنها ليست جاهزة للإنتاج بعد، ومن المفيد أن تعرف ما ينقصها بالتحديد حتى لا تظن أن مثالاً يعمل يكفي. أولها فحص الصحة Health Check: نقطة مثل /healthz ترد بسرعة وتفحص أن قاعدة البيانات متاحة، لكي يعرف الـ Load Balancer أو Kubernetes متى يرسل الطلبات للنسخة الجديدة ومتى يخرج نسخة معطلة. وثانيها السجلات Logs: أوقفنا سجل الوصول بـ --no-access-log لكي لا يؤثر على القياس، أما في الإنتاج فتحتاج سجلاً منظماً بصيغة JSON فيه معرف لكل طلب، يربط سطر الخطأ بالطلب الذي سببه. وثالثها الإيقاف الهادئ Graceful Shutdown: uvicorn يستقبل إشارة SIGTERM من Docker ويكمل الطلبات الجارية قبل أن يخرج، ودالة lifespan تغلق المجمع، ولكن عليك أن تتأكد أن مهلة الإيقاف في منصتك أطول من أطول طلب. ورابعها الأسرار Secrets: عنوان قاعدة البيانات بكلمة المرور يمر هنا كمتغير بيئة نصي، وفي الإنتاج يأتي من مدير أسرار ولا يكتب في أي ملف في المستودع. وخامسها الترحيل Migrations الذي ذكرناه، والمهلة على كل استعلام بـ statement_timeout لكي لا يحجز استعلام بطيء اتصالاً من المجمع إلى الأبد. وكل واحدة من هذه النقاط سطر أو سطران في الكود، ولكن غيابها هو ما يحول مشكلة صغيرة في الإنتاج إلى ساعة من البحث.
أخطاء شائعة Common Mistakes
- فحص المخزون في Python ثم كتابة القيمة المحسوبة بدون قفل، فيضيع التحديث بصمت كما رأينا في النسخة الثانية من التجربة.
- الاعتماد على قيد
CHECKوحده، فيمنع القيمة السالبة ولكنه يرد على العميل بـ 500 ولا يمنع التحديث الضائع. - قفل الصفوف بدون ترتيب ثابت، فيجمد طلبان كل منهما يمسك منتجاً وينتظر الآخر.
- ترك Pydantic في الوضع المتساهل، فتقبل الخدمة
"3"نصاً وتصبح هذه عادة يعتمد عليها العملاء. - إنشاء الجداول من كل عملية عند البدء بدون قفل استشاري أو أداة ترحيل.
- تشغيل الخدمة بمستخدم غير root دون ترجمة المكتبة القياسية مسبقاً، فيدفع كل بدء ثمن الترجمة.
- عدد Workers أكبر من المعالجات المتاحة للـ Container، فتتنافس العمليات على نفس المعالجين وتزيد الذاكرة دون فائدة.
- ترك psycopg بدون autocommit لطلبات القراءة، فيفتح كل استعلام معاملة ضمنية تبقى حتى يعود الاتصال إلى المجمع.
- شكلان مختلفان لرسائل الخطأ في نفس الخدمة، كما ظهر في
detailمقابل الرد المباشر.
قائمة تحقق Checklist قبل النشر
- هل كل المبالغ أعداد صحيحة بالهللة من الطلب إلى قاعدة البيانات، ولدالة الضريبة اختبارات لحدود التقريب؟
- هل الطلب كله في معاملة واحدة، والصفوف مقفلة بترتيب ثابت؟
- هل يوجد اختبار توازي على قاعدة بيانات حقيقية لكل مورد محدود كالمخزون؟
- هل ruff وmypy وpytest تعمل في CI بإعداد مكتوب صراحة؟
- هل الـ Image متعددة المراحل، وتعمل بمستخدم غير root، ومكتباتها مترجمة إلى
.pycوقت البناء؟ - هل عدد الـ Workers بعدد المعالجات المتاحة، ومجمع الاتصالات بحجم تتحمله قاعدة البيانات مضروباً في عدد العمليات؟
- هل قست زمن البدء والذاكرة وعدد الطلبات على نفس الحدود التي سوف تعمل بها في الإنتاج، وكررت القياس؟
- هل شكل الخطأ واحد في كل الردود؟
- هل حسبت عدد الاتصالات بقاعدة البيانات عند أقصى عدد من النسخ، وهل هو أقل من
max_connectionsمع هامش لأدوات الإدارة والترحيل؟ - هل طلبات القراءة تعمل بـ autocommit، والمعاملات الصريحة فقط حيث تحتاجها فعلاً؟
تدريب عملي
- أضف معالجاً لـ
HTTPExceptionيرجع نفس شكل{"error": ...}، وعدل الاختبارات لتتأكد من الشكل في 400 و404. - غير الخصم إلى
UPDATE ... WHERE id = %s AND stock >= %sبدونFOR UPDATE، وافحصcur.rowcount، وشغل اختبار التوازي لترى هل يكفي هذا وحده. - شغل الخدمة بـ
--workers 1ثم--workers 4على نفس حد المعالجين، وقارن نتيجة wrk والذاكرة. - أضف نقطة
/healthzتنفذSELECT 1بمهلة قصيرة، ثم أوقف PostgreSQL وراقب ماذا ترجع، وكم تأخذ. - أضف Alembic وانقل إنشاء الجداول من
lifespanإلى أول ترحيل.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الخدمة بـ FastAPI وpsycopg مع SQL مكتوب يدوياً أعطت أرقام المواصفات بالضبط: 2970 و446 و3416 هللة، وعشرين اختباراً ناجحاً منها اختبار التوازي.
- FastAPI يحول تلميحات الأنواع إلى تحقق حقيقي عبر Pydantic، ولكن عليك أن تختار الوضع الصارم وأن تحول 422 إلى 400 إذا كانت المواصفات تطلب ذلك.
FOR UPDATEمعORDER BY idجعل عشرين طلباً متوازياً تعطي عشرة 201 وعشرة 409 بالضبط، وبدونه إما 500 من القيد أو عشرون طلباً مقبولاً من مخزون عشرة بلا أي خطأ.- الـ Image متعددة المراحل بحجم 297 ميجابايت، وسطر
compileallأنزل البدء من 12 إلى 16 ثانية إلى 5 إلى 6 ثوان على جهاز مشغول. - الخدمة أخذت 120 ميجابايت وقت الراحة، وأعطت بين 450 و579 طلباً في الثانية على معالجين في النسخة الأولى، مع تقلب بين التشغيلات سببه الجهاز وليس الكود.
- فتح الاتصالات بـ autocommit أزال معاملة ضمنية من كل طلب قراءة، فزادت الطلبات في الثانية بين 30% و60% في قياس بالتناوب، ووصلت النسخة النهائية إلى بين 643 و1118 طلباً في الثانية.
وفي المقال الأخير من مرحلة لغة Python للمطورين سوف نجمع الأخطاء التي يقع فيها القادمون من لغات أخرى، كل واحد مع تشغيل خاطئ حقيقي وإصلاحه، ثم خطة قراءة من المصادر الرسمية:
 دليلPython للمطورين: التركيب Syntax والأدوات في يوم واحددليل لمن يبرمج بلغة أخرى ويريد أن يبدأ بـ Python 3.15 من أول يوم: التثبيت، وما يختلف في التركيب، والأدوات uv وruff وmypy وpytest على مشروع حقيقي بمخرجه الفعلي.
 دليلPython من الداخل: الأنواع Types والذاكرة والاستثناءاتما هو المتغير فعلاً في Python، ومن يحرر الذاكرة، وكيف تعبر اللغة عن الخطأ، بقياسات حقيقية على Python 3.15 من حجم مليون سجل إلى Container قتلته النواة دون رسالة.
 دليلالتزامن Concurrency في Python: الخيوط و asyncio وقفل GILقسنا مئة طلب HTTP وأربعة ملايين عملية هاش بالخيوط وasyncio والعمليات والبناء الخالي من القفل في Python 3.15، ثم أعدنا تسابقاً باع عشرين قطعة من مخزون عشرة وجموداً بين قفلين وأصلحناهما.
 دليلكيف تختار لغة البرمجة Programming Language لمشروعك؟نختار لغة خدمة حقيقية بأسئلة الفريق والتوظيف والمكتبات والرخصة، ثم نكتبها بأربع لغات ونقيس البناء والحجم والذاكرة والطلبات في الثانية بأنفسنا.
 دليلكيف تصمم API يبقى متوافقاً مع عملائه بعد سنةمبادئ تصميم API يتطور دون أن يعطل التطبيقات التي تعتمد عليه، وكيف تختار الشكل المناسب لنظامك.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وبناء الخدمة وتشغيل الاختبارات والقياسات على Python 3.15.2 مع FastAPI 0.162.0 وuvicorn 0.54.0 وpsycopg 3.3.6 وPostgreSQL 17.11، داخل Containers محدودة بـ 2 CPU و512 MB.


