يتوقف مزود الرسائل النصية SMS الذي يرسل عبره تطبيقك رموز التحقق عشرين ثانية فقط في منتصف الليل، ثم يعود كأن شيئاً لم يكن. وفي الصباح تجد أن مئة عميل لم تصلهم رسائلهم، مع أن الطابور Queue سليم وال Workers تعمل والمزود يرد الآن بشكل طبيعي. وعندما تفتح لوحة الوسيط Broker تجد الرسائل المئة كلها في ال Dead Letter Queue، رسائل سليمة تماماً لا عيب فيها، ونقلها الوسيط إلى هناك في أربع ثوان لأن كل Worker رفضها خمس مرات متتالية وهو ينتظر مزوداً متوقفاً. وفي نسخة أخرى من نفس القصة لا يذهب شيء إلى ال DLQ، ولكن المزود يستقبل في تلك الثواني العشرين 1731 طلباً فاشلاً من مئة رسالة فقط، ثم يقرر أن يحظر عنوان سيرفرك لأنه يبدو كهجوم.
والقصتان حقيقيتان، فقد شغلناهما بالأرقام نفسها في التجربة العملية في هذا المقال، والسبب فيهما واحد: إعادة المحاولة Retry موجودة، ولكنها مكتوبة دون سياسة واضحة تقول متى تعيد، وكم تنتظر، ومتى تستسلم، وأين تذهب الرسالة بعد ذلك. وقد شرحنا أساسيات الطابور والتأكيد Ack وحد التسليم وال Dead Letter Queue بتجربة صغيرة على RabbitMQ في مقال مفاهيم الطوابير، وشرحنا التأخير المتزايد Exponential Backoff والعشوائية Jitter وميزانية إعادة المحاولة بين خدمتين متزامنتين في مقال أنماط المرونة، وكيف يتحمل ال Consumer وصول الرسالة مرتين في مقال Idempotency، فلن نكرر ذلك هنا. وهذا المقال يأخذ السؤال الذي بعدها: كيف تكتب سياسة إعادة المحاولة في الطابور نفسه، وما الذي يفعله الوسيط فعلاً عندما ترفض الرسالة أو لا تؤكدها، وكيف تفرق بين خطأ مؤقت سوف يزول ورسالة لن تنجح أبداً.
وسوف نناقش في هذا المقال ما يلي:
- لماذا تفشل الرسالة، وكيف تصنف الخطأ قبل أن تقرر إعادة المحاولة.
- أين تحدث الإعادة: داخل ال Consumer، أم بإرجاع الرسالة إلى الوسيط، أم في طابور انتظار منفصل، ولماذا يغير ذلك ترتيب الرسائل.
- كم مرة وكم تنتظر: حد المحاولات مقابل حد الوقت، وأنواع العشوائية، ولماذا قد يكون الحد بعدد المحاولات خادعاً.
- الرسالة المسمومة Poison Message: كيف تعرفها، ولماذا يجب أن تخرج من الطابور فوراً.
- تجربة عملية على RabbitMQ 4.3.6 بطوابير Quorum، وعلى واجهة SQS عبر ElasticMQ: سبع سياسات أمام نفس العطل، مع عدد الاستدعاءات الفاشلة وعدد الرسائل في ال DLQ والوقت حتى يفرغ الطابور.
- مشكلات ظهرت في التجربة: رسالة تنتظر خمس عشرة ثانية وانتظارها ثانية، ورسائل أرسلت ثماني مرات ثم ذهبت إلى ال DLQ، وإعادة من ال DLQ أغرقت المزود من جديد.
- كيف تعيد الرسائل من ال DLQ Redrive بأمان، وما الذي تراقبه، وجدول قرار تختار به السياسة.
لماذا تفشل الرسالة؟ صنف الخطأ Error Classification قبل أن تعيد
أول قرار في أي سياسة إعادة محاولة ليس عدد المحاولات، وإنما سؤال أبسط: هل ستنجح هذه الرسالة إذا أعدتها؟ والإجابة تعتمد على نوع الخطأ، وأغلب الأنظمة التي رأيناها تعامل كل الأخطاء معاملة واحدة، فتعيد رسالة فيها JSON تالف عشرين مرة كما تعيد رسالة فشلت لأن المزود كان متوقفاً، وهذا هدر في الحالة الأولى وخطر في الثانية. والتصنيف العملي ثلاثة أنواع:
- الخطأ المؤقت Transient Error: سببه خارج الرسالة وسوف يزول وحده، مثل رد
503من مزود متوقف، أو انقطاع قصير في الشبكة، أو مهلة Timeout، أو قفل في قاعدة البيانات، أو رد429لأنك تجاوزت حد الطلبات المسموح. وهذا النوع هو الوحيد الذي تفيده إعادة المحاولة، بشرط أن تنتظر قبلها. - الخطأ الدائم Permanent Error: سببه في الرسالة نفسها، فلن يتغير مهما أعدت، مثل جسم لا يمكن قراءته، أو حقل مطلوب غير موجود، أو رقم هاتف غير صالح، أو رد
400أو422من المزود، أو رسالة بنسخة Schema لا يعرفها الكود الحالي. والرسالة التي تحمل خطأ من هذا النوع هي ما يسمى Poison Message، ومكانها ال DLQ من أول مرة. - الخطأ غير المعروف: استثناء Exception لم يتوقعه أحد، أو توقف ال Consumer كله أثناء المعالجة. وهذا النوع يعامل كالمؤقت مع حد صغير، لأنك لا تعرف هل السبب في الرسالة أم في الكود، فإذا تكرر مع نفس الرسالة فهو غالباً دائم.
والصورة التالية تبين القرار الذي يجب أن يأخذه ال Consumer مع كل فشل، قبل أن يقرر الوسيط أي شيء:
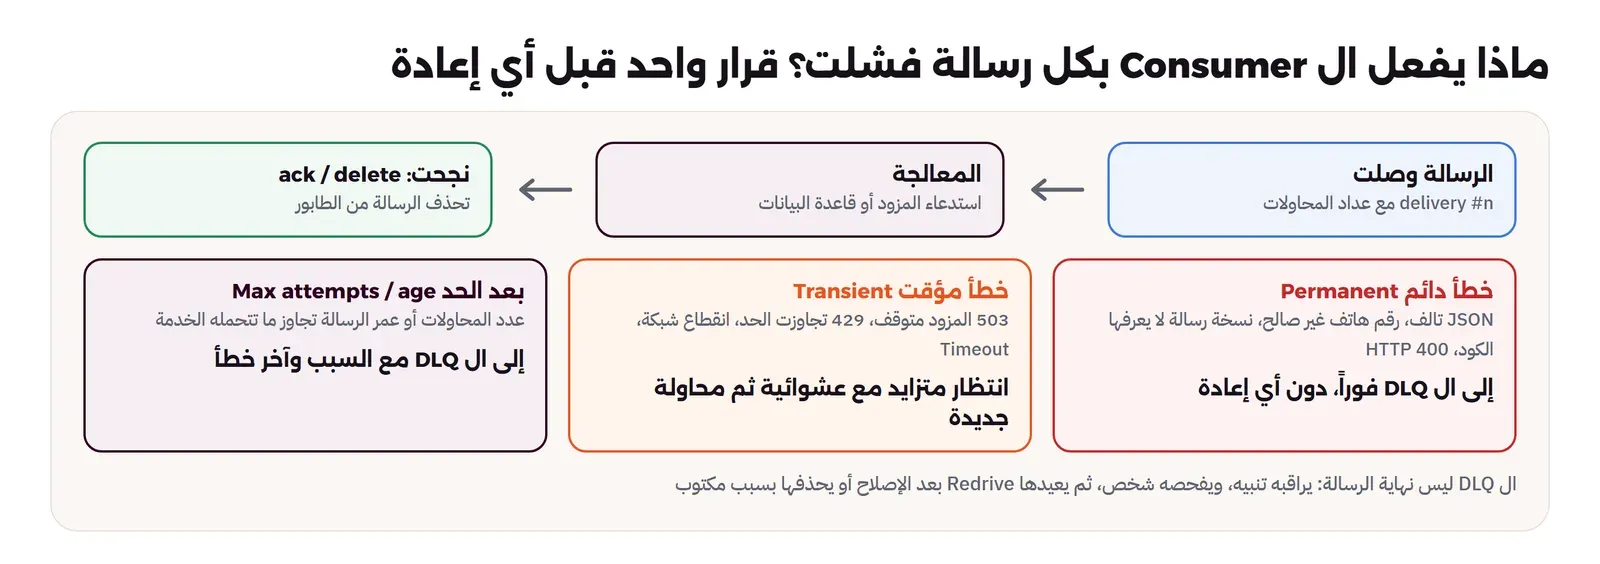
وقد يتساءل البعض: لماذا لا أترك الوسيط يقرر بحد التسليم، فالرسالة التالفة سوف تصل إلى الحد وتذهب إلى ال DLQ في النهاية؟ والإجابة أن الحد مصمم ليحمي الطابور من رسالة لا يعرف عنها شيئاً، وأنت تعرف. فالرسالة التالفة التي تعاد عشرين مرة تأخذ من وقت ال Workers عشرين مرة، وتظهر في السجلات Logs عشرين خطأ تخفي الأخطاء الحقيقية، وإذا كان ال Worker يتوقف بسببها، كأن يستهلك الذاكرة كلها مع ملف ضخم، فهي توقف معها كل الرسائل التي يحملها ذلك ال Worker في نفس اللحظة. لذلك اجعل الكود يرفض الخطأ الدائم مباشرة دون إعادة، واترك حد الوسيط شبكة أمان أخيرة للحالات التي لم تتوقعها.
429: هو خطأ مؤقت، ولكن سببه أنت، فالمزود يقول إنك ترسل أسرع مما يسمح. وإذا كان معه ترويسة Retry-After فهي أدق من أي معادلة انتظار تكتبها، فاستخدمها كحد أدنى للانتظار، ولا تعد المحاولة قبلها لأن كل محاولة مبكرة تستهلك من نفس الحد.أين تحدث إعادة المحاولة؟ ثلاثة أماكن ولكل منها ثمن
عندما يفشل ال Consumer في معالجة رسالة، أمامه ثلاث طرق ليعيد المحاولة، والفرق بينها ليس في الكود فقط، وإنما في ما يحدث للرسائل الأخرى وللترتيب ولما يراه الوسيط:
- داخل ال Consumer In-process Retry: يمسك ال Worker الرسالة ويعيد استدعاء المزود مرتين أو ثلاثاً بانتظار قصير قبل أن يقرر أنها فشلت. وهذا مناسب للأخطاء التي تزول في أجزاء من الثانية، مثل اتصال انقطع، ولكنه يحجز ال Worker طوال الانتظار، ومع Prefetch أكبر من واحد يحجز معه رسائل أخرى لم يبدأ بها، وإذا توقف ال Worker أثناء الانتظار عادت كل هذه الرسائل. لذلك اجعل الانتظار هنا قصيراً جداً ومجموعه أقل من ثانيتين.
- إرجاع الرسالة إلى الوسيط Requeue: يرفض ال Worker الرسالة فيعيدها الوسيط إلى الطابور، أو لا يحذفها في SQS فتعود بعد مهلة الإخفاء. وهنا يتحرر ال Worker فوراً لرسائل أخرى، ولكن السؤال: متى تعود الرسالة؟ إذا عادت فوراً فقد صنعت حلقة تدور بأقصى سرعة، وهذه أول تجربة في المختبر.
- طابور انتظار منفصل Retry Queue: يؤكد ال Worker الرسالة من الطابور الأصلي وينشرها في طابور آخر تنتظر فيه مدة محددة، ثم تعود إلى الأصلي. وهذه الطريقة التي وصفها فريق Uber في مقال Building Reliable Reprocessing and Dead Letter Queues with Apache Kafka المنشور في فبراير 2018، وكانت مشكلتهم أن الرسائل التي تفشل مراراً تسد معالجة الدفعات في Kafka، لأن المستهلك لا يستطيع أن يتقدم بالموضع Offset حتى تنجح، فنقلوا الرسالة الفاشلة إلى موضوع Topic مخصص للإعادة بتأخير محدد، ثم إلى موضوع آخر بتأخير أطول، ثم إلى DLQ. وفي Kafka تحديداً هذه هي الطريقة الوحيدة تقريباً، لأنه لا يوجد تأكيد لكل رسالة كما في RabbitMQ وSQS، وقد شرحنا سبب ذلك في مقال Kafka.
ولاحظ أن الطرق الثلاث تغير ترتيب الرسائل بدرجات مختلفة: في الأولى تبقى الرسالة في مكانها ولكنها تؤخر ما بعدها في نفس ال Worker، وفي الثانية والثالثة تعالج الرسالة الفاشلة بعد رسائل جاءت بعدها. فإذا كانت رسالتان لنفس الكيان، مثل «أنشئ الطلب» ثم «ألغ الطلب»، وفشلت الأولى وأعيدت، فقد تصل «ألغ الطلب» إلى الكود قبل «أنشئ الطلب». والقاعدة أن تجعل المعالجة لا تعتمد على الترتيب، كأن تحمل كل رسالة رقم نسخة Version للكيان فيتجاهل الكود النسخة الأقدم، وإذا كان الترتيب شرطاً لا يمكن الاستغناء عنه فهذا طابور بمستهلك واحد لكل مفتاح، وهو ثمن كبير في السرعة.
كم مرة، وكم تنتظر؟ Max Attempts وBackoff
بعد التصنيف يأتي سؤالان: كم ننتظر قبل كل محاولة، ومتى نتوقف. وقد شرحنا في مقال أنماط المرونة لماذا يزيد الانتظار مع كل محاولة، والمعادلة المعروفة: الانتظار يساوي min(cap, base × 2^attempt)، أي ثانية ثم اثنتان ثم أربع ثم ثمان حتى السقف، ولماذا تضاف إليه العشوائية Jitter حتى لا تعود كل المحاولات في نفس اللحظة. ولكن هناك ثلاثة أشياء تتغير عندما تكون الإعادة في طابور وليس في طلب HTTP متزامن:
- الطابور يحفظ الرسالة أثناء الانتظار: في الطلب المتزامن ينتظر المستخدم، فلا تستطيع أن تنتظر أكثر من ثوان، أما في الطابور فلا أحد ينتظر على الشاشة، فتستطيع أن تجعل الانتظار دقائق أو ساعات إذا كانت الرسالة تتحمل ذلك، مثل فاتورة شهرية، ولا تستطيع ذلك في رمز تحقق ينتهي بعد خمس دقائق.
- الدفعة كلها تفشل معاً: في الطلب المتزامن يفشل كل طلب في لحظته، أما في الطابور فعندما يتوقف المزود تفشل كل الرسائل الموجودة في نفس الثانية، فتبدأ عداداتها معاً، وتعود معاً، وهذا يجعل العشوائية أهم بكثير مما هي بين خدمتين، كما سوف ترى في التجربة.
- الحد بعدد المحاولات هو في الحقيقة حد بالوقت: إذا قلت «خمس محاولات ثم DLQ» دون انتظار بينها، فقد قلت إن الرسالة تتحمل عطلاً مدته خمسة أضعاف زمن الفشل الواحد، وإذا كان المزود المتوقف يرد في 20 مللي ثانية فهذا يعني أن رسالتك تتحمل عطلاً مدته مئة مللي ثانية فقط.
والنقطة الأخيرة هي أهم فكرة في هذا المقال، لذلك اكتب الحد بالشكل الذي يفهمه أصحاب الخدمة: «هذه الرسالة يجب أن تتحمل عطلاً في المزود مدته عشر دقائق، وبعد ساعة من إرسالها لا فائدة منها». ثم احسب منها عدد المحاولات والانتظار، وليس العكس. فإذا كان الانتظار يبدأ من ثانية ويتضاعف حتى سقف 60 ثانية، فمجموع الانتظار بعد ثماني محاولات قرابة أربع دقائق، وبعد خمس عشرة محاولة قرابة إحدى عشرة دقيقة، وهذا هو الرقم الذي يجب أن تقارنه بعطل المزود الذي تريد أن تتحمله.
أي عشوائية Jitter تختار؟
يقارن Marc Brooker في مقال Exponential Backoff And Jitter في مدونة AWS بين عدة طرق، واثنتان منها تهمانا هنا:
- Full Jitter: انتظر وقتاً عشوائياً بين صفر والقيمة المتزايدة كلها. وهي تفرق المحاولات أكثر من غيرها، ولكن بعض الرسائل سوف تسحب أرقاماً صغيرة عدة مرات متتالية، فتستهلك محاولاتها في وقت قصير.
- Equal Jitter: انتظر نصف القيمة المتزايدة على الأقل، ثم أضف إليه وقتاً عشوائياً بين صفر والنصف الآخر. والتفريق أقل قليلاً، ولكن لكل محاولة حد أدنى معروف، فيبقى مجموع الانتظار قريباً مما حسبته.
وفي مقال AWS كانت المقارنة على عدد الاستدعاءات والوقت حتى ينتهي العمل، ورأى أن Full Jitter أفضل في الاثنين، وهذا صحيح عندما يكون الهدف أن تنجح كل المحاولات بأقل ضغط. أما مع الطابور فهناك حد بعدد المحاولات وبعده DLQ، وهنا يظهر عيب لم يكن في تلك المقارنة، وسوف تراه بالأرقام في التجربة.
الرسالة المسمومة Poison Message: كيف تعرفها؟
ال Poison Message رسالة يفشل ال Consumer في معالجتها في كل مرة بسبب محتواها، وأشهر أشكالها في الواقع:
- جسم لا يمكن قراءته: JSON مقطوع أو بترميز Encoding مختلف أو ضغط Compression لا يعرفه ال Consumer، وغالباً سببه خطأ في نسخة جديدة من المنتج Producer.
- نسخة Schema جديدة: المنتج نشر قبل ال Consumer، فأرسل حقلاً بنوع جديد أو حذف حقلاً مطلوباً.
- بيانات صحيحة الشكل وخاطئة المعنى: طلب لعميل حذف حسابه، أو منتج غير موجود، فيرمي الكود استثناء في كل مرة.
- رسالة توقف ال Worker نفسه: ملف ضخم يستهلك الذاكرة فيقتل نظام التشغيل العملية OOM Kill، أو مدخل يسبب حلقة لا تنتهي. وهذه أخطرها، لأن ال Worker لا يصل إلى سطر الرفض أصلاً، فلا يعرف الوسيط إلا أن الاتصال انقطع ومعه رسائل لم تؤكد.
والنوع الأخير هو سبب وجود حد التسليم في الوسيط، فالكود لا يستطيع أن يصنف رسالة تقتله، والوسيط وحده يرى أن نفس الرسالة كانت مع كل اتصال انقطع. ولذلك يعد RabbitMQ في طوابير Quorum انقطاع الاتصال مع رسالة غير مؤكدة فشلاً حقيقياً يزيد العداد، كما يبين جدول «متى يزيد عداد التسليم» في توثيق Quorum Queues، وهو جدول يستحق أن تقرأه بعناية لأن فيه مفاجأة سوف نراها في أول تجربة: منذ الإصدار 4.3 لا يزيد العداد مع basic.nack، ويزيد مع basic.reject ومع انقطاع الاتصال.
وفي SQS يعد العداد ApproximateReceiveCount كل مرة استلم فيها أي Consumer الرسالة، دون أن يعرف لماذا عادت، فإذا تجاوز العدد القيمة maxReceiveCount في سياسة ال Redrive Policy نقلت الرسالة إلى ال DLQ، كما يشرح توثيق Dead-letter queues في SQS. وهذا يعني أن أي شيء يجعل الرسالة تعود دون فشل حقيقي، مثل مهلة إخفاء قصيرة، يستهلك من محاولاتها، وهذه ثالث مشكلة في التجربة.
ماذا يحفظ ال Dead Letter Queue مع الرسالة؟
ال DLQ طابور عادي في نفس الوسيط، والفرق في طريقة استخدامه: لا يقرأ منه ال Consumer الأصلي، وإنما يراقبه تنبيه ويقرؤه شخص. ولكي يفيد هذا الشخص يجب أن يجد مع الرسالة ما يكفي ليعرف ماذا حدث دون أن يبحث في السجلات، وأقل ما يجب أن تجده:
- الطابور الذي جاءت منه، وسبب نقلها: انتهى الحد، أم رفضها الكود كخطأ دائم، أم انتهت صلاحيتها TTL. وفي RabbitMQ يضيف الوسيط هذه المعلومات في الترويسات
x-deathوx-first-death-reason، كما يبين توثيق Dead Letter Exchanges. - عدد المحاولات، ووقت أول محاولة وآخرها.
- آخر رسالة خطأ ونوعه، ونسخة الكود التي رفضتها. وهذه لا يضيفها الوسيط، فإذا أردتها فعلى ال Consumer أن ينشر الرسالة بنفسه إلى ال DLQ مع ترويسات إضافية بدل أن يرفضها، وهذا ما تفعله أغلب المكتبات الجاهزة.
وانتبه إلى مدة الحفظ: في SQS تحسب مدة حفظ الرسالة من وقت دخولها الطابور الأصلي وليس من وقت وصولها إلى ال DLQ، كما ينص التوثيق، فإذا كانت الرسالة قضت ثلاثة أيام في الطابور الأصلي ومدة الحفظ في ال DLQ أربعة أيام، فسوف تحذف بعد يوم واحد من وصولها إلى ال DLQ. لذلك اجعل مدة الحفظ في ال DLQ أطول من الطابور الأصلي دائماً، والحد الأعلى في SQS أربعة عشر يوماً.
تجربة عملية Lab: سبع سياسات أمام نفس العطل
الكلام السابق يبقى نظرياً حتى ترى الأرقام، لذلك بنينا مختبراً صغيراً فيه: مزود SMS وهمي نستطيع أن نوقفه عدداً محدداً من الثواني فيرد 503، وله حد للطلبات في الثانية يرد بعده 429، ويعد كل استدعاء وكل رسالة أرسلها وكم مرة أرسلها. ثم نشغل أمامه نفس العطل في كل تجربة: مئة رسالة سليمة في الطابور، والمزود متوقف أول عشرين ثانية، وأربعة Workers تعالج الرسائل، ونغير سياسة إعادة المحاولة فقط. ونستخدم وسيطين: RabbitMQ 4.3.6 بطوابير Quorum، وواجهة SQS عبر ElasticMQ 1.7.1، وهو سيرفر مفتوح المصدر يتكلم نفس واجهة Amazon SQS ويعمل محلياً، فتستطيع أن تجرب سلوك SQS دون حساب AWS. وكل الملفات في مجلد lab مع المقال.
التجهيز Setup
الملف compose.yaml فيه أربع Containers ولا ينشر أي منفذ Port على الجهاز:
# Retry and DLQ lab: RabbitMQ (quorum queues), ElasticMQ (SQS API), a fake SMS provider and a tools container.
# Nothing is published on the host: every call stays inside the compose network.
name: sw4-q

services:
  broker:
    image: sw4-rabbitmq:4.3.6-management-alpine   # tag of rabbitmq:4.3.6-management-alpine
    container_name: sw4-q-broker
    hostname: broker

  sqs:
    image: sw4-elasticmq:1.7.1                    # tag of softwaremill/elasticmq-native:1.7.1
    container_name: sw4-q-sqs

  provider:
    image: sw4-qlab
    container_name: sw4-q-provider
    command: ["python", "provider.py"]

  tools:
    image: sw4-qlab
    container_name: sw4-q-tools
    command: ["sleep", "infinity"]
    environment:
      AMQP_URL: amqp://guest:guest@broker:5672/%2F
      MGMT_URL: http://guest:guest@broker:15672
      SQS_URL: http://sqs:9324
      PROVIDER_URL: http://provider:8080
والملف Dockerfile يبني Image الأدوات من Python 3.13 مع مكتبة pika لعميل RabbitMQ ومكتبة boto3 لواجهة SQS:
FROM sw4-python:3.13.18-slim
RUN pip install --no-cache-dir pika==1.3.2 boto3==1.40.0
WORKDIR /lab
COPY *.py ./
ENV PYTHONUNBUFFERED=1
ولأننا نسمي كل شيء في المختبر باسم يبدأ بالبادئة sw4- أعطينا ال Images العامة أسماء محلية قبل التشغيل:
docker pull rabbitmq:4.3.6-management-alpine
docker pull softwaremill/elasticmq-native:1.7.1
docker pull python:3.13.18-slim
docker tag rabbitmq:4.3.6-management-alpine sw4-rabbitmq:4.3.6-management-alpine
docker tag softwaremill/elasticmq-native:1.7.1 sw4-elasticmq:1.7.1
docker tag python:3.13.18-slim sw4-python:3.13.18-slim
docker build -t sw4-qlab .
docker compose up -d
والمزود الوهمي في الملف provider.py، وكل ما يفعله أنه يرد 503 قبل نهاية مدة التوقف، و429 بعد الحد في الثانية، و200 غير ذلك، ويعد كل شيء:
# A fake SMS provider: it can be "down" for some seconds (HTTP 503) and it accepts at most RATE calls per second
# (HTTP 429 above that). It counts every call per second and every successful send per message id.
import json, threading, time
from collections import defaultdict
from http.server import ThreadingHTTPServer, BaseHTTPRequestHandler

state = {"down_until": 0.0, "rate": 50, "t0": time.time()}
calls = defaultdict(lambda: defaultdict(int))   # second -> status -> count
sent = defaultdict(int)                          # message id -> successful sends
window = {"sec": 0, "n": 0}
lock = threading.Lock()


class H(BaseHTTPRequestHandler):
    def log_message(self, *a):
        pass

    def reply(self, code, body):
        b = json.dumps(body).encode()
        self.send_response(code)
        self.send_header("Content-Type", "application/json")
        self.send_header("Content-Length", str(len(b)))
        self.end_headers()
        self.wfile.write(b)

    def do_POST(self):
        n = int(self.headers.get("Content-Length", 0))
        body = json.loads(self.rfile.read(n) or b"{}")
        now = time.time()
        sec = int(now - state["t0"])
        with lock:
            if self.path.startswith("/admin/reset"):
                state.update(down_until=now + body.get("down", 0), rate=body.get("rate", 50), t0=now)
                calls.clear(); sent.clear(); window.update(sec=0, n=0)
                return self.reply(200, {"ok": True})
            if now < state["down_until"]:
                calls[sec]["503"] += 1
                return self.reply(503, {"error": "provider down"})
            if window["sec"] != int(now):
                window.update(sec=int(now), n=0)
            window["n"] += 1
            if window["n"] > state["rate"]:
                calls[sec]["429"] += 1
                return self.reply(429, {"error": "rate limit"})
            calls[sec]["200"] += 1
            sent[body["id"]] += 1
        time.sleep(body.get("work", 0))           # the time the provider takes to answer
        return self.reply(200, {"ok": True})

    def do_GET(self):
        with lock:
            self.reply(200, {"calls": {s: dict(c) for s, c in calls.items()},
                             "sent": len(sent), "duplicates": sum(v - 1 for v in sent.values() if v > 1)})


ThreadingHTTPServer(("0.0.0.0", 8080), H).serve_forever()
والملف common.py فيه دالة الإرسال إلى المزود، ودالة تطبع جدولاً بعدد الاستدعاءات في كل خمس ثوان، وهو الجدول الذي سوف تراه في كل تجربة:
# Helpers shared by the RabbitMQ and SQS experiments: the fake provider, and a timeline printed from its counters.
import json, os, time, urllib.error, urllib.request

PROVIDER = os.environ["PROVIDER_URL"]


def post(path, body, timeout=5):
    req = urllib.request.Request(PROVIDER + path, json.dumps(body).encode(), {"Content-Type": "application/json"})
    try:
        with urllib.request.urlopen(req, timeout=timeout) as r:
            return r.status
    except urllib.error.HTTPError as e:
        return e.code


def reset_provider(down=0, rate=50):
    post("/admin/reset", {"down": down, "rate": rate})


def send_sms(msg_id, work=0.0):
    """Call the provider once. Returns the HTTP status: 200 sent, 503 down, 429 rate limited."""
    return post("/send", {"id": msg_id, "work": work}, timeout=work + 5)


def provider_stats():
    with urllib.request.urlopen(PROVIDER + "/stats") as r:
        return json.load(r)


def timeline(bucket=5):
    s = provider_stats()
    calls = {int(k): v for k, v in s["calls"].items()}
    last = max(calls) if calls else 0
    print(f"{'seconds':>9} {'200 sent':>9} {'503 down':>9} {'429 limit':>10} {'peak/s':>7}")
    for b in range(0, last + 1, bucket):
        secs = [calls.get(x, {}) for x in range(b, b + bucket)]
        ok = sum(c.get("200", 0) for c in secs)
        down = sum(c.get("503", 0) for c in secs)
        lim = sum(c.get("429", 0) for c in secs)
        peak = max(sum(c.values()) for c in secs)
        print(f"{b:>4}-{b + bucket - 1:<4} {ok:>9} {down:>9} {lim:>10} {peak:>7}")
    total = {k: sum(c.get(k, 0) for c in calls.values()) for k in ("200", "503", "429")}
    print(f"provider calls: {sum(total.values())} (200={total['200']} 503={total['503']} 429={total['429']}), "
          f"distinct messages sent: {s['sent']}, sent twice or more: {s['duplicates']}")
أما تجارب RabbitMQ ففي الملف rmq_lab.py. والجزء المهم فيه الدالة handle داخل consumer، فهي تصنف الخطأ كما في الصورة الأولى: JSON لا يمكن قراءته خطأ دائم يرفض دون إعادة requeue=False فيذهب إلى ال DLQ فوراً، وأي رد غير 200 من المزود خطأ مؤقت تعالجه الدالة on_fail التي تتغير بين التجارب. والطابور sms من نوع Quorum بحد تسليم 5، وال DLQ هو sms.dlq عبر ال Default Exchange، ومع كل تجربة ننشر مئة رسالة سليمة ورسالة واحدة تالفة sms-bad تمثل خطأ في المنتج:
# RabbitMQ experiments: python rmq_lab.py nack|reject|delayed|hol
import base64, json, os, sys, threading, time, urllib.request
import pika
from common import reset_provider, send_sms, timeline

AMQP = os.environ["AMQP_URL"]
QUEUE, DLQ = "sms", "sms.dlq"


def channel():
    return pika.BlockingConnection(pika.URLParameters(AMQP)).channel()


def depth(name):
    """Messages ready in a queue (a passive declare does not change the queue)."""
    ch = channel()
    n = ch.queue_declare(queue=name, passive=True).method.message_count
    ch.connection.close()
    return n


def setup(extra):
    ch = channel()
    for q in (QUEUE, DLQ):
        ch.queue_delete(queue=q)
    time.sleep(2)                                   # let the broker finish deleting before declaring again
    ch.queue_declare(queue=DLQ, durable=True, arguments={"x-queue-type": "quorum"})
    ch.queue_declare(queue=QUEUE, durable=True, arguments={
        "x-queue-type": "quorum",
        "x-delivery-limit": 5,                      # after 5 failed deliveries ...
        "x-dead-letter-exchange": "",               # ... dead-letter through the default exchange
        "x-dead-letter-routing-key": DLQ,           # ... into sms.dlq
        **extra})
    return ch


def publish(ch, n, poison=True):
    for i in range(1, n + 1):
        ch.basic_publish("", QUEUE, json.dumps({"id": f"sms-{i}", "to": f"+9665000{i:05d}"}),
                         pika.BasicProperties(delivery_mode=2, message_id=f"sms-{i}"))
    if poison:   # a message the consumer can never handle: the producer sent broken JSON
        ch.basic_publish("", QUEUE, b'{"id": "sms-bad", "to": ', pika.BasicProperties(delivery_mode=2, message_id="sms-bad"))


stats = {"deliveries": 0, "max_count": 0, "done": 0}
lock = threading.Lock()


def consumer(on_fail, stop):
    ch = channel()
    ch.basic_qos(prefetch_count=10)

    def handle(ch, method, props, body):
        with lock:
            stats["deliveries"] += 1
            stats["max_count"] = max(stats["max_count"], (props.headers or {}).get("x-delivery-count", 0))
        try:
            msg = json.loads(body)
        except json.JSONDecodeError:
            # permanent error: retrying will never help, send it to the DLQ now
            with lock:
                stats["done"] += 1
            return ch.basic_reject(method.delivery_tag, requeue=False)
        if send_sms(msg["id"]) == 200:
            with lock:
                stats["done"] += 1
            ch.basic_ack(method.delivery_tag)
        else:
            on_fail(ch, method.delivery_tag)       # temporary error: the provider is down or busy

    ch.basic_consume(QUEUE, handle)
    while not stop.is_set():
        ch.connection.process_data_events(time_limit=0.2)
    ch.connection.close()


def run(name, extra, on_fail, n=100, down=20, rate=50, seconds=45):
    ch = setup(extra)
    reset_provider(down=down, rate=rate)
    publish(ch, n)
    stop = threading.Event()
    workers = [threading.Thread(target=consumer, args=(on_fail, stop)) for _ in range(4)]
    t0 = time.time()
    for w in workers:
        w.start()
    while time.time() - t0 < seconds:
        time.sleep(1)
        if stats["done"] + depth(DLQ) >= n + 1:      # every message is either handled or in the DLQ
            break
    elapsed = time.time() - t0
    stop.set()
    for w in workers:
        w.join()
    print(f"== {name}: {n} messages + 1 poison, provider down {down}s, rate limit {rate}/s")
    timeline()
    print(f"consumer deliveries: {stats['deliveries']}, highest x-delivery-count seen: {stats['max_count']}")
    print(f"after {elapsed:.0f}s: {QUEUE}={depth(QUEUE)} {DLQ}={depth(DLQ)}")


nack = lambda ch, tag: ch.basic_nack(tag, requeue=True)
reject = lambda ch, tag: ch.basic_reject(tag, requeue=True)

exp = sys.argv[1]
if exp == "nack":
    run("basic_nack(requeue=True), delivery-limit 5", {}, nack)
elif exp == "reject":
    run("basic_reject(requeue=True), delivery-limit 5", {}, reject)
elif exp == "delayed":
    run("basic_reject + delayed retry 1s..10s, delivery-limit 20",
        {"x-delivery-limit": 20, "x-delayed-retry-type": "failed",
         "x-delayed-retry-min": 1000, "x-delayed-retry-max": 10000}, reject, rate=20, seconds=90)
elif exp == "hol":
    # A wait queue with per-message TTL: a retry that waits 1s published behind a retry that waits 15s.
    qtype = sys.argv[2] if len(sys.argv) > 2 else "classic"
    ch = channel()
    for q in ("work", "wait"):
        ch.queue_delete(queue=q)
    time.sleep(2)
    ch.queue_declare(queue="work", durable=True)
    ch.queue_declare(queue="wait", durable=True, arguments={
        "x-queue-type": qtype, "x-dead-letter-exchange": "", "x-dead-letter-routing-key": "work"})
    t0 = time.time()
    for name, ttl in (("A", 15000), ("B", 1000), ("C", 2000)):
        ch.basic_publish("", "wait", name.encode(), pika.BasicProperties(delivery_mode=2, expiration=str(ttl)))
        print(f"published {name} to wait queue with expiration {ttl / 1000:.0f}s")

    back = []

    def got(ch, method, props, body):
        print(f"{time.time() - t0:5.1f}s  {body.decode()} is back in the work queue")
        ch.basic_ack(method.delivery_tag)
        back.append(body)
        if len(back) == 3:
            ch.stop_consuming()

    ch.basic_consume("work", got)
    ch.start_consuming()
elif exp == "redrive":
    # After a "reject" run: the provider is healthy again, move sms.dlq back into sms with a Shovel.
    reset_provider(down=0, rate=50)
    stop = threading.Event()
    workers = [threading.Thread(target=consumer, args=(reject, stop)) for _ in range(4)]
    for w in workers:
        w.start()
    print(f"before: {QUEUE}={depth(QUEUE)} {DLQ}={depth(DLQ)}")
    t0 = time.time()
    # a dynamic Shovel through the management API: move what is in sms.dlq now, then delete itself
    shovel = {"value": {"src-protocol": "amqp091", "src-uri": "amqp://", "src-queue": DLQ,
                        "src-delete-after": "queue-length",
                        "dest-protocol": "amqp091", "dest-uri": "amqp://", "dest-queue": QUEUE}}
    req = urllib.request.Request("http://broker:15672/api/parameters/shovel/%2F/redrive-sms",
                                 json.dumps(shovel).encode(), method="PUT",
                                 headers={"Content-Type": "application/json",
                                          "Authorization": "Basic " + base64.b64encode(b"guest:guest").decode()})
    print("shovel:", urllib.request.urlopen(req).status)
    time.sleep(3)
    while stats["done"] < 100 and time.time() - t0 < 60:
        time.sleep(1)
    stop.set()
    for w in workers:
        w.join()
    timeline()
    print(f"after {time.time() - t0:.0f}s: {QUEUE}={depth(QUEUE)} {DLQ}={depth(DLQ)}")
    ch = channel()
    method, props, body = ch.basic_get(DLQ, auto_ack=False)
    print("still in the DLQ:", body.decode(errors="replace"))
    for d in props.headers["x-death"]:
        print(f"  x-death: queue={d['queue']} reason={d['reason']} count={d['count']}")
التجربة 1: basic_nack مع الإعادة الفورية
نبدأ بما يكتبه أغلب المطورين أول مرة: إذا فشلت الرسالة أرجعها إلى الطابور basic_nack(requeue=True)، والطابور عليه حد تسليم 5، فالمتوقع أن تذهب الرسالة إلى ال DLQ بعد خمس محاولات إذا لم تنجح:
docker exec sw4-q-tools python rmq_lab.py nackوالمخرج سوف يكون كما يلي:
== basic_nack(requeue=True), delivery-limit 5: 100 messages + 1 poison, provider down 20s, rate limit 50/s
  seconds  200 sent  503 down  429 limit  peak/s
   0-4            0       443          0     120
   5-9            0       430          0     112
  10-14           0       400          0      88
  15-19           0       458          0     115
  20-24         100         0         57     114
provider calls: 1888 (200=100 503=1731 429=57), distinct messages sent: 100, sent twice or more: 0
consumer deliveries: 1889, highest x-delivery-count seen: 0
after 22s: sms=0 sms.dlq=1
في المخرج أعلاه لاحظ التالي:
- في العشرين ثانية التي توقف فيها المزود استقبل 1731 استدعاء فاشلاً من مئة رسالة، أي أكثر من سبع عشرة محاولة لكل رسالة، وبمعدل وصل إلى 120 استدعاء في الثانية، ولو استمر العطل ساعة لكان العدد قرابة ثلاثمئة ألف.
- أعلى قيمة رأيناها للترويسة
x-delivery-countصفر، أي أن الوسيط لم يعد أي محاولة من هذه المحاولات فشلاً، فالحد 5 لم يعمل أبداً، وهذا ما يقوله جدول التوثيق: منذ RabbitMQ 4.3 لا يزيدbasic.nackعداد التسليم، ويزيد العداد الآخرx-acquired-countفقط. والنتيجة أن من يعتمد على حد التسليم ليحميه، ويكتب nack في الكود، ليس عنده حد إطلاقاً. - عندما عاد المزود في الثانية العشرين أرسلت الرسائل المئة كلها في ثانيتين، ومعها 57 رداً
429لأن المحاولات المتراكمة جاءت أسرع من الحد 50 في الثانية. - الرسالة التالفة وحدها ذهبت إلى ال DLQ، وذلك لأن الكود رفضها كخطأ دائم ولم ينتظر الوسيط.
والدرس أن الإعادة الفورية ليست إعادة محاولة، وإنما حلقة تضغط على خدمة متعبة بكل سرعة ال Workers، وهي من نفس نوع العاصفة التي وصفناها بين الخدمات في مقال أنماط المرونة، ولكنها هنا أسوأ لأن الطابور يحمل كل الرسائل المتراكمة ويطلقها معاً.
التجربة 2: basic_reject وحد التسليم
نغير سطراً واحداً: بدل nack نستخدم basic_reject(requeue=True)، وهو الذي يزيد العداد بحسب التوثيق، فيعمل حد التسليم 5:
docker exec sw4-q-tools python rmq_lab.py rejectوالمخرج سوف يكون كما يلي:
== basic_reject(requeue=True), delivery-limit 5: 100 messages + 1 poison, provider down 20s, rate limit 50/s
  seconds  200 sent  503 down  429 limit  peak/s
   0-4            0       600          0     164
provider calls: 600 (200=0 503=600 429=0), distinct messages sent: 0, sent twice or more: 0
consumer deliveries: 601, highest x-delivery-count seen: 5
after 5s: sms=0 sms.dlq=101
في المخرج أعلاه لاحظ التالي:
- الحد عمل هذه المرة: أعلى عداد 5، وكل رسالة جربت ست مرات، فاستقبل المزود 600 استدعاء بالضبط.
- ولكن كل ذلك حدث في أقل من خمس ثوان، فبعد خمس ثوان كانت الرسائل المئة السليمة كلها في
sms.dlqمع الرسالة التالفة، والمزود ما زال متوقفاً، أي أن عطلاً مدته عشرون ثانية تحول إلى مئة رسالة تحتاج تدخلاً يدوياً. - لم يصل أي إرسال ناجح، فالجدول ينتهي في الثانية الرابعة، لأن الطابور الأصلي أصبح فارغاً قبل أن يعود المزود.
وهذا تطبيق مباشر لفكرة «الحد بعدد المحاولات هو حد بالوقت»: خمس محاولات دون انتظار تعني أن الرسالة تتحمل عطلاً مدته أقل من ثانية، فكل عطل أطول من ذلك يملأ ال DLQ برسائل سليمة. وفي هذه الحالة يصبح ال DLQ مكاناً تختلط فيه رسائل تحتاج إصلاحاً حقيقياً مع رسائل كانت تحتاج دقيقة انتظار فقط، فيفقد قيمته كإشارة.
التجربة 3: الإعادة المؤجلة Delayed Retry في RabbitMQ 4.3
أضاف RabbitMQ 4.3 لطوابير Quorum تأجيلاً للرسائل العائدة، والانتظار فيه خطي: min(min_delay × delivery_count, max_delay)، أي ثانية ثم اثنتان ثم ثلاث حتى السقف، وتفعله بالخيار x-delayed-retry-type. والقيمة failed تؤجل الرسائل التي زاد عدادها فقط، أي التي رفضت بـ reject أو انقطع اتصالها، والقيمة all تؤجل كل رسالة عائدة. ونرفع حد التسليم إلى 20 ونجعل التأجيل بين ثانية وعشر ثوان، ونخفض حد المزود إلى 20 في الثانية لنرى ما يحدث عند العودة:
docker exec sw4-q-tools python rmq_lab.py delayedوالمخرج سوف يكون كما يلي:
== basic_reject + delayed retry 1s..10s, delivery-limit 20: 100 messages + 1 poison, provider down 20s, rate limit 20/s
  seconds  200 sent  503 down  429 limit  peak/s
   0-4            0       245          0      60
   5-9            0       155          0      41
  10-14           0       100          0      49
  15-19           0       100          0      39
  20-24          53         0         26      41
  25-29          10         0         11      21
  30-34          25         0          0      19
  35-39          12         0          0      12
provider calls: 737 (200=100 503=600 429=37), distinct messages sent: 100, sent twice or more: 0
consumer deliveries: 738, highest x-delivery-count seen: 7
after 40s: sms=0 sms.dlq=1
في المخرج أعلاه لاحظ التالي:
- الرسائل المئة كلها وصلت ولم يذهب أي منها إلى ال DLQ، وأعلى عداد 7، أي أن أبطأ رسالة احتاجت ثماني محاولات.
- الاستدعاءات الفاشلة 600 بدل 1731 في التجربة الأولى، ولاحظ شكلها: 100 في كل خمس ثوان في النصف الثاني من العطل، أي أن كل رسالة أصبحت تحاول مرة كل خمس ثوان تقريباً بدل عشرات المرات في الثانية.
- بعد عودة المزود وصل إليه 41 طلباً في ثانية واحدة وحده 20، فرد 37 مرة بالرمز
429، والسبب أن الرسائل المئة فشلت معاً وزادت عداداتها معاً، فكانت مواعيد عودتها متطابقة، لأن التأجيل في RabbitMQ لا يضيف أي عشوائية. - كل رد
429أصبح فشلاً جديداً زاد العداد وأجل الرسالة أكثر، لذلك احتاج الطابور عشرين ثانية بعد عودة المزود ليفرغ، مع أن المزود يستطيع إرسال مئة رسالة في خمس ثوان.
وهذه الميزة تحل المشكلة الكبرى، أي الحلقة السريعة وال DLQ المملوء برسائل سليمة، دون أي كود إضافي، ولكنها تترك مشكلة الموجة المتزامنة، فإذا كان عندك آلاف الرسائل بدل مئة فالموجة عند العودة قد تسقط المزود من جديد. وفي التوثيق خيار أدق في AMQP 1.0 هو أن يحدد ال Consumer وقت العودة بنفسه بالترويسة x-opt-delivery-time، فتستطيع أن تضيف العشوائية في الكود.
ماذا لو بنيت الانتظار بنفسك بمدة صلاحية لكل رسالة؟ What If
قبل الإصدار 4.3 كان الحل المعروف في RabbitMQ لبناء الانتظار هو طابور انتظار ليس له Consumers، تدخل إليه الرسالة الفاشلة بمدة صلاحية TTL، وعندما تنتهي يرسلها ال Dead Letter Exchange إلى الطابور الأصلي. والفكرة البديهية أن تضع لكل رسالة مدتها الخاصة بالخاصية expiration، فتكون المدة متزايدة وعشوائية لكل رسالة. ولنجرب ذلك بثلاث رسائل في طابور انتظار واحد: A تنتظر 15 ثانية، ثم B تنتظر ثانية، ثم C تنتظر ثانيتين:
docker exec sw4-q-tools python rmq_lab.py hol classic
docker exec sw4-q-tools python rmq_lab.py hol quorum
والمخرج سوف يكون كما يلي:
published A to wait queue with expiration 15s
published B to wait queue with expiration 1s
published C to wait queue with expiration 2s
 15.0s  A is back in the work queue
 15.0s  B is back in the work queue
 15.0s  C is back in the work queue
published A to wait queue with expiration 15s
published B to wait queue with expiration 1s
published C to wait queue with expiration 2s
 15.2s  A is back in the work queue
 15.2s  B is back in the work queue
 15.2s  C is back in the work queue
الرسالة B كان يجب أن تعود بعد ثانية، ولكنها عادت بعد خمس عشرة ثانية مع A، وكذلك C، وهذا في نوعي الطوابير. والسبب كما يقول توثيق TTL أن الطابور لا ينقل الرسالة المنتهية إلا عندما تصل إلى رأس الطابور، فتبقى كل رسالة منتهية خلف رسالة أمامها لم تنته بعد، وهذا ما يسمى حجب رأس الطابور Head-of-line Blocking. ومع إعادة محاولة متزايدة فهذا يعني أن رسالة في محاولتها الأولى تنتظر خلف رسالة في محاولتها العاشرة، أي أن الانتظار الذي حسبته بدقة لا علاقة له بما يحدث.
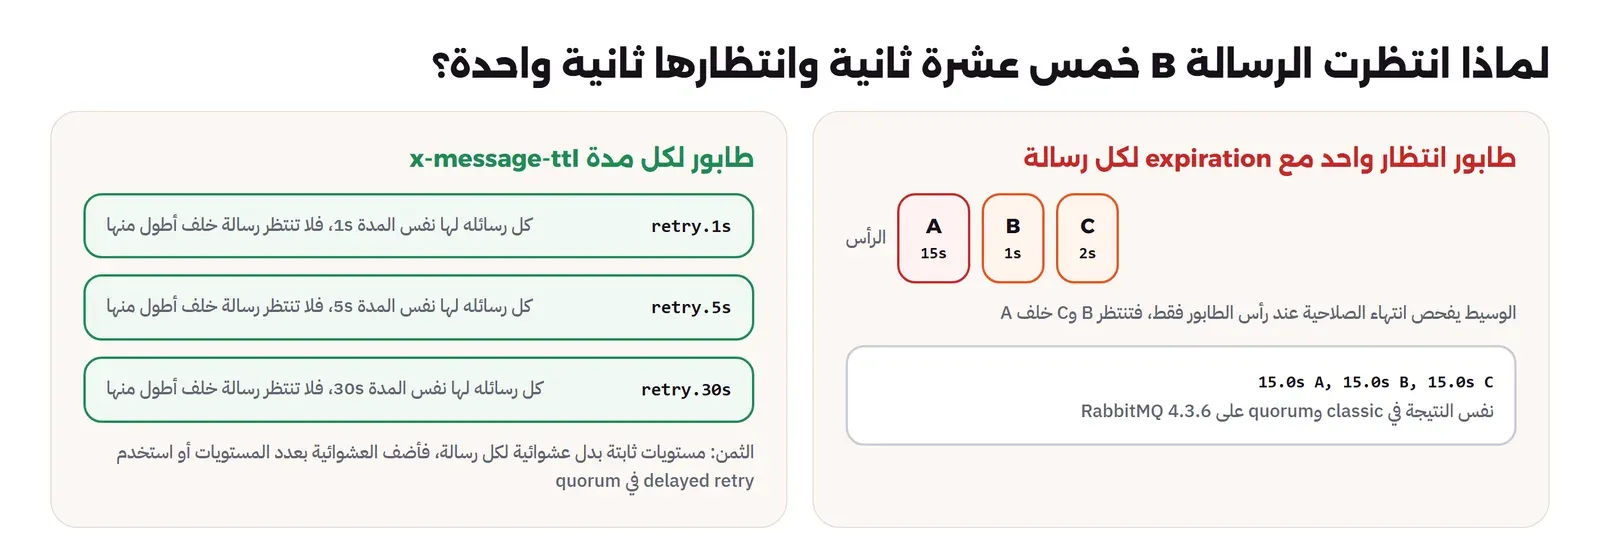
والحل المعروف أن تجعل لكل مدة طابوراً خاصاً بمدة ثابتة على مستوى الطابور x-message-ttl، مثل retry.1s وretry.5s وretry.30s، فكل الرسائل في الطابور الواحد لها نفس المدة، فلا تنتظر رسالة خلف أطول منها. وهذا هو نفس الحل الذي وصفه فريق Uber بمواضيع إعادة متدرجة في Kafka. والثمن أن الانتظار أصبح مستويات ثابتة دون عشوائية، فإذا أردت عشوائية فوزع الرسائل على أكثر من طابور في كل مستوى، أو استخدم الإعادة المؤجلة في Quorum إذا كان إصدارك 4.3 أو أحدث.
التجارب 4 إلى 7: نفس العطل على واجهة SQS
في SQS لا يوجد رفض بالمعنى الذي في RabbitMQ: يستلم ال Consumer الرسالة فتختفي عن غيره مدة تسمى مهلة الإخفاء Visibility Timeout، فإذا حذفها خلالها انتهى أمرها، وإذا لم يحذفها عادت للظهور. ولكن الأهم أنك تستطيع أن تغير هذه المهلة لرسالة واحدة بالعملية ChangeMessageVisibility، فإذا فشلت الرسالة جعلت مهلتها مدة الانتظار التي تريدها، وهذا يعطيك تأخيراً لكل رسالة دون مشكلة رأس الطابور، لأن SQS لا يحفظ الرسائل كطابور مرتب أصلاً. والملف sqs_lab.py فيه أربع سياسات في الدالة delay_for: دون انتظار، وتأخير متزايد دون عشوائية، وFull Jitter، وEqual Jitter، والطابور عليه maxReceiveCount يساوي 8:
# SQS experiments on ElasticMQ: python sqs_lab.py backoff none|exp|jitter|equal / vt plain|heartbeat / redrive
import json, os, random, sys, threading, time
import boto3
from common import reset_provider, send_sms, timeline

sqs = boto3.client("sqs", endpoint_url=os.environ["SQS_URL"], region_name="elasticmq",
                   aws_access_key_id="x", aws_secret_access_key="x")


def make_queues(visibility, max_receives):
    for name in ("sms", "sms-dlq"):
        try:
            sqs.delete_queue(QueueUrl=sqs.get_queue_url(QueueName=name)["QueueUrl"])
        except sqs.exceptions.QueueDoesNotExist:
            pass
    dlq = sqs.create_queue(QueueName="sms-dlq")["QueueUrl"]
    dlq_arn = sqs.get_queue_attributes(QueueUrl=dlq, AttributeNames=["QueueArn"])["Attributes"]["QueueArn"]
    q = sqs.create_queue(QueueName="sms", Attributes={
        "VisibilityTimeout": str(visibility),
        "RedrivePolicy": json.dumps({"deadLetterTargetArn": dlq_arn, "maxReceiveCount": str(max_receives)})})["QueueUrl"]
    return q, dlq


def count(url):
    a = sqs.get_queue_attributes(QueueUrl=url, AttributeNames=["ApproximateNumberOfMessages",
                                                              "ApproximateNumberOfMessagesNotVisible"])["Attributes"]
    return int(a["ApproximateNumberOfMessages"]) + int(a["ApproximateNumberOfMessagesNotVisible"])


def publish(q, n):
    for i in range(0, n, 10):
        sqs.send_message_batch(QueueUrl=q, Entries=[
            {"Id": str(j), "MessageBody": json.dumps({"id": f"sms-{j}"})} for j in range(i + 1, min(i + 10, n) + 1)])


def delay_for(mode, attempt, base=1.0, cap=30.0):
    """Seconds to wait before the next attempt, after `attempt` failed tries."""
    if mode == "none":
        return 0
    exp = min(cap, base * 2 ** (attempt - 1))       # 1, 2, 4, 8, 16, 30, 30 ...
    if mode == "exp":
        return exp
    if mode == "jitter":
        return random.uniform(0, exp)                # "full jitter": anywhere between 0 and exp
    return exp / 2 + random.uniform(0, exp / 2)      # "equal jitter": at least half of exp


def consumer(q, mode, stop, work=0.0, heartbeat=False, batch=10):
    while not stop.is_set():
        r = sqs.receive_message(QueueUrl=q, MaxNumberOfMessages=batch, WaitTimeSeconds=1,
                                AttributeNames=["ApproximateReceiveCount"])
        for m in r.get("Messages", []):
            attempt = int(m["Attributes"]["ApproximateReceiveCount"])
            beat = threading.Event()
            if heartbeat:   # keep the message invisible while we still work on it
                def keep(rh=m["ReceiptHandle"]):
                    while not beat.wait(1):
                        sqs.change_message_visibility(QueueUrl=q, ReceiptHandle=rh, VisibilityTimeout=3)
                threading.Thread(target=keep, daemon=True).start()
            status = send_sms(json.loads(m["Body"])["id"], work=work)
            beat.set()
            if status == 200:
                try:
                    sqs.delete_message(QueueUrl=q, ReceiptHandle=m["ReceiptHandle"])
                except sqs.exceptions.ReceiptHandleIsInvalid:
                    # the message became visible again and another consumer received it: our handle is stale
                    print(f"stale receipt handle for {json.loads(m['Body'])['id']} (receive #{attempt})")
            else:
                sqs.change_message_visibility(QueueUrl=q, ReceiptHandle=m["ReceiptHandle"],
                                              VisibilityTimeout=int(round(delay_for(mode, attempt))))


def run(label, q, dlq, mode, n, seconds, threads=4, **kw):
    stop = threading.Event()
    ts = [threading.Thread(target=consumer, args=(q, mode, stop), kwargs=kw) for _ in range(threads)]
    t0 = time.time()
    for t in ts:
        t.start()
    while time.time() - t0 < seconds and count(q) > 0:
        time.sleep(1)
    elapsed = time.time() - t0
    stop.set()
    for t in ts:
        t.join()
    print(f"== {label}")
    timeline()
    print(f"after {elapsed:.0f}s: sms={count(q)} sms-dlq={count(dlq)}")


exp, arg = sys.argv[1], sys.argv[2] if len(sys.argv) > 2 else ""
if exp == "backoff":
    q, dlq = make_queues(visibility=30, max_receives=8)
    reset_provider(down=20, rate=20)
    publish(q, 100)
    run(f"backoff={arg}: 100 messages, provider down 20s, rate limit 20/s, maxReceiveCount 8", q, dlq, arg, 100, 120)
elif exp == "vt":
    q, dlq = make_queues(visibility=3, max_receives=8)
    reset_provider(down=0, rate=50)
    publish(q, 20)
    run(f"visibility 3s, work 5s, heartbeat={arg == 'heartbeat'}: 20 messages", q, dlq, "exp", 20, 90,
        work=5.0, heartbeat=(arg == "heartbeat"), batch=1)
elif exp == "redrive":
    dlq = sqs.get_queue_url(QueueName="sms-dlq")["QueueUrl"]
    q = sqs.get_queue_url(QueueName="sms")["QueueUrl"]
    arn = sqs.get_queue_attributes(QueueUrl=dlq, AttributeNames=["QueueArn"])["Attributes"]["QueueArn"]
    print("before:", "sms", count(q), "sms-dlq", count(dlq))
    task = sqs.start_message_move_task(SourceArn=arn, MaxNumberOfMessagesPerSecond=10)
    print("task:", task["TaskHandle"][:36])
    t0 = time.time()
    while count(dlq) > 0:
        time.sleep(2)
        print(f"{time.time() - t0:4.0f}s  sms={count(q)} sms-dlq={count(dlq)}")
ونشغل السياسات الأربع واحدة بعد الأخرى بنفس العطل، وحد المزود 20 في الثانية:
for m in none exp jitter equal; do docker exec sw4-q-tools python sqs_lab.py backoff $m; doneوالمخرج سوف يكون كما يلي:
== backoff=none: 100 messages, provider down 20s, rate limit 20/s, maxReceiveCount 8
  seconds  200 sent  503 down  429 limit  peak/s
   0-4            0       398          0      90
   5-9            0       296          0      72
  10-14           0       106          0      57
provider calls: 800 (200=0 503=800 429=0), distinct messages sent: 0, sent twice or more: 0
after 12s: sms=0 sms-dlq=100
== backoff=exp: 100 messages, provider down 20s, rate limit 20/s, maxReceiveCount 8
  seconds  200 sent  503 down  429 limit  peak/s
   0-4            0       300          0      97
   5-9            0       100          0      53
  10-14           0         0          0       0
  15-19           0       100          0      50
  20-24           0         0          0       0
  25-29           0         0          0       0
  30-34          18         0          0       7
  35-39          24         0          0      12
  40-44          58         0          0      20
provider calls: 600 (200=100 503=500 429=0), distinct messages sent: 100, sent twice or more: 0
after 45s: sms=0 sms-dlq=0
== backoff=jitter: 100 messages, provider down 20s, rate limit 20/s, maxReceiveCount 8
  seconds  200 sent  503 down  429 limit  peak/s
   0-4            0       260          0      69
   5-9            0       181          0      50
  10-14           0        37          0      14
  15-19           0        49          0      29
  20-24          42         0          0      18
  25-29          28         0          0      10
  30-34          14         0          0       4
  35-39           9         0          0       3
  40-44           4         0          0       3
  45-49           1         0          0       1
provider calls: 625 (200=98 503=527 429=0), distinct messages sent: 98, sent twice or more: 0
after 49s: sms=0 sms-dlq=2
== backoff=equal: 100 messages, provider down 20s, rate limit 20/s, maxReceiveCount 8
  seconds  200 sent  503 down  429 limit  peak/s
   0-4            0       235          0      57
   5-9            0       162          0      54
  10-14           0        66          0      30
  15-19           0        38          0      22
  20-24          21         0          0      13
  25-29           9         0          0       3
  30-34          31         0          0      12
  35-39           3         0          0       1
  40-44          36         0          0      20
provider calls: 601 (200=100 503=501 429=0), distinct messages sent: 100, sent twice or more: 0
after 45s: sms=0 sms-dlq=0
في المخرج أعلاه لاحظ التالي:
- دون انتظار: نفس نتيجة التجربة الثانية، فكل رسالة استلمت ثماني مرات في اثنتي عشرة ثانية، والرسائل المئة كلها في
sms-dlqقبل عودة المزود. وشغلنا هذه السياسة أربع مرات، فامتلأت ال DLQ بالرسائل المئة في ثلاث منها بين 12 و16 ثانية، وفي المرة الرابعة كان ال Workers أبطأ في الفشل، فاستقبل المزود 474 استدعاء فاشلاً فقط ولم تصل أي رسالة إلى ثماني استلامات قبل عودته، فنجحت كلها. أي أن نفس الإعداد أعطى نتيجتين متعاكستين بحسب سرعة الفشل، وهذا يؤكد الفكرة: هذا الحد لا يقول شيئاً عن الوقت الذي تتحمله الرسالة. - تأخير متزايد دون عشوائية: لا شيء في ال DLQ، والفشل 500 استدعاء، ولكن لاحظ الشكل: الاستدعاءات تأتي في موجات من مئة بالضبط، في الثانية الأولى ثم بعد ثانيتين ثم بعد أربع ثم بعد ثمان، لأن الرسائل كلها فشلت معاً وتنتظر نفس المدة. والأسوأ أن المزود عاد في الثانية العشرين، ولم يصله أول إرسال ناجح إلا بعد الثانية الثلاثين، لأن الموجة التالية كانت بعد ست عشرة ثانية من السابقة، فبقي المزود السليم عشر ثوان ينتظر رسائل نائمة.
- Full Jitter: بدأ الإرسال الناجح فور عودة المزود وانتشر على عشرين ثانية بهدوء، وهذا ما وعد به مقال AWS، ولكن رسالتين ذهبتا إلى ال DLQ، لأن كل منهما سحبت أرقاماً صغيرة جداً عدة مرات متتالية، فاستهلكت محاولاتها الثماني قبل أن ينتهي العطل.
- Equal Jitter: لا شيء في ال DLQ، والفشل 501 استدعاء، والإرسال بدأ بعد العودة مباشرة على دفعات متفرقة، لأن كل انتظار له حد أدنى هو نصف القيمة المتزايدة، فلا تستطيع رسالة أن تستهلك محاولاتها بسرعة.
والصورة التالية تجمع التجارب السبع، ثم شكل الاستدعاءات في السياسات الثلاث الأخيرة:
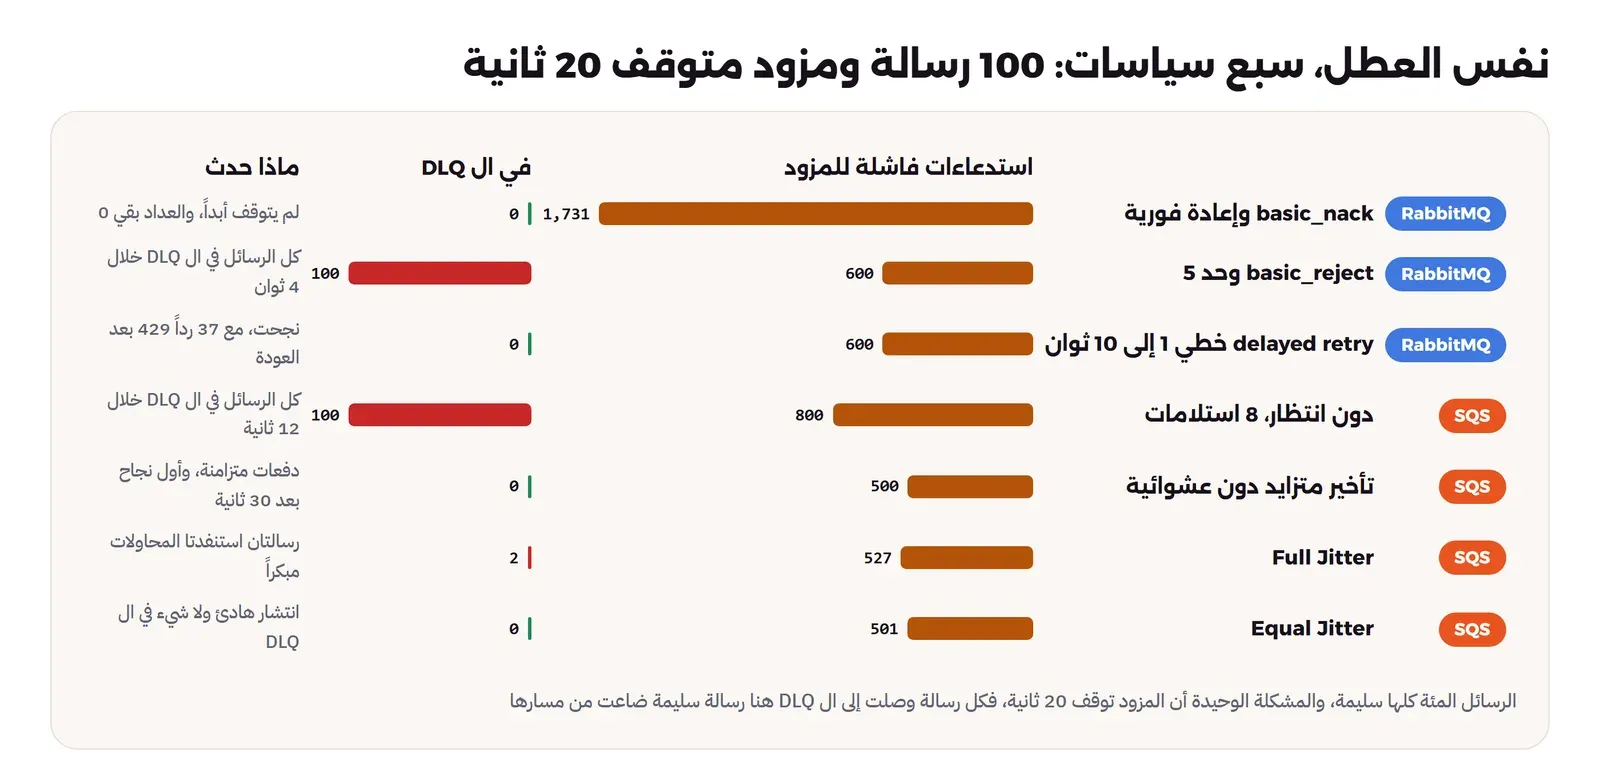
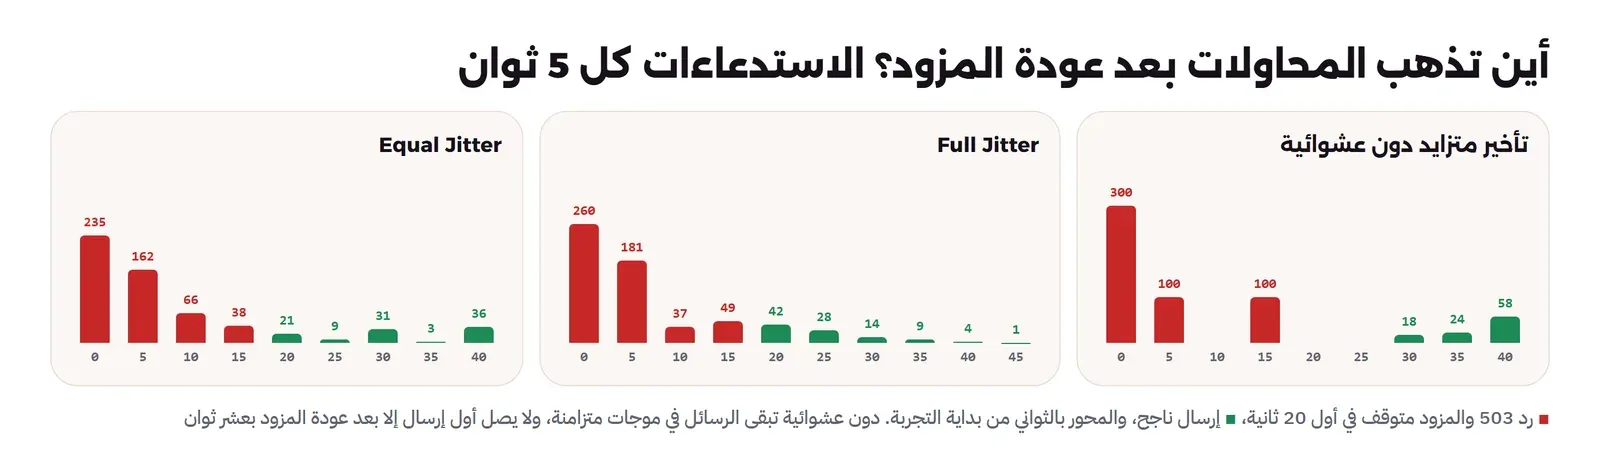
وقد يتساءل البعض: إذا كانت Full Jitter أفضل في مقال AWS فلماذا خسرت هنا؟ والإجابة أن ذلك المقال يقيس عدداً كبيراً من الكلاينتات تتنافس على مورد واحد، وكل كلاينت يعيد حتى ينجح، أما هنا فهناك حد ثابت للمحاولات، وكل محاولة تضيع بسبب انتظار قصير جداً تقرب الرسالة من ال DLQ. فإذا كان عندك حد للمحاولات فاختر عشوائية لها حد أدنى، أو اجعل الحد بعمر الرسالة بدل عددها، كأن يتوقف ال Consumer عن الإعادة عندما يكون الوقت منذ أول محاولة أكبر من ساعة، ويرسلها بنفسه إلى ال DLQ.
مشكلة ظهرت في التجربة: مهلة الإخفاء أقصر من العمل
في التجربة التالية لا يتوقف المزود، ولكنه بطيء: كل إرسال يأخذ خمس ثوان، ومهلة الإخفاء ثلاث ثوان فقط، وهذا يحدث في الواقع عندما تحدد المهلة على متوسط زمن المعالجة ثم يبطئ المزود في يوم ما. وأول مرة شغلنا فيها التجربة توقفت ثلاثة من ال Workers الأربعة فجأة، وهذا آخر سطر في رسالة الخطأ:
botocore.errorfactory.ReceiptHandleIsInvalid: An error occurred (ReceiptHandleIsInvalid) when calling the DeleteMessage operation: The receipt handle "d35c4ed4-2cf3-4a25-9db0-9244c941c24d#72672042-7245-428d-a6ad-76abb94c9aac" is not valid.والسبب أن الرسالة عادت للظهور بعد ثلاث ثوان، فاستلمها Worker آخر بإيصال استلام Receipt Handle جديد، وعندما انتهى ال Worker الأول وحاول أن يحذفها بإيصاله القديم رفض ElasticMQ الحذف برمي استثناء، ولم يكن في الكود ما يلتقطه، فتوقف الخيط Thread كله. وفي SQS الحقيقي قد ينجح الحذف بالإيصال القديم أو يفشل بحسب الحالة، لذلك التقط هذا الخطأ دائماً وسجله. وبعد أن أضفنا التقاط الاستثناء كما في الملف أعلاه شغلنا التجربة مرتين، مرة دون تمديد ومرة مع نبض Heartbeat يمدد مهلة الرسالة كل ثانية ما دام العمل مستمراً:
docker exec sw4-q-tools python sqs_lab.py vt plain
docker exec sw4-q-tools python sqs_lab.py vt heartbeat
والمخرج سوف يكون كما يلي:
stale receipt handle for sms-13 (receive #1)
stale receipt handle for sms-14 (receive #1)
stale receipt handle for sms-13 (receive #2)
stale receipt handle for sms-14 (receive #2)
stale receipt handle for sms-13 (receive #3)
stale receipt handle for sms-14 (receive #3)
stale receipt handle for sms-13 (receive #4)
stale receipt handle for sms-14 (receive #4)
stale receipt handle for sms-13 (receive #5)
stale receipt handle for sms-14 (receive #5)
stale receipt handle for sms-13 (receive #6)
stale receipt handle for sms-14 (receive #6)
stale receipt handle for sms-13 (receive #7)
stale receipt handle for sms-14 (receive #7)
stale receipt handle for sms-13 (receive #8)
stale receipt handle for sms-14 (receive #8)
== visibility 3s, work 5s, heartbeat=False: 20 messages
  seconds  200 sent  503 down  429 limit  peak/s
   0-4            4         0          0       4
   5-9            4         0          0       4
  10-14           4         0          0       4
  15-19           4         0          0       4
  20-24           4         0          0       4
  25-29           4         0          0       2
  30-34           4         0          0       2
  35-39           2         0          0       2
  40-44           4         0          0       2
provider calls: 34 (200=34 503=0 429=0), distinct messages sent: 20, sent twice or more: 14
after 48s: sms=0 sms-dlq=2
== visibility 3s, work 5s, heartbeat=True: 20 messages
  seconds  200 sent  503 down  429 limit  peak/s
   0-4            4         0          0       4
   5-9            4         0          0       4
  10-14           4         0          0       4
  15-19           4         0          0       4
  20-24           4         0          0       4
provider calls: 20 (200=20 503=0 429=0), distinct messages sent: 20, sent twice or more: 0
after 26s: sms=0 sms-dlq=0
في المخرج أعلاه لاحظ التالي:
- دون تمديد وصل إلى المزود 34 إرسالاً ناجحاً لعشرين رسالة، و14 رسالة أرسلت مرتين أو أكثر، أي أن العميل استقبل رسالة التحقق مرتين، وكل ذلك والمزود يرد بنجاح في كل مرة.
- الرسالتان
sms-13وsms-14أرسلتا بنجاح ثماني مرات، وفي كل مرة رفض الحذف لأن الإيصال قديم، ثم وصلتا إلى الحدmaxReceiveCountوانتقلتا إلى ال DLQ. أي أن ال DLQ فيه الآن رسالتان أرسلتا ثماني مرات، ومن يفحصهما سوف يظن أنهما لم ترسلا أبداً، ولو أعادهما لأرسلتا مرة تاسعة. - مع النبض أرسلت الرسائل العشرون عشرين مرة بالضبط، دون أي تكرار ودون شيء في ال DLQ، وانتهى العمل أسرع لأن ال Workers لم يضيعوا وقتهم في إرسال مكرر.
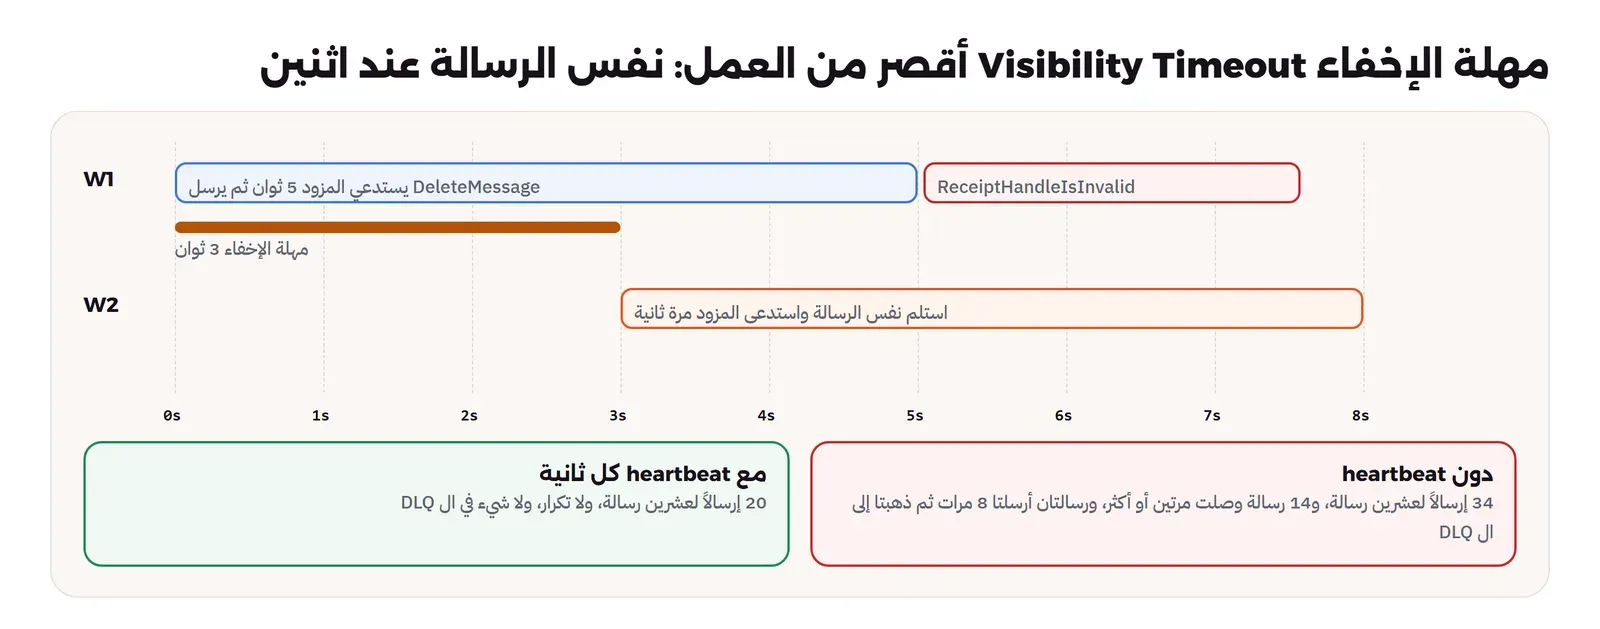
وهذا ما يوصي به توثيق مهلة الإخفاء في SQS: ابدأ بمهلة أطول من الزمن المعتاد للمعالجة، ومددها بنبض دوري ما دام العمل مستمراً، مع العلم أن الحد الأعلى للمهلة اثنتا عشرة ساعة من أول استلام ولا يعيده التمديد. وفي RabbitMQ يقابل ذلك المهلة consumer_timeout، فإذا لم يؤكد ال Consumer الرسالة خلالها يغلق الوسيط القناة وتعود الرسالة، والفرق أن هذه المهلة طويلة افتراضياً لأنها لحماية الوسيط وليست لإعادة المحاولة. ولاحظ أن النبض لا يغني عن أن يكون ال Consumer آمناً عند التكرار، فإذا توقف ال Worker بعد الإرسال وقبل الحذف فسوف تعود الرسالة في كل الأحوال، والطريقة الصحيحة لذلك جدول الرسائل المعالجة كما شرحنا في مقال Idempotency، أو مفتاح منع التكرار Idempotency Key يرسل إلى المزود نفسه إذا كان يدعمه.
إعادة الرسائل من ال DLQ Redrive: بسرعة محددة
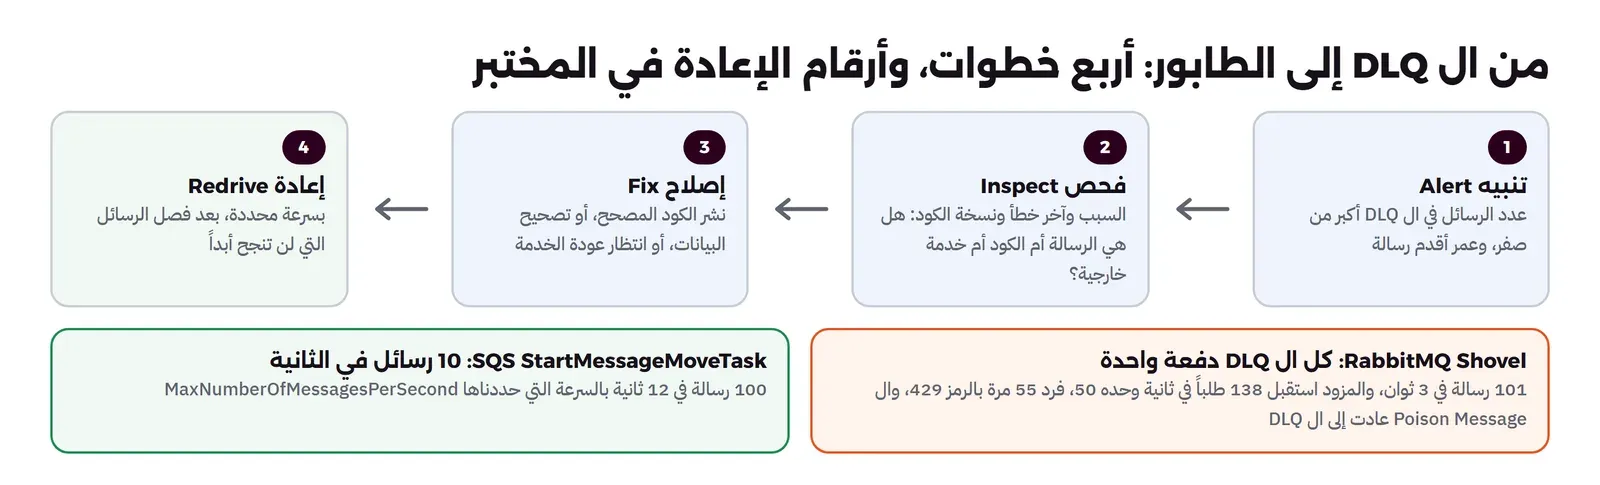
بعد أن يعود المزود ويصلح السبب تأتي الخطوة الأخيرة: إعادة الرسائل من ال DLQ إلى الطابور الأصلي. وفي SQS لهذا عملية رسمية هي StartMessageMoveTask، تنقل الرسائل إلى الطابور الذي جاءت منه، ولها معامل MaxNumberOfMessagesPerSecond يحدد السرعة. وبعد تشغيل سياسة «دون انتظار» مرة أخرى حتى تمتلئ ال DLQ بمئة رسالة، طلبنا النقل بعشر رسائل في الثانية:
docker exec sw4-q-tools python sqs_lab.py backoff none
docker exec sw4-q-tools python sqs_lab.py redrive
والمخرج سوف يكون كما يلي:
before: sms 0 sms-dlq 100
task: d4053213-be21-4a1f-a479-1a18b1ccc2dd
   2s  sms=17 sms-dlq=83
   4s  sms=34 sms-dlq=66
   6s  sms=51 sms-dlq=49
   8s  sms=69 sms-dlq=31
  10s  sms=85 sms-dlq=14
  12s  sms=100 sms-dlq=0
انتقلت الرسائل بالسرعة المطلوبة بالضبط، 17 رسالة كل ثانيتين تقريباً، وانتهى النقل في اثنتي عشرة ثانية. ولاحظ أننا نراقب أعداد الطابورين ولا نسأل عن حالة النقل بالعملية ListMessageMoveTasks، والسبب أن ElasticMQ توقف كلياً عندما استدعيناها في هذا الإصدار، فإذا كنت تختبر على محاك Emulator لخدمة سحابية فتذكر أنه لا يطبق كل شيء، وجرب العمليات المهمة على الخدمة الحقيقية قبل أن تعتمد عليها.
أما RabbitMQ فلا توجد فيه عملية بهذا الاسم، والطريقة المعتادة أن تنشئ Shovel مؤقتاً يقرأ من ال DLQ وينشر في الطابور الأصلي ثم يحذف نفسه، وهو ما تفعله واجهة الإدارة عندما تضغط «Move messages». ونفعل الإضافة أولاً ثم نعيد التجربة الثانية حتى تمتلئ ال DLQ، ثم ننشئ ال Shovel عبر واجهة الإدارة HTTP API والمزود سليم وال Workers تعمل:
docker exec sw4-q-broker rabbitmq-plugins enable rabbitmq_shovel rabbitmq_shovel_management
docker exec sw4-q-tools python rmq_lab.py reject
docker exec sw4-q-tools python rmq_lab.py redrive
والمخرج سوف يكون كما يلي:
before: sms=0 sms.dlq=101
shovel: 201
  seconds  200 sent  503 down  429 limit  peak/s
   0-4          100         0         55     138
provider calls: 155 (200=100 503=0 429=55), distinct messages sent: 100, sent twice or more: 0
after 3s: sms=0 sms.dlq=1
still in the DLQ: {"id": "sms-bad", "to":
  x-death: queue=sms reason=rejected count=1
في المخرج أعلاه لاحظ التالي:
- الخيار
"src-delete-after": "queue-length"جعل ال Shovel يقيس طول ال DLQ عند بدايته وينقل هذا العدد ثم يحذف نفسه، كما يشرح توثيق Dynamic Shovels، فنقل 101 رسالة في أقل من ثلاث ثوان. - ولكن هذه السرعة نفسها مشكلة: وصل إلى المزود 138 طلباً في ثانية وحده 50، فرد 55 مرة بالرمز
429، أي أن الإعادة من ال DLQ صنعت نفس الموجة التي صنعها العطل. ونجحت الرسائل لأن حد التسليم 5 كان كافياً هنا، ولكن مع آلاف الرسائل كانت سوف تعود إلى ال DLQ. ولا يوجد في ال Shovel حد للسرعة بالرسائل في الثانية، لذلك انقل على دفعات صغيرة بالخيارsrc-delete-afterبرقم ثابت بدل queue-length، وانتظر بين الدفعات، أو اكتب أداة إعادة صغيرة تقرأ من ال DLQ بالسرعة التي تريدها. - الرسالة التالفة عادت مع الرسائل ثم رفضها الكود فوراً، فهي الوحيدة الباقية في ال DLQ، وهذا صحيح، فإعادة رسالة دون إصلاح سببها لا تفيد. ولاحظ أن العداد
countفيx-deathما زال 1 مع أنها رفضت مرتين، لأنها دخلت الطابور من جديد كرسالة منشورة عبر ال Shovel، فلا تعتمد على هذا العداد لتعرف كم مرة أعيدت رسالة من ال DLQ، وأضف ترويسة خاصة بك في أداة الإعادة.
ماذا تراقب؟ Monitoring
ال DLQ الذي لا ينظر فيه أحد عمل يضيع ببطء دون أن يشعر به أحد، والمقاييس التي تكشف المشكلات التي رأيتها في التجربة قبل أن يكتشفها العملاء هي:
- عدد الرسائل في كل DLQ: تنبيه عندما يكون أكبر من صفر في الطوابير المهمة، وتنبيه أقوى عندما يزيد بسرعة، لأن الزيادة السريعة تعني غالباً عطلاً في خدمة وليس رسالة تالفة.
- عمر أقدم رسالة: في الطابور الأصلي يكشف أن ال Workers لا تلحق، وفي ال DLQ يكشف أن أحداً لا يعالجها. وفي SQS هو المقياس
ApproximateAgeOfOldestMessage، ولاحظ أنه في ال DLQ يحسب من وقت النقل إليها كما يقول التوثيق. - معدل الإعادة: نسبة الرسائل التي أعيدت إلى كل الرسائل المسلمة، وفي RabbitMQ يظهر في واجهة الإدارة كمعدل Redelivered، وارتفاعه المفاجئ يسبق امتلاء ال DLQ.
- توزيع العداد: إذا كان أغلب الرسائل تنجح في المحاولة الأولى وبعضها يحتاج السابعة، فهناك مشكلة في خدمة خارجية، وإذا كانت نسبة ثابتة تحتاج الثانية دائماً فهناك خطأ في الكود يختفي بالإعادة، مثل سباق بين خدمتين.
كيف تختار السياسة؟ Decision Table
الجدول التالي يلخص ما رأيته في التجربة على شكل قرار:
| الحالة | السياسة المناسبة | والسبب |
|---|---|---|
| JSON تالف، حقل ناقص، رد 400 أو 422 | رفض دون إعادة إلى ال DLQ فوراً، مع السبب في ترويسة | لن تنجح مهما أعدت، وكل إعادة تأخذ من وقت ال Workers وتخفي الأخطاء الحقيقية |
| خطأ مؤقت يزول في أجزاء من الثانية، مثل اتصال انقطع | إعادة داخل ال Consumer مرتين بانتظار قصير | أسرع من إرجاع الرسالة إلى الوسيط، بشرط أن يكون المجموع أقل من ثانيتين |
| خدمة خارجية متوقفة أو بطيئة، والرسائل في RabbitMQ 4.3 أو أحدث | Quorum مع delayed retry، وreject وليس nack، وحد يغطي العطل الذي تريد تحمله | الوسيط يحفظ الرسالة وينتظر، ولكن أضف عشوائية في الكود إذا كانت الرسائل بالآلاف |
| نفس الحالة في إصدار أقدم من RabbitMQ | طابور انتظار لكل مدة بمدة ثابتة، ثم DLQ | المدة لكل رسالة تحجب الطابور خلف أطول رسالة |
| نفس الحالة في SQS | ChangeMessageVisibility بتأخير متزايد مع Equal Jitter، أو حد بعمر الرسالة | تأخير لكل رسالة دون حجب، وحد أدنى للانتظار حتى لا تستهلك الرسالة محاولاتها مبكراً |
| معالجة قد تطول أكثر من المعتاد | مهلة إخفاء أطول من المعتاد مع نبض يمددها | الإعادة بسبب انتهاء المهلة تكرر العمل الناجح وتستهلك المحاولات |
| Kafka | مواضيع إعادة بتأخير متدرج ثم موضوع DLQ | لا يوجد تأكيد لكل رسالة، والرسالة الفاشلة تسد ال Partition |
| الإعادة من ال DLQ | بعد الإصلاح، بسرعة محددة، وبعد فصل الرسائل التالفة | الإعادة الجماعية موجة جديدة على نفس الخدمة |
وإذا كانت مهامك في PostgreSQL وليست في وسيط منفصل، كما في مقال PostgreSQL لكل شيء، فالأفكار نفسها تنطبق: عمود عداد للمحاولات، وعمود وقت التشغيل التالي تحسبه بالتأخير المتزايد مع العشوائية، وحالة failed تقوم مقام ال DLQ، وتصنيف الخطأ في الكود قبل كل ذلك.
أخطاء شائعة Common Mistakes
- nack مع حد تسليم في RabbitMQ 4.3: رأيت أن العداد لا يزيد، فالحد لا يعمل أبداً، والرسالة الفاشلة تدور بلا نهاية. استخدم reject للفشل الحقيقي، أو حدد الحد في الكود بالعداد
x-acquired-count. - حد بعدد المحاولات دون انتظار: خمس محاولات في ثانية واحدة، فكل عطل أطول من ثانية يملأ ال DLQ برسائل سليمة.
- تأخير متزايد دون عشوائية: الرسائل التي فشلت معاً تعود معاً، فتبقى الخدمة العائدة دون عمل ثم تستقبل موجة، وقد تسقط من جديد.
- مدة صلاحية مختلفة لكل رسالة في طابور انتظار واحد: الرسالة تنتظر خلف أطول رسالة أمامها، فالانتظار الذي حسبته لا يحدث.
- مهلة إخفاء أقصر من أبطأ معالجة: تكرار للعمل الناجح، ورسائل أرسلت عدة مرات تصل إلى ال DLQ كأنها فشلت.
- معاملة كل الأخطاء معاملة واحدة: الرسالة التالفة تعاد عشرين مرة، والمزود المتوقف يعامل كرسالة تالفة.
- DLQ دون تنبيه ودون صاحب: يمتلئ أسابيع ثم تحذف الرسائل بانتهاء مدة الحفظ، وفي SQS قد يكون ذلك أسرع مما تتوقع لأن المدة تحسب من الطابور الأصلي.
- إعادة كل ال DLQ دفعة واحدة دون إصلاح: الرسائل التالفة تعود إليه، والسليمة تصنع موجة على الخدمة نفسها.
قائمة تحقق Checklist
- الكود يصنف كل خطأ إلى دائم ومؤقت وغير معروف، ويرسل الدائم إلى ال DLQ دون إعادة.
- لكل طابور حد مكتوب بالوقت: كم دقيقة من العطل يجب أن تتحمل الرسالة، ومتى تصبح بلا فائدة.
- الانتظار متزايد وله حد أدنى وعشوائية، والحد الأعلى للانتظار مناسب لعمر الرسالة.
- في RabbitMQ: الطوابير Quorum، والفشل الحقيقي reject، والحد مضبوط بسياسة Policy وليس فقط في الكود.
- في SQS: مهلة الإخفاء أطول من أبطأ معالجة معروفة، ومع نبض لمعالجة قد تطول، وخطأ الإيصال القديم ملتقط.
- لكل طابور مهم DLQ خاص به، ومدة حفظه أطول من الطابور الأصلي.
- الرسالة في ال DLQ معها السبب وآخر خطأ وعدد المحاولات.
- تنبيه على عدد الرسائل في ال DLQ وعلى عمر أقدم رسالة، وشخص أو فريق مسؤول عنه.
- أداة إعادة بسرعة محددة، تضيف ترويسة بعدد مرات الإعادة.
- ال Consumer آمن عند التكرار، لأن كل ما سبق يعني أن الرسالة قد تصل أكثر من مرة.
حذف المختبر Cleanup
docker compose down
docker rmi sw4-qlab sw4-rabbitmq:4.3.6-management-alpine sw4-elasticmq:1.7.1 sw4-python:3.13.18-slim
ماذا تقرأ بعد ذلك؟ Next Steps
هذا المقال آخر خطوة في فهم الطوابير قبل أن تبني عليها، والمقالات التالية تكمل الصورة: المهام الخلفية التي تضعها في الطابور أصلاً، وال Webhooks التي تواجه نفس مشكلة الإعادة ولكن من الطرف الآخر، وكيف تجعل ال Consumer آمناً عند التكرار، وأي وسيط يناسب حجم عملك.
 دليلالمهام الخلفية Background Jobs: لماذا لا ينتظر المستخدم؟كيف تخرج إرسال البريد ومعالجة الملفات من الطلب إلى عامل يعمل في الخلفية، مع تجربة على Celery وRedis تقيس زمن الطلب قبل وبعد وتقتل العامل في منتصف مهمة.
 دليلWebhooks: كيف ترسل الأحداث بين الأنظمة وتستقبلها بأمانكيف تستقبل رسائل الـ Webhook وترسلها دون أن تخدعك رسالة مزورة أو مكررة أو قديمة، مع تجربة تعيد كل عطل من التوقيع الخاطئ إلى ثلاثة إيصالات لدفعة واحدة.
 دليلIdempotency: كيف تجعل العملية آمنة عند تكرارهالماذا تصل الرسالة نفسها أكثر من مرة، وكيف تكتب مستهلكاً يطبقها مرة واحدة فقط مهما تكررت.
 دليلالطابور Queue للمبتدئين: لماذا تحتاجه وكيف يعمللماذا تضع العمل البطيء في طابور بدل أن ينتظره المستخدم، وكيف تضمن ألا تضيع الرسالة إذا توقف ال Worker فجأة.
 دليلكيف تمنع خدمة بطيئة من إسقاط نظامك كله؟لماذا تسقط خدمة بطيئة واحدة تطبيقك السليم، وكيف تحميه بالمهلة وإعادة المحاولة المحدودة وقاطع الدائرة ورفض الزائد.
 دليلRabbitMQ: طوابير موثوقة لتطبيقاتك على سيرفرككيف تشغل RabbitMQ في عنقود من ثلاث عقد، وتوجه الرسائل بالموزعات، وتضمن ألا تضيع رسالة إذا سقطت عقدة.
 دليلRabbitMQ أم Kafka أم NATS؟ كيف تختار وسيط الرسائلكيف تختار بين RabbitMQ وKafka وNATS بحسب نموذج كل منها وضماناته وتكلفة تشغيله، مع قياس على جهاز واحد.
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- صنف الخطأ قبل أن تعيد: الدائم إلى ال DLQ فوراً، والمؤقت ينتظر ثم يعاد، وحد الوسيط شبكة أمان أخيرة للرسائل التي توقف ال Worker نفسه.
- الحد بعدد المحاولات هو حد بالوقت: خمس محاولات دون انتظار تتحمل عطلاً أقل من ثانية، وفي التجربة ملأت عطلاً مدته عشرون ثانية DLQ بمئة رسالة سليمة في أربع ثوان.
- في RabbitMQ 4.3 لا يزيد
basic.nackعداد التسليم، فكانت النتيجة 1731 استدعاء فاشلاً لمئة رسالة دون أن يعمل الحد، والإعادة المؤجلة في طوابير Quorum حلت المشكلة بستمئة استدعاء دون أي رسالة في ال DLQ. - التأخير دون عشوائية يصنع موجات: رسائل نائمة والمزود سليم، ثم موجة تتجاوز حده، وFull Jitter استهلك محاولات رسالتين مبكراً، وEqual Jitter أعطى أفضل توازن مع حد ثابت للمحاولات.
- مدة الصلاحية لكل رسالة في طابور واحد لا تصلح للانتظار لأن الرسائل تنتهي عند الرأس فقط، والحل طابور لكل مدة.
- مهلة الإخفاء الأقصر من العمل أعادت رسائل ناجحة، فأرسلت 14 رسالة من عشرين أكثر من مرة، ووصلت رسالتان أرسلتا ثماني مرات إلى ال DLQ، والنبض أصلح ذلك كله.
- الإعادة من ال DLQ إعادة محاولة جماعية: بعد الإصلاح، وبسرعة محددة، ودون الرسائل التالفة.
سجل التحديثات Changelog
- 18 نوفمبر 2026: كتابة المقال، وتنفيذ التجارب على Docker Engine 29.8.0 مع RabbitMQ 4.3.6 (rabbitmq:4.3.6-management-alpine) وElasticMQ 1.7.1 (softwaremill/elasticmq-native:1.7.1) وPython 3.13.18 مع pika 1.3.2 وboto3 1.40.0.