تضيف إلى تطبيقك ميزة رفع الصور: المستخدم يرفع صورة من جواله، والتطبيق يصنع منها ثلاث نسخ بأحجام مختلفة للعرض، ثم يرسل له بريداً يقول إن الصورة جاهزة. وتكتب الكود في دالة واحدة داخل الطلب، وتجربه على جهازك فيأخذ ثلاث ثوان ونصف، وتقول إن هذا مقبول لصورة حجمها خمسة ميجابايت. ثم يأتي يوم يرفع فيه ثمانية مستخدمين صورهم في اللحظة نفسها، فيصبح الطلب عشر ثوان، ثم يبطئ مزود البريد لأن عنده ضغطاً، فتصل بعض الطلبات إلى المهلة Timeout في الـ Reverse Proxy، فيرى المستخدم خطأ 504 ويرفع الصورة مرة ثانية، فيصله بريدان، ويتضاعف الضغط على السيرفر الذي كان يعاني أصلاً.
والمشكلة هنا ليست في سرعة الكود، فصناعة النسخ الثلاث تأخذ ثانية ونصفاً مهما فعلت، وإنما في أن المستخدم ينتظر شيئاً لا يحتاج أن ينتظره: هو يحتاج أن يعرف أن الصورة وصلت، أما النسخ المصغرة والبريد فيمكن أن تجهز بعد ثوان دون أن يلاحظ أحد. والحل المعروف أن ينقل هذا العمل إلى مهمة خلفية Background Job: الطلب يحفظ الصورة ويضع رسالة صغيرة في طابور Queue ويرد فوراً، وعامل Worker منفصل يأخذ الرسالة وينفذ العمل. وهذا المقال هو الأول في مرحلة الطوابير لأنه أكثر سبب يجعل المطور يحتاج طابوراً في حياته.
وسوف نناقش في هذا المقال ما يلي:
- ما الذي يجب أن يخرج من الطلب، وما الذي يجب أن يبقى فيه.
- كيف تعمل المهام الخلفية: المنتج Producer والوسيط Broker والعامل Worker ومخزن النتائج Result Backend.
- الخيارات المتاحة: خيط Thread داخل العملية، والمهام المجدولة Cron، ومكتبات الطوابير مثل Celery وBullMQ، والطوابير فوق PostgreSQL.
- ماذا يرى المستخدم بعد أن يصبح العمل في الخلفية، ورمز الرد 202 Accepted.
- عدد العمال Concurrency، والفرق بين العمل الذي يستهلك المعالج CPU-bound والعمل الذي ينتظر الشبكة I/O-bound.
- إعادة المحاولة Retry، والتسليم مرة على الأقل At-least-once، ومهلة الرؤية Visibility Timeout، ولماذا يجب أن تكون المهمة آمنة عند تكرارها.
- المهام المجدولة Scheduled Jobs، ومراقبة الطابور.
- تجربة عملية على تطبيق صور حقيقي مع FastAPI وCelery وRedis: نقيس زمن الطلب قبل وبعد، ونرى الطابور يكبر، ونوقف خادم البريد، ونقتل العامل في منتصف مهمة.
ما الذي يجب أن يخرج من الطلب؟
القاعدة البسيطة: الطلب يجب أن يحتوي فقط ما يحتاجه الرد. فإذا كان المستخدم يحتاج أن يرى نتيجة العمل في الصفحة التالية مباشرة فالعمل يبقى في الطلب، وإذا كان يكفيه أن يعرف أن العمل «بدأ» أو «سوف يتم» فالعمل يخرج. ومع هذه القاعدة هناك ثلاث علامات تقول لك إن العمل يجب أن يخرج حتى لو بدا سريعاً:
- يعتمد على طرف خارجي: خادم بريد، أو بوابة رسائل SMS، أو واجهة شركة شحن، أو أي Webhook ترسله، فهذه أشياء لا تتحكم في زمنها، وإذا تعطلت فلا يجب أن يتعطل معها تسجيل المستخدم.
- يستهلك المعالج أو الذاكرة بشكل ملحوظ: معالجة الصور والفيديو وملفات PDF وملفات Excel الكبيرة والتقارير، لأن كل ثانية منها تحجز Worker من عمال الويب كان يمكن أن يخدم عشرات الطلبات الصغيرة.
- يمكن أن يفشل ويعاد: العمل الذي يحتاج إعادة محاولة بعد دقيقة لا يمكن أن ينتظر فيه المستخدم دقيقة.
والجدول التالي يبين أمثلة شائعة وأين يكون مكان كل منها:
| العمل | المكان | السبب |
|---|---|---|
| التحقق من كلمة المرور وإنشاء الجلسة | داخل الطلب | الرد نفسه يعتمد عليه |
| حفظ الطلب في قاعدة البيانات | داخل الطلب | يجب أن يعرف المستخدم أن طلبه حفظ فعلاً |
| بريد الترحيب أو الإيصال | مهمة خلفية | طرف خارجي، ويمكن أن يتأخر ثوان |
| النسخ المصغرة للصورة | مهمة خلفية | يستهلك المعالج، والصفحة تستطيع أن تعرض «جاري التجهيز» |
| تقرير Excel لسنة كاملة | مهمة خلفية | قد يأخذ دقائق، ويرسل الرابط بالبريد أو يظهر في الصفحة عند جهوزه |
| إرسال Webhook لعملائك | مهمة خلفية | يحتاج إعادة محاولة لأيام كما شرحنا في مقال الـ Webhooks |
| حذف الملفات المؤقتة كل ليلة | مهمة مجدولة | لا يرتبط بطلب أي مستخدم |
ولاحظ أن «الخروج من الطلب» لا يعني «الخروج من الكود»، فالعمل نفسه هو الدالة نفسها، وما يتغير هو من يستدعيها ومتى. وفي التجربة سوف ترى أن الملف work.py هو نفسه في النسختين، والفرق سطر واحد في الطلب.
كيف تعمل المهام الخلفية من الداخل؟
أي نظام مهام خلفية، مهما كان اسمه، فيه أربعة أجزاء، وهي نفسها الأجزاء التي شرحناها في مفاهيم الطوابير Queue مع أسماء مختلفة قليلاً:
- المنتج Producer: وهو تطبيق الويب، يضع في الطابور رسالة صغيرة تقول «نفذ المهمة
process_photoعلى الصورة رقم 42»، ولا يضع الصورة نفسها، لأن الرسالة يجب أن تبقى صغيرة، والملف مكانه القرص أو تخزين الكائنات S3. - الوسيط Broker: المكان الذي تنتظر فيه الرسائل، مثل Redis أو RabbitMQ، أو جدول في PostgreSQL.
- العامل Worker: عملية Process منفصلة تعمل على السيرفر نفسه أو على سيرفر آخر، تسحب الرسائل من الوسيط وتنفذ الدالة المطلوبة، وتستطيع أن تشغل عدة عمال، وكل عامل قد ينفذ عدة مهام في الوقت نفسه.
- مخزن النتائج Result Backend: اختياري، يحفظ حالة كل مهمة ونتيجتها، فيستطيع التطبيق أن يسأل «هل انتهت المهمة؟».
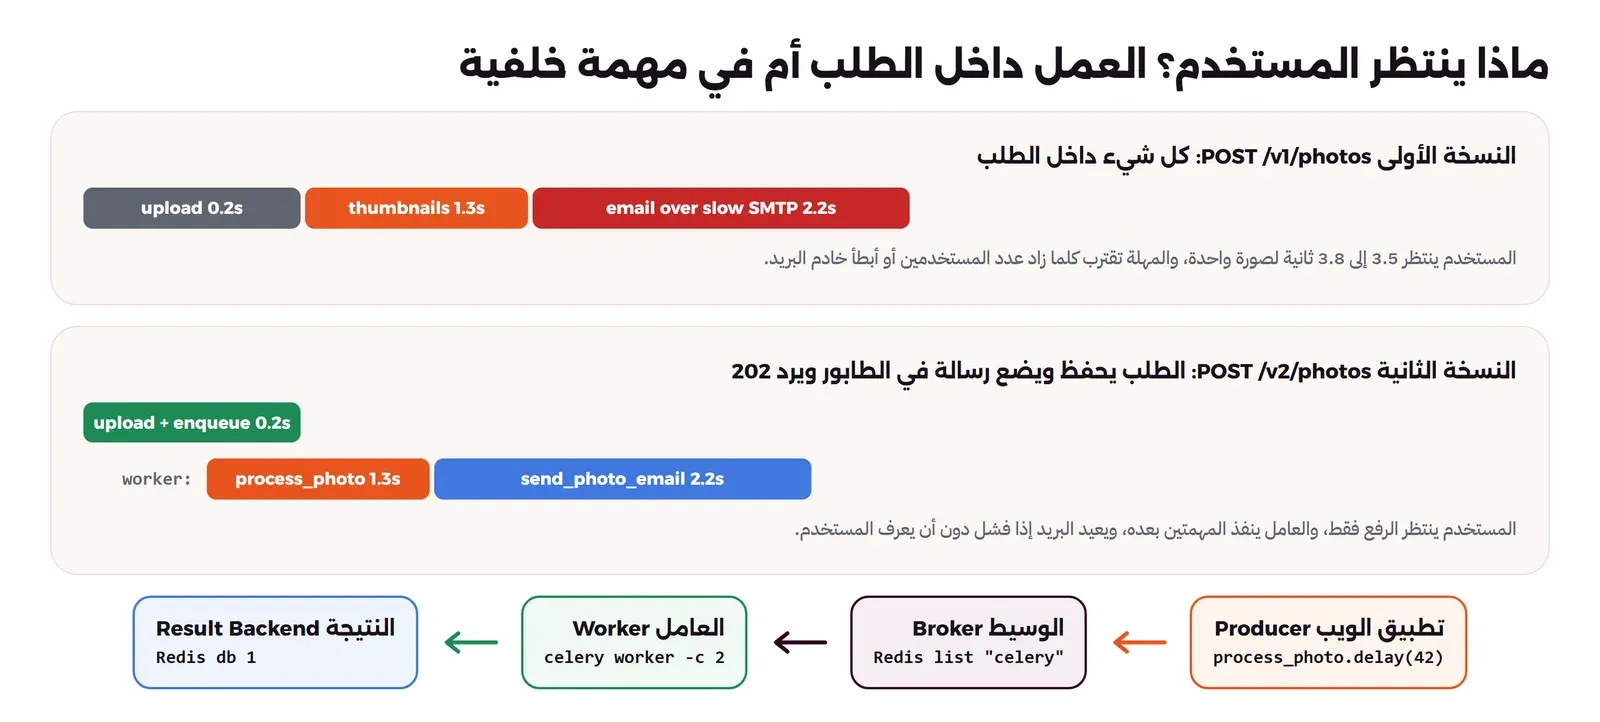
والجديد هنا مقارنة بالطابور العادي أن الرسالة ليست «حدثاً» يهم عدة أطراف، وإنما «أمر» بتنفيذ دالة معينة بمعاملات معينة، وأن مكتبة المهام تعطيك فوق الطابور أشياء جاهزة: إعادة المحاولة بجدول، والمهام المؤجلة إلى وقت محدد، والمهام الدورية، وتتبع الحالة، والمهلة لكل مهمة، وأدوات المراقبة. والصورة التالية تبين الفرق بين النسختين اللتين سوف نقيسهما:
ما الخيارات المتاحة؟ من الخيط إلى الطابور
قبل أن تضيف Redis وعاملاً إلى نظامك، اعرف الطرق الأبسط ولماذا لا تكفي غالباً، فالترتيب هنا من الأسهل إلى الأقوى:
- خيط Thread أو مهمة داخل العملية نفسها: أغلب الأطر تقدم شيئاً مثل
BackgroundTasksفي FastAPI، ينفذ الدالة بعد إرسال الرد في العملية نفسها. وهذا يحل مشكلة الانتظار، ولكن المهمة تعيش في ذاكرة العملية فقط، فإذا أعيد تشغيل التطبيق أثناء النشر أو توقف بسبب نفاد الذاكرة ضاعت كل المهام التي لم تنته، ولا توجد إعادة محاولة ولا مراقبة، وما زالت المهمة تأخذ المعالج من عمال الويب. وهو مناسب لأشياء لا يضر ضياعها، مثل تسجيل إحصائية. - المهمة المجدولة Cron: تكتب الطلب في جدول بحالة «جديد»، ومهمة Cron كل دقيقة تعالج الجديد. وهذا بسيط ويعيش بعد إعادة التشغيل، ولكن المستخدم ينتظر حتى دقيقة، وإذا تأخرت دورة عن دقيقة بدأت دورتان معاً على الصفوف نفسها إلا إذا أضفت قفلاً. وقد شرحنا Cron وsystemd Timers في المهام المجدولة.
- مكتبة مهام فوق Redis أو RabbitMQ: مثل Celery وRQ وDramatiq في Python، وBullMQ في Node.js، وSidekiq في Ruby. وهذا هو الخيار الأشهر، وهو ما نستخدمه في التجربة، وقد شرحنا أين تضيع المهام في Redis وكيف تتعامل كل مكتبة مع العامل المتوقف في طوابير المهام فوق Redis وValkey.
- مكتبة مهام فوق PostgreSQL: مثل River في Go، وpg-boss في Node.js، وProcrastinate في Python، وSolid Queue في Rails، وOban في Elixir. وكلها تعتمد على
SELECT … FOR UPDATE SKIP LOCKED، وميزتها الكبيرة أنك تستطيع أن تضيف المهمة في المعاملة Transaction نفسها التي حفظت فيها الطلب، فلا توجد حالة «الطلب حفظ والمهمة ضاعت»، ولا تحتاج خدمة جديدة تشغلها. وقد شرحنا متى تكفيك قاعدة البيانات لهذا في PostgreSQL لكل شيء. - وسيط رسائل كامل مع مستهلكين تكتبهم بنفسك: RabbitMQ أو Kafka أو NATS، وهذا مناسب عندما تتجاوز المسألة «نفذ دالة» إلى أحداث تهم عدة خدمات، وهو موضوع بقية مقالات هذه المرحلة.
ولاحظ مشكلة الكتابة المزدوجة Dual Write في الخيار الثالث: التطبيق يحفظ الصورة في PostgreSQL ثم يضع المهمة في Redis، فإذا توقف بين الخطوتين بقيت صورة بلا مهمة، وإذا وضع المهمة قبل أن تنتهي المعاملة فقد يبدأ العامل قبل أن يرى الصف في قاعدة البيانات. والحل إما طابور في PostgreSQL نفسه، أو نمط Outbox الذي شرحناه في Saga ونمط Outbox، أو على الأقل أن تضع المهمة بعد نجاح المعاملة Commit وتضيف مهمة مصالحة دورية تبحث عن الصور العالقة.
ماذا يرى المستخدم؟ رمز الرد 202 Accepted
عندما يخرج العمل من الطلب يتغير معنى الرد: الطلب لم ينته، وإنما قبل. ولهذا يوجد رمز الحالة 202 Accepted، ومعناه أن الطلب استلم وسوف يعالج، دون وعد بالنتيجة. والرد الجيد يحمل معرفاً يستطيع العميل أن يسأل به عن الحالة لاحقاً، وفي التجربة يعيد التطبيق رقم الصورة ومعرف المهمة، ونقطة GET /jobs/{id} تعيد حالتها: PENDING ثم SUCCESS أو FAILURE.
والواجهة تستطيع أن تعرض الحالة بثلاث طرق: أن تعرض الصورة الأصلية مع علامة «جاري التجهيز» ثم تتحقق كل ثانيتين، أو أن تفتح اتصالاً يرسل لها السيرفر التحديث عند حدوثه، وقد شرحنا الطرق الثلاث للتواصل اللحظي في Polling وSSE وWebSocket، أو ببساطة أن ترسل للمستخدم إشعاراً أو بريداً عند الانتهاء، وهذا يكفي لأغلب الأعمال الطويلة مثل التقارير. والخطأ الذي يجب تجنبه أن تقول للمستخدم «تم» وأنت تقصد «قبل»، فإذا فشلت المهمة بعد ذلك يجب أن يعرف، إما بحالة «فشل» في الصفحة أو بإشعار.
كم عاملاً تحتاج؟ Concurrency
العامل في Celery يشغل افتراضياً عدداً من العمليات الفرعية Processes يساوي عدد أنوية المعالج، وكل عملية تنفذ مهمة واحدة في الوقت نفسه، ويمكنك أن تغير العدد بالخيار --concurrency. والسؤال «كم عملية؟» جوابه يعتمد على نوع العمل:
- العمل الذي يستهلك المعالج CPU-bound: مثل معالجة الصور، وهذا لا يستفيد من عمليات أكثر من الأنوية المتاحة فعلاً، لأن كل عملية إضافية تنتظر دورها على المعالج نفسه. وإذا كان السيرفر يشارك الأنوية مع تطبيق الويب وقاعدة البيانات، فالمتاح أقل من العدد الذي تراه في
nproc. - العمل الذي ينتظر الشبكة I/O-bound: مثل إرسال البريد واستدعاء واجهات خارجية، وهنا العملية تقضي أغلب وقتها منتظرة، فتستطيع أن تشغل عدداً أكبر بكثير من الأنوية، أو أن تستخدم مجموعة خيوط Threads أو
geventبدل العمليات، والسعة تتضاعف تقريباً مع كل مضاعفة للعدد حتى يصل الطرف الآخر إلى حده.
وقانون Little الذي يربط بين المعدل والزمن وعدد العناصر داخل النظام يعطيك الرقم المبدئي: إذا كان يصل 5 صور في الثانية، وكل صورة تأخذ 1.5 ثانية من عمل المعالج، فأنت تحتاج 7.5 عملية مشغولة في المتوسط، فإذا كان عندك عمليتان فقط فالطابور سوف يكبر بلا توقف، وهذا بالضبط ما سوف تراه في التجربة. والقاعدة: الطابور لا يزيد السعة، وإنما يؤجل العمل، فإذا كان معدل الوصول أعلى من معدل المعالجة لفترة طويلة فأنت تحتاج عمالاً أكثر، أو عملاً أقل في كل مهمة.
ولهذا السبب أيضاً لا تضع المهام السريعة والمهام الطويلة في طابور واحد، لأن بريداً يأخذ ثانيتين سوف ينتظر خلف مئتي صورة تأخذ كل منها ثانية ونصفاً، وهذا ما حدث في التجربة. والحل طوابير منفصلة، مثل emails وmedia، ولكل منها عمال خاصون به، وهو ما يسمى أحياناً العزل Bulkhead.
إعادة المحاولة Retry: أي خطأ يستحق المحاولة مرة ثانية؟
المهام الخلفية تفشل لأسباب كثيرة، وبعضها مؤقت وبعضها دائم، والتمييز بينهما أهم قرار في إعادة المحاولة:
- أخطاء مؤقتة تستحق إعادة المحاولة: انقطاع الاتصال، وانتهاء المهلة، والرد 503 أو 429 من واجهة خارجية، وخادم البريد الذي يرد «حاول لاحقاً». وهذه تعاد بتأخير أسي Exponential Backoff مع عشوائية Jitter، أي ثانيتين ثم أربع ثم ثمان، حتى لا تعود كل المهام الفاشلة في اللحظة نفسها عندما يعود الطرف الآخر.
- أخطاء دائمة لا تستحق: صورة تالفة لا تفتح، وعنوان بريد غير صالح، وخطأ في الكود. وهذه إذا أعدتها عشر مرات فسوف تفشل عشر مرات، وتأخذ وقت العمال من المهام الصحيحة، ومكانها أن تسجل وتنقل إلى مكان تراجعه فيه، وهو ما يسمى طابور الرسائل الميتة Dead Letter Queue.
وفي Celery تحدد ذلك على المهمة نفسها: autoretry_for لقائمة الأخطاء التي تعاد، وretry_backoff للتأخير الأسي، وretry_jitter للعشوائية، وmax_retries للحد الأقصى، والمهمة التي تتجاوز الحد تنتهي بحالة FAILURE. ولاحظ أن إعادة المحاولة في Celery تنشئ رسالة جديدة في الطابور بموعد مستقبلي، والعامل يحتفظ بها في ذاكرته حتى يحين موعدها، لذلك المهام المؤجلة لساعات طويلة لها مشكلة خاصة مع مهلة الرؤية سوف نذكرها بعد قليل.
مرة على الأقل At-least-once: لماذا يجب أن تكون المهمة آمنة عند تكرارها؟
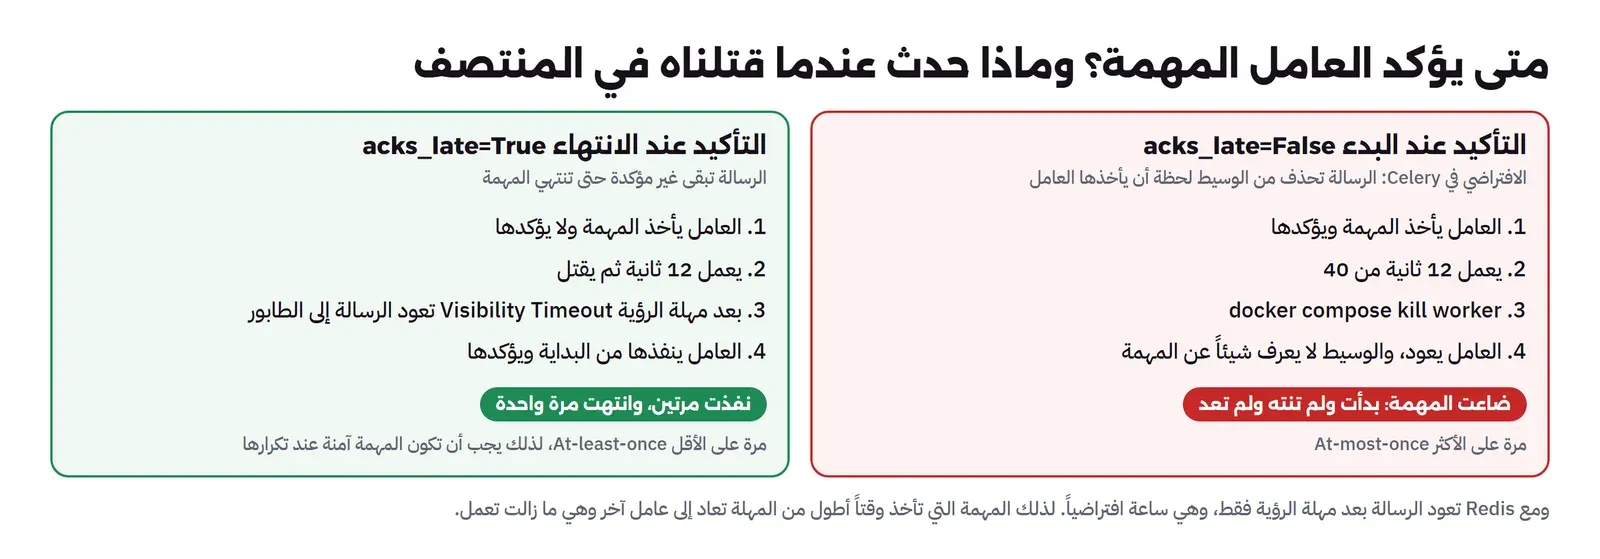
هناك لحظة واحدة تحدد سلوك أي نظام مهام عند الأعطال: متى يخبر العامل الوسيط أنه انتهى من الرسالة، أي متى يرسل التأكيد Ack. وCelery يعطيك خيارين:
- التأكيد عند البدء، وهو الافتراضي في Celery: العامل يؤكد الرسالة لحظة أن يأخذها، فإذا توقف في منتصف المهمة ضاعت المهمة، لأن الوسيط حذفها. وهذا يسمى «مرة على الأكثر» At-most-once.
- التأكيد عند الانتهاء
task_acks_late=True: العامل يؤكد بعد أن تنتهي المهمة، فإذا توقف في المنتصف بقيت الرسالة غير مؤكدة، ويعيدها الوسيط لعامل آخر، فتنفذ المهمة مرة ثانية من البداية. وهذا يسمى «مرة على الأقل» At-least-once، وهو ما تريده في أغلب الحالات، بشرط أن تكون المهمة آمنة عند تكرارها Idempotent.
ومع Redis كوسيط لا يوجد اتصال يلاحظ الوسيط انقطاعه كما في RabbitMQ، لذلك تعتمد Celery على مهلة الرؤية Visibility Timeout: الرسالة المأخوذة وغير المؤكدة تعود إلى الطابور إذا مضت عليها هذه المهلة، وقيمتها الافتراضية ساعة كما يذكر توثيق Celery مع Redis. وهذا يعني شيئين سوف نراهما في التجربة: المهمة التي توقف عاملها لا تعود قبل أن تمر المهلة، والمهمة التي تأخذ وقتاً أطول من المهلة تعاد إلى عامل آخر وهي ما زالت تعمل، فتنفذ مرتين في الوقت نفسه. لذلك اجعل المهلة أطول من أطول مهمة عندك بهامش واضح.
والمهمة الآمنة عند التكرار هي التي يكون تنفيذها مرتين مثل تنفيذها مرة، وقد شرحنا الطرق بالتفصيل في Idempotency. وفي المهام الخلفية أغلب الحالات تحل بأحد أمرين: إما أن تكون نتيجة المهمة ثابتة، مثل كتابة الملف المصغر نفسه في المسار نفسه، فالتكرار يكتب الشيء نفسه مرة ثانية، وإما أن تسجل أنك أنجزت العمل في قاعدة البيانات بقيد فريد، وتتحقق منه قبل أن تبدأ، كما يفعل جدول emails في التجربة. ويبقى في الحالة الثانية شباك صغير لا يغلق تماماً: إذا أرسل العامل البريد ثم توقف قبل أن يسجل ذلك، فسوف يرسله مرة ثانية عند الإعادة. وإذا كان التكرار مكلفاً، مثل خصم مبلغ، فاستخدم مفتاح منع التكرار Idempotency Key لدى الطرف الخارجي نفسه إذا كان يدعمه.
المهام المجدولة Scheduled Jobs
بعض المهام لا يطلقها مستخدم، وإنما الساعة: تقرير يومي، وتنظيف الملفات المؤقتة، وتجديد الاشتراكات، والمصالحة مع بوابة الدفع. وCelery فيها مكون اسمه Celery Beat، وهو عملية منفصلة تقرأ جدولاً وتضع المهمة في الطابور عندما يحين موعدها، والعمال ينفذونها كأي مهمة أخرى. وثلاثة أشياء يجب أن تنتبه لها:
- نسخة واحدة فقط من Beat: إذا شغلت Beat في كل سيرفر فسوف يرسل التقرير اليومي ثلاث مرات، وهذا خطأ شائع عند التوسع الأفقي، كما ذكرنا في مدخل إلى تصميم الأنظمة.
- التداخل: إذا كانت المهمة تعمل كل خمس دقائق وأخذت مرة سبع دقائق، فسوف تبدأ النسخة التالية قبل أن تنتهي الأولى، لذلك اجعلها آمنة عند التكرار، أو ضع قفلاً، أو احسب العمل من آخر نقطة انتهت إليها وليس من الوقت.
- المنطقة الزمنية: «كل يوم الساعة 2 فجراً» تعني توقيتاً مختلفاً حسب إعداد
timezone، وقد شرحنا مشكلات التوقيت في التاريخ والوقت للمطورين.
النشر دون أن تقطع المهام Graceful Shutdown
أكثر لحظة تقتل فيها المهام في الحياة الحقيقية ليست عطلاً في السيرفر، وإنما النشر العادي لإصدار جديد: يتوقف العامل القديم ويبدأ الجديد، وكل مهمة كانت تعمل في تلك اللحظة معرضة للقطع. وCelery تفرق بين نوعين من الإيقاف: الإيقاف المرتب Warm Shutdown عندما تصلها إشارة SIGTERM، كما يشرح توثيق العمال في Celery، فتتوقف عن أخذ مهام جديدة وتنتظر المهام الجارية حتى تنتهي ثم تخرج، والإيقاف الفوري Cold Shutdown عند SIGQUIT أو عند الإشارة الثانية، فتقطع كل شيء. والمشكلة أن Docker يرسل SIGTERM ثم ينتظر عشر ثوان فقط افتراضياً، ثم يرسل SIGKILL، وKubernetes ينتظر ثلاثين ثانية، فإذا كانت عندك مهام تأخذ دقيقتين فسوف تقطع في كل نشر مهما كان إيقاف Celery مرتباً.
والحل من ثلاثة أجزاء: اجعل مهلة الإيقاف في المنصة أطول من أطول مهمة، مثل stop_grace_period في Compose وterminationGracePeriodSeconds في Kubernetes، وفعل التأكيد عند الانتهاء حتى تعود المهمة التي قطعت رغم ذلك، واجعل المهام الطويلة جداً تحفظ تقدمها على مراحل، فالتصدير الذي يعالج مليون صف يستطيع أن يسجل آخر صف أنهاه كل عشرة آلاف صف، ويبدأ منه إذا أعيد، بدل أن يبدأ من الصفر. والاختبار الذي سوف تراه في التجربة، قتل العامل بإشارة SIGKILL في منتصف مهمة، هو أسوأ حالة ممكنة، وإذا تحملها نظامك فسوف يتحمل النشر العادي.
كيف تراقب الطابور؟ Monitoring
المهام الخلفية تفشل بصمت، فلا يوجد مستخدم ينتظر الرد ويشتكي، لذلك المراقبة هنا ليست رفاهية. والأرقام التي تحتاجها قليلة:
- طول الطابور: عدد الرسائل التي تنتظر، ومع Redis هو طول القائمة
LLEN celery. والطابور الذي يكبر باستمرار يعني أن معدل الوصول أعلى من معدل المعالجة. - عمر أقدم مهمة: أهم من الطول، لأن ألف مهمة تنتهي في ثانية أفضل من عشر مهام تنتظر منذ ساعة، وهو الرقم الذي يشعر به المستخدم.
- نسبة الفشل وعدد إعادات المحاولة: ارتفاعها المفاجئ يعني غالباً أن طرفاً خارجياً تعطل.
- العمال أحياء: عدد العمال المتصلين والمهام الجارية الآن، وCelery تعطيك ذلك بالأمر
celery inspect، وتعرضه أداة Flower في واجهة ويب.
وأرقام الطابور تدخل في نظام المراقبة نفسه الذي تستخدمه للسيرفرات، والتنبيه يكون على عمر أقدم مهمة وعلى نسبة الفشل، وقد شرحنا كيف تختار ما تنبه عليه في مفاهيم المراقبة Observability.
تجربة عملية Lab: خدمة صور مع FastAPI وCelery وRedis
في هذه التجربة نبني خدمة الصور من بداية المقال بنسختين في التطبيق نفسه: /v1/photos تعمل كل شيء داخل الطلب، و/v2/photos تحفظ الصورة وتضع مهمة في الطابور. والعمل في النسختين واحد: ثلاث نسخ مصغرة بصيغة WebP من صورة حجمها 4000 × 3000، ثم بريد. ولكي يكون البريد واقعياً نضع أمام خادم البريد التجريبي Mailpit وكيلاً اسمه Toxiproxy يضيف 300 مللي ثانية على كل رد، فيصبح إرسال الرسالة الواحدة قرابة ثانيتين، كما يحدث مع مزود بريد خارجي في يوم مزدحم. ثم نقيس، ونوقف خادم البريد، ونقتل العامل في منتصف مهمة. وكل الملفات في مجلد lab مع المقال.
ملفات التجربة
العمل نفسه في ملف work.py، وهو كود عادي لا يعرف شيئاً عن الطوابير:
# work.py: the two slow jobs of the photo service. The same code runs inside the request (v1) or in a worker (v2).
import os, smtplib, time
from email.message import EmailMessage
from PIL import Image

UPLOADS = "/data/uploads"
SIZES = {"large": 1600, "medium": 800, "thumb": 200}

def make_thumbnails(photo_id: int) -> list[str]:
    out = []
    with Image.open(f"{UPLOADS}/{photo_id}.jpg") as img:
        for name, width in SIZES.items():
            copy = img.copy()
            copy.thumbnail((width, width))                     # keeps the aspect ratio
            path = f"{UPLOADS}/{photo_id}-{name}.webp"
            copy.save(path, "WEBP", quality=80)
            out.append(path)
    return out

def send_email(to: str, subject: str, text: str) -> None:
    msg = EmailMessage()
    msg["From"], msg["To"], msg["Subject"] = "[email protected]", to, subject
    msg.set_content(text)
    with smtplib.SMTP(os.environ.get("SMTP_HOST", "mailpit"), 1025, timeout=10) as s:
        s.send_message(msg)
والتطبيق api.py بالنسختين، ولاحظ أن الفرق بينهما سطر واحد تقريباً: الأولى تستدعي الدالتين، والثانية تستدعي process_photo.delay التي تضع رسالة في Redis وتعود فوراً:
# api.py: the photo service. /v1 does the work inside the request, /v2 hands it to a worker.
import os, time
import psycopg
from fastapi import FastAPI, UploadFile
from celery.result import AsyncResult
import work, tasks

DB = os.environ["DATABASE_URL"]
app = FastAPI()

def save_upload(file: UploadFile) -> int:
    with psycopg.connect(DB, autocommit=True) as c:
        photo_id, = c.execute("INSERT INTO photos (status) VALUES ('uploaded') RETURNING id").fetchone()
    with open(f"{work.UPLOADS}/{photo_id}.jpg", "wb") as f:
        f.write(file.file.read())
    return photo_id

@app.post("/v1/photos", status_code=201)
def upload_v1(file: UploadFile):
    photo_id = save_upload(file)
    work.make_thumbnails(photo_id)                                 # the user waits for this
    work.send_email("[email protected]", f"Photo {photo_id} is ready", "Your thumbnails are ready.")
    with psycopg.connect(DB, autocommit=True) as c:
        c.execute("UPDATE photos SET status = 'ready' WHERE id = %s", (photo_id,))
    return {"id": photo_id, "status": "ready"}

@app.post("/v2/photos", status_code=202)
def upload_v2(file: UploadFile):
    photo_id = save_upload(file)
    job = tasks.process_photo.delay(photo_id)                     # a message in Redis, nothing more
    return {"id": photo_id, "status": "processing", "job": job.id}

@app.get("/jobs/{job_id}")
def job_status(job_id: str):
    r = AsyncResult(job_id, app=tasks.app)
    return {"job": job_id, "state": r.state, "result": r.result if r.ready() else None}
والمهام في tasks.py، ومعها إعدادات Celery التي يدور حولها هذا المقال: التأكيد عند الانتهاء، وإعادة المهمة إذا قتلت عمليتها، وأخذ مهمة واحدة في كل مرة، ومهلة الرؤية من متغير بيئة حتى نغيرها في التجربة، والمهمة اليومية التي نجعلها كل دقيقة في المختبر:
# tasks.py: the Celery app and its jobs. Broker and result backend: Redis.
import os, time
import psycopg
from celery import Celery
from celery.schedules import crontab
import work

DB = os.environ["DATABASE_URL"]
app = Celery("photos", broker="redis://redis:6379/0", backend="redis://redis:6379/1")
app.conf.update(
    task_acks_late=os.environ.get("ACKS_LATE", "1") == "1",     # ack after the job ends, not when it starts
    task_reject_on_worker_lost=True,                             # a killed worker process gives the job back
    worker_prefetch_multiplier=1,                                # take one job at a time per process
    broker_transport_options={"visibility_timeout": int(os.environ.get("VISIBILITY_TIMEOUT", "3600"))},
    result_expires=86400,
    beat_schedule={"daily-report": {"task": "tasks.daily_report", "schedule": crontab(minute="*")}},  # every minute for the lab
)

def db():
    return psycopg.connect(DB, autocommit=True)

@app.task
def process_photo(photo_id: int):
    t0 = time.monotonic()
    work.make_thumbnails(photo_id)
    with db() as c:
        c.execute("UPDATE photos SET status = 'ready' WHERE id = %s", (photo_id,))
    send_photo_email.delay(photo_id)
    return round(time.monotonic() - t0, 2)

@app.task(bind=True, autoretry_for=(OSError,), retry_backoff=2, retry_backoff_max=60, retry_jitter=True, max_retries=6)
def send_photo_email(self, photo_id: int):
    with db() as c:
        # idempotency: one email per photo, even if this job runs twice
        if c.execute("SELECT 1 FROM emails WHERE photo_id = %s", (photo_id,)).fetchone():
            return "already sent"
        print(f"photo {photo_id}: sending email, attempt {self.request.retries + 1}", flush=True)
        work.send_email("[email protected]", f"Photo {photo_id} is ready", "Your thumbnails are ready.")
        c.execute("INSERT INTO emails (photo_id) VALUES (%s)", (photo_id,))
    return "sent"

@app.task
def daily_report():
    with db() as c:
        n, = c.execute("SELECT count(*) FROM photos WHERE created_at > now() - interval '1 day'").fetchone()
    print(f"daily report: {n} photos in the last 24h", flush=True)
    return n

@app.task(bind=True)
def export_archive(self, seconds: int):
    """A long job: it writes a progress line every 5 seconds."""
    with db() as c:
        run_id, = c.execute("INSERT INTO runs (task_id, started_at) VALUES (%s, now()) RETURNING id",
                            (self.request.id,)).fetchone()
    for i in range(0, seconds, 5):
        print(f"export {self.request.id[:8]}: {i}s of {seconds}s", flush=True)
        time.sleep(5)
    with db() as c:
        c.execute("UPDATE runs SET finished_at = now() WHERE id = %s", (run_id,))
    return "done"
في الكود أعلاه لاحظ التالي:
send_photo_emailمنفصلة عنprocess_photo: فإذا فشل البريد أعيد البريد وحده، ولا تعاد معالجة الصورة التي نجحت.- إعادة المحاولة على
OSError: وتحتها أخطاء الشبكة وأخطاءsmtplibكلها، بتأخير أسي يبدأ بثانيتين ولا يتجاوز 60 ثانية، وست محاولات كحد أقصى. - التحقق من جدول
emailsقبل الإرسال: هذا ما يجعل المهمة آمنة عند تكرارها، والمفتاح الأساسيphoto_idيمنع صفين للصورة نفسها. export_archive: مهمة طويلة تسجل بدايتها ونهايتها في جدولrunsلكل تشغيل، حتى نرى في اختبار التوقف كم مرة بدأت وكم مرة انتهت.
وملف Compose يجمع سبع خدمات: قاعدة البيانات، وRedis وسيطاً ومخزناً للنتائج، وMailpit، وToxiproxy أمامه، والتطبيق بأربع عمليات uvicorn، والعامل، وBeat للمهام المجدولة، وFlower للمراقبة:
name: sw3-bg
x-app: &app
  image: sw3-bg-app:1
  environment:
    DATABASE_URL: postgresql://postgres:lab@db/postgres
    SMTP_HOST: slowmail
    ACKS_LATE: ${ACKS_LATE:-1}
    VISIBILITY_TIMEOUT: ${VISIBILITY_TIMEOUT:-3600}
  volumes: [ "uploads:/data/uploads" ]
  depends_on: { db: { condition: service_healthy }, redis: { condition: service_started } }
services:
  db:
    image: postgres:18-alpine
    environment: { POSTGRES_PASSWORD: lab }
    volumes: [ "./schema.sql:/docker-entrypoint-initdb.d/schema.sql:ro" ]
    healthcheck: { test: ["CMD", "pg_isready", "-U", "postgres"], interval: 2s, retries: 30 }
  redis:
    image: redis:8-alpine
  mailpit:
    image: axllent/mailpit:v1.31.5
  slowmail:                   # a TCP proxy in front of Mailpit that adds latency, like a slow external SMTP server
    image: ghcr.io/shopify/toxiproxy:2.13.0
    command: -host=0.0.0.0 -config=/toxiproxy.json
    volumes: [ "./toxiproxy.json:/toxiproxy.json:ro" ]
  api:
    <<: *app
    build: .
    command: uvicorn api:app --host 0.0.0.0 --port 8000 --workers 4
    ports: [ "127.0.0.1:9556:8000" ]
  worker:
    <<: *app
    command: celery -A tasks worker --loglevel=INFO --concurrency=${CONCURRENCY:-2}
  beat:
    <<: *app
    command: celery -A tasks beat --loglevel=INFO
  flower:
    <<: *app
    command: celery -A tasks flower --port=5555
    ports: [ "127.0.0.1:9557:5555" ]
volumes:
  uploads:
نبني ونشغل، ثم نضيف تأخير 300 مللي ثانية إلى خادم البريد، وننشئ صورة الاختبار بالسكربت make-photo.py:
docker compose up -d --build --wait
docker compose exec slowmail /toxiproxy-cli toxic add -t latency -a latency=300 smtp
docker run --rm -v "$PWD:/w" -w /w sw3-bg-app:1 python make-photo.py
طلب واحد: النسخة الأولى مقابل الثانية
نرفع الصورة ثلاث مرات لكل نسخة من Container فيه curl على الشبكة نفسها، ونطبع زمن الطلب:
docker run --rm --network sw3-bg_default -v "$PWD:/lab" curlimages/curl:8.23.0 sh -c \
  'for v in v1 v2 v1 v2 v1 v2; do curl -s -F file=@/lab/photo.jpg -w "  -> HTTP %{http_code} in %{time_total}s\n" http://api:8000/$v/photos; done'
والمخرج سوف يكون كما يلي:
{"id":505,"status":"ready"}  -> HTTP 201 in 3.635540s
{"id":506,"status":"processing","job":"eecee93a-1713-4993-9bcb-5beb060ce77d"}  -> HTTP 202 in 0.970509s
{"id":507,"status":"ready"}  -> HTTP 201 in 3.501393s
{"id":508,"status":"processing","job":"5acf1e5f-d3de-459c-b9c0-c469b1b33dbe"}  -> HTTP 202 in 0.438013s
{"id":509,"status":"ready"}  -> HTTP 201 in 3.835131s
{"id":510,"status":"processing","job":"46a1a9ae-4b84-4d16-9ed2-e659fc9d2001"}  -> HTTP 202 in 0.205892s
النسخة الأولى ترد بـ 201 وحالة ready بعد 3.5 إلى 3.8 ثانية، والنسخة الثانية ترد بـ 202 وحالة processing ومعرف المهمة بعد 0.2 إلى 0.97 ثانية. وسجل العامل يبين أين ذهب الوقت في الحالتين:
Task tasks.process_photo[eecee93a-…] succeeded in 1.2614914459991269s: 1.25
Task tasks.send_photo_email[1661db32-…] succeeded in 2.258318480999151s: 'sent'
أي أن النسخ المصغرة تأخذ قرابة 1.3 ثانية والبريد قرابة 2.2 ثانية، والمجموع هو ما كان المستخدم ينتظره في النسخة الأولى. ولاحظ أن النسخة الثانية ليست صفراً، فالجزء الباقي هو استقبال خمسة ميجابايت وقراءتها وكتابتها على القرص، وتتراوح بين 0.2 وثانية حسب ضغط السيرفر لحظتها. وإذا أردت أن تزيل هذا الجزء أيضاً فالخطوة التالية أن يرفع المتصفح الصورة مباشرة إلى تخزين الكائنات برابط موقع Presigned URL، كما شرحنا في S3 من داخل تطبيقك، فلا يمر الملف بالتطبيق أصلاً.
ثمانية مستخدمين معاً: k6 على النسختين
نشغل اختبار ضغط بأداة k6 فيه ثمانية مستخدمين يرفعون الصورة نفسها بلا توقف لمدة 30 ثانية، مرة على كل نسخة، وهذا ملف الاختبار:
// upload.js: 8 users upload the same 5 MB photo again and again for 30 seconds.
// k6 run -e V=v1 upload.js     (V=v1: work inside the request, V=v2: work in the worker)
import http from 'k6/http';
import { check } from 'k6';

const photo = open('/lab/photo.jpg', 'b');
export const options = {
  vus: 8, duration: '30s',
  summaryTrendStats: ['avg', 'med', 'p(95)', 'p(99)', 'max'],
};

export default function () {
  const r = http.post(`http://api:8000/${__ENV.V}/photos`, { file: http.file(photo, 'photo.jpg', 'image/jpeg') },
                      { timeout: '120s' });
  check(r, { 'accepted': (x) => x.status === 201 || x.status === 202 });
}
for v in v1 v2; do
docker run --rm --network sw3-bg_default -v "$PWD:/lab" grafana/k6:1.8.3 run -q -e V=$v /lab/upload.js
docker compose exec -T redis redis-cli LLEN celery
doneوالمخرج سوف يكون كما يلي، مختصراً إلى الأسطر المهمة:
== V=v1
    checks_succeeded...: 100.00% 30 out of 30
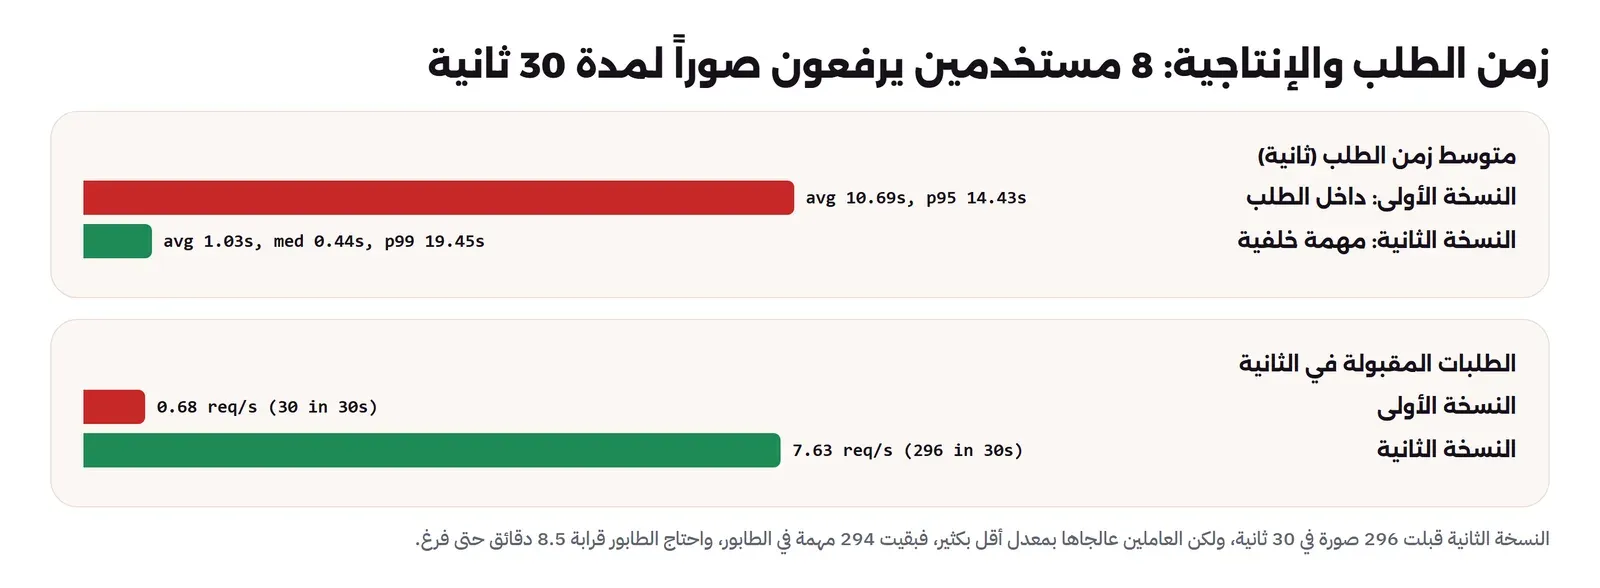
    http_req_duration..............: avg=10.69s med=10.69s p(95)=14.43s p(99)=14.43s max=14.43s
    http_reqs......................: 30     0.678843/s
jobs waiting in the queue after V=v1: 0
== V=v2
    checks_succeeded...: 100.00% 296 out of 296
    http_req_duration..............: avg=1.03s med=437.55ms p(95)=2.17s p(99)=19.45s max=19.88s
    http_reqs......................: 296    7.62687/s
jobs waiting in the queue after V=v2: 294
في المخرج أعلاه لاحظ التالي:
- النسخة الأولى صار متوسطها 10.69 ثانية: الطلب الذي كان 3.6 ثانية وحده أصبح ثلاثة أضعاف، لأن ثمانية طلبات تتنافس على أنوية المعالج نفسها لصناعة النسخ المصغرة، وعمال الويب الأربعة مشغولون بالكامل. وفي الواقع الـ Reverse Proxy عادة يقطع الطلب بعد 60 ثانية، فنحن قريبون من أول خطأ 504 مع بضعة مستخدمين إضافيين.
- النسخة الثانية قبلت عشرة أضعاف الطلبات: 296 مقابل 30، والوسيط 0.44 ثانية. ولكن p99 كان 19.45 ثانية، لأن العامل نفسه يعمل على السيرفر نفسه ويأخذ المعالج من عمليات الويب عندما يصنع النسخ المصغرة، وهذا سبب لوضع العمال على سيرفر آخر عندما يصبح العمل ثقيلاً.
- 294 مهمة تنتظر في الطابور: هذا هو السطر الأهم. النسخة الثانية لم تجعل العمل أسرع، وإنما نقلته من المستخدم إلى الطابور. والعاملان يعالجان أقل من صورة في الثانية، والتطبيق قبل 7.6 صورة في الثانية، فالطابور كبر طوال الاختبار.
الطابور يفرغ ببطء، والبريد ينتظر خلف الصور
بعد الاختبار نراقب الطابور بالسكربت queue-stats.sh، الذي يطبع كل ثانيتين طول القائمة في Redis وعدد الصور الجاهزة والرسائل المرسلة منذ بداية التجربة:
#!/bin/sh
# queue-stats.sh: every 2 seconds, the jobs waiting in the Redis list, and the photos and emails already done.
start=$(date +%s)
while true; do
  waiting=$(docker compose exec -T redis redis-cli LLEN celery | tr -d '\r')
  progress=$(docker compose exec -T db psql -U postgres -tAc \
    "SELECT count(*) FILTER (WHERE status = 'ready') || ' ready, ' || (SELECT count(*) FROM emails) || ' emails' FROM photos")
  echo "t=$(( $(date +%s) - start ))s waiting=$waiting  $progress"
  [ "$waiting" = "0" ] && [ -n "$STOP_WHEN_EMPTY" ] && break
  sleep 2
done
t=3s waiting=294 594 ready, 475 emails
t=11s waiting=293 603 ready, 476 emails
t=16s waiting=292 609 ready, 477 emails
t=20s waiting=292 617 ready, 477 emails
...
t=242s waiting=214 836 ready, 557 emails
t=424s waiting=64 836 ready, 708 emails
...
t=506s waiting=11 836 ready, 762 emails
t=509s waiting=8 836 ready, 766 emails
t=512s waiting=0 836 ready, 768 emailsاحتاج الطابور 512 ثانية، أي قرابة 8.5 دقائق، ليفرغ من 294 مهمة، وهذا هو الثمن الحقيقي لاختبار مدته 30 ثانية. ولكن انظر إلى السطر عند الثانية 242: كل الصور كانت جاهزة، 836 صورة، بينما الرسائل 557 فقط، والطابور ما زال فيه 214 مهمة كلها رسائل بريد. والسبب أن مهام البريد تدخل الطابور بعد أن تنتهي مهمة الصورة، فتقف في آخره خلف كل الصور التي وصلت قبلها، أي أن المستخدم الذي رفع صورته في أول ثانية من الاختبار وصله البريد بعد دقائق. وهذا هو الدرس الذي ذكرناه في قسم العمال: المهام القصيرة التي ينتظرها المستخدم يجب ألا تقف في طابور واحد مع المهام الطويلة. وفي Celery يكفي أن توجه كل مهمة إلى طابور باسمها بالإعداد task_routes، وتشغل لكل طابور عاملاً بالخيار -Q.
كم عملية في العامل؟ الصور مقابل البريد
نضع في الطابور دفعة من المهام دفعة واحدة، ونقيس متى تنتهي كلها، بعدد عمليات مختلف في كل مرة. والسكربت drain.py يفعل ذلك:
# drain.py: put N jobs in the queue at once, then time until all of them are done.
#   python drain.py 24          photo jobs (copies of photo 1): thumbnails, then an email for each
#   python drain.py 24 email    email jobs only
import shutil, sys, time
import psycopg
import tasks, work

n = int(sys.argv[1])
email_only = len(sys.argv) > 2 and sys.argv[2] == "email"
with psycopg.connect(tasks.DB, autocommit=True) as c:
    ids = []
    for _ in range(n):
        pid, = c.execute("INSERT INTO photos (status) VALUES (%s) RETURNING id",
                         ("ready" if email_only else "uploaded",)).fetchone()
        if not email_only:
            shutil.copy(f"{work.UPLOADS}/1.jpg", f"{work.UPLOADS}/{pid}.jpg")
        ids.append(pid)
    t0 = time.monotonic()
    for pid in ids:
        (tasks.send_photo_email if email_only else tasks.process_photo).delay(pid)
    while True:
        ready, = c.execute("SELECT count(*) FROM photos WHERE id = ANY(%s) AND status = 'ready'", (ids,)).fetchone()
        sent, = c.execute("SELECT count(*) FROM emails WHERE photo_id = ANY(%s)", (ids,)).fetchone()
        if ready == n and sent == n:
            break
        time.sleep(0.5)
    took = time.monotonic() - t0
    what = "emails" if email_only else "photos and emails"
    print(f"{n} {what} in {took:.1f}s = {n / took:.2f} jobs/s")
for c in 1 4 16; do
CONCURRENCY=$c docker compose up -d --wait worker
docker compose exec -T api python drain.py 32 email
doneوالمخرج لمهام البريد عبر الخادم البطيء:
== concurrency=1
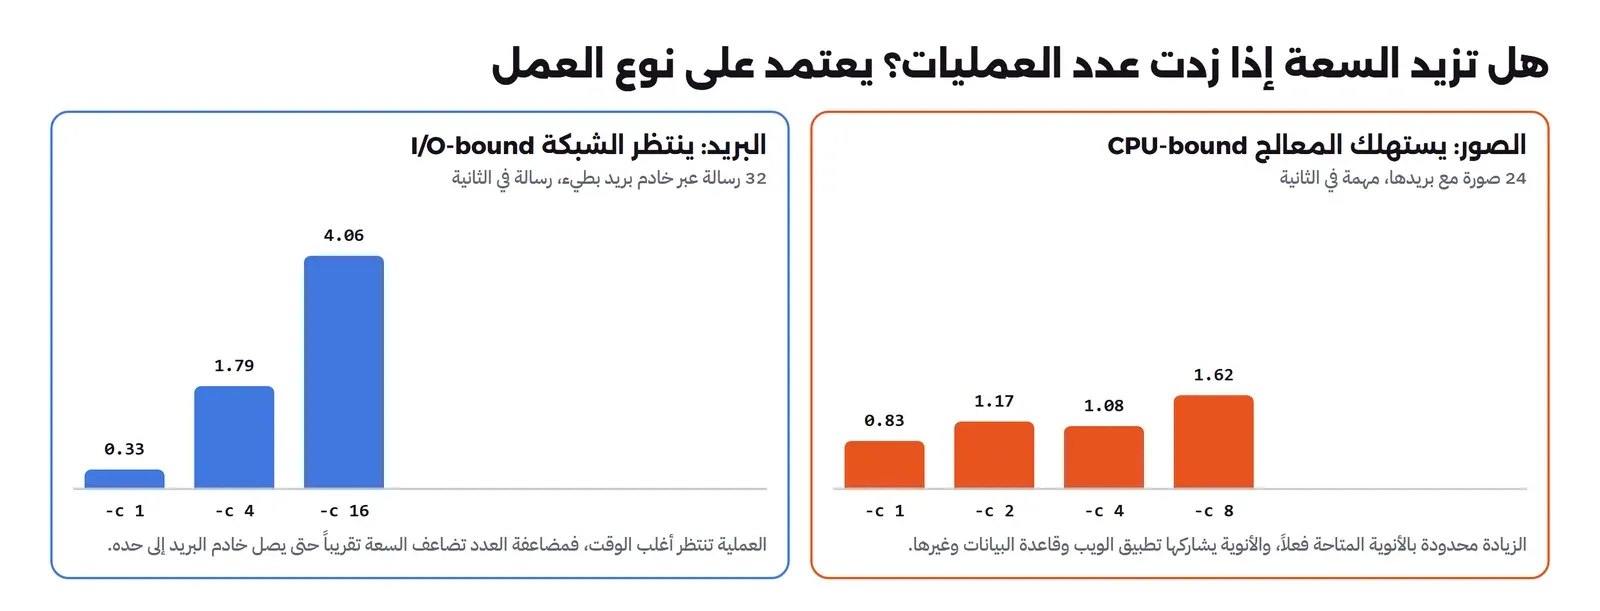
32 emails in 96.0s = 0.33 jobs/s
== concurrency=4
32 emails in 17.8s = 1.79 jobs/s
== concurrency=16
32 emails in 7.9s = 4.06 jobs/s
وأجرينا الشيء نفسه على مهام الصور، 24 صورة مع بريدها، قبل أن نضيف التأخير إلى خادم البريد، أي أن العمل هنا معالج في أغلبه:
== concurrency=1
24 photos and 24 emails in 28.8s = 0.83 photos/s
== concurrency=2
24 photos and 24 emails in 20.5s = 1.17 photos/s
== concurrency=4
24 photos and 24 emails in 22.2s = 1.08 photos/s
== concurrency=8
24 photos and 24 emails in 14.8s = 1.62 photos/s
الفرق واضح: البريد ينتظر الشبكة، فارتفعت السعة من 0.33 رسالة في الثانية بعملية واحدة إلى 4.06 بست عشرة عملية، أي أكثر من اثني عشر ضعفاً، وكان يمكن أن تستمر في الارتفاع حتى يصل خادم البريد إلى حده. أما الصور فتحتاج المعالج، فلم تتجاوز ضعفين تقريباً حتى بثماني عمليات على جهاز يرى فيه nproc ثمانية معالجات، أي أربع أنوية بخيطين لكل منها، والأنوية مشتركة مع التطبيق وقاعدة البيانات وكل ما يعمل على السيرفر نفسه، وقراءة 4 عمليات أقل قليلاً من 2 تذكرك بأن القياس على سيرفر مشترك له تذبذب يجب أن تعيده أكثر من مرة قبل أن تبني عليه قراراً. والقاعدة: لمهام الشبكة عمليات كثيرة أو خيوط Threads، ولمهام المعالج عدد العمليات بعدد الأنوية المتاحة فعلاً، وإذا لم يكف فسيرفر آخر للعمال.
خادم البريد متوقف: إعادة المحاولة
نوقف Mailpit، ونضع مهمة بريد واحدة، ثم نعيد تشغيله بعد قرابة 40 ثانية، ونقرأ سجل العامل لهذه المهمة:
docker compose stop mailpit
docker compose exec -T api python one-email.py
sleep 40; docker compose start mailpit
docker compose logs --no-log-prefix worker | grep -E 'ab9de04c|photo 933'
12:02:40] INFO/MainProcess] Task tasks.send_photo_email[ab9de04c-1ec7-4962-a917-5b32f7741a5d] received
12:02:41] WARNING/ForkPoolWorker-2] photo 933: sending email, attempt 1
12:02:49] INFO/MainProcess] Task tasks.send_photo_email[ab9de04c-1ec7-4962-a917-5b32f7741a5d] received
12:02:49] INFO/ForkPoolWorker-2] Task tasks.send_photo_email[ab9de04c-1ec7-4962-a917-5b32f7741a5d] retry: Retry in 0s: SMTPServerDisconnected('Connection unexpectedly closed')
12:02:49] WARNING/ForkPoolWorker-1] photo 933: sending email, attempt 2
12:02:53] INFO/MainProcess] Task tasks.send_photo_email[ab9de04c-1ec7-4962-a917-5b32f7741a5d] received
12:02:53] INFO/ForkPoolWorker-1] Task tasks.send_photo_email[ab9de04c-1ec7-4962-a917-5b32f7741a5d] retry: Retry in 3s: SMTPServerDisconnected('Connection unexpectedly closed')
12:02:56] WARNING/ForkPoolWorker-2] photo 933: sending email, attempt 3
12:03:04] INFO/ForkPoolWorker-2] Task tasks.send_photo_email[ab9de04c-1ec7-4962-a917-5b32f7741a5d] retry: Retry in 8s: SMTPServerDisconnected('Connection unexpectedly closed')
12:03:04] INFO/MainProcess] Task tasks.send_photo_email[ab9de04c-1ec7-4962-a917-5b32f7741a5d] received
12:03:12] WARNING/ForkPoolWorker-2] photo 933: sending email, attempt 4
12:03:20] INFO/MainProcess] Task tasks.send_photo_email[ab9de04c-1ec7-4962-a917-5b32f7741a5d] received
12:03:20] INFO/ForkPoolWorker-2] Task tasks.send_photo_email[ab9de04c-1ec7-4962-a917-5b32f7741a5d] retry: Retry in 8s: SMTPServerDisconnected('Connection unexpectedly closed')
12:03:28] WARNING/ForkPoolWorker-2] photo 933: sending email, attempt 5
12:03:36] INFO/MainProcess] Task tasks.send_photo_email[ab9de04c-1ec7-4962-a917-5b32f7741a5d] received
12:03:36] INFO/ForkPoolWorker-2] Task tasks.send_photo_email[ab9de04c-1ec7-4962-a917-5b32f7741a5d] retry: Retry in 31s: SMTPServerDisconnected('Connection unexpectedly closed')
12:04:07] WARNING/ForkPoolWorker-2] photo 933: sending email, attempt 6
12:04:14] INFO/MainProcess] Task tasks.send_photo_email[ab9de04c-1ec7-4962-a917-5b32f7741a5d] received
12:04:14] INFO/ForkPoolWorker-2] Task tasks.send_photo_email[ab9de04c-1ec7-4962-a917-5b32f7741a5d] retry: Retry in 13s: SMTPServerDisconnected('Connection unexpectedly closed')
12:04:27] WARNING/ForkPoolWorker-2] photo 933: sending email, attempt 7
12:04:30] INFO/ForkPoolWorker-2] Task tasks.send_photo_email[ab9de04c-1ec7-4962-a917-5b32f7741a5d] succeeded in 2.1780705529999977s: 'sent'في المخرج أعلاه لاحظ التالي:
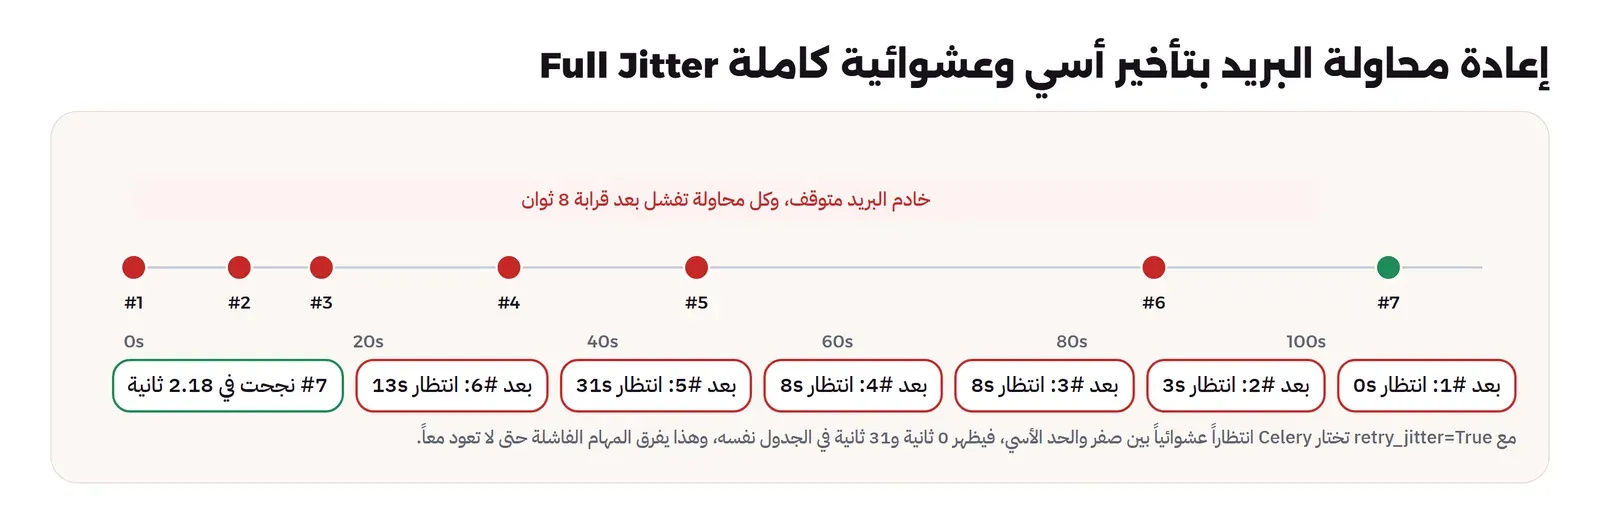
- كل محاولة فاشلة أخذت قرابة 8 ثوان: لأن Toxiproxy قبل الاتصال ثم حاول أن يصل إلى Mailpit فلم يجد اسمه في DNS، فأغلق الاتصال، وظهر الخطأ عند العامل
SMTPServerDisconnected. ولو لم نضع مهلةtimeout=10فيsmtplib.SMTPلكان العامل قد علق مدة أطول بكثير، والقاعدة أن كل اتصال خارجي في مهمة خلفية يجب أن تكون له مهلة. - الانتظار بين المحاولات: 0 ثم 3 ثم 8 ثم 8 ثم 31 ثم 13 ثانية: وهذا لا يبدو أسياً، والسبب أن
retry_jitter=Trueفي Celery يختار رقماً عشوائياً بين صفر والحد الأسي، فالحدود كانت 2 و4 و8 و16 و32 و60 ثانية، والمختار من كل منها عشوائي، وهذا ما يسمى العشوائية الكاملة Full Jitter. وفائدته أن ألف رسالة فشلت في اللحظة نفسها لن تعود في اللحظة نفسها. - Mailpit عاد فعلاً عند 12:04:21: وليس بعد 40 ثانية كما أردنا، لأن الأمر
docker compose startنفسه تأخر على سيرفر مضغوط، لذلك فشلت المحاولتان الخامسة والسادسة أيضاً، ونجحت السابعة بعد 6 ثوان من عودته. - لم يعرف المستخدم شيئاً: الصورة كانت جاهزة، والبريد وصل بعد دقيقتين، ولو كانت ست محاولات غير كافية لانتهت المهمة بحالة
FAILURE، وهنا يأتي دور طابور الرسائل الميتة والتنبيه.
نقتل العامل في منتصف مهمة
هذا الاختبار هو أهم ما في التجربة، لأنه ما يحدث فعلاً عند كل نشر لإصدار جديد أو عند نفاد ذاكرة السيرفر. السكربت crash-test.sh يبدأ مهمة مدتها 40 ثانية، ثم يقتل حاوية العامل بعد 12 ثانية بإشارة SIGKILL، فلا يحصل العامل على فرصة للإغلاق المرتب Warm Shutdown، ثم يعيد تشغيله وينتظر، ثم يعرض جدول التشغيلات:
#!/bin/sh
# crash-test.sh: start a 40-second job, kill the worker container after ~12 seconds, start it again,
# then look at the runs table: did the job run again, and did it finish?
docker compose exec -T db psql -U postgres -qc "TRUNCATE runs"
docker compose exec -T api python -c "import tasks; print('job', tasks.export_archive.delay(40).id)"
sleep 12
docker compose kill worker            # SIGKILL: no warm shutdown, the job is cut in the middle
docker compose start worker
sleep ${WAIT:-75}
docker compose exec -T db psql -U postgres -c \
  "SELECT left(task_id, 8) AS task, to_char(started_at, 'HH24:MI:SS') AS started, to_char(finished_at, 'HH24:MI:SS') AS finished FROM runs ORDER BY started_at"
المرة الأولى مع الإعداد الافتراضي في Celery، أي التأكيد عند البدء، ومهلة رؤية 30 ثانية:
ACKS_LATE=0 VISIBILITY_TIMEOUT=30 docker compose up -d --wait worker
sh crash-test.sh
### acks early (ACKS_LATE=0)
job 055ee909-f0ac-4469-9dca-00471168f128
task | started | finished
----------+----------+----------
055ee909 | 12:07:04 |
(1 row)المهمة بدأت ولم تنته، ولم تعد أبداً. فالعامل أكد الرسالة لحظة أخذها، فحذفها Redis، وعندما قتل العامل لم يبق في أي مكان ما يدل على أن هناك تصديراً لم يكتمل. ولو كانت هذه المهمة «أرسل الفاتورة الشهرية» فلن يعرف أحد أنها لم ترسل إلا عندما يسأل العميل.
والمرة الثانية مع التأكيد عند الانتهاء:
ACKS_LATE=1 VISIBILITY_TIMEOUT=30 docker compose up -d --wait worker
WAIT=150 sh crash-test.sh
### acks late (ACKS_LATE=1), visibility timeout 30s
job 28ee47c1-935b-4a10-a42e-0f2457269146
task | started | finished
----------+----------+----------
28ee47c1 | 12:13:39 |
28ee47c1 | 12:14:40 | 12:15:20
(2 rows)وسجل العامل يبين ما حدث:
12:13:49] WARNING/ForkPoolWorker-2] export 28ee47c1: 10s of 40s
12:13:54] WARNING/ForkPoolWorker-2] export 28ee47c1: 15s of 40s
  . tasks.export_archive
12:14:40] INFO/MainProcess] celery@460cc8473c2a ready.
12:14:40] INFO/MainProcess] Task tasks.export_archive[28ee47c1-935b-4a10-a42e-0f2457269146] received
12:14:40] WARNING/ForkPoolWorker-2] export 28ee47c1: 0s of 40s
12:14:45] WARNING/ForkPoolWorker-2] export 28ee47c1: 5s of 40s
12:14:50] WARNING/ForkPoolWorker-2] export 28ee47c1: 10s of 40s
12:14:55] WARNING/ForkPoolWorker-2] export 28ee47c1: 15s of 40s
12:15:00] WARNING/ForkPoolWorker-2] export 28ee47c1: 20s of 40s
12:15:05] WARNING/ForkPoolWorker-2] export 28ee47c1: 25s of 40s
12:15:10] WARNING/ForkPoolWorker-2] export 28ee47c1: 30s of 40s
12:15:15] WARNING/ForkPoolWorker-2] export 28ee47c1: 35s of 40s
12:15:20] INFO/ForkPoolWorker-2] Task tasks.export_archive[28ee47c1-935b-4a10-a42e-0f2457269146] succeeded in 40.42769989499902s: 'done'
التشغيل الأول قتل عند الثانية 15، والرسالة بقيت في Redis غير مؤكدة، وعندما بدأ العامل الجديد عند 12:14:40 كانت قد مضت على الرسالة أكثر من 30 ثانية، فأعادها إلى الطابور وأخذها ونفذها من البداية حتى انتهت. والجدول يبين الحقيقة التي يجب أن تبني عليها: المهمة بدأت مرتين، والجزء الذي نفذ في التشغيل الأول قبل التوقف قد يكون كتب أشياء، لذلك يجب أن تتحمل المهمة أن تبدأ من جديد فوق عمل ناقص.
ماذا لو كانت المهمة أطول من مهلة الرؤية؟ What If
نبقي التأكيد عند الانتهاء ومهلة الرؤية 30 ثانية، ونشغل مهمة مدتها 60 ثانية دون أن نقتل شيئاً، ثم نضيف عاملاً ثانياً بعد 40 ثانية، كما يحدث عندما يتوسع النظام تلقائياً أو ينشر إصدار جديد:
docker compose exec -T api python -c "import tasks; print('job', tasks.export_archive.delay(60).id)"
sleep 40
docker compose up -d --no-recreate --scale worker=2
job 75f97659-fd41-4cb7-b06e-3882b3b2d8fe
1
task | started | finished
----------+----------+----------
75f97659 | 12:20:09 | 12:21:09
75f97659 | 12:21:09 | 12:22:10
(2 rows)worker-2 | 12:21:18] INFO/MainProcess] celery@8645ab508282 ready.
worker-1 | 12:20:09] INFO/MainProcess] Task tasks.export_archive[75f97659-fd41-4cb7-b06e-3882b3b2d8fe] received
worker-1 | 12:20:09] WARNING/ForkPoolWorker-2] export 75f97659: 0s of 60s
worker-1 | 12:20:19] WARNING/ForkPoolWorker-2] export 75f97659: 10s of 60s
worker-1 | 12:20:29] WARNING/ForkPoolWorker-2] export 75f97659: 20s of 60s
worker-1 | 12:20:39] WARNING/ForkPoolWorker-2] export 75f97659: 30s of 60s
worker-1 | 12:20:49] WARNING/ForkPoolWorker-2] export 75f97659: 40s of 60s
worker-1 | 12:20:59] WARNING/ForkPoolWorker-2] export 75f97659: 50s of 60s
worker-1 | 12:21:09] INFO/MainProcess] Task tasks.export_archive[75f97659-fd41-4cb7-b06e-3882b3b2d8fe] received
worker-1 | 12:21:09] WARNING/ForkPoolWorker-1] export 75f97659: 0s of 60s
worker-1 | 12:21:10] INFO/ForkPoolWorker-2] Task tasks.export_archive[75f97659-fd41-4cb7-b06e-3882b3b2d8fe] succeeded in 60.81792145300096s: 'done'
worker-1 | 12:21:20] WARNING/ForkPoolWorker-1] export 75f97659: 10s of 60s
worker-1 | 12:21:30] WARNING/ForkPoolWorker-1] export 75f97659: 20s of 60s
worker-1 | 12:21:40] WARNING/ForkPoolWorker-1] export 75f97659: 30s of 60s
worker-1 | 12:21:50] WARNING/ForkPoolWorker-1] export 75f97659: 40s of 60s
worker-1 | 12:22:00] WARNING/ForkPoolWorker-1] export 75f97659: 50s of 60s
worker-1 | 12:22:10] INFO/ForkPoolWorker-1] Task tasks.export_archive[75f97659-fd41-4cb7-b06e-3882b3b2d8fe] succeeded in 60.96040907000133s: 'done'لم يتوقف أي عامل، ومع ذلك نفذت المهمة مرتين، والثانية بدأت والأولى ما زالت تعمل. والسبب أن العامل الجديد عندما اتصل بـ Redis أعاد إلى الطابور كل رسالة غير مؤكدة مضى عليها أكثر من مهلة الرؤية، ورسالتنا كانت قد مضى عليها 60 ثانية وهي ما زالت تعمل، فأخذتها عملية فارغة في العامل الأول نفسه. وهذا بالضبط ما يحذر منه توثيق Celery مع Redis: إذا لم تؤكد المهمة خلال مهلة الرؤية فسوف تعاد إلى عامل آخر وتنفذ. لذلك اجعل مهلة الرؤية أطول بوضوح من أطول مهمة عندك، ومن أطول تأخير تؤجل إليه مهمة بخيار countdown أو eta، أو قسم المهام الطويلة إلى مهام أقصر، أو استخدم وسيطاً مثل RabbitMQ يعرف أن المستهلك ما زال متصلاً.
المهمة المجدولة
عملية Beat ترسل المهمة اليومية كل دقيقة في إعداد المختبر، والعامل ينفذها:
docker compose logs --no-log-prefix beat worker | grep -E 'Sending due|daily report'12:24:00] INFO/MainProcess] Scheduler: Sending due task daily-report (tasks.daily_report)
12:25:00] INFO/MainProcess] Scheduler: Sending due task daily-report (tasks.daily_report)
12:25:00] WARNING/ForkPoolWorker-2] daily report: 939 photos in the last 24h
12:25:00] INFO/ForkPoolWorker-2] Task tasks.daily_report[f3b016ae-39c4-4ba0-9ea8-054835d3b5fa] succeeded in 0.024334297000677907s: 939وBeat هنا مجرد منتج آخر يضع رسائل في الطابور نفسه، لذلك المهمة المجدولة تحصل على كل ما تحصل عليه المهام الأخرى من إعادة المحاولة والمراقبة، وفي الوقت نفسه تتأخر إذا كان الطابور مزدحماً، فالتقرير المجدول عند منتصف الليل سوف ينتظر خلف 300 صورة إذا وصلت في الدقيقة نفسها.
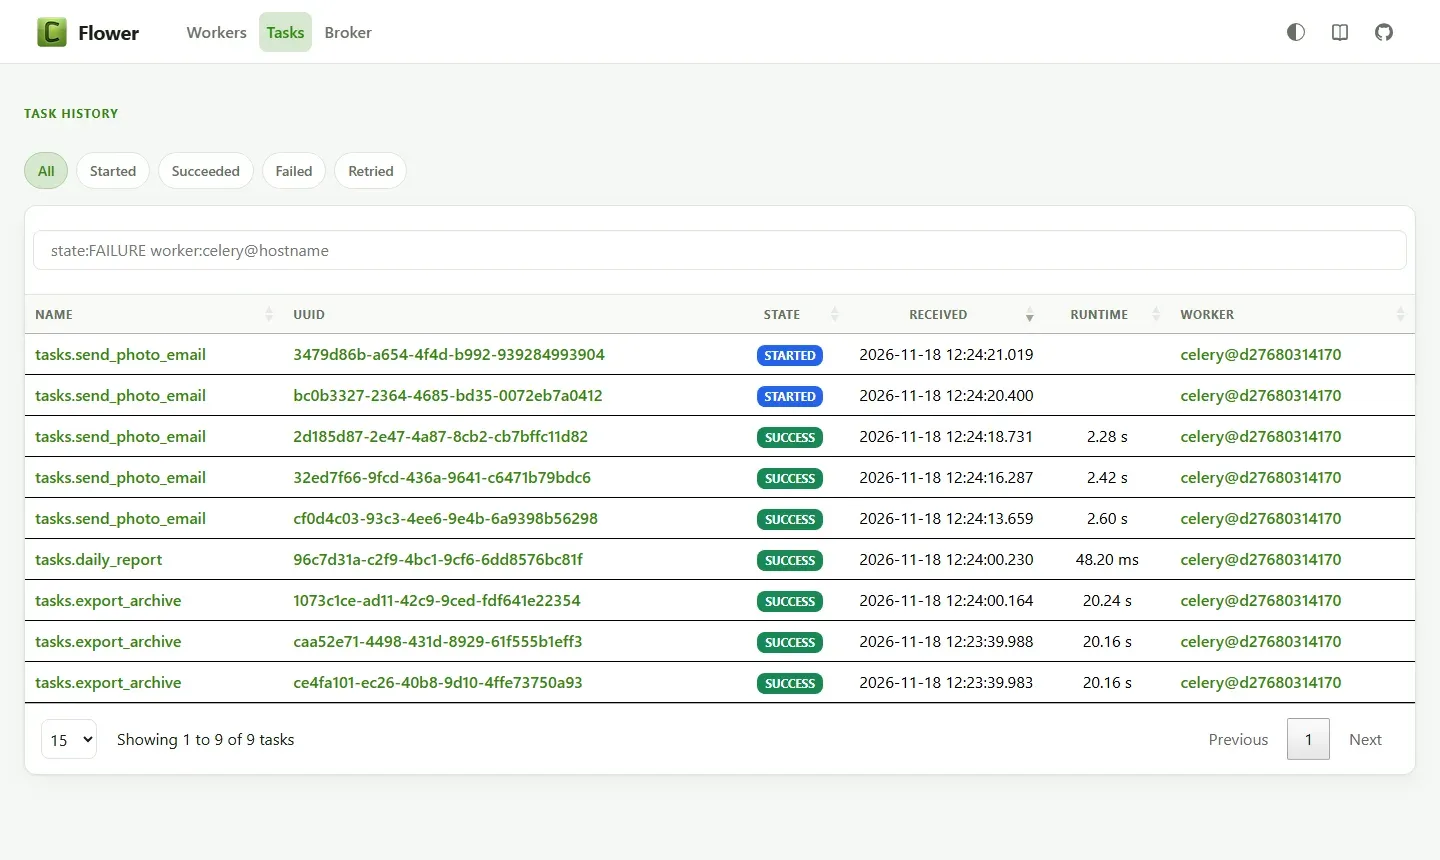
مراقبة الطابور: inspect وFlower
نضع ثلاث مهام تصدير ونسأل العامل عما ينفذه الآن، ونسأل Redis عن طول الطابور:
docker compose exec -T worker celery -A tasks inspect active
docker compose exec -T redis redis-cli LLEN celery
-> celery@d27680314170: OK
* {'id': 'ce4fa101-ec26-40b8-9d10-4ffe73750a93', 'name': 'tasks.export_archive', 'args': [20], 'kwargs': {}, 'type': 'tasks.export_archive', 'host …
* {'id': 'caa52e71-4498-431d-8929-61f555b1eff3', 'name': 'tasks.export_archive', 'args': [20], 'kwargs': {}, 'type': 'tasks.export_archive', 'host …
1 node online.
1العامل بعمليتين ينفذ مهمتين، والثالثة تنتظر في القائمة، ولهذا LLEN تعيد 1. وأداة Flower تعرض المعلومات نفسها في واجهة ويب، مع تاريخ كل مهمة وحالتها وزمنها والعامل الذي نفذها، وهي مفيدة للتحقيق في مهمة بعينها، أما التنبيه فمكانه نظام المراقبة الذي تستخدمه لبقية الخدمات:
النتائج في جدول
| القياس | النتيجة |
|---|---|
| طلب واحد: داخل الطلب | 3.5 إلى 3.8 ثانية، رد 201 |
| طلب واحد: مهمة خلفية | 0.2 إلى 0.97 ثانية، رد 202 |
| 8 مستخدمين 30 ثانية: داخل الطلب | 30 طلباً، متوسط 10.69 ثانية |
| 8 مستخدمين 30 ثانية: مهمة خلفية | 296 طلباً، وسيط 0.44 ثانية، و294 مهمة في الطابور فرغت بعد 512 ثانية |
| البريد عبر خادم بطيء | 0.33 ثم 1.79 ثم 4.06 رسالة في الثانية بعملية ثم 4 ثم 16 |
| الصور | من 0.83 إلى 1.62 صورة في الثانية بعملية ثم 8 |
| خادم البريد متوقف | 6 محاولات فاشلة بعشوائية كاملة، ونجحت السابعة |
| قتل العامل مع التأكيد عند البدء | ضاعت المهمة |
| قتل العامل مع التأكيد عند الانتهاء | أعيدت ونفذت من البداية وانتهت |
| مهمة 60 ثانية ومهلة رؤية 30 ثانية | نفذت مرتين دون أي عطل |
حذف التجربة Cleanup
docker compose down -v
docker rmi sw3-bg-app:1
أخطاء شائعة Common Mistakes
- وضع الملف أو الكائن كاملاً في رسالة المهمة: ضع المعرف فقط، والعامل يقرأ أحدث حالة من قاعدة البيانات أو التخزين، فالرسالة الكبيرة تبطئ الوسيط، والحالة داخلها قد تكون قديمة عندما تنفذ.
- وضع المهمة قبل نجاح المعاملة: العامل قد يبدأ قبل أن يرى الصف، أو تفشل المعاملة وتبقى المهمة، فضعها بعد الـ Commit أو استخدم Outbox أو طابوراً في قاعدة البيانات نفسها.
- الإبقاء على التأكيد عند البدء دون قرار واع: كل مهمة يقطعها نشر أو نفاد ذاكرة سوف تضيع بصمت.
- مهام غير آمنة عند التكرار: مع التأكيد عند الانتهاء ومهلة الرؤية سوف تنفذ بعض المهام مرتين، وهذا ليس احتمالاً نظرياً كما رأيت.
- مهلة رؤية أقصر من أطول مهمة أو أطول تأجيل: المهمة تعاد وهي تعمل.
- بلا مهلة على الاتصالات الخارجية: عامل واحد عالق على خادم لا يرد يأخذ عملية من العمليات إلى الأبد.
- إعادة المحاولة على الأخطاء الدائمة: الصورة التالفة لن تفتح في المحاولة العاشرة، وإنما تأخذ وقت العمال.
- طابور واحد لكل شيء: البريد ينتظر خلف مئات الصور، والتقرير المجدول خلف الجميع.
- أكثر من نسخة من Beat: كل مهمة مجدولة تنفذ بعدد النسخ.
- مراقبة العمال دون الطابور: العامل حي ويعمل، والطابور يكبر منذ ساعة، والمقياس الذي يكشف ذلك هو عمر أقدم مهمة.
قائمة تحقق Checklist
- كل عمل يعتمد على طرف خارجي أو يستهلك المعالج أو يحتاج إعادة محاولة خرج من الطلب.
- الطلب يرد بـ 202 مع معرف، والواجهة تعرض الحالة وتخبر المستخدم إذا فشلت المهمة.
- رسالة المهمة تحمل معرفات فقط، وتوضع بعد نجاح المعاملة أو عبر Outbox.
- التأكيد عند الانتهاء، وكل مهمة آمنة عند تكرارها بقيد فريد أو بنتيجة ثابتة.
- مهلة الرؤية أطول بوضوح من أطول مهمة وأطول تأجيل.
- كل اتصال خارجي له مهلة، وكل مهمة لها حد زمني.
- إعادة المحاولة للأخطاء المؤقتة فقط، بتأخير أسي وعشوائية وحد أقصى، والفاشل نهائياً يذهب إلى مكان يراجع فيه.
- طوابير منفصلة للمهام القصيرة التي ينتظرها المستخدم وللمهام الطويلة.
- عدد العمليات حسب نوع العمل: كثير للشبكة، وبعدد الأنوية المتاحة للمعالج.
- نسخة واحدة من Beat، ومهام مجدولة تتحمل التداخل.
- تنبيه على عمر أقدم مهمة ونسبة الفشل، وليس على حياة العامل فقط.
ماذا تقرأ بعد ذلك؟ Next Steps
هذا المقال هو بداية مرحلة الطوابير، والمقالات التالية تأخذ الوسيط نفسه إلى العمق: مفاهيم الطوابير، ثم الفرق بين الطابور وبث الأحداث، ثم RabbitMQ وRedis، ثم إعادة المحاولة وطابور الرسائل الميتة والرسالة المسمومة Poison Message بالتفصيل:
 دليلالطابور Queue للمبتدئين: لماذا تحتاجه وكيف يعمللماذا تضع العمل البطيء في طابور بدل أن ينتظره المستخدم، وكيف تضمن ألا تضيع الرسالة إذا توقف ال Worker فجأة.
 دليلطوابير المهام فوق Redis وValkey: متى تضيع المهمة؟كيف تبني طابور مهام فوق Redis أو Valkey بالقوائم والتدفقات، وأين تضيع المهام عند توقف العامل أو امتلاء الذاكرة.
 دليلRabbitMQ: طوابير موثوقة لتطبيقاتك على سيرفرككيف تشغل RabbitMQ في عنقود من ثلاث عقد، وتوجه الرسائل بالموزعات، وتضمن ألا تضيع رسالة إذا سقطت عقدة.
 دليلإعادة المحاولة Retry وDead Letter Queue وPoison Messageكيف تكتب سياسة إعادة محاولة في الطابور لا تملأ ال Dead Letter Queue برسائل سليمة ولا تغرق خدمة متعبة، بسبع سياسات شغلناها على RabbitMQ وSQS أمام نفس العطل.
 دليلWebhooks: كيف ترسل الأحداث بين الأنظمة وتستقبلها بأمانكيف تستقبل رسائل الـ Webhook وترسلها دون أن تخدعك رسالة مزورة أو مكررة أو قديمة، مع تجربة تعيد كل عطل من التوقيع الخاطئ إلى ثلاثة إيصالات لدفعة واحدة.
 دليلزمن الاستجابة Latency والإنتاجية Throughput بالأرقامالأرقام التي يحتاجها كل تصميم من الذاكرة إلى القارات، مقاسة على جهاز واحد، مع الذيل Tail Latency وقانون Little واختبار k6 يبين أين تنهار الخدمة.
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الطلب يحتوي فقط ما يحتاجه الرد، وكل ما يعتمد على طرف خارجي أو يستهلك المعالج أو يحتاج إعادة محاولة يخرج إلى مهمة خلفية.
- في التجربة نزل الطلب من 3.6 ثانية إلى أقل من ثانية، وقبل التطبيق عشرة أضعاف الطلبات تحت الضغط، ولكن الطابور كبر إلى 294 مهمة واحتاج 8.5 دقائق ليفرغ: الطابور يؤجل العمل ولا يلغيه.
- المهام القصيرة لا تقف خلف المهام الطويلة، فالبريد انتظر خلف كل الصور.
- مهام الشبكة تتوسع بزيادة العمليات، فالبريد ارتفع اثني عشر ضعفاً، ومهام المعالج محدودة بالأنوية المتاحة.
- التأكيد عند البدء أضاع مهمة قتل عاملها، والتأكيد عند الانتهاء أعادها، ومهلة رؤية أقصر من المهمة نفذتها مرتين دون أي عطل، لذلك كل مهمة يجب أن تكون آمنة عند تكرارها.
- راقب عمر أقدم مهمة ونسبة الفشل، فالمهام الخلفية تفشل بصمت.
سجل التحديثات Changelog
- 18 نوفمبر 2026: كتابة المقال، وتنفيذ التجربة على Docker Engine 29.8.0 مع Python 3.13.18 وCelery 5.7.0 وkombu 5.7.0 وredis-py 8.1.0 وRedis 8.10.3 وFastAPI 0.163.2 وuvicorn 0.54.0 وPillow 13.0.0 وFlower 2.2.0 وPostgreSQL 18.6 وMailpit 1.31.5 وToxiproxy 2.13.0 وk6 1.8.3.