مربع البحث في تطبيقك بدأ بسطر واحد: WHERE body LIKE '%' || :q || '%'، وكان يعمل جيداً مع ألف مقال. ثم أصبح عندك ثلاثمئة ألف، فصار البحث عن كلمة واحدة يأخذ خمس ثوان، وصار المستخدم يكتب «البيانات» فلا يجد المقال الذي فيه «بيانات»، ويكتب «مستشفى» فلا يجد «المستشفيات»، ويخطئ في حرف واحد فلا يجد شيئاً. وأول نصيحة يسمعها أغلب المطورين في هذه اللحظة أن ينقلوا البحث إلى Elasticsearch أو OpenSearch، أي سيرفر جديد، ومزامنة بين قاعدة البيانات والمحرك، وفريق يراقب الاثنين. والسؤال الذي يستحق أن تسأله قبل ذلك: هل يكفيك البحث النصي Full-Text Search الموجود داخل PostgreSQL نفسه، وأين تنتهي حدوده بالضبط مع النص العربي؟
وقد شرحنا كيف يعمل البحث عموماً بالفهرس المعكوس Inverted Index والترتيب في مقال أساسيات البحث، ومشكلات النص العربي من الهمزات إلى الجموع في مقال البحث في النصوص العربية، وعرضنا البحث النصي في PostgreSQL مع دالة توحيد للحروف في فقرة من مقال PostgreSQL لكل شيء، وقارناه بثلاثة محركات على مئة ألف مستند في مقارنة محركات البحث. وهذا المقال هو الدليل الكامل للأداة نفسها: كيف يحول PostgreSQL النص العربي إلى كلمات قابلة للبحث، وما الذي يفعله الإعداد العربي المدمج بالكلمات فعلاً، وكيف تبني الفهرس والترتيب وتمييز الكلمات Highlighting، وكيف تتعامل مع الأخطاء الإملائية، وكل ذلك مقاس على 348 ألف مقال حقيقي من ويكيبيديا العربية، حتى تعرف من الأرقام متى يكفيك ومتى تنتقل.
وسوف نناقش في هذا المقال ما يلي:
- كيف يعمل البحث النصي في PostgreSQL من الداخل: المحلل Parser والقواميس Dictionaries والإعداد Configuration، ثم
tsvectorوtsquery. - ماذا يفعل الإعداد
arabicبالكلمات العربية فعلاً، ولماذا لا تجد «بيانات» نفس ما تجده «البيانات». - تجربة عملية على 348,343 مقالاً من ويكيبيديا العربية: من LIKE في خمس ثوان إلى فهرس GIN في أقل من مللي ثانية.
- جذع خفيف Light Stemmer تكتبه بلغة SQL، وكم مقالاً يجد كل شكل من الكلمة قبله وبعده، وأخطاؤه هو أيضاً.
- الترتيب Ranking والتمييز ts_headline: أين يذهب الوقت فعلاً، ولماذا تأخذ كلمة شائعة ثلاث ثوان.
- الأخطاء الإملائية والبحث داخل الكلمة مع pg_trgm.
- خطأ شائع يجعل الفهرس لا يستخدم أبداً، وجدول قرار: متى يكفيك PostgreSQL، ومتى تحتاج محركاً منفصلاً.
لماذا لا يكفي LIKE؟
الجملة LIKE '%كلمة%' تطابق حروفاً وليس كلمات، وهذا يسبب ثلاث مشكلات لا تحلها أي سرعة. الأولى أن الفهرس العادي B-tree لا يساعدها، لأنه مرتب من أول النص، والنمط يبدأ بعلامة %، فتقرأ قاعدة البيانات كل صف في الجدول. والثانية أن المطابقة حرفية، فلا تعرف أن «المكتبات» و«مكتبة» كلمة واحدة، ولا أن «أحمد» و«احمد» نفس الاسم. والثالثة أنها لا ترتب النتائج، فالمقال الذي ذكر الكلمة مرة في الهامش يظهر بجانب المقال الذي عنوانه هو الكلمة نفسها. والبحث النصي في PostgreSQL يحل الثلاث: يحول النص إلى كلمات بعد توحيدها، ويحفظها في فهرس، ويعطي كل نتيجة درجة.
كيف يعمل البحث النصي من الداخل؟
البحث النصي في PostgreSQL مبني على نوعين من البيانات وعلى مسار ثابت يمر به كل نص، كما يشرح فصل البحث النصي في التوثيق:
- المحلل Parser: يقسم النص إلى أجزاء Tokens ويعطي كل جزء نوعاً، مثل
wordللكلمة وuintللرقم وhostلاسم موقع وemailللبريد. ويوجد في PostgreSQL محلل واحد مدمج اسمهdefault، وهو يعرف الحروف العربية كحروف كلمات. - القواميس Dictionaries: تأخذ كل جزء وتعيد الكلمة الموحدة Lexeme، أو لا شيء إذا كانت كلمة شائعة Stop Word لا تفيد في البحث. ومن أنواعها القاموس
simpleالذي يحول الحروف إلى صغيرة فقط، وقواميس Snowball التي ترجع الكلمة إلى جذعها Stem، وقاموسunaccentالذي يحذف العلامات. - الإعداد Configuration: يربط بين الاثنين، أي يقول لكل نوع جزء أي قواميس يمر بها بالترتيب. والإعداد
arabicيمرر الكلمات بالقاموسarabic_stem، والأرقام والعناوين بالقاموسsimple. - النوع tsvector: نتيجة المسار السابق على المستند: قائمة مرتبة بالكلمات الموحدة، ومع كل كلمة مواضعها في النص، ووزن اختياري من A إلى D تحدد به أهمية الحقل، كأن يكون العنوان A والنص B.
- النوع tsquery: سؤال المستخدم بعد نفس المسار، مع العوامل
&و|و!و<->للعبارة المتتالية. - العامل @@: يقول هل يطابق ال
tsvectorهذا الtsquery، وفهرس GIN على عمود الtsvectorيجعل هذا السؤال بحثاً في قائمة لكل كلمة بدل قراءة كل مستند.
والصورة التالية تبين المسار على جملة عربية، وتبين أيضاً أين تحدث المشكلة التي سوف نقضي فيها جزءاً كبيراً من المقال:
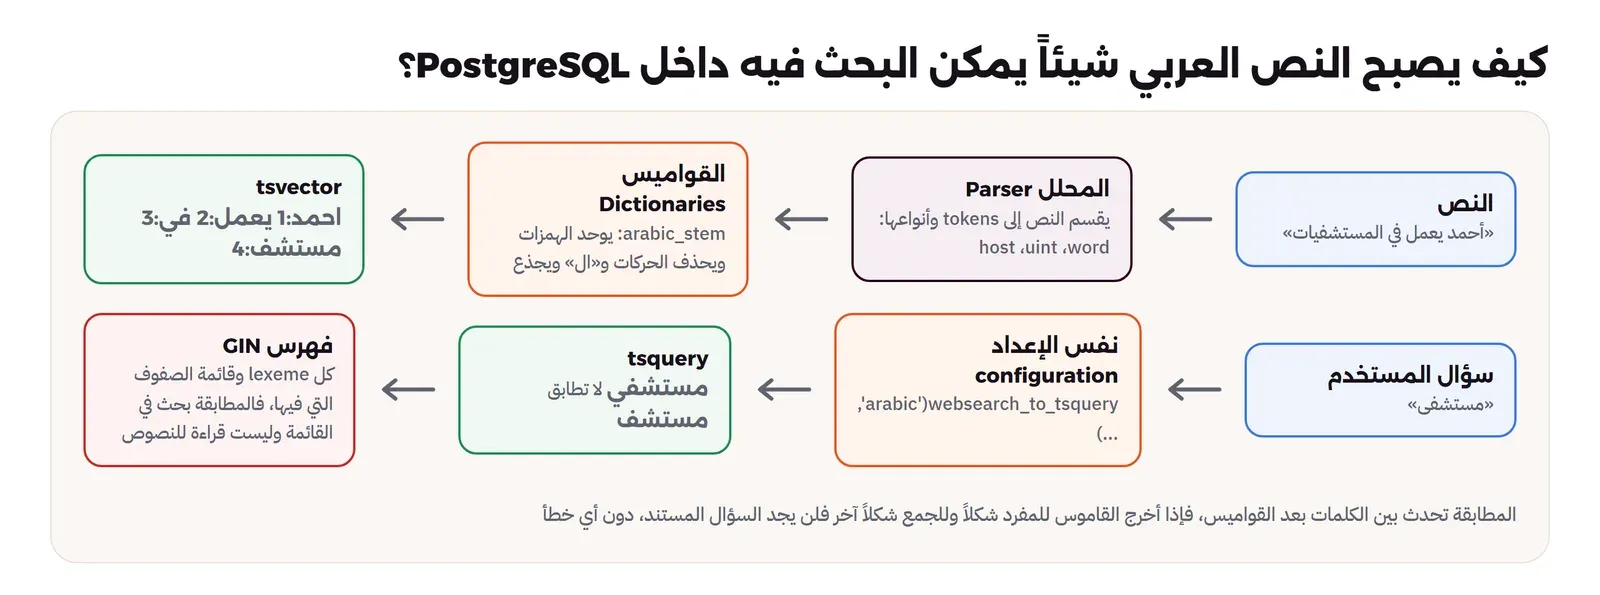
والتشبيه الأقرب للفهرس هو الفهرس الذي في آخر الكتاب: لا تقرأ الكتاب كله لتجد صفحات «الخوارزميات»، وإنما تذهب إلى الكلمة في الفهرس المرتب فتجد بجانبها أرقام الصفحات. ولكن من كتب فهرس الكتاب قرر شيئاً مهماً قبل ذلك، وهو أن «خوارزمية» و«الخوارزميات» تكتبان تحت كلمة واحدة، وأن «في» و«من» لا تكتبان أصلاً، وهذا بالضبط عمل القواميس، فإذا أخطأ القاموس في قرار من هذه القرارات فلن يصلحه أي فهرس بعده.
والقاعدة الأولى التي تخرج من هذا المسار أن الإعداد يجب أن يكون نفسه في الكتابة وفي السؤال، فإذا بنيت ال tsvector بالإعداد arabic وسألت بالإعداد simple فالسؤال «المستشفيات» لن يطابق الكلمة المحفوظة «مستشف»، والنتيجة صفر دون أي رسالة خطأ. وسوف ترى نسخة أخطر من هذه المشكلة في آخر التجربة، حيث يختفي الفهرس كله بسبب كلمة واحدة ناقصة في الاستعلام.
ماذا يفعل الإعداد arabic بالكلمات العربية؟
أضاف PostgreSQL 12 جذع Snowball للغة العربية، كما في ملاحظات إصدار PostgreSQL 12، فأصبح الإعداد arabic موجوداً في كل نسخة حديثة دون أي إضافة. والجذع مبني على خوارزمية Snowball العربية، وهي تبدأ بتوحيد الحروف: حذف الحركات والتطويل، وتوحيد أشكال الألف، ثم تحذف السوابق مثل «ال» و«وال» و«بال»، واللواحق مثل «ات» و«ون» و«ة»، بقواعد تعتمد على طول الكلمة. وأفضل طريقة لتعرف ما يفعله أي إعداد أن تسأله مباشرة بالدالة ts_debug، التي تبين كل جزء ونوعه والقاموس الذي مر به والكلمة الناتجة، كما يشرح توثيق اختبار الإعدادات. وهذا ما سوف نفعله في أول التجربة، والنتيجة باختصار:
- التوحيد يعمل جيداً: «أحمد» تصبح «احمد»، والحركات في كلمة مشكولة مثل «مستشفى» بالتشكيل الكامل تحذف، والتطويل في «الــمدينة» يحذف، فلا تحتاج إلى دالة توحيد للهمزات والحركات مع هذا الإعداد.
- لا توجد كلمات شائعة Stop Words عربية، فكلمة «في» تدخل الفهرس وتطابق تقريباً كل مستند، وسوف ترى ثمن ذلك في الترتيب.
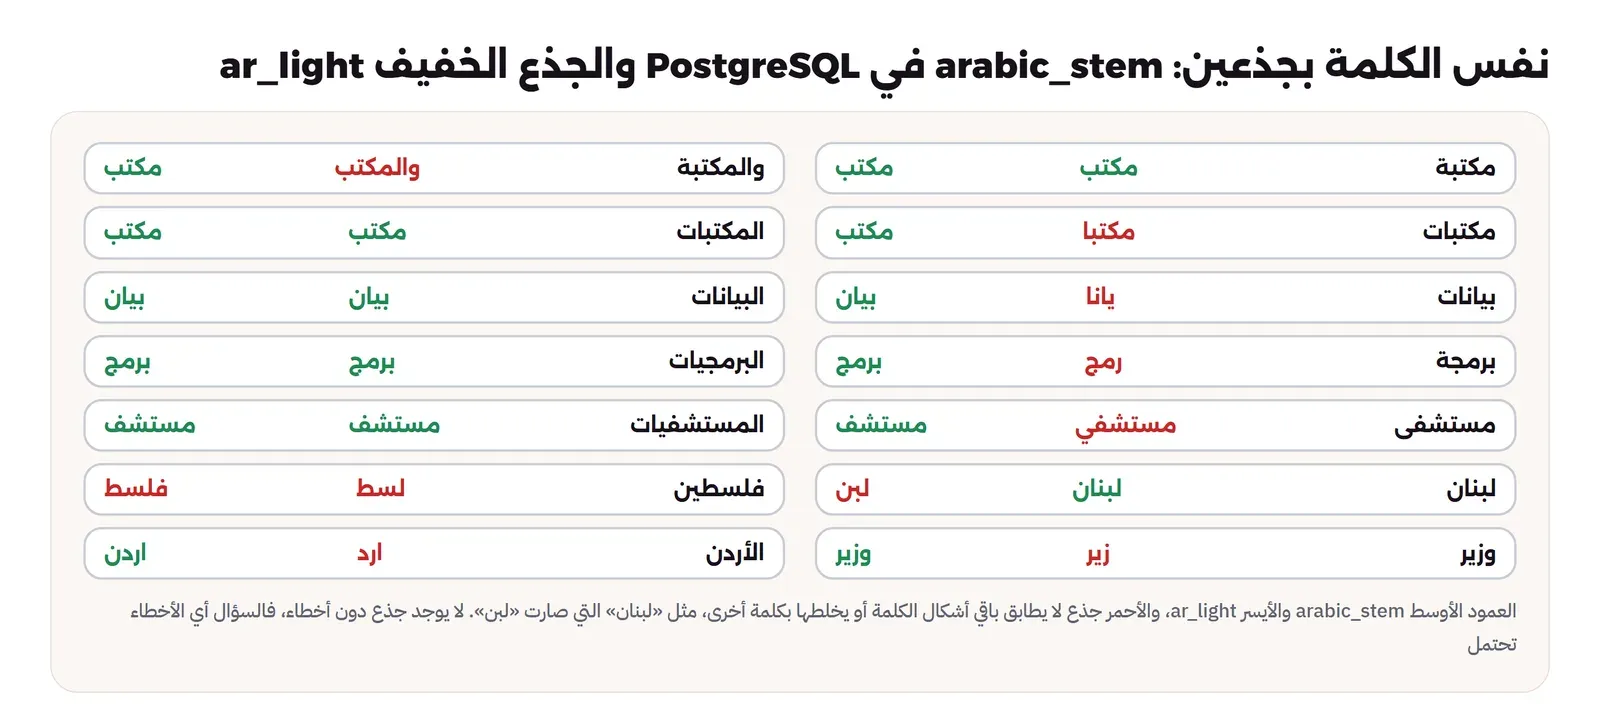
- الجذع غير متسق بين المفرد والجمع وبين الكلمة مع «ال» ودونها في حالات كثيرة: «بيانات» تصبح «يانا» لأن الجذع ظن الباء حرف جر، و«البيانات» تصبح «بيان»، و«برمجة» تصبح «رمج»، و«مستشفى» تصبح «مستشفي» و«المستشفيات» تصبح «مستشف». أي أن السؤال بأحد الشكلين لا يجد المستندات التي فيها الشكل الآخر.
وانتبه أيضاً إلى الكلمات الإنجليزية داخل النص العربي، مثل أسماء الأدوات والمصطلحات التقنية، فهي تمر في الإعداد arabic بنفس القاموس arabic_stem، وهو لا يعرف الإنجليزية فيتركها كما هي بعد تحويلها إلى حروف صغيرة: الكلمة Databases تبقى databases مع الإعداد العربي، وتصبح databas مع القاموس english_stem. أي أن من يبحث عن «database» في مقالات عربية لن يجد «databases»، وإذا كان محتواك التقني مليئاً بالمصطلحات الإنجليزية فتستطيع أن تبني إعداداً خاصاً بالأمر CREATE TEXT SEARCH CONFIGURATION يمرر النوع asciiword بالقاموس الإنجليزي والنوع word بالعربي.
وهذه النقطة الأخيرة لم تذكر في أغلب ما كتب عن البحث العربي في PostgreSQL، لأن أغلب الأمثلة تجرب كلمة أو كلمتين بـ «ال»، وهي الحالة التي يعمل فيها الجذع جيداً. ولكي تعرف أثرها الحقيقي تحتاج بيانات حقيقية وعدداً، وهذا ما تفعله التجربة.
تجربة عملية Lab: 348 ألف مقال من ويكيبيديا العربية
البيانات مقالات ويكيبيديا العربية من مجموعة wikimedia/wikipedia المنشورة على Hugging Face، نسخة 20231101.ar، وأخذنا منها ملفين من سبعة فيهما 348,343 مقالاً بعنوانها ونصها الكامل، ومتوسط طول المقال 912 حرفاً وأطولها قرابة 218 ألف حرف. والنصوص مرخصة برخصة CC BY-SA كما هي في ويكيبيديا. والسيرفر PostgreSQL 18.6 في Container واحد، مع ذاكرة مشتركة shared_buffers قدرها 1 جيجابايت، وكل ملفات SQL في مجلد lab مع المقال.
التجهيز Setup
حولنا ملفي Parquet إلى ملف CSV فيه ثلاثة أعمدة بسكربت Python صغير مع مكتبة pyarrow، ثم شغلنا السيرفر وربطنا مجلد البيانات للقراءة فقط:
docker pull postgres:18.6
docker tag postgres:18.6 sw4-postgres:18.6
docker run -d --name sw4-fts-pg -e POSTGRES_PASSWORD=lab -e POSTGRES_DB=wiki \
  -v "$PWD/data:/data:ro" --shm-size=1g sw4-postgres:18.6 \
  -c shared_buffers=1GB -c work_mem=64MB -c maintenance_work_mem=1GB -c max_parallel_maintenance_workers=4
docker exec -i sw4-fts-pg psql -U postgres -d wiki < 01-load.sql
والملف 01-load.sql ينشئ الجدول ويحمل الملف:
-- 348,343 Arabic Wikipedia articles (wikimedia/wikipedia 20231101.ar, shards 1 and 4), CC BY-SA
\timing on
CREATE TABLE articles (
    id    bigint PRIMARY KEY,
    title text NOT NULL,
    body  text NOT NULL
);
\copy articles FROM '/data/arwiki.csv' WITH (FORMAT csv)
ANALYZE articles;
SELECT count(*) AS articles,
       pg_size_pretty(pg_total_relation_size('articles')) AS total_size,
       round(avg(length(body))) AS avg_chars,
       max(length(body)) AS max_chars
FROM articles;
والمخرج سوف يكون كما يلي:
Timing is on.
CREATE TABLE
Time: 14.866 ms
COPY 348343
Time: 131688.194 ms (02:11.688)
ANALYZE
Time: 2001.308 ms (00:02.001)
 articles | total_size | avg_chars | max_chars
----------+------------+-----------+-----------
   348343 | 356 MB     |       912 |    217942
(1 row)

Time: 5662.576 ms (00:05.663)
الجدول 356 ميجابايت مع ضغط النصوص الطويلة في TOAST، والتحميل أخذ دقيقتين.
نقطة البداية: LIKE دون فهرس
-- the starting point: LIKE on the body, no index
\timing on
SELECT count(*) FROM articles WHERE body LIKE '%خوارزمية%';
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF)
SELECT id, title FROM articles WHERE body LIKE '%خوارزمية%' LIMIT 10;
-- the same word with "ال" in the text is a different string
SELECT count(*) FILTER (WHERE body LIKE '%خوارزمية%')  AS like_singular,
       count(*) FILTER (WHERE body LIKE '%خوارزميات%') AS like_plural
FROM articles;
والمخرج سوف يكون كما يلي:
Timing is on.
 count
-------
   200
(1 row)

Time: 5011.209 ms (00:05.011)
                                 QUERY PLAN
-----------------------------------------------------------------------------
 Limit (actual time=11.641..228.116 rows=10.00 loops=1)
   Buffers: shared hit=2079
   ->  Seq Scan on articles (actual time=11.638..228.099 rows=10.00 loops=1)
         Filter: (body ~~ '%خوارزمية%'::text)
         Rows Removed by Filter: 2587
         Buffers: shared hit=2079
 Planning:
   Buffers: shared hit=6 dirtied=1
 Planning Time: 0.603 ms
 Execution Time: 228.164 ms
(10 rows)

Time: 252.783 ms
 like_singular | like_plural
---------------+-------------
           200 |         207
(1 row)

Time: 5760.351 ms (00:05.760)
في المخرج أعلاه لاحظ التالي:
- عد المقالات التي فيها «خوارزمية» أخذ خمس ثوان، لأنه قرأ كل الجدول، وهذا الزمن يزيد مع كل مقال تضيفه.
- أول عشر نتائج دون ترتيب أخذت 228 مللي ثانية فقط، لأن الخطة Seq Scan توقفت عند العاشرة، فالبحث يبدو سريعاً في الاختبار ثم يبطئ عندما تريد العدد أو الترتيب أو كلمة نادرة لا توجد إلا في آخر الجدول.
- «خوارزمية» في 200 مقال و«خوارزميات» في 207، وLIKE لا يعرف أنهما كلمة واحدة، فالمستخدم الذي يبحث بإحداهما لا يرى نصف النتائج.
ماذا يفعل الإعداد arabic بكلماتنا؟
-- what the built-in "arabic" configuration does to Arabic words
\dF+ arabic
SELECT alias, token, dictionaries, lexemes
FROM ts_debug('arabic', 'أحمد يعمل في المستشفيات، ومُسْتَشْفَى الــمدينة 2026 www.example.com');
SELECT w AS word, ts_lexize('arabic_stem', w) AS lexeme
FROM unnest(ARRAY['مكتبة','المكتبة','والمكتبة','بالمكتبة','مكتبات','المكتبات',
                  'بيانات','البيانات','برمجة','البرمجيات','مستشفى','المستشفيات',
                  'في','على','التي']) AS w;
والمخرج سوف يكون كما يلي:
Text search configuration "pg_catalog.arabic"
Parser: "pg_catalog.default"
      Token      | Dictionaries
-----------------+--------------
 asciihword      | arabic_stem
 asciiword       | arabic_stem
 email           | simple
 file            | simple
 float           | simple
 host            | simple
 hword           | arabic_stem
 hword_asciipart | arabic_stem
 hword_numpart   | simple
 hword_part      | arabic_stem
 int             | simple
 numhword        | simple
 numword         | simple
 sfloat          | simple
 uint            | simple
 url             | simple
 url_path        | simple
 version         | simple
 word            | arabic_stem

 alias |      token      | dictionaries  |      lexemes
-------+-----------------+---------------+-------------------
 word  | أحمد            | {arabic_stem} | {احمد}
 blank |                 | {}            |
 word  | يعمل            | {arabic_stem} | {يعمل}
 blank |                 | {}            |
 word  | في              | {arabic_stem} | {في}
 blank |                 | {}            |
 word  | المستشفيات      | {arabic_stem} | {مستشف}
 blank | ،               | {}            |
 word  | ومُسْتَشْفَى         | {arabic_stem} | {مستشفي}
 blank |                 | {}            |
 word  | الــمدينة       | {arabic_stem} | {مدين}
 blank |                 | {}            |
 uint  | 2026            | {simple}      | {2026}
 blank |                 | {}            |
 host  | www.example.com | {simple}      | {www.example.com}
(15 rows)

    word    |  lexeme
------------+-----------
 مكتبة      | {مكتب}
 المكتبة    | {مكتب}
 والمكتبة   | {والمكتب}
 بالمكتبة   | {مكتب}
 مكتبات     | {مكتبا}
 المكتبات   | {مكتب}
 بيانات     | {يانا}
 البيانات   | {بيان}
 برمجة      | {رمج}
 البرمجيات  | {برمج}
 مستشفى     | {مستشفي}
 المستشفيات | {مستشف}
 في         | {في}
 على        | {علي}
 التي       | {الت}
(15 rows)
في المخرج أعلاه لاحظ التالي:
- الأمر
\dF+ arabicيبين أن الكلمات من النوعwordتمر بالقاموسarabic_stemوحده، فلا يوجد قاموس كلمات شائعة قبله، والأرقام والعناوين بالقاموسsimple. - في
ts_debugوحد الجذع الهمزة والحركات والتطويل كما توقعنا، و«المستشفيات» أصبحت «مستشف»، وwww.example.comبقي كما هو كنوعhost. - في الجدول الثاني الكلمات الحمراء في الصورة التالية: «والمكتبة» بقيت «والمكتب» فلم تحذف «وال»، و«مكتبات» دون «ال» أصبحت «مكتبا»، و«بيانات» أصبحت «يانا» و«برمجة» أصبحت «رمج»، و«على» أصبحت «علي» و«التي» أصبحت «الت»، أي أن الجذع لا يعرف هذه الكلمات الشائعة أصلاً.
الفهرس: عمود tsvector مولد وفهرس GIN
هناك طريقتان لفهرسة النص: فهرس على تعبير Expression Index مثل to_tsvector('arabic', body)، أو عمود tsvector محفوظ يولده PostgreSQL من الأعمدة الأخرى Generated Column ثم فهرس عليه. والثانية أفضل في أغلب الحالات، كما يقول توثيق الجداول والفهارس، لأن الترتيب يحتاج قراءة ال tsvector لكل نتيجة، فإذا كان محفوظاً قرأه، وإذا لم يكن حسبه من النص من جديد، ولأن الاستعلام لا يحتاج أن يكرر التعبير بالضبط. والثمن مساحة إضافية على القرص. ونعطي العنوان الوزن A والنص الوزن B:
-- a stored tsvector column with weights (title A, body B), then a GIN index on it
\timing on
ALTER TABLE articles ADD COLUMN fts_ar tsvector GENERATED ALWAYS AS (
    setweight(to_tsvector('arabic', title), 'A') ||
    setweight(to_tsvector('arabic', body), 'B')) STORED;
CREATE INDEX articles_fts_ar ON articles USING gin (fts_ar);
VACUUM ANALYZE articles;
SELECT pg_size_pretty(pg_relation_size('articles'))                AS heap,
       pg_size_pretty(pg_total_relation_size('articles')
                      - pg_relation_size('articles')
                      - pg_indexes_size('articles'))                AS toast,
       pg_size_pretty(pg_relation_size('articles_fts_ar'))          AS gin_index;
والمخرج سوف يكون كما يلي:
Timing is on.
NOTICE:  word is too long to be indexed
DETAIL:  Words longer than 2047 characters are ignored.
ALTER TABLE
Time: 384124.946 ms (06:24.125)
CREATE INDEX
Time: 121809.142 ms (02:01.809)
VACUUM
Time: 4978.221 ms (00:04.978)
  heap  | toast  | gin_index
--------+--------+-----------
 408 MB | 453 MB | 134 MB
(1 row)

Time: 6.419 ms
في المخرج أعلاه لاحظ التالي:
- إضافة العمود المولد أعادت كتابة الجدول كله وحسبت ال
tsvectorلكل مقال، فأخذت ست دقائق ونصفاً، وطوال هذا الوقت كان الجدول مقفلاً أمام القراءة والكتابة. وعلى جدول يعمل في الإنتاج لا تقم بذلك بأمر واحد، وأضف عموداً عادياً واملأه على دفعات مع Trigger، كما نشرح في مقال تعديل الجداول دون توقف ضمن مرحلة قواعد البيانات في الإنتاج. - التنبيه
word is too long to be indexedيعني أن في أحد المقالات «كلمة» أطول من 2047 حرفاً، غالباً جدول أو رابط طويل دون مسافات، فتجاهلها PostgreSQL ولم يفشل. وهذا أحد حدود البحث النصي المذكورة في صفحة الحدود، ومعها أن حجم الtsvectorالواحد لا يتجاوز 1 ميجابايت، وأن المواضع لا تتجاوز 16383، فالكلمات بعد هذا الموضع في مقال طويل جداً تحفظ بموضع 16383. - فهرس GIN أخذ دقيقتين وحجمه 134 ميجابايت، وزاد حجم الجدول مع ال
tsvectorالمحفوظ إلى 408 ميجابايت للجدول نفسه و453 لجزء TOAST، أي أن البحث النصي ضاعف المساحة تقريباً.
البحث بالفهرس: websearch_to_tsquery وقراءة الخطة
لتحويل سؤال المستخدم إلى tsquery هناك أربع دوال، والتي تناسب مربع البحث هي websearch_to_tsquery، لأنها تقبل الصيغة التي يعرفها الناس من محركات البحث: العبارة بين علامتي تنصيص، والكلمة المستبعدة بعلامة ناقص، والكلمة or بين بديلين، ولا ترمي خطأ مهما كتب المستخدم، أما to_tsquery فترمي خطأ Syntax Error إذا كتب المستخدم قوساً ناقصاً، فلا تمرر لها نصاً من المستخدم مباشرة:
-- the same search through the GIN index
\timing on
SELECT websearch_to_tsquery('arabic', 'خوارزمية') AS q1,
       websearch_to_tsquery('arabic', '"قاعدة بيانات" -أوراكل') AS q2,
       websearch_to_tsquery('arabic', 'برمجة or خوارزميات') AS q3;
SELECT count(*) FROM articles WHERE fts_ar @@ websearch_to_tsquery('arabic', 'خوارزمية');
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF)
SELECT id, title FROM articles
WHERE fts_ar @@ websearch_to_tsquery('arabic', 'خوارزمية') LIMIT 10;
-- a rare word and a common word, ranked, top 10
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF)
SELECT id, title, ts_rank(fts_ar, q) AS rank
FROM articles, websearch_to_tsquery('arabic', 'خوارزمية') q
WHERE fts_ar @@ q ORDER BY rank DESC LIMIT 10;
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF)
SELECT id, title, ts_rank(fts_ar, q) AS rank
FROM articles, websearch_to_tsquery('arabic', 'مدينة') q
WHERE fts_ar @@ q ORDER BY rank DESC LIMIT 10;
والمخرج سوف يكون كما يلي:
Timing is on.
    q1    |              q2               |         q3
----------+-------------------------------+--------------------
 'خوارزم' | 'قاعد' <-> 'يانا' & !'اوراكل' | 'رمج' | 'خوارزميا'
(1 row)

Time: 2.151 ms
 count
-------
   337
(1 row)

Time: 167.381 ms
                                           QUERY PLAN
-------------------------------------------------------------------------------------------------
 Limit (actual time=0.122..0.151 rows=10.00 loops=1)
   Buffers: shared hit=15
   ->  Bitmap Heap Scan on articles (actual time=0.120..0.147 rows=10.00 loops=1)
         Recheck Cond: (fts_ar @@ '''خوارزم'''::tsquery)
         Heap Blocks: exact=10
         Buffers: shared hit=15
         ->  Bitmap Index Scan on articles_fts_ar (actual time=0.070..0.071 rows=337.00 loops=1)
               Index Cond: (fts_ar @@ '''خوارزم'''::tsquery)
               Index Searches: 1
               Buffers: shared hit=4
 Planning:
   Buffers: shared hit=9
 Planning Time: 0.271 ms
 Execution Time: 0.175 ms
(14 rows)

Time: 1.404 ms
                                              QUERY PLAN
-------------------------------------------------------------------------------------------------------
 Limit (actual time=8.687..8.692 rows=10.00 loops=1)
   Buffers: shared hit=1805
   ->  Sort (actual time=8.683..8.686 rows=10.00 loops=1)
         Sort Key: (ts_rank(articles.fts_ar, '''خوارزم'''::tsquery)) DESC
         Sort Method: top-N heapsort  Memory: 26kB
         Buffers: shared hit=1805
         ->  Bitmap Heap Scan on articles (actual time=0.380..8.478 rows=337.00 loops=1)
               Recheck Cond: (fts_ar @@ '''خوارزم'''::tsquery)
               Heap Blocks: exact=326
               Buffers: shared hit=1802
               ->  Bitmap Index Scan on articles_fts_ar (actual time=0.077..0.077 rows=337.00 loops=1)
                     Index Cond: (fts_ar @@ '''خوارزم'''::tsquery)
                     Index Searches: 1
                     Buffers: shared hit=4
 Planning:
   Buffers: shared hit=28 read=1
 Planning Time: 100.002 ms
 Execution Time: 8.732 ms
(18 rows)

Time: 293.168 ms
                                               QUERY PLAN
---------------------------------------------------------------------------------------------------------
 Limit (actual time=235.794..235.798 rows=10.00 loops=1)
   Buffers: shared hit=120384
   ->  Sort (actual time=235.792..235.794 rows=10.00 loops=1)
         Sort Key: (ts_rank(articles.fts_ar, '''مدين'''::tsquery)) DESC
         Sort Method: top-N heapsort  Memory: 26kB
         Buffers: shared hit=120384
         ->  Bitmap Heap Scan on articles (actual time=11.894..227.477 rows=38097.00 loops=1)
               Recheck Cond: (fts_ar @@ '''مدين'''::tsquery)
               Heap Blocks: exact=19154
               Buffers: shared hit=120384
               ->  Bitmap Index Scan on articles_fts_ar (actual time=9.475..9.476 rows=38097.00 loops=1)
                     Index Cond: (fts_ar @@ '''مدين'''::tsquery)
                     Index Searches: 1
                     Buffers: shared hit=13
 Planning:
   Buffers: shared hit=1
 Planning Time: 0.260 ms
 Execution Time: 235.951 ms
(18 rows)

Time: 236.588 ms
في المخرج أعلاه لاحظ التالي:
- العبارة
"قاعدة بيانات"أصبحت'قاعد' <-> 'يانا'، أي كلمتين متتاليتين، والثانية «يانا» بسبب نفس مشكلة الجذع، فالمقال الذي فيه «قاعدة البيانات» لن يطابق هذه العبارة. والكلمة المستبعدة أصبحت!'اوراكل'، وorأصبحت|، ولاحظ أن «برمجة» أصبحت «رمج» و«خوارزميات» أصبحت «خوارزميا» وليس «خوارزم». - العدد 337 مقالاً بدل 200 مع LIKE، لأن الجذع جمع «خوارزمية» و«الخوارزمية» و«بالخوارزمية» في كلمة واحدة، وأخذ 167 مللي ثانية بدل خمس ثوان.
- أول عشر نتائج دون ترتيب في 0.175 مللي ثانية، والخطة Bitmap Index Scan على الفهرس ثم Bitmap Heap Scan لقراءة الصفوف، وأربع صفحات فقط من الفهرس.
- مع الترتيب
ts_rankزاد الزمن إلى 8.7 مللي ثانية، لأن PostgreSQL قرأ الtsvectorللمقالات الـ 337 كلها ليحسب درجتها ثم رتبها، فقرأ 1802 صفحة بدل 15. - مع كلمة شائعة مثل «مدينة» تطابق 38,097 مقالاً أخذ الترتيب 236 مللي ثانية وقرأ 120 ألف صفحة، والسبب نفسه: الفهرس يقول أين المطابقات، ولكنه لا يعرف أيها الأفضل، فلا بد من قراءتها كلها.
والنقطة الأخيرة هي أهم فرق بين PostgreSQL ومحركات البحث، ويقولها التوثيق صراحة في صفحة التحكم في البحث: الترتيب مكلف لأنه يحتاج قراءة ال tsvector لكل مستند مطابق، ولا يمكن تجنبه تقريباً. أما محركات البحث فتحفظ في الفهرس نفسه ما تحتاجه للترتيب بطريقة BM25، كما شرحنا في مقال أساسيات البحث، فتتوقف عند أفضل النتائج دون أن تقرأ كل المطابقات.
جذع خفيف Light Stemmer بلغة SQL
بعد أن رأينا أن الجذع المدمج غير متسق، الحل البسيط أن نكتب جذعاً خفيفاً بأنفسنا، والفكرة مأخوذة من قواعد الجذع الخفيف Light Stemming التي نشرتها Leah Larkey وزملاؤها من جامعة Massachusetts في ورقة Improving Stemming for Arabic Information Retrieval سنة 2002، ووجدوا فيها أن حذف عدد قليل من السوابق واللواحق دون محاولة الوصول إلى الأصل الثلاثي Root أفضل للبحث من التحليل الصرفي الكامل. والقواعد: وحد الحروف، ثم احذف «ال» و«وال» و«بال» و«كال» و«فال» و«لل» من أول الكلمة إذا بقي حرفان على الأقل، ثم احذف كل لاحقة من قائمة ثابتة مرة واحدة بالترتيب. ونكتبها بدالتين في SQL، ونستخدمهما مع الإعداد simple الذي لا يغير الكلمات:
-- A light Arabic stemmer in SQL, after the Light10 rules: normalise letters, strip a few prefixes, then each
-- suffix once, in order, only when at least two letters stay. Used with the 'simple' configuration.
\timing on
CREATE FUNCTION ar_norm(t text) RETURNS text
LANGUAGE sql IMMUTABLE PARALLEL SAFE AS $$
  SELECT translate(regexp_replace(t, '[ً-ْـ]', '', 'g'),   -- harakat and tatweel
                   'أإآٱىة', 'اااايه')                                      -- alef forms, alef maqsura, ta marbuta
$$;

CREATE FUNCTION ar_light(t text) RETURNS text
LANGUAGE sql IMMUTABLE PARALLEL SAFE AS $$
  WITH p AS (   -- prefixes: wal, bal, kal, fal, ll, al (when two letters or more stay)
    SELECT regexp_replace(ar_norm(t), '(^|[^[:alnum:]])(وال|بال|كال|فال|لل|ال)(?=[[:alnum:]]{2})', '\1', 'g') AS s
  )
  SELECT regexp_replace(regexp_replace(regexp_replace(regexp_replace(regexp_replace(
         regexp_replace(regexp_replace(regexp_replace(regexp_replace(s,
           '([[:alnum:]]{2,})ها(?![[:alnum:]])', '\1', 'g'),
           '([[:alnum:]]{2,})ان(?![[:alnum:]])', '\1', 'g'),
           '([[:alnum:]]{2,})ات(?![[:alnum:]])', '\1', 'g'),
           '([[:alnum:]]{2,})ون(?![[:alnum:]])', '\1', 'g'),
           '([[:alnum:]]{2,})ين(?![[:alnum:]])', '\1', 'g'),
           '([[:alnum:]]{2,})يه(?![[:alnum:]])', '\1', 'g'),   -- ية after normalisation
           '([[:alnum:]]{2,})ه(?![[:alnum:]])', '\1', 'g'),    -- ة after normalisation
           '([[:alnum:]]{2,})ي(?![[:alnum:]])', '\1', 'g'),
           '\s+', ' ', 'g')
  FROM p
$$;

SELECT w AS word, ts_lexize('arabic_stem', w) AS arabic, ar_light(w) AS light
FROM unnest(ARRAY['مكتبة','المكتبة','والمكتبة','مكتبات','المكتبات','بيانات','البيانات',
                  'برمجة','البرمجيات','مستشفى','المستشفيات','مدينة','المدن','معلمون','المعلمين']) AS w;

ALTER TABLE articles ADD COLUMN fts_light tsvector GENERATED ALWAYS AS (
    setweight(to_tsvector('simple', ar_light(title)), 'A') ||
    setweight(to_tsvector('simple', ar_light(body)), 'B')) STORED;
CREATE INDEX articles_fts_light ON articles USING gin (fts_light);
VACUUM ANALYZE articles;
SELECT pg_size_pretty(pg_relation_size('articles_fts_light')) AS gin_light;
والمخرج سوف يكون كما يلي:
Timing is on.
CREATE FUNCTION
Time: 4.241 ms
CREATE FUNCTION
Time: 3.517 ms
    word    |  arabic   | light
------------+-----------+-------
 مكتبة      | {مكتب}    | مكتب
 المكتبة    | {مكتب}    | مكتب
 والمكتبة   | {والمكتب} | مكتب
 مكتبات     | {مكتبا}   | مكتب
 المكتبات   | {مكتب}    | مكتب
 بيانات     | {يانا}    | بيان
 البيانات   | {بيان}    | بيان
 برمجة      | {رمج}     | برمج
 البرمجيات  | {برمج}    | برمج
 مستشفى     | {مستشفي}  | مستشف
 المستشفيات | {مستشف}   | مستشف
 مدينة      | {مدين}    | مدين
 المدن      | {مدن}     | مدن
 معلمون     | {معلم}    | معلم
 المعلمين   | {معلم}    | معلم
(15 rows)

Time: 5.137 ms
ALTER TABLE
Time: 654389.253 ms (10:54.389)
CREATE INDEX
Time: 48904.634 ms (00:48.905)
VACUUM
Time: 78999.840 ms (01:19.000)
 gin_light
-----------
 144 MB
(1 row)

Time: 2.873 ms
الدالتان مكتوبتان كـ IMMUTABLE، وهذا شرط ليقبلهما PostgreSQL في عمود مولد وفي فهرس، وهو وعد منك بأن نفس المدخل يعطي دائماً نفس المخرج، فإذا غيرت الدالة لاحقاً فيجب أن تعيد حساب العمود كله، وإلا بقيت المقالات القديمة بكلماتها القديمة. ولاحظ أن العمود أخذ هذه المرة قرابة إحدى عشرة دقيقة بدل ست، لأن تسعة تعبيرات منتظمة Regular Expressions على كل النص أبطأ من جذع Snowball المكتوب بلغة C، وهذا ثمن ثابت في كل INSERT وUPDATE أيضاً. والصورة التالية تبين الجذعين على نفس الكلمات:
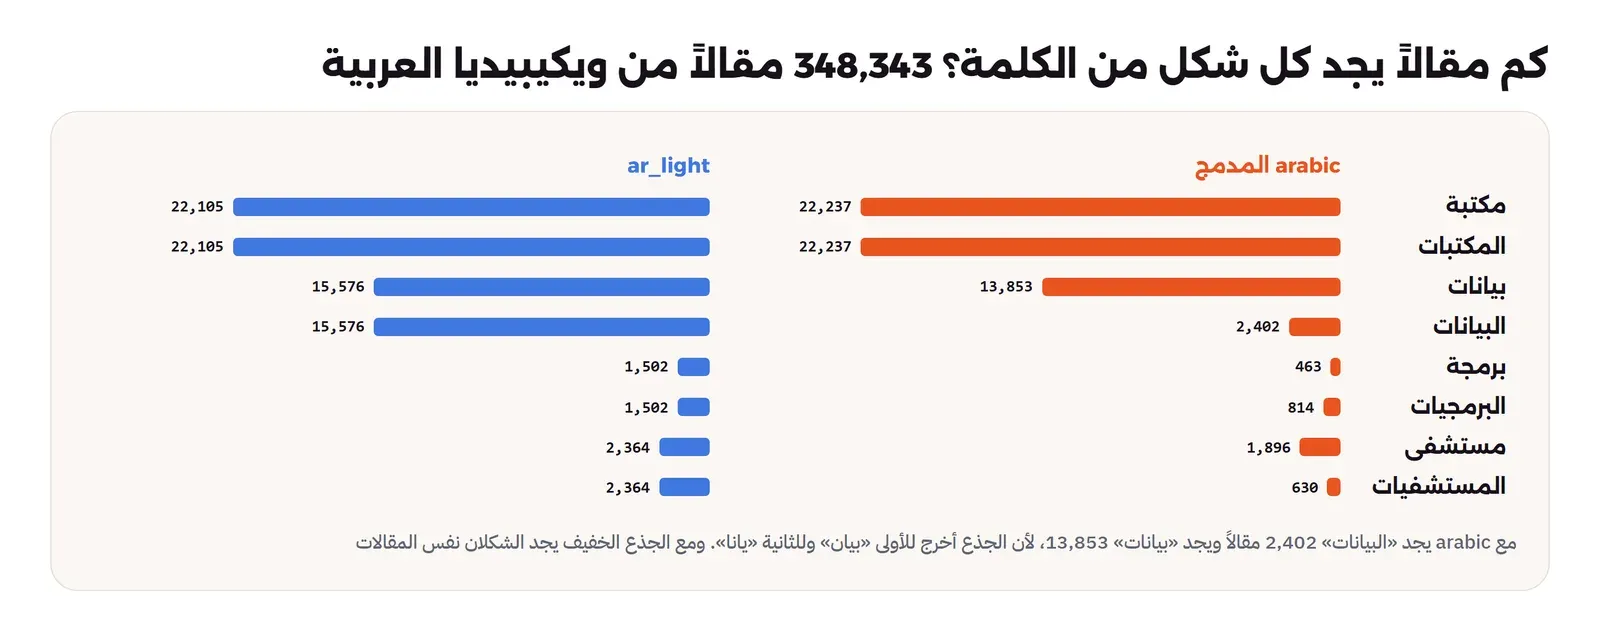
والسؤال الذي يهمك ليس أي جذع أجمل، وإنما كم مقالاً يجد المستخدم بكل شكل من الكلمة، لذلك نعد:
-- How many articles each form of the same word finds, with the built-in 'arabic' stemmer and with ar_light
\timing off
WITH words(w) AS (VALUES ('مكتبة'), ('المكتبات'), ('بيانات'), ('البيانات'), ('برمجة'), ('البرمجيات'),
                        ('مستشفى'), ('المستشفيات'), ('لبنان'), ('فلسطين'))
SELECT w AS query,
       (SELECT count(*) FROM articles WHERE fts_ar @@ plainto_tsquery('arabic', w))              AS arabic,
       (SELECT count(*) FROM articles WHERE fts_light @@ plainto_tsquery('simple', ar_light(w))) AS light,
       plainto_tsquery('arabic', w)::text AS arabic_q,
       plainto_tsquery('simple', ar_light(w))::text AS light_q
FROM words;
-- a phrase: "قاعدة بيانات" (database) in both
SELECT (SELECT count(*) FROM articles WHERE fts_ar @@ phraseto_tsquery('arabic', 'قاعدة بيانات')) AS arabic_phrase,
       (SELECT count(*) FROM articles WHERE fts_light @@ phraseto_tsquery('simple', ar_light('قاعدة بيانات'))) AS light_phrase,
       (SELECT count(*) FROM articles WHERE body LIKE '%قاعدة بيانات%' OR body LIKE '%قاعدة البيانات%'
                                          OR body LIKE '%قواعد البيانات%' OR body LIKE '%قواعد بيانات%') AS like_any_form;
والمخرج سوف يكون كما يلي:
Timing is off.
   query    | arabic | light | arabic_q | light_q
------------+--------+-------+----------+---------
 مكتبة      |  22237 | 22105 | 'مكتب'   | 'مكتب'
 المكتبات   |  22237 | 22105 | 'مكتب'   | 'مكتب'
 بيانات     |  13853 | 15576 | 'يانا'   | 'بيان'
 البيانات   |   2402 | 15576 | 'بيان'   | 'بيان'
 برمجة      |    463 |  1502 | 'رمج'    | 'برمج'
 البرمجيات  |    814 |  1502 | 'برمج'   | 'برمج'
 مستشفى     |   1896 |  2364 | 'مستشفي' | 'مستشف'
 المستشفيات |    630 |  2364 | 'مستشف'  | 'مستشف'
 لبنان      |   4434 |  4381 | 'لبنان'  | 'لبن'
 فلسطين     |   2546 |  2205 | 'لسط'    | 'فلسط'
(10 rows)

 arabic_phrase | light_phrase | like_any_form
---------------+--------------+---------------
           692 |          768 |           927
(1 row)
في المخرج أعلاه لاحظ التالي:
- مع الإعداد
arabicيجد من كتب «البيانات» 2,402 مقالاً، ومن كتب «بيانات» 13,853 مقالاً، والمجموعتان مختلفتان تماماً لأن الكلمتين أصبحتا «بيان» و«يانا». ومع الجذع الخفيف يجد الشكلان نفس الـ 15,576 مقالاً. والأمر نفسه مع «برمجة» و«البرمجيات»: 463 و814 مقابل 1,502 للشكلين، ومع «مستشفى» و«المستشفيات»: 1,896 و630 مقابل 2,364. - «مكتبة» و«المكتبات» تجد نفس العدد تقريباً في الطريقتين، لأن الجذع المدمج يعمل جيداً مع هذه الكلمة، وهذا ما يجعل المشكلة تختفي في الاختبار السريع.
- الجذع الخفيف ليس أفضل في كل شيء: «لبنان» أصبحت «لبن»، فالسؤال عن لبنان يطابق المقالات التي فيها «لبن» أي الحليب، و«فلسطين» أصبحت «فلسط» فلا تطابق «الفلسطينية» التي تصبح «فلسطين». ولو أضفنا حذف حرف الواو من أول الكلمة كما في بعض نسخ الجذع الخفيف لأصبحت «وزير» «زير» كما في الجذع المدمج.
- العبارة «قاعدة بيانات» وجدت 692 مقالاً بالجذع المدمج و768 بالخفيف، وLIKE على الأشكال الأربعة للعبارة وجد 927، فالفرق مقالات فيها «قواعد البيانات» بالجمع المكسر، وهذا لا يحله أي جذع خفيف.
وقد يتساءل البعض: إذن أي الجذعين أختار؟ والإجابة أنه لا يوجد جذع عربي دون أخطاء، فالعربية فيها جموع التكسير وكلمات تبدأ حروفها الأصلية بما يشبه السوابق، وكل قاعدة تحذف حرفاً سوف تخطئ في كلمة ما. والطريقة الصحيحة أن تجمع أسئلة مستخدميك الحقيقية من سجل البحث، وتكتب بجانب كل سؤال المقالات الصحيحة، ثم تقيس كل تغيير، كما فعلنا في مقال البحث العربي. وتستطيع أن تحفظ العمودين معاً وتبحث بأحدهما ثم بالآخر إذا لم تجد نتائج، أو أن تصلح كلمات محددة بقاموس مرادفات Synonym Dictionary صغير، والثمن مساحة وتعقيد في الاستعلام.
البحث بالبادئة Prefix والعبارة Phrase والوزن Weight
مربع البحث الحديث يعرض نتائج والمستخدم ما زال يكتب، وهذا يحتاج البحث بالبادئة: الكلمة التي تبدأ بما كتبه حتى الآن. وفي tsquery تكتب ذلك بعلامة :* بعد الكلمة، والفهرس GIN يدعمها لأنه يحفظ الكلمات مرتبة فيقرأ كل الكلمات التي تبدأ بنفس الحروف. وللعبارة عامل المسافة <-> للكلمة التالية مباشرة، و<N> لكلمة بعد N مواضع، وهذا ممكن لأن ال tsvector يحفظ موضع كل كلمة. أما الوزن فتستطيع أن تقيد به الكلمة بحقل، فالكتابة خوارزم:A تعني «في العنوان فقط» لأننا أعطينا العنوان الوزن A:
-- prefix search for search-as-you-type, and phrase distance
\timing on
SELECT count(*) AS prefix_khwarz FROM articles WHERE fts_light @@ to_tsquery('simple', 'خوارز:*');
SELECT count(*) AS prefix_bar FROM articles WHERE fts_light @@ to_tsquery('simple', 'بر:*');
SELECT to_tsquery('simple', 'ذكاء <-> اصطناع') AS next_word, to_tsquery('simple', 'ذكاء <2> اصطناع') AS two_apart;
SELECT (SELECT count(*) FROM articles WHERE fts_light @@ to_tsquery('simple', 'ذكاء <-> اصطناع')) AS phrase,
       (SELECT count(*) FROM articles WHERE fts_light @@ to_tsquery('simple', 'ذكاء & اصطناع')) AS both_anywhere;
-- weights: the same query, title matches only (A)
SELECT count(*) AS in_title FROM articles WHERE fts_light @@ to_tsquery('simple', 'خوارزم:A');
والمخرج سوف يكون كما يلي:
Timing is on.
 prefix_khwarz
---------------
           418
(1 row)

Time: 28.045 ms
 prefix_bar
------------
      91680
(1 row)

Time: 988.280 ms
      next_word      |      two_apart
---------------------+---------------------
 'ذكاء' <-> 'اصطناع' | 'ذكاء' <2> 'اصطناع'
(1 row)

Time: 0.211 ms
 phrase | both_anywhere
--------+---------------
    238 |           255
(1 row)

Time: 24.871 ms
 in_title
----------
       18
(1 row)

Time: 20.390 ms
في المخرج أعلاه لاحظ التالي:
- البادئة «خوارز» وجدت 418 مقالاً في 144 مللي ثانية، أما البادئة «بر» فوجدت 91,680 مقالاً في 831 مللي ثانية، لأن عدداً ضخماً من الكلمات يبدأ بهذين الحرفين. لذلك لا تبدأ البحث أثناء الكتابة قبل ثلاثة أحرف على الأقل، وهذا ما تفعله أغلب الواجهات.
- العبارة «الذكاء الاصطناعي» بعد الجذع الخفيف أصبحت «ذكاء» ثم «اصطناع»، فوجدت 238 مقالاً فيها الكلمتان متتاليتين، و255 فيها الكلمتان في أي مكان، والفرق 17 مقالاً ذكرت الكلمتين في سياقين مختلفين، وهذا ما تريده عندما يكتب المستخدم العبارة بين علامتي تنصيص.
- الكلمة في العنوان وحده وجدت 18 مقالاً فقط من 411، وهذه هي المقالات التي يجب أن تظهر أولاً، وهذا ما يفعله الوزن في الترتيب تلقائياً، فالدالة
ts_rankتعطي الأوزان A وB وC وD القيم 1.0 و0.4 و0.2 و0.1 افتراضياً، وتستطيع أن تغيرها بمصفوفة في أول معامل للدالة.
وقد يتساءل البعض: لماذا GIN وليس GiST، والاثنان يدعمان tsvector؟ والإجابة في توثيق أنواع الفهارس للبحث النصي: فهرس GIN يحفظ قائمة دقيقة لكل كلمة، فالبحث فيه أسرع والنتيجة لا تحتاج إعادة فحص، والثمن أن بناءه وتحديثه أبطأ وحجمه أكبر. أما GiST فيحفظ توقيعاً تقريبياً لكل مستند، فيكون أصغر وأسرع في التحديث، ولكنه يعطي نتائج خاطئة محتملة يجب أن يعيد فحصها من الجدول، فيبطئ كثيراً مع عدد كبير من الكلمات المختلفة كما في نص عربي طويل. لذلك GIN هو الاختيار الافتراضي للبحث، وGiST لحالات خاصة يكثر فيها التحديث وتقل فيها الكلمات.
وماذا عن الكلمات الشائعة؟ الطريقة الرسمية قاموس من النوع simple أو snowball مع ملف كلمات شائعة بالخيار StopWords، كما يشرح توثيق القواميس، والملف يجب أن يكون في مجلد tsearch_data داخل مجلد تثبيت PostgreSQL على السيرفر نفسه، ولا يأتي PostgreSQL بملف للعربية. وهذا ممكن على سيرفرك، أما في قواعد البيانات المدارة Managed Databases فلا تستطيع أن تضع ملفاً في مجلد التثبيت غالباً، فيبقى الحل أن تحذف الكلمات الشائعة في دالة التوحيد نفسها أو في كود التطبيق قبل بناء السؤال.
الترتيب والتمييز: أين يذهب الوقت فعلاً؟
رأينا أن المطابقة سريعة وأن الترتيب يقرأ كل المطابقات، والآن نقيس الحالة الصعبة: كلمة في أغلب المقالات، ودالة التمييز ts_headline التي تعرض المقطع الذي فيه الكلمة مع تعليمها، وهي ما يراه المستخدم تحت كل نتيجة:
-- What ranking and highlighting cost when a word is common
\timing on
-- how many articles each query matches
SELECT q, (SELECT count(*) FROM articles WHERE fts_light @@ plainto_tsquery('simple', ar_light(q))) AS matches
FROM (VALUES ('خوارزمية'), ('مدينة'), ('في')) AS t(q);
-- 1) match only, no order: stops after 10 rows
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY ON)
SELECT id, title FROM articles
WHERE fts_light @@ plainto_tsquery('simple', ar_light('في')) LIMIT 10;
-- 2) ranked: every matching row must be read and ranked before the top 10 are known
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF)
SELECT id, title, ts_rank(fts_light, q) AS rank
FROM articles, plainto_tsquery('simple', ar_light('في')) q
WHERE fts_light @@ q ORDER BY rank DESC LIMIT 10;
-- 3) ts_rank_cd (cover density) on the same common word
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY ON)
SELECT id, title, ts_rank_cd(fts_light, q) AS rank
FROM articles, plainto_tsquery('simple', ar_light('في')) q
WHERE fts_light @@ q ORDER BY rank DESC LIMIT 10;
-- 4) the top 5 for a two-word query, rank with length normalisation (32: rank/(rank+1), 1: divide by 1+log(length))
SELECT id, title, round(ts_rank(fts_light, q, 1|32)::numeric, 4) AS rank
FROM articles, websearch_to_tsquery('simple', ar_light('خوارزمية البحث')) q
WHERE fts_light @@ q ORDER BY rank DESC LIMIT 5;
-- 5) highlighting: ts_headline on the 10 rows only, and on every matching row
SELECT id, ts_headline('simple', body, q, 'MaxFragments=1, MaxWords=18, MinWords=8, StartSel=[, StopSel=]') AS snippet
FROM (SELECT id, body, q FROM articles, websearch_to_tsquery('simple', ar_light('خوارزمية البحث')) q
      WHERE fts_light @@ q ORDER BY ts_rank(fts_light, q, 1|32) DESC LIMIT 3) top;
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY ON)
SELECT id, ts_headline('simple', body, q) FROM (
  SELECT id, body, q, ts_rank(fts_light, q) AS r FROM articles, plainto_tsquery('simple', ar_light('مدينة')) q
  WHERE fts_light @@ q ORDER BY r DESC LIMIT 10) top;
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY ON)
SELECT id, ts_headline('simple', body, q)            -- no LIMIT: the app keeps 10 and drops the rest
FROM articles, plainto_tsquery('simple', ar_light('مدينة')) q
WHERE fts_light @@ q;
والمخرج سوف يكون كما يلي:
Timing is on.
    q     | matches
----------+---------
 خوارزمية |     411
 مدينة    |   36759
 في       |  309301
(3 rows)

Time: 2236.313 ms (00:02.236)
                       QUERY PLAN
--------------------------------------------------------
 Limit (actual rows=10.00 loops=1)
   Buffers: shared hit=27 read=7
   ->  Seq Scan on articles (actual rows=10.00 loops=1)
         Filter: (fts_light @@ '''في'''::tsquery)
         Buffers: shared hit=27 read=7
 Planning:
   Buffers: shared hit=11 read=1
 Planning Time: 3.356 ms
 Execution Time: 0.343 ms
(9 rows)

Time: 14.374 ms
                                              QUERY PLAN
------------------------------------------------------------------------------------------------------
 Limit (actual time=2790.880..2850.579 rows=10.00 loops=1)
   Buffers: shared hit=814974 read=32259
   ->  Gather Merge (actual time=2790.878..2850.574 rows=10.00 loops=1)
         Workers Planned: 2
         Workers Launched: 2
         Buffers: shared hit=814974 read=32259
         ->  Sort (actual time=2762.745..2762.746 rows=8.67 loops=3)
               Sort Key: (ts_rank(articles.fts_light, '''في'''::tsquery)) DESC
               Sort Method: top-N heapsort  Memory: 27kB
               Buffers: shared hit=814974 read=32259
               Worker 0:  Sort Method: top-N heapsort  Memory: 27kB
               Worker 1:  Sort Method: top-N heapsort  Memory: 26kB
               ->  Parallel Seq Scan on articles (actual time=5.382..2636.611 rows=103100.33 loops=3)
                     Filter: (fts_light @@ '''في'''::tsquery)
                     Rows Removed by Filter: 13014
                     Buffers: shared hit=814898 read=32259
 Planning:
   Buffers: shared hit=27 read=2
 Planning Time: 0.592 ms
 Execution Time: 2850.744 ms
(20 rows)

Time: 2854.180 ms (00:02.854)
                                    QUERY PLAN
----------------------------------------------------------------------------------
 Limit (actual rows=10.00 loops=1)
   Buffers: shared hit=827343 read=19890
   ->  Gather Merge (actual rows=10.00 loops=1)
         Workers Planned: 2
         Workers Launched: 2
         Buffers: shared hit=827343 read=19890
         ->  Sort (actual rows=7.33 loops=3)
               Sort Key: (ts_rank_cd(articles.fts_light, '''في'''::tsquery)) DESC
               Sort Method: top-N heapsort  Memory: 26kB
               Buffers: shared hit=827343 read=19890
               Worker 0:  Sort Method: top-N heapsort  Memory: 27kB
               Worker 1:  Sort Method: top-N heapsort  Memory: 27kB
               ->  Parallel Seq Scan on articles (actual rows=103100.33 loops=3)
                     Filter: (fts_light @@ '''في'''::tsquery)
                     Rows Removed by Filter: 13014
                     Buffers: shared hit=827267 read=19890
 Planning:
   Buffers: shared hit=1
 Planning Time: 0.430 ms
 Execution Time: 1407.929 ms
(20 rows)

Time: 1408.818 ms (00:01.409)
   id    |        title        |  rank
---------+---------------------+--------
 5641361 | انتشار التفعيل      | 0.1146
 5956087 | البحث المتسع الاول  | 0.0996
 2462994 | الأدلة العليا       | 0.0952
 2235009 | مصفوفة (حوسبة)      | 0.0841
 5818878 | تعلم قواعد الارتباط | 0.0735
(5 rows)

Time: 4.373 ms
   id    |                        snippet
---------+--------------------------------------------------------
 5641361 | انتشار التفعيل في علم الأعصاب هي الفرضية القائلة
 5956087 | [بحث] اتساعي الأولوية / افقي الأولوية أو البحث المتوسع
 2462994 | الأدلة العليا ، في علوم الحاسب والأمثلة الرياضية، هي
(3 rows)

Time: 4.334 ms
                                           QUERY PLAN
------------------------------------------------------------------------------------------------
 Subquery Scan on top (actual rows=10.00 loops=1)
   Buffers: shared hit=126662 read=31
   ->  Limit (actual rows=10.00 loops=1)
         Buffers: shared hit=126627 read=24
         ->  Sort (actual rows=10.00 loops=1)
               Sort Key: (ts_rank(articles.fts_light, '''مدين'''::tsquery)) DESC
               Sort Method: top-N heapsort  Memory: 29kB
               Buffers: shared hit=126627 read=24
               ->  Bitmap Heap Scan on articles (actual rows=36759.00 loops=1)
                     Recheck Cond: (fts_light @@ '''مدين'''::tsquery)
                     Heap Blocks: exact=19778
                     Buffers: shared hit=126627 read=24
                     ->  Bitmap Index Scan on articles_fts_light (actual rows=36759.00 loops=1)
                           Index Cond: (fts_light @@ '''مدين'''::tsquery)
                           Index Searches: 1
                           Buffers: shared hit=2 read=11
 Planning:
   Buffers: shared hit=1
 Planning Time: 0.254 ms
 Execution Time: 317.933 ms
(20 rows)

Time: 318.646 ms
                                     QUERY PLAN
------------------------------------------------------------------------------------
 Gather (actual rows=36759.00 loops=1)
   Workers Planned: 2
   Workers Launched: 2
   Buffers: shared hit=50294 read=6178
   ->  Parallel Bitmap Heap Scan on articles (actual rows=12253.00 loops=3)
         Recheck Cond: (fts_light @@ '''مدين'''::tsquery)
         Heap Blocks: exact=6767
         Buffers: shared hit=50294 read=6178
         Worker 0:  Heap Blocks: exact=6663
         Worker 1:  Heap Blocks: exact=6348
         ->  Bitmap Index Scan on articles_fts_light (actual rows=36759.00 loops=1)
               Index Cond: (fts_light @@ '''مدين'''::tsquery)
               Index Searches: 1
               Buffers: shared hit=13
 Planning:
   Buffers: shared hit=1
 Planning Time: 0.396 ms
 Execution Time: 14220.073 ms
(18 rows)

Time: 14220.961 ms (00:14.221)
في المخرج أعلاه لاحظ التالي:
- كلمة «في» موجودة في 309,301 مقال من 348,343، أي 89% من الجدول، لأنه لا توجد قائمة كلمات شائعة. ومع هذه النسبة اختار المخطط Seq Scan وليس الفهرس، وهذا صحيح، لأن قراءة الجدول بالترتيب أرخص من قفزات الفهرس إلى أغلب الصفوف.
- أول عشر نتائج دون ترتيب أخذت 0.34 مللي ثانية، لأن البحث توقف بعد عشر، أما مع الترتيب فأخذ 2.85 ثانية مع ثلاثة معالجات بالتوازي Parallel، وقرأ أكثر من 847 ألف صفحة، لأنه حسب الدرجة لكل المقالات المطابقة. وإذا كتب المستخدم «في مدينة الرياض» فالكلمة الشائعة لا تضيف شيئاً للنتائج وتضيف هذا الوقت كله، لذلك احذف الكلمات الشائعة من السؤال قبل البحث، أو من الفهرس بقاموس Stop Words.
- الدالة
ts_rank_cd، أي كثافة التغطية Cover Density التي تعطي درجة أعلى للكلمات المتقاربة، أخذت 1.4 ثانية في نفس الحالة، والفرق بينهما هنا غالباً من عدد الصفحات التي قرئت من القرص، 19,890 بدل 32,259، وليس من الدالة نفسها. - الرقم
1|32في الاستعلام الرابع خيارات تطبيع الدرجة Normalization: الرقم 1 يقسم الدرجة على لوغاريتم طول المستند حتى لا يفوز المقال الطويل لمجرد أنه طويل، و32 يجعل الدرجة بين صفر وواحد. وأفضل النتائج لـ «خوارزمية البحث» مقالات معقولة مثل «البحث المتسع الأول» و«مصفوفة (حوسبة)». - التمييز على أفضل عشر نتائج بعد الترتيب أخذ 318 مللي ثانية، وعلى كل المطابقات قبل أن يأخذ التطبيق عشراً أخذ 14.2 ثانية. والسبب كما يقول التوثيق أن
ts_headlineلا يستخدم الtsvector، وإنما يحلل النص الأصلي من جديد لكل مستند، لذلك ضعه دائماً خارج استعلام فرعي فيهLIMIT، ولا تتركه لكود يأخذ النتائج كلها ثم يعرض أول صفحة.
ts_headline('simple', body, q) يحلل النص الأصلي بالإعداد simple دون الجذع الخفيف الذي طبقناه بدالة خارج الإعداد، فلا تطابق كلماته كلمات السؤال. وهذا ثمن التوحيد بدالة SQL بدل قاموس داخل الإعداد. والحل العملي أن تستخدم الإعداد arabic للتمييز وحده، أو أن تعلم الكلمات في كود التطبيق. والمخرج التالي من الملف 08b-headline-arabic.sql على نفس المقالات الثلاث بالإعداد arabic، وفيه علمت «البحث» و«خوارزمية» كما يجب. id | snippet
---------+---------------------------------------------------------------------------------------------------------------------------
2462994 | المستوى مصممة لإيجاد أو ابتكار أو اختيار طرق [بحث] [خوارزمية] نحصل من خلالها على حلول عالية الجودة لمسألة
5641361 | انتشار التفعيل في علم الأعصاب هي الفرضية القائلة
5956087 | [بحث] اتساعي الأولوية / افقي الأولوية أو [البحث] المتوسع والمسمى أيضا [خوارزمية] BFS هي العملية التي تقوم بالمرور المنهجي
(3 rows)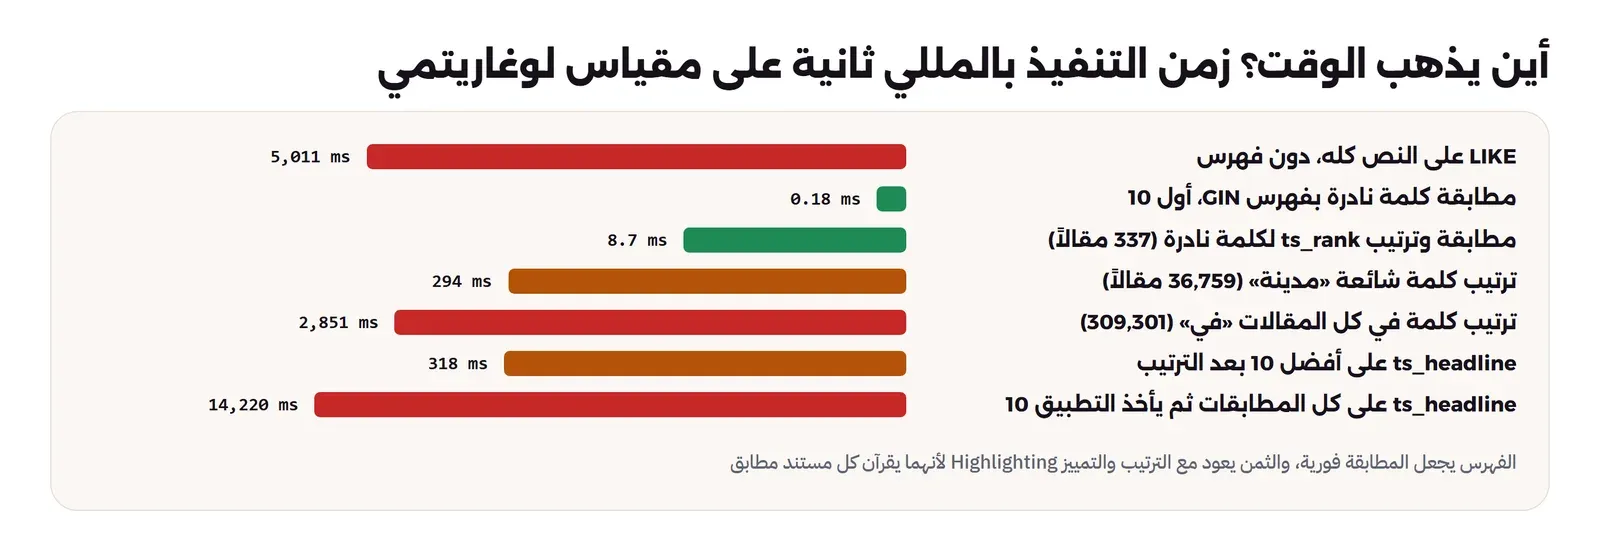
ولاحظ أن الأزمنة في هذا القسم تتغير بين تشغيل وآخر بحسب ما في الذاكرة، فقد أخذ الاستعلام الرابع نفسه 8.4 ثانية في أول تشغيل بعد VACUUM لأن الصفحات لم تكن في الذاكرة، ثم 4 مللي ثانية في التشغيل الثاني، والتشغيلان في مجلد lab/out. لذلك قس كل استعلام أكثر من مرة، وانظر إلى عدد الصفحات Buffers في الخطة قبل الزمن، لأنه لا يتغير مع حالة الذاكرة.
الأخطاء الإملائية والبحث داخل الكلمة مع pg_trgm
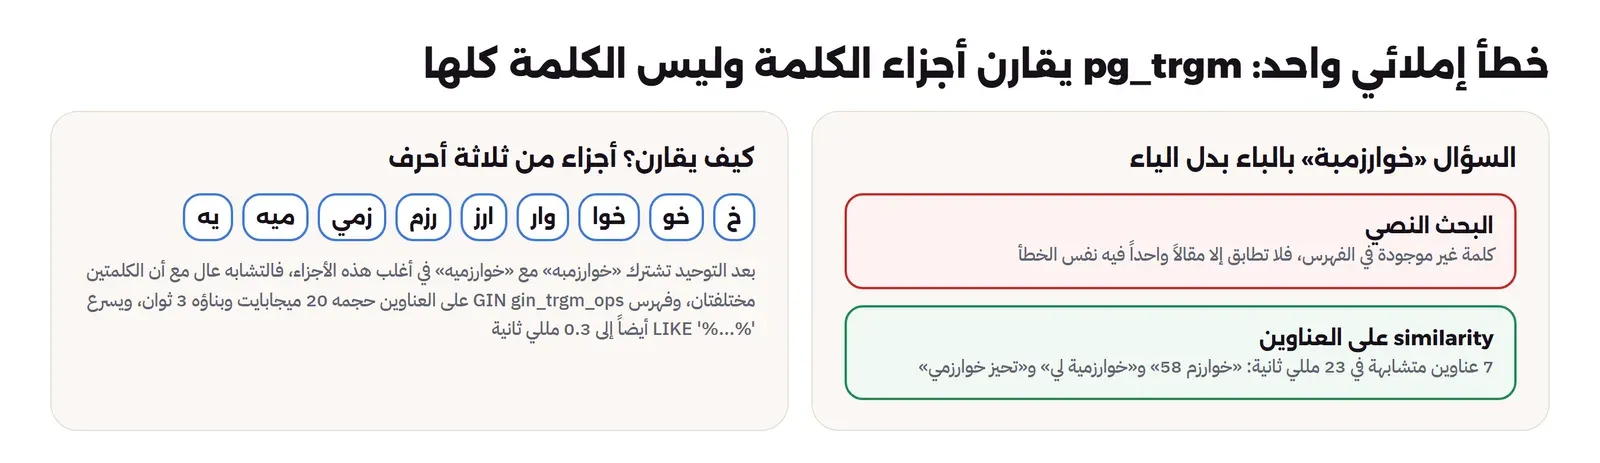
البحث النصي يطابق كلمات كاملة بعد التوحيد، فإذا كتب المستخدم «خوارزمبة» بالباء بدل الياء فلن يجد شيئاً، لأن هذه الكلمة غير موجودة في الفهرس. والإضافة pg_trgm تحل هذا بطريقة أخرى: تقسم النص إلى أجزاء من ثلاثة أحرف Trigrams، وتقيس التشابه بين نصين بنسبة الأجزاء المشتركة، فكلمتان بينهما حرف مختلف تشتركان في أغلب الأجزاء. ونبني فهرس GIN بالخيار gin_trgm_ops على العنوان بعد التوحيد:
-- Typos and substrings with pg_trgm on titles
\timing on
CREATE EXTENSION IF NOT EXISTS pg_trgm;
SELECT show_trgm('خوارزمية');
CREATE INDEX articles_title_trgm ON articles USING gin (ar_norm(title) gin_trgm_ops);
SELECT pg_size_pretty(pg_relation_size('articles_title_trgm')) AS trgm_index;
-- a typo: ب instead of ي. Full-text search finds nothing
SELECT count(*) AS fts FROM articles WHERE fts_light @@ plainto_tsquery('simple', ar_light('خوارزمبة'));
-- trigram similarity on the normalised title finds the right words
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY ON)
SELECT title FROM articles WHERE ar_norm(title) % ar_norm('خوارزمبة');
SELECT title, round(similarity(ar_norm(title), ar_norm('خوارزمبة'))::numeric, 2) AS sim
FROM articles WHERE ar_norm(title) % ar_norm('خوارزمبة')
ORDER BY sim DESC LIMIT 5;
-- a word inside a longer title: word_similarity and the <% operator
SELECT title, round(word_similarity(ar_norm('الذكاء الاصطناعى'), ar_norm(title))::numeric, 2) AS wsim
FROM articles WHERE ar_norm('الذكاء الاصطناعى') <% ar_norm(title)
ORDER BY wsim DESC, length(title) LIMIT 5;
-- LIKE '%...%' on titles can use the same index
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY ON)
SELECT title FROM articles WHERE ar_norm(title) LIKE '%خوارزميه%';
والمخرج سوف يكون كما يلي:
Timing is on.
CREATE EXTENSION
Time: 3706.273 ms (00:03.706)
                                     show_trgm
------------------------------------------------------------------------------------
 {0x8f8a35,0xb04d83,0xb9a9b0,0xff79ac,0x15fae4,0x1b2248,0x64f824,0x750691,0x7b8894}
(1 row)

Time: 0.495 ms
CREATE INDEX
Time: 3336.903 ms (00:03.337)
 trgm_index
------------
 20 MB
(1 row)

Time: 76.328 ms
 fts
-----
   1
(1 row)

Time: 3.168 ms
                                                                  QUERY PLAN
----------------------------------------------------------------------------------------------------------------------------------------------
 Bitmap Heap Scan on articles (actual rows=7.00 loops=1)
   Recheck Cond: (translate(regexp_replace(title, '[ً-ْـ]'::text, ''::text, 'g'::text), 'أإآٱىة'::text, 'اااايه'::text) % 'خوارزمبه'::text)
   Rows Removed by Index Recheck: 699
   Heap Blocks: exact=593
   Buffers: shared hit=449 read=184
   ->  Bitmap Index Scan on articles_title_trgm (actual rows=706.00 loops=1)
         Index Cond: (translate(regexp_replace(title, '[ً-ْـ]'::text, ''::text, 'g'::text), 'أإآٱىة'::text, 'اااايه'::text) % 'خوارزمبه'::text)
         Index Searches: 1
         Buffers: shared hit=40
 Planning:
   Buffers: shared hit=13 read=1
 Planning Time: 2.643 ms
 Execution Time: 23.377 ms
(13 rows)

Time: 26.429 ms
    title     | sim
--------------+------
 خوارزم 58    | 0.46
 خوارزم 60    | 0.46
 خوارزمية لي  | 0.40
 تحيز خوارزمي | 0.38
 خوارزمية CYK | 0.38
(5 rows)

Time: 19.471 ms
                     title                      | wsim
------------------------------------------------+------
 تاريخ الذكاء الاصطناعي                         | 1.00
 ديفيد فيرنون (باحث في مجال الذكاء الاصطناعي)   | 1.00
 ميخائيل كولينز (باحث في مجال الذكاء الاصطناعي) | 1.00
 الحث الاصطناعي للمناعة                         | 0.67
 مراقبة المحاصيل بالقمر الاصطناعي               | 0.67
(5 rows)

Time: 66.808 ms
                                                                   QUERY PLAN
-------------------------------------------------------------------------------------------------------------------------------------------------
 Bitmap Heap Scan on articles (actual rows=11.00 loops=1)
   Recheck Cond: (translate(regexp_replace(title, '[ً-ْـ]'::text, ''::text, 'g'::text), 'أإآٱىة'::text, 'اااايه'::text) ~~ '%خوارزميه%'::text)
   Heap Blocks: exact=11
   Buffers: shared hit=35
   ->  Bitmap Index Scan on articles_title_trgm (actual rows=11.00 loops=1)
         Index Cond: (translate(regexp_replace(title, '[ً-ْـ]'::text, ''::text, 'g'::text), 'أإآٱىة'::text, 'اااايه'::text) ~~ '%خوارزميه%'::text)
         Index Searches: 1
         Buffers: shared hit=24
 Planning:
   Buffers: shared hit=4
 Planning Time: 0.188 ms
 Execution Time: 0.317 ms
(12 rows)

Time: 0.963 ms
في المخرج أعلاه لاحظ التالي:
show_trgmيعرض الأجزاء العربية كأرقام Hash وليس كحروف، لأن pg_trgm يحفظ الجزء الذي فيه حروف خارج ASCII بهذا الشكل، وهذا لا يؤثر على عمله.- البحث النصي عن «خوارزمبة» وجد مقالاً واحداً فقط، فيه نفس الخطأ الإملائي، أما العامل
%فوجد سبعة عناوين متشابهة في 23 مللي ثانية، أولها «خوارزم 58» و«خوارزمية لي». والحد الافتراضي للتشابه 0.3، وتغيره بالإعدادpg_trgm.similarity_threshold. - الدالة
word_similarityمع العامل<%تقيس تشابه السؤال مع أفضل جزء في العنوان وليس مع العنوان كله، فوجدت «تاريخ الذكاء الاصطناعي» بدرجة 1.00 مع أن السؤال مكتوب بالألف المقصورة «الاصطناعى»، لأن الدالةar_normوحدت الحرفين. - نفس الفهرس يسرع
LIKE '%خوارزميه%'على العناوين إلى 0.3 مللي ثانية، فإذا كان كل ما تحتاجه بحثاً داخل الأسماء أو العناوين، مثل أسماء المنتجات، فقد يكفيك هذا الفهرس وحده. - حجم الفهرس على العناوين 20 ميجابايت فقط، ولكن على النص الكامل يكون أكبر من النص نفسه بعدة أضعاف، لذلك استخدم pg_trgm على الحقول القصيرة، واستخدمه كخطة ثانية عندما لا يجد البحث النصي شيئاً، كما فعلنا في مقارنة المحركات.
ماذا لو لم يطابق الاستعلام تعبير الفهرس؟ What If
الخطأ التالي من أكثر ما يحدث في الواقع: ينشئ أحد الفريق فهرساً على التعبير to_tsvector('arabic', title)، ويكتب آخر الاستعلام to_tsvector(title) دون اسم الإعداد، لأن الأمثلة في الإنترنت مكتوبة هكذا:
-- What if the query does not match the index expression? An expression index on titles, then two queries
\timing on
CREATE INDEX articles_title_fts ON articles USING gin (to_tsvector('arabic', title));
SHOW default_text_search_config;
-- the same words, written without the configuration name
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY ON)
SELECT id, title FROM articles WHERE to_tsvector(title) @@ to_tsquery('خوارزمية');
-- written exactly as the index
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY ON)
SELECT id, title FROM articles WHERE to_tsvector('arabic', title) @@ to_tsquery('arabic', 'خوارزمية');
-- and the results differ, not only the speed
SELECT (SELECT count(*) FROM articles WHERE to_tsvector(title) @@ to_tsquery('مكتبة')) AS default_config,
       (SELECT count(*) FROM articles WHERE to_tsvector('arabic', title) @@ to_tsquery('arabic', 'مكتبة')) AS arabic_config;
DROP INDEX articles_title_fts;
والمخرج سوف يكون كما يلي:
Timing is on.
CREATE INDEX
Time: 2124.878 ms (00:02.125)
 default_text_search_config
----------------------------
 pg_catalog.english
(1 row)

Time: 0.270 ms
                              QUERY PLAN
----------------------------------------------------------------------
 Gather (actual rows=10.00 loops=1)
   Workers Planned: 2
   Workers Launched: 2
   Buffers: shared hit=41016 read=24598
   ->  Parallel Seq Scan on articles (actual rows=3.33 loops=3)
         Filter: (to_tsvector(title) @@ to_tsquery('خوارزمية'::text))
         Rows Removed by Filter: 116111
         Buffers: shared hit=41016 read=24598
 Planning:
   Buffers: shared hit=137
 Planning Time: 1.060 ms
 Execution Time: 1393.535 ms
(12 rows)

Time: 1395.368 ms (00:01.395)
                                       QUERY PLAN
----------------------------------------------------------------------------------------
 Bitmap Heap Scan on articles (actual rows=18.00 loops=1)
   Recheck Cond: (to_tsvector('arabic'::regconfig, title) @@ '''خوارزم'''::tsquery)
   Heap Blocks: exact=17
   Buffers: shared hit=21
   ->  Bitmap Index Scan on articles_title_fts (actual rows=18.00 loops=1)
         Index Cond: (to_tsvector('arabic'::regconfig, title) @@ '''خوارزم'''::tsquery)
         Index Searches: 1
         Buffers: shared hit=4
 Planning:
   Buffers: shared hit=9
 Planning Time: 0.241 ms
 Execution Time: 0.096 ms
(12 rows)

Time: 0.732 ms
 default_config | arabic_config
----------------+---------------
             70 |           137
(1 row)

Time: 934.109 ms
DROP INDEX
Time: 29.069 ms
الاستعلام دون اسم الإعداد لم يستخدم الفهرس، وقرأ الجدول كله بالتوازي وحسب to_tsvector لكل عنوان، فأخذ 1.4 ثانية بدل 0.1 مللي ثانية. والسبب أن to_tsvector(title) يستخدم الإعداد الافتراضي default_text_search_config، وهو هنا english لأن هذا ما تأتي به ال Image الرسمية، فالتعبير مختلف عن تعبير الفهرس ولا يستطيع المخطط أن يستخدمه، ولأن نتيجة هذا التعبير قد تتغير إذا غير أحد الإعداد الافتراضي فلا يقبله PostgreSQL في فهرس أصلاً. والنتيجة مختلفة أيضاً وليس الزمن فقط: 70 عنواناً فيها «مكتبة» بالإعداد الإنجليزي الذي لا يعرف العربية، و137 بالإعداد العربي. لذلك اكتب اسم الإعداد في كل استدعاء، أو استخدم عموداً مولداً كما فعلنا، فالاستعلام عليه لا يحتاج تكرار التعبير.
ماذا عن الكتابة؟ الفهرس وتحديث المقالات
كل ما سبق عن القراءة، أما الكتابة فلها ثمن أيضاً. فكل INSERT أو UPDATE لمقال يعيد حساب ال tsvector كله من النص، وفي الجذع الخفيف هذا أبطأ من الجذع المدمج كما رأيت. وفهرس GIN مكلف في التحديث لأن مقالاً واحداً فيه مئات الكلمات، وكل كلمة مدخل في الفهرس، لذلك يستخدم PostgreSQL افتراضياً قائمة انتظار Pending List يضيف إليها المدخلات الجديدة بسرعة، ثم ينقلها إلى الفهرس الحقيقي دفعة واحدة عند VACUUM أو عندما تتجاوز الحد gin_pending_list_limit، كما يشرح توثيق GIN في فقرة Fast Update. والنتيجة أن الكتابة سريعة في أغلب الأوقات، وأن بعض عمليات الكتابة تتأخر فجأة عندما تقع عليها مهمة النقل، وأن البحث يقرأ القائمة كلها مع الفهرس فيبطئ إذا كبرت. فإذا كان التطبيق يكتب كثيراً ويحتاج زمن كتابة ثابتاً فاترك النقل لعملية VACUUM التلقائية واجعلها أكثر تكراراً على هذا الجدول، وإذا كانت المقالات تتغير نادراً فلا يهمك ذلك.
وهناك ميزة للبحث في قاعدة البيانات لا تجدها في أي محرك منفصل: الفهرس جزء من المعاملة Transaction، فعندما ينتهي COMMIT يكون المقال قابلاً للبحث فوراً، وإذا ألغيت المعاملة فلا يظهر أبداً، دون مزامنة ودون رسائل بين نظامين ودون حالة يكون فيها المقال محذوفاً من الجدول وموجوداً في نتائج البحث. وهذه الميزة وحدها سبب كاف لتبقى في PostgreSQL ما دامت الأرقام تسمح.
متى تنتقل إلى محرك بحث منفصل؟
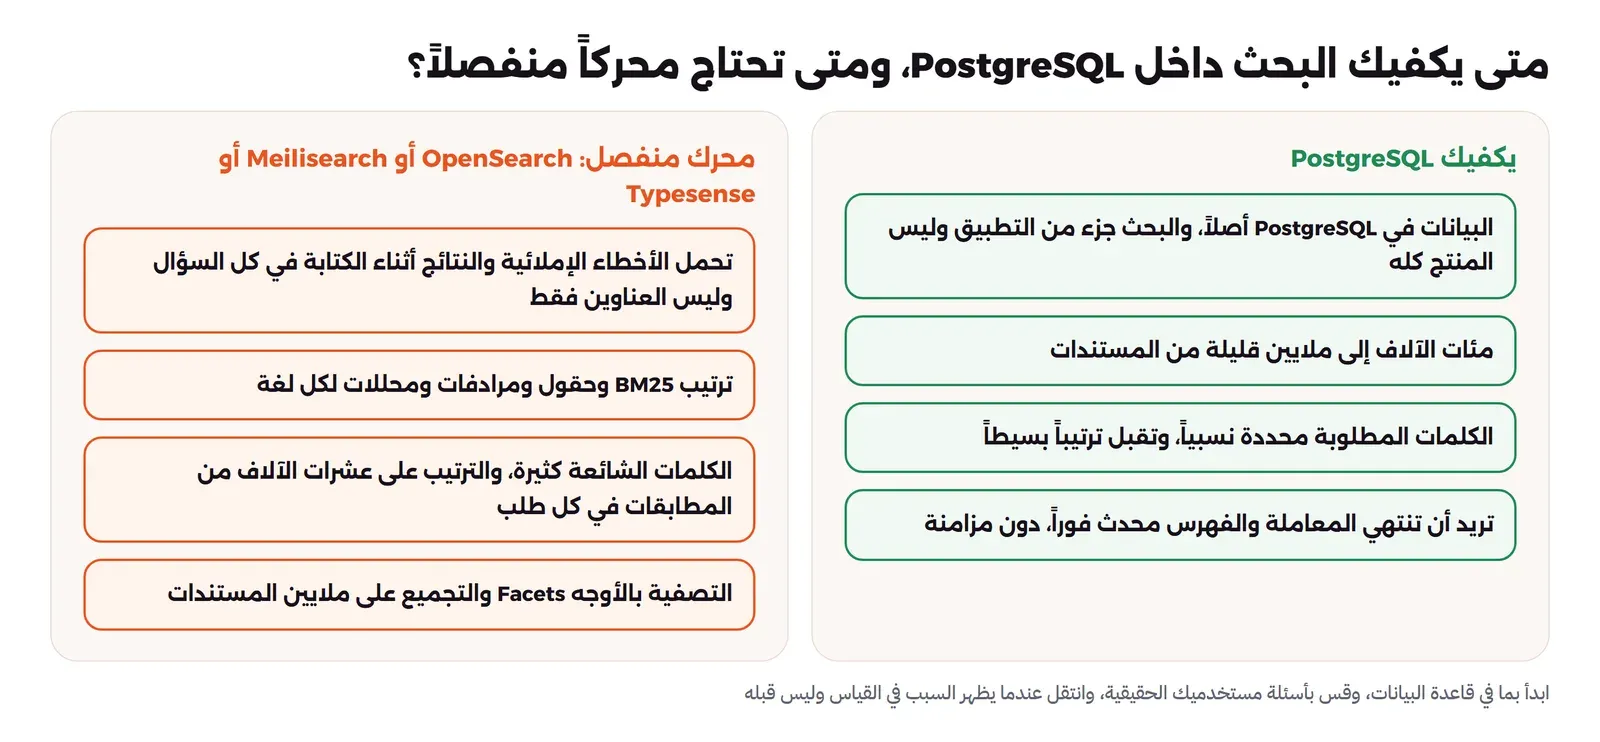
على أساس الأرقام السابقة يكفيك البحث في PostgreSQL عندما تكون البيانات فيه أصلاً، والبحث جزء من التطبيق وليس المنتج كله، والمستندات بمئات الآلاف أو ملايين قليلة، والأسئلة كلمات محددة لا تطابق عشرات الآلاف في كل مرة. وتحتاج محركاً منفصلاً مثل OpenSearch أو Meilisearch أو Typesense عندما يظهر واحد من الأسباب التالية في القياس:
- الترتيب على عدد كبير من المطابقات في كل طلب، كما رأيت مع «مدينة» و«في»، لأن المحركات ترتب بطريقة BM25 من الفهرس دون قراءة كل مستند.
- تحمل الأخطاء الإملائية في السؤال كله وفي النص الكامل، والنتائج أثناء الكتابة Search as you type، وهي جاهزة في Meilisearch وTypesense دون إعداد.
- محللات عربية أفضل ومرادفات وقواعد ترتيب لكل حقل، كما رأينا مع المحلل
arabicفي OpenSearch في مقال البحث العربي. - التصفية بالأوجه Facets، أي عدد النتائج لكل تصنيف أو سعر بجانب النتائج، على ملايين المستندات في كل طلب.
- ضغط البحث نفسه أصبح يأخذ من وقت المعالج الذي تحتاجه المعاملات الأساسية في قاعدة البيانات.
وإذا انتقلت فلا تحذف ما بنيته، فالعمود المولد والفهرس يبقيان مفيدين للبحث الإداري الداخلي، ولخطة بديلة إذا توقف المحرك. وقد قارنا المحركات الثلاثة على نفس البيانات في مقال المقارنة، وشرحنا تشغيل كل منها في دليل مستقل.
أخطاء شائعة Common Mistakes
- الإعداد الافتراضي:
to_tsvector(body)دون اسم الإعداد يستخدمenglishفي أغلب التثبيتات، فلا يستخدم الفهرس ويعطي نتائج مختلفة. - إعداد مختلف في الكتابة والسؤال: النتيجة صفر دون خطأ، لأن الكلمات في الفهرس غير الكلمات في السؤال.
- الثقة في الجذع المدمج دون قياس: «بيانات» و«البيانات» تعطيان مجموعتين مختلفتين، ولن تكتشف ذلك بتجربة كلمتين.
- to_tsquery على نص المستخدم: قوس ناقص أو علامة
&في السؤال ترمي خطأ، فاستخدمwebsearch_to_tsqueryأوplainto_tsquery. - الترتيب دون حذف الكلمات الشائعة: «في» و«من» و«على» تطابق كل الجدول، فيرتب PostgreSQL مئات الآلاف من المقالات من أجل كلمة لا تفيد.
- ts_headline قبل LIMIT: يحلل النص الكامل لكل مطابقة، ورأيت الفرق بين 318 مللي ثانية و14 ثانية.
- إضافة العمود المولد بأمر واحد على جدول في الإنتاج: يعيد كتابة الجدول ويقفله دقائق.
- تغيير دالة التوحيد دون إعادة الحساب: الدالة IMMUTABLE وعد بأن نتيجتها لا تتغير، فإذا غيرتها بقيت المقالات القديمة بكلماتها القديمة.
- pg_trgm على النص الكامل: فهرس أكبر من البيانات بأضعاف، فاجعله على العناوين والأسماء.
قائمة تحقق Checklist
- عمود
tsvectorمولد بأوزان للحقول، وفهرس GIN عليه، واسم الإعداد مكتوب في كل مكان. - جربت الإعداد على كلمات مستخدميك الحقيقية بالدالتين
ts_debugوts_lexize، وعرفت أين يخطئ الجذع. - عندي قائمة أسئلة حقيقية مع النتائج المتوقعة، وأقيس عليها كل تغيير في الجذع أو التوحيد.
- السؤال يمر بنفس التوحيد الذي مر به النص، بدالة واحدة مشتركة.
websearch_to_tsqueryلنص المستخدم، والكلمات الشائعة تحذف قبل البحث.- الترتيب بخيارات تطبيع مناسبة، و
ts_headlineبعدLIMIT. - pg_trgm على العناوين كخطة ثانية للأخطاء الإملائية.
- أراقب زمن استعلام البحث في
pg_stat_statements، وأعرف الأسئلة التي تطابق عشرات الآلاف. - أعرف الأرقام التي تجعلني أنتقل إلى محرك منفصل، وأقيسها قبل أن أنتقل.
حذف المختبر Cleanup
docker rm -f sw4-fts-pg
docker rmi sw4-postgres:18.6
rm -rf data
ماذا تقرأ بعد ذلك؟ Next Steps
إذا كفاك PostgreSQL فقد انتهيت، وإذا ظهر في القياس سبب للانتقال فهذه المقالات تكمل الطريق: محركات البحث المنفصلة وتشغيلها، والمقارنة بينها على النص العربي، والبحث الدلالي بالمتجهات عندما لا تكفي الكلمات أصلاً.
 دليلكيف يعمل البحث؟ الفهرس المعكوس Inverted Index وترتيب النتائجلماذا لا يكفي LIKE للبحث في تطبيقك، وكيف يجد محرك البحث الكلمات في جزء من الثانية ويرتب أهم النتائج في الأعلى.
 دليلالبحث في النصوص العربية مع OpenSearch وMeilisearchلماذا يرجع البحث صفحة فارغة لمن يكتب «مستشفي» أو «اجازه»، وكيف تضبط محركك حتى يجد الكلمة بكل أشكالها.
 دليلMeilisearch: مربع بحث فوري داخل تطبيقككيف تشغل Meilisearch على سيرفرك بمفاتيح محدودة لكل مستخدم ونسخ احتياطي تسترجعه، وتضبطه حتى يفهم النص العربي.
 دليلOpenSearch: البديل المفتوح لـ Elasticsearch وقصة الترخيصلماذا ولد OpenSearch من Elasticsearch، وكيف تشغله على سيرفرك بصلاحيات دقيقة وتنبيهات حقيقية على سجلاتك.
 دليلTypesense: بحث سريع يتحمل الأخطاء الإملائيةكيف تبني على Typesense بحثاً يتحمل الأخطاء ويفهم العربية، وتشغله في عنقود من ثلاث عقد يستمر إذا سقطت إحداها.
 دليلأي محرك بحث يناسب تطبيقك ونصوصك العربية؟قارنا أربعة محركات بحث على الأسئلة العربية نفسها في جودة النتائج والذاكرة والسرعة والرخصة، لتعرف أيها يناسب حالتك.
 دليلالبحث الدلالي Semantic Search بالـ Embeddingsمتى يتفوق البحث بالمعنى على البحث بالكلمات في النص العربي، وكيف تقيس ذلك على أسئلتك قبل أن تختار.
 دليلتعديل الجداول Schema Migrations دون توقف الخدمةكيف تعدل جداول PostgreSQL والتطبيق يعمل، مقاساً على عشرة ملايين صف وتطبيق يرسل مئات الطلبات في الثانية، من طابور الأقفال إلى تحويل المفتاح الأساسي إلى bigint.
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- البحث النصي في PostgreSQL يحول النص إلى كلمات موحدة بالمحلل والقواميس، ويحفظها في
tsvectorعليه فهرس GIN، والسؤال يمر بنفس الإعداد ليصبحtsquery. - على 348 ألف مقال عربي نزل البحث عن كلمة من خمس ثوان مع LIKE إلى أقل من مللي ثانية مع الفهرس، ووجد 337 مقالاً بدل 200 لأنه جمع أشكال الكلمة.
- الإعداد
arabicيوحد الهمزات والحركات جيداً، ولكن جذعه غير متسق: «بيانات» و«البيانات» وجدتا 13,853 و2,402 مقالاً مختلفاً، والجذع الخفيف بلغة SQL وحدهما في 15,576، وأضاف أخطاء أخرى مثل «لبنان» التي صارت «لبن». - المطابقة رخيصة، والترتيب والتمييز يقرآن كل المطابقات: 2.85 ثانية لترتيب كلمة في كل المقالات، و14 ثانية لتمييز كل المطابقات بدل 318 مللي ثانية بعد LIMIT.
- pg_trgm يحل الأخطاء الإملائية والبحث داخل الكلمة على الحقول القصيرة بفهرس صغير.
- اكتب اسم الإعداد في كل استدعاء، فدونه يختفي الفهرس وتتغير النتائج.
- ابق في PostgreSQL ما دامت الأرقام تسمح، لأن الفهرس جزء من المعاملة، وانتقل إلى محرك منفصل عندما يظهر في القياس الترتيب على مطابقات كثيرة أو حاجة لتحمل الأخطاء والمرادفات في كل السؤال.
سجل التحديثات Changelog
- 18 نوفمبر 2026: كتابة المقال، وتنفيذ التجارب على Docker Engine 29.8.0 مع PostgreSQL 18.6 (postgres:18.6) و348,343 مقالاً من ويكيبيديا العربية (wikimedia/wikipedia، نسخة 20231101.ar، الملفان 1 و4 من 7).