يحتوي النشر الجديد على ملف ترحيل Migration من سطر واحد يضيف عموداً إلى جدول الطلبات، وقد شغلته على جهازك فانتهى في جزء من الثانية، ومر في بيئة الاختبار دون مشكلة. وفي الإنتاج يبدأ النشر في منتصف النهار، وبعد ثوان تبدأ التنبيهات: الصفحات لا ترد، ومجموعة الاتصالات Connection Pool ممتلئة، وكل طلب ينتظر. ثم يعود كل شيء وحده بعد دقيقة، ويكتب أحد الفريق في القناة: «لا أعرف ماذا حدث، ولكنه عاد». وما حدث أن الأمر احتاج قفلاً على الجدول كله، فانتظر تقريراً طويلاً كان مفتوحاً، ووقف خلفه كل طلب جاء بعده، أو أن الأمر نفسه كان يعيد كتابة الجدول كله وهو مقفل، أو أنه أضاف قيداً يقرأ عشرة ملايين صف قبل أن يسمح لأحد بالكتابة.
وقد شرحنا طابور الأقفال Lock Queue الذي يسبب أغلب هذه الحالات وقرأنا pg_locks بالتفصيل في مقال الأقفال، وعرضنا فكرة التوسيع ثم التقليص Expand / Contract على مثال صغير في مقال تصميم قواعد البيانات، ورأينا كيف حول توليد الترحيل التلقائي في Alembic إعادة تسمية عمود إلى حذف بيانات في مقال ORM. وهذا المقال يجمع ذلك في طريقة عمل كاملة لتعديل مخطط قاعدة البيانات Schema في PostgreSQL والتطبيق يعمل: ما الذي يقفله كل أمر، وكيف تقيس أثره على التطبيق قبل أن تنشره، وكيف تنفذ أصعب التغييرات خطوة بخطوة، وكل ذلك على جدول فيه عشرة ملايين طلب وتطبيق يقرأ ويكتب فيه طوال التجربة.
وسوف نناقش في هذا المقال ما يلي:
- لماذا يوقف تعديل صغير تطبيقاً كاملاً: مستوى القفل، ومدة الأمر، وطابور الأقفال.
- جدول بالأوامر الشائعة والقفل الذي يأخذه كل منها، وأي منها يعيد كتابة الجدول.
- تجربة عملية تشغل كل تغيير وتطبيق وهمي يرسل مئات الطلبات في الثانية، وتطبع ما شعر به التطبيق في كل ثانية وما كان ينتظره.
- طابور الأقفال مع
lock_timeoutوإعادة المحاولة، وNOT NULL بقيد CHECK من نوع NOT VALID، والفهرس CONCURRENTLY وما يتركه عندما يفشل. - ملء الأعمدة على دفعات Backfill: لماذا لا يكفي تقسيم العمل، وما الذي ينتظره التطبيق فعلاً.
- أصعب تغيير: تحويل المفتاح الأساسي من
integerإلىbigintبالتوسيع ثم التقليص، ومشكلة ظهرت في التجربة أوقفت التطبيق بعد الترحيل لا أثناءه. - إعادة التسمية عبر نسخ المخطط بال Views مع pgroll، وما تفعله أدوات الترحيل Alembic وFlyway وsqitch وما لا تفعله.
لماذا يوقف تعديل صغير تطبيقاً كاملاً؟
كل أمر يغير شكل جدول في PostgreSQL يحتاج قفلاً على الجدول، والأقفال لها مستويات، وأعلاها ACCESS EXCLUSIVE الذي لا يتفق مع أي قفل آخر، حتى قفل القراءة البسيط الذي يأخذه أي SELECT، كما يبين جدول الأقفال في التوثيق. وأغلب أوامر ALTER TABLE تأخذ هذا القفل، وهذا منطقي، فلا يستطيع أحد أن يقرأ صفاً بينما يتغير تعريف أعمدته. ولذلك يتحدد أثر أي تعديل على التطبيق بثلاثة أشياء:
- مستوى القفل: هل يمنع القراءة والكتابة معاً، أم الكتابة فقط، أم لا يمنع شيئاً من عمل التطبيق العادي، مثل SHARE UPDATE EXCLUSIVE الذي يأخذه VALIDATE وCREATE INDEX CONCURRENTLY.
- مدة الأمر وهو يمسك القفل: إضافة عمود دون قيمة افتراضية تغير تعريف الجدول فقط، فتنتهي في أجزاء من الثانية مهما كان حجمه، أما تغيير نوع عمود فيعيد كتابة كل صف وكل فهرس، وSET NOT NULL يقرأ الجدول كله ليتأكد أنه لا يوجد NULL، وهذا كله والقفل ممسوك.
- وقت الانتظار قبل أن يحصل على القفل: الأمر الذي ينتهي في مللي ثانية قد ينتظر دقائق إذا كانت هناك معاملة مفتوحة تقرأ الجدول، وكل استعلام يأتي بعده يقف خلفه في الطابور، حتى القراءات التي لا تتعارض مع المعاملة المفتوحة، لأنها تتعارض مع القفل المنتظر.
والصورة التالية تجمع أشهر الأوامر وأثرها، وهي ملخص لما يقوله توثيق ALTER TABLE عن كل نوع، وسوف نقيس أغلبها في التجربة:
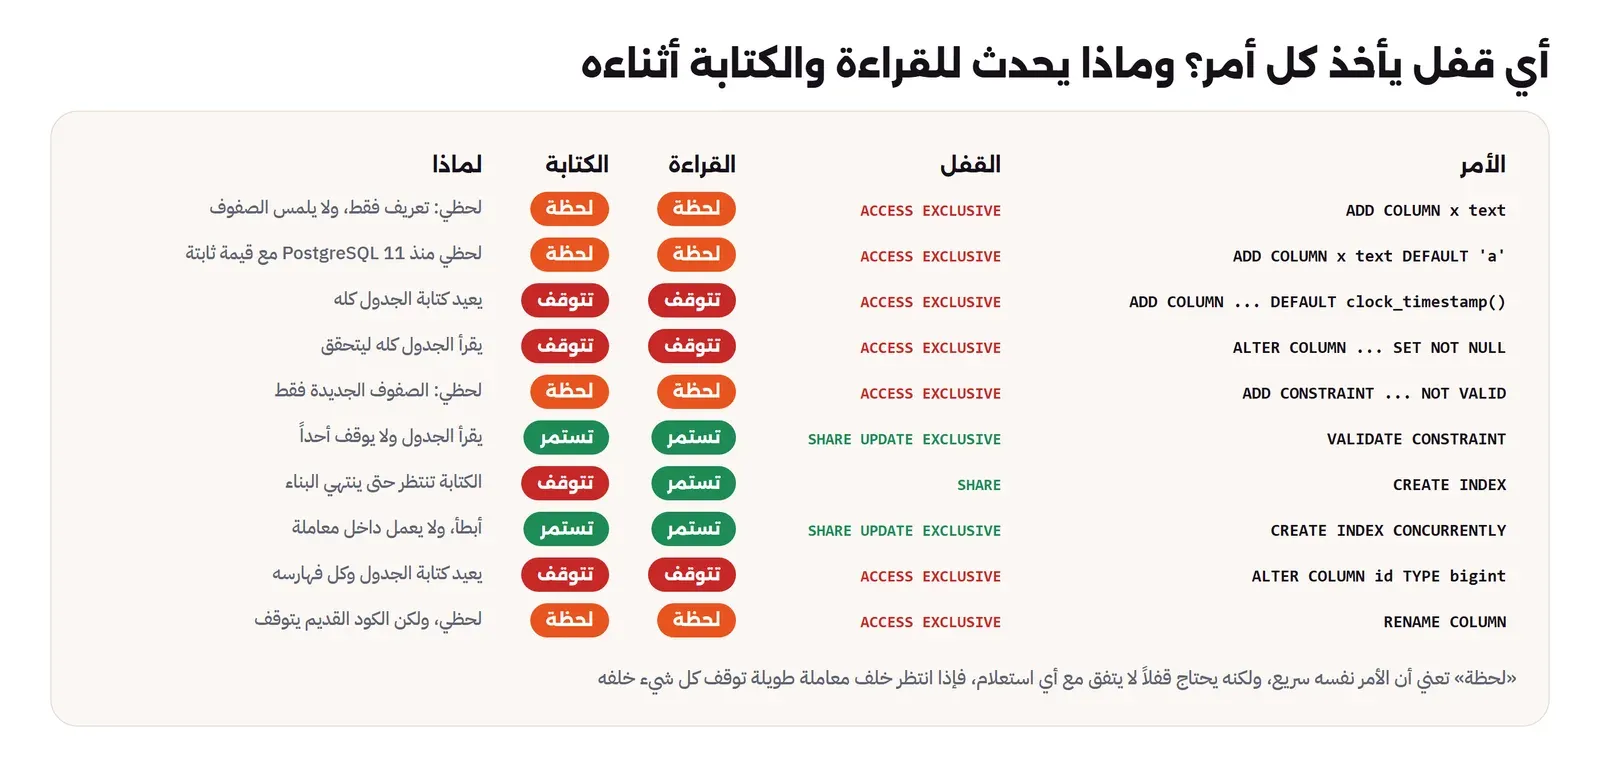
ولاحظ أن «لحظي» لا تعني «آمن»، فكل الأوامر اللحظية في الجدول تحتاج ACCESS EXCLUSIVE ولو لمللي ثانية، فإذا لم تحصل عليه فوراً وقفت في الطابور وأوقفت كل شيء خلفها، وهذا ما حدث لفريق GoCardless.
lock_timeout في سكربتات الترحيل بمقدار ما يتحمله التطبيق، لأن إلغاء النشر أفضل من إيقاف التطبيق.تجربة عملية Lab: عشرة ملايين طلب وتطبيق لا يتوقف
الطريقة الوحيدة لتعرف أثر ترحيل على التطبيق هي أن تشغله والتطبيق يعمل وتقيس، وهذا ما تفعله التجربة: جدول طلبات فيه عشرة ملايين صف، و«تطبيق» من ثمانية خيوط Threads يرسل كل منها طلباً كل خمسة مللي ثوان تقريباً: 70% قراءة طلب بمعرفه، و20% تعديل حالة طلب، و10% إضافة طلب جديد. ثم ننفذ الترحيل في نفس الوقت، ونطبع لكل ثانية عدد الطلبات التي اكتملت، وأبطأ طلب، وأكثر شيء كانت جلسات التطبيق تنتظره في تلك الثانية من العمود wait_event في pg_stat_activity. وكل الملفات في مجلد lab مع المقال.
التجهيز Setup
الملف compose.yaml فيه سيرفر PostgreSQL 18.6 مع تسجيل انتظار الأقفال، وContainer أدوات فيه Python وpsql وAlembic وpgroll:
# Zero-downtime migrations lab: PostgreSQL 18.6 and a tools container (Python load generator, Alembic, pgroll).
name: sw4-mig

services:
  pg:
    image: sw4-postgres:18.6              # tag of postgres:18.6
    container_name: sw4-mig-pg
    environment:
      POSTGRES_PASSWORD: lab
      POSTGRES_DB: shop
    command: >
      postgres -c shared_buffers=512MB -c max_wal_size=4GB
               -c log_lock_waits=on -c deadlock_timeout=1s
    shm_size: 512m

  tools:
    image: sw4-miglab
    container_name: sw4-mig-tools
    command: ["sleep", "infinity"]
    environment:
      DSN: postgresql://postgres:lab@pg:5432/shop
      PGHOST: pg
      PGUSER: postgres
      PGPASSWORD: lab
      PGDATABASE: shop
FROM sw4-python:3.13.18-slim
RUN apt-get update && apt-get install -y --no-install-recommends postgresql-client && rm -rf /var/lib/apt/lists/*
RUN pip install --no-cache-dir "psycopg[binary]==3.3.9" alembic==1.20.1 sqlalchemy==2.1.9
RUN python -c "import urllib.request; urllib.request.urlretrieve('https://github.com/xataio/pgroll/releases/download/v0.16.3/pgroll.linux.amd64', '/usr/local/bin/pgroll')" \
&& chmod +x /usr/local/bin/pgroll
WORKDIR /lab
COPY *.py *.sql ./
ENV PYTHONUNBUFFERED=1والجدول في الملف schema.sql، والمفتاح الأساسي فيه serial أي integer، كما تبدأ جداول كثيرة قبل أن يفكر أحد في حجمها بعد سنوات:
-- 10 million orders; id is a plain integer, as many tables started years ago
DROP TABLE IF EXISTS orders CASCADE;
CREATE TABLE orders (
    id          serial PRIMARY KEY,
    customer_id int NOT NULL,
    status      text NOT NULL DEFAULT 'new',
    total       numeric(10,2) NOT NULL,
    created_at  timestamptz NOT NULL DEFAULT now()
);
INSERT INTO orders (customer_id, status, total, created_at)
SELECT 1 + g % 50000,
       (ARRAY['new','paid','shipped','delivered'])[1 + g % 4],
       (g % 900) + 0.99,
       now() - make_interval(mins => g % 500000)
FROM generate_series(1, 10000000) g;
VACUUM ANALYZE orders;
SELECT count(*) AS orders, pg_size_pretty(pg_total_relation_size('orders')) AS size FROM orders;
docker pull postgres:18.6 && docker tag postgres:18.6 sw4-postgres:18.6
docker pull python:3.13.18-slim && docker tag python:3.13.18-slim sw4-python:3.13.18-slim
docker build -t sw4-miglab . && docker compose up -d
docker exec sw4-mig-tools psql -f /lab/schema.sqlوالمخرج سوف يكون كما يلي:
 orders  |  size
----------+--------
 10000000 | 811 MB
(1 row)
والملف lab.py فيه التطبيق الوهمي والمراقب وكل التجارب، وكل تجربة دالة صغيرة في scenario. ولاحظ أن خيوط التطبيق تستخدم prepare_threshold الافتراضي في psycopg، أي أن المكتبة تحول الاستعلام إلى Prepared Statement بعد أن يتكرر خمس مرات، وهذا سلوك أغلب مكتبات الاتصال الحديثة، وسوف يكون له دور في آخر التجربة:
# Runs a migration while an "app" keeps reading and writing orders, then prints what the app felt each second.
#   python lab.py <scenario>
#   scenarios: lockqueue, lockqueue-timeout, notnull, index, backfill, bigint-naive, bigint-online
import os, random, sys, threading, time
import psycopg

DSN = os.environ["DSN"]
T0 = time.time()
samples = []                     # (second, latency ms, ok)
waits = {}                       # second -> {wait event: count} for app sessions that are not running
events = []                      # (second, text)
lock = threading.Lock()
stop = threading.Event()


def now():
    return time.time() - T0


def event(text):
    with lock:
        events.append((now(), text))
    print(f"[{now():5.1f}s] {text}", flush=True)


def app_worker():
    """One app server thread: 70% reads by id, 20% updates, 10% inserts, every ~5 ms."""
    # psycopg prepares a statement after 5 executions; APP_PREPARE=off turns that off (prepare_threshold=None)
    prepare = None if os.environ.get("APP_PREPARE") == "off" else 5
    conn = psycopg.connect(DSN, autocommit=True, prepare_threshold=prepare, application_name="app")
    max_id = conn.execute("SELECT max(id) FROM orders").fetchone()[0]
    while not stop.is_set():
        r, oid = random.random(), random.randint(1, max_id)
        t = time.time()
        ok = True
        try:
            if r < 0.7:
                conn.execute("SELECT id, status, total FROM orders WHERE id = %s", (oid,)).fetchone()
            elif r < 0.9:
                conn.execute("UPDATE orders SET status = 'paid' WHERE id = %s", (oid,))
            else:
                conn.execute("INSERT INTO orders (customer_id, total) VALUES (%s, 10.5)", (oid % 50000 + 1,))
        except psycopg.Error as e:
            ok = False
            event(f"app error: {type(e).__name__}: {str(e).splitlines()[0]}")
        with lock:
            samples.append((int(t - T0), (time.time() - t) * 1000, ok))
        time.sleep(0.005)
    conn.close()


def wait_sampler():
    """Every 0.25 s: what are the app's sessions waiting for? (Lock, LWLock:WALWrite, IO:WalSync ...)"""
    c = psycopg.connect(DSN, autocommit=True)
    while not stop.is_set():
        rows = c.execute("""SELECT wait_event_type || ':' || wait_event FROM pg_stat_activity
                            WHERE backend_type = 'client backend' AND state = 'active' AND wait_event IS NOT NULL
                              AND application_name = 'app'""").fetchall()
        sec = int(now())
        with lock:
            for (w,) in rows:
                waits.setdefault(sec, {}).setdefault(w, 0)
                waits[sec][w] += 1
        time.sleep(0.25)


def report():
    print(f"\n{'sec':>4} {'ops':>5} {'errors':>6} {'max ms':>8}  {'app waits on':<22} events")
    by = {}
    for s, ms, ok in samples:
        b = by.setdefault(s, [0, 0, 0.0])
        b[0] += 1
        b[1] += 0 if ok else 1
        b[2] = max(b[2], ms)
    for s in range(0, max(by) + 1):
        ops, err, mx = by.get(s, [0, 0, 0.0])
        ev = "; ".join(t for es, t in events if int(es) == s and not t.startswith("app error"))
        w = waits.get(s)
        top = max(w, key=w.get) if w else ""
        print(f"{s:>4} {ops:>5} {err:>6} {mx:>8.0f}  {top:<22} {ev}")
    lat = sorted(ms for _, ms, _ in samples)
    print(f"requests: {len(lat)}, errors: {sum(1 for *_, ok in samples if not ok)}, "
          f"p50 {lat[len(lat) // 2]:.1f} ms, p99 {lat[int(len(lat) * 0.99)]:.0f} ms, max {lat[-1]:.0f} ms")


def sql(conn, q, label=None):
    t = time.time()
    event(f"start: {label or q}")
    conn.execute(q)
    event(f"done in {time.time() - t:.2f}s: {label or q}")


def show_locks(conn):
    rows = conn.execute("""
        SELECT a.pid, l.mode, l.granted, pg_blocking_pids(a.pid) AS blocked_by, left(a.query, 48) AS query
        FROM pg_locks l JOIN pg_stat_activity a ON a.pid = l.pid
        WHERE l.relation = 'orders'::regclass
        ORDER BY l.granted DESC, a.query_start LIMIT 8""").fetchall()
    print(f"{'pid':>6} {'mode':<20} {'granted':<8} {'blocked_by':<12} query")
    for pid, mode, granted, by, q in rows:
        print(f"{pid:>6} {mode:<20} {str(granted):<8} {str(by):<12} {q}")


def long_report(seconds):
    """An analyst's report: reads orders in a transaction and keeps it open."""
    c = psycopg.connect(DSN)
    event(f"report: BEGIN; SELECT count(*) FROM orders; (open for {seconds}s)")
    c.execute("SELECT count(*) FROM orders").fetchone()
    time.sleep(seconds)
    c.commit()
    event("report: COMMIT")
    c.close()


def scenario(name, mig, watcher):
    if name in ("lockqueue", "lockqueue-timeout"):
        threading.Thread(target=long_report, args=(12,)).start()
        time.sleep(3)
        if name == "lockqueue":
            threading.Thread(target=lambda: sql(mig, "ALTER TABLE orders ADD COLUMN note text")).start()
            time.sleep(3)
            show_locks(watcher)
        else:
            mig.execute("SET lock_timeout = '1s'")
            for attempt in range(1, 20):
                try:
                    sql(mig, "ALTER TABLE orders ADD COLUMN note text", f"ALTER ... ADD COLUMN note (attempt {attempt})")
                    break
                except psycopg.errors.LockNotAvailable:
                    wait = min(8, 0.5 * 2 ** attempt) * random.uniform(0.5, 1)
                    event(f"lock_timeout, retry in {wait:.1f}s")
                    time.sleep(wait)
        time.sleep(12)
        mig.execute("ALTER TABLE orders DROP COLUMN IF EXISTS note")
    elif name == "notnull":
        sql(mig, "ALTER TABLE orders ALTER COLUMN customer_id DROP NOT NULL", "setup: DROP NOT NULL")
        time.sleep(2)
        sql(mig, "ALTER TABLE orders ALTER COLUMN customer_id SET NOT NULL", "A: SET NOT NULL")
        time.sleep(3)
        sql(mig, "ALTER TABLE orders ALTER COLUMN customer_id DROP NOT NULL", "reset: DROP NOT NULL")
        time.sleep(2)
        sql(mig, "ALTER TABLE orders ADD CONSTRAINT customer_nn CHECK (customer_id IS NOT NULL) NOT VALID",
            "B1: ADD CHECK ... NOT VALID")
        sql(mig, "ALTER TABLE orders VALIDATE CONSTRAINT customer_nn", "B2: VALIDATE CONSTRAINT")
        sql(mig, "ALTER TABLE orders ALTER COLUMN customer_id SET NOT NULL", "B3: SET NOT NULL")
        sql(mig, "ALTER TABLE orders DROP CONSTRAINT customer_nn", "B4: DROP CONSTRAINT")
        time.sleep(3)
    elif name == "index":
        time.sleep(2)
        sql(mig, "CREATE INDEX orders_customer ON orders (customer_id)", "A: CREATE INDEX")
        time.sleep(2)
        sql(mig, "DROP INDEX orders_customer")
        time.sleep(2)
        sql(mig, "CREATE INDEX CONCURRENTLY orders_customer ON orders (customer_id)", "B: CREATE INDEX CONCURRENTLY")
        time.sleep(2)
        try:
            sql(mig, "CREATE UNIQUE INDEX CONCURRENTLY orders_customer_uq ON orders (customer_id)",
                "C: CREATE UNIQUE INDEX CONCURRENTLY")
        except psycopg.Error as e:
            event(f"failed: {str(e).splitlines()[0]}")
        for r in mig.execute("""SELECT c.relname, i.indisvalid, i.indisready, pg_size_pretty(pg_relation_size(c.oid))
                                FROM pg_index i JOIN pg_class c ON c.oid = i.indexrelid
                                WHERE i.indrelid = 'orders'::regclass ORDER BY 1"""):
            print("   index:", r)
        sql(mig, "DROP INDEX CONCURRENTLY orders_customer_uq")
        sql(mig, "DROP INDEX orders_customer")
        time.sleep(2)
    elif name == "backfill-one":
        mig.execute("ALTER TABLE orders DROP COLUMN IF EXISTS total_cents")
        mig.execute("VACUUM orders")
        sql(mig, "ALTER TABLE orders ADD COLUMN total_cents bigint")
        sql(mig, "UPDATE orders SET total_cents = total * 100", "A: one UPDATE for all rows")
        time.sleep(3)
    elif name == "backfill":
        mig.execute("ALTER TABLE orders DROP COLUMN IF EXISTS total_cents")
        sql(mig, "ALTER TABLE orders ADD COLUMN total_cents bigint")
        lsn0 = mig.execute("SELECT pg_current_wal_lsn()").fetchone()[0]
        sql(mig, "UPDATE orders SET total_cents = total * 100", "A: one UPDATE for all rows")
        lsn1 = mig.execute("SELECT pg_current_wal_lsn()").fetchone()[0]
        print("   WAL:", mig.execute("SELECT pg_size_pretty(pg_wal_lsn_diff(%s, %s))", (lsn1, lsn0)).fetchone()[0])
        time.sleep(3)
        mig.execute("ALTER TABLE orders DROP COLUMN total_cents")
        mig.execute("ALTER TABLE orders ADD COLUMN total_cents bigint")
        event("B: batches of 10,000 ids, autocommit after each")
        t, batch, last = time.time(), 10000, 0
        top = mig.execute("SELECT max(id) FROM orders").fetchone()[0]
        lsn0 = mig.execute("SELECT pg_current_wal_lsn()").fetchone()[0]
        while last < top:
            mig.execute("UPDATE orders SET total_cents = total * 100 WHERE id > %s AND id <= %s", (last, last + batch))
            last += batch
        lsn1 = mig.execute("SELECT pg_current_wal_lsn()").fetchone()[0]
        event(f"B done in {time.time() - t:.1f}s")
        print("   WAL:", mig.execute("SELECT pg_size_pretty(pg_wal_lsn_diff(%s, %s))", (lsn1, lsn0)).fetchone()[0])
        time.sleep(3)
    elif name == "backfill-throttle":
        # the same batches, a pause after each, and a sampler of what the app sessions wait for
        mig.execute("ALTER TABLE orders DROP COLUMN IF EXISTS total_cents")
        mig.execute("VACUUM orders")
        mig.execute("ALTER TABLE orders ADD COLUMN total_cents bigint")
        waits = {}

        def sampler():
            c = psycopg.connect(DSN, autocommit=True)
            while not stop.is_set() and not done.is_set():
                for w, n in c.execute("""SELECT coalesce(wait_event_type || ':' || wait_event, 'CPU'), count(*)
                                         FROM pg_stat_activity WHERE backend_type = 'client backend'
                                           AND state = 'active' AND pid <> pg_backend_pid()
                                           AND query NOT LIKE 'UPDATE orders SET total_cents%%' GROUP BY 1"""):
                    waits[w] = waits.get(w, 0) + n
                time.sleep(0.5)
        done = threading.Event()
        threading.Thread(target=sampler, daemon=True).start()
        event("C: batches of 10,000 ids, 0.2 s pause after each")
        t, batch, last = time.time(), 10000, 0
        top = mig.execute("SELECT max(id) FROM orders").fetchone()[0]
        lsn0 = mig.execute("SELECT pg_current_wal_lsn()").fetchone()[0]
        while last < top:
            mig.execute("UPDATE orders SET total_cents = total * 100 WHERE id > %s AND id <= %s", (last, last + batch))
            last += batch
            time.sleep(0.2)
        lsn1 = mig.execute("SELECT pg_current_wal_lsn()").fetchone()[0]
        done.set()
        event(f"C done in {time.time() - t:.1f}s")
        print("   WAL:", mig.execute("SELECT pg_size_pretty(pg_wal_lsn_diff(%s, %s))", (lsn1, lsn0)).fetchone()[0])
        print("   app sessions seen waiting on:", dict(sorted(waits.items(), key=lambda x: -x[1])[:6]))
        time.sleep(3)
    elif name == "backfill-small":
        # smaller batches sized by WAL, on the first 2 million ids: does the app still wait on WAL?
        mig.execute("ALTER TABLE orders DROP COLUMN IF EXISTS total_cents")
        mig.execute("ALTER TABLE orders ADD COLUMN total_cents bigint")
        mig.execute("VACUUM orders")
        event("D: batches of 1,000 ids, 0.05 s pause after each, ids 1 to 2,000,000")
        t, batch, last = time.time(), 1000, 0
        lsn0 = mig.execute("SELECT pg_current_wal_lsn()").fetchone()[0]
        while last < 2000000:
            mig.execute("UPDATE orders SET total_cents = total * 100 WHERE id > %s AND id <= %s", (last, last + batch))
            last += batch
            time.sleep(0.05)
        lsn1 = mig.execute("SELECT pg_current_wal_lsn()").fetchone()[0]
        event(f"D done in {time.time() - t:.1f}s")
        print("   WAL:", mig.execute("SELECT pg_size_pretty(pg_wal_lsn_diff(%s, %s))", (lsn1, lsn0)).fetchone()[0])
        time.sleep(3)
    elif name == "bigint-naive":
        time.sleep(2)
        sql(mig, "ALTER TABLE orders ALTER COLUMN id TYPE bigint", "ALTER COLUMN id TYPE bigint")
        time.sleep(3)
    elif name == "bigint-online":
        import bigint_online
        bigint_online.run(mig, sql, event)
        time.sleep(3)


if __name__ == "__main__":
    name = sys.argv[1]
    mig = psycopg.connect(DSN, autocommit=True)
    watcher = psycopg.connect(DSN, autocommit=True)
    app = [threading.Thread(target=app_worker) for _ in range(8)] + [threading.Thread(target=wait_sampler)]
    for a in app:
        a.start()
    time.sleep(3)
    try:
        scenario(name, mig, watcher)
    finally:
        stop.set()
        for a in app:
            a.join()
    report()
التجربة 1: إضافة عمود خلف تقرير مفتوح Lock Queue
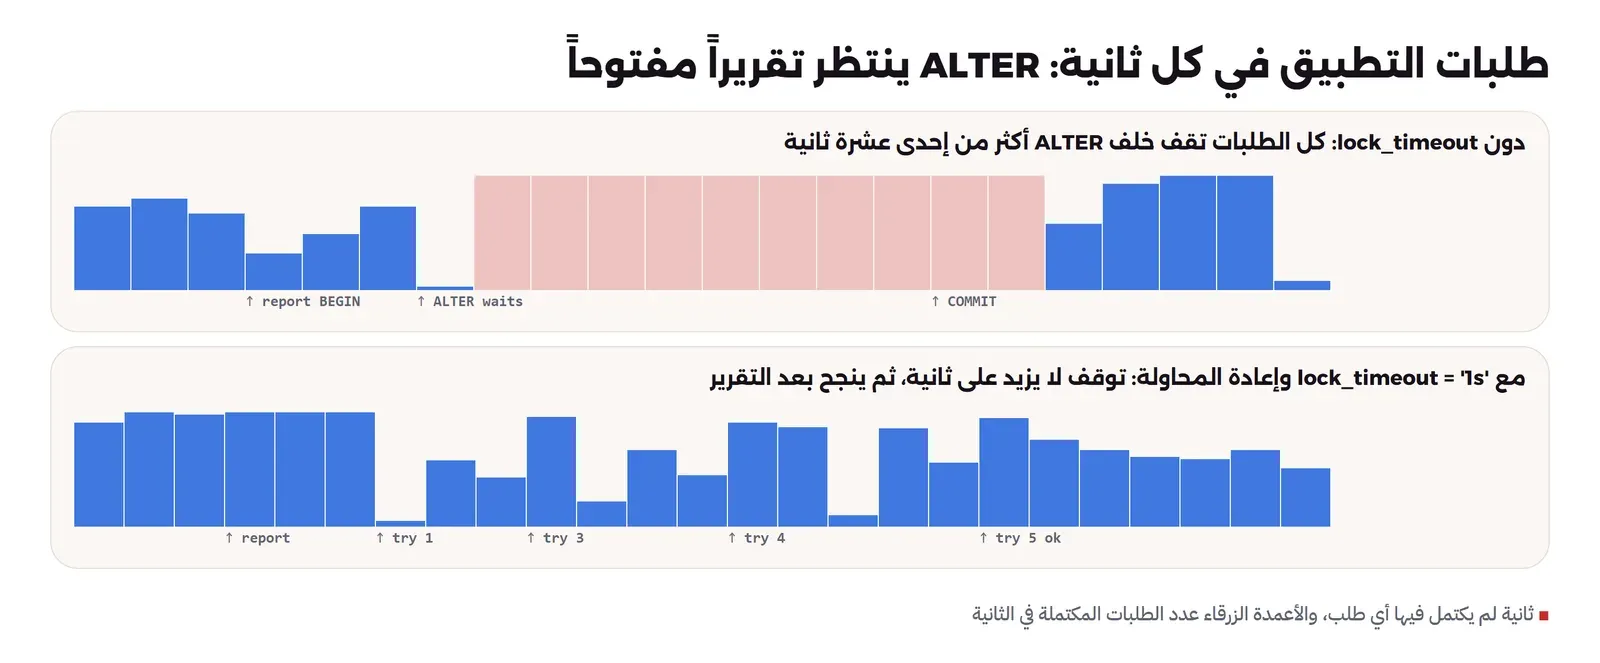
نبدأ بأبسط ترحيل ممكن: ALTER TABLE orders ADD COLUMN note text، وهو أمر لحظي لأنه يغير التعريف فقط. ولكن قبله بثلاث ثوان يبدأ محلل بيانات تقريراً يقرأ الجدول في معاملة ويتركها مفتوحة اثنتي عشرة ثانية، وهذا يحدث كل يوم في الواقع: لوحة تقارير، أو جلسة مفتوحة في أداة إدارة نسي صاحبها أن يغلقها، أو مهمة تصدير ليلية. وبعد ثلاث ثوان من بدء الأمر نطبع ما في pg_locks:
docker exec sw4-mig-tools python lab.py lockqueueوالمخرج سوف يكون كما يلي، مع حذف الثواني الهادئة من الجدول:
[  3.1s] report: BEGIN; SELECT count(*) FROM orders; (open for 12s)
[  6.1s] start: ALTER TABLE orders ADD COLUMN note text
   pid mode                 granted  blocked_by   query
   448 AccessShareLock      True     []           SELECT count(*) FROM orders
   437 AccessExclusiveLock  False    [448]        ALTER TABLE orders ADD COLUMN note text
   445 AccessShareLock      False    [437]        SELECT id, status, total FROM orders WHERE id =
   442 AccessShareLock      False    [437]        SELECT id, status, total FROM orders WHERE id =
   446 RowExclusiveLock     False    [437]        UPDATE orders SET status = 'paid' WHERE id = $1
   443 AccessShareLock      False    [437]        SELECT id, status, total FROM orders WHERE id =
   440 AccessShareLock      False    [437]        SELECT id, status, total FROM orders WHERE id =
   444 RowExclusiveLock     False    [437]        INSERT INTO orders (customer_id, total) VALUES (
[ 17.4s] report: COMMIT
[ 17.4s] done in 11.33s: ALTER TABLE orders ADD COLUMN note text

 sec   ops errors   max ms  app waits on           events
   ...
   2   807      0       45  IO:WalSync
   3   394      0      184  LWLock:WALWrite        report: BEGIN; SELECT count(*) FROM orders; (open for 12s)
   4   589      0       75  LWLock:WALWrite
   5   883      0       86  IO:WalSync
   6    38      0    11332  Lock:relation          start: ALTER TABLE orders ADD COLUMN note text
   7     0      0        0  Lock:relation
   8     0      0        0  Lock:relation
   9     0      0        0  Lock:relation
  10     0      0        0  Lock:relation
  11     0      0        0  Lock:relation
  12     0      0        0  Lock:relation
  13     0      0        0  Lock:relation
  14     0      0        0  Lock:relation
  15     0      0        0  Lock:relation
  16     0      0        0  Lock:relation
  17   701      0       59  Lock:relation          report: COMMIT; done in 11.33s: ALTER TABLE orders ADD COLUMN note text
  18  1119      0       38  LWLock:WALWrite
   ...
requests: 8980, errors: 0, p50 0.8 ms, p99 41 ms, max 11332 ms
في المخرج أعلاه لاحظ التالي:
- في
pg_locksجلسة التقرير 448 تمسك AccessShareLock وقد حصلت عليهgranted = True، والأمرALTERفي الجلسة 437 يطلب AccessExclusiveLock ولم يحصل عليه، والعمودblocked_byيقول إنه ينتظر الجلسة 448. - كل جلسات التطبيق بعده، حتى القراءة
SELECT ... WHERE id =التي لا تتعارض مع التقرير أبداً، تنتظر الجلسة 437 وليس 448، لأنها جاءت بعد قفل منتظر لا يتفق معها، وهذا هو طابور الأقفال. - من الثانية 7 إلى 16 لم يكتمل أي طلب للتطبيق، وأبطأ طلب انتظر 11.3 ثانية، والعمود «app waits on» يقول السبب بوضوح:
Lock:relation، أي انتظار قفل على الجدول. والأمر نفسه انتهى فور حصوله على القفل مع COMMIT التقرير، أي أن 11.33 ثانية من زمنه كانت انتظاراً. - في الثواني العادية يظهر في نفس العمود
LWLock:WALWriteأوIO:WalSync، وهي انتظارات قصيرة جداً لكتابة سجل ال WAL عند كل COMMIT، وتظهر لأن المراقب يسجل الجلسات المنتظرة فقط في لحظة القياس، فلا تعني مشكلة ما دام عدد الطلبات طبيعياً.
والحل الذي شرحناه في مقال الأقفال هو lock_timeout: مهلة يتنازل بعدها الأمر عن انتظار القفل ويفشل، فيخرج من الطابور وتمر الطلبات التي خلفه، ثم يعيد الترحيل المحاولة بعد انتظار. ونفس التجربة بمهلة ثانية واحدة وإعادة محاولة بتأخير متزايد مع عشوائية:
docker exec sw4-mig-tools python lab.py lockqueue-timeoutوالمخرج سوف يكون كما يلي:
[  3.1s] report: BEGIN; SELECT count(*) FROM orders; (open for 12s)
[  6.0s] start: ALTER ... ADD COLUMN note (attempt 1)
[  7.0s] lock_timeout, retry in 0.6s
[  7.6s] start: ALTER ... ADD COLUMN note (attempt 2)
[  8.6s] lock_timeout, retry in 1.6s
[ 10.2s] start: ALTER ... ADD COLUMN note (attempt 3)
[ 11.2s] lock_timeout, retry in 3.6s
[ 14.8s] start: ALTER ... ADD COLUMN note (attempt 4)
[ 15.8s] lock_timeout, retry in 5.6s
[ 15.9s] report: COMMIT
[ 21.4s] start: ALTER ... ADD COLUMN note (attempt 5)
[ 21.5s] done in 0.09s: ALTER ... ADD COLUMN note (attempt 5)

 sec   ops errors   max ms  app waits on           events
   ...
   2  1167      0       23  LWLock:WALWrite
   3  1208      0       19  IO:WalSync             report: BEGIN; SELECT count(*) FROM orders; (open for 12s)
   4  1275      0       11
   5  1256      0       27  IO:WalSync
   6    60      0     1001  Lock:relation          start: ALTER ... ADD COLUMN note (attempt 1)
   7   687      0     1002  Lock:relation          lock_timeout, retry in 0.6s; start: ALTER ... ADD COLUMN note (attempt 2)
   8   509      0        9  Lock:relation          lock_timeout, retry in 1.6s
   9  1144      0       47  IO:WalSync
  10   255      0     1001  Lock:relation          start: ALTER ... ADD COLUMN note (attempt 3)
  11   799      0       82  Lock:relation          lock_timeout, retry in 3.6s
  12   531      0      200  LWLock:WALWrite
  13  1091      0       45  LWLock:WALWrite
  14  1041      0     1075  Lock:relation          start: ALTER ... ADD COLUMN note (attempt 4)
  15   115      0       67  Lock:relation          lock_timeout, retry in 5.6s; report: COMMIT
  16  1025      0       48  LWLock:WALWrite
   ...
  20   800      0       49  LWLock:WALWrite
  21   732      0      103  IO:WalSync             start: ALTER ... ADD COLUMN note (attempt 5); done in 0.09s: ALTER ... ADD COLUMN note (attempt 5)
  22   703      0       88  LWLock:WALWrite
   ...
requests: 28772, errors: 0, p50 0.8 ms, p99 32 ms, max 1075 ms
حاول الأمر أربع مرات وفشل في كل مرة بعد ثانية، وفي كل محاولة نزلت طلبات التطبيق في تلك الثانية فقط، وأبطأ طلب في التجربة كلها 1.08 ثانية بدل 11.3، ثم نجح في المحاولة الخامسة بعد انتهاء التقرير في 90 مللي ثانية. والمهلة المناسبة في الإنتاج أقل من ذلك عادة، بين 100 مللي ثانية وثانيتين، بحسب ما يتحمله أبطأ طلب في تطبيقك، والمهم أن تكون موجودة في كل ترحيل، وأن يعيد الترحيل المحاولة بنفسه بدل أن يفشل النشر كله. ولاحظ أن المهلة لا تجعل الترحيل ينجح، وإنما تجعل فشله رخيصاً، فإذا كان هناك تقرير يعمل ساعة فلن ينجح الأمر حتى ينتهي، لذلك أضف معها مهلة للمعاملات الخاملة idle_in_transaction_session_timeout ومهلة للاستعلامات الطويلة لمستخدم التقارير، كما يشرح توثيق إعدادات الكلاينت.
التجربة 2: NOT NULL دون قراءة الجدول وهو مقفل
إضافة NOT NULL إلى عمود موجود تحتاج أن يتأكد PostgreSQL أنه لا يوجد صف فيه NULL، فيقرأ الجدول كله وهو يمسك ACCESS EXCLUSIVE. والطريقة الآمنة كما يقول توثيق ALTER TABLE: أضف أولاً قيد CHECK (col IS NOT NULL) بالخيار NOT VALID، فيطبق على الصفوف الجديدة فوراً دون أن يقرأ القديمة، ثم VALIDATE CONSTRAINT الذي يقرأ الجدول بقفل SHARE UPDATE EXCLUSIVE لا يمنع القراءة ولا الكتابة، ثم SET NOT NULL الذي يرى القيد الصالح فلا يقرأ الجدول من جديد، ثم تحذف القيد لأنه لم يعد له حاجة. ونقارن الطريقتين على عمود customer_id:
docker exec sw4-mig-tools python lab.py notnullوالمخرج سوف يكون كما يلي:
[  3.1s] start: setup: DROP NOT NULL
[  3.1s] done in 0.07s: setup: DROP NOT NULL
[  5.1s] start: A: SET NOT NULL
[  9.2s] done in 4.03s: A: SET NOT NULL
[ 12.2s] start: reset: DROP NOT NULL
[ 12.3s] done in 0.09s: reset: DROP NOT NULL
[ 14.3s] start: B1: ADD CHECK ... NOT VALID
[ 15.0s] done in 0.76s: B1: ADD CHECK ... NOT VALID
[ 15.0s] start: B2: VALIDATE CONSTRAINT
[ 18.6s] done in 3.55s: B2: VALIDATE CONSTRAINT
[ 18.6s] start: B3: SET NOT NULL
[ 18.7s] done in 0.11s: B3: SET NOT NULL
[ 18.7s] start: B4: DROP CONSTRAINT
[ 18.8s] done in 0.11s: B4: DROP CONSTRAINT

 sec   ops errors   max ms  app waits on           events
   ...
   2   203      0      480  LWLock:WALWrite
   3   328      0      220  LWLock:WALWrite        start: setup: DROP NOT NULL; done in 0.07s: setup: DROP NOT NULL
   4   328      0      289  LWLock:WALWrite
   5    31      0     4767  Lock:relation          start: A: SET NOT NULL
   6     0      0        0  Lock:relation
   7     0      0        0  Lock:relation
   8     0      0        0  Lock:relation
   9    46      0     1074  LWLock:WALWrite        done in 4.03s: A: SET NOT NULL
  10   109      0      723  LWLock:WALWrite
  11   246      0      525  LWLock:WALWrite
  12   407      0      124  LWLock:WALWrite        start: reset: DROP NOT NULL; done in 0.09s: reset: DROP NOT NULL
  13   221      0      246  LWLock:WALWrite
  14    63      0     1273  Lock:relation          start: B1: ADD CHECK ... NOT VALID
  15    45      0      675  LWLock:WALWrite        done in 0.76s: B1: ADD CHECK ... NOT VALID; start: B2: VALIDATE CONSTRAINT
  16   112      0      389  LWLock:WALWrite
  17   197      0      420  LWLock:WALWrite
  18   234      0      207  LWLock:WALWrite        done in 3.55s: B2: VALIDATE CONSTRAINT; start: B3: SET NOT NULL; done in 0.11s: B3: SET NOT NULL; start: B4: DROP CONSTRAINT; done in 0.11s: B4: DROP CONSTRAINT
  19   281      0      255  LWLock:WALWrite
   ...
requests: 5071, errors: 0, p50 0.9 ms, p99 455 ms, max 4767 ms
الطريقة المباشرة A قرأت عشرة ملايين صف في 4.03 ثانية، ولم يكتمل أي طلب للتطبيق في ثلاث منها، وانتظر أبطأ طلب 4.8 ثانية على Lock:relation. أما الطريقة B فقرأت نفس الصفوف في 3.55 ثانية في خطوة VALIDATE دون أي ثانية متوقفة، ثم أخذ SET NOT NULL 0.11 ثانية فقط لأنه وجد القيد الصالح. ولاحظ أن الخطوة B1، أي إضافة القيد NOT VALID، أخذت 0.76 ثانية وجعلت أبطأ طلب 1.27 ثانية، مع أنها لا تقرأ أي صف، والسبب أنها تحتاج ACCESS EXCLUSIVE لحظة، فانتظرت معاملات التطبيق الجارية، وانتظرها ما جاء بعدها، أي طابور أقفال صغير، لذلك ضع lock_timeout حتى على الأوامر اللحظية. وقد يبدو الفرق صغيراً هنا، ولكن زمن القراءة يكبر مع الجدول، فعلى جدول فيه مئة مليون صف أو على قرص أبطأ تصبح الثانية دقيقة، وتبقى الطريقة B دون توقف. ومنذ PostgreSQL 18 تستطيع أن تكتب ADD CONSTRAINT ... NOT NULL col NOT VALID مباشرة كما رأينا في مقال تصميم قواعد البيانات، والفكرة نفسها.
ونفس الطريقة تنطبق على المفتاح الأجنبي، وهو ما أوقف GoCardless: ADD CONSTRAINT ... FOREIGN KEY ... NOT VALID لحظي ولكنه يحتاج قفلاً على الجدولين، ثم VALIDATE CONSTRAINT يقرأ دون أن يوقف أحداً، وكلاهما مع مهلة قفل.
التجربة 3: الفهرس العادي والفهرس CONCURRENTLY
الأمر CREATE INDEX يأخذ قفل SHARE، وهو يسمح بالقراءة ويمنع أي INSERT أو UPDATE أو DELETE حتى ينتهي البناء، أما CREATE INDEX CONCURRENTLY فيأخذ SHARE UPDATE EXCLUSIVE فلا يمنع الكتابة، والثمن كما يشرح توثيق CREATE INDEX أنه يقرأ الجدول مرتين، وينتظر انتهاء المعاملات التي قد تستخدم الفهرس، ولا يعمل داخل معاملة. ونقارن الاثنين على عمود customer_id، ثم نجرب فهرساً فريداً CONCURRENTLY على عمود فيه قيم مكررة، لنرى ما يحدث عندما يفشل:
docker exec sw4-mig-tools python lab.py indexوالمخرج سوف يكون كما يلي:
[  5.1s] start: A: CREATE INDEX
[ 10.9s] done in 5.89s: A: CREATE INDEX
[ 12.9s] start: DROP INDEX orders_customer
[ 13.0s] done in 0.04s: DROP INDEX orders_customer
[ 15.0s] start: B: CREATE INDEX CONCURRENTLY
[ 31.5s] done in 16.52s: B: CREATE INDEX CONCURRENTLY
[ 33.5s] start: C: CREATE UNIQUE INDEX CONCURRENTLY
[ 33.9s] failed: could not create unique index "orders_customer_uq"
   index: ('orders_customer', True, True, '65 MB')
   index: ('orders_customer_uq', False, False, '0 bytes')
   index: ('orders_pkey', True, True, '430 MB')
[ 33.9s] start: DROP INDEX CONCURRENTLY orders_customer_uq
[ 34.0s] done in 0.07s: DROP INDEX CONCURRENTLY orders_customer_uq
[ 34.0s] start: DROP INDEX orders_customer
[ 34.0s] done in 0.03s: DROP INDEX orders_customer

 sec   ops errors   max ms  app waits on           events
   ...
   5    73      0     5886  Lock:relation          start: A: CREATE INDEX
   6     0      0        0  Lock:relation
   7     0      0        0  Lock:relation
   8     0      0        0  Lock:relation
   9     0      0        0  Lock:relation
  10    60      0        6  Lock:relation          done in 5.89s: A: CREATE INDEX
   ...
  12   833      0       47  IO:WalSync             start: DROP INDEX orders_customer; done in 0.04s: DROP INDEX orders_customer
   ...
  14  1038      0       18  IO:WalSync             start: B: CREATE INDEX CONCURRENTLY
   ...
  22   296      0      179  LWLock:WALWrite
   ...
  27   296      0      112  LWLock:WALWrite
   ...
  29   306      0      125  LWLock:WALWrite
   ...
  31  1074      0       32  IO:WalSync             done in 16.52s: B: CREATE INDEX CONCURRENTLY
   ...
  33   885      0       41  LWLock:WALWrite        start: C: CREATE UNIQUE INDEX CONCURRENTLY; failed: could not create unique index "orders_customer_uq"; start: DROP INDEX CONCURRENTLY orders_customer_uq; done in 0.07s: DROP INDEX CONCURRENTLY orders_customer_uq; start: DROP INDEX orders_customer
  34   997      0       21  LWLock:WALWrite        done in 0.03s: DROP INDEX orders_customer
   ...
  36     5      0        8
requests: 23527, errors: 0, p50 0.9 ms, p99 60 ms, max 5886 ms
في المخرج أعلاه لاحظ التالي:
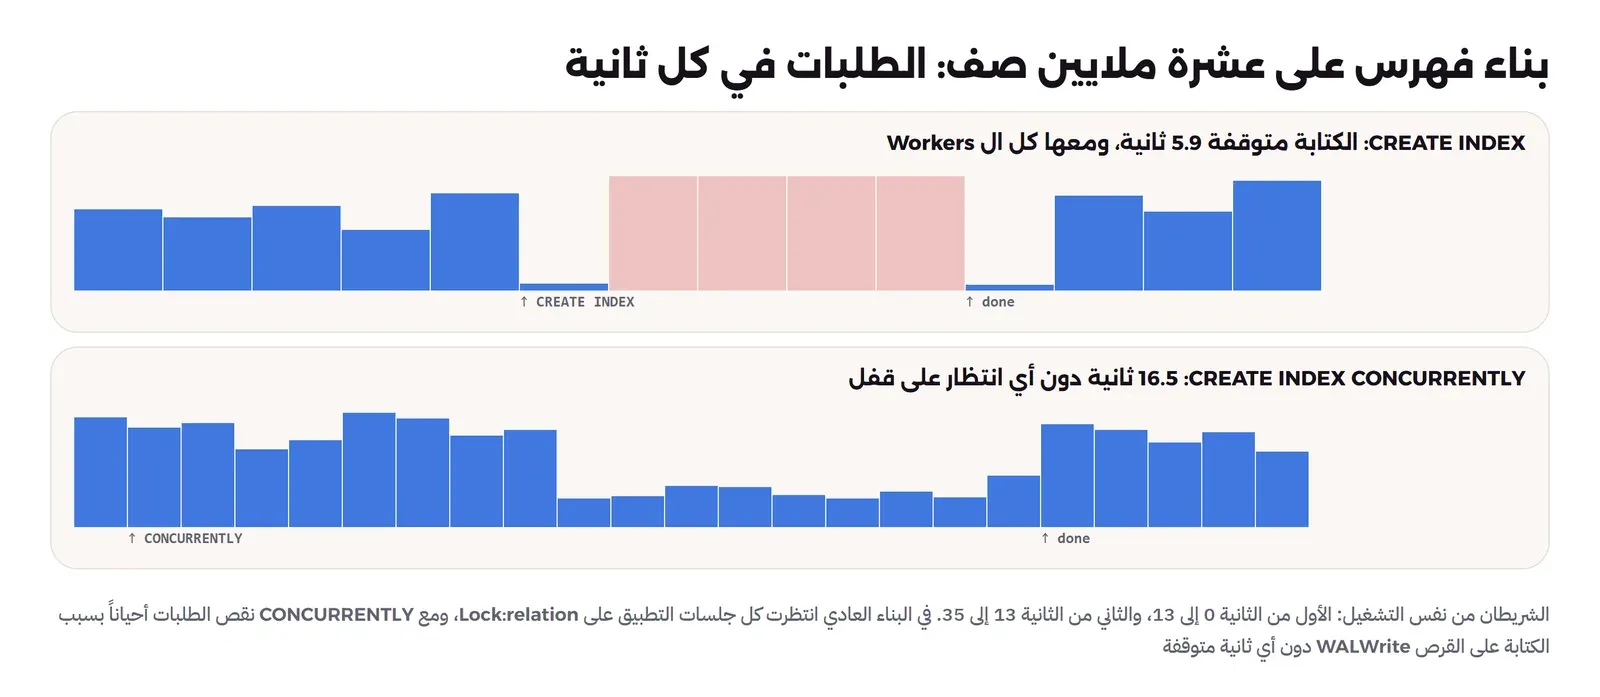
- البناء العادي أخذ 5.9 ثانية، ولم يكتمل أي طلب للتطبيق في أربع منها، مع أن 70% من الطلبات قراءة مسموحة، والسبب أن كل خيط من الخيوط الثمانية يصل خلال ثانية إلى طلب كتابة فيقف عنده، فيتوقف التطبيق كله. وهذا ما يحدث في الواقع أيضاً: مجموعة الاتصالات تمتلئ بالطلبات المنتظرة، فتنتظر القراءات اتصالاً فارغاً.
- البناء CONCURRENTLY أخذ 16.5 ثانية، أي قرابة ثلاثة أضعاف، ولم تتوقف فيه أي ثانية، ونقصت الطلبات في بعض الثواني إلى قرابة 300، والعمود «app waits on» يقول إن الانتظار كان
LWLock:WALWrite، أي على كتابة القرص وليس على قفل. - الفهرس الفريد فشل لأن العمود فيه قيم مكررة، ولكنه لم يختف: بقي في الجدول باسم
orders_customer_uqوالعمودindisvalidفيهFalse. وهذا ما يقوله التوثيق: الفهرس الذي يفشل بناؤه CONCURRENTLY يبقى غير صالح INVALID، فلا يستخدمه المخطط للقراءة، وقد يبقى PostgreSQL يحدثه مع كل كتابة. والإجراء الصحيح أن تحذفه بالأمرDROP INDEX CONCURRENTLYثم تصلح البيانات وتعيد البناء.
SELECT indexrelid::regclass FROM pg_index WHERE NOT indisvalid، لأن إعادة الترحيل بنفس الاسم سوف تفشل بخطأ «already exists»، وإذا كتبت IF NOT EXISTS فسوف ينجح الترحيل دون أن يبني شيئاً، ويبقى الفهرس غير صالح دون أن يلاحظ أحد.التجربة 4: ملء عمود جديد Backfill في عشرة ملايين صف
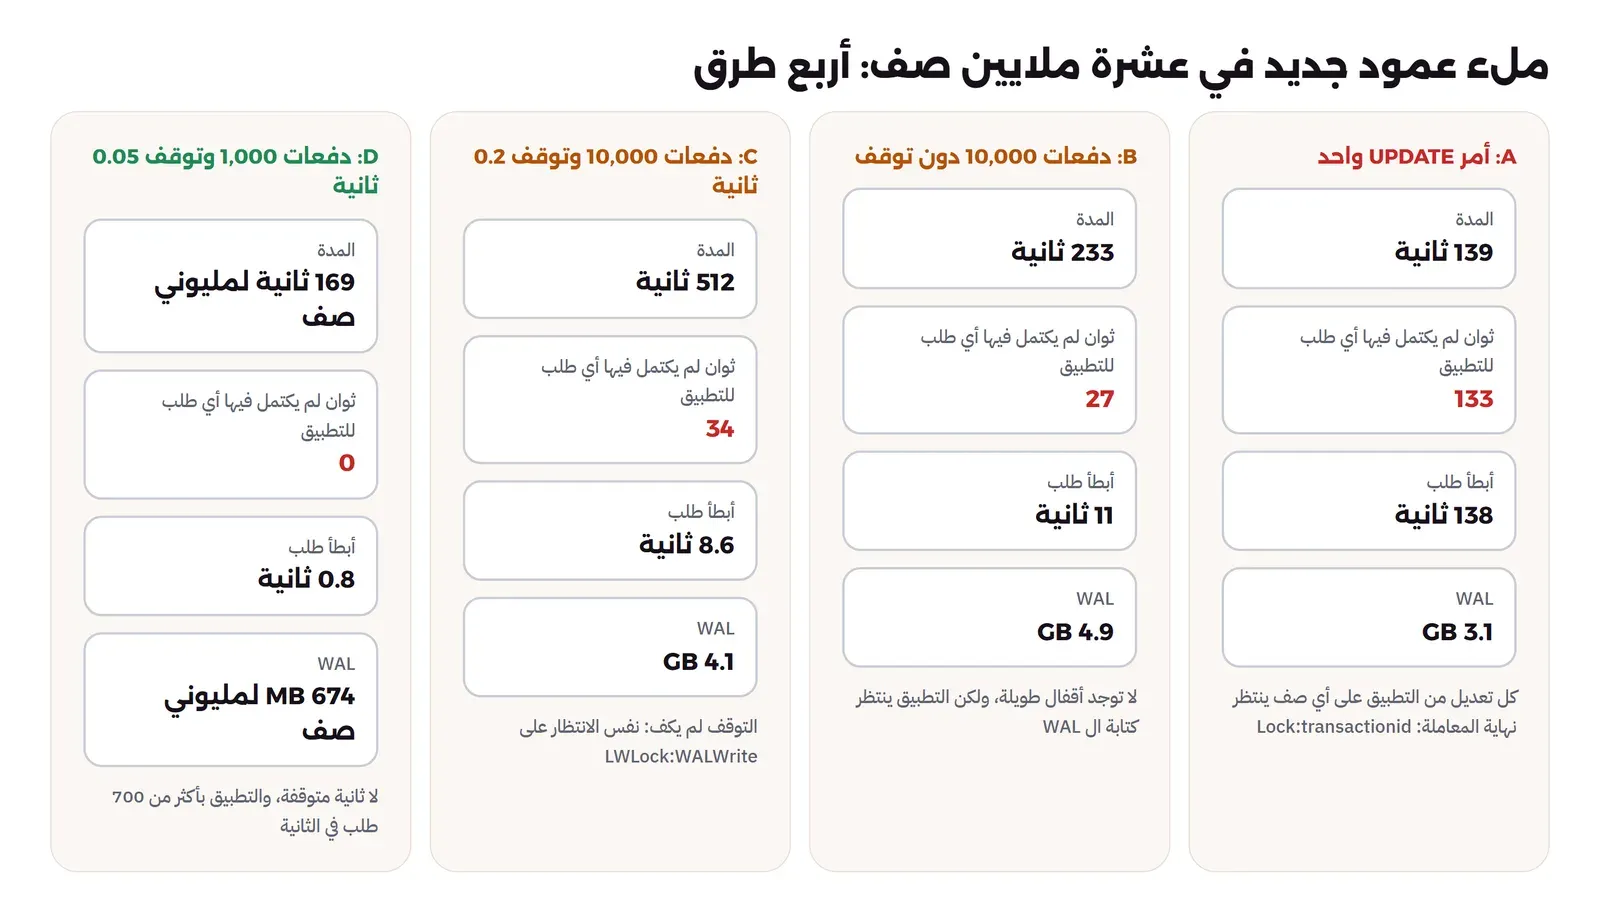
بعد إضافة عمود جديد يأتي ملؤه بالقيم للصفوف القديمة، والحل البسيط أمر UPDATE واحد. ونجرب أربع طرق لملء العمود total_cents: أمر واحد، ثم دفعات من عشرة آلاف صف متتالية، ثم نفس الدفعات مع توقف 0.2 ثانية بعد كل دفعة، ثم دفعات من ألف صف مع توقف 0.05 ثانية على أول مليوني صف:
docker exec sw4-mig-tools python lab.py backfill-one
docker exec sw4-mig-tools python lab.py backfill
docker exec sw4-mig-tools python lab.py backfill-throttle
docker exec sw4-mig-tools python lab.py backfill-small
والجداول الكاملة لكل ثانية في مجلد lab/out، والملخص التالي من السكربت summarize.py الذي يقرأ الجدول بين بداية الملء ونهايته. والتجربتان B وC شغلناهما قبل أن نضيف عمود الانتظار إلى كل التجارب، فالتجربة C فيها بدله سطر يعد ما كانت جلسات التطبيق تنتظره طوال الملء:
# Summarise the per-second table of a lab.py output between two events:
#   python summarize.py out/file.txt "start text" "end text"
import collections, re, sys
path, start, end = sys.argv[1:4]
lines = open(path, encoding="utf8").read().splitlines()
t0 = next(float(re.match(r"\[ *([\d.]+)s\]", l).group(1)) for l in lines if l.startswith("[") and start in l)
t1 = next(float(re.match(r"\[ *([\d.]+)s\]", l).group(1)) for l in lines if l.startswith("[") and end in l)
rows = [l.split() for l in lines if re.match(r"^\s*\d+\s+\d+\s+\d+\s+\d+", l)]
rows = [r for r in rows if int(t0) <= int(r[0]) <= int(t1)]
waits = collections.Counter(r[4] for r in rows if len(r) > 4 and ":" in r[4] and not r[4].endswith(":"))
print(f"{t1 - t0:.0f} s | requests/s avg {sum(int(r[1]) for r in rows) / len(rows):.0f} | "
      f"seconds with 0 requests: {sum(1 for r in rows if r[1] == '0')} | "
      f"seconds with a request over 1 s: {sum(1 for r in rows if int(r[3]) > 1000)} | "
      f"slowest request {max(int(r[3]) for r in rows) / 1000:.1f} s | app mostly waits on: "
      + (", ".join(f"{w} ({n} s)" for w, n in waits.most_common(2)) or "not sampled in this run"))
139 s | requests/s avg 22 | seconds with 0 requests: 133 | seconds with a request over 1 s: 4 | slowest request 137.9 s | app mostly waits on: Lock:transactionid (138 s), LWLock:WALWrite (1 s)
233 s | requests/s avg 426 | seconds with 0 requests: 27 | seconds with a request over 1 s: 48 | slowest request 11.0 s | app mostly waits on: not sampled in this run
app sessions seen waiting on: {'LWLock:WALWrite': 3857, 'IO:WalSync': 649, 'CPU': 104, 'IO:DataFileRead': 49, 'IO:WalWrite': 14, 'Client:ClientRead': 7}
512 s | requests/s avg 467 | seconds with 0 requests: 34 | seconds with a request over 1 s: 48 | slowest request 8.6 s | app mostly waits on: not sampled in this run
169 s | requests/s avg 710 | seconds with 0 requests: 0 | seconds with a request over 1 s: 0 | slowest request 0.8 s | app mostly waits on: LWLock:WALWrite (135 s), IO:WalSync (31 s)في المخرج أعلاه لاحظ التالي:
- أمر UPDATE واحد (A): أخذ 139 ثانية، ولم يكتمل أي طلب للتطبيق في 133 منها، وأبطأ طلب انتظر 138 ثانية على
Lock:transactionid، أي انتظار انتهاء معاملة أخرى. والسبب أن الأمر الواحد معاملة واحدة تقفل كل صف عدلته حتى نهايتها، فأي UPDATE من التطبيق على أي طلب ينتظر حتى تنتهي العشرة ملايين، ثم يقف كل خيط خلف أول تعديل يصل إليه. ولم يأخذ الأمر أي قفل يمنع القراءة، ومع ذلك توقف التطبيق كله. - دفعات 10,000 دون توقف (B): اختفت الأقفال الطويلة، فكل دفعة تقفل عشرة آلاف صف لأجزاء من الثانية، ونزل أبطأ طلب من 138 ثانية إلى 11، ولكن بقيت 27 ثانية لم يكتمل فيها أي طلب.
- دفعات 10,000 مع توقف (C): التوقف بين الدفعات ضاعف المدة إلى 512 ثانية ولم يحل المشكلة، فبقيت 34 ثانية متوقفة. والعد يكشف السبب: في أغلب العينات كانت جلسات التطبيق تنتظر
LWLock:WALWriteوIO:WalSync، أي كتابة سجل ال WAL على القرص، فكل دفعة من عشرة آلاف صف تكتب ميجابايتات من ال WAL، ومعها نسخ صفحات كاملة Full Page Images بعد كل Checkpoint، وكل COMMIT صغير من التطبيق ينتظر دوره خلفها. - دفعات 1,000 مع توقف قصير (D): لم تتوقف أي ثانية، ولم يتجاوز أي طلب 0.8 ثانية، والتطبيق أسرع من كل الحالات السابقة بأكثر من 700 طلب في الثانية. والانتظار على WALWrite ما زال يظهر في العمود، ولكنه انتظار قصير عند كل COMMIT كما في الثواني العادية. والثمن أن المليوني صف أخذت 169 ثانية، أي أن الجدول كله يحتاج قرابة أربع عشرة دقيقة بدل دقيقتين، وهذا ثمن مقبول لعمل يعمل في الخلفية.
- حجم ال WAL لم يصغر بالدفعات، فقد كتب الأمر الواحد 3.1 جيجابايت في أول تشغيل لنفس التجربة، وكتبت الدفعات B قرابة 4.9 جيجابايت، والسبب غالباً نسخ الصفحات الكاملة بعد كل Checkpoint عندما يطول العمل. وهذا مهم إذا كان عندك نسخ Replicas، لأن كل هذا ال WAL يجب أن يصل إليها، فراقب تأخر النسخ Replication Lag أثناء الملء وأبطئ إذا زاد.
والدرس أن تقسيم العمل إلى دفعات يحل مشكلة الأقفال فقط، أما الضغط على القرص فيحتاج دفعات أصغر وقياساً، وأفضل طريقة لتحديد حجم الدفعة أن تبدأ صغيراً وتراقب زمن طلبات التطبيق وتأخر النسخ، ثم تكبر الدفعة ما دام كل شيء هادئاً. ولاحظ أن الملء على دفعات يحتاج شرطاً يجعله آمناً عند التوقف والإعادة، مثل حدود المعرف id التي نتقدم بها، أو WHERE total_cents IS NULL، فإذا توقف السكربت في منتصفه تعيد تشغيله فيكمل من حيث توقف.
التجربة 5: تحويل المفتاح الأساسي من integer إلى bigint
هذا أصعب ترحيل شائع، لأن العمود هو المفتاح الأساسي، وعليه فهرس، وتشير إليه جداول أخرى عادة، وقد تحتاجه فجأة. ففي 8 نوفمبر 2018 بقي Basecamp 3 في وضع القراءة فقط قرابة خمس ساعات، كما كتب David Heinemeier Hansson في تحديث الحادثة، لأن جدولاً مهماً وصل إلى آخر رقم في عمود من نوع integer، أي 2,147,483,647، وكان تغيير النوع إلى bigint على ذلك الجدول الكبير يحتاج قرابة ساعة وأربعين دقيقة. والدرس الأول أن تراقب المعرفات قبل أن تصل إلى الحد بوقت طويل، والدرس الثاني أن الترحيل نفسه يحتاج طريقة لا توقف الخدمة، وهذا ما نجربه الآن. نبدأ بالأمر المباشر:
docker exec sw4-mig-tools python lab.py bigint-naiveوالمخرج سوف يكون كما يلي، مع اختصار الثواني المتوقفة:
[  5.1s] start: ALTER COLUMN id TYPE bigint
[ 81.5s] app error: FeatureNotSupported: cached plan must not change result type   (the first of 2170)
[ 81.8s] done in 76.72s: ALTER COLUMN id TYPE bigint

 sec   ops errors   max ms  app waits on           events
   0   765      0       25  LWLock:WALWrite
   1   884      0       29  IO:WalSync
   2   746      0       54  LWLock:WALWrite
   3   841      0       50  LWLock:WALWrite
   4   870      0       83  IO:WalSync
   5    99      6    76375  Lock:relation          start: ALTER COLUMN id TYPE bigint
   6     0      0        0  Lock:relation
   ...  (seconds 7 to 79: no request completed)
  80     0      0        0  Lock:relation
  81   556    390       17  Lock:relation          done in 76.72s: ALTER COLUMN id TYPE bigint
  82  1069    760       12  IO:WalSync
  83   850    573       47  LWLock:WALWrite
  84   650    441       31  LWLock:WALWrite
requests: 7330, errors: 2170, p50 1.5 ms, p99 23 ms, max 76375 ms
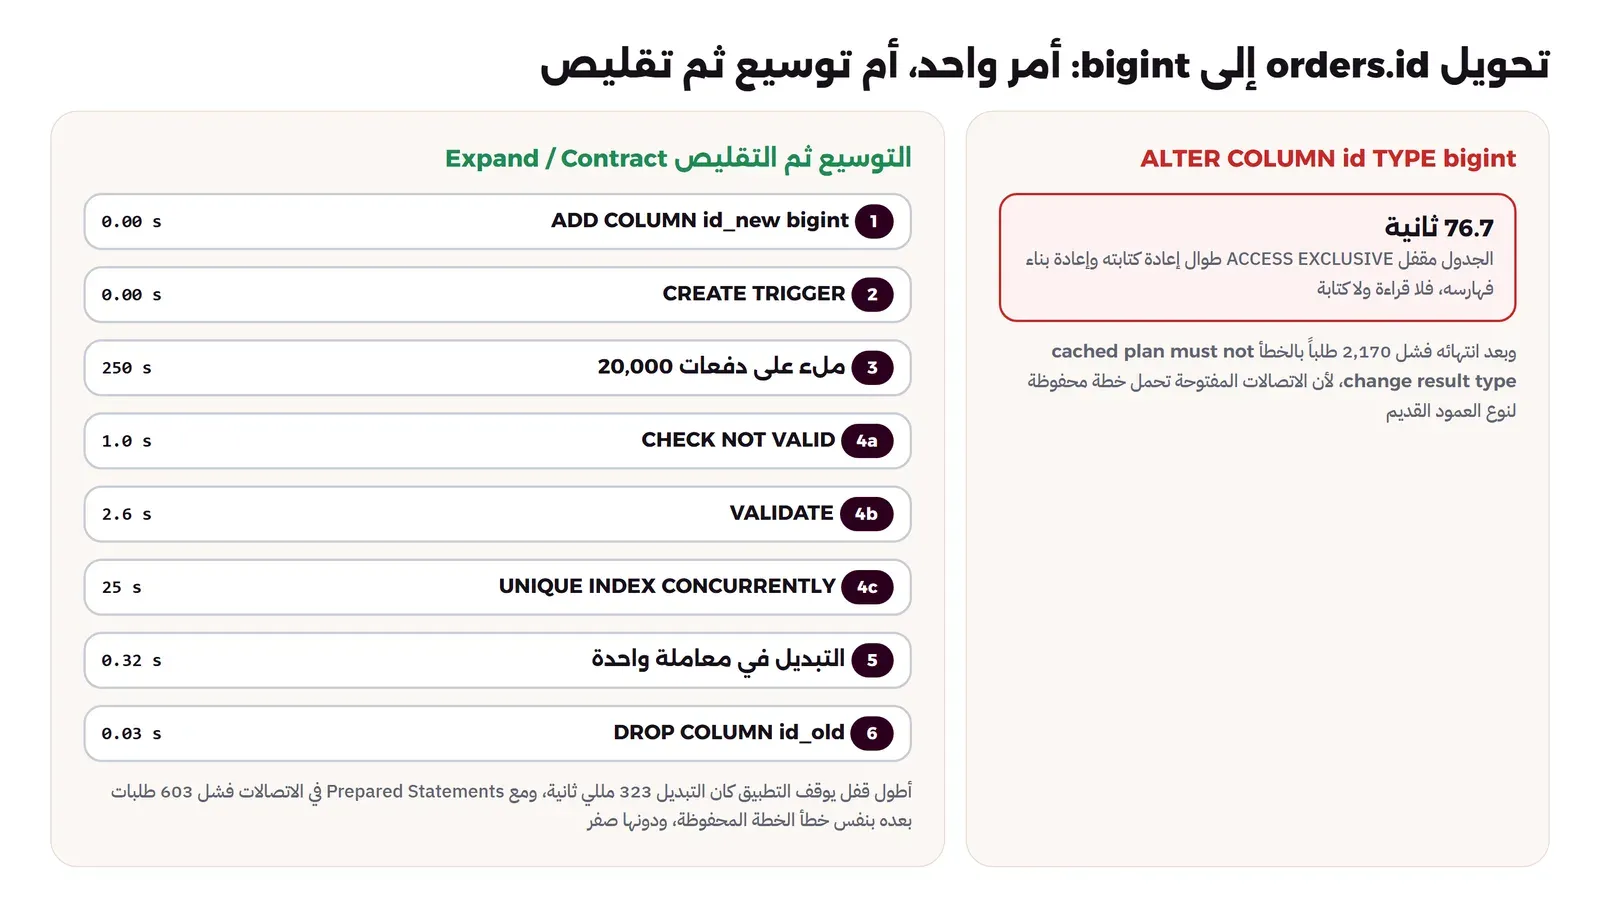
الأمر أعاد كتابة الجدول وفهرسه وهو يمسك ACCESS EXCLUSIVE، فتوقف التطبيق 76.7 ثانية لعشرة ملايين صف، وعلى جدول بمليارات الصفوف يصبح ذلك ساعات. ولكن لاحظ ما حدث بعد أن انتهى الأمر: 2,170 طلباً فشلت بالخطأ cached plan must not change result type، أي أكثر من نصف الطلبات في الثواني الأربع الأخيرة، وسوف نعود إلى هذا الخطأ بعد قليل.
والطريقة دون توقف هي التوسيع ثم التقليص، وهي في الملف bigint_online.py: عمود جديد id_new من نوع bigint، وTrigger يملؤه في كل INSERT وUPDATE من الآن، ثم ملء الصفوف القديمة على دفعات، ثم إثبات أنه لا يوجد NULL بقيد CHECK من نوع NOT VALID ثم VALIDATE، وبناء فهرس فريد CONCURRENTLY، ثم التبديل في معاملة واحدة قصيرة بمهلة قفل: المفتاح الأساسي ينتقل إلى الفهرس الجديد بالأمر ADD CONSTRAINT ... PRIMARY KEY USING INDEX الذي لا يبني شيئاً، والتسلسل Sequence يصبح bigint وينتقل إلى العمود الجديد، ويتبادل العمودان الاسمين. وفي النهاية يحذف العمود القديم:
# orders.id from integer to bigint without a long lock: expand, sync, backfill, validate, swap, contract.
import time
import psycopg

SWAP = """
BEGIN;
SET LOCAL lock_timeout = '1s';
LOCK TABLE orders IN ACCESS EXCLUSIVE MODE;
ALTER TABLE orders ALTER COLUMN id_new SET NOT NULL;            -- instant: the CHECK below is already valid
ALTER TABLE orders DROP CONSTRAINT orders_pkey;
ALTER TABLE orders ADD CONSTRAINT orders_pkey PRIMARY KEY USING INDEX orders_id_new_uq;
ALTER SEQUENCE orders_id_seq AS bigint OWNED BY orders.id_new;
ALTER TABLE orders ALTER COLUMN id_new SET DEFAULT nextval('orders_id_seq');
ALTER TABLE orders ALTER COLUMN id DROP DEFAULT, ALTER COLUMN id DROP NOT NULL;
DROP TRIGGER orders_sync_id ON orders;
ALTER TABLE orders RENAME COLUMN id TO id_old;
ALTER TABLE orders RENAME COLUMN id_new TO id;
ALTER TABLE orders DROP CONSTRAINT id_new_nn;
COMMIT;
"""


def run(mig, sql, event):
    # 1) expand: a new nullable column, nothing reads it yet
    sql(mig, "ALTER TABLE orders ADD COLUMN id_new bigint", "1 expand: ADD COLUMN id_new bigint")
    # 2) every new or changed row fills it from now on
    mig.execute("""CREATE OR REPLACE FUNCTION orders_sync_id() RETURNS trigger LANGUAGE plpgsql AS $$
                   BEGIN NEW.id_new := NEW.id; RETURN NEW; END $$""")
    sql(mig, "CREATE TRIGGER orders_sync_id BEFORE INSERT OR UPDATE ON orders "
             "FOR EACH ROW EXECUTE FUNCTION orders_sync_id()", "2 sync: CREATE TRIGGER")
    # 3) backfill the old rows in batches
    top = mig.execute("SELECT max(id) FROM orders").fetchone()[0]
    event(f"3 backfill: batches of 20,000 ids up to {top}")
    t, last = time.time(), 0
    while last < top:
        mig.execute("UPDATE orders SET id_new = id WHERE id > %s AND id <= %s AND id_new IS NULL", (last, last + 20000))
        last += 20000
    event(f"3 backfill done in {time.time() - t:.1f}s")
    # 4) prove NOT NULL without blocking, and build the unique index without blocking
    sql(mig, "ALTER TABLE orders ADD CONSTRAINT id_new_nn CHECK (id_new IS NOT NULL) NOT VALID", "4a CHECK NOT VALID")
    sql(mig, "ALTER TABLE orders VALIDATE CONSTRAINT id_new_nn", "4b VALIDATE")
    sql(mig, "CREATE UNIQUE INDEX CONCURRENTLY orders_id_new_uq ON orders (id_new)", "4c UNIQUE INDEX CONCURRENTLY")
    # 5) the swap: one short transaction, with a lock_timeout and retries
    for attempt in range(1, 10):
        t = time.time()
        try:
            event(f"5 swap: attempt {attempt}")
            mig.execute(SWAP)
            event(f"5 swap committed in {(time.time() - t) * 1000:.0f} ms")
            break
        except psycopg.errors.LockNotAvailable:
            mig.execute("ROLLBACK")
            event("5 swap: lock_timeout, retry")
            time.sleep(attempt)
    # 6) contract, after every app version stopped reading id_old
    sql(mig, "ALTER TABLE orders DROP COLUMN id_old", "6 contract: DROP COLUMN id_old")
    print(mig.execute("""SELECT a.attname, format_type(a.atttypid, a.atttypmod), pg_get_expr(d.adbin, d.adrelid)
                         FROM pg_attribute a LEFT JOIN pg_attrdef d ON d.adrelid = a.attrelid AND d.adnum = a.attnum
                         WHERE a.attrelid = 'orders'::regclass AND a.attname = 'id'""").fetchone())
docker exec sw4-mig-tools psql -qf /lab/schema.sql
docker exec sw4-mig-tools python lab.py bigint-onlineوالمخرج سوف يكون كما يلي، مع الثواني حول التبديل فقط:
[  3.1s] start: 1 expand: ADD COLUMN id_new bigint
[  4.2s] done in 1.01s: 1 expand: ADD COLUMN id_new bigint
[  4.2s] start: 2 sync: CREATE TRIGGER
[  4.2s] done in 0.01s: 2 sync: CREATE TRIGGER
[  4.2s] 3 backfill: batches of 20,000 ids up to 10014284
[372.1s] 3 backfill done in 367.9s
[372.1s] start: 4a CHECK NOT VALID
[373.1s] done in 1.04s: 4a CHECK NOT VALID
[373.1s] start: 4b VALIDATE
[387.1s] done in 14.03s: 4b VALIDATE
[387.1s] start: 4c UNIQUE INDEX CONCURRENTLY
[415.8s] done in 28.65s: 4c UNIQUE INDEX CONCURRENTLY
[415.8s] 5 swap: attempt 1
[417.1s] app error: FeatureNotSupported: cached plan must not change result type   (the first of 603)
[417.3s] 5 swap committed in 1517 ms
[417.3s] start: 6 contract: DROP COLUMN id_old
[418.2s] done in 0.86s: 6 contract: DROP COLUMN id_old
('id', 'bigint', "nextval('orders_id_seq'::regclass)")

 sec   ops errors   max ms  events
   ...
 413     0      0        0
 414    64      0     1126
 415    17      3     2082  done in 28.65s: 4c UNIQUE INDEX CONCURRENTLY; 5 swap: attempt 1
 416     3      2     1129
 417    14      7     1019  5 swap committed in 1517 ms; start: 6 contract: DROP COLUMN id_old
 418    78     58      436  done in 0.86s: 6 contract: DROP COLUMN id_old
 419   231    166      145
 420   220    150      118
 421   314    217      114
requests: 137883, errors: 603, p50 1.5 ms, p99 328 ms, max 8591 ms
في المخرج أعلاه لاحظ التالي:
- أطول خطوة الملء على دفعات، 368 ثانية، ثم الفهرس الفريد 29 ثانية، وكلاهما والتطبيق يعمل، وفي النهاية أصبح العمود
idمن نوع bigint مع التسلسل نفسه كقيمة افتراضية. - التبديل أخذ 1.5 ثانية في هذا التشغيل، وهي المدة الوحيدة التي أمسك فيها الترحيل ACCESS EXCLUSIVE، مقابل 76.7 ثانية في الأمر المباشر.
- ولكن بعد التبديل مباشرة بدأ التطبيق يفشل بنفس الخطأ: 603 طلبات حتى نهاية التجربة، ونسبة الأخطاء في الثواني الأخيرة قرابة 70%، أي أن الترحيل نجح دون توقف ثم أوقع التطبيق بعده.
وهذه مشكلة ظهرت في التجربة ولم نكن ننتظرها: مكتبة psycopg، مثل أغلب مكتبات الاتصال الحديثة وال ORMs، تحول الاستعلام الذي يتكرر إلى Prepared Statement، فيحفظ PostgreSQL خطته في الاتصال، ومنها نوع كل عمود في النتيجة. فإذا تغير نوع العمود id من integer إلى bigint، يحاول PostgreSQL أن يعيد تخطيط الاستعلام المحفوظ فيجد أن نوع النتيجة تغير، فيرفض بهذا الخطأ، ويبقى يرفض في كل مرة على نفس الاتصال، لأن الكود يستخدم نفس الاستعلام المحفوظ. وال Connection Pool يبقي الاتصالات مفتوحة ساعات، فالخطأ لا يزول وحده. ونفس التجربة مع prepare_threshold=None في التطبيق، أي دون Prepared Statements:
docker exec sw4-mig-tools psql -qf /lab/schema.sql
docker exec -e APP_PREPARE=off sw4-mig-tools python lab.py bigint-online
والمخرج سوف يكون كما يلي:
[  3.0s] start: 1 expand: ADD COLUMN id_new bigint
[  3.0s] done in 0.00s: 1 expand: ADD COLUMN id_new bigint
[  3.1s] start: 2 sync: CREATE TRIGGER
[  3.1s] done in 0.00s: 2 sync: CREATE TRIGGER
[  3.1s] 3 backfill: batches of 20,000 ids up to 10000299
[253.3s] 3 backfill done in 250.3s
[253.3s] start: 4a CHECK NOT VALID
[254.3s] done in 1.00s: 4a CHECK NOT VALID
[254.3s] start: 4b VALIDATE
[256.9s] done in 2.58s: 4b VALIDATE
[256.9s] start: 4c UNIQUE INDEX CONCURRENTLY
[282.1s] done in 25.18s: 4c UNIQUE INDEX CONCURRENTLY
[282.1s] 5 swap: attempt 1
[282.4s] 5 swap committed in 323 ms
[282.4s] start: 6 contract: DROP COLUMN id_old
[282.4s] done in 0.03s: 6 contract: DROP COLUMN id_old
('id', 'bigint', "nextval('orders_id_seq'::regclass)")

 sec   ops errors   max ms  app waits on           events
   ...
 280   499      0      163  LWLock:WALWrite
 281   615      0       83  LWLock:WALWrite
 282   640      0       77  LWLock:WALWrite        done in 25.18s: 4c UNIQUE INDEX CONCURRENTLY; 5 swap: attempt 1; 5 swap committed in 323 ms; start: 6 contract: DROP COLUMN id_old; done in 0.03s: 6 contract: DROP COLUMN id_old
 283   435      0      712  LWLock:WALWrite
 284    31      0    11066  LWLock:WALWrite
requests: 148664, errors: 0, p50 1.1 ms, p99 83 ms, max 12626 ms
صفر أخطاء، والتبديل أخذ 323 مللي ثانية هذه المرة. والحلول العملية لهذه المشكلة في الإنتاج ثلاثة: أن تعيد تشغيل التطبيق أو تفرغ ال Connection Pool مباشرة بعد أي ترحيل يغير نوع عمود يعيده استعلام، أو أن ينفذ التطبيق DEALLOCATE ALL عندما يرى هذا الخطأ ثم يعيد الطلب، أو أن تتجنب تغيير النوع تحت كود يعمل أصلاً، فتضيف العمود الجديد باسم جديد وتنقل الكود إليه في نشر منفصل، كما في الخطوة الثالثة من الصورة الأخيرة في هذا القسم.
إعادة التسمية بنسخ المخطط: pgroll
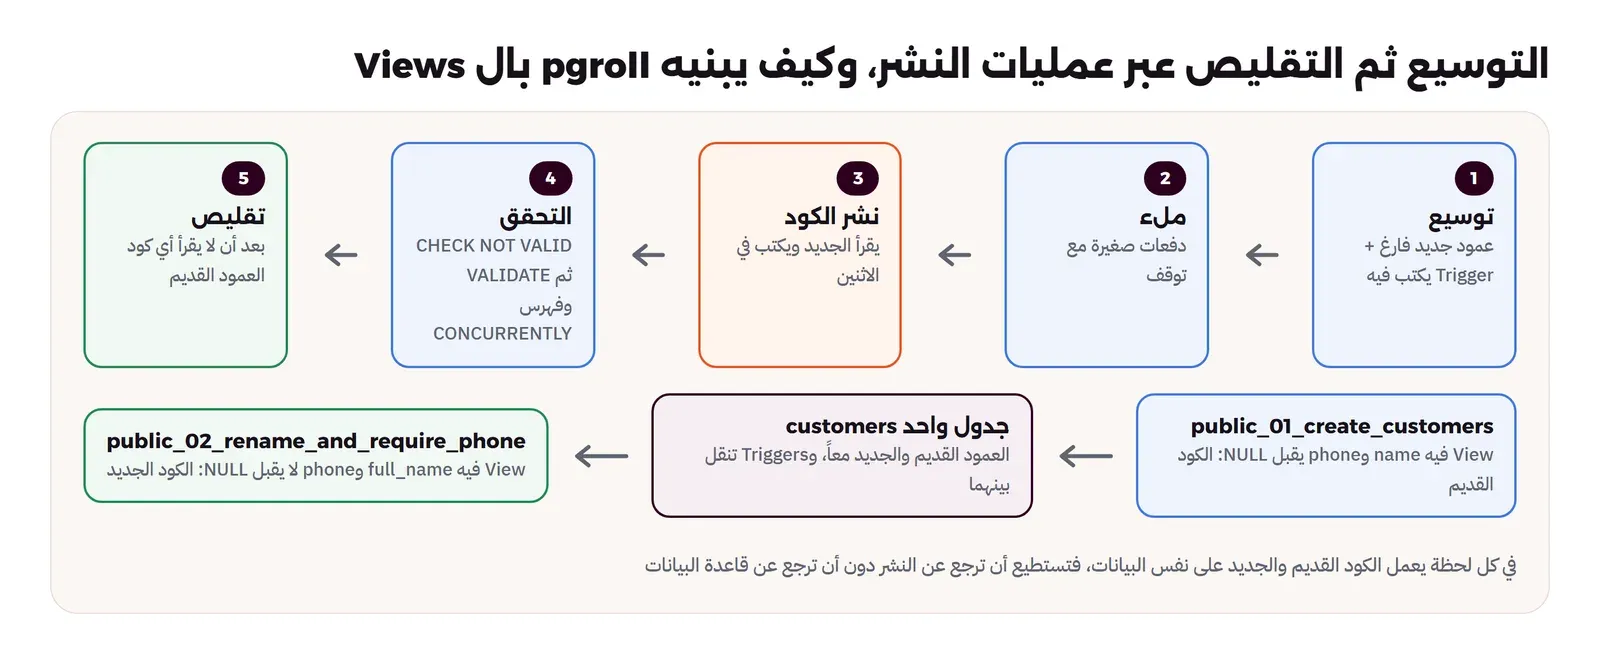
إعادة تسمية عمود أمر لحظي، ولكن الكود القديم الذي يقرأ الاسم القديم يتوقف فوراً، والحل اليدوي هو التوسيع ثم التقليص: عمود جديد ونسخ متزامن ونشران. وهناك طريقة أخرى: أن يبقى الجدول كما هو، وأن يرى كل إصدار من التطبيق «نسخة» من المخطط على شكل Views تعرض الأعمدة بالأسماء التي يعرفها. وهذه فكرة أداة pgroll مفتوحة المصدر من شركة Xata، ومثلها Reshape: تكتب الترحيل كعمليات JSON، فتنشئ الأداة لكل إصدار مخططاً Schema فيه Views، وتضيف الأعمدة وال Triggers وتملأ البيانات، ويختار كل إصدار من التطبيق مخططه بالإعداد search_path. والترحيل في التجربة يعيد تسمية name إلى full_name، ويجعل phone لا يقبل NULL مع قيمة للصفوف القديمة:
{
  "operations": [
    { "rename_column": { "table": "customers", "from": "name", "to": "full_name" } },
    {
      "alter_column": {
        "table": "customers",
        "column": "phone",
        "nullable": false,
        "up": "SELECT CASE WHEN phone IS NULL THEN 'unknown' ELSE phone END",
        "down": "phone"
      }
    }
  ]
}
#!/bin/sh
# pgroll: two schema versions live at the same time, then the old one goes away
set -e
psql -qc "DROP DATABASE IF EXISTS rolldb" -c "CREATE DATABASE rolldb" # pgroll wants a schema it manages from the start
export PGDATABASE=rolldb
export PGROLL_PG_URL="postgres://postgres:lab@pg:5432/rolldb?sslmode=disable"
pgroll init
pgroll start --complete 01_create_customers.json
psql -qc "INSERT INTO customers (name, phone) VALUES ('Sara', '0500000001'), ('Omar', NULL)"
pgroll start 02_rename_and_require_phone.json
echo "--- schemas"
psql -Atc "SELECT schema_name FROM information_schema.schemata WHERE schema_name LIKE 'public_%' ORDER BY 1"
echo "--- the old app (version 01) still reads and writes name and a NULL phone"
psql -c "SET search_path TO public_01_create_customers" \
-c "INSERT INTO customers (name, phone) VALUES ('Huda', NULL)" \
-c "SELECT * FROM customers ORDER BY id"
echo "--- the new app (version 02) sees full_name, and phone is never NULL"
psql -c "SET search_path TO public_02_rename_and_require_phone" \
-c "INSERT INTO customers (full_name, phone) VALUES ('Ali', '0500000004')" \
-c "SELECT * FROM customers ORDER BY id"
echo "--- the real table during the migration"
psql -c "\d customers"
pgroll complete
echo "--- after complete"
psql -Atc "SELECT schema_name FROM information_schema.schemata WHERE schema_name LIKE 'public_%' ORDER BY 1"
psql -c "\d customers"والمخرج سوف يكون كما يلي:
 SUCCESS  Initialization complete
 SUCCESS  New version of the schema available under the postgres "public_01_create_customers" schema
 SUCCESS  New version of the schema available under the postgres "public_02_rename_and_require_phone" schema
--- schemas
public_01_create_customers
public_02_rename_and_require_phone
--- the old app (version 01) still reads and writes name and a NULL phone
SET
INSERT 0 1
   phone    | id | name
------------+----+------
 0500000001 |  1 | Sara
            |  2 | Omar
            |  3 | Huda
(3 rows)
--- the new app (version 02) sees full_name, and phone is never NULL
SET
INSERT 0 1
   phone    | full_name | id
------------+-----------+----
 0500000001 | Sara      |  1
 unknown    | Omar      |  2
 unknown    | Huda      |  3
 0500000004 | Ali       |  4
(4 rows)
--- the real table during the migration
                                    Table "public.customers"
         Column         |  Type   | Collation | Nullable |                Default
------------------------+---------+-----------+----------+---------------------------------------
 id                     | bigint  |           | not null | nextval('customers_id_seq'::regclass)
 name                   | text    |           | not null |
 phone                  | text    |           |          |
 _pgroll_new_phone      | text    |           |          |
 _pgroll_needs_backfill | boolean |           |          | true
Indexes:
    "customers_pkey" PRIMARY KEY, btree (id)
Check constraints:
    "_pgroll_check_not_null_phone" CHECK (_pgroll_new_phone IS NOT NULL) NOT VALID
Triggers:
    _pgroll_trigger_customers__pgroll_new_phone BEFORE INSERT OR UPDATE ON customers FOR EACH ROW EXECUTE FUNCTION _pgroll_trigger_customers__pgroll_new_phone()
    _pgroll_trigger_customers_phone BEFORE INSERT OR UPDATE ON customers FOR EACH ROW EXECUTE FUNCTION _pgroll_trigger_customers_phone()
 SUCCESS  Migration successful!
--- after complete
public_02_rename_and_require_phone
                             Table "public.customers"
  Column   |  Type  | Collation | Nullable |                Default
-----------+--------+-----------+----------+---------------------------------------
 id        | bigint |           | not null | nextval('customers_id_seq'::regclass)
 full_name | text   |           | not null |
 phone     | text   |           | not null |
Indexes:
    "customers_pkey" PRIMARY KEY, btree (id)
في المخرج أعلاه لاحظ التالي:
- أثناء الترحيل كان هناك مخططان، والكود القديم الذي يستخدم
public_01_create_customersأضاف عميلاً بالاسمnameودون رقم هاتف، والكود الجديد فيpublic_02_rename_and_require_phoneرأى نفس العملاء بالاسمfull_name، ورأى الرقمunknownبدل NULL حتى للعميل الذي أضافه الكود القديم للتو. - الجدول الحقيقي يكشف كيف فعل ذلك: عمود مؤقت
_pgroll_new_phone، وTriggers تنقل القيم بين العمودين في الاتجاهين، وقيدCHECK ... NOT VALID، أي نفس الخطوات التي كتبناها بأيدينا في تجربة bigint. - بعد
pgroll completeاختفى المخطط القديم والأعمدة المؤقتة، وأصبح الجدول بأسمائه الجديدة وphoneلا يقبل NULL، وهذه خطوة التقليص.
والثمن أن التطبيق يجب أن يحدد مخططه في كل اتصال، وأن كل جدول يحمل أثناء الترحيل أعمدة وTriggers إضافية تبطئ الكتابة قليلاً، وأن الأداة تريد أن تدير المخطط من البداية، فقد رفضت العمل على قاعدة البيانات التي فيها جدول الطلبات بالرسالة Schema "public" is non-empty but has no migration history. Run `pgroll baseline` first، لذلك شغلناها على قاعدة بيانات جديدة، ومع قاعدة بيانات قائمة تبدأ بالأمر pgroll baseline.
أداة الترحيل والمعاملة: Alembic وCREATE INDEX CONCURRENTLY
أغلب أدوات الترحيل تشغل كل ملف داخل معاملة، وهذا جيد في أغلب الحالات لأن الترحيل الذي يفشل في منتصفه يلغى كله، ولكنه يتعارض مع الأوامر التي لا تعمل داخل معاملة، وأشهرها CREATE INDEX CONCURRENTLY. والملف env.py في التجربة يضع lock_timeout على اتصال الترحيل كله، ويشغل كل ملف في معاملة خاصة به، والترحيل الأول يكتب الفهرس بالطريقة المعتادة في Alembic، على قاعدة بيانات صغيرة منفصلة حتى لا تتأثر التجارب الأخرى:
# Minimal Alembic environment: online migrations only, with a lock_timeout on every migration connection.
from alembic import context
from sqlalchemy import create_engine, text

config = context.config
engine = create_engine(config.get_main_option("sqlalchemy.url"))

with engine.connect() as connection:
    # never wait more than 2 seconds for a table lock: fail, and let the deploy retry later
    connection.execute(text("SET lock_timeout = '2s'"))
    connection.commit()
    context.configure(connection=connection, target_metadata=None, transaction_per_migration=True)
    with context.begin_transaction():
        context.run_migrations()
"""index orders.customer_id without blocking writes"""
from alembic import op
revision = "0001"
down_revision = None
def upgrade():
op.create_index("orders_customer", "orders", ["customer_id"], postgresql_concurrently=True)
def downgrade():
op.drop_index("orders_customer", table_name="orders", postgresql_concurrently=True)ثم نشغله، ثم نستبدله بنسخة تخرج من المعاملة لهذا الأمر فقط بالدالة autocommit_block كما يشرح توثيق Alembic، وفي الآخر نطلب من Alembic أن يطبع ال SQL الذي يرسله دون تنفيذه بالخيار --sql:
"""index orders.customer_id without blocking writes"""
from alembic import op

revision = "0001"
down_revision = None


def upgrade():
    # CREATE INDEX CONCURRENTLY cannot run inside a transaction: step out of Alembic's transaction for it
    with op.get_context().autocommit_block():
        op.create_index("orders_customer", "orders", ["customer_id"], postgresql_concurrently=True)


def downgrade():
    with op.get_context().autocommit_block():
        op.drop_index("orders_customer", table_name="orders", postgresql_concurrently=True)
docker exec sw4-mig-tools sh /lab/alembic/demo.shوالمخرج سوف يكون كما يلي:
NOTICE:  database "alemb" does not exist, skipping
== alembic upgrade head (op.create_index with postgresql_concurrently=True)
psycopg.errors.ActiveSqlTransaction: CREATE INDEX CONCURRENTLY cannot run inside a transaction block
(psycopg.errors.ActiveSqlTransaction) CREATE INDEX CONCURRENTLY cannot run inside a transaction block
== the fixed migration: autocommit_block()
== the SQL Alembic sent, offline mode
BEGIN;
CREATE TABLE alembic_version (
COMMIT;
CREATE INDEX CONCURRENTLY orders_customer ON orders (customer_id);
BEGIN;
INSERT INTO alembic_version (version_num) VALUES ('0001') RETURNING alembic_version.version_num;
COMMIT;
                               Table "public.orders"
   Column    |  Type   | Collation | Nullable |              Default
-------------+---------+-----------+----------+------------------------------------
 id          | bigint  |           | not null | nextval('orders_id_seq'::regclass)
 customer_id | integer |           | not null |
Indexes:
    "orders_pkey" PRIMARY KEY, btree (id)
    "orders_customer" btree (customer_id)
الترحيل الأول فشل بالخطأ CREATE INDEX CONCURRENTLY cannot run inside a transaction block مع أن الخيار postgresql_concurrently=True مكتوب صراحة، لأن Alembic فتح معاملة قبل الملف. والنسخة المصححة نجحت، وال SQL المطبوع يبين ما حدث: معاملة لجدول الإصدارات، ثم الأمر CREATE INDEX CONCURRENTLY وحده خارج أي معاملة، ثم معاملة جديدة تسجل رقم الإصدار. ولاحظ نتيجة مهمة لذلك: إذا فشل الفهرس فلن يلغى ما قبله، وسوف يبقى فهرس غير صالح كما رأيت في التجربة الثالثة، فاجعل هذا الأمر وحده في ملف ترحيل خاص به.
والأدوات الأخرى تواجه نفس القرار بأسماء مختلفة. ففي Flyway تحدد للملف أنه لا يعمل في معاملة بالإعداد executeInTransaction كما يشرح توثيق Flyway، وفي sqitch تكتب لكل تغيير ثلاثة ملفات SQL للتنفيذ والإلغاء والتحقق Verify، ويعتمد على ترتيب التغييرات في ملف خطة Plan وليس على أرقام الإصدارات. وكلها تشترك في أنها تنفذ ما تكتبه بالترتيب، ولا تعرف هل الأمر يقفل الجدول أم لا، فلا تحميك من أي شيء رأيته في هذا المقال، وإنما تحفظ أي ترحيل نفذ على أي قاعدة بيانات. أما pgroll وReshape فتنفذ بنفسها خطوات التوسيع ثم التقليص.
الترحيل والنشر: بأي ترتيب؟
كل ما سبق عن قاعدة البيانات وحدها، ولكن الترحيل جزء من نشر التطبيق، والسؤال الذي يسبب أغلب المشكلات: هل تشغل الترحيل قبل نشر الكود الجديد أم بعده؟ والإجابة أن كل ترحيل يجب أن يكون متوافقاً مع الكود الذي يعمل قبله والكود الذي يأتي بعده في نفس الوقت، لأن النشر التدريجي Rolling Deployment يعني أن النسختين تعملان معاً دقائق، وأن الرجوع عن النشر يعني أن الكود القديم يعود إلى قاعدة بيانات تغيرت. ولذلك يقسم التغيير الواحد إلى خطوات، كل خطوة في نشر مستقل، وهذا ما يسميه Martin Fowler Parallel Change:
- التوسيع Expand، قبل الكود: كل ما يضيف ولا يحذف، أي جدول جديد، أو عمود يقبل NULL، أو فهرس CONCURRENTLY، أو Trigger يملأ العمود الجديد. والكود القديم لا يرى شيئاً من ذلك.
- الملء Backfill، في الخلفية: مهمة على دفعات صغيرة، تعمل ساعات إذا احتاجت، ويمكن أن تتوقف وتكمل.
- نشر الكود الذي يكتب في الاثنين ويقرأ الجديد: وإذا ظهرت مشكلة ترجع عن هذا النشر فقط، والبيانات القديمة ما زالت صحيحة.
- التحقق Validate: القيود بالطريقة NOT VALID ثم VALIDATE، والفهارس الفريدة CONCURRENTLY.
- التقليص Contract، بعد الكود: حذف العمود أو الجدول القديم، ولكن فقط بعد أن تتأكد أنه لا يوجد كود يقرؤه، ولا تقارير، ولا Views، ولا مهام ليلية.
ولاحظ أن حذف عمود لحظي في PostgreSQL، ولكنه قد يكسر الكود الذي لا يذكره أصلاً، فبعض ال ORMs تحفظ قائمة الأعمدة عند تشغيل التطبيق وتكتبها صراحة في كل INSERT، فإذا حذفت عموداً تعرفه النسخة القديمة فشلت كل إضافة فيها حتى تعيد تشغيلها. لذلك يخبر الكود أولاً بأن العمود سوف يحذف، كما يفعل الخيار ignored_columns في Rails، ثم يحذف العمود في نشر لاحق. وهي نفس فكرة الخطط المحفوظة التي رأيتها في تجربة bigint: الكود الذي يعمل يحمل في ذاكرته صورة عن الجدول، وأي تغيير يكسر هذه الصورة يحتاج نشراً يجددها.
قواعد الترحيل الآمن في PostgreSQL
من كل ما سبق تخرج قواعد قليلة تغطي أغلب الحالات، وكلها مبنية على ما يقوله توثيق ALTER TABLE وعلى ما قسناه:
| التغيير | الطريقة الخطرة | الطريقة الآمنة |
|---|---|---|
| كل أمر يأخذ ACCESS EXCLUSIVE | دون مهلة، فينتظر خلف أي معاملة طويلة | SET lock_timeout بين 100 مللي ثانية وثانيتين، وإعادة المحاولة بتأخير متزايد |
| عمود جديد | قيمة افتراضية متغيرة مثل clock_timestamp() أو عمود مولد STORED | عمود يقبل NULL أو بقيمة ثابتة، ثم ملء على دفعات |
| NOT NULL على عمود موجود | SET NOT NULL مباشرة | CHECK (col IS NOT NULL) NOT VALID ثم VALIDATE ثم SET NOT NULL |
| مفتاح أجنبي أو CHECK | ADD CONSTRAINT يقرأ الجدول كله | ADD CONSTRAINT ... NOT VALID ثم VALIDATE CONSTRAINT |
| فهرس | CREATE INDEX يوقف الكتابة | CREATE INDEX CONCURRENTLY في ملف ترحيل خاص، والبحث عن الفهارس غير الصالحة بعد الفشل |
| فهرس فريد أو مفتاح أساسي جديد | ADD PRIMARY KEY يبني الفهرس والقفل ممسوك | CREATE UNIQUE INDEX CONCURRENTLY ثم ADD CONSTRAINT ... USING INDEX |
| ملء عمود | أمر UPDATE واحد على كل الجدول | دفعات صغيرة بحدود المعرف، مع توقف قصير ومراقبة زمن التطبيق وتأخر النسخ |
| تغيير نوع عمود | ALTER COLUMN TYPE يعيد كتابة الجدول | عمود جديد وTrigger وملء وتبديل قصير، ثم تجديد اتصالات التطبيق |
| إعادة تسمية عمود أو جدول | RENAME والكود القديم يعمل | التوسيع ثم التقليص بنشرين، أو Views لكل إصدار كما في pgroll |
| حذف عمود أو جدول | في نفس نشر الكود الذي توقف عن استخدامه | بعد نشر لا يعرف العمود، وبعد التأكد من التقارير والمهام |
وبعض التغييرات آمنة دائماً تقريباً، مثل إضافة جدول جديد، وإضافة عمود يقبل NULL، وزيادة طول varchar أو تحويله إلى text لأنهما لا يعيدان كتابة الجدول، وحذف قيد أو فهرس بالأمر DROP INDEX CONCURRENTLY. ولكن أغلب هذه الأوامر يأخذ ACCESS EXCLUSIVE ولو لحظة، فتحتاج هي أيضاً مهلة القفل.
وقد يتساءل البعض: هل أحتاج كل هذا لجدول فيه ألف صف؟ والإجابة لا، فالأمر المباشر على جدول صغير ينتهي في مللي ثوان، والطريقة الطويلة لها ثمن في الوقت والتعقيد. ولكن مهلة القفل تبقى ضرورية حتى للجداول الصغيرة، لأن الطابور لا يهتم بحجم الجدول، وإنما بوجود معاملة مفتوحة عليه، والجدول الصغير قد يكون أكثر الجداول قراءة في التطبيق، كما في حالة GoCardless. والقاعدة العملية أن تعرف حجم كل جدول وعدد الطلبات عليه قبل أن تكتب ترحيله، وأن تجرب الترحيل على نسخة بحجم الإنتاج مع ضغط حقيقي، كما فعلنا في هذا المقال، قبل أن تشغله على الإنتاج.
أخطاء شائعة Common Mistakes
- ترحيل دون lock_timeout: أمر لحظي ينتظر خلف تقرير مفتوح فيوقف التطبيق كله، كما رأيت في التجربة الأولى.
- تشغيل الترحيل عند بدء كل نسخة من التطبيق: عشر نسخ تبدأ معاً تحاول نفس الترحيل، والنشر ينتظر ترحيلاً طويلاً، والأفضل خطوة مستقلة في ال Pipeline قبل نشر الكود أو بعده بحسب نوع التغيير.
- الترحيل الطويل داخل معاملة واحدة: عدة أوامر في ملف واحد داخل معاملة تعني أن القفل الذي أخذه الأمر الأول يبقى ممسوكاً حتى ينتهي الأخير.
- الملء بأمر UPDATE واحد: لا يقفل الجدول، ولكنه يقفل كل الصفوف حتى ينتهي، فيتوقف كل تعديل في التطبيق.
- الدفعات الكبيرة دون قياس: تحل مشكلة الأقفال وتصنع مشكلة في كتابة ال WAL، ويظهر ذلك في
wait_eventوليس فيpg_locks. - فهرس CONCURRENTLY داخل معاملة الأداة: يفشل الترحيل، أو يبقى فهرس غير صالح بعد الفشل دون أن يلاحظ أحد.
- تغيير نوع عمود والتطبيق يعمل بخطط محفوظة: الترحيل ينجح ثم يفشل التطبيق بالخطأ
cached plan must not change result typeحتى تجدد الاتصالات. - إعادة التسمية أو الحذف في نفس نشر الكود: النسخة القديمة التي ما زالت تعمل، أو التي ترجع إليها، تتوقف فوراً.
- الوثوق بالترحيل المولد تلقائياً: كما رأينا في مقال ORM، تحولت إعادة التسمية إلى حذف وإضافة، فاقرأ كل ملف ترحيل قبل تشغيله.
- معرفات من نوع integer دون مراقبة: اكتشاف الحد عندما يتوقف الإدخال كما حدث في Basecamp، بدل أن تراقب نسبة المستخدم من المدى قبل سنة.
قائمة تحقق Checklist
- كل اتصال ترحيل فيه
lock_timeoutقصير، والأداة أو السكربت يعيد المحاولة بتأخير متزايد. - لمستخدم التقارير والأدوات الإدارية مهلة للاستعلامات والمعاملات الخاملة
idle_in_transaction_session_timeout. - أعرف القفل الذي يأخذه كل أمر في الترحيل، وهل يقرأ الجدول أو يعيد كتابته.
- كل تغيير يحتاج أكثر من خطوة مقسم إلى نشرات: توسيع، ثم ملء، ثم كود، ثم تحقق، ثم تقليص.
- الملء على دفعات صغيرة يمكن أن تتوقف وتكمل، مع مراقبة زمن التطبيق وتأخر النسخ.
- القيود NOT VALID ثم VALIDATE، والفهارس CONCURRENTLY في ملفات خاصة بها، والبحث عن
indisvalid = falseبعد أي فشل. - بعد تغيير نوع عمود يعيده التطبيق: تجديد اتصالات ال Pool أو إعادة تشغيل التطبيق.
- جربت الترحيل على نسخة بحجم الإنتاج مع ضغط يشبه الإنتاج، وراقبت
pg_stat_activityوpg_locksأثناءه. - أراقب المعرفات من نوع integer ونسبة ما استخدم منها.
- عندي طريقة رجوع لكل خطوة، وأعرف الخطوات التي لا رجوع عنها إلا من نسخة احتياطية، مثل حذف عمود.
حذف المختبر Cleanup
docker compose down -v
docker rmi sw4-miglab sw4-postgres:18.6 sw4-python:3.13.18-slim
ماذا تقرأ بعد ذلك؟ Next Steps
هذا المقال في مرحلة قواعد البيانات في الإنتاج، والمقالات حوله تكمل الصورة: الأقفال وطابورها بالتفصيل، والتخزين من الداخل الذي يفسر لماذا يعيد تغيير النوع كتابة الجدول، والجداول الضخمة والتقسيم عندما يصبح الملء نفسه مشروعاً، والاستعادة إلى أي لحظة إذا أخطأ ترحيل ما.
 دليلالأقفال Locks والجمود Deadlock في قواعد البياناتلماذا يوقف أمر ALTER TABLE صغير كل الاستعلامات خلفه، وكيف تقرأ pg_locks وتتجنب الجمود وظواهر العزل في PostgreSQL.
 دليلتصميم قواعد البيانات: التطبيع Normalization ومتى تتخلى عنهلماذا يفشل الجدول الواحد الكبير، وكيف تقسمه إلى جداول لا تناقض نفسها، وما الذي يتغير عندما تكبر البيانات.
 دليلORM أم SQL مباشرة؟ كيف يتحدث تطبيقك مع قاعدة البياناتما الذي يرسله ال ORM إلى قاعدة البيانات نيابة عنك، بصفحة واحدة أرسلت 251 استعلاماً ثم استعلاماً واحداً مع SQLAlchemy وPostgreSQL، ومتى تكسب SQL المكتوبة يدوياً.
 دليلكيف تخزن قاعدة البيانات بياناتك من الداخلماذا يحدث على القرص عند INSERT وUPDATE وCOMMIT، ولماذا تنجو قاعدة البيانات من الانهيار، وكيف تختلف LSM عن B-tree.
 دليلPostgreSQL للجداول الضخمة: عشرات الملايين من الصفوفماذا تفعل عندما يصل جدول الطلبات إلى عشرات الملايين من الصفوف وتبطئ لوحة التحكم ويمتلئ القرص، وكيف تقيس قبل أن تصلح.
 دليلتقسيم الجداول Partitioning وتوزيعها على السيرفرات Shardingمتى تقسم الجدول داخل سيرفر واحد، ومتى توزع البيانات على عدة سيرفرات، وكيف تضيف سيرفراً وتتعامل مع العميل الضخم.
 دليلاستعادة PostgreSQL إلى أي لحظة مع pgBackRestكيف تأخذ نسخاً احتياطية من PostgreSQL مع أرشيف WAL، وتستعيد القاعدة إلى الثانية التي سبقت حذفاً خاطئاً.
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- أثر أي ترحيل على التطبيق يتحدد بالقفل الذي يأخذه، ومدة إمساكه، ووقت انتظاره قبل أن يحصل عليه، وأغلب أوامر ALTER TABLE تأخذ ACCESS EXCLUSIVE.
- أمر لحظي خلف تقرير مفتوح أوقف التطبيق 11 ثانية، ومع
lock_timeoutقدره ثانية وإعادة المحاولة لم يتجاوز أبطأ طلب 1.1 ثانية. - NOT NULL بقيد CHECK من نوع NOT VALID ثم VALIDATE يقرأ الجدول دون أن يوقف أحداً، والفهرس CONCURRENTLY أبطأ بثلاثة أضعاف ولا يوقف الكتابة، وإذا فشل يترك فهرساً غير صالح يجب حذفه.
- الملء بأمر واحد أوقف التطبيق 133 ثانية بأقفال الصفوف، والدفعات الكبيرة أزالت الأقفال وتركت توقفاً بسبب كتابة ال WAL، والدفعات الصغيرة مع توقف قصير لم توقف التطبيق ثانية واحدة.
- تحويل المفتاح الأساسي إلى bigint بأمر واحد أوقف التطبيق 77 ثانية، وبالتوسيع ثم التقليص أقل من ثانية ونصف، ولكن الخطط المحفوظة في الاتصالات أفشلت مئات الطلبات بعد الترحيل في الحالتين حتى أوقفنا Prepared Statements.
- pgroll يبني التوسيع ثم التقليص بنفسه بمخطط من Views لكل إصدار، وأدوات الترحيل الأخرى تحفظ ما نفذ ولا تحميك من الأقفال، وAlembic يحتاج
autocommit_blockلأي فهرس CONCURRENTLY. - قسم كل تغيير كبير إلى نشرات متوافقة مع الكود القديم والجديد، وجربه على نسخة بحجم الإنتاج مع ضغط حقيقي قبل أن تشغله.
سجل التحديثات Changelog
- 18 نوفمبر 2026: كتابة المقال، وتنفيذ التجارب على Docker Engine 29.8.0 مع PostgreSQL 18.6 (postgres:18.6) وPython 3.13.18 مع psycopg 3.3.9 وAlembic 1.20.1 وSQLAlchemy 2.1.9 وpgroll 0.16.3.