إذا كنت تعمل في التطوير أو التشغيل، فغالباً قرأت عنواناً مثل «تعبير نمطي واحد أوقف Cloudflare» أو «مهندس حذف قاعدة بيانات GitLab»، ثم مررت عليه وأنت تقول في نفسك: الحمد لله أن هذا لم يحدث عندنا. ولكن خلف كل عنوان من هذه العناوين تقرير طويل نشرته الشركة بعد أيام، كتبه مهندسون قضوا ساعات في فهم ما حدث، وفيه تفاصيل لا تجدها في أي كتاب: كيف تتصرف أنظمة حقيقية تحت ضغط حقيقي، وأين تفشل الحمايات التي كان الجميع يظن أنها تعمل، وما الذي تغير بعدها. وهذا التقرير اسمه تقرير ما بعد الحادثة Postmortem، وقراءته بطريقة صحيحة من أرخص الطرق لتتعلم من أخطاء غيرك قبل أن تدفع ثمنها بنفسك.
والمشكلة أن أغلب من يقرأ هذه التقارير يقرأها كقصة مثيرة، فيخرج منها بالعنوان فقط: «Regex سيئ» أو «مهندس متعب في الليل». أما القارئ الذي يعرف ما يبحث عنه، فيخرج من نفس التقرير بخمسة أسئلة عن نظامه هو، وثلاث تذاكر في قائمة عمل فريقه، وخطوة جديدة في دليل التشغيل Runbook. وهذا المقال عن الطريقة الثانية.
وسوف نناقش في هذا المقال ما يلي:
- ما هو تقرير ما بعد الحادثة، وأين تجد التقارير العامة التي نشرتها الشركات.
- أقسام التقرير الجيد، والسؤال الذي يجيب عنه كل قسم.
- طريقة قراءة في سبع خطوات، من الأثر والخط الزمني إلى العوامل المساهمة والإجراءات، ثم تطبيقها على تقرير AWS عن S3.
- كيف تميز لغة اللوم Blame من لغة النظام، ولماذا يهمك ذلك كقارئ.
- كيف تنقل الدرس من تقرير شركة أخرى إلى تذكرة ودليل تشغيل في نظامك، مع ثلاثة أمثلة حقيقية من AWS وGitLab وCloudflare.
- قائمة تحقق للقراءة، وأخطاء شائعة يقع فيها القارئ.
باختصار Quick Summary
اقرأ الخط الزمني بالدقائق: وابحث عن الفجوات بين الحدث والاكتشاف والقرار والعودة.
افصل المحفز عن العوامل المساهمة: فالمحفز يحدث مرة، والعوامل هي التي تتكرر في نظامك.
اسأل لماذا فشلت الحماية: النسخة الاحتياطية، والتنبيه، والتراجع Rollback.
اقرأ الإجراءات: هل تغير الأدوات والأنظمة أم تطلب من الناس أن «ينتبهوا»؟
انقل الدرس: حقيقة، ثم سؤال عن نظامك، ثم إجراء له مالك، ثم سطر في دليل التشغيل.
ما هو تقرير ما بعد الحادثة Postmortem؟
يعرفه كتاب Google عن هندسة موثوقية المواقع في فصل Postmortem Culture: Learning from Failure بأنه سجل مكتوب للحادثة، وأثرها، والإجراءات التي اتخذت لتخفيفها أو حلها، وأسبابها، وإجراءات المتابعة التي تمنع تكرارها. ويقول الفصل إن كتابة التقرير «ليست عقوبة»، وإنما فرصة تعلم للشركة كلها، ويقترح معايير تحدد متى يكتب التقرير قبل أن تقع الحادثة، ومنها:
- توقف أو تدهور يلاحظه المستخدم فوق حد معين.
- فقدان بيانات من أي نوع.
- تدخل يدوي من المناوب On-call، مثل التراجع عن إصدار أو تحويل حركة المرور.
- زمن حل أطول من حد معين.
- فشل في المراقبة، أي أن الحادثة اكتشفها إنسان وليس تنبيهاً آلياً.
وهناك نوعان من التقارير: التقرير الداخلي الذي يكتبه الفريق لنفسه، وفيه تفاصيل الأنظمة والأسماء الداخلية، والتقرير العام الذي تنشره الشركة لعملائها وللناس، وهو أقصر وأكثر حذراً ولكنه ما زال غنياً. وفي هذا المقال نتحدث عن قراءة التقارير العامة، لأنها المتاحة لك، أما كتابة تقرير لفريقك بعد حادثة عندكم فقد شرحناها بقالب كامل في مقال من يتحمل المسؤولية عندما يتعطل الإنتاج، وشرحنا كيف تصل إليها من لحظة التنبيه في مقال إدارة الحوادث Incident Response.
أين تجد التقارير العامة؟
أغلب الشركات الكبيرة تنشر تقاريرها في مدونتها الهندسية أو صفحة الحالة Status Page الخاصة بها، وبعضها، مثل AWS، لها صفحة خاصة بملخصات الحوادث الكبرى. وإذا أردت مكتبة جاهزة فهناك مستودع danluu/post-mortems على GitHub الذي يجمع روابط مئات التقارير مصنفة حسب نوع الخطأ: إعدادات، وتحديثات، وأعطال عتاد، وغيرها. والتقارير الثلاثة التي سوف نستخدمها أمثلة في هذا المقال كلها عامة ويمكنك قراءتها كاملة:
- Summary of the Amazon S3 Service Disruption: توقف خدمة S3 في منطقة US-EAST-1 في 28 فبراير 2017.
- Postmortem of database outage of January 31: حذف بيانات قاعدة GitLab.com الأساسية وفقدان ساعات من البيانات.
- Details of the Cloudflare outage on July 2, 2019: انقطاع عالمي لمدة 27 دقيقة بسبب قاعدة في جدار حماية تطبيقات الويب WAF.
أقسام التقرير الجيد
لا يوجد قالب واحد تلتزم به كل الشركات، ولكن أغلب التقارير الجيدة تجيب عن نفس الأسئلة. ويضع كتاب Google نموذجاً كاملاً في صفحة Example Postmortem لحادثة خيالية عن محرك بحث في أعمال Shakespeare، وأقسامه تصلح خريطة لقراءة أي تقرير:
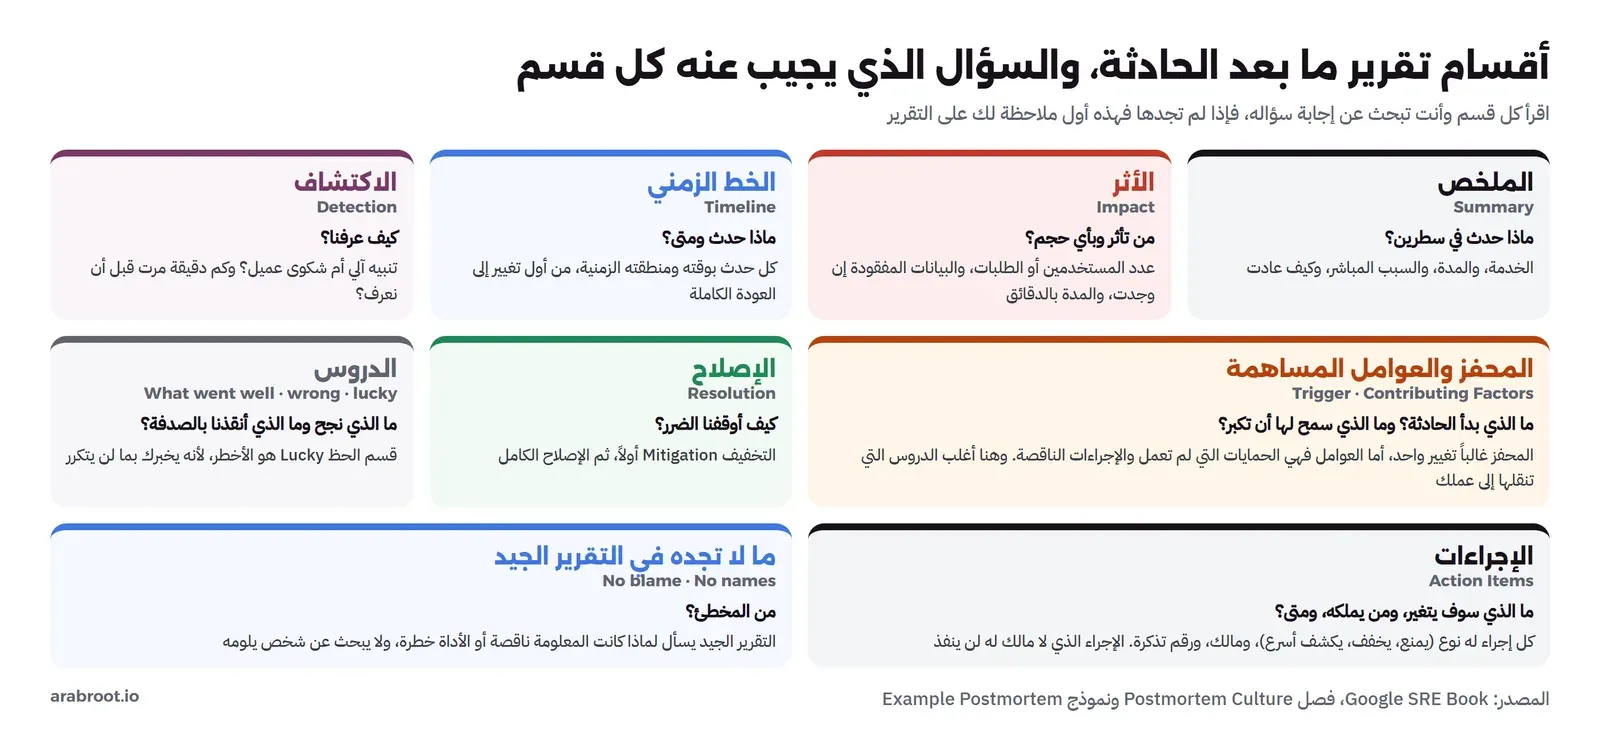
ولاحظ في نموذج Google قسماً صغيراً يغفل عنه أغلب القراء اسمه «أين حالفنا الحظ Where we got lucky»، وفيه أشياء أنقذت الفريق دون أن يخطط لها أحد، مثل أن رسالة بريد بالمعلومة المطلوبة وصلت بالصدفة في الوقت المناسب. وهذا القسم من أهم ما تقرأ، لأنه يخبرك بما لن يتكرر في المرة القادمة، فالحظ ليس جزءاً من خطة الاستمرارية.
كيف تقرأ التقرير؟ سبع خطوات
الطريقة التالية هي ما نقترحه لقراءة أي تقرير عام، وكل خطوة فيها تجيب عن سؤال، وفي آخر كل خطوة سطر واحد تكتبه في ملاحظاتك.
1. ابدأ بالأثر والمدة Impact
قبل أن تقرأ أي تفصيل تقني، اعرف حجم ما حدث: من تأثر، وكم دقيقة أو ساعة، وهل ضاعت بيانات. ففي تقرير GitLab مثلاً تجد في الفقرة الأولى أن الحادثة أفقدت تعديلات قاعدة البيانات بين 17:20 ومنتصف الليل بتوقيت UTC، وأن التقدير حوالي 5,000 مشروع و5,000 تعليق و700 حساب جديد، وأن مستودعات Git نفسها لم تتأثر. وفي تقرير Cloudflare تجد المدة: 27 دقيقة لخدمة HTTP وHTTPS حول العالم. وهذه الأرقام تحدد كيف تقرأ الباقي: حادثة 27 دقيقة سؤالها الأساسي «لماذا لم نكتشفها ونوقفها أسرع؟»، وحادثة فيها فقدان بيانات سؤالها الأساسي «لماذا لم تنقذنا النسخ الاحتياطية؟».
2. اقرأ الخط الزمني بالدقائق وابحث عن الفجوات
الخط الزمني Timeline هو أصدق جزء في التقرير، لأنه مبني غالباً على سجلات وتنبيهات ورسائل محفوظة. ولا تقرأه كقصة، وإنما احسب المسافة بين كل حدثين، لأن الدروس الحقيقية في الفجوات. والصورة التالية من تقرير Cloudflare:
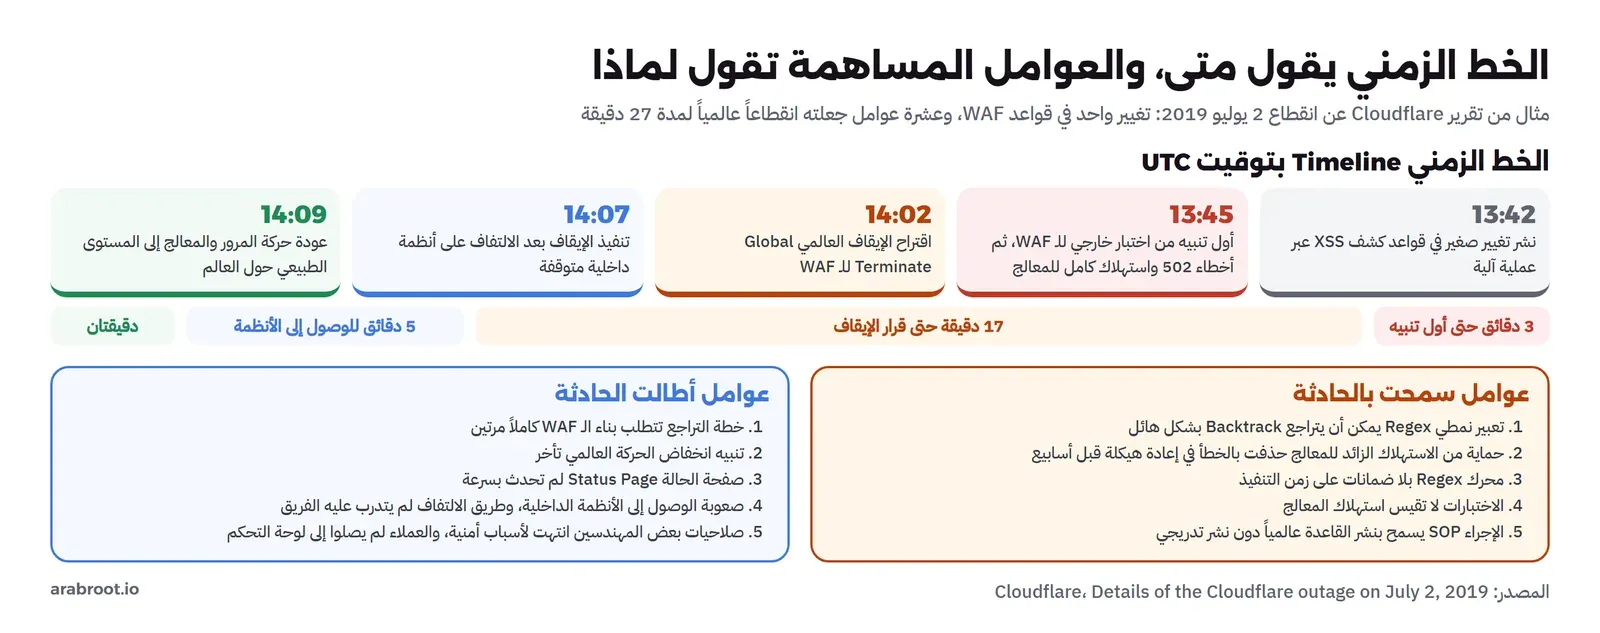
لاحظ أن التنبيه الأول جاء بعد 3 دقائق فقط من النشر، أي أن المراقبة عملت بشكل جيد. أما الوقت الأطول فكان بين التنبيه وقرار الإيقاف العالمي، ثم 5 دقائق أخرى لتنفيذ القرار، لأن الفريق، كما يقول التقرير، لم يستطع الدخول إلى لوحة التحكم الداخلية، لأن خدمة الدخول نفسها تعمل خلف Cloudflare المتوقفة، واضطر إلى طريق التفاف لم يكن يستخدم كثيراً. وهذه الملاحظة وحدها تعطيك سؤالاً لنظامك: إذا توقف نظام الدخول الموحد SSO عندك، فكيف يصل المناوب إلى الأدوات التي يحتاجها لإصلاحه؟
وفي تقرير AWS فجوة من نوع آخر: فالتقرير يقول إن الفريق لم يستطع تحديث حالة الخدمات على لوحة الحالة الرسمية حتى 11:37 صباحاً بتوقيت المحيط الهادئ، أي قرابة ساعتين من بداية الحادثة، لأن واجهة إدارة اللوحة نفسها تعتمد على S3. وهذا نمط يتكرر كثيراً: أداة المراقبة أو التواصل تعتمد على الشيء الذي تراقبه.
3. افصل المحفز عن العوامل المساهمة
كل حادثة لها محفز Trigger، أي التغيير أو الحدث الذي بدأها: أمر بمدخل خاطئ، أو قاعدة جديدة، أو ارتفاع مفاجئ في الحركة. والقارئ المستعجل يتوقف عنده، ولكن المحفز وحده نادراً ما يكفي لصنع حادثة كبيرة. ويقول تقرير Cloudflare ذلك صراحة: «الوصول إلى سبب جذري واحد، رغم أنه مريح، قد يخفي الحقيقة»، ثم يذكر عشرة عوامل اجتمعت معاً، تراها في الصورة أعلاه، ومنها أن حماية تمنع الاستهلاك الزائد للمعالج كانت قد حذفت بالخطأ في إعادة هيكلة قبل أسابيع، وأن إجراء النشر كان يسمح بنشر قواعد الـ WAF عالمياً دون نشر تدريجي، بخلاف باقي البرمجيات في الشركة.
وهذا الفهم له أساس قديم في هندسة السلامة، ففي الورقة القصيرة المشهورة How Complex Systems Fail يكتب الطبيب والباحث Richard Cook أن نسبة الحادثة إلى «سبب جذري» بعد وقوعها «خاطئة من الأساس»، لأن الفشل الكبير يحتاج عدة أخطاء، كل واحد منها لا يكفي وحده، وإنما ارتباطها معاً هو الذي يصنع الحادثة. لذلك عندما تقرأ تقريراً اكتب قائمتين: ما الذي سمح بالحادثة، وما الذي أطالها. والقائمة الثانية غالباً أهم لك، لأن المحفز عندك سوف يكون مختلفاً، أما التراجع البطيء والتنبيه المتأخر والأدوات التي لا تصل إليها، فهي موجودة في أغلب الأنظمة.
4. اسأل: لماذا لم تعمل الحماية؟
في كل نظام حمايات وضعها أحد ما لهذا اليوم بالضبط: نسخ احتياطية، ونسخة احتياطية ثانية، وتنبيهات، وخطة تراجع. والسؤال الأهم في أي تقرير هو لماذا لم تعمل هذه الحمايات عندما احتاجها الفريق. وتقرير GitLab أفضل مثال، لأنه يستخدم طريقة الأسئلة الخمسة 5 Whys التي شرحناها في مقال اسأل لماذا خمس مرات، ويصل إلى سلسلة تستحق أن تقرأها ببطء:
- النسخ الاحتياطي اليومي بالأداة
pg_dumpلم يكن موجوداً، لأن الأداة كانت تعمل بالإصدار 9.2 بينما قاعدة البيانات بالإصدار 9.6، فكانت تفشل كل يوم. - والفشل كان صامتاً، لأن تنبيهات الفشل ترسل بالبريد، والبريد لم يكن موقعاً بإعدادات DMARC، فكان الخادم المستقبل يرفضه.
- والنسخ اللحظية Snapshots من Azure لم تكن مفعلة لسيرفرات قاعدة البيانات، لأن الفريق افترض أن الطرق الأخرى تكفي.
- والسؤال الأخير في السلسلة: لماذا لم يختبر أحد إجراء النسخ بانتظام؟ والإجابة: «لأنه لم يكن له مالك، فلم يكن أحد مسؤولاً عن اختباره».
ولاحظ أن الإجابة الأخيرة ليست تقنية إطلاقاً. ومن تقرير واحد خرجت بثلاثة أسئلة لنظامك: هل يصل تنبيه فشل النسخ فعلاً إلى إنسان؟ ومتى آخر مرة استعدتم نسخة كاملة؟ ومن يملك هذا الاختبار باسمه؟ وقد شرحنا اختبار الاستعادة في مقال النسخ الاحتياطي بقاعدة 3-2-1 واختبار الاستعادة.
5. اقرأ الإجراءات: هل تغير النظام أم تطلب من الناس الانتباه؟
قسم الإجراءات Action Items هو الذي يكشف جودة التقرير كله. والإجراء الجيد يغير شيئاً في الأدوات أو الأنظمة أو الإجراءات، أما الإجراء الضعيف فيطلب من الناس أن يكونوا «أكثر حذراً» أو «أكثر انتباهاً». وتقرير AWS مثال واضح على النوع الأول، فرغم أن الحادثة بدأت بمدخل خاطئ كتبه موظف، لم يطلب التقرير منه أو من غيره أن ينتبه، وإنما قال إن الأداة «سمحت بحذف سعة كبيرة بسرعة كبيرة»، وإنهم عدلوها لتحذف السعة ببطء، وأضافوا حماية تمنع حذف سعة تنزل بأي نظام فرعي تحت حده الأدنى، وبدأوا مراجعة أدوات التشغيل الأخرى بحثاً عن نفس النقص.
وتقرير GitLab يقول نفس الفكرة بكلمات أخرى، فقد كتب الفريق أن تركيزهم على تحسين الاستعادة، وعلى أن يكون واضحاً أي سيرفر تستخدم، «بدل منع المهندسين من تشغيل أوامر معينة»، وأن البيئة المثالية هي التي تستطيع فيها أن تخطئ ثم تتعافى بسرعة ودون أثر. ومن إجراءاتهم المكتوبة تعديل سطر الأوامر في كل السيرفرات ليميز السيرفرات والبيئات بوضوح، وتعيين مالك لسلامة البيانات. لذلك عندما تقرأ قسم الإجراءات اسأل عن كل إجراء ثلاثة أسئلة: هل يغير شيئاً حقيقياً؟ وهل له مالك؟ وهل يمكن أن تنفذ مثله عندك؟
6. احذر من حكمة ما بعد الحدث Hindsight Bias
عندما تعرف النهاية يبدو لك كل شيء واضحاً: «كيف لم يلاحظوا أنهم على سيرفر الإنتاج؟». ويسمي Richard Cook هذا الانحياز في نفس الورقة بانحياز ما بعد الحدث، ويقول إن معرفة النتيجة تجعل العلامات التي سبقتها تبدو أوضح مما كانت عليه فعلاً للناس في تلك اللحظة. والتقرير الجيد يحاول أن يعيد بناء ما كان يعرفه الناس وقت القرار، كما فعل تقرير GitLab عندما ذكر أن الأداة pg_basebackup كانت تنتظر بصمت دون أي مخرج، وأن هذا السلوك لم يكن موثقاً في أدلة الفريق ولا في الوثائق الرسمية، أي أن المهندس كان يتخذ قراره بمعلومة ناقصة. وأنت كقارئ اسأل نفسك عند كل قرار في الخط الزمني: بالمعلومة التي كانت لديهم، هل كنت سوف أتصرف بشكل مختلف؟ والإجابة الصادقة غالباً «لا»، وهنا يبدأ الدرس الحقيقي.
7. لاحظ ما لم يذكره التقرير
التقرير العام يكتب لجمهور، لذلك فيه أشياء لا تقال. فقد يذكر التقرير المدة ولا يذكر عدد العملاء، أو يذكر الإجراءات دون تواريخ، أو يتحدث عن «خطأ بشري» دون أن يشرح لماذا كان هذا الخطأ ممكناً. ولا تعتبر ذلك سوء نية بالضرورة، فبعض التفاصيل أمنية أو قانونية، ولكن انتبه إلى أن غياب قسم كامل، مثل الاكتشاف أو الدروس، يعني أن جزءاً من الصورة ليس أمامك، فلا تبن عليه استنتاجاً قوياً.
مثال كامل: قراءة تقرير AWS عن S3 في 2017
لنطبق الخطوات السبع على تقرير واحد قصير يمكنك أن تقرأه في عشر دقائق، وهو ملخص حادثة S3 في 28 فبراير 2017. والمطلوب منك أثناء القراءة أن تكتب سطراً واحداً لكل خطوة، وهذا ما خرجنا به:
- الأثر: خدمة S3 في منطقة US-EAST-1 لم تستطع خدمة الطلبات أثناء إعادة تشغيل نظامين فرعيين، ومعها تأثرت خدمات أخرى تعتمد عليها في نفس المنطقة مثل تشغيل أجهزة EC2 جديدة وAWS Lambda.
- الخط الزمني: الأمر نفذ في 9:37 صباحاً بتوقيت المحيط الهادئ، وعادت طلبات القراءة والحذف بالكامل في 1:18 ظهراً، وعادت طلبات الكتابة في 1:54، أي أن الإصلاح نفسه أخذ أغلب الوقت وليس الاكتشاف.
- المحفز والعوامل: المحفز مدخل خاطئ في أمر من دليل تشغيل معتمد أثناء تتبع مشكلة بطء في نظام الفوترة. والعوامل: أداة تسمح بحذف سعة كبيرة بسرعة، ونظامان فرعيان لم يعد تشغيلهما بالكامل في المناطق الكبيرة منذ سنوات، ونمو كبير جعل إعادة التشغيل وفحوص السلامة أبطأ من المتوقع.
- لماذا لم تعمل الحماية؟ الأنظمة مصممة لتحمل فقدان سعة كبيرة، ولكن إجراء إعادة التشغيل الكامل نفسه لم يجرب على هذا الحجم منذ زمن طويل، فلم يعرف أحد كم سوف يستغرق.
- الإجراءات: تعديل الأداة لتحذف ببطء وترفض النزول تحت الحد الأدنى، ومراجعة أدوات التشغيل الأخرى، وتقديم تقسيم النظام الفرعي إلى خلايا Cells أصغر لتسريع الاستعادة، ونقل واجهة إدارة لوحة الحالة لتعمل عبر عدة مناطق.
- حكمة ما بعد الحدث: من السهل أن تقول «كان يجب أن يراجع المدخل»، ولكن التقرير يوضح أن الأمر من دليل معتمد ويستخدم بانتظام، أي أن نفس الخطوة نفذت مرات كثيرة قبل ذلك دون مشكلة.
- ما لم يذكره: عدد العملاء المتأثرين والخسائر، وهذا طبيعي في تقرير عام، فلا تبن عليه.
والسؤال الذي يخرج به أي فريق من هذا التقرير، مهما كان حجمه: ما الإجراء الكبير في نظامنا الذي لم نجربه منذ سنة أو أكثر، مثل إعادة تشغيل قاعدة البيانات كاملة أو استعادة النسخة الاحتياطية من الصفر؟ وكم سوف يستغرق اليوم بعد أن كبرت البيانات؟ فإذا لم تعرف الإجابة، فهذه أول تذكرة لك.
لغة التقرير: اللوم أم النظام؟
من أسهل الطرق لتعرف هل التقرير مفيد أن تنظر إلى لغته. ويقول كتاب Google إن التقرير دون لوم Blameless يركز على الأسباب المساهمة دون أن يدين شخصاً أو فريقاً، ويفترض أن كل من شارك في الحادثة كانت نيته حسنة وفعل الصواب بالمعلومة التي كانت لديه، ثم يلخص الفكرة في جملة: «لا يمكنك أن تصلح الناس، ولكن يمكنك أن تصلح الأنظمة والإجراءات لتساعد الناس على اتخاذ القرار الصحيح». ويحذر الكتاب من أن ثقافة البحث عن مذنب تجعل الناس يخفون المشكلات خوفاً من العقاب.
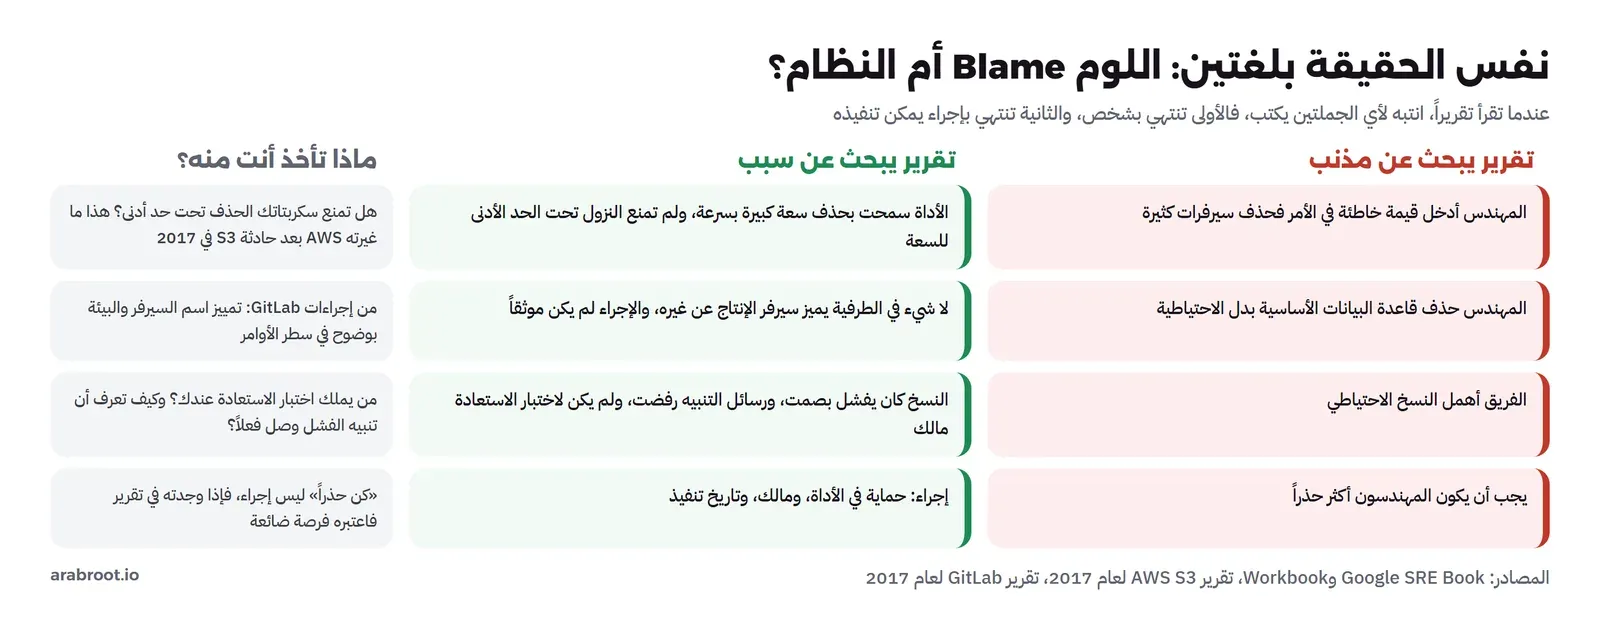
وفي تقرير GitLab تفصيلة صغيرة تستحق الانتباه: فالوثيقة التي تابع فيها الفريق الحادثة علناً كانت تحمل اسم المهندس الذي حذف البيانات، وقد أضافه المهندس بنفسه ولم يمانع نشره، ولكن الشركة كتبت في التقرير أنها سوف تخفي الأسماء في الحوادث القادمة، لأن غيره قد لا يرتاح لنشر اسمه. وهذه الجملة وحدها تخبرك بشيء عن ثقافة الفريق. وإذا وجدت نفسك يوماً في موقف من يلام على عطل، فقد كتبنا عن ذلك في مقال حين يلومك الفريق على عطل لم تسببه، وعن الأمان النفسي الذي يجعل الناس يتحدثون عن أخطائهم في مقال الأمان النفسي Psychological Safety.
ولماذا يهمك هذا كقارئ وليس ككاتب؟ لأن التقرير الذي يتوقف عند شخص لا يعطيك شيئاً تنقله، فليس عندك نفس الشخص. أما التقرير الذي يصل إلى الأداة والإجراء والملكية، فيعطيك أشياء موجودة في نظامك أيضاً.
من تقرير شركة أخرى إلى تذكرة في نظامك
القراءة وحدها لا تغير شيئاً، والقيمة الحقيقية أن يتحول الدرس إلى تغيير في نظامك. والطريقة التي نقترحها أربع خطوات لكل درس: الحقيقة كما وردت في التقرير، ثم سؤال عن نظامك، ثم إجراء له مالك، ثم ما يضاف إلى دليل التشغيل. والصورة التالية تطبقها على التقارير الثلاثة:
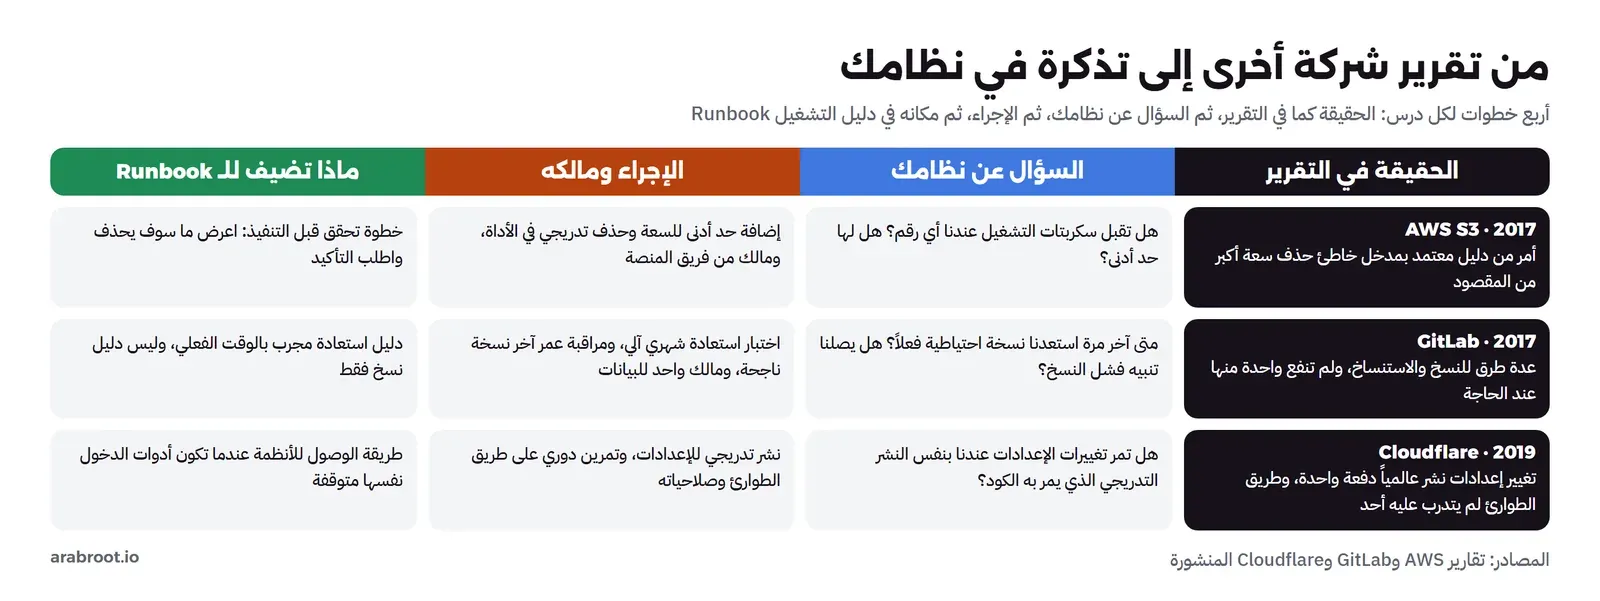
ولاحظ أن الإجراء في كل صف ليس نسخة من إجراء الشركة الأصلية، وإنما ترجمة له إلى حجم نظامك. فأنت غالباً لا تدير آلاف السيرفرات مثل AWS، ولكن لديك على الأقل سكربت واحد يحذف شيئاً بناء على مدخل، وهذا السكربت يستحق نفس الحماية: أن يعرض ما سوف يحذفه قبل التنفيذ، وأن يرفض الأرقام غير المعقولة. وقد شرحنا كيف تكتب هذه الخطوات بحيث ينفذها أي شخص في مقال دليل التشغيل Runbook، وفيه قصة حادثة S3 نفسها من زاوية كاتب الدليل.
ماذا تنسخ إلى أدلة التشغيل؟
بعد قراءة عدة تقارير سوف تلاحظ أن بعض الدروس تتكرر، وهذه بالذات تستحق مكاناً ثابتاً في أدلة التشغيل عندك:
| الدرس المتكرر | من أين جاء | ماذا تضيف إلى الدليل |
|---|---|---|
| الأمر الخطر يحتاج خطوة تحقق | AWS S3 في 2017، وGitLab في 2017 | قبل كل أمر حذف أو إعادة بناء: تأكد من اسم السيرفر والبيئة، واعرض ما سوف يتأثر، ثم نفذ |
| طريق الطوارئ يجب أن يجرب | Cloudflare في 2019 | طريقة الوصول للأنظمة عندما يتوقف SSO أو VPN، ومن يملك الصلاحية، ومتى جربت آخر مرة |
| صفحة الحالة يجب ألا تعتمد على ما تراقبه | AWS S3 في 2017، وCloudflare في 2019 | أين تنشر حالة الخدمة إذا توقفت المنصة نفسها، ومن يكتب الرسالة الأولى |
| النسخة التي لم تستعد لا تعتبر نسخة | GitLab في 2017 | خطوات الاستعادة بالوقت الفعلي من آخر تجربة، وأين تجد آخر نسخة ناجحة وكم عمرها |
| الإعدادات تحتاج نشراً تدريجياً مثل الكود | Cloudflare في 2019 | مراحل نشر الإعدادات وقواعد الحماية، وطريقة التراجع السريع عنها دون بناء كامل |
ولا تكتف بالنسخ، فالدليل الذي لم يجرب لا يختلف كثيراً عن النسخة التي لم تستعد. خصص يوم تجربة Game Day كل فترة تنفذ فيه خطوة من هذه الخطوات فعلاً، كما شرحنا في مقال اختبار التعطل Failover Testing ومقال هندسة الفوضى Chaos Engineering.
اجعل القراءة عادة في الفريق
يذكر كتاب Google أن فرقهم تشجع ثقافة التقارير بأنشطة مثل «تقرير الشهر» الذي يقرأه الجميع ويناقشونه، وأن التقرير الذي لا يراجع «كأنه لم يكتب أصلاً». ويمكنك أن تطبق نفس الفكرة على التقارير العامة دون أي تكلفة: اختر تقريراً واحداً كل شهر، ويقرأه الفريق قبل اجتماع قصير، ويخرج كل شخص بسؤال واحد عن نظامكم. ومع الوقت سوف يتعلم الفريق قراءة التقارير بنفس الطريقة التي يقرأ بها الكود، ويصبح أسرع في كتابة تقاريره هو عندما تقع حادثة عندكم.
وإذا أردت أن تبدأ بتقارير قرأناها بالتفصيل، فهذه قصص كوارث تقنية من هذا القسم، كل واحدة منها مبنية على تقريرها الرسمي:
 دليلحادثة GitLab سنة 2017: حذف قاعدة البيانات وخمس نسخ لا تعملكيف حذف مهندس في GitLab بيانات قاعدة الإنتاج بالخطأ، ولماذا لم تنقذهم خمس طرق للنسخ الاحتياطي، وما الذي تختبره في نسخك اليوم.
 دليلانقطاع Facebook سنة 2021: أمر صيانة أخفى الشبكة عن الإنترنتكيف أغلق أمر صيانة واحد شبكة Facebook الأساسية، ولماذا سحبت سيرفرات DNS عناوينها من الإنترنت وهي تعمل، وما الذي تتعلمه لشبكتك وأدوات الطوارئ عندك.
 دليلتحديث CrowdStrike سنة 2024: ملف واحد أوقف 8.5 مليون جهازكيف أوقف ملف إعدادات واحد من CrowdStrike قرابة 8.5 مليون جهاز Windows، ولماذا احتاج كل جهاز إصلاحاً يدوياً، وما الذي تغيره في طريقة نشر الإعدادات عندك.
ومن الكوارث الأقدم التي تعلمنا نفس الدروس بطريقة أخرى: انهيار شبكة AT&T سنة 1990، وجهاز Therac-25، ومسبار Mars Climate Orbiter.
قائمة تحقق Checklist عند قراءة أي تقرير
- هل عرفت الأثر: من تأثر، وكم من الوقت، وهل ضاعت بيانات؟
- هل حسبت الفجوات في الخط الزمني: حتى الاكتشاف، وحتى القرار، وحتى العودة؟
- هل كتبت المحفز في سطر، والعوامل المساهمة في قائمتين: ما سمح بالحادثة وما أطالها؟
- هل عرفت لماذا لم تعمل الحمايات: النسخ، والتنبيه، والتراجع؟
- هل الإجراءات تغير أدوات وأنظمة، ولها مالكون؟
- هل قرأت قسم الحظ إن وجد، وما الذي أنقذهم ولن يتكرر؟
- هل خرجت بسؤال واحد على الأقل عن نظامك، وتحول إلى تذكرة لها مالك؟
- هل أضفت شيئاً إلى دليل تشغيل عندك، وحددت متى تجربه؟
أخطاء شائعة عند قراءة التقارير
- الوقوف عند العنوان: «Regex سيئ» ليس درساً، والدرس في الحماية التي حذفت والنشر غير التدريجي. لذلك اقرأ قسم العوامل المساهمة قبل أن تحكم.
- الحكم على الأشخاص: «كيف فعلوا ذلك؟» سؤال يريحك ولا يعلمك شيئاً، والسبب أنك تقرأ بمعرفة النهاية. اسأل بدلاً منه: ما المعلومة التي كانت تنقصهم؟
- نسخ الإجراء كما هو: إجراءات شركة بحجم AWS قد لا تناسب فريقاً من خمسة أشخاص، فترجم الفكرة إلى حجمك، ولا تنقل الأداة.
- الاعتقاد أن «هذا لا يحدث عندنا»: أغلب العوامل في هذه التقارير، مثل التنبيه الذي لا يصل والنسخة التي لم تختبر، موجودة في أغلب الأنظمة الصغيرة أكثر من الكبيرة.
- القراءة دون أثر: إذا انتهت القراءة دون تذكرة أو سطر في دليل التشغيل، فقد استمتعت بقصة ولم تتعلم درساً.
- الاعتماد على ملخصات الأخبار: المقالات الإخبارية عن الحوادث تختصر وتبالغ أحياناً، لذلك ارجع دائماً إلى التقرير الأصلي الذي نشرته الشركة.
الخلاصة
- تقرير ما بعد الحادثة سجل مكتوب للحادثة وأثرها وأسبابها وإجراءاتها، والتقارير العامة من AWS وGitLab وCloudflare وغيرها مكتبة مجانية لتتعلم من أخطاء غيرك.
- اقرأ التقرير بالترتيب: الأثر، ثم الخط الزمني وفجواته، ثم المحفز والعوامل المساهمة، ثم لماذا فشلت الحمايات، ثم الإجراءات.
- السبب الجذري الواحد نادراً ما يكون القصة كاملة، والعوامل التي أطالت الحادثة غالباً أهم لك من محفزها.
- التقرير الجيد يتكلم عن الأدوات والإجراءات والملكية، لا عن الأشخاص، وهذا ما يجعل دروسه قابلة للنقل.
- كل درس يجب أن يتحول إلى سؤال عن نظامك، ثم إجراء له مالك، ثم سطر في دليل التشغيل تجربه فعلاً.
المصادر الأساسية: فصل Postmortem Culture ونموذج Example Postmortem في كتاب Google SRE، وتقارير AWS عن S3 في 2017 وGitLab في 2017 وCloudflare في 2019 المنشورة على مواقعها، وورقة How Complex Systems Fail لـ Richard Cook.
سجل التحديثات
- نوفمبر 2026: كتابة الدليل من التقارير الأصلية لـ AWS وGitLab وCloudflare وكتاب Google SRE.