


المتجر الذي قسنا سعته في مقال تخطيط السعة أصبح يعمل بنسختين من التطبيق خلف موزع طلبات nginx، وقاعدة بيانات PostgreSQL واحدة. وفي اجتماع الفريق يسأل مسؤول المنتج سؤالاً بسيطاً: «إذا توقفت إحدى النسختين في منتصف الليل، هل يلاحظ الزبائن؟». فيجيب الجميع بثقة: «لا، لهذا السبب وضعنا نسختين». ولكن لا أحد في الغرفة أوقف نسخة فعلاً ونظر ماذا يحدث للزبائن في تلك الدقيقة. فالجواب مبني على تصميم في الرسم، وعلى إعدادات افتراضية لم يقرأها أحد، وعلى افتراض أن nginx «يعرف» أن النسخة توقفت.
وهندسة الفوضى Chaos Engineering هي الطريقة التي تحول هذا الافتراض إلى تجربة: تقيس ما يراه الزبون الآن، وتكتب ما تتوقع أن يبقى عليه إذا حدث عطل معين، ثم تحدث العطل بنفسك، في وقت تختاره، وعلى نطاق صغير، وتقارن. وإذا بقي الرقم كما هو فقد اكتسبت ثقة مبنية على قياس، وإذا تغير فقد وجدت ضعفاً قبل أن يجده الزبائن في الثالثة فجراً. وفي هذا المقال سوف نجري ثلاث تجارب حقيقية على المتجر نفسه في مختبر Docker، بأدوات مفتوحة المصدر: Chaos Toolkit لإدارة التجربة، وPumba لقتل الـ Containers وتجميدها، وtoxiproxy لإبطاء قاعدة البيانات. والنتيجة الأهم ليست أن النظام صمد، وإنما ما تعلمناه من المرات التي ظننا فيها أنه صمد.
وسوف نناقش في هذا المقال ما يلي:
- من أين جاءت هندسة الفوضى، ومبادئها الأربعة، والفرق بينها وبين «تخريب الأشياء عشوائياً».
- حادثة حقيقية من AWS تبين لماذا لا يكفي أن تصمم إعادة المحاولة، ويجب أن تجربها.
- المختبر: متجر بنسختين، ومسبار يقيس ما يراه الزبون، وتجارب مكتوبة كملفات.
- التجربة الأولى: نسخة تموت، وثلاث محاولات حتى صدقت النتيجة، ومشكلة الثقة الكاذبة.
- التجربة الثانية: نسخة تتجمد ولا تموت.
- التجربة الثالثة: قاعدة البيانات تبطئ، وماذا يحدث إذا أبطأت أكثر.
- الأدوات، وكيف تنقل التجارب إلى الإنتاج بأمان، والأخطاء الشائعة، وقائمة تحقق.
ما هي هندسة الفوضى Chaos Engineering؟
بدأت الفكرة في Netflix عندما نقلت خدماتها إلى سحابة AWS، حيث يمكن أن يختفي أي سيرفر افتراضي في أي لحظة، فكتب الفريق أداة اسمها Chaos Monkey، وما زالت صفحتها على GitHub تصفها بأنها تنهي الأجهزة الافتراضية والـ Containers بشكل عشوائي في بيئة الإنتاج، حتى يضطر كل فريق أن يبني خدمته بحيث تتحمل ذلك. والفكرة هنا ليست التخريب، وإنما تغيير الحوافز: إذا كنت تعرف أن سيرفرك قد يختفي في أي يوم عمل وأنت حاضر، فسوف تصمم لذلك، بدلاً من أن تكتشفه في عطلة نهاية الأسبوع.
ثم كتب المهندسون الذين عملوا على هذه الأدوات مبادئ هندسة الفوضى، وآخر تحديث لها في مارس 2019، وتعرفها بأنها تجريب على النظام لبناء الثقة في قدرته على تحمل الظروف المضطربة في الإنتاج. والتجربة بحسب المبادئ أربع خطوات: أن تعرف الحالة المستقرة Steady State كمخرج قابل للقياس يدل على السلوك الطبيعي، وأن تفترض أن هذه الحالة ستستمر في مجموعة التحكم ومجموعة التجربة، وأن تدخل متغيرات تعكس أحداثاً حقيقية مثل توقف سيرفر أو انقطاع شبكة، وأن تحاول إثبات خطأ الفرضية بالبحث عن فرق في الحالة المستقرة. وتضيف المبادئ نقاطاً متقدمة: أن تبني الفرضية حول الحالة المستقرة وليس حول التفاصيل الداخلية، وأن تنوع الأحداث الحقيقية، وأن تجري التجارب في الإنتاج لأن الأنظمة تتصرف بشكل مختلف بحسب البيئة والحركة، وأن تجعلها آلية ومستمرة، وأن تقلل نصف قطر الضرر Blast Radius.
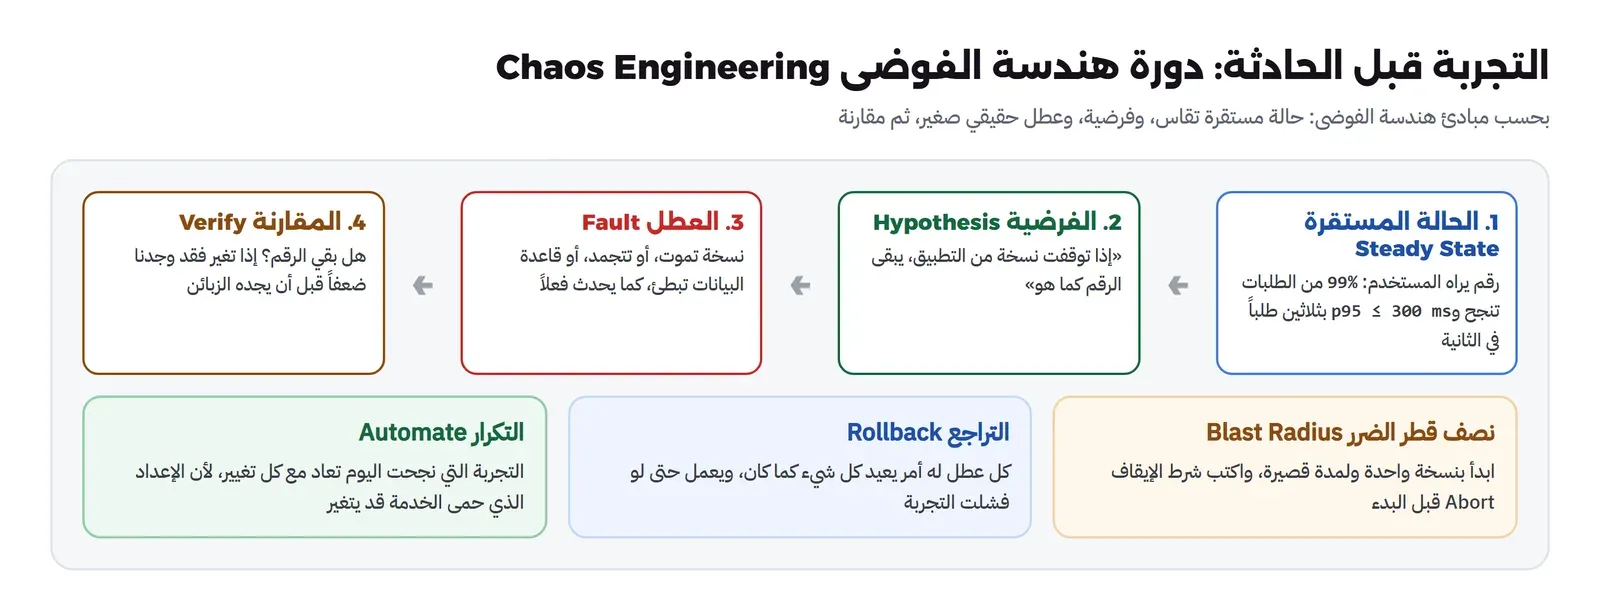
ولاحظ الكلمة المهمة في التعريف: الحالة المستقرة رقم يراه المستخدم، مثل نسبة الطلبات الناجحة وزمن الاستجابة، وليس «المعالج أقل من 80%» أو «الـ Container يعمل». والسبب أن الهدف هو حماية تجربة المستخدم، والنظام قد يكون كل جزء فيه «يعمل» بينما المستخدم يرى أخطاء، وهذا ما سنراه في المختبر. ولذلك تتصل هندسة الفوضى مباشرة بأهداف الخدمة SLO التي شرحناها في مقال أهداف الخدمة: الحالة المستقرة هي الـ SLO نفسه، والتجربة تستهلك جزءاً صغيراً ومحسوباً من ميزانية الأخطاء، بدلاً من أن تستهلكه حادثة في وقت لا تختاره.
وقد يتساءل البعض: ما الفرق بين هذا وبين الاختبار العادي؟ والإجابة أن الاختبار يتحقق من شيء تعرفه: «إذا أرسلت هذا الطلب، يجب أن يرجع هذا الرد». أما التجربة فتبحث عن شيء لا تعرفه: كيف تتفاعل أجزاء النظام مع بعضها عندما يتعطل أحدها، بإعداداتها الحقيقية ومهلاتها وإعادات المحاولة فيها. وقد ذكرنا فكرة اختبار التعطل قبل أن يحدث باختصار في مقال التوفر العالي، وشرحنا أنماط الحماية مثل المهلة وقاطع الدائرة في مقال منع الخدمة البطيئة من إسقاط النظام، وهذا المقال هو المكان الذي نتأكد فيه أن هذه الأنماط تعمل فعلاً بالإعدادات التي في ملفاتنا.
لماذا تجرب ما صممته؟ حادثة AWS في 7 ديسمبر 2021
في 7 ديسمبر 2021 تعطلت خدمات كثيرة في منطقة US-EAST-1، وبحسب التقرير الذي نشرته AWS بدأ الأمر عند 7:30 صباحاً بتوقيت المحيط الهادئ عندما أطلق نشاط آلي لزيادة سعة إحدى الخدمات سلوكاً غير متوقع من عدد كبير من الكلاينتات داخل الشبكة الداخلية، فحدث ارتفاع كبير في الاتصالات أغرق أجهزة الشبكة التي تربط الشبكة الداخلية بالشبكة الرئيسية. ويذكر التقرير أن هذه الكلاينتات لديها سلوك تراجع Back-off مختبر جيداً، مصمم ليسمح للأنظمة بالتعافي من هذا النوع من الازدحام، ولكن مشكلة كامنة منعها من التراجع بالشكل الكافي في هذه الحادثة، فزادت التأخيرات من محاولات الاتصال وإعادة المحاولة. والأسوأ أن الازدحام عطل بيانات المراقبة اللحظية لفرق التشغيل، فأصبحوا يبحثون عن السبب دون رؤية، واستمر التعافي الكامل لأجهزة الشبكة حتى 2:22 ظهراً.
والدرس الذي يهمنا هنا ليس حجم الحادثة، وإنما الجملة «سلوك تراجع مختبر جيداً، ومشكلة كامنة منعته». فالتصميم كان صحيحاً على الورق، والاختبارات كانت موجودة، ولكن السلوك الحقيقي تحت الضغط الحقيقي كان مختلفاً. وهذا بالضبط ما تحاول هندسة الفوضى أن تجده مبكراً: إعادة المحاولة التي تضاعف الضغط بدلاً من أن تخففه، والمهلة الافتراضية التي لم يغيرها أحد، والمراقبة التي تعتمد على نفس الشيء الذي تعطل. وسوف نرى نسخة صغيرة من الأولى في التجربة الثالثة. ولاحظ أن مثل هذه المشكلة لا تظهر في اختبار وحدة ولا في اختبار تكامل، لأنها تحتاج حركة حقيقية وعطلاً حقيقياً في نفس الوقت، وهذا تحديداً ما تصنعه التجربة بشكل متعمد وفي وقت تختاره أنت، بدلاً من أن تنتظر يوماً يصنعه فيه الإنتاج لك.
المختبر Lab: متجر بنسختين وثلاث أدوات
المختبر نفس تطبيق shop-api من مقال تخطيط السعة، بلغة Python مع PostgreSQL 18 ومئة ألف منتج ومليون مراجعة، ولكن هذه المرة بنسختين app1 وapp2، كل منهما بعمليتين، خلف nginx، والتطبيق يصل إلى قاعدة البيانات عبر toxiproxy حتى نستطيع إبطاء الطريق بينهما. والملف docker-compose.yml كما يلي:
# Chaos lab: two shop-api replicas behind nginx, PostgreSQL reached through toxiproxy (so we can slow or cut it).
#   docker compose -p wr-sre-chaos up -d --build
name: wr-sre-chaos
services:
  db:
    image: postgres:18-alpine
    environment: { POSTGRES_DB: shop, POSTGRES_USER: shop, POSTGRES_PASSWORD: lab-shop-pass }
    volumes: ["../../capacity-planning/lab/seed.sql:/docker-entrypoint-initdb.d/seed.sql:ro", "db:/var/lib/postgresql"]
  toxiproxy:
    image: ghcr.io/shopify/toxiproxy:2.12.0
    ports: ["18708:8474"]          # toxiproxy API, used by the experiments
  app1: &app
    build: ../../capacity-planning/lab
    image: wr-sre-cap-app:1
    environment: { WORKERS: "2", POOL: "10", DSN: "host=toxiproxy port=15432 dbname=shop user=shop password=lab-shop-pass" }
  app2: *app
  lb:
    image: nginx:1.31.6-alpine
    volumes: ["./${LB_CONF:-nginx-lb.conf}:/etc/nginx/conf.d/default.conf:ro"]
    ports: ["18700:80"]
volumes: { db: {} }
وموزع الطلبات في نسخته الأولى أبسط ما يمكن، أي إعدادات nginx الافتراضية، لأن هذا ما يكتبه أغلب الناس، وما كتبه فريق المتجر:
# Load balancer in front of the two replicas, first version: nginx defaults only.
upstream shop { server app1:8000; server app2:8000; }
log_format lb '$time_iso8601 $status $upstream_addr $upstream_status $request_time';
server {
    listen 80;
    access_log /var/log/nginx/access.log lb;
    location / { proxy_pass http://shop; proxy_http_version 1.1; proxy_set_header Connection ""; }
}
والمسبار probe.py هو الحالة المستقرة نفسها: يرسل 30 طلباً في الثانية بنموذج مفتوح، أي بجدول ثابت لا ينتظر الردود، كما يفعل الزبائن الحقيقيون، ويطبع النتيجة كسطر JSON، ويخرج بالرمز 1 إذا لم يتحقق الهدف، أي نجاح أقل من 99% أو شريحة 95% أكثر من 300 ملي ثانية. ويسجل أيضاً لكل ثانية عدد الطلبات الفاشلة أو الأبطأ من ثانية، حتى نرى متى بدأت المشكلة ومتى انتهت:
start = time.time()
with ThreadPoolExecutor(max_workers=400) as ex:
    for i in range(SECONDS * RATE):                      # open model: fixed schedule, not waiting for answers
        t = start + i / RATE
        time.sleep(max(0, t - time.time()))
        ex.submit(one, i, t - start)
# ...
out = {"requests": n, "success_pct": round(100 * good / n, 2), "p50": p(.5), "p95": p(.95), "p99": p(.99), "max": round(max(r[3] for r in res)),
       "codes": codes, "bad_or_slow_by_second": bad_by_sec}
print(json.dumps(out))
sys.exit(0 if out["success_pct"] >= 99 and (out["p95"] or 1e9) <= 300 else 1)
والتجربة نفسها ملف JSON تشغله أداة Chaos Toolkit بالإصدار 1.21.4، وبنيته بحسب مرجع ملف التجربة أربعة أجزاء: الفرضية steady-state-hypothesis وفيها مسابير لكل منها حد مقبول tolerance، والطريقة method وفيها الأعطال والمسابير أثناءها، والتراجع rollbacks الذي يعيد كل شيء كما كان. والأداة تشغل الفرضية قبل الطريقة، فإذا لم تتحقق لا تبدأ التجربة أصلاً، لأنك لا تجرب على نظام مريض، ثم تشغل الطريقة، ثم تشغل الفرضية مرة أخرى، ثم التراجع، وتحفظ كل شيء في ملف journal.json. وهذه تجربة النسخة التي تموت:
{
  "version": "1.0.0",
  "title": "One shop-api replica crashes",
  "description": "If app1 dies (SIGKILL) while customers browse, nginx sends them to app2 and the SLO holds.",
  "steady-state-hypothesis": {
    "title": "99% of product requests succeed and p95 stays under 300 ms",
    "probes": [
      { "type": "probe", "name": "slo-holds", "tolerance": 0,
        "provider": { "type": "process", "path": "python", "arguments": "probe.py 15 30" } }
    ]
  },
  "method": [
    { "type": "probe", "name": "customers-during-the-fault", "background": true,
      "provider": { "type": "process", "path": "python", "arguments": "probe.py 100 30" } },
    { "type": "action", "name": "kill-app1",
      "provider": { "type": "process", "path": "python", "arguments": "fault.py kill wr-sre-chaos-app1-1" },
      "pauses": { "before": 10, "after": 2 } },
    { "type": "probe", "name": "app1-is-really-down", "tolerance": 1,
      "provider": { "type": "process", "path": "python", "arguments": "fault.py check wr-sre-chaos-app1-1 running" },
      "pauses": { "after": 60 } }
  ],
  "rollbacks": [
    { "type": "action", "name": "start-app1",
      "provider": { "type": "process", "path": "python", "arguments": "fault.py start wr-sre-chaos-app1-1" }, "pauses": { "after": 5 } }
  ]
}
في الملف أعلاه لاحظ التالي:
- الفرضية هي المسبار لمدة 15 ثانية، والحد المقبول
tolerance: 0أي رمز الخروج صفر، أي أن الهدف تحقق. - أول خطوة في الطريقة مسبار الزبائن لمدة 100 ثانية يعمل في الخلفية
background: true، فيقيس ما يحدث قبل العطل وأثناءه وبعده، ثم بعد عشر ثوان يأتي العطل. - العطل يشغله سكربت صغير
fault.pyيستدعي Pumba الإصدار 1.5.1، وهي أداة فوضى للـ Containers تقتل أو توقف أو تجمد الـ Container عبر Docker، والقتل هنا بالإشارةSIGKILL، أي موت مفاجئ دون أي فرصة للتطبيق لينهي ما يعمله، كما يحدث عند نفاد الذاكرة أو تعطل السيرفر. - بعد العطل مسبار ثالث يتحقق أن
app1لم يعد في حالةrunning، وسوف ترى بعد قليل لماذا أضفناه. - التراجع يعيد تشغيل
app1سواء نجحت التجربة أو فشلت.
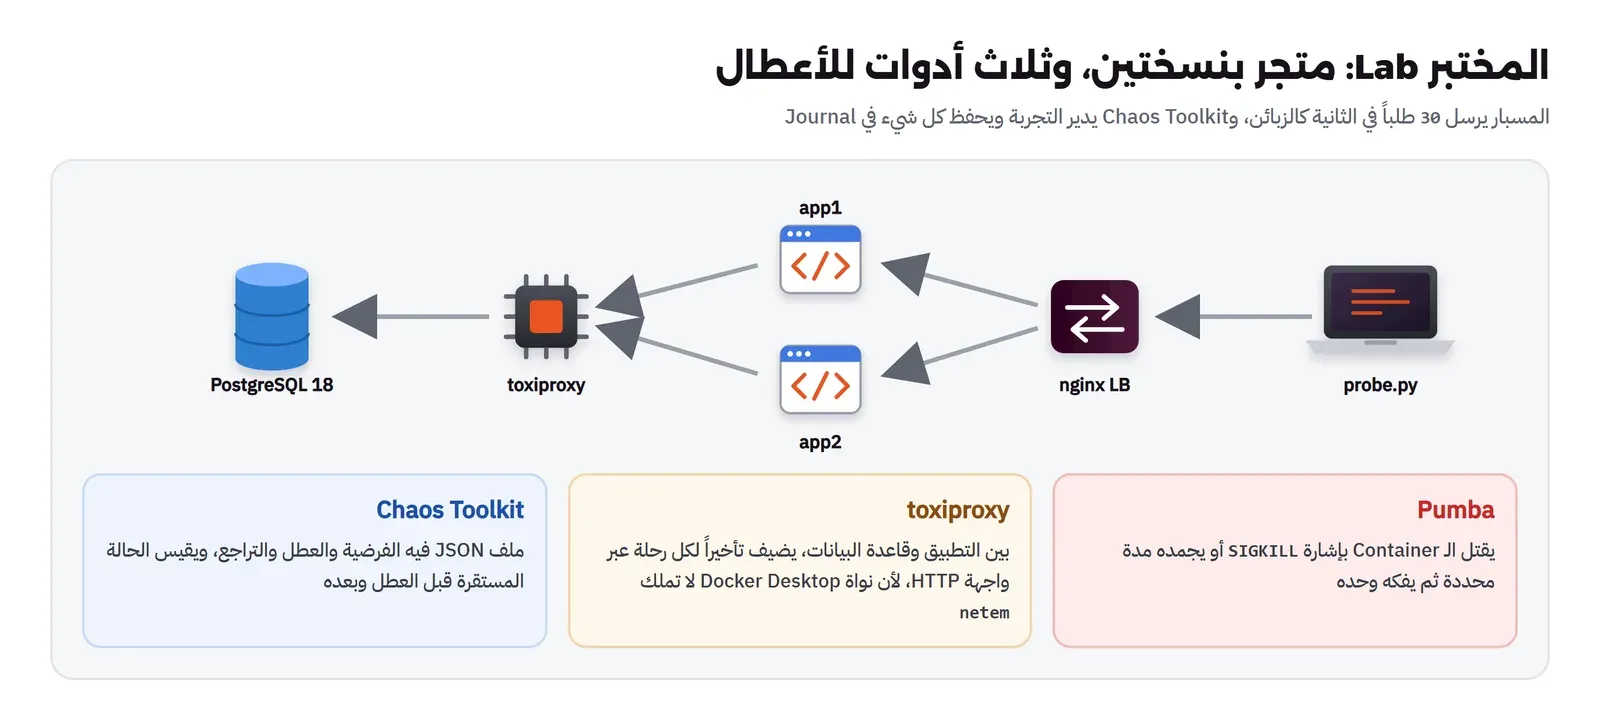
ولماذا toxiproxy وليس أداة Pumba نفسها لإبطاء الشبكة؟ لأن Pumba تبطئ الشبكة بالأمر tc ووحدة netem في نواة Linux، وقد وجدنا في مقال قياس السرعة مع Lighthouse أن نواة Docker Desktop لا تحتوي هذه الوحدة. وعلى سيرفر Linux عادي تعمل الطريقتان، وtoxiproxy له ميزة إضافية: يعمل كـ Proxy على مستوى TCP بين خدمتين محددتين فقط، فيقل نصف قطر الضرر تلقائياً، ويتحكم فيه عبر واجهة HTTP يستطيع Chaos Toolkit أن يستدعيها مباشرة.
وقبل أي عطل شغلنا المسبار وحده للتأكد من الحالة المستقرة: 600 طلب، كلها ناجحة، والشريحة 95% قدرها 42 ملي ثانية:
{"requests": 600, "success_pct": 100.0, "p50": 20, "p95": 42, "p99": 217, "max": 413, "codes": {"200": 600}, "bad_or_slow_by_second": {}}التجربة الأولى: نسخة تموت Replica Crash
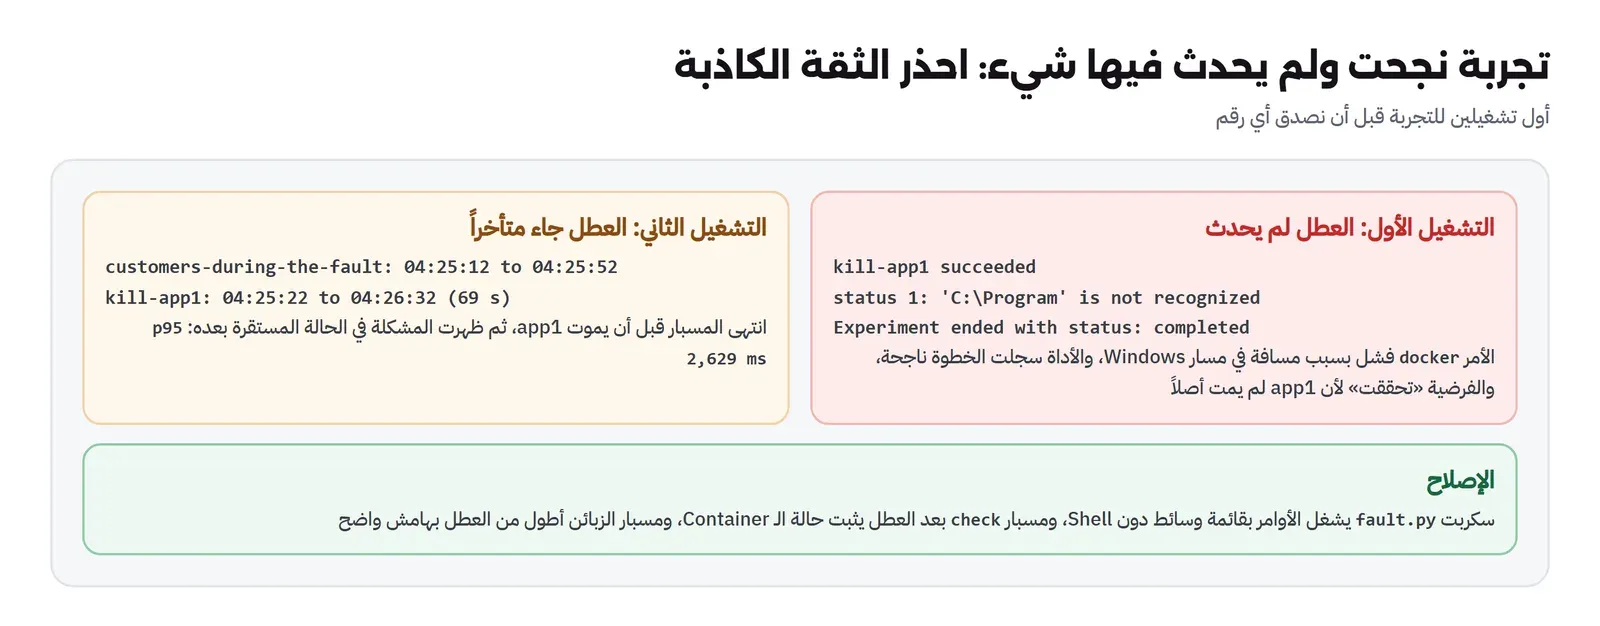
المحاولة الأولى: تجربة ناجحة لم يحدث فيها شيء False Confidence
في النسخة الأولى من الملف كان العطل أمر docker مباشرة في الحقل path، وكانت النتيجة في الطرفية مطمئنة جداً:
[2026-11-05 07:22:16 INFO] Steady state hypothesis is met!
[2026-11-05 07:22:26 INFO] Action: kill-app1
[2026-11-05 07:22:26 WARNING] This process returned a non-zero exit code. This may indicate some error and not what you expected. Please have a look at the logs.
[2026-11-05 07:23:16 INFO] Steady state hypothesis is met!
[2026-11-05 07:23:21 INFO] Experiment ended with status: completed
الفرضية تحققت قبل العطل وبعده، والتجربة «اكتملت». ولكن هناك سطر تحذير، وفي ملف الـ Journal كان السبب:
kill-app1 succeeded {"status":1,"stdout":"","stderr":"'C:\\Program' is not recognized as an internal or external command,\r\noperable program or batch file.\r\n"}الأمر لم يعمل أصلاً، لأن مسار docker على Windows فيه مسافة، والـ Shell قسمه إلى كلمتين، ومع ذلك سجلت الأداة الخطوة بالحالة succeeded، لأن الأفعال Actions في Chaos Toolkit لا تفشل التجربة برمز الخروج. أي أن النسخة لم تمت، والتجربة قالت إن النظام تحمل موتها. وهذا أخطر ما يمكن أن يحدث في هندسة الفوضى: ثقة كاذبة مكتوبة في تقرير. ولذلك كتبنا fault.py الذي يشغل الأوامر بقائمة وسائط دون Shell، وأضفنا مسباراً بعد العطل يتحقق من حالة الـ Container، فإذا لم يمت نعرف ذلك من الـ Journal. والقاعدة: كل تجربة يجب أن تثبت أن العطل حدث فعلاً، بنفس الجدية التي تثبت بها أن النظام تحمله.
المحاولة الثانية: العطل جاء بعد انتهاء القياس Timing
في المحاولة الثانية مات app1 فعلاً، ولكن بعد أن انتهى مسبار الزبائن، لأن أمر Pumba استغرق 69 ثانية، والمسبار كان 40 ثانية فقط:
customers-during-the-fault 04:25:12 to 04:25:52  {"requests": 1200, "success_pct": 100.0, "p50": 20, "p95": 42, ...}
kill-app1                  04:25:22 to 04:26:32  (69 s)
app1-is-really-down        wr-sre-chaos-app1-1 exited
after: {"requests": 450, "success_pct": 100.0, "p50": 21, "p95": 2629, "p99": 3532, "max": 4024, "codes": {"200": 450}, ...}
مسبار الزبائن قال 100% لأن العطل لم يحدث أثناءه، ولكن الفرضية بعد العطل فشلت لأول مرة: كل الطلبات نجحت، ولكن الشريحة 95% أصبحت 2.6 ثانية، فانتهت التجربة بالحالة deviated، أي أن الأداة وجدت ضعفاً. وفي سجل nginx كان السبب واضحاً:
[error] connect() failed (113: Host is unreachable) while connecting to upstream, ... upstream: "http://172.22.0.5:8000/api/products?cat=25"
[warn] upstream server temporarily disabled while connecting to upstream, ...
فـ nginx ما زال يرسل طلبات إلى عنوان app1 الذي لم يعد موجوداً، وكل اتصال ينتظر ثوان قبل أن يفشل ويذهب إلى app2. فجعلنا مسبار الزبائن مئة ثانية، أي أطول من العطل بهامش واضح، وأعدنا التجربة.
المحاولة الثالثة: إعدادات nginx الافتراضية Defaults
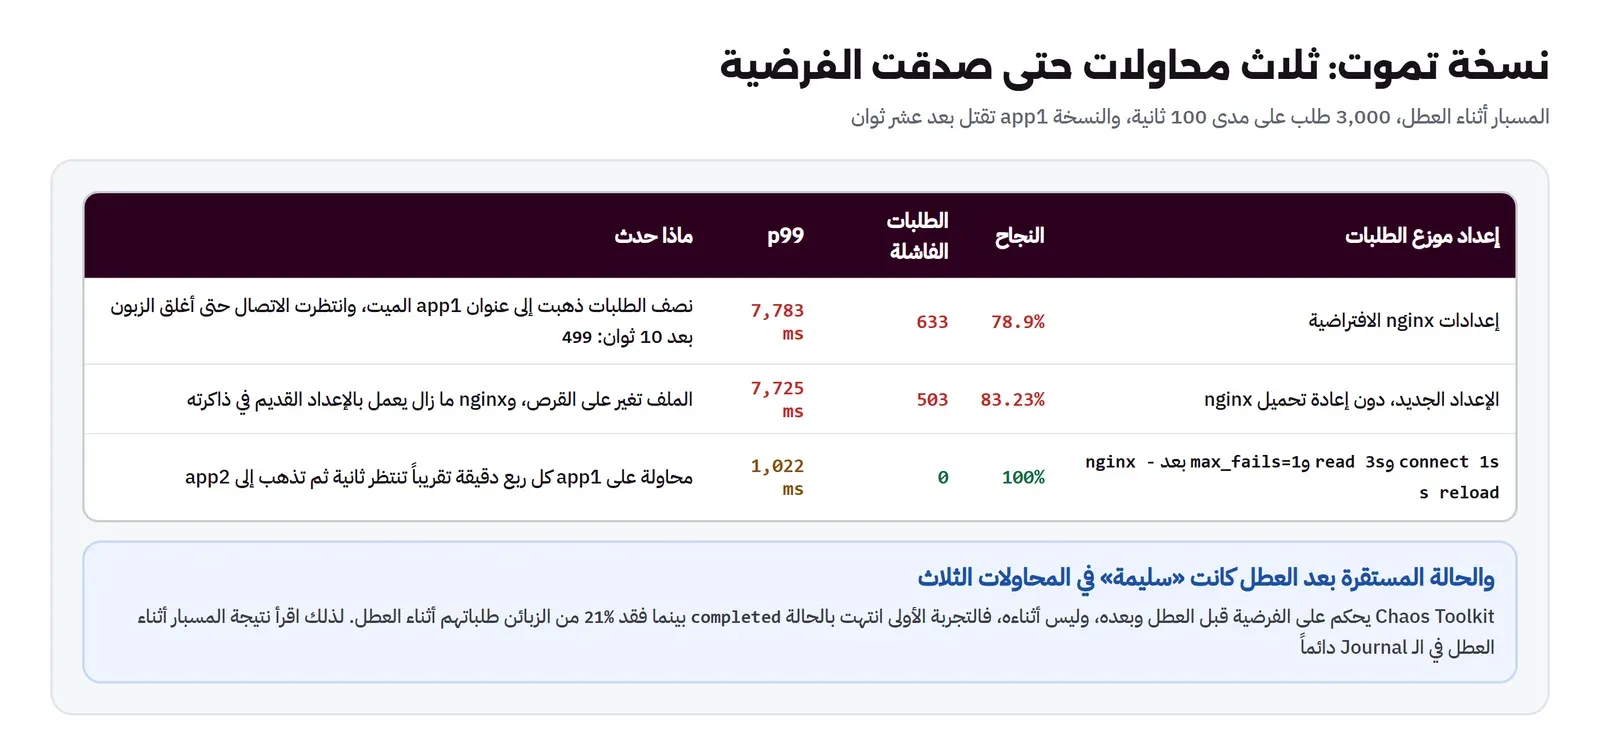
customers-during-the-fault 04:28:24 | {"requests": 3000, "success_pct": 78.9, "p50": 20, "p95": 50, "p99": 7783, "max": 10041, "codes": {"200": 2367, "-1": 633},
  "bad_or_slow_by_second": {"13": 15, "14": 15, "15": 15, "16": 11, "17": 11, "18": 15, "19": 15, "20": 15, ...}}
kill-app1 04:28:34 |
app1-is-really-down 04:28:41 | wr-sre-chaos-app1-1 exited
after: {"requests": 450, "success_pct": 100.0, "p50": 18, "p95": 40, "p99": 2074, "max": 3117, ...}
وهذه هي الحقيقة التي كان الاجتماع يفترض عكسها: أثناء موت نسخة واحدة من اثنتين نجح 78.9% من الطلبات فقط، و633 طلباً فشلت عند الزبون بالرمز -1، أي أن المسبار انتظر عشر ثوان دون أي رد فتخلى. والعمود bad_or_slow_by_second يقول إن حوالي 15 طلباً من كل 30 في كل ثانية كانت سيئة، أي نصف الحركة تقريباً، وهو النصف الذي يرسله nginx إلى app1. وفي سجل nginx رأينا نفس الطلبات بالحالة 499، وهي حالة خاصة بـ nginx تعني أن الكلاينت أغلق الاتصال قبل الرد، بعد 10 ثوان تماماً:
2026-11-05T04:28:47+00:00 499 172.22.0.5:8000 - 10.014
2026-11-05T04:28:47+00:00 499 172.22.0.5:8000 - 10.006
2026-11-05T04:28:48+00:00 499 172.22.0.5:8000 - 10.015
والسبب في توثيق وحدة proxy: القيمة الافتراضية لمهلة الاتصال proxy_connect_timeout هي 60 ثانية، ولمهلة القراءة proxy_read_timeout 60 ثانية أيضاً. وعنوان الـ Container الميت لا يرد على محاولة الاتصال أصلاً، فلا يأتي رفض سريع، وإنما صمت، فينتظر nginx حتى تنتهي المهلة، والزبون لا ينتظر دقيقة. وبحسب توثيق وحدة upstream يعتبر nginx السيرفر غير متاح بعد max_fails محاولة فاشلة، وهي محاولة واحدة افتراضياً، لمدة fail_timeout وهي 10 ثوان، ولكن المحاولة الفاشلة نفسها تحتاج دقيقة لتفشل. أي أن الحماية موجودة في nginx، ولكن الإعدادات الافتراضية تجعلها بطيئة لدرجة أنها لا تحمي أحداً. ولاحظ أيضاً أن الفرضية بعد العطل تحققت، لأن nginx كان قد تعلم بعد دقيقة أن app1 ميت، ولذلك انتهت التجربة بالحالة completed رغم أن خمس الزبائن فقدوا طلباتهم أثناءها. فالأداة بإعدادها الافتراضي تحكم على الفرضية قبل العطل وبعده فقط، ويمكن تغيير ذلك بالخيار --hypothesis-strategy الذي يقبل قيماً مثل during-method-only وcontinuously، أو أن تقرأ نتيجة المسبار أثناء العطل في الـ Journal كما فعلنا.
الإصلاح Fix: مهلات قصيرة، ثم مشكلة لم نتوقعها
كتبنا نسخة ثانية من إعداد موزع الطلبات تتخلى عن النسخة الميتة بسرعة وترسل الطلب إلى الأخرى:
upstream shop {
    server app1:8000 max_fails=1 fail_timeout=15s;
    server app2:8000 max_fails=1 fail_timeout=15s;
}
server {
    listen 80;
    location / {
        proxy_pass http://shop;
        proxy_connect_timeout 1s;          # default 60s: a vanished replica held requests until the client gave up
        proxy_read_timeout 3s;             # default 60s: a frozen replica would do the same
        proxy_next_upstream error timeout http_502 http_503;
        proxy_next_upstream_tries 2;
    }
}
وأعدنا التجربة، فكانت النتيجة 83.23% فقط، و503 طلبات فشلت بنفس الطريقة. فبحثنا في السجل عن وقت بدء الـ Container، فوجدنا أنه لم يتغير، أي أن nginx ما زال يعمل بالإعداد القديم في ذاكرته. فالملف مربوط بالـ Container كـ Bind Mount، ومحتواه تغير داخل الـ Container، ولكن nginx يقرأ إعداده عند التشغيل أو عند إعادة التحميل فقط، والأمر docker compose up -d لم يعد إنشاء الـ Container لأن سطر الربط في ملف Compose لم يتغير. وهذا خطأ يحدث في الإنتاج أيضاً: تعدل الإعداد، وتتحقق من الملف، فتظن أن التغيير طبق. فشغلنا nginx -s reload، وأعدنا التجربة للمرة الثالثة بالإعداد الجديد:
customers-during-the-fault 04:34:20 | {"requests": 3000, "success_pct": 100.0, "p50": 19, "p95": 43, "p99": 1022, "max": 1045, "codes": {"200": 3000},
  "bad_or_slow_by_second": {"13": 15, "14": 15, "15": 15, "16": 3, "29": 2, "30": 2, "31": 1, "32": 2, "33": 1, "46": 2, "47": 2, ...}}
kill-app1 04:34:30 |
app1-is-really-down 04:34:37 | wr-sre-chaos-app1-1 exited
كل الطلبات الثلاثة آلاف نجحت، والشريحة 95% بقيت 43 ملي ثانية، أي أن الفرضية صدقت أخيراً. ولكن لاحظ ما بقي في العمود الأخير: في الثواني 13 إلى 16 كانت هناك طلبات أبطأ من ثانية، وهي الطلبات التي جربت app1 وانتظرت ثانية الاتصال ثم ذهبت إلى app2، ثم تكرر ذلك بعدد صغير كل 15 إلى 17 ثانية تقريباً، لأن nginx يجرب السيرفر المعطل مرة أخرى بعد انتهاء fail_timeout، وكل عملية Worker في nginx تتعلم وحدها. أي أن الإصلاح حول خمس الزبائن الفاشلين إلى طلبات قليلة أبطأ بثانية، وهذا ثمن مقبول، ويمكن تقليله أكثر بفحص صحة نشط Active Health Check يخرج النسخة قبل أن يصلها أي زبون، وهو موجود في nginx التجاري أو في موزعات أخرى مثل HAProxy.
ماذا تحفظ من كل تجربة؟ Journal
كل تشغيل لأداة Chaos Toolkit يكتب ملف Journal بصيغة JSON، فيه نص التجربة كما كان وقت التشغيل، ونتيجة كل مسبار وكل فعل مع وقت بدايته ونهايته، ومخرج كل أمر كاملاً، وحالة الفرضية قبل الطريقة وبعدها، والحالة النهائية للتجربة. وهذا الملف هو ما كشف لنا الأخطاء الثلاثة في المحاولات الأولى: رمز الخروج 1 لأمر القتل، وتوقيت العطل بعد نهاية المسبار، والمسبار الذي سبق العطل في تجربة التجميد. ولذلك احفظ ملفات الـ Journal بجانب ملفات التجارب في Git، باسم يدل على الإعداد الذي جربته، كما فعلنا في مجلد results في المختبر، فبعد ستة أشهر عندما يسأل أحد «لماذا مهلة الاتصال ثانية واحدة؟» يكون الجواب ملفاً فيه 633 طلباً فاشلاً، وليس ذاكرة شخص ترك الشركة.
التجربة الثانية: نسخة تتجمد ولا تموت Hang
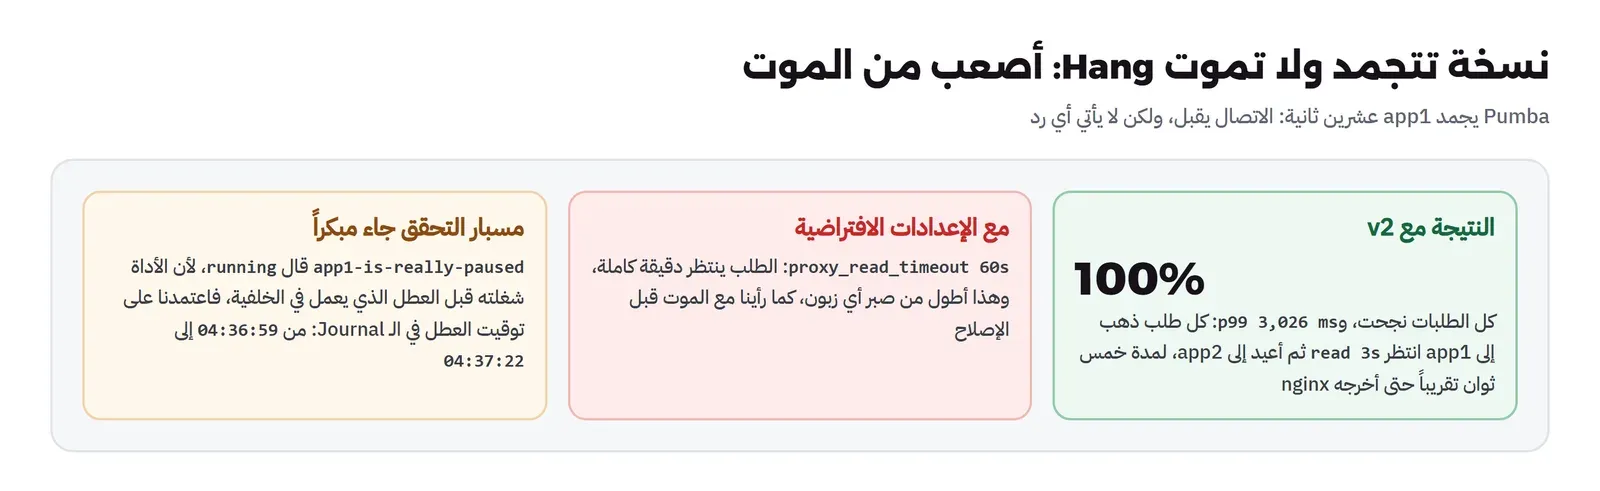
الموت المفاجئ أسهل الأعطال في الحقيقة، لأن الشيء الميت لا يتظاهر بأنه حي. أما النسخة التي تتجمد، بسبب حلقة لا تنتهي في الكود أو قفل في قاعدة البيانات أو توقف طويل لجامع القمامة Garbage Collector، فتقبل الاتصال ولا ترد، وهذا أصعب على موزع الطلبات. ولكي نحاكي ذلك جمدنا app1 عشرين ثانية بأمر Pumba pause، الذي يجمد كل عمليات الـ Container دون أن يوقفه، ثم يفكه وحده بعد المدة، وذلك مع الإعداد الثاني لموزع الطلبات:
customers-during-the-fault 04:36:49 04:37:49 | {"requests": 1800, "success_pct": 100.0, "p50": 22, "p95": 59, "p99": 3026, "max": 3058, "codes": {"200": 1800},
  "bad_or_slow_by_second": {"12": 15, "13": 15, "11": 7, "14": 15, "15": 12}}
app1-is-really-paused 04:36:52 04:36:52 | wr-sre-chaos-app1-1 running
pause-app1-20s 04:36:59 04:37:22 |
كل الطلبات نجحت، والشريحة 95% بقيت 59 ملي ثانية، ولكن الشريحة 99% وصلت إلى 3,026 ملي ثانية، وهذا رقم مألوف: إنه مهلة القراءة 3 ثوان التي وضعناها. فكل طلب ذهب إلى app1 المجمد انتظر 3 ثوان ثم أرسله nginx إلى app2، وذلك لمدة خمس ثوان تقريباً، من الثانية 11 إلى 15، حتى أخرج nginx النسخة المجمدة. وبإعدادات nginx الافتراضية كانت هذه الطلبات ستنتظر 60 ثانية كما رأينا مع الموت، أي أن نفس السطر أصلح المشكلتين.
ولاحظ سطراً غريباً في المخرج: مسبار التحقق app1-is-really-paused قال running، أي أن النسخة لم تتجمد. والسبب ليس في العطل، وإنما في ترتيب التجربة: جعلنا العطل يعمل في الخلفية لأن Pumba ينتظر عشرين ثانية حتى يفك التجميد، فشغلت الأداة المسبار التالي قبل أن يبدأ العطل نفسه، كما يظهر من التوقيتين 04:36:52 و04:36:59. ولذلك اعتمدنا في هذه التجربة على توقيت العطل في الـ Journal وعلى الثواني السيئة في المسبار، وهي تقع داخل فترة العطل تماماً. وهذا مثال آخر على أن التجربة نفسها كود يحتاج مراجعة، مثل أي كود آخر.
التجربة الثالثة: قاعدة البيانات تبطئ Slow Dependency
التجربتان السابقتان عن نسخة واحدة من اثنتين، وهذا ما صممنا له. أما قاعدة البيانات فهي واحدة، وكل النسخ تعتمد عليها، فماذا يحدث إذا لم تتوقف، وإنما أصبحت بطيئة، كما يحدث عند نسخة احتياطية ثقيلة أو استعلام سيئ من فريق آخر أو قرص ممتلئ؟ الفرضية: «إذا تأخر كل رد من قاعدة البيانات 300 ملي ثانية لمدة 30 ثانية، يبقى المتجر ضمن هدفه». والعطل هذه المرة طلب HTTP إلى toxiproxy مباشرة من ملف التجربة، والتراجع حذف نفس الـ Toxic:
{ "type": "action", "name": "add-300ms-to-db",
  "provider": { "type": "http", "url": "http://localhost:18708/proxies/shopdb/toxics", "method": "POST",
    "headers": { "Content-Type": "application/json" },
    "arguments": { "name": "db_latency", "type": "latency", "stream": "downstream", "attributes": { "latency": 300 } } },
  "pauses": { "before": 10, "after": 30 } },
{ "type": "action", "name": "remove-db-latency",
  "provider": { "type": "http", "url": "http://localhost:18708/proxies/shopdb/toxics/db_latency", "method": "DELETE" } }
customers-during-the-fault 04:38:35 | {"status":1,"stdout":"{\"requests\": 1500, \"success_pct\": 100.0, \"p50\": 923, \"p95\": 993, \"p99\": 1499, \"max\": 1698, ...
add-300ms-to-db 04:38:45 | {"status":200, ... "body":{"attributes":{"latency":300,"jitter":0},"name":"db_latency","type":"latency","stream":"downstream","toxicity":1}}
remove-db-latency 04:39:15 | {"status":204, ...}
after: {"requests": 450, "success_pct": 100.0, "p50": 20, "p95": 41, "p99": 57, "max": 177, ...}كل الطلبات نجحت، ولكن الوسيط أصبح 923 ملي ثانية والشريحة 95% أصبحت 993، أي أن الهدف سقط، والمسبار خرج بالرمز 1. والرقم المهم هنا هو 923: أضفنا 300 ملي ثانية فقط، والطلب أصبح أبطأ بحوالي 900. والسبب أن الطلب الواحد لا يعني ذهاب وعودة واحد إلى قاعدة البيانات، فهناك بداية المعاملة ثم الاستعلام ثم تأكيد المعاملة COMMIT، وكل ذهاب وعودة يدفع التأخير كاملاً، فـ 300 ملي ثانية في الشبكة أصبحت قرابة ثانية للزبون. وهذا يحدث في كل تطبيق يتكلم مع قاعدة بيانات بعدة مرات ذهاب وعودة لكل طلب، والطريقة الوحيدة لتعرف عدد مرات الذهاب والعودة الحقيقي في تطبيقك أن تجرب، لأن مكتبة الاتصال تخفيها عنك.
ماذا يحدث إذا أصبح التأخير ثانية كاملة؟ What If
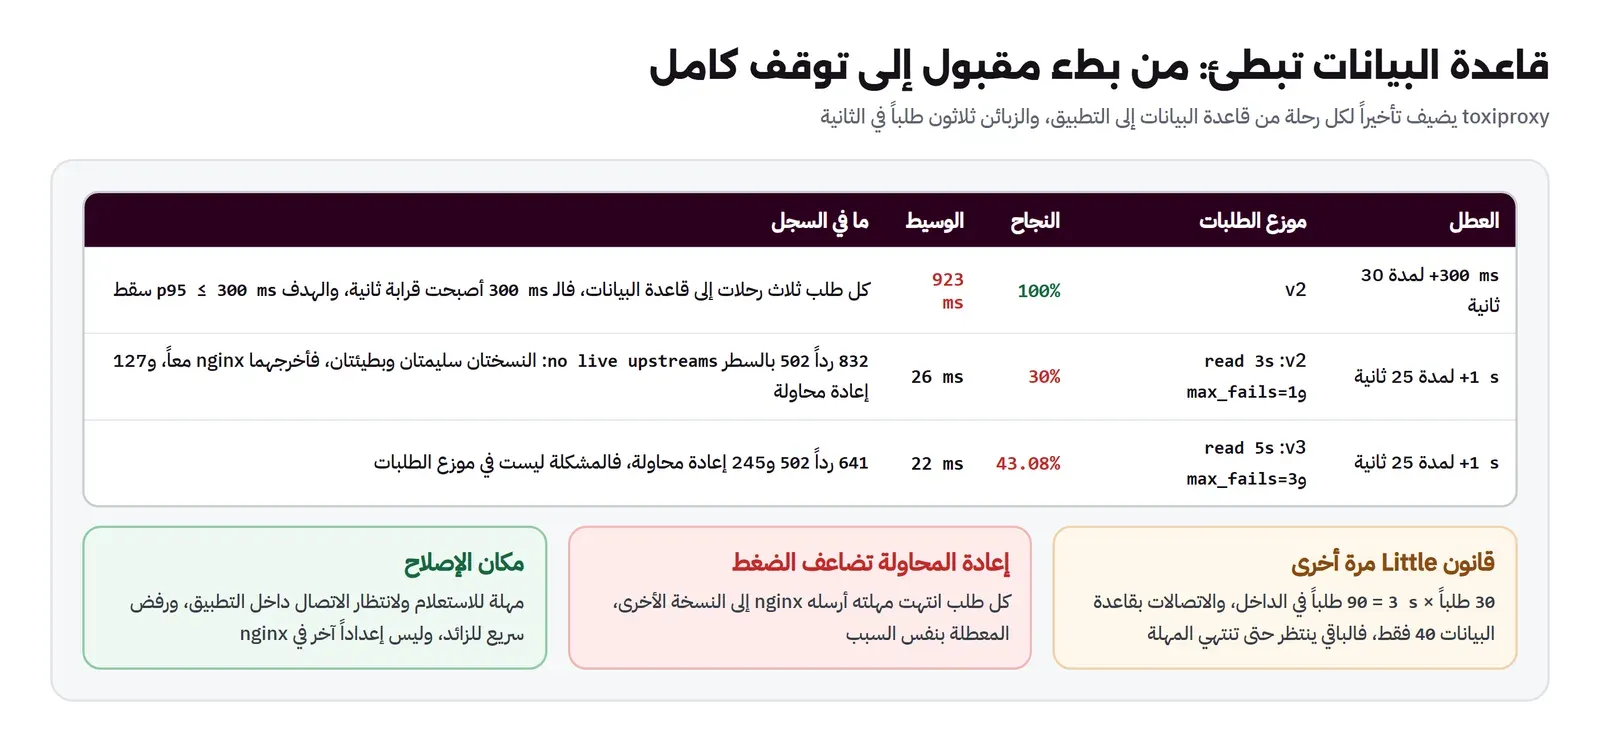
300 ملي ثانية أبطأت المتجر ولكنها لم توقفه، فرفعنا التأخير إلى ثانية لمدة 25 ثانية بالسكربت whatif-1s.sh، مع الإعداد الثاني لموزع الطلبات الذي أصلح الموت والتجمد:
{"requests": 1200, "success_pct": 30.0, "p50": 26, "p95": 52, "p99": 2025, "max": 6019, "codes": {"200": 360, "502": 832, "504": 8}, ...}
status 200 360
status 502 832
status 504 8
retried on the other replica: 127
نجح 30% من الطلبات فقط، و832 طلباً رجعت بالحالة 502، والسطر المتكرر في سجل nginx يقول السبب:
[error] upstream timed out (110: Operation timed out) while reading response header from upstream, ...
[error] no live upstreams while connecting to upstream, client: 172.22.0.1, server: , request: "GET /api/products?cat=200 HTTP/1.1", upstream: "http://shop/api/products?cat=200"
وهنا المفاجأة الحقيقية في هذا المقال: الإصلاح الذي حمانا من موت نسخة هو نفسه الذي أوقف المتجر كله. فالطلب أصبح يأخذ ثلاث ثوان أو أكثر، فانتهت مهلة القراءة 3 ثوان على النسختين، وكل مهلة منتهية تعتبر فشلاً، وmax_fails=1 يخرج النسخة بعد فشل واحد، فأخرج nginx النسختين معاً، وكلاهما سليم ولكن بطيء، وأصبح يرد على كل زبون بـ 502 «لا توجد نسخة حية» لمدة 15 ثانية. وفوق ذلك أعاد nginx 127 طلباً إلى النسخة الأخرى بعد انتهاء مهلتها، والنسخة الأخرى بطيئة بنفس السبب، فضاعف الضغط على قاعدة البيانات البطيئة أصلاً، وهذه نسخة صغيرة من إعادة المحاولة التي زادت الازدحام في حادثة AWS.
فجربنا نسخة ثالثة من الإعداد أكثر صبراً: مهلة قراءة 5 ثوان، وmax_fails=3، أي ثلاثة فشل قبل إخراج النسخة:
{"requests": 1200, "success_pct": 43.08, "p50": 22, "p95": 3043, "p99": 4902, "max": 10026, "codes": {"200": 517, "502": 641, "504": 33, "-1": 9}, ...}
status 502 641
retried on the other replica: 245
تحسن قليل فقط: 43% بدلاً من 30%، وما زالت 641 طلباً بالحالة 502، وإعادة المحاولة تضاعفت إلى 245. والسبب أن المشكلة ليست في موزع الطلبات أصلاً، وقانون Little الذي شرحناه في مقال تخطيط السعة يقول ذلك بوضوح: 30 طلباً في الثانية مضروبة في 3 ثوان أو أكثر لكل طلب تعني 90 طلباً داخل النظام في نفس اللحظة، بينما الاتصالات المتاحة بقاعدة البيانات 40 فقط، أي نسختان في عمليتين في عشرة اتصالات. فالباقي ينتظر اتصالاً، ثم تنتهي مهلته، ثم يعاد إرساله فيزيد الانتظار. أي أن الاعتماد البطيء تحول إلى مشكلة سعة، وأي إعداد في nginx سوف يختار فقط شكل الفشل.
والإصلاح الحقيقي مكانه التطبيق نفسه، وهو ما شرحناه بالتفصيل في مقال منع الخدمة البطيئة من إسقاط النظام: مهلة للاستعلام في قاعدة البيانات مثل statement_timeout، ومهلة قصيرة لانتظار اتصال من المجمع بدلاً من الانتظار المفتوح، ورد سريع وواضح عندما تمتلئ الاتصالات بدلاً من أن ينتظر الزبون حتى ينتهي صبر nginx، وربما نسخة محفوظة لنتائج الأقسام المشهورة تخدم الزبائن عندما تبطئ قاعدة البيانات. وفي موزع الطلبات يبقى قرار واحد مهم: هل تعتبر مهلة القراءة فشلاً للنسخة؟ فإذا كانت النسخ تعتمد كلها على نفس قاعدة البيانات، فبطء القراءة غالباً ليس ذنب النسخة، وإخراجها لا يفيد. وهذا بالضبط نوع القرار الذي لا يمكن أن تتخذه من الرسم، وإنما من تجربة مثل هذه. ولذلك أبقينا الإعداد الثالث في الملف nginx-lb.conf، مع تعليق يشرح لماذا، والنسخ الثلاث كلها في مجلد المختبر.
فحص الصحة Health Check: ماذا يقول فعلاً؟
هناك سؤال يظهر في كل تجربة على الاعتماديات، وهو ماذا يقول فحص الصحة. ففي تطبيقنا يرجع المسار /health الرد {"ok":true} دون أن يسأل قاعدة البيانات أي شيء، أي أنه يقول فقط إن العملية حية وتستقبل طلبات. وهذا جيد لموزع الطلبات في حالة الموت والتجمد، لأنه يكشفهما، ولكنه لا يقول شيئاً عن البطء في قاعدة البيانات، فالتطبيق «صحي» بحسب الفحص بينما الزبائن ينتظرون ثانية كاملة. وفي المقابل إذا جعلت الفحص يسأل قاعدة البيانات، ثم أبطأت قاعدة البيانات، ستفشل الفحوص في كل النسخ معاً، ويخرجها موزع الطلبات كلها، وهو نفس ما رأيناه في الثانية الكاملة مع max_fails=1. ولذلك يفرق كثير من الفرق بين فحصين: فحص حياة Liveness يقول هل العملية تعمل ويستخدمه موزع الطلبات ومنصة التشغيل لإعادة تشغيلها، وفحص جاهزية Readiness يقول هل تستطيع أن تخدم الآن، ويستخدم بحذر حتى لا يخرج كل النسخ بسبب مشكلة مشتركة. والتجربة الرابعة في قسم التدريب العملي مصممة لتريك هذا الفرق بنفسك.
أي الأعطال تستحق التجربة؟ Fault Catalog
التجارب الثلاث في المختبر اختيرت لأنها الأكثر حدوثاً في متجر بهذا الشكل، ولكن قائمة الأعطال الممكنة أطول، ويفيد أن تراها مصنفة قبل أن تختار. فهناك أعطال العمليات: موت مفاجئ كما فعلنا بالإشارة SIGKILL، وإيقاف منظم بالإشارة SIGTERM يختبر هل يكمل التطبيق الطلبات التي بدأها قبل أن يخرج، وتجميد كما فعلنا بأمر pause. وهناك أعطال الشبكة: تأخير كما فعلنا في toxiproxy، وفقد حزم Packet Loss يجعل بعض الطلبات تعاد بعد مهلة، وانقطاع كامل بين خدمتين مع بقاء كل منهما حية، ويسمى التقسيم Partition، وهو الذي يكشف مشاكل مثل انقسام الدماغ Split Brain التي شرحناها في مقال التوفر العالي. وهناك أعطال الاعتماديات: خدمة خارجية ترجع أخطاء 500 بدلاً من أن تبطئ، أو ترجع ردوداً صحيحة الشكل وخاطئة المحتوى. وهناك نفاد الموارد: قرص ممتلئ يمنع كتابة السجلات أو ملفات قاعدة البيانات، وذاكرة تنفد فيقتل النظام العملية، واتصالات قاعدة بيانات تنفد كما رأينا في التجربة الثالثة. وأخيراً أعطال يندر أن يجربها أحد مع أنها تحدث: ساعة السيرفر تنحرف فتفشل الشهادات والتوكنات، وخادم الأسماء DNS لا يرد، وشهادة TLS تنتهي.
ولا تحتاج أن تجرب كل هذا، وإنما أن تسأل لكل عطل: هل يمكن أن يحدث عندنا؟ وماذا نعتقد أنه سيحدث؟ وهل نحن متأكدون؟ والعطل الذي يجيب عنه الفريق بثقة دون أن يكون قد رآه هو المرشح الأول للتجربة، لأن الثقة دون تجربة هي بالضبط ما رأيناه في اجتماع المتجر. ولاحظ أن كل نوع من هذه الأعطال يحتاج أداة مختلفة في Docker: Pumba للعمليات، وtoxiproxy للشبكة بين خدمتين، وContainer صغير يملأ Volume للقرص، وحد للذاكرة في ملف Compose للذاكرة.
أدوات هندسة الفوضى Tools
| الأداة | ماذا تفعل | نقاط القوة | نقاط الضعف |
|---|---|---|---|
| Chaos Toolkit | يدير التجربة كملف: فرضية وعطل وتراجع وسجل | مفتوح المصدر، يعمل في أي مكان، إضافات لـ Kubernetes والسحابات، والتجربة ملف في Git | لا يحكم على الفترة أثناء العطل إلا بخيار، والأفعال لا تفشل التجربة برمز الخروج |
| Pumba | يقتل الـ Containers أو يوقفها أو يجمدها، ويبطئ الشبكة بـ netem | أداة واحدة صغيرة لكل أعطال Docker، وأسماء الـ Containers بتعبيرات منتظمة | أعطال الشبكة تحتاج netem في النواة، ويحتاج الوصول إلى Docker Socket |
| toxiproxy | Proxy بين خدمتين يضيف تأخيراً أو يقطع أو يحد السرعة | يعمل بلا صلاحيات خاصة، ونصف قطر ضرر محدد بخدمة واحدة، وواجهة HTTP | يجب أن يمر الاتصال عبره من البداية، أي تغيير في إعداد التطبيق |
| Chaos Monkey | ينهي أجهزة ونسخاً عشوائياً في الإنتاج | الفكرة الأصلية، وتغير ثقافة الفريق | مرتبط بمنصة Spinnaker، ونوع واحد من الأعطال |
| Chaos Mesh وLitmusChaos | تجارب فوضى داخل Kubernetes | أعطال كثيرة للـ Pods والشبكة والقرص والوقت، وجدولة | تحتاج Kubernetes، وتعقيد إضافي لفريق صغير |
| AWS Fault Injection Service | أعطال مدارة لخدمات AWS | أعطال على مستوى السحابة نفسها، مع شروط إيقاف مدمجة | خاصة بـ AWS وبكلفة لكل تجربة |
وتفاصيل الأدوات الأخيرة في توثيق Chaos Mesh وموقع LitmusChaos وتوثيق AWS FIS. والقاعدة لفريق صغير: ابدأ بما عندك. فمع Docker Compose يكفي Pumba وtoxiproxy وChaos Toolkit كما رأينا، ولا تحتاج منصة كاملة قبل أن تعرف أول عشرة أسئلة تريد أن تسألها لنظامك.
من المختبر إلى الإنتاج: يوم اللعب Game Day
المبادئ تقول إن التجارب الحقيقية تكون في الإنتاج، لأن الحركة والإعدادات والبيانات هناك هي الحقيقية، وقد رأينا كيف يكفي اختلاف صغير مثل مهلة افتراضية أو ملف لم يعد تحميله ليغير النتيجة كلها. ولكن لا يوجد فريق عاقل يبدأ بقتل خوادم الإنتاج يوم الاثنين القادم. والطريق المعتاد ثلاث مراحل: التجارب في بيئة الاختبار Staging بنفس إعدادات الإنتاج حتى تصبح نتائجها مملة، ثم يوم لعب Game Day في الإنتاج، أي موعد معلن يحضر فيه الفريق كله، فيه تجربة واحدة أو اثنتان مكتوبتان مسبقاً، ثم تجارب آلية صغيرة ومستمرة بعد أن يثق الفريق بأدواته.
وقد نفذنا يوماً كاملاً من هذا النوع على متجر من 17 Container في مقال اختبار التعطل Failover Testing، بفرضيات مكتوبة قبل كل تجربة. ويوم اللعب له قواعد بسيطة، وأغلبها رأيناه في المختبر بشكل مصغر:
- الفرضية مكتوبة بأرقام الـ SLO: «99% نجاح وp95 أقل من 300 ملي ثانية أثناء العطل»، وليس «يجب أن يعمل كل شيء».
- نصف قطر الضرر صغير: نسخة واحدة من عشر، أو نسبة صغيرة من الحركة، أو منطقة واحدة، ولمدة قصيرة محددة.
- شرط إيقاف Abort مكتوب: إذا انخفض النجاح تحت رقم معين أو ارتفعت الشكاوى، يوقف المسؤول التجربة فوراً، ولا نقاش في تلك اللحظة.
- التراجع مجرب قبل العطل: الأمر الذي يعيد كل شيء يجب أن يعمل حتى لو فشلت التجربة، وقد رأينا أن الأمر نفسه قد يفشل بصمت.
- دليل على أن العطل حدث: حالة الـ Container، أو سطر في السجل، أو مقياس يتغير، وليس فقط «الأمر انتهى بنجاح».
- إعلان مسبق: فريق الدعم والمناوب يعرفون الموعد، حتى لا يعامل العطل المقصود كحادثة حقيقية، وحتى يستطيعوا أن يقولوا «توقفوا» إذا رأوا شيئاً لا تراه أنت.
- الميزانية تسمح: إذا كانت ميزانية الأخطاء في الشهر قاربت على النهاية، تؤجل التجربة، لأن التجربة تستهلك من نفس الميزانية.
وأهم ما يخرج من يوم اللعب ليس الرقم، وإنما قائمة الإصلاحات، مثل التي خرجت من مختبرنا: مهلة اتصال قصيرة في موزع الطلبات، وإعادة تحميل الإعداد بعد تغييره، ومهلة للاستعلامات داخل التطبيق، وسؤال مفتوح عن إخراج النسخ عند البطء. وتكتب هذه القائمة بنفس الطريقة التي تكتب بها مراجعة الحادثة، كما شرحنا في مقال إدارة الحوادث، مع مسؤول وموعد لكل بند، ثم تعاد التجربة بعد الإصلاح لتثبت أنه يعمل، كما أعدنا تجربة الموت ثلاث مرات. وفي فصل اختبار الموثوقية في كتاب Google SRE تجد كيف تضع Google هذا النوع من الاختبار بجانب الاختبارات الأخرى، من اختبار الوحدة إلى اختبار الكوارث.
كيف يبدأ فريق صغير؟ First Experiments
إذا كان فريقك لم يجرب أي عطل حتى الآن، فلا تبدأ بالأداة، وإنما بالأسئلة. اجلس مع الفريق ساعة، وارسم المسار الذي يمر به أهم طلب، مثل إتمام الطلب، واسأل عن كل مربع في الرسم: ماذا يحدث إذا مات؟ وإذا تجمد؟ وإذا أبطأ؟ وإذا رجع أخطاء؟ وستجد أن أغلب الإجابات «نعتقد أن...». وكل «نعتقد» هي تجربة. ثم رتب التجارب بحسب احتمال حدوث العطل وأثره، وابدأ بالأكثر احتمالاً، وغالباً يكون موت نسخة من التطبيق، وبطء قاعدة البيانات، وتوقف خدمة خارجية مثل بوابة الدفع أو مزود البريد.
وأول تجارب الفريق غالباً تجد مشاكل في الإعدادات وليس في الكود: مهلات افتراضية طويلة، وإعادة محاولة بلا حد، وفحص صحة /health يرجع 200 بينما التطبيق لا يستطيع الوصول إلى قاعدة البيانات، ومراقبة تعتمد على نفس الشيء الذي تعطل. وهذه أرخص الإصلاحات وأكثرها أثراً، ولذلك التجارب الأولى تعطي أكبر عائد. وبعد أن تستقر النتائج، ضع التجارب الناجحة في خط النشر أو في جدول أسبوعي على بيئة الاختبار، لأن الإعداد الذي حماك اليوم قد يغيره أحد غداً دون أن يعرف لماذا كان هناك، وهذا ما جعلنا نكتب التعليقات في ملف nginx نفسه.
أخطاء شائعة Common Mistakes
- تصديق «اكتملت التجربة» دون دليل على العطل: أول تشغيل لنا اكتمل وتحققت فرضيته، والعطل لم يحدث أصلاً.
- قياس الحالة المستقرة قبل العطل وبعده فقط: 21% من الزبائن فقدوا طلباتهم أثناء العطل، والفرضية بعده كانت سليمة.
- مسبار أقصر من العطل: العطل جاء بعد 69 ثانية، والمسبار انتهى بعد 40.
- الوثوق بالإعدادات الافتراضية: مهلة اتصال 60 ثانية في nginx حولت موت نسخة من اثنتين إلى فشل خمس الطلبات.
- تعديل الإعداد دون إعادة تحميله: التجربة الثانية قاست الإعداد القديم الذي ما زال في ذاكرة nginx.
- إصلاح عطل يحدث عطلاً آخر: مهلة القراءة القصيرة مع
max_fails=1حمت من موت نسخة، وأوقفت المتجر كله عندما أبطأت قاعدة البيانات، فأعد كل التجارب بعد كل إصلاح. - إعادة المحاولة على نسخة معطلة بنفس السبب: 127 ثم 245 طلباً أعيدت إلى نسخة بطيئة مثل الأولى، فضاعفت الضغط.
- الحالة المستقرة من داخل النظام: «الـ Container يعمل» لا يعني شيئاً، والرقم الصحيح هو ما يراه الزبون.
- البدء في الإنتاج دون إعلان أو شرط إيقاف: العطل المقصود يتحول إلى حادثة حقيقية بلا قائد.
- تجارب لمرة واحدة: الإعداد الذي نجح اليوم قد يتغير غداً، فاجعل التجارب تتكرر.
قائمة تحقق Checklist لكل تجربة
| البند | كيف تتحقق منه |
|---|---|
| الحالة المستقرة رقم يراه المستخدم | نسبة النجاح وشريحة زمن الاستجابة بنفس أرقام الـ SLO |
| الفرضية مكتوبة قبل البدء | جملة واحدة: «إذا حدث X يبقى الرقم Y» |
| العطل حدث فعلاً | مسبار بعد العطل يثبت الحالة، وتوقيت العطل في السجل |
| القياس يغطي فترة العطل | مسبار في الخلفية أطول من العطل، أو استراتيجية فرضية أثناء الطريقة |
| نصف قطر الضرر محدد | نسخة واحدة أو خدمة واحدة، ومدة قصيرة مكتوبة |
| التراجع مجرب | أمر التراجع شغل مرة قبل التجربة ونجح |
| شرط الإيقاف مكتوب | رقم يوقف التجربة فوراً، ومن يملك قرار الإيقاف |
| الإعداد المطبق هو الإعداد المقصود | إعادة تحميل الخدمة، والتحقق من وقت بدء العملية أو من الإعداد المحمل |
| كل إصلاح يعيد كل التجارب | تجارب الموت والتجمد والبطء معاً بعد أي تغيير في المهلات أو إعادة المحاولة |
| النتائج محفوظة | ملف الـ Journal مع التجربة في Git، وقائمة الإصلاحات بمسؤول وموعد |
تدريب عملي Practice
- أضف إلى
app.pyمهلة لانتظار الاتصال من المجمع، بالخيارtimeoutفيPOOL.connection()، ومهلة للاستعلام بالإعدادstatement_timeout، ثم أعد تجربة الثانية الكاملة وقارن النجاح بالرقمين 30% و43%. - اكتب تجربة رابعة تقطع قاعدة البيانات تماماً عبر toxiproxy بالحقل
"enabled": false، وانظر ماذا يرجع/healthبينما يفشل/api/products، ثم اجعل فحص الصحة يسأل قاعدة البيانات.
حذف المختبر Cleanup
docker compose -p wr-sre-chaos down -v
docker rmi wr-sre-cap-app:1 gaiaadm/pumba:1.5.1 ghcr.io/shopify/toxiproxy:2.12.0
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- هندسة الفوضى تجربة وليست تخريباً: حالة مستقرة يراها المستخدم، وفرضية، وعطل حقيقي صغير، ومقارنة، مع نصف قطر ضرر صغير وتراجع مجرب.
- أول تشغيل لنا «اكتمل» والعطل لم يحدث، والثاني جاء فيه العطل بعد انتهاء القياس، فكل تجربة تحتاج دليلاً على العطل وقياساً يغطيه.
- موت نسخة من اثنتين بإعدادات nginx الافتراضية أفشل 21% من الطلبات بسبب مهلة اتصال 60 ثانية، ومهلة ثانية واحدة مع إعادة التحميل جعلت النجاح 100%.
- تجميد نسخة كلف بعض الزبائن 3 ثوان، أي مهلة القراءة، بدلاً من دقيقة.
- 300 ملي ثانية في قاعدة البيانات أصبحت قرابة ثانية للزبون لأن الطلب ثلاث مرات ذهاب وعودة، وثانية كاملة أوقفت المتجر: 30% نجاح لأن nginx أخرج النسختين معاً، والمشكلة الحقيقية سعة الاتصالات بقانون Little.
- الإصلاح الذي حمى من عطل قد يسبب آخر، فأعد كل التجارب بعد كل تغيير، واجعلها تتكرر.
وبهذا المقال تكتمل مرحلة الأداء والموثوقية: قسنا السرعة كما يراها الزائر، ثم بأدوات المختبر، ثم وزعنا التخزين المؤقت على طبقاته، وقسنا السعة، وجربنا الأعطال بأيدينا. وكل هذه الأرقام تعود في النهاية إلى نفس السؤال الذي بدأنا به في أهداف الخدمة: ماذا يرى المستخدم، وكيف نعرف قبل أن يخبرنا.
 دليلماذا تعني 99.9%؟ أهداف الخدمة SLO للمبتدئيننقيس خدمة حقيقية من أربعة أماكن فنحصل على أربعة أرقام، ونحول الهدف إلى دقائق مسموحة وميزانية أخطاء وسياسة تحكم قرارات الفريق.
 دليلكيف تمنع خدمة بطيئة من إسقاط نظامك كله؟لماذا تسقط خدمة بطيئة واحدة تطبيقك السليم، وكيف تحميه بالمهلة وإعادة المحاولة المحدودة وقاطع الدائرة ورفض الزائد.
 دليلمفاهيم التوفر العالي High Availability للمبتدئينماذا يعني أن تبقى خدمتك تعمل رغم تعطل جزء منها، وكيف تحسب التوفر وتجد نقاط الفشل الواحدة وتقرر متى يستحق ذلك تكلفته.
 دليلإدارة الحوادث Incident Response: من التنبيه إلى عودة الخدمةنعيش حادثة حقيقية على PostgreSQL من التنبيه إلى الإغلاق بخط زمني مسجل بالثواني، ونرى لماذا لم تنفع إعادة التشغيل وما الذي أنهى الحادثة.
 دليلتخطيط السعة Capacity Planning: متى تحتاج سيرفراً أكبر؟نقيس سعة متجر حقيقي باختبار ضغط، فنرى لماذا لم يضاعف المعالج الثاني السعة، ونحسب بالأشهر متى تنفد قبل أن تأتي الحملة.
 دليلاختبار الضغط Load Testing للمبتدئينلماذا يعمل تطبيقك مع خمسة مستخدمين وينهار مع خمسمئة، وكيف تكتشف ذلك وتصلحه قبل يوم الإطلاق.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة الدليل وتنفيذ المختبر بإصدارات Chaos Toolkit 1.21.4 وPumba 1.5.1 وtoxiproxy 2.12.0 وnginx 1.31.6 وPostgreSQL 18.6 على Docker Engine 29.8.0.


