


بنى فريق المتجر خلال الأشهر الماضية كل ما شرحناه في مرحلة التوفر العالي: سيرفران للتطبيق خلف HAProxy كما في مقال توزيع الطلبات، وقاعدة PostgreSQL بثلاث نسخ مع Patroni وetcd، وسلال المشتريات في Valkey مع ثلاث Sentinels. والرسم المعماري على الحائط يبدو مطمئناً، فكل صندوق فيه نسخة ثانية، وكل سهم فيه طريق بديل. وبقي أسبوعان على موسم التخفيضات، وسأل المدير السؤال الذي يجب أن يسأله: «هل جربنا أن نطفئ شيئاً من هذه الصناديق لنرى ماذا يحدث؟». والإجابة الصادقة عند أغلب الفرق «لا»، فكل جزء جرب وحده يوم بنائه، ولكن المتجر كاملاً لم يتعطل أمام أحد عمداً أبداً.
وفي مقال مفاهيم التوفر العالي رأينا حادثة Cloudflare في نوفمبر 2023، حيث كانت الشركة قد بنت عنقوداً على ثلاثة مراكز بيانات، واختبرت إيقاف أجزاء منه، ولكنها لم تختبر إيقاف مركز كامل أبداً، فتوقفت لوحة التحكم يومين، وحسبنا هناك أن الانتقال الذي ينجح 99% من المرات فقط يرفع التوقف أكثر من عشرة أضعاف. وهذا المقال عن الجزء الذي يسد هذه الفجوة: يوم الأعطال Game Day، أي أن تعطل نظامك عمداً، بخطة مكتوبة وفرضيات مسبقة، قبل أن يعطله الواقع في أسوأ ليلة. وسوف نشغل المتجر كاملاً في 17 Container، وننفذ عليه خمس تجارب بفرضيات كتبناها قبل التشغيل، ونرى أين صدقت وأين كذبت.
وسوف نناقش في هذا المقال ما يلي:
- لماذا لا يكفي أن تبني التوفر العالي، وما الفرق بين يوم الأعطال وهندسة الفوضى Chaos Engineering.
- عناصر التجربة: الحالة المستقرة Steady State، والفرضية Hypothesis، ونطاق الأثر Blast Radius، وشرط الإيقاف Abort Criteria، والأدوار.
- مختبر يجمع ما بنيناه في المرحلة: موزعان، وتطبيقان، وPatroni مع etcd، وValkey مع Sentinel، ومسبار يشتري كل 100 ملي ثانية.
- خمس تجارب بنتائجها الحقيقية، منها اثنتان كذبت فيهما الفرضية، وإصلاحان تحققنا منهما بإعادة التجربة.
- كيف تحول النتائج إلى مهام، وكيف تنقل يوم الأعطال إلى الإنتاج، وكم مرة تكرره.
لماذا لا يكفي أن تبني التوفر العالي؟ Untested Failover
التوفر العالي في الرسم المعماري فرضية، وفي يوم العطل حقيقة، والفرق بينهما أشياء لا يظهرها الرسم. فالرسم يقول إن HAProxy يخرج السيرفر المعطل، ولا يقول كم طلباً يضيع قبل أن يخرجه. ويقول إن Patroni يرقي نسخة، ولا يقول ماذا يحدث لقاعدة البيانات إذا توقف etcd نفسه. ويقول إن لكل شيء نسخة ثانية، ولا يذكر الصندوق الصغير الذي رسمه أحدهم بين التطبيق وقاعدة البيانات ولم ينتبه أنه واحد فقط. وكل هذه الأسئلة لها إجابات محددة، ولكن الطريقة الوحيدة لمعرفتها هي أن تجرب، والسبب أن الأنظمة الموزعة تتصرف في الأعطال بطرق تنتج من تفاعل أجزائها، وليس من إعداد كل جزء وحده، كما رأيت في كل مقالات هذه المرحلة: مهلة في جزء تتفاعل مع مهلة في جزء آخر، وإعداد صحيح في سيرفر يصبح خطيراً مع سياسة إعادة تشغيل في سيرفر آخر.
ويضع فصل اختبار الموثوقية في كتاب Google SRE الفكرة ببساطة: النظام الذي لم تختبر فيه آلية التعافي ليس لديك دليل على أنه يتعافى، ويقترح أن تختبر الأعطال بشكل دوري ومخطط، لأن الأنظمة تتغير، والانتقال الذي نجح في السنة الماضية قد لا ينجح بعد عشرين تحديثاً. ويضيف إطار AWS Well-Architected في ركيزة الموثوقية أن أيام الأعطال يجب أن تشمل الأشخاص والإجراءات أيضاً، وليس التقنية وحدها، فالمناوب الذي لم يقرأ دليل التشغيل أبداً جزء من النظام كما أن السيرفر جزء منه.
ما هو يوم الأعطال Game Day؟
يوم الأعطال تمرين مخطط، يجتمع فيه الفريق في وقت محدد، ويعطل أجزاء من النظام عمداً واحداً بعد الآخر، ويراقب ما يحدث، ويقارنه بما توقعه، ثم يكتب ما تعلمه. وهو قريب من هندسة الفوضى Chaos Engineering التي تصف مبادئها المنشورة بأنها تجارب على النظام لبناء الثقة في قدرته على تحمل الظروف المضطربة، ولكن الفرق بينهما في الدرجة: يوم الأعطال يبدأ يدوياً، في وقت يختاره الفريق، وغالباً في بيئة اختبار، أما هندسة الفوضى في صورتها الكاملة فتجارب آلية مستمرة على الإنتاج نفسه، مثل الأداة Chaos Monkey التي اشتهرت بها Netflix وكانت تطفئ سيرفرات الإنتاج عشوائياً في ساعات العمل. وأغلب الفرق يجب أن تبدأ بيوم الأعطال، ولا تنتقل إلى الفوضى الآلية إلا بعد أن تصبح الأيام اليدوية مملة لأنها لا تكشف شيئاً جديداً.
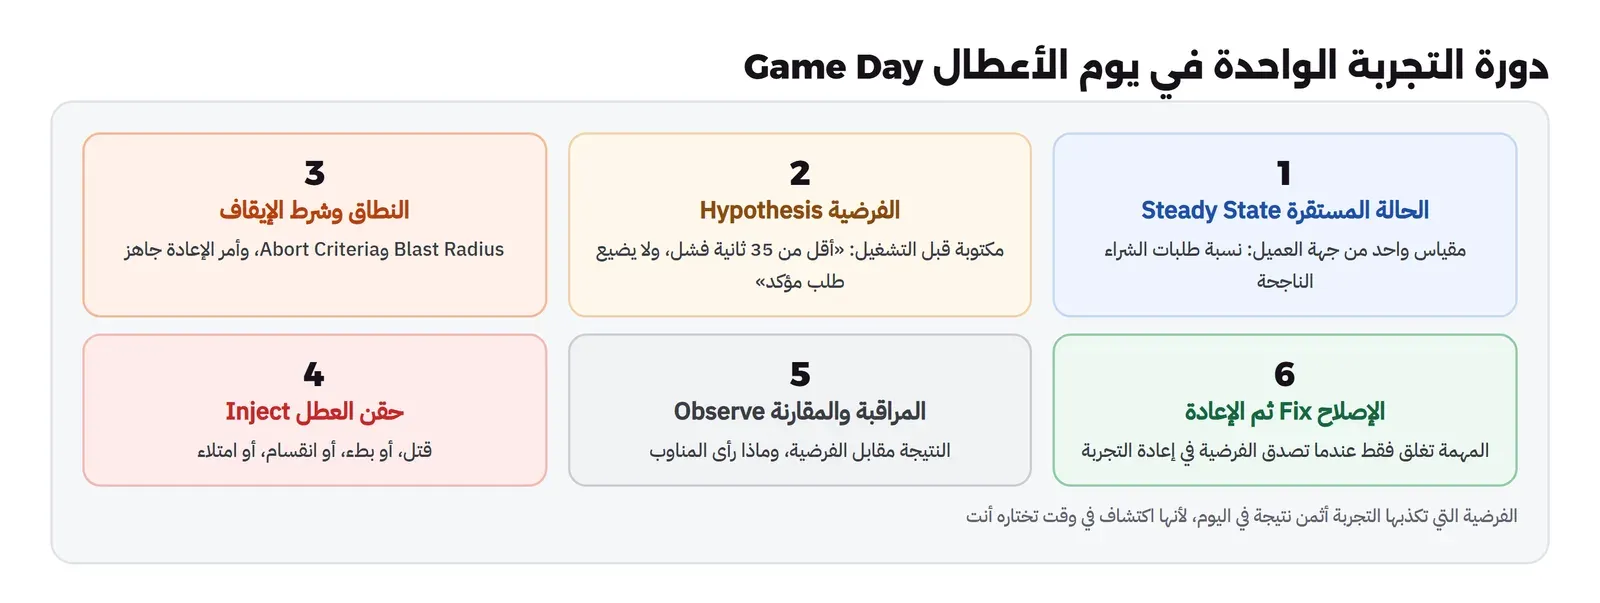
والتجربة الواحدة في يوم الأعطال لها دورة ثابتة، تبينها الصورة التالية:
الحالة المستقرة Steady State: ماذا تقيس؟
قبل أن تعطل أي شيء، يجب أن تعرف كيف يبدو النظام وهو سليم، بمقياس واحد واضح من جهة العميل، وليس من جهة السيرفرات. والسبب أن السيرفرات قد تقول إن كل شيء بخير بينما العميل لا يستطيع أن يشتري، كما رأيت في مقال أهداف الخدمة حين أعطت أربعة أماكن قياس أربعة أرقام لنفس الدقائق. وفي المتجر اخترنا أبسط مقياس ممكن: مسبار يرسل طلب شراء حقيقياً كل 100 ملي ثانية عبر الموزع الأمامي، والطلب ينجح فقط إذا كتب في PostgreSQL وفي Valkey معاً، ونقيس نسبة الطلبات الفاشلة ونوافذ الفشل وأي جزء فشل. وفي الحالة المستقرة قبل أي تجربة نجحت كل الطلبات: 98 طلباً في 10 ثوان دون أي فشل.
ولاحظ أن المسبار يقيس العملية الأهم كاملة، وليس جزءاً منها، فطلب الشراء يمر بالموزعين والتطبيق وقاعدة البيانات وValkey، فإذا فشل أي منها ظهر الفشل في المقياس نفسه، ومعه اسم الجزء. ولو اكتفينا بفحص صحة لكل جزء لما ظهرت مشكلة التجربة الرابعة أبداً، لأن كل جزء كان سليماً من وجهة نظره. وفي الإنتاج يكون هذا المقياس عادة مؤشر الخدمة SLI نفسه الذي تبني عليه الهدف، مع مسبار خارجي يشتري منتجاً تجريبياً، وتستطيع أن تضع حد الفشل في الفرضية بلغة ميزانية الأخطاء: «هذه التجربة يجب ألا تستهلك أكثر من 1% من ميزانية الشهر».
الفرضية Hypothesis قبل كل تجربة
الفرضية جملة تكتبها قبل أن تشغل التجربة، فيها العطل والأثر المتوقع بالأرقام، مثل: «إذا توقف رئيسي PostgreSQL فجأة، فسوف تفشل طلبات الشراء أقل من 35 ثانية، ولن يضيع أي طلب مؤكد». وكتابتها قبل التشغيل هي الجزء الأهم في اليوم كله، والسبب أن الإنسان بعد أن يرى النتيجة يقنع نفسه بسرعة أنها كانت متوقعة، فإذا لم تكن مكتوبة لن تعرف أبداً أن فهمك للنظام كان خاطئاً. والفرضية التي تكذبها التجربة ليست فشلاً للتمرين، بل هي أثمن نتيجة فيه، لأنها اكتشاف حدث في يوم تختاره أنت، وليس في ليلة التخفيضات.
نطاق الأثر Blast Radius مع شرط الإيقاف Abort Criteria
نطاق الأثر هو ما قد يتأثر بالتجربة في أسوأ حالة: كم مستخدماً، وأي خدمات، وكم من الوقت. وفي بيئة اختبار كالتي في المختبر النطاق صغير، أما في الإنتاج فتبدأ بأصغر نطاق ممكن، مثل سيرفر تطبيق واحد من عشرة، أو نسخة قاعدة بيانات وليس الرئيسي. وشرط الإيقاف هو الرقم الذي إذا وصلت إليه توقف التجربة فوراً وتعيد كل شيء، مثل «أكثر من 5% من الطلبات تفشل أكثر من دقيقة»، أو «أي خسارة في طلبات مؤكدة». ويجب أن يكون أمر الإعادة مكتوباً ومجرباً قبل التجربة، كما في السكربت الذي سوف تراه، فكل تجربة فيه لها أمر عطل وأمر إعادة.
الأدوار Roles في يوم الأعطال
حتى في فريق صغير، وزع الأدوار قبل البدء، لأن الفوضى في يوم الأعطال تشبه الفوضى في الحادثة الحقيقية، وقد شرحنا أدوار الحادثة في دليل إدارة الحوادث. وأقل ما تحتاجه أربعة أدوار: قائد التجربة الذي يقرر متى تبدأ ومتى تتوقف، ومنفذ العطل الذي يكتب الأوامر، والمراقب الذي يتابع المقياس وشرط الإيقاف، والكاتب الذي يسجل الوقت والملاحظات. والأفضل أن يكون المناوب الحقيقي بين الحاضرين دون أن يعرف تفاصيل التجربة مسبقاً، حتى ترى هل تصله التنبيهات وهل يعرف ماذا يفعل من دليل التشغيل وحده.
ابدأ بالطاولة قبل الأوامر Tabletop First
قبل أن تقتل أي شيء، هناك خطوة أرخص تكشف نصف المشاكل تقريباً، وهي تمرين الطاولة الذي شرحناه في دليل تمرين الطاولة: يجلس الفريق أمام الرسم المعماري، ويقول القائد «الآن توقف هذا الصندوق»، فيشرح كل شخص ماذا سوف يرى وماذا سوف يفعل، دون أن يلمس أحد لوحة المفاتيح. وفي المتجر كان هذا التمرين هو الذي ولد التجربة الخامسة، عندما سأل أحدهم عن الصندوق الذي لم يكن له نسخة ثانية، وهو الذي جعل الفريق يختلف على الفرضية الثالثة، فنصف الحاضرين قالوا إن توقف etcd لا يؤثر، ونصفهم قالوا إنه يؤثر، ولم يقتنع أحد حتى رأى الأرقام. والقاعدة أن الطاولة تكشف ما لا يعرفه الفريق عن الإجراء والأدوار، ويوم الأعطال يكشف ما لا يعرفه عن سلوك النظام نفسه، وتحتاج الاثنين.
المختبر Lab: المتجر كاملاً في 17 Container
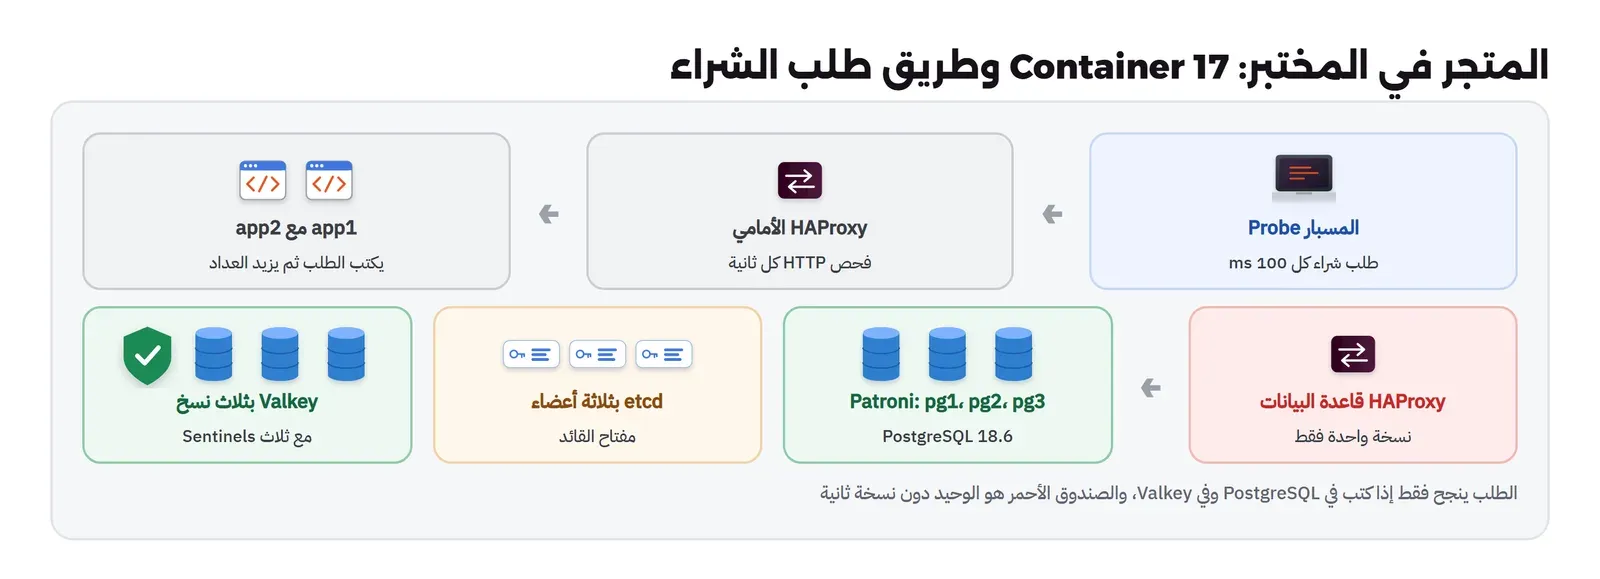
المختبر يجمع ما بنيناه في مقالات المرحلة على شبكة Docker واحدة بعناوين ثابتة، والصورة التالية تبين مكوناته وطريق طلب الشراء فيه:
ملفات المختبر Lab Files
إعداد Patroni وHAProxy قاعدة البيانات وSentinel هي نفسها التي شرحناها في مقالاتها، والجديد هنا التطبيق والمسبار وسكربت التجارب. والتطبيق يكتب الطلب في PostgreSQL، ثم يزيد عداد السلة في Valkey، ويرد باسم الجزء الذي فشل إن فشل شيء. احفظه باسم app.py:
# Store app for the game day: POST /order writes an order to PostgreSQL (through the db HAProxy)
# and counts it in the cart session in Valkey (through Sentinel). The reply names the part that failed.
import json, os, socket, psycopg, redis
from redis.sentinel import Sentinel
from http.server import ThreadingHTTPServer, BaseHTTPRequestHandler
NAME = socket.gethostname()
DSN = "host=wr-ha-dblb port=5000 user=postgres password=lab-only-pass dbname=shop connect_timeout=2"
SENT = Sentinel([("172.31.90.51", 26379), ("172.31.90.52", 26379), ("172.31.90.53", 26379)], socket_timeout=0.5)

class H(BaseHTTPRequestHandler):
    def log_message(self, *a): pass
    def reply(self, code, body):
        data = json.dumps(body).encode()
        self.send_response(code); self.send_header("Content-Length", str(len(data))); self.end_headers(); self.wfile.write(data)
    def do_GET(self):                                   # health check for the web HAProxy
        self.reply(200, {"app": NAME})
    def do_POST(self):
        try:
            with psycopg.connect(DSN, autocommit=True) as c:
                oid = c.execute("insert into orders(app) values (%s) returning id", (NAME,)).fetchone()[0]
        except Exception as e:
            return self.reply(503, {"app": NAME, "failed": "postgres", "error": type(e).__name__})
        try:
            SENT.master_for("shop", socket_timeout=1, socket_connect_timeout=1).incr("cart:count")
        except Exception as e:
            return self.reply(503, {"app": NAME, "failed": "valkey", "error": type(e).__name__, "id": oid})
        self.reply(201, {"app": NAME, "id": oid})

ThreadingHTTPServer(("0.0.0.0", 8000), H).serve_forever()
والمسبار يرسل طلب شراء كل 100 ملي ثانية بمهلة 3 ثوان، ويسجل لكل طلب الرمز والجزء الذي فشل. احفظه باسم probe.py:
# Customer probe for the game day: one order every 100 ms through the web HAProxy for SECONDS.
# Prints error windows with the failing part, the share of failed orders, and the longest gap.
import collections, json, os, sys, time, urllib.request, urllib.error
SECONDS, OUT = float(os.environ.get("SECONDS", "60")), sys.argv[1]
end, log = time.time() + SECONDS, []
while time.time() < end:
    t0 = time.time()
    try:
        req = urllib.request.Request("http://wr-ha-weblb/order", method="POST")
        with urllib.request.urlopen(req, timeout=3) as r: status, part = r.status, "-"
    except urllib.error.HTTPError as e:
        status = e.code
        try: part = json.loads(e.read()).get("failed", "lb")
        except Exception: part = "lb"
    except Exception as e:
        status, part = 0, type(e).__name__
    log.append((t0, status, part))
    time.sleep(max(0, 0.1 - (time.time() - t0)))
json.dump(log, open(OUT, "w"))
bad = [x for x in log if x[1] != 201]
print(f"orders {len(log)}  failed {len(bad)} ({len(bad) / len(log) * 100:.1f}%)  by part {dict(collections.Counter(x[2] for x in bad))}")
start = None
for t, s, p in log + [(log[-1][0] + 1, 201, "-")]:
    if s != 201:
        if start is None: start, parts = t, collections.Counter()
        parts[p] += 1
    elif start is not None:
        print(f"  errors {time.strftime('%H:%M:%S', time.gmtime(start))} -> {time.strftime('%H:%M:%S', time.gmtime(t))} UTC {t - start:5.1f} s  {dict(parts)}"); start = None
والموزع الأمامي في نسخته الأولى هو الإعداد الذي يكتبه أغلب الناس، فحص HTTP كل ثانية لكل سيرفر، واحفظه باسم haproxy-web.cfg:
# Web load balancer: two app servers, HTTP health check every second
defaults
    mode http
    timeout connect 2s
    timeout client 30s
    timeout server 30s
frontend web
    bind :80
    default_backend apps
backend apps
    option httpchk GET /
    default-server check inter 1s fall 2 rise 2
    server app1 wr-ha-app1:8000
    server app2 wr-ha-app2:8000
وكل تجربة تنفذ بسكربت واحد يأخذ اسم التجربة، ومدتها، ومدة بقاء العطل، وأمر العطل، وأمر الإعادة، فيشغل المسبار، وبعد 10 ثوان من الحالة المستقرة ينفذ العطل، ثم الإعادة، ثم يطبع النتيجة. وكتابة أمر الإعادة في السكربت قبل التجربة هو تطبيق عملي لشرط الإيقاف، فالإعادة جاهزة ولا يحتاج أحد أن يفكر فيها تحت الضغط. احفظه باسم gameday.sh:
#!/bin/sh
# One game-day experiment: probe for SECONDS, run the fault command after 10 s, the recovery command
# after HOLD more seconds, then print the probe summary.
#   sh gameday.sh <name> <seconds> <hold> "<fault command>" "<recovery command>"
NAME=$1 SECONDS=$2 HOLD=$3 FAULT=$4 RECOVER=$5
export MSYS_NO_PATHCONV=1
docker exec -d -e SECONDS=$SECONDS wr-ha-probe python probe.py out/$NAME.json
sleep 10; echo "$(date -u +%T) fault: $FAULT"; sh -c "$FAULT" >/dev/null
sleep $HOLD; echo "$(date -u +%T) recover: $RECOVER"; [ -n "$RECOVER" ] && sh -c "$RECOVER" >/dev/null
sleep $((SECONDS - 10 - HOLD + 3))
docker exec wr-ha-probe python -c "
import json, collections, time
log = json.load(open('out/$NAME.json')); bad = [x for x in log if x[1] != 201]
print(f'orders {len(log)}  failed {len(bad)} ({len(bad) / len(log) * 100:.1f}%)  by part {dict(collections.Counter(x[2] for x in bad))}')
start = None
for t, s, p in log + [(log[-1][0] + 1, 201, '-')]:
    if s != 201:
        if start is None: start, parts = t, collections.Counter()
        parts[p] += 1
    elif start is not None:
        print(f'  errors {time.strftime(\"%H:%M:%S\", time.gmtime(start))} -> {time.strftime(\"%H:%M:%S\", time.gmtime(t))} UTC {t - start:5.1f} s  {dict(parts)}'); start = None
"
والجزء الأخير في السكربت يقرأ سجل المسبار ويطبع الملخص نفسه الذي في آخر probe.py، لأن المسبار يعمل في الخلفية فلا نرى مخرجه مباشرة. أما تشغيل المتجر كاملاً فهو السكربت up.sh في مجلد المختبر، ويشغل الأجزاء بالترتيب الذي تحتاجه: etcd ثم Patroni ثم موزع قاعدة البيانات ثم Valkey وSentinels ثم التطبيق والموزع الأمامي والمسبار، وفي آخره يطبع حالة Patroni وSentinels:
sh up.sh
docker exec -e SECONDS=10 wr-ha-probe python probe.py out/baseline.json
| pg1 | wr-ha-pg1 | Leader | running | 1 | | | | |
| pg2 | wr-ha-pg2 | Replica | streaming | 1 | 0/4445900 | 0 | 0/4445900 | 0 |
| pg3 | wr-ha-pg3 | Replica | streaming | 1 | 0/4445900 | 0 | 0/4445900 | 0 |
OK 3 usable Sentinels. Quorum and failover authorization can be reached
orders 98 failed 0 (0.0%) by part {}خطة اليوم Game Day Plan: خمس تجارب مع فرضياتها
قبل أن نشغل أي تجربة كتبنا هذا الجدول، والعمود الأخير ملأناه بعد التشغيل فقط:
| التجربة | العطل | الفرضية المكتوبة قبلها | شرط الإيقاف |
|---|---|---|---|
| 1 | قتل سيرفر تطبيق app1 | لا يفشل أي طلب، لأن الموزع يفحص كل ثانية | أكثر من 5% فشل لمدة 30 ثانية |
| 2 | قتل رئيسي PostgreSQL | فشل أقل من 35 ثانية، ولا يضيع طلب مؤكد | أكثر من 60 ثانية فشل |
| 3 | قتل عضو etcd ثم عضوين | لا أثر على الطلبات، لأن etcd ليس في طريق الطلب | أكثر من 5% فشل لمدة 30 ثانية |
| 4 | قتل رئيسي Valkey | فشل أقل من 10 ثوان، والطلب الفاشل لا يكتب شيئاً | أكثر من 30 ثانية فشل |
| 5 | قتل موزع قاعدة البيانات | لم يسأل أحد هذا السؤال قبل اليوم | أي فشل أكثر من 60 ثانية |
التجربة 1: توقف سيرفر تطبيق App Server
sh gameday.sh g1-app 40 15 "docker kill wr-ha-app1" "docker start wr-ha-app1"03:40:37 fault: docker kill wr-ha-app1
03:40:53 recover: docker start wr-ha-app1
orders 341 failed 2 (0.6%) by part {'TimeoutError': 2}
errors 03:40:37 -> 03:40:40 UTC 3.0 s {'TimeoutError': 1}
errors 03:40:40 -> 03:40:43 UTC 3.0 s {'TimeoutError': 1}الفرضية كانت «لا يفشل أي طلب»، والنتيجة طلبان فشلا، وكل واحد منهما انتظر 3 ثوان كاملة قبل أن يفشل. والرقم صغير، 0.6%، ولكنه كشف شيئاً عن الإعداد: في الثواني التي بين موت app1 وبين أن يخرجه الفحص، أرسل HAProxy إليه طلبين، وكل محاولة اتصال بعنوان Container ميت لا ترفض فوراً، وإنما تنتظر timeout connect كاملة، أي ثانيتين، ثم يعيد HAProxy الطلب إلى السيرفر نفسه، فانتهت مهلة المسبار. والإصلاح ثلاثة أسطر: مهلة اتصال قصيرة، ومحاولة ثانية، والخيار option redispatch الذي يجعل المحاولة الثانية تذهب إلى سيرفر آخر، وإعادة الطلب هنا آمنة حتى لو كان شراء، لأن فشل الاتصال يعني أن الطلب لم يصل إلى التطبيق أصلاً:
defaults
    mode http
    timeout connect 500ms
    retries 2
    option redispatch
    timeout client 30s
    timeout server 30s
وأعدنا التجربة نفسها بعد إعادة تشغيل الموزع، وهذه هي الخطوة التي ينساها الكثيرون، فالإصلاح الذي لم تعد تجربته فرضية أخرى:
03:42:15 fault: docker kill wr-ha-app1
03:42:31 recover: docker start wr-ha-app1
orders 379  failed 0 (0.0%)  by part {}
صفر فشل، والفرضية صدقت هذه المرة، وأصبح لدينا دليل وليس رأياً بأن توقف سيرفر تطبيق لا يراه العملاء. ولاحظ أن عدد الطلبات ارتفع من 341 إلى 379 في المدة نفسها، لأن المسبار لم يعد ينتظر ثلاث ثوان في أي طلب.
التجربة 2: توقف الرئيسي في PostgreSQL
sh gameday.sh g2-pgleader 60 30 "docker kill wr-ha-pg1" "docker start wr-ha-pg1"03:43:34 fault: docker kill wr-ha-pg1
03:44:05 recover: docker start wr-ha-pg1
orders 566 failed 257 (45.4%) by part {'postgres': 257}
errors 03:43:34 -> 03:44:03 UTC 29.0 s {'postgres': 257}
| pg1 | wr-ha-pg1 | Replica | streaming | 2 | 0/44DFB70 | 0 | 0/44DFB70 | 0 |
| pg2 | wr-ha-pg2 | Leader | running | 2 | | | | |هنا صدقت الفرضية تماماً: 29 ثانية من الفشل، أقل من 35، وكل الفشل من PostgreSQL، وعاد pg1 نسخة على الخط الزمني 2. وهذه نتيجة مهمة رغم أنها متوقعة، لأنها تحول الرقم الذي قسناه في مقال Patroni على عنقود وحده إلى رقم على المتجر كاملاً بتطبيقه وموزعيه، وتعطيك رقماً تكتبه في دليل التشغيل: «إذا رأيت أخطاء PostgreSQL أقل من 35 ثانية بعد عطل الرئيسي فهذا متوقع، ولا تتدخل». ولكن لاحظ أيضاً أن 45% من الطلبات في هذه الدقيقة فشلت، فإذا كان هذا مقبولاً في الصيانة المخطط لها فاستخدم الانتقال المخطط Switchover الذي رأيته يأخذ أقل من خمس ثوان.
وفي يوم أعطال حقيقي لا يكفي أن تقيس الفشل، وإنما أن تسأل المراقب أيضاً: ماذا رأى المناوب؟ هل وصله تنبيه، وبعد كم ثانية، وماذا قال التنبيه؟ فإذا وصله تنبيه «قاعدة البيانات متوقفة» بعد دقيقة، والانتقال كان قد انتهى قبله بثلاثين ثانية، فقد استيقظ شخص على مشكلة حلت نفسها، وهذا ما يجعل الناس يتجاهلون التنبيهات بعد أشهر. والأنسب أن يكون التنبيه على شيئين: أن الانتقال حدث، كمعلومة تقرأ في الصباح، وأن الكتابة فشلت أكثر من المدة المتوقعة، أي أكثر من 35 ثانية في هذه الحالة، كإيقاظ فوري، كما شرحنا في مقال التنبيهات.
التجربة 3: etcd، عضو واحد ثم عضوان
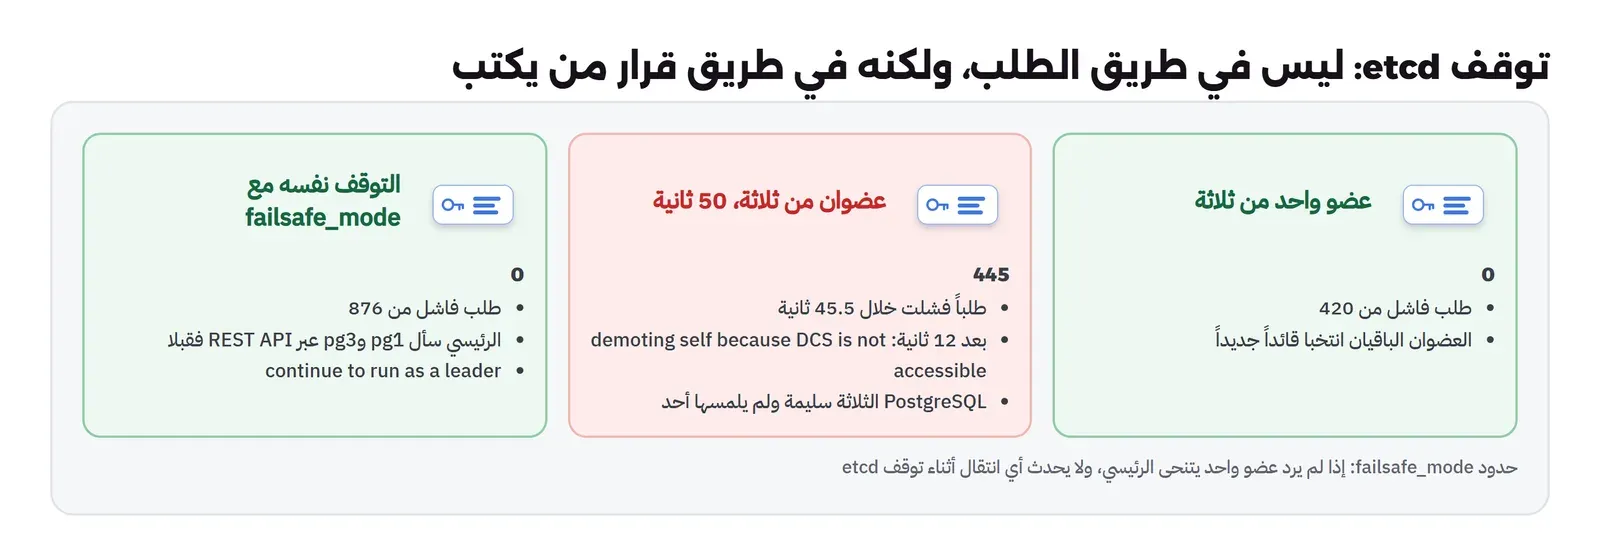
هذه التجربة كانت الأكثر إثارة للنقاش في الفريق، فالفرضية المكتوبة قالت إن etcd ليس في طريق طلب الشراء، فالتطبيق لا يكلمه أبداً، فلا أثر لتوقفه. قتلنا أولاً العضو القائد في etcd:
sh gameday.sh g3-etcd1 45 25 "docker kill wr-ha-etcd1" "docker start wr-ha-etcd1"03:47:10 fault: docker kill wr-ha-etcd1
03:47:37 recover: docker start wr-ha-etcd1
orders 420 failed 0 (0.0%) by part {}لا أثر إطلاقاً، فالعضوان الباقيان اثنان من ثلاثة، فانتخبا قائداً جديداً واستمر Patroni في تجديد مفتاحه دون أن يلاحظ. ثم قتلنا عضوين معاً، كما يحدث إذا كانا على سيرفرين في المكان نفسه وتوقف هذا المكان:
sh gameday.sh g3-etcd2 90 50 "docker kill wr-ha-etcd2 wr-ha-etcd3" "docker start wr-ha-etcd2 wr-ha-etcd3"
docker logs wr-ha-pg2 2>&1 | grep -iE "demot|DCS"
03:48:53 fault: docker kill wr-ha-etcd2 wr-ha-etcd3
03:49:44 recover: docker start wr-ha-etcd2 wr-ha-etcd3
orders 874 failed 445 (50.9%) by part {'postgres': 445}
errors 03:49:05 -> 03:49:50 UTC 45.5 s {'postgres': 445}
03:49:05,230 ERROR: Error communicating with DCS
03:49:05,230 INFO: demoting self because DCS is not accessible and I was a leaderالفرضية كذبت، وبشكل كبير: 45.5 ثانية لم يستطع فيها أحد أن يشتري، مع أن سيرفرات PostgreSQL الثلاثة كانت تعمل بشكل ممتاز ولم يلمسها أحد. والسبب ما شرحناه في مقال Patroni دون أن نربطه بهذه الحالة: الرئيسي لا يبقى رئيسياً إلا إذا جدد مفتاحه في etcd، وetcd دون أغلبية لا يقبل أي كتابة، فبعد 12 ثانية من فقدان الأغلبية، أي عندما فشلت محاولة التجديد، خفض Patroni الرئيسي إلى القراءة فقط، وبقي كذلك حتى عاد etcd بعد 50 ثانية. أي أن etcd ليس في طريق الطلب، ولكنه في طريق قرار «من يقبل الكتابة»، وتوقفه يوقف الكتابة. وهذا أهم اكتشاف في اليوم، لأن الفريق كان يعامل etcd كخدمة جانبية صغيرة، يضع أعضاءها حيث يتوفر مكان، ولا يراقبها.
والأرقام نفسها تتطابق مع ما شرحناه عن مهل Patroni: الكتابة بدأت تفشل بعد 12 ثانية من قتل العضوين، وهي تقريباً مدة retry_timeout العشر ثوان مع بقية الدورة، وعادت بعد حوالي 6 ثوان من عودة etcd، حين أعاد Patroni أخذ المفتاح وأعاد PostgreSQL رئيسياً. ولاحظ أن Patroni لم ينقل الدور إلى سيرفر آخر في هذه الحالة، ولا يستطيع أن ينقله، فلا أحد يستطيع أن يأخذ المفتاح من etcd متوقف، أي أن العنقود كله كان دون كاتب طوال المدة. وهذا الفرق بين الأعطال مهم لدليل التشغيل: في توقف الرئيسي ينتظر المناوب الانتقال التلقائي، أما في توقف etcd فلا يوجد انتقال ينتظره، والإصلاح الوحيد هو إعادة etcd نفسه.
ماذا لو فعلنا failsafe_mode؟ What If
Patroni يعرف هذه المشكلة، وفيه حل لها يشرحه توثيق وضع الأمان failsafe mode: إذا فشل تجديد المفتاح لأن etcd نفسه متوقف، وليس لأن الرئيسي معزول، يتصل الرئيسي مباشرة بكل الأعضاء الآخرين عبر ال REST API، فإذا ردوا كلهم بالقبول بقي رئيسياً، وإذا لم يرد واحد منهم خفض نفسه كالعادة. والمنطق أن الرئيسي الذي يرى كل النسخ مباشرة ليس معزولاً، فلا خطر من رئيسي آخر. فعلناه بأمر واحد ثم كررنا التجربة نفسها:
docker exec wr-ha-pg2 patronictl -c /etc/patroni.yml edit-config -s failsafe_mode=true --force
sh gameday.sh g3-etcd2-failsafe 90 50 "docker kill wr-ha-etcd2 wr-ha-etcd3" "docker start wr-ha-etcd2 wr-ha-etcd3"
03:52:06 fault: docker kill wr-ha-etcd2 wr-ha-etcd3
03:52:57 recover: docker start wr-ha-etcd2 wr-ha-etcd3
orders 876 failed 0 (0.0%) by part {}
03:52:26,168 ERROR: Error communicating with DCS
03:52:26,173 INFO: Got response from pg3 http://wr-ha-pg3:8008/failsafe: Accepted
03:52:26,173 INFO: Got response from pg1 http://wr-ha-pg1:8008/failsafe: Accepted
03:52:26,174 INFO: continue to run as a leader because failsafe mode is enabled and all members are accessibleصفر فشل في 876 طلباً، والسطر الأخير يقول بالضبط ما حدث: الرئيسي سأل pg1 وpg3 مباشرة، فقبلا، فبقي رئيسياً طوال 50 ثانية من توقف etcd. ولكن لاحظ حدود هذا الحل كما في التوثيق: إذا لم يرد عضو واحد خفض الرئيسي نفسه، أي أنه يحميك من توقف etcd وحده، وليس من توقف etcd مع أي سيرفر قاعدة بيانات، وأنه لا يسمح بأي انتقال أثناء توقف etcd، فإذا توقف الرئيسي في هذه اللحظة فلن يحل محله أحد. لذلك هو تحسين حقيقي، ولكنه لا يغني عن الإصلاح الأساسي: ثلاثة أعضاء etcd في ثلاثة أماكن مستقلة، مراقبة كأي خدمة في طريق الطلب.
التجربة 4: توقف رئيسي Valkey
sh gameday.sh g4-valkey 45 25 "docker kill wr-ha-v1" "docker start wr-ha-v1"03:55:04 fault: docker kill wr-ha-v1
03:55:31 recover: docker start wr-ha-v1
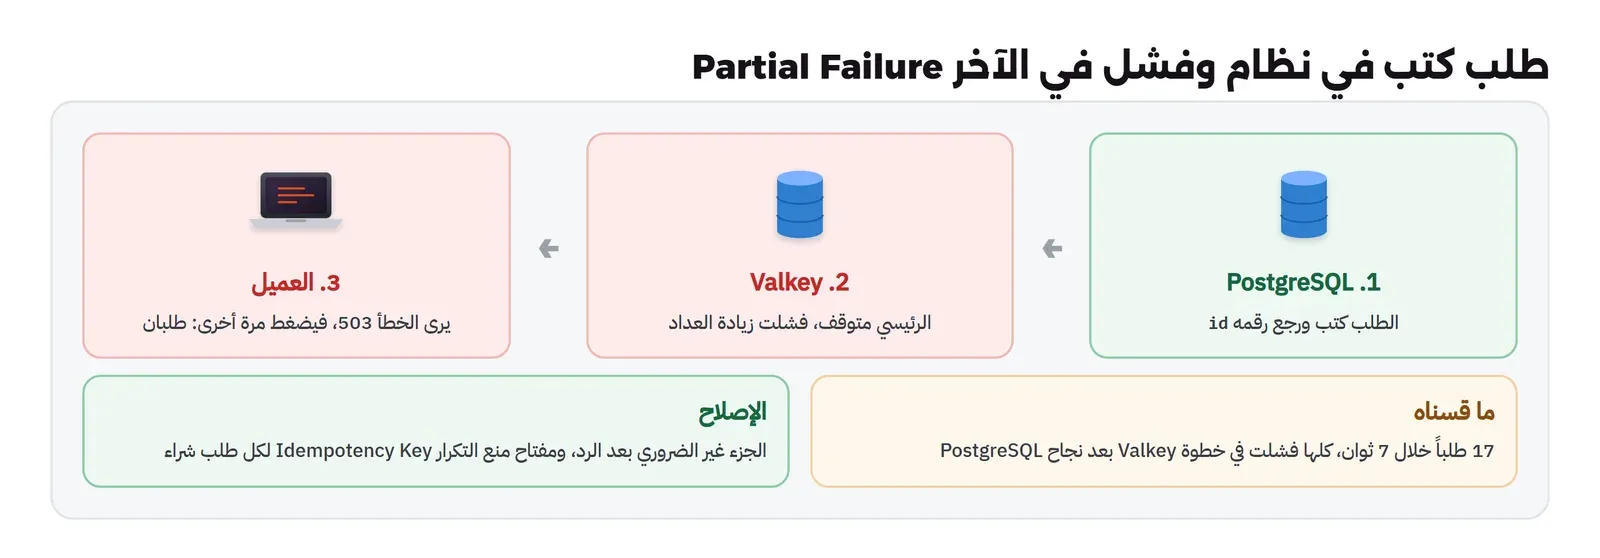
orders 385 failed 17 (4.4%) by part {'valkey': 17}
errors 03:55:05 -> 03:55:12 UTC 7.0 s {'valkey': 17}نصف الفرضية صدق: الفشل 7 ثوان، أقل من 10، وهو ما رأيته في مقال Sentinel. أما النصف الثاني، «الطلب الفاشل لا يكتب شيئاً»، فقد كذب، وهذا ما كشفه عمود «الجزء الذي فشل» في المسبار. فالطلبات الـ 17 فشلت كلها في خطوة Valkey، أي بعد أن كتب التطبيق الطلب في PostgreSQL ورجع رقمه، فالعميل رأى رسالة خطأ، والطلب موجود في قاعدة البيانات. والعميل الذي يرى خطأ في صفحة الدفع يضغط الزر مرة أخرى، فيصبح لديه طلبان، وإذا كان الدفع قد تم في الأول فقد دفع مرتين. والسبب ليس في Valkey ولا في Sentinel، وإنما في التطبيق الذي يكتب في نظامين دون أن يربطهما، وهذه المشكلة لا تظهر أبداً إلا عندما يتعطل الثاني بعد نجاح الأول، أي لا تظهر في أي اختبار عادي.
والإصلاحات الممكنة كثيرة، وأبسطها ترتيب الخطوات بحيث يكون الجزء غير الضروري بعد الرد، أي أن يرد التطبيق بالنجاح بعد كتابة PostgreSQL، ويحدث عداد السلة في Valkey بعده دون أن يفشل الطلب إذا فشل، لأن العداد يمكن إعادة حسابه. والإصلاح الأعم أن يحمل كل طلب شراء مفتاح منع التكرار Idempotency Key من المتصفح، فإذا أعاد العميل المحاولة وجد التطبيق الطلب الأول وأعاده بدلاً من إنشاء ثان، وقد شرحنا الفكرة في مقال الأنظمة الموزعة.
التجربة 5: موزع قاعدة البيانات Single Point of Failure
آخر تجربة جاءت من سؤال أحد الحاضرين وهو ينظر إلى الرسم: «وماذا عن هذا الصندوق؟»، وكان يشير إلى HAProxy الذي بين التطبيق وقاعدة البيانات، فهو صندوق واحد في الرسم، ولم يلاحظ أحد ذلك عندما بني، لأن كل ما خلفه ثلاثي:
وهذا النوع من نقاط الفشل هو الأكثر شيوعاً في الأنظمة التي بنيت على مراحل، فكل مقال في هذه المرحلة أضاف طبقة متكررة، وكل طبقة جاءت ومعها أداة صغيرة تربطها بما قبلها: موزع، أو سكربت، أو اسم في DNS، أو سيرفر مراقبة. والطبقة نفسها تختبر عادة يوم بنائها، أما الأداة الصغيرة التي تربطها فلا يختبرها أحد، لأنها لا تبدو جزءاً من التوفر العالي، وإنما مجرد توصيل. لذلك عندما تراجع الرسم في تمرين الطاولة، ابحث عن الأسهم وليس عن الصناديق فقط، واسأل عن كل سهم: من يحمل هذا الاتصال، وكم نسخة منه؟
sh gameday.sh g5-dblb 45 20 "docker kill wr-ha-dblb" "docker start wr-ha-dblb"03:56:44 fault: docker kill wr-ha-dblb
03:57:07 recover: docker start wr-ha-dblb
orders 185 failed 14 (7.6%) by part {'postgres': 7, 'TimeoutError': 7}
errors 03:56:45 -> 03:57:09 UTC 23.7 s {'postgres': 7, 'TimeoutError': 7}المتجر توقف بالكامل 23.7 ثانية، ولم يعد إلا لأن السكربت أعاد تشغيل الموزع بعد 20 ثانية، وفي الواقع لن يعود حتى يستيقظ شخص. ولاحظ أن عدد الطلبات الفاشلة صغير، 14 فقط، والسبب أن كل محاولة كانت تنتظر حتى 3 ثوان قبل أن تفشل، فالنسبة 7.6% تخفي أن كل العملاء في هذه الثواني فشلوا، وهذا سبب أن تقيس نوافذ الفشل وليس النسبة وحدها. والإصلاح أحد خيارين رأيتهما في مقال Patroni: نسختان من HAProxy مع عنوان عائم كما في دليل Keepalived، أو HAProxy على كل سيرفر تطبيق يتصل به التطبيق محلياً، فيتوقف مع سيرفره فقط، والموزع الأمامي يخرج ذلك السيرفر كما رأيت في التجربة الأولى بعد إصلاحها.
النتائج: الفرضيات مقابل الواقع Results
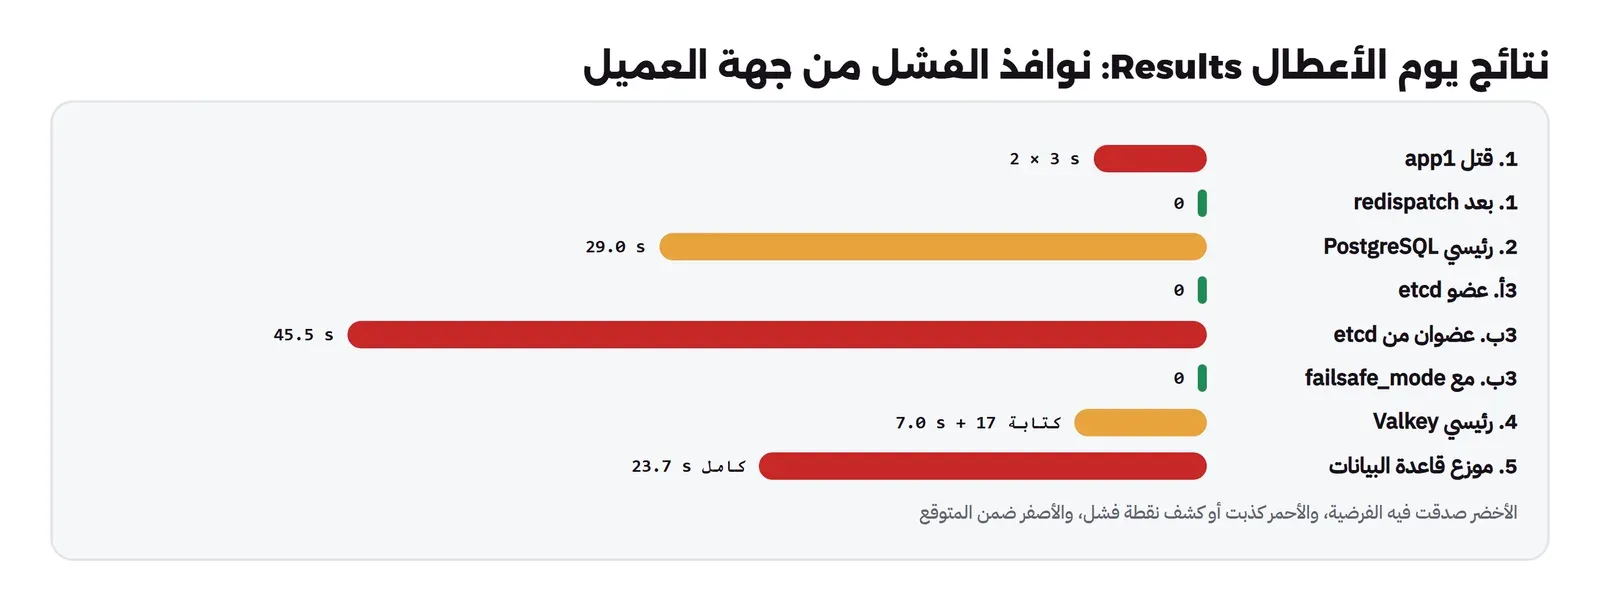
والجدول التالي هو المخرج الحقيقي ليوم الأعطال، وهو ما يذهب إلى الفريق والإدارة:
| التجربة | الفرضية | النتيجة | الحكم |
|---|---|---|---|
| 1. قتل app1 | صفر فشل | طلبان، 3 ثوان لكل واحد | كذبت، وصدقت بعد redispatch |
| 2. قتل رئيسي PostgreSQL | أقل من 35 ثانية | 29.0 ثانية، 257 طلباً | صدقت |
| 3أ. قتل عضو etcd | لا أثر | صفر فشل | صدقت |
| 3ب. قتل عضوين من etcd | لا أثر | 45.5 ثانية، 445 طلباً | كذبت، وصدقت مع failsafe_mode |
| 4. قتل رئيسي Valkey | أقل من 10 ثوان، دون كتابة | 7.0 ثوان، و17 طلباً كتبت في PostgreSQL | نصف صدقت |
| 5. قتل موزع قاعدة البيانات | لم تكتب | 23.7 ثانية توقف كامل حتى أعيد يدوياً | نقطة فشل واحدة |
حذف المختبر Cleanup
docker rm -f -v wr-ha-etcd1 wr-ha-etcd2 wr-ha-etcd3 wr-ha-pg1 wr-ha-pg2 wr-ha-pg3 wr-ha-dblb \
  wr-ha-v1 wr-ha-v2 wr-ha-v3 wr-ha-s1 wr-ha-s2 wr-ha-s3 wr-ha-app1 wr-ha-app2 wr-ha-weblb wr-ha-probe
docker volume rm wr-ha-pg1 wr-ha-pg2 wr-ha-pg3
docker network rm wr-ha-net
docker rmi wr-ha-patroni:1 wr-ha-app:2 gcr.io/etcd-development/etcd:v3.7.2 valkey/valkey:9.1.2 haproxy:3.4.6
من النتائج إلى المهام Action Items
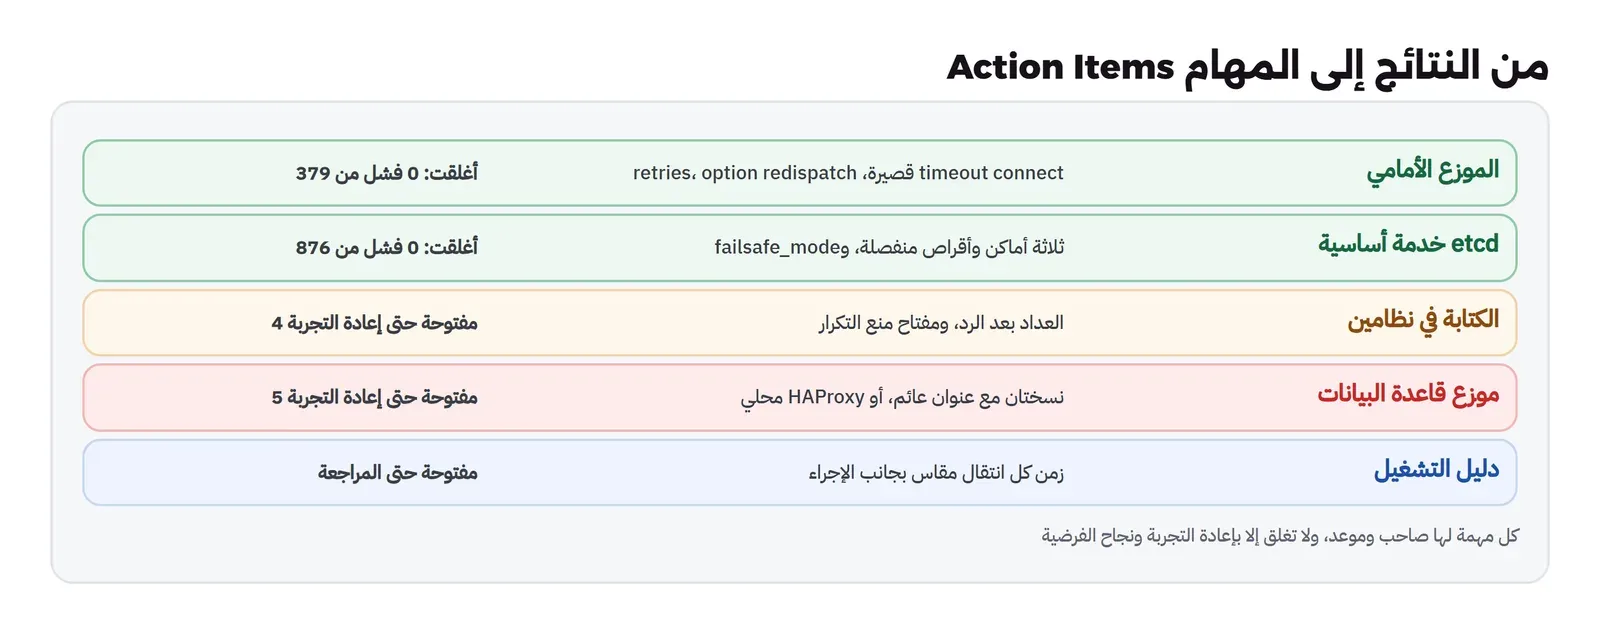
يوم الأعطال الذي ينتهي بجدول نتائج دون مهام هو عرض ممتع وليس تمريناً، والقاعدة أن كل فرضية كذبت تتحول إلى مهمة لها صاحب وموعد، وأن المهمة لا تغلق إلا بإعادة التجربة نفسها ونجاح الفرضية، كما فعلنا في التجربة الأولى والثالثة. ومن هذا اليوم خرجت خمس مهام، ولكل واحدة منها صاحب واحد باسمه وموعد قبل موسم التخفيضات، لأن المهمة التي يملكها الجميع لا يملكها أحد:
- إعداد الموزع الأمامي:
timeout connectقصيرة معretriesوoption redispatch، وتحققنا منها في المختبر، فتنقل إلى الإنتاج وتعاد التجربة هناك. - etcd خدمة أساسية: ثلاثة أعضاء في ثلاثة أماكن، على أقراص منفصلة، مع تنبيه على عدد الأعضاء السليمة، وتفعيل
failsafe_modeبعد قراءة حدوده. - التطبيق والكتابة في نظامين: نقل تحديث عداد السلة إلى ما بعد الرد، وإضافة مفتاح منع التكرار لطلب الشراء، ثم إعادة التجربة الرابعة والتأكد أن الطلب الفاشل لا يكتب شيئاً، أو أن الإعادة لا تكرره.
- موزع قاعدة البيانات: إزالة نقطة الفشل الواحدة بأحد الخيارين، ثم إعادة التجربة الخامسة.
- دليل التشغيل: كتابة الأرقام التي قسناها، مثل 29 ثانية لانتقال PostgreSQL و7 ثوان لانتقال Valkey، حتى يعرف المناوب ما هو طبيعي وما يحتاج تدخله، كما شرحنا في دليل ال Runbook.
واكتب التقرير بالطريقة نفسها التي تكتب بها مراجعة ما بعد الحادثة، دون لوم لأحد، فالفرضيات التي كذبت كتبها الفريق كله، والهدف أن يتعلم النظام والناس، كما في فصل ثقافة المراجعة في كتاب Google SRE.
ما الذي تجربه بعد ذلك؟ Failure Catalog
التجارب الخمس في المختبر كلها من نوع واحد: جزء يختفي فجأة. وهو أسهل نوع لتنفيذه، ولكنه ليس أكثر الأعطال حدوثاً في الواقع، فالجزء الذي يختفي تماماً يكتشفه أي فحص صحة، أما الجزء الذي يبطئ، أو يرد بأخطاء، أو يرى نصف الشبكة فقط، فهو الذي يخدع الأنظمة كما رأيت في السيرفر الذي يبتلع الطلبات في مقال توزيع الطلبات. لذلك اكتب قائمة بالأعطال الممكنة لنظامك، ورتبها بحسب احتمال حدوثها وحجم أثرها إذا حدثت، وجرب الأعلى أولاً. وهذه الأنواع التي يجب أن تكون في كل قائمة:
- الاختفاء Crash: ما فعلناه في المختبر، بقتل العملية أو ال Container أو السيرفر كله، والفرق بين قتل العملية وقطع الكهرباء عن السيرفر كبير، فالأول يترك نظام التشغيل يغلق الاتصالات فيعرف الطرف الآخر فوراً، والثاني يتركها معلقة حتى تنتهي المهل.
- البطء Latency: الجزء يعمل ولكنه يرد ببطء، وهو أخطر من الاختفاء لأن الفحوص قد تنجح، والطوابير تمتلئ في كل الأجزاء التي تنتظره. وتصنعه على Linux بالأداة tc مع netem التي تضيف تأخيراً أو فقداً للحزم على واجهة شبكة، أو بوسيط مثل Toxiproxy تضعه بين التطبيق والخدمة وتتحكم في سلوكه.
- الانقسام Partition: جزء يرى بعض الأجزاء ولا يرى غيرها، كما فعلنا في مقالي Patroni وSentinel بشبكة جانبية، وهو الذي يكشف الكتابة على رئيسي معزول.
- الموارد Resources: قرص ممتلئ، وذاكرة ممتلئة، ونفاد الاتصالات المتاحة في قاعدة البيانات، وهي التي أوقفت المتجر في قصة مقال تكلفة التوقف.
- الاعتمادات الخارجية Dependencies: DNS، وبوابة الدفع، ومزود البريد، وشهادة TLS التي تنتهي، فكل واحد منها قد يوقف عملية الشراء دون أن يتعطل أي سيرفر عندك.
- الأشخاص والإجراءات People: المناوب الذي لا يصله التنبيه، وكلمة المرور الموجودة عند شخص واحد، ودليل التشغيل الذي يشير إلى سيرفر لم يعد موجوداً.
وكل نوع من هذه الأنواع يستحق يوم أعطال خاصاً به في وقت ما، والترتيب المعقول أن تبدأ بالاختفاء لأنه الأسهل والأوضح، كما فعلنا، ثم البطء لأنه الأكثر خداعاً، ثم الانقسام، ثم الاعتمادات الخارجية، وتبقى الأشخاص والإجراءات حاضرة في كل يوم منها.
الأدوات Tools: من السكربت إلى المنصات
في المختبر لم نحتج إلا سكربتاً من عشرين سطراً، وهذا يكفي لأغلب الفرق في البداية، فالأمر docker kill أو systemctl kill أو إيقاف جهاز افتراضي من لوحة المزود هي أدوات حقن أعطال حقيقية. ولكن عندما تكبر التجارب وتتكرر، تفيد أدوات تعطيك ثلاثة أشياء لا يعطيها السكربت: وصفاً للتجربة في ملف يمكن مراجعته وتكراره، وفحصاً للحالة المستقرة قبل التجربة وبعدها يوقفها تلقائياً إذا تجاوزت الحد، وتقريراً موحداً. ومن الأدوات مفتوحة المصدر في هذا المجال Chaos Toolkit الذي يصف التجربة في ملف JSON أو YAML فيه الفرضية والحقن والإعادة، وLitmusChaos لبيئات Kubernetes. والمهم أن الأداة لا تصنع الثقافة، فالفريق الذي لا يكتب فرضياته قبل التجربة ولا يحول نتائجها إلى مهام لن يستفيد من أي منصة، والفريق الذي يفعل ذلك يستطيع أن يبدأ اليوم بسكربت كالذي في المختبر.
يوم الأعطال في الإنتاج Production
المختبر وبيئة الاختبار تكشف أغلب المشاكل في الإعداد، ولكن هناك أشياء لا تظهر إلا في الإنتاج: حجم البيانات الحقيقي الذي يطيل المزامنة، والضغط الحقيقي الذي يغير زمن الانتقال، والشبكة الحقيقية بين الأماكن، والأهم من ذلك الناس الحقيقيون في المناوبة. لذلك تنتقل الفرق الناضجة تدريجياً إلى تجارب في الإنتاج، بشروط تقلل الخطر:
- ابدأ بأصغر نطاق: نسخة PostgreSQL واحدة وليس الرئيسي، وسيرفر تطبيق واحد من عدة، وفي وقت ضغط منخفض، ثم وسع النطاق تجربة بعد تجربة.
- ابدأ بالانتقال المخطط:
patronictl switchoverوSENTINEL failoverانتقالات حقيقية في الإنتاج، ولكنها لطيفة، وإذا لم تنجح هذه فلن ينجح العطل المفاجئ. - أعلن قبل التجربة: أخبر فريق خدمة العملاء والمناوبين بالوقت والنطاق، حتى لا يتحول التمرين إلى حادثة حقيقية لا يعرف أحد سببها.
- شرط الإيقاف آلي إذا أمكن: تنبيه على المقياس نفسه يوقف التجربة ويعيد كل شيء إذا تجاوز الحد، بدلاً من الاعتماد على أن يلاحظ شخص.
- لا تجرب ما تعرف أنه سوف يفشل: إذا كشفت بيئة الاختبار نقطة فشل واحدة، فأصلحها أولاً، ولا تثبتها مرة أخرى على العملاء.
وبهذه الشروط يمكن أن يكون أول يوم أعطال للمتجر في الإنتاج بعد إغلاق المهام الخمس، في صباح يوم تكون فيه المبيعات في أدنى مستوياتها، وبثلاث تجارب فقط: انتقال مخطط في PostgreSQL بالأمر switchover، ثم انتقال مخطط في Valkey بالأمر SENTINEL failover، ثم إخراج سيرفر تطبيق واحد من الموزع بالتصريف Drain ثم إيقافه. وشرط الإيقاف أي فشل أكثر من 10 ثوان في المسبار الخارجي، أو أي شكوى من خدمة العملاء، والمناوب لذلك الأسبوع هو منفذ التجارب، حتى ينفذ كل خطوة من دليل التشغيل بيده. والسبب في هذا الاختيار الأخير أن أكثر ما يكشفه اليوم الأول في الإنتاج عادة ليس سلوك النظام، فقد عرفته من المختبر، وإنما الفجوة بين دليل التشغيل والواقع: أمر يشير إلى اسم سيرفر قديم، أو صلاحية لا يملكها المناوب، أو لوحة مراقبة لا تعرض الجزء الذي يحتاجه، وهذه أشياء لا يكشفها أي مختبر.
كم مرة تكرر يوم الأعطال؟ Cadence
يوم الأعطال ليس مشروعاً ينتهي، فالنظام يتغير كل أسبوع، وكل تغيير قد يكسر افتراضاً كان صحيحاً في آخر تجربة. والإيقاع الذي يناسب أغلب الفرق: يوم أعطال كامل كل ثلاثة أشهر، وقبل كل موسم ضغط مثل التخفيضات، وبعد كل تغيير كبير في البنية مثل إضافة طبقة أو نقل مركز بيانات، وتجربة صغيرة واحدة في كل مرة يتغير فيها إعداد التوفر العالي نفسه. ومع الوقت حول التجارب التي تتكرر دون أن تكشف شيئاً إلى اختبارات آلية تعمل كل أسبوع في بيئة الاختبار، مثل سكربت gameday.sh نفسه في خط النشر، واترك الأيام اليدوية للأسئلة الجديدة. وتذكر أن تجعل الأشخاص يتغيرون أيضاً، فالمناوب الجديد يجب أن ينفذ الانتقال بنفسه مرة في يوم أعطال قبل أن ينفذه في ليلة حقيقية.
وجدول سنة لمتجر بحجم المتجر الذي نتابعه قد يبدو كالتالي: في الربع الأول يوم اختفاء الأجزاء كما في هذا المقال، وفي الثاني يوم البطء بالأداة netem على قاعدة البيانات وValkey، وفي الثالث يوم الانقسام والاعتمادات الخارجية مثل بوابة الدفع وDNS، وفي الرابع قبل موسم التخفيضات يوم يجمع أهم التجارب السابقة على الإنتاج بنطاق صغير، ومعه تمرين طاولة لسيناريو أكبر مثل فقدان المكان كله، وهو موضوع المقال القادم.
كيف تقنع الإدارة بيوم أعطال؟ Making the Case
أول اعتراض تسمعه عندما تقترح يوم أعطال: «تريد أن تعطل النظام عمداً؟ ونحن ندفع لكي لا يتعطل!». والإجابة الأقوى بالأرقام التي حسبناها في مقال تكلفة التوقف: الفريق دفع ثمن التوفر العالي في السيرفرات ووقت المهندسين، وقيمة هذا الثمن كلها معلقة على شرط واحد، أن يعمل الانتقال عندما يحتاجه. وفي حساب مقال المفاهيم رأيت أن الانتقال الذي ينجح 99% من المرات فقط يرفع التوقف السنوي من نصف دقيقة إلى حوالي ست دقائق، أي أن الجزء الأكبر من قيمة الاستثمار يضيع في المرة الواحدة التي لا ينجح فيها. ويوم الأعطال الذي يأخذ نصف يوم من أربعة مهندسين كل ثلاثة أشهر هو أرخص تأمين على هذا الاستثمار.
والحجة الثانية من نتائج المتجر نفسه: يوم واحد في بيئة اختبار كشف نقطة فشل واحدة كانت سوف توقف المتجر كله، وخدمة جانبية توقف الكتابة 45 ثانية، ومشكلة في التطبيق تجعل العملاء يدفعون مرتين، وكلها كانت سوف تظهر في الإنتاج يوماً ما، والسؤال الوحيد هو في أي ليلة. والإدارة تفهم هذه الجملة أكثر من أي شرح تقني: «نحن نختار متى نكتشف المشكلة، بدلاً من أن تختار هي».
أخطاء شائعة Common Mistakes
- الفرضية بعد التجربة: فتبدو كل نتيجة متوقعة، ولا تكتشف أن فهمك للنظام كان خاطئاً.
- قياس السيرفرات بدلاً من العميل: فتقول السيرفرات إن كل شيء بخير بينما العميل لا يشتري.
- نسبة الفشل وحدها: فتبدو 7.6% صغيرة بينما المتجر كان متوقفاً بالكامل 23 ثانية.
- إصلاح دون إعادة التجربة: فيبقى الإصلاح فرضية جديدة.
- تجاهل الخدمات الجانبية: مثل etcd والموزعات، لأنها ليست في الرسم الذي يعرفه الجميع.
- اختبار جزء جزء فقط: فلا تظهر مشكلة الكتابة في نظامين، لأنها تظهر فقط عندما يتعطل الثاني بعد نجاح الأول.
- اختبار التعطل بالأمر
docker stopأو الإغلاق السليم: فتختبر الحالة الأسهل، والأعطال الحقيقية مفاجئة. - يوم أعطال دون أدوار ولا أمر إعادة: فيتحول التمرين إلى حادثة حقيقية بلا قائد.
قائمة تحقق Checklist
| البند | كيف تتحقق منه |
|---|---|
| مقياس واحد من جهة العميل | مسبار يشتري أو ينفذ العملية الأهم، ويقيس النوافذ والنسبة |
| فرضية مكتوبة لكل تجربة | جدول الخطة موقع قبل التشغيل |
| نطاق الأثر وشرط الإيقاف | رقم واضح لكل تجربة، وأمر إعادة مكتوب ومجرب |
| الأدوار موزعة | قائد، ومنفذ، ومراقب، وكاتب، والمناوب حاضر |
| كل صندوق في الرسم جرب | بما فيها الموزعات وetcd وSentinels وDNS |
| كل فرضية كذبت مهمة | صاحب وموعد، وتغلق بإعادة التجربة |
| الأرقام في دليل التشغيل | زمن كل انتقال مقاس مكتوب بجانب الإجراء |
| إيقاع ثابت | كل ثلاثة أشهر، وقبل كل موسم، وبعد كل تغيير كبير |
| التجارب المتكررة آلية | سكربت أسبوعي في بيئة الاختبار |
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه لمن يخطط ليومه الأول من الأعطال قبل الموسم القادم:
- التوفر العالي الذي لم تختبره فرضية، ويوم الأعطال يحولها إلى أرقام: حالة مستقرة، وفرضية مكتوبة قبلها، ونطاق أثر، وشرط إيقاف، وأدوار.
- في خمس تجارب على المتجر كاملاً كذبت فرضيتان: قتل سيرفر تطبيق أفشل طلبين بثلاث ثوان لكل واحد حتى أضفنا
redispatch، وفقدان أغلبية etcd أوقف الكتابة 45.5 ثانية وقاعدة البيانات سليمة. failsafe_modeفي Patroni جعل توقف etcd نفسه دون أي أثر، لأن الرئيسي سأل كل النسخ مباشرة.- توقف رئيسي Valkey كشف 17 طلباً كتبت في PostgreSQL ورأى أصحابها خطأ، وهي مشكلة في التطبيق لا تظهر إلا في هذا العطل.
- موزع قاعدة البيانات كان نقطة فشل واحدة لم يلاحظها أحد، وأوقف المتجر كله 23.7 ثانية.
- كل فرضية كذبت تصبح مهمة تغلق بإعادة التجربة، وكرر اليوم كل ثلاثة أشهر وقبل كل موسم.
- الاختفاء أسهل الأعطال لتجربته وليس أكثرها حدوثاً، فأضف بعده البطء والانقسام والموارد والاعتمادات الخارجية، وابدأ دائماً بالطاولة قبل الأوامر.
وفي المقال الأخير من مرحلة التوفر العالي بإذن الله ننتقل من عطل جزء إلى عطل المكان كله: التعافي من الكوارث Disaster Recovery، ومتى يكفيك النسخ الاحتياطي، ومتى تحتاج موقعاً ثانياً.
 دليلمفاهيم التوفر العالي High Availability للمبتدئينماذا يعني أن تبقى خدمتك تعمل رغم تعطل جزء منها، وكيف تحسب التوفر وتجد نقاط الفشل الواحدة وتقرر متى يستحق ذلك تكلفته.
 دليلانتقال تلقائي Failover لقاعدة PostgreSQL مع Patroniبنينا عنقود PostgreSQL من ثلاث نسخ يديره Patroni، ثم قتلنا الرئيسي وعزلناه عن الشبكة وقسنا كم ثانية توقفت الكتابة وكم طلباً مؤكداً ضاع.
 دليلSentinel أمام Redis أو Valkey: ماذا يضيع عند الانتقال؟قتلنا الرئيسي وعزلناه عن الشبكة في Valkey مع ثلاث Sentinels، وعددنا كل سلة أكدها الخادم ثم اختفت، لترى متى يضيع ما كتبته وكيف تحدد سقف الخسارة.
 دليلتوزيع الطلبات Load Balancing: الخوارزميات مقاسة في مختبرقسنا التناوب وأقل اتصالات والاختيار من اثنين والهاش على ثلاثة سيرفرات خلف HAProxy، لترى متى يكون التوزيع بالتساوي خطأ ومتى يبتلع السيرفر المعطل كل الطلبات.
 دليلإدارة الحوادث Incident Response: من التنبيه إلى عودة الخدمةنعيش حادثة حقيقية على PostgreSQL من التنبيه إلى الإغلاق بخط زمني مسجل بالثواني، ونرى لماذا لم تنفع إعادة التشغيل وما الذي أنهى الحادثة.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة الدليل وتنفيذ يوم أعطال على مختبر من HAProxy 3.4.6 وPatroni 4.1.5 مع PostgreSQL 18.6 وetcd 3.7.2 وValkey 9.1.2 مع Sentinel على Docker Engine 29.8.0.


