


سلال المشتريات في المتجر وجلسات الدخول محفوظة في Valkey منذ أن نقلها الفريق إليه كما شرحنا في دليل Redis وValkey، وفي دليل عناقيد قواعد البيانات أضفنا نسخة وثلاثة Sentinels، وقرأنا سجلاتها سطراً سطراً حتى رأينا الانتقال يحدث من جهة Sentinel: الاشتباه، ثم الاتفاق، ثم الانتخاب، ثم الترقية. ولكن عميل المتجر لا يقرأ سجلات Sentinel، وإنما يضع منتجاً في السلة ويضغط زر الدفع، والسؤالان اللذان يهمانه وتهم الإدارة مختلفان تماماً: كم ثانية لا يستطيع أن يضيف إلى السلة؟ وهل يمكن أن يضيف منتجاً، ويرى الرسالة «تمت الإضافة»، ثم يجد السلة فارغة بعد دقيقة؟
والإجابة عن السؤال الثاني ليست «لا» كما يظن كثيرون، والتوثيق نفسه يقولها صراحة، ولكن متى يحدث ذلك، وكم يضيع، وكيف تقلله، فهذه أشياء تحتاج تجربة. وفي هذا المقال نبني الإعداد نفسه بثلاث نسخ Valkey 9.1.2 وثلاثة Sentinels، ونكتب عليه من عميلين مختلفين، ونعطله بثلاث طرق، ونعد بعد كل تجربة كل سلة أكدها الخادم للعميل ثم اختفت. والكلام كله يصدق على Redis أيضاً، لأن Sentinel ونسخ البيانات فيهما واحد.
وسوف نناقش في هذا المقال ما يلي:
- ما الذي يفعله Sentinel باختصار، والفرق بين النصاب Quorum والأغلبية التي تسمح بالانتقال.
- كيف يجد التطبيق الرئيسي الجديد، ولماذا لا يكفي عنوان ثابت في الإعداد.
- لماذا قد تضيع كتابات مؤكدة في النسخ غير المتزامن، كما يصفها التوثيق.
- مختبر حقيقي: قتل الرئيسي مع عميل يعرف Sentinel وعميل بعنوان ثابت، ومشكلة الرئيسي القديم الذي عاد رئيسياً 15 ثانية.
- عزل الرئيسي عن الشبكة مع عميل بجانبه، ثم التجربة نفسها مع
min-replicas-to-write. - أين تضع Sentinels، وأي إعدادات تغير، ومتى تكون الخسارة مقبولة أصلاً.
Sentinel في دقيقتين: ماذا يحدث عند الانتقال؟
Sentinel عملية صغيرة منفصلة، تشغل منها ثلاث نسخ على الأقل في أجهزة مستقلة، وكل واحدة تراقب الرئيسي ونسخه، وتتكلم مع بقية Sentinels عبر الرئيسي نفسه. ويذكر توثيق Sentinel أربع مهام لها: المراقبة، والتنبيه، والانتقال التلقائي، ومزود الإعداد Configuration Provider، أي أن العميل يسألها عن عنوان الرئيسي الحالي بدلاً من أن يحفظه. والانتقال يمر بثلاث مراحل رأيناها في دليل العناقيد:
- الاشتباه الذاتي Subjectively Down: Sentinel واحدة لا تصلها إجابة صحيحة من الرئيسي مدة
down-after-milliseconds، فتكتب في سجلها+sdown. - الاتفاق Objectively Down: تسأل بقية Sentinels، فإذا وصل عدد من يراه متوقفاً إلى النصاب Quorum الذي كتبته في الإعداد، كتبت
+odown. - الانتخاب والترقية: قبل أن تنفذ أي واحدة الانتقال، يجب أن تنتخبها أغلبية Sentinels الموجودة، أي اثنتان من ثلاث، ثم تختار أفضل نسخة وترقيها، وتعلن العنوان الجديد
+switch-master.
ولاحظ الفرق بين الرقمين، فهو سبب خطأ شائع: النصاب في سطر sentinel monitor يحدد فقط كم Sentinel يجب أن تتفق على أن الرئيسي متوقف، أما تنفيذ الانتقال فيحتاج دائماً أغلبية Sentinels، مهما كان النصاب. فلو كانت لديك ثلاث Sentinels بنصاب 1، فواحدة تكفي لإعلان التوقف، ولكن الانتقال يحتاج اثنتين تنتخبان، وهذا ما يمنع Sentinel معزولة وحدها من ترقية نسخة.
وكل انتقال يأخذ رقماً متزايداً اسمه حقبة الإعداد Configuration Epoch، وهو ما رأيته في السجل بالسطر +new-epoch. والسبب أن Sentinels لا تتفق على الإعداد عبر مخزن مركزي كما يفعل Patroni مع etcd، وإنما تنشر كل واحدة ما تعرفه عبر قناة على الرئيسي والنسخ نفسها، فإذا وصلت إلى Sentinel معلومتان مختلفتان عن الرئيسي، أخذت صاحبة الحقبة الأعلى، وهذا ما يجعل كل Sentinels تصل في النهاية إلى الإعداد نفسه بعد أن تعود الشبكة، حتى لو رأت أجزاء مختلفة من الانقسام. ولكن كلمة «في النهاية» مهمة، فبين لحظة الانتقال ولحظة وصول المعلومة إلى كل الأطراف قد يرى بعض المشاركين صورة قديمة، وهذا بالضبط ما سوف تراه في تجربة الرئيسي الذي عاد بعد غيابه.
كيف يجد التطبيق الرئيسي؟ Sentinel-aware Clients
بعد الانتقال يصبح للرئيسي عنوان جديد، وSentinel لا تغير DNS ولا تنقل أي عنوان عائم، فالتطبيق هو الذي يجب أن يعرف. والطريقة التي يصفها دليل عملاء Sentinel أن المكتبة تحفظ قائمة Sentinels واسم الخدمة، وليس عنوان الرئيسي، ثم:
- تسأل أول Sentinel ترد عليها بالأمر
SENTINEL get-master-addr-by-nameعن عنوان الرئيسي الحالي. - تتصل بهذا العنوان، وترسل الأمر
ROLEلتتأكد أنه رئيسي فعلاً، لأن Sentinel التي ردت قد تكون متأخرة في معلوماتها. - عند أي انقطاع أو مهلة أو خطأ، تعيد الخطوات من الأول، فلا تعيد الاتصال بالعنوان القديم.
وأغلب المكتبات المعروفة تفعل ذلك، مثل redis-py التي سوف نستخدمها، كما في توثيق الاتصالات فيها، بالكلاس Sentinel والدالة master_for. والبديل الذي يفعله كثيرون هو أن يكتبوا عنوان الرئيسي في متغير بيئة، أو أن يضعوا أمامه HAProxy بفحص يسأل عن الدور، والأول هو أخطر شيء رأيناه في المختبر كما سوف ترى.
والطريقة الثانية، أي HAProxy أمام Valkey، مفيدة عندما تكون المكتبة في لغتك لا تدعم Sentinel، أو عندما يكون لديك تطبيقات كثيرة لا تريد أن تعدل إعداد كل واحد منها. والفكرة أن يفحص HAProxy كل سيرفر بفحص TCP يرسل الأمر INFO replication وينتظر في الرد النص role:master، فيرسل الاتصالات إلى السيرفر الذي يقول إنه رئيسي فقط. ولكن انتبه إلى أن هذا الفحص يسأل السيرفر عن رأيه في نفسه، وليس Sentinels عن قرارها، فالرئيسي القديم الذي يعود ويقول إنه رئيسي، كما سوف ترى في المختبر، سوف ينجح في الفحص، فيصبح لدى HAProxy سيرفران رئيسيان لثوان. لذلك إذا استخدمت هذه الطريقة فاجعل الخلفية تقبل سيرفراً واحداً فقط في كل لحظة، وأضف إلى الفحص التأكد من عدد النسخ المتصلة، أو اجعل سكربتاً صغيراً يسأل Sentinels ويغير حالة السيرفرات في HAProxy عبر الواجهة البرمجية، كما شرحنا الواجهة في مقال توزيع الطلبات.
لماذا قد تضيع كتابات مؤكدة؟ Asynchronous Replication
النسخ في Redis وValkey غير متزامن دائماً، فالرئيسي يرد على العميل بالنجاح فور أن ينفذ الأمر في ذاكرته، ثم يرسله إلى النسخ بعد ذلك، كما في توثيق النسخ. وهذا ما يجعله سريعاً جداً، ولكنه يعني أن هناك دائماً لحظة يكون فيها الأمر مؤكداً للعميل وغير موجود في أي نسخة. ويقول توثيق Sentinel صراحة إن النظام لا يضمن بقاء الكتابات المؤكدة عند الأعطال لهذا السبب، ويذكر مثالاً يطابق ما سوف نصنعه: رئيسي معزول عن بقية العنقود، وعميل ما زال يصل إليه ويكتب، فتنتخب Sentinels رئيسياً جديداً في الجهة الأخرى، وعندما تعود الشبكة يصبح الرئيسي القديم نسخة للجديد، ويحذف كل بياناته ليأخذ نسخة كاملة، «فتضيع كل البيانات التي كتبت أثناء الانقسام إلى الأبد».
والتوثيق نفسه يقترح طريقة لتقليل هذه النافذة، وهي إعدادان في الرئيسي: min-replicas-to-write عدد النسخ التي يجب أن تكون متصلة حتى يقبل الرئيسي الكتابة، وmin-replicas-max-lag عدد الثواني التي تعتبر بعدها النسخة غير متصلة إذا لم يصل منها تأكيد. فإذا انعزل الرئيسي عن كل نسخه، رفض الكتابة بعد مهلة التأخر، فتصبح الخسارة القصوى ثوان المهلة بدلاً من مدة الانقسام كلها. وسوف نقيس الفرق بالأرقام.
وقد يتساءل البعض: لماذا لا يجعل Valkey النسخ متزامناً كما فعلنا مع PostgreSQL، فينتهي الأمر؟ والإجابة أن سبب وجود Valkey أصلاً هو السرعة، فالأمر الواحد يأخذ أجزاء من الملي ثانية، وأي انتظار لتأكيد نسخة عبر الشبكة يضاعف هذا الزمن عدة مرات، ويجعل الرئيسي يتوقف إذا تأخرت نسخة. لذلك اختار المشروع أن يكون النسخ غير متزامن دائماً، وأن يعطيك أدوات تحدد بها سقف الخسارة بدلاً من أن تلغيها، وهي min-replicas-to-write للرئيسي كله، وWAIT لأمر بعينه. وهذا الاختيار يحدد ما يصلح أن تضعه فيه، كما سوف نشرح في آخر المقال.
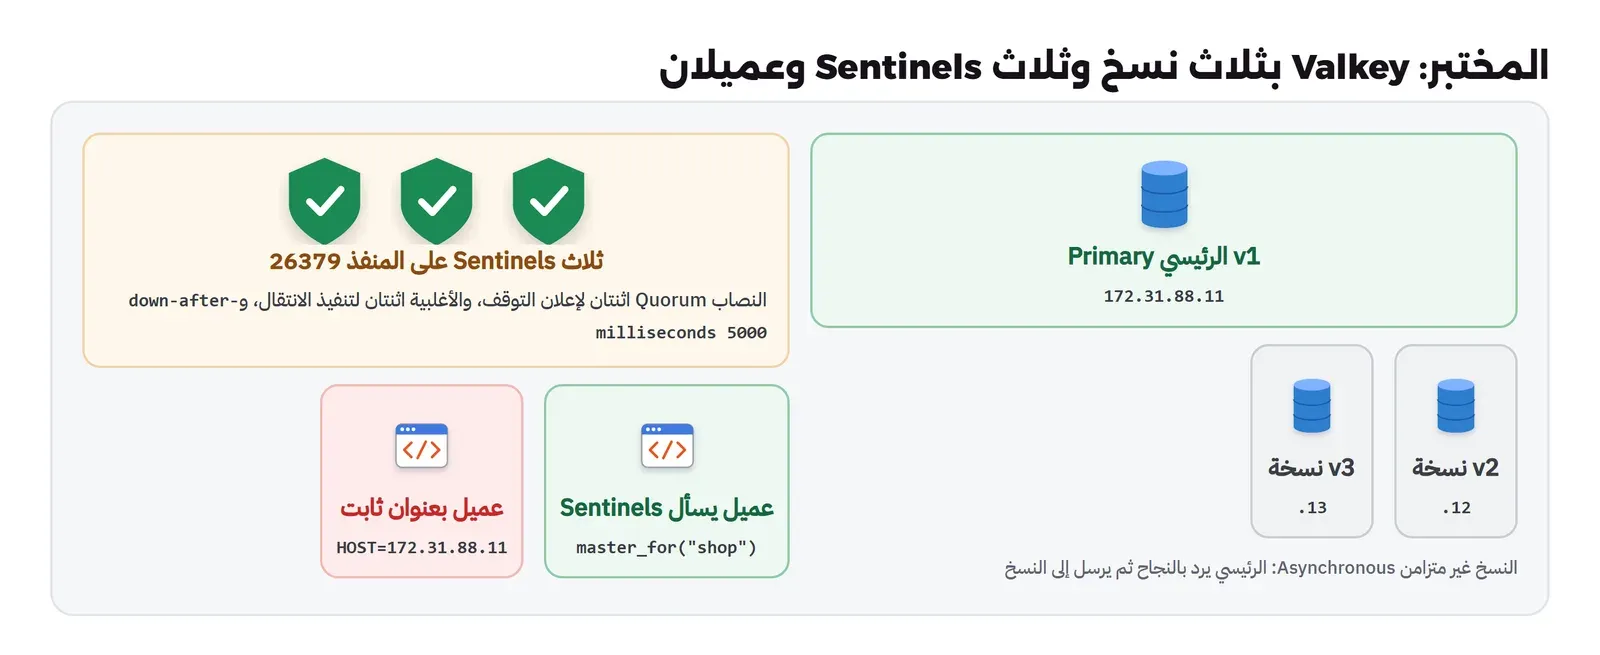
المختبر Lab: ثلاث نسخ Valkey مع ثلاثة Sentinels
تعلمنا من دليل العناقيد درساً مهماً: أسماء Containers في Docker تختفي من DNS الشبكة عندما يتوقف ال Container، فتدخل Sentinels في وضع TILT وهي تحاول حل الاسم ولا يحدث الانتقال، لذلك نعطي كل Container عنواناً ثابتاً على شبكة لها مدى معروف.
ملفات المختبر Lab Files
إعداد Sentinel واحد للثلاث، واحفظه باسم sentinel.conf:
# Sentinel for the "shop" Valkey: quorum 2 of 3, master down after 5 s without a valid reply
port 26379
sentinel monitor shop 172.31.88.11 6379 2
sentinel down-after-milliseconds shop 5000
sentinel failover-timeout shop 60000
sentinel parallel-syncs shop 1
ولاحظ أن Sentinel تعيد كتابة ملف إعدادها بنفسها، فتضيف إليه معرفها والنسخ وSentinels الأخرى التي اكتشفتها والرئيسي الجديد بعد كل انتقال، لذلك لا تضعه للقراءة فقط، وفي المختبر ننسخه إلى داخل ال Container عند التشغيل. والعميل يكتب سلة جديدة كل 100 ملي ثانية، إما عبر Sentinels بالوضع MODE=sentinel، أو على عنوان ثابت بالوضع MODE=direct، ويحفظ كل محاولة. احفظه باسم writer.py:
# Cart writer: SET cart:<n> every 100 ms for SECONDS, through Sentinel discovery (MODE=sentinel)
# or straight to one address (MODE=direct HOST=...). Logs every attempt and the server that took it.
import json, os, sys, time, redis
from redis.sentinel import Sentinel
MODE, SECONDS, OUT = os.environ.get("MODE", "sentinel"), float(os.environ.get("SECONDS", "60")), sys.argv[1]
SENTINELS = [("172.31.88.21", 26379), ("172.31.88.22", 26379), ("172.31.88.23", 26379)]
def connect():
    if MODE == "sentinel":
        return Sentinel(SENTINELS, socket_timeout=0.5).master_for("shop", socket_timeout=1, socket_connect_timeout=1)
    return redis.Redis(host=os.environ["HOST"], socket_timeout=1, socket_connect_timeout=1)
r, end, log, n = connect(), time.time() + SECONDS, [], 0
while time.time() < end:
    t0, n = time.time(), n + 1
    try:
        r.set(f"cart:{os.environ.get('TAG', 'a')}:{n}", t0)
        log.append((t0, "ok", n))
    except Exception as e:
        log.append((t0, type(e).__name__, n))
        if MODE == "sentinel": r = connect()          # ask the Sentinels again for the current master
    time.sleep(max(0, 0.1 - (time.time() - t0)))
json.dump(log, open(OUT, "w"))
ok = [x for x in log if x[1] == "ok"]
print(f"attempts {len(log)}  confirmed {len(ok)}  failed {len(log) - len(ok)}")
start, kinds = None, {}
for t, res, _ in log + [(time.time(), "ok", 0)]:
    if res != "ok":
        if start is None: start, kinds = t, {}
        kinds[res] = kinds.get(res, 0) + 1
    elif start is not None:
        print(f"outage {time.strftime('%H:%M:%S', time.gmtime(start))} -> {time.strftime('%H:%M:%S', time.gmtime(t))} UTC {t - start:5.1f} s  {kinds}"); start = None
وبعد كل تجربة نسأل الرئيسي الحالي عن كل سلة أكدها الخادم للعميل، بالسكربت check.py، ونطبع نوافذ التوقف من السجل بالسكربت outage.py، وهو الجزء الأخير من writer.py نفسه في ملف مستقل:
# Which confirmed cart keys from a writer log still exist on the current master?
import json, sys, redis
from redis.sentinel import Sentinel
log, tag = json.load(open(sys.argv[1])), sys.argv[2]
m = Sentinel([("172.31.88.21", 26379)], socket_timeout=1).master_for("shop", socket_timeout=2)
ok = [n for _, res, n in log if res == "ok"]
pipe = m.pipeline()
for n in ok: pipe.exists(f"cart:{tag}:{n}")
have = pipe.execute()
lost = [n for n, h in zip(ok, have) if not h]
print(f"{tag}: confirmed {len(ok)}, missing on the master now {len(lost)}" + (f" (writes {lost[0]}..{lost[-1]})" if lost else ""))
ثم نبني عميلاً فيه redis-py فقط، ونشغل كل شيء بعناوين ثابتة:
export MSYS_NO_PATHCONV=1
printf 'FROM python:3.13-slim\nRUN pip install --no-cache-dir "redis==6.4.0"\n' > Dockerfile.client
docker build -q -t wr-ha-rclient:1 -f Dockerfile.client .
docker network create --subnet 172.31.88.0/24 wr-ha-net
docker run -d --name wr-ha-v1 --network wr-ha-net --ip 172.31.88.11 valkey/valkey:9.1.2
for i in 2 3; do docker run -d --name wr-ha-v$i --network wr-ha-net --ip 172.31.88.1$i valkey/valkey:9.1.2 \
  valkey-server --replicaof 172.31.88.11 6379; done
for i in 1 2 3; do docker run -d --name wr-ha-s$i --network wr-ha-net --ip 172.31.88.2$i -v "$(pwd -W):/cfg:ro" \
  valkey/valkey:9.1.2 sh -c 'cp /cfg/sentinel.conf /data/sentinel.conf && exec valkey-sentinel /data/sentinel.conf'; done
docker run -d --name wr-ha-client --network wr-ha-net --ip 172.31.88.30 -v "$(pwd -W):/lab" -w /lab wr-ha-rclient:1 sleep infinity
docker exec wr-ha-v1 valkey-cli INFO replication | head -5
docker exec wr-ha-s1 valkey-cli -p 26379 SENTINEL ckquorum shop
# Replication
role:master
connected_slaves:2
slave0:ip=172.31.88.12,port=6379,state=online,offset=2625,lag=1,type=replica
slave1:ip=172.31.88.13,port=6379,state=online,offset=2625,lag=1,type=replica
OK 3 usable Sentinels. Quorum and failover authorization can be reachedوالسطر الأخير مهم، فالأمر SENTINEL ckquorum يتحقق من أن عدد Sentinels الموجودة يكفي للنصاب وللأغلبية معاً، وهو أول أمر تشغله بعد أي تغيير في الإعداد، وتستطيع أن تضعه في المراقبة.
نقتل الرئيسي: عميل يعرف Sentinel مقابل عميل بعنوان ثابت
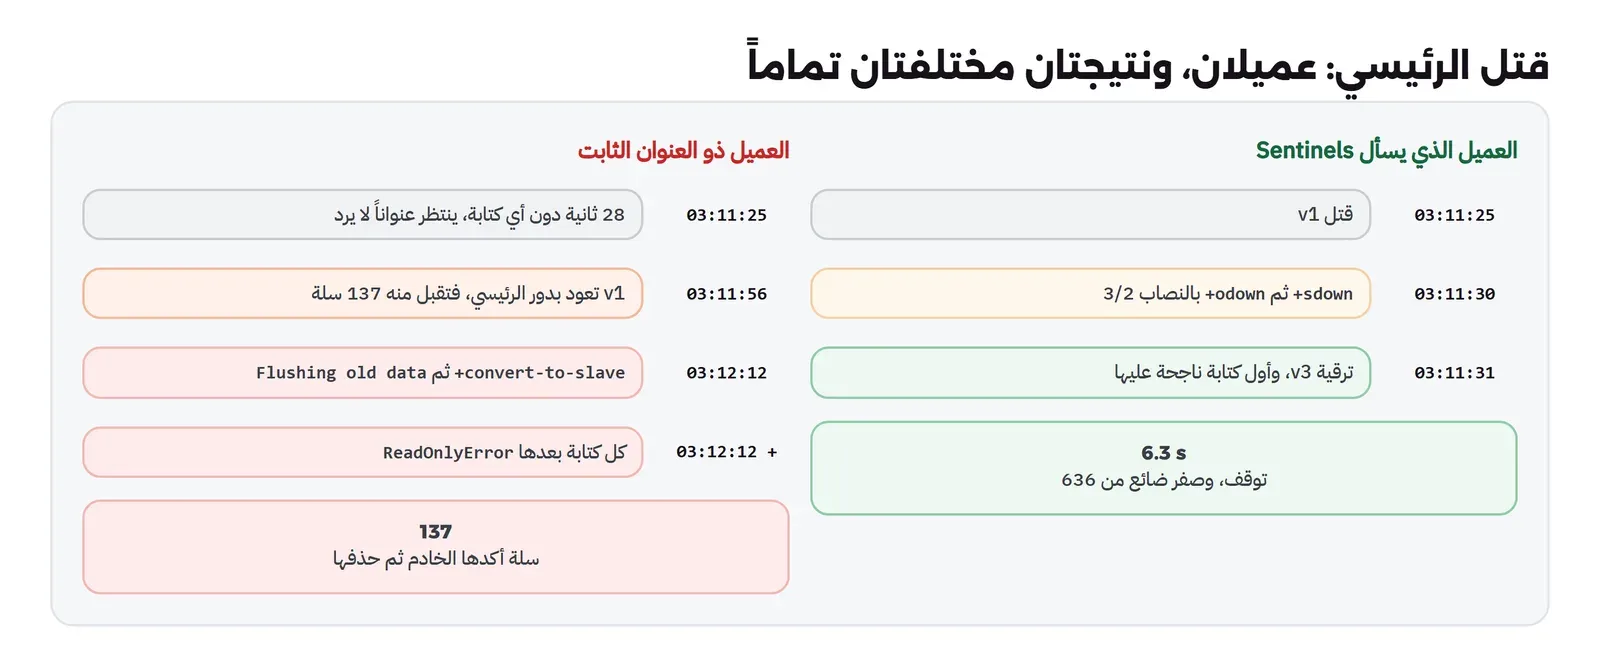
نشغل العميلين معاً 70 ثانية، الأول عبر Sentinels، والثاني على عنوان v1 الثابت كما يفعل تطبيق كتب أحدهم عنوان Valkey في ملف .env، ثم نقتل v1 بعد 10 ثوان، ونعيد تشغيله بعد 30 ثانية كما يحدث عندما يعود سيرفر بعد إعادة تشغيل:
docker exec -d -e SECONDS=70 -e TAG=s wr-ha-client python writer.py out/r1-sentinel.json
docker exec -d -e SECONDS=70 -e TAG=d -e MODE=direct -e HOST=172.31.88.11 wr-ha-client python writer.py out/r1-direct.json
sleep 10; docker kill wr-ha-v1
sleep 30; docker start wr-ha-v1
sleep 35; docker logs wr-ha-s1 2>&1 | grep -E "sdown|odown|switch-master"
وسجل Sentinel الأولى مع سجلات الأخريين، ثم نتيجة العميلين:
03:11:25.056 kill v1
03:11:30.568 # +sdown master shop 172.31.88.11 6379
03:11:30.675 # +odown master shop 172.31.88.11 6379 #quorum 3/2
03:11:30.707 # +elected-leader master shop 172.31.88.11 6379
03:11:30.808 # +selected-slave slave 172.31.88.13:6379 172.31.88.13 6379 @ shop 172.31.88.11 6379
03:11:31.662 # +promoted-slave slave 172.31.88.13:6379 172.31.88.13 6379 @ shop 172.31.88.11 6379
03:11:31.733 # +switch-master shop 172.31.88.11 6379 172.31.88.13 6379

== r1-sentinel
attempts 645 confirmed 636 failed 9
outage 03:11:25 -> 03:11:31 6.3 s {'ConnectionError': 1, 'TimeoutError': 6, 'MasterNotFoundError': 2}
s: confirmed 636, missing on the master now 0
== r1-direct
attempts 373 confirmed 240 failed 133
outage 03:11:25 -> 03:11:53 28.2 s {'TimeoutError': 2}
outage 03:12:12 -> 03:12:26 14.0 s {'ReadOnlyError': 131}
d: confirmed 240, missing on the master now 137 (writes 106..242)
العميل الذي يسأل Sentinels رأى ما يجب أن يراه: توقف 6.3 ثانية، منها 5 ثوان هي down-after-milliseconds، وأقل من ثانية للاتفاق والانتخاب والترقية، ولم تضع أي سلة من 636. ولاحظ الخطأين MasterNotFoundError، وهما لحظتان سأل فيهما العميل Sentinels أثناء الانتقال فلم يكن لديها رئيسي تعطيه، فأعاد السؤال بعد 100 ملي ثانية.
وهذا السلوك هو ما يجب أن يفعله تطبيقك أيضاً، ولكن بحذر: المكتبة لا تعيد كتابة الأمر الذي فشل من تلقاء نفسها في أغلب الحالات، لأنها لا تعرف هل وصل الأمر إلى الرئيسي قبل أن ينقطع الاتصال أم لا، فإذا كان الأمر SET لسلة فإعادته آمنة، أما إذا كان INCR لعداد المخزون فإعادته قد تنقص الكمية مرتين. لذلك قسم أوامرك إلى نوعين: أوامر تعطي النتيجة نفسها إذا تكررت، فأعدها مرة أو مرتين بعد تأخير قصير، وأوامر لا تحتمل التكرار، فاجعلها تحمل مفتاحاً يمنع التكرار، أو أعد الخطأ للمستخدم بدلاً من إعادتها. والتوقف الذي رأيته، حوالي ست ثوان، يعني أن المستخدم الذي ضغط زر الإضافة في هذه اللحظة يجب أن يرى رسالة تقول له أن يحاول بعد قليل، وليس صفحة خطأ عامة.
أما العميل بالعنوان الثابت فقصته مختلفة تماماً، وفيها ثلاث مراحل. في الأولى، من القتل حتى 03:11:53، فشلت محاولتان فقط بمهلة، لأن كل محاولة كانت تنتظر الاتصال بعنوان لم يعد موجوداً، أي أنه لم يكتب شيئاً 28 ثانية. وفي الثالثة، من 03:12:12 حتى النهاية، كل محاولة فشلت بالخطأ ReadOnlyError، لأن v1 أصبحت نسخة. والمرحلة الثانية بينهما هي الأخطر، وهي موضوع القسم التالي.
مشكلة واجهتنا: الرئيسي القديم يعود رئيسياً 15 ثانية Zombie Primary
بين 03:11:53 و03:12:12 نجح العميل ذو العنوان الثابت في كتابة 137 سلة، كلها أكدها الخادم، وكلها غير موجودة الآن على الرئيسي. وعندما قرأنا سجل v1 وسجلات Sentinels معاً ظهر ما حدث:
7:M 05 Nov 2026 03:11:56.720 * Ready to accept connections tcp
7:X 05 Nov 2026 03:12:12.021 * +convert-to-slave slave 172.31.88.11:6379 172.31.88.11 6379 @ shop 172.31.88.13 6379
7:S 05 Nov 2026 03:12:12.021 * REPLICAOF 172.31.88.13:6379 enabled (user request from 'id=4 addr=172.31.88.23:51986 ...
7:S 05 Nov 2026 03:12:17.719 * Full resync from primary: f2c9beb7218b37822f0a0e237843dafb118ca9fd:52546
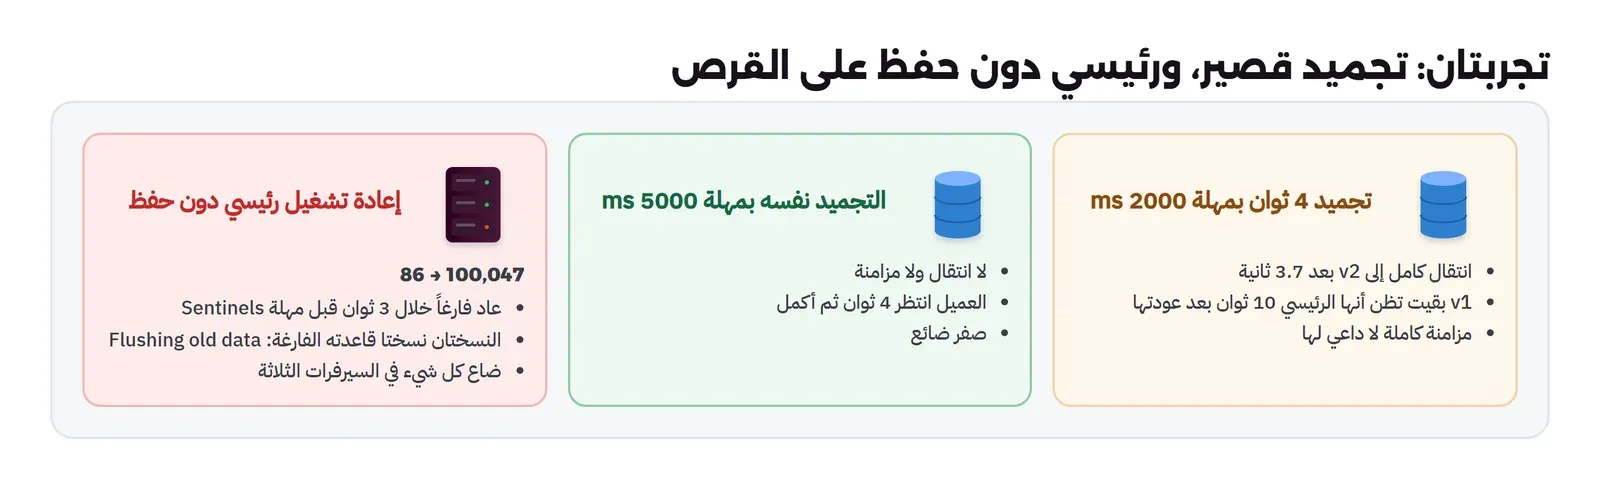
7:S 05 Nov 2026 03:12:17.907 * RDB signature and version check passed. Flushing old data
7:S 05 Nov 2026 03:12:17.910 * Done loading RDB, keys loaded: 666, keys expired: 0, ...
الحرف M في السطر الأول يعني أن v1 قلعت بدور الرئيسي Primary، لأن إعداد ال Container نفسه لا يقول إنها نسخة، فهي لا تعرف أن انتقالاً حدث أثناء غيابها. وبقيت رئيسياً يقبل الكتابة 15.3 ثانية، حتى رأتها إحدى Sentinels وأرسلت إليها REPLICAOF بالسطر +convert-to-slave، ثم طلبت نسخة كاملة من الرئيسي الجديد، والسطر Flushing old data هو اللحظة التي حذفت فيها السلال الـ 137. والسبب في الانتظار أن Sentinel تفحص أدوار السيرفرات بالأمر INFO كل عشر ثوان افتراضياً، فتحتاج حتى دورة كاملة لترى أن سيرفراً عاد بدور خاطئ.
والعميل الذي يسأل Sentinels لم يتأثر إطلاقاً، لأنه لم يعرف عنوان v1 أصلاً بعد الانتقال، أما العميل ذو العنوان الثابت فوجد السيرفر الذي يعرفه يرد ويقبل الكتابة، فظن أن كل شيء بخير. والدرس أن العنوان الثابت ليس مجرد إعداد غير مرن، وإنما طريق مباشر لخسارة بيانات مؤكدة، لذلك لا يتصل أي تطبيق بـ Valkey إلا عبر Sentinels أو عبر طبقة تسألها. وفي الإنتاج أضف أيضاً إلى إعداد كل سيرفر السطر replicaof الذي يشير إلى الرئيسي الحالي بعد كل انتقال، أو اجعل أداة إدارة الإعداد تكتبه، حتى لا يقلع سيرفر عائد كرئيسي، وإذا كان حفظ البيانات على القرص مفعلاً فلا تحذف ملفاته في هذه الحالة، فلن تفيدك، لأن المزامنة الكاملة سوف تستبدلها.
عزل الرئيسي مع عميل بجانبه Network Partition
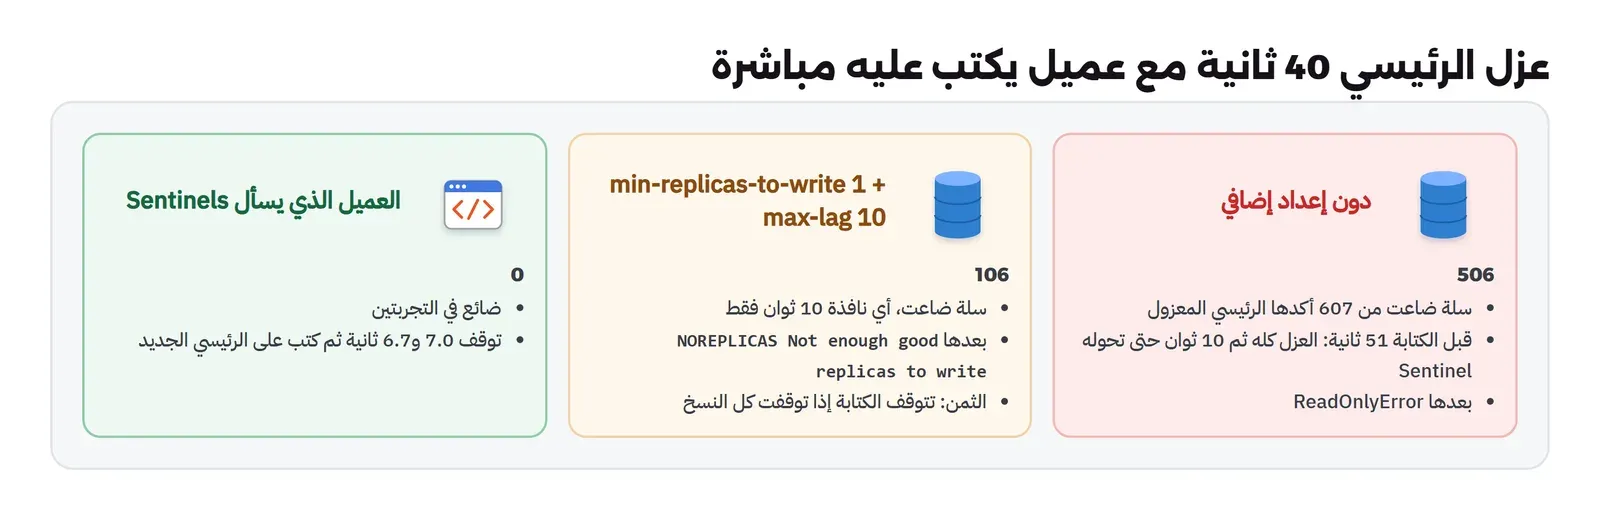
الآن الحالة التي يصفها التوثيق: الرئيسي الحالي v3 يعمل، ولكنه انعزل عن Sentinels وعن النسخ، وعميل بجانبه ما زال يصل إليه، كأن يكون سيرفر تطبيق في الشبكة نفسها معه. أنشأنا شبكة جانبية wr-ha-side، ووصلنا بها v3 وعميلاً ثانياً يكتب على عنوان v3 في هذه الشبكة، ثم فصلنا v3 عن الشبكة الرئيسية 40 ثانية:
docker network create --subnet 172.31.89.0/24 wr-ha-side
docker network connect --ip 172.31.89.13 wr-ha-side wr-ha-v3
docker run -d --name wr-ha-side --network wr-ha-side --ip 172.31.89.30 -v "$(pwd -W):/lab" -w /lab wr-ha-rclient:1 sleep infinity
docker exec -d -e SECONDS=80 -e TAG=m wr-ha-client python writer.py out/r2-main.json
docker exec -d -e SECONDS=80 -e TAG=x -e MODE=direct -e HOST=172.31.89.13 wr-ha-side python writer.py out/r2-side.json
sleep 10; docker network disconnect wr-ha-net wr-ha-v3
sleep 40; docker network connect --ip 172.31.88.13 wr-ha-net wr-ha-v3
03:13:39.412 cut v3 (master) from the main network
03:13:45.784 # +switch-master shop 172.31.88.13 6379 172.31.88.12 6379
03:14:20 reconnect
03:14:30.376 * +convert-to-slave slave 172.31.88.13:6379 172.31.88.13 6379 @ shop 172.31.88.12 6379
== r2-main
attempts 736 confirmed 729 failed 7
outage 03:13:39 -> 03:13:46 UTC 7.0 s {'TimeoutError': 7}
m: confirmed 729, missing on the master now 0
== r2-side
attempts 799 confirmed 607 failed 192
outage 03:14:30 -> 03:14:50 UTC 20.1 s {'ReadOnlyError': 192}
x: confirmed 607, missing on the master now 506 (writes 102..607)العميل الرئيسي توقف 7 ثوان ثم كتب على v2 الرئيسي الجديد، ولم يضع منه شيء. أما العميل الجانبي فلم ير أي خطأ لمدة 51 ثانية، من لحظة العزل حتى حولت Sentinel السيرفر v3 إلى نسخة بعد عودة الشبكة بعشر ثوان، وكل ما كتبه في هذه المدة ضاع: 506 سلال، من الكتابة رقم 102، أي أول كتابة بعد العزل، حتى الأخيرة. والكتابات من 1 إلى 101 بقيت لأنها كانت قبل العزل ووصلت إلى النسخ. ولاحظ أن Sentinels تصرفت بشكل صحيح تماماً في هذه التجربة: لم يحدث رئيسيان من وجهة نظرها، والعميل الذي يسألها لم يخسر شيئاً، ولكن العميل الجانبي كان يتكلم مع رئيسي لا يعرف أنه لم يعد رئيسياً.
ماذا لو اشترطنا نسخة واحدة على الأقل؟ min-replicas What If
الآن نكرر العزل نفسه على الرئيسي الحالي v2، بعد أن نطلب من كل السيرفرات ألا تقبل الكتابة إذا لم تكن متصلة بنسخة واحدة على الأقل، تأخرت أقل من 10 ثوان:
for i in 1 2 3; do docker exec wr-ha-v$i valkey-cli CONFIG SET min-replicas-to-write 1
  docker exec wr-ha-v$i valkey-cli CONFIG SET min-replicas-max-lag 10; done
docker exec wr-ha-v2 valkey-cli INFO replication | grep -E "role|connected_slaves|min_slaves"
role:master
connected_slaves:2
min_slaves_good_slaves:2والسطر الأخير يقول إن الرئيسي يرى نسختين جيدتين الآن، أي متصلتين وتأخرهما أقل من الحد. ونكرر الشبكة الجانبية والعميلين والعزل 40 ثانية كما قبلها، والمخرج سوف يكون كما يلي:
03:15:40.690 cut v2 (master) from the main network
== r3-main
attempts 745  confirmed 732  failed 13
outage 03:15:40 -> 03:15:47 UTC   6.7 s  {'TimeoutError': 6, 'MasterNotFoundError': 7}
m3: confirmed 732, missing on the master now 0
== r3-side
attempts 799  confirmed 207  failed 592
outage 03:15:51 -> 03:16:51 UTC  60.2 s  {'ResponseError': 402, 'ReadOnlyError': 190}
x3: confirmed 207, missing on the master now 106 (writes 102..207)
العميل الجانبي هنا كتب بنجاح حوالي 10 ثوان بعد العزل فقط، من 03:15:40 حتى 03:15:51، ثم بدأ يستلم خطأ ResponseError، وهو رد الرئيسي NOREPLICAS Not enough good replicas to write، لأن آخر تأكيد من نسخه أصبح أقدم من 10 ثوان، فتوقف عن قبول الكتابة وهو ما زال يظن أنه رئيسي. وضاعت 106 سلال بدلاً من 506، أي كل ما كتب في نافذة الثواني العشر. وبعد عودة الشبكة حولته Sentinel إلى نسخة، فأصبح الخطأ ReadOnlyError. والعميل الرئيسي لم يتأثر بهذا الإعداد، فتوقفه 6.7 ثانية مثل المرة السابقة.
وهذا الإعداد لا يغلق النافذة، وإنما يحدد طولها، فالخسارة القصوى أصبحت min-replicas-max-lag بدلاً من مدة الانقسام كلها. ولكن له ثمن يجب أن تعرفه: إذا توقفت كل النسخ لأي سبب، حتى لو كان الرئيسي سليماً والشبكة سليمة، يتوقف الرئيسي عن قبول الكتابة، أي أنك تبادل التوفر بالبيانات، وهذا القرار يعتمد على نوع ما تحفظه، كما سوف نشرح بعد قليل. ولاحظ أيضاً أننا وضعنا الإعداد بالأمر CONFIG SET على كل السيرفرات وليس على الرئيسي وحده، لأن أي واحد منها قد يصبح رئيسياً بعد الانتقال، وفي الإنتاج ضعه في ملف الإعداد حتى يبقى بعد إعادة التشغيل.
توقف قصير وليس عطلاً: docker pause What If
الأعطال السابقة كانت حقيقية، فالرئيسي مات أو انعزل. ولكن ماذا عن الرئيسي الذي يتوقف عن الرد ثوان قليلة ثم يعود، كما يحدث عند حفظ نسخة RDB كبيرة على قرص بطيء، أو عند أمر ثقيل؟ لكي نصنع ذلك أعدنا بناء المختبر نفسه، وملأنا الرئيسي بمئة ألف مفتاح، ثم أوقفنا عملية v1 أربع ثوان بالأمر docker pause، الذي يجمد كل عمليات ال Container دون أن يقطع الشبكة، مرة بمهلة down-after-milliseconds ثانيتين، ومرة بخمس ثوان. ونغير المهلة في Sentinels أثناء العمل بالأمر SENTINEL SET:
for i in 1 2 3; do docker exec wr-ha-s$i valkey-cli -p 26379 SENTINEL SET shop down-after-milliseconds 2000; done
docker exec -d -e SECONDS=40 -e TAG=q wr-ha-client python writer.py out/q2000.json
sleep 10; docker pause wr-ha-v1; sleep 4; docker unpause wr-ha-v1
03:28:16.644 pause v1 4 s
03:28:19.053 # +sdown master shop 172.31.88.11 6379
03:28:19.797 # +odown master shop 172.31.88.11 6379 #quorum 3/2
03:28:20.343 # +switch-master shop 172.31.88.11 6379 172.31.88.12 6379
03:28:21.308 unpause
03:28:31.240 * +convert-to-slave slave 172.31.88.11:6379 172.31.88.11 6379 @ shop 172.31.88.12 6379
outage 03:28:16 -> 03:28:20 UTC 3.4 s {'TimeoutError': 3, 'MasterNotFoundError': 4}
q: confirmed 365, missing on the master now 0بمهلة ثانيتين حدث انتقال كامل بسبب توقف مدته أربع ثوان فقط، فرقيت v2، ثم عادت v1 بعد ثانية من الترقية وبقيت تظن أنها الرئيسي عشر ثوان حتى حولتها Sentinel إلى نسخة، ثم طلبت مزامنة كاملة. والعميل الذي يسأل Sentinels لم يخسر شيئاً هنا، لأنه انتقل إلى v2 فوراً، ولكن أي عميل بعنوان ثابت أو أي اتصال بقي مفتوحاً مع v1 كان سوف يكتب في هذه الثواني العشر ما رأيته يضيع في تجربة الرئيسي العائد. ثم أعدنا المهلة إلى خمس ثوان، وكررنا التجميد نفسه على الرئيسي الجديد:
03:29:32.634 pause wr-ha-v2 4 s
outage 03:29:33 -> 03:29:37 UTC   4.0 s  {'TimeoutError': 4}
q5: confirmed 357, missing on the master now 0
(no lines above = no failover)
هذه المرة لم يحدث أي انتقال، فلم تظهر في سجلات Sentinels أي من الأسطر +sdown أو +switch-master، والعميل انتظر 4 ثوان ثم أكمل على الرئيسي نفسه، ولم تحتج أي نسخة إلى مزامنة. والمقارنة بين التجربتين هي القرار كله: المهلة القصيرة وفرت 0.6 ثانية من التوقف، وثمنها انتقال كامل ومزامنة كاملة ونافذة عشر ثوان يقبل فيها سيرفر قديم الكتابة، أما المهلة الأطول فحولت التجميد إلى انتظار عادي.
ماذا لو أعيد تشغيل الرئيسي دون حفظ على القرص؟ What If
آخر تجربة هي الأخطر في المقال، وهي من النوع الذي لا يتوقعه أحد لأن كل جزء فيه يبدو سليماً. كثير من الفرق تطفئ الحفظ على القرص في الرئيسي لتسرعه، على أساس أن النسخ تحمل البيانات، وتشغل Valkey بسياسة إعادة تشغيل تلقائية كما فعلنا في مقال تكلفة التوقف. ويحذر توثيق النسخ من هذا الجمع بالتحديد في قسم أمان النسخ عندما يكون الحفظ مطفأً في الرئيسي، فجربناه: أطفأنا الحفظ على الرئيسي، والبيانات فيه أكثر من مئة ألف مفتاح موجودة في النسختين أيضاً، ثم أعدنا تشغيله:
docker exec wr-ha-v1 valkey-cli CONFIG SET save ""
for i in 1 2 3; do echo "v$i before: $(docker exec wr-ha-v$i valkey-cli DBSIZE)"; done
docker restart -t 1 wr-ha-v1; sleep 8
for i in 1 2 3; do echo "v$i after: $(docker exec wr-ha-v$i valkey-cli DBSIZE) $(docker exec wr-ha-v$i valkey-cli INFO replication | grep -m1 role)"; done
v1 before: 100047
v2 before: 100054
v3 before: 100057
03:26:58.794 restart v1 (no persistence)
03:27:04.001 v1 back
v1 after: 86 role:master
v2 after: 97 role:slave
v3 after: 107 role:slave
6:S 05 Nov 2026 03:27:09.422 * RDB signature and version check passed. Flushing old data
6:S 05 Nov 2026 03:27:09.423 * Done loading RDB, keys loaded: 48, keys expired: 0, all fields expired hashes: 0.
outage 03:27:01 -> 03:27:04 UTC 2.7 s {'ConnectionError': 9, 'TimeoutError': 1}
p: confirmed 271, missing on the master now 85 (writes 1..85)ضاعت البيانات كلها، في السيرفرات الثلاثة، في أقل من عشر ثوان. والتسلسل كما يلي: v1 عادت خلال حوالي ثلاث ثوان، وهذا أقل من مهلة Sentinels الخمس، فلم ترها Sentinels متوقفة أصلاً، ولم يحدث أي انتقال، ولكنها عادت فارغة لأنه لا يوجد ملف على القرص تحمله. ثم اتصلت بها النسختان كما تفعلان مع أي رئيسي عاد، فطلبتا مزامنة، فأرسلت إليهما ما عندها، أي قاعدة شبه فارغة، فكتبت كل نسخة في سجلها Flushing old data وحذفت مئة ألف مفتاح، ثم حملت 48 مفتاحاً فقط هي ما كتبه العميل في الثواني الأولى بعد العودة. وحتى سلال العميل نفسه التي كتبها قبل إعادة التشغيل، من 1 إلى 85، ضاعت. والتوفر العالي هنا لم يحم البيانات، وإنما كان هو الطريق الذي وصل به الحذف إلى النسخ.
والحلول في التوثيق واضحة: إما أن يكون الحفظ على القرص مفعلاً في الرئيسي، بملف RDB أو AOF كما شرحنا الفرق بينهما في دليل Redis وValkey، وإما ألا يعيد أي شيء تشغيل الرئيسي تلقائياً إذا كان الحفظ مطفأً، فيبقى متوقفاً مدة أطول من المهلة، فترقي Sentinels نسخة تحمل البيانات. والأول هو الأبسط والأضمن، والسرعة التي تكسبها بإطفاء الحفظ نادراً ما تستحق هذا الخطر.
ولاحظ أن الشرط يجب أن يكون على كل السيرفرات وليس على الرئيسي الحالي وحده، فالنسخة التي ترقيها Sentinels غداً تصبح هي الرئيسي، فإذا كان الحفظ مطفأً فيها، فقد عادت المشكلة نفسها بعد أول انتقال. وهذا مثال على قاعدة تتكرر في كل مقالات هذه المرحلة: إعداد العنقود يجب أن يكون متطابقاً في كل الأعضاء، لأن الدور يتنقل بينها، وما تضبطه على الرئيسي وحده يختفي مع أول انتقال.
حذف المختبر Cleanup
docker rm -f -v wr-ha-v1 wr-ha-v2 wr-ha-v3 wr-ha-s1 wr-ha-s2 wr-ha-s3 wr-ha-client wr-ha-side
docker network rm wr-ha-net wr-ha-side
docker rmi wr-ha-rclient:1 valkey/valkey:9.1.2
والخيار -v في الأمر الأول يحذف أيضاً ال Volumes المجهولة التي أنشأتها ال Image لمجلد /data، والتي لا تحذف مع ال Container دونه، فإذا نسيته بقيت على القرص Volumes بلا أسماء لا تعرف بعد أسبوع لمن هي، وهذا ما يحدث كثيراً على سيرفرات الاختبار التي تمتلئ أقراصها دون سبب واضح.
أين تضع Sentinels؟ Placement
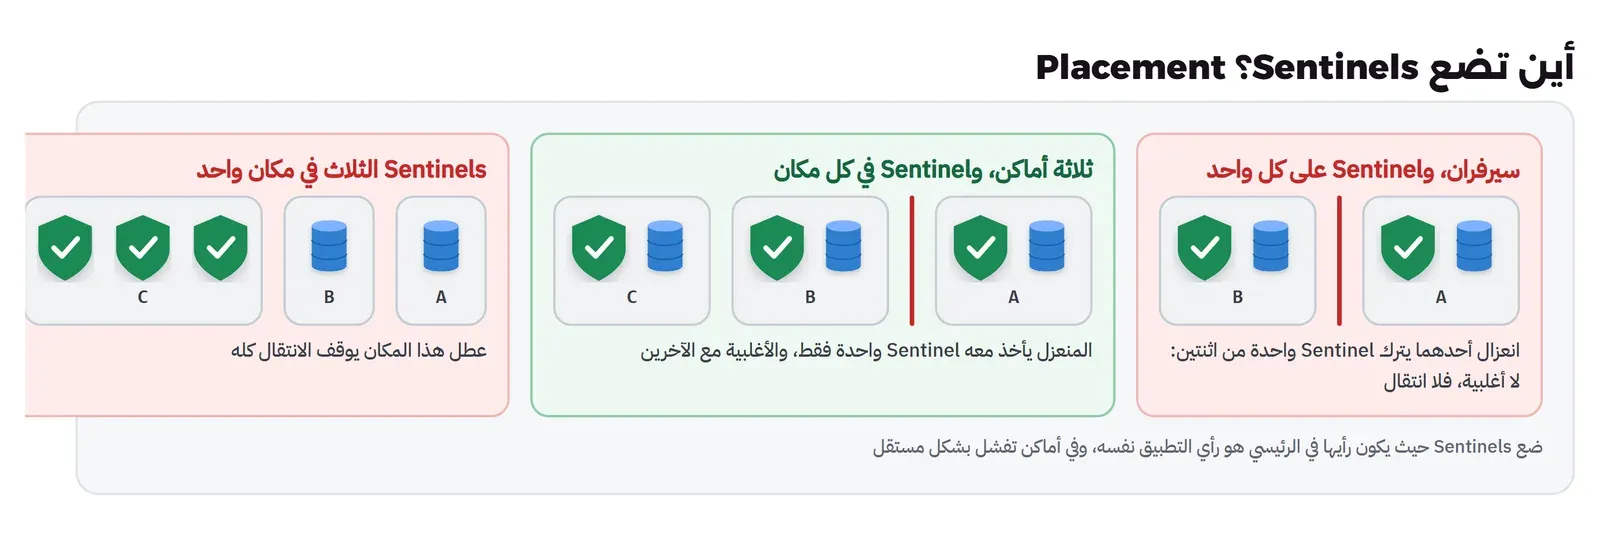
كل ما سبق يفترض أن Sentinels الثلاث تفشل بشكل مستقل، وأن الأغلبية منها في الجهة الصحيحة من أي انقسام، وهذا يعتمد على أين تضعها، وليس على إعدادها. ويناقش التوثيق عدة أشكال، وهذه الخلاصة العملية منها:
- Sentinel على كل سيرفر Valkey: الشكل الأشهر لثلاثة سيرفرات، وهو جيد إذا كانت السيرفرات الثلاثة في ثلاثة أماكن مستقلة، والسبب أن السيرفر الذي ينعزل يأخذ معه Sentinel واحدة فقط، فتبقى الأغلبية مع الآخرين.
- سيرفران فقط مع Sentinel على كل واحد: لا ينفع، لأن انعزال أحدهما يترك Sentinel واحدة من اثنتين، فلا أغلبية، فلا انتقال، والتوثيق يحذر من هذا الشكل صراحة. والحل Sentinel ثالثة على سيرفر آخر، ولو كان سيرفر التطبيق.
- Sentinels على سيرفرات التطبيق: شكل جيد عندما تكون سيرفرات التطبيق ثلاثة أو أكثر، لأن Sentinels ترى Valkey من المكان نفسه الذي يراه منه التطبيق، فإذا انعزل الرئيسي عن التطبيق فهو منعزل فعلاً.
- Sentinels الثلاث في مكان واحد: أسوأ شكل، لأن عطل هذا المكان يوقف الانتقال كله، ولأن انعزال هذا المكان عن الرئيسي يسبب انتقالاً بينما التطبيق ما زال يصل إلى الرئيسي.
والقاعدة البسيطة: ضع Sentinels حيث يكون رأيها في الرئيسي هو رأي التطبيق نفسه، وفي ثلاثة أماكن تفشل بشكل مستقل، وشغل SENTINEL ckquorum في المراقبة حتى تعرف فوراً إذا نقص عددها.
وفي السحابة يترجم هذا إلى مناطق التوفر Availability Zones: الرئيسي في منطقة، وكل نسخة في منطقة أخرى، وSentinel في كل منطقة مع سيرفرات التطبيق فيها. ولكن انتبه إلى أن التطبيق في منطقة الرئيسي يصل إليه أسرع من غيره، وأن انعزال هذه المنطقة هو بالضبط حالة العميل الجانبي في المختبر، فالتطبيق فيها يكتب على رئيسي فقد بقية العنقود، وهذا سبب إضافي لتفعيل min-replicas-to-write إذا كانت البيانات مهمة.
ضبط المهلة down-after-milliseconds Tuning
في المختبر كان التوقف من جهة العميل حوالي 6.5 إلى 7 ثوان، وأغلبه الثواني الخمس في down-after-milliseconds، والقيمة في ملفات المثال في التوثيق 30 ثانية أو 60 ثانية، فإذا أخذت الإعداد كما هو فتوقفك في كل انتقال قد يصل إلى دقيقة. وقد يتساءل البعض: لماذا لا نجعلها ثانية واحدة؟ والإجابة أن الرئيسي قد يتوقف عن الرد ثانية أو ثانيتين لأسباب عادية، مثل حفظ نسخة RDB كبيرة على قرص بطيء، أو أمر ثقيل مثل KEYS على قاعدة كبيرة، والانتقال في هذه الحالة يقطع كل الاتصالات، ويطلب من كل النسخ مزامنة جديدة، وقد يضيع كتابات الثانية الأخيرة، أي أنه أسوأ من الانتظار. لذلك اختر قيمة أكبر من أطول توقف عادي تراه في الرئيسي، وقسه من سجل الأوامر البطيئة SLOWLOG ومن مدة حفظ RDB في INFO persistence.
وهناك إعدادان آخران يستحقان الانتباه. الأول parallel-syncs، وهو عدد النسخ التي تبدأ المزامنة مع الرئيسي الجديد في الوقت نفسه بعد الانتقال، وقيمته 1 حتى لا تتوقف كل النسخ عن خدمة القراءة معاً أثناء المزامنة. والثاني replica-priority في كل سيرفر Valkey، فالنسخة ذات الرقم الأقل تفضل في الترقية، والقيمة 0 تعني ألا ترقى أبداً، وهي مفيدة لنسخة في مكان بعيد تستخدمها للنسخ الاحتياطي فقط. وإذا احتجت أن تتأكد أن كتابة معينة وصلت إلى نسخة قبل أن ترد على العميل، فهناك الأمر WAIT الذي ينتظر تأكيد عدد من النسخ، ولكنه لا يجعل النظام متزامناً، فالكتابة نفذت على الرئيسي قبله، ويفيد فقط في الكتابات القليلة المهمة مثل تأكيد الطلب.
ماذا تراقب في Sentinel؟ Monitoring
الانتقال التلقائي الذي لا تعرف أنه حدث مشكلة في حد ذاته، فكل انتقال يعني أن شيئاً توقف، وقد يتكرر كل ليلة بسبب مهلة قصيرة دون أن ينتبه أحد، حتى يأتي يوم يضيع فيه شيء مهم. لذلك راقب أربعة أشياء على الأقل. الأول عدد Sentinels والنصاب، بالأمر SENTINEL ckquorum الذي رأيته في المختبر، والتنبيه عندما لا يرد بـ OK. والثاني كل تغيير في عنوان الرئيسي، وتستطيع أن تلتقطه من سطر +switch-master في السجل، أو من قناة النشر التي تنشر عليها Sentinels أحداثها، أو بسكربت تنبيه تضعه في الإعداد sentinel notification-script، بحيث يصل إلى المناوب سبب الانتقال وليس فقط أنه حدث. والثالث تأخر النسخ عن الرئيسي، من الحقلين lag وoffset في INFO replication، لأن النسخة المتأخرة هي ما يضيع عند الانتقال. والرابع دخول أي Sentinel في وضع TILT، لأنه يعني أن مؤقتها تأخر عن موعده، أي أن السيرفر الذي تعمل عليه مزدحم، وSentinel في هذا الوضع لا تشارك في أي قرار. وأضف إليها مؤشراً خامساً بعد تجربة الحفظ: هل الحفظ على القرص مفعل في كل سيرفر قد يصبح رئيسياً، ومتى كان آخر حفظ ناجح، من الحقل rdb_last_bgsave_status في INFO persistence.
ذاكرة مؤقتة أم مخزن بيانات؟ Cache or Store
كل الأرقام السابقة تعني شيئاً مختلفاً بحسب ما تحفظه في Valkey، والقرار الأهم ليس في الإعدادات، وإنما في هذا السؤال. فإذا كان Valkey ذاكرة مؤقتة أمام قاعدة البيانات، فالسلة الضائعة ليست ضائعة فعلاً، لأن الأصل في قاعدة البيانات، والتطبيق سوف يعيد ملء الذاكرة، وفي هذه الحالة يقول التوثيق نفسه إن قبول الكتابة على الرئيسي القديم قد يكون مفيداً، فلا تفعل min-replicas-to-write، لأن التوفر أهم من بيانات يمكن إعادة حسابها. أما إذا كانت السلال والجلسات موجودة في Valkey وحده، كما في المتجر الذي نتابعه، فالسلة الضائعة عميل غاضب، وفي هذه الحالة فعل الإعداد، وتقبل أن الكتابة تتوقف إذا توقفت كل النسخ. وإذا كانت البيانات لا تحتمل أي خسارة إطلاقاً، مثل الأرصدة والطلبات المدفوعة، فمكانها قاعدة بيانات بنسخ متزامن كما رأيت في مقال Patroni، وليس Valkey مهما كان إعداده.
والسؤال الأخير الذي يأتي بعد هذا: هل أحتاج Valkey Cluster بدلاً من Sentinel؟ والإجابة في الغالب لا، فقد شرحنا في دليل العناقيد أن Cluster لتوزيع البيانات على عدة سيرفرات عندما لا تكفيها ذاكرة سيرفر واحد، وأنه يأتي بقيود على الأوامر متعددة المفاتيح، وأن النسخ فيه غير متزامن أيضاً، فلا يحل مشكلة الخسارة التي رأيتها هنا. فإذا كانت بياناتك تتسع في ذاكرة سيرفر واحد، فرئيسي مع نسختين وثلاث Sentinels هو الأبسط والأوضح.
وبين الطرفين حالة شائعة هي الجلسات Sessions، فالجلسة الضائعة لا تضيع مالاً، ولكنها تخرج المستخدم من حسابه في منتصف عملية الشراء، وقد تفرغ سلته إذا كانت مربوطة بالجلسة. وفي هذه الحالة احسب الأمر كما حسبنا في مقال تكلفة التوقف: كم مستخدماً يكون في منتصف عملية في أي لحظة، وكم مرة في السنة تتوقع انتقالاً بسبب عطل حقيقي، وكم منهم سوف يعود ويكمل. وغالباً تجد أن سقف خسارة بعشر ثوان مع min-replicas-to-write مقبول تماماً، وأن الثمن الحقيقي الذي يجب أن تمنعه هو حالات مثل الرئيسي العائد والرئيسي دون حفظ، التي تضيع دقائق كاملة أو كل شيء.
من سيرفر واحد إلى Sentinel دون توقف Migration
أغلب الفرق لا تبدأ بثلاث نسخ وثلاث Sentinels، وإنما بسيرفر Valkey واحد يعمل منذ سنة، والتطبيق يتصل بعنوانه مباشرة، وهذا بالضبط العميل ذو العنوان الثابت الذي رأيته يخسر 137 سلة. والانتقال من هذا الوضع إلى Sentinel يمكن أن يتم دون توقف، بشرط أن ترتب الخطوات بحيث يكون التطبيق آخر ما يتغير، ولكن قبل أن يحدث أول انتقال:
- أضف النسخ أولاً: شغل سيرفرين جديدين بالإعداد
replicaofإلى السيرفر الحالي، وتأكد منINFO replicationأن الاثنينstate=onlineوأنoffsetعندهما قريب من الرئيسي، والمزامنة الأولى ترسل نسخة كاملة، فاختر لها وقتاً هادئاً إذا كانت البيانات كبيرة. - فعل الحفظ على القرص في الثلاثة: قبل أي شيء آخر، بعد ما رأيته في تجربة إعادة التشغيل، وتأكد أن ملف الإعداد في كل سيرفر يحمل الإعدادات نفسها، بما فيها
min-replicas-to-writeإذا قررته. - شغل Sentinels: ثلاثاً في ثلاثة أماكن، وكلها تراقب السيرفر الحالي، ثم
SENTINEL ckquorum. وفي هذه المرحلة لا يحدث شيء للتطبيق، ولكن تذكر أن أي عطل الآن سوف يسبب انتقالاً، والتطبيق ما زال على العنوان الثابت، لذلك اجعل المدة بين هذه الخطوة والتالية قصيرة. - غير التطبيق: انشر إصداراً يستخدم مكتبة تسأل Sentinels، مع إعادة السؤال بعد كل خطأ، وتأكد من سجلات التطبيق أنه يجد الرئيسي عبرها.
- اختبر الانتقال مخططاً: بالأمر
SENTINEL failover shopالذي يجبر Sentinels على انتقال الآن دون أي عطل، في وقت هادئ، وراقب أخطاء التطبيق، ثم اختبره بعطل حقيقي في بيئة الاختبار كما فعلنا في المختبر.
ولاحظ أن الخطوة الأخيرة ليست اختيارية، فالانتقال الذي لم تجربه سوف يحدث أول مرة في ليلة لا تختارها، وهذا موضوع المقال القادم بالتفصيل.
أخطاء شائعة Common Mistakes
- عنوان الرئيسي في إعداد التطبيق: فيكتب التطبيق على الرئيسي القديم إذا عاد رئيسياً، وتضيع كتاباته عند المزامنة كما رأيت في 137 سلة.
- سيرفر عائد بإعداد يقول إنه رئيسي: فيقبل الكتابة ثوان حتى تحوله Sentinel، والحل أن يكتب الإعداد
replicaofالصحيح. - Sentinelان فقط: فلا أغلبية عند انعزال أحدهما، ولا انتقال.
- الخلط بين النصاب والأغلبية: فتظن أن نصاب 1 يسمح لـ Sentinel واحدة بالانتقال.
- أسماء متغيرة بدلاً من عناوين ثابتة: فتدخل Sentinels في وضع TILT وهي تحاول حل الأسماء ولا يحدث الانتقال.
min-replicas-to-writeعلى الرئيسي وحده: فيختفي الإعداد بعد أول انتقال، لأن الرئيسي الجديد لم يكن عليه.- ملف Sentinel للقراءة فقط: فلا تستطيع Sentinel أن تحفظ الرئيسي الجديد، وتعود بعد إعادة التشغيل إلى العنوان القديم.
- بيانات لا تحتمل الخسارة في Valkey: فالنسخ غير متزامن دائماً، ومكانها قاعدة بيانات بنسخ متزامن.
قائمة تحقق Checklist
| البند | كيف تتحقق منه |
|---|---|
| ثلاث Sentinels في ثلاثة أماكن مستقلة | SENTINEL ckquorum يرد بـ OK، في المراقبة |
| التطبيق يسأل Sentinels | لا يوجد عنوان Valkey ثابت في أي إعداد أو متغير بيئة |
| المكتبة تعيد السؤال بعد كل خطأ | اختبار قتل الرئيسي يظهر توقفاً بثوان down-after-milliseconds فقط |
| السيرفر العائد يقلع نسخة | replicaof في إعداده يشير إلى الرئيسي الحالي |
| سقف الخسارة مكتوب | min-replicas-to-write وmin-replicas-max-lag في ملفات كل السيرفرات، أو قرار مكتوب بعدم تفعيلهما |
| المهلة أكبر من أطول توقف عادي | مقارنة down-after-milliseconds بسجل SLOWLOG ومدة حفظ RDB |
| نسخة النسخ الاحتياطي لا ترقى | replica-priority 0 عليها |
| عناوين ثابتة لكل السيرفرات | لا يوجد TILT في سجلات Sentinels بعد الأعطال |
| ما لا يحتمل الخسارة ليس هنا | الأرصدة والطلبات المدفوعة في قاعدة بيانات بنسخ متزامن |
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- Sentinel تعلن التوقف بالنصاب، ولكنها تنتقل فقط بأغلبية Sentinels، والعميل يجب أن يسألها عن الرئيسي بعد كل خطأ.
- العميل الذي يسأل Sentinels توقف بين 6.3 و7 ثوان في كل الأعطال، ولم يخسر أي سلة في أي تجربة.
- العميل ذو العنوان الثابت كتب 137 سلة على رئيسي قديم عاد رئيسياً 15.3 ثانية، فحذفت كلها عند المزامنة الكاملة.
- الرئيسي المعزول مع عميل بجانبه قبل الكتابة 51 ثانية فضاعت 506 سلال، ومع
min-replicas-to-writeقبلها 10 ثوان فقط فضاعت 106. - الإعداد يحدد سقف الخسارة ولا يمنعها، وثمنه أن الكتابة تتوقف إذا توقفت كل النسخ، والقرار يعتمد على هل Valkey ذاكرة مؤقتة أم المخزن الوحيد.
- ضع Sentinels في ثلاثة أماكن ترى Valkey كما يراه التطبيق، واختر المهلة أكبر من أطول توقف عادي، فتجميد أربع ثوان بمهلة ثانيتين صنع انتقالاً كاملاً لا داعي له.
- الرئيسي دون حفظ على القرص مع إعادة تشغيل سريعة مسح أكثر من مئة ألف مفتاح من السيرفرات الثلاثة، فاجعل الحفظ مفعلاً في كل عضو.
وكل هذه الأرقام من مختبر صغير بعميل واحد يكتب كل 100 ملي ثانية، فكرر التجارب نفسها بضغط تطبيقك الحقيقي وبيانات بحجمها الحقيقي، لأن زمن المزامنة الكاملة ومدة حفظ RDB يكبران مع حجم البيانات، وهما ما يحدد طول النوافذ التي رأيتها.
وفي المقال القادم من مرحلة التوفر العالي بإذن الله نجمع ما بنيناه في هذه المقالات، ونتعلم كيف تختبر خطة التوفر العالي كلها بتمارين أعطال مخططة، قبل أن يختبرها عطل حقيقي في ليلة التخفيضات.
 دليلRedis وبديله المفتوح Valkey: التخزين المؤقت والجلساتكيف تستخدم Redis للجلسات والعدادات دون أن تمتلئ الذاكرة، وماذا تعني رخصته الجديدة، ومتى يكفيك Valkey بدلاً منه.
 دليلعناقيد قواعد البيانات Database Clustering ومتى تحتاجهاماذا تعني كلمة Cluster في كل قاعدة بيانات، ومتى تحتاج نسخاً أو انتقالاً تلقائياً، ومتى يكفيك سيرفر واحد مع نسخ احتياطية جيدة.
 دليلانتقال تلقائي Failover لقاعدة PostgreSQL مع Patroniبنينا عنقود PostgreSQL من ثلاث نسخ يديره Patroni، ثم قتلنا الرئيسي وعزلناه عن الشبكة وقسنا كم ثانية توقفت الكتابة وكم طلباً مؤكداً ضاع.
 دليلعنقود MariaDB Galera بثلاث عقد: النصاب Quorum عملياًبنينا عنقود MariaDB Galera من ثلاث عقد، وقسنا القراءة بعد الكتابة والتعارض على الصنف نفسه، ثم عزلنا العقد وقطعنا الكهرباء عنها لنرى من يستمر ومتى تحتاج تدخلاً يدوياً.
 دليلمفاهيم التوفر العالي High Availability للمبتدئينماذا يعني أن تبقى خدمتك تعمل رغم تعطل جزء منها، وكيف تحسب التوفر وتجد نقاط الفشل الواحدة وتقرر متى يستحق ذلك تكلفته.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة الدليل وتنفيذ المختبر على Valkey 9.1.2 مع Sentinel وredis-py 6.4.0 على Python 3.13 وDocker Engine 29.8.0.


