


بعد سنة من قرار الاكتفاء بسيرفر واحد مصنوع جيداً، وقع المتجر اتفاقية مع شريك يبيع منتجاته عبر واجهته البرمجية، وفي الاتفاقية بند تعويض إذا توقفت الواجهة أكثر من دقائق محدودة في الشهر. فأعاد الفريق تشغيل نموذج التكلفة الذي بنيناه في مقال تكلفة التوقف، فتغيرت النتيجة: ساعة فقدان سيرفر قاعدة البيانات لم تعد 13 ألف ريال، وإنما أصبح فيها تعويض للشريك أيضاً. وسيرفرات التطبيق أصبحت خلف موزع طلبات كما شرحنا في مقال توزيع الطلبات، فبقيت الطبقة الأصعب: قاعدة البيانات. وفي دليل عناقيد قواعد البيانات بنينا نسخة PostgreSQL ورقيناها يدوياً، ورأينا كيف يعود السيرفر القديم فيظن أنه ما زال الرئيسي، وشرحنا فكرة مخزن التوافق DCS ومفتاح القائد Leader Key. والسؤال الآن عملي تماماً: كيف تجعل هذا الانتقال تلقائياً دون أن تصنع انقسام دماغ، وكم ثانية يتوقف المتجر فعلاً، وكم طلباً يضيع؟
والأداة الأشهر لذلك هي Patroni، وهي مفتوحة المصدر بترخيص MIT، وتدير PostgreSQL على كل سيرفر، وتعتمد على مخزن توافق مثل etcd لتقرر من هو الرئيسي. وفي هذا المقال سوف نبني عنقوداً حقيقياً من ثلاثة سيرفرات PostgreSQL 18.6 مع Patroni 4.1.5، وثلاثة سيرفرات etcd 3.7.2، وأمامها HAProxy يوجه الكتابة دائماً إلى الرئيسي، ثم نعطله بخمس طرق ونقيس كل ثانية.
وسوف نناقش في هذا المقال ما يلي:
- ما الذي يفعله Patroni في كل دورة، وكيف يجيب ال REST API عن سؤال «من الرئيسي؟» لموزع الطلبات.
- الأرقام الثلاثة التي تحدد زمن الانتقال:
ttlوloop_waitوretry_timeout، والقاعدة التي تربطها. - مختبر حقيقي على Docker، مع مشكلة واجهتنا قبل أن يقلع العنقود أصلاً.
- قتل السيرفر الرئيسي فجأة، ثم عودته بالأداة pg_rewind، ثم الانتقال المخطط Switchover.
- عزل الرئيسي عن الشبكة وعميل ما زال يكتب عليه، وكم طلباً مؤكداً ضاع، ثم التجربة نفسها مع النسخ المتزامن.
- ماذا لو قصرنا المهلة، وكيف يجد التطبيق الرئيسي الجديد، وما تحتاجه قبل الإنتاج.
ماذا يفعل Patroni بالضبط؟ The HA Loop
Patroni برنامج Python يعمل على كل سيرفر قاعدة بيانات، ويتولى تشغيل PostgreSQL وإيقافه بنفسه، فلا تشغل PostgreSQL عبر systemd أو عبر ال Image مباشرة، وإنما تشغل Patroni وهو يشغله. والسبب أن Patroni يجب أن يكون هو الوحيد الذي يقرر متى يكون هذا السيرفر رئيسياً ومتى يكون نسخة، فإذا شغل أحد PostgreSQL من وراء ظهره، أو رقاه يدوياً، فقد عدنا إلى المشكلة التي رأيناها في دليل العناقيد. وفي كل دورة، ومدتها loop_wait أي عشر ثوان افتراضياً، يقوم Patroni على كل سيرفر بما يلي:
- يقرأ حالة العنقود من etcd: من يملك مفتاح القائد، وما الأعضاء الموجودون، وما الإعداد المشترك.
- يفحص PostgreSQL المحلي: هل يعمل، وهل هو رئيسي أم نسخة، وأين وصل في سجل WAL.
- إذا كان يملك المفتاح جدده، والمفتاح في etcd مربوط بعقد إيجار Lease له مدة صلاحية
ttl، فإذا لم يجدده أحد انتهى وحده. - إذا لم يملك أحد المفتاح، تسابقت النسخ السليمة على أخذه، بشرط أن تكون النسخة غير متأخرة أكثر من
maximum_lag_on_failover، وأن تسأل بقية النسخ عبر ال REST API عن موقعها في WAL، فلا تأخذ المفتاح نسخة متأخرة عن غيرها. - من يأخذ المفتاح يرقي PostgreSQL عنده، والبقية يغيرون إعدادهم ليتبعوه.
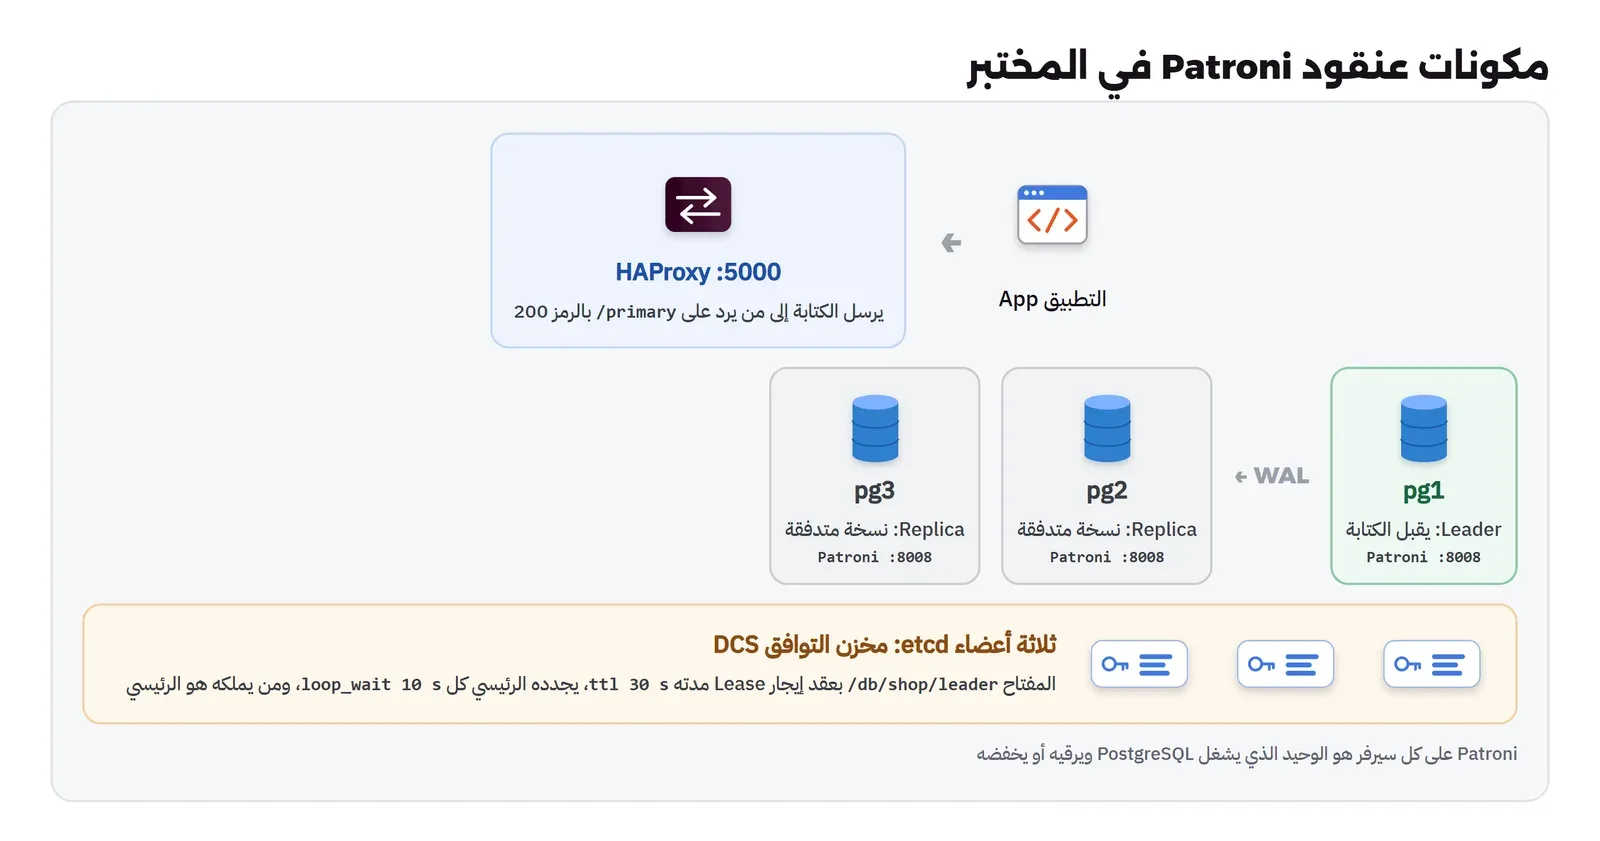
وكل سيرفر يشغل أيضاً واجهة REST API على المنفذ 8008، وأهم ما فيها لهذا المقال ثلاثة مسارات كما في توثيق ال REST API: /primary يرد بالرمز 200 فقط على السيرفر الذي يملك مفتاح القائد، و/replica يرد بالرمز 200 فقط على النسخة التي تعمل، و/health يرد بالرمز 200 إذا كان PostgreSQL يعمل أياً كان دوره. وهذه المسارات هي ما يجعل موزع الطلبات يعرف أين يرسل الكتابة، دون أن يفهم أي شيء عن PostgreSQL نفسه، كما سوف ترى في إعداد HAProxy. وتأتي معه أداة patronictl التي تعرض حالة العنقود وتنفذ الانتقال المخطط وتعدل الإعداد المشترك.
والصورة التالية تبين مكونات العنقود الذي سوف نبنيه:
لماذا Patroni بدلاً من سكربت ترقية؟ Alternatives
قبل أن نكمل، قد يتساءل البعض: لماذا كل هذه المكونات؟ ألا يكفي سكربت على كل نسخة يفحص الرئيسي ويرقي نفسه إذا توقف؟ والإجابة أن هذا السكربت يجيب عن سؤال واحد من ثلاثة: هل الرئيسي يرد علي؟ ولكنه لا يجيب عن السؤالين الآخرين، وهما الأهم: هل الرئيسي متوقف فعلاً أم أنني أنا المعزولة عنه؟ وإذا كنت أنا والنسخة الأخرى سليمتين، فمن منا يجب أن يصبح الرئيسي؟ والإجابة عن السؤالين تحتاج طرفاً ثالثاً يتفق عليه الجميع بالأغلبية، وهذا بالضبط ما يقدمه etcd لـ Patroni، وقد شرحنا سبب الأغلبية في مقال الأنظمة الموزعة. فكل أداة جادة للانتقال التلقائي في PostgreSQL فيها هذا الطرف الثالث بشكل أو بآخر، والفرق بينها في مكانه وفي ما تديره:
- Patroni: يعتمد على مخزن توافق خارجي، etcd أو Consul أو ZooKeeper أو Kubernetes نفسه، ويدير PostgreSQL بالكامل من التهيئة إلى النسخ إلى الترقية إلى العودة بالأداة pg_rewind، وهو الأوسع انتشاراً خارج Kubernetes، وتستخدمه أدوات أخرى من داخلها.
- repmgr: أداة أقدم تدير النسخ وتنفذ الترقية، وفيها خدمة repmgrd للانتقال التلقائي، ولكن القرار فيها يعتمد على تصويت السيرفرات نفسها مع سيرفر شاهد Witness، وليس على مخزن توافق مستقل، لذلك يحتاج إعدادها عناية أكبر حتى لا يحدث انقسام الدماغ عند انقسام الشبكة.
- pg_auto_failover: يضع سيرفراً مراقباً Monitor واحداً يقرر عن الجميع، وهو أبسط في الإعداد، ولكن المراقب نفسه يصبح جزءاً يجب أن تحميه.
- CloudNativePG: إذا كانت قواعدك داخل Kubernetes، فالمشغل Operator يستخدم Kubernetes نفسه كمخزن للحالة، وقد شرحناه في دليل CloudNativePG.
والسبب الذي يجعلنا نختار Patroni في هذا المقال أن الطرف الثالث فيه منفصل تماماً عن قاعدة البيانات، فقرار من هو الرئيسي يتخذه عنقود etcd الذي له أغلبيته المستقلة، وكل سيرفر PostgreSQL يطيع هذا القرار، حتى الرئيسي نفسه عندما يفقد الاتصال به، وهذا ما سوف تراه بعينك في تجربة العزل.
كم ثانية يستغرق الانتقال؟ ttl مع loop_wait مع retry_timeout
قبل أن نبني، يجب أن تفهم الأرقام الثلاثة التي تحدد زمن الانتقال، لأنها تحدد كم يتوقف المتجر في كل عطل، وتحدد أيضاً متى يتوقف السيرفر القديم عن قبول الكتابة. والقيم الافتراضية في توثيق الإعداد الديناميكي هي:
ttl= 30 ثانية: مدة صلاحية مفتاح القائد، فإذا توقف الرئيسي فجأة، فلن يأخذ غيره المفتاح قبل أن تنتهي هذه المدة من آخر تجديد. وهذا هو الجزء الأكبر من زمن الانتقال في العطل المفاجئ.loop_wait= 10 ثوان: المدة بين دورتين، فالرئيسي يجدد المفتاح كل عشر ثوان، والنسخ تنظر إلى المفتاح كل عشر ثوان، وهذا يعني أن النسخة قد ترى انتهاء المفتاح بعد انتهائه بثوان.retry_timeout= 10 ثوان: كم يحاول Patroni الوصول إلى etcd أو إلى PostgreSQL قبل أن يعتبر المحاولة فاشلة. وهنا الجزء المهم: إذا لم يستطع الرئيسي تجديد المفتاح خلال هذه المدة، فإنه يخفض PostgreSQL عنده فوراً، أي يوقفه عن قبول الكتابة، حتى لو كان يعمل بشكل ممتاز.
والقاعدة التي تربط الثلاثة هي loop_wait + 2 * retry_timeout <= ttl، والسبب فيها هو الأمان من انقسام الدماغ: الرئيسي الذي انقطع عن etcd يجب أن يتنحى قبل أن ينتهي مفتاحه ويأخذه غيره، فإذا كانت الدورة عشر ثوان ومحاولة التجديد تستمر حتى عشر ثوان، فالرئيسي المعزول يتنحى قبل أن ينتهي مفتاحه، ثم ينتظر الآخرون انتهاءه، فلا توجد لحظة يكون فيها رئيسيان يقبلان الكتابة عبر طريق يعرف القائد. ولاحظ أن الهامش ليس كبيراً كما يبدو على الورق، فسوف ترى في تجربة العزل أن الرئيسي تنحى قبل انتهاء مفتاحه بثانية ونصف فقط، لأن كل محاولة لتجديد المفتاح تجرب أعضاء etcd واحداً بعد الآخر حتى تنتهي مهلتها. والصورة التالية تبين ذلك على خط زمني:
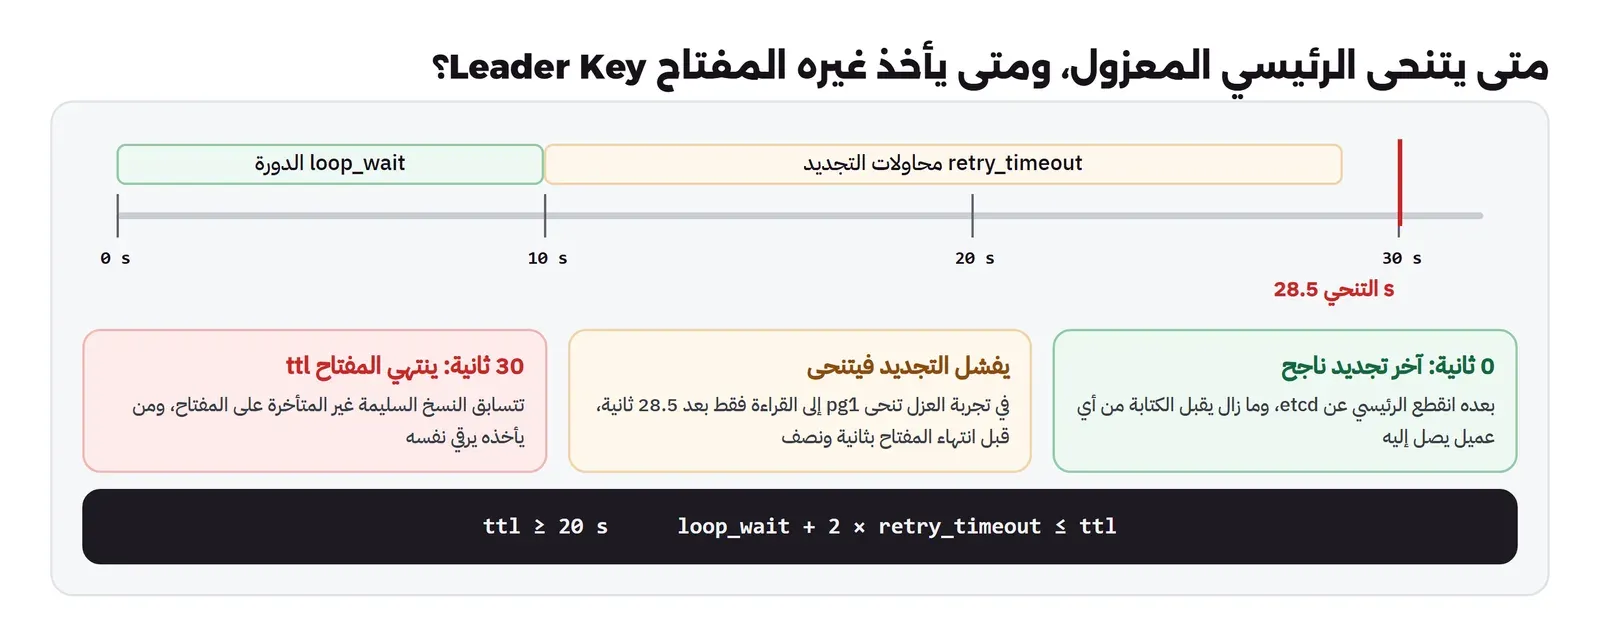
وقد يتساءل البعض: لماذا لا نجعل ttl ثلاث ثوان فيصبح الانتقال سريعاً جداً؟ والإجابة أن المهلة القصيرة تجعل كل توقف قصير في الشبكة أو في القرص أو في etcd انتقالاً كاملاً، والانتقال نفسه يقطع كل الاتصالات ويرسل أخطاء للعملاء، فالانتقال غير الضروري أسوأ من بطء قصير. وسوف ترى في المختبر أن Patroni نفسه يرفض أي قيمة أقل من 20 ثانية.
وهناك رقم رابع يحدد ليس متى يحدث الانتقال، وإنما هل يحدث أصلاً، وهو maximum_lag_on_failover. فإذا كانت كل النسخ متأخرة عن الرئيسي أكثر من هذا الحد لحظة توقفه، فلن تأخذ أي نسخة المفتاح، ويبقى العنقود دون رئيسي حتى يعود الرئيسي القديم أو يتدخل شخص. وقد يبدو هذا سلوكاً سيئاً، ولكنه في الحقيقة قرار مكتوب لصالح البيانات: الأفضل أن تتوقف الكتابة دقائق حتى يقرر إنسان، من أن يصبح رئيسياً سيرفر سوف يضيع آخر دقيقة من الطلبات دون أن يعرف أحد. لذلك راقب تأخر النسخ بالبايت دائماً، وإذا رأيت النسخ تتأخر كثيراً في ساعات الذروة، فاعرف أن الانتقال التلقائي في هذه الساعات قد لا يحدث، وأن تأخر النسخ نفسه مشكلة سعة يجب أن تحلها قبل أن تعتمد على العنقود.
المختبر Lab: ثلاثة سيرفرات PostgreSQL مع ثلاثة etcd
المختبر كله على شبكة Docker واحدة: ثلاث Containers لـ etcd، وثلاث لـ Patroni مع PostgreSQL، وواحدة لـ HAProxy، وعميل يكتب طلب شراء كل 100 ملي ثانية عبر HAProxy، ويسجل لكل محاولة نتيجتها ورقم الطلب الذي أكدته القاعدة والسيرفر الذي رد. وفي الإنتاج تكون هذه سيرفرات منفصلة في أماكن مختلفة، ولكن المنطق نفسه.
ملفات المختبر Lab Files
لا توجد Image رسمية لـ Patroni، لذلك نبني واحدة من Image PostgreSQL الرسمية، ونثبت فيها Patroni من مستودع PGDG الذي تأتي به ال Image أصلاً. احفظ الملف التالي باسم Dockerfile:
FROM postgres:18.6
RUN apt-get update && apt-get install -y --no-install-recommends patroni python3-psycopg2 python3-etcd && rm -rf /var/lib/apt/lists/*
USER postgres
ENTRYPOINT ["patroni"]
CMD ["/etc/patroni.yml"]
وملف الإعداد واحد لكل السيرفرات، والفرق بينها في اسم السيرفر وعناوينه، ونمررها عبر متغيرات البيئة التي يقرأها Patroni كما في توثيق متغيرات البيئة. احفظه باسم patroni.yml:
# Patroni 4.1 node config; PATRONI_NAME and the two *_CONNECT_ADDRESS values come from the environment
scope: shop
namespace: /db/
restapi:
  listen: 0.0.0.0:8008
etcd3:
  hosts: wr-ha-etcd1:2379,wr-ha-etcd2:2379,wr-ha-etcd3:2379
bootstrap:
  dcs:
    ttl: 30
    loop_wait: 10
    retry_timeout: 10
    maximum_lag_on_failover: 1048576
    postgresql:
      use_pg_rewind: true
      parameters:
        wal_level: replica
        hot_standby: "on"
        wal_log_hints: "on"
        max_wal_senders: 10
        max_replication_slots: 10
  initdb:
    - encoding: UTF8
    - data-checksums
  pg_hba:
    - local all all trust
    - host replication replicator 0.0.0.0/0 scram-sha-256
    - host all all 0.0.0.0/0 scram-sha-256
postgresql:
  listen: 0.0.0.0:5432
  data_dir: /var/lib/postgresql/data
  bin_dir: /usr/lib/postgresql/18/bin
  authentication:
    superuser:
      username: postgres
      password: lab-only-pass
    replication:
      username: replicator
      password: lab-only-repl
في الإعداد أعلاه لاحظ التالي:
scope: shopاسم العنقود، وnamespace: /db/البادئة في etcd، فيكون مفتاح القائد/db/shop/leader، وتستطيع أن تشغل عدة عناقيد على etcd نفسه بأسماء مختلفة.- القسم
bootstrap.dcsيكتب في etcd مرة واحدة عند إنشاء العنقود، وبعد ذلك يصبح الإعداد المشترك في etcd هو المرجع، وتغيره بالأمرpatronictl edit-configوليس بتعديل الملف، وهذا خطأ يقع فيه كثيرون: يعدلونttlفي الملف ويعيدون التشغيل ولا يتغير شيء. maximum_lag_on_failover: 1048576يعني أن النسخة المتأخرة أكثر من 1 MB من WAL لا تشارك في السباق على المفتاح، حتى لا يصبح رئيسياً سيرفر سوف يضيع كثيراً من البيانات.use_pg_rewind: trueمعwal_log_hints: "on"يسمحان لـ Patroni أن يعيد السيرفر القديم نسخة بالأداة pg_rewind، بدلاً من أن ينسخ قاعدة البيانات كلها من جديد، وسوف ترى ذلك في تجربة العودة.- كلمات المرور هنا للمختبر فقط، وفي الإنتاج ضعها في متغيرات بيئة من خزنة أسرار، ولا تفتح
pg_hbaعلى0.0.0.0/0وإنما على شبكة السيرفرات فقط.
وإعداد HAProxy يستمع على المنفذ 5000 للكتابة، ويرسل إلى السيرفر الذي يرد على /primary بالرمز 200، وعلى 5001 للقراءة من النسخ. احفظه باسم haproxy.cfg:
# Clients connect to :5000 and always reach the current primary; Patroni's REST API answers 200 on /primary only there
global
    stats socket [email protected]:9999 level admin
defaults
    mode tcp
    timeout connect 2s
    timeout client 30m
    timeout server 30m
listen primary
    bind :5000
    option httpchk GET /primary
    http-check expect status 200
    default-server inter 1s fall 2 rise 2 on-marked-down shutdown-sessions
    server pg1 wr-ha-pg1:5432 check port 8008
    server pg2 wr-ha-pg2:5432 check port 8008
    server pg3 wr-ha-pg3:5432 check port 8008
listen replicas
    bind :5001
    balance roundrobin
    option httpchk GET /replica
    http-check expect status 200
    default-server inter 1s fall 2 rise 2 on-marked-down shutdown-sessions
    server pg1 wr-ha-pg1:5432 check port 8008
    server pg2 wr-ha-pg2:5432 check port 8008
    server pg3 wr-ha-pg3:5432 check port 8008
ولاحظ هنا ثلاثة أشياء: أن الحركة نفسها TCP على المنفذ 5432، ولكن الفحص HTTP على المنفذ 8008 بالكلمة check port 8008، وأن on-marked-down shutdown-sessions يقطع كل الاتصالات المفتوحة إلى السيرفر الذي سقط في الفحص، حتى لا يبقى تطبيق متصلاً بسيرفر لم يعد رئيسياً، وأن inter 1s fall 2 يجعل HAProxy يكتشف التغيير خلال ثانيتين تقريباً.
والعميل يفتح اتصالاً جديداً لكل طلب، ويحفظ كل محاولة مع نوع الخطأ إن فشلت، ورقم الطلب وعنوان السيرفر إن نجحت. احفظه باسم writer.py:
# Writer: one order every 100 ms through HAProxy :5000, a new connection each time (like a short-lived worker).
# Logs time, result, confirmed id and which server answered, then prints outage windows.
import json, os, sys, time, psycopg
DSN = os.environ.get("DSN", "host=wr-ha-lb port=5000 user=postgres password=lab-only-pass dbname=shop connect_timeout=2")
SECONDS, OUT = float(os.environ.get("SECONDS", "60")), sys.argv[1]
end, log = time.time() + SECONDS, []
while time.time() < end:
    t0 = time.time()
    try:
        with psycopg.connect(DSN, autocommit=True) as c:
            oid, srv = c.execute("insert into orders(amount) values (150) returning id, inet_server_addr()::text").fetchone()
        log.append((t0, "ok", oid, srv))
    except Exception as e:
        log.append((t0, type(e).__name__, None, None))
    time.sleep(max(0, 0.1 - (time.time() - t0)))
json.dump(log, open(OUT, "w"))
ok = [x for x in log if x[1] == "ok"]
print(f"attempts {len(log)}  confirmed {len(ok)}  failed {len(log) - len(ok)}")
start = None
for t, r, _, srv in log + [(time.time(), "ok", None, None)]:
    if r != "ok" and start is None: start, kinds = t, {}
    if r != "ok": kinds[r] = kinds.get(r, 0) + 1
    if r == "ok" and start is not None:
        print(f"outage {time.strftime('%H:%M:%S', time.gmtime(start))} -> {time.strftime('%H:%M:%S', time.gmtime(t))} UTC {t - start:5.1f} s  {kinds}"); start = None
servers = []
for x in ok:
    if not servers or servers[-1][0] != x[3]: servers.append([x[3], 0])
    servers[-1][1] += 1
print("served by:", " -> ".join(f"{s} x{n}" for s, n in servers))
وسكربت التحليل analyze.py يقرأ سجل العميل بعد التجربة، ويطبع نوافذ التوقف والسيرفرات التي خدمت الكتابة بأسمائها، ثم يسأل الرئيسي الحالي: هل كل طلب أكدته القاعدة للعميل ما زال موجوداً؟ والعناوين فيه عناوين شبكة المختبر، فعدلها بحسب شبكتك:
# Reads a writer log: outage windows, which server served the writes, and whether every confirmed order
# still exists on the current primary (a confirmed order that is gone was lost in the failover).
import json, sys, time, psycopg
NAMES = {"172.21.0.5/32": "pg1", "172.22.0.2/32": "pg1", "172.22.0.4/32": "pg3", "172.21.0.6/32": "pg2", "172.21.0.7/32": "pg3"}
log = json.load(open(sys.argv[1])); ok = [x for x in log if x[1] == "ok"]
print(f"attempts {len(log)}  confirmed {len(ok)}  failed {len(log) - len(ok)}")
start = None
for t, r, _, _ in log + [[log[-1][0], "ok", None, None]]:
    if r != "ok" and start is None: start, kinds = t, {}
    if r != "ok": kinds[r] = kinds.get(r, 0) + 1
    if r == "ok" and start is not None:
        print(f"outage {time.strftime('%H:%M:%S', time.gmtime(start))} -> {time.strftime('%H:%M:%S', time.gmtime(t))} UTC {t - start:5.1f} s  {kinds}"); start = None
runs = []
for x in ok:
    n = NAMES.get(x[3], x[3])
    if not runs or runs[-1][0] != n: runs.append([n, 0])
    runs[-1][1] += 1
print("served by:", " -> ".join(f"{s} x{n}" for s, n in runs))
with psycopg.connect("host=wr-ha-lb port=5000 user=postgres password=lab-only-pass dbname=shop") as c:
    have = {r[0] for r in c.execute("select id from orders where id = any(%s)", ([x[2] for x in ok],))}
lost = [x[2] for x in ok if x[2] not in have]
print(f"confirmed orders missing on the primary now: {len(lost)} {lost[:10]}")
ونبني ال Images، وعميل صغير فيه psycopg فقط من ملف Dockerfile.client:
export MSYS_NO_PATHCONV=1
docker build -q -t wr-ha-patroni:1 .
printf 'FROM python:3.13-slim\nRUN pip install --no-cache-dir "psycopg[binary]==3.3.7"\nCOPY writer.py /lab/\n' > Dockerfile.client
docker build -q -t wr-ha-pgclient:1 -f Dockerfile.client .
مشكلة واجهتنا: Can not find suitable configuration of DCS
في أول محاولة بنينا ال Image دون الحزمة python3-etcd، لأن etcd3 في Patroni يتكلم مع etcd عبر واجهة HTTP، فظننا أنه لا يحتاج مكتبة إضافية. فشغلنا السيرفرات الثلاثة، فتوقفت كلها خلال ثوان بالحالة Exited (0)، وفي آخر سجلها:
patroni.exceptions.PatroniFatalException: Can not find suitable configuration of distributed configuration store
Available implementations: consul, kubernetes
والرسالة مضللة قليلاً، فهي تقول إن الإعداد غير مناسب، والإعداد صحيح تماماً. والسطر الثاني هو المفتاح: القائمة فيها consul وkubernetes فقط، أي أن Patroni لم يستطع تحميل etcd وetcd3 أصلاً. وعندما جربنا داخل ال Image الأمر python3 -c 'import patroni.dcs.etcd3' ظهر السبب: ModuleNotFoundError: No module named 'etcd'، فوحدة etcd3 في Patroni تستورد مكتبة python-etcd القديمة لبعض الأنواع والاستثناءات، وحزمة Debian لا تثبتها لأنها مقترحة وليست مطلوبة، والخيار --no-install-recommends الذي نضعه عادة لتصغير ال Image يزيدها بعداً. والحل إضافة python3-etcd كما في ال Dockerfile أعلاه، وبعدها ظهرت في القائمة. والدرس أن تقرأ السطر الأخير من الخطأ قبل أن تعيد كتابة الإعداد، وأن تتحقق من وحدات DCS بعد كل تحديث لل Image.
تشغيل العنقود Bootstrap
الآن نشغل etcd بثلاثة أعضاء، ثم سيرفرات Patroni الثلاثة بفارق ثوان، ثم HAProxy والعميل:
docker network create wr-ha-net
CL="etcd1=http://wr-ha-etcd1:2380,etcd2=http://wr-ha-etcd2:2380,etcd3=http://wr-ha-etcd3:2380"
for i in 1 2 3; do docker run -d --name wr-ha-etcd$i --network wr-ha-net gcr.io/etcd-development/etcd:v3.7.2 \
  /usr/local/bin/etcd --name etcd$i --data-dir /etcd-data \
  --listen-client-urls http://0.0.0.0:2379 --advertise-client-urls http://wr-ha-etcd$i:2379 \
  --listen-peer-urls http://0.0.0.0:2380 --initial-advertise-peer-urls http://wr-ha-etcd$i:2380 \
  --initial-cluster $CL --initial-cluster-state new --initial-cluster-token wr-ha; done
for i in 1 2 3; do docker run -d --name wr-ha-pg$i --hostname pg$i --network wr-ha-net -e PATRONI_NAME=pg$i \
  -e PATRONI_RESTAPI_CONNECT_ADDRESS=wr-ha-pg$i:8008 -e PATRONI_POSTGRESQL_CONNECT_ADDRESS=wr-ha-pg$i:5432 \
  -v "$(pwd -W)/patroni.yml:/etc/patroni.yml:ro" -v wr-ha-pg$i:/var/lib/postgresql wr-ha-patroni:1; sleep 3; done
docker exec wr-ha-pg1 patronictl -c /etc/patroni.yml list
والمخرج بعد حوالي دقيقة سوف يكون كما يلي:
+ Cluster: shop (7704501444103983136) -----+----+-------------+-----+------------+-----+
| Member | Host      | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+--------+-----------+---------+-----------+----+-------------+-----+------------+-----+
| pg1    | wr-ha-pg1 | Leader  | running   |  1 |             |     |            |     |
| pg2    | wr-ha-pg2 | Replica | streaming |  1 |   0/5000060 |   0 |  0/5000060 |   0 |
| pg3    | wr-ha-pg3 | Replica | streaming |  1 |   0/5000060 |   0 |  0/5000060 |   0 |
+--------+-----------+---------+-----------+----+-------------+-----+------------+-----+
أول سيرفر قلع وجد العنقود فارغاً في etcd، فأخذ مفتاح التهيئة ونفذ initdb وأصبح القائد، والسيرفران الآخران رأيا أن العنقود موجود، فنسخا قاعدة البيانات منه بالأداة pg_basebackup وبدآ النسخ المتدفق، والعمود TL هو رقم الخط الزمني Timeline الذي يزيد مع كل ترقية. ثم ننشئ قاعدة البيانات والجدول على الرئيسي، ونشغل HAProxy، ونسأل ال REST API في كل سيرفر:
docker exec wr-ha-pg1 psql -U postgres -c "create database shop"
docker exec wr-ha-pg1 psql -U postgres -d shop -c "create table orders (id bigserial primary key, amount int not null, created_at timestamptz not null default now())"
docker run -d --name wr-ha-lb --network wr-ha-net -v "$(pwd -W)/haproxy.cfg:/usr/local/etc/haproxy/haproxy.cfg:ro" haproxy:3.4.6
docker run -d --name wr-ha-client --network wr-ha-net -v "$(pwd -W):/lab" -w /lab wr-ha-pgclient:1 sleep infinity
docker logs wr-ha-lb 2>&1 | grep DOWN
[WARNING] (8) : Server primary/pg2 is DOWN, reason: Layer7 wrong status, code: 503, info: "Service Unavailable" ...
[WARNING] (8) : Server primary/pg3 is DOWN, reason: Layer7 wrong status, code: 503, info: "Service Unavailable" ...
[WARNING] (8) : Server replicas/pg1 is DOWN, reason: Layer7 wrong status, code: 503, info: "Service Unavailable" ...وهذا بالضبط ما نريده: في الخلفية primary سقطت النسختان في الفحص لأنهما ترد على /primary بالرمز 503، وفي الخلفية replicas سقط الرئيسي. أي أن HAProxy لا يعرف شيئاً عن PostgreSQL، ولكنه يعرف دائماً أين يرسل الكتابة.
نقتل السيرفر الرئيسي Kill the Leader
أول عطل هو الأسوأ: السيرفر الرئيسي يختفي فجأة، دون أن يتنحى ودون أن يحرر مفتاحه، كما يحدث عندما تنقطع الكهرباء عنه. نشغل العميل 100 ثانية، وبعد 15 ثانية نقتل ال Container بالكامل، أي Patroni وPostgreSQL معاً:
docker exec -d -e SECONDS=100 wr-ha-client python writer.py out/e1-kill.json
sleep 15; date -u +%T.%N | cut -c1-12; docker kill wr-ha-pg1
sleep 90; docker exec wr-ha-client python analyze.py out/e1-kill.json
والمخرج سوف يكون كما يلي:
02:02:47.966
attempts 709  confirmed 441  failed 268
outage 02:02:48 -> 02:03:19 UTC  30.7 s  {'OperationalError': 261, 'ConnectionTimeout': 1, 'ReadOnlySqlTransaction': 6}
served by: pg1 x139 -> pg2 x302
confirmed orders missing on the primary now: 0 []
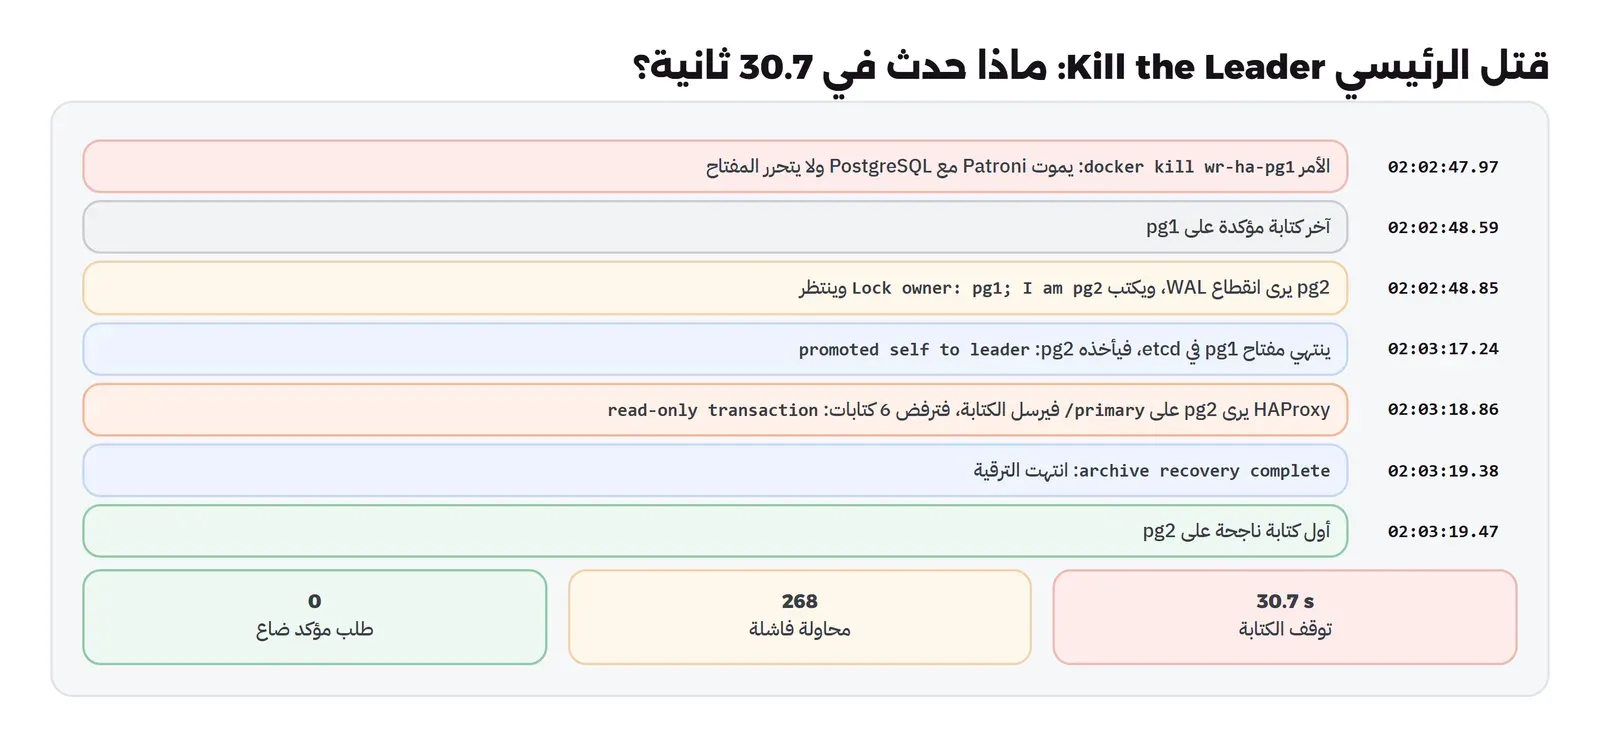
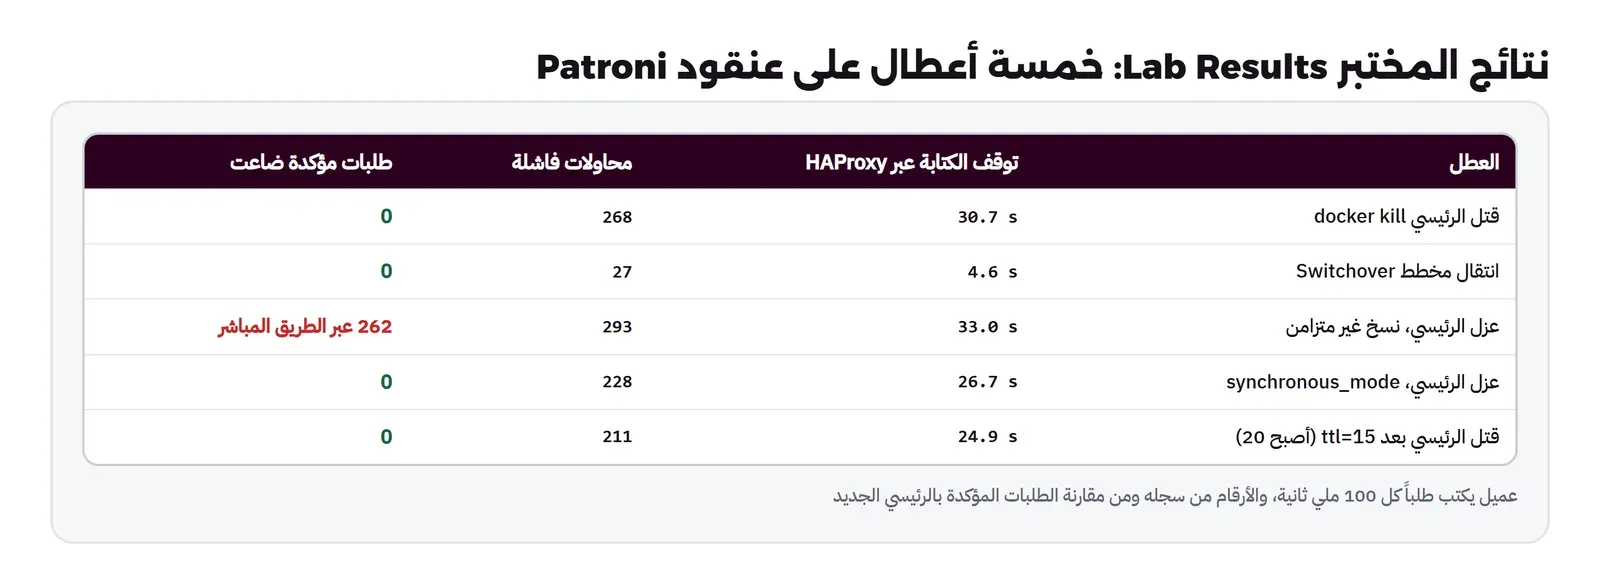
والتوقف 30.7 ثانية، وهو تقريباً ttl بالضبط، ولم يضع أي طلب أكدته القاعدة. ولكن الأرقام وحدها لا تشرح ما حدث في هذه الثواني، فلنقرأ سجل pg2 الذي أصبح الرئيسي:
02:02:48.845 UTC [65] FATAL:  could not receive data from WAL stream: server closed the connection unexpectedly
02:02:53,234 INFO: Lock owner: pg1; I am pg2
02:03:17,037 WARNING: failed to resolve host wr-ha-pg1: [Errno -2] Name or service not known
02:03:17,237 INFO: promoted self to leader by acquiring session lock
02:03:17.250 UTC [38] LOG:  received promote request
02:03:17.813 UTC [38] LOG:  redo done at 0/549AFA0 ...
02:03:17.814 UTC [38] LOG:  last completed transaction was at log time 2026-11-05 02:02:48.654308+00
02:03:17.905 UTC [38] LOG:  selected new timeline ID: 2
02:03:18.905 UTC [92] ERROR:  cannot execute INSERT in a read-only transaction
02:03:19.333 UTC [97] ERROR:  cannot execute INSERT in a read-only transaction
02:03:19.383 UTC [38] LOG:  archive recovery complete
في السجل أعلاه لاحظ التالي:
- بعد أقل من ثانية من القتل عرفت النسخة أن الاتصال بالرئيسي انقطع، فسطر
could not receive data from WAL streamفي 02:02:48. ولكن معرفة النسخة لا تكفي، فهي لا تستطيع أن تفرق بين رئيسي ميت ورئيسي انقطعت الشبكة بينها وبينه فقط، لذلك تكتب في الدورة التاليةLock owner: pg1; I am pg2وتنتظر. - في 02:03:17 انتهى مفتاح pg1 في etcd، أي بعد حوالي 29 ثانية من القتل، فأخذه pg2 وكتب
promoted self to leader by acquiring session lock. وقبل ذلك بلحظة حاول أن يسأل pg1 عن موقعه في WAL فلم يجد الاسم أصلاً، لأن Docker يحذف اسم ال Container الميت من DNS الشبكة. - السطر
last completed transaction was at log time 02:02:48.654يقول إن آخر معاملة وصلت إلى pg2 كانت بعد آخر طلب أكده pg1 للعميل، وهو في 02:02:48.594 في سجل العميل، ولذلك لم يضع أي طلب مؤكد. وهذا ليس مضموناً في النسخ غير المتزامن، وإنما حدث هنا لأن الضغط Load خفيف والنسخة لم تكن متأخرة. - الأخطاء الست
ReadOnlySqlTransactionهي أطرف ما في التجربة: HAProxy رأى pg2 يرد على/primaryبالرمز 200 لأن Patroni يملك المفتاح، فأرسل إليه الكتابة، ولكن PostgreSQL نفسه كان ما زال في منتصف الترقية حتىarchive recovery completeفي 02:03:19.383، فرفض ست كتابات خلال نصف ثانية. لذلك يجب أن يعيد التطبيق المحاولة عند هذا الخطأ بالذات، فهو خطأ مؤقت يحدث في كل انتقال.
عودة السيرفر القديم مع pg_rewind
الآن نعيد تشغيل pg1، وهذا هو الموقف الذي رأينا في دليل العناقيد أنه يصنع انقسام الدماغ عندما يكون الانتقال يدوياً، لأن السيرفر القديم يقلع كرئيسي. ومع Patroni يقرأ pg1 المفتاح من etcd قبل أي شيء، فيجد أن القائد pg2، فيعرف أنه يجب أن يصبح نسخة:
docker start wr-ha-pg1
docker logs wr-ha-pg1 2>&1 | grep -iE "rewind|diverge|single user|Lock owner"
02:05:51,075 INFO: Lock owner: pg2; I am pg1
02:05:54,419 INFO: doing crash recovery in a single user mode
02:07:11,670 INFO: running pg_rewind from pg2
02:07:15,465 INFO: pg_rewind exit code=0
02:07:15,465 INFO: stderr=pg_rewind: servers diverged at WAL location 0/549AFC8 on timeline 1
pg_rewind: rewinding from last common checkpoint at 0/3000130 on timeline 1
pg_rewind: Done!
02:07:18.688 UTC [71] LOG: started streaming WAL from primary at 0/5000000 on timeline 2وهذه العودة فيها ثلاث خطوات تستحق الشرح. الأولى أن pg1 قتل وهو رئيسي، فمجلد بياناته ليس في حالة إغلاق سليم، والأداة pg_rewind تحتاج إغلاقاً سليماً، لذلك شغله Patroni أولاً في وضع المستخدم الواحد Single User Mode ليكمل استعادة ما بعد التعطل. والثانية أن pg_rewind وجد أن السيرفرين افترقا عند الموقع 0/549AFC8 في الخط الزمني 1، أي أن pg1 كان قد كتب في WAL شيئاً بعد هذا الموقع لم يصل إلى pg2 قبل موته، وهي معاملات كانت في الطريق ولم يؤكدها للعميل، فأرجعها pg_rewind إلى آخر نقطة تفتيش مشتركة ونسخ من pg2 الملفات التي تغيرت فقط. والثالثة أن pg1 بدأ يتبع pg2 على الخط الزمني 2، دون أن ينسخ قاعدة البيانات كلها من جديد.
ولاحظ أن خطوة المستخدم الواحد استغرقت حوالي 77 ثانية، وهذا وقت طويل لقاعدة صغيرة، وعندما بحثنا عن السبب وجدنا في سجلات etcd الثلاثة في اللحظة نفسها تحذيراً مثل "msg":"slow fdatasync","took":"33.498466836s","expected-duration":"1s"، أي أن القرص الذي تتشاركه كل ال Containers توقف عن الكتابة أكثر من 30 ثانية. وفي هذه الحالة لم يحدث انتقال لأن الرئيسي جدد مفتاحه قبل التوقف وبعده، ولكنه تحذير مهم لتصميمك: توثيق عتاد etcd يقول إن etcd حساس جداً لزمن الكتابة على القرص، ويوصي بقرص SSD، فإذا وضعت etcd على القرص نفسه الذي تكتب عليه قاعدة البيانات، فإن ضغط الكتابة في القاعدة قد يبطئ etcd، فيفشل الرئيسي في تجديد مفتاحه، فيحدث انتقال لم يكن له داع. لذلك ضع etcd على قرص منفصل، أو على سيرفرات صغيرة خاصة به.
الانتقال المخطط Switchover
ليس كل انتقال عطلاً، فعندما تريد أن تحدث نظام التشغيل على السيرفر الرئيسي أو تعيد تشغيله، فأنت تريد أن تنقل الدور إلى نسخة أولاً، بطريقة يتنحى فيها الرئيسي بإرادته ويحرر مفتاحه، فلا ينتظر أحد انتهاء ttl:
docker exec -d -e SECONDS=40 wr-ha-client python writer.py out/e3-switchover.json
sleep 10; docker exec wr-ha-pg2 patronictl -c /etc/patroni.yml switchover --leader pg2 --candidate pg1 --force
sleep 33; docker exec wr-ha-client python analyze.py out/e3-switchover.json
2026-11-05 02:08:31.46520 Successfully switched over to "pg1"
attempts 358 confirmed 331 failed 27
outage 02:08:28 -> 02:08:32 UTC 4.6 s {'OperationalError': 20, 'ConnectionTimeout': 1, 'ReadOnlySqlTransaction': 6}
served by: pg2 x125 -> pg1 x206
confirmed orders missing on the primary now: 0 []التوقف 4.6 ثانية بدلاً من 30.7، و27 محاولة فاشلة بدلاً من 268، والسبب أن pg2 أوقف PostgreSQL بإغلاق سليم، وانتظر حتى تصل النسخة pg1 إلى آخر موقع في WAL، ثم حرر المفتاح، فأخذه pg1 فوراً. وهذا يعني أن الصيانة المخطط لها، وهي كما رأيت في مقال التكلفة 60 دقيقة في السنة على سيرفر واحد، تصبح ثوان قليلة، ويمكن تنفيذها في وضح النهار بدلاً من الفجر. ولاحظ أن الأخطاء الست ReadOnlySqlTransaction ظهرت هنا أيضاً لنفس السبب الذي شرحناه في التجربة السابقة.
عزل الرئيسي عن الشبكة Network Partition
القتل المفاجئ عطل نظيف، فالسيرفر إما يعمل أو لا يعمل. أما العطل الأخطر فهو أن يبقى الرئيسي يعمل بشكل ممتاز، ولكنه ينقطع عن etcd وعن النسخ، بينما يستطيع جزء من التطبيق أن يصل إليه، كأن يكون سيرفر تطبيق في الشبكة نفسها معه، أو تطبيق يتصل بعنوانه مباشرة دون HAProxy. ولكي نصنع ذلك أنشأنا شبكة ثانية wr-ha-side، ووصلنا بها الرئيسي pg1 وعميلاً ثانياً يكتب على pg1 مباشرة، ثم فصلنا pg1 عن الشبكة الرئيسية 60 ثانية:
docker network create wr-ha-side; docker network connect wr-ha-side wr-ha-pg1
docker run -d --name wr-ha-side --network wr-ha-side -v "$(pwd -W):/lab" -w /lab wr-ha-pgclient:1 sleep infinity
docker exec -d -e SECONDS=100 wr-ha-client python writer.py out/e4-main.json
docker exec -d -e SECONDS=100 -e DSN="host=wr-ha-pg1 port=5432 user=postgres password=lab-only-pass dbname=shop connect_timeout=2" \
  wr-ha-side python writer.py out/e4-side.json
sleep 10; docker network disconnect wr-ha-net wr-ha-pg1
sleep 60; docker network connect wr-ha-net wr-ha-pg1
والمخرج من العميلين ومن سجل pg1 سوف يكون كما يلي:
== main (through HAProxy)
attempts 876  confirmed 583  failed 293
outage 02:09:32 -> 02:10:05 UTC  33.0 s  {'ConnectionTimeout': 1, 'OperationalError': 282, 'ReadOnlySqlTransaction': 10}
served by: pg1 x94 -> pg3 x489
confirmed orders missing on the primary now: 0 []
== side (direct to pg1)
attempts 984  confirmed 350  failed 634
outage 02:09:58 -> 02:11:02 UTC  63.6 s  {'OperationalError': 434, 'ReadOnlySqlTransaction': 200}
served by: pg1 x350
confirmed orders missing on the primary now: 24 [1036, 1037, 1038, 1039, 1040, 1041, 1042, 1043, 1044, 1045]

02:09:58,944 ERROR: Error communicating with DCS
02:09:58,945 INFO: demoting self because DCS is not accessible and I was a leader
العميل الذي يمر بـ HAProxy رأى ما يشبه القتل: توقف 33 ثانية، ثم أصبح pg3 هو الرئيسي، ولم يضع شيء مما أكده. أما العميل الذي يكتب على pg1 مباشرة فرأى شيئاً مختلفاً تماماً: الكتابة استمرت وكأن شيئاً لم يحدث من لحظة العزل في 02:09:32 حتى 02:09:58، أي 26 ثانية، لأن pg1 كان يعمل ويقبل الكتابة، ولم يكتشف أنه معزول إلا عندما فشلت محاولة تجديد المفتاح التي بدأت في دورة 02:09:40 حتى نهاية مهلتها، فكتب demoting self because DCS is not accessible في 02:09:58.9، أي بعد 28.5 ثانية من آخر تجديد ناجح في 02:09:30، وقبل أن ينتهي مفتاحه بثانية ونصف فقط، ثم أخذ pg3 المفتاح في 02:10:04.9 بعد انتهائه. وكل ما كتب على pg1 في هذه الثواني لم يصل إلى أي نسخة.
والسطر الأخير يقول إن 24 طلباً مؤكداً فقط ضاعت، وهذا رقم خادع، لذلك كتبنا سكربتاً ثانياً lost.py يأخذ كل طلب أكده pg1 بعد لحظة العزل، ويبحث عن رقمه على الرئيسي الجديد، ويقارن وقت إنشائه بوقت تأكيده:
# For each order the isolated old primary confirmed after the partition began, look up that id on the new primary:
# missing = lost; present with a later created_at = the number was given again to a different order.
import json, sys, psycopg
log, cut = json.load(open(sys.argv[1])), float(sys.argv[2])
mine = [(x[0], x[2]) for x in log if x[1] == "ok" and x[0] >= cut]
with psycopg.connect("host=wr-ha-lb port=5000 user=postgres password=lab-only-pass dbname=shop") as c:
    rows = dict(c.execute("select id, extract(epoch from created_at) from orders where id = any(%s)", ([i for _, i in mine],)).fetchall())
lost = [i for t, i in mine if i not in rows]
reused = [(i, t, float(rows[i])) for t, i in mine if i in rows and float(rows[i]) - t > 1]
print(f"confirmed by the isolated primary after the cut: {len(mine)} (ids {mine[0][1]}..{mine[-1][1]})")
print(f"  missing on the new primary: {len(lost)}")
print(f"  id given again to another order: {len(reused)}, e.g. {[(i, round(r - t, 1)) for i, t, r in reused[:3]]} (seconds later)")
confirmed by the isolated primary after the cut: 262 (ids 1030..1294)
missing on the new primary: 24
id given again to another order: 235, e.g. [(1060, 30.7), (1061, 30.6), (1062, 30.8)] (seconds later)والحقيقة أن pg1 المعزول أكد 262 طلباً لم يصل منها شيء إلى العنقود تقريباً، ووجدنا 235 من أرقامها مستخدمة على الرئيسي الجديد لطلبات أخرى أنشئت بعد حوالي 30 ثانية. والسبب أن PostgreSQL لا يكتب في WAL كل قيمة من العداد Sequence، وإنما يحجز دفعة من القيم مرة واحدة، فالرئيسي الجديد بدأ من آخر دفعة وصلته، وأعطى الأرقام نفسها التي أعطاها pg1 لعملاء آخرين. وهذه هي المشكلة نفسها التي رأيناها في مقال التكلفة بعد الاستعادة من نسخة احتياطية، ولكنها هنا جاءت من آلية التوفر العالي نفسها. وعندما عاد pg1 إلى الشبكة أعاده Patroni نسخة تتبع pg3 على الخط الزمني 4، فلم يعد لهذه الطلبات أثر على أي سيرفر في العنقود، وبقيت فقط في سجل العميل.
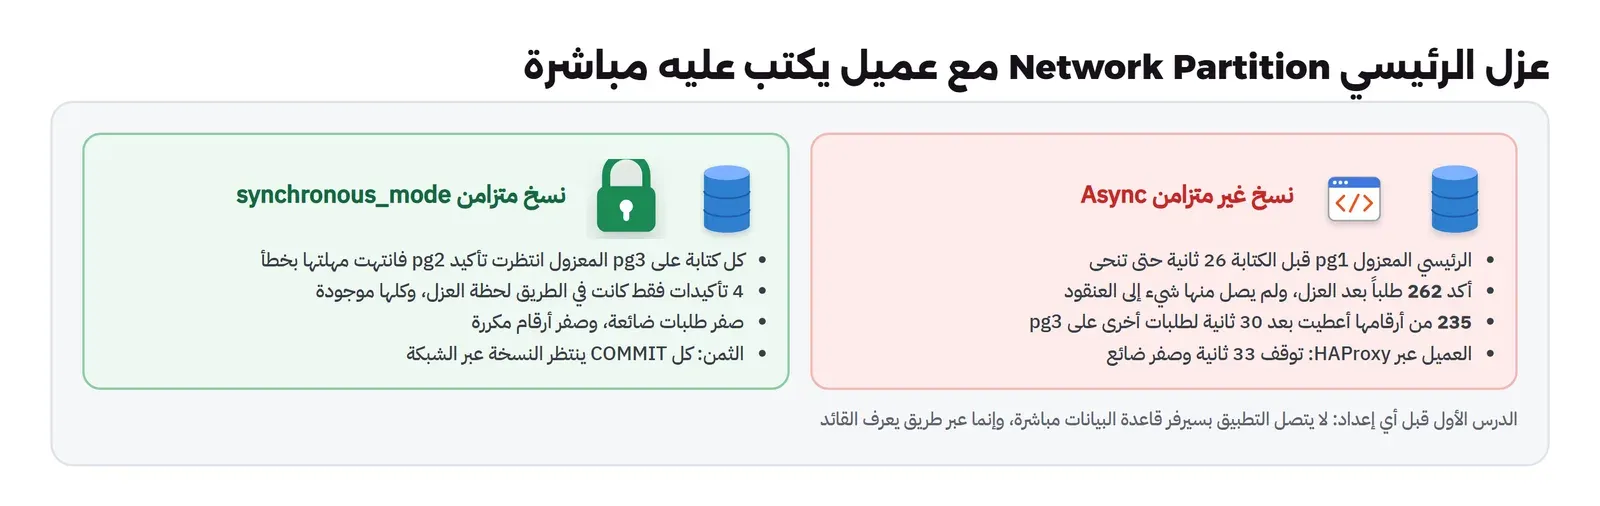
والدرس الأول من هذه التجربة أن التطبيق يجب ألا يتصل بسيرفر قاعدة البيانات مباشرة أبداً، وإنما عبر طريق يعرف من يملك المفتاح، مثل HAProxy مع فحص /primary، والسبب أن الطريق المباشر هو الذي يجعل الرئيسي المعزول يقبل الكتابة. والدرس الثاني أن العزل يضيع الكتابة في النسخ غير المتزامن حتى مع Patroni، والسؤال الطبيعي بعده: ماذا لو كان النسخ متزامناً؟
ماذا لو كان النسخ متزامناً؟ synchronous_mode What If
في الوضع المتزامن الذي يشرحه توثيق أوضاع النسخ، يختار Patroni نسخة متزامنة ويكتب اسمها في synchronous_standby_names، فلا يرد الرئيسي على COMMIT إلا بعد أن تكتب هذه النسخة السجل على قرصها. نفعله بأمر واحد على الإعداد المشترك، ثم نكرر العزل نفسه على الرئيسي الحالي pg3، وعميل جانبي يكتب عليه مباشرة بمهلة 3 ثوان لكل أمر:
docker exec wr-ha-pg3 patronictl -c /etc/patroni.yml edit-config -s synchronous_mode=true --force
docker exec wr-ha-pg3 patronictl -c /etc/patroni.yml list
docker exec wr-ha-pg3 psql -U postgres -tAc "show synchronous_standby_names"
| pg1 | wr-ha-pg1 | Replica | streaming | 4 | 0/550DAE0 | 0 | 0/550DAE0 | 0 |
| pg2 | wr-ha-pg2 | Sync Standby | streaming | 4 | 0/550DAE0 | 0 | 0/550DAE0 | 0 |
| pg3 | wr-ha-pg3 | Leader | running | 4 | | | | |
pg2وبعد تكرار العزل 60 ثانية، والمخرج سوف يكون كما يلي:
== main
outage 02:12:31 -> 02:12:57 UTC  26.7 s  {'OperationalError': 224, 'ReadOnlySqlTransaction': 4}
confirmed orders missing on the primary now: 0 []
== side
outage 02:12:30 -> 02:14:00 UTC  89.6 s  {'OperationalError': 423, 'ReadOnlySqlTransaction': 257}
confirmed by the isolated primary after the cut: 4 (ids 1731..1737)
  missing on the new primary: 0
  id given again to another order: 0, e.g. [] (seconds later)
02:12:52,573 INFO: demoting self because DCS is not accessible and I was a leader
02:12:52.640 UTC [857] WARNING:  canceling the wait for synchronous replication and terminating connection due to administrator command
والفرق كامل: العميل الجانبي لم يحصل على أي تأكيد بعد العزل إلا أربعة طلبات كانت في الطريق إلى النسخة المتزامنة لحظة الفصل، وكلها موجودة على الرئيسي الجديد، فلم يضع شيء ولم يتكرر رقم. والسبب أن كل كتابة على pg3 المعزول انتظرت تأكيد pg2 الذي لا يستطيع الوصول إليه، فانتهت مهلتها بخطأ بدلاً من أن تنجح، والسطر canceling the wait for synchronous replication يبين أن Patroni عندما خفض pg3 قطع هذه الكتابات المنتظرة فلم يؤكد أياً منها للعميل.
ولكن الوضع المتزامن له ثمن وحدود يجب أن تعرفها قبل أن تفعله:
- زمن كل كتابة: كل
COMMITينتظر ذهاباً وعودة عبر الشبكة إلى النسخة المتزامنة مع كتابتها على قرصها، فإذا كانت النسخة في مركز بيانات آخر فهذا الزمن يضاف إلى كل طلب شراء، لذلك قسه على شبكتك قبل القرار. - إذا توقفت النسخة المتزامنة: في
synchronous_modeالعادي يحول Patroni الرئيسي إلى غير متزامن مؤقتاً حتى لا تتوقف الكتابة، أي أنه يفضل التوفر على ضمان البيانات في هذه اللحظة، ومعsynchronous_mode_strictتتوقف الكتابة حتى تعود نسخة متزامنة. - الإلغاء أثناء الانتظار: يذكر التوثيق صراحة أن المعاملة قد تضيع حتى مع الوضع الصارم إذا ألغيت أثناء انتظار تأكيد النسخة، لأن PostgreSQL يكون قد كتبها محلياً، فلا تعتمد على أن المهلة في التطبيق تعني دائماً أن الكتابة لم تحدث.
ماذا لو قصرنا ttl؟ What If
آخر تجربة هي السؤال الذي يسأله كل من يرى التوقف 30 ثانية: لماذا لا نقصر المهلة؟ فأعدنا الوضع غير المتزامن، وطلبنا ttl 15 ثانية مع loop_wait 5 وretry_timeout 5، وهي قيم تحقق القاعدة، ثم قتلنا الرئيسي من جديد:
docker exec wr-ha-pg2 patronictl -c /etc/patroni.yml edit-config -s synchronous_mode=false \
  -s ttl=15 -s loop_wait=5 -s retry_timeout=5 --force
docker exec -d -e SECONDS=60 wr-ha-client python writer.py out/e6-ttl15.json
sleep 12; docker kill wr-ha-pg2; sleep 50
docker exec wr-ha-client python analyze.py out/e6-ttl15.json
docker logs wr-ha-pg1 2>&1 | grep -i "ttl="
docker exec wr-ha-etcd1 sh -c 'for l in $(etcdctl lease list | tail -n +2); do etcdctl lease timetolive $l; done'
attempts 534 confirmed 323 failed 211
outage 02:19:16 -> 02:19:41 UTC 24.9 s {'ConnectionTimeout': 1, 'OperationalError': 210}
served by: pg2 x102 -> pg1 x221
confirmed orders missing on the primary now: 0 []
2026-11-05 02:18:50,461 WARNING: ttl=15 can't be smaller than 20, adjusting...
lease 7ff6a1a96dc23659 granted with TTL(20s), remaining(19s)
lease 3254a1a96dc212fd granted with TTL(20s), remaining(19s)وهذه مشكلة ثانية واجهتنا، وهي من النوع الصامت: الأمر edit-config قبل القيمة 15 دون أي اعتراض، وعرضها في الإعداد، ولكن Patroni رفعها إلى 20 ثانية وكتب تحذيراً في سجل كل سيرفر فقط، وعقود الإيجار في etcd نفسها 20 ثانية. فلو اكتفيت بقراءة الإعداد لظننت أن الانتقال سوف يكون خلال 15 ثانية، والحقيقة أنه أخذ 24.9 ثانية، أي حوالي 20 ثانية للمفتاح وبقية الدورة. فالحد الأدنى في Patroni 20 ثانية، وتخفيض المهلة من 30 إلى 20 وفر حوالي ست ثوان في هذا العطل، وهذا كل ما تستطيع أن تكسبه من هذا الباب. وإذا كنت تحتاج أسرع من ذلك فالحل ليس في المهلة، وإنما في أن يكون أغلب الانتقالات مخططاً بالأمر switchover الذي رأيته يأخذ أقل من خمس ثوان.
وأخيراً، هذا هو سجل الخطوط الزمنية للعنقود بعد كل التجارب، كما يعرضه الأمر patronictl history، وكل سطر فيه انتقال حقيقي من التجارب السابقة:
+----+-----------+------------------------------+----------------------------------+------------+
| TL |       LSN | Reason                       | Timestamp                        | New Leader |
+----+-----------+------------------------------+----------------------------------+------------+
|  1 |  88715208 | no recovery target specified | 2026-11-05T02:03:19.284190+00:00 | pg2        |
|  2 |  88845368 | no recovery target specified | 2026-11-05T02:08:32.751994+00:00 | pg1        |
|  3 |  88991120 | no recovery target specified | 2026-11-05T02:10:04.932160+00:00 | pg3        |
|  4 |  89221760 | no recovery target specified | 2026-11-05T02:12:57.645398+00:00 | pg2        |
|  5 | 241813352 | no recovery target specified | 2026-11-05T02:19:40.649378+00:00 | pg1        |
+----+-----------+------------------------------+----------------------------------+------------+
حذف المختبر Cleanup
docker rm -f wr-ha-pg1 wr-ha-pg2 wr-ha-pg3 wr-ha-etcd1 wr-ha-etcd2 wr-ha-etcd3 wr-ha-lb wr-ha-client wr-ha-side
docker volume rm wr-ha-pg1 wr-ha-pg2 wr-ha-pg3
docker network rm wr-ha-net wr-ha-side
docker rmi wr-ha-patroni:1 wr-ha-pgclient:1 gcr.io/etcd-development/etcd:v3.7.2
كيف يجد التطبيق الرئيسي الجديد؟ Client Routing
في المختبر استخدمنا HAProxy، وهو أشهر طريقة، ولكنها ليست الوحيدة، والاختيار بينها يحدد كم ثانية يضيف التوجيه إلى زمن الانتقال، وكم نقطة فشل جديدة تضيفها:
- HAProxy مع فحص ال REST API: كما في المختبر، يعمل مع أي تطبيق وأي لغة، ويكتشف الرئيسي الجديد خلال ثانيتين، ولكن HAProxy نفسه أصبح نقطة فشل واحدة، فإما أن تضع منه نسختين مع عنوان عائم كما شرحنا في دليل Keepalived، أو أن تشغل HAProxy على كل سيرفر تطبيق ويتصل التطبيق بـ
localhost. - سلسلة اتصال بعدة عناوين: مكتبة libpq وأغلب المكتبات المبنية عليها تقبل عدة عناوين في السلسلة مع
target_session_attrs=read-write، فتجرب العناوين بالترتيب حتى تجد الذي يقبل الكتابة، وقد جربنا ذلك في دليل العناقيد. وهي طريقة لا تحتاج أي مكون إضافي، ولكنها لا تعرف مفتاح القائد، فقد تتصل بالرئيسي المعزول في تجربة العزل إذا وصلت إليه، وتعتمد على أن التطبيق يعيد الاتصال. - عنوان IP عائم يتبع القائد: أداة مثل vip-manager تراقب مفتاح القائد في etcd، وتضع عنواناً عائماً على السيرفر الذي يملكه، فيتصل التطبيق بعنوان واحد دائماً، وهي مناسبة عندما تكون السيرفرات في شبكة واحدة.
- مجمع اتصالات أمام الكل: مثل PgBouncer خلف HAProxy، وهو مفيد عندما يفتح التطبيق اتصالات كثيرة، ولكنه طبقة أخرى يجب أن تفهم سلوكها عند الانتقال، لأنها تحتفظ باتصالات مفتوحة إلى الرئيسي القديم.
وفي المختبر جهزنا أيضاً المنفذ 5001 للقراءة من النسخ، فالتقارير والبحث وصفحات المنتجات لا تحتاج الرئيسي، وإرسالها إلى النسخ يخفف الضغط عليه. ولكن تذكر ما شرحناه في دليل العناقيد عن المستخدم الذي لا يرى ما كتبه، فالنسخة قد تكون متأخرة عن الرئيسي ثوان، فلا ترسل إليها قراءة تأتي مباشرة بعد كتابة المستخدم نفسه، مثل صفحة «طلبك تم» بعد الدفع. ويقدم ال REST API مساراً يساعد هنا هو /replica?lag=1048576، فلا يرد بالرمز 200 إلا إذا كانت النسخة متأخرة أقل من الحد بالبايت، فإذا وضعته في فحص HAProxy على المنفذ 5001 أخرج الموزع النسخة المتأخرة من القراءة تلقائياً، وأعادها عندما تلحق. وإذا خرجت كل النسخ بسبب التأخر، فأرسل القراءة إلى الرئيسي بخيار backup في سطر سيرفر إضافي، بدلاً من أن تفشل صفحات المنتجات كلها.
وأياً كانت الطريقة، فالتطبيق يجب أن يعيد المحاولة عند أخطاء الانتقال، أي انقطاع الاتصال وcannot execute INSERT in a read-only transaction، مع مفتاح منع التكرار لكل طلب شراء، حتى لا يتحول الانتقال إلى طلبات مكررة أو صفحات خطأ.
قبل الإنتاج Production Checklist
المختبر يبين الآلية، والإنتاج يحتاج أشياء لا تظهر في المختبر، وهذه أهمها:
- الأماكن: ثلاثة سيرفرات etcd في ثلاثة أماكن تفشل بشكل مستقل، مثل ثلاث مناطق توفر، والسبب أن النصاب Quorum يحتاج اثنين من ثلاثة، فإذا كان اثنان منهم في المكان نفسه وتوقف هذا المكان توقف الانتقال كله.
- القرص: etcd على قرص منفصل عن قاعدة البيانات، كما رأيت في تحذير
slow fdatasync. - Watchdog: إذا علق Patroni نفسه، فقد يبقى PostgreSQL رئيسياً دون أن يجدد أحد المفتاح، والحل الذي يشرحه توثيق Watchdog أن يفعل Patroni جهاز Watchdog في Linux يعيد تشغيل السيرفر إذا لم يصله نبض في الوقت المحدد.
- النسخ الاحتياطي: العنقود لا يحميك من
DELETEالخاطئ ولا من الفدية، لأن الخطأ ينتقل إلى النسخ خلال ملي ثوان، فاستمر في النسخ الاحتياطي والاستعادة إلى أي لحظة كما في دليل pgBackRest، ويمكن أن تأخذ النسخة من إحدى النسخ لتخفف الضغط على الرئيسي. - المراقبة: ال REST API فيه المسار
/metricsبصيغة Prometheus، وأهم ما تنبه عليه: لا يوجد قائد، وتأخر النسخ عن الرئيسي بالبايت، وعدد الأعضاء أقل من ثلاثة، وأي تغيير في الخط الزمني Timeline، لأن كل تغيير فيه انتقال يجب أن تعرف سببه. - الصيانة: الأمر
patronictl pauseيوقف الانتقال التلقائي أثناء الصيانة اليدوية، فلا يقرر Patroni انتقالاً بينما أنت تعيد تشغيل شيء، ولا تنسpatronictl resumeبعدها. - التحديث: حدث النسخ أولاً واحدة بعد الأخرى، ثم انقل الدور بالأمر
switchoverإلى نسخة محدثة، ثم حدث الرئيسي القديم، فلا يتوقف المتجر إلا ثوان الانتقال المخطط. - اختبار الانتقال: كل ما في هذا المقال من أعطال يجب أن تكرره على عنقودك قبل أن تحتاجه، وهو موضوع مقال قادم في هذه المرحلة.
أخطاء شائعة Common Mistakes
- تشغيل PostgreSQL خارج Patroni: عبر systemd أو ال Image الأصلية، فيصبح لديك من يقرر غير Patroni، وتعود مشكلة انقسام الدماغ.
- تعديل
ttlفي ملف الإعداد: فلا يتغير شيء، لأن الإعداد المشترك في etcd هو المرجع بعد التهيئة، والصحيحpatronictl edit-config. - قيمة
ttlأقل من 20: فيرفعها Patroni بصمت، وتظن أن الانتقال أسرع مما هو. - تطبيق يتصل بسيرفر قاعدة البيانات مباشرة: فيكتب على الرئيسي المعزول، وتضيع كتاباته وتتكرر أرقامها.
- etcd بسيرفرين أو بأربعة: فالاثنان لا يتحملان توقف أي واحد، والأربعة تحتمل توقف واحد فقط مثل الثلاثة وتكلف أكثر.
- etcd على قرص القاعدة نفسه: فيبطئ ضغط الكتابة etcd، ويحدث انتقال لا داعي له.
- عدم إعادة المحاولة في التطبيق: فيتحول نصف ثانية من
read-only transactionفي كل انتقال إلى صفحات خطأ. - اعتبار العنقود نسخة احتياطية: فالحذف الخاطئ يصل إلى كل النسخ فوراً.
قائمة تحقق Checklist
| البند | كيف تتحقق منه |
|---|---|
| ثلاثة أعضاء etcd في ثلاثة أماكن | etcdctl endpoint status --cluster يعرض ثلاثة، وكل واحد في مكان مختلف |
| etcd على قرص سريع منفصل | لا توجد تحذيرات slow fdatasync في سجلاته |
| كل الكتابة عبر طريق يعرف القائد | لا يوجد تطبيق يتصل بعنوان سيرفر قاعدة البيانات مباشرة |
| المهلة مقاسة | زمن قتل الرئيسي في اختبار حقيقي، وليس القيمة في الإعداد |
| وضع النسخ مكتوب | غير متزامن مع قبول خسارة ثوان، أو متزامن مع ثمن كل كتابة مقاس |
| العودة بـ pg_rewind تعمل | use_pg_rewind مع wal_log_hints أو Data Checksums، ومجربة |
| Watchdog مفعل | رسالة تفعيل ال Watchdog في سجل Patroni عند التشغيل |
| التطبيق يعيد المحاولة | انتقال مخطط لا يظهر للمستخدم أي خطأ |
| تنبيه على تغيير الخط الزمني | كل انتقال يصل إلى المناوب مع سببه |
| النسخ الاحتياطي مستمر | استعادة إلى لحظة معينة مجربة على العنقود نفسه |
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- Patroni يشغل PostgreSQL على كل سيرفر، ومن يملك مفتاح القائد في etcd هو الرئيسي، وال REST API يخبر HAProxy بذلك عبر
/primary. - قتل الرئيسي فجأة أوقف الكتابة 30.7 ثانية، أي مدة
ttlتقريباً، دون أن يضيع طلب مؤكد، مع نصف ثانية من أخطاء القراءة فقط أثناء الترقية. - عاد الرئيسي القديم نسخة بالأداة pg_rewind دون نسخ القاعدة كلها، والانتقال المخطط Switchover أخذ 4.6 ثانية فقط.
- عزل الرئيسي مع عميل يكتب عليه مباشرة جعله يقبل الكتابة 26 ثانية، فضاع 262 طلباً مؤكداً وتكرر 235 رقماً، ومع النسخ المتزامن لم يضع شيء.
- أقل
ttlيقبله Patroni 20 ثانية، وهو يرفع القيمة الأقل بصمت، والانتقال المخطط هو الطريق إلى ثوان قليلة. - سكربت الترقية البسيط لا يعرف هل الرئيسي متوقف أم هو المعزول، والطرف الثالث بالأغلبية هو ما يجيب عن ذلك.
- ضع etcd على قرص منفصل، ووجه الكتابة دائماً عبر طريق يعرف القائد، واستمر في النسخ الاحتياطي، واختبر الانتقال قبل أن تحتاجه.
وفي المقال القادم من مرحلة التوفر العالي بإذن الله نرى الطريقة الأخرى: عنقود MariaDB Galera الذي تكتب فيه على كل السيرفرات، ونرى ماذا يفعل النصاب Quorum عندما تنقسم الشبكة.
 دليلعناقيد قواعد البيانات Database Clustering ومتى تحتاجهاماذا تعني كلمة Cluster في كل قاعدة بيانات، ومتى تحتاج نسخاً أو انتقالاً تلقائياً، ومتى يكفيك سيرفر واحد مع نسخ احتياطية جيدة.
 دليلمفاهيم التوفر العالي High Availability للمبتدئينماذا يعني أن تبقى خدمتك تعمل رغم تعطل جزء منها، وكيف تحسب التوفر وتجد نقاط الفشل الواحدة وتقرر متى يستحق ذلك تكلفته.
 دليلاستعادة PostgreSQL إلى أي لحظة مع pgBackRestكيف تأخذ نسخاً احتياطية من PostgreSQL مع أرشيف WAL، وتستعيد القاعدة إلى الثانية التي سبقت حذفاً خاطئاً.
 دليلعنوان IP عائم بين سيرفرين مع Keepalived وVRRPكيف ينقل Keepalived عنواناً واحداً بين سيرفرين تلقائياً عندما يتوقف أحدهما، مع تجربة حقيقية تقيس زمن الانتقال بالثواني.
 دليلالأنظمة الموزعة للمبتدئين: ماذا يحدث عندما تنقطع الشبكةلماذا تتصرف الأنظمة الموزعة بشكل غريب عند انقطاع الشبكة، وكيف تتفق السيرفرات على قرار واحد رغم ذلك.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة الدليل وتنفيذ المختبر على Patroni 4.1.5 وPostgreSQL 18.6 وetcd 3.7.2 وHAProxy 3.4.6 على Docker Engine 29.8.0.


