


في مقال Patroni رأينا العنقود الذي يكتب فيه سيرفر واحد فقط، والبقية نسخ تنتظر دورها، والانتقال يأخذ حوالي 30 ثانية في العطل المفاجئ. ونظام المخزون في المتجر نفسه مبني على MariaDB، وفريقه يسأل سؤالاً مختلفاً: لماذا ننتظر الانتقال أصلاً؟ لماذا لا تكون السيرفرات الثلاثة كلها رئيسية، فيكتب التطبيق على أي واحد منها، وإذا توقف واحد استمر الآخران دون أي انتقال؟ وهذا بالضبط ما يعد به MariaDB Galera Cluster، وهو مدمج في MariaDB منذ سنوات، ويكفي أن تفعله في ملف الإعداد. والوعد جذاب جداً، ولكن خلفه أسئلة يجب أن تعرف إجاباتها قبل أن تضع عليه المخزون: ماذا يحدث عندما يكتب سيرفران على الصنف نفسه في اللحظة نفسها؟ وهل يرى السيرفر الثالث الكتابة فوراً؟ ومن يستمر في الكتابة عندما تنقسم الشبكة؟ وكيف تعيد العنقود بعد أن تنقطع الكهرباء عن السيرفرات الثلاثة معاً؟
وقد عرضنا Galera باختصار في دليل عناقيد قواعد البيانات ضمن أشكال العناقيد التي يكتب فيها أكثر من سيرفر، وقارنا بين MySQL وMariaDB في مقال MySQL أم MariaDB، وفي هذا المقال نبني عنقوداً حقيقياً من ثلاث عقد MariaDB 11.8.9 ونجيب عن كل سؤال من هذه الأسئلة بتجربة.
وسوف نناقش في هذا المقال ما يلي:
- كيف يعمل النسخ القائم على التحقق Certification-Based Replication، ولماذا يسمى شبه متزامن Virtually Synchronous.
- النصاب Quorum والمكون الرئيسي Primary Component، وكيف يمنعان انقسام الدماغ، وانضمام العقد بالنسخ الكامل SST أو التزايدي IST.
- مختبر حقيقي: قراءة ما كتبته من عقدة أخرى، والتعارض عند الكتابة على صنف واحد من ثلاث عقد.
- عزل عقدة ثم عزل الجميع، مع ثلاث مشاكل حقيقية ظهرت أثناء إعادة العنقود.
- انقطاع الكهرباء عن العقد الثلاث، ثم الحالة الأصعب عندما يضيع قرص إحداها، وعنقود العقدتين مع الحكم Arbitrator.
- هل تكتب على كل العقد فعلاً، وحدود Galera، ومقارنة مع Patroni، وقائمة تحقق.
كيف يعمل Galera؟ Certification-Based Replication
في النسخ العادي يكتب الرئيسي، ثم يرسل التغييرات إلى النسخ بعد أن ينتهي، فالنسخة دائماً خلفه قليلاً، ولا تستطيع أن تكتب هي. أما Galera فيعمل بطريقة مختلفة تماماً يصفها توثيق النسخ القائم على التحقق، والصورة التالية تبينها لمعاملة واحدة:
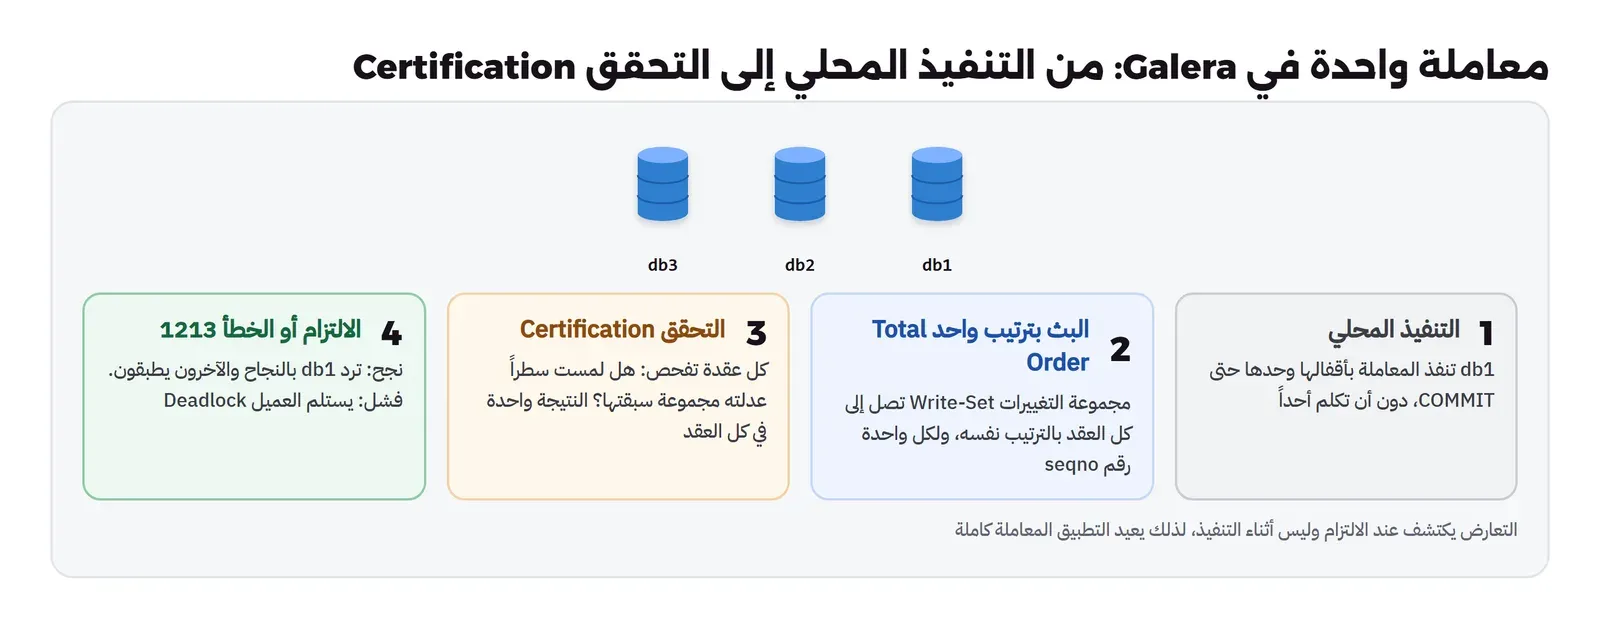
- التنفيذ المحلي: العقدة التي استقبلت المعاملة تنفذها وحدها، بأقفالها المحلية، دون أن تكلم أي عقدة أخرى، حتى يرسل العميل
COMMIT. - البث بترتيب واحد Total Order: عند
COMMITتجمع العقدة التغييرات ومفاتيح الأسطر التي لمستها في مجموعة واحدة اسمها Write-Set، وترسلها إلى كل العقد عبر طبقة اتصال جماعي تضمن أن كل العقد تستلم كل المجموعات بالترتيب نفسه تماماً، وكل مجموعة تأخذ رقماً تسلسلياً عالمياً اسمه seqno. - التحقق Certification: كل عقدة، بما فيها العقدة الأصلية، تفحص المجموعة: هل لمست سطراً عدلته مجموعة سبقتها في الترتيب ولم تكن العقدة الأصلية قد رأتها عند التنفيذ؟ وبما أن الترتيب واحد والقاعدة واحدة، فكل العقد تصل إلى النتيجة نفسها دون أن تتبادل أي رسالة إضافية.
- الالتزام أو الإلغاء: إذا نجح التحقق ترد العقدة الأصلية على العميل بالنجاح، والعقد الأخرى تطبق التغيير. وإذا فشل ألغت العقدة الأصلية المعاملة، ويستلم العميل الخطأ 1213
Deadlock found when trying to get lock، مع أنه لم يحدث أي قفل في عقدته أصلاً.
والنتيجة المهمة لهذا التصميم أن التعارض لا يكتشف أثناء التنفيذ كما في قاعدة واحدة، حيث تنتظر المعاملة الثانية قفل الأولى، وإنما عند الالتزام، أي بعد أن ينفذ التطبيق كل شيء. لذلك يجب أن يعيد التطبيق المعاملة كاملة عند هذا الخطأ، وسوف ترى في المختبر كم مرة يحدث ذلك عندما يكتب الجميع على الصنف نفسه.
من أين جاء Galera؟ History
Galera ليس جزءاً من كود MariaDB نفسه، وإنما مكتبة مستقلة اسمها wsrep provider، طورتها شركة Codership، وتتكلم مع قاعدة البيانات عبر واجهة اسمها wsrep API، أي Write-Set Replication. وMariaDB تأتي بها جاهزة وتحمل الواجهة في الخادم نفسه، لذلك لا تحتاج إلا ملف الإعداد الذي سوف تراه، أما مع MySQL الأصلي فتحتاج نسخة معدلة من الخادم تدعم الواجهة، مثل Percona XtraDB Cluster. وفي عالم MySQL هناك حل آخر بالفكرة نفسها تقريباً هو Group Replication الذي يقوم عليه InnoDB Cluster، وقد ذكرناه في دليل العناقيد. والفكرة المشتركة بينهما أن الاتفاق على ترتيب المعاملات يحدث داخل العنقود نفسه عبر بروتوكول اتصال جماعي، وليس عبر مخزن خارجي كما في Patroni، ولهذا لا يحتاج Galera سيرفرات etcd، ولكنه يحتاج أن تكون العقد نفسها ثلاثاً على الأقل، لأنها هي التي تصوت.
شبه متزامن Virtually Synchronous: ماذا يعني لك؟
يسمي Galera نفسه متزامناً، والكلمة الأدق في توثيقه هي شبه متزامن Virtually Synchronous، والفرق مهم جداً للتطبيق. فالجزء المتزامن هو أن كل عقدة استلمت مجموعة التغييرات وتحققت منها قبل أن يرد الالتزام على العميل، فلا يمكن أن تضيع كتابة أكدتها عقدة لأن العقد الأخرى تملكها. أما تطبيق التغيير على الجداول في العقد الأخرى فيحدث بعد ذلك بشكل غير متزامن، أي أن هناك لحظة قصيرة يكون فيها الطلب مؤكداً على db1، ولكن من يقرأ من db3 لا يراه بعد. والإعداد الذي يتحكم في ذلك هو wsrep_sync_wait، فإذا فعلته على جلسة القراءة انتظرت القراءة حتى تطبق العقدة كل ما سبقها في الترتيب العالمي، ثم تقرأ، وسوف نقيس ثمنه بالملي ثانية.
النصاب Quorum: من يبقى يكتب عند انقسام الشبكة؟
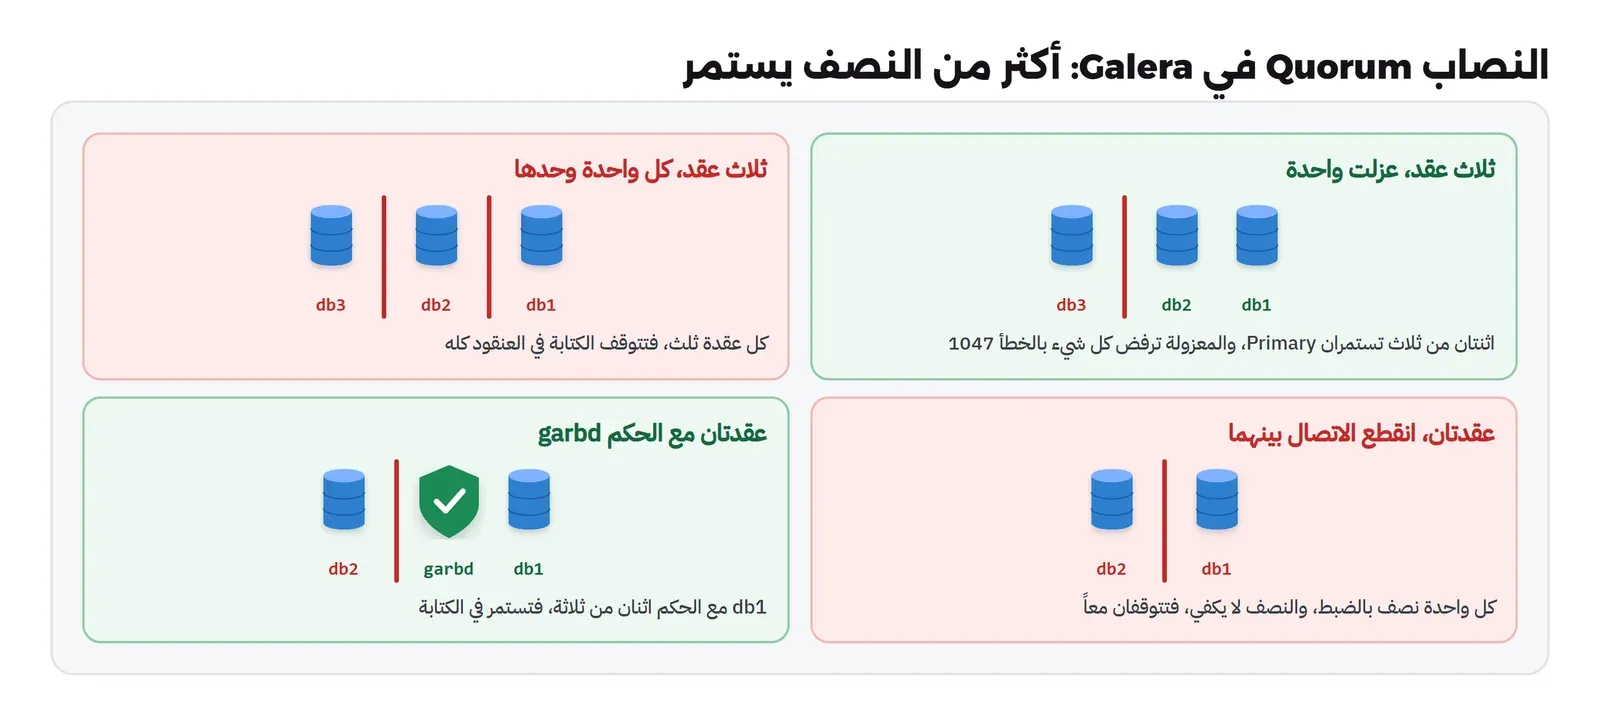
عندما تنقسم الشبكة، تحسب كل مجموعة من العقد التي ما زالت ترى بعضها وزنها من آخر مكون رئيسي Primary Component كانت فيه، فإذا كان وزنها أكثر من النصف استمرت كمكون رئيسي يقبل القراءة والكتابة، وإذا كان النصف أو أقل أصبحت مكوناً غير رئيسي Non-Primary، وترفض كل الأوامر تقريباً، كما يشرح توثيق النصاب الموزون. ولاحظ كلمة «أكثر من النصف»، فالنصف بالضبط لا يكفي، وهذا ما يجعل عنقود العقدتين خطيراً كما سوف ترى، فإذا انقطع الاتصال بينهما فكل واحدة منهما تملك النصف، فتتوقف الاثنتان معاً. والمهم أيضاً أن العقدة التي تخرج بشكل سليم، أي تغلق نفسها وتخبر الآخرين، تخرج من الحساب، فلا تحسب ضمن الغائبين، أما العقدة التي تختفي فجأة فتبقى في المقام حتى يقرر العنقود أنها غائبة.
انضمام عقدة: SST أم IST؟
العقدة التي تنضم إلى العنقود، أو تعود إليه بعد غياب، تحتاج أن تصل إلى حالة الآخرين، وهناك طريقتان يشرحهما توثيق تجهيز العقد. الأولى النقل الكامل SST (State Snapshot Transfer)، حيث تختار العقدة عقدة مانحة Donor تنسخ منها قاعدة البيانات كاملة، وفي MariaDB الطريقة الشائعة هي mariabackup التي تنسخ الملفات والمانحة تعمل، والثانية النقل التزايدي IST (Incremental State Transfer)، حيث تأخذ العقدة العائدة فقط مجموعات التغييرات التي فاتتها، من ذاكرة مؤقتة على القرص في كل عقدة اسمها GCache. والفرق بينهما في عنقود كبير هو الفرق بين دقائق وساعات، فإذا غابت العقدة مدة أطول مما تحفظه GCache من تغييرات احتاجت SST كاملاً، والعقدة المانحة تكون مشغولة أثناءه، لذلك اجعل حجم GCache يكفي غياب صيانة عادية، وهو 128 MB افتراضياً، وسوف ترى في المختبر عودة بالطريقتين.
المختبر Lab: ثلاث عقد MariaDB Galera
المختبر ثلاث Containers من ال Image الرسمية mariadb:11.8.9، وهي تحتوي مكتبة Galera وأداة mariabackup جاهزة، وعميل Python فيه مكتبة PyMySQL فقط. وكل العقد على شبكة Docker واحدة، ونقطع الشبكة عن أي عقدة بالأمر docker network disconnect.
ملفات المختبر Lab Files
الإعداد واحد لكل العقد، واحفظه باسم galera.cnf:
# Galera settings shared by the three nodes; node name and address come from the command line
[mysqld]
binlog_format            = ROW
default_storage_engine   = InnoDB
innodb_autoinc_lock_mode = 2
wsrep_on                 = ON
wsrep_provider           = /usr/lib/galera/libgalera_smm.so
wsrep_cluster_name       = shop
wsrep_cluster_address    = gcomm://wr-ha-db1,wr-ha-db2,wr-ha-db3
wsrep_sst_method         = mariabackup
wsrep_sst_auth           = root:lab-only-pass
في الإعداد أعلاه لاحظ التالي:
binlog_format = ROWوinnodb_autoinc_lock_mode = 2شرطان في دليل البدء من MariaDB، والسبب أن Galera ينسخ الأسطر التي تغيرت وليس الأوامر، وأن قفل الترقيم التلقائي بالطريقة القديمة لا يعمل مع التنفيذ المتوازي للمجموعات.wsrep_cluster_addressفيه أسماء العقد الثلاث، وكل عقدة تحاول الاتصال بأي منها عند التشغيل، وسوف ترى لاحقاً أن العنوان الذي تحفظه العقد لبعضها أثناء العمل هو عنوان IP وليس الاسم.wsrep_sst_authالمستخدم الذي تستخدمهmariabackupفي العقدة المانحة، وفي الإنتاج أنشئ له مستخدماً خاصاً بالصلاحيات التي يحتاجها فقط بدلاً من root.
ونشغل العقدة الأولى بالخيار --wsrep-new-cluster، وهو الذي يقول لها: لا تبحث عن عنقود، وإنما أنشئ واحداً جديداً، ثم العقدتين الأخريين دونه:
export MSYS_NO_PATHCONV=1
docker network create wr-ha-net
run() { docker run -d --name wr-ha-db$1 --hostname db$1 --network wr-ha-net -e MARIADB_ROOT_PASSWORD=lab-only-pass \
  -v "$(pwd -W)/galera.cnf:/etc/mysql/conf.d/galera.cnf:ro" -v wr-ha-db$1:/var/lib/mysql mariadb:11.8.9 \
  --wsrep-node-name=db$1 --wsrep-node-address=wr-ha-db$1 ${2:-}; }
run 1 --wsrep-new-cluster; sleep 20
run 2; sleep 25; run 3; sleep 50
ولكي نرى حالة العقد ونجرب الكتابة على كل واحدة منها، نستخدم في كل التجارب سكربتاً صغيراً باسم state.sh:
#!/bin/sh
# Print cluster size, status and node state on each running node, then try one write on each.
for i in 1 2 3; do
  docker exec wr-ha-db$i mariadb -uroot -plab-only-pass -N -e "select 'db$i', group_concat(variable_value order by variable_name separator ' ') from information_schema.global_status where variable_name in ('wsrep_cluster_size','wsrep_cluster_status','wsrep_local_state_comment')" 2>&1 | tr '\t' ' '
  docker exec wr-ha-db$i mariadb -uroot -plab-only-pass -e "insert into shop.orders(node, amount) values ('db$i', 1)" 2>&1 | sed "s/^/  db$i write: /" | head -1
done
وأثناء انضمام العقدة الثالثة ظهرت هذه الأسطر في سجلها، وهي SST كامل من عقدة مانحة، لأن العقدة جديدة وليس لديها أي بيانات:
2:34:13 0 [Note] WSREP: SST received: 3408559c-d8c1-11f1-9fdb-6a6ec959b7fd:3
2:34:13 0 [Note] WSREP: SST succeeded for position 3408559c-d8c1-11f1-9fdb-6a6ec959b7fd:3
2:34:13 2 [Note] WSREP: Synchronized with group, ready for connections
والرقم بعد النقطتين هو seqno، أي رقم آخر مجموعة تغييرات في الترتيب العالمي، والسلسلة قبله هي معرف العنقود UUID. ثم ننشئ الجداول على db1، وهي تظهر على العقد الأخرى فوراً لأن أوامر تعريف البيانات DDL تنفذ في Galera على كل العقد بالترتيب نفسه:
create database shop;
create table shop.orders (id bigint auto_increment primary key, node varchar(8), amount int, created_at datetime(6) default now(6));
create table shop.stock (sku int primary key, qty int not null);
insert into shop.stock values (1, 1000000);
db1 3 Primary Synced
db2 3 Primary Synced
db3 3 Primary Syncedوالأعمدة الثلاثة هي عدد العقد في العنقود، وحالة المكون Primary، وحالة العقدة نفسها Synced، أي أنها متزامنة وتقبل العمل.
هل ترى db3 ما كتبته على db1؟ Read After Write
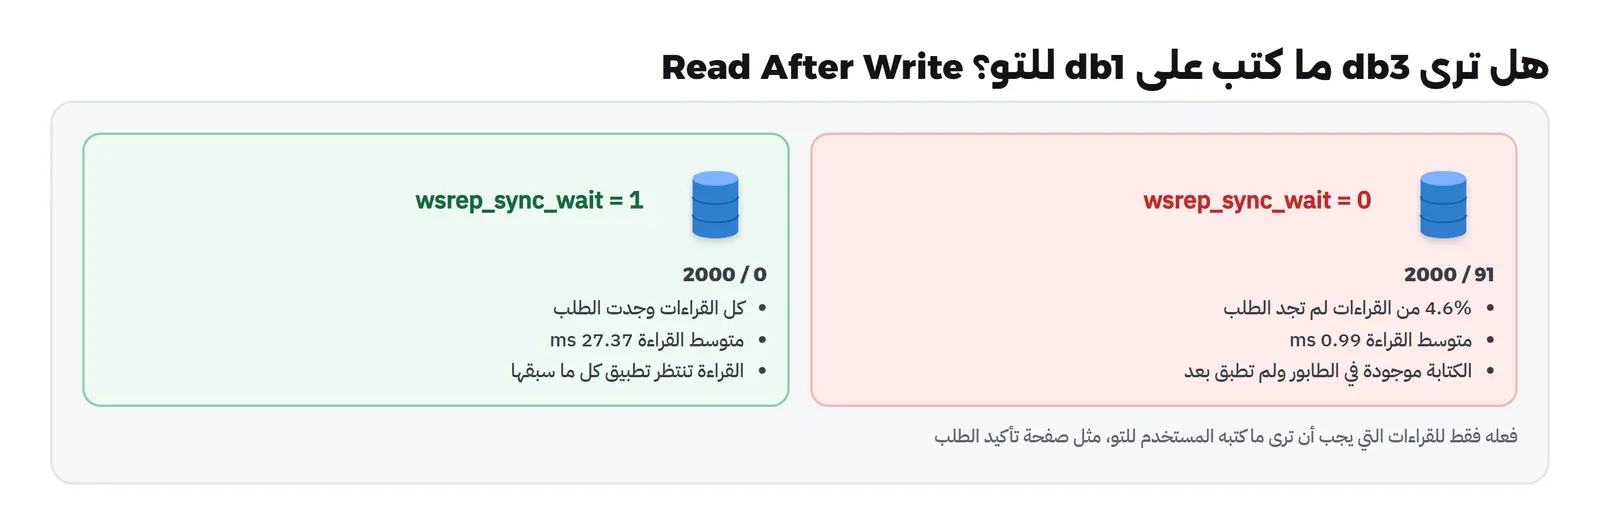
أول سؤال نختبره هو معنى «شبه متزامن». السكربت التالي يكتب طلباً على db1، ثم يقرأه فوراً من db3، ألفي مرة، مرة دون wsrep_sync_wait ومرة معه، ويعد كم مرة لم تجد db3 الطلب. احفظه باسم readafter.py:
# Read-your-write across nodes: insert on db1, then at once look for the row on db3, N times,
# with wsrep_sync_wait off and on. Counts how often db3 had not applied the write yet.
import pymysql, sys, time
N = int(sys.argv[1]) if len(sys.argv) > 1 else 2000
conn = lambda h: pymysql.connect(host=h, user="root", password="lab-only-pass", database="shop", autocommit=True)
w, r = conn("wr-ha-db1"), conn("wr-ha-db3")
for wait in (0, 1):
r.cursor().execute(f"set session wsrep_sync_wait = {wait}")
miss, t_read = 0, 0.0
for i in range(N):
c = w.cursor(); c.execute("insert into orders(node, amount) values ('db1', 150)"); oid = c.lastrowid
t0 = time.perf_counter(); c2 = r.cursor(); c2.execute("select count(*) from orders where id = %s", (oid,)); n = c2.fetchone()[0]
t_read += time.perf_counter() - t0
miss += (n == 0)
print(f"wsrep_sync_wait={wait}: {miss} of {N} reads on db3 did not see the row just written on db1; avg read {t_read / N * 1000:.2f} ms")docker run -d --name wr-ha-client --network wr-ha-net -v "$(pwd -W):/lab" -w /lab wr-ha-myclient:1 sleep infinity
docker exec wr-ha-client python readafter.py 2000والمخرج سوف يكون كما يلي:
wsrep_sync_wait=0: 91 of 2000 reads on db3 did not see the row just written on db1; avg read 0.99 ms
wsrep_sync_wait=1: 0 of 2000 reads on db3 did not see the row just written on db1; avg read 27.37 msفي 91 مرة من ألفين، أي 4.6%، قرأ العميل من db3 بعد أن أكدت له db1 الكتابة، فلم يجد ما كتبه. وهذه بالضبط مشكلة «المستخدم الذي لا يرى ما كتبه» التي رأيناها في النسخ العادي، مع فرق أن الكتابة هنا لم تضع، فهي موجودة في db3 في الطابور وتنتظر التطبيق. ومع wsrep_sync_wait=1 لم تفشل أي قراءة، ولكن متوسط القراءة ارتفع من أقل من ملي ثانية إلى 27 ملي ثانية، لأن كل قراءة تنتظر حتى تطبق db3 كل ما سبقها في الترتيب العالمي. وهذا الرقم يكبر مع الضغط Load، فكلما زادت الكتابة طال الطابور الذي تنتظره القراءة، فلا تعتبر 27 ملي ثانية ثمناً ثابتاً، وإنما قسه في ذروة نظامك. وله أثر خفي على الذاكرة المؤقتة أيضاً: إذا كان التطبيق يكتب على db1 ثم يمسح مفتاح الذاكرة المؤقتة، وجاء طلب آخر يقرأ من db3 قبل أن تطبق التغيير، فسوف يعيد ملء الذاكرة المؤقتة بالقيمة القديمة، وتبقى قديمة حتى تنتهي صلاحيتها، وهذه مشكلة لا تظهر في الاختبار وتظهر في الذروة. والقرار العملي: لا تفعل الإعداد على كل الجلسات، وإنما فقط على القراءات التي يجب أن ترى ما كتبه المستخدم للتو، مثل صفحة تأكيد الطلب، أو وجه القراءة والكتابة للمستخدم الواحد إلى العقدة نفسها.
الكتابة على الصنف نفسه من ثلاث عقد Write Conflicts
الآن السؤال الثاني: ماذا يحدث عندما يبيع الجميع الصنف نفسه في اللحظة نفسها، كما يحدث مع منتج عليه عرض؟ السكربت التالي يشغل ستة عملاء ينقصون كمية الصنف 1 لمدة 20 ثانية، موزعين على العقد التي تعطيها له، ويعد الالتزامات الناجحة والأخطاء. احفظه باسم hotrow.py:
# Write conflicts: THREADS clients update the same stock row (sku 1) for SECONDS,
# spread over the nodes given on the command line. Counts commits and certification failures.
import pymysql, sys, threading, time, collections
nodes, THREADS, SECONDS = sys.argv[1].split(","), int(sys.argv[2]), float(sys.argv[3])
ok, err, lock = collections.Counter(), collections.Counter(), threading.Lock()
def worker(i):
host = nodes[i % len(nodes)]
c = pymysql.connect(host=host, user="root", password="lab-only-pass", database="shop", autocommit=True)
end = time.time() + SECONDS
while time.time() < end:
try:
c.cursor().execute("update stock set qty = qty - 1 where sku = 1")
with lock: ok[host] += 1
except pymysql.err.OperationalError as e:
with lock: err[(host, e.args[0])] += 1
ts = [threading.Thread(target=worker, args=(i,)) for i in range(THREADS)]
[t.start() for t in ts]; [t.join() for t in ts]
total = sum(ok.values()); fails = sum(err.values())
print(f"nodes {','.join(nodes)}: {total} commits ({total / SECONDS:.0f}/s), {fails} failed ({fails / max(1, total + fails) * 100:.1f}%)")
for k, v in sorted(err.items()): print(f" {k[0]} error {k[1]}: {v}")docker exec wr-ha-client python hotrow.py wr-ha-db1 6 20
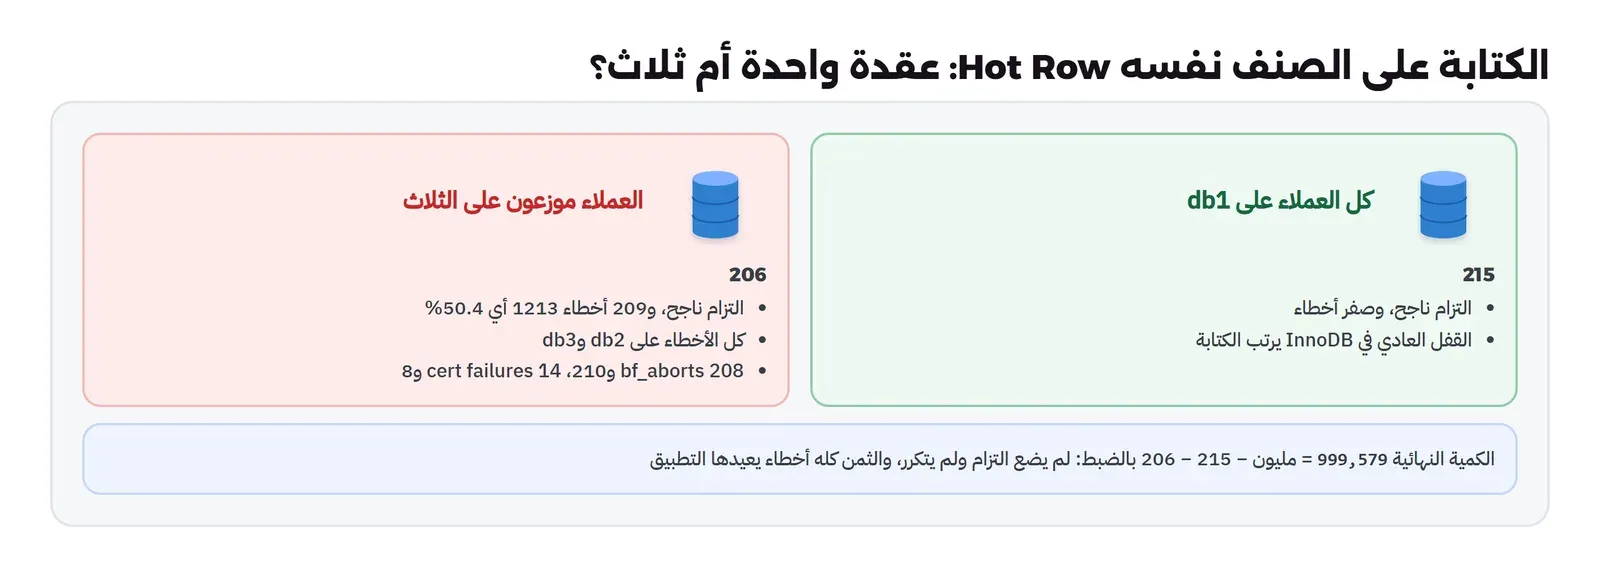
docker exec wr-ha-client python hotrow.py wr-ha-db1,wr-ha-db2,wr-ha-db3 6 20nodes wr-ha-db1: 215 commits (11/s), 0 failed (0.0%)
nodes wr-ha-db1,wr-ha-db2,wr-ha-db3: 206 commits (10/s), 209 failed (50.4%)
wr-ha-db2 error 1213: 104
wr-ha-db3 error 1213: 105عندما كتب العملاء الستة على db1 وحدها لم يفشل أي التزام، لأن التعارض داخل عقدة واحدة يحله القفل العادي في InnoDB: ينتظر العميل الثاني حتى ينتهي الأول ثم ينفذ. وعندما توزعوا على العقد الثلاث فشلت 209 محاولة من 415، أي أكثر من النصف، كلها بالخطأ 1213، ولم يرتفع عدد الالتزامات الناجحة، بل نزل قليلاً. أي أن الكتابة على كل العقد لم تزد السرعة إطلاقاً في هذه الحالة، وإنما حولت نصف العمل إلى أخطاء يجب أن يعيدها التطبيق. وعدادات Galera نفسها تشرح ما حدث:
db1 wsrep_last_committed=4450 wsrep_local_cert_failures=0 wsrep_local_bf_aborts=0
db2 wsrep_last_committed=4450 wsrep_local_cert_failures=14 wsrep_local_bf_aborts=208
db3 wsrep_last_committed=4450 wsrep_local_cert_failures=8 wsrep_local_bf_aborts=210والعداد wsrep_local_cert_failures يعد المعاملات التي فشلت في التحقق عند الالتزام، وwsrep_local_bf_aborts يعد المعاملات المحلية التي ألغتها مجموعة تغييرات قادمة من عقدة أخرى بالقوة Brute Force Abort، لأن المجموعة القادمة أخذت ترتيبها قبلها وتحتاج القفل نفسه. وفي هذا التشغيل كانت كل الخسائر على db2 وdb3 ولا شيء على db1، أي أن معاملات db1 كانت تصل إلى الترتيب العالمي أولاً في كل مرة تقريباً، وهذا يبين أن من يخسر في التعارض ليس عشوائياً، وقد يكون دائماً العقدة نفسها، فيرى المستخدمون المتصلون بها أخطاء أكثر من غيرهم. والتطبيق الذي يعمل على Galera يجب أن يتعامل مع الخطأ 1213 كأنه طلب طبيعي لإعادة المحاولة: يعيد المعاملة كاملة من بدايتها، بعد انتظار قصير عشوائي حتى لا تتصادم المحاولات مرة أخرى، وبحد أقصى لعدد المحاولات، مع مفتاح منع التكرار للعمليات التي لا يجب أن تتكرر مثل خصم المبلغ. والكمية في النهاية 999,579، أي مليون ناقص 215 ناقص 206 بالضبط، فالعنقود لم يخسر أي التزام ولم يكرر أي واحد، والثمن كله كان في الأخطاء.
نعزل عقدة واحدة Isolate One Node
الآن نختبر النصاب. نقطع db3 عن الشبكة وننتظر 25 ثانية:
docker network disconnect wr-ha-net wr-ha-db3; sleep 25; sh state.sh
docker exec wr-ha-db3 mariadb -uroot -plab-only-pass -e "select count(*) from shop.orders"db1 2 Primary Synced
db2 2 Primary Synced
db3 1 non-Primary Initialized
ERROR 1047 (08S01) at line 1: WSREP has not yet prepared node for application use
2:41:05 0 [Note] WSREP: evs::proto(...) suspecting node: 2f4088c8-aee5
2:41:06 0 [Note] WSREP: view(view_id(NON_PRIM,2f4088c8-aee5,3) memb {
2:41:06 0 [Note] WSREP: Received NON-PRIMARY.العقدتان db1 وdb2 تريان بعضهما، فهما اثنتان من ثلاث، فاستمرتا مكوناً رئيسياً بحجم 2 وتقبلان الكتابة. أما db3 فأصبحت وحدها ثلثاً، فأصبحت non-Primary، ورفضت حتى القراءة البسيطة بالخطأ 1047. وهذا هو الشيء الذي يميز Galera عن النسخ العادي: العقدة المعزولة لا تقبل أي كتابة، فلا يوجد انقسام دماغ ولا كتابات تضيع كما رأينا في تجربة عزل الرئيسي مع Patroni دون النسخ المتزامن. والسطر suspecting node جاء بعد 6 ثوان من القطع، وهو evs.suspect_timeout وقيمته الافتراضية 5 ثوان. ويمكن أن تقرأ من العقدة المعزولة إذا أردت ذلك بوعي، بتفعيل wsrep_dirty_reads على الجلسة، فتقرأ بيانات قد تكون قديمة.
ولكن ماذا رأى من يكتب على db1 أثناء العزل؟ أعدنا التجربة وعميل يكتب طلباً كل 100 ملي ثانية على db1، ويطبع كل فجوة أكبر من ثانية بين التزامين ناجحين، والفجوة الأكبر كانت هذه:
02:43:57 isolate db3
gap 6.8 s from 02:43:59 UTC
wr-ha-db1: 168 commits, 0 errors, longest gap between commits 6.8 s starting 02:43:59 UTC
2:44:05 0 [Note] WSREP: evs::proto(...) suspecting node
2:44:05 0 [Note] WSREP: view(view_id(PRIM,2f4088c8-aee5,8) memb {أي أن الكتابة على db1 نفسها توقفت 6.8 ثانية دون أي خطأ، حتى قرر العنقود أن db3 غائبة وشكل مكوناً رئيسياً جديداً في 02:44:05. والسبب أن كل التزام يحتاج أن تستلمه كل العقد في المكون الحالي، وdb3 ما زالت فيه حتى يعلن غيابها، فينتظر الالتزام. وهذا يعني أن Galera لا يخلو من توقف الكتابة عند العطل كما يبدو من الوعد، وإنما التوقف أقصر بكثير من انتقال Patroni، وهو مدة اكتشاف الغياب فقط.
وقد يتساءل البعض: لماذا لا نقصر evs.suspect_timeout إلى ثانية واحدة فيصبح التوقف ثانية؟ والإجابة هي نفسها التي رأيناها مع ttl في Patroni: المهلة القصيرة تجعل كل تأخر قصير في الشبكة، أو توقف قصير في القرص كما يحدث تحت الضغط، سبباً لإخراج عقدة سليمة من العنقود، ثم عودتها بنقل تزايدي أو كامل، وكل خروج وعودة يوقف الكتابة ثوان أخرى. لذلك اترك القيم الافتراضية، إلا إذا كانت شبكتك بين العقد مستقرة جداً وقست ذلك، وغير قيمة واحدة في كل مرة وراقب عدد مرات تغير المكون بعدها.
وعندما أعدنا db3 إلى الشبكة عادت وحدها، وفي سجلها ظهر النقل التزايدي، لأن ما فاتها موجود في GCache عند الآخرين:
2:41:51 2 [Note] WSREP: Receiving IST: 4 writesets, seqnos 4454-4457نعزل الجميع، ثم ثلاث مشاكل في الإعادة Total Partition
الآن الحالة الأسوأ في الشبكة: كل عقدة وحدها. قطعنا db1 عن الآخرين، فبقيت db2 وdb3 مكوناً رئيسياً بحجم 2، ثم قطعنا db3، فأصبحت db2 وحدها نصف آخر مكون كانت فيه:
db1 1 non-Primary Initialized
db2 1 non-Primary Initialized
db3 1 non-Primary Initialized
db1 last_committed 4775
db2 last_committed 4778
db3 last_committed 4778العنقود كله متوقف، ولا عقدة تقبل الكتابة، وهذا هو السلوك الصحيح، لأن لا أحد يملك أغلبية. ولاحظ أن db1 متأخرة بثلاث مجموعات عن db2 وdb3، لأنها عزلت أولاً، فإذا قررت أن تعيد العنقود يدوياً من عقدة واحدة فيجب أن تختار الأكثر تقدماً، وإلا ضاعت هذه المجموعات الثلاث. والطريقة الموثقة لذلك أن تقول لعقدة واحدة إنها المكون الرئيسي بالخيار pc.bootstrap، ففعلنا ذلك على db2:
set global wsrep_provider_options='pc.bootstrap=YES'
ERROR 1210 (HY000) at line 1: wsrep_provider_options cannot be changed while the wsrep-provider plugin is loadedوهذه أول مشكلة واجهتنا: الأمر الذي تجده في أغلب الأدلة والإجابات لا يعمل في MariaDB 11.8. والسبب أن MariaDB أصبحت تحمل مزود Galera كإضافة Plugin اسمها wsrep_provider، وتعرض كل خيار من خياراته كمتغير مستقل، فبحثنا عنه:
docker exec wr-ha-db2 mariadb -uroot -plab-only-pass -N -e "show variables like 'wsrep_provider_pc%'"wsrep_provider_pc_bootstrap OFF
wsrep_provider_pc_ignore_quorum OFF
wsrep_provider_pc_ignore_sb OFF
wsrep_provider_pc_recovery ON
wsrep_provider_pc_weight 1فأصبح الأمر الصحيح set global wsrep_provider_pc_bootstrap = ON، وبعده أصبحت db2 وحدها 1 Primary Synced تقبل الكتابة. ثم أعدنا db1 وdb3 إلى الشبكة، وهنا المشكلة الثانية: بعد 75 ثانية كانت db1 وdb3 قد شكلتا مكوناً غير رئيسي بحجم 2، ولم تنضما إلى db2 أبداً، وفي سجل db1 سطر يتكرر كل ثانية ونصف:
WSREP: (2f4088c8-aee5, 'tcp://0.0.0.0:4567') Found matching local endpoint for a connection, blacklisting address tcp://172.20.0.3:4567
WSREP: (2f4088c8-aee5, 'tcp://0.0.0.0:4567') reconnecting to 3c728d54-bce0 (tcp://172.20.0.3:4567), attempt 90والسبب أن Docker أعطى العقد عناوين IP جديدة عندما أعدنا ربطها بالشبكة بترتيب مختلف، فأصبح العنوان 172.20.0.3 الذي كان لـ db2 هو عنوان db1 نفسها، وGalera يحفظ عناوين الأعضاء التي عرفها أثناء العمل، وليس الأسماء التي في wsrep_cluster_address، فبقيت db1 تحاول الاتصال بـ db2 على عنوان أصبح عنوانها هي، فتجده نفسها وتضعه في القائمة السوداء. وهذا ليس خاصاً بالمختبر، فأي سيرفر يعاد بناؤه أو يأخذ عنوانه من DHCP قد يقع فيه، لذلك أعط عقد Galera عناوين ثابتة، وإذا رأيت هذا السطر فأعد تشغيل العقدة حتى تقرأ الأسماء من جديد.
فأعدنا تشغيل db1 وdb3، فعادت db3، أما db1 فلم تقلع أصلاً، وهذه المشكلة الثالثة:
WSREP: Found saved state: 3408559c-d8c1-11f1-9fdb-6a6ec959b7fd:4782, safe_to_bootstrap: 0
WSREP: Connecting with bootstrap option: 1
[ERROR] WSREP: It may not be safe to bootstrap the cluster from this node. It was not the last one to leave the cluster and may not contain all the updates. To force cluster bootstrap with this node, edit the grastate.dat file manually and set safe_to_bootstrap to 1 .
[ERROR] Abortingوالسطر الثاني هو المفتاح: bootstrap option: 1، أي أن db1 حاولت أن تنشئ عنقوداً جديداً، والسبب أن ال Container أنشئ في البداية بالخيار --wsrep-new-cluster، وهذا الخيار ما زال في أمر تشغيله، فكل إعادة تشغيل له هي محاولة إنشاء عنقود جديد. ولحسن الحظ رفض Galera ذلك، لأن الملف grastate.dat يقول safe_to_bootstrap: 0، أي أن هذه العقدة لم تكن آخر من غادر، فقد لا تملك كل التغييرات، ولو قبل لأصبح لدينا عنقودان منفصلان بالمعرف نفسه. وهذا خطأ شائع جداً في الإنتاج أيضاً: خيار الإنشاء في ملف الخدمة أو في ال Compose يبقى بعد أن ينتهي دوره. والحل أن تنشئ ال Container من جديد بالقرص نفسه دون الخيار، فانضمت db1 وأصبح العنقود ثلاثياً مرة أخرى.
انقطاع الكهرباء عن الجميع Full Cluster Crash
الآن العطل الذي يخافه كل من يدير Galera: انقطاع الكهرباء عن العقد الثلاث في اللحظة نفسها، أثناء الكتابة. قتلنا ال Containers الثلاث بالأمر docker kill وعميل يكتب على db2، ثم قرأنا ملف الحالة في كل عقدة:
docker kill wr-ha-db1 wr-ha-db2 wr-ha-db3
for i in 1 2 3; do docker run --rm -v wr-ha-db$i:/d alpine:3.24 grep -E "seqno|safe" /d/grastate.dat; doneseqno: -1
safe_to_bootstrap: 0
seqno: -1
safe_to_bootstrap: 0
seqno: -1
safe_to_bootstrap: 0والقيمة -1 تعني أن العقدة لم تغلق بشكل سليم فلم تكتب موقعها، وكل العقد safe_to_bootstrap: 0. والأدلة القديمة تقول إنك هنا يجب أن تجد العقدة الأكثر تقدماً يدوياً وتنشئ منها العنقود، ولكننا شغلنا db1 وحدها أولاً، فبقيت non-primary تنتظر، ثم شغلنا db2 وdb3، فعاد العنقود وحده خلال ثوان، وفي سجل db2:
WSREP: Found saved state: 3408559c-d8c1-11f1-9fdb-6a6ec959b7fd:-1, safe_to_bootstrap: 0
WSREP: Connecting with bootstrap option: 0
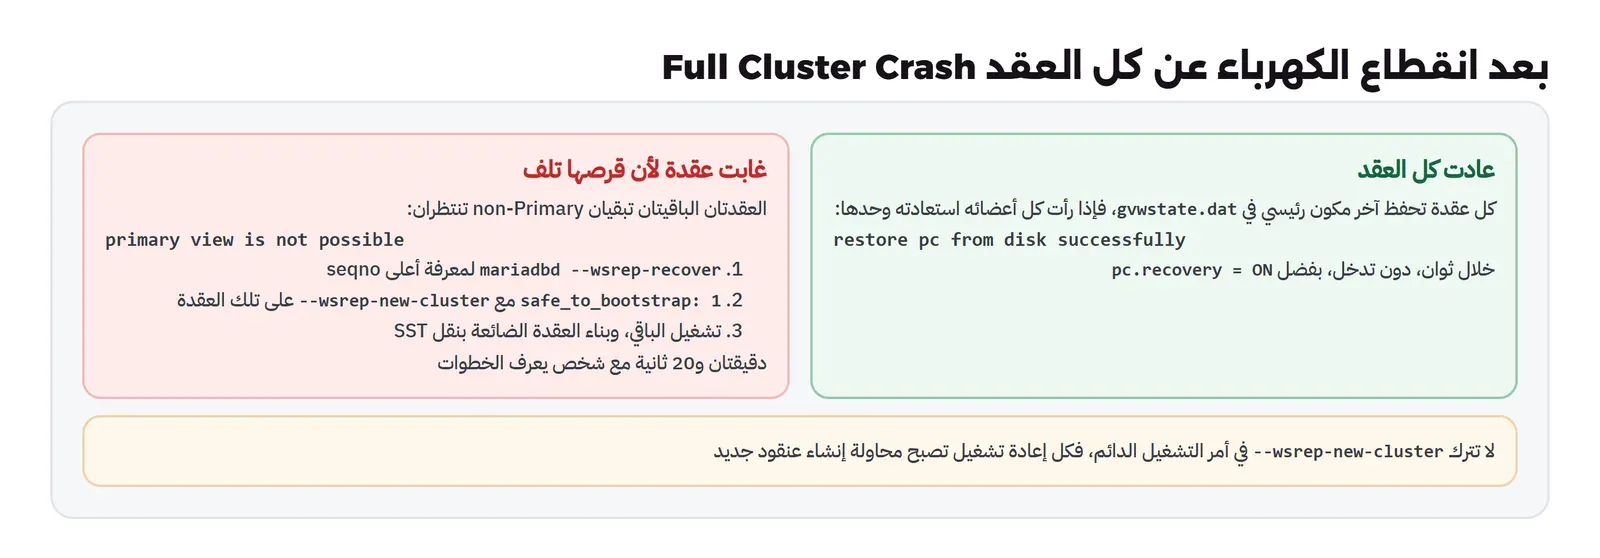
WSREP: restore pc from disk successfully
db1 3 Primary Synced
db2 3 Primary Synced
db3 3 Primary Syncedوالسبب هو الخيار pc.recovery، وهو مفعل افتراضياً كما رأيت في قائمة المتغيرات، فكل عقدة تحفظ آخر مكون رئيسي كانت فيه في الملف gvwstate.dat، فإذا عاد كل أعضاء هذا المكون ورأوا بعضهم، استعادوه دون تدخل، كما يشرح توثيق التعافي من التعطل. أي أن انقطاع الكهرباء عن الجميع ثم عودتهم جميعاً لا يحتاج شخصاً.
ماذا لو ضاع قرص إحدى العقد؟ What If
ولكن pc.recovery يحتاج أن يعود كل الأعضاء، فماذا لو انقطعت الكهرباء ولم يعد أحد السيرفرات، لأن قرصه تلف؟ كررنا القتل، ثم حذفنا db3 مع قرصها، وشغلنا db1 وdb2 فقط. وبعد دقيقتين كانتا ما زالتا تنتظران، لا تقبلان حتى اتصال العميل، وفي سجل db1:
WSREP: No nodes coming from primary view, primary view is not possible
WSREP: New COMPONENT: primary = no, bootstrap = no, my_idx = 0, memb_num = 2
WSREP: Received NON-PRIMARY.
والعقدتان على حق، فهما لا تعرفان هل db3 ميتة أم أنها تعمل في مكان آخر وتقبل الكتابة، لذلك يجب أن يقرر إنسان. والخطوات اليدوية الصحيحة ثلاث، ونفذناها مع قياس الوقت:
- اعرف الأكثر تقدماً: أوقف العقد وشغل على قرص كل واحدة
mariadbd --wsrep-recover، فيقرأ آخر موقع من InnoDB ويطبع سطرRecovered position، واختر صاحب أعلى seqno. - اسمح لها بالإنشاء: عدل
safe_to_bootstrap: 1فيgrastate.datعلى هذه العقدة وحدها، ثم شغلها بالخيار--wsrep-new-cluster. - أعد الباقي: شغل العقد الأخرى دون الخيار، فتنضم بالنقل التزايدي أو الكامل، والعقدة التي ضاع قرصها تبنى من جديد بنقل كامل SST.
docker stop -t 20 wr-ha-db1 wr-ha-db2
for i in 1 2; do docker run --rm -v wr-ha-db$i:/var/lib/mysql -v "$(pwd -W)/galera.cnf:/etc/mysql/conf.d/galera.cnf:ro" \
  mariadb:11.8.9 mariadbd --user=mysql --wsrep-recover 2>&1 | grep "Recovered position"; done
docker run --rm -v wr-ha-db2:/d alpine:3.24 sed -i 's/^safe_to_bootstrap: 0/safe_to_bootstrap: 1/' /d/grastate.dat
docker rm wr-ha-db1 wr-ha-db2; run 2 --wsrep-new-cluster; sleep 20; run 1; sleep 30; run 3
02:56:16 manual recovery starts
WSREP: Recovered position: 00000000-0000-0000-0000-000000000000:83
WSREP: Recovered position: 00000000-0000-0000-0000-000000000000:83
02:57:19 bootstrap db2
db2 1 Primary Synced
02:57:41 start db1
02:58:12 new db3 (empty disk)
2:58:35 0 [Note] WSREP: SST succeeded for position a316c9ad-d8c4-11f1-8008-63664c016af5:4
db1 3 Primary Synced
db2 3 Primary Synced
db3 3 Primary Syncedواستغرقت الإعادة اليدوية حوالي دقيقتين وعشرين ثانية من أول أمر حتى أصبحت العقد الثلاث متزامنة، مع شخص يعرف الخطوات مسبقاً، ومع قاعدة صغيرة نقلها SST في ثوان. وفي الإنتاج سوف يكون الجزء الأطول هو التشخيص والقرار، لذلك اكتب هذه الخطوات في دليل تشغيل قبل أن تحتاجها، كما شرحنا في دليل ال Runbook. ولاحظ في المخرج أن العقدتين أعطتا الموقع نفسه، فاخترنا أياً منهما، وأن معرف العنقود بعد الإعادة أصبح جديداً، a316c9ad، لأن الإنشاء اليدوي يبدأ تاريخاً جديداً، ولذلك احتاجت العقد الأخرى نقلاً كاملاً بدلاً من التزايدي.
عقدتان فقط؟ مع الحكم garbd What If
كثير من الفرق تبدأ بعقدتين لأن الثالثة تكلف سيرفراً إضافياً، فلنر ماذا يحدث. أوقفنا db3 بشكل سليم، فأصبح العنقود عقدتين ما زالتا رئيسيتين، لأن الخروج السليم يخرج العقدة من الحساب. ثم قطعنا الاتصال بين db1 وdb2:
== after graceful stop of db3
db1 2 Primary Synced
db2 2 Primary Synced
02:59:59 isolate db2 (two-node cluster)
db1 1 non-Primary Initialized
db2 1 non-Primary Initialized
العقدتان توقفتا معاً، لأن كل واحدة تملك النصف بالضبط، والنصف لا يكفي. أي أن عنقود العقدتين أقل توفراً من سيرفر واحد في هذا العطل، فانقطاع الشبكة بينهما وحده يوقف الخدمة، وهذا ما يجعل الرقم الأدنى للعنقود ثلاثة. ولكن الصوت الثالث لا يحتاج أن يكون قاعدة بيانات كاملة، فهناك حكم Galera Arbitrator واسمه garbd، كما في توثيق الحكم، وهو برنامج صغير يشارك في الاتصال الجماعي ويحسب في النصاب، ولكنه لا يخزن أي بيانات. ولا يوجد في ال Image الرسمية، فبنيناه من الحزمة galera-arbitrator-4 في ملف Dockerfile.garbd:
FROM mariadb:11.8.9
RUN apt-get update && apt-get install -y --no-install-recommends galera-arbitrator-4 && rm -rf /var/lib/apt/lists/*
USER mysql
ENTRYPOINT ["garbd"]
docker build -q -t wr-ha-garbd:1 -f Dockerfile.garbd .
docker run -d --name wr-ha-garbd --hostname garbd --network wr-ha-net wr-ha-garbd:1 \
--address gcomm://wr-ha-db1,wr-ha-db2 --group shop --name garbd
sleep 15; sh state.sh
docker network disconnect wr-ha-net wr-ha-db2; sleep 25; sh state.shdb1 3 Primary Synced
db2 3 Primary Synced
03:01:23 isolate db2 again, now with the arbitrator
db1 2 Primary Synced
db2 1 non-Primary Initialized
2026-11-05 03:01:29.444 INFO: New COMPONENT: primary = yes, bootstrap = no, my_idx = 0, memb_num = 2مع الحكم أصبح حجم العنقود 3، فلما عزلنا db2 بقيت db1 مع garbd اثنين من ثلاثة، فاستمرت db1 تقبل الكتابة، والسطر الأخير من سجل garbd نفسه. وهذا هو الحل المعتاد للعنقود الصغير: عقدتان كاملتان في مكانين، وحكم صغير على سيرفر ثالث في مكان ثالث، وهو يحتاج موارد قليلة جداً، ولكن تذكر أنه يرى كل مجموعات التغييرات تمر به، فيحتاج شبكة جيدة إلى العقد.
حذف المختبر Cleanup
docker rm -f wr-ha-db1 wr-ha-db2 wr-ha-db3 wr-ha-garbd wr-ha-client
docker volume rm wr-ha-db1 wr-ha-db2 wr-ha-db3
docker network rm wr-ha-net
docker rmi wr-ha-myclient:1 wr-ha-garbd:1
هل تكتب على كل العقد فعلاً؟ Single Writer
بعد تجربة التعارض قد يبدو السؤال غريباً، ولكن الواقع أن أغلب الفرق التي تشغل Galera في الإنتاج لا تكتب على كل العقد، وإنما توجه كل الكتابة إلى عقدة واحدة في كل لحظة، وتستخدم العقد الأخرى للقراءة ولتأخذ مكانها إذا توقفت. والسبب ما رأيته بالأرقام: الكتابة على عقد متعددة لا تزيد سعة الكتابة، لأن كل عقدة تطبق كل الكتابات في النهاية، وتضيف أخطاء تعارض لا تحدث في عقدة واحدة. فما الذي تكسبه إذاً من Galera في هذا الشكل؟ تكسب أن أي عقدة جاهزة للكتابة فوراً دون ترقية، وأن الانتقال إلى عقدة أخرى يأخذ مدة اكتشاف الغياب فقط، أي ثوان، بدلاً من انتظار انتهاء مفتاح القائد، وأن العقدة المعزولة لا تقبل الكتابة أبداً.
والتوجيه نفسه يتم عبر موزع طلبات، مثل HAProxy بخلفية فيها عقدة رئيسية والباقي بالخيار backup، كما شرحنا في مقال توزيع الطلبات، أو MaxScale من MariaDB الذي يفهم حالة Galera ويختار عقدة الكتابة بنفسه. والمهم في الحالتين أن يكون فحص الصحة مبنياً على حالة Galera وليس على المنفذ، أي أن تكون العقدة Synced وفي مكون Primary، لأن العقدة غير الرئيسية تقبل الاتصال على المنفذ 3306، ثم ترد على كل أمر بالخطأ 1047، كما رأيت، وقد شرحنا في تجربة السيرفر الذي يفشل بسرعة لماذا هذا أخطر نوع من الأعطال على موزع الطلبات.
ومتى تكتب على كل العقد إذاً؟ عندما تكون الكتابات على بيانات منفصلة، مثل مستخدمين مختلفين أو فروع مختلفة لا تلمس الأسطر نفسها، وعندما يعيد التطبيق المعاملة عند الخطأ 1213 دائماً، وعندما تريد أن يكتب كل فرع على أقرب عقدة إليه. وحتى في هذه الحالة، فالأسطر المشتركة مثل المخزون والعدادات يجب أن تبقى على عقدة واحدة.
حدود Galera Limitations
هناك أشياء لا يحبها Galera، وبعضها يظهر فقط بعد أن تضع عليه بيانات حقيقية، والقائمة الكاملة في صفحة الحدود المعروفة من MariaDB، وأهمها:
- InnoDB فقط: الجداول بمحركات أخرى لا تنسخ بشكل صحيح، فتأكد من محرك كل جدول قبل النقل.
- مفتاح أساسي لكل جدول: الجدول دون مفتاح أساسي Primary Key يجعل تطبيق التغييرات بطيئاً جداً على العقد الأخرى، وقد يرتب الأسطر بشكل مختلف بينها.
- المعاملات الكبيرة: مجموعة التغييرات ترسل كاملة عند الالتزام، فالمعاملة التي تعدل مليون سطر ترسل مجموعة ضخمة دفعة واحدة، وتوقف العنقود حتى تطبقها كل العقد، لذلك قسم عمليات التعديل الكبيرة إلى دفعات.
- التحكم في التدفق Flow Control: إذا تأخرت عقدة واحدة في تطبيق التغييرات وامتلأ طابورها فوق
gcs.fc_limit، وقيمته 16 في عنقودنا، أرسلت إلى الجميع أن يتوقفوا عن الكتابة حتى تلحق، أي أن أبطأ عقدة تحدد سرعة الكتابة في العنقود كله، وراقب ذلك بالعدادwsrep_flow_control_paused. - أوامر تعريف البيانات DDL: مثل
ALTER TABLEتنفذ افتراضياً على كل العقد في اللحظة نفسها بالترتيب العالمي، فتوقف الكتابة على الجدول في العنقود كله أثناءها، والجدول الكبير يحتاج طريقة أخرى مثل التحديث المتدرج عقدة بعد عقدة. - زمن الشبكة: كل التزام ينتظر وصول المجموعة إلى كل العقد، فإذا وضعت العقد في مدن بعيدة، أضيف زمن الوصول إلى كل التزام.
التشغيل اليومي Operations: المراقبة والصيانة
العنقود الذي رأيته في المختبر يتصرف بشكل صحيح عندما يحدث العطل، ولكن أكثر الأعطال في الواقع لا تبدأ بانقطاع واضح، وإنما بعقدة تتأخر شيئاً فشيئاً، أو بنقل كامل يرهق العقدة المانحة في ساعة الذروة، أو بعنقود أصبح عقدتين دون أن يلاحظ أحد. لذلك يحتاج Galera مراقبة تعرف لغته، وصيانة تحترم طريقته في العمل.
ماذا تراقب في Galera؟ Monitoring
كل ما تحتاجه موجود في متغيرات الحالة التي استخدمناها في المختبر، وهذه أهمها ومعنى كل واحد منها:
wsrep_cluster_size: عدد العقد في المكون الحالي، وأهم تنبيه في العنقود كله أن ينزل عن ثلاثة، لأن عنقوداً من عقدتين لا يتحمل أي انقطاع آخر كما رأيت، فإذا خرجت عقدة للصيانة ولم تعد، فأنت تعمل دون أي هامش وقد لا تعرف ذلك.wsrep_cluster_statusوwsrep_local_state_comment: يجب أن تكون القيمتانPrimaryوSyncedعلى كل عقدة تخدم الطلبات، وأي قيمة أخرى تعني أن العقدة لا يجب أن تستقبل شيئاً من موزع الطلبات.wsrep_flow_control_paused: نسبة الوقت الذي توقف فيه العنقود عن الكتابة بسبب عقدة متأخرة، وقرأنا في المختبر 0.083 بعد تجربة التعارض، أي أن الكتابة توقفت حوالي 8% من الوقت، وإذا ارتفعت هذه النسبة باستمرار فابحث عن العقدة الأبطأ، فهي التي تحدد سرعة الجميع.wsrep_local_recv_queue: طول طابور مجموعات التغييرات التي وصلت إلى العقدة ولم تطبقها بعد، وهو ما سبب القراءات التي لم تجد الطلب، وارتفاعه في عقدة واحدة يسبق التحكم في التدفق.wsrep_local_cert_failuresوwsrep_local_bf_aborts: عدد التعارضات، فإذا ارتفعت فهناك كتابة على الأسطر نفسها من أكثر من عقدة، وهو ما يجب أن يمنعه موزع الطلبات في نمط الكاتب الواحد.
وكل هذه المتغيرات يجمعها مصدر بيانات MySQL المعتاد في Prometheus، فلا تحتاج أداة خاصة، وإنما قواعد تنبيه تعرف هذه الأسماء، كما شرحنا في مقال التنبيهات.
الصيانة والتحديث Rolling Maintenance
ميزة Galera الكبيرة في الصيانة أنك تستطيع أن تحدث العقد واحدة بعد الأخرى دون توقف، بشرط أن تتذكر الدرس الذي رأيته في تجربة العقدتين: أخرج العقدة بإغلاق سليم دائماً، فيخرج من الحساب ويبقى المكون الباقي اثنين من اثنين، ولا تقطعها فجأة. والترتيب المعتاد: أخرج العقدة من موزع الطلبات أولاً، ثم أوقفها بإغلاق سليم، ثم حدثها، ثم شغلها فتعود بنقل تزايدي IST إذا كانت GCache تكفي مدة غيابها، ثم انتظر حتى تصبح Synced قبل أن تنتقل إلى العقدة التالية، ولا تخرج عقدتين معاً في عنقود من ثلاث.
والنسخ الاحتياطي يتبع الفكرة نفسها، فالعنقود لا يحميك من الحذف الخاطئ، لأن DELETE يصل إلى العقد الثلاث بالترتيب العالمي نفسه، لذلك خذ نسخة بالأداة mariabackup من إحدى العقد، ويفضل أن تكون غير العقدة التي تكتب عليها، كما شرحنا في دليل نسخ قواعد البيانات. وإذا كانت النسخة ثقيلة على القرص، فيمكن أن تعزل العقدة مؤقتاً عن التحكم في التدفق بالمتغير wsrep_desync، حتى لا تبطئ العنقود كله بينما تنسخ، ثم تعيده بعد النسخة وتتركها تلحق.
Galera أم Patroni مع النسخ العادي؟ Comparison
بعد المقالين صار عندك مثالان واضحان للطريقتين، وكلاهما قيس على الجهاز نفسه وبالعميل نفسه تقريباً، أي طلب كل 100 ملي ثانية، فالفروق بينهما تعكس التصميم وليس العتاد. والجدول التالي يجمع ما قسناه وما يعنيه لاختيارك:
| السؤال | Patroni مع النسخ المتدفق | MariaDB Galera |
|---|---|---|
| من يكتب؟ | سيرفر رئيسي واحد | أي عقدة، والأنسب عقدة واحدة في كل لحظة |
| زمن توقف الكتابة عند موت الرئيسي | 30.7 ثانية في مختبرنا، انتظار مفتاح القائد | 6.8 ثانية في مختبرنا، اكتشاف الغياب فقط |
| العقدة المعزولة | تقبل الكتابة حتى تتنحى، إلا مع النسخ المتزامن | ترفض كل الأوامر فوراً بالخطأ 1047 |
| قراءة ما كتبته من عقدة أخرى | قد تتأخر بحسب تأخر النسخة | تأخرت في 4.6% من القراءات، وwsrep_sync_wait يحلها |
| الكتابة على السطر نفسه | قفل عادي على الرئيسي | 50.4% أخطاء 1213 عند التوزيع على العقد |
| من يقرر من الرئيسي؟ | مخزن توافق خارجي مثل etcd | النصاب داخل العنقود نفسه |
| العدد الأدنى | سيرفران مع ثلاثة etcd | ثلاث عقد، أو عقدتان مع garbd |
| العودة بعد انقطاع الكهرباء عن الجميع | تلقائية من حالة etcd | تلقائية إذا عاد الجميع، ويدوية إذا غاب أحدهم |
والخلاصة العملية: إذا كانت قاعدتك PostgreSQL فالسؤال محسوم تقريباً لصالح Patroni أو ما يشبهه، وإذا كانت MariaDB وتريد أقصر توقف عند العطل وأقوى ضمان ضد الكتابة على عقدة معزولة، فـ Galera مع كاتب واحد خيار ممتاز، بشرط أن تقبل حدوده، وأن يتدرب الفريق على إعادته بعد العطل الكبير.
أخطاء شائعة Common Mistakes
- عنقود من عقدتين دون حكم: فيتوقف الاثنان معاً عند انقطاع الشبكة بينهما.
- ترك
--wsrep-new-clusterفي أمر التشغيل: فتحاول العقدة إنشاء عنقود جديد عند كل إعادة تشغيل، ويرفضها Galera إذا كنت محظوظاً. - تعديل
safe_to_bootstrapعلى أي عقدة: دون التحقق من أنها الأكثر تقدماً بالأداة--wsrep-recover، فتضيع المجموعات التي لم تصل إليها. - أوامر
wsrep_provider_optionsمن الأدلة القديمة: فتفشل في MariaDB 11.8 بالخطأ 1210، والصحيح المتغيراتwsrep_provider_*. - عناوين IP متغيرة للعقد: فتبقى العقدة العائدة تتصل بعناوين قديمة ولا تنضم.
- الكتابة على الأسطر نفسها من كل العقد: فتتحول نسبة كبيرة من العمل إلى أخطاء 1213، والتطبيق لا يعيد المحاولة.
- فحص صحة على المنفذ فقط: فيرسل الموزع الطلبات إلى عقدة غير رئيسية ترد بالخطأ على كل شيء.
- قراءة ما كتبه المستخدم من عقدة أخرى: دون
wsrep_sync_wait، فلا يرى طلبه في بعض المرات. - GCache صغيرة: فتحتاج كل عقدة تعود من صيانة قصيرة نقلاً كاملاً يرهق العقدة المانحة.
قائمة تحقق Checklist
| البند | كيف تتحقق منه |
|---|---|
| ثلاثة أصوات على الأقل | ثلاث عقد، أو عقدتان مع garbd، في ثلاثة أماكن |
| عناوين ثابتة للعقد | لا يوجد blacklisting address في السجلات بعد إعادة التشغيل |
| خيار الإنشاء غير موجود في التشغيل الدائم | ملف الخدمة أو ال Compose لا يحتوي --wsrep-new-cluster |
| كاتب واحد في كل لحظة | موزع الطلبات يرسل الكتابة إلى عقدة واحدة والباقي احتياطي |
| فحص صحة يقرأ حالة Galera | wsrep_local_state_comment = Synced وwsrep_cluster_status = Primary |
| التطبيق يعيد المحاولة عند 1213 | اختبار تعارض متعمد لا يظهر للمستخدم |
| كل جدول InnoDB بمفتاح أساسي | استعلام على information_schema.tables لا يعيد شيئاً |
| حجم GCache يكفي الصيانة | عقدة غابت ساعة تعود بنقل IST وليس SST |
| دليل إعادة العنقود مكتوب ومجرب | تمرين انقطاع كامل مع غياب عقدة، والوقت مقاس |
| مراقبة العدادات | حجم العنقود، وflow control، وcert failures، وbf aborts |
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما تحتاج أن تتذكره منه قبل أن تضع المخزون على Galera:
- Galera يرسل كل معاملة عند الالتزام إلى كل العقد بترتيب واحد، وكل عقدة تتحقق منها بالقاعدة نفسها، فلا تضيع كتابة مؤكدة، ولكن العقد الأخرى تطبقها بعد ذلك.
- في 4.6% من القراءات لم تر db3 ما كتب على db1 للتو، ومع
wsrep_sync_waitرأته دائماً بثمن 27 ملي ثانية للقراءة. - الكتابة على الصنف نفسه من ثلاث عقد حولت 50.4% من المحاولات إلى أخطاء 1213 دون أي زيادة في السرعة، لذلك اكتب على عقدة واحدة.
- العقدة المعزولة رفضت كل شيء بالخطأ 1047، والأغلبية توقفت عن الكتابة 6.8 ثانية فقط حتى أعلنت غيابها.
- إعادة العنقود كشفت ثلاث مشاكل: أمر
pc.bootstrapالقديم لا يعمل في MariaDB 11.8، وعناوين IP المتغيرة تمنع الانضمام، وخيار الإنشاء المتروك في أمر التشغيل. - راقب حجم العنقود ونسبة توقف التدفق وطابور التطبيق في كل عقدة، وحدث العقد واحدة بعد الأخرى بإغلاق سليم، واستمر في النسخ الاحتياطي لأن الحذف الخاطئ يصل إلى كل العقد.
- انقطاع الكهرباء عن الجميع يعود وحده إذا عادت كل العقد، وإذا غاب أحدها فالإعادة يدوية بثلاث خطوات أخذت دقيقتين و20 ثانية، وعقدتان دون حكم تتوقفان معاً.
وفي المقال القادم من مرحلة التوفر العالي بإذن الله ننتقل إلى Redis وValkey مع Sentinel، ونرى كيف يتصرف عنقود الذاكرة عندما يتوقف الرئيسي أو ينعزل.
 دليلعناقيد قواعد البيانات Database Clustering ومتى تحتاجهاماذا تعني كلمة Cluster في كل قاعدة بيانات، ومتى تحتاج نسخاً أو انتقالاً تلقائياً، ومتى يكفيك سيرفر واحد مع نسخ احتياطية جيدة.
 دليلانتقال تلقائي Failover لقاعدة PostgreSQL مع Patroniبنينا عنقود PostgreSQL من ثلاث نسخ يديره Patroni، ثم قتلنا الرئيسي وعزلناه عن الشبكة وقسنا كم ثانية توقفت الكتابة وكم طلباً مؤكداً ضاع.
 دليلMySQL أم MariaDB؟ ومتى تختار أياً منهمالماذا لم يعد MariaDB نسخة من MySQL، وأين يفشل نقل تطبيقك بينهما، وكيف تختار الأنسب لك.
 دليلمفاهيم التوفر العالي High Availability للمبتدئينماذا يعني أن تبقى خدمتك تعمل رغم تعطل جزء منها، وكيف تحسب التوفر وتجد نقاط الفشل الواحدة وتقرر متى يستحق ذلك تكلفته.
 دليلتوزيع الطلبات Load Balancing: الخوارزميات مقاسة في مختبرقسنا التناوب وأقل اتصالات والاختيار من اثنين والهاش على ثلاثة سيرفرات خلف HAProxy، لترى متى يكون التوزيع بالتساوي خطأ ومتى يبتلع السيرفر المعطل كل الطلبات.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة الدليل وتنفيذ المختبر على MariaDB 11.8.9 مع Galera 4 وgarbd من الحزمة galera-arbitrator-4 وPython 3.13 مع PyMySQL 1.1.2 على Docker Engine 29.8.0.


