


شركة ناشئة تبيع إكسسوارات الجوال عبر متجر إلكتروني، وفريقها التقني ثلاثة أشخاص، والمتجر يعمل على سيرفر واحد فيه التطبيق وقاعدة البيانات في Containers. وقبل موسم التخفيضات بأسابيع يرسل فريق التسويق رسالة قصيرة: «سوف نطلق حملة إعلانية كبيرة، ونتوقع ثلاثة أضعاف الزوار في يوم الإطلاق، هل نحتاج سيرفراً أكبر؟». ويفتح المطور لوحة المراقبة فيجد أن المعالج عند 35% في أعلى ساعة من الأسبوع الماضي، فيقول بثقة: «لدينا مساحة لثلاثة أضعاف تقريباً». ثم يأتي يوم الإطلاق، وتصل الحركة إلى الضعفين فقط، ويتوقف المتجر عن الرد لمدة نصف ساعة، والمعالج في اللوحة عند 70%.
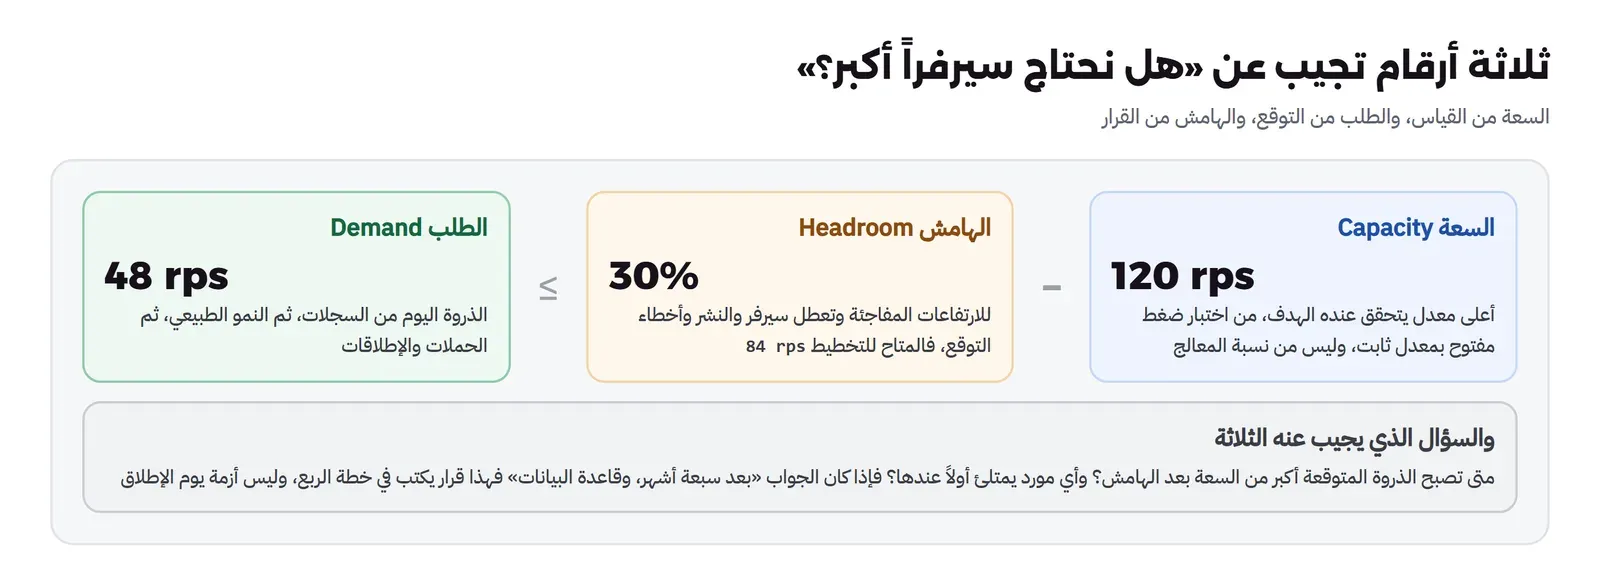
هذه القصة تتكرر لأن السؤال «هل نحتاج سيرفراً أكبر؟» يبدو سؤالاً عن العتاد، بينما هو في الحقيقة سؤال عن ثلاثة أرقام لا يعرفها أغلب الفرق: كم طلباً تستطيع الخدمة أن تخدم وهي ما زالت ضمن هدفها، وكم طلباً سوف يأتي، ومتى. وتخطيط السعة Capacity Planning هو الطريقة التي تحصل بها على هذه الأرقام من القياس بدلاً من التخمين: تقيس السعة باختبار ضغط، وتتوقع الطلب من الحركة الحالية ونموها والأحداث القادمة، ثم تترك هامشاً Headroom للأشياء التي لا تتوقعها. وقد شرحنا أدوات اختبار الضغط وأنواعه في مقال اختبار الضغط Load Testing، وفي هذا المقال نستخدم k6 وحده لنجيب عن سؤال واحد: متى يحتاج هذا المتجر سيرفراً أكبر، وأي جزء منه بالتحديد يحتاج أن يكبر؟
وسوف نناقش في هذا المقال ما يلي:
- لماذا نسبة المعالج لا تجيب عن سؤال السعة، وما هو السؤال الصحيح.
- المصطلحات: الطلب Demand والسعة Capacity والهامش Headroom ونقطة الانعطاف Knee، وقانون Little.
- لماذا ينفجر زمن الاستجابة قرب الامتلاء، بحساب بسيط من نظرية الطوابير Queueing Theory.
- مختبر: متجر بلغة Python مع PostgreSQL، نقيس سعته بمعالج واحد ثم باثنين، وبعملية واحدة ثم باثنتين.
- مشكلة واجهتنا: سيرفر أكبر لم يعط سعة أكبر، ومشكلة ثانية: الجهاز الذي نقيس عليه كان مشغولاً بغيرنا.
- التوقع Forecasting: النمو الطبيعي والحملات، ومتى تنفد السعة بالأشهر.
- الهامش وN+1، والتوسع العمودي مقابل الأفقي، وجدول قرار وقائمة تحقق.
ما السؤال الصحيح؟ السعة Capacity ضمن الهدف SLO
نسبة المعالج في اللوحة تقول كم كان المعالج مشغولاً في المتوسط خلال فترة، ولا تقول شيئاً عن ثلاثة أشياء مهمة. الأول أن المتوسط يخفي الذروة، فمتوسط 35% على دقيقة قد يكون عشر ثوان عند 100% وخمسين ثانية شبه فارغة، والطلبات التي جاءت في الثواني العشر انتظرت. والثاني أن المعالج ليس المورد الوحيد، فقد تنفد اتصالات قاعدة البيانات أو الذاكرة أو أقفال الجداول أو قدرة التطبيق نفسه على استخدام أكثر من نواة قبل أن يصل المعالج إلى 100%، وهذا ما سنراه في المختبر. والثالث أن العلاقة بين الحركة والمعالج ليست خطاً مستقيماً، فالضعف في الحركة لا يعني الضعف في المعالج، والضعف في المعالج لا يعني الضعف في زمن الاستجابة.
ولذلك يعرف تخطيط السعة بلغة المستخدم وليس بلغة العتاد: سعة الخدمة هي أعلى معدل طلبات تستطيع أن تخدمه وهي ما زالت تحقق هدفها، أي الـ SLO الذي شرحناه في مقال أهداف الخدمة SLO. ففي متجرنا الهدف أن يكون زمن الاستجابة عند الشريحة 95% أقل من 300 ملي ثانية، وأن تكون نسبة الأخطاء أقل من 1%، فالسعة هي أعلى عدد طلبات في الثانية يتحقق عنده هذان الشرطان معاً. وهذا التعريف يأتي من فصل المقدمة في كتاب Google SRE، الذي يجعل تخطيط السعة من مسؤوليات فريق الموثوقية، ويذكر ثلاث خطوات إلزامية: توقع دقيق للنمو الطبيعي Organic Growth، وإدخال النمو غير الطبيعي Inorganic Growth مثل الحملات وإطلاق الميزات في التوقع، واختبار ضغط منتظم يربط العتاد بسعة الخدمة الحقيقية.
المصطلحات Terms
- الطلب Demand: عدد الطلبات التي ستأتي فعلاً، ويقاس من سجلات Nginx أو المقاييس عند أعلى نقطة، وليس بالمتوسط اليومي، لأن الخدمة تتوقف في الذروة وليس في المتوسط.
- السعة Capacity: أعلى معدل طلبات تتحقق عنده أهداف الخدمة، ويقاس باختبار ضغط مفتوح Open Model يرسل الطلبات بمعدل ثابت مهما كان رد السيرفر.
- الاستخدام Utilization: الطلب الحالي مقسوماً على السعة، فإذا كان الطلب 48 طلباً في الثانية والسعة 120 فالاستخدام 40%.
- الهامش Headroom: الجزء من السعة الذي لا تخطط لاستخدامه، ويغطي الارتفاعات المفاجئة وتعطل سيرفر ونشر نسخة جديدة وأخطاء التوقع.
- نقطة الانعطاف Knee: المعدل الذي يبدأ عنده زمن الاستجابة في الارتفاع بسرعة، وقد شرحناها في مقال اختبار الضغط، والسعة تكون قبلها دائماً.
- عنق الزجاجة Bottleneck: المورد الذي يمتلئ أولاً، وتكبير أي مورد آخر لا يغير السعة.
قانون Little: كم طلباً في داخل النظام؟
قبل أن نقيس، معادلة واحدة تربط الأرقام الثلاثة التي يتكلم عنها الجميع: عدد الطلبات داخل النظام في أي لحظة يساوي معدل وصول الطلبات مضروباً في متوسط الزمن الذي يقضيه الطلب داخله، وتسمى قانون Little Little's Law. فإذا كان المتجر يستقبل 100 طلب في الثانية وكل طلب يأخذ 16 ملي ثانية، ففي أي لحظة يوجد داخله طلبان تقريباً، وهذا رقم صغير لا يحتاج إلا Thread أو اتصالين بقاعدة البيانات. ولكن إذا وصل زمن الطلب إلى 3 ثوان بنفس المعدل، ففي داخله 300 طلب في نفس اللحظة، وكل منها يحجز Thread وذاكرة واتصالاً، وهنا تبدأ المشاكل الثانوية: نفاد اتصالات قاعدة البيانات، وامتلاء الذاكرة، وانتهاء مهلة الطلبات. والقانون مفيد في تخطيط السعة لأنه يقول لك كم مورداً متزامناً تحتاج لمعدل معين، ويقول لك أيضاً لماذا تنهار الخدمة بسرعة بعد نقطة معينة: الزمن يرتفع، فيرتفع عدد الطلبات في الداخل، فتنفد الموارد، فيرتفع الزمن أكثر.
كيف تعرف الطلب Demand من السجلات؟
الرقم 48 في المثال يجب أن يأتي من مكان حقيقي، وأسهل مكان هو سجل الـ Reverse Proxy، لأنه يرى كل الطلبات بما فيها التي فشلت. والسؤال الذي تسأله السجل ليس «كم طلباً جاء اليوم؟»، وإنما «ما أعلى عدد طلبات في ثانية واحدة، أو في دقيقة واحدة مقسوماً على ستين، خلال الأسابيع الأخيرة، لكل مسار مهم؟». فالمتوسط اليومي لمتجر يبيع في المساء قد يكون عشر الذروة، والتخطيط عليه يعني أنك خططت لساعات الفجر. ومع Nginx يكفي أمر مثل التالي ليعطيك أعلى عشر دقائق لمسار المنتجات من سجل بالصيغة الافتراضية، ثم تقسم العدد على ستين:
grep ' /api/products' /var/log/nginx/access.log | awk '{print substr($4, 2, 17)}' | sort | uniq -c | sort -rn | head -10والدقيقة أفضل من الثانية للتخطيط لأن الثانية الواحدة تتأثر بالصدف، والدقيقة تمثل ما تحمله الخدمة فعلاً، ولكن انتبه أن الارتفاعات داخل الدقيقة موجودة، وهذا جزء من سبب الهامش. وإذا كان عندك نظام مقاييس مثل Prometheus فنفس السؤال يجيب عنه معدل العداد على نافذة دقيقة، وأعلى قيمة له على أربعة أسابيع، كما شرحنا في مقال Prometheus مع لوحات Grafana. ثم احسب النمو من نفس الرقم شهراً بشهر، وليس من عدد الزوار في أداة التحليلات، لأن الزائر الواحد قد يرسل عشرين طلباً للـ API في الصفحة الواحدة، وتغيير في الواجهة قد يضاعف هذا العدد دون أي زائر جديد.
لماذا ينفجر الزمن قرب الامتلاء؟ نظرية الطوابير Queueing Theory
الحدس العادي يقول إن السيرفر عند 80% يعمل أبطأ قليلاً منه عند 50%، وعند 95% أبطأ قليلاً أيضاً. ولكن نظرية الطوابير تقول شيئاً مختلفاً تماماً. ففي أبسط نموذج للطابور، ويسمى M/M/1، حيث تصل الطلبات بشكل عشوائي ويخدمها خادم واحد، متوسط الزمن داخل النظام يساوي زمن الخدمة مقسوماً على واحد ناقص الاستخدام. والسبب أن الطلبات العشوائية تصل أحياناً متقاربة، فتنتظر في الطابور، وكلما قل الوقت الفارغ للخادم قلت فرصته ليفرغ الطابور قبل أن تأتي مجموعة أخرى. والسكربت queue.py يحسب ذلك بزمن خدمة من المختبر، أي 8.6 ملي ثانية للطلب، وهو واحد على 116 طلباً في الثانية التي أنهاها التطبيق بمعالج واحد عند امتلائه:
# Why latency explodes near full utilization: average time in an M/M/1 queue is S / (1 - rho).
# S = 8.6 ms of service time (1 / 116 rps, the most the 1-CPU app finished in the lab).
S = 1000 / 116
print(f"service time S = {S:.1f} ms")
print(" util   arrivals/s   time in system   x S")
for rho in (0.5, 0.6, 0.7, 0.8, 0.9, 0.95, 0.99):
    w = S / (1 - rho)
    print(f"{rho:>5.0%} {rho*116:>11.0f} {w:>13.1f} ms {w/S:>6.1f}")
# Little's law: requests inside the system = arrival rate x time in system
for rate, ms in ((100.0, 16), (115.9, 3050)):   # medians measured at the 100 rps step, and at the 140 rps step (115.9 rps done)
    print(f"Little: {rate} rps x {ms} ms = {rate*ms/1000:.0f} requests in flight")
service time S = 8.6 ms
util arrivals/s time in system x S
50% 58 17.2 ms 2.0
60% 70 21.6 ms 2.5
70% 81 28.7 ms 3.3
80% 93 43.1 ms 5.0
90% 104 86.2 ms 10.0
95% 110 172.4 ms 20.0
99% 115 862.1 ms 100.0
Little: 100.0 rps x 16 ms = 2 requests in flight
Little: 115.9 rps x 3050 ms = 353 requests in flight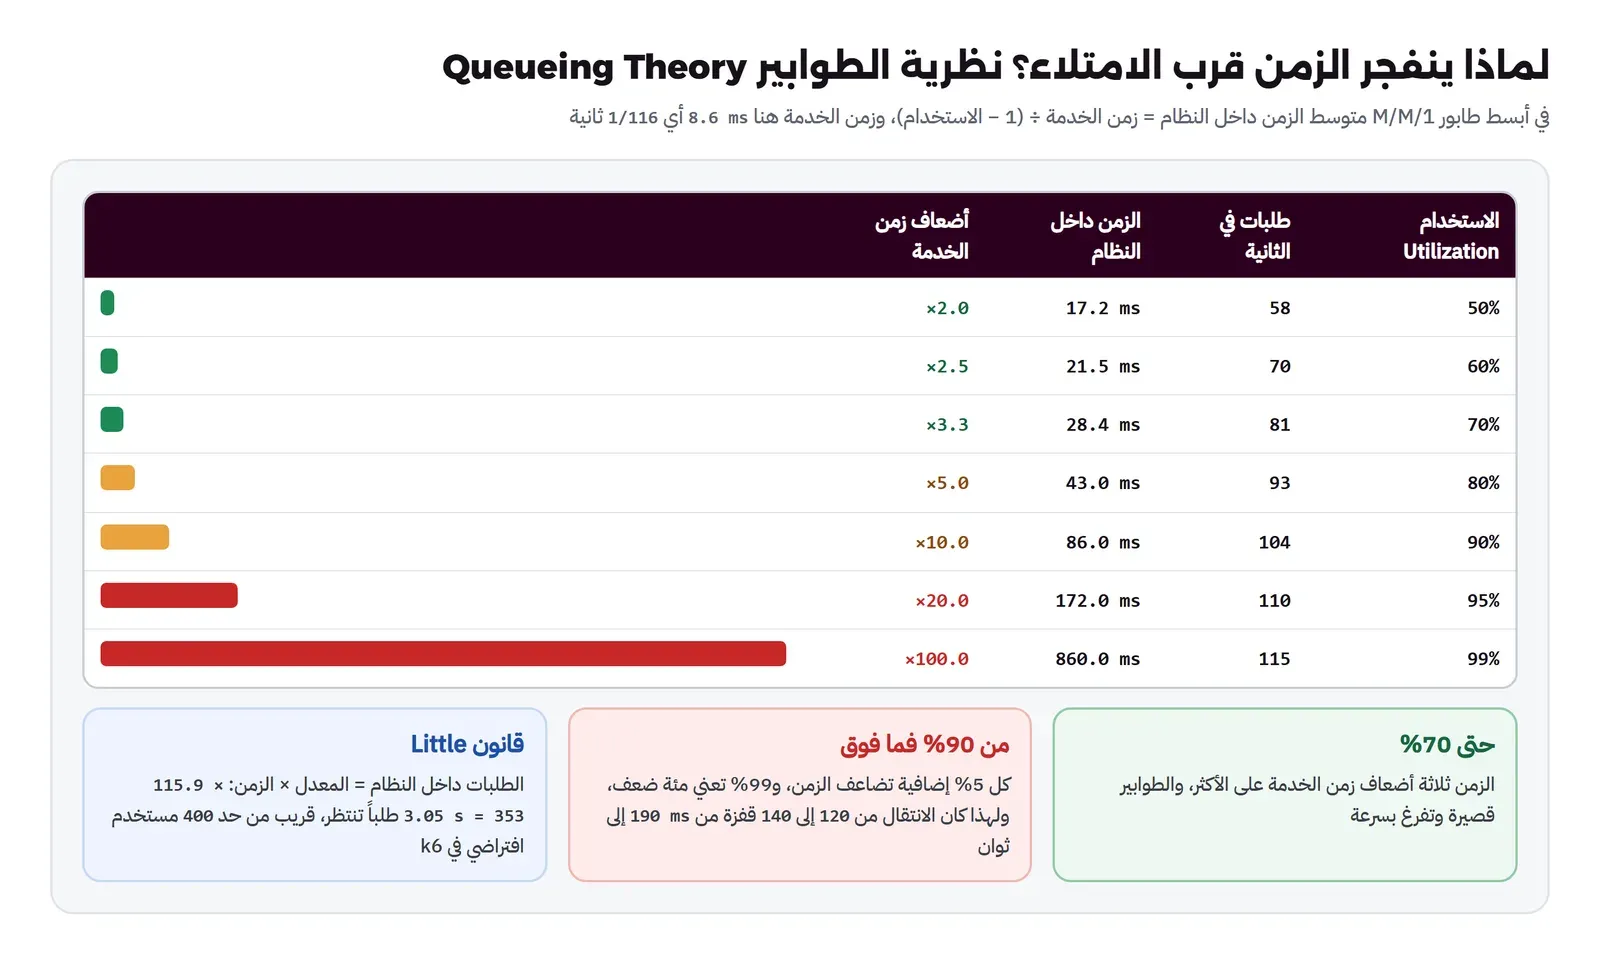
الجدول يشرح شيئين سنراهما في المختبر بأرقام حقيقية. الأول أن الزمن عند 70% ثلاثة أضعاف زمن الخدمة فقط، وعند 90% عشرة أضعاف، وعند 99% مئة ضعف، أي أن آخر عشرة بالمئة من السعة أغلى بكثير من التسعين الأولى. والثاني أن السطر الأخير، وهو قانون Little بأرقام القياس عند الامتلاء، يقول إن 353 طلباً كانت تنتظر داخل النظام، وهذا قريب جداً من 400 مستخدم افتراضي سمحنا لأداة k6 بها، أي أن الأداة استنفدت كل مستخدميها في الانتظار وبدأت تسقط الطلبات. والنموذج تبسيط بالطبع، فالسيرفر الحقيقي فيه عدة Threads وزمن خدمة غير ثابت، ولكن الشكل العام للمنحنى صحيح في كل الأنظمة تقريباً، وهو السبب في أن أغلب الفرق تخطط للعمل بين 60% و70% من السعة، وليس عند 90%.
وقد يتساءل البعض: هل ينطبق هذا على سيرفر فيه عدة أنوية وعدة Threads؟ والإجابة نعم مع فرق في الدرجة، فالطابور الذي يخدمه عدة خوادم معاً يتحمل استخداماً أعلى قليلاً قبل الانعطاف، لأن احتمال أن تكون كل الخوادم مشغولة في نفس اللحظة أقل، ولكن الشكل نفسه يبقى: منحنى هادئ ثم ارتفاع حاد قرب الامتلاء. ولذلك لا تبحث عن رقم سحري للهامش في كتاب، وإنما ارسم منحنى خدمتك أنت باختبار ضغط بخطوات، كما سنفعل الآن، وانظر أين ينعطف.
المختبر Lab: متجر بلغة Python مع PostgreSQL
المتجر في المختبر خدمة واحدة shop-api بمسار /api/products?cat=N، ترجع أفضل عشرين منتجاً في قسم مع عدد مراجعاتها، ثم تحسب سعر كل منتج بعد العروض في Python، وهذا ما تفعله أغلب المتاجر: استعلام فيه تجميع، ثم منطق عمل على كل عنصر. والخدمة مكتوبة بمكتبة Python القياسية مع psycopg 3 ومجمع اتصالات Connection Pool، ويمكن أن تعمل بعدة عمليات Processes تشترك في نفس المنفذ:
SQL = """SELECT p.id, p.name, p.price, p.rating, count(r.id) AS reviews
         FROM products p LEFT JOIN reviews r ON r.product_id = p.id
         WHERE p.category = %s GROUP BY p.id ORDER BY p.rating DESC, p.id LIMIT 20"""

def offers(price, pid):
    # stands in for the business rules a real shop runs per item (coupons, bundles, tax): ~0.4 ms of CPU each
    h = str(pid).encode()
    for _ in range(300): h = hashlib.sha256(h).digest()
    return round(float(price) * (0.9 if h[0] % 3 == 0 else 1.0), 2)

class Server(ThreadingHTTPServer):
    daemon_threads = True
    def server_bind(self):
        self.socket.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEPORT, 1)
        super().server_bind()

def serve():
    global POOL
    from psycopg_pool import ConnectionPool
    POOL = ConnectionPool(DSN, min_size=4, max_size=int(os.environ.get("POOL", "10")), open=True)
    print(f"worker {os.getpid()} ready", flush=True)
    Server(("0.0.0.0", 8000), H).serve_forever()

for _ in range(WORKERS - 1):
    if os.fork() == 0: serve()
serve()
في الكود أعلاه لاحظ أن المتغير WORKERS يحدد عدد العمليات، وكل عملية تفتح نفس المنفذ بالخيار SO_REUSEPORT، فتوزع النواة الاتصالات بينها، ولكل عملية مجمع اتصالات حجمه عشرة. وسوف نرى بعد قليل لماذا هذا التفصيل هو أهم سطر في المختبر. وقاعدة البيانات PostgreSQL 18 فيها مئة ألف منتج في مئتي قسم ومليون مراجعة، والإعداد ملف Compose يحدد معالجات كل خدمة بمتغيرات:
name: wr-sre-cap
services:
  db:
    image: postgres:18-alpine
    cpus: ${DB_CPUS:-2}
    mem_limit: 1g
    command: ["postgres", "-c", "shared_buffers=256MB", "-c", "max_connections=100"]
    volumes: ["./seed.sql:/docker-entrypoint-initdb.d/seed.sql:ro", "db:/var/lib/postgresql"]
  app:
    build: .
    image: wr-sre-cap-app:1
    cpus: ${APP_CPUS:-1}
    mem_limit: 512m
    environment: { WORKERS: "${WORKERS:-1}", POOL: "10" }
    ports: ["18600:8000"]
وأول مشكلة واجهتنا كانت قبل أي قياس: ملف البيانات seed.sql فشل في إدخال المراجعات، وتوقفت قاعدة البيانات، والتطبيق يكتب failed to resolve host 'db'. وسجل PostgreSQL قال السبب:
INSERT 0 100000
ERROR:  integer out of range
STATEMENT:  INSERT INTO reviews (product_id, stars, body)
	  SELECT 1 + (g * 7919 % 100000), 1 + (g % 5), 'review text ' || g FROM generate_series(1, 1000000) g;
الرقم g * 7919 يصل إلى حوالي 7.9 مليار، وهذا أكبر من حد النوع integer في PostgreSQL، أي 2,147,483,647، فالحل تحويل g إلى bigint قبل الضرب. ولاحظ شيئاً آخر: فحص الصحة pg_isready قال إن قاعدة البيانات «سليمة» أثناء التهيئة، لأن PostgreSQL يشغل سيرفراً مؤقتاً أثناء تنفيذ ملفات التهيئة، فبدأ التطبيق قبل أن تفشل التهيئة. ومثل هذا الخطأ في ملف تهيئة لا يظهر في الاختبار ببيانات صغيرة، ويظهر فقط عندما تكبر الأرقام، وهذا بالضبط ما يحدث مع النمو في الإنتاج.
وأداة الضغط k6 بنموذج مفتوح Open Model، أي معدل وصول ثابت constant-arrival-rate مهما كان رد السيرفر، كما في توثيق k6، لأن الزوار الحقيقيين لا ينتظرون أن ينتهي السيرفر من غيرهم قبل أن يأتوا، وقد شرحنا الفرق بين النموذجين في مقال اختبار الضغط:
export const options = {
  discardResponseBodies: true,
  scenarios: { fixed: { executor: 'constant-arrival-rate', rate: Number(__ENV.RATE || 20), timeUnit: '1s',
    duration: __ENV.DURATION || '40s', preAllocatedVUs: 50, maxVUs: 400 } },
  summaryTrendStats: ['med', 'p(95)', 'p(99)', 'max'],
};
export default function () {
  const r = http.get(`http://app:8000/api/products?cat=${1 + Math.floor(Math.random() * 200)}`, { timeout: '5s' });
  check(r, { 'status 200': (x) => x.status === 200 });
}
والسكربت steps.sh يشغل k6 مرة لكل معدل، أربعين ثانية لكل خطوة، ويسجل بعد عشر ثوان من كل خطوة نسبة المعالج للتطبيق ولقاعدة البيانات من docker stats، وفي النسخة الأخيرة نسبة معالج الجهاز كله أيضاً، والسبب سوف تراه في قسم المشكلة الثانية.
السعة بمعالج واحد Single CPU: 120 طلباً في الثانية
أول قياس: التطبيق بمعالج واحد وعملية واحدة، وقاعدة البيانات بمعالجين، والمعدل من 40 إلى 160 طلباً في الثانية:
cpu1-w1 {"rate":40,"done":"40.0","med":"14","p95":"25","p99":"34","failed":"0.00","dropped":0,"vus":50} wr-sre-cap-app-1 19.58% 46.09MiB / 512MiB wr-sre-cap-db-1 26.91% 206MiB / 1GiB
cpu1-w1 {"rate":80,"done":"80.0","med":"18","p95":"30","p99":"40","failed":"0.00","dropped":0,"vus":50} wr-sre-cap-app-1 58.23% 47.04MiB / 512MiB wr-sre-cap-db-1 73.42% 206.6MiB / 1GiB
cpu1-w1 {"rate":100,"done":"100.0","med":"16","p95":"42","p99":"135","failed":"0.00","dropped":0,"vus":50} wr-sre-cap-app-1 58.11% 48.01MiB / 512MiB wr-sre-cap-db-1 74.12% 220MiB / 1GiB
cpu1-w1 {"rate":120,"done":"120.0","med":"17","p95":"190","p99":"247","failed":"0.00","dropped":0,"vus":50} wr-sre-cap-app-1 61.16% 48.27MiB / 512MiB wr-sre-cap-db-1 81.04% 220.6MiB / 1GiB
cpu1-w1 {"rate":140,"done":"115.9","med":"3050","p95":"3382","p99":"3437","failed":"0.02","dropped":600,"vus":400} wr-sre-cap-app-1 102.26% 63.78MiB / 512MiB wr-sre-cap-db-1 112.44% 220.5MiB / 1GiB
cpu1-w1 {"rate":160,"done":"116.3","med":"2961","p95":"4272","p99":"4343","failed":"0.00","dropped":1398,"vus":400} wr-sre-cap-app-1 100.22% 73.7MiB / 512MiB wr-sre-cap-db-1 110.98% 221.3MiB / 1GiB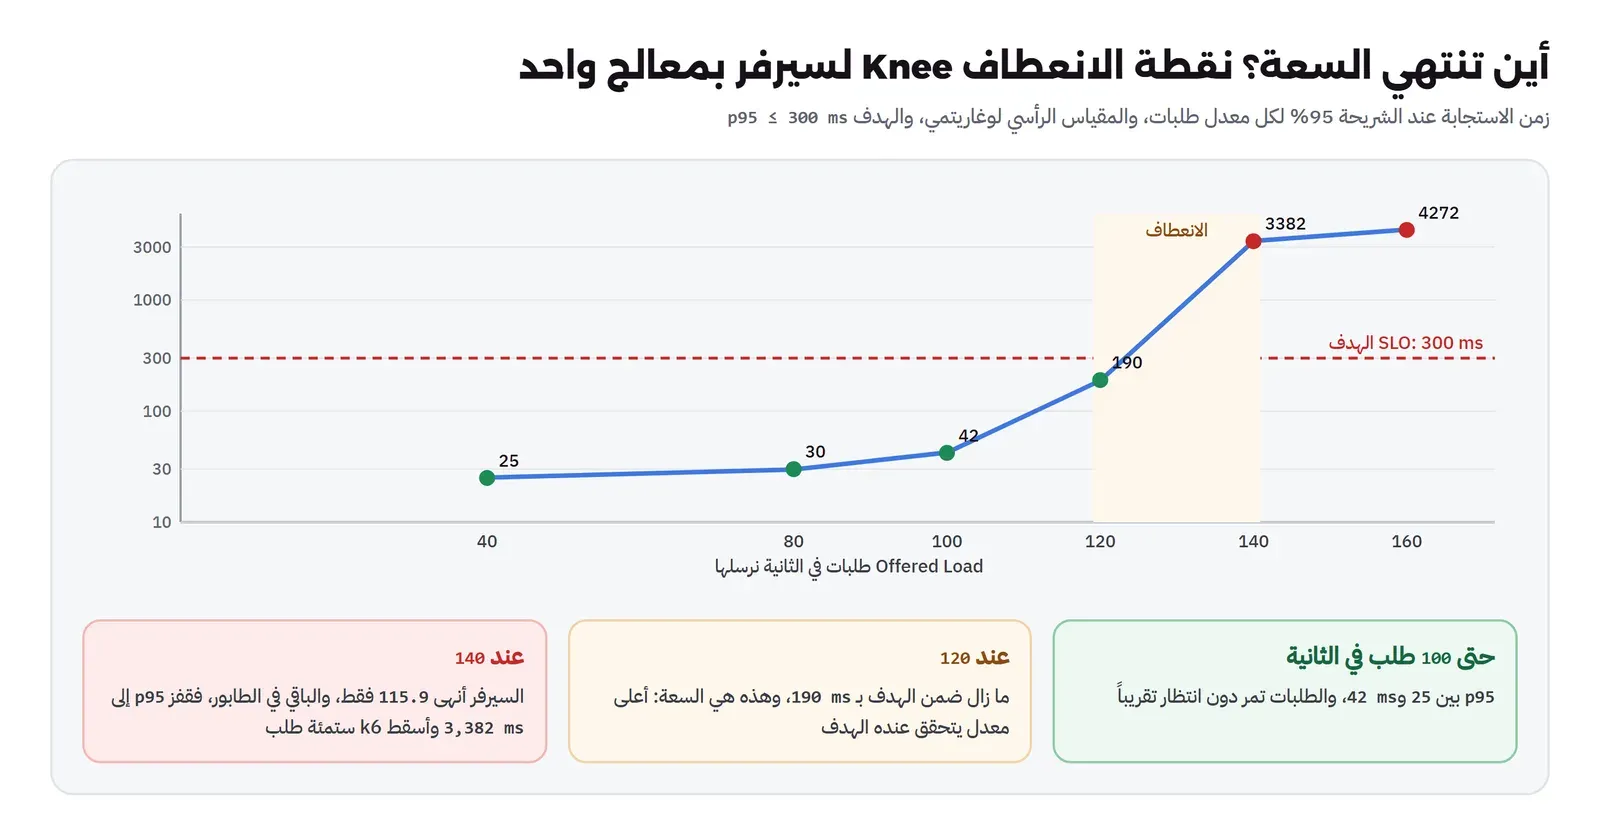
ولنقرأ المخرج بعين من يخطط:
- حتى 100 طلب في الثانية: الشريحة 95% بين 25 و42 ملي ثانية، والوسيط ثابت تقريباً حول 15 ملي ثانية، أي أن الطلبات لا تنتظر في أي طابور، وكل الزمن هو زمن الخدمة نفسه.
- عند 120: الوسيط ما زال 17 ملي ثانية، ولكن الشريحة 95% قفزت إلى 190 والشريحة 99% إلى 247. وهذا هو شكل الاقتراب من الامتلاء في الجدول السابق: أغلب الطلبات بخير، والطلبات التي تصل في لحظات التقارب تنتظر. والنتيجة ما زالت ضمن الهدف، فالسعة لهذا الإعداد 120 طلباً في الثانية، ولكن بهامش صغير جداً.
- عند 140: أنهى التطبيق 115.9 طلباً في الثانية فقط، وهذا هو حده الأعلى Throughput، والفرق بين ما يصل وما ينتهي يتراكم في الطابور، فوصل الوسيط إلى 3 ثوان، وأسقطت k6 ستمئة طلب لأنها استنفدت مستخدميها الأربعمئة. وفي الإنتاج هذه الطلبات الساقطة زوار ينتظرون ثم يغادرون، أو متصفحات تعيد المحاولة فتزيد الضغط.
- المعالج عند 120 كان 61%: وهذا يعيدنا إلى أول القصة، فلوحة المراقبة عند 61% كانت ستقول إن هناك مساحة لـ 60% إضافية، بينما الخدمة على بعد 20 طلباً من الانهيار. والسبب أن العينة لحظة واحدة من
docker stats، وأن عملية Python الواحدة لا تستطيع أصلاً أن تستخدم معالجها كاملاً بثبات، كما سنرى.
مشكلة واجهتنا: سيرفر أكبر لم يعط سعة أكبر GIL
الخطوة الطبيعية بعد هذه النتيجة أن نضاعف المعالج، وهذا ما يفعله أغلب الناس عندما يسمعون «السيرفر لا يكفي»: يرفعون الخطة من معالج إلى اثنين. فأعدنا نفس القياس بمعالجين للتطبيق، ونفس العملية الواحدة:
cpu2-w1 {"rate":100,"done":"100.0","med":"16","p95":"34","p99":"70","failed":"0.00","dropped":0,"vus":50} wr-sre-cap-app-1 58.30% 46.58MiB / 512MiB wr-sre-cap-db-1 82.97% 211.7MiB / 1GiB
cpu2-w1 {"rate":120,"done":"120.0","med":"20","p95":"149","p99":"285","failed":"0.00","dropped":0,"vus":50} wr-sre-cap-app-1 97.83% 47.88MiB / 512MiB wr-sre-cap-db-1 94.20% 220.9MiB / 1GiB
cpu2-w1 {"rate":140,"done":"139.8","med":"39","p95":"263","p99":"406","failed":"0.00","dropped":7,"vus":57} wr-sre-cap-app-1 87.85% 48.29MiB / 512MiB wr-sre-cap-db-1 105.38% 221.1MiB / 1GiB
cpu2-w1 {"rate":160,"done":"111.8","med":"2855","p95":"5001","p99":"5001","failed":"8.45","dropped":1407,"vus":400} wr-sre-cap-app-1 122.53% 71.99MiB / 512MiB wr-sre-cap-db-1 119.16% 220.8MiB / 1GiB
ضاعفنا المعالج، فارتفعت السعة من 120 إلى 140، أي 17% فقط، وعند 160 انهار التطبيق كما انهار قبلها بأخطاء وصلت إلى 8.45%. ولاحظ عمود معالج التطبيق: لم يتجاوز 122%، أي أن المعالج الثاني بقي فارغاً في أغلب الوقت. والسبب في مسرد Python الرسمي: قفل المفسر العام Global Interpreter Lock، واختصاراً GIL، يسمح لـ Thread واحد فقط بتنفيذ كود Python في كل لحظة داخل العملية الواحدة. فالعملية الواحدة مهما كان عدد الـ Threads فيها تنفذ كود Python على نواة واحدة، والزيادة الصغيرة التي رأيناها جاءت من الأجزاء التي تحرر القفل، مثل انتظار قاعدة البيانات وحساب SHA-256 في مكتبة C. وتوجد اليوم نسخة من Python بدون هذا القفل يشرحها دليل Free-threaded Python، ولكنها ليست الافتراضية، وأغلب السيرفرات في الإنتاج تعمل بالنسخة العادية.
وهذا الدرس أوسع من Python: قبل أن تشتري سيرفراً أكبر تأكد أن تطبيقك يستطيع أن يستخدمه. فتطبيق Node.js بعملية واحدة لا يستخدم إلا نواة واحدة لكوده، وقاعدة بيانات SQLite تكتب من عملية واحدة، وتطبيقات كثيرة لها مجمع اتصالات بحجم ثابت أو عدد Threads ثابت في إعدادها. والحل هنا عدة عمليات، أي WORKERS=2، وهو ما تفعله في الإنتاج أدوات مثل Gunicorn أو PM2 أو عدة نسخ من الـ Container خلف موزع طلبات:
cpu2-w2b {"rate":140,"done":"139.8","med":"26","p95":"269","p99":"398","failed":"0.00","dropped":2,"vus":52} wr-sre-cap-app-1 127.63% 74.67MiB / 512MiB wr-sre-cap-db-1 170.45% 241.8MiB / 1GiB
cpu2-w2b {"rate":160,"done":"153.6","med":"382","p95":"1393","p99":"1821","failed":"0.16","dropped":251,"vus":248} wr-sre-cap-app-1 193.45% 114.3MiB / 512MiB wr-sre-cap-db-1 200.98% 243.3MiB / 1GiB
cpu2-w2b {"rate":180,"done":"163.1","med":"903","p95":"2788","p99":"3239","failed":"0.84","dropped":620,"vus":400} wr-sre-cap-app-1 173.43% 100.6MiB / 512MiB wr-sre-cap-db-1 186.91% 243.9MiB / 1GiB
cpu2-w2b {"rate":200,"done":"165.4","med":"606","p95":"3324","p99":"3713","failed":"0.21","dropped":984,"vus":400} wr-sre-cap-app-1 190.71% 102.5MiB / 512MiB wr-sre-cap-db-1 206.56% 243.9MiB / 1GiB
الآن التطبيق يستخدم معالجيه فعلاً، 193% عند 160 طلباً، والحد الأعلى ارتفع إلى 165 طلباً في الثانية تقريباً. ولكن السعة ضمن الهدف بقيت 140، لأن عمود قاعدة البيانات وصل إلى 200%، أي معالجيها كاملين. أي أن عنق الزجاجة انتقل من التطبيق إلى قاعدة البيانات، وأي معالج إضافي للتطبيق بعد هذه النقطة لا يفيد. وهذا بالضبط ما يقصده أسلوب USE لبريندان غريغ: لكل مورد افحص الاستخدام والتشبع والأخطاء، والمورد الذي يتشبع أولاً هو الذي يحدد السعة، وقد شرحنا تشبع الموارد في مقال الإشارات الذهبية.
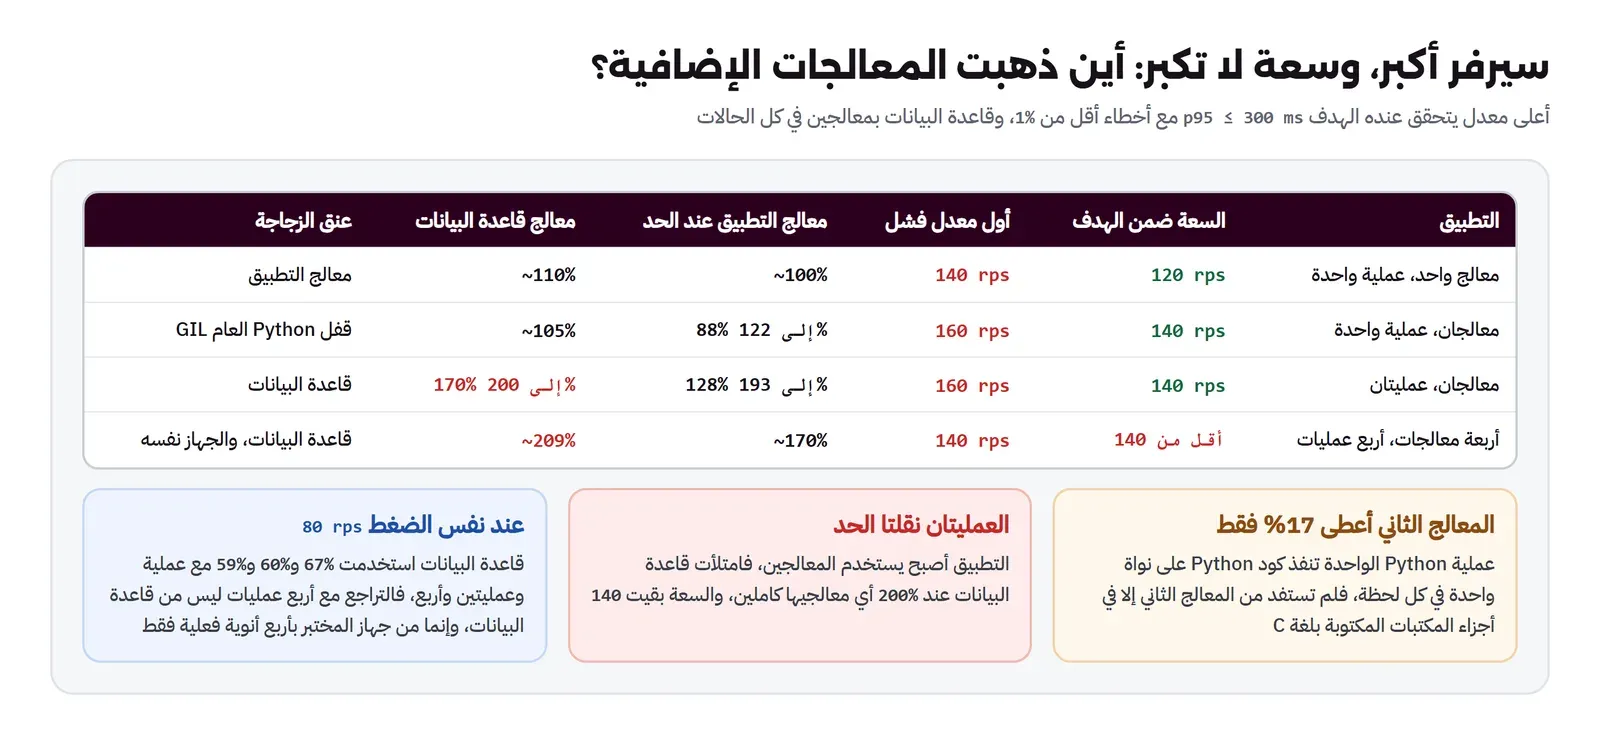
وجربنا بعد ذلك أربعة معالجات وأربع عمليات، فكانت النتيجة أسوأ: فشل عند 140 بشريحة 95% قدرها 2.5 ثانية. فهل أربع عمليات تزيد الضغط على قاعدة البيانات؟ قسنا الثلاثة بنفس الضغط المنخفض، 80 طلباً في الثانية، فكانت قاعدة البيانات عند 67% و60% و59%، أي نفس الكلفة لكل طلب تقريباً. فالتراجع لم يأت من قاعدة البيانات، وإنما من جهاز المختبر نفسه: معالجه أربع أنوية فعلية، وطلبنا أربعة للتطبيق واثنين لقاعدة البيانات ومعهما k6، فأصبحت الـ Containers تتنافس على أنوية غير موجودة. وفي الإنتاج يحدث نفس الشيء عندما تطلب من سيرفر افتراضي أكثر مما يملكه فعلاً، أو عندما تضع قاعدة البيانات والتطبيق على نفس السيرفر وتكبر أحدهما على حساب الآخر.
مشكلة ثانية: الجهاز الذي نقيس عليه لم يكن لنا وحدنا Noisy Neighbor
بعد هذه النتائج أردنا أن نكرر كل قياس مرتين لنتأكد من الأرقام، فكانت المفاجأة: نفس الإعداد، معالج واحد وعملية واحدة، ونفس المعدل 100 طلب في الثانية، الذي أعطى في المرة الأولى شريحة 95% قدرها 42 ملي ثانية، أعطى الآن هذا:
db2-app1-w1-rep1 {"rate":100,"done":"85.0","med":"2054","p95":"3944","p99":"4061","failed":"0.00","dropped":275,"vus":321} wr-sre-cap-app-1 100.95% wr-sre-cap-db-1 108.59% host 89%والعمود الجديد في آخر السطر هو معالج الجهاز كله من عداد Windows، وكان 89%. فالجهاز الذي نقيس عليه مشترك مع أعمال أخرى، وعندما قسنا الجهاز وحده دون أي اختبار منا كان بين 36% و48%. ثم أعدنا التجربة بترتيب أفضل، نعيد تشغيل التطبيق قبل كل تكرار وننتظر ثلاثين ثانية بين الخطوات، فكانت النتيجة أسوأ بكثير: 73% أخطاء عند 100 طلب والجهاز عند 90%. وهنا وجدنا خطأنا نحن: سلسلة القياس الأولى التي أوقفناها من أداة التشغيل كانت ما زالت تعمل في الخلفية، لأن إيقاف الأداة لم يوقف السكربت الذي أطلقته، فكان هناك اختباران يرسلان الطلبات لنفس التطبيق في نفس الوقت. فأوقفنا السلسلتين، وتأكدنا من عدم وجود أي Container لأداة k6 قبل كل قياس.
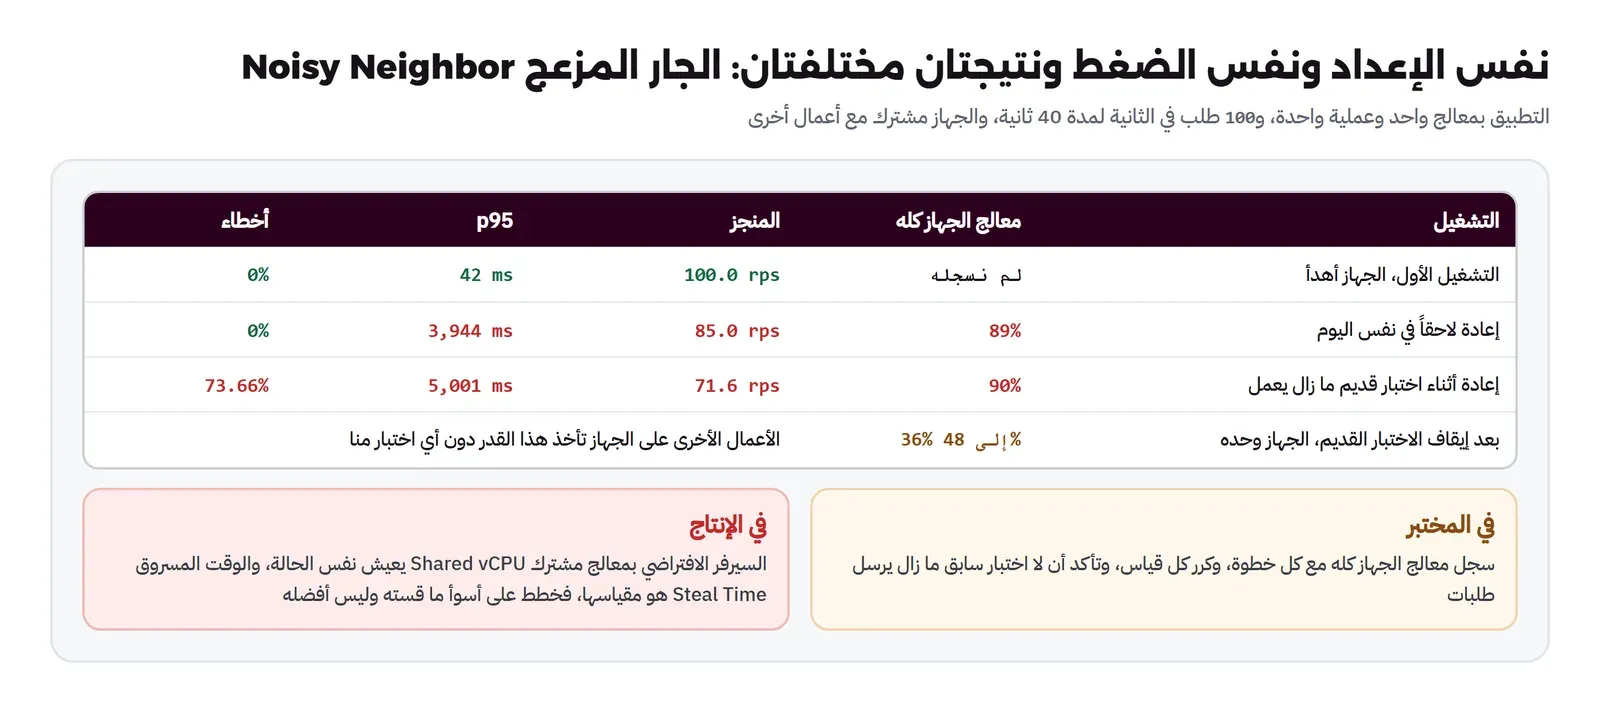
وهذه المشكلة ليست مشكلة مختبر فقط. فالسيرفر الافتراضي بمعالج مشترك Shared vCPU يعيش نفس الحالة كل يوم: الجيران على نفس الجهاز الفعلي يأخذون من المعالج، ويظهر ذلك في مقياس الوقت المسروق Steal Time الذي شرحناه في مقال تحليل أداء Linux في 60 ثانية. والقاعدة لتخطيط السعة: قس أكثر من مرة وفي أوقات مختلفة، وسجل حالة الجهاز مع كل قياس، وخطط على أسوأ نتيجة معقولة وليس أفضلها، لأن زوارك يأتون في كل الأوقات وليس فقط عندما يكون الجيران هادئين. وإذا كانت الخدمة مهمة فخطط على معالج مخصص Dedicated vCPU، حتى يكون الرقم الذي قسته هو الرقم الذي ستحصل عليه. وأما الاختبار المنسي الذي يعمل في الخلفية، فهو نفس الخطأ الذي يحدث في الفرق عندما يشغل شخص اختبار ضغط على بيئة الاختبار بينما يقيس زميله شيئاً آخر، ولذلك اجعل بيئة القياس محجوزة لشخص واحد في كل مرة، أو اجعل كل اختبار يكتب اسمه في سجل مشترك قبل أن يبدأ.
ماذا يحدث يوم الحملة إذا لم نفعل شيئاً؟ What If
لنعد إلى سؤال فريق التسويق بأرقام المختبر نفسها. الحملة تجلب 144 طلباً في الثانية، وأقرب خطوة قسناها للإعداد الحالي بمعالج واحد هي 140، وفي تلك الخطوة أنهى التطبيق 115.9 طلباً في الثانية فقط، أي أن حوالي 24 طلباً في الثانية زيادة على ما يستطيع، وكل ثانية تضيف 24 طلباً إلى الطابور. وبعد دقيقة واحدة يصبح في الطابور أكثر من ألف طلب نظرياً، ولذلك وصل الوسيط إلى ثلاث ثوان خلال الأربعين ثانية الأولى، وأسقطت k6 ستمئة طلب لأنها لم تجد مستخدماً افتراضياً متاحاً. والمهم أن الوسيط هو الذي ارتفع، وليس الذيل فقط، أي أن كل الزوار تقريباً شعروا بالبطء، وليس قلة منهم.
وفي الإنتاج الصورة أسوأ من المختبر لسببين. الأول أن الزوار الحقيقيين لا يسقطون بهدوء مثل k6، وإنما يضغطون زر التحديث بعد ثانيتين، فيرسلون طلباً جديداً بينما الأول ما زال في الطابور، فيرتفع الضغط الفعلي فوق 144. والثاني أن الطلبات التي تنتظر طويلاً تحجز اتصالات وذاكرة كما رأينا في قانون Little، فتبدأ أعطال ثانوية في أجزاء لم تكن مضغوطة أصلاً، مثل صفحة الدفع التي تشارك نفس قاعدة البيانات. ولذلك الخطة لأي حدث أكبر من السعة يجب أن تجيب عن سؤالين: كيف نرفع السعة قبل الحدث، وماذا تفعل الخدمة إذا جاء أكثر مما خططنا. والإجابة عن الثاني غالباً أن ترفض الخدمة الزائد بسرعة برسالة واضحة، أو تقدم نسخة أبسط من الصفحة، بدلاً من أن تجعل الجميع ينتظرون حتى تنهار، وهذا ما سوف نختبره بأيدينا في المقال القادم.
السعة ليست المعالج فقط: الاتصالات والذاكرة Connections and Memory
كل ما قسناه حتى الآن كان عن المعالج، لأنه المورد الذي امتلأ في هذا المتجر. ولكن نفس القياسات أظهرت مورداً آخر يكبر مع كل خطوة توسع، وهو عدد الاتصالات بقاعدة البيانات. فبعد قياس الضغط 80 طلباً في الثانية سألنا PostgreSQL عن عدد الاتصالات المفتوحة من التطبيق، فكانت 11 مع عملية واحدة، و14 مع عمليتين، و17 مع أربع، وبعد خطوات الضغط العالي مع أربع عمليات وصلت إلى 40 اتصالاً، أغلبها خاملة. والسبب أن لكل عملية مجمع اتصالات خاصاً بها، يفتح أربعة اتصالات عند البداية ويصل إلى عشرة عند الضغط. فإذا كبرت التطبيق إلى ثماني عمليات على سيرفرين، فأنت تطلب من قاعدة البيانات 160 اتصالاً، والإعداد max_connections كان 100، وكل اتصال في PostgreSQL عملية كاملة على السيرفر لها ذاكرتها، كما يشرح توثيق إعدادات الاتصال. ولذلك في تخطيط السعة يحسب عدد الاتصالات مثل المعالج: مجموع المجمعات في كل النسخ يجب أن يكون أقل من حد قاعدة البيانات بهامش، وإلا فشلت النسخ الجديدة في الاتصال في نفس اللحظة التي أضفتها فيها لتتحمل الضغط.
والذاكرة كذلك: التطبيق بعملية واحدة استخدم حوالي 46 MB، وبأربع عمليات بعد الضغط حوالي 219 MB، أي أن الذاكرة تكبر مع عدد العمليات وليس مع عدد الطلبات فقط، والحد في المختبر كان 512 MB. وفي الإنتاج انظر إلى ثلاثة أشياء مع كل خطوة توسع: الذاكرة لكل عملية مضروبة في عدد العمليات، وذاكرة قاعدة البيانات لكل اتصال مضروبة في عدد الاتصالات، والقرص إذا كانت البيانات تكبر مع الزمن، لأن جدولاً يكبر 10% شهرياً قد يخرج من الذاكرة المؤقتة لقاعدة البيانات بعد أشهر، فيتغير زمن الاستعلام نفسه، وقد رأينا في مقال التخزين المؤقت ماذا يحدث عندما تصبح الذاكرة أصغر من البيانات.
وقبل أي ترقية اسأل سؤالاً أخيراً: هل التحسين أرخص من السيرفر؟ ففي هذا المتجر يأخذ الاستعلام الواحد حوالي 11 ملي ثانية داخل PostgreSQL، وقد ظهر ذلك في خطة التنفيذ EXPLAIN ANALYZE التي شغلناها قبل القياس: Execution Time: 10.855 ms، لأنه يجمع مراجعات خمسمئة منتج في القسم ليرتب أفضل عشرين. فإذا حفظنا عدد المراجعات في عمود في جدول المنتجات يحدث عند كل مراجعة جديدة، يصبح الاستعلام قراءة عشرين سطراً من فهرس، وتنخفض كلفة الطلب على قاعدة البيانات عدة مرات، وترتفع السعة أكثر من أي معالج إضافي. وهذا لا يعني أن كل تحسين يستحق، فوقت المطورين له كلفة أيضاً، ولكن تخطيط السعة الجيد يضع الخيارين بجانب بعضهما بالأرقام: كم يكلف السيرفر الأكبر شهرياً، وكم يوم عمل يحتاج التحسين، وكم يضيف كل منهما من السعة.
التوقع Forecasting: متى تنفد السعة؟
الآن نعرف السعة، والخطوة الثانية أن نعرف الطلب. ولنفرض أن أعلى دقيقة في سجل Nginx خلال الشهر الماضي كانت 48 طلباً في الثانية لهذا المسار، وأن الحركة تنمو بنسبة 8% شهرياً منذ ستة أشهر، وهذا هو النمو الطبيعي Organic Growth. وفوقه النمو غير الطبيعي Inorganic Growth: حملة التسويق التي تتوقع ثلاثة أضعاف الذروة. والسكربت forecast.py يحسب لكل إعداد كم شهراً يبقى قبل أن تأكل الذروة الهامش، وهل يتحمل يوم الحملة:
docker run --rm -v "$PWD:/w" -w /w python:3.13-slim python forecast.py 48 8 3 30 1cpu-1proc=120 2cpu-1proc=140 2cpu-2proc=140peak today 48 rps, organic growth 8%/month, campaign x3, keep 30% headroom
config capacity usable used today months left campaign day
1cpu-1proc 120 84 40% 7.3 overload
2cpu-1proc 140 98 34% 9.3 overload
2cpu-2proc 140 98 34% 9.3 overload
month peak campaign
0 48 144
3 60 181
6 76 229
9 96 288
12 121 363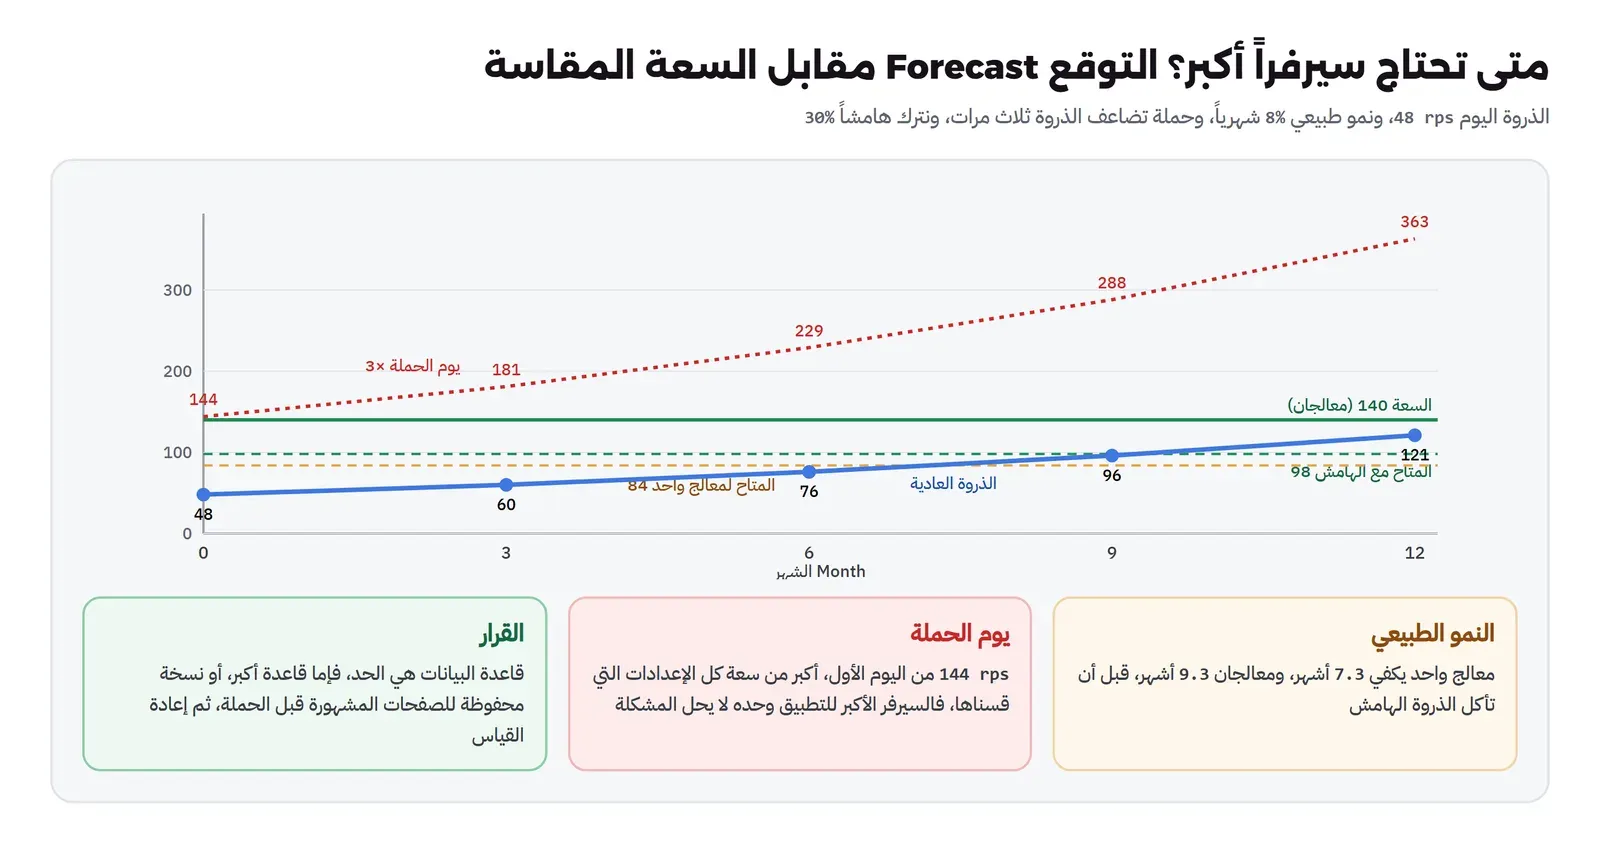
والجدول يجيب عن سؤال فريق التسويق بوضوح لم يكن ممكناً من نسبة المعالج. فبالنمو الطبيعي وحده يكفي الإعداد الحالي 7.3 أشهر قبل أن تصل الذروة إلى 70% من سعته، ومضاعفة المعالج تضيف شهرين فقط. أما يوم الحملة فيحتاج 144 طلباً في الثانية من اليوم الأول، وهذا أكبر من سعة كل الإعدادات التي قسناها، حتى بدون أي هامش. أي أن الإجابة على «هل نحتاج سيرفراً أكبر؟» هي: سيرفر أكبر للتطبيق وحده لا يكفي، لأن قاعدة البيانات هي الحد عند 140 تقريباً. والخيارات الحقيقية ثلاثة، ولكل منها كلفة: قاعدة بيانات بمعالجات أكثر ثم إعادة القياس لنعرف أين ينتقل الحد بعدها، أو نسخة محفوظة لنتائج الأقسام المشهورة، لأن نفس القسم يطلبه آلاف الزوار في يوم الحملة كما شرحنا في مقال التخزين المؤقت على كل طبقة، أو رفض الزائد Load Shedding بشكل منظم بدلاً من أن ينهار كل شيء، كما في مقال منع الخدمة البطيئة من إسقاط النظام.
ولاحظ أن التوقع نفسه يحتاج صيانة مثل السعة. فالنمو 8% شهرياً رقم من الماضي، وقد يتغير بإطلاق تطبيق جوال أو بتغير في محركات البحث، ولذلك راجع التوقع كل شهر بالرقم الحقيقي للذروة، وكل حملة أو إطلاق كبير يجب أن يصل إلى فريق التشغيل قبل موعده بأسابيع، مع تقدير للحركة، وهذا ما يقصده كتاب Google SRE بإدخال النمو غير الطبيعي في التوقع. ويوصي فصل التعامل مع الضغط الزائد في نفس الكتاب بأن تقاس السعة بالموارد التي يستهلكها الطلب فعلاً وليس بعدد الطلبات فقط، لأن طلبات مختلفة تكلف أشياء مختلفة، وهذا ينطبق على متجرنا: قياسنا لمسار المنتجات وحده، ومسار الدفع له كلفة أخرى يجب أن تقاس.
كم هامشاً تترك؟ Headroom مع N+1
اخترنا في المثال هامشاً قدره 30%، أي أننا نخطط لاستخدام 70% من السعة فقط. وهذا الرقم ليس عشوائياً، وإنما من ثلاثة مصادر رأيناها في هذا المقال. الأول نظرية الطوابير: عند 70% الزمن ثلاثة أضعاف زمن الخدمة، وبعدها يرتفع بسرعة. والثاني التباين: رأينا أن نفس القياس يختلف من وقت لآخر، والارتفاعات المفاجئة في الحركة لا تظهر في الذروة الشهرية. والثالث العمليات اليومية: النشر الذي يعيد تشغيل نصف النسخ، والنسخة الاحتياطية الليلية التي تأخذ من قاعدة البيانات، ومهمة مجدولة تعمل في نفس الساعة.
وإذا كان لديك أكثر من سيرفر للتطبيق فالسؤال يصبح: هل تتحمل الخدمة الذروة إذا تعطل سيرفر واحد؟ ويسمى هذا التخطيط N+1، أي أن تكون السعة بعد خروج سيرفر واحد كافية للذروة. فإذا كان عندك سيرفران سعة كل منهما 140 طلباً، فالسعة الكلية 280، ولكن سعة N+1 هي 140 فقط، وهي التي تقارنها بالذروة، وليس 280. وقد شرحنا التكرار ونقاط الفشل الواحدة في مقال التوفر العالي، والمهم هنا أن الهامش والتكرار يحسبان معاً: هامش 30% فوق سعة N+1، وليس فوق السعة الكلية. وفي المتاجر التي تعتمد على موسم واحد كبير يكون الهامش لذلك الموسم مختلفاً عن الهامش اليومي، فقد تستأجر سعة إضافية لأسبوع الحملة ثم تتركها.
التوسع العمودي أم الأفقي؟ Vertical vs Horizontal
التوسع العمودي Vertical Scaling يعني سيرفراً أكبر، والأفقي Horizontal Scaling يعني سيرفرات أكثر. والعمودي أبسط بكثير، فلا يحتاج موزع طلبات ولا تغييراً في التطبيق، وأغلب التطبيقات تعمل عليه دون أي تعديل، ولكن المختبر بين حدوده: التطبيق يجب أن يستطيع استخدام المعالجات الإضافية، والسيرفر الأكبر له سقف، وكل ترقية تحتاج إعادة تشغيل غالباً، والسيرفر الأكبر الواحد ما زال نقطة فشل واحدة. والأفقي يحل هذه المشاكل، ولكنه يحتاج تطبيقاً بلا حالة Stateless، وموزع طلبات، وقاعدة بيانات تتحمل اتصالات من كل النسخ، وهنا انتبه لمجمع الاتصالات: كل نسخة إضافية تفتح اتصالاتها، وأربع نسخ بعشرة اتصالات لكل عملية مع عمليتين لكل نسخة تعني 80 اتصالاً، والإعداد max_connections في قاعدة البيانات كان 100. وقد شرحنا متى تحتاج فعلاً منصة مثل Kubernetes للتوسع الأفقي في مقال هل تحتاج Kubernetes فعلاً.
والقاعدة العملية لفريق صغير: ابدأ عمودياً حتى تصل إلى سيرفر متوسط بأربعة أو ثمانية معالجات، لأن الكلفة الإدارية للتوسع الأفقي حقيقية، وافصل قاعدة البيانات عن التطبيق قبل أي شيء آخر، لأنها غالباً أول مورد يمتلئ كما رأينا، وتوسعها مختلف تماماً عن توسع التطبيق. ثم انتقل أفقياً للتطبيق عندما تحتاج N+1 أو عندما يصبح السيرفر الواحد أغلى من اثنين.
كيف يبدو هذا في فريق حقيقي؟ Capacity Review
في الشركات التي تعمل بهذا بشكل جيد لا يكون تخطيط السعة مشروعاً يحدث قبل الحملة، وإنما مراجعة دورية قصيرة، مرة كل ربع سنة مثلاً، فيها أربعة أرقام لكل خدمة مهمة: الذروة الحالية من السجلات، ونسبة النمو، والسعة المقاسة في آخر اختبار، وعدد الأشهر المتبقية قبل أن تأكل الذروة الهامش. وأي خدمة باقي لها أقل من ستة أشهر تدخل خطة الربع التالي، سواء كان الحل سيرفراً أكبر أو تحسيناً أو تخزيناً مؤقتاً. وبين المراجعات تراقب لوحة واحدة الاتجاه: الذروة اليومية مقسومة على السعة المقاسة، أي الاستخدام الحقيقي بلغة الخدمة وليس بلغة المعالج، مع تنبيه هادئ في قناة الفريق إذا تجاوز 60% لعدة أيام، وليس تنبيهاً يوقظ أحداً، كما ناقشنا في مقال التنبيهات.
وأهم ما في هذه العملية أن السعة المقاسة رقم له تاريخ صلاحية. فكل نسخة جديدة من التطبيق قد تغير كلفة الطلب، وكل ميزة جديدة قد تضيف استعلاماً، ولذلك يعاد اختبار السعة بعد التغييرات الكبيرة، وبعضها يدخل في خط النشر كاختبار ضغط قصير بمعدل ثابت يقارن الشريحة 95% بالنسخة السابقة، كما شرحنا في مقال اختبار الضغط. والقناة الثانية المهمة هي التواصل مع الفرق الأخرى: فريق التسويق الذي يخبر فريق التشغيل بموعد الحملة قبل شهر يعطيه وقتاً ليقيس ويقرر، والذي يخبره قبل يوم يعطيه فقط فرصة ليشاهد الانهيار.
جدول القرار: هل تحتاج سيرفراً أكبر؟ Decision Table
| ما تراه في القياس | ما يعنيه | القرار |
|---|---|---|
| الذروة أقل من 70% من السعة لأكثر من 6 أشهر في التوقع | لا حاجة لأي تغيير الآن | راجع التوقع كل شهر، وأعد القياس بعد كل تغيير كبير في الكود |
| معالج التطبيق ممتلئ، وقاعدة البيانات بعيدة عن الامتلاء | التطبيق هو عنق الزجاجة | تأكد أنه يستخدم كل الأنوية أولاً، ثم معالجات أكثر أو نسخة ثانية |
| معالج التطبيق لا يتجاوز نواة واحدة مهما زادت المعالجات | قفل أو عملية واحدة | عدة عمليات أو نسخ، وليس سيرفراً أكبر |
| قاعدة البيانات عند حدها | عنق الزجاجة في البيانات | استعلامات أخف أو فهارس، ثم تخزين مؤقت للقراءات المشهورة، ثم قاعدة أكبر |
| النتائج تختلف كثيراً بين تكرارات نفس القياس | جار مزعج أو اختبار آخر يعمل | معالج مخصص، وخطط على أسوأ نتيجة |
| حملة أو إطلاق يتجاوز السعة | نمو غير طبيعي مؤقت | سعة مؤقتة، أو نسخة محفوظة، أو رفض منظم للزائد، مع اختبار قبل الموعد |
أخطاء شائعة Common Mistakes
- الحكم من نسبة المعالج: المعالج كان 61% والخدمة على بعد 20 طلباً من الانهيار.
- اختبار الضغط بنموذج مغلق: المستخدمون الافتراضيون ينتظرون الردود فيخففون الضغط تلقائياً، فلا ترى الطابور الذي يراه الزوار الحقيقيون.
- شراء معالجات لا يستخدمها التطبيق: المعالج الثاني أعطى 17% بسبب GIL.
- تكبير التطبيق وعنق الزجاجة في قاعدة البيانات: عمليتان على معالجين لم تغيرا السعة لأن قاعدة البيانات وصلت إلى 200%.
- القياس على جهاز مشترك دون تسجيل حالته: نفس الاختبار أعطى 42 ملي ثانية مرة وأربع ثوان مرة.
- اختبار منسي يعمل في الخلفية: اختباران على نفس التطبيق يعطيان أرقاماً لا معنى لها.
- التوقع من المتوسط اليومي: الخدمة تنهار في الذروة، فخطط على أعلى دقيقة.
- نسيان النمو غير الطبيعي: الحملة تضاعف الذروة ثلاث مرات في يوم واحد.
- حساب الهامش على السعة الكلية بدلاً من سعة N+1: سيرفران لا يعطيانك 280 طلباً إذا تعطل أحدهما.
- بيانات اختبار صغيرة: ملف التهيئة نفسه فشل عندما وصلت الأرقام إلى المليون.
قائمة تحقق Checklist
| البند | كيف تتحقق منه |
|---|---|
| الهدف مكتوب | شريحة زمن الاستجابة ونسبة الأخطاء التي تعرف السعة |
| السعة مقاسة لكل مسار مهم | اختبار ضغط مفتوح بخطوات، وأعلى معدل يتحقق عنده الهدف |
| عنق الزجاجة معروف | استخدام كل مورد عند الحد: التطبيق، قاعدة البيانات، الاتصالات، الذاكرة |
| التطبيق يستخدم كل الأنوية | معالج التطبيق يتجاوز نواة واحدة عند الضغط |
| القياس مكرر وبيئته معروفة | تكراران على الأقل، ومعالج الجهاز مسجل، ولا اختبار آخر يعمل |
| الطلب من الذروة | أعلى دقيقة من السجلات، ونسبة النمو الشهرية |
| الأحداث القادمة في التوقع | الحملات والإطلاقات تصل إلى فريق التشغيل قبل موعدها بأسابيع |
| الهامش محسوب على N+1 | السعة بعد خروج سيرفر واحد، ناقص 30% |
| القياس يعاد | بعد كل تغيير كبير في الكود أو البيانات أو العتاد |
تدريب عملي Practice
- أعد قياس الإعداد بمعالجين وعمليتين مع
DB_CPUS=3، وانظر هل ترتفع السعة ضمن الهدف فوق 140، وأي مورد يمتلئ بعدها. - أضف فهرساً مركباً يجعل استعلام المراجعات أخف، أو احفظ نتيجة كل قسم لمدة دقيقة في ذاكرة التطبيق، ثم أعد الخطوات من 100 إلى 200 وقارن السعة بالجدول.
حذف المختبر Cleanup
docker compose -p wr-sre-cap down -v
docker rmi wr-sre-cap-app:1 grafana/k6:2.3.0
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- السعة أعلى معدل يتحقق عنده الهدف، وتقاس باختبار ضغط مفتوح، وليس من نسبة المعالج: المعالج كان 61% والخدمة على بعد 20 طلباً من الانهيار.
- نظرية الطوابير تفسر الانعطاف: عند 70% الزمن ثلاثة أضعاف زمن الخدمة، وعند 99% مئة ضعف، ولذلك نخطط عند 70%.
- بمعالج واحد كانت السعة 120 طلباً، وبمعالجين 140 فقط بسبب GIL، وبعمليتين بقيت 140 لأن قاعدة البيانات وصلت إلى حدها.
- نفس القياس أعطى 42 ملي ثانية مرة وأربع ثوان مرة بسبب جهاز مشترك واختبار منسي، فكرر القياس وسجل حالة الجهاز وخطط على الأسوأ.
- النمو الطبيعي 8% شهرياً يعطي الإعداد الحالي 7.3 أشهر، والحملة بثلاثة أضعاف تتجاوز كل الإعدادات من اليوم الأول.
- الهامش يحسب على سعة N+1، والقرار يبدأ من عنق الزجاجة: سيرفر أكبر للمورد الممتلئ، وليس لكل شيء.
وفي المقال القادم من هذه المرحلة بإذن الله ننتقل من سؤال «كم نتحمل؟» إلى سؤال «ماذا يحدث عندما يتعطل شيء؟»، ونجرب التعطل بأيدينا قبل أن يحدث وحده، في هندسة الفوضى Chaos Engineering.
 دليلاختبار الضغط Load Testing للمبتدئينلماذا يعمل تطبيقك مع خمسة مستخدمين وينهار مع خمسمئة، وكيف تكتشف ذلك وتصلحه قبل يوم الإطلاق.
 دليلالإشارات الذهبية Golden Signals: ماذا تقيس في خدمتك؟نضيف القياس إلى خدمة دفع حقيقية ونضغط عليها حتى تنهار، فنرى لماذا انتظر المستخدم ست ثوان والمعالج عند 5% دون خطأ واحد.
 دليلتحليل أداء سيرفر Linux في 60 ثانية: ماذا تكتب أولاً؟ماذا تكتب أول ما تدخل إلى سيرفر بطيء، وكيف تعرف خلال دقيقة هل المشكلة في المعالج أم الذاكرة أم القرص أم الشبكة.
 دليلمفاهيم التوفر العالي High Availability للمبتدئينماذا يعني أن تبقى خدمتك تعمل رغم تعطل جزء منها، وكيف تحسب التوفر وتجد نقاط الفشل الواحدة وتقرر متى يستحق ذلك تكلفته.
 دليلكيف تمنع خدمة بطيئة من إسقاط نظامك كله؟لماذا تسقط خدمة بطيئة واحدة تطبيقك السليم، وكيف تحميه بالمهلة وإعادة المحاولة المحدودة وقاطع الدائرة ورفض الزائد.
 دليلالتخزين المؤقت Caching على كل طبقة من موقعكحالة حقيقية من هذا الموقع: كيف نزلت صفحات Ghost من ثوان إلى أجزاء من الثانية، وما الذي تعطل بين المتصفح والـ CDN والسيرفر وقاعدة البيانات.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة الدليل وتنفيذ المختبر بإصدارات k6 2.3.0 وPython 3.13 مع psycopg 3.3.8 وPostgreSQL 18.6 على Docker Engine 29.8.0.


