إذا كان عندك سكربت يأخذ نسخة احتياطية Backup من قاعدة البيانات كل ليلة، وتنام مطمئناً لأن السكربت موجود في جدول المهام المجدولة Cron Jobs منذ سنة، فهذه القصة لك. ففي ليلة 31 يناير 2017 كان مهندس في GitLab يحاول إصلاح النسخة الثانوية من قاعدة بيانات موقع GitLab.com، وبعد يوم طويل من المشاكل كتب أمر حذف مجلد البيانات في نافذة الطرفية الخطأ، فحذفه من السيرفر الرئيسي Primary بدل السيرفر الثانوي. وانتبه بعد ثانية أو ثانيتين وأوقف الأمر، ولكن من قرابة 300 جيجابايت لم يبق إلا 4.5 جيجابايت.
والخطأ البشري هنا ليس هو القصة الأهم، فكل مهندس يمكن أن يكتب أمراً في المكان الخطأ. القصة الأهم بدأت بعد دقائق، عندما ذهب الفريق إلى النسخ الاحتياطية ليستعيد منها، فاكتشف أن خمس طرق للنسخ والتكرار كانت موجودة على الورق، ولم تكن واحدة منها تعمل بالشكل الذي يظنونه. والذي أنقذ الموقع في النهاية نسخة أخذها نفس المهندس بيده قبل ست ساعات لسبب لا علاقة له بالنسخ الاحتياطي أصلاً.
وسوف نناقش في هذا المقال ما يلي:
- كيف كانت قاعدة بيانات GitLab.com مبنية، ولماذا كانت نقطة ضعف معروفة.
- اليوم الذي بدأ برسائل مزعجة Spam وانتهى بنسخة ثانوية متأخرة.
- لحظة الحذف، ولماذا حدثت على السيرفر الخطأ.
- الطرق الخمس للنسخ الاحتياطي، ولماذا فشلت كل واحدة منها.
- الاستعادة التي بثتها GitLab على الهواء، وما الذي ضاع فعلاً.
- تحليل السبب الجذري Root Cause بطريقة «لماذا خمس مرات»، وما غيرته الشركة بعدها.
- الدروس التي تطبقها على نسخك الاحتياطية من اليوم.
كيف كانت قاعدة البيانات مبنية؟
كان موقع GitLab.com في ذلك الوقت يعتمد على قاعدة بيانات PostgreSQL واحدة رئيسية، ومعها سيرفر ثانوي Secondary يعمل في وضع الاستعداد Hot Standby، أي أنه ينسخ كل تغيير من الرئيسي أولاً بأول عن طريق التكرار Replication، ولكنه لا يستقبل أي طلبات، ووظيفته الوحيدة أن يكون جاهزاً إذا تعطل الرئيسي. واسم السيرفر الرئيسي كان db1.cluster.gitlab.com واسم الثانوي db2.cluster.gitlab.com، ولاحظ أن الفرق بين الاسمين حرف واحد، وهذا سوف يهمنا بعد قليل.
ويقول تقرير ما بعد الحادثة Postmortem الذي نشرته GitLab نفسها إن هذا التصميم يجعل قاعدة بيانات واحدة تتحمل كل الضغط Load، وإن السيرفر الرئيسي كان نقطة فشل واحدة Single Point of Failure سببت لهم مشاكل قبل الحادثة، منها توقف في نوفمبر 2016 بسبب تضخم جدول في القاعدة. لذلك كان أحد المهندسين في يوم الحادثة يعمل على حل هذه المشكلة نفسها: تجربة أداة pgpool-II في بيئة الاختبار Staging لتوزيع الاستعلامات على أكثر من سيرفر.
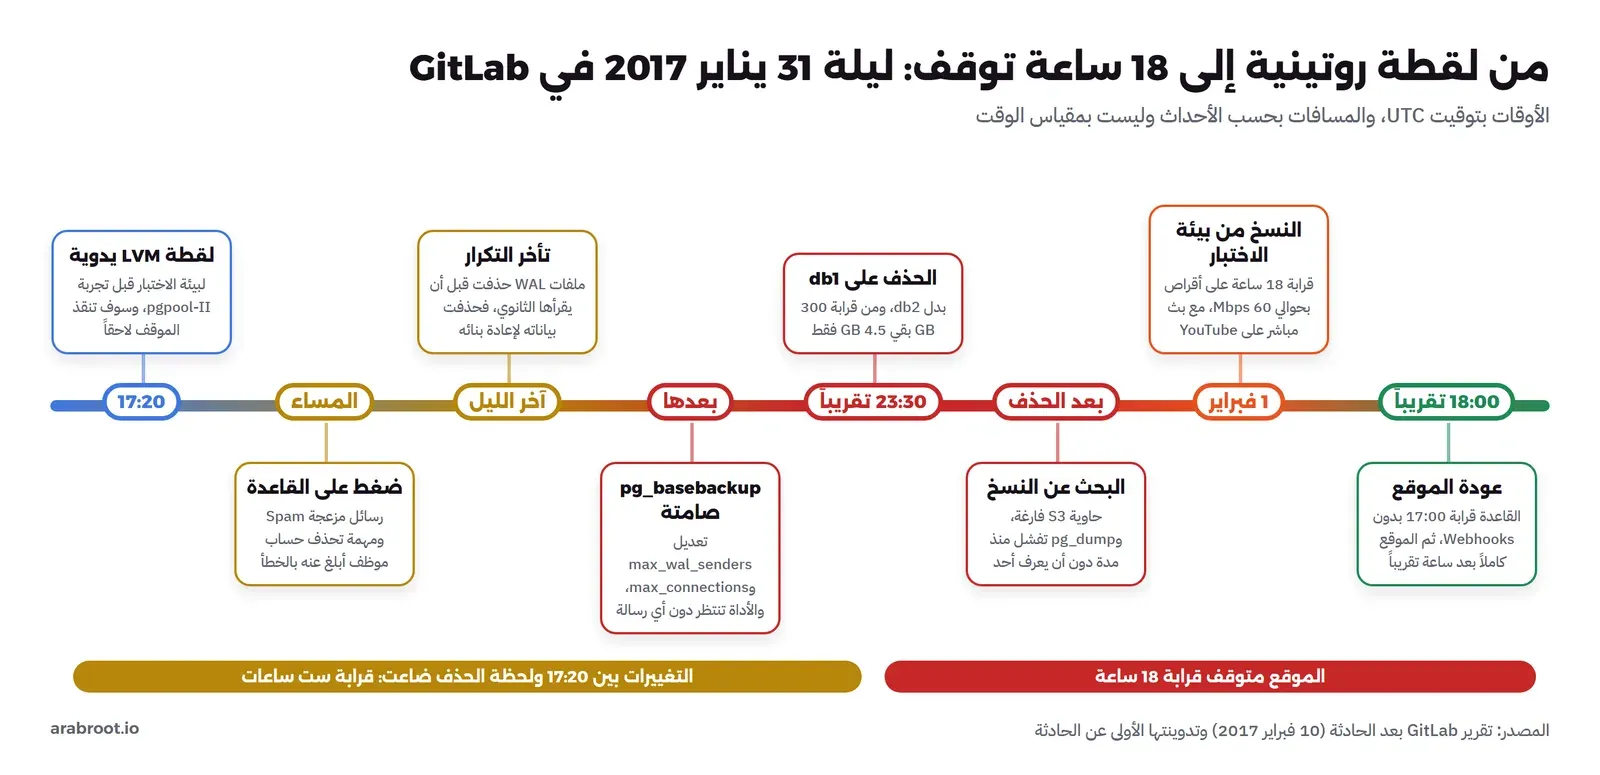
وقبل أن يبدأ هذا المهندس عمله في الساعة 17:20 بتوقيت UTC أخذ لقطة LVM Snapshot يدوية من قاعدة الإنتاج ونقلها إلى بيئة الاختبار، والسبب أن اختبار الضغط يحتاج بيانات حديثة، والنسخة التي تنقل تلقائياً إلى بيئة الاختبار تؤخذ مرة واحدة كل 24 ساعة. هذه اللقطة اليدوية كانت عملاً روتينياً عادياً، ولم يكن أحد يعرف أنها سوف تكون أهم ملف في الشركة بعد ست ساعات.
يوم بدأ بالرسائل المزعجة Spam
في المساء بدأت قاعدة البيانات تعاني من ضغط غير عادي، وكان الفريق يشك أن السبب حسابات تنشر محتوى مزعجاً بكميات كبيرة، فقد كان الموقع يعاني من مشاكل مشابهة طوال الأسبوع السابق ولكن ليس بهذه الشدة. وكانت النتيجة أن كثيراً من المستخدمين لم يستطيعوا إضافة تعليقات على المهام Issues وطلبات الدمج Merge Requests. فحظر الفريق عناوين IP التي يأتي منها المحتوى المزعج، وحذف حسابات تنشره، وحذف حساباً كان يستخدم مستودعاً كأنه شبكة توصيل محتوى CDN، فقد كان 47 ألف عنوان IP يسجلون الدخول بنفس الحساب.
واكتشفوا لاحقاً أن جزءاً من الضغط كان له سبب آخر لا يخطر على البال: مهمة تعمل في الخلفية تحاول حذف أحد موظفي GitLab مع كل بياناته. فقد أبلغ شخص يريد الإزعاج عن حساب هذا الموظف بأنه حساب مسيء، وكان نظام التعامل مع البلاغات يسهل على من يراجعها أن يتجاوز التفاصيل، فجدول الحساب للحذف بالخطأ. وهنا أول درس صغير قبل أن نصل إلى الكارثة: أداة الإدارة التي تحذف حساباً بنقرة واحدة دون أن توضح من هو صاحبه هي أداة خطرة، حتى لو لم تكن جزءاً من قاعدة البيانات.
النسخة الثانوية تتأخر Replication Lag
وفي آخر الليل وصل تنبيه بأن التكرار تأخر كثيراً، والسبب أن السيرفر الثانوي لم يستطع اللحاق بالكتابات الكثيرة على الرئيسي. ولكي تفهم ما حدث بعدها تحتاج أن تعرف أن PostgreSQL يكتب كل تغيير أولاً في ملفات تسمى سجل الكتابة المسبقة Write-Ahead Log، واختصاراً WAL، والسيرفر الثانوي يقرأ هذه الملفات ليطبق نفس التغييرات عنده. فإذا تأخر الثانوي كثيراً، وحذف الرئيسي ملفات WAL القديمة قبل أن يقرأها الثانوي، فلا توجد طريقة ليكمل الثانوي من حيث توقف.
وهذا ما حدث بالضبط، ولم تكن GitLab تحفظ أرشيفاً لملفات WAL في مكان آخر WAL Archiving، فلم يبق إلا الحل اليدوي: حذف مجلد البيانات بالكامل من السيرفر الثانوي، ثم تشغيل أداة pg_basebackup لتنسخ القاعدة من جديد من الرئيسي إلى الثانوي. والإجراء نفسه معروف، ولكن التقرير يقول إنه لم يكن مؤتمتاً ولا موثقاً بشكل جيد، والمسودة الأولى للتقرير تصفه بأنه هش جداً ويعتمد على مجموعة من سكربتات Shell المتفرقة.
فذهب المهندس إلى السيرفر الثانوي وحذف مجلد البيانات وشغل pg_basebackup، فتوقفت الأداة دون أن تطبع أي شيء مفيد، رغم أنه شغلها مع خيار الإخراج المفصل verbose. وبعد عدة محاولات ظهرت رسالة تقول إن الرئيسي لا يملك اتصالات تكرار كافية، وهذا العدد يتحكم فيه الإعداد max_wal_senders، فرفعوه من القيمة الافتراضية 3 إلى 32. وعند إعادة التشغيل رفض PostgreSQL أن يعمل وقال إن عدد الإشارات Semaphores المطلوبة كبير جداً، والسبب إعداد آخر هو max_connections الذي كان مضبوطاً على 8000 اتصال منذ قرابة سنة، وهو رقم مبالغ فيه جداً ولكنه لم يسبب مشكلة حتى تلك الليلة. فخفضوه إلى 2000 فعاد PostgreSQL للعمل.
ومع ذلك بقيت pg_basebackup معلقة لا تفعل شيئاً، فشغلها المهندس مع أداة strace ليرى على ماذا تنتظر، فلم يجد إلا أنها تنتظر في استدعاء نظام، دون أي معلومة تشرح السبب. والذي عرفوه لاحقاً من مهندس آخر لم يكن موجوداً في تلك الليلة أن هذا سلوك طبيعي: الأداة تنتظر بصمت حتى يبدأ الرئيسي بإرسال البيانات، وقد يستغرق ذلك عشر دقائق، ولم يكن هذا مكتوباً لا في دليل التشغيل Runbook الخاص بهم ولا في التوثيق الرسمي للأداة.
ولاحظ هنا كيف تتراكم الأشياء الصغيرة: إعداد قديم مبالغ فيه، وأداة صامتة، وإجراء غير موثق، ومهندس تجاوز الوقت الذي كان ينوي أن ينهي فيه عمله. فالمسودة الأولى للتقرير تذكر أن هذا المهندس كان قد قال في وقت سابق من الليلة إنه سوف ينهي عمله لأن الوقت تأخر عنده، ولكنه بقي بسبب مشاكل التكرار التي ظهرت فجأة، وتقول المسودة بكلمات صريحة إن الإحباط بدأ يظهر عند هذه النقطة.
الحذف على السيرفر الخطأ
قرابة الساعة 23:30 بتوقيت UTC فكر المهندس أن pg_basebackup ربما ترفض العمل لأن مجلد البيانات موجود على الثانوي، حتى لو كان فارغاً، أو لأن المحاولات السابقة تركت فيه بعض الملفات. فقرر أن يحذف المجلد مرة أخرى، وكتب أمر الحذف وهو يظن أنه في نافذة السيرفر الثانوي db2، ولكنه كان في نافذة الرئيسي db1. وبعد ثانية أو ثانيتين انتبه للاسم وأوقف الأمر، ولكن الحذف كان قد أخذ قرابة 300 جيجابايت من بيانات الإنتاج، ولم يبق من المجلد إلا 4.5 جيجابايت تقريباً.
والآن أصبح الوضع كما يلي: السيرفر الرئيسي فقد أغلب بياناته، والسيرفر الثانوي حذفت بياناته قبل ساعة بشكل متعمد لإعادة بنائه، فلا يمكن الاستعادة من أي منهما. فأوقف الفريق الموقع وأعلن على حساب الحالة في Twitter أنه يجري صيانة طارئة لقاعدة البيانات، وطلب المهندسون المساعدة على Slack، وذهبوا يبحثون عن النسخ الاحتياطية.
وقبل أن ننتقل إلى النسخ، لاحظ أن GitLab لم تجعل علاج هذا الجزء أن تمنع المهندسين من كتابة أوامر الحذف. فالتقرير يقول بوضوح إن تركيزهم سوف يكون على التعافي من الكوارث وعلى جعل السيرفر الذي تعمل عليه واضحاً أمامك، وليس على منع أوامر معينة، والسبب كما يشرحون أنك لو جعلت أمر rm يطلب تأكيداً فأنت تحمي نفسك من هذا الخطأ بالذات فقط، ولا تحمي نفسك من تلف القرص أو من عشرات الطرق الأخرى التي تضيع بها البيانات. وكانت إحدى المهام الأولى بعد الحادثة تعديل شكل سطر الأوامر Prompt على كل السيرفرات ليفرق بوضوح بين السيرفرات وبين البيئات.
خمس طرق للنسخ الاحتياطي، ولا واحدة تعمل
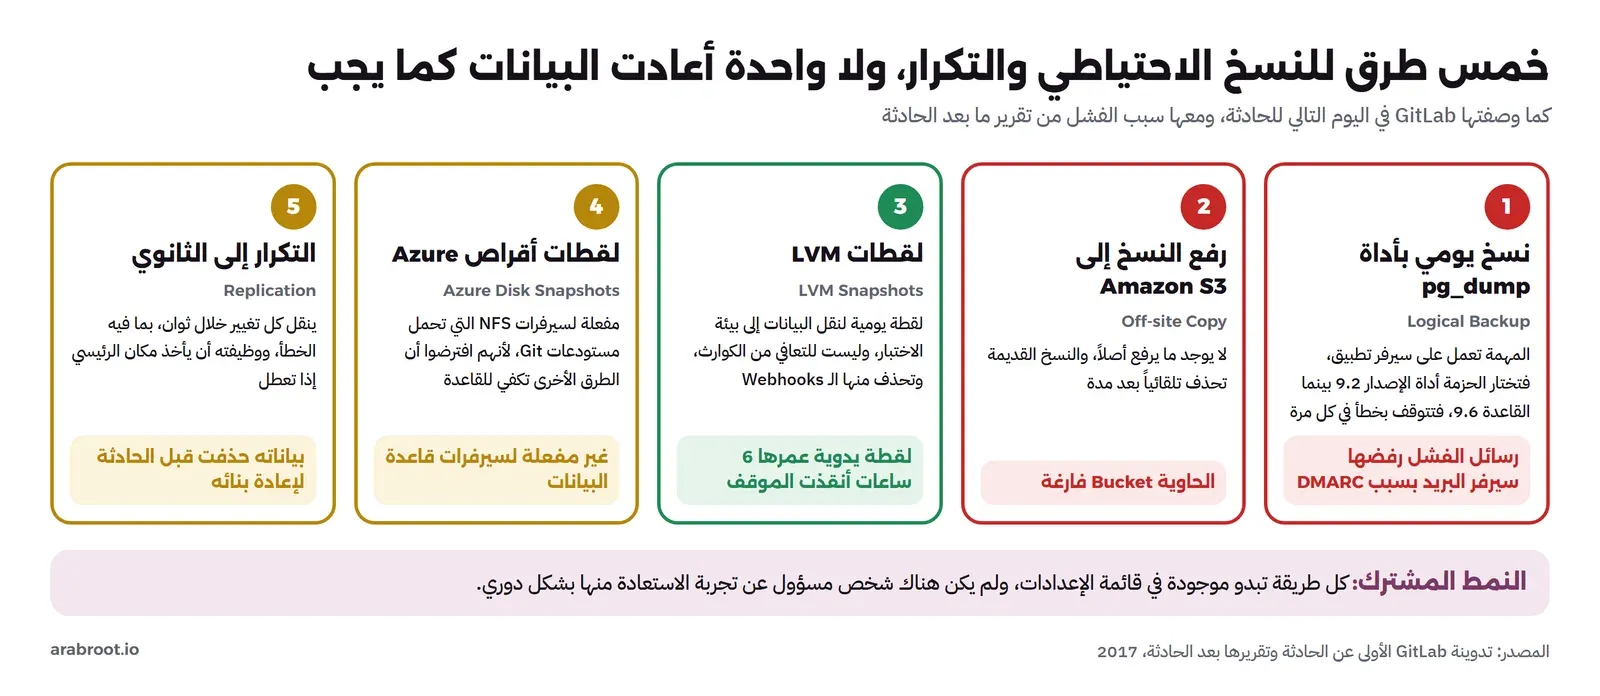
كتبت GitLab في تدوينتها الأولى في اليوم التالي جملة أصبحت أشهر ما في القصة: «من أصل خمس تقنيات للنسخ الاحتياطي والتكرار مطبقة عندنا، لا توجد واحدة تعمل بشكل موثوق أو كانت مفعلة من الأصل». والصورة التالية تبين الطرق الخمس وما حدث لكل منها:
النسخ اليومي بأداة pg_dump والرفع إلى S3
هذه هي النسخة الاحتياطية الحقيقية الوحيدة في القائمة: مهمة مجدولة تشغل أداة pg_dump كل 24 ساعة لتأخذ نسخة منطقية Logical Backup من القاعدة، ثم ترفعها إلى Amazon S3، وتحذف النسخ القديمة تلقائياً بعد مدة. وعندما فتح الفريق S3 وجد الحاوية Bucket فارغة، ولا توجد أي نسخة حديثة في أي مكان، والنسخ التي كانت تنتج كان حجمها بضعة بايتات فقط.
والسبب مثال ممتاز على الأعطال التي لا يراها أحد. فالمهمة كانت تعمل على سيرفر تطبيق عادي وليس على سيرفر قاعدة البيانات، وحزمة Omnibus التي تثبت GitLab كانت تدعم إصداري PostgreSQL 9.2 و9.6، وتختار الإصدار بقراءة ملف PG_VERSION داخل مجلد البيانات. وعلى سيرفر التطبيق لا يوجد مجلد بيانات أصلاً، فكانت الحزمة تختار 9.2 بشكل افتراضي، بينما القاعدة تعمل بالإصدار 9.6، وفي PostgreSQL يعتبر الانتقال من 9.2 إلى 9.6 إصداراً رئيسياً، فكانت pg_dump تتوقف بخطأ في كل مرة.
وهنا قد تتساءل: ألم يكن هناك تنبيه عند الفشل؟ والإجابة أن التنبيه كان موجوداً، فكل مهمة مجدولة تفشل ترسل بريداً إلكترونياً. ولكن GitLab كانت تستخدم سياسة DMARC لبريدها، ورسائل المهام المجدولة لم تكن موقعة بما يوافق هذه السياسة، فكان سيرفر البريد المستقبل يرفضها. والنتيجة كما يقول التقرير أنهم لم يعرفوا أبداً أن النسخ تفشل حتى فات الأوان. وإذا لم تكن تعرف كيف يرفض البريد غير الموثق فقد شرحنا ذلك في مقال SPF وDKIM وDMARC للمبتدئين، والمهم هنا أن أفضل إعداد لحماية بريدك من الانتحال هو نفسه الذي أسكت تنبيهات النسخ.
لقطات LVM
كل 24 ساعة كانت تؤخذ لقطة LVM من القرص الذي يحمل بيانات الإنتاج، ثم تنسخ إلى بيئة الاختبار ويبنى منها قرص جديد، ثم تحذف منها كل الـ Webhooks حتى لا تطلق بالخطأ من بيئة الاختبار نحو أنظمة العملاء. هذه الطريقة كانت تعمل كما صممت، ولكنها صممت لتسهيل الاختبار وليس للتعافي من الكوارث. وفي لحظة الحادثة كانت هناك لقطتان: اللقطة اليومية وعمرها قرابة 24 ساعة، واللقطة اليدوية التي أخذها المهندس في الساعة 17:20 وعمرها قرابة ست ساعات.
لقطات أقراص Azure
كانت GitLab تأخذ لقطة يومية لأقراص بعض السيرفرات في Azure، مثل سيرفرات NFS التي تحمل مستودعات Git، ولكن هذه اللقطات لم تكن مفعلة لسيرفرات قاعدة البيانات، والسبب كما يقول التقرير أنهم افترضوا أن طرق النسخ الأخرى كافية. وأضافوا سبباً آخر: استعادة لقطة من حساب تخزين مختلف في Azure قد تأخذ ساعات أو أياماً، وفي إحدى المرات أخذت أكثر من أسبوع، فلم يكونوا يعتمدون عليها كثيراً.
التكرار إلى السيرفر الثانوي
التكرار ليس نسخة احتياطية، وهذه نقطة يخلط فيها كثيرون. فالتكرار ينقل كل تغيير إلى السيرفر الثانوي خلال ثوان، بما في ذلك التغييرات الخاطئة، فإذا حذفت جدولاً من الرئيسي فسوف يحذف من الثانوي أيضاً. ووظيفته أن يأخذ مكان الرئيسي إذا تعطل السيرفر نفسه Failover، وليس أن يعيدك إلى الماضي. وفي هذه الحادثة لم يكن له دور أصلاً، لأن بياناته حذفت بشكل متعمد قبل الحادثة بساعة كجزء من إعادة بنائه.
والآن ضع الخمسة معاً وستجد نمطاً واحداً: كل طريقة كانت تبدو موجودة لمن ينظر إلى قائمة الإعدادات، ولم يكن أحد مسؤولاً عن أن يحاول الاستعادة منها بشكل دوري ليكتشف أنها لا تعمل.
الاستعادة على الهواء مباشرة
كان أمام الفريق خياران: لقطة LVM اليومية وتعني خسارة قرابة 24 ساعة من البيانات، أو اللقطة اليدوية وتعني خسارة قرابة ست ساعات. فاختاروا اللقطة اليدوية بكل تأكيد، ولكن هذه اللقطة كانت في بيئة الاختبار، وبيئة الاختبار كانت على Azure الكلاسيكي بأقراص عادية بدون التخزين المميز Premium Storage، لأن التخزين المميز مكلف. وهذه الأقراص أقراص شبكية محدودة السرعة بحوالي 60 ميجابت في الثانية، ولا توجد طريقة لنقلها إلى تخزين أسرع، فلم يكن عنق الزجاجة Bottleneck في الشبكة ولا في المعالج، وإنما في الأقراص نفسها.
واستغرق نسخ البيانات من بيئة الاختبار إلى سيرفر الإنتاج قرابة 18 ساعة. وحتى بعد النسخ لم تكن الاستعادة مجرد تشغيل للقاعدة، فاللقطة التي في بيئة الاختبار حذفت منها الـ Webhooks كما ذكرنا، لذلك كانت خطة الاستعادة كما يلي:
- نسخ قاعدة بيانات بيئة الاختبار إلى سيرفر الإنتاج، وهي بدون Webhooks.
- بالتوازي، بناء قاعدة منفصلة من اللقطة نفسها بدون تشغيل خطوة حذف الـ Webhooks.
- تصدير جدول الـ Webhooks من القاعدة المنفصلة واستيراده إلى قاعدة الإنتاج المستعادة.
- زيادة كل العدادات Sequences في القاعدة بمقدار 100 ألف، حتى لا تعطى أرقام معرفات IDs سبق أن استخدمت في الساعات الضائعة.
- إعادة تشغيل GitLab.com بشكل تدريجي.
والخطوة الرابعة تستحق أن تتوقف عندها. فالمستخدمون أنشؤوا مشاريع ومهام في الساعات الست التي ضاعت، وربما أرسلوا روابطها لغيرهم أو سجلوها في أنظمة أخرى، فإذا أعطت القاعدة المستعادة نفس الأرقام لعناصر جديدة فسوف تشير الروابط القديمة إلى أشياء لا علاقة لها بها. وهذا النوع من التفاصيل لا تفكر فيه إلا إذا جربت الاستعادة قبل أن تحتاجها.
وفي هذه الأثناء اختارت GitLab الشفافية الكاملة: فتحت مستند Google الذي يكتب فيه الفريق ملاحظاته للجميع، وبثت عملية الاستعادة على YouTube مباشرة، ووصل عدد المشاهدين في الذروة إلى قرابة 5000 شخص، حتى أصبح ثاني أكثر بث مباشر مشاهدة على YouTube لعدة ساعات، مع تحديثات مستمرة على حساب الحالة في Twitter. وكان المستند في البداية داخلياً وفيه اسم المهندس الذي حذف البيانات، وقد كتبه المهندس بنفسه ولم يمانع نشره، ولكن الشركة قررت أن تحذف الأسماء في الحوادث القادمة لأن غيره قد لا يرتاح لذلك.
وفي الأول من فبراير قرابة الساعة 17:00 بتوقيت UTC عادت قاعدة البيانات بدون الـ Webhooks، وبعد ساعة تقريباً انتهت الخطوات الأخيرة وعاد الموقع للعمل. ويقول التقرير إن GitLab.com توقف قرابة 18 ساعة، وإن الاستعادة نفسها أخذت أكثر من 18 ساعة. والصورة التالية تبين تسلسل ما حدث:
ماذا ضاع فعلاً؟
ضاعت كل التغييرات في قاعدة البيانات بين الساعة 17:20 ولحظة الحذف، أي المشاريع والمهام وطلبات الدمج والتعليقات والمقاطع Snippets والحسابات الجديدة التي أنشئت في تلك الساعات. وتقدر GitLab أن الخسارة شملت قرابة 5000 مشروع و5000 تعليق و700 حساب جديد. أما مستودعات Git نفسها وصفحات Wiki فلم تتأثر، لأنها مخزنة على سيرفرات NFS منفصلة، ولم يتأثر عملاء النسخة التي تستضيفها الشركات بنفسها Self-managed ولا عملاء الخدمات الأخرى.
وهذا الفصل بين نوعي البيانات أنقذ جزءاً مهماً، فالمشاريع التي أنشئت بعد 17:20 كانت مستودعاتها موجودة على NFS ولكن سجلها في القاعدة ضاع، فشغل الفريق إجراءً يعيد بناء هذه المشاريع من مستودعاتها، ولكن بشكلها الأساسي فقط، بدون المهام وطلبات الدمج التي كانت مرتبطة بها. وظهرت أيضاً حالات غريبة، مثل طلبات دمج تظهر مفتوحة مع أن تعديلاتها دمجت فعلاً، لأن Git يعرف أنها دمجت والقاعدة لا تعرف.
وتأثرت GitLab نفسها، لأنها تطور منتجها على GitLab.com. فاستمر أغلب المطورين في العمل على نسخهم المحلية من المستودعات، ولكن فتح المهام وغيرها تأجل، واضطرت الشركة أن تنشر تدوينة الحادثة من نسخة GitLab خاصة تستخدمها عادة للإصدارات الأمنية. ولوحة المراقبة العامة التي فتحتها للناس لم تتحمل عدد الزوار، بينما بقيت أنظمة المراقبة الداخلية تعمل.
لماذا حدث كل هذا؟ تحليل لماذا خمس مرات
استخدمت GitLab في تقريرها طريقة «لماذا خمس مرات» 5 Whys، وهي أن تسأل «لماذا؟» عن كل إجابة حتى تصل إلى سبب يمكن إصلاحه، وقد شرحناها في مقال اسأل لماذا خمس مرات. وقسمت الحادثة إلى مشكلتين منفصلتين: لماذا توقف الموقع، ولماذا أخذت الاستعادة كل هذا الوقت. والصورة التالية تلخص السلسلتين:
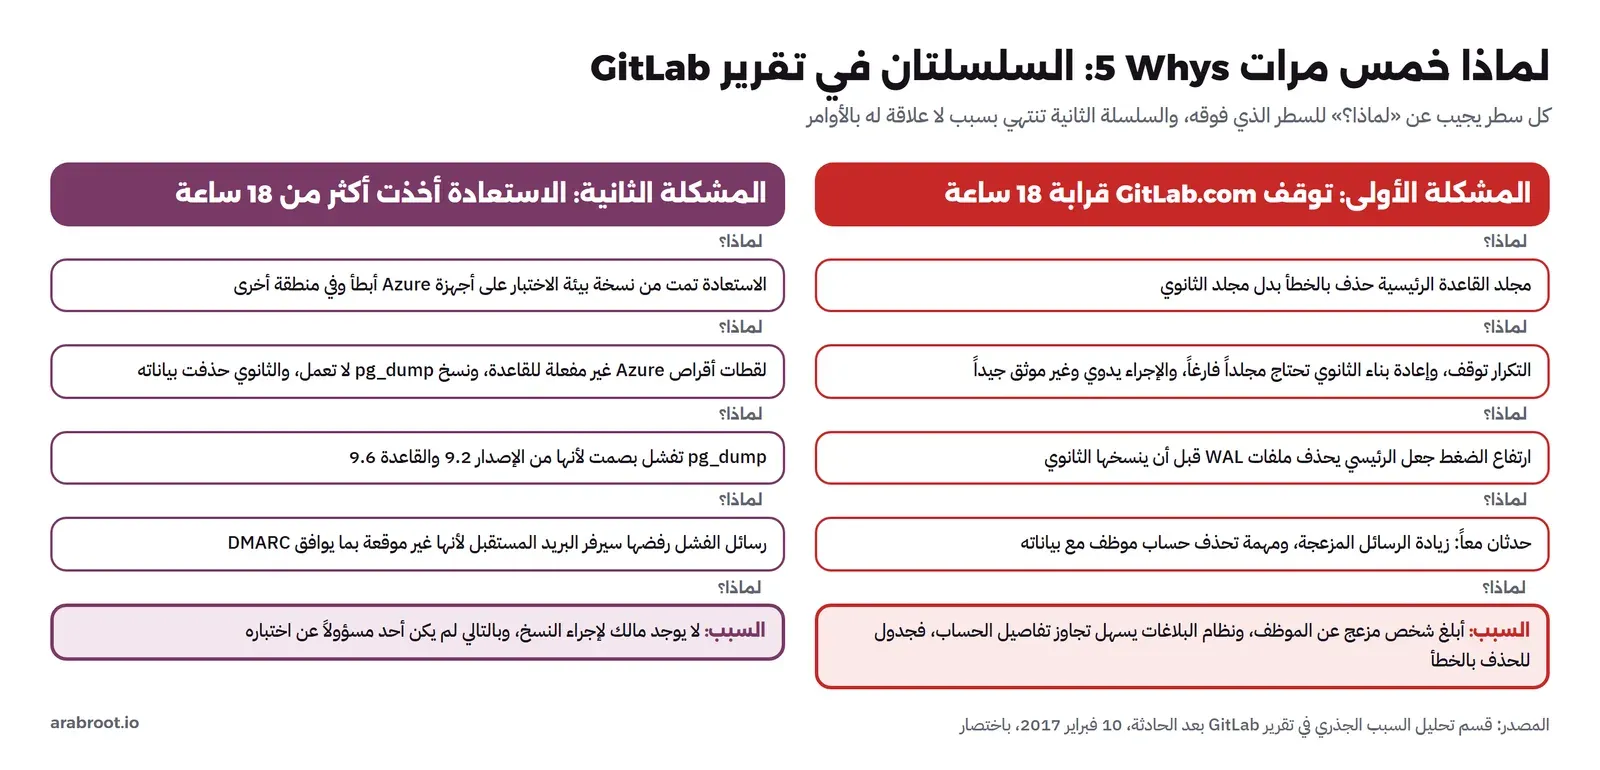
والسؤال الأخير في السلسلة الثانية هو الذي يجب أن تقرأه أكثر من مرة: لماذا لم يكن إجراء النسخ يختبر بشكل دوري؟ والإجابة في التقرير: لأنه لم يكن له مالك Owner، وبالتالي لم يكن أحد مسؤولاً عن اختباره. فكل المشاكل التقنية في القائمة، من الإصدار الخطأ إلى البريد المرفوض إلى اللقطات غير المفعلة، كان سوف يكتشفها أي شخص يحاول الاستعادة مرة واحدة في الشهر.
ولاحظ أيضاً ما لم يقله التقرير: لم يقل إن السبب الجذري هو المهندس. فالحذف في السيرفر الخطأ موجود في أول السلسلة، والتحليل يكمل بعده ليسأل لماذا احتاج المهندس أن يحذف مجلداً يدوياً في منتصف الليل أصلاً. وهذا هو الفرق بين تقرير يبحث عن شخص يلومه وتقرير يبحث عن نظام يصلحه، وقد تكلمنا عن الجانب الإنساني لهذا في مقال حين يلومك الفريق على عطل لم تسببه.
ماذا غيرت GitLab بعد الحادثة؟
نشرت GitLab التقرير في 10 فبراير 2017 ومعه قائمة مهام علنية، وأهمها كما يلي:
| المشكلة | ما قررته GitLab |
|---|---|
| صعوبة معرفة السيرفر الذي تعمل عليه | تعديل سطر الأوامر على كل السيرفرات ليفرق بين السيرفرات والبيئات |
| فشل النسخ دون أن يعرف أحد | مراقبة النسخ الاحتياطية بأداة Prometheus، ولوحة عامة تبين عمر آخر نسخة |
| لقطة واحدة كل 24 ساعة | لقطات LVM كل ساعة لقواعد الإنتاج، ودراسة تفعيل لقطات أقراص Azure |
| لا يوجد أرشيف لملفات WAL | دراسة الاستعادة إلى أي لحظة Point-in-Time Recovery والأرشفة المستمرة، وأدوات مثل WAL-E وpgbarman |
| لا أحد يختبر الاستعادة | اختبار تلقائي لاستعادة نسخ PostgreSQL، وتعيين مالك لسلامة البيانات Data Durability |
| إجراء التكرار غير موثق | تحسين توثيق التكرار وأدلة التشغيل |
| إعداد مبالغ فيه | ضبط max_connections على قيمة معقولة |
| قاعدة رئيسية واحدة | أكثر من سيرفر ثانوي وتوزيع الضغط بينها مع pgpool-II |
والجملة التي تلخص فلسفة هذه القائمة موجودة في التقرير نفسه: البيئة المثالية هي التي تستطيع أن تخطئ فيها ثم تتعافى بسرعة وبأقل أثر ممكن، وهذا يحتاج أن تمارس إجراءات الاستعادة بشكل منتظم، وأن يكون اختبار أي تغيير والتراجع عنه سهلاً. وقد طبقوا ذلك على أشياء أخرى غير قاعدة البيانات، مثل أداة تسمح للمطورين بتجربة ترحيل القاعدة Migration في بيئة الاختبار والتراجع عنه.
ماذا تتعلم من القصة لعملك؟
قد تقول إن شركتك صغيرة وقاعدة بياناتك على سيرفر واحد، وإن هذه مشاكل الشركات الكبيرة. والحقيقة أن كل ما فشل في GitLab موجود في أغلب الشركات الصغيرة بنفس الشكل: سكربت نسخ كتبه شخص ترك الشركة، ورسائل فشل تذهب إلى بريد لا يقرؤه أحد، ولقطات يظن الفريق أنها نسخ احتياطية. لذلك فيما يلي الدروس كما نراها، وكل واحد منها تستطيع أن تطبقه هذا الأسبوع.
النسخة التي لم تستعدها ليست نسخة
لا تقم بتقييم نسخك الاحتياطية بوجود الملفات، وإنما بنجاح الاستعادة منها على سيرفر فارغ، والسبب أن ملفاً حجمه بضعة بايتات يبدو موجوداً في القائمة تماماً مثل ملف سليم. وحدد موعداً ثابتاً لتجربة الاستعادة، مرة في الشهر على الأقل، وقس الوقت الذي تأخذه، لأن GitLab اكتشفت في ليلة الحادثة أن الاستعادة من أقراص بطيئة تأخذ 18 ساعة، وهذا رقم كان يجب أن يعرفوه مسبقاً. وقد شرحنا طريقة اختبار الاستعادة تلقائياً في دليل النسخ الاحتياطي بقاعدة 3-2-1، وطريقة أخذ نسخة متسقة من القاعدة في مقال نسخ قواعد البيانات بشكل متسق.
نبه على غياب النجاح، وليس على الفشل فقط
التنبيه الذي يرسل عند الفشل يعتمد على أن الفشل سوف يصل إليك، وفي GitLab لم يصل. لذلك الطريقة الأصح أن يسجل كل نسخ ناجح وقته وحجمه في نظام المراقبة، وأن تنبه إذا مرت أكثر من 26 ساعة مثلاً على آخر نسخة ناجحة، أو إذا كان حجم النسخة أصغر بكثير من المعتاد. وبهذا الشكل يصلك التنبيه حتى لو تعطل السكربت كله أو توقف السيرفر الذي يشغله. وقد شرحنا فكرة التنبيه الذي يتأكد أن مسار التنبيه نفسه يعمل في فقرة تنبيه Watchdog.
التكرار واللقطات ليست نسخاً احتياطية
التكرار يحميك من تعطل السيرفر، ولا يحميك من حذف خاطئ أو ترحيل سيئ أو هجوم فدية، لأنه ينقل الخطأ إلى الثانوي خلال ثوان. واللقطة التي تبقى على نفس القرص أو نفس الحساب تضيع معه. والذي يحميك من الخطأ البشري هو نسخة في مكان آخر، ومعها أرشيف لملفات WAL يسمح لك أن تعود إلى أي لحظة قبل الخطأ، وهذا ما شرحناه في مقال استعادة PostgreSQL إلى أي لحظة. ولو كان عند GitLab هذا الأرشيف لاستطاعت أن تعيد القاعدة إلى ما قبل الحذف بدقائق بدل ست ساعات.
اجعل السيرفر الخطأ واضحاً أمامك
اسمان يختلفان في حرف واحد، ونافذتان متشابهتان، ومهندس في آخر الليل: هذه وصفة معروفة. لذلك اجعل سطر الأوامر على سيرفرات الإنتاج بلون مختلف واسم واضح مثل PROD، ولا تفتح جلسة على الرئيسي إذا كان عملك على الثانوي فقط، واكتب قبل أي أمر حذف أمراً يطبع اسم السيرفر الذي أنت عليه. وإذا كانت المهمة الحساسة في منتصف الليل فاطلب من زميل أن يراجع الأمر معك قبل تنفيذه، وقد تكلمنا عن الإرهاق في الحوادث في مقال ضغط المناوبة On-call والحوادث.
وثق الإجراء قبل أن تحتاجه
لو كان في دليل التشغيل سطر واحد يقول إن pg_basebackup تنتظر بصمت قد يصل إلى عشر دقائق، لما فكر المهندس في حذف المجلد مرة ثانية. لذلك كل إجراء يدوي تقوم به في حادثة يجب أن يتحول بعدها إلى خطوات مكتوبة، ثم إلى سكربت إن أمكن، كما شرحنا في مقال دليل التشغيل Runbook.
لكل نسخة احتياطية مالك
هذا هو السبب الجذري الذي كتبته GitLab بنفسها، وهو أسهل درس في القائمة وأكثرها إهمالاً. فاكتب اسم شخص واحد مسؤول عن النسخ الاحتياطية وعن اختبار الاستعادة، وليس اسم فريق، واجعل نتيجة آخر اختبار استعادة جزءاً من اجتماع الفريق الدوري.
الشفافية تبني ثقة أكثر مما تخسر
كان يمكن لـ GitLab أن تكتب «صيانة طارئة» ثم «عادت الخدمة» وتنتهي القصة، ولكنها فتحت ملاحظاتها وبثت الاستعادة ونشرت تقريراً مفصلاً فيه أخطاؤها بالتفصيل. وهذا القرار جعل الحادثة درساً مفتوحاً لكل مهندس، ومنه هذا المقال. وإذا كنت تكتب تقارير الحوادث في شركتك فقد شرحنا طريقة إدارة الحادثة من التنبيه إلى التقرير في مقال إدارة الحوادث Incident Response.
والجدول التالي يحول هذه الدروس إلى أسئلة تسألها عن نظامك اليوم:
| السؤال | كيف تتحقق |
|---|---|
| متى آخر مرة استعدت فيها من نسختك على سيرفر فارغ؟ | إذا لم تكن تعرف التاريخ فالإجابة: لم تفعل |
| كم تأخذ الاستعادة الكاملة؟ | رقم مقاس في آخر تجربة، وليس تقديراً |
| هل يصلك تنبيه إذا لم تحدث نسخة ناجحة اليوم؟ | أوقف السكربت يوماً واحداً وانتظر التنبيه |
| هل إصدار أداة النسخ يطابق إصدار القاعدة؟ | شغل الأداة يدوياً من نفس السيرفر وبنفس المستخدم الذي تعمل به المهمة |
| هل توجد نسخة خارج السيرفر وخارج الحساب؟ | افتح مكانها بنفسك وانظر إلى حجم وتاريخ آخر ملف |
| كم دقيقة من البيانات تخسر في أسوأ حالة؟ | الفرق بين الآن وآخر نسخة أو آخر ملف WAL مؤرشف |
| من المسؤول عن كل ما سبق؟ | اسم شخص واحد مكتوب |
الخلاصة
وصلنا لنهاية القصة، وأهم ما فيها:
- في 31 يناير 2017 حذف مهندس في GitLab مجلد بيانات PostgreSQL من السيرفر الرئيسي بدل الثانوي، بعد ليلة من الضغط وتأخر التكرار ومحاولات إعادة بناء الثانوي يدوياً.
- من خمس طرق للنسخ والتكرار لم تعمل واحدة كما يجب: pg_dump كانت تفشل بسبب اختلاف الإصدار، ورسائل الفشل ترفض بسبب DMARC، وحاوية S3 فارغة، ولقطات Azure غير مفعلة للقاعدة، والثانوي حذفت بياناته.
- أنقذت الموقف لقطة LVM يدوية أخذت قبل ست ساعات لغرض الاختبار، واستغرق نسخها 18 ساعة بسبب أقراص بطيئة، وبثت GitLab الاستعادة مباشرة على YouTube.
- ضاعت تغييرات القاعدة لقرابة ست ساعات، بحوالي 5000 مشروع و5000 تعليق و700 حساب، وبقيت مستودعات Git سليمة.
- السبب الجذري كما كتبته GitLab: لا يوجد مالك لإجراء النسخ، فلم يختبره أحد. والعلاج: اختبار استعادة دوري، وتنبيه على غياب النجاح، وأرشيف WAL، وسيرفرات واضحة الأسماء، وأدلة تشغيل مكتوبة.
وإذا أردت أن تكمل من هنا، فهذه المقالات تشرح النسخ الاحتياطي والتعافي، وبقية كوارث هذه المرحلة:
 دليلكيف تقرأ تقرير ما بعد الحادثة Postmortemطريقة عملية لقراءة تقارير الحوادث العامة من AWS وGitLab وCloudflare وتحويل كل درس فيها إلى إجراء ودليل تشغيل في نظامك.
 دليلالنسخ الاحتياطي بقاعدة 3-2-1 واختبار الاستعادةكيف تحدد كم بيانات تقبل أن تخسر، وتبني نسخاً لا يستطيع المخترق حذفها، وتتأكد أنك تستطيع استعادتها فعلاً.
 دليلنسخ قواعد البيانات بشكل متسق: pg_dump أو mysqldumpلماذا ينجح نسخ مجلد قاعدة البيانات أحياناً ثم يعطيك قاعدة تتوقف عند أول استعلام، وكيف تأخذ نسخة متسقة من PostgreSQL وMySQL وتثبت أنها تستعاد قبل أن تحتاجها.
 دليلاستعادة PostgreSQL إلى أي لحظة مع pgBackRestكيف تأخذ نسخاً احتياطية من PostgreSQL مع أرشيف WAL، وتستعيد القاعدة إلى الثانية التي سبقت حذفاً خاطئاً.
 دليلانتقال تلقائي Failover لقاعدة PostgreSQL مع Patroniبنينا عنقود PostgreSQL من ثلاث نسخ يديره Patroni، ثم قتلنا الرئيسي وعزلناه عن الشبكة وقسنا كم ثانية توقفت الكتابة وكم طلباً مؤكداً ضاع.
 دليلالتعافي من الكوارث Disaster Recovery: موقع ثان أم نسخة تكفي؟أحرقنا موقعاً كاملاً أثناء البيع، واستعدنا المتجر في موقع ثان مرة من نسخة جاهزة ومرة من النسخة الاحتياطية، وقسنا زمن العودة وكم طلباً ضاع، ثم حذفنا جدولاً لنرى ما لا يحميك منه الموقع الثاني.
 دليلحريق OVHcloud في ستراسبورغ: نسخ احتياطية احترقت مع البياناتماذا حدث في حريق مركز بيانات OVHcloud سنة 2021، ولماذا فقد عملاء نسخهم الاحتياطية، وكيف تتأكد أن نسختك خارج الموقع فعلاً.
 دليلانهيار شبكة AT&T سنة 1990: تحديث برمجي أسقط 114 مقسماًكيف حول خلل في تحديث برمجي عطلاً عادياً في مقسم واحد إلى انهيار شبكة AT&T تسع ساعات، وماذا تتعلم عن اختبار مسار الاستعادة.
المصادر: تقرير GitLab بعد الحادثة المنشور في 10 فبراير 2017، وتدوينتها الأولى المكتوبة أثناء الاستعادة.
سجل التحديثات
- 2026-11-16: كتابة القصة اعتماداً على تقرير GitLab الرسمي بعد الحادثة وتدوينتها الأولى عن الحادثة، مع رسوم توضيحية من عملنا.