


في ليلة 10 مارس 2021 احترق مبنى كامل من مركز بيانات OVHcloud في ستراسبورغ، كما شرحنا في مقال حريق OVHcloud، والعملاء الذين خسروا بياناتهم لم يكونوا بلا نسخ احتياطية، فكثير منهم كانت نسخه في المبنى نفسه أو في المبنى المجاور، وكثير منهم كانت لديه أنظمة متكررة بالكامل، سيرفران وقاعدة بيانات بنسخ، ولكن كلها في المكان نفسه. وهذا بالضبط ما بنيناه في مقالات مرحلة التوفر العالي كلها: موزعات متكررة، وPostgreSQL بثلاث نسخ مع Patroni، وValkey مع Sentinel، وكلها تحمي المتجر من توقف جزء، ولا شيء منها يحميه إذا توقف المكان كله. وفي مقال تكلفة التوقف رأيت هذه الفئة في النموذج: توقف المزود أو الموقع، 54 دقيقة في السنة، ولا يزيلها أي عدد من السيرفرات في المكان نفسه.
والسؤال الذي يأتي بعد ذلك يسأله كل فريق عندما يقرأ قصة كهذه: هل نحتاج موقعاً ثانياً يعمل طوال الوقت، أم تكفينا نسخة احتياطية خارج الموقع نستعيدها إذا احترق الأول؟ والإجابة تعتمد على رقمين شرحناهما في دليل استمرارية الأعمال BCP، هما كم تقبل أن تتوقف RTO، وكم تقبل أن تخسر من البيانات RPO، وفي ذلك الدليل رتبنا العمليات وحددنا هذه الأرقام لكل واحدة. وفي هذا المقال نأخذ الأرقام إلى المختبر: نبني موقعين، ونحرق الأول وعملاء يشترون منه، ثم نستعيد المتجر في الموقع الثاني بطريقتين، من نسخة احتياطية ومن نسخة جاهزة، ونقيس كم ثانية توقف وكم طلباً ضاع في كل طريقة، ثم نرى الكارثة التي لا تحرق شيئاً ولكنها أخطر.
وسوف نناقش في هذا المقال ما يلي:
- الفرق بين التعافي من الكوارث والتوفر العالي، وما الذي يجب أن ينتقل إلى الموقع الثاني غير قاعدة البيانات.
- أربع استراتيجيات للتعافي من النسخة الاحتياطية إلى موقعين يعملان معاً، وتكلفة كل واحدة.
- مختبر حقيقي: موقع أول فيه PostgreSQL مع أرشفة WAL إلى تخزين خارجي ونسخة جاهزة في الموقع الثاني، ثم كارثة كاملة أثناء البيع.
- مشكلة واجهتنا: دقيقة كاملة من الطلبات لم تصل إلى الأرشيف، وماذا يغير الإعداد
archive_timeout. - الكارثة المنطقية: حذف جدول ينتقل إلى الموقع الثاني خلال ثوان، والاستعادة إلى لحظة قبله.
- تحويل المستخدمين والعودة إلى الموقع الأول، ومتى يكفيك النسخ الاحتياطي، وتمرين التعافي.
التعافي من الكوارث Disaster Recovery مقابل التوفر العالي
التوفر العالي يجيب عن سؤال: ماذا يحدث إذا توقف جزء؟ والإجابة عنده تلقائية وسريعة، بثوان أو دقائق، لأن الأجزاء البديلة قريبة وتعمل الآن. أما التعافي من الكوارث فيجيب عن سؤال أكبر: ماذا يحدث إذا توقف كل شيء في المكان، أو ضاعت البيانات نفسها؟ والإجابة عنده غالباً قرار بشري، وليست آلية، لأن الانتقال إلى موقع آخر له ثمن كبير، والخطأ فيه، أي أن تنتقل بينما الموقع الأول ما زال يعمل، يصنع أسوأ انقسام دماغ ممكن: متجران يبيعان من قاعدتين مختلفتين. لذلك تجد في أغلب خطط التعافي خطوة «القرار» بشكل صريح، شخص له صلاحية أن يقول «ننتقل الآن»، وسوف ترى هذه الخطوة في سكربت المختبر كانتظار متعمد.
وقد يتساءل البعض: لماذا لا نجعل الانتقال إلى الموقع الثاني تلقائياً كما فعل Patroni داخل الموقع؟ والإجابة أن الآلية التلقائية تحتاج طرفاً ثالثاً يحكم بالأغلبية، ومع موقعين فقط لا يوجد ثالث، فالموقع الثاني لا يستطيع أن يفرق بين موقع أول احترق، وموقع أول يعمل ولكن الربط بينهما انقطع، وهذا بالضبط ما حدث في حادثة GitHub التي ذكرناها في مقال التكلفة، حين نقلت الأداة التلقائية قواعد البيانات بين ساحلين بسبب انقطاع 43 ثانية. لذلك الفرق التي تجعل الانتقال بين المواقع تلقائياً تضع موقعاً ثالثاً صغيراً للتصويت، والأغلب يكتفي بقرار بشري سريع، مع مهلة مكتوبة: إذا لم يعد الموقع الأول خلال كذا دقيقة، ننتقل.
والكارثة ليست حريقاً فقط، وهذا أهم ما يجب أن تتذكره عند التصميم، فهناك ثلاثة أنواع، ولكل نوع ما يحميك منه:
- فقدان المكان Site Loss: حريق، أو انقطاع طويل للكهرباء أو الشبكة، أو حساب سحابي أغلق. ويحميك منه وجود البيانات والقدرة على التشغيل في مكان آخر.
- الكارثة المنطقية Logical Disaster: حذف خاطئ، أو ترحيل فاسد، أو خطأ في الكود يكتب بيانات خاطئة، وهي لا تحرق شيئاً، ولكنها تنتقل إلى كل النسخ الجاهزة خلال ثوان، فلا يحميك منها إلا نسخة من الماضي.
- الهجوم Attack: برنامج فدية يشفر البيانات، أو مخترق يحذف النسخ، وهو يجمع بين النوعين، ويحتاج نسخاً لا يستطيع المخترق أن يصل إليها، كما شرحنا في دليل 3-2-1 ودليل النسخة خارج السيرفر.
أربع طرق للتعافي Recovery Strategies
شرحنا في دليل BCP أنواع المواقع البديلة كما يصفها دليل NIST، من الموقع البارد إلى موقع المرآة، وفي البنية التقنية يستخدم الناس أسماء أخرى للفكرة نفسها، أشهرها الأربعة التي يصفها دليل AWS للتعافي من الكوارث، وهي تنطبق على أي مكان وليس على AWS وحدها:
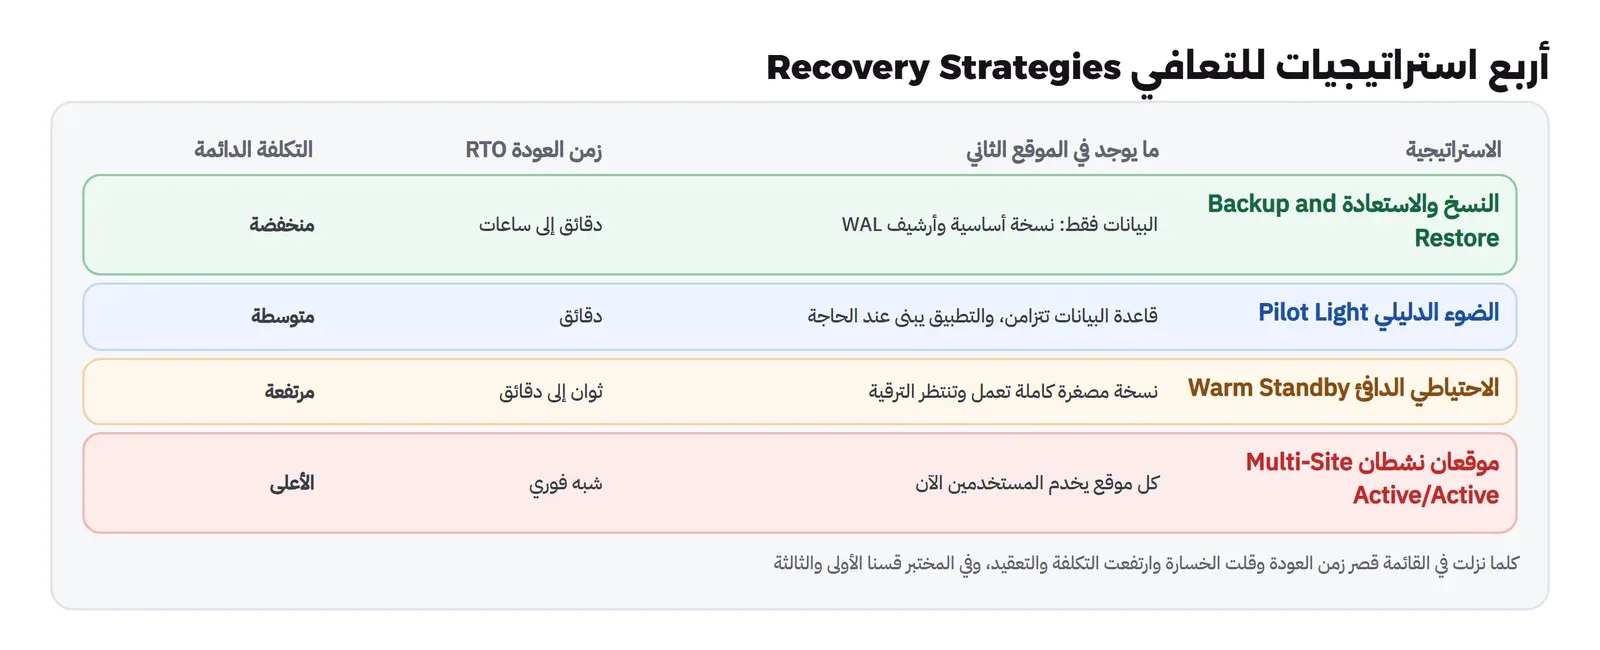
- النسخ والاستعادة Backup and Restore: لا يوجد في الموقع الثاني إلا البيانات، أي نسخة كاملة دورية مع السجلات التي بعدها، وعند الكارثة تبني كل شيء من الصفر. وهي الأرخص بكثير، لأنك تدفع ثمن التخزين فقط، وزمن التعافي فيها هو زمن البناء والاستعادة، أي دقائق لقاعدة صغيرة وساعات لقاعدة كبيرة، والخسارة هي كل ما لم يصل إلى الأرشيف.
- الضوء الدليلي Pilot Light: قاعدة البيانات في الموقع الثاني تعمل وتتزامن مع الأولى، ولكن سيرفرات التطبيق مطفأة أو غير موجودة، وتشغلها عند الكارثة من قوالب جاهزة. والاسم من الشعلة الصغيرة في سخان الغاز التي تبقى مشتعلة لتشعل الباقي عند الحاجة.
- الاحتياطي الدافئ Warm Standby: نسخة كاملة ولكن مصغرة من النظام تعمل في الموقع الثاني، تستطيع أن تخدم المستخدمين فوراً بعد ترقية قاعدة البيانات وتحويل الأسماء، ثم تكبرها بعد ذلك.
- موقعان نشطان Multi-Site Active/Active: كل موقع يخدم المستخدمين طوال الوقت، وتوقف أحدهما يعني فقط أن الآخر يأخذ كل الحركة. وهو الأسرع، والأغلى، والأصعب بكثير في جهة البيانات، لأن الكتابة في مكانين تعيدك إلى مشاكل التعارض التي رأيتها في مقال Galera، ولكن مع زمن وصول بين مدن.
وفي المختبر سوف نقيس الطريقتين الأولى والثالثة، لأنهما الخياران الواقعيان لأغلب الفرق الصغيرة والمتوسطة، والفرق بينهما هو السؤال الذي جاء في عنوان المقال. وللمتجر الذي نتابعه يمكن أن يبدو الضوء الدليلي هكذا: نسخة PostgreSQL تتبع الرئيسي في الموقع الثاني كما في المختبر، ونسخة Valkey تتبع الرئيسي هناك أيضاً، والتطبيق نفسه غير موجود، وإنما ملف OpenTofu يبنيه بأمر واحد مع موزع الطلبات، فتدفع ثمن قاعدتي بيانات صغيرتين فقط، ويضاف إلى زمن العودة زمن بناء التطبيق، وهو دقائق إذا كانت ال Images جاهزة في سجل خارج الموقع الأول. وهذا حل وسط جيد لأغلب الفرق، لأن الجزء الأبطأ في الاستعادة، أي البيانات، جاهز دائماً.
ما الذي يجب أن ينتقل؟ Beyond the Database
أغلب خطط التعافي التي تفشل لا تفشل في قاعدة البيانات، فهي الجزء الذي يفكر فيه الجميع، وإنما في الأشياء الصغيرة التي كانت في الموقع الأول ولم ينتبه أحد أنها مطلوبة. وقبل أي مختبر، اكتب قائمة بكل ما يحتاجه المتجر ليعمل، وضع بجانب كل بند أين توجد نسخته في الموقع الثاني:
- البيانات: قاعدة البيانات، والملفات التي يرفعها المستخدمون، وبيانات Valkey إذا كانت هي المخزن الوحيد لشيء.
- الكود والصور: Images التطبيق في سجل يمكن الوصول إليه من الموقع الثاني، وليس سجلاً يعمل في الموقع الأول نفسه.
- الإعداد والأسرار: ملفات الإعداد، وكلمات المرور، ومفاتيح التشفير، ومفتاح فك تشفير النسخ الاحتياطية نفسها، فالنسخة المشفرة التي ضاع مفتاحها مع الموقع الأول لا قيمة لها.
- الأسماء والشهادات: سجلات DNS ومن يستطيع تعديلها، وشهادات TLS أو طريقة إصدارها من الموقع الثاني.
- البنية: كيف تبني سيرفرات الموقع الثاني، والأفضل أن تكون مكتوبة كود كما شرحنا في مقال أول بنية مع OpenTofu، فتبنيها بأمر واحد بدلاً من ذاكرة شخص.
- الأشخاص والوصول: من يملك صلاحية الدخول إلى الموقع الثاني، وأين دليل التشغيل، وهل هو نفسه مخزن في مكان سوف يحترق.
المختبر Lab: موقعان وتخزين خارجي
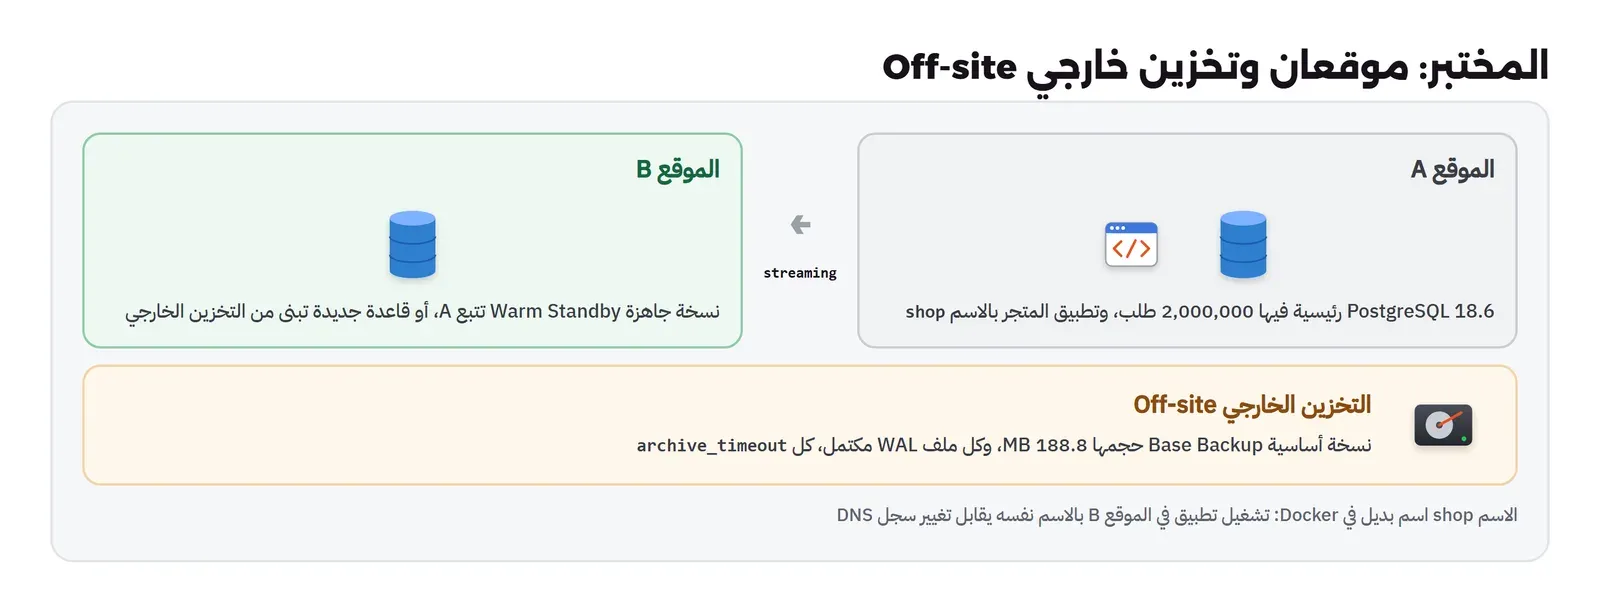
المختبر يحاكي موقعين على شبكة Docker واحدة تمثل الربط بينهما. في الموقع الأول قاعدة PostgreSQL 18.6 رئيسية فيها مليونا طلب، تؤرشف كل ملف WAL مكتمل إلى Volume يمثل التخزين الخارجي، وأخذنا منها نسخة كاملة أساسية Base Backup إلى التخزين نفسه، ومعها تطبيق المتجر الذي يجيب باسم shop. وفي الموقع الثاني نسخة جاهزة تتبع الأولى بالنسخ المتدفق. والعميل يشتري عبر الاسم shop، وهو اسم بديل Network Alias في Docker، فعندما نشغل تطبيقاً في الموقع الثاني بالاسم نفسه، فكأننا غيرنا سجل DNS، وهذه هي خطوة تحويل المستخدمين.
ملفات المختبر Lab Files
التطبيق والعميل هما نفسهما من مقال تكلفة التوقف، مع تغيير عنوان قاعدة البيانات إلى متغير بيئة DSN، وعنوان المتجر في العميل إلى الاسم shop. والسكربت setup.sh يبني الموقعين، ولاحظ فيه إعدادات الأرشفة في الموقع الأول، ووقت archive_timeout الذي سوف نغيره بين التجارب:
#!/bin/sh
# Site A primary with WAL archiving to the off-site volume, a base backup there, a streaming standby at site B,
# and the store app at site A answering as "shop". ARCHIVE_TIMEOUT defaults to 60 s.
export MSYS_NO_PATHCONV=1
AT=${ARCHIVE_TIMEOUT:-60}
docker network create wr-ha-wan >/dev/null
docker run --rm -v wr-ha-offsite:/offsite alpine:3.24 sh -c "mkdir -p /offsite/wal /offsite/base && chown -R 999:999 /offsite"
docker run -d --name wr-ha-a-db --network wr-ha-wan -e POSTGRES_PASSWORD=lab-only-pass -e POSTGRES_DB=shop \
  -v wr-ha-a-data:/var/lib/postgresql -v wr-ha-offsite:/offsite postgres:18.6 \
  -c wal_level=replica -c archive_mode=on -c archive_timeout=$AT \
  -c "archive_command=test ! -f /offsite/wal/%f && cp %p /offsite/wal/%f" >/dev/null
until [ "$(docker logs wr-ha-a-db 2>&1 | grep -c 'ready to accept')" -ge 2 ]; do sleep 1; done
docker exec wr-ha-a-db sh -c "echo 'host replication all all scram-sha-256' >> \$PGDATA/pg_hba.conf"
docker exec wr-ha-a-db psql -U postgres -d shop -qc "select pg_reload_conf()" \
  -c "create table orders (id bigserial primary key, amount int not null, created_at timestamptz not null default now())" \
  -c "insert into orders(amount, created_at) select (random()*900+50)::int, now() - (g || ' seconds')::interval from generate_series(1,2000000) g"
docker exec -u postgres wr-ha-a-db pg_basebackup -D /offsite/base/full -Fp -X fetch -c fast
docker run --rm --network wr-ha-wan --user postgres -e PGPASSWORD=lab-only-pass -v wr-ha-b-data:/var/lib/postgresql postgres:18.6 \
  sh -c "mkdir -p /var/lib/postgresql/18 && pg_basebackup -h wr-ha-a-db -U postgres -D /var/lib/postgresql/18/docker -R -X stream -c fast"
docker run -d --name wr-ha-b-db --network wr-ha-wan -e POSTGRES_PASSWORD=lab-only-pass \
  -v wr-ha-b-data:/var/lib/postgresql -v wr-ha-offsite:/offsite postgres:18.6 >/dev/null
docker run -d --name wr-ha-a-app --network wr-ha-wan --network-alias shop wr-ha-drapp:1 >/dev/null
sleep 8
docker exec wr-ha-a-db psql -U postgres -tAc "select application_name, state, sync_state from pg_stat_replication"
في السكربت أعلاه لاحظ التالي:
archive_commandينسخ كل ملف WAL مكتمل إلى التخزين الخارجي، والجزءtest ! -fيمنع الكتابة فوق ملف موجود، كما يوصي توثيق الأرشفة المستمرة، لأن الكتابة فوق ملف في الأرشيف قد تتلف تاريخك كله. وفي الإنتاج تستخدم أداة مثل pgBackRest التي شرحناها في دليل pgBackRest بدلاً منcp، لأنها تضغط وتتحقق وتدير الاحتفاظ.pg_basebackup -D /offsite/base/full -Fp -X fetchيأخذ النسخة الأساسية إلى التخزين الخارجي مع ملفات WAL التي تحتاجها لتكون متسقة، واستغرق 56.8 ثانية لقاعدة 150 MB، فحجم النسخة على القرص 188.8 MB.- النسخة الجاهزة في الموقع الثاني بنيت بالأمر نفسه مع الخيار
-R، الذي يكتب إعداد الاتصال بالرئيسي ويضع الملفstandby.signal، فتقلع نسخة تتبع الرئيسي، واستغرق ذلك 3.3 ثانية.
والسكربت disaster.sh يشغل العميل، وبعد مدة يحذف الموقع الأول بالكامل مع قرصه، وينتظر مدة القرار، ثم يستعيد بالطريقتين ويطبع وقت كل خطوة:
#!/bin/sh
# Site A burns down while customers buy; then recover twice at site B and time each path (UTC).
#   warm: promote the streaming standby and move the "shop" name to an app at site B
#   cold: rebuild a new database from the off-site base backup + archived WAL
export MSYS_NO_PATHCONV=1
t() { date -u +%T; }
docker exec -d -e SECONDS=${SECONDS:-200} wr-ha-client python writer.py out/${RUN:-dr}.json
sleep ${BEFORE:-60}
echo "$(t) DISASTER: site A is gone (db, app, disk)"
docker rm -f -v wr-ha-a-app wr-ha-a-db >/dev/null; docker volume rm wr-ha-a-data >/dev/null
sleep ${DECIDE:-20}                                   # someone notices and decides to fail over to site B
echo "$(t) warm: promote the standby at site B"
docker exec wr-ha-b-db psql -U postgres -tAc "select pg_promote(wait => true, wait_seconds => 60)"
docker run -d --name wr-ha-b-app --network wr-ha-wan --network-alias shop \
  -e DSN=postgresql://postgres:lab-only-pass@wr-ha-b-db/shop wr-ha-drapp:1 >/dev/null
echo "$(t) warm: app at site B answers as shop"
echo "$(t) cold: restore base backup + WAL archive into a new database"
docker run --rm --user postgres -v wr-ha-offsite:/offsite -v wr-ha-c-data:/var/lib/postgresql postgres:18.6 sh -c '
  mkdir -p /var/lib/postgresql/18 && cp -a /offsite/base/full /var/lib/postgresql/18/docker &&
  chmod 700 /var/lib/postgresql/18/docker &&
  echo "restore_command = '"'"'cp /offsite/wal/%f %p'"'"'" >> /var/lib/postgresql/18/docker/postgresql.auto.conf &&
  touch /var/lib/postgresql/18/docker/recovery.signal'
echo "$(t) cold: files copied, starting recovery"
docker run -d --name wr-ha-c-db --network wr-ha-wan -e POSTGRES_PASSWORD=lab-only-pass \
  -v wr-ha-c-data:/var/lib/postgresql -v wr-ha-offsite:/offsite postgres:18.6 >/dev/null
until docker exec wr-ha-c-db psql -U postgres -tAc "select not pg_is_in_recovery()" 2>/dev/null | grep -q t; do sleep 1; done
echo "$(t) cold: database open for writes"
ولاحظ في الطريق البارد أننا لا نحدد أي نقطة استعادة، فتطبق القاعدة كل ما في الأرشيف حتى آخره، ثم تفتح للكتابة على خط زمني جديد. والسكربت preloss.py يأخذ كل طلب أكده المتجر قبل لحظة الكارثة، ويبحث عنه في كل قاعدة مستعادة:
# Orders confirmed before the disaster that are missing on each recovered database.
import calendar, json, sys, time, psycopg
log, cut = json.load(open(sys.argv[1])), calendar.timegm(time.strptime(sys.argv[2], "%Y-%m-%d %H:%M:%S"))
pre = [(t, i) for t, s, i in log if s == 201 and t < cut]
for h in sys.argv[3:]:
    with psycopg.connect(f"host={h} user=postgres password=lab-only-pass dbname=shop") as c:
        have = {r[0] for r in c.execute("select id from orders where id = any(%s)", ([i for _, i in pre],))}
    miss = [x for x in pre if x[1] not in have]
    span = f" ({time.strftime('%H:%M:%S', time.gmtime(miss[0][0]))} -> {time.strftime('%H:%M:%S', time.gmtime(miss[-1][0]))} UTC)" if miss else ""
    print(f"{h}: confirmed before the disaster {len(pre)}, missing {len(miss)}{span}")
الكارثة: الموقع الأول يختفي أثناء البيع Site Loss
شغلنا الموقعين بمهلة أرشفة 60 ثانية، وهي قيمة يصفها التوثيق بأنها معقولة عادة، ثم شغلنا الكارثة: دقيقة من البيع، ثم يختفي الموقع الأول، ثم 20 ثانية حتى يقرر أحد الانتقال:
sh setup.sh
RUN=dr1 SECONDS=200 BEFORE=60 DECIDE=20 sh disaster.sh
04:14:07 DISASTER: site A is gone (db, app, disk)
04:14:31 warm: promote the standby at site B
t
04:14:36 warm: app at site B answers as shop
04:14:36 cold: restore base backup + WAL archive into a new database
04:15:01 cold: files copied, starting recovery
04:15:24 cold: database open for writesثم نقارن ما بقي في كل طريق من الطلبات التي أكدها المتجر قبل الكارثة، ونقرأ سجل القاعدة الباردة:
docker exec wr-ha-client python preloss.py out/dr1.json "2026-11-05 04:14:07" wr-ha-b-db wr-ha-c-db
docker logs wr-ha-c-db 2>&1 | grep -E "redo done|last completed transaction|selected new timeline"
outage 04:14:07 -> 04:14:37 30.4 s
wr-ha-b-db: confirmed before the disaster 539, missing 0
wr-ha-c-db: confirmed before the disaster 539, missing 539 (04:13:07 -> 04:14:06 UTC)
04:15:22.782 UTC [32] LOG: redo done at 0/1D03D4D8 system usage: CPU: user: 0.12 s, system: 0.07 s, elapsed: 0.96 s
04:15:22.782 UTC [32] LOG: last completed transaction was at log time 2026-11-05 04:12:43.742594+00
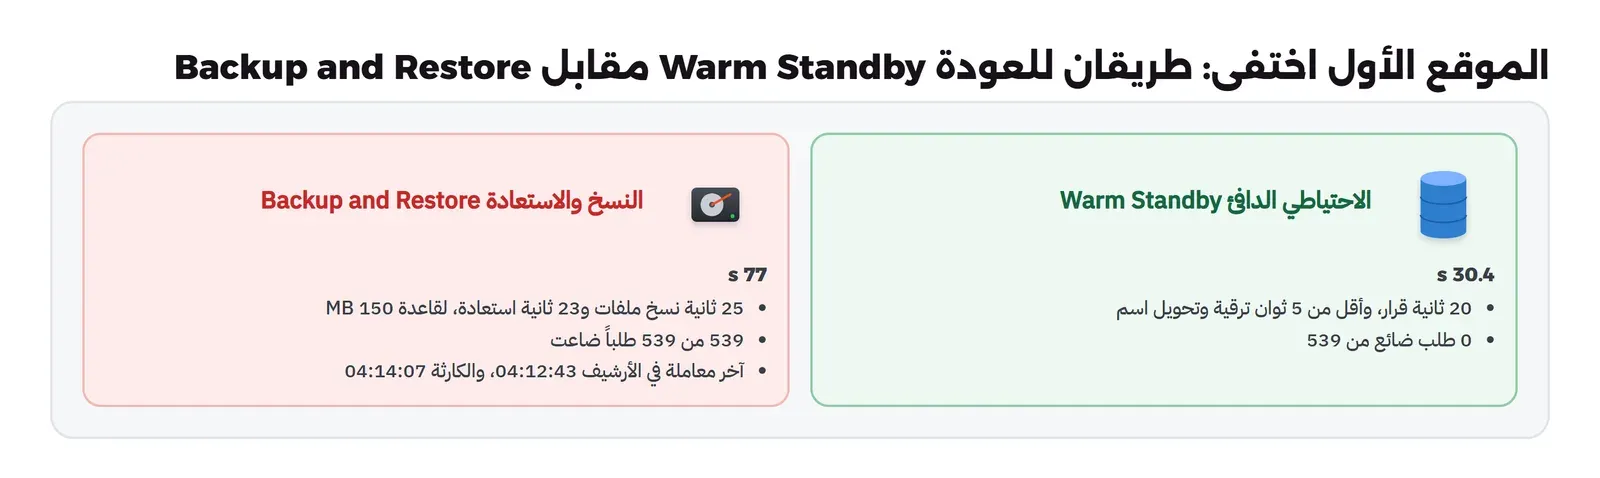
04:15:22.836 UTC [32] LOG: selected new timeline ID: 2ومن جهة العميل كانت الثواني الثلاثون كلها محاولات فاشلة متتالية، تنتظر كل واحدة منها حتى تنتهي مهلتها، لأن الاسم shop لم يعد يشير إلى أي شيء بعد حذف تطبيق الموقع الأول، وعادت الطلبات إلى النجاح في اللحظة التي أخذ فيها تطبيق الموقع الثاني الاسم. وهذه هي المقارنة التي جاء من أجلها المقال، فلنقرأها بعناية:
- الطريق الدافئ Warm Standby: عاد المتجر بعد 30.4 ثانية من جهة العميل، منها 20 ثانية انتظار القرار الذي وضعناه عمداً، وأقل من 5 ثوان للترقية وتشغيل التطبيق وتحويل الاسم، ولم يضع أي طلب من 539، لأن النسخة كانت متأخرة أجزاء من الثانية فقط عن الرئيسي.
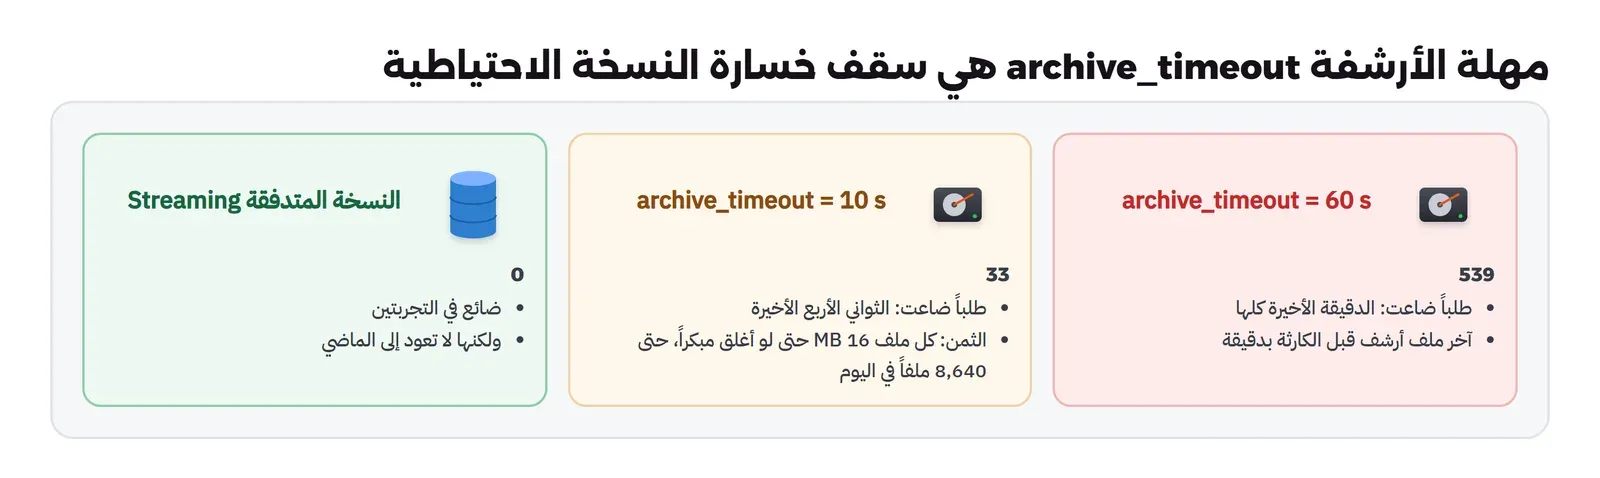
- الطريق البارد Backup and Restore: نسخ الملفات من التخزين الخارجي أخذ 25 ثانية، والاستعادة 23 ثانية أخرى، فالقاعدة فتحت بعد 48 ثانية من بداية العمل، أي بعد 77 ثانية من الكارثة. وهذا لقاعدة 150 MB، والزمن يكبر مع الحجم تقريباً بنسبة ثابتة، فقاعدة 500 GB تحتاج ساعات للنسخ وحده. ولكن الأهم هو السطر الثاني: ضاعت كل الطلبات الـ 539 التي أكدها المتجر في الدقيقة الأخيرة.
مشكلة واجهتنا: دقيقة كاملة لم تصل إلى الأرشيف archive_timeout
السطر last completed transaction was at log time 04:12:43 يقول إن آخر معاملة في الأرشيف كانت قبل أن يبدأ العميل بالشراء أصلاً، وهي طلبات اختبار سريع شغلناه بعد البناء. فالدقيقة كلها، من 04:13:07 حتى الكارثة، لم يصل منها شيء إلى التخزين الخارجي. ولكي نفهم السبب نظرنا إلى أوقات الملفات في الأرشيف:
docker run --rm -v wr-ha-offsite:/o alpine:3.24 sh -c "ls -l --full-time /o/wal | tail -5 | awk '{print \$7, \$9}'"04:12:05 00000001000000000000001A
04:12:06 00000001000000000000001B
04:12:06 00000001000000000000001C
04:12:06 00000001000000000000001C.00000028.backup
04:13:07 00000001000000000000001Dآخر ملف أرشف في 04:13:07، والملف الذي بعده، وفيه كل طلبات الدقيقة، كان مفتوحاً على قرص الموقع الأول، ولم يكن ليغلق ويؤرشف قبل 04:14:07 تقريباً، لأن توثيق archive_timeout يشرح أن الأرشفة تعمل فقط على الملفات المكتملة، والملف يكتمل إما عندما يمتلئ بـ 16 MB من التغييرات، وإما عندما تمر مدة archive_timeout منذ آخر تبديل. والمتجر يكتب أقل بكثير من 16 MB في الدقيقة، فكان الملف يغلق كل 60 ثانية فقط، والكارثة جاءت في آخر ثانية قبل الإغلاق. أي أن RPO الطريق البارد ليس «لحظة الكارثة»، وإنما قد يصل إلى مدة archive_timeout كاملة، وفي هذه التجربة وصل إليها فعلاً. وهذا شيء لا يظهر إذا اختبرت الاستعادة على قاعدة لا يكتب فيها أحد، وهو ما يفعله أغلب الناس.
ماذا لو قصرنا مهلة الأرشفة إلى 10 ثوان؟ What If
أعدنا بناء الموقعين بالمهلة 10 ثوان، وكررنا الكارثة نفسها:
sh reset.sh; ARCHIVE_TIMEOUT=10 sh setup.sh
RUN=dr2 SECONDS=150 BEFORE=60 DECIDE=20 sh disaster.sh
docker exec wr-ha-client python preloss.py out/dr2.json "2026-11-05 04:22:14" wr-ha-b-db wr-ha-c-db
04:22:14 DISASTER: site A is gone (db, app, disk)
04:22:37 warm: promote the standby at site B
04:22:44 warm: app at site B answers as shop
04:22:44 cold: restore base backup + WAL archive into a new database
04:23:12 cold: files copied, starting recovery
04:23:25 cold: database open for writes
wr-ha-b-db: confirmed before the disaster 228, missing 0
wr-ha-c-db: confirmed before the disaster 228, missing 33 (04:22:10 -> 04:22:13 UTC)الخسارة في الطريق البارد نزلت من 539 طلباً إلى 33، أي الثواني الأربع الأخيرة قبل الكارثة، والطريق الدافئ لم يخسر شيئاً كما قبله. فلماذا لا نجعل المهلة ثانية واحدة إذاً؟ والإجابة في التوثيق نفسه: الملف الذي يغلق مبكراً يبقى بحجمه الكامل 16 MB، فالمهلة 10 ثوان تعني حتى 8,640 ملفاً في اليوم، أي حوالي 138 GB من الأرشيف قبل الضغط لمتجر لا يكتب إلا القليل، والتوثيق يصف المهلة القصيرة جداً بأنها غير حكيمة لهذا السبب، ويقترح النسخ المتدفق إذا أردت أن تصل البيانات أسرع من دقيقة. والحل الذي تفعله أدوات الإنتاج أن تجمع الطريقين: نسخة متدفقة لخسارة شبه معدومة، وأرشيف بمهلة دقيقة أو أكثر للعودة إلى الماضي، وبعض الأدوات تأخذ WAL من الرئيسي بالبث المستمر إلى الأرشيف نفسه بدلاً من انتظار اكتمال الملف.
ماذا تعني هذه الأرقام لبياناتك؟ Scaling the Numbers
الأرقام التي قسناها صغيرة لأن القاعدة صغيرة، والخطأ الشائع أن تأخذها كما هي إلى خطتك. والطريقة الصحيحة أن تأخذ منها النسبة وليس الزمن: نسخ النسخة الأساسية من التخزين الخارجي أخذ 25 ثانية لحجم 188.8 MB، أي حوالي 7.5 MB في الثانية على القرص المشترك في المختبر، فإذا كانت قاعدتك 500 GB وسرعة النقل من التخزين الخارجي إلى الموقع الثاني بهذا المعدل، فالنسخ وحده يحتاج حوالي 19 ساعة، قبل أي استعادة. وفي الإنتاج السرعة أعلى عادة، والتخزين الخارجي قد يكون في الشبكة نفسها أو عبر الإنترنت، فلا تفترض الرقم، وإنما قسه مرة في تمرين حقيقي بحجمك الحقيقي، كما شرحنا في دليل النسخة خارج السيرفر عن حساب زمن النقل وال Bandwidth.
والجزء الثاني من زمن الاستعادة هو تطبيق WAL منذ النسخة الأساسية حتى الكارثة، وكان أقل من ثانية في المختبر لأن النسخة الأساسية أخذت قبل الكارثة بدقائق. ولكن إذا كانت النسخة الأساسية أسبوعية، فالقاعدة يجب أن تعيد تطبيق أسبوع كامل من التغييرات، وقد يكون هذا أطول من نسخ الملفات نفسه. لذلك فتكرار النسخة الأساسية ليس فقط قرار تخزين، وإنما قرار زمن تعاف، وأدوات مثل pgBackRest تقلل ذلك بالنسخ الفرقية والتزايدية بين النسخ الكاملة، فتبقى السلسلة التي يجب تطبيقها قصيرة. وتذكر أيضاً أن زمن الاستعادة يشمل أشياء لم نقسها هنا: تجهيز السيرفرات في الموقع الثاني إذا لم تكن موجودة، وتشغيل التطبيق، وتحويل الأسماء، وانتظار انتهاء مدة صلاحية DNS عند المستخدمين.
الكارثة المنطقية: حذف جدول Logical Disaster What If
بعد التجربتين قد يبدو أن النسخة الجاهزة تتفوق في كل شيء، وهنا تأتي التجربة التي تقلب الصورة. أعدنا بناء الموقعين، وشغلنا العميل، وبعد 30 ثانية حذفنا جدول الطلبات في الموقع الأول، كما يحدث عندما يشغل أحدهم ترحيلاً على الإنتاج بدلاً من بيئة الاختبار، ثم نظرنا إلى النسخة الجاهزة:
docker exec -d -e SECONDS=45 wr-ha-client python writer.py out/drop.json
sleep 30; docker exec wr-ha-a-db psql -U postgres -tAc "select now()::timestamptz(3)"
docker exec wr-ha-a-db psql -U postgres -d shop -c "drop table orders"
sleep 2; docker exec wr-ha-b-db psql -U postgres -d shop -c "select count(*) from orders"
2026-11-05 04:27:17.613+00
DROP TABLE
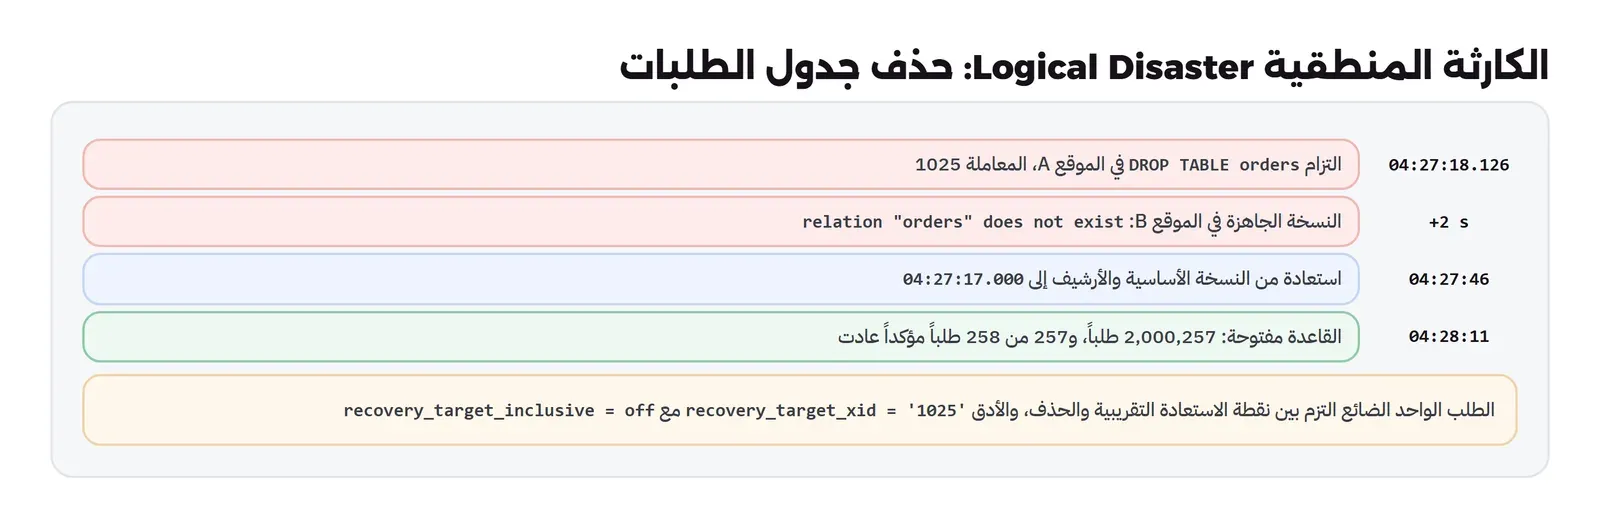
ERROR: relation "orders" does not exist
LINE 1: select count(*) from ordersالجدول اختفى من الموقع الثاني أيضاً خلال ثانيتين، فالنسخة الجاهزة فعلت بالضبط ما بنيت لتفعله: نسخت كل تغيير في الأول، بما فيه الحذف. أي أن الطريق الذي لم يخسر أي طلب في الحريق أصبح عديم الفائدة في هذه الكارثة. أما الطريق البارد فيستطيع أن يعود إلى الماضي، فأجبرنا الموقع الأول على إغلاق ملف WAL الحالي حتى يصل الحذف وما قبله إلى الأرشيف، ثم بنينا قاعدة جديدة من النسخة الأساسية، مع نقطة استعادة قبل الحذف بأقل من ثانية:
docker exec wr-ha-a-db psql -U postgres -tAc "select pg_switch_wal()"
TGT="2026-11-05 04:27:17.000+00"
docker run --rm --user postgres -v wr-ha-offsite:/offsite -v wr-ha-c-data:/var/lib/postgresql postgres:18.6 sh -c "
  mkdir -p /var/lib/postgresql/18 && cp -a /offsite/base/full /var/lib/postgresql/18/docker && chmod 700 /var/lib/postgresql/18/docker &&
  printf \"restore_command = 'cp /offsite/wal/%%f %%p'\nrecovery_target_time = '$TGT'\nrecovery_target_action = 'promote'\n\" \
    >> /var/lib/postgresql/18/docker/postgresql.auto.conf && touch /var/lib/postgresql/18/docker/recovery.signal"
docker run -d --name wr-ha-c-db --network wr-ha-wan -e POSTGRES_PASSWORD=lab-only-pass \
  -v wr-ha-c-data:/var/lib/postgresql -v wr-ha-offsite:/offsite postgres:18.6
04:27:46 restore to 2026-11-05 04:27:17.000+00
04:28:09.446 UTC [33] LOG: starting point-in-time recovery to 2026-11-05 04:27:17+00
04:28:10.776 UTC [33] LOG: recovery stopping before commit of transaction 1025, time 2026-11-05 04:27:18.12607+00
04:28:10.776 UTC [33] LOG: last completed transaction was at log time 2026-11-05 04:27:16.805515+00
04:28:10.825 UTC [33] LOG: selected new timeline ID: 2
04:28:11 open
2000257|2026-11-05 04:27:16.804798+00
confirmed before the drop 258 missing after PITR 1عادت القاعدة بعد 25 ثانية من بداية الاستعادة، وفيها 2,000,257 طلباً، أي المليونان الأصليان مع 257 طلباً من الطلبات الـ 258 التي أكدها المتجر قبل الحذف. وفي السجل تفصيلان يستحقان الانتباه. الأول أن معاملة الحذف نفسها رقم 1025 التزمت في 04:27:18.126، بعد نصف ثانية من بداية الأمر، لأن DROP TABLE انتظر حتى تنتهي كتابات التطبيق على الجدول ليأخذ قفله. والثاني أن طلباً واحداً ضاع، وهو طلب التزم بين 04:27:17.000، وهي النقطة التي اخترناها بالتقريب، وبين بداية الحذف. والطريقة الأدق أن تستعيد إلى المعاملة نفسها وليس إلى وقت تقريبي، بالإعداد recovery_target_xid = '1025' مع recovery_target_inclusive = off، فتتوقف قبل الحذف مباشرة بالضبط، والسجل نفسه يعطيك رقم المعاملة كما رأيت.
بعد التعافي: قاعدتان رئيسيتان Two Primaries
في التجربة الأولى حدث شيء لم نخطط له، ولكنه يحدث في كل تمرين تعاف حقيقي: بعد أن انتهت الطريقتان، أصبح لدينا قاعدتان رئيسيتان في الموقع الثاني، كل واحدة على خطها الزمني 2، وكل واحدة تقبل الكتابة، وكل واحدة فيها تاريخ مختلف، فالدافئة فيها كل الطلبات، والباردة ينقصها الدقيقة الأخيرة. وفي المختبر هذا مقصود للمقارنة، ولكن في كارثة حقيقية يحدث الشيء نفسه بطريقة أخطر: فريق يرقي النسخة الجاهزة، وفريق آخر يبدأ الاستعادة من النسخة الاحتياطية لأنه لم يعرف، أو يعود الموقع الأول بعد ساعات، فتجد قاعدته القديمة نفسها رئيسية أيضاً كما رأيت في مقال Patroni. لذلك يجب أن يكون في خطة التعافي قرار مكتوب وواحد: أي قاعدة هي الرئيسية الآن، وخطوة صريحة تمنع الموقع الأول من العودة رئيسياً إذا عاد، مثل إيقاف خدماته أو حذف اسمه من DNS قبل أن تبدأ.
حذف المختبر Cleanup
sh reset.sh
docker rm -f -v wr-ha-client
docker rmi wr-ha-drapp:1
تحويل المستخدمين Cutover: DNS أم عنوان ثابت؟
في المختبر حولنا المستخدمين بتغيير الاسم البديل في Docker، وهو يحدث فوراً. وفي الواقع الخطوة المقابلة هي تغيير سجل DNS للنطاق إلى عنوان الموقع الثاني، وهنا يدخل رقم ينساه الجميع: مدة الصلاحية TTL. فإذا كان سجلك بمدة صلاحية ساعة، فالمتصفحات والمزودون الذين سألوا عنه قبل دقيقة من الكارثة سوف يستمرون في إرسال المستخدمين إلى الموقع الميت ساعة كاملة، وبعض المزودين يحتفظون به أطول من مدته، كما شرحنا في دليل DNS. لذلك إذا كانت خطتك تعتمد على DNS، فاجعل مدة صلاحية السجلات المهمة قصيرة، خمس دقائق مثلاً، قبل الحاجة وليس أثناءها، لأن تقصيرها بعد الكارثة لا يفيد من حفظ القيمة القديمة. والبدائل الأسرع عنوان IP ينتقل بين المواقع من مزود الشبكة، أو خدمة توزيع أمامية مثل CDN تغير خلفها الموقع دون أن يتغير شيء عند المستخدم. وأياً كانت الطريقة، فمن يملك صلاحية التغيير يجب أن يستطيع الدخول إلى لوحة DNS من خارج الموقع الأول، وبحساب لا يعتمد على بريد مستضاف في الموقع نفسه.
العودة إلى الموقع الأول Failback
الانتقال إلى الموقع الثاني نصف القصة، والنصف الآخر الذي لا يخطط له أحد هو العودة. فالموقع الثاني غالباً أصغر، أو أبعد عن المستخدمين، أو أغلى، والفريق يريد أن يعود إلى الأول بعد إصلاحه. والعودة انتقال مخطط له كامل، بخطوات التعافي نفسها في الاتجاه المعاكس: تبني في الموقع الأول نسخة تتبع الرئيسي الجديد في الموقع الثاني، من نسخة أساسية جديدة أو بالأداة pg_rewind إذا بقيت البيانات القديمة، وتنتظر حتى تلحق، ثم تنقل الدور في وقت هادئ بانتقال مخطط كالذي رأيته يأخذ ثوان في مقال Patroni، ثم تعيد الأسماء. والخطأ الشائع أن يعاد تشغيل الموقع الأول كما كان، فتقلع قاعدته القديمة رئيسية ببياناتها القديمة، وهذا هو انقسام الدماغ الذي حذرنا منه في القسم السابق. والقاعدة: الموقع الذي غادرته لا يعود إلا كنسخة تتبع الموقع الحالي، ثم ترقيه بقرار.
وإذا لم يكن الموقع الأول قد احترق فعلاً، وإنما انقطع فقط، فقد يكون فيه طلبات لم تصل إلى الموقع الثاني قبل الانقطاع، كما رأيت في الطريق البارد. وهذه الطلبات لا تدمج تلقائياً، لأن أرقامها قد تكون أعطيت لطلبات أخرى في الموقع الثاني، كما رأيت في مقال التكلفة وفي مقال Patroni. لذلك قبل أن تعيد بناء الموقع الأول كنسخة، استخرج منه الطلبات التي بعد آخر نقطة مشتركة، وعالجها يدوياً مع سجلات بوابة الدفع، ثم اسمح لأداة العودة أن تحذفها من قرصه.
كم يكلف الموقع الثاني؟ Cost of a Second Site
الطريقتان اللتان قسناهما تختلفان في الثمن بقدر ما تختلفان في الأرقام، والفرق ليس فقط في عدد السيرفرات. فالنسخ والاستعادة يكلف التخزين الخارجي، أي النسخ الأساسية والأرشيف بمدة الاحتفاظ التي تختارها، وهذا عادة جزء صغير من فاتورة البنية. أما الاحتياطي الدافئ فيكلف سيرفر قاعدة بيانات يعمل طوال السنة في الموقع الثاني بحجم يكفي على الأقل لتحمل الضغط مؤقتاً، وسيرفر تطبيق صغيراً أو قالباً جاهزاً لتشغيله، والأهم حركة البيانات بين الموقعين، فكل تغيير في الموقع الأول ينتقل عبر الشبكة إلى الثاني، وعند بعض المزودين لهذه الحركة ثمن منفصل لم يحسبه أحد عند التصميم، كما شرحنا في مقال التكاليف الخفية في السحابة.
وهناك تكلفة ثالثة أكبر من الاثنتين، وهي وقت الفريق: الموقع الثاني يحتاج تحديثات ومراقبة وتمرينات مثل الأول، ونسخة لم يراقبها أحد ستة أشهر قد تكون متوقفة منذ شهر دون أن يعرف أحد، فتكتشف في يوم الكارثة أن موقعك الدافئ بارد. لذلك احسبها كما حسبنا التوفر العالي في مقال التكلفة: احتمال فقدان المكان في السنة، مضروباً في الفرق بين زمن العودة في الطريقتين وفي تكلفة الساعة، مضافاً إليه ثمن الطلبات التي تضيع في الطريق البارد، ثم قارنه بالتكلفة السنوية للموقع الدافئ بسيرفراته وحركته ووقت فريقه. وفي أغلب الفرق الصغيرة تكون النتيجة نسخاً خارجياً جيداً مع تمرين سنوي، وفي المتاجر والأنظمة التي تخسر مالاً حقيقياً في كل دقيقة، أو التي عليها التزامات تعاقدية، تكون النتيجة موقعاً دافئاً، بشرط ألا يحل محل النسخ الاحتياطي.
خطة التعافي في صفحة واحدة DR Runbook
في ليلة الكارثة لن يقرأ أحد وثيقة من ثلاثين صفحة، والذي ينفع صفحة واحدة بخطوات مرقمة، لكل خطوة صاحب وأمر جاهز وطريقة تحقق، كما شرحنا شكلها في دليل ال Runbook. ولمتجر بالطريق الدافئ تبدو الصفحة تقريباً هكذا:
- التأكد: هل الموقع الأول متوقف فعلاً، أم أن الشبكة بيننا وبينه فقط؟ من فحص خارجي من مكان ثالث، وليس من الموقع الثاني وحده.
- القرار: صاحب الصلاحية يقرر الانتقال ويعلنه في قناة الحادثة، ويسجل الوقت، لأن هذا الوقت يبدأ عداد RTO الحقيقي.
- العزل: خطوة تمنع الموقع الأول من العودة رئيسياً، مثل إيقاف خدماته من لوحة المزود إن أمكن، وتسجيل أن أي عودة له تكون كنسخة فقط.
- الترقية: الأمر
pg_promoteعلى النسخة في الموقع الثاني، والتحقق بأنpg_is_in_recoveryأصبحتfalse، ومعها خدمات البيانات الأخرى مثل Valkey والملفات. - التطبيق: تشغيل التطبيق أو تكبيره في الموقع الثاني بإعداده الخاص، والتحقق بطلب شراء تجريبي.
- التحويل: تغيير سجلات DNS أو العنوان، ومراقبة وصول الحركة إلى الموقع الثاني.
- الحساب: مقارنة آخر طلب في القاعدة بسجلات بوابة الدفع، لمعرفة ما ضاع وإعادة إدخاله.
- التواصل: تحديث صفحة الحالة والعملاء والإدارة بإيقاع ثابت حتى الإغلاق.
ولاحظ أن الخطوتين الأولى والثالثة لا علاقة لهما بالتقنية التي بنيناها، وأنهما الأكثر أهمية، فالانتقال إلى الموقع الثاني بينما الأول يعمل، أو دون أن تمنعه من العودة، هو الطريق المباشر إلى قاعدتين رئيسيتين وطلبات في الاثنتين لا يمكن دمجها بسهولة.
الكارثة التي تهاجم النسخ نفسها Ransomware
في المختبر كان التخزين الخارجي Volume يكتب فيه الموقع الأول بالأمر cp، أي أن الموقع الأول يملك صلاحية الكتابة على الأرشيف، وهذا يكفي لحريق، ولا يكفي لمخترق. فالمخترق الذي يصل إلى سيرفر قاعدة البيانات في الموقع الأول يجد عليه كل ما يحتاجه ليصل إلى النسخ: مسار الأرشيف، أو مفاتيح التخزين الخارجي في إعداد أداة النسخ، فيحذف النسخ أولاً، ثم يشفر القاعدة، ثم يترك رسالة الفدية، وعندها يكون الموقع الثاني الدافئ قد نسخ التشفير أيضاً كما نسخ حذف الجدول. ولذلك يحتاج التعافي من هذا النوع شرطاً إضافياً شرحناه في دليل 3-2-1 ودليل النسخة خارج السيرفر: أن يكتب الموقع الأول في الأرشيف بصلاحية إضافة فقط، دون حذف ولا تعديل، مثل مستودع restic بالوضع Append-Only، أو تخزين S3 مع قفل الكائنات Object Lock، وأن تكون صلاحيات الحذف والاحتفاظ في حساب آخر لا يوجد مفتاحه على أي سيرفر في الموقع الأول. وفي تمرين التعافي السنوي أضف سؤالاً واحداً: لو أخذ المخترق كل ما على سيرفرات الموقع الأول، هل يستطيع أن يحذف أحدث نسخة؟ فإذا كانت الإجابة نعم، فخطتك تحمي من الحريق فقط.
ومكان الموقع الثاني نفسه قرار له أبعاد غير تقنية، فإذا كانت بياناتك يجب أن تبقى داخل المملكة بحسب التزاماتك أو تصنيف بياناتك، فالموقع الثاني والتخزين الخارجي يجب أن يكونا كذلك أيضاً، والمزود الذي يعرض عليك منطقة ثانية في بلد آخر بسعر أقل قد يحل مشكلة الحريق ويصنع مشكلة امتثال، فتحقق من ذلك مع من يملك قرار تصنيف البيانات قبل أن تختار المكان.
متى يكفيك النسخ الاحتياطي؟ Decision
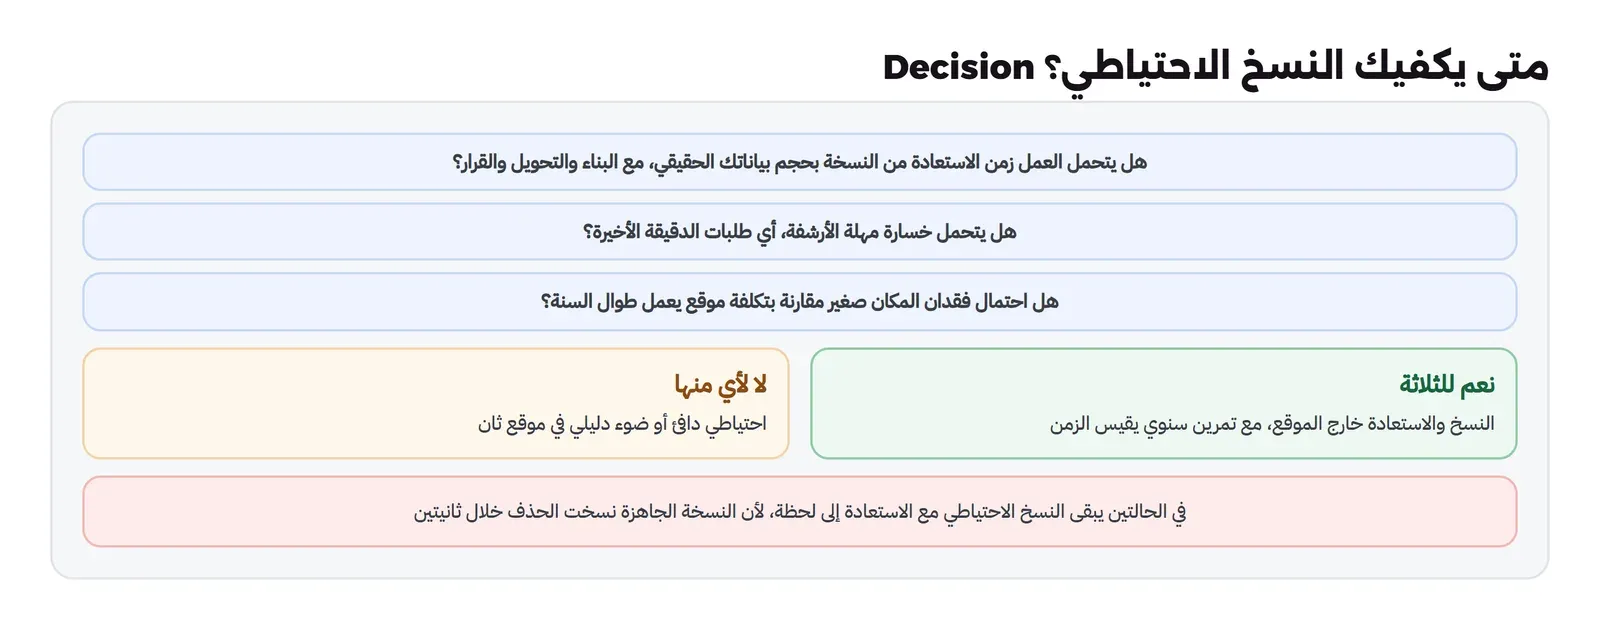
الآن نستطيع أن نجيب عن سؤال العنوان بالأرقام التي قسناها مع النموذج الذي بنيناه في مقال تكلفة التوقف. فالنسخ والاستعادة يكفيك إذا كانت ثلاثة شروط صحيحة معاً:
- زمن الاستعادة مقبول بحجم بياناتك الحقيقي: قسناه 48 ثانية لقاعدة 150 MB، وهو ينمو مع الحجم، فقس أنت على بياناتك، وأضف إليه زمن بناء السيرفرات والتطبيق وتحويل الأسماء، وزمن القرار نفسه، وقارن المجموع بالمهلة التي كتبتها في دراسة BIA.
- خسارة مهلة الأرشفة مقبولة: دقيقة من الطلبات في تجربتنا، وهي في الواقع طلبات مدفوعة يجب أن تعيد إدخالها من سجلات بوابة الدفع، فاحسب كم تكلف.
- احتمال فقدان المكان صغير: فالموقع الدافئ يكلف سيرفرات تعمل طوال السنة لحادثة قد لا تحدث في عشر سنوات، والنموذج في مقال التكلفة يبين كيف تحسب ذلك.
وإذا لم يتحقق أحدها، فالموقع الدافئ يستحق تكلفته، ولكن بشرط لا يتنازل عنه: النسخ الاحتياطي يبقى، لأن تجربة الحذف بينت أن الموقع الدافئ لا يحميك من الكارثة المنطقية، والهجمات اليوم تجمع النوعين. أي أن السؤال الحقيقي ليس «موقع ثان أم نسخة احتياطية»، وإنما «نسخة احتياطية وحدها، أم نسخة احتياطية مع موقع ثان».
تمرين التعافي DR Drill
كل الأرقام في هذا المقال جاءت من تمرين، وهذا هو الدرس الذي يجمع المرحلة كلها. فخطة التعافي التي لم تنفذ أبداً فيها دائماً شيء لا يعمل: أمر في دليل التشغيل يشير إلى مسار تغير، أو مفتاح تشفير غير موجود في الموقع الثاني، أو سجل DNS بمدة صلاحية يوم، أو مهلة أرشفة تضيع دقيقة لم يحسبها أحد. وقد شرحنا في دليل تمرين الطاولة كيف تجرب الخطة بالكلام، وفي مقال اختبار التعطل كيف تجرب الأعطال بالأوامر، وتمرين التعافي يجمع الاثنين على مستوى المكان كله: مرة في السنة على الأقل، ابن المتجر في الموقع الثاني من الصفر، من النسخ والأرشيف والكود المكتوب فقط، دون أي وصول إلى الموقع الأول، وكأنه احترق فعلاً، وقس الزمن من أول أمر حتى أول طلب شراء ناجح، وقارنه بالمهلة المكتوبة. والقاعدة المهمة في هذا التمرين أن ينفذه شخص لم يكتب الخطة، لأن الكاتب يعرف ما لم يكتبه، والتمرين يجب أن يكشف ذلك.
وسجل في كل تمرين الأرقام نفسها التي سجلناها في المختبر: وقت القرار، ووقت فتح القاعدة، ووقت أول طلب ناجح، وآخر معاملة موجودة مقارنة بلحظة الكارثة المفترضة، وكل خطوة توقف عندها المنفذ لأنه لم يجد أمراً أو صلاحية. ثم قارن هذه الأرقام بالتمرين السابق، فإذا كبر زمن الاستعادة سنة بعد سنة، فهذا لأن البيانات كبرت، وهو إنذار مبكر بأن الطريق البارد قد لا يحقق المهلة المكتوبة قريباً.
أخطاء شائعة Common Mistakes
- اعتبار النسخة الجاهزة نسخة احتياطية: فتنقل الحذف خلال ثانيتين كما رأيت، ولا تستطيع أن تعود بك إلى الماضي أبداً.
- اختبار الاستعادة على قاعدة لا يكتب فيها أحد: فلا تظهر الدقيقة التي تضيع بسبب مهلة الأرشفة.
- مهلة أرشفة قصيرة جداً: فيمتلئ الأرشيف بملفات 16 MB شبه فارغة.
- نسخ في المكان نفسه: كما في حريق OVHcloud، فالنسخة في المبنى المجاور ليست خارج الموقع.
- نسخة جاهزة لا يراقبها أحد: فتكتشف في يوم الكارثة أنها توقفت عن التزامن منذ أسابيع، والصحيح تنبيه على تأخرها بالبايت وبالثواني مثل الرئيسي تماماً.
- نسيان ما غير قاعدة البيانات: الأسرار، ومفتاح فك تشفير النسخ، والصور، وحساب DNS.
- مدة صلاحية DNS طويلة: فيبقى المستخدمون على الموقع الميت ساعة بعد التحويل.
- طريقان للتعافي ينفذان معاً: فتصبح لديك قاعدتان رئيسيتان بتاريخين مختلفين.
- عودة الموقع الأول كما كان: فتقلع قاعدته القديمة رئيسية، والصحيح أن يعود نسخة ثم يرقى بقرار.
- الاستعادة إلى وقت تقريبي: فتفقد ما بين الوقت والخطأ، والأدق رقم المعاملة من السجل.
قائمة تحقق Checklist
| البند | كيف تتحقق منه |
|---|---|
| RTO وRPO مكتوبان لكل خدمة | من دراسة BIA، وموقعان من صاحب القرار |
| البيانات خارج المكان | نسخة أساسية وأرشيف WAL في مكان لا يشترك في الكهرباء ولا الحساب مع الأول |
| مهلة الأرشفة تطابق RPO | archive_timeout أو بث WAL مستمر، ومقيس بكارثة أثناء الكتابة |
| كل ما غير البيانات موجود | الصور، والأسرار، ومفاتيح التشفير، والإعداد، وكود البنية |
| تحويل المستخدمين جاهز | مدة صلاحية DNS قصيرة مسبقاً، والوصول إلى لوحته من خارج الموقع |
| قرار الانتقال مكتوب | من يقرر، وبعد كم دقيقة، وأي قاعدة تصبح رئيسية |
| الموقع الأول لا يعود رئيسياً | خطوة إيقاف أو عزل مكتوبة قبل بدء التعافي |
| العودة مخططة | إجراء Failback مكتوب، يبدأ بنسخة تتبع الموقع الحالي |
| الكارثة المنطقية مغطاة | استعادة إلى لحظة أو إلى معاملة مجربة، مع النسخة الجاهزة إن وجدت |
| تمرين سنوي | بناء المتجر في الموقع الثاني من الصفر، ينفذه غير كاتب الخطة، والزمن مقيس |
الخلاصة Summary
وصلنا لنهاية الموضوع، ولنهاية مرحلة التوفر العالي، وأهم ما في هذا المقال لمن يكتب خطة التعافي الأولى لخدمته:
- التوفر العالي يحميك من توقف جزء، والتعافي من الكوارث يحميك من فقدان المكان أو البيانات نفسها، والكارثة قد تكون حريقاً أو حذفاً أو هجوماً.
- عند اختفاء الموقع الأول عاد المتجر من النسخة الجاهزة بعد 30.4 ثانية منها 20 ثانية قرار، دون أن يضيع طلب، ومن النسخة الاحتياطية بعد 77 ثانية لقاعدة 150 MB.
- النسخة الاحتياطية أضاعت 539 طلباً، أي الدقيقة الأخيرة كلها، لأن ملف WAL المفتوح لم يؤرشف قبل مهلة 60 ثانية، ومع 10 ثوان ضاع 33 طلباً بثمن أرشيف أكبر بكثير.
- حذف الجدول انتقل إلى النسخة الجاهزة خلال ثانيتين، والاستعادة من الأرشيف إلى لحظة قبله أعادت 257 من 258 طلباً، والأدق الاستعادة إلى رقم المعاملة.
- القرار ليس موقعاً ثانياً أم نسخة، وإنما نسخة وحدها أم نسخة مع موقع ثان، بحسب زمن الاستعادة الحقيقي وخسارة الأرشفة واحتمال فقدان المكان.
- اجعل كتابة الموقع الأول في الأرشيف إضافة فقط، بصلاحيات حذف في حساب آخر، حتى لا يحذف المخترق النسخ قبل أن يشفر القاعدة.
- اكتب من يقرر، وأي قاعدة تصبح رئيسية، وكيف تمنع الموقع الأول من العودة، وكيف تعود إليه، وجرب كل ذلك مرة في السنة على الأقل.
وبهذا المقال تكتمل مرحلة التوفر العالي في خريطة التعلم: بدأنا بسؤال هل تحتاجه، ثم بنينا كل طبقة من الموزع إلى قاعدة البيانات إلى الذاكرة، ثم اختبرنا الأعطال، وانتهينا بالمكان كله. والخيط الذي يجمعها كلها أن كل رقم في الرسم المعماري فرضية حتى تقيسه.
 دليلاستمرارية الأعمال BCP والتعافي من الكوارث DRP: الخطة والاختبارحولنا جرد عمليات شركة إلى طبقات تعاف بسكربت صغير، فكشف خدمة ظنها الفريق ثانوية وهي حرجة، وشرحنا MTD وRTO وRPO والموقع البديل.
 دليلالنسخ الاحتياطي بقاعدة 3-2-1 واختبار الاستعادةكيف تحدد كم بيانات تقبل أن تخسر، وتبني نسخاً لا يستطيع المخترق حذفها، وتتأكد أنك تستطيع استعادتها فعلاً.
 دليلالنسخة خارج السيرفر Off-site: إلى S3 مع restic أو Kopiaمتى تكون النسخة خارج الموقع فعلاً، وأين تضعها، وكم تحتاج النسخة الأولى من الوقت، ومن يملك صلاحية حذفها، مع تجربة أربعين يوماً من النسخ إلى Garage وتمرين استعادة على سيرفر جديد.
 دليلاستعادة PostgreSQL إلى أي لحظة مع pgBackRestكيف تأخذ نسخاً احتياطية من PostgreSQL مع أرشيف WAL، وتستعيد القاعدة إلى الثانية التي سبقت حذفاً خاطئاً.
 دليلاختبار التعطل Failover Testing: تأكد أن خطة التوفر تعملنفذنا يوم أعطال على متجر كامل من 17 Container بفرضيات مكتوبة مسبقاً، فكذبت اثنتان منها وظهرت نقطة فشل واحدة لم يرها أحد، ثم تحققنا من الإصلاحات بإعادة التجارب.
 دليلحريق OVHcloud في ستراسبورغ: نسخ احتياطية احترقت مع البياناتماذا حدث في حريق مركز بيانات OVHcloud سنة 2021، ولماذا فقد عملاء نسخهم الاحتياطية، وكيف تتأكد أن نسختك خارج الموقع فعلاً.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة الدليل وتنفيذ المختبر على PostgreSQL 18.6 مع أرشفة WAL ونسخة متدفقة وPython 3.13 مع psycopg 3.3.7 على Docker Engine 29.8.0.


