


تقرأ حل مسألة برمجية فتفهم كل سطر فيه، وتقول لنفسك إن الأمر سهل، ثم تفتح محرراً فارغاً أمام مسألة جديدة فلا تعرف ماذا تكتب في السطر الأول. وهذه التجربة يمر بها كل من تعلم البرمجة تقريباً، وسببها أن قراءة الحل وكتابته مهارتان مختلفتان: الأولى تحتاج أن تعرف قواعد اللغة، والثانية تحتاج أن تعرف كيف تحول سؤالاً غامضاً مكتوباً بلغة البشر إلى خطوات دقيقة لا تحتمل التخمين. واللغة تتعلمها في أسابيع، أما الثانية فهي ما يقصده الناس عندما يقولون «يفكر كمبرمج»، وهي مهارة لها طرق معروفة يمكن أن تتدرب عليها مثل أي مهارة أخرى.
وفي هذا المقال سوف نأخذ مسألة واحدة صغيرة ونمشي معها من أول قراءة إلى آخر قياس: لديك نص، قد يكون تعليقات العملاء على متجر أو رسائل مجموعة أو مقالاً، وتريد أن تعرف أكثر كلمة تكررت فيه وكم مرة تكررت. ومسألة بهذه البساطة كافية لترى كل مهارات التفكير الحاسوبي، وسوف ترى أيضاً أنها أخفت عنا ثلاث مفاجآت لم نتوقعها حتى شغلنا الكود. وإذا لم تجهز بيئة Python بعد فابدأ بمقال بيئة البرمجة للمبتدئين، وكل الكود هنا يعمل بـ Python 3 دون أي مكتبة إضافية.
وسوف نناقش في هذا المقال ما يلي:
- لماذا تعرف اللغة ولا تعرف من أين تبدأ، وما هو التفكير الحاسوبي Computational Thinking ومهاراته الأربع.
- خطوات بوليا Polya الأربع لحل أي مسألة، ولماذا يقفز المبتدئون فوق أهمها.
- فهم المشكلة: المدخل والمخرج والحالات الخاصة، والأسئلة التي يجب أن تسألها قبل أي سطر كود.
- التفكيك Decomposition والتجريد Abstraction، ثم الكود الوهمي Pseudocode والتتبع اليدوي Tracing.
- تجربة عملية تحل المسألة بثلاث طرق مختلفة، مع اختبارات كشفت خطأين حقيقيين، وقياس للوقت حتى مليون كلمة.
- الأخطاء الشائعة في طريقة التفكير، وقائمة تحقق تستخدمها مع كل مسألة جديدة.
لماذا تعرف اللغة ولا تعرف من أين تبدأ؟
عندما تتعلم لغة برمجة فأنت تتعلم مفرداتها وقواعدها: كيف تعرف متغيراً، وكيف تكتب شرطاً وحلقة ودالة. وهذا يشبه أن تتعلم قواعد اللغة العربية وتحفظ آلاف الكلمات، ثم يطلب منك أحدهم أن تكتب مقالاً يقنع القارئ بفكرة، فتكتشف أن معرفة القواعد لا تخبرك بماذا تبدأ، ولا كيف ترتب الأفكار، ولا متى تتوقف. والبرمجة كذلك، فالمسألة لا تأتيك مكتوبة بلغة Python، وإنما بلغة بشرية مليئة بالغموض: «أكثر كلمة تكررت». وما الكلمة؟ وهل «القهوة،» بفاصلة هي نفس «القهوة»؟ وماذا لو تساوت كلمتان؟ وهذه الأسئلة لا يجيب عنها أي كتاب في قواعد اللغة.
والخطأ الذي يقع فيه أغلب المبتدئين أنهم يحاولون حل الغموض وهم يكتبون الكود، فيكتبون سطراً ثم يتوقفون ليفكروا، ثم يمسحونه ويكتبون غيره، ويخلطون بين سؤال «ماذا أريد أن أفعل؟» وسؤال «كيف أكتب هذا في Python؟». والنتيجة كود يعمل على المثال الذي في رأسك ويفشل على أول مثال حقيقي. والحل أن تفصل بين المرحلتين: تفكر أولاً بالورقة والقلم حتى تصل إلى خطوات واضحة، ثم تترجم الخطوات إلى كود، وهذه الترجمة تصبح سهلة بشكل مفاجئ عندما تكون الخطوات واضحة.
ما هو التفكير الحاسوبي Computational Thinking؟
في عام 2006 نشرت Jeannette Wing، أستاذة علوم الحاسب في جامعة Carnegie Mellon، مقالاً قصيراً بعنوان Computational Thinking في مجلة Communications of the ACM، قالت فيه إن طريقة التفكير التي يستخدمها علماء الحاسب في حل المسائل مهارة أساسية يحتاجها كل شخص، مثل القراءة والكتابة والحساب، وليست خاصة بمن يبرمج. ومن أفكار المقال أن التفكير الحاسوبي يعني أن تعيد صياغة مسألة صعبة في صورة مسألة تعرف حلها، وأن تختار التمثيل المناسب للبيانات، وأن تفكر في الحالات الخاصة وفي كلفة الحل. وانتشر المصطلح بعد ذلك في مناهج التعليم، وأصبح المعلمون يقسمونه عادة إلى أربع مهارات، والصورة التالية تبينها على مسألتنا:
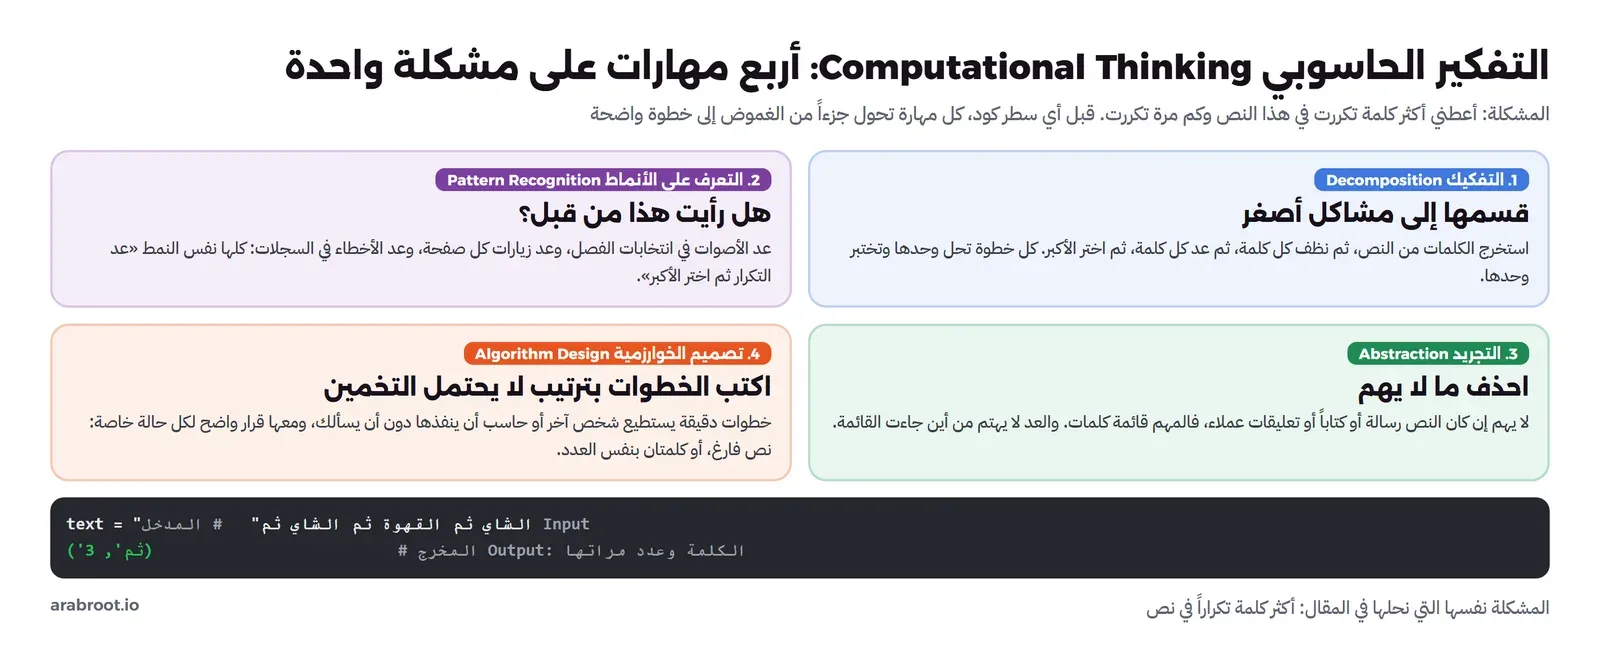
- التفكيك Decomposition: أن تقسم المسألة الكبيرة إلى مسائل أصغر، كل واحدة منها تحل وحدها وتختبر وحدها. فبدل «أكثر كلمة تكررت» تصبح عندك: استخرج الكلمات، ثم عد كل كلمة، ثم اختر الأكبر.
- التعرف على الأنماط Pattern Recognition: أن تلاحظ أن المسألة تشبه مسألة حللتها من قبل. فعد تكرار الكلمات هو نفس عد الأصوات في انتخابات الفصل، ونفس عد زيارات كل صفحة في موقع، ونفس عد رسائل الخطأ في سجلات السيرفر، وإذا حللت واحدة منها فقد حللتها كلها.
- التجريد Abstraction: أن تحذف التفاصيل التي لا تؤثر في الحل. فلا يهم إن كان النص تعليقات عملاء أو رواية، والمهم أنه سوف يصبح قائمة كلمات، وجزء العد لا يحتاج أن يعرف من أين جاءت القائمة.
- تصميم الخوارزمية Algorithm Design: أن تكتب خطوات دقيقة بترتيب محدد يستطيع شخص آخر أو حاسب أن ينفذها دون أن يسألك، ومعها قرار واضح لكل حالة خاصة.
والخوارزمية Algorithm كلمة تخيف المبتدئين، مع أن تعريفها بسيط: مجموعة خطوات محددة ومرتبة تحل مسألة في عدد محدود من الخطوات. ووصفة الطبخ خوارزمية، وتعليمات تركيب قطعة أثاث خوارزمية. والفرق في البرمجة أن المنفذ حاسب لا يملك أي حس سليم، فإذا قالت الوصفة «أضف قليلاً من الملح» فالإنسان يفهم، أما الحاسب فيحتاج أن تقول له كم غراماً بالضبط. ولهذا السبب بالتحديد يحتاج المبرمج أن يفكر في الحالات التي لا يفكر فيها أحد: ماذا لو كانت القائمة فارغة؟ وماذا لو تساوى عنصران؟ لأن الحاسب سوف يفعل في هذه الحالات شيئاً ما، والسؤال الوحيد هل سيكون هذا الشيء ما تريده أم لا.
خطوات بوليا Polya الأربع: افهم ثم خطط ثم نفذ ثم راجع
قبل التفكير الحاسوبي بستين سنة، نشر عالم الرياضيات المجري George Pólya عام 1945 كتاباً صغيراً اسمه How to Solve It، ما زالت جامعة Princeton تطبعه إلى اليوم، وفيه قسم حل أي مسألة رياضية إلى أربع خطوات. وهذه الخطوات تنطبق على البرمجة بشكل مدهش، حتى أن كثيراً من مدرسي البرمجة يبدؤون بها:
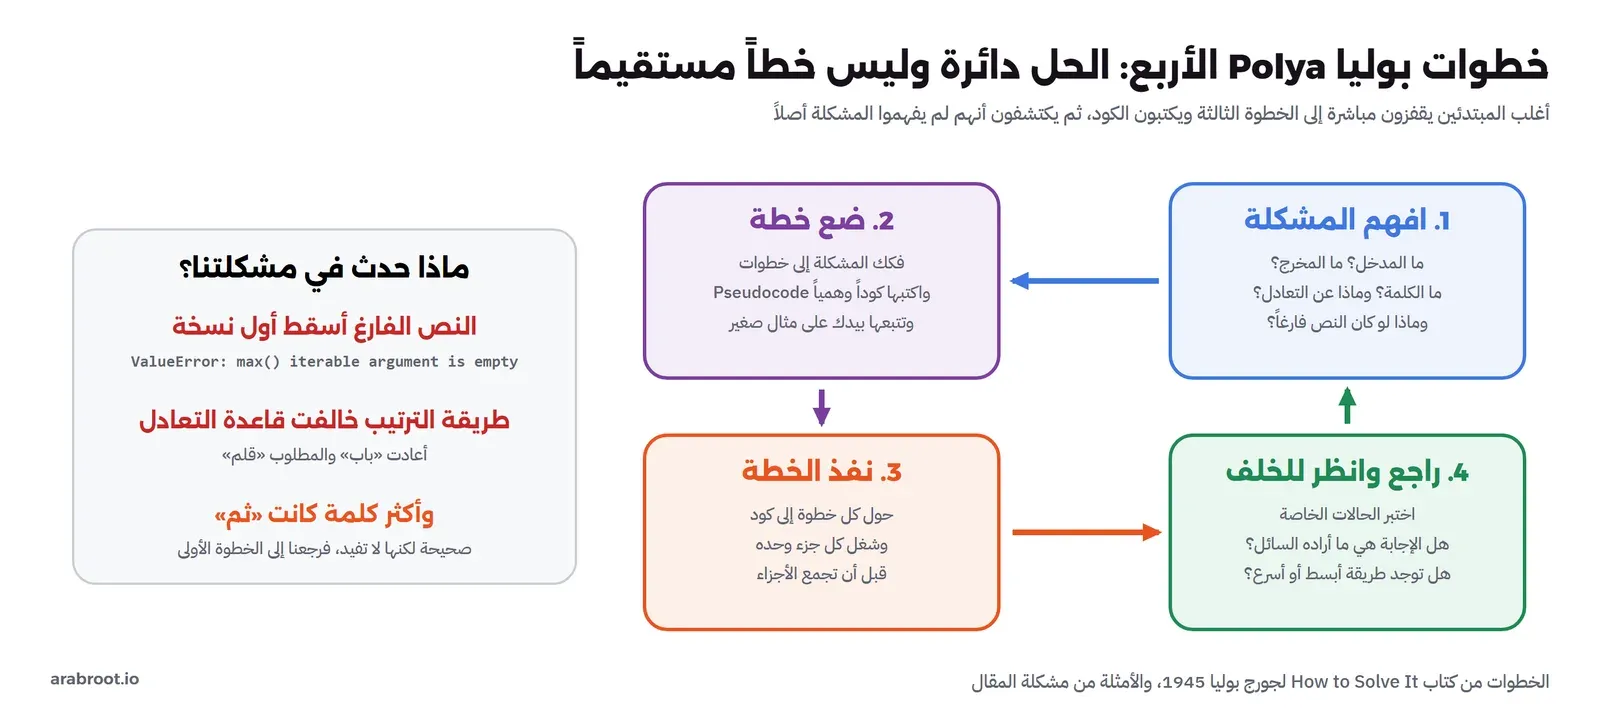
- افهم المشكلة Understand the Problem: ما المجهول؟ ما المعطيات؟ ما الشروط؟ وفي البرمجة: ما المدخل Input، وما المخرج Output، وما الحالات الخاصة.
- ضع خطة Devise a Plan: هل رأيت مسألة مشابهة؟ هل يمكن أن تقسمها؟ وفي البرمجة: التفكيك، ثم الكود الوهمي، ثم التتبع اليدوي على مثال صغير.
- نفذ الخطة Carry Out the Plan: حول الخطة إلى كود، وتأكد من كل خطوة قبل أن تنتقل إلى التي بعدها.
- راجع وانظر للخلف Look Back: هل النتيجة صحيحة؟ هل تجيب عن السؤال الذي سئل فعلاً؟ هل توجد طريقة أبسط أو أسرع؟
والمبتدئ يقفز عادة إلى الخطوة الثالثة مباشرة، لأن كتابة الكود تبدو له العمل الحقيقي وما قبلها إضاعة وقت. ولكن لاحظ في الصورة ما حدث في مسألتنا البسيطة: ثلاث مرات أرجعتنا الخطوة الرابعة إلى ما قبلها، مرة لأننا لم نفكر في النص الفارغ، ومرة لأن إحدى الطرق خالفت قاعدة لم نكتبها بوضوح، ومرة لأن الإجابة كانت صحيحة حرفياً ولكنها لا تفيد من سأل. وكل مرة من هذه كانت ستكلف وقتاً أقل بكثير لو اكتشفناها بالورقة والقلم.
وماذا تفعل إذا وصلت إلى الخطوة الثانية ولم تجد خطة؟ يقترح بوليا في كتابه أسئلة يسألها الشخص لنفسه عندما يتعثر، وأغلبها يعمل في البرمجة كما هو. فأولاً حل نسخة أصغر من المسألة: بدل نص كامل خذ ثلاث كلمات، وبدل أكثر كلمة تكراراً اسأل كم مرة تكررت كلمة واحدة بعينها، فإذا عرفت حل النسخة الصغيرة فغالباً تعرف كيف تكبرها. وثانياً ابدأ من النهاية: ما الذي أحتاجه حتى أعرف الإجابة؟ أحتاج عدد كل كلمة، فما الذي أحتاجه حتى أعرف عدد كل كلمة؟ أحتاج قائمة الكلمات، وبهذا الشكل تكتشف الخطوات بالترتيب العكسي. وثالثاً ارسم: سهم لكل خطوة ومربع لكل قيمة، والرسم يكشف لك أين تضيع معلومة أو أين تتكرر خطوة. ورابعاً اسأل هل حللت مسألة لها نفس المجهول، وهذا هو التعرف على الأنماط بكلمات بوليا قبل أن يظهر المصطلح بعقود.
افهم المشكلة Understanding the Problem: المدخل والمخرج والحالات الخاصة
لنبدأ بالخطوة التي يتجاوزها الجميع. المسألة كما وصلتنا: «أعطني أكثر كلمة تكررت في النص». وأول ما تفعله أن تكتب المدخل والمخرج بوضوح: المدخل نص واحد، أي سلسلة حروف String، والمخرج الكلمة وعدد مرات تكرارها. ثم تكتب مثالاً بيدك، والمثال الذي سوف نتابعه في كل المقال هو النص «الشاي ثم القهوة ثم الشاي ثم». وبمجرد أن تكتب مثالاً تبدأ الأسئلة بالظهور، والجدول التالي يجمع الأسئلة التي سألناها والقرار الذي اتخذناه في كل منها:
| السؤال | مثال | القرار |
|---|---|---|
| كيف نفصل الكلمات؟ | مسافة أو سطر جديد | كل مسافة أو سطر جديد يفصل بين كلمتين |
| هل علامات الترقيم جزء من الكلمة؟ | «القهوة،» و«القهوة!» | لا، نحذفها من أول الكلمة وآخرها |
| هل حالة الحروف مهمة؟ | «Python» و«python» | لا، كلمة واحدة |
| ماذا لو تساوت كلمتان؟ | «قلم باب قلم باب» | الكلمة التي ظهرت أولاً في النص تفوز |
| ماذا لو كان النص فارغاً؟ | «» أو « ، . ! » | لا توجد إجابة، ونرجع قيمة فارغة None |
ولاحظ أن كل قرار في هذا الجدول اختيار وليس حقيقة، فيمكن أن تقرر في التعادل أن ترجع كل الكلمات المتساوية، أو الأولى أبجدياً، وكلها قرارات صحيحة إذا كانت مكتوبة ومتفق عليها. والخطأ الوحيد أن لا تتخذ قراراً، لأن الكود عندها سوف يتخذه بدلاً منك بطريقة عشوائية تعتمد على تفاصيل التنفيذ، وسوف ترى هذا بعينك في التجربة. وفي العمل الحقيقي هذه هي اللحظة التي ترجع فيها إلى من طلب الميزة وتسأله، وأغلب الأخطاء التي تصل إلى المستخدمين ليست أخطاء برمجة وإنما أسئلة لم تسأل.
ومن أدوات الفهم المفيدة أن تكتب الأمثلة على شكل حالات اختبار Test Cases من الآن: كل سطر في الجدول أعلاه هو مدخل ومخرج متوقع. وهذا ليس ترفاً، فهذه الأمثلة نفسها سوف تصبح اختبارات حقيقية في التجربة بعد قليل، وهي التي كشفت لنا خطأين.
الحالات الخاصة Edge Cases: أين تختبئ الأخطاء؟
أسئلة الجدول السابق لم تأت من فراغ، فالحالات الخاصة في أغلب المسائل تقع في عائلات قليلة تتكرر، ويمكن أن تمر عليها كقائمة كلما قرأت مسألة جديدة. فأولاً المدخل الفارغ: قائمة بلا عناصر، أو نص بلا كلمات، أو ملف بلا أسطر، وهذه الحالة وحدها مسؤولة عن عدد كبير من الأعطال لأن الكاتب يتخيل دائماً مدخلاً فيه شيء. وثانياً المدخل الذي فيه عنصر واحد، لأن كثيراً من الخوارزميات تقارن عنصراً بالذي بعده، فإذا لم يوجد ما بعده ظهر خطأ. وثالثاً التساوي والتكرار: كلمتان بنفس العدد، أو عنصر يتكرر في كل القائمة. ورابعاً الحدود: أول عنصر وآخر عنصر، وأصغر قيمة وأكبر قيمة، لأن أغلب أخطاء الحلقات خطأ بخطوة واحدة عند أحد الطرفين. وخامساً الحجم: ماذا لو كان المدخل أكبر بألف مرة مما تجرب عليه؟ وسوف ترى في التجربة أن هذا السؤال وحده يغير الحل الذي تختاره. وسادساً المدخل غير المتوقع: نص بلغة أخرى، أو أرقام بدل كلمات، أو حروف لم تخطر على بالك، مثل علامات الترقيم العربية في مسألتنا.
ولا يعني هذا أن كل حالة تحتاج كوداً خاصاً، فأحياناً يكون القرار أن الحالة لا تحدث في الواقع، أو أن رسالة خطأ واضحة تكفي. والمهم أن يكون هذا قراراً اتخذته وأنت تعرف، وليس شيئاً اكتشفه المستخدم بالنيابة عنك.
التفكيك Decomposition: من سؤال غامض إلى خطوات يمكن كتابتها
الآن نقسم المسألة. والسؤال الذي تسأله في كل مرة: هل أعرف كيف أكتب هذه الخطوة مباشرة؟ فإذا كانت الإجابة لا، قسمها مرة أخرى. والصورة التالية تبين الشجرة التي وصلنا إليها:
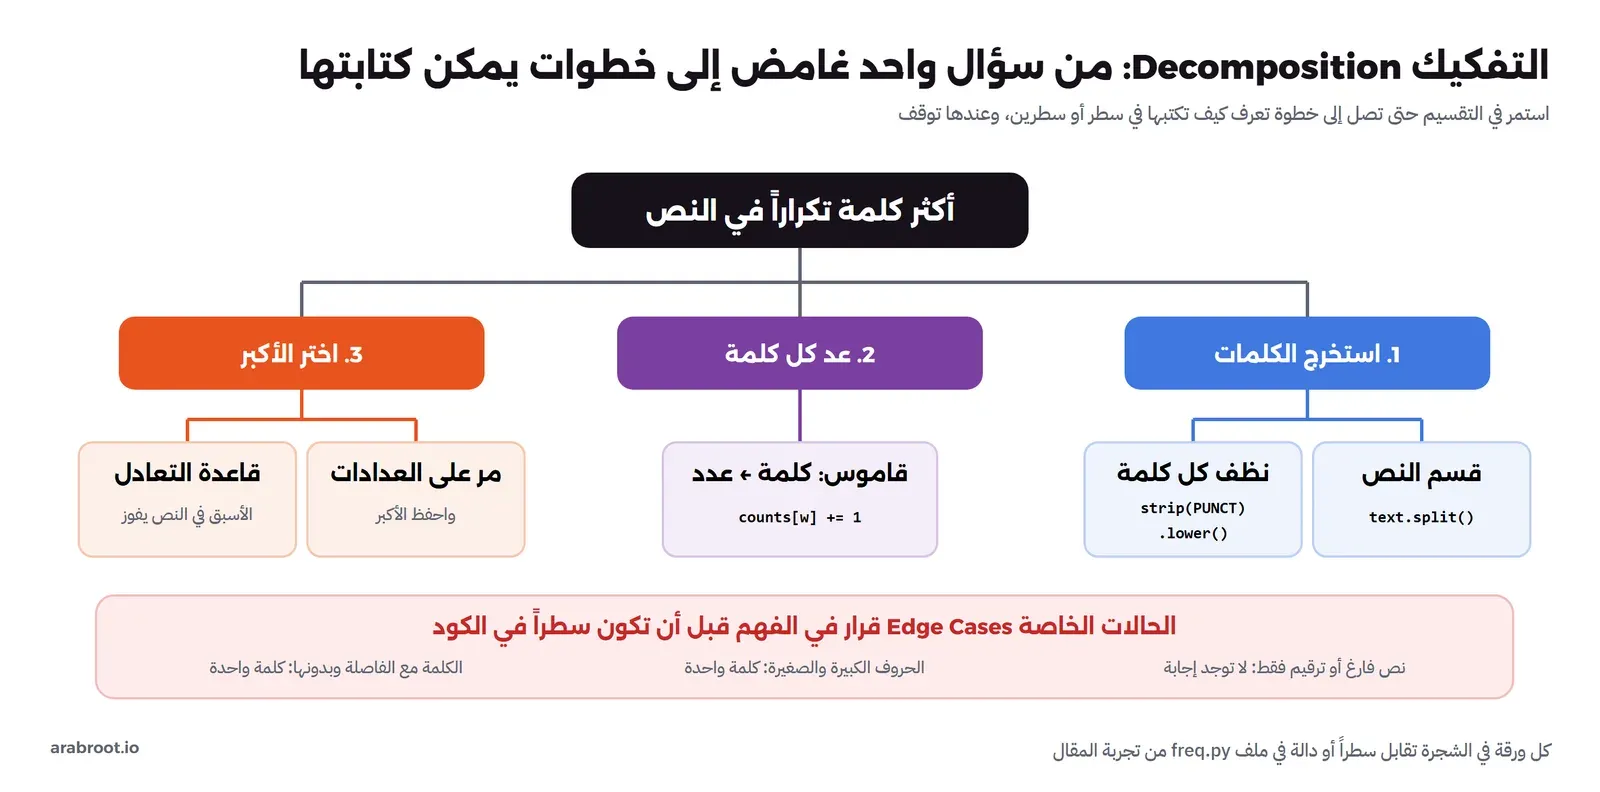
والفائدة الأولى من التفكيك أن كل جزء صغير يمكن أن تختبره وحده. فإذا كتبت دالة تستخرج الكلمات النظيفة من النص فإنك تستطيع أن تجربها على «القهوة، القهوة! الشاي؟» وترى أنها تعيد ثلاث كلمات نظيفة، قبل أن تكتب أي سطر للعد. والفائدة الثانية أن الأجزاء يمكن أن تتغير وحدها، فإذا قررنا لاحقاً أن نستبعد كلمات الربط مثل «ثم» و«في» فالتغيير يكون في جزء الاستخراج فقط، وجزء العد لا يعرف بذلك ولا يتأثر. وهذا هو التجريد في صورته العملية: جزء العد يرى قائمة كلمات، ولا يعرف ولا يهمه كيف نظفت.
وفي Python أصبح الجزء الأول دالة اسمها words_of، وهي الدالة الوحيدة التي تعرف شيئاً عن علامات الترقيم وحالة الحروف:
PUNCT = ".,;:!?()[]{}\"'«»،؛؟-"


def words_of(text):
    """Step 1 of the decomposition: text -> clean list of words."""
    out = []
    for raw in text.split():
        w = raw.strip(PUNCT).lower()
        if w:
            out.append(w)
    return out
في الكود أعلاه لاحظ التالي:
- الدالة
split()بدون معامل تقسم عند أي مسافة أو سطر جديد أو مسافة جدولة Tab، وتتجاهل المسافات المتكررة، وهذا يحل سؤال الفصل بين الكلمات كاملاً. - الدالة
strip(PUNCT)تحذف أي حرف من القائمةPUNCTمن أول الكلمة وآخرها فقط، ولاحظ أننا أضفنا علامات الترقيم العربية «،» و«؛» و«؟» وعلامات التنصيص «» لأن النص عربي، وهذا قرار لم يكن ليخطر على البال لو نسخنا مثالاً من درس إنجليزي. - الشرط
if wيتجاهل «الكلمات» التي أصبحت فارغة بعد التنظيف، مثل فاصلة وحدها بين مسافتين، وبدونه كانت الفاصلة ستصبح كلمة فارغة تعد وقد تفوز.
وقبل أن ننتقل إلى الكود الوهمي لاحظ ما يعطيك التعرف على الأنماط في العمل الحقيقي. فبعد أن تحل هذه المسألة مرة، سوف تراها متنكرة في أماكن كثيرة: مدير السيرفر الذي يريد أكثر عنوان IP أرسل طلبات في سجل الوصول، ومحلل البيانات الذي يريد أكثر منتج بيع هذا الشهر، والمطور الذي يريد أكثر رسالة خطأ ظهرت في سجلات التطبيق بعد الإصدار الأخير. وكلها نفس الخطوات الثلاث: استخرج العناصر، ثم عدها في قاموس، ثم اختر الأكبر، والفرق الوحيد في الخطوة الأولى، أي كيف تستخرج العنصر من السطر، وهذا ما يجعل التجريد مفيداً: إذا كان جزء العد منفصلاً فإنك تعيد استخدامه كما هو وتكتب جزء الاستخراج فقط. والمبرمج الذي يقال عنه إنه سريع في حل المسائل غالباً ليس أذكى من غيره، وإنما رأى أنماطاً أكثر، فيتعرف على المسألة الجديدة بسرعة كنسخة من مسألة حلها من قبل. ولذلك لا تقس تقدمك بعدد اللغات التي تعرفها، وإنما بعدد المسائل المختلفة التي حللتها بنفسك.
الكود الوهمي Pseudocode: الخطوات بلغتك قبل أي لغة برمجة
الكود الوهمي Pseudocode هو أن تكتب الخوارزمية بلغة قريبة من لغتك، بدون أن تهتم بقواعد أي لغة برمجة: لا أقواس ولا فواصل منقوطة ولا أسماء دوال. والهدف أن تركز على المنطق وحده، فإذا كان الكود الوهمي واضحاً ومكتملاً صار تحويله إلى Python أو JavaScript عملاً آلياً تقريباً، وإذا كان غامضاً فلن ينقذك أي كود. والصورة التالية تبين الكود الوهمي لجزأي العد والاختيار، وبجانبه ترجمته إلى Python:
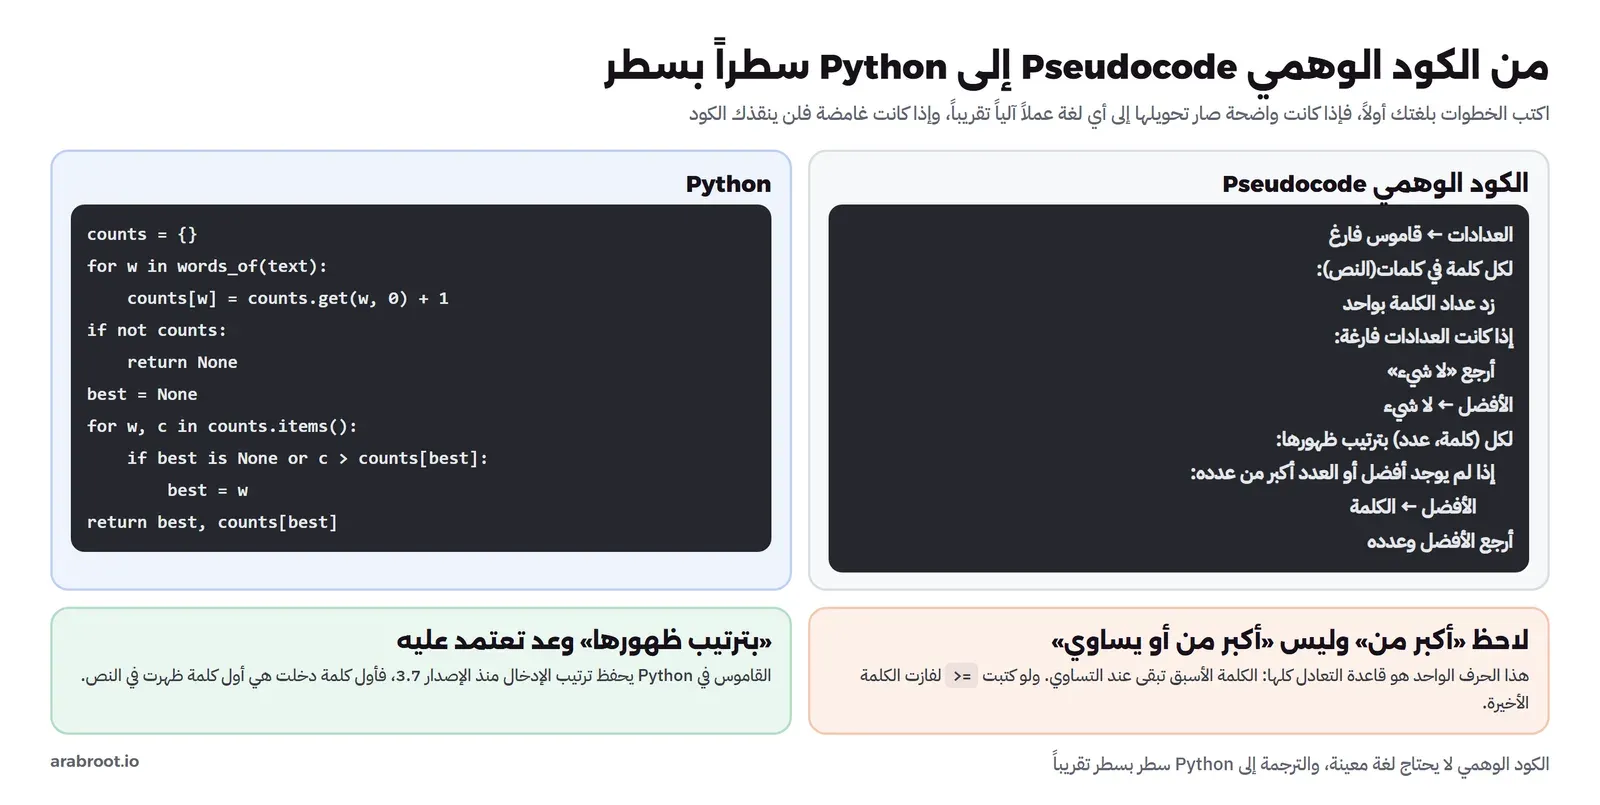
ولاحظ أمرين في الصورة. الأول أن قاعدة التعادل كلها موجودة في حرف واحد: الشرط «أكبر من» وليس «أكبر من أو يساوي». فعندما نمر على الكلمات بترتيب ظهورها ونستبدل الأفضل فقط إذا وجدنا عدداً أكبر منه، تبقى الكلمة الأسبق عند التساوي. ولو كتبنا >= لفازت الكلمة الأخيرة، والبرنامج لن يشتكي أبداً، وإنما سيعطي إجابة مختلفة بهدوء. والثاني أن عبارة «بترتيب ظهورها» في الكود الوهمي وعد يجب أن تتأكد أن اللغة تحققه، وفي Python تقول وثائق الأنواع الأساسية إن القاموس يحفظ ترتيب الإدخال وإن ذلك أصبح مضموناً منذ الإصدار 3.7، فأول كلمة دخلت القاموس هي أول كلمة ظهرت في النص. وفي إصدارات أقدم لم يكن هذا مضموناً، وكان نفس الكود سيعطي نتائج مختلفة عند التعادل.
وقد يتساءل البعض: هل يكتب المبرمجون المحترفون كوداً وهمياً فعلاً؟ والإجابة أنهم نادراً ما يكتبونه بهذا الشكل الرسمي، ولكنهم يفعلون نفس الشيء بطرق أخرى: تعليقات تصف الخطوات قبل كتابتها، أو رسم على السبورة في اجتماع التصميم، أو أسماء دوال فارغة تكتب أولاً ثم تملأ. والمبتدئ يحتاج الشكل الرسمي لأنه يجبره على الفصل بين التفكير والكتابة، وبعد عشرات المسائل يصبح هذا الفصل عادة في رأسه.
التتبع اليدوي Tracing: نفذ الخوارزمية بيدك
قبل أن تشغل الكود، نفذه بيدك على مثال صغير. والتتبع اليدوي Tracing يعني أن ترسم جدولاً فيه سطر لكل دورة في الحلقة وعمود لكل متغير يتغير، ثم تملؤه كما سيفعل الحاسب تماماً، دون أن تقفز إلى النتيجة التي تتوقعها. وهذا جدول مثالنا «الشاي ثم القهوة ثم الشاي ثم»:
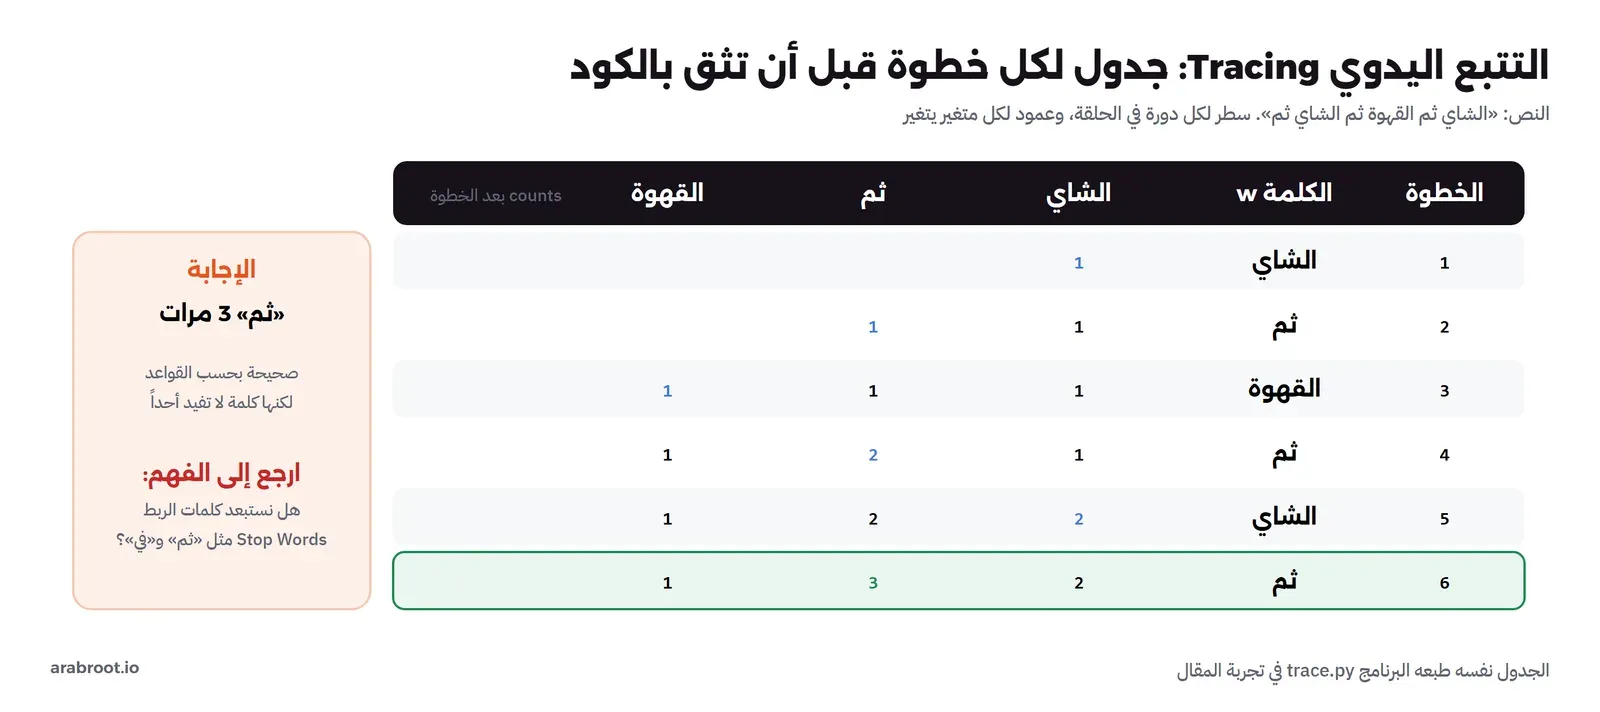
ثم تحققنا من الجدول بتشغيل برنامج صغير اسمه trace.py يطبع نفس الجدول من الكود الحقيقي، وكان المخرج كما يلي:
words: ['الشاي', 'ثم', 'القهوة', 'ثم', 'الشاي', 'ثم']
step w         counts after the step
1    الشاي     {'الشاي': 1}
2    ثم        {'الشاي': 1, 'ثم': 1}
3    القهوة    {'الشاي': 1, 'ثم': 1, 'القهوة': 1}
4    ثم        {'الشاي': 1, 'ثم': 2, 'القهوة': 1}
5    الشاي     {'الشاي': 2, 'ثم': 2, 'القهوة': 1}
6    ثم        {'الشاي': 2, 'ثم': 3, 'القهوة': 1}
answer: ('ثم', 3)
في المخرج أعلاه لاحظ التالي:
- السطر الأول هو نتيجة الجزء الأول من التفكيك وحده: ست كلمات نظيفة، وهذا يؤكد أن
words_ofتعمل قبل أن ننظر إلى العد. - في الخطوة 5 تساوت «الشاي» و«ثم» بعدد 2، ولو توقف النص هنا لفازت «الشاي» لأنها ظهرت أولاً، وهذه هي قاعدة التعادل في العمل.
- القاموس يطبع مفاتيحه بترتيب دخولها: «الشاي» ثم «ثم» ثم «القهوة»، وهو ترتيب ظهورها في النص كما وعدت الوثائق.
- الإجابة النهائية «ثم» بثلاث مرات، وهي مطابقة للجدول الذي ملأناه بيدنا.
ولكن انظر إلى الإجابة نفسها مرة أخرى. إنها صحيحة تماماً بحسب القواعد التي كتبناها، ومع ذلك لا تفيد أحداً، فلو كان النص تعليقات عملاء على متجر قهوة فإن صاحب المتجر لا يريد أن يعرف أن «ثم» و«في» و«من» أكثر الكلمات تكراراً. وهذه هي الخطوة الرابعة عند بوليا في أوضح صورها: الكود صحيح، والمسألة كما فهمناها محلولة، لكن الفهم نفسه كان ناقصاً. والحل الحقيقي يرجعنا إلى الخطوة الأولى لنضيف قاعدة جديدة: استبعد كلمات الربط Stop Words من قائمة نتفق عليها. ولاحظ أن هذا التغيير بفضل التفكيك يكون في الدالة words_of وحدها، وتركناه تدريباً لك في آخر المقال.
والتتبع اليدوي قد يبدو بطيئاً، وهو كذلك، ولكنه أسرع طريقة لفهم خوارزمية لم تكتبها، ولاكتشاف خطأ في خوارزمية كتبتها. وفي مقابلات العمل التقنية يطلب منك كثيراً أن تتتبع الكود على السبورة، والسبب أن المقابل يريد أن يرى كيف تفكر، لا أن يرى هل تحفظ الحل. وقد جمعنا مسائل كثيرة تتدرب فيها على هذه المهارة في تمارين Kata في البرمجة.
التجربة العملية: المسألة بثلاث طرق Lab
الآن ننفذ الخطة فعلاً، ولكن بثلاث طرق مختلفة لنفس المسألة، لأن مقارنة الطرق هي ما يعلمك أن الحل الصحيح ليس واحداً، وأن لكل حل كلفة. والملفات كلها في مجلد واحد:
freq.py: الدالةwords_ofوالطرق الثلاث، ومعها النسخة الأولى التي كتبناها مباشرة من الكود الوهمي.test_freq.py: اختبارات من جدول الفهم، تشغل كل الطرق على كل حالة.trace.py: يطبع جدول التتبع الذي رأيته.bench.py: يقيس وقت كل طريقة على نصوص يتضاعف حجمها.
وشغلنا كل شيء داخل Container من الـ Image الرسمية python:3.13-slim حتى تكون الأرقام قابلة للتكرار، ويمكنك تشغيل نفس الملفات مباشرة على جهازك بأي Python 3 حديث:
docker run --rm -v "$PWD":/lab -w /lab python:3.13-slim sh run.sh > run.out 2>&1أول مفاجأة: النص الفارغ Empty Input
النسخة الأولى كتبناها مباشرة من الكود الوهمي، لكننا نسينا سطر «إذا كانت العدادات فارغة»، واستخدمنا الدالة الجاهزة max لنختصر الحلقة الأخيرة:
def most_frequent_v0(text):
    words = words_of(text)
    counts = {}
    for w in words:
        counts[w] = counts.get(w, 0) + 1
    best = max(counts, key=counts.get)
    return best, counts[best]
وعلى نص عادي عملت بشكل صحيح، أما على نص فارغ فكان المخرج كما يلي:
('الشاي', 2)
Traceback (most recent call last):
  File "<string>", line 1, in <module>
    import freq; print(freq.most_frequent_v0(""))
                       ~~~~~~~~~~~~~~~~~~~~~^^^^
  File "/lab/freq.py", line 30, in most_frequent_v0
    best = max(counts, key=counts.get)
ValueError: max() iterable argument is empty
[exit 1]
اقرأ الـ Traceback من الأسفل إلى الأعلى: آخر سطر يقول ما الخطأ، وهو أن max طلب منها أن تختار أكبر عنصر من مجموعة فارغة، والسطر الذي فوقه يقول أين حدث، وهو السطر 30 من freq.py. والدالة max لا تستطيع أن تخترع إجابة، فالقرار يجب أن يكون منا، وقد اتخذناه في جدول الفهم: نرجع None. ولكننا لم نترجمه إلى كود، وهذا بالضبط ما يحدث عندما يكون القرار في رأسك وليس مكتوباً. ولاحظ أن هذا الخطأ كان سيظهر في أسوأ مكان: عند أول عميل لا يكتب تعليقاً أصلاً.
ثلاث طرق للحل: Brute Force والترتيب Sorting والقاموس Dictionary
بعد إصلاح الحالة الفارغة كتبنا ثلاث طرق، والصورة التالية تبين كيف تعمل كل واحدة على مثال التعادل «قلم باب قلم باب»:
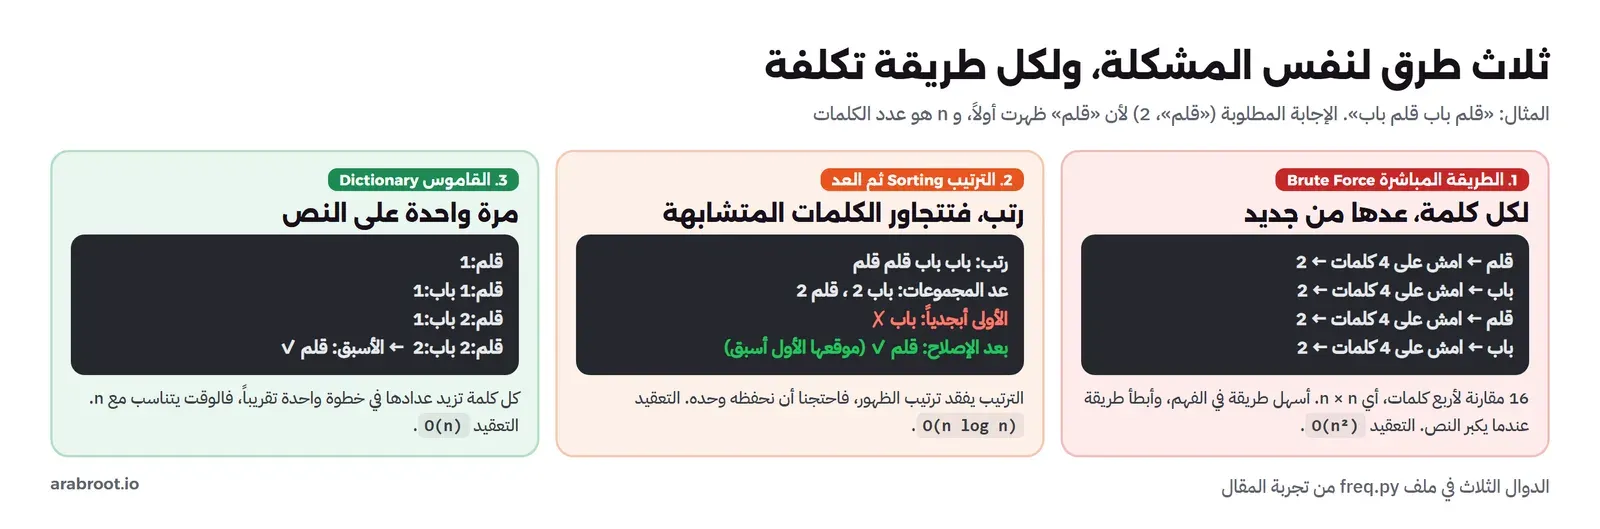
الطريقة الأولى هي الطريقة المباشرة Brute Force، وهي أول ما يخطر على البال لمن لم يعرف القاموس بعد: لكل كلمة في القائمة، امش على القائمة كلها من أولها وعد كم مرة ظهرت، واحفظ الأكبر. وهي صحيحة وسهلة الفهم، ولكن لاحظ أن كل كلمة تعد من جديد في كل مرة تظهر فيها، فلأربع كلمات نحتاج 16 مقارنة، ولألف كلمة مليون مقارنة:
def most_frequent_brute(text):
    words = words_of(text)
    best, best_count = None, 0
    for i in range(len(words)):
        c = 0
        for j in range(len(words)):
            if words[j] == words[i]:
                c += 1
        if c > best_count:          # strictly greater: the first one keeps the tie
            best, best_count = words[i], c
    return (best, best_count) if best is not None else None
والطريقة الثانية تعتمد على فكرة ذكية: إذا رتبت الكلمات أبجدياً فإن الكلمات المتشابهة تصبح متجاورة، وعندها يكفي أن تمشي على القائمة مرة واحدة وتعد طول كل مجموعة متجاورة. والترتيب نفسه يكلف أكثر من مرور واحد، لكنه أرخص بكثير من مقارنة كل كلمة بكل كلمة. وقد كتبناها أولاً كما يلي:
def most_frequent_sorted_v1(text):
    words = sorted(words_of(text))
    best, best_count = None, 0
    i = 0
    while i < len(words):
        j = i
        while j < len(words) and words[j] == words[i]:
            j += 1
        if j - i > best_count:
            best, best_count = words[i], j - i
        i = j
    return (best, best_count) if best is not None else None
والطريقة الثالثة هي التي رأيتها في الكود الوهمي: قاموس Dictionary مفاتيحه الكلمات وقيمه عدد مرات ظهورها، ومرور واحد على النص يزيد عداد كل كلمة، ثم مرور على القاموس لاختيار الأكبر. والقاموس في Python جدول هاش Hash Table من الداخل، وهذا يعني أن البحث عن كلمة فيه وزيادة عدادها يأخذ وقتاً ثابتاً تقريباً مهما كبر القاموس، وقد شرحنا لماذا في مقال هياكل البيانات للمبتدئين. وهنا يظهر التعرف على الأنماط مرة أخرى: من رأى نمط «عد التكرار» من قبل يعرف أن القاموس هو الأداة الطبيعية له، بل إن Python فيها أداة جاهزة لهذا النمط بالضبط اسمها collections.Counter، وتقول وثائقها إن الدالة most_common ترتب العناصر المتساوية بترتيب أول ظهور لها، أي نفس قاعدة التعادل التي اخترناها. ولكننا كتبنا الحلقة بأنفسنا لأن الهدف أن تفهم ما تفعله الأداة.
الاختبارات Tests قبل القياس: المفاجأة الثانية
قبل أن نقيس سرعة أي طريقة، يجب أن نتأكد أن الطرق كلها تعطي نفس الإجابة الصحيحة، فلا قيمة لطريقة سريعة تعطي إجابة خاطئة. وحولنا جدول الفهم إلى اختبارات بالمكتبة المدمجة unittest، كل اختبار يشغل كل الطرق على نفس الحالة:
WAYS = [freq.most_frequent_brute, freq.most_frequent_sorted_v1, freq.most_frequent_sorted, freq.most_frequent_dict]


class MostFrequent(unittest.TestCase):
    def check(self, text, expected):
        for f in WAYS:
            with self.subTest(way=f.__name__):
                self.assertEqual(f(text), expected)

    def test_punctuation(self):
        self.check("القهوة، القهوة! الشاي؟", ("القهوة", 2))

    def test_tie_first_wins(self):
        self.check("قلم باب قلم باب", ("قلم", 2))

    def test_empty(self):
        self.check("", None)
    # ... test_simple, test_case, test_single_word, test_only_punctuation
وعند التشغيل كان المخرج كما يلي:
test_case (test_freq.MostFrequent.test_case) ... ok
test_empty (test_freq.MostFrequent.test_empty) ... ok
test_only_punctuation (test_freq.MostFrequent.test_only_punctuation) ... ok
test_punctuation (test_freq.MostFrequent.test_punctuation) ... ok
test_simple (test_freq.MostFrequent.test_simple) ... ok
test_single_word (test_freq.MostFrequent.test_single_word) ... ok
test_tie_first_wins (test_freq.MostFrequent.test_tie_first_wins) ...
  test_tie_first_wins (test_freq.MostFrequent.test_tie_first_wins) (way='most_frequent_sorted_v1') ... FAIL

======================================================================
FAIL: test_tie_first_wins (test_freq.MostFrequent.test_tie_first_wins) (way='most_frequent_sorted_v1')
----------------------------------------------------------------------
Traceback (most recent call last):
  File "/lab/test_freq.py", line 13, in check
    self.assertEqual(f(text), expected)
    ~~~~~~~~~~~~~~~~^^^^^^^^^^^^^^^^^^^
AssertionError: Tuples differ: ('باب', 2) != ('قلم', 2)

First differing element 0:
'باب'
'قلم'

- ('باب', 2)
+ ('قلم', 2)

----------------------------------------------------------------------
Ran 7 tests in 0.044s

FAILED (failures=1)
[exit 1]
في المخرج أعلاه لاحظ التالي:
- ستة اختبارات نجحت لكل الطرق، ومنها النص الفارغ والنص الذي فيه علامات ترقيم فقط، أي أن إصلاح المفاجأة الأولى يعمل في الطرق الثلاث.
- الاختبار الوحيد الذي فشل هو التعادل، وفي طريقة واحدة فقط هي
most_frequent_sorted_v1، والفضل في معرفة الطريقة بالضبط للدالةsubTestالتي تكتب اسمها في السطر. - السطر
('باب', 2) != ('قلم', 2)يقول إن الطريقة أعادت «باب» والمطلوب «قلم». والعدد صحيح، والكلمة خاطئة بحسب قاعدتنا.
والسبب واضح عندما تفكر فيه: الترتيب الأبجدي يضع «باب» قبل «قلم» لأن الباء قبل القاف، والطريقة تختار أول مجموعة وصلت إلى العدد الأكبر، فتفوز «باب» دائماً عند التعادل مهما كان ترتيبها في النص. أي أن الترتيب أضاع معلومة كنا نحتاجها، وهي موقع كل كلمة في النص الأصلي. ولاحظ أن الاختبار الأول «الشاي ثم القهوة ثم الشاي» نجح بالصدفة، لأن الكلمة الفائزة فيه لم تكن متعادلة مع غيرها. وهذا النوع من الأخطاء هو الأخطر، لأن البرنامج يعمل على أغلب الأمثلة ويعطي في بعضها إجابة خاطئة بهدوء، دون أي رسالة خطأ. ولولا أننا كتبنا قاعدة التعادل صراحة في جدول الفهم ثم حولناها إلى اختبار لما اكتشفناه أبداً.
والإصلاح أن نحفظ أول موقع لكل كلمة قبل الترتيب، ثم نستخدمه لكسر التعادل بين المجموعات المتساوية:
def most_frequent_sorted(text):
    words = words_of(text)
    first = {}
    for pos, w in enumerate(words):
        if w not in first:
            first[w] = pos
    ordered = sorted(words)
    best, best_count = None, 0
    i = 0
    while i < len(ordered):
        j = i
        while j < len(ordered) and ordered[j] == ordered[i]:
            j += 1
        c = j - i
        if c > best_count or (c == best_count and first[ordered[i]] < first[best]):
            best, best_count = ordered[i], c
        i = j
    return (best, best_count) if best is not None else None
ولاحظ ما حدث: لكي نصلح طريقة الترتيب احتجنا قاموساً، وهو نفس الأداة التي تحل المسألة كلها في الطريقة الثالثة. وهذه ملاحظة تعلمك شيئاً عن التصميم: عندما يحتاج حل إلى أداة حل آخر ليعمل بشكل صحيح، فغالباً الحل الآخر هو الأبسط. واحتفظنا بالنسخة الخاطئة في الملف وفي الاختبارات عن قصد، حتى ترى الفشل بنفسك عند التشغيل.
قياس الوقت Timing: ماذا يحدث عندما يتضاعف النص؟
بعد أن تأكدنا أن الطرق تعطي نفس الإجابة، قسنا الوقت. والبرنامج bench.py ينشئ نصاً من كلمات عشوائية يختارها من 2,000 كلمة مختلفة، بحجم يتضاعف من 1,000 كلمة إلى 16,000، ويشغل الطرق الثلاث على نفس النص، ويتأكد أن إجاباتها متطابقة، ويقيس الوقت بالدالة time.perf_counter التي تصفها وثائق الوحدة time بأنها أدق ساعة متاحة لقياس فترات قصيرة. ولأن البرامج الأخرى على الجهاز تشوش على القياسات الصغيرة، أخذنا أفضل نتيجة من خمس محاولات لطريقتي الترتيب والقاموس، ومحاولة واحدة للطريقة المباشرة لأنها طويلة. والمخرج كان كما يلي:
Python 3.13.17
        n      brute     sorted       dict  answer
     1000     0.150s    0.0008s    0.0005s  ('w1590', 4)
     2000     0.411s    0.0026s    0.0014s  ('w964', 5)
     4000     1.677s    0.0034s    0.0024s  ('w1001', 8)
     8000     6.526s    0.0061s    0.0031s  ('w709', 12)
    16000    27.173s    0.0127s    0.0064s  ('w673', 18)

without the brute force:
   100000          -     0.090s     0.045s  ('w1647', 72)
  1000000          -     1.336s     0.679s  ('w1076', 575)
في المخرج أعلاه لاحظ التالي:
- العمود الأخير متطابق في كل سطر للطرق الثلاث، لأن البرنامج يتوقف بخطأ إذا اختلفت الإجابات، فكل الأرقام في الجدول لطرق صحيحة.
- الطريقة المباشرة تضرب وقتها في 4 تقريباً كلما تضاعف النص: من 1.677 إلى 6.526 ثم إلى 27.173 ثانية. وهذا متوقع، لأنها تقارن كل كلمة بكل كلمة، فضعف الكلمات يعني ضعفها في ضعفها من المقارنات.
- القاموس يضاعف وقته تقريباً كلما تضاعف النص، أي أن الوقت يتناسب مع عدد الكلمات، و16,000 كلمة أخذت 6.4 مللي ثانية، أي أسرع من الطريقة المباشرة بأكثر من 4,000 مرة على نفس النص.
- طريقة الترتيب في المنتصف، أبطأ من القاموس بمرتين تقريباً في كل الأحجام، لكنها في نفس فئته وبعيدة جداً عن الطريقة المباشرة.
- عند مليون كلمة أخذ القاموس 0.679 ثانية والترتيب 1.336 ثانية، ولم نشغل الطريقة المباشرة على هذا الحجم، والسبب في القسم التالي.
وقبل أن تقيس أي كود بنفسك تذكر ثلاث قواعد تعلمناها من هذه التجربة. الأولى أن تقيس كل الطرق على نفس المدخل بالضبط، ولذلك ثبتنا مولد الأرقام العشوائية بالأمر random.seed(2026)، فيحصل كل من يشغل البرنامج على نفس النصوص ونفس الإجابات في العمود الأخير. والثانية أن القياس الواحد للفترات القصيرة لا يعتمد عليه، فالجهاز يشغل في نفس اللحظة عشرات البرامج الأخرى، وفي تشغيل سابق لنفس البرنامج بينما كان Container آخر يثبت حزماً على نفس الجهاز ظهر القاموس أبطأ على 2,000 كلمة منه على 4,000 كلمة، وهي نتيجة لا معنى لها، ولذلك نأخذ أفضل نتيجة من عدة محاولات. والثالثة أن الأرقام المطلقة تختلف من جهاز لآخر، فجهازك قد يكون أسرع أو أبطأ بمرتين، أما النسبة بين الأحجام وبين الطرق فهي التي تبقى ثابتة، وهي التي تعلمك شيئاً عن الخوارزمية نفسها.
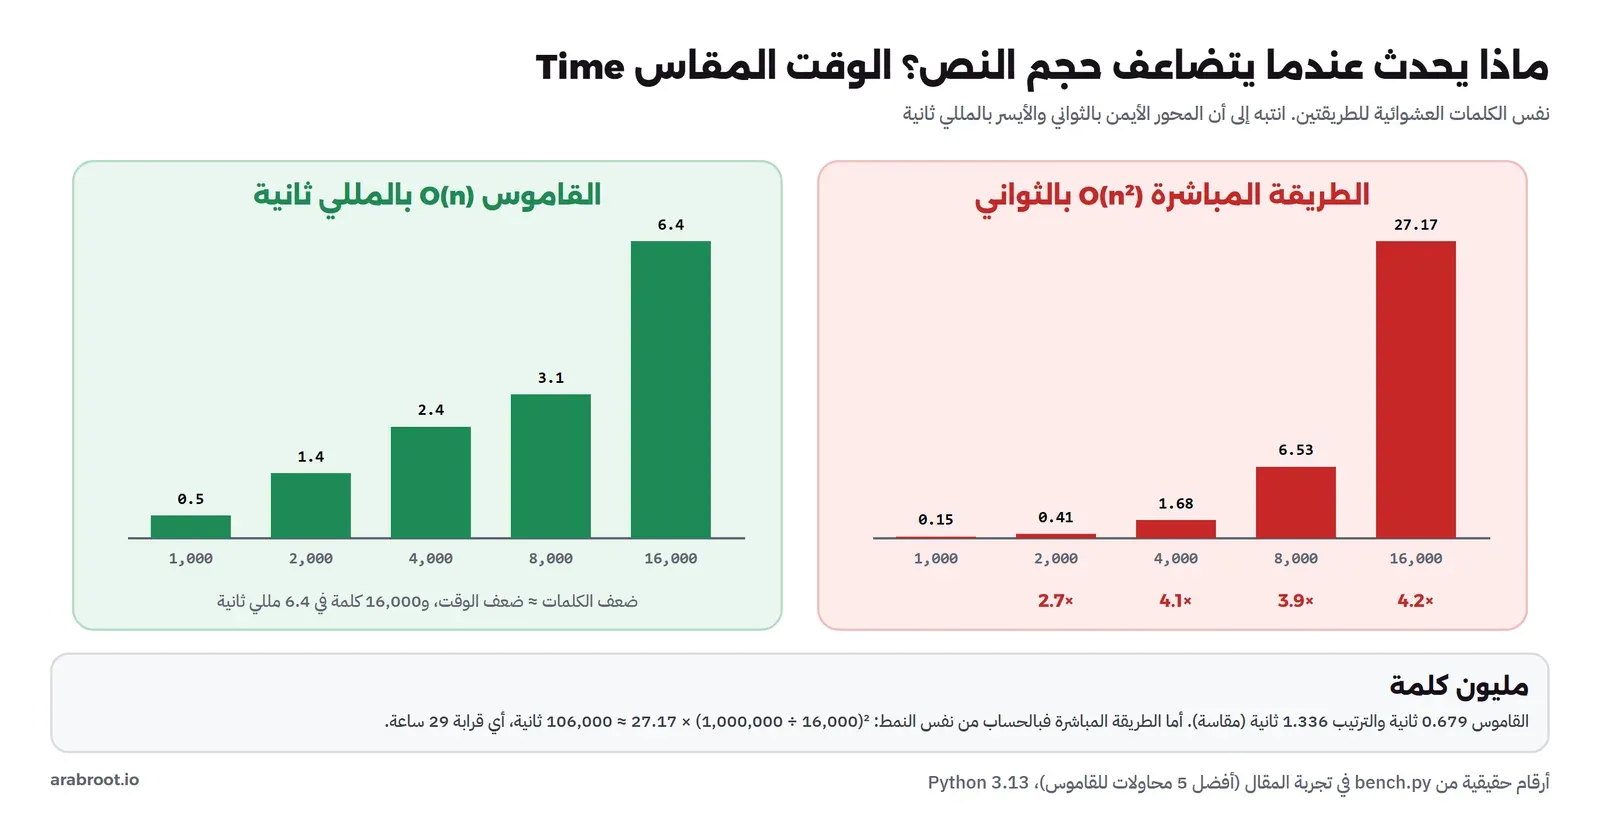
وهذا النمط في نمو الوقت هو ما يعبر عنه المبرمجون بتعقيد الوقت Time Complexity وترميز Big-O: الطريقة المباشرة O(n²) لأن وقتها يتناسب مع مربع عدد الكلمات، والقاموس O(n) لأن وقته يتناسب مع عددها، والترتيب O(n log n) لأن خوارزمية الترتيب في Python تحتاج هذا القدر من الخطوات. ولن نشرح هذا الترميز هنا، فقد خصصنا له مقال الخوارزميات وتعقيد Big-O للمبتدئين، والمهم أن ترى أنه ليس نظرية في كتاب، وإنما وصف لما قسته بعينك للتو.
ماذا لو شغلنا الطريقة المباشرة Brute Force على مليون كلمة؟
لم نشغلها، والحساب يخبرك لماذا. فإذا كان وقتها يتضاعف أربع مرات كلما تضاعف النص، فإن الانتقال من 16,000 كلمة إلى مليون كلمة يعني أن النص كبر 62.5 مرة، فيكبر الوقت مربع هذا الرقم، أي 3,906 مرات تقريباً. والحساب كما يلي: 27.17 ثانية مضروبة في 3,906 تساوي قرابة 106,000 ثانية، أي حوالي 29 ساعة لمسألة يحلها القاموس في أقل من ثانية. وهذا تقدير بالحساب وليس قياساً، لكنه مبني على نمط ثابت قسناه في خمسة أحجام متتالية.
ولاحظ أن الطريقة المباشرة عند ألف كلمة أخذت 0.15 ثانية فقط، وهو وقت لن يلاحظه أحد. وهنا الدرس الأهم في هذا القسم: الطرق البطيئة لا تظهر بطأها على أمثلة الاختبار الصغيرة التي تجربها وأنت تكتب الكود، وإنما تظهره عندما يكبر المدخل في الاستخدام الحقيقي، بعد أن يكون الكود قد وصل إلى المستخدمين. ولذلك جزء من المراجعة عند بوليا أن تسأل: ما أكبر مدخل يمكن أن يصل إلى هذا الكود؟ فإذا كان النص تعليقاً واحداً فالطريقة المباشرة مقبولة تماماً، وإذا كان كل تعليقات المتجر لسنة كاملة فهي غير مناسبة إطلاقاً.
وقد يتساءل البعض: إذن لماذا نتعلم الطريقة المباشرة أصلاً؟ والإجابة أنها أول حل يجب أن تكتبه في أغلب المسائل، لأنها الأقرب إلى تعريف المسألة والأسهل في التأكد من صحتها، فتصبح المرجع الذي تقارن به الحلول الأسرع. وهذا بالضبط ما فعلناه في الاختبارات: الطرق الثلاث تختبر بعضها البعض، والطريقة المباشرة لم تخطئ في أي حالة لأنها لا تحتوي أي حيلة يمكن أن تخطئ.
أخطاء شائعة في طريقة التفكير Problem Solving
- البدء بالكود قبل كتابة مثال واحد بيدك: المثال يكشف الأسئلة الغامضة في دقائق، والكود يكشفها بعد ساعات أو بعد وصوله إلى المستخدم.
- اختبار المثال الذي في رأسك فقط: الحالة الفارغة وحالة العنصر الواحد وحالة التعادل هي أين تختبئ الأخطاء، وكلها ظهرت في مسألتنا البسيطة.
- ترك القرارات ضمنية: قاعدة التعادل التي لم تكتب كانت ستعطي إجابات مختلفة بحسب الطريقة، وكل طريقة كانت ستبدو صحيحة لمن كتبها.
- محاولة كتابة الحل الأسرع من أول مرة: الحل البسيط الصحيح أولاً، ثم الحل الأسرع مع اختبارات تقارنه بالبسيط، وليس العكس.
- الحكم على السرعة من مثال صغير: الطريقة المباشرة أخذت 0.15 ثانية على ألف كلمة وكانت ستأخذ 29 ساعة على مليون.
- الخلط بين «صحيح» و«مفيد»: الإجابة «ثم» كانت صحيحة بحسب القواعد، والمراجعة هي التي سألت هل تفيد من طلبها.
- الاستسلام عند أول تعثر: إذا لم تعرف كيف تكتب خطوة فهذه إشارة أنها تحتاج تفكيكاً إضافياً، وليست إشارة أن البرمجة ليست لك.
قائمة التحقق مع كل مسألة جديدة Checklist
| المرحلة | السؤال | في مسألتنا |
|---|---|---|
| الفهم | ما المدخل وما المخرج بالضبط؟ | نص، والمخرج كلمة وعدد أو None |
| الفهم | هل كتبت مثالين على الأقل بيدك؟ | «الشاي ثم القهوة...» و«قلم باب قلم باب» |
| الفهم | ما الحالات الخاصة وما القرار في كل منها؟ | نص فارغ، تعادل، ترقيم، حالة الحروف |
| الخطة | هل قسمت المسألة حتى صارت كل خطوة سطراً أو سطرين؟ | استخراج، عد، اختيار |
| الخطة | هل رأيت نمطاً مشابهاً من قبل؟ | عد التكرار، وأداته القاموس |
| الخطة | هل تتبعت الكود الوهمي بيدك على مثال؟ | جدول الخطوات الست |
| التنفيذ | هل اختبرت كل جزء وحده قبل جمعها؟ | words_of أولاً |
| المراجعة | هل حولت الأمثلة إلى اختبارات تشغل آلياً؟ | 7 اختبارات كشفت خطأ التعادل |
| المراجعة | ما أكبر مدخل حقيقي، وهل الحل يتحمله؟ | مليون كلمة: القاموس 0.679 ثانية |
| المراجعة | هل الإجابة تفيد من طلبها؟ | «ثم» صحيحة وغير مفيدة |
تدريب عملي
- أضف قاعدة كلمات الربط Stop Words: قائمة صغيرة مثل «ثم» و«في» و«من» و«على» تستبعد في
words_of، ثم أضف اختباراً يتأكد أن «الشاي ثم القهوة ثم الشاي ثم» تعطي «الشاي». ولاحظ كم سطراً تغير في بقية الكود. - غير قاعدة التعادل لتعيد كل الكلمات المتعادلة في قائمة، وعدل الاختبارات أولاً قبل الكود، ثم اكتشف أي طريقة من الثلاث كان تعديلها أسهل.
- اكتب حلاً رابعاً باستخدام
collections.Counterوأضفه إلى قائمةWAYSفي الاختبارات وإلىbench.py، وقارن وقته بالقاموس الذي كتبناه بأيدينا. - مسألة جديدة بنفس الطريقة: في قائمة درجات الطلاب، ما أطول سلسلة متتالية من الدرجات المتزايدة؟ اكتب جدول الفهم والتفكيك والكود الوهمي والتتبع قبل أي سطر كود.
حذف المختبر Cleanup
التجربة عملت داخل Container بالخيار --rm، فلا يبقى بعدها إلا الـ Image، واحذفها إذا لم تكن تحتاجها:
docker rmi python:3.13-slimالخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- معرفة قواعد اللغة وحل المسائل مهارتان مختلفتان، والثانية لها طرق تتدرب عليها، وأهمها أن تفصل التفكير عن كتابة الكود.
- التفكير الحاسوبي Computational Thinking أربع مهارات: التفكيك، والتعرف على الأنماط، والتجريد، وتصميم الخوارزمية.
- خطوات بوليا الأربع دائرة وليست خطاً: افهم، ثم خطط، ثم نفذ، ثم راجع، والمراجعة ترجعك إلى الفهم غالباً.
- جدول الفهم بالأمثلة والحالات الخاصة هو نفسه جدول الاختبارات، وفي مسألتنا كشف خطأين: النص الفارغ الذي أسقط النسخة الأولى، والتعادل الذي أخطأت فيه طريقة الترتيب بهدوء.
- الكود الوهمي والتتبع اليدوي يكشفان الأخطاء قبل أن تكلفك، والإجابة في التتبع كانت صحيحة ولكن غير مفيدة.
- لنفس المسألة حلول بكلف مختلفة: على 16,000 كلمة أخذت الطريقة المباشرة 27.17 ثانية والقاموس 6.4 مللي ثانية، وعلى مليون كلمة أخذ القاموس 0.679 ثانية بينما تحتاج الطريقة المباشرة قرابة 29 ساعة بالحساب.
- اكتب الحل البسيط الصحيح أولاً، واجعله مرجعاً تختبر به الحلول الأسرع.
وفي المقال التالي من هذه المرحلة سوف نتعلم أدوات الكتابة نفسها: المتغيرات والأنواع والشروط والحلقات والدوال بلغتي Python وJavaScript جنباً إلى جنب، مع الأخطاء الحقيقية التي تظهر لكل مبتدئ. وهذه مقالات مرتبطة بما رأيته هنا:
 دليلBig-O للمبتدئين: لماذا يبطؤ كودك عندما تكبر البياناتلماذا يعمل الكود بسرعة على مئة صف ثم يتوقف على مئة ألف، وكيف تقرأ Big-O وتكتشف الخوارزمية البطيئة في كودك.
 دليلهياكل البيانات Data Structures للمبتدئينلماذا تكون نفس العملية سريعة في هيكل بيانات وبطيئة في آخر، وأين تقابل كل هيكل في السيرفرات وقواعد البيانات.
 دليلتمارين Kata في البرمجة بثلاثة مستويات مع الحلولتمارين برمجة تحلها بيدك دون ذكاء اصطناعي، من FizzBuzz إلى النصوص العربية وحالة السباق، ولكل تمرين حل مجرب في لغتين.
 دليلبيئة البرمجة للمبتدئين: المحرر VS Code والطرفية Terminalنجهز المحرر والطرفية وPython وNode على جهاز نظيف، ونفهم كل رسالة خطأ تظهر في الأيام الأولى مثل command not found وPATH وpython3 قبل أن نكتب أول برنامج.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجربة (الطرق الثلاث والاختبارات وقياس الوقت حتى مليون كلمة) داخل Container من python:3.13-slim مع Python 3.13.17 على Docker Engine 29.8.0.


