فريق صغير يبني وحدة تحكم لخط تعبئة في مصنع، والوحدة لها ثلاثة أعمال: تضيء مصباح LED لكاميرا الفحص بنبضات عرض النبضة PWM يجب أن تكون ثابتة تماماً لأن الكاميرا تلتقط الصورة في منتصف النبضة، وترسل رسالة حالة إلى الحاسب عبر المنفذ التسلسلي UART، وتراقب زر توقف الطوارئ. وكتب الفريق النسخة الأولى على متحكم دقيق Microcontroller بلغة C كما في مقالات المرحلة السابقة، واشتغلت على المكتب، ولكن في الخط ظهرت صور معتمة كل بضع دقائق، والسبب أن مقاطعة Interrupt من وحدة UART تأتي أحياناً في نفس لحظة تحديث نبضة الضوء فتتأخر النبضة بضع ميكروثوان، أي أن التوقيت يتغير من دورة إلى أخرى، وهذا ما يسمى الارتجاف Jitter. وحاول الفريق أن يرفع الأولويات ويعيد ترتيب المقاطعات، فقل الخطأ ولم يختف، لأن المشكلة في طبيعة المعالج نفسه: هو ينفذ تعليمة بعد تعليمة، وكل الأعمال تتقاسم نفس المعالج.
وهنا يقترح أحد المهندسين أن تنقل هذه الأعمال إلى مصفوفة البوابات القابلة للبرمجة Field Programmable Gate Array، واختصاراً FPGA، وهي شريحة لا تنفذ برنامجاً أصلاً، وإنما تصف فيها دائرة رقمية Digital Circuit، فيصبح لكل عمل دائرته الخاصة التي تعمل في نفس الوقت مع غيرها، وتتغير مخارجها عند حافة الساعة Clock Edge بالضبط، فلا يؤخر عمل عملاً آخر. وفي هذا المقال سوف نبني هذه الأعمال الثلاثة فعلاً بلغة وصف العتاد Verilog للوحة iCEBreaker التي عليها شريحة Lattice iCE40UP5K وساعة 12 MHz، ونختبرها بالمحاكاة، ثم نحولها إلى دائرة حقيقية بالأدوات المفتوحة المصدر، ونقرأ ما تقوله الأدوات عن الموارد والتوقيت.
وسوف نناقش في هذا المقال ما يلي:
- متى لا يكفي المعالج المتسلسل Sequential Processor، ومتى تختار FPGA أو الشريحة المخصصة ASIC أو المعالج الرسومي GPU.
- ماذا يوجد داخل FPGA: جداول البحث LUT، والقلابات Flip-Flops، وسلاسل المنقول Carry Chains، والذاكرة Block RAM، وكتل الضرب DSP، وشبكات الساعة، وملف البرمجة Bitstream.
- لغة Verilog: الوحدات Modules، والأسلاك والمسجلات، والمنطق التركيبي Combinational Logic والتتابعي Sequential Logic، والإسناد المانع Blocking وغير المانع Nonblocking، وجهاز الحالات FSM.
- مراحل العمل Design Flow: المحاكاة Simulation، ثم التركيب Synthesis، ثم التوزيع والتوصيل Place and Route، ثم التوقيت Timing، ثم ملف البرمجة.
- التوقيت: زمن الإعداد Setup Time والاستبقاء Hold Time، والمسار الحرج Critical Path، وأعلى تردد Fmax، وعبور الإشارة بين الساعات Clock Domain Crossing.
- المختبر Lab: عداد Counter ومولد PWM ومرسل UART Transmitter بسرعة 115200، باختبارات ذاتية التحقق في Icarus Verilog وVerilator، وصورة موجات حقيقية من GTKWave، ثم Yosys وnextpnr، وثلاث تجارب «ماذا يحدث إذا…؟».
وقبل أن نبدأ، يفترض المقال أنك تعرف البوابات المنطقية والقلاب D والساعة، وقد شرحناها من الترانزستور إلى الجامع في مقال البوابات المنطقية Logic Gates، وتعرف الأرقام الثنائية والست عشرية من مقال الأنظمة العددية للمبرمجين، وتعرف كيف ينفذ المعالج التعليمات من مقال كيف يعمل المعالج CPU من الداخل. وهذا المقال من مرحلة البرمجيات المدمجة Firmware.
لماذا لا يكفي المعالج المتسلسل؟
المعالج، سواءً كان معالج جهازك أو متحكماً صغيراً، يعمل بنفس الفكرة: يجلب تعليمة، ويفكها، وينفذها، ثم ينتقل إلى التالية. وحتى المعالجات التي تنفذ عدة تعليمات في النبضة الواحدة، أو تحتوي عدة أنوية، تبقى في الأساس آلة واحدة تمر على قائمة من الأعمال، وكل عمل ينتظر دوره. وهذا التصميم مرن جداً، لأنك تغير البرنامج دون أن تغير الشريحة، ولكنه يعطيك ثلاث مشاكل عندما يكون العمل مرتبطاً بالزمن أو بالأسلاك:
- التوقيت غير المحدد Non-deterministic Timing: زمن تنفيذ نفس الكود يتغير بحسب المقاطعات Interrupts والذاكرة المؤقتة Cache والتفرعات، فإذا كان العمل يحتاج أن يحدث في نفس النانوثانية كل مرة، فالمعالج يعطيك متوسطاً جيداً وأسوأ حالة لا تعرفها بالضبط، وقد قسنا هذا الفرق بين Linux والمتحكم في مقال Raspberry Pi والمتحكم الدقيق.
- التوازي المحدود Limited Parallelism: المتحكم الذي يعمل بتردد 100 MHz ينفذ قرابة مئة مليون تعليمة في الثانية لكل الأعمال معاً، فإذا كان لديك ثمانية محركات وأربعة حساسات سريعة وواجهة شبكة، فكلها تتقاسم نفس المئة مليون.
- الواجهات الثابتة Fixed Interfaces: الشريحة فيها عدد محدد من وحدات UART وSPI وI2C والمؤقتات، فإذا احتجت بروتوكولاً غير موجود، أو عشرين منفذاً تسلسلياً بدل ثلاثة، فعليك أن تحاكيه بالبرنامج بتحريك الأرجل يدوياً Bit-banging، وهذا يعود بنا إلى المشكلتين السابقتين.
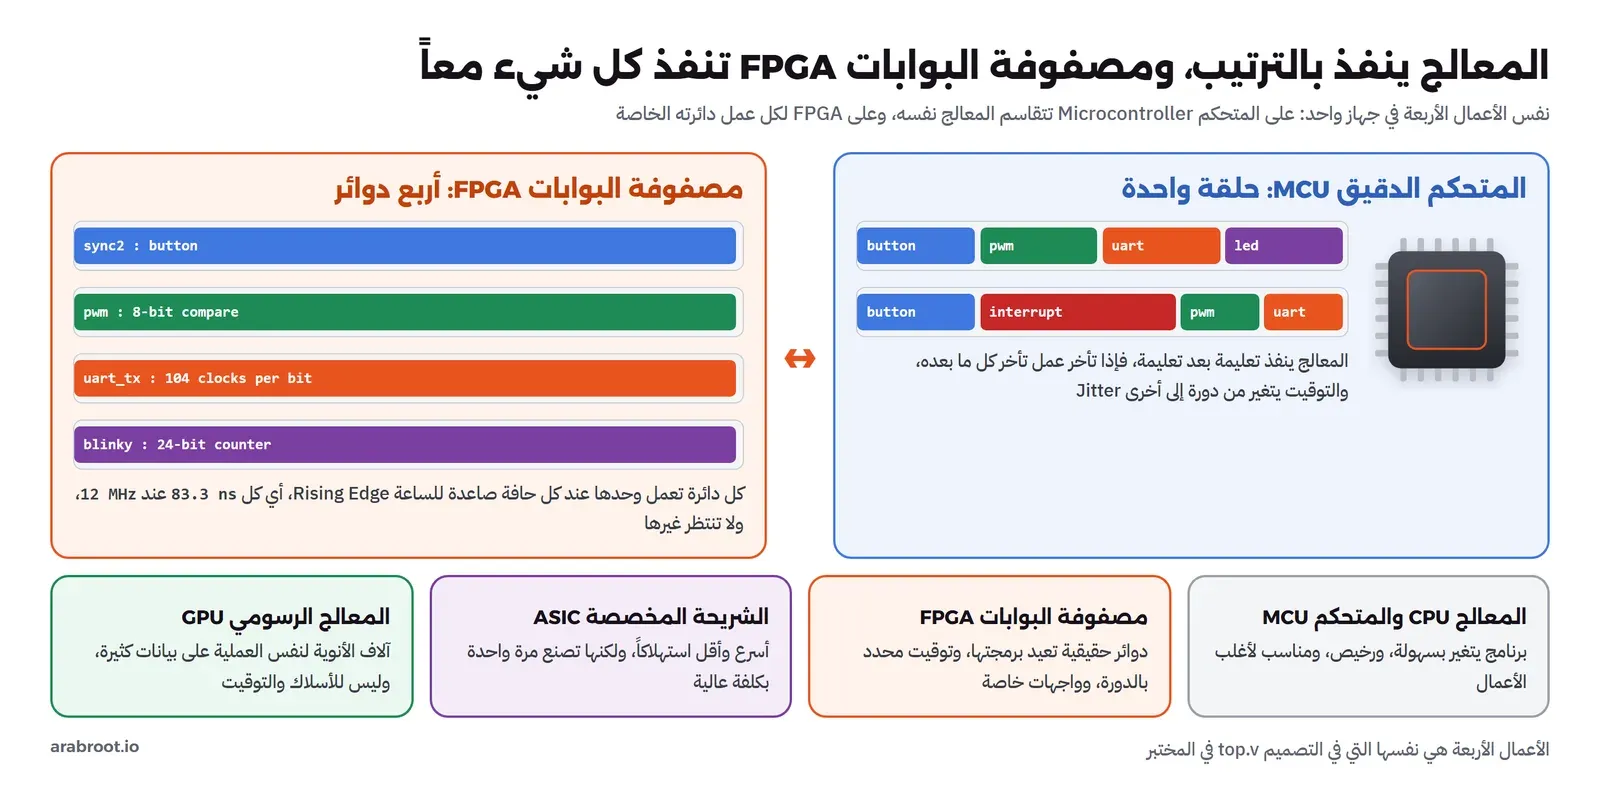
أما في FPGA فلا يوجد معالج يمر على الأعمال. فعندما تكتب عداداً، تبني الأدوات عداداً حقيقياً من قلابات وبوابات في مكان من الشريحة، وعندما تكتب مولد PWM تبني دائرة مقارنة في مكان آخر، وعندما تكتب مرسل UART تبني جهاز حالات في مكان ثالث، والثلاثة موصولة بنفس الساعة، فتتغير كلها في نفس اللحظة عند كل حافة صاعدة Rising Edge. وبالتالي زمن كل عمل محدد بعدد دورات الساعة، فإذا قلت إن البت في UART يأخذ 104 دورات فسوف يأخذ 104 دورات دائماً، مهما كانت الدوائر الأخرى مشغولة، والصورة التالية تبين الفرق:
وقد يتساءل البعض: إذا كانت FPGA بهذه القوة، فلماذا لا نستخدمها في كل شيء؟ والإجابة أن لها ثمناً في ثلاثة أشياء: سعر الشريحة أعلى من متحكم بنفس الحجم غالباً، واستهلاك الطاقة في الدوائر الكبيرة أعلى من شريحة مصممة لعمل واحد، والأهم أن كتابة الدوائر واختبارها أصعب وأبطأ بكثير من كتابة برنامج، فتغيير سطر في Verilog قد يحتاج دقائق أو ساعات من التركيب والتوصيل في التصاميم الكبيرة، وخطأ واحد في التوقيت قد لا يظهر إلا على شريحة حقيقية في حرارة معينة. ولذلك القاعدة العملية أن تكتب في المعالج كل ما يستطيع المعالج أن يفعله في الوقت المطلوب، وتنقل إلى FPGA فقط الجزء الذي يحتاج توقيتاً محدداً بالنانوثانية أو توازياً حقيقياً أو واجهة خاصة.
المعالج أم FPGA أم الشريحة المخصصة ASIC أم المعالج الرسومي GPU؟
عندما يصل الفريق إلى حدود المتحكم، أمامه أربعة أنواع من العتاد Hardware، ولكل نوع مكانه. والشريحة المخصصة للتطبيق Application-Specific Integrated Circuit، واختصاراً ASIC، هي دائرة رقمية تصمم لعمل واحد وتصنع في مصنع الرقائق كما شرحنا في مقال كيف تصنع الرقاقة، فلا يمكن تغييرها بعد التصنيع، والمعالج الرسومي Graphics Processing Unit، واختصاراً GPU، شرحناه في مقال GPU وNPU وTPU. والجدول التالي يلخص الفرق:
| العتاد | كيف يعمل | نقاط القوة | نقاط الضعف | أين تجده |
|---|---|---|---|---|
| المتحكم MCU والمعالج CPU | برنامج ينفذ بالتتابع | رخيص، وسهل البرمجة والتعديل، ومكتبات كثيرة | توقيت غير محدد، وتوازي محدود، وواجهات ثابتة | أغلب الأجهزة، ومنطق التحكم والشبكة والواجهات |
| مصفوفة البوابات FPGA | دائرة رقمية تعيد برمجتها | توازي حقيقي، وتوقيت محدد بالدورة، وأي واجهة تريدها | أغلى، وتصميمها واختبارها أصعب، واستهلاكها أعلى من ASIC | الراديو المعرف برمجياً، ومعالجة الفيديو، والتداول السريع، والتحكم بالمحركات، ونماذج ASIC قبل التصنيع |
| الشريحة المخصصة ASIC | دائرة ثابتة تصنع مرة واحدة | أعلى سرعة وأقل طاقة وأرخص قطعة في الكميات الكبيرة | كلفة تصميم وتصنيع أولية كبيرة جداً، ولا تتغير بعد التصنيع | المعالجات، وشرائح الشبكات والجوالات، وأجهزة الملايين |
| المعالج الرسومي GPU | آلاف الأنوية تنفذ نفس التعليمة على بيانات مختلفة | إنتاجية Throughput هائلة في الحساب المتوازي على المصفوفات | زمن استجابة Latency أعلى، ولا يتصل بالأسلاك والأرجل مباشرة | الذكاء الاصطناعي، والرسوميات، والحساب العلمي |
ولاحظ أن FPGA في الوسط بين المعالج والشريحة المخصصة: أبطأ وأغلى في القطعة من ASIC، ولكنها لا تحتاج مصنعاً ولا ملايين لكي تبدأ، وأسرع وأدق من المعالج في الأعمال المتوازية، ولكنها أصعب في الكتابة. ولذلك تجدها في أماكن محددة:
- الراديو المعرف برمجياً Software Defined Radio: عينات من محول تماثلي رقمي بعشرات الملايين في الثانية، تمر في مرشحات رقمية Digital Filters قبل أن يستطيع أي معالج التعامل معها.
- الفيديو والكاميرات: كل بكسل يمر في نفس السلسلة من العمليات، والبيانات تأتي من الحساس بسرعة ثابتة لا تنتظر أحداً.
- التداول عالي السرعة High-Frequency Trading: قراءة رسالة السوق من بطاقة الشبكة والرد عليها في دائرة واحدة، بدون المرور بنظام التشغيل.
- التحكم بالمحركات Motor Control: إشارات PWM لعدة محركات بتوقيت محدد، وحماية تقطع التيار خلال دورات قليلة.
- نماذج ASIC قبل التصنيع Prototyping: شركات الشرائح تشغل تصميمها على لوحات FPGA كبيرة لتختبره ببرامج حقيقية قبل أن تدفع كلفة التصنيع، وسوف نرى بعد قليل لماذا هذا مهم.
وفي مثال خط التعبئة، المتحكم يبقى مسؤولاً عن الشبكة والإعدادات والمنطق العام، وFPGA صغيرة بجانبه تولد نبضة الضوء وتراقب الزر بتوقيت ثابت، وهذا التقسيم بين معالج وFPGA شائع جداً، حتى أن بعض الشركات تبيع شرائح فيها الاثنان معاً.
ماذا يوجد داخل FPGA؟
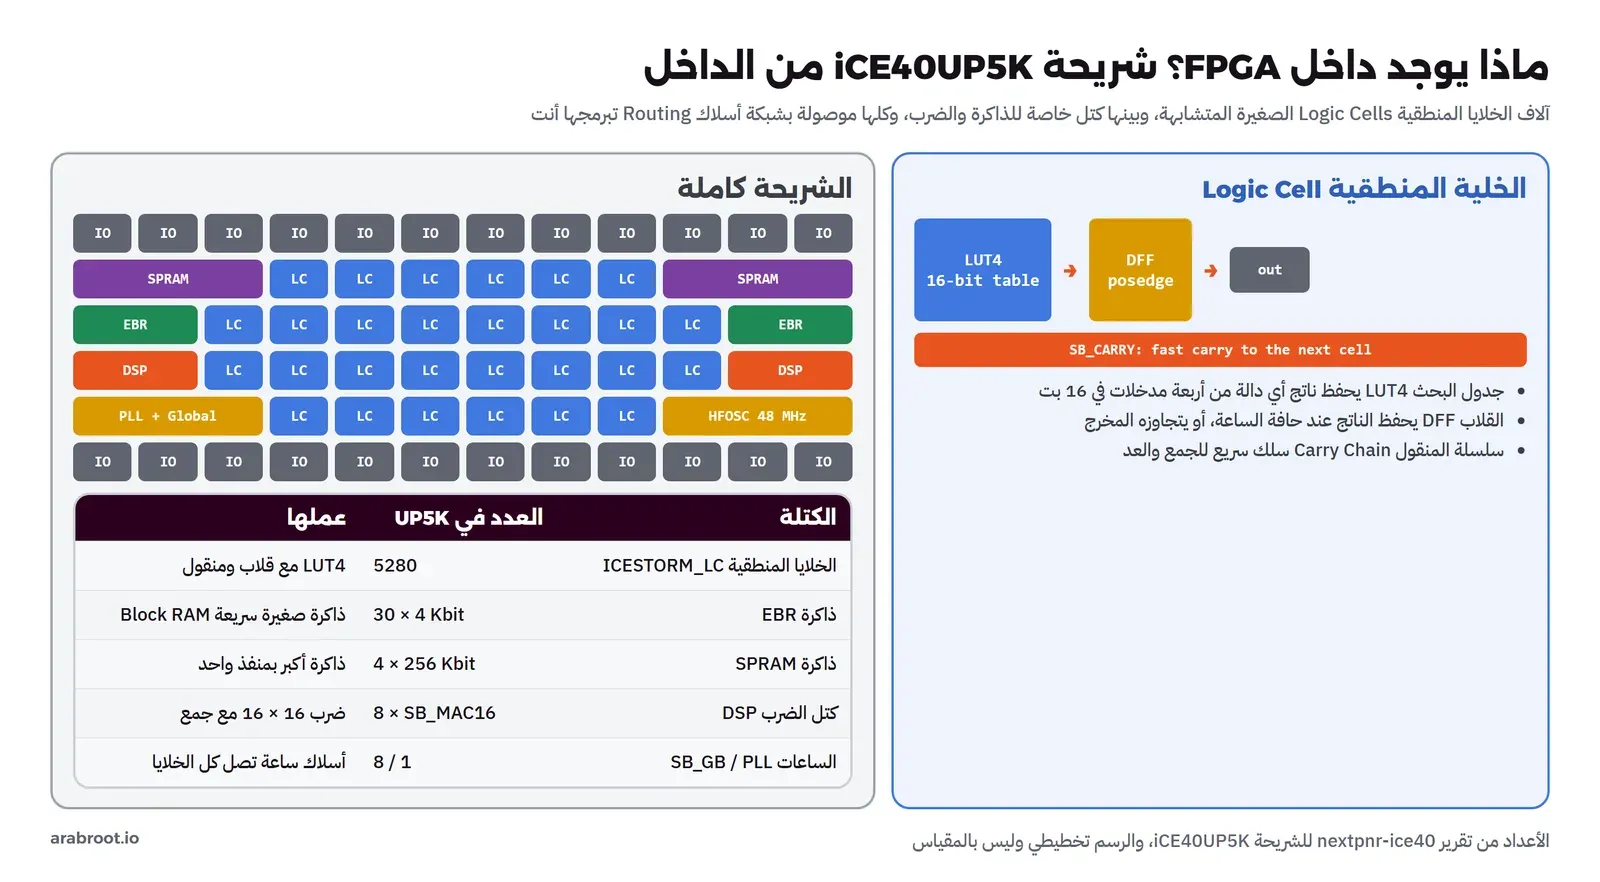
إذا فتحت شريحة FPGA فلن تجد بوابات AND وOR جاهزة بالشكل الذي تراه في الكتب، وإنما آلاف الخلايا المنطقية Logic Cells المتشابهة، كل واحدة منها صغيرة ويمكن أن تصبح أي دالة منطقية، وبينها شبكة ضخمة من الأسلاك والمفاتيح، وكتل خاصة للذاكرة والضرب والساعات والأرجل. وما تفعله الأدوات هو أن تقرر ماذا تكون كل خلية، وأي مفتاح يفتح وأي مفتاح يغلق. والصورة التالية تبين شريحة iCE40UP5K التي نستخدمها في المختبر:
ولنمر على كل جزء:
- جدول البحث Look-Up Table واختصاراً LUT: ذاكرة صغيرة جداً، في iCE40 فيها 16 بتاً، ومدخلاتها الأربعة هي عنوان البت الذي يخرج. فأي دالة منطقية من أربعة مدخلات، مهما كانت، لها جدول حقيقة Truth Table من 16 سطراً، فتكتب الأدوات هذا الجدول في الذاكرة الصغيرة، وتصبح الخلية تلك الدالة. والدالة التي لها أكثر من أربعة مدخلات تقسم على عدة جداول متتالية.
- القلاب Flip-Flop: بجانب كل جدول في iCE40 قلاب D يحفظ الناتج عند حافة الساعة، كالذي بنيناه من البوابات في مقال البوابات المنطقية، وله مداخل اختيارية للتمكين Enable والضبط والمسح Set وReset، ولذلك سترى في تقارير Yosys أسماء مثل
SB_DFFEوSB_DFFESR. - سلسلة المنقول Carry Chain: سلك سريع خاص يمر من خلية إلى التي فوقها، لكي يصل المنقول في الجمع والعد دون أن يمر في شبكة الأسلاك العامة البطيئة، وهو الحل العملي لمشكلة الجامع المتسلسل Ripple-Carry Adder التي رأيناها في مقال البوابات.
- ذاكرة الكتل Block RAM: كتل ذاكرة حقيقية داخل الشريحة، في iCE40 اسمها EBR، وفي UP5K ثلاثون كتلة كل منها 4 Kbit، وفيها أيضاً أربع كتل أكبر اسمها SPRAM كل منها 256 Kbit، ولو بنيت نفس الذاكرة من القلابات لأخذت الشريحة كلها.
- كتل الضرب DSP: دوائر ضرب وجمع جاهزة، في UP5K ثمان كتل SB_MAC16 تضرب 16 بتاً في 16 بتاً، لأن الضرب من الجداول الصغيرة يأخذ مئات الخلايا كما سنرى في المختبر.
- الأرجل IO: كل رجل لها خلية تتحكم بالاتجاه والجهد، وفي الشرائح الكبيرة دوائر خاصة للسرعات العالية مثل DDR والواجهات التسلسلية بسرعة الغيغابت.
- شبكات الساعة Clock Networks وPLL: الساعة يجب أن تصل إلى آلاف القلابات في نفس اللحظة تقريباً، ولذلك لها أسلاك خاصة اسمها Global Buffers، في UP5K ثمانية منها، ومعها حلقة PLL تولد من ساعة اللوحة ترددات أخرى.
- شبكة التوصيل Routing: الأسلاك والمفاتيح بين كل ما سبق، وهي الجزء الأكبر من مساحة الشريحة، والجزء الأكبر من التأخير في أغلب التصاميم كما ستلاحظ في تقرير التوقيت.
وهذه الفكرة نفسها موجودة عند كل الشركات مع اختلاف الأحجام والأسماء، فشرائح AMD من سلسلة 7 Series مثلاً تستخدم جداول بستة مدخلات، ويجمع كل جزء منها اسمه Slice أربعة جداول وثمانية قلابات كما في دليل CLB من AMD، وشرائح Altera التي كانت جزءاً من Intel تستخدم وحدة اسمها Adaptive Logic Module فيها جدول قابل للتقسيم بثمانية مدخلات وأربعة قلابات كما في نظرة Cyclone V العامة. ولذلك لا تقارن الشرائح بعدد «البوابات» في الإعلانات، وإنما بعدد الجداول والقلابات وكتل الذاكرة والضرب، وبالسرعة التي تصل إليها في تصميمك أنت.
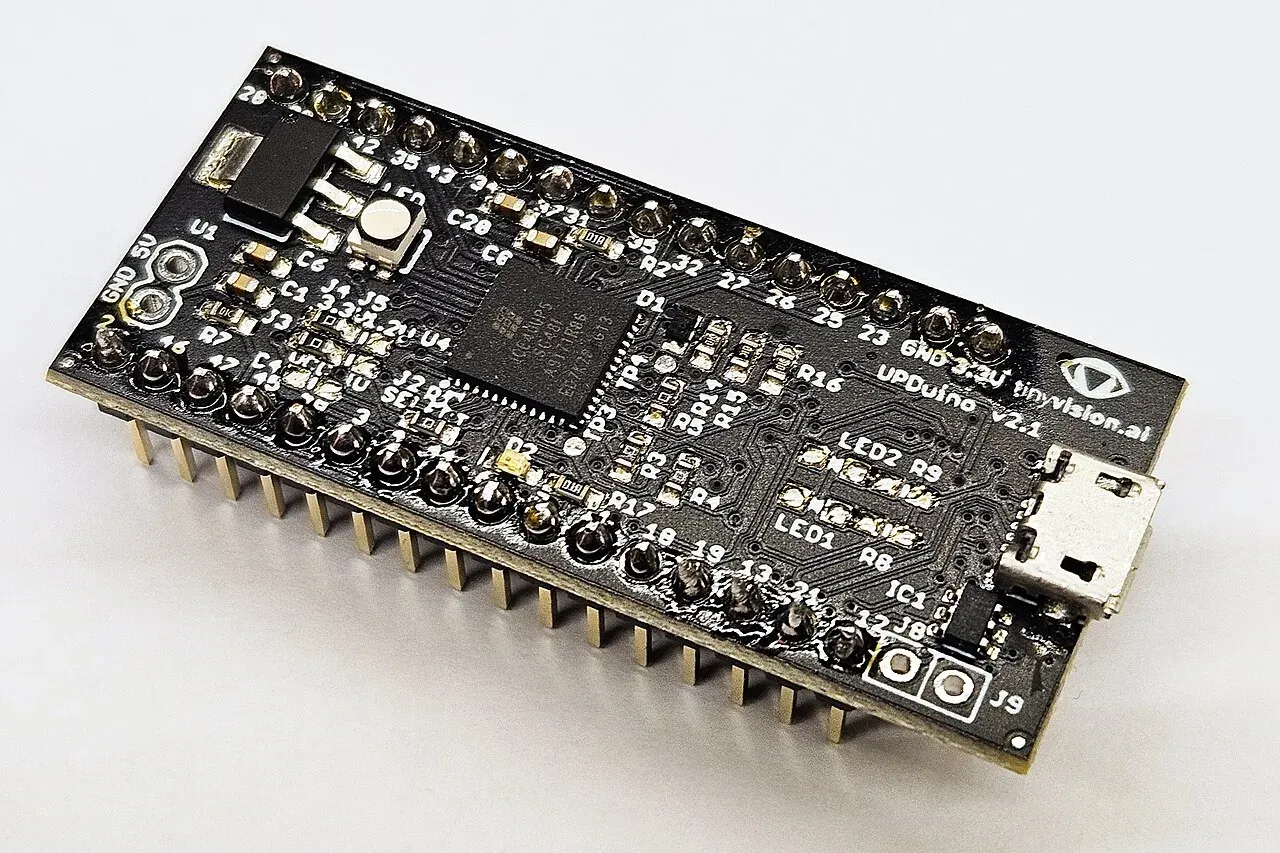
والصورة التالية للوحة UPduino، وهي لوحة صغيرة عليها نفس الشريحة iCE40UP5K التي نستخدمها في المختبر، لكي ترى أن FPGA في هذا الحجم قطعة صغيرة بحجم متحكم:
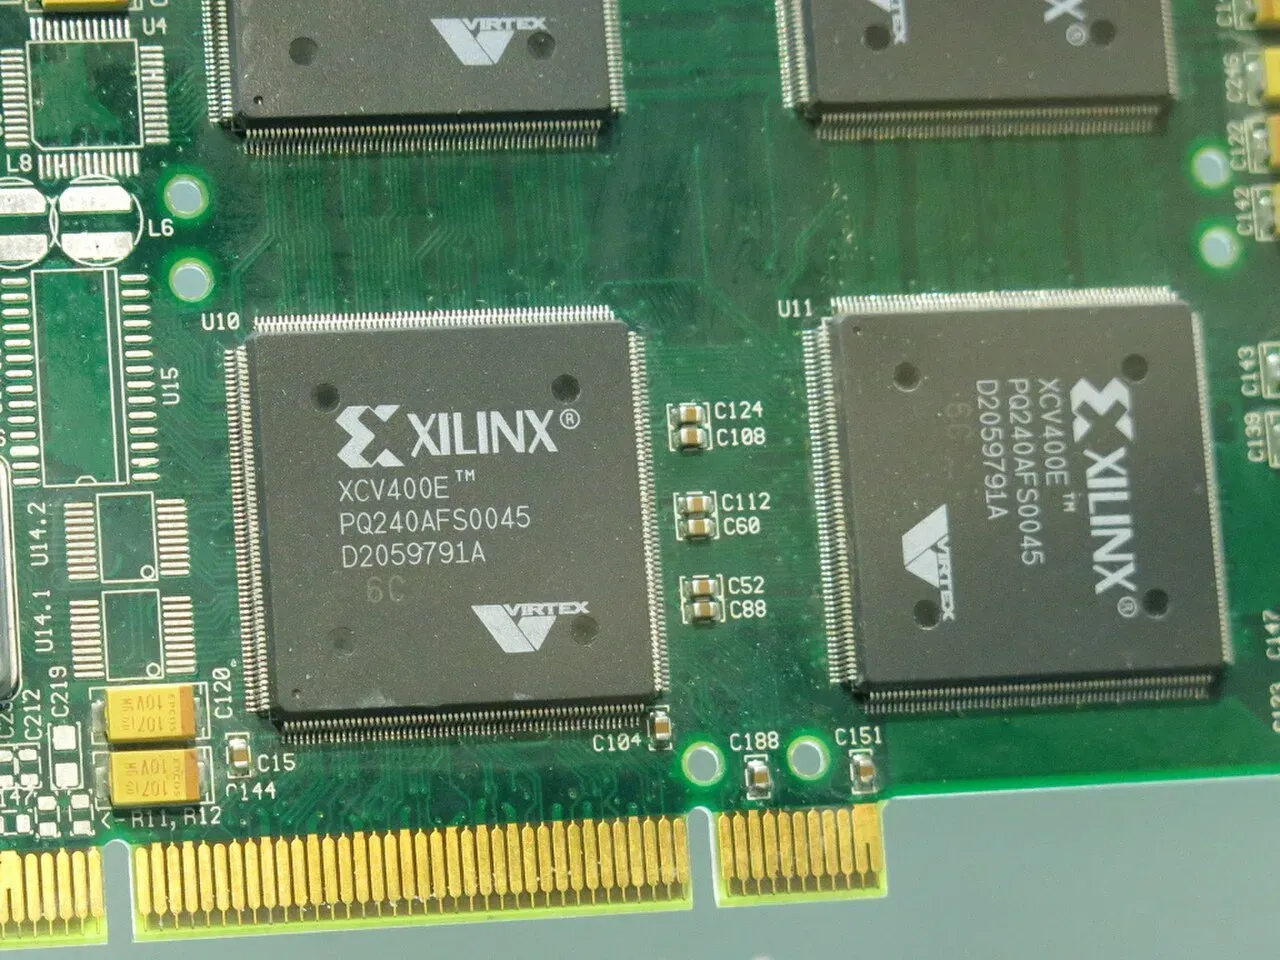
وفي الطرف الآخر من السوق شرائح كبيرة بمئات الأرجل، وتجد أحياناً عدة شرائح منها على لوحة واحدة، كما في هذه اللوحة التي عليها أربع شرائح Xilinx من عائلة Virtex-E، وكل شريحة منها بـ 240 رجلاً:
ملف البرمجة Bitstream: ذاكرة SRAM أم Flash؟
كل ما سبق، أي محتوى كل جدول، وحالة كل مفتاح في شبكة الأسلاك، وإعداد كل رجل، يحفظ في خلايا إعداد Configuration Cells داخل الشريحة، والملف الذي يحمل كل هذه البتات اسمه ملف البرمجة Bitstream. وفي أغلب شرائح FPGA، ومنها iCE40 وأغلب شرائح AMD وAltera، خلايا الإعداد من نوع SRAM، أي أنها تفقد محتواها عندما ينقطع التيار، ولذلك تكون على اللوحة ذاكرة فلاش Flash صغيرة من نوع SPI تقرأ منها الشريحة ملف البرمجة عند كل تشغيل، وهذا يأخذ ملي ثوان قليلة قبل أن تبدأ الدائرة بالعمل. وفي المختبر سوف ترى أن ملف شريحتنا 104090 بايت بالضبط، مهما كان حجم تصميمك، لأنه يحمل حالة كل خلية في الشريحة وليس فقط الخلايا التي استخدمتها.
وهناك عائلات تحفظ الإعداد في خلايا Flash داخل الشريحة نفسها، مثل شرائح PolarFire وIGLOO من Microchip، وشرائح MAX 10 من Altera، فتعمل فور التشغيل بدون فلاش خارجية، ولا يمكن قراءة التصميم من الأسلاك بين الفلاش والشريحة، وهذا مهم في الأجهزة التي تهتم بحماية التصميم أو تعمل في بيئات فيها إشعاع. وشرائح iCE40 نفسها فيها ذاكرة داخلية اسمها NVCM تكتب مرة واحدة فقط، تستخدمها الشركات في الكميات الكبيرة بعد أن يستقر التصميم.
لغة Verilog: أنت تصف دائرة ولا تكتب برنامجاً
لغة Verilog هي لغة وصف العتاد Hardware Description Language، واختصاراً HDL، ظهرت في الثمانينات، وصارت معياراً برقم IEEE 1364، ثم دمجت في معيار أكبر اسمه SystemVerilog برقم IEEE 1800 يضيف أدوات للتحقق والاختبار. والمنافس التاريخي لها لغة VHDL، وهي أكثر انتشاراً في أوروبا وفي المشاريع العسكرية والفضائية، والأفكار في اللغتين واحدة. وأول ما يجب أن تفهمه أن Verilog تشبه C في شكلها فقط: فيها if وcase والفواصل المنقوطة، ولكن كل سطر فيها يصف قطعة من العتاد تعمل طوال الوقت، وليس خطوة تنفذ ثم تنتهي. فإذا كتبت سطرين متتاليين فهما دائرتان تعملان معاً، وليس أمراً ثم أمراً.
الوحدة Module والأسلاك Wires والمسجلات Registers
كل تصميم في Verilog مكون من وحدات Modules، والوحدة تشبه شريحة صغيرة لها أرجل داخلة input وخارجة output، وتستطيع أن تضع داخلها وحدات أخرى كما تضع شرائح على لوحة. وأبسط مثال هو العداد الذي يجعل المصباح يومض، وهو أول تصميم في المختبر:
// A free-running counter: the "hello world" of FPGAs.
// At 12 MHz, bit 23 of the counter toggles every 2^23 cycles, so the LED blinks about 0.7 times per second.
`timescale 1ns/1ps
module blinky #(
    parameter WIDTH = 24
) (
    input  wire clk,
    output wire led
);
    reg [WIDTH-1:0] count = 0;

    always @(posedge clk)
        count <= count + 1'b1;

    assign led = count[WIDTH-1];
endmodule
في الكود أعلاه لاحظ التالي:
parameter WIDTH = 24معامل Parameter يحدد عرض العداد عند استخدام الوحدة، فنستخدم 24 بتاً على الشريحة و4 بتات في الاختبار لكي لا ننتظر ملايين الدورات، وهذا يشبه ثابتاً يمرر عند إنشاء الكلاس.reg [WIDTH-1:0] countمتغير من نوعreg، والاسم مضلل قليلاً، فهو لا يعني دائماً مسجلاً في العتاد، وإنما يعني أن قيمته تكتب داخل كتلةalways. وهنا يصبح فعلاً 24 قلاباً لأننا نكتبه عند حافة الساعة.always @(posedge clk)تعني «عند كل حافة صاعدة للساعة»، وكل ما بداخلها يصبح قلابات تحفظ القيمة الجديدة في تلك اللحظة، وهذا هو المنطق التتابعي Sequential Logic.assign led = count[WIDTH-1]سلك Wire يوصل البت الأعلى بالمخرج طوال الوقت، وassignتصف دائماً منطقاً تركيبياً Combinational Logic، أي مخرجاً يتبع مدخلاته فوراً دون ساعة.
وبحساب بسيط: الساعة 12 MHz، والبت 23 يتغير كل 223 دورة، أي كل 0.7 ثانية تقريباً، فيومض المصباح ببطء تراه العين. وهذا هو «Hello World» في عالم FPGA، لأن البرنامج الذي يطبع على الشاشة لا معنى له في شريحة لا شاشة لها ولا معالج.
المنطق التركيبي Combinational والتتابعي Sequential
كل دائرة رقمية في النهاية خليط من نوعين، كما شرحنا في مقال البوابات: منطق تركيبي مخرجه يعتمد على مدخلاته الحالية فقط، مثل الجامع والمقارن والمحدد Multiplexer، ومنطق تتابعي يتذكر قيمة بين الدورات، أي القلابات. وفي Verilog تكتب الأول بـ assign أو بكتلة always @(*)، والنجمة تعني «كلما تغير أي مدخل»، وتكتب الثاني بكتلة always @(posedge clk). ومولد PWM في المختبر يجمع النوعين في سطرين:
// 8-bit PWM generator: the output is high for `duty` cycles out of every 256.
// At 12 MHz the PWM period is 256 / 12 MHz = 21.3 us, i.e. about 46.9 kHz.
`timescale 1ns/1ps
module pwm (
    input  wire       clk,
    input  wire [7:0] duty,
    output reg        out = 1'b0
);
    reg [7:0] count = 8'd0;

    always @(posedge clk) begin
        count <= count + 8'd1;
        out   <= (count < duty);   // registered output: no glitches on the pin
    end
endmodule
في الكود أعلاه لاحظ التالي:
- العداد
countبثمانية بتات يدور من 0 إلى 255 ثم يرجع إلى الصفر وحده، لأن الجمع في عرض ثابت يلتف عند الفيضان Overflow، فالدورة الكاملة 256 نبضة، أي قرابة 21.3 ميكروثانية عند 12 MHz، وتردد PWM قرابة 46.9 kHz. - المقارنة
count < dutyمنطق تركيبي، أي دائرة مقارن من الجداول، وناتجها يدخل قلاباً هوout، فيتغير المخرج عند الحافة فقط، وهذا ما يجعل النبضة نظيفة على الرجل بدون نبضات صغيرة كاذبة Glitches أثناء تغير بتات العداد. - نسبة التشغيل Duty Cycle هي
duty/256، فالقيمة 128 تعطي 50%، والقيمة 255 تعطي 99.61% وليس 100%، وهذا تفصيل سيظهر في الاختبار.
وفي المتحكم كان PWM وحدة عتاد جاهزة تضبطها بالمسجلات كما في مقال GPIO وPWM وADC، أما هنا فأنت تبني الوحدة نفسها، فإذا احتجت أربعين قناة PWM بدل أربع، فهي أربعون نسخة من نفس الوحدة، وكل نسخة عداد صغير ومقارن يأخذان جزءاً صغيراً من آلاف الخلايا في الشريحة.
الإسناد المانع Blocking والإسناد غير المانع Nonblocking
في Verilog علامتان للإسناد، وهذا أكثر ما يربك من يأتي من البرمجة. العلامة = اسمها الإسناد المانع Blocking Assignment، وتعمل كما تتوقع في أي لغة: يحسب الطرف الأيمن ويكتب فوراً، والسطر التالي يرى القيمة الجديدة. والعلامة <= اسمها الإسناد غير المانع Nonblocking Assignment، وتعني: احسب الطرف الأيمن الآن من القيم القديمة، واكتب الناتج في نهاية الخطوة الزمنية، بعد أن تحسب كل الكتل الأخرى. والثانية هي بالضبط ما يفعله القلاب الحقيقي: كل القلابات في الشريحة تقرأ مدخلاتها في نفس اللحظة عند الحافة، ثم تتغير معاً.
والقاعدة التي يتبعها كل المصممين بسيطة: داخل always @(posedge clk) استخدم <= دائماً، وداخل always @(*) للمنطق التركيبي استخدم =، ولا تخلط النوعين في كتلة واحدة. والسبب أن الإسناد المانع في كتلة الساعة يغير معنى الدائرة كلها، وقد يجعل المحاكاة تختلف عن الدائرة التي يبنيها التركيب، وسوف نرى ذلك برقم حقيقي في تجربة «ماذا يحدث إذا…؟» في المختبر.
جهاز الحالات Finite State Machine: مرسل UART
أغلب الدوائر التي تفعل شيئاً على مراحل تكتب كجهاز حالات Finite State Machine، واختصاراً FSM: مسجل يحفظ الحالة الحالية، ومنطق يقرر الحالة التالية والمخارج بحسب الحالة والمدخلات. ومرسل UART مثال كامل على ذلك، والإطار نفسه شرحناه في مقال بروتوكولات الاتصال التسلسلي: بت بداية صفر، ثم ثمانية بتات من الأصغر إلى الأكبر، ثم بت نهاية واحد، والطرفان يتفقان على السرعة مسبقاً. وهذا المرسل بأربع حالات:
// UART transmitter, 8N1: one start bit (0), eight data bits LSB first, one stop bit (1).
// CLKS_PER_BIT = clock / baud, rounded: 12_000_000 / 115_200 = 104.17, so 104.
`timescale 1ns/1ps
module uart_tx #(
    parameter CLKS_PER_BIT = 104
) (
    input  wire       clk,
    input  wire       start,      // one-cycle pulse: send `data`
    input  wire [7:0] data,
    output reg        tx = 1'b1,  // the line idles high
    output wire       busy
);
    localparam IDLE = 2'd0, START = 2'd1, DATA = 2'd2, STOP = 2'd3;

    reg [1:0]  state   = IDLE;
    reg [15:0] clk_cnt = 16'd0;
    reg [2:0]  bit_idx = 3'd0;
    reg [7:0]  shift   = 8'd0;

    assign busy = (state != IDLE);

    always @(posedge clk) begin
        case (state)
            IDLE: begin
                tx <= 1'b1;
                if (start) begin
                    shift   <= data;
                    clk_cnt <= 16'd0;
                    state   <= START;
                end
            end
            START: begin
                tx <= 1'b0;
                if (clk_cnt == CLKS_PER_BIT - 1) begin
                    clk_cnt <= 16'd0;
                    bit_idx <= 3'd0;
                    state   <= DATA;
                end else
                    clk_cnt <= clk_cnt + 16'd1;
            end
            DATA: begin
                tx <= shift[bit_idx];
                if (clk_cnt == CLKS_PER_BIT - 1) begin
                    clk_cnt <= 16'd0;
                    if (bit_idx == 3'd7)
                        state <= STOP;
                    else
                        bit_idx <= bit_idx + 3'd1;
                end else
                    clk_cnt <= clk_cnt + 16'd1;
            end
            STOP: begin
                tx <= 1'b1;
                if (clk_cnt == CLKS_PER_BIT - 1) begin
                    clk_cnt <= 16'd0;
                    state   <= IDLE;
                end else
                    clk_cnt <= clk_cnt + 16'd1;
            end
        endcase
    end
endmodule
في الكود أعلاه لاحظ التالي:
- الحالات الأربع
IDLEوSTARTوDATAوSTOPثوابت محليةlocalparamبعرض بتين، والمسجلstateيحفظ الحالة الحالية. - العداد
clk_cntيعد دورات الساعة داخل كل بت حتىCLKS_PER_BIT - 1، أي 104 دورات لكل بت، ثم ينتقل إلى البت التالي، وهذا هو مقسم السرعة Baud Rate Divider بأكمله. - البايت ينسخ إلى
shiftعند البداية، لكي لا يتأثر الإرسال إذا تغير المدخلdataفي منتصف الإطار، والبت يختار بالفهرسshift[bit_idx]. - المخرج
busyسلك تركيبي يكون 1 في كل الحالات غيرIDLE، والمرسل يتجاهلstartطوال هذا الوقت، وهذه النقطة بالذات سببت المشكلة الحقيقية في المختبر. - العداد بعرض 16 بتاً وهو يحتاج 7 بتات فقط للقيمة 103، وتركناه كذلك لكي يعمل المرسل مع ساعات أسرع وسرعات أبطأ، والثمن بضع خلايا.
من الكود إلى الشريحة: مراحل العمل Design Flow
في البرمجة تكتب الكود ثم تترجمه وتشغله. أما في FPGA فبين الكود والشريحة خمس مراحل، ولكل مرحلة أداة وتقرير، والأدوات التي نستخدمها كلها مفتوحة المصدر، وتعمل مع شرائح iCE40 لأن مشروع Project IceStorm فك صيغة ملف البرمجة لهذه العائلة ووثقها، فصار ممكناً بناء سلسلة أدوات كاملة بدون برامج الشركة. والصورة التالية تبين المراحل بالأرقام التي خرجت في المختبر:
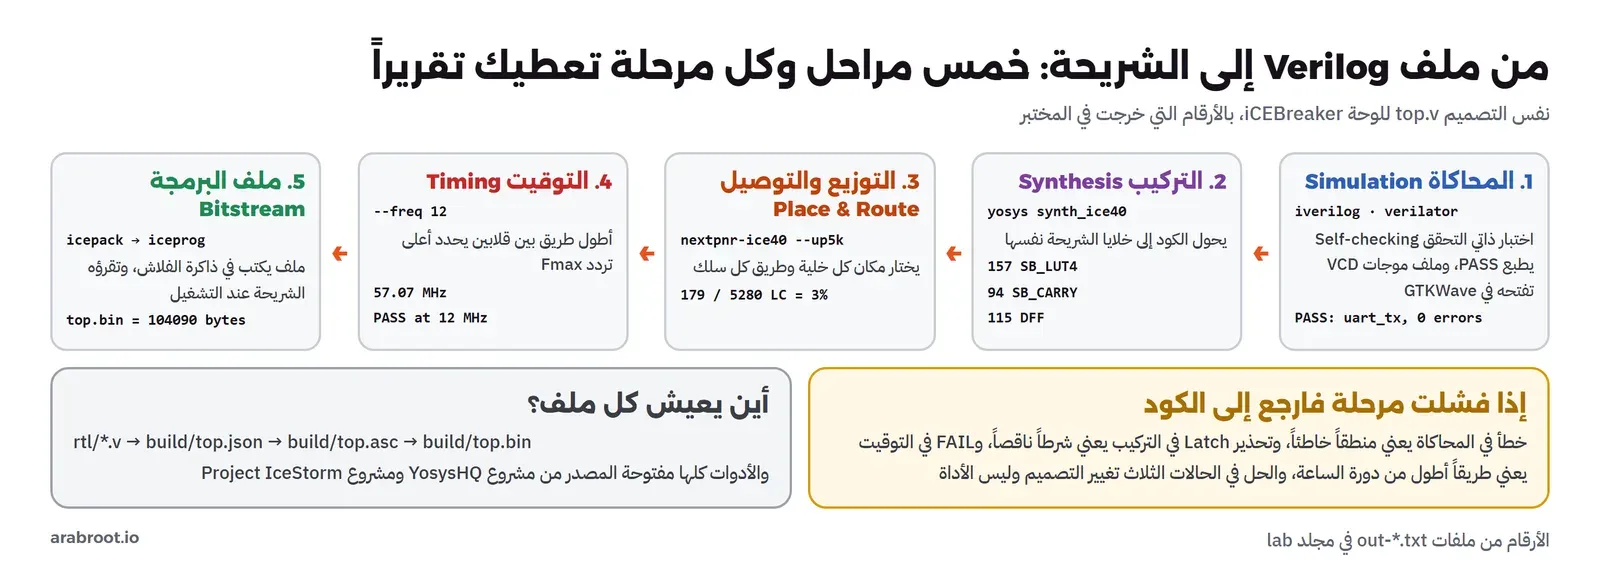
- المحاكاة Simulation: برنامج على جهازك ينفذ وصف الدائرة نبضة نبضة، ومعه ملف اختبار Testbench يولد المدخلات ويتحقق من المخارج، وأشهر الأدوات المفتوحة Icarus Verilog الذي يترجم التصميم إلى ملف وسيط ينفذه البرنامج
vvp، وهو سهل وسريع البدء، وVerilator الذي يحول التصميم إلى C++ ويترجمه، فيكون أسرع بكثير في التصاميم الكبيرة. والمحاكي يكتب ملف موجات بصيغة VCD تفتحه في GTKWave. - التركيب Synthesis: أداة Yosys تقرأ Verilog وتحوله إلى شبكة من الخلايا الموجودة فعلاً في الشريحة، أي جداول LUT4 وقلابات وخلايا منقول وكتل ذاكرة وضرب، والأمر الخاص بعائلة iCE40 هو
synth_ice40، وهو مشروح في أوامر iCE40 في توثيق Yosys. - التوزيع والتوصيل Place and Route: أداة nextpnr تختار لكل خلية مكاناً في الشريحة، ثم تختار لكل سلك طريقاً في شبكة التوصيل، وتحاول أن تقصر الطرق المهمة.
- تحليل التوقيت Timing Analysis: بعد التوصيل تعرف الأداة زمن كل طريق، فتحسب أطول طريق بين قلابين، وتقارنه بدورة الساعة التي طلبتها، وتقول PASS أو FAIL.
- ملف البرمجة Bitstream: أداة
icepackمن IceStorm تحول نتيجة التوصيل إلى الملف الثنائي، وiceprogتكتبه في فلاش اللوحة عبر USB.
وعند الشركات الكبيرة تجد نفس المراحل في أداة واحدة، فبرنامج Vivado من AMD وبرنامج Quartus من Altera يقومان بكل ما سبق، وهما مجانيان للشرائح الصغيرة والمتوسطة، ولكنهما ضخمان ويحتاجان عشرات الغيغابايت. ولذلك اخترنا iCE40 للتعلم: الأدوات كلها في Docker Image واحدة، والتصميم الكامل يمر بالمراحل الخمس في ثوان.
التوقيت Timing: لماذا للدائرة أعلى تردد؟
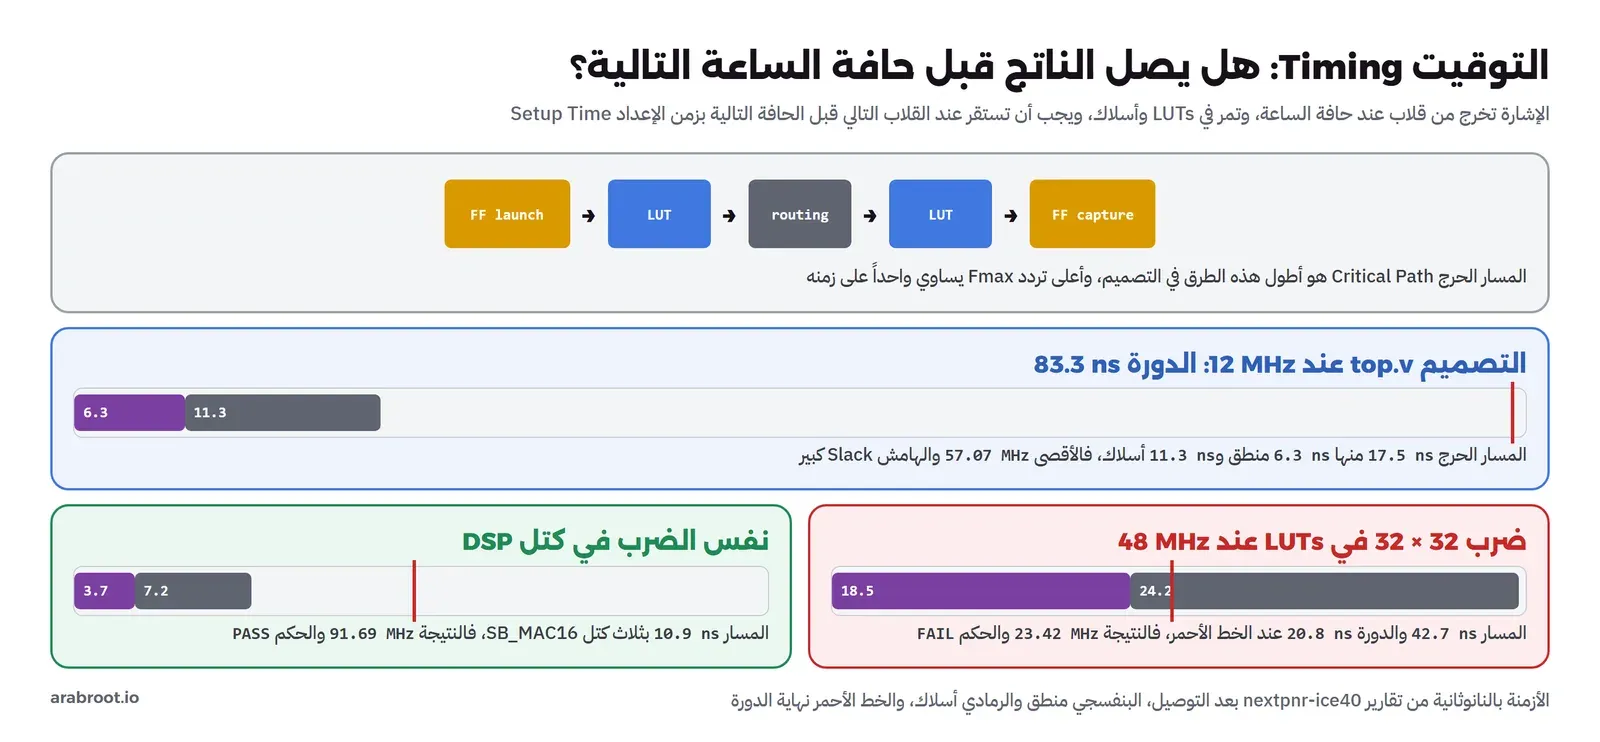
في مقال البوابات رأينا أن لكل بوابة زمن انتشار Propagation Delay، وأن أطول طريق في الدائرة يحدد سرعتها. وفي FPGA هذا هو السؤال الذي يحكم كل تصميم: الإشارة تخرج من قلاب عند حافة الساعة، وتمر في عدة جداول وأسلاك، ويجب أن تصل إلى القلاب التالي وتستقر قبل الحافة التالية بزمن صغير اسمه زمن الإعداد Setup Time، وأن تبقى ثابتة بعد الحافة زمناً صغيراً آخر اسمه زمن الاستبقاء Hold Time. فإذا وصلت متأخرة، قرأ القلاب قيمة قديمة أو خليطاً بين القديمة والجديدة، وهذا خطأ لا تراه في المحاكاة العادية، لأن المحاكي لا يعرف أزمنة الأسلاك.
وأطول طريق بين قلابين في التصميم اسمه المسار الحرج Critical Path، وأعلى تردد Fmax يساوي واحداً على زمنه. وفي الساعة 12 MHz الدورة 83.3 نانوثانية، فأي تصميم مساره الحرج أقصر من ذلك ينجح، والفرق بين الدورة والمسار اسمه الهامش Slack. وإذا طلبت 48 MHz صارت الدورة 20.8 نانوثانية فقط، وهنا تبدأ المشاكل كما سنرى في المختبر:
وعندما يفشل التوقيت، فالحل ليس في الأداة وإنما في التصميم، ولديك أربع طرق رئيسية:
- تقسيم الطريق Pipelining: تضع قلابات في منتصف الحساب الطويل، فيصبح طريقين قصيرين، والثمن أن الناتج يصل بعد دورة إضافية، وهذا ما تفعله المعالجات في خط التنفيذ Pipeline.
- الكتل المخصصة: الضرب في كتل DSP والذاكرة في Block RAM أسرع بكثير من بنائهما من الجداول.
- تقليل العرض: عداد من 32 بتاً حيث يكفي 8 يطيل سلسلة المنقول بلا فائدة، ومقارنة عداد عريض بالصفر تحتاج عدة طبقات من الجداول.
- ساعة أبطأ: إذا كان العمل لا يحتاج السرعة، فلماذا تطلبها؟ وفي مثالنا 12 MHz تكفي لكل الأعمال الثلاثة بهامش كبير.
عبور الإشارة بين الساعات Clock Domain Crossing وعدم الاستقرار Metastability
كل ما سبق يفترض أن الإشارات كلها تتبع نفس الساعة، ولكن الزر لا يعرف شيئاً عن ساعة الشريحة، وكذلك بيانات تأتي من شريحة أخرى بساعتها الخاصة. فإذا تغير مدخل في نفس لحظة حافة الساعة تقريباً، داخل نافذة الإعداد والاستبقاء، فقد يعلق القلاب لفترة بين الصفر والواحد قبل أن يستقر على أحدهما، وهذه الحالة اسمها عدم الاستقرار Metastability، وقد رأينا شكلها في القفل SR في مقال البوابات. والخطر ليس في القلاب الأول نفسه، وإنما في أن قيمته غير المستقرة قد تصل إلى عدة دوائر فتقرأ كل منها قيمة مختلفة، فيدخل جهاز الحالات حالة غير موجودة في التصميم، والخطأ يحدث مرة في الساعة أو في الأسبوع، ولا تستطيع أن تكرره على المكتب.
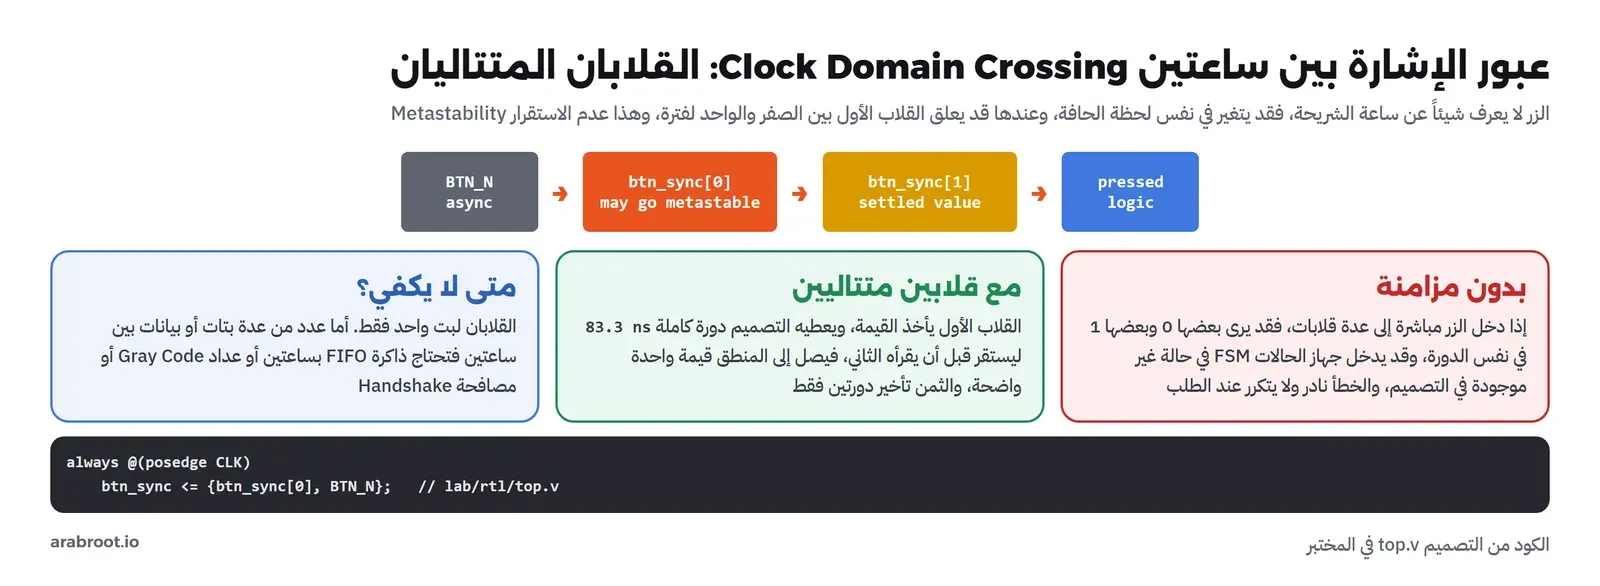
والحل المعروف لإشارة من بت واحد هو المزامن بقلابين Two-Flop Synchronizer: تدخل الإشارة قلاباً أول لا يقرؤه أحد غير قلاب ثان، فيأخذ القلاب الأول دورة كاملة لكي يستقر، واحتمال أن يبقى غير مستقر بعد دورة كاملة صغير جداً، فيصل إلى المنطق قيمة واحدة واضحة. والثمن تأخير دورتين، أي 167 نانوثانية عند 12 MHz، وهذا لا يعني شيئاً لزر يضغطه إنسان. أما الأرقام من عدة بتات، مثل عداد يأتي من ساعة أخرى، فلا يصلح لها المزامن بقلابين، لأن كل بت قد يستقر في دورة مختلفة فتقرأ رقماً لم يكن موجوداً أبداً، ولها حلول أخرى مثل ذاكرة FIFO بساعتين أو عداد Gray Code الذي يتغير فيه بت واحد فقط في كل خطوة.
المختبر Lab: عداد ومولد PWM ومرسل UART على iCE40
الآن نبني الوحدة كلها للوحة iCEBreaker، وهي لوحة مفتوحة التصميم من مشروع iCEBreaker عليها شريحة iCE40UP5K من عائلة iCE40 UltraPlus، ومذبذب Oscillator بتردد 12 MHz، ومصباحان وزر، وشريحة FTDI تعطي المنفذ التسلسلي عبر USB. والتصميم الكامل top.v يجمع الأعمال الثلاثة من مثال خط التعبئة: المصباح الأخضر يومض من العداد، والمصباح الأحمر «يتنفس» بنبضات PWM تزيد وتنقص، والمرسل يرسل Hello FPGA قرابة ثلاث مرات في الثانية بسرعة 115200، والزر يمر في المزامن بقلابين ويجعل الإضاءة كاملة عند الضغط. وأرقام الأرجل في الملف icebreaker.pcf مأخوذة من أمثلة iCEBreaker الرسمية.
وكل الأدوات في Docker Image واحدة مبنية على Debian 13، بهذا الملف:
# FPGA lab image: simulation (Icarus Verilog, Verilator), synthesis (Yosys), place and route (nextpnr-ice40),
# bitstream (IceStorm) and a real GTKWave window under Xvfb for the screenshot.
FROM debian:trixie-20261005-slim
RUN apt-get update \
 && apt-get install -y --no-install-recommends \
      iverilog verilator g++ make \
      yosys nextpnr-ice40 fpga-icestorm \
      gtkwave xvfb x11-apps netpbm fonts-dejavu-core \
 && rm -rf /var/lib/apt/lists/*
WORKDIR /work
والبناء والتشغيل بثلاثة أوامر، الأول يبني الـ Image، والثاني يشغل المحاكاة والتركيب والتوصيل، والثالث يشغل التجارب وصورة GTKWave:
cd content/articles/fpga-verilog-basics/lab
docker build -t elm-fpga-lab:1 .
docker run --rm -v "$PWD:/work" elm-fpga-lab:1 bash /work/run.sh
docker run --rm -v "$PWD:/work" elm-fpga-lab:1 bash /work/run-whatif.sh
والملف run.sh يحتوي كل الأوامر بالترتيب، وكل مرحلة تكتب مخرجها في ملف out-*.txt:
#!/bin/bash
# Whole lab: simulate, synthesise, place and route, bitstream, then the "what if" variations.
#   docker run --rm -v "$PWD:/work" elm-fpga-lab:1 bash /work/run.sh
set -u
cd /work
mkdir -p build out
B=build

# ---- 1. simulation with Icarus Verilog ----------------------------------------------------------
{
  for t in blinky pwm uart; do
    echo "### iverilog: tb_$t"
    iverilog -g2012 -Wall -o $B/tb_$t tb/tb_$t.v rtl/blinky.v rtl/pwm.v rtl/uart_tx.v && (cd $B && vvp -n tb_$t)
  done
} > out/out-sim-iverilog.txt 2>&1

# ---- 2. the same UART testbench with Verilator ----------------------------------------------------
{
  echo "### verilator --binary --timing tb_uart"
  verilator --binary --timing -Wno-fatal -Wall --top-module tb_uart -Mdir $B/vl \
      tb/tb_uart.v rtl/uart_tx.v 2>&1 | grep -E "^%|Walltime"
  (cd $B && ./vl/Vtb_uart)
} > out/out-sim-verilator.txt 2>&1

# ---- 3. synthesis with Yosys for the iCE40 -------------------------------------------------------
yosys -q -l out/yosys-top.log -p "read_verilog rtl/blinky.v rtl/pwm.v rtl/uart_tx.v rtl/top.v; synth_ice40 -top top -json $B/top.json; tee -o out/out-yosys-stat.txt stat" > /dev/null

# ---- 4. place and route, timing, bitstream ------------------------------------------------------
nextpnr-ice40 --up5k --package sg48 --pcf icebreaker.pcf --json $B/top.json --asc $B/top.asc \
    --freq 12 --report out/nextpnr-report.json > out/out-nextpnr.txt 2>&1
icepack $B/top.asc $B/top.bin
ls -l $B/top.bin | awk '{print $5, $9}' > out/out-bitstream.txt
الاختبار الذاتي التحقق Self-checking Testbench
أسوأ طريقة لاختبار دائرة هي أن تفتح الموجات وتنظر إليها بعينك بعد كل تعديل، لأنك سوف تمل بعد المرة الثالثة وتتوقف عن النظر بدقة. والطريقة الصحيحة هي ملف اختبار Testbench يولد المدخلات ويتحقق من المخارج بنفسه، ويطبع PASS أو FAIL، تماماً كاختبارات الوحدة Unit Tests التي تكتبها للكود. وملف الاختبار وحدة Verilog ليس لها أرجل، تحتوي الوحدة المختبرة، وتستخدم أشياء لا يمكن تحويلها إلى عتاد، مثل التأخير الزمني # والطباعة $display والأرقام العشرية real. وهذا اختبار المرسل كاملاً:
// Self-checking testbench for uart_tx at 12 MHz / 115200 baud.
// A model receiver samples the line in the middle of each bit at the IDEAL 115200 baud,
// and the testbench measures the real bit width the transmitter produced.
`timescale 1ns/1fs
module tb_uart;
    localparam real CLK_NS = 1000.0 / 12.0;          // 83.333 ns
    localparam real BIT_NS = 1.0e9 / 115200.0;       // 8680.556 ns, what the receiver expects

    reg clk = 0;
    always #(CLK_NS / 2.0) clk = ~clk;

    reg        start = 0;
    reg  [7:0] data  = 0;
    wire       tx, busy;
    uart_tx #(.CLKS_PER_BIT(104)) dut (.clk(clk), .start(start), .data(data), .tx(tx), .busy(busy));

    integer errors = 0;
    real    t_fall, t_rise;

    task send(input [7:0] b);
        begin
            wait (!busy);                            // the transmitter ignores start while it is busy
            @(negedge clk); data = b; start = 1;
            @(negedge clk); start = 0;
        end
    endtask

    // Receive one frame like a real UART receiver would: find the start edge, then sample mid-bit.
    task receive_and_check(input [7:0] expected);
        reg [7:0] got;
        integer i;
        begin
            @(negedge tx);
            t_fall = $realtime;
            #(BIT_NS / 2.0);
            if (tx !== 1'b0) begin $display("FAIL start bit not low"); errors = errors + 1; end
            for (i = 0; i < 8; i = i + 1) begin
                #(BIT_NS);
                got[i] = tx;
            end
            #(BIT_NS);
            if (tx !== 1'b1) begin $display("FAIL stop bit not high"); errors = errors + 1; end
            if (got !== expected) begin
                $display("FAIL byte: expected 0x%02h got 0x%02h", expected, got);
                errors = errors + 1;
            end else
                $display("ok   byte 0x%02h received, start edge at t=%0.3f us", got, t_fall / 1000.0);
        end
    endtask

    // watchdog: a testbench that waits for an edge that never comes must fail, not run forever
    initial begin
        #2_000_000;
        $display("FAIL: timeout at %0t", $realtime);
        $finish;
    end

    initial begin
        $dumpfile("uart.vcd");
        $dumpvars(0, tb_uart);
        #1000;

        // 0x55 = 0101_0101: every bit toggles, so the line shows each bit edge.
        fork
            send(8'h55);
            receive_and_check(8'h55);
        join

        // measure the real bit width: start bit edge to the next rising edge, and 9 bits to the stop bit
        @(posedge clk); send(8'h55);
        @(negedge tx); t_fall = $realtime;
        @(posedge tx); t_rise = $realtime;
        $display("start bit width : %0.3f ns (ideal %0.3f ns)", t_rise - t_fall, BIT_NS);
        $display("bit error       : %0.3f %%", 100.0 * ((t_rise - t_fall) - BIT_NS) / BIT_NS);
        repeat (8) @(edge tx);                      // the 8th edge after the start bit is the rise into the stop bit
        $display("9 bits measured : %0.3f ns (ideal %0.3f ns)", $realtime - t_fall, 9.0 * BIT_NS);
        wait (!busy);

        fork
            send("H");
            receive_and_check("H");
        join
        fork
            send(8'hA5);
            receive_and_check(8'hA5);
        join

        #20000;
        if (errors == 0) $display("PASS: uart_tx, 0 errors");
        else             $display("FAIL: uart_tx, %0d errors", errors);
        $finish;
    end
endmodule
في الملف أعلاه لاحظ التالي:
- السطر
`timescale 1ns/1fsيجعل وحدة الزمن نانوثانية بدقة فيمتوثانية، لأن نصف دورة الساعة 41.666… نانوثانية، ولو كانت الدقة بيكوثانية لتراكم خطأ التقريب في القياس. - المستقبل Receiver في
receive_and_checkيعمل كمستقبل UART حقيقي: ينتظر الحافة الهابطة لبت البداية، ثم ينتظر نصف بت ليصل إلى منتصفه، ثم يقرأ كل بت بعد زمن بت كامل بالسرعة المثالية 115200، وليس بسرعة المرسل، لكي يختبر أن خطأ السرعة مقبول. - القياس يأخذ زمن الحافة الهابطة والصاعدة بـ
$realtime، فيحسب عرض البت الحقيقي، ثم يعد ثماني حواف ليصل إلى بداية بت النهاية، أي بعد تسعة بتات من البداية. - الكتلة الأولى في
initialحارس زمني Watchdog: إذا لم ينته الاختبار خلال 2 ms من وقت المحاكاة يطبع FAIL ويتوقف، وسوف ترى بعد قليل لماذا أضفناه. fork … joinتشغل الإرسال والاستقبال معاً، كأنهما جهازان على طرفي السلك.
واختبارا العداد وPWM بنفس الفكرة: اختبار العداد يتحقق أن المصباح يتغير كل 8 دورات بعداد من 4 بتات، واختبار PWM يعد الدورات التي يكون فيها المخرج 1 خلال 256 دورة لخمس قيم من duty. والمخرج في out/out-sim-iverilog.txt سوف يكون كما يلي:
### iverilog: tb_blinky
VCD info: dumpfile blinky.vcd opened for output.
led changed 8 times in 64 cycles
PASS: blinky, 0 errors
tb/tb_blinky.v:29: $finish called at 5292709 (1ps)
### iverilog: tb_pwm
ok   duty=  0: high for   0 of 256 cycles =   0.00 %
ok   duty=  1: high for   1 of 256 cycles =   0.39 %
ok   duty= 64: high for  64 of 256 cycles =  25.00 %
ok   duty=128: high for 128 of 256 cycles =  50.00 %
ok   duty=255: high for 255 of 256 cycles =  99.61 %
PASS: pwm, 0 errors
tb/tb_pwm.v:32: $finish called at 231627853 (1ps)
### iverilog: tb_uart
VCD info: dumpfile uart.vcd opened for output.
ok   byte 0x55 received, start edge at t=1.125 us
start bit width : 8666.667 ns (ideal 8680.556 ns)
bit error       : -0.160 %
9 bits measured : 78000.001 ns (ideal 78125.000 ns)
ok   byte 0x48 received, start edge at t=174.625 us
ok   byte 0xa5 received, start edge at t=261.375 us
PASS: uart_tx, 0 errors
tb/tb_uart.v:91: $finish called at 363840279873 (1fs)
ولنقرأه سطراً سطراً:
led changed 8 times in 64 cycles: العداد بأربعة بتات يغير البت الأعلى كل 8 دورات، والاختبار تحقق من المسافة بين كل تغيرين، فطبعPASS: blinky.- في PWM خرجت كل قيمة كما هي:
duty=64أعطت 64 دورة من 256 أي 25%، وduty=255أعطت 99.61%، أي أن هذا المولد لا يستطيع أن يعطي 100% بالضبط، وإذا احتجتها فعليك أن تضيف حالة خاصة أو تجعل العداد يعد إلى 254. وهذه تفاصيل صغيرة تجدها في الاختبار وليس في الموجات. - في UART استقبل المستقبل المثالي البايت
0x55ثم0x48وهو الحرف H، ثم0xa5، بدون خطأ. start bit width : 8666.667 ns: عرض البت الذي يولده المرسل، والمثالي8680.556 ns، والخطأ-0.160 %، أي أن مرسلنا أسرع قليلاً من 115200.9 bits measured : 78000.001 nsمقابل78125.000 ns: عند بداية بت النهاية يكون المرسل قد سبق المستقبل المثالي بـ 125 نانوثانية، والجزء الأخير.001بقايا تقريب الأرقام العشرية في المحاكي.$finish called at 363840279873 (1fs): الاختبار انتهى بعد قرابة 364 ميكروثانية من وقت المحاكاة، والرقم بالفيمتوثانية لأنها الدقة التي طلبناها.
خطأ السرعة بالحساب: لماذا 104 وليس 104.17؟
العداد في العتاد يعد أرقاماً صحيحة فقط، والساعة 12,000,000 نبضة في الثانية، والسرعة المطلوبة 115200 بت في الثانية، فالقسمة 104.17 نبضة لكل بت، وأقرب رقم صحيح هو 104. وبالتالي السرعة الفعلية 12,000,000 مقسومة على 104، أي 115384.6 بت في الثانية، وعرض البت 104 × 83.333 = 8666.667 نانوثانية، وهذا بالضبط الرقم الذي قاسه الاختبار، والخطأ (8666.667 − 8680.556) ÷ 8680.556 = −0.16%.
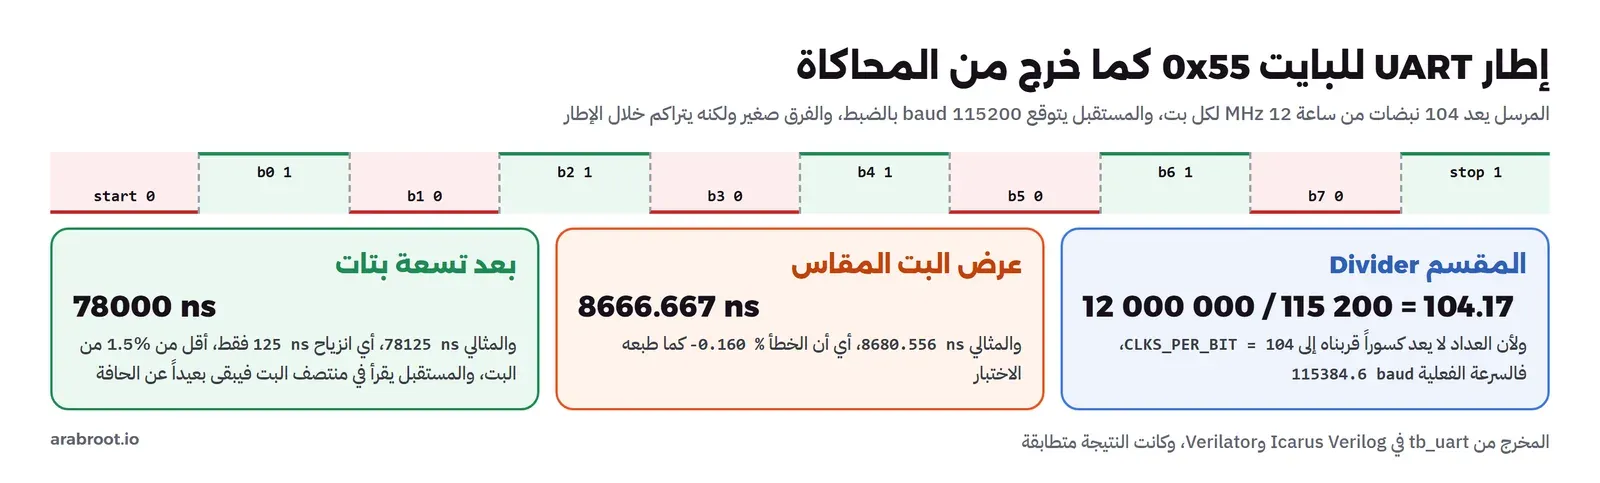
وهل هذا الخطأ مقبول؟ المستقبل يقرأ كل بت في منتصفه، فيتحمل أن ينزاح الإطار نصف بت قبل نهايته، أي قرابة 5% من السرعة على عشرة بتات، وهذا الهامش يتقاسمه الطرفان، والقاعدة العملية الشائعة أن يبقى خطأ كل طرف تحت 2% تقريباً. ومرسلنا عند 0.16%، والانزياح بعد تسعة بتات 125 نانوثانية من بت عرضه 8681، أي أقل من 1.5% من البت، وهذا بعيد جداً عن الحافة. ولكن لاحظ أن الحساب نفسه يعطي نتائج مختلفة لسرعات أخرى: مع 9600 القسمة 1250 بالضبط بدون أي خطأ، ومع سرعة عالية مثل 3,000,000 القسمة 4 بالضبط، أما مع 921600 فالقسمة 13.02، فتقرب إلى 13 بخطأ 0.16% أيضاً، وفي كل الأحوال احسب الخطأ قبل أن تختار الساعة والسرعة، وإذا خرج كبيراً فغير الساعة بحلقة PLL إلى تردد ينقسم بشكل أفضل.
المشكلة التي ظهرت: اختبار لا ينتهي وملف موجات بمئات الميغابايت
في أول تشغيل لاختبار المرسل لم يطبع المحاكي إلا أول بايت، ثم بقي يعمل، وبعد أربع دقائق كان ملف الموجات uart.vcd قد وصل إلى 360 ميغابايت ويزيد. والسبب كان في ملف الاختبار وليس في المرسل: المستقبل في الاختبار ينتهي من قراءة بت النهاية في منتصفه، أي قبل أن ينتهي المرسل من الإطار بنصف بت، فأرسل الاختبار البايت التالي فوراً بينما المرسل ما زال في حالة STOP، والمرسل يتجاهل start وهو مشغول كما صممناه، فلم يرسل شيئاً، وبقي الاختبار ينتظر حافة هابطة على tx لن تأتي أبداً، والمحاكي يكتب كل نبضة ساعة في الملف إلى ما لا نهاية.
والإصلاح كان في أمرين، وكلاهما نصيحة عامة لكل اختبار تكتبه:
- احترم إشارات الانشغال في ملف الاختبار كما يحترمها أي مستخدم حقيقي للوحدة، ولذلك تنتظر المهمة
sendالآنwait (!busy)قبل أن ترسل. والدرس الأعمق أن ملف الاختبار كود مثل أي كود آخر، وأخطاؤه تبدو كأنها أخطاء في التصميم. - ضع حارساً زمنياً Watchdog في كل اختبار: كتلة
initialتنتظر زمناً أطول من الاختبار كله ثم تطبع FAIL وتنهي المحاكاة، فيفشل الاختبار خلال ثانية بدل أن يملأ القرص، وهذا مهم جداً عندما تشغل الاختبارات في خط CI لا يراقبه أحد.
وواجهتنا مشكلة ثانية أصغر تستحق الذكر: الأداة icetime من IceStorm، وهي أداة توقيت مستقلة، توقفت بالرسالة Can't find chipdb file for device 5k. والسبب أن ملفات وصف الشريحة في Debian في حزمة منفصلة اسمها fpga-icestorm-chipdb، وهي من الحزم الموصى بها فقط، فلا تنزل مع الخيار --no-install-recommends الذي نستخدمه لتصغير الـ Image. فإذا احتجت icetime فأضف الحزمة صراحة، أو اعتمد على تقرير التوقيت في nextpnr كما فعلنا هنا، وهو التقرير الذي يستخدمه أغلب المصممين اليوم.
نفس الاختبار في Verilator
المحاكي Icarus ينفذ التصميم حدثاً بحدث، وهذا ممتاز للتعلم وللتصاميم الصغيرة، ولكنه بطيء في التصاميم الكبيرة. والمحاكي Verilator يأخذ طريقاً آخر: يحول التصميم وملف الاختبار إلى كود C++ ثم يترجمه بـ g++ إلى برنامج تنفيذي، ومنذ الإصدار 5 يدعم التأخيرات الزمنية في ملفات الاختبار بالخيار --timing، والخيار --binary يبني البرنامج ويجهزه للتشغيل في خطوة واحدة كما في توثيق الأمر verilator. وشغلنا نفس الملف بدون أي تعديل، والمخرج سوف يكون كما يلي:
### verilator --binary --timing tb_uart
%Warning-BLKSEQ: tb/tb_uart.v:10:32: Blocking assignment '=' in sequential logic process
- Verilator: Walltime 21.386 s (elab=0.002, cvt=0.038, bld=21.230); cpu 0.041 s on 1 threads; alloced 9.453 MB
-Info: tb/tb_uart.v:60: $dumpvar ignored, as Verilated without --trace
ok   byte 0x55 received, start edge at t=1.125 us
start bit width : 8666.667 ns (ideal 8680.556 ns)
bit error       : -0.160 %
9 bits measured : 78000.001 ns (ideal 78125.000 ns)
ok   byte 0x48 received, start edge at t=174.625 us
ok   byte 0xa5 received, start edge at t=261.375 us
PASS: uart_tx, 0 errors
- tb/tb_uart.v:91: Verilog $finish
- S i m u l a t i o n   R e p o r t: Verilator 5.032 2025-01-01
- Verilator: $finish at 364us; walltime 0.010 s; speed 35.200 ms/s
- Verilator: cpu 0.010 s on 1 threads; alloced 57 MB
لاحظ التالي:
%Warning-BLKSEQ: Verilator يحذر من الإسناد المانع=في كتلة متتابعة، والسطر المقصود هو مولد الساعة في ملف الاختبارalways #(CLK_NS / 2.0) clk = ~clk;، وهو مقبول في ملف اختبار لا يتحول إلى عتاد، ولكن نفس التحذير في ملف تصميم يعني خطأ حقيقياً كما سنرى. وVerilator أشد من Icarus في التحذيرات، وهذا سبب جيد لتشغيل الاثنين.Walltime 21.386 sأغلبه فيbld، أي ترجمة كود C++، أما المحاكاة نفسها فأخذتwalltime 0.010 s. وفي التصاميم الكبيرة تنقلب الصورة: الترجمة مرة واحدة، والمحاكاة أسرع من Icarus بمرات كثيرة.$dumpvar ignored, as Verilated without --trace: لم نطلب ملف موجات في Verilator، فتجاهل الأمر، ويمكن أن تضيف--traceإذا احتجته.- الأرقام نفسها حرفاً بحرف:
8666.667 nsو-0.160 %و78000.001 nsوالبايتات الثلاثة، أي أن المحاكيين اتفقا على سلوك الدائرة.
الموجات في GTKWave
الاختبار يقول هل الدائرة صحيحة، والموجات تقول لك لماذا عندما لا تكون صحيحة. وملف uart.vcd الذي كتبه Icarus يحتوي كل إشارة في الاختبار والمرسل، فتحناه في GTKWave داخل الـ Container على شاشة افتراضية Xvfb، مع ملف إعداد uart.gtkw يختار الإشارات ومستوى التكبير، والصورة التالية لقطة حقيقية من النافذة للإطار الأول:
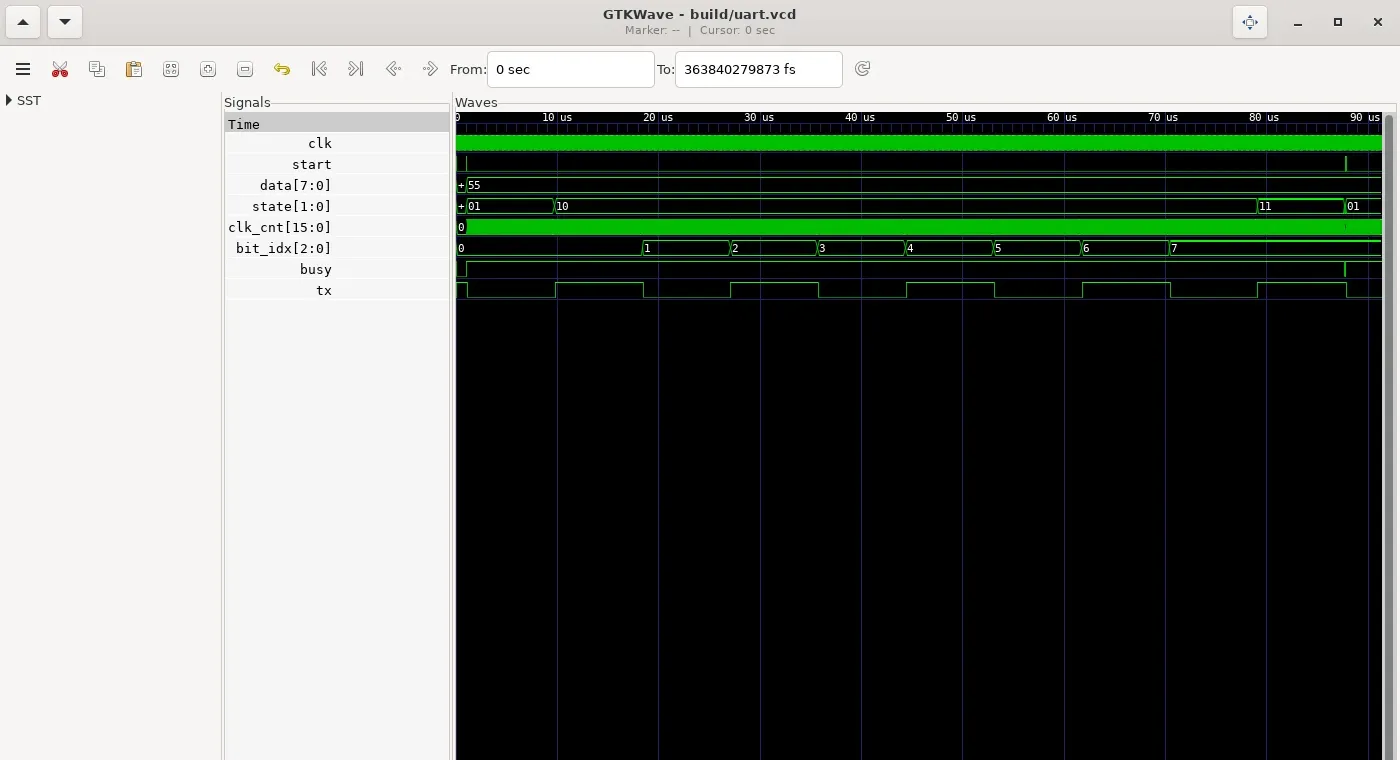
في الصورة أعلاه لاحظ التالي:
- عند الزمن 1 ميكروثانية تقريباً تظهر نبضة
startالصغيرة، ومعها تصبحbusyواحداً، وتنتقلstateمن00إلى01، أيSTART، وينزلtxإلى الصفر. - بعد قرابة 8.7 ميكروثانية تنتقل الحالة إلى
10، أيDATA، ويبدأbit_idxمن 0 ويزيد كل بت حتى 7، وtxيتناوب بين 1 و0 لأن البايت0x55هو01010101يرسل من البت الأصغر. - عند قرابة 79 ميكروثانية تصبح الحالة
11، أيSTOP، ويبقىtxواحداً، ثم ترجع إلىIDLE. والإشارةclk_cntتظهر شريطاً أخضر ممتلئاً لأنها تتغير في كل نبضة، وكذلكclk، فلا ترى تفاصيلها إلا بالتكبير. - وعند الطرف الأيمن قرابة 88 ميكروثانية تظهر نبضة
startثانية، وهي الإرسال الذي يقيس عرض البت، أي بعد أن انتظر الاختبارbusyكما في الإصلاح.
وقد واجهنا عند أخذ هذه اللقطة مشكلة صغيرة: عندما شغلنا GTKWave مع ملف أوامر Tcl بالخيار -S لكي يضبط التكبير، خرجت النافذة سوداء بالكامل، وعندما وضعنا التكبير في ملف .gtkw نفسه، في السطر الذي يبدأ بنجمة، رسمت النافذة كما ترى. فإذا كنت تولد لقطات الموجات آلياً في خط CI، فاعتمد على ملف الإعداد وليس على الأوامر.
التركيب Synthesis: ماذا بنى Yosys؟
بعد أن نجحت المحاكاة، نعطي التصميم لـ Yosys بالأمر synth_ice40، فيحوله إلى خلايا iCE40، والتقرير في out/out-yosys-stat.txt كما يلي:
=== top ===

   Number of wires:                267
   Number of wire bits:            420
   Number of public wires:         267
   Number of public wire bits:     420
   Number of ports:                  5
   Number of port bits:              5
   Number of memories:               0
   Number of memory bits:            0
   Number of processes:              0
   Number of cells:                369
     $scopeinfo                      3
     SB_CARRY                       94
     SB_DFF                         81
     SB_DFFE                         5
     SB_DFFESR                      26
     SB_DFFESS                       1
     SB_DFFSR                        1
     SB_DFFSS                        1
     SB_LUT4                       157
ولنقرأه سطراً سطراً:
SB_LUT4 157: 157 جدول بحث بأربعة مدخلات لكل المنطق التركيبي: المقارنة في PWM، واختيار الحرف من الرسالة، ومنطق الحالات في المرسل، ومقارنة العدادات بالأرقام.SB_CARRY 94: خلايا المنقول، وأغلبها للعدادات: 24 بتاً للوميض، و23 للتنفس، و22 للرسالة، و16 في المرسل، وبقية العدادات الصغيرة. فكل بت في عداد يحتاج خلية منقول.SB_DFFوSB_DFFEوSB_DFFESRوأخواتها: 115 قلاباً بالمجموع، والحروف بعد DFF تقول ماذا يحتاج القلاب: E للتمكين، أي يتغير فقط عندما يكون شرط معين صحيحاً، وSR للمسح المتزامن، وSS للضبط المتزامن.Number of processes: 0: كل كتلalwaysتحولت إلى خلايا، ولم يبق شيء لا تعرف الأداة كيف تبنيه، وهذا ما تريده دائماً.
التوزيع والتوصيل Place and Route: تقرير الموارد
بعد ذلك يأخذ nextpnr ملف top.json وملف الأرجل، ويجمع كل جدول مع قلابه في خلية واحدة إذا أمكن، ثم يوزع الخلايا ويوصلها. وأول جزء مهم من التقرير:
Info: Packing LUT-FFs..
Info:       45 LCs used as LUT4 only
Info:      112 LCs used as LUT4 and DFF
Info: Packing non-LUT FFs..
Info:        3 LCs used as DFF only
Info: Packing carries..
Info:       10 LCs used as CARRY only
Info: Packing indirect carry+LUT pairs...
Info:        0 LUTs merged into carry LCs
Info: Packing RAMs..
Info: Placing PLLs..
Info: Packing special functions..
Info: Packing PLLs..
Info: Promoting globals..
Info: promoting CLK$SB_IO_IN (fanout 115)
Info: promoting u_tx.bit_idx_SB_DFFESR_Q_R_SB_LUT4_I3_O_SB_LUT4_I2_O [reset] (fanout 16)
Info: promoting sending_SB_LUT4_I2_O_SB_LUT4_I2_O_SB_LUT4_I2_O[2] [cen] (fanout 16)
Info: Constraining chains...
Info:        7 LCs used to legalise carry chains.
Info: Checksum: 0x69444817

Info: Device utilisation:
Info: 	         ICESTORM_LC:   179/ 5280     3%
Info: 	        ICESTORM_RAM:     0/   30     0%
Info: 	               SB_IO:     5/   96     5%
Info: 	               SB_GB:     3/    8    37%
Info: 	        ICESTORM_PLL:     0/    1     0%
Info: 	         SB_WARMBOOT:     0/    1     0%
Info: 	        ICESTORM_DSP:     0/    8     0%
Info: 	      ICESTORM_HFOSC:     0/    1     0%
Info: 	      ICESTORM_LFOSC:     0/    1     0%
Info: 	              SB_I2C:     0/    2     0%
Info: 	              SB_SPI:     0/    2     0%
Info: 	              IO_I3C:     0/    2     0%
Info: 	         SB_LEDDA_IP:     0/    1     0%
Info: 	         SB_RGBA_DRV:     0/    1     0%
Info: 	      ICESTORM_SPRAM:     0/    4     0%
لاحظ التالي:
112 LCs used as LUT4 and DFF: في 112 خلية استخدم الجدول والقلاب معاً، و45 خلية للجدول فقط، و3 للقلاب فقط، و10 للمنقول فقط، و7 خلايا إضافية لكي تكون سلاسل المنقول متصلة في عمود واحد، فالمجموع179/ 5280خلية، أي 3% من الشريحة.promoting CLK$SB_IO_IN (fanout 115): الساعة تصل إلى 115 قلاباً، فنقلها nextpnr إلى شبكة ساعة عامة Global Buffer، وكذلك إشارتا مسح وتمكين تصل كل منهما إلى 16 قلاباً، ولذلكSB_GB: 3/ 8.SB_IO: 5/ 96: خمس أرجل هي الساعة والزر والمصباحان وTX، والرقم 96 لكل خلايا الأرجل في الشريحة، أما في غلاف sg48 الذي على اللوحة فالأرجل المتاحة أقل بكثير.ICESTORM_RAM: 0/ 30وICESTORM_DSP: 0/ 8وICESTORM_SPRAM: 0/ 4: لم نستخدم ذاكرة ولا ضرباً، فالتصميم كله من الخلايا العامة.
تقرير التوقيت: أين المسار الحرج؟
وبعد التوصيل يكتب nextpnr أعلى تردد والمسار الحرج:
Info: Critical path report for clock 'CLK$SB_IO_IN_$glb_clk' (posedge -> posedge):
Info: curr total
Info:  1.4  1.4  Source tick_SB_DFF_Q_15_D_SB_LUT4_O_LC.O
Info:  1.8  3.2    Net tick[6] (10,1) -> (9,1)
Info:                Sink sending_SB_LUT4_I2_I3_SB_LUT4_O_LC.I0
Info:                Defined in:
Info:                  rtl/top.v:34.16-34.20
Info:  1.3  4.4  Source sending_SB_LUT4_I2_I3_SB_LUT4_O_LC.O
Info:  2.4  6.8    Net sending_SB_LUT4_I2_I3[3] (9,1) -> (10,4)
Info:                Sink sending_SB_LUT4_I2_LC.I3
Info:                Defined in:
Info:                  /usr/bin/../share/yosys/ice40/cells_map.v:6.21-6.22
Info:  0.9  7.7  Source sending_SB_LUT4_I2_LC.O
Info:  1.8  9.5    Net sending_SB_LUT4_I2_O[2] (10,4) -> (10,4)
Info:                Sink sending_SB_LUT4_I2_O_SB_LUT4_I2_LC.I3
Info:                Defined in:
Info:                  /usr/bin/../share/yosys/ice40/cells_map.v:6.21-6.22
Info:  0.9 10.4  Source sending_SB_LUT4_I2_O_SB_LUT4_I2_LC.O
Info:  1.8 12.1    Net sending_SB_LUT4_I2_O_SB_LUT4_I2_O[2] (10,4) -> (10,4)
Info:                Sink sending_SB_LUT4_I2_O_SB_LUT4_I2_O_SB_LUT4_I2_LC.I3
Info:                Defined in:
Info:                  /usr/bin/../share/yosys/ice40/cells_map.v:6.21-6.22
Info:  0.9 13.0  Source sending_SB_LUT4_I2_O_SB_LUT4_I2_O_SB_LUT4_I2_LC.O
Info:  1.8 14.7    Net sending_SB_LUT4_I2_O_SB_LUT4_I2_O_SB_LUT4_I2_O[3] (10,4) -> (9,4)
Info:                Sink start_SB_LUT4_I2_1_LC.I3
Info:                Defined in:
Info:                  /usr/bin/../share/yosys/ice40/cells_map.v:6.21-6.22
Info:  0.9 15.6  Source start_SB_LUT4_I2_1_LC.O
Info:  1.8 17.4    Net idx_SB_DFFESR_Q_E (9,4) -> (9,3)
Info:                Sink idx_SB_DFFESR_Q_1_D_SB_LUT4_O_LC.CEN
Info:  0.1 17.5  Setup idx_SB_DFFESR_Q_1_D_SB_LUT4_O_LC.CEN
Info: 6.3 ns logic, 11.3 ns routing
...
Info: Max frequency for clock 'CLK$SB_IO_IN_$glb_clk': 57.07 MHz (PASS at 12.00 MHz)

Info: Max delay <async>                       -> posedge CLK$SB_IO_IN_$glb_clk: 2.59 ns
Info: Max delay posedge CLK$SB_IO_IN_$glb_clk -> <async>                      : 7.66 ns
ولنقرأه سطراً سطراً:
- المسار يبدأ من القلاب الذي يحفظ أحد بتات العداد
tick، والسطرrtl/top.v:34يشير إلى تعريف هذا العداد في الكود، ثم يمر في خمس جداول متتالية، كل منها يأخذ قرابة 0.9 إلى 1.3 نانوثانية، وبين كل جدولين سلك يأخذ 1.8 إلى 2.4 نانوثانية. - والطريق هو مقارنة
tick == 0، أي أن البتات الـ 22 كلها صفر، ثم شرطsending، ثم تمكينidx. والمقارنة بـ 22 مدخلاً تحتاج عدة طبقات من الجداول ذات الأربعة مدخلات، لأن كل جدول يجمع أربعة فقط. 6.3 ns logic, 11.3 ns routing: ثلث الزمن في الجداول وثلثاه في الأسلاك، وهذا طبيعي في FPGA، ولذلك يحرص nextpnr على وضع الخلايا المتصلة قريبة من بعضها.Max frequency … 57.07 MHz (PASS at 12.00 MHz): المسار 17.5 نانوثانية، فالتصميم يعمل حتى 57 MHz تقريباً، ونحن نطلب 12، فالهامش أكثر من 65 نانوثانية في كل دورة.Max delay <async> -> posedge: هذا طريق الزر من الرجل إلى القلاب الأول في المزامن، 2.59 نانوثانية، والأداة تسميه async لأنها تعرف أنه لا يتبع ساعتنا، وهذا بالضبط ما يحميه المزامن.
وأخيراً يحول icepack النتيجة إلى ملف البرمجة، وحجمه في out/out-bitstream.txt:
104090 build/top.binأي 104090 بايت، وهذا الحجم ثابت لكل تصاميم UP5K لأنه حالة كل خلية في الشريحة كما ذكرنا. ولو كانت اللوحة موصولة لكتبناه بالأمر iceprog build/top.bin، ولا نحتاج أي برنامج من Lattice في أي خطوة.
ماذا يحدث إذا نسيت حالة في case؟ القفل Latch
هذا من أشهر أخطاء المبتدئين في Verilog. ففي كتلة تركيبية always @(*) كتبنا محدداً من ثلاث حالات، ونسينا الرابعة:
// A combinational mux with a missing case: sel == 2'b11 assigns nothing, so y must keep its old value.
// Keeping a value without a clock is a latch.
module latch_bad (input wire [1:0] sel, input wire a, b, c, output reg y);
    always @(*) begin
        case (sel)
            2'b00: y = a;
            2'b01: y = b;
            2'b10: y = c;
        endcase
    end
endmodule

// The fix: every path assigns y (a default, or a value before the case).
module latch_good (input wire [1:0] sel, input wire a, b, c, output reg y);
    always @(*) begin
        case (sel)
            2'b00:   y = a;
            2'b01:   y = b;
            2'b10:   y = c;
            default: y = 1'b0;
        endcase
    end
endmodule
فماذا يجب أن يكون y عندما sel = 2'b11؟ الكود لا يقول شيئاً، أي أن y يجب أن يبقى على قيمته السابقة، والدائرة التي تحفظ قيمة بدون ساعة اسمها القفل Latch. وعند تركيب النسختين:
### yosys synth_ice40 -top latch_bad
Latch inferred for signal `\latch_bad.\y' from process `\latch_bad.$proc$whatif/latch.v:4$1': $auto$proc_dlatch.cc:432:proc_dlatch$454
Couldn't topologically sort cells, optimizing module \$_DLATCH_N_ may take a longer time.
   Number of cells:                  3
     SB_LUT4                         3
   Number of cells:                  3
     SB_LUT4                         3
### yosys synth_ice40 -top latch_good
No latch inferred for signal `\latch_good.\y' from process `\latch_good.$proc$whatif/latch.v:15$2'.
   Number of cells:                  2
     SB_LUT4                         2
   Number of cells:                  2
     SB_LUT4                         2
لاحظ التالي:
Latch inferred for signal `\latch_bad.\y': Yosys يقول صراحة إنه بنى قفلاً، وهذه الرسالة يجب أن تبحث عنها في كل تقرير تركيب، لأنها في 99% من الحالات خطأ وليست قصداً.Couldn't topologically sort cells: شريحة iCE40 ليس فيها قفل جاهز، فبنى Yosys القفل من جدول يرجع مخرجه إلى مدخله، أي حلقة تغذية راجعة Feedback Loop تركيبية، كالقفل SR في مقال البوابات، ولذلك لم يستطع ترتيب الخلايا. وهذه الحلقة لا تعرف أدوات التوقيت كيف تحللها، وقد تتذبذب على الشريحة.- النسخة الخاطئة 3 جداول، والصحيحة جدولان فقط، أي أن الخطأ لم يكتف بتغيير المعنى، وإنما كبر الدائرة أيضاً.
No latch inferredفي النسخة الصحيحة، والإصلاح سطر واحد:defaultيعطيyقيمة في كل الحالات، أو تعطيه قيمة قبلcaseفي أول الكتلة.
ماذا يحدث إذا استخدمت = بدل <= في كتلة الساعة؟
كتبنا سجل إزاحة Shift Register من ثلاث مراحل مرتين، بنفس السطور تماماً، مرة بـ <= ومرة بـ =، ثم أدخلنا نبضة واحدة في المدخل:
// Three-stage shift register written twice: with nonblocking (<=) and with blocking (=) assignments.
module shift3_nb (input wire clk, input wire d, output reg q1 = 0, output reg q2 = 0, output reg q3 = 0);
    always @(posedge clk) begin
        q1 <= d;
        q2 <= q1;      // the OLD q1, sampled at the same edge
        q3 <= q2;
    end
endmodule

module shift3_b (input wire clk, input wire d, output reg q1 = 0, output reg q2 = 0, output reg q3 = 0);
    always @(posedge clk) begin
        q1 = d;
        q2 = q1;       // the NEW q1, already equal to d
        q3 = q2;
    end
endmodule
والمخرج من المحاكاة ثم من Yosys:
### iverilog tb_shift3
edge d | nonblocking q1 q2 q3 | blocking q1 q2 q3
  1  1 |              1  0  0 |           1  1  1
  2  0 |              0  1  0 |           0  0  0
  3  0 |              0  0  1 |           0  0  0
  4  0 |              0  0  0 |           0  0  0
  5  0 |              0  0  0 |           0  0  0
whatif/tb_shift3.v:20: $finish called at 500004 (1ps)
### yosys synth_ice40 -top shift3_nb
   Number of cells:                  3
     SB_DFF                          3
### yosys synth_ice40 -top shift3_b
   Number of cells:                  1
     SB_DFF                          1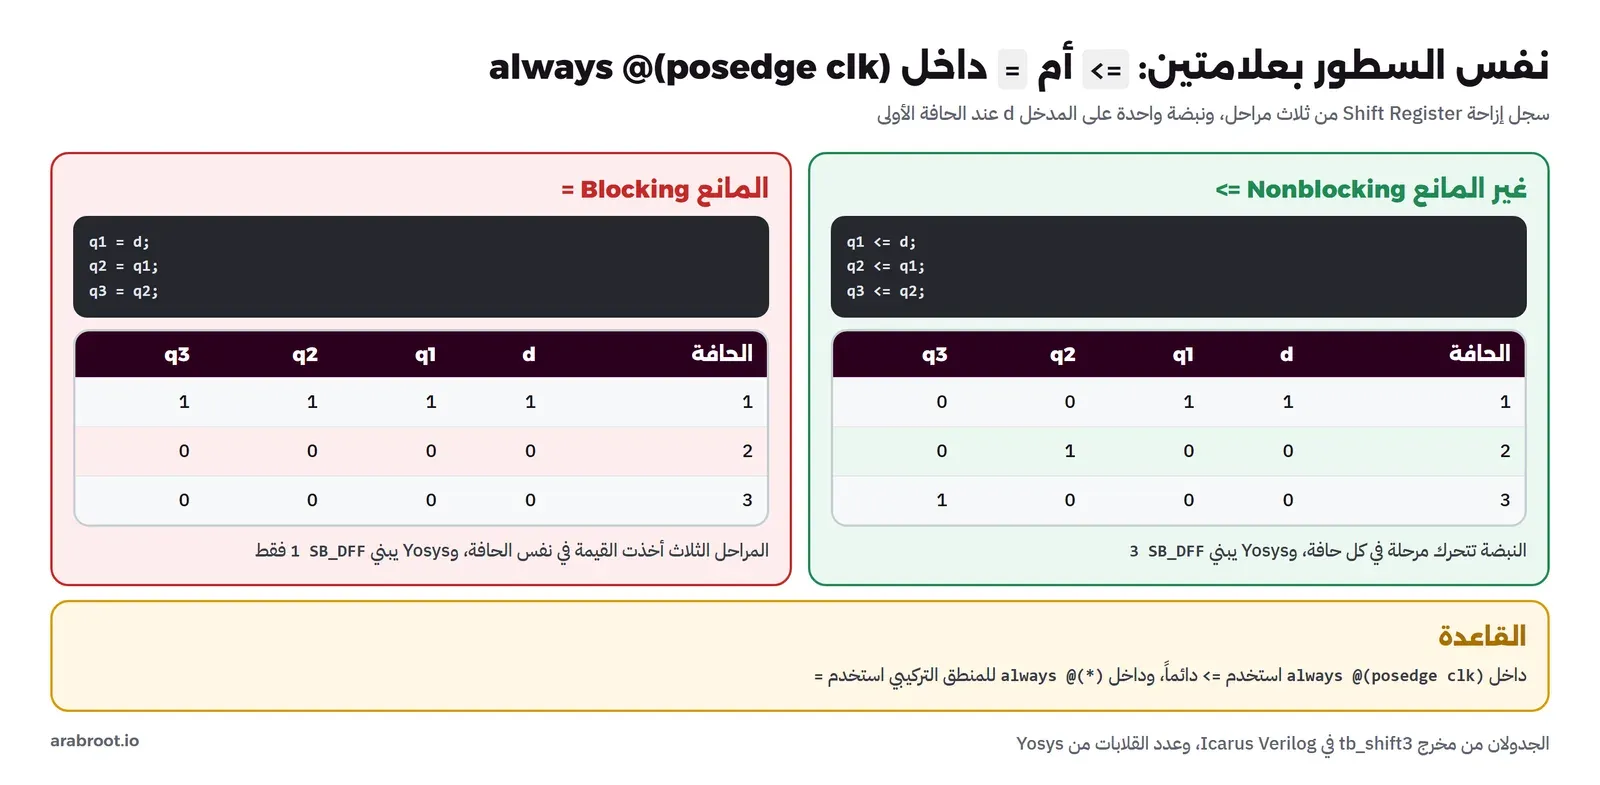
لاحظ التالي:
- مع
<=تتحرك النبضة مرحلة في كل حافة:1 0 0ثم0 1 0ثم0 0 1، وهذا سجل الإزاحة الذي أردناه، وYosys بنىSB_DFF 3. - مع
=أخذت المراحل الثلاث القيمة في نفس الحافة1 1 1، لأن السطر الثاني قرأq1الجديدة، والثالث قرأq2الجديدة. وYosys فهم ذلك فبنىSB_DFF 1فقط، أي أنq2وq3صارتا سلكين من نفس القلاب. - والأخطر من ذلك عندما يكون الإسناد المانع في كتلتين مختلفتين تقرأ إحداهما ما تكتبه الأخرى: عندها تعتمد النتيجة على الترتيب الذي يختاره المحاكي لتنفيذ الكتل، فقد يعطي Icarus نتيجة وVerilator نتيجة أخرى، والشريحة نتيجة ثالثة، وهذا ما يسمى سباق المحاكاة Simulation Race.
ماذا يحدث إذا طلبت ضرب 32 بتاً في دورة واحدة عند 48 MHz؟
في مثال خط التعبئة قد يحتاج الفريق يوماً أن يحسب شدة الضوء من قراءتين بالضرب، فلنجرب ضرب رقمين من 32 بتاً بين مسجلين، أي أن الضرب كله يجب أن ينتهي في دورة واحدة. والمدخلات من مولد أرقام عشوائية بسيط LFSR، والناتج يطوى في بت واحد، لأن غلاف الشريحة sg48 لا يحتوي 96 رجلاً لمدخلين من 32 بتاً ومخرج من 32 بتاً، فلو وضعناها على الأرجل لرفض nextpnr التصميم قبل أن يصل إلى التوقيت. والملف:
// Timing experiment: a 32 x 32 multiply between two register stages, fed by an LFSR so that
// the design needs only one pin (the UP5K package has 39 user pins, not 96).
`timescale 1ns/1ps
module mult_top (input wire CLK, output wire LEDG_N);
    reg [31:0] lfsr = 32'h1;
    always @(posedge CLK) lfsr <= {lfsr[30:0], lfsr[31] ^ lfsr[21] ^ lfsr[1] ^ lfsr[0]};

    reg [31:0] a = 0, b = 0, p = 0;
    reg        r = 0;
    always @(posedge CLK) begin
        a <= lfsr;
        b <= {lfsr[15:0], lfsr[31:16]};
        p <= a * b;            // the long combinational path: register a, b -> multiplier -> register p
        r <= ^p;               // fold the product into one bit for the pin
    end
    assign LEDG_N = r;
endmodule
ثم ركبناه مرتين: مرة بالأمر synth_ice40 العادي، فيبني الضرب من الجداول، ومرة مع الخيار -dsp فيستخدم كتل SB_MAC16، ووصلنا كل نسخة عند 12 MHz وعند 48 MHz، وهو أعلى تردد للمذبذب الداخلي في الشريحة. والمخرج في out/out-timing.txt:
  [synth_ice40 ]      SB_CARRY                       22
  [synth_ice40 ]      SB_DFF                         66
  [synth_ice40 ]      SB_LUT4                      1188
### nextpnr-ice40 --up5k --freq 12  (synth_ice40 )
Info: 	         ICESTORM_LC:  1221/ 5280    23%
Info: 	        ICESTORM_DSP:     0/    8     0%
Info: Max frequency for clock 'CLK$SB_IO_IN_$glb_clk': 23.65 MHz (PASS at 12.00 MHz)
Info: 18.5 ns logic, 24.2 ns routing
Info: 1.4 ns logic, 1.8 ns routing
Info: Max frequency for clock 'CLK$SB_IO_IN_$glb_clk': 23.42 MHz (PASS at 12.00 MHz)
    exit code: 0
### nextpnr-ice40 --up5k --freq 48  (synth_ice40 )
Info: 	         ICESTORM_LC:  1221/ 5280    23%
Info: 	        ICESTORM_DSP:     0/    8     0%
Info: Max frequency for clock 'CLK$SB_IO_IN_$glb_clk': 23.65 MHz (FAIL at 48.00 MHz)
Info: 18.5 ns logic, 24.2 ns routing
Info: 1.4 ns logic, 1.8 ns routing
ERROR: Max frequency for clock 'CLK$SB_IO_IN_$glb_clk': 23.42 MHz (FAIL at 48.00 MHz)
    exit code: 1
  [synth_ice40 -dsp]      SB_DFF                         33
  [synth_ice40 -dsp]      SB_LUT4                        15
  [synth_ice40 -dsp]      SB_MAC16                        3
### nextpnr-ice40 --up5k --freq 12  (synth_ice40 -dsp)
Info: 	         ICESTORM_LC:    48/ 5280     0%
Info: 	        ICESTORM_DSP:     3/    8    37%
Info: Max frequency for clock 'CLK$SB_IO_IN_$glb_clk': 98.26 MHz (PASS at 12.00 MHz)
Info: 3.7 ns logic, 7.2 ns routing
Info: 1.4 ns logic, 5.5 ns routing
Info: Max frequency for clock 'CLK$SB_IO_IN_$glb_clk': 91.69 MHz (PASS at 12.00 MHz)
    exit code: 0
### nextpnr-ice40 --up5k --freq 48  (synth_ice40 -dsp)
Info: 	         ICESTORM_LC:    48/ 5280     0%
Info: 	        ICESTORM_DSP:     3/    8    37%
Info: Max frequency for clock 'CLK$SB_IO_IN_$glb_clk': 98.26 MHz (PASS at 48.00 MHz)
Info: 3.7 ns logic, 7.2 ns routing
Info: 1.4 ns logic, 5.5 ns routing
Info: Max frequency for clock 'CLK$SB_IO_IN_$glb_clk': 91.69 MHz (PASS at 48.00 MHz)
    exit code: 0
ولنقرأه:
- بدون DSP بنى Yosys الضرب من
SB_LUT4 1188جدولاً، وبعد التوصيلICESTORM_LC: 1221/ 5280، أي قرابة ربع الشريحة لعملية ضرب واحدة. - المسار الحرج
18.5 ns logic, 24.2 ns routing، أي 42.7 نانوثانية، فأعلى تردد بعد التوصيل23.42 MHz. عند 12 MHz النتيجة PASS، وعند 48 MHz النتيجةERROR: Max frequency … 23.42 MHz (FAIL at 48.00 MHz)وexit code: 1، أي أن nextpnr رفض أن يكمل، وهذا سلوك جيد في خط بناء آلي، لأن ملف برمجة يفشل في التوقيت أسوأ من عدم وجود ملف. - والسطر
23.65 MHzقبله هو التقدير بعد التوزيع وقبل التوصيل، والرقم النهائي هو الثاني. - مع
-dspصار التصميمSB_MAC16 3وSB_LUT4 15فقط، أي ثلاث كتل ضرب تجمع نواتجها بعض الجداول، وICESTORM_LC: 48/ 5280، والتردد91.69 MHz، فنجح عند 48 MHz بهامش كبير.
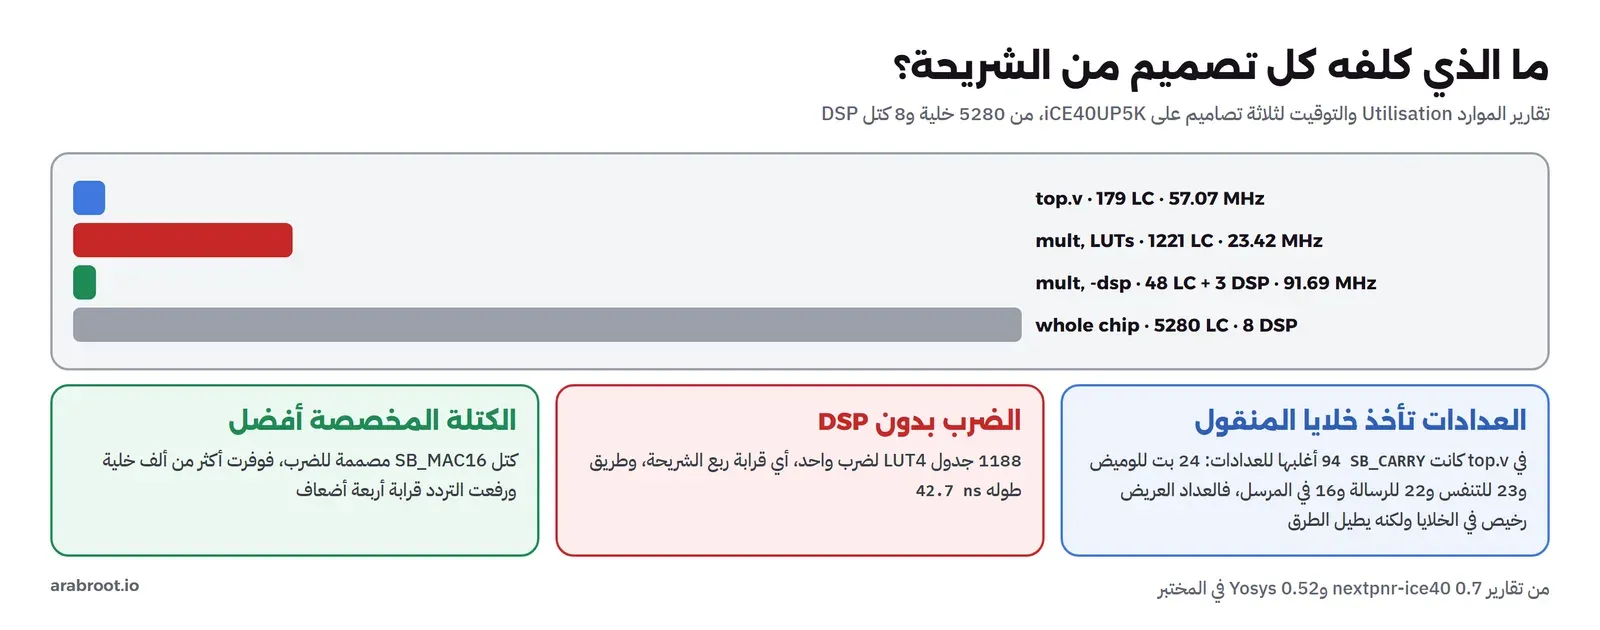
والدرس هنا مزدوج: أولاً، الكتلة المخصصة في الشريحة أسرع وأصغر بكثير من بناء نفس الوظيفة من الجداول، فاعرف ما في شريحتك واجعل الأداة تستخدمه. وثانياً، إذا فشل التوقيت حتى مع الكتل المخصصة، فالحل تقسيم الضرب على دورتين بمسجل في المنتصف، أي Pipelining، وليس رفع جهد الشريحة أو الأمل بأن «يعمل على أي حال». فالتصميم الذي فشل في التوقيت قد يعمل على مكتبك في درجة حرارة الغرفة، ثم يعطي نتائج خاطئة في صندوق حار في المصنع.
خطأ في العتاد لا يصلحه تحديث: قسمة Pentium
ولاحظ نسبة الخطأ: مرة في تسعة مليارات قسمة عشوائية. هذا النوع من الأخطاء لا يظهر في اختبار يجرب عشر قيم ينظر إليها مهندس، وإنما في اختبار ذاتي التحقق يمر على ملايين القيم ويقارنها بنموذج مرجعي Reference Model، أو في أدوات تثبت رياضياً أن الدائرة تساوي المواصفة. وهذا ما بدأناه بشكل صغير في اختبار PWM عندما مررنا على خمس قيم وتحققنا من كل واحدة، والخطوة التالية في مشروع حقيقي أن تمر على كل القيم الـ 256.
أخطاء شائعة Common Mistakes
| الخطأ | ماذا يحدث | الإصلاح |
|---|---|---|
| التفكير في Verilog كبرنامج يتنفذ سطراً بعد سطر | تصميم لا يمكن تركيبه، أو دائرة ضخمة من حلقة for ظننتها تكراراً | ارسم الدائرة في ذهنك قبل الكود: أين القلابات وأين المنطق بينها |
= في always @(posedge clk) | مراحل تختفي كما في سجل الإزاحة، وسباق بين الكتل | <= في كتل الساعة و= في الكتل التركيبية فقط |
case أو if ناقص في كتلة تركيبية | Latch inferred وحلقة تغذية راجعة لا يحللها التوقيت | default أو قيمة افتراضية في أول الكتلة، وابحث عن الكلمة Latch في كل تقرير |
| مدخل خارجي بدون مزامنة | أعطال نادرة لا تتكرر، وحالات غير موجودة في جهاز الحالات | قلابان متتاليان لكل بت، وFIFO أو Gray Code للأرقام |
| تجاهل FAIL في تقرير التوقيت | يعمل على المكتب ويفشل في الحرارة أو مع شريحة أخرى | Pipelining، أو كتل DSP وBlock RAM، أو ساعة أبطأ |
| اختبار بدون حارس زمني | محاكاة لا تنتهي وملف VCD بمئات الميغابايت | كتلة initial تطبع FAIL بعد زمن محدد |
| النظر إلى الموجات بدل الاختبار الذاتي | أخطاء نادرة تمر، مثل 99.61% بدل 100% | اختبار يطبع PASS أو FAIL، والموجات للتشخيص فقط |
| إرسال أمر لوحدة مشغولة في الاختبار | الوحدة تتجاهله والاختبار ينتظر للأبد | انتظر busy كما يفعل المستخدم الحقيقي |
| مقسم سرعة بدون حساب الخطأ | منفذ تسلسلي يعطي رموزاً غريبة في سرعات معينة | احسب الساعة على السرعة، وغير الساعة بـ PLL إذا كان الخطأ كبيراً |
| بناء الضرب والذاكرة من الجداول | ربع الشريحة لضرب واحد، وتردد منخفض | الكتل المخصصة: synth_ice40 -dsp وBlock RAM |
جدول القرار Decision Table: هل تحتاج FPGA فعلاً؟
| إذا كان عملك… | الاختيار الأنسب | والسبب |
|---|---|---|
| منطق تحكم وشبكة وواجهة مستخدم، والتوقيت بالملي ثانية | متحكم MCU | أسهل وأرخص، والمؤقتات والمقاطعات تكفي |
| توقيت محدد بالميكروثانية لعمل أو عملين | متحكم بوحدات عتاد مثل PWM وDMA، أو PIO في Raspberry Pi Pico | العتاد الموجود في المتحكم يكفي غالباً قبل أن تحتاج FPGA |
| عشرات القنوات المتوازية بتوقيت محدد بالنانوثانية | FPGA بجانب متحكم | لكل قناة دائرتها، والمتحكم للإعدادات والشبكة |
| بروتوكول غير موجود في أي متحكم، أو بسرعة عالية جداً | FPGA | تبني الواجهة التي تريدها بالضبط |
| معالجة إشارة أو فيديو بسرعة ثابتة عالية | FPGA بكتل DSP | سلسلة عمليات ثابتة على كل عينة، بدون انتظار |
| حساب متوازي ضخم على مصفوفات وأرقام عشرية | GPU | إنتاجية أعلى وأدوات أسهل للذكاء الاصطناعي والحساب العلمي |
| نفس الدائرة في ملايين الأجهزة، والتصميم مستقر | ASIC، بعد نموذج على FPGA | أرخص في القطعة وأقل طاقة، بعد أن تتأكد من التصميم |
وفي مثال خط التعبئة كان الجواب في الصف الثالث: FPGA صغيرة من عائلة iCE40 بجانب المتحكم، تولد نبضة الضوء والرسائل بتوقيت لا يتغير، والمتحكم يبقى للشبكة والإعدادات، وقد يكون الصف الثاني كافياً لو اكتفى الفريق بقناة واحدة واستخدم وحدة PWM في المتحكم مع DMA بدل المقاطعات، وهذا يستحق التجربة قبل إضافة شريحة ثانية للوحة.
تدريب عملي
- عدل مولد PWM لكي يعطي 100% عندما
duty = 255، وعدل الاختبار ليمر على كل القيم من 0 إلى 255 بدل خمس قيم، وتأكد أن Icarus وVerilator يعطيان PASS. - اكتب مستقبل UART اسمه
uart_rxيأخذ العينة في منتصف كل بت، ومرر الإشارة أولاً في مزامن بقلابين، ثم صل مخرج المرسل بمدخل المستقبل في ملف اختبار، وأرسل الأرقام من 0 إلى 255 وتحقق أن كلاً منها وصل. - غير
CLKS_PER_BITلتجرب سرعة 921600 عند 12 MHz، واحسب الخطأ بيدك قبل التشغيل، ثم قارنه بما يطبعه الاختبار. - قسم الضرب في
mult_top.vعلى دورتين بمسجل في المنتصف بدون-dsp، وانظر كم يرتفع أعلى تردد في تقرير nextpnr، وهل ينجح عند 48 MHz. - إذا كانت لديك لوحة iCEBreaker، فاكتب
build/top.binبالأمرiceprog، وافتح المنفذ التسلسلي بسرعة 115200 لترى الرسالة، ثم صل محلل المنطق على الرجل TX كما في مقال راسم الإشارة ومحلل المنطق، وقس عرض البت لتقارنه بـ 8666.667 نانوثانية من المحاكاة.
الخلاصة
- المعالج ينفذ الأعمال بالتتابع، فتوقيته غير محدد وتوازيه محدود، أما FPGA فتبني لكل عمل دائرة تعمل مع غيرها عند كل حافة ساعة، فيكون التوقيت عدداً ثابتاً من الدورات.
- داخل FPGA جداول بحث صغيرة وقلابات وسلاسل منقول، وكتل ذاكرة وضرب، وشبكات ساعة وأسلاك قابلة للبرمجة، وكلها تضبط من ملف البرمجة الذي يحمل في iCE40UP5K حجماً ثابتاً 104090 بايت.
- Verilog تصف دائرة:
always @(posedge clk)بـ<=للقلابات، وalways @(*)بـ=وحالات كاملة للمنطق التركيبي، والإسناد الخاطئ حول ثلاثة قلابات إلى قلاب واحد، والحالة الناقصة صنعت قفلاً. - الاختبار الذاتي التحقق نجح في Icarus وVerilator بنفس الأرقام، وقاس عرض بت UART بـ 8666.667 نانوثانية مقابل 8680.556 المثالي، أي خطأ −0.16% من تقريب المقسم 104.17 إلى 104.
- التصميم الكامل أخذ 179 خلية من 5280، وأعلى تردد 57.07 MHz مقابل 12 MHz مطلوبة، ومساره الحرج مقارنة عداد من 22 بتاً بالصفر، وثلثا زمنه في الأسلاك.
- الضرب من 32 بتاً بالجداول أخذ 1221 خلية وفشل عند 48 MHz بتردد أعلى 23.42 MHz، وبكتل DSP أخذ 48 خلية وثلاث كتل ونجح بـ 91.69 MHz.
- كل مدخل لا يتبع ساعتك يمر في مزامن بقلابين، وكل اختبار يحتاج حارساً زمنياً، وكل تقرير تركيب تبحث فيه عن Latch، وكل تقرير توقيت تقرأ فيه PASS أو FAIL قبل أن تكتب الملف على اللوحة.
وفي المقالات القادمة من مرحلة البرمجيات المدمجة Firmware بإذن الله نعود إلى المتحكم، ونرى كيف تعمل نماذج الذكاء الاصطناعي الصغيرة داخله، وفي مرحلة لاحقة نتحدث عن الحساسات والمحركات التي تتصل بها هذه الدوائر. وإلى ذلك الحين، هذه مقالات تكمل ما بنينا عليه:
 دليلالبوابات المنطقية Logic Gates: من الترانزستور إلى الجامعنبني من بوابة NAND واحدة دائرة تجمع رقمين وأخرى تحفظ الناتج، ونرى في محاكي Python لماذا للمعالج سرعة قصوى ولماذا يحتاج إلى ساعة.
 دليلكيف يعمل المعالج CPU من الداخل ولماذا يهمك ذلكنتابع تعليمة واحدة داخل نواة المعالج، ونرى لماذا يصبح نفس الكود أبطأ بعشر مرات عندما تغير ترتيب المرور على البيانات.
 دليلUART وI2C وSPI: كيف تتكلم القطع مع المتحكمالفرق بين UART وI2C وSPI ومتى تستخدم كلاً منها، مع حساس حرارة على I2C ومحول على SPI بمكتبات Arduino القياسية، وكل بايت مر على الناقل، وماذا يحدث عندما تخطئ العنوان.
 دليلراسم الإشارة Oscilloscope ومحلل المنطق Logic Analyzerمتى تحتاج راسم الإشارة ومتى يكفيك محلل المنطق، مع مختبر يسجل أرجل Arduino ويفك رسائلها بالأداة sigrok-cli ويحاكي أثر المسبار على الإشارة.
 دليلRaspberry Pi أم متحكم دقيق؟ الفرق ومتى تختارالفرق بين حاسوب Linux صغير ومتحكم دقيق بالأرقام: مهمة تتكرر كل ملي ثانية تأخرت على Linux حتى 20 ملي ثانية، وعلى المتحكم 5 ميكروثانية فقط، ومتى تختار كلاً منهما.
 دليللغة C للأنظمة المدمجة Embedded C: الذاكرة والمسجلاتنكتب برنامجاً كاملاً لشريحة STM32F407 بدون أي مكتبة، من خريطة الذاكرة والمسجلات إلى كود البداية وملف الربط، ثم نشغله في Renode، ثم نقرأ ملف الخريطة ومخرج size.
 دليلالذكاء الاصطناعي على الحافة TinyML: كشف الأعطال داخل المتحكمندرب نموذجاً صغيراً على اهتزاز محامل حقيقية، ونكممه إلى int8، ونشغله بـ TFLite Micro على Cortex-M4 في Renode مع CMSIS-NN، ثم نرى لماذا يفشل أمام عطل لم يره وكيف يساعد كشف الشذوذ.
 دليلمن Arduino إلى STM32: معالجات Arm Cortex-M في الصناعةما الذي يتغير عندما تنتقل من Arduino إلى STM32: الترخيص وعائلة Cortex-M والساعات وRCC وNVIC وطبقات HAL وLL وlibopencm3، مع مختبر في Renode يقيس الحجم ويدخل إلى المقاطعة بـ GDB.
 دليلربط الحساسات والمحركات بالمتحكم Interfacingما يحدث بين رجل المتحكم والحساس أو المحرك: دقة المحول والضجيج وفرق 5 و3.3 فولت، وBME280 ومعادلته، وحدود التيار، وServo وDRV8833 وA4988 مقاسة على الأرجل في مختبر حقيقي.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة المقال، وتشغيل كل التجارب داخل Container من Docker Image elm-fpga-lab:1 على Debian 13 مع Icarus Verilog 12.0 وVerilator 5.032 وYosys 0.52 وnextpnr-ice40 0.7 وProject IceStorm وGTKWave 3.3.121 تحت Xvfb، لشريحة iCE40UP5K في غلاف sg48 على لوحة iCEBreaker، على Docker Engine 29.8.0.