


في المتجر الذي نتابعه في هذه السلسلة ظهرت مجموعة من المهام الصغيرة لا تشبه بعضها إلا في شيء واحد: أنها لا تعمل أغلب الوقت. فإصدار الإيصال الموقع بعد كل عملية دفع يحدث بضع مرات في الساعة، ثم مئات المرات في ساعة العروض، واستقبال إشعارات بوابة الدفع Webhooks لا يأتي بانتظام، وتقرير نهاية اليوم يعمل دقيقة واحدة في الليل. ولكل مهمة منها خيار من اثنين: أن تضاف إلى التطبيق الرئيسي فتكبره وتربط نشرها بنشره، أو أن تكون خدمة مستقلة تعمل طوال اليوم لتنتظر طلبات قليلة. والفريق سمع عن الحل الثالث في السحابة، أي AWS Lambda وأمثالها: تكتب الدالة، وتدفع لكل استدعاء، ولا تدير أي سيرفر. ولكن البيانات يجب أن تبقى على سيرفرات الشركة، والفاتورة لكل طلب صعبة التوقع في أيام العروض، فجاء السؤال: هل نستطيع أن نحصل على نفس الطريقة على سيرفرنا؟
والإجابة نعم، ولكن بشرط يجب أن تعرفه من البداية: Serverless على سيرفرك ليس «بلا سيرفر»، فأنت من يدير السيرفر والعنقود Cluster الذي تحته، والذي تحصل عليه هو طريقة العمل: المطور يسلم دالة، والمنصة تتولى التوجيه والتوسع والتصغير إلى صفر. وفي هذا المقال سوف نجرب أشهر منصتين مفتوحتين لهذا، OpenFaaS وKnative، على نفس الدالة ونفس السيرفر، ونقيس الفرق بالأرقام. وكلاهما يحتاج Kubernetes، فشغلنا k3s، وهو توزيعة Kubernetes خفيفة، داخل Container واحد على Docker، بنفس الطريقة التي تعمل بها أداة k3d، وكان كافياً لحدود المختبر من القرص والذاكرة.
وسوف نناقش في هذا المقال ما يلي:
- ما الذي تعنيه Serverless فعلاً، ومتى تفيد ومتى تضر، والفرق بينها وبين خدمة عادية على Kubernetes.
- OpenFaaS وKnative: من أين جاء كل منهما، وكيف يعمل من الداخل، والترخيص والحدود.
- مختبر حقيقي: عنقود k3s على Docker، ودالة إيصال واحدة بلغة Python على المنصتين.
- خمس مشكلات واجهتنا: cgroup v1، وPython يتجاهل SIGTERM، وشرط ال Images العامة في OpenFaaS CE، وRegistry دون TLS، وجسم طلب بلا Content-Length.
- تجارب بالأرقام: التصغير إلى صفر والبدء البارد، ونفس الضغط على المنصتين، والذاكرة.
- جدول قرار، وأخطاء شائعة، وقائمة تحقق.
ما هي Serverless فعلاً؟ Functions as a Service
الكلمة مضللة قليلاً، لأن الكود يعمل دائماً على سيرفر، والمقصود أن المطور لا يرى السيرفر ولا يديره. والنموذج الأشهر لها هو الدوال كخدمة Functions as a Service واختصاراً FaaS: تكتب دالة تستقبل طلباً وترجع إجابة، وتسلمها للمنصة، والمنصة تعطيها عنواناً، وتشغل منها نسخة عندما يأتي طلب، وتشغل نسخاً أكثر عندما تزيد الطلبات، وتوقفها كلها عندما تتوقف الطلبات. والصورة التالية تبين من يفعل ماذا عندما تكون المنصة على سيرفرك:
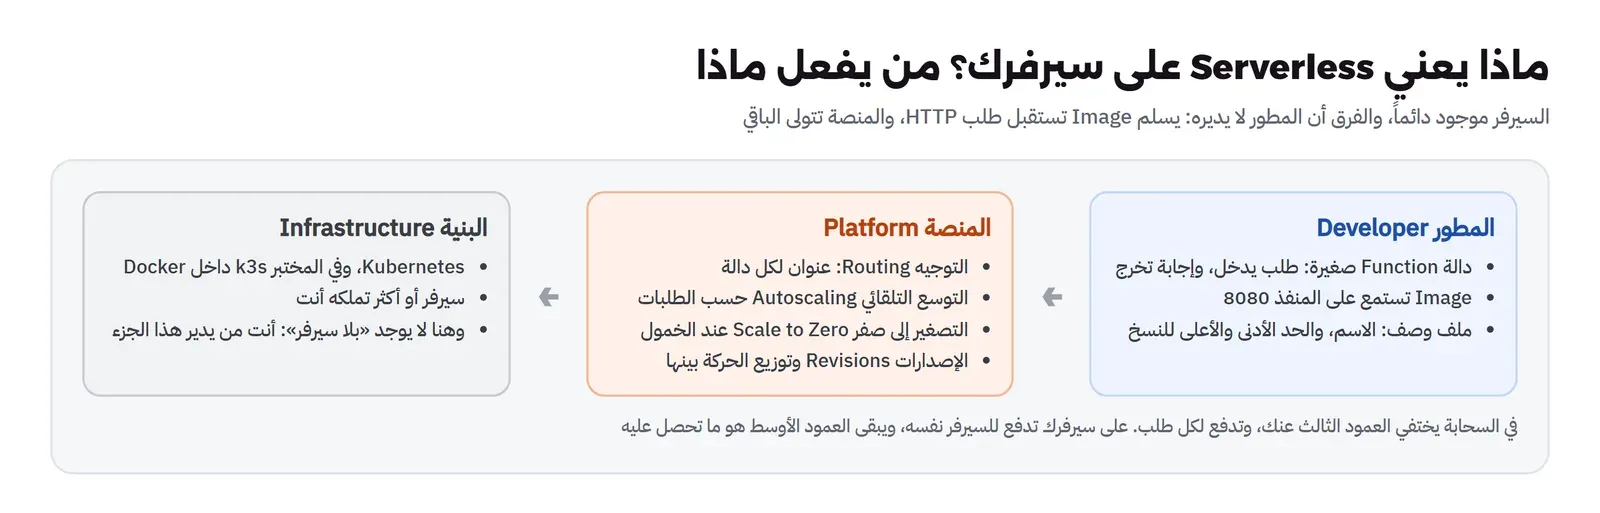
والفائدة الحقيقية في ثلاثة أشياء. الأولى التصغير إلى صفر Scale to Zero: الدالة التي لا يطلبها أحد لا تأخذ ذاكرة ولا معالجاً، وهذا مهم عندما تكون عندك عشرات المهام الصغيرة التي تعمل نادراً، فبدلاً من عشرين خدمة تعمل طوال اليوم بنصف جيجابايت لكل واحدة، تعمل فقط الدوال التي يطلبها أحد الآن. والثانية التوسع التلقائي Autoscaling على الطلبات نفسها، فساعة العروض تضيف نسخاً دون أن يستيقظ أحد. والثالثة أن المطور يركز على الدالة، فلا يكتب ملف Deployment وService وIngress وقواعد التوسع لكل مهمة صغيرة.
ولكن لهذا ثمن. فأول طلب بعد الصفر ينتظر حتى تبدأ نسخة جديدة، وهذا ما يسمى البدء البارد Cold Start، وقسناه في المختبر بأكثر من ثانية. والدالة يجب أن تكون بلا حالة Stateless، لأن نسختها قد تحذف في أي لحظة. والمنصة نفسها طبقة إضافية فوق Kubernetes، فيها Containers ومكونات تحتاج ذاكرة وترقية وفهماً عند العطل. ولذلك Serverless ليست بديلاً عن الخدمات العادية، وإنما مكانها المهام الصغيرة المتقطعة، أما الخدمة التي تستقبل طلبات طوال اليوم فهي خدمة عادية، ونسختها الواحدة التي تعمل دائماً أرخص وأبسط من منصة تقرر كل دقيقة كم نسخة تحتاج. وإذا كنت لم تقرر بعد هل تحتاج Kubernetes أصلاً، فابدأ من مقال هل تحتاج Kubernetes فعلاً، لأن كل ما في هذا المقال يفترض أن الجواب نعم.
المنصتان OpenFaaS مع Knative
المنصتان تحلان نفس المشكلة بطريقتين، ومن أين جاءت كل منهما يفسر الكثير من الفرق بينهما.
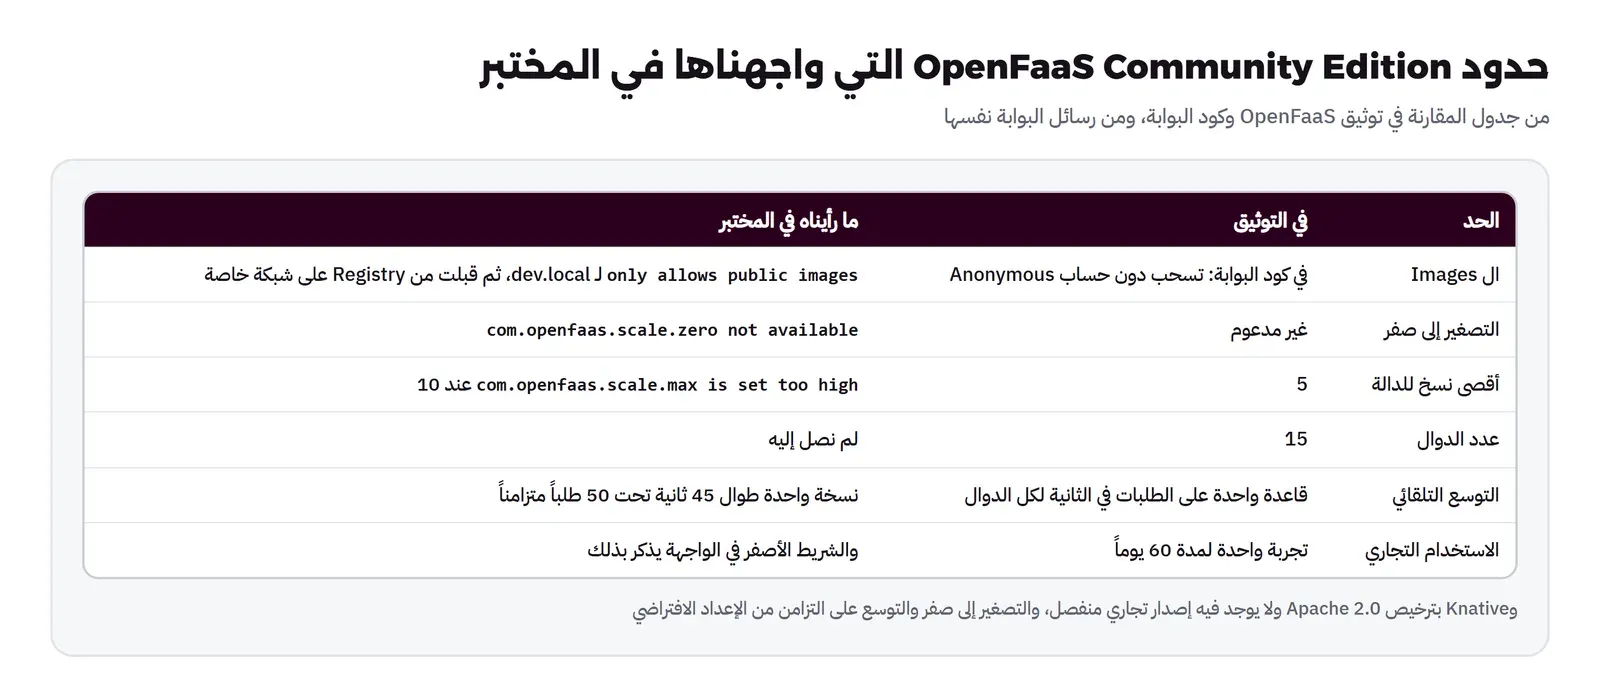
OpenFaaS منصة تجعل أي Container يستقبل HTTP دالة، وتطورها شركة OpenFaaS Ltd. وفكرته أن تكون بسيطة: بوابة Gateway تستقبل الطلبات على /function/<name>، وتحولها إلى نسخ الدالة، وأداة سطر أوامر faas-cli تبني وتنشر من ملف stack.yaml، وقوالب جاهزة للغات. وهناك إصداران: إصدار المجتمع Community Edition واختصاراً CE، والإصدار التجاري Pro. وهذا الفرق هو أهم ما في القرار، كما سنرى، فبحسب جدول المقارنة الرسمي فإن CE لا يدعم التصغير إلى صفر، وأقصى عدد نسخ للدالة 5، وأقصى عدد دوال 15، والتوسع بقاعدة واحدة على عدد الطلبات في الثانية لكل الدوال، والاستخدام التجاري محدود بتجربة واحدة لمدة 60 يوماً بحسب اتفاقية الترخيص.
Knative طبقة فوق Kubernetes تجعل تشغيل الخدمات والدوال أبسط، وقبلته مؤسسة CNCF في 2 مارس 2022 في مستوى الاحتضان Incubating، ثم تخرج Graduated في 11 سبتمبر 2025 كما في صفحة المشروع في CNCF، وترخيصه Apache 2.0 دون إصدار تجاري منفصل. وفي Knative جزءان: Serving الذي يشغل الخدمات ويوسعها ويصغرها، وEventing الذي يوصل الأحداث بها، وفي هذا المقال نستخدم Serving فقط. والفرق في الفكرة أن Knative لا يقول «دالة» وإنما «خدمة» Service، أي أي Container يستقبل HTTP، مع إصدارات Revisions ثابتة لكل تغيير، وتوزيع الحركة بينها.
كيف يعمل كل منهما من الداخل؟ Architecture
شغلنا المنصتين على نفس العنقود، والصورة التالية تبين ما يعمل لكل منهما، وذاكرته بعد تجارب الضغط:
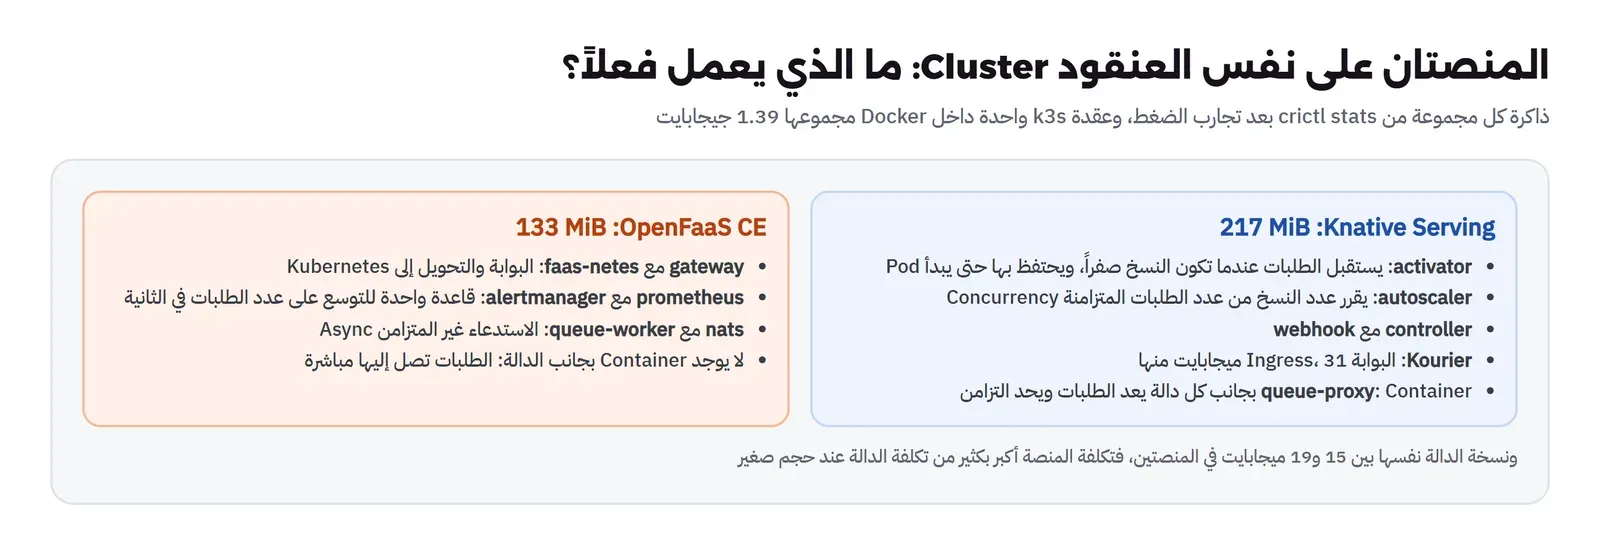
في Knative المكون الأهم هو queue-proxy، وهو Container صغير يضيفه Knative بجانب كل نسخة من الدالة، فيمر عليه كل طلب قبل أن يصل إلى الكود. وهو يعد الطلبات المتزامنة Concurrency ويرسل العدد إلى autoscaler، ويحد عدد الطلبات التي تصل إلى الدالة في نفس اللحظة إذا ضبطت ذلك. ثم autoscaler يحسب كل بضع ثوان كم نسخة تحتاج ليكون عدد الطلبات المتزامنة لكل نسخة قريباً من الهدف الذي حددته، وهو في المختبر 10. وعندما تكون النسخ صفراً، يوجه Kourier الطلبات إلى activator، فيحتفظ بها ويطلب من autoscaler نسخة، ثم يرسلها إليها عندما تصبح جاهزة، وهذا هو البدء البارد. وكل هذا موصوف في توثيق التزامن في Knative.
أما OpenFaaS CE فطريقه أقصر. البوابة تستقبل الطلب، والجزء faas-netes داخلها يعرف أين نسخ الدالة في Kubernetes، فيرسل الطلب إليها مباشرة، ولا يوجد Container بجانب الدالة. والتوسع يحدث بطريقة مختلفة تماماً بحسب توثيق التوسع في OpenFaaS: Prometheus يجمع عدد الطلبات في الثانية لكل دالة، وAlertManager فيه قاعدة واحدة لكل الدوال، فإذا تجاوزت دالة الحد أطلق تنبيهاً إلى البوابة، فتضيف البوابة نسخاً بنسبة 20% من الحد الأعلى افتراضياً عند كل تنبيه. وNATS مع queue-worker للاستدعاء غير المتزامن Async، أي أن ترسل الطلب وتعود فوراً، وفي CE هذا في الذاكرة فقط مع حد عشرة عناصر في الطابور. ولاحظ أن OpenFaaS Pro يستبدل هذا كله بموسع Autoscaler مستقل يحسب كل دورة، ويدعم التصغير إلى صفر، أي أن جزءاً كبيراً من تصميم CE هو ما يجعلك تحتاج Pro.
المختبر Lab: عنقود k3s داخل Docker
عنقود Kubernetes من عقدة واحدة يكفي لنفهم المنصتين ونقيسهما، والطريقة الأخف أن نشغل k3s داخل Container بصلاحيات كاملة، وهي نفس فكرة k3d. والسكربت كاملاً كما يلي:
#!/bin/sh
# A one-node Kubernetes (k3s) inside Docker, like k3d does it. Traefik is off: Knative brings its own ingress (Kourier).
# fail-cgroupv1=false: this Docker Desktop (WSL 2, kernel 5.15) still runs cgroup v1, and kubelet 1.37 refuses it by default.
export MSYS_NO_PATHCONV=1
docker network create wr-dp-net >/dev/null 2>&1
docker run -d --name wr-dp-k3s --hostname wr-dp-k3s --network wr-dp-net --privileged \
  --tmpfs /run --tmpfs /var/run \
  -p 127.0.0.1:48080:80 -p 127.0.0.1:41112:31112 \
  -v wr-dp-k3s-data:/var/lib/rancher/k3s \
  rancher/k3s:v1.37.2-k3s1 server --disable traefik --disable metrics-server --tls-san wr-dp-k3s \
  --kubelet-arg=fail-cgroupv1=false
until docker exec wr-dp-k3s kubectl get nodes 2>/dev/null | grep -q " Ready"; do sleep 2; done
docker exec wr-dp-k3s kubectl get nodes -o wide
في السكربت أعلاه لاحظ التالي:
- عطلنا Traefik، وهو ال Ingress الافتراضي في k3s، لأن Knative يأتي ببوابته Kourier، وعطلنا metrics-server لأننا لا نحتاجه.
- نشرنا منفذين فقط على
127.0.0.1: المنفذ 80 لبوابة Knative، والمنفذ 31112 لبوابة OpenFaaS، والمنصتان في نفس العنقود. - والسطر الأخير
--kubelet-arg=fail-cgroupv1=falseلم يكن في النسخة الأولى، وهو أول مشكلة واجهتنا.
مشكلة واجهتنا: kubelet يرفض cgroup v1
في أول تشغيل توقف ال Container بعد ثوان، وفي السجل:
level=error msg="Shutdown request received: \"kubelet exited: failed to validate kubelet configuration, error: kubelet is configured to not run on a host using cgroup v1. cgroup v1 support is unsupported and will be remove…
level=fatal msg="failed to start controllers: failed to create new server context: failed to create crd 'etcdsnapshotfiles.k3s.cattle.io': context canceled"
والسبب أن Docker Desktop على هذا الجهاز، وهو WSL 2 بنواة 5.15، ما زال يعمل بـ cgroup v1، والأمر docker info يقول cgroup 1. وبحسب توثيق cgroups في Kubernetes فإن دعم cgroup v1 مهمل Deprecated منذ الإصدار 1.35، ولم يعد kubelet يبدأ على عقدة cgroup v1 افتراضياً، إلا إذا ضبط المسؤول failCgroupV1 على false. فأضفنا الخيار، فبدأ العنقود وصار جاهزاً في 10 ثوان:
NAME        STATUS   ROLES           AGE   VERSION        INTERNAL-IP   EXTERNAL-IP   OS-IMAGE           KERNEL-VERSION                               CONTAINER-RUNTIME
wr-dp-k3s   Ready    control-plane   3s    v1.37.2+k3s1   172.18.0.2    <none>        K3s v1.37.2+k3s1   5.15.167.4-microsoft-standard-WSL2 (amd64)   containerd://2.3.7-k3s1
k3s ready after 10s
وفي سجل containerd بعدها تحذير يقول إن دعم cgroup v1 مهمل منذ containerd 2.2 وسيحذف في موعد أقصاه مايو 2029. وهذا الحل مناسب للمختبر، أما في الإنتاج فالحل الصحيح سيرفر بنظام حديث يعمل بـ cgroup v2، وأغلب التوزيعات الحالية كذلك، فإذا ظهر لك هذا الخطأ على سيرفر حقيقي فهو إشارة إلى أن النظام قديم، وليس إلى أن تضيف الخيار.
الدالة receipt
كتبنا دالة واحدة تعمل على المنصتين دون تغيير: سيرفر HTTP بالمكتبة القياسية في Python، يستقبل طلباً فيه رقم الطلب والأصناف، ويرجع المجموع وتوقيعاً، مع قليل من العمل على المعالج لكي يظهر الضغط في التوسع:
# receipt: the same function for OpenFaaS and Knative. A plain HTTP server on PORT (8080), standard library only.
# POST / {"order": 1042, "items": [{"sku": "A1", "price": 49.5, "qty": 2}]} -> receipt with a signature.
import hashlib, json, os, signal, socket, sys, time
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer

STARTED = time.time()

class H(BaseHTTPRequestHandler):
    def _send(self, code, body):
        data = json.dumps(body).encode()
        self.send_response(code)
        self.send_header("Content-Type", "application/json")
        self.send_header("Content-Length", str(len(data)))
        self.end_headers()
        self.wfile.write(data)

    def body(self):
        # A gateway may forward the body with Transfer-Encoding: chunked and no Content-Length (OpenFaaS did),
        # and BaseHTTPRequestHandler does not decode chunks by itself.
        if os.environ.get("DEBUG_HEADERS"):
            print(dict(self.headers), flush=True)
        if "chunked" in self.headers.get("Transfer-Encoding", ""):
            data = b""
            while True:
                size = int(self.rfile.readline().strip(), 16)
                if size == 0:
                    self.rfile.readline()
                    return data
                data += self.rfile.read(size)
                self.rfile.readline()
        return self.rfile.read(int(self.headers.get("Content-Length", 0)))

    def do_GET(self):  # health checks: OpenFaaS probes /_/health and /_/ready, Knative probes the port
        self._send(200, {"ok": True, "pod": socket.gethostname(), "uptime_s": round(time.time() - STARTED, 1)})

    def do_POST(self):
        try:
            order = json.loads(self.body() or b"{}")
            total = round(sum(i["price"] * i["qty"] for i in order.get("items", [])), 2)
        except (ValueError, KeyError, TypeError) as e:
            return self._send(400, {"error": f"bad order: {e}"})
        sig = str(order.get("order", 0)).encode()
        for _ in range(20000):                  # a little CPU work, so load shows up in the autoscaler
            sig = hashlib.sha256(sig).digest()
        self._send(200, {"order": order.get("order"), "total": total, "signature": sig.hex()[:16],
                         "pod": socket.gethostname()})

    def log_message(self, *a):
        pass

# Python as PID 1 in a container ignores SIGTERM unless it installs a handler: without this line a pod being
# scaled down waits for the whole grace period (300 s in Knative) before it is killed.
signal.signal(signal.SIGTERM, lambda *_: sys.exit(0))
ThreadingHTTPServer(("0.0.0.0", int(os.environ.get("PORT", "8080"))), H).serve_forever()
والدالة كما تراها هي النسخة الأخيرة، وفيها جزءان أضفناهما بعد مشكلتين سوف نشرحهما: معالجة الإشارة SIGTERM، وقراءة الجسم المقسم Chunked. ولاحظ أن الدالة تجيب على أي طلب GET بحالة صحية، لأن OpenFaaS يفحص /_/health و/_/ready كما في توثيق تشغيل Container موجود، وKnative يفحص المنفذ. وال Dockerfile ثلاثة أسطر من python:3.13-slim مع مستخدم غير root، وحجم ال Image الناتجة 176 ميجابايت.
Knative في المختبر
ثبتنا Knative Serving 1.24.0 مع Kourier بثلاثة ملفات YAML رسمية كما في توثيق التثبيت، ثم ضبطنا Kourier بوابة، ونطاقاً اسمه shop.lab، والسكربت في lab/install.sh. واستغرق تطبيق الملفات 10 ثوان، وبعد 56 ثانية كانت كل المكونات تعمل. ثم الدالة كخدمة Knative:
# The receipt function as a Knative Service: scale to zero when idle, one pod per 10 concurrent requests.
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: receipt
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/min-scale: "0"
        autoscaling.knative.dev/max-scale: "10"
        autoscaling.knative.dev/target: "10"        # concurrent requests per pod
    spec:
      containers:
        - image: 172.18.0.3:5000/receipt:3
          imagePullPolicy: IfNotPresent
          ports: [ { containerPort: 8080 } ]
          resources:
            requests: { cpu: 100m, memory: 64Mi }
            limits: { memory: 128Mi }
في الملف أعلاه لاحظ التالي:
min-scale: "0"يسمح بالتصغير إلى صفر، وmax-scale: "10"حد أعلى، وtarget: "10"هو عدد الطلبات المتزامنة التي يحاول autoscaler أن يجعلها لكل نسخة.- حد الذاكرة 128 ميجابايت لكل نسخة، والطلب 64 ميجابايت، وهذا ما يجعل الجدولة ممكنة عندما تزيد النسخ.
- في البداية كانت ال Image باسم
dev.local/receipt، لأن Knative يحول الوسم Tag إلى البصمة Digest عند إنشاء كل إصدار، أي أنه يسأل ال Registry، والنطاقdev.localمن النطاقات التي يتخطاها افتراضياً كما في توثيق تحويل الوسوم، فصلح ل Image حملناها في containerd مباشرة دون Registry. وبعد أن أضفنا Registry للمختبر من أجل OpenFaaS، نقلنا الخدمة إليه، فحول Knative الوسم إلى البصمةsha256:2a4e83e6…وثبت الإصدار عليها.
وبعد 11 ثانية من التطبيق كانت الخدمة جاهزة:
service.serving.knative.dev/receipt created
ready after 11s
NAME      URL                               LATESTCREATED   LATESTREADY     READY   REASON
receipt   http://receipt.default.shop.lab   receipt-00001   receipt-00001   True
NAME            CONFIG NAME   GENERATION   READY   REASON   ACTUAL REPLICAS   DESIRED REPLICAS
receipt-00001   receipt       1            True             1                 1
ولاحظ الإصدار receipt-00001: كل تغيير في القالب spec.template ينشئ إصداراً جديداً ثابتاً، والإصدارات القديمة تبقى بصفر نسخ، فتستطيع أن ترجع إليها أو تقسم الحركة بينها، مثل 90% للقديم و10% للجديد، وهذا ما شرحنا فكرته في مقال الإطلاق التدريجي.
مشكلة واجهتنا: Pod عالق خمس دقائق
أرسلنا طلبين، ثم انتظرنا التصغير إلى صفر. وقرر autoscaler التصغير بعد 62 ثانية من آخر طلب، ولكن بعد خمس دقائق كان ال Pod ما زال موجوداً:
NAME                                        READY   STATUS        RESTARTS   AGE
receipt-00001-deployment-5c96fc69cf-hhcds   1/2     Terminating   0          5m35s
NAME            DESIREDSCALE   ACTUALSCALE   READY   REASON
receipt-00001   0              0             False   NoTraffic
أي أن Knative يقول إن العدد المطلوب صفر والحالة NoTraffic، ولكن ال Pod في Terminating منذ دقائق. والسبب في الدالة نفسها: Kubernetes يرسل الإشارة SIGTERM إلى العملية الأولى في ال Container، أي PID 1، وPython لا يضع معالجاً لهذه الإشارة افتراضياً، والنواة لا تطبق السلوك الافتراضي للإشارة على PID 1، فتتجاهلها العملية تماماً. فينتظر Kubernetes مهلة الإنهاء كاملة ثم يقتلها بـ SIGKILL، ومهلة الإنهاء في Knative مرتبطة بمهلة الطلب في الإصدار، وقيمتها الافتراضية 300 ثانية كما في إعدادات Knative الافتراضية، وهذا ما رأيناه. والحل سطر واحد في الدالة يجعل SIGTERM ينهي البرنامج، أو تشغيل العملية خلف برنامج init صغير مثل الخيار --init في Docker كما في توثيق docker run.
وقد يتساءل البعض: لماذا يهم هذا والنتيجة في النهاية أن ال Pod حذف؟ والإجابة أن ال Pod العالق يحجز ذاكرته من العنقود خمس دقائق بعد كل تصغير، وفي منصة فائدتها الأساسية أن تحرر الموارد عند الخمول، فهذا يلغي الفائدة. وأخطر من ذلك عند النشر: الإصدار القديم لا يخرج بسرعة، فالترقية تأخذ خمس دقائق أطول لكل نسخة. وبعد الإصلاح أعدنا التجربة:
{"order": 1042, "total": 148.0, "signature": "512e4cf55b17d619", "pod": "receipt-00002-deployment-67bb85fccd-6t2v6"}  time_total=0.026703s code=200
last call at 11:37:18
no pods 126s after the last call
cold:
{"order": 1042, "total": 148.0, "signature": "512e4cf55b17d619", "pod": "receipt-00002-deployment-67bb85fccd-vdjq6"}  time_total=1.053332s code=200
warm:
{"order": 1042, "total": 148.0, "signature": "512e4cf55b17d619", "pod": "receipt-00002-deployment-67bb85fccd-vdjq6"}  time_total=0.032051s code=200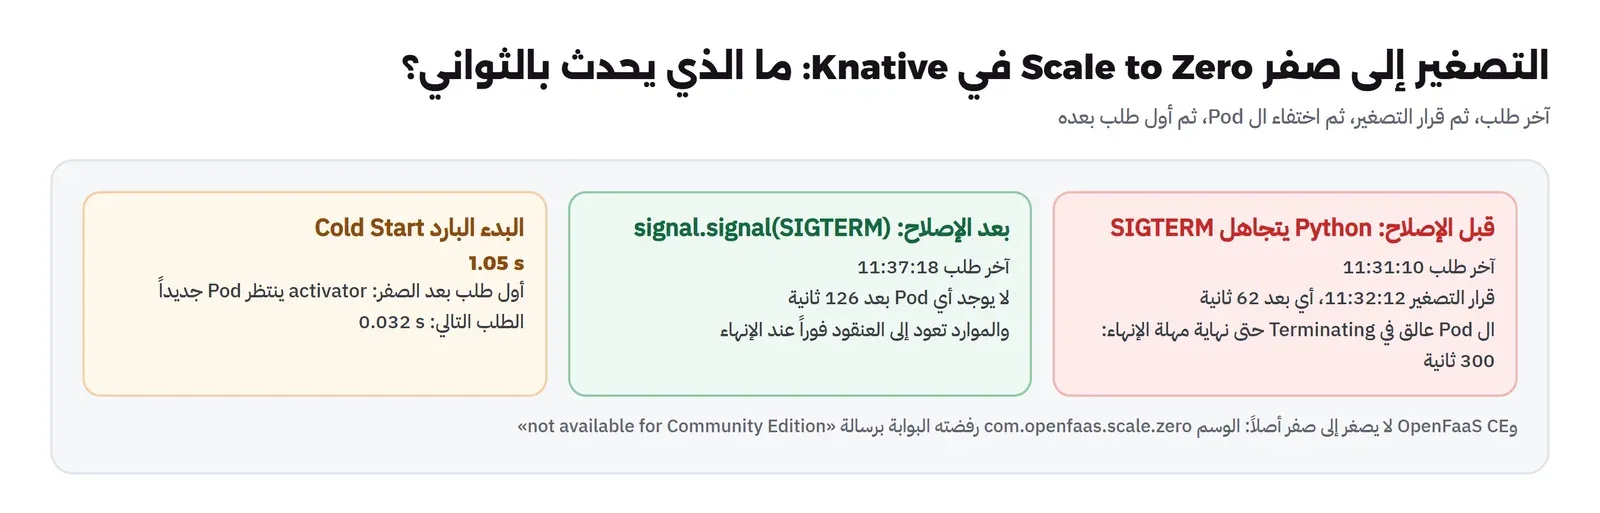
في المخرج أعلاه لاحظ التالي:
- لم يبق أي Pod بعد 126 ثانية من آخر طلب، أي التصغير بعد نافذة الاستقرار، ثم إنهاء ال Pod بعد أن ينهي queue-proxy الطلبات التي معه. وبحسب توثيق التصغير إلى صفر فهناك إعدادات تتحكم في هذا، منها
scale-to-zero-grace-periodوقيمته الافتراضية 30 ثانية، وscale-to-zero-pod-retention-periodالذي يبقي آخر Pod مدة أطول إذا أردت أن تقلل البدء البارد. - الطلب الأول بعد الصفر أخذ 1.05 ثانية، وهو البدء البارد كاملاً: activator يستقبل، وKubernetes ينشئ Pod، وPython يبدأ، وqueue-proxy يتأكد أن الدالة جاهزة. والطلب التالي 32 ميلي ثانية، وال Pod نفسه في الطلبين، أي أن الفرق كله في البدء.
- ثانية واحدة قد تكون مقبولة لإيصال يصدر بعد الدفع، ولكنها غير مقبولة لصفحة يفتحها المستخدم وينتظرها. ولذلك القرار لكل دالة:
min-scale: "0"للمهام التي تقبل التأخير، و"1"لما يحتاج إجابة سريعة دائماً، مع أن هذا يلغي التوفير.
OpenFaaS في المختبر
ثبتنا OpenFaaS CE بمخطط Helm الرسمي بالإصدار 15.0.14، والبوابة 0.27.14 مع faas-netes 0.18.17، واستغرق Helm 8 ثوان، وصارت المكونات جاهزة بعد نحو دقيقة. والأمر في lab/install.sh، وكلمة مرور المسؤول تولد في Secret اسمه basic-auth، لأن CE يدعم الدخول بكلمة مرور فقط Basic Auth. ثم ملف الدالة:
# The same receipt image as an OpenFaaS function (faas-cli deploy -f stack.yaml).
version: 1.0
provider:
  name: openfaas
  gateway: http://wr-dp-k3s:31112
functions:
  receipt:
    image: 172.18.0.3:5000/receipt:3   # the CE gateway checks that this reference can be pulled anonymously
    labels:
      com.openfaas.scale.min: "1"
      com.openfaas.scale.max: "5"
    environment: { DEBUG_HEADERS: "1" }   # prints the request headers: how we found the chunked body
    limits: { memory: 128Mi }
    requests: { memory: 64Mi, cpu: 100m }
مشكلة واجهتنا: CE يقبل ال Images العامة فقط
في المحاولة الأولى كانت ال Image هي نفسها dev.local/receipt:2 التي استخدمها Knative، فرفضت البوابة النشر:
Unexpected status: 400, message: the Community Edition license agreement only allows public images
Function 'receipt' failed to deploy with status code: 400
ولم نجد هذا الشرط في صفحة التثبيت، فقرأنا كود البوابة، ووجدناه في الملف validate.go في faas-netes 0.18.17: قبل كل نشر تحاول البوابة أن تقرأ وصف ال Image من ال Registry دون أي حساب Anonymous، فإذا فشلت رفضت النشر بهذه الرسالة، والتعليق فوق الدالة يقول إن هذا جزء من ترخيص CE، وإن Registry محلي مسموح للتجربة. والنتيجة العملية كبيرة: في CE لا تستطيع أن تنشر دالة من Registry خاص يحتاج كلمة مرور، أي أن كود دوالك يجب أن يكون في Image يستطيع أي أحد يصل إلى ال Registry أن يسحبها. وهذا بالإضافة إلى حد الاستخدام التجاري، يقول لك إن CE مصمم للتعلم والتجربة، وليس للإنتاج.
فشغلنا Registry للمختبر على شبكة Docker بعنوان خاص 172.18.0.3:5000، ورفعنا إليه ال Image، فقبلتها البوابة، لأن مكتبة ال Registry التي تستخدمها تتصل بالعناوين الخاصة عبر HTTP. ولكن ال Pod نفسه لم يبدأ:
Failed to pull image "172.18.0.3:5000/receipt:2": failed to pull and unpack image "172.18.0.3:5000/receipt:2": failed to resolve reference "172.18.0.3:5000/receipt:2": failed to do request: Head "https://172.18.0.3:5000/v2/receipt/manifests/2": http: server gave HTTP response to HTTPS clientفالبوابة تحدثت مع ال Registry عبر HTTP، أما containerd في العقدة فحاول HTTPS، وال Registry دون TLS. وحاولنا أولاً أن نجعل سياسة السحب IfNotPresent عبر قيمة functions.imagePullPolicy في المخطط، لأن ال Image موجودة في containerd أصلاً، وظهرت القيمة في إعداد البوابة، ولكن ال Deployment الذي أنشأته للدالة بقي Always. فأضفنا ملف registries.yaml لـ k3s كما في توثيق Registry الخاص في k3s، يقول لـ containerd أن يستخدم HTTP لهذا العنوان، ثم أعدنا تشغيل k3s، فبدأت الدالة وأجابت بعد 66 ثانية من إعادة التشغيل:
# k3s: pull from the lab registry over plain HTTP (it has no TLS). Goes to /etc/rancher/k3s/registries.yaml, then restart k3s.
mirrors:
  "172.18.0.3:5000":
    endpoint:
      - "http://172.18.0.3:5000"
وفي الإنتاج لا تفعل هذا، وإنما Registry بشهادة TLS حقيقية، كما في دليل Gitea الذي يحتوي Registry لل Images.
مشكلة واجهتنا: رمز 200 مع جسم Body فارغ
الدالة أجابت عبر OpenFaaS برمز 200، ولكن الإجابة نفسها كانت خاطئة:
{"order": null, "total": 0, "signature": "0781b7c2c8c22c9d", "pod": "receipt-6c7ddd66d4-6rz72"} time_total=0.022281s code=200رقم الطلب null والمجموع صفر، مع أن نفس الطلب عبر Knative أرجع المجموع 148. أي أن الدالة لم تر الجسم Body أصلاً. ولكي نعرف السبب أضفنا إلى الدالة متغيراً يطبع ترويسات Headers كل طلب، فظهر في سجلها:
{'Host': '10.42.0.38:8080', 'User-Agent': 'curl/8.12.1', 'Transfer-Encoding': 'chunked', 'Accept': '*/*', 'Accept-Encoding': 'gzip', 'Content-Type': 'application/x-www-form-urlencoded', 'X-Call-Id': 'b9c559f2-4896-4dc0-9b47-c6bfa841b734', 'X-Forwarded-For': '10.42.0.1:50461', 'X-Forwarded-Host': '127.0.0.1:41112', 'X-Start-Time': '1793879283818822649'}فالبوابة ترسل الجسم إلى الدالة بترميز Transfer-Encoding: chunked ودون ترويسة Content-Length، والنسخة الأولى من الدالة كانت تقرأ عدد البايتات من Content-Length، فقرأت صفراً، وBaseHTTPRequestHandler في Python لا يفك الترميز المقسم بنفسه. فأضفنا الدالة body() التي تقرأ الأجزاء. وهذه المشكلة أخطر من الأخطاء السابقة، لأنها لا تظهر كخطأ: رمز 200، وزمن قصير، وبيانات خاطئة. ولو كانت الدالة تحفظ الإيصال في قاعدة بيانات لحفظت إيصالات بصفر ريال. والدرس أن الاختبار بعد النشر يجب أن يتحقق من محتوى الإجابة وليس من رمزها، وأن الدالة التي تعمل خلف منصة واحدة قد لا تعمل خلف أخرى لأن كل بوابة تعيد كتابة الطلب بطريقتها.
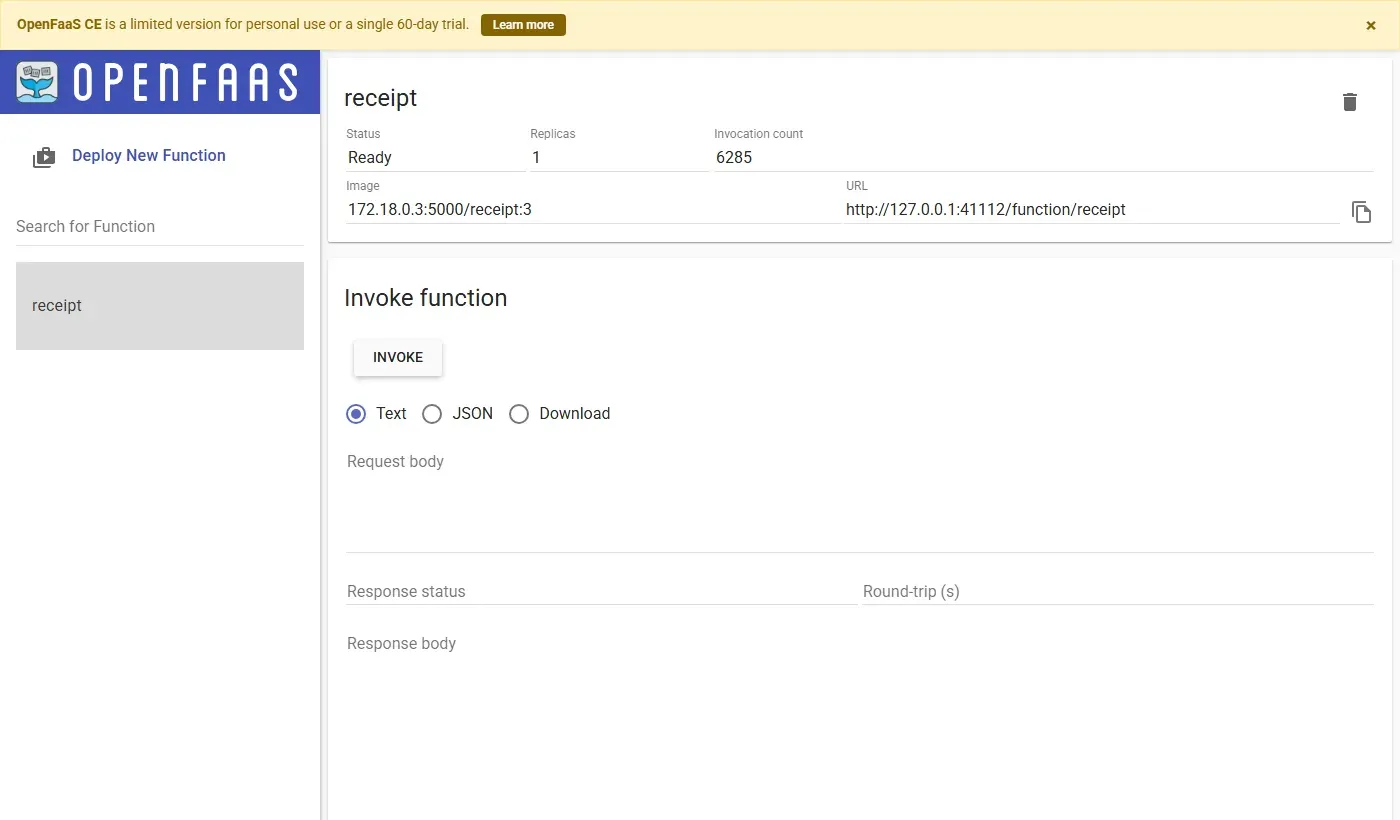
والصورة التالية من واجهة OpenFaaS CE بعد التجارب، وفيها الدالة بنسخة واحدة و6285 استدعاء، والشريط الأصفر في أعلاها يذكر بحدود الترخيص:
ماذا لو طلبنا ما لا يقدمه CE؟
جربنا الحدين اللذين يهمان أكثر: التصغير إلى صفر، وعشر نسخ بدلاً من خمس، بنفس الملف مع وسم Label إضافي:
Deploying: receipt.
WARNING! You are not using an encrypted connection to the gateway, consider using HTTPS.
Unexpected status: 400, message: validation failed: com.openfaas.scale.zero not available for Community Edition
Function 'receipt' failed to deploy with status code: 400
Deploying: receipt.
WARNING! You are not using an encrypted connection to the gateway, consider using HTTPS.
Unexpected status: 400, message: validation failed: com.openfaas.scale.max is set too high for Community Edition
Function 'receipt' failed to deploy with status code: 400
والرفض هنا واضح وصريح، وهذا جيد، لأنك تعرف الحد عند النشر وليس في منتصف ساعة العروض. والصورة التالية تجمع حدود CE كما في التوثيق، وما رأيناه منها:
ماذا لو جاءت ساعة العروض؟ What If
الآن التجربة التي تهم الفريق أكثر: نفس الضغط على المنصتين. كتبنا مولد ضغط مغلق الحلقة Closed-loop، أي 50 عاملاً يرسل كل منهم طلباً وينتظر الإجابة ثم يرسل التالي، لمدة 90 ثانية، وبجانبه سكربت يعد النسخ التي تعمل كل 5 ثوان:
# Closed-loop load: C workers send receipt calls for D seconds. Prints requests/s, latency percentiles, errors, pods seen.
#   docker run --rm --network wr-dp-net -v "$PWD:/w" python:3.13-slim python /w/load.py <url> <host-header|-> <C> <D>
import json, sys, threading, time, urllib.request, collections
url, host, C, D = sys.argv[1], sys.argv[2], int(sys.argv[3]), float(sys.argv[4])
body = json.dumps({"order": 1042, "items": [{"sku": "A1", "price": 49.5, "qty": 2}]}).encode()
lat, errs, pods, lock = [], collections.Counter(), collections.Counter(), threading.Lock()
end = time.time() + D
def worker():
    while time.time() < end:
        req = urllib.request.Request(url, data=body, headers={"Content-Type": "application/json", **({"Host": host} if host != "-" else {})})
        t = time.time()
        try:
            with urllib.request.urlopen(req, timeout=30) as r:
                pod = json.loads(r.read())["pod"]
            with lock: lat.append(time.time() - t); pods[pod] += 1
        except Exception as e:
            with lock: errs[type(e).__name__] += 1
ts = [threading.Thread(target=worker) for _ in range(C)]
[t.start() for t in ts]; [t.join() for t in ts]
lat.sort(); n = len(lat)
pct = lambda p: round(lat[min(n - 1, int(p * n))] * 1000) if n else None
print(f"requests {n} in {D:.0f}s = {n / D:.1f}/s, p50 {pct(.5)} ms, p95 {pct(.95)} ms, p99 {pct(.99)} ms, errors {dict(errs)}, pods {len(pods)}")
والنتيجة على Knative ثم على OpenFaaS:
requests 13877 in 90s = 154.2/s, p50 297 ms, p95 544 ms, p99 756 ms, errors {'HTTPError': 2}, pods 8
requests 6089 in 90s = 67.7/s, p50 164 ms, p95 3261 ms, p99 7374 ms, errors {'HTTPError': 178, 'TimeoutError': 11}, pods 3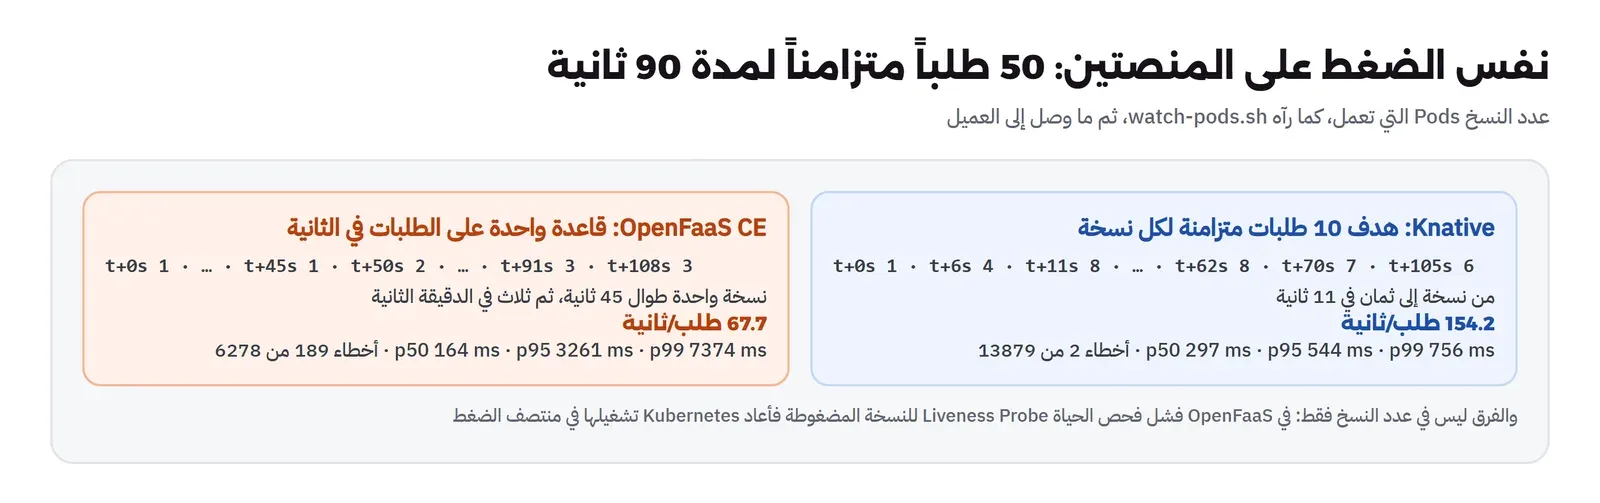
في النتائج أعلاه لاحظ التالي:
- Knative توسع بسرعة: من نسخة إلى أربع في 6 ثوان، ثم ثمان في 11 ثانية، لأن autoscaler يرى عدد الطلبات المتزامنة من queue-proxy كل بضع ثوان، و50 طلباً متزامناً مع هدف 10 لكل نسخة تعني خمس نسخ على الأقل، وزاد إلى ثمان لأن الطلبات تتراكم أثناء بدء النسخ. فكانت الإنتاجية 154.2 طلب في الثانية، وp99 أقل من ثانية، وخطآن فقط من 13879.
- OpenFaaS CE بقي على نسخة واحدة 45 ثانية: لأن التوسع يمر عبر Prometheus ثم قاعدة تنبيه ثم AlertManager ثم البوابة، ولكل خطوة فترتها، ثم يضيف نسخة واحدة عند كل تنبيه، أي 20% من الحد الأعلى 5. فوصل إلى ثلاث نسخ بعد 91 ثانية، أي بعد أن انتهى أغلب الضغط.
- والأخطاء 189 في OpenFaaS: وفي أحداث Kubernetes وجدنا السبب الأهم: فشل فحص الحياة Liveness Probe لنسخة الدالة لأن
/_/healthلم يجب خلال المهلة، فالنسخة الوحيدة كانت مشغولة بخمسين طلباً، فأعاد Kubernetes تشغيلها في منتصف الضغط، وكل الطلبات التي كانت معها فشلت. وهذا فرق تصميم حقيقي: في Knative يقف queue-proxy أمام الدالة ويحمي فحوصها من الطلبات، وفي OpenFaaS CE تصل كل الطلبات إلى الدالة نفسها، ومعها الفحص. والفرق بين فحص الحياة وفحص الجاهزية Readiness في توثيق الفحوص في Kubernetes، والقاعدة أن فحص الحياة يجب ألا يفشل بسبب الضغط، وإلا فإن الضغط نفسه يقتل الخدمة. - p50 أقل في OpenFaaS: 164 ميلي ثانية مقابل 297 في Knative، لأن طريق الطلب أقصر دون queue-proxy، ولأن الطلبات التي نجحت كانت أقل. ولكن الرقم الذي يهم المستخدم في ساعة العروض هو p99 والأخطاء، وليس الوسيط.
ولاحظ أن هذه المقارنة بين Knative وOpenFaaS CE تحديداً، وليس OpenFaaS Pro، الذي يقول توثيقه إن موسعه يحسب كل دورة على أساس الضغط الفعلي، ويدعم التوسع على التزامن Capacity مثل Knative، وحده الأعلى الافتراضي 20 نسخة. فإذا كانت OpenFaaS بطريقتها البسيطة تعجب فريقك، فالقرار الحقيقي هو بين Knative وOpenFaaS Pro بسعره، وليس بين Knative وCE.
الاستدعاء غير المتزامن Async مع الأحداث Events
كل التجارب أعلاه كانت طلباً ينتظر إجابته، ولكن كثيراً من مهام المتجر لا تحتاج أن ينتظر أحد: الإيصال يمكن أن يصدر بعد الدفع بثوان، وتقرير نهاية اليوم لا ينتظره أحد. وهنا يظهر نمط ثان: أن ترسل الطلب إلى طابور Queue وتعود فوراً، والمنصة تشغل الدالة عندما تستطيع، وتعيد المحاولة إذا فشلت. وفي OpenFaaS هذا هو المسار /async-function/<name>، وNATS مع queue-worker اللذان رأيناهما في العنقود هما من يحملانه. ولكن جدول المقارنة يقول إن الطابور في CE في الذاكرة فقط، بحد عشرة عناصر وحجم 256 كيلوبايت للرسالة، ودون إعادة محاولة، أي أن الطلبات في الطابور تضيع إذا أعيد تشغيل queue-worker، وهذا لا يصلح لأي مهمة يهمك أن تحدث، مثل إصدار إيصال لعميل دفع.
وفي Knative هذا دور الجزء الثاني Eventing، الذي لم نثبته في المختبر، وهو يوصل مصادر الأحداث، مثل قوائم الرسائل أو Webhooks، بالخدمات عبر وسطاء Brokers ومحفزات Triggers، مع إعادة المحاولة وطابور للرسائل الفاشلة Dead Letter. وهو طبقة كاملة بمكوناتها وذاكرتها، فلا تثبته إلا إذا كانت عندك أحداث حقيقية من أكثر من مصدر. وإذا كانت عندك قائمة رسائل واحدة فقط، فالأبسط غالباً Worker عادي يقرأ منها، كما في مقال مفاهيم الطوابير ودليل RabbitMQ.
نشر نسخة جديدة من الدالة Rollout
في المختبر نشرنا ثلاث نسخ من الدالة، فرأينا الفرق بين المنصتين في التحديث أيضاً. ففي Knative كل تطبيق لملف الخدمة بقالب مختلف أنشأ إصداراً جديداً، وبقي القديم بصفر نسخ، ونقلت الحركة إلى الجديد عندما صار جاهزاً، أي أن الرجوع إلى نسخة سابقة يعني أن توجه الحركة إلى إصدار موجود، دون بناء ولا نشر. وفي OpenFaaS كل faas-cli deploy حدث نفس ال Deployment في Kubernetes، فاستبدل Kubernetes النسخ تدريجياً Rolling Update، والنسخة القديمة لا تبقى كإصدار له اسم، فالرجوع يعني أن تنشر ال Image القديمة من جديد. وكلا الطريقين يعمل، ولكن الأول يجعل الرجوع أسرع والنشر التدريجي أسهل، والثاني أبسط في الفهم لمن يعرف Kubernetes.
وفي الحالتين ال Image مثبتة بالوسم في ملفنا، مثل receipt:3، وKnative وحده حول الوسم إلى بصمة Digest وثبت الإصدار عليها، فإذا أعاد أحد رفع نفس الوسم بكود مختلف، بقي الإصدار القائم على الكود الذي اختبرته. أما في OpenFaaS فمع سياسة السحب Always التي رأيناها، قد تحصل نسخة جديدة من الدالة بعد إعادة تشغيل على كود مختلف تحت نفس الوسم، ولذلك ثبت البصمة في stack.yaml نفسه، كما شرحنا في مقال تحديث ال Containers.
كم تكلف المنصة؟ Resources
جمعنا ذاكرة كل Container في العنقود من crictl stats حسب مساحة الأسماء Namespace بعد تجارب الضغط: Knative Serving 186.7 ميجابايت مع Kourier 30.5، أي 217 ميجابايت، وOpenFaaS 133.1 ميجابايت، ونسخة الدالة نفسها بين 15 و19 ميجابايت في المنصتين، ومكونات k3s الأساسية 30.6 ميجابايت. وال Container الكامل لعقدة k3s كان 1.39 جيجابايت، والفرق هو خادم Kubernetes نفسه وقاعدة بياناته وkubelet وcontainerd.
وهذه الأرقام تقول شيئاً مهماً لقرار فريق صغير: المنصة نفسها أغلى بكثير من الدالة. فعقدة k3s مع Knative تأخذ نحو جيجابايت ونصف قبل أي دالة، ودالة الإيصال تأخذ 15 ميجابايت. فإذا كانت عندك ثلاث مهام صغيرة، فثلاث خدمات عادية في Docker Compose، كل واحدة بنسخة واحدة تعمل دائماً بنحو 20 ميجابايت، أرخص بكثير من منصة Serverless كاملة، وأبسط في الفهم عند العطل. أما إذا كانت عندك أربعون مهمة، أغلبها خامل أغلب الوقت، وبعضها يحتاج أن يتوسع فجأة، فهنا تبدأ المنصة تستحق تكلفتها. وإذا كان عندك Kubernetes أصلاً لأسباب أخرى، فإضافة Knative بنحو 217 ميجابايت قرار صغير، أما تثبيت Kubernetes من أجل الدوال فقط فقرار كبير.
متى تكون Serverless فكرة سيئة؟ Anti-patterns
بعد أن رأينا المنصتين تعملان، من المهم أن نعرف أين لا تصلحان، لأن الفرق التي تتحمس للفكرة تميل إلى أن تنقل إليها كل شيء. وهذه الحالات الأربع هي التي تفشل فيها الفكرة غالباً:
- المهام الطويلة: في Knative لكل طلب مهلة، وقيمتها الافتراضية 300 ثانية، وهي نفس القيمة التي علق بها ال Pod في المختبر. فتقرير يأخذ عشر دقائق، أو معالجة ملف فيديو، لا يناسب طلب HTTP ينتظر الإجابة، ومكانه مهمة في طابور Queue يعمل عليها Worker، أو مهمة مجدولة.
- الاتصالات المفتوحة: WebSockets والبث Streaming يربطان المستخدم بنسخة معينة لمدة طويلة، والمنصة تريد أن تحرك النسخ وتحذفها بحرية، فيتعارض الطرفان.
- البدء الثقيل: دالة إيصال بلغة Python بدأت في نحو ثانية، أما خدمة تحمل نموذج ذكاء اصطناعي بحجم عدة جيجابايت أو تطبيق يحتاج عشرين ثانية ليبدأ، فالتصغير إلى صفر يعني أن أول مستخدم بعد كل فترة خمول ينتظر هذه المدة كاملة.
- قاعدة البيانات خلف دوال كثيرة: كل نسخة جديدة تفتح اتصالاتها بقاعدة البيانات. ففي تجربة الضغط صنع Knative ثماني نسخ في 11 ثانية، فإذا كان في كل نسخة مجمع اتصالات Connection Pool من عشرة، فهذه 80 اتصالاً ظهرت فجأة، ومع خمس دوال مثلها تصل إلى حد
max_connectionsفي PostgreSQL. والحل مجمع اتصالات أمام القاعدة، كما شرحنا في مقال تجميع الاتصالات، وحد أعلى للنسخ يناسب ما تتحمله القاعدة.
والقاعدة العملية التي نعطيها للفريق: إذا كانت المهمة قصيرة، وبلا حالة، وتأتي طلباتها بشكل متقطع أو مفاجئ، فهي مرشحة لتكون دالة. وإذا اختل شرط واحد من الثلاثة فابدأ بخدمة عادية، وانقلها لاحقاً إذا ثبت أن نمط طلباتها يناسب.
الإصدارات وتقسيم الحركة Traffic Splitting
من أقوى ما في Knative ولم نحتجه في التجارب أعلاه أن كل إصدار ثابت وله اسم، فتستطيع أن توجه نسبة من الحركة إلى إصدار جديد قبل أن تنقل الجميع إليه. وفي المختبر كان عندنا ثلاثة إصدارات: receipt-00001 بال Image الأولى، وreceipt-00002 بعد إصلاح SIGTERM، وreceipt-00003 بعد إصلاح الجسم المقسم، والإصداران الأولان بقيا بصفر نسخ دون أن يأخذا أي ذاكرة. ويشرح توثيق إدارة الحركة كيف تضيف قسم traffic إلى الخدمة، فتجعل مثلاً 90% للإصدار المستقر و10% للجديد، وتعطي الجديد وسماً Tag له عنوان خاص يختبره الفريق مباشرة قبل أن يصله أي مستخدم. وهذا هو النشر التدريجي Canary الذي يحتاج في Kubernetes العادي أداة إضافية، وهنا هو جزء من المنصة.
ولو كان هذا موجوداً في تجربة الجسم المقسم، لكان الإصدار الذي يعطي مجموعاً صفراً قد وصل إلى 10% من الطلبات فقط، ولظهر الفرق في مراقبة محتوى الإجابات قبل أن يصل إلى الجميع. ولكن لاحظ أن هذا يعمل فقط إذا كانت المراقبة تنظر في الشيء الصحيح، فكل مقاييس زمن الاستجابة ورموز الإجابة كانت ستقول إن الإصدار سليم.
مراقبة الدوال Observability
الدالة الصغيرة التي لا يراها أحد هي أصعب شيء في التشخيص، لأنها لا تعمل إلا عندما يطلبها أحد، وقد تكون صفراً عندما تبدأ البحث. ولذلك المراقبة هنا أهم منها في الخدمات العادية. وفي OpenFaaS المراقبة جزء من المنصة نفسها، لأن التوسع يعتمد على Prometheus، وبحسب توثيق المقاييس في OpenFaaS فالبوابة تخرج ثلاثة مقاييس أساسية متاحة في CE: gateway_function_invocation_total بعدد الاستدعاءات لكل دالة ورمز إجابة، وgateway_functions_seconds مدرج تكراري لزمن الاستدعاء، وgateway_service_count بعدد النسخ. وفي Knative تخرج المكونات مقاييسها كما في توثيق مقاييس Serving، ومنها عدد الطلبات وزمنها من queue-proxy لكل إصدار، وقرارات autoscaler.
وما تراقبه لكل دالة هو نفس الإشارات الذهبية التي شرحناها في مقال الإشارات الذهبية، مع إشارتين خاصتين بهذه المنصات: عدد النسخ مقابل الحد الأعلى، لأن الدالة التي وصلت إلى حدها لن تتوسع أكثر مهما زاد الضغط، كما حدث في OpenFaaS CE بحد خمس نسخ، وزمن البدء البارد، لأنه يظهر في p99 فقط ويضيع في المتوسط. وتجمع هذه المقاييس في Prometheus ولوحة Grafana كما في دليل Prometheus مع Grafana.
من يستطيع أن يستدعي الدالة؟ Security
في المختبر استدعينا دالة OpenFaaS من سطر الأوامر عبر /function/receipt دون أي كلمة مرور، والطلب نجح. فكلمة مرور المسؤول في CE تحمي الواجهة وواجهة الإدارة، ولكن استدعاء الدالة نفسها مفتوح لكل من يصل إلى البوابة. ويقول توثيق المصادقة في OpenFaaS إن حماية نقاط الدوال دون كود إضافي جزء من OpenFaaS Pro، أما في CE فحماية كل دالة مسؤوليتها هي، مثل توكن في ترويسة تتحقق منه، أو أن تكون البوابة خلف Reverse Proxy يطلب الدخول.
وفي Knative الوضع الافتراضي أكثر أماناً مما فعلناه: فبحسب توثيق الخدمات الخاصة تستخدم الخدمات النطاق الداخلي .svc.cluster.local افتراضياً، ولا تصبح عامة إلا عندما تضبط نطاقاً للعنقود أو للخدمة، وهذا ما فعلناه عندما ضبطنا shop.lab في config-domain، فأصبحت كل خدمة في العنقود عامة على بوابة Kourier. والطريقة الصحيحة أن تبقي الخدمات الداخلية خاصة بالوسم networking.knative.dev/visibility=cluster-local، ولا تجعل عاماً إلا ما يجب أن يصله أحد من الخارج، مثل استقبال إشعارات بوابة الدفع، ومع هذا تحقق من توقيع كل إشعار داخل الدالة، لأن العنوان العام يصله أي أحد.
أي منصة؟ Decision Table
| وضعك | الأنسب | والسبب |
|---|---|---|
| مهام قليلة صغيرة، ولا يوجد Kubernetes | خدمات عادية في Docker Compose، أو مهام مجدولة | المنصة أغلى من المهام نفسها |
| Kubernetes موجود، ومهام كثيرة متقطعة، وتحتاج التصغير إلى صفر | Knative Serving | صفر وتوسع على التزامن وإصدارات من الإعداد الافتراضي، وApache 2.0 |
| تريد تجربة الفكرة أو التعلم أو مشروعاً شخصياً | OpenFaaS CE | أبسط في البدء وفيه واجهة وأداة faas-cli، ضمن حدود الترخيص |
| فريق تجاري يعجبه أسلوب OpenFaaS ويريد الدعم | OpenFaaS Pro | التصغير إلى صفر والموسع الكامل والدعم، بترخيص مدفوع |
| أحداث من قوائم الرسائل وليس HTTP فقط | Knative Eventing، أو OpenFaaS مع موصلات Connectors | Serving وحده يستقبل HTTP |
| دوال تحتاج إجابة سريعة دائماً | أي منهما مع حد أدنى نسخة واحدة، أو خدمة عادية | البدء البارد كان أكثر من ثانية |
أخطاء شائعة Common Mistakes
- Kubernetes من أجل ثلاث دوال: العقدة وحدها أكثر من جيجابايت، والدالة 15 ميجابايت.
- Python أو Node كعملية أولى دون معالجة SIGTERM: كل تصغير ينتظر 300 ثانية في Knative.
- الاعتماد على Content-Length: البوابة قد ترسل الجسم مقسماً، فتعمل الدالة وتعطي نتائج خاطئة برمز 200.
- اختبار ما بعد النشر على رمز الإجابة فقط: رأينا 200 مع بيانات فارغة.
- OpenFaaS CE في الإنتاج التجاري: الترخيص لا يسمح بعد 60 يوماً، وال Images يجب أن تكون عامة، والحد خمس نسخ.
- فحص حياة يتأثر بالضغط: يقتل النسخة الوحيدة في أسوأ لحظة.
- التصغير إلى صفر لكل شيء: البدء البارد ثانية أو أكثر لكل دالة تفتحها صفحة.
- Registry دون TLS: يحتاج استثناء في كل عقدة، والحل شهادة حقيقية.
- إيقاف فحص cgroup v1 في الإنتاج: الحل نظام حديث بـ cgroup v2، وليس الخيار.
قائمة تحقق Checklist قبل الإنتاج
| البند | كيف تتحقق منه |
|---|---|
| كل دالة تنتهي فوراً مع SIGTERM | حذف Pod يأخذ ثوان وليس دقائق |
| الدالة تقرأ الجسم المقسم | اختبار عبر البوابة نفسها يتحقق من محتوى الإجابة |
| لكل دالة حد ذاكرة وطلب | الجدولة تعمل عندما تزيد النسخ |
| الحد الأدنى للنسخ مقصود | صفر للمهام التي تقبل التأخير، وواحد لما يفتحه المستخدم |
| فحص الحياة لا يمر بالضغط | تجربة ضغط دون إعادة تشغيل للنسخ |
| التوسع مجرب بضغط حقيقي | زمن الوصول إلى العدد المطلوب من النسخ مقيس |
| ال Registry بشهادة TLS | لا يوجد استثناء HTTP في العقد |
| الترخيص مناسب للاستخدام | CE للتجربة فقط، أو Pro، أو Knative |
| الدوال بلا حالة | لا تكتب على قرص ال Pod ما تحتاجه بعد الطلب |
| المراقبة لكل دالة | زمن الاستجابة والأخطاء وعدد النسخ في لوحة |
تدريب عملي Practice
- غير
targetفي خدمة Knative من 10 إلى 2، وأعد تجربة الضغط، وسجل كم نسخة صنع autoscaler وكيف تغير p99. - أضف إلى دالة OpenFaaS فحص حياة على مسار منفصل يجيب من Thread مستقل، وأعد تجربة الضغط، وعد الأخطاء وإعادات التشغيل.
- اضبط
scale-to-zero-pod-retention-periodعلى دقيقتين، وقس البدء البارد بعد دقيقة من آخر طلب ثم بعد ثلاث.
حذف المختبر Cleanup
docker rm -f wr-dp-k3s wr-dp-registry
docker volume rm wr-dp-k3s-data
docker network rm wr-dp-net
docker rmi rancher/k3s:v1.37.2-k3s1 alpine/helm:3.22.1 ghcr.io/openfaas/faas-cli:0.18.18
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- Serverless على سيرفرك تعني أن المطور يسلم دالة والمنصة تتولى التوجيه والتوسع والتصغير إلى صفر، وأنت تدير Kubernetes تحتها، فهي مناسبة للمهام الكثيرة المتقطعة وليست للخدمة التي تعمل طوال اليوم.
- Knative بترخيص Apache 2.0 ومتخرج من CNCF، ويصغر إلى صفر ويتوسع على التزامن من الإعداد الافتراضي، وOpenFaaS CE أبسط ولكنه دون صفر، وبحد خمس نسخ و15 دالة، وتجربة تجارية لمدة 60 يوماً، وImages عامة فقط.
- تحت 50 طلباً متزامناً، توسع Knative إلى ثمان نسخ في 11 ثانية بـ 154.2 طلب في الثانية وp99 أقل من ثانية، وبقي OpenFaaS CE على نسخة واحدة 45 ثانية بـ 67.7 طلب في الثانية و189 خطأ، أغلبها لأن فحص الحياة فشل تحت الضغط.
- التصغير إلى صفر حدث بعد 126 ثانية، والبدء البارد 1.05 ثانية مقابل 32 ميلي ثانية للطلب الدافئ.
- خمس مشكلات حقيقية: kubelet يرفض cgroup v1، وPython يتجاهل SIGTERM فيعلق ال Pod 300 ثانية، وشرط ال Images العامة، وRegistry دون TLS، وجسم مقسم أعطى 200 ببيانات فارغة.
- المنصة أغلى من الدالة: عقدة k3s بنحو 1.39 جيجابايت وKnative 217 ميجابايت، والدالة 15 ميجابايت، فاحسب قبل أن تبني.
وبهذا المقال نكمل مرحلة الأدوات التي تخدم المطورين، من كتالوج الخدمات إلى بيئات التطوير إلى الدوال، والفكرة المشتركة بينها أن المنصة الجيدة تأخذ عن المطور ما لا يحتاج أن يعرفه، ولكنها لا تأخذ عن الفريق مسؤولية فهمها.
 دليلهل تحتاج Kubernetes فعلاً؟ متى يكفي Docker Composeما الذي يحله Kubernetes وما الذي يكلفك، ومتى يكفيك Docker Compose على سيرفر واحد أو بضعة سيرفرات.
 دليلمصطلحات Kubernetes مشروحة بالترتيب، من Pod إلى Ingressشرح مصطلحات Kubernetes بالترتيب الذي يبني بعضها على بعض، مع رسم لكل مفهوم وملفات YAML حقيقية.
 دليلهندسة المنصات Platform Engineering والمشكلة التي تحلهالماذا تبني الشركات منصة داخلية لمطوريها ومتى لا تحتاجها، مع قالب في Backstage ينشئ خدمة جاهزة بخط CI.
 دليلFeature Flags: انشر الكود وفعل الميزة لاحقاًكيف يفصل ال Feature Flag بين نشر الكود وإطلاق الميزة، وكيف تطلقها لجزء من المستخدمين أولاً وتوقفها فوراً إذا تعطلت.
 دليلالإشارات الذهبية Golden Signals: ماذا تقيس في خدمتك؟نضيف القياس إلى خدمة دفع حقيقية ونضغط عليها حتى تنهار، فنرى لماذا انتظر المستخدم ست ثوان والمعالج عند 5% دون خطأ واحد.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة الدليل وتنفيذ المختبر على k3s v1.37.2+k3s1 داخل Docker، وKnative Serving 1.24.0 مع Kourier 1.24.0، وOpenFaaS CE بمخطط Helm 15.0.14 (البوابة 0.27.14 مع faas-netes 0.18.17) وfaas-cli 0.18.18، وPython 3.13، وDocker Engine 29.8.0.


