تثبت أداة مفتوحة المصدر لفريقك، وتفتح الإعدادات وتختار العربية، فتظهر القوائم بالعربية وتطمئن أن المشكلة انتهت، ثم يكتب أحد الزملاء في مربع البحث «اجازة» دون همزة فلا يجد صفحة «إجازة الموظفين» التي كتبها هو بنفسه قبل أسبوع، ويفتح آخر الأداة فيجد زر «Remember me» بالإنجليزية في وسط صفحة عربية، وثالث يرى حجم الملف مكتوباً «KB 1 >» بدل «أقل من 1 KB». وهذه ليست أخطاء نادرة، وإنما هي ما يحدث عادة عندما نعامل دعم العربية كخيار واحد في القائمة، بينما هو في الواقع عدة طبقات مستقلة، قد تنجح الأداة في واحدة منها وتفشل في أخرى.
وهذا المقال في مرحلة ما المصادر المفتوحة وكيف تعمل، وهو عملي: سوف نشغل ثلاث أدوات مشهورة تستضيفها الفرق بنفسها في Docker، ونحولها للعربية، ونأخذ صوراً حقيقية من واجهاتها، ونبحث فيها بنفس الكلمات بأشكال كتابة مختلفة، ثم نضع لكل أداة درجة في جدول واحد. وسوف نناقش في هذا المقال ما يلي:
- الطبقات الأربع لدعم العربية: الترجمة والاتجاه والبحث والخط مع الأرقام والتواريخ.
- كيف تصل الجملة العربية إلى الواجهة عبر منصات الترجمة Weblate وCrowdin وTransifex، ولماذا تبقى جمل إنجليزية.
- نسبة الترجمة العربية في تسعة مشاريع مشهورة، عددناها بأنفسنا من ملفات اللغة.
- الاتجاه من اليمين لليسار RTL، وما الذي يجب أن ينعكس في الواجهة.
- البحث العربي: الهمزات والتاء المربوطة والألف المقصورة والتشكيل و«ال»، وأربع طرق تطابق بها الأدوات الكلمات.
- الخطوط وطريقة عرض الأرقام والتواريخ.
- تجربة عملية على Nextcloud وBookStack وForgejo وPostgreSQL، وجدول النتيجة، ثم قائمة تحقق قبل أن تعتمد أداة لفريق عربي.
ولن نعيد هنا شرح خوارزمية النص ثنائي الاتجاه، فقد شرحناها في مقال التعريب i18n للمطورين، ولا ضبط محركات البحث المتخصصة، فقد قسناه بالأرقام في مقال البحث في النصوص العربية، وإنما نركز على ما يراه مدير النظام والمستخدم عندما يختار العربية في أداة جاهزة.
ماذا يعني دعم العربية Arabic Support في أداة؟
عندما يكتب مشروع في صفحته أنه «يدعم العربية» فهو غالباً يقصد أن هناك ملف ترجمة عربي، وهذا الجزء الأول فقط، وحتى تكون الأداة صالحة لفريق يعمل بالعربية يجب أن تنجح في أربع طبقات مستقلة عن بعضها، وكل طبقة يعمل عليها أشخاص مختلفون في المشروع:
- الترجمة Translation: نصوص الأزرار والقوائم ورسائل الخطأ والبريد الذي ترسله الأداة، ويعمل عليها متطوعون في منصة ترجمة.
- الاتجاه RTL: أن تنعكس الواجهة كلها من اليمين لليسار، فتنتقل القائمة الجانبية لليمين وتنقلب الأسهم ويبدأ النص من اليمين، ويعمل عليها مطورو الواجهة.
- البحث Search: أن يجد المستخدم الكلمة مهما اختلفت كتابتها، وهذا عمل من يكتب طبقة البحث وقاعدة البيانات.
- الخط والأرقام والتاريخ: أن يظهر الحرف العربي بخط مقروء، وأن تعرض الأرقام والتواريخ بشكل متسق حسب إعداد المنطقة Locale.
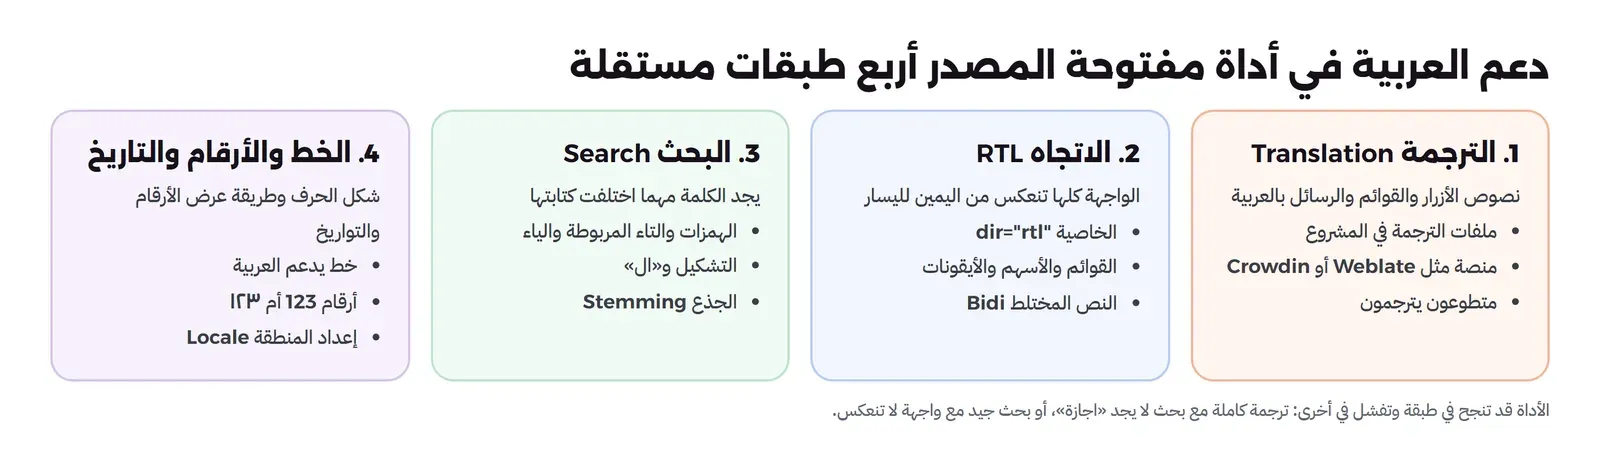
لاحظ أن هذه الطبقات لا يعتمد بعضها على بعض، فقد تجد أداة مترجمة بالكامل لكن واجهتها تبقى من اليسار لليمين، وأخرى تنعكس بشكل ممتاز لكن بحثها لا يعرف أن «اجازة» و«إجازة» كلمة واحدة، وسوف نرى الحالتين في التجربة، لذلك لا تقم بالحكم على أداة من صفحة الدخول فقط، والسبب أن صفحة الدخول هي أكثر صفحة يراها المترجمون فتكون غالباً أفضل ما في الأداة.
الترجمة Translation: كيف تصل الجملة العربية إلى الواجهة؟
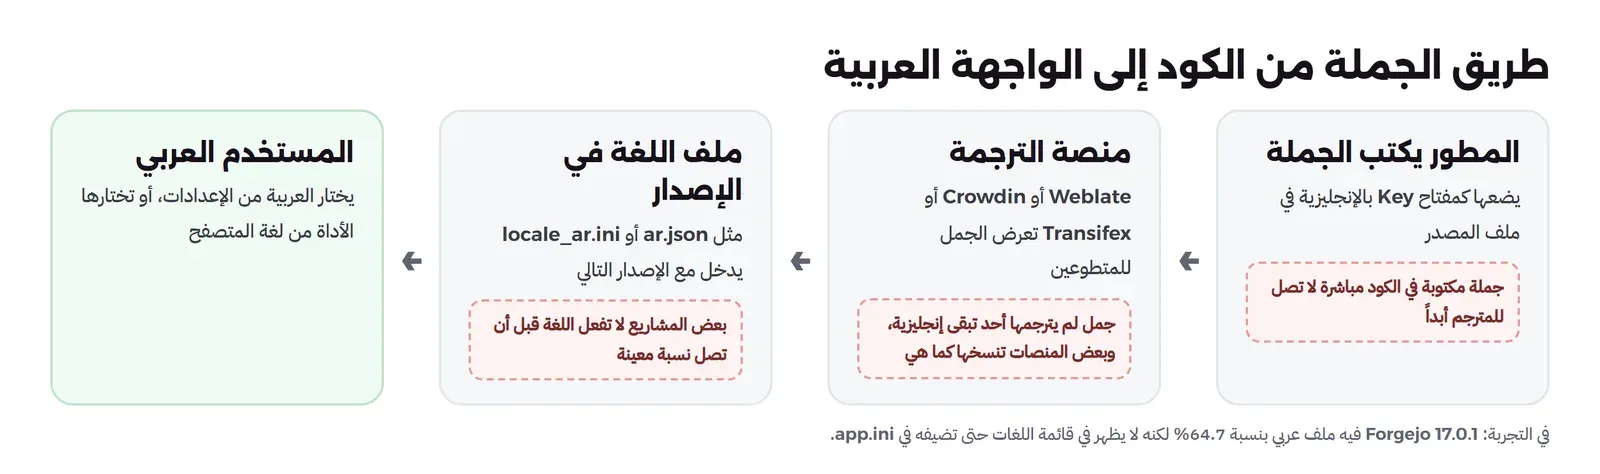
المطور لا يكتب نص الزر في الكود مباشرة، وإنما يكتب مفتاحاً Key ونصاً إنجليزياً أصلياً، مثل مفتاح login.remember_me ونصه «Remember me»، ثم تجمع أداة في المشروع كل هذه المفاتيح في ملف مصدر واحد، وهذا الملف يرفع إلى منصة ترجمة يدخل إليها المتطوعون من كل اللغات، فيرى المترجم العربي الجملة الإنجليزية ويكتب مقابلها، وعند الإصدار التالي تسحب المنصة الترجمات وتضعها في ملفات اللغة داخل المستودع، مثل ar.json أو locale_ar.ini أو ملفات .po بنظام gettext، ثم تقرأها الأداة عندما يختار المستخدم العربية.
منصات الترجمة الثلاث: Weblate وCrowdin وTransifex
أغلب المشاريع الكبيرة تستخدم واحدة من ثلاث منصات، ومعرفة المنصة التي يستخدمها مشروعك تفيدك في أمرين: أن تعرف نسبة الترجمة العربية قبل التثبيت، وأن تعرف أين تصحح ترجمة خاطئة إذا أردت المساهمة:
| المنصة | نوعها | أمثلة من المشاريع |
|---|---|---|
| Weblate | مفتوحة المصدر، ويمكن استضافتها ذاتياً | Forgejo على خادم Codeberg، وMattermost وJellyfin وUptime Kuma على خوادمها، وImmich على الخدمة المستضافة |
| Crowdin | خدمة تجارية مجانية للمشاريع المفتوحة | BookStack وBitwarden |
| Transifex | خدمة تجارية | Nextcloud |
والفرق المهم بينها لمن يدير الأداة ليس في الواجهة، وإنما في طريقة تصدير الجمل التي لم يترجمها أحد، فبعض المشاريع لا تضع الجملة في الملف العربي أصلاً فتعرض الأداة النص الإنجليزي بدلاً منها، وبعضها ينسخ النص الإنجليزي في الملف العربي كما هو، فيبدو الملف كاملاً عند العد وهو ليس كذلك، وهذا ما سوف نراه في Bitwarden بعد قليل.
لماذا تظهر جمل إنجليزية داخل واجهة عربية؟
عندما ترى جملة إنجليزية في واجهة اخترت لها العربية، فالسبب غالباً واحد من أربعة، وكل سبب له حل مختلف:
- جملة لم يترجمها أحد بعد: موجودة في منصة الترجمة لكن لا يوجد متطوع عربي وصل إليها، والحل أن تترجمها بنفسك في المنصة، وتظهر في الإصدار التالي.
- جملة مكتوبة في الكود مباشرة Hardcoded: لم يضعها المطور كمفتاح، فلا تظهر في المنصة أصلاً، والحل بلاغ Issue في المشروع وليس ترجمة.
- جملة جديدة في إصدار حديث: كل إصدار يضيف جملاً، والترجمة تتأخر عنه، لذلك قد تنخفض النسبة بعد الترقية ثم ترتفع.
- إضافة Plugin أو تطبيق داخلي له ملفات ترجمة منفصلة: في Nextcloud مثلاً لكل تطبيق داخلي ملفاته، فقد يكون تطبيق الملفات مترجماً وتطبيق آخر لا.
صيغ الجمع Plurals: لماذا تحتاج العربية ست صيغ؟
هناك مشكلة رئيسية في ترجمة أي واجهة للعربية لا تظهر في الإنجليزية، وهي العدد، فالإنجليزية لها صيغتان فقط، «1 file» و«2 files»، أما العربية فلها ست صيغ حسب قواعد Unicode CLDR: صفر، وواحد، واثنان، ومن ثلاثة إلى عشرة، ومن أحد عشر إلى تسعة وتسعين، وما بعدها، فنقول «ملف واحد» و«ملفان» و«ثلاثة ملفات» و«أحد عشر ملفاً». ولذلك يجب أن يكون نظام الترجمة في الأداة يعرف قاعدة الجمع العربية، وأن يملأ المترجم الصيغ الست كلها، وإلا ظهرت جمل مثل «ملفات 2» التي شرحنا سببها في قسم صيغ الجمع في مقال التعريب.
وفي التجربة فتحنا ملف اللغة العربي لتطبيق الملفات داخل Nextcloud 34.0.6، فوجدنا أن قاعدة الجمع فيه مكتوبة بشكل صحيح بست صيغ nplurals=6، ووجدنا فيه خمس جمل لها صيغ جمع، كلها مملوءة بالصيغ الست، لكن المثال الأول منها، وهو عدد العناصر المحددة، فيه نفس النص في الصيغ الست: {count} تمّ تحديده. أي أن النظام جاهز، لكن المترجم وضع جملة واحدة تصلح لكل الأعداد بدل ست جمل، وهذا حل عملي يتجنب الخطأ النحوي الواضح، لكنه يعطي عبارة جامدة مثل «5 تم تحديده». والدرس لمن يقيم أداة أن صيغ الجمع لا تظهر في نسبة الترجمة، فالجملة محسوبة مترجمة سواءً كتب المترجم صيغة واحدة أو ستاً، لذلك افتح صفحة فيها أعداد مختلفة وانظر كيف تقرأ.
نسبة الترجمة العربية في تسعة مشاريع مشهورة
بدل الاعتماد على عبارة «يدعم العربية» قمنا بالعد بأنفسنا في 16 نوفمبر 2026، فأخذنا ملف اللغة الإنجليزية الأصلي وملف اللغة العربية من المستودع الرسمي لكل مشروع، وعددنا المفاتيح في الملف الإنجليزي، ثم عددنا منها المفاتيح التي قيمتها في الملف العربي تحتوي حروفاً عربية فعلاً، وليس فقط المفاتيح الموجودة، والسبب أن بعض المنصات تنسخ النص الإنجليزي في الملف العربي كما ذكرنا. وفي Mattermost أخذنا الرقم من واجهة API لمنصة Weblate الخاصة بالمشروع، وفي BookStack وForgejo عددنا من الإصدار الذي شغلناه في التجربة.
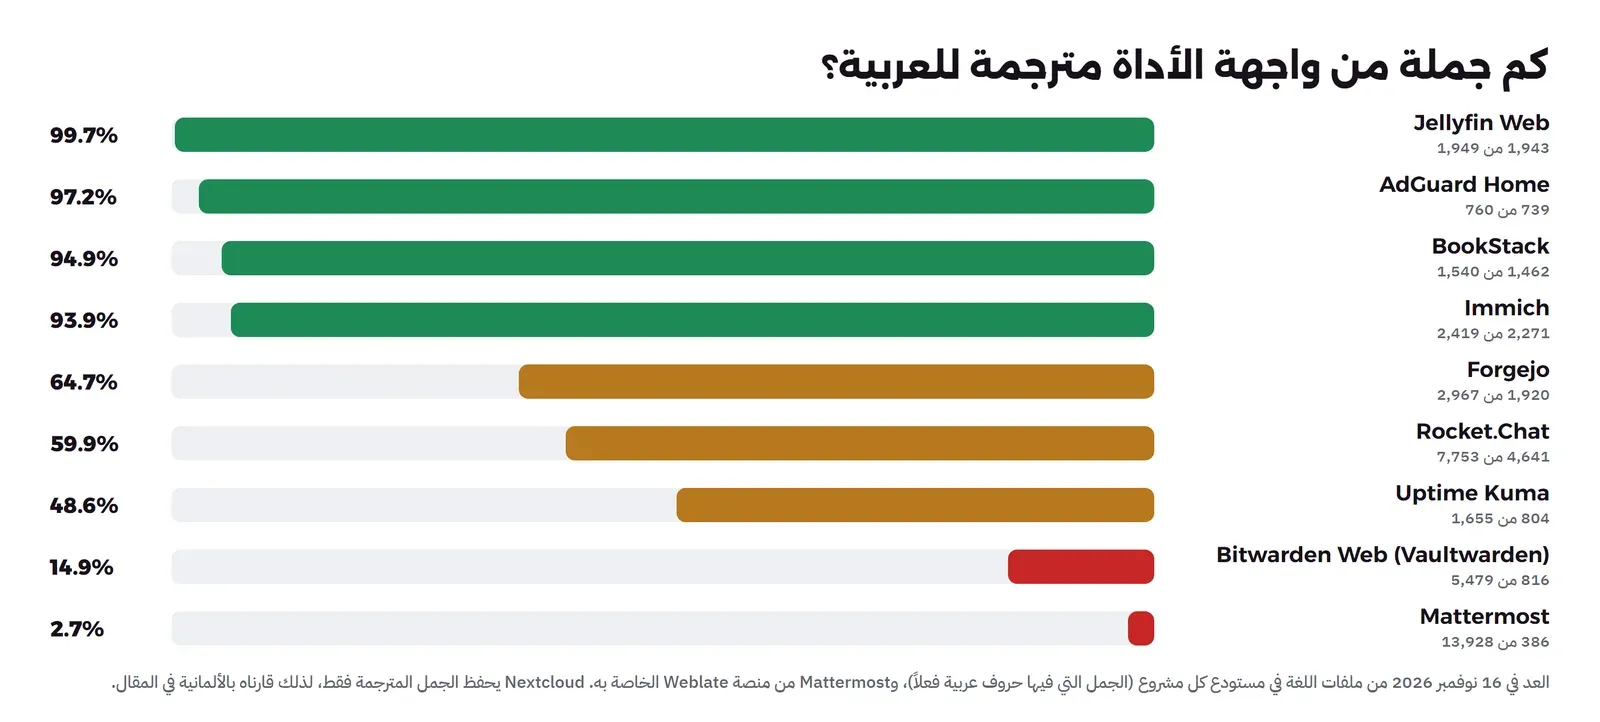
في الأرقام أعلاه لاحظ التالي:
- أربعة مشاريع فوق 90%: Jellyfin وAdGuard Home وBookStack وImmich، وفي هذه المشاريع لن ترى جملة إنجليزية إلا نادراً، وفي Immich قرأنا أيضاً واجهة Weblate فأعطت 93.8%، وهو قريب جداً من عدنا 93.9%، مما يطمئن أن طريقة العد صحيحة.
- Bitwarden Web هو المفاجأة: الملف العربي فيه 5,479 مفتاحاً مثل الإنجليزي تماماً، فيبدو كاملاً، لكن 4,650 منها نص إنجليزي منسوخ كما هو، والمترجم فعلاً 816 جملة فقط، أي 14.9%. وهذه الواجهة نفسها هي التي يعرضها Vaultwarden لمستخدميه، فإذا كنت تخطط لتقديمه لفريق لا يقرأ الإنجليزية فاعرف هذا مسبقاً.
- Mattermost شبه خال من العربية: 386 جملة من 13,928 أي 2.7%، بينما الفارسية في نفس المنصة 49.8% والألمانية 88.4%، فإذا كانت العربية شرطاً لأداة المحادثة عندك فقارن مع Rocket.Chat الذي وصل إلى 59.9%.
- Forgejo عند 64.7%: وفيه قصة أخرى، فرغم وجود الملف العربي لا تظهر العربية في قائمة اللغات أصلاً، وسوف نصل لها في التجربة.
أما Nextcloud فلا يمكن حسابه بنفس الطريقة، والسبب أن ملفات اللغة فيه تحفظ الجمل المترجمة فقط ولا تحفظ النص الأصلي، لذلك قارنا عدد الجمل العربية بعدد الجمل الألمانية، والألمانية من أكمل اللغات فيه، داخل الإصدار 34.0.6 نفسه: الأساسيات core عند 64% من الألمانية، وتطبيق الملفات 76%، والإعدادات 80%، والمشاركة 88%. وهذا يفسر لماذا ستجد الواجهة الرئيسية عربية في أغلبها، ومعها جمل إنجليزية متفرقة.
الاتجاه من اليمين لليسار RTL: ما الذي يجب أن ينعكس؟
الترجمة تغير الكلمات، أما الاتجاه فيغير شكل الصفحة كلها، وأول ما تحتاجه الواجهة أن تضع الخاصية dir="rtl" على عنصر الصفحة عندما تكون اللغة عربية، كما في توثيق الخاصية dir، وبعد ذلك يجب أن يكون التصميم مكتوباً بالخصائص المنطقية Logical Properties في CSS، مثل margin-inline-start بدل margin-left، حتى ينعكس كل شيء تلقائياً، كما في توثيق الخصائص المنطقية. وإذا كتب المطورون التصميم بالاتجاهات الثابتة يميناً ويساراً فسوف تحصل على ترجمة عربية فوق صفحة إنجليزية الشكل، وهذا ما رأيناه في Forgejo.
وما يجب أن ينعكس في الواجهة العربية:
- القائمة الجانبية تنتقل لليمين، والمحتوى يبدأ من اليمين.
- أسهم الرجوع والتقدم، فالسهم «التالي» يشير لليسار في العربية.
- ترتيب الأعمدة في الجداول، فعمود الاسم يكون الأول من اليمين.
- مكان مربع الاختيار Checkbox بجانب النص، ويكون على يمين النص.
وما لا ينعكس: الشعارات، وأيقونات التشغيل في مشغل الفيديو، والأرقام، والكود، وأسماء الملفات اللاتينية، وقد فصلنا هذه القواعد مع أمثلة من التصميم في مقال تصميم الواجهات العربية RTL. والمشكلة الأصعب هنا هي النص المختلط، مثل اسم ملف عربي ينتهي بامتداد .txt أو حجم ملف فيه رقم ووحدة إنجليزية، فهذه تعتمد على خوارزمية Unicode للنص ثنائي الاتجاه Bidi، ويجب أن يعزل المطور كل قيمة مستقلة حتى لا تنقلب، وسوف نرى مثالين حقيقيين في Nextcloud.
البحث Search: لماذا لا تجد الأداة «اجازة»؟
الكلمة العربية تكتب بأشكال كثيرة لها نفس المعنى، فالمستخدم يكتب «اجازة» دون همزة والمستند فيه «إجازة»، أو يكتب «المدرسه» بالهاء والمستند فيه «المدرسة» بالتاء المربوطة، أو «مستشفي» بالياء والمستند فيه «المستشفى» بالألف المقصورة، أو يكتب «ملخص» والعنوان منسوخ من مصدر رسمي بالتشكيل. وفوق ذلك «ال» والواو والجمع ملتصقة بالكلمة نفسها، فكلمة «المستشفى» عند البرنامج سلسلة حروف مختلفة عن «مستشفى». وقد شرحنا هذه الأشكال بالتفصيل في مقال معالجة اللغة العربية.
ومحرك البحث الذي يفهم العربية يعالج هذا في مرحلتين: التوحيد Normalization، أي تحويل الأشكال المختلفة لنفس الحرف، مثل أ وإ وآ إلى ا، وحذف التشكيل. ثم الجذع Stemming، أي حذف الزوائد مثل «ال» والواو وعلامات الجمع للوصول إلى أصل الكلمة. والسؤال لمن يختار أداة جاهزة: هل يفعل بحث الأداة أياً من هذا؟ والإجابة أن أغلب الأدوات لا تستخدم محرك بحث متخصصاً، وإنما تبحث في قاعدة البيانات بطريقة من أربع:
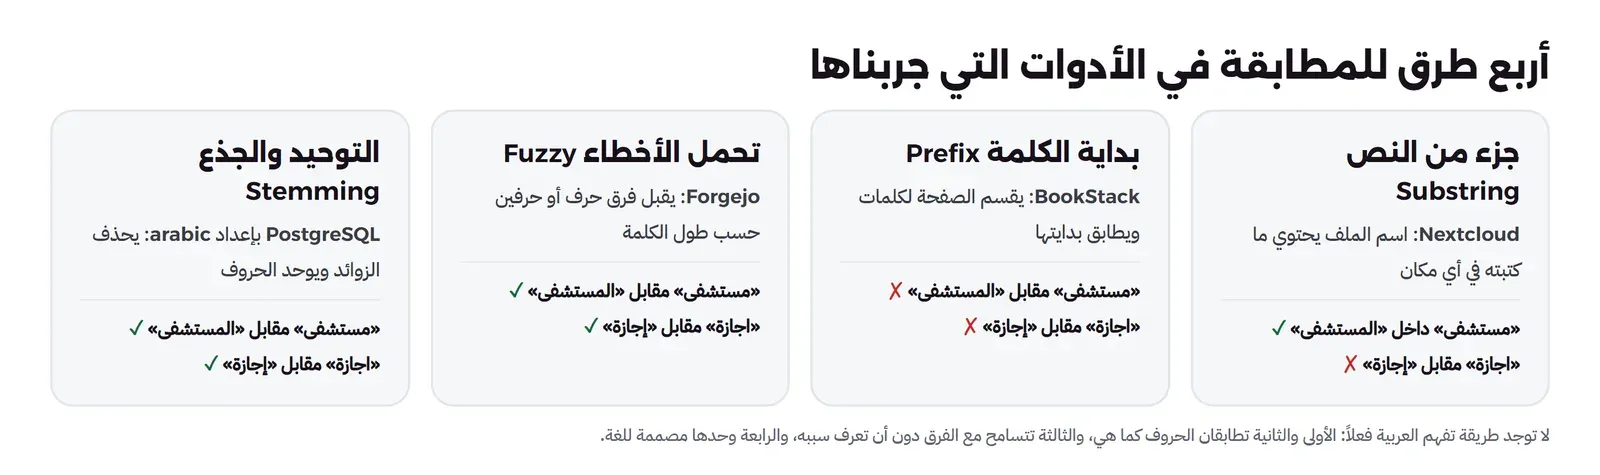
- جزء من النص Substring: يبحث عن الحروف التي كتبتها في أي مكان من الاسم، وفي Nextcloud رأينا في الكود أنه يستخدم مقارنة
iLikeعلى اسم الملف. فيجد «مستشفى» داخل «المستشفى»، لكنه لا يعرف أن الهمزة اختيارية. - بداية الكلمة Prefix: يقسم النص إلى كلمات ويحفظها في جدول، ثم يبحث عن الكلمات التي تبدأ بما كتبته، كما في BookStack الذي يستخدم
term LIKE 'x%'. فإذا كتبت «مستشفى» لا يجد «المستشفى»، لأن الكلمة المحفوظة تبدأ بـ«ال». - تحمل الأخطاء Fuzzy: يقبل اختلافاً في حرف أو حرفين حسب طول الكلمة، كما في Forgejo الذي يستخدم مكتبة Bleve. فيجد «اجازة» لأنها تختلف عن «إجازة» بحرف واحد، دون أن يعرف أن الفرق همزة.
- التوحيد والجذع: يحول الكلمة إلى أصلها قبل المقارنة، كما في PostgreSQL بإعداد
arabic، وهي الطريقة الوحيدة المصممة للغة، لكن لها مشكلاتها كما سنرى.
وإذا كان البحث مهماً في أداتك، كأرشيف وثائق أو قاعدة معرفة، فأغلب الأدوات تسمح بربط محرك بحث خارجي، مثل تطبيق Full Text Search في Nextcloud الذي يرسل المحتوى إلى Elasticsearch، وعندها تضبط المحلل العربي Arabic Analyzer كما شرحنا في مقال البحث في النصوص العربية، وهناك رفع المحلل العربي نسبة النتائج الصحيحة في تجربتنا من 0.30 إلى 0.74 بتغيير واحد.
الخطوط Fonts والأرقام والتواريخ
أغلب الأدوات المفتوحة لا تحمل خطاً عربياً خاصاً بها، وإنما تعتمد على قائمة خطوط النظام System Font Stack، وفي التجربة قرأنا الخط المستخدم في الصفحة من المتصفح فوجدنا أن Nextcloud يبدأ بـ system-ui ثم Segoe UI وRoboto وNoto Sans، وBookStack وForgejo يبدآن بخطوط أنظمة Apple ثم Segoe UI. وهذا يعني أن شكل الحرف العربي يعتمد على جهاز المستخدم، فعلى Windows يظهر بخط Segoe UI وهو مقبول، أما على توزيعة Linux لم يثبت فيها خط عربي فقد يظهر بخط بديل غير مريح للقراءة الطويلة، والحل على الجهاز وليس في الأداة: ثبت خطاً مثل Noto Sans Arabic، أو استخدم خاصية الخط المخصص Custom CSS إذا كانت الأداة تسمح بها.
أما الأرقام والتواريخ فتعتمد على إعداد المنطقة Locale وليس على اللغة فقط، فإعداد ar_SA مثلاً يعرض الأرقام العربية الهندية ١٢٣ في كثير من المكتبات، وإعداد ar وحده قد يعرض الأرقام الغربية 123، وكلاهما صحيح، والمشكلة فقط عندما تختلط في نفس الصفحة، كما سنرى في Nextcloud حيث ظهر حجم الملف بأرقام عربية هندية والوقت بجانبه بأرقام غربية. ومصدر هذه القواعد عند أغلب المكتبات هو قاعدة Unicode CLDR، وقد شرحنا كيف تنسق الأرقام والتواريخ والتقويم الهجري برمجياً في مقال التعريب i18n.
التجربة العملية Lab: ثلاث أدوات بالعربية في Docker
اخترنا ثلاث أدوات تستضيفها الفرق كثيراً، ومن ثلاثة أنواع مختلفة: Nextcloud للملفات، وBookStack للتوثيق، وForgejo لإدارة الكود والمهام، ومعها PostgreSQL للمقارنة لأن كثيراً من الأدوات تبني بحثها عليه. وسوف نقوم بالتالي لكل أداة: نشغلها، ونحولها للعربية، ونأخذ صورة من واجهتها، ثم نضع فيها نفس العناوين الأربعة ونبحث بنفس الأسئلة الاثني عشر. وكل الأوامر تعمل على أي جهاز عليه Docker، والأدوات مع قواعد بياناتها تحتاج أقل من 1 GB من الذاكرة.
تشغيل الأدوات الثلاث
الأوامر التالية تنشئ شبكة واحدة، ثم تشغل Nextcloud بقاعدة SQLite حتى لا نحتاج قاعدة بيانات منفصلة، وBookStack مع MariaDB، وForgejo بقاعدة SQLite:
docker network create oss7-net

docker run -d --name oss7-nc --network oss7-net -p 9531:80 \
  -e SQLITE_DATABASE=nc -e NEXTCLOUD_ADMIN_USER=admin -e NEXTCLOUD_ADMIN_PASSWORD=Lab-Pass-2026x \
  -e NEXTCLOUD_TRUSTED_DOMAINS="localhost oss7-nc" nextcloud:34.0.6-apache

docker run -d --name oss7-bsdb --network oss7-net -e MARIADB_ROOT_PASSWORD=rootpw \
  -e MARIADB_DATABASE=bookstack -e MARIADB_USER=bookstack -e MARIADB_PASSWORD=bspw mariadb:12.3.3

docker run -d --name oss7-bs --network oss7-net -p 9532:80 -e PUID=1000 -e PGID=1000 -e TZ=Asia/Riyadh \
  -e APP_URL=http://localhost:9532 -e APP_KEY="base64:$(head -c 32 /dev/urandom | base64)" \
  -e DB_HOST=oss7-bsdb -e DB_PORT=3306 -e DB_USERNAME=bookstack -e DB_PASSWORD=bspw -e DB_DATABASE=bookstack \
  lscr.io/linuxserver/bookstack:v26.09.3-ls297

docker run -d --name oss7-fj --network oss7-net -p 9533:3000 \
  -e FORGEJO__security__INSTALL_LOCK=true -e FORGEJO__server__ROOT_URL=http://localhost:9533/ \
  -e FORGEJO__database__DB_TYPE=sqlite3 codeberg.org/forgejo/forgejo:17.0.1-rootless
في الأوامر أعلاه لاحظ التالي:
- متغيرات
NEXTCLOUD_ADMIN_*تجعل Nextcloud يكمل التثبيت وحده دون صفحة الإعداد، وقد شرحنا التثبيت الكامل للإنتاج في دليل تثبيت Nextcloud. - صورة BookStack من LinuxServer تحتاج المفتاح
APP_KEY، ونولده عشوائياً في نفس الأمر، والتثبيت الكامل في دليل BookStack. - المتغير
INSTALL_LOCK=trueفي Forgejo يتخطى صفحة التثبيت، وكل متغير يبدأ بـFORGEJO__يكتب في ملف الإعدادapp.iniعند التشغيل.
بعد دقيقة تقريباً نتأكد أن الثلاثة تعمل:
for p in 9531 9532 9533; do curl -s -o /dev/null -w "$p %{http_code}\n" http://localhost:$p/; doneوالمخرج سوف يكون كما يلي:
9531 302
9532 302
9533 200
الرمز 302 في Nextcloud وBookStack تحويل إلى صفحة الدخول، والرمز 200 في Forgejo صفحة البداية، وكلها تعني أن الخدمة جاهزة.
Nextcloud: العربية بأمر واحد
Nextcloud يختار اللغة من المتصفح تلقائياً، لكن الأفضل أن تحددها للمستخدم وللخادم حتى لا تعتمد على جهاز كل شخص، وذلك بالأداة occ التي تأتي معه:
O(){ docker exec -u www-data oss7-nc php occ "$@"; }
O user:setting admin core lang ar
O user:setting admin core locale ar_SA
O config:system:set default_language --value=ar
O config:system:set default_locale --value=ar_SA
والمخرج سوف يكون كما يلي:
System config value default_language set to string ar
System config value default_locale set to string ar_SA
الأمران الأولان لا يطبعان شيئاً، فهما يحفظان لغة المستخدم admin ومنطقته، والأمران الأخيران يجعلان العربية الافتراضية لكل مستخدم جديد. ولاحظ الفرق بين lang وهي لغة النصوص، وlocale وهي طريقة عرض الأرقام والتواريخ وأول يوم في الأسبوع، وسوف نرى أثر الثانية بعد قليل.
الآن نضع البيانات، فالسكربت lab/seed.mjs يرفع إلى Nextcloud أربعة ملفات نصية عبر WebDAV بأسماء عربية، وينشئ في BookStack كتاباً فيه أربع صفحات، وفي Forgejo مستودعاً فيه أربع مهام Issues، وكلها بنفس العناوين الأربعة، ومنها عنوان مشكول عمداً:
const TITLES = ['إجازة الموظفين 2026', 'تقرير المستشفى السنوي', 'أسعار المدرسة الجديدة', 'مُلَخَّص الاجتماع الأول'];لكن قبل تشغيل السكربت نحتاج حساباً في Forgejo ومفتاح API في BookStack، فننتظر بهما حتى نصل لكل أداة، والسكربت كاملاً في مجلد المختبر. وبعد تشغيله فتحنا Nextcloud في متصفح Chrome بلغة عربية، فكانت الواجهة كما يلي:
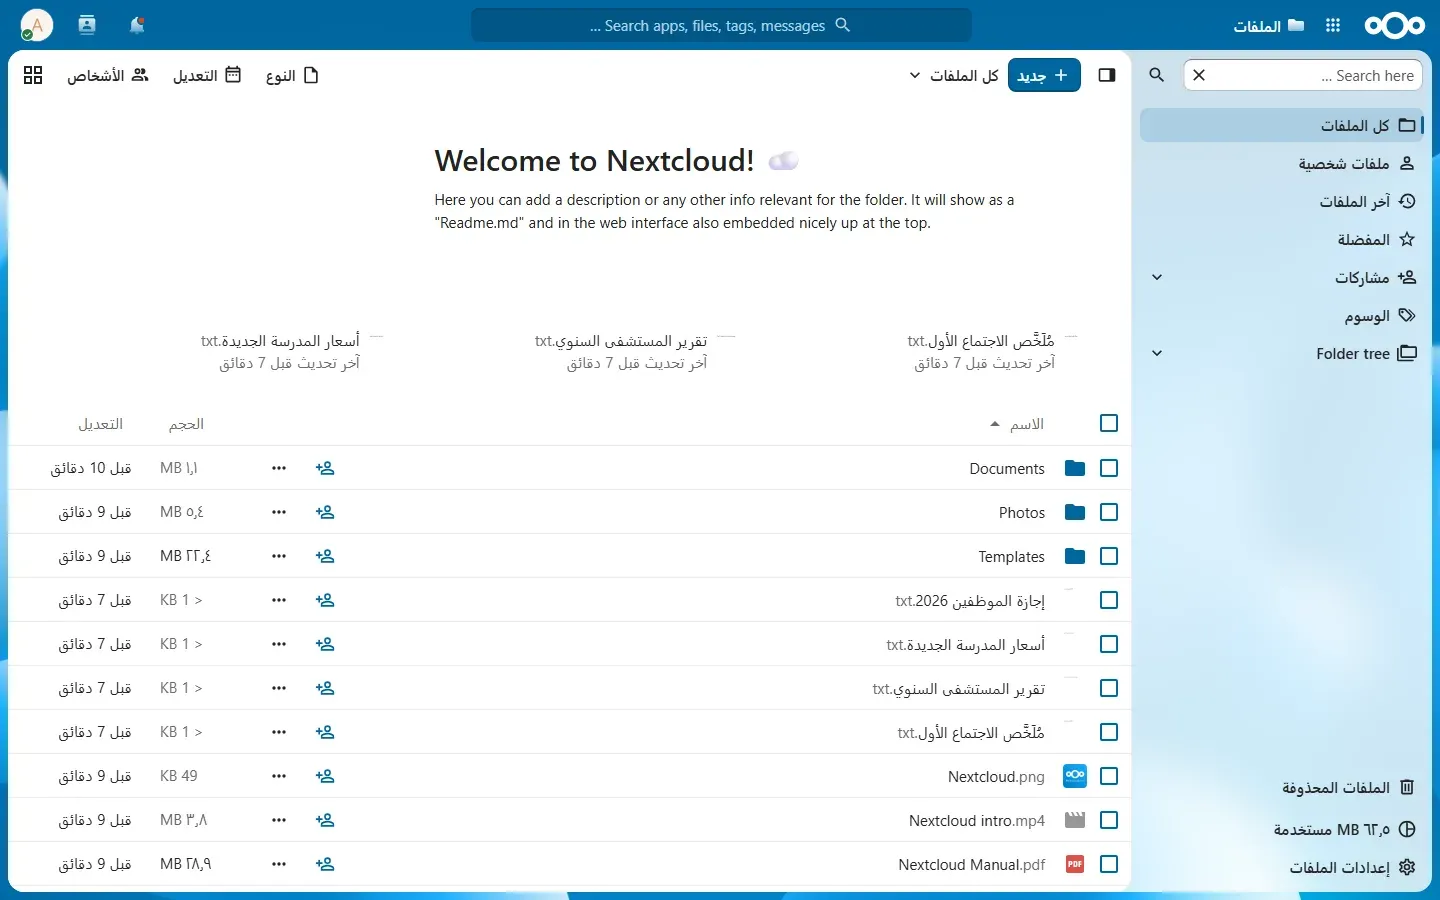
في الصورة أعلاه لاحظ التالي:
- الانعكاس كامل: القائمة الجانبية على اليمين، وعمود الاسم أول الأعمدة من اليمين، ومربعات الاختيار على يمين الأسماء، وهذا أفضل ما في Nextcloud للعربية.
- جمل إنجليزية ظاهرة: نص مربع البحث العلوي «Search apps, files, tags, messages»، ومربع البحث في القائمة «Search here»، وعنصر «Folder tree»، وهذه من النسبة الناقصة التي حسبناها في الأساسيات وتطبيق الملفات.
- خطأ في النص ثنائي الاتجاه: حجم الملفات الصغيرة ظهر «KB 1 >» والمقصود «أقل من 1 KB»، فالعلامة < انعكست وانتقلت لطرف آخر، لأن القيمة لم تعزل عن النص العربي حولها، وهذا المثال الذي يتكرر في قسم العزل Isolation في مقال التعريب.
- أرقام مختلطة في نفس الصف: الحجم بأرقام عربية هندية مثل «MB ٣٣،٤» لأن المنطقة ar_SA، والوقت بجانبه «قبل 10 دقائق» بأرقام غربية، لأن جملة الوقت تأتي من مكتبة أخرى لا تقرأ نفس الإعداد.
وفي صفحة الدخول تظهر نفس الملاحظة على مستوى أصغر:
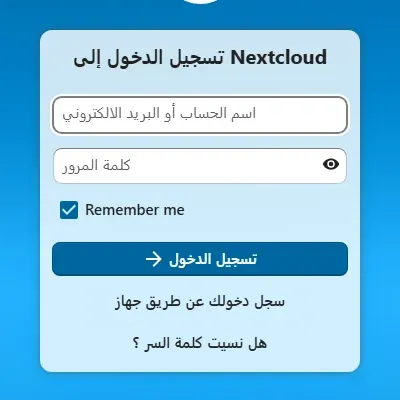
الحقول مترجمة ومحاذاتها صحيحة لليمين، لكن خيار «Remember me» بقي بالإنجليزية، ومربعه في اليسار، فهذه الجملة لا تمر على نظام الترجمة أصلاً أو لم تترجم بعد، وفي الحالتين لا يمكن إصلاحها من الإعدادات.
BookStack: ترجمة شبه كاملة
BookStack يحفظ لغة كل مستخدم في إعداداته، فتغيرها من صفحة «My Account» ثم «Preferences»، وفي التجربة وضعناها مباشرة في قاعدة البيانات للمستخدم الأول، وأنشأنا مفتاح API حتى يتمكن سكربت البيانات من إنشاء الصفحات، وكلمة السر في جدول المفاتيح تحفظ بخوارزمية bcrypt فنولدها من PHP داخل الـ Container:
docker exec oss7-bsdb mariadb -ubookstack -pbspw bookstack -e \
  "INSERT INTO settings (setting_key,value,created_at,updated_at,type) VALUES ('user:1:language','ar',NOW(),NOW(),'string');"

H=$(docker exec oss7-bs php -r 'echo password_hash("labsecret123", PASSWORD_BCRYPT);')
docker exec oss7-bsdb mariadb -ubookstack -pbspw bookstack -e \
  "INSERT INTO api_tokens (name,token_id,secret,user_id,expires_at,created_at,updated_at)
   VALUES ('lab','labtokenid','$H',1,'2027-12-31',NOW(),NOW());"
هذه طريقة مختصرة للمختبر فقط، وفي سيرفر حقيقي أنشئ المفتاح من صفحة المستخدم في الواجهة، والسبب أن الإدخال المباشر في الجداول يتجاوز التحقق الذي تفعله الأداة. وبعد تشغيل seed.mjs فتحنا الكتاب:
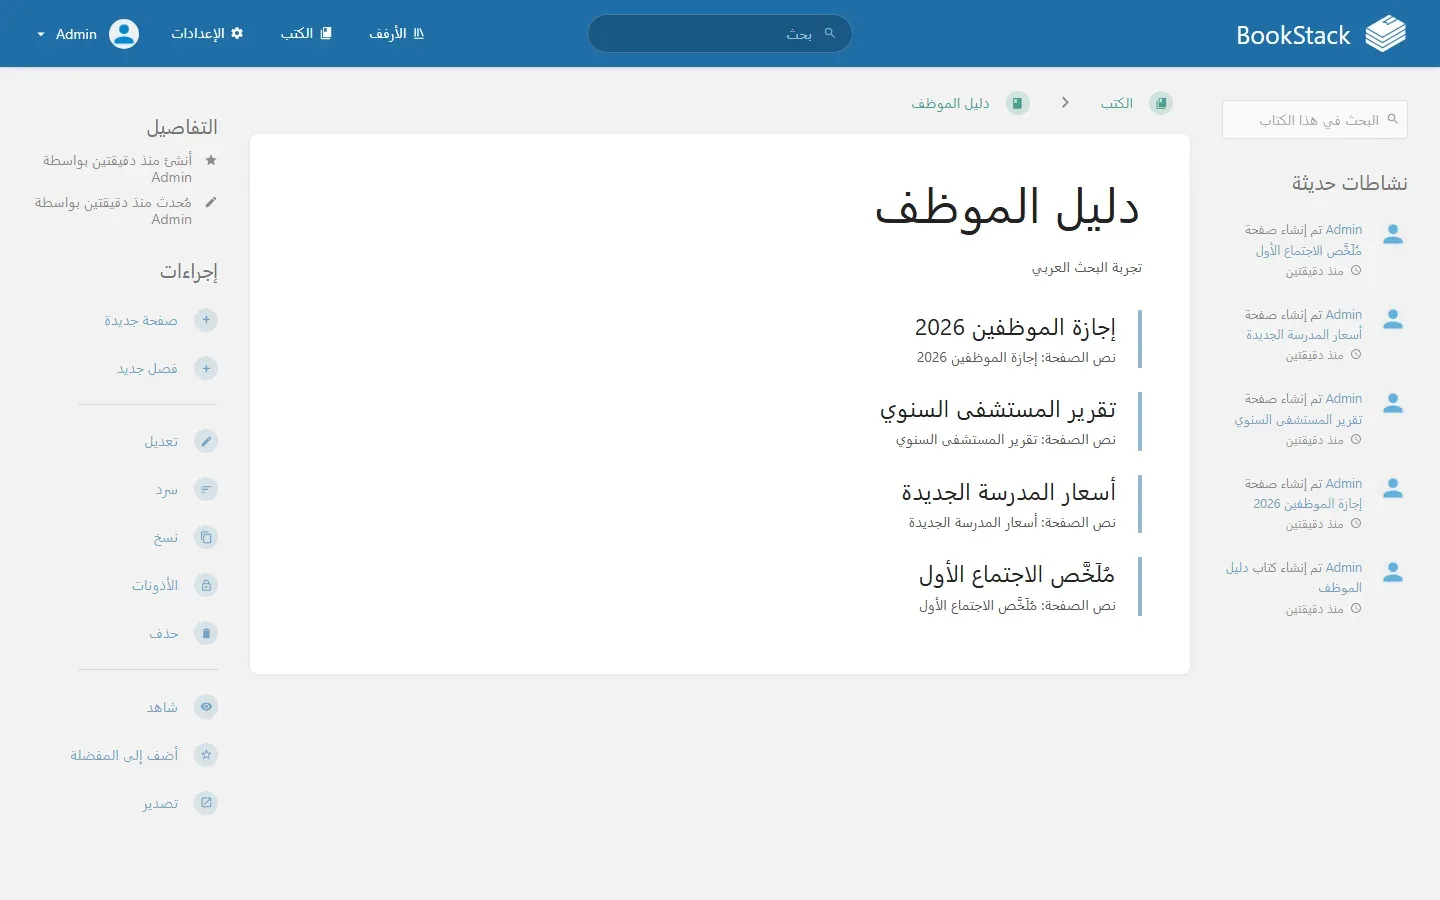
هنا الصورة أفضل بكثير: الصفحة منعكسة بالكامل، والقوائم والإجراءات كلها عربية، والتواريخ النسبية مثل «منذ دقيقتين» صحيحة لغوياً، وهذا يتفق مع النسبة التي عددناها من ملفات اللغة في نفس الإصدار: 1,462 جملة عربية من 1,540، أي 94.9%، والباقي 75 جملة منسوخة بالإنجليزية في الملف العربي. وكلمة «Admin» في الصورة هي اسم المستخدم وليست جملة غير مترجمة.
ولاحظ عنوان الكتاب في شريط العنوان: /books/dlyl-almothf، فقد حول BookStack العنوان العربي «دليل الموظف» إلى حروف لاتينية في الرابط، وهذا يجعل الرابط صالحاً في أي مكان، لكنه غير مقروء للمستخدم العربي، وهو قرار تصميم وليس خطأ، فبعض الأدوات تترك الحروف العربية في الرابط كما يفعل Ghost في روابط هذا الموقع.
Forgejo: العربية موجودة لكنها مخفية
نبدأ بإنشاء حساب مدير من داخل الـ Container:
docker exec oss7-fj forgejo admin user create --username labadmin --password Lab-Pass-2026x \
  --email [email protected] --admin --must-change-password=false
والمخرج سوف يكون كما يلي:
New user 'labadmin' has been successfully created!ثم حاولنا تغيير لغة المستخدم من واجهة API إلى ar-SA، فقبلها Forgejo ورجع "language":"ar-SA" دون خطأ، لكن الواجهة بقيت بالإنجليزية بالكامل، وعندما فتحنا قائمة اللغات أسفل الصفحة لم نجد العربية فيها أصلاً، رغم أنها فيها الفارسية والكورية والإسبرانتو. والسبب في ملف i18n.go في كود Forgejo، ففيه قائمة اللغات الافتراضية، وهي إحدى وثلاثون لغة ليس منها العربية، رغم أن الملف locale_ar.ini موجود مع الإصدار ومترجم بنسبة 64.7%. والحل أن تضيف القسم [i18n] إلى ملف الإعداد كما في دليل إعدادات Forgejo، وتكتب فيه اللغات التي تريدها بأسمائها:
docker exec oss7-fj sh -c 'printf "\n[i18n]\nLANGS = en-US,ar,fa-IR,de-DE\nNAMES = English,العربية,فارسی,Deutsch\n" \
  >> /var/lib/gitea/custom/conf/app.ini'
docker restart oss7-fj
وهنا واجهنا مشكلة ثانية: كتبنا الأمر أولاً على المسار /etc/gitea/app.ini كما في صورة Forgejo العادية، فظهر الخطأ can't create /etc/gitea/app.ini: nonexistent directory، والسبب أن صورة rootless تحفظ ملف الإعداد في مسار آخر، تجده في المتغير GITEA_APP_INI داخل الـ Container، وهو /var/lib/gitea/custom/conf/app.ini. وبعد إعادة التشغيل غيرنا لغة المستخدم إلى ar بالرمز الصحيح، فظهرت الواجهة كما يلي:
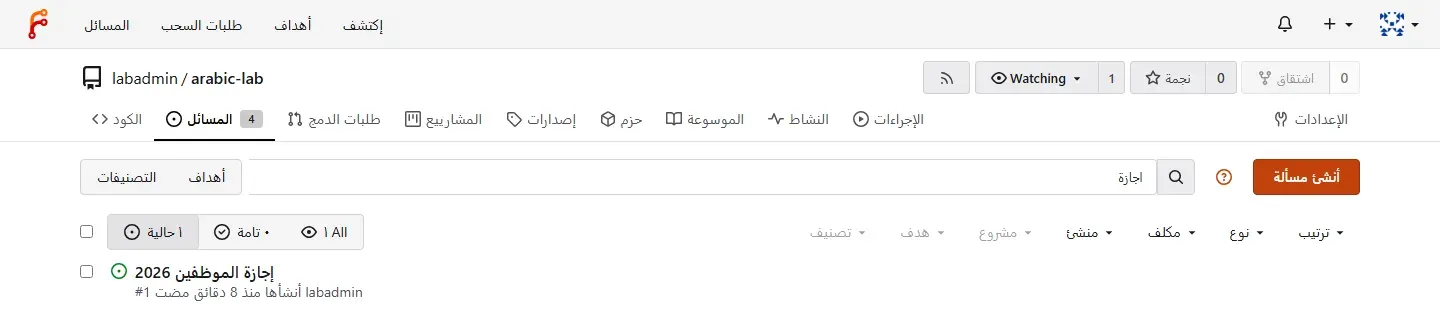
النصوص الآن عربية في أغلبها، مثل «المسائل» و«طلبات الدمج» و«أنشئ مسألة»، لكن الصفحة نفسها لم تنعكس، فالشعار في اليسار والتبويبات تبدأ من اليسار، وقرأنا خصائص الصفحة من المتصفح فكانت lang="ar" مع dir="ltr"، أي أن Forgejo يعرف أن اللغة عربية لكنه لا يغير الاتجاه، وكلمتا «Watching» و«All» بقيتا بالإنجليزية. وفي المقابل لاحظ نتيجة البحث في الصورة: كتبنا «اجازة» دون همزة فوجد «إجازة الموظفين 2026»، وهذا ما لم يفعله Nextcloud ولا BookStack.
اختبار البحث: اثنا عشر سؤالاً في ثلاث أدوات
السكربت lab/search-test.mjs يرسل نفس الأسئلة الاثني عشر إلى واجهة البحث في كل أداة عبر API، ويطبع عدد العناوين التي وجدها من الأربعة، والأسئلة هي كل عنوان كما كتب، ثم نفس الكلمة دون همزة أو بالهاء بدل التاء المربوطة أو بالياء بدل الألف المقصورة أو دون «ال» أو دون تشكيل أو بصيغة الجمع:
const QUERIES = ['إجازة', 'اجازة', 'إجازه', 'المستشفى', 'مستشفي', 'مستشفى', 'أسعار', 'اسعار', 'المدرسه', 'ملخص', 'مُلَخَّص', 'إجازات'];

const APPS = {
  nextcloud: async (q) => {
    const r = await fetch(`http://localhost:9531/ocs/v2.php/search/providers/files/search?format=json&term=${encodeURIComponent(q)}`,
      { headers: { authorization: basic('admin', 'Lab-Pass-2026x'), 'OCS-APIRequest': 'true' } });
    return (await r.json()).ocs.data.entries.filter(e => e.title.endsWith('.txt')).length;
  },
  bookstack: async (q) => {
    const r = await fetch(`http://localhost:9532/api/search?query=${encodeURIComponent(q)}`,
      { headers: { authorization: 'Token labtokenid:labsecret123' } });
    return (await r.json()).data.filter(x => x.type === 'page').length;
  },
  forgejo: async (q) => {
    const r = await fetch(`http://localhost:9533/api/v1/repos/labadmin/arabic-lab/issues?state=all&type=issues&q=${encodeURIComponent(q)}`,
      { headers: { authorization: basic('labadmin', 'Lab-Pass-2026x') } });
    return (await r.json()).length;
  },
};
نشغل سكربت البيانات ثم سكربت البحث:
node seed.mjs && node search-test.mjsوالمخرج سوف يكون كما يلي:
nextcloud: 4 files
bookstack: book 6 (dlyl-almothf), 4 pages
forgejo: repo arabic-lab, 4 issues
query     	nextcloud	bookstack	forgejo
إجازة     	1	1	1
اجازة     	0	0	1
إجازه     	0	0	1
المستشفى  	1	1	1
مستشفي    	0	0	0
مستشفى    	1	0	1
أسعار     	1	1	1
اسعار     	0	0	1
المدرسه   	0	0	1
ملخص      	0	0	0
مُلَخَّص  	1	1	1
إجازات    	0	0	1
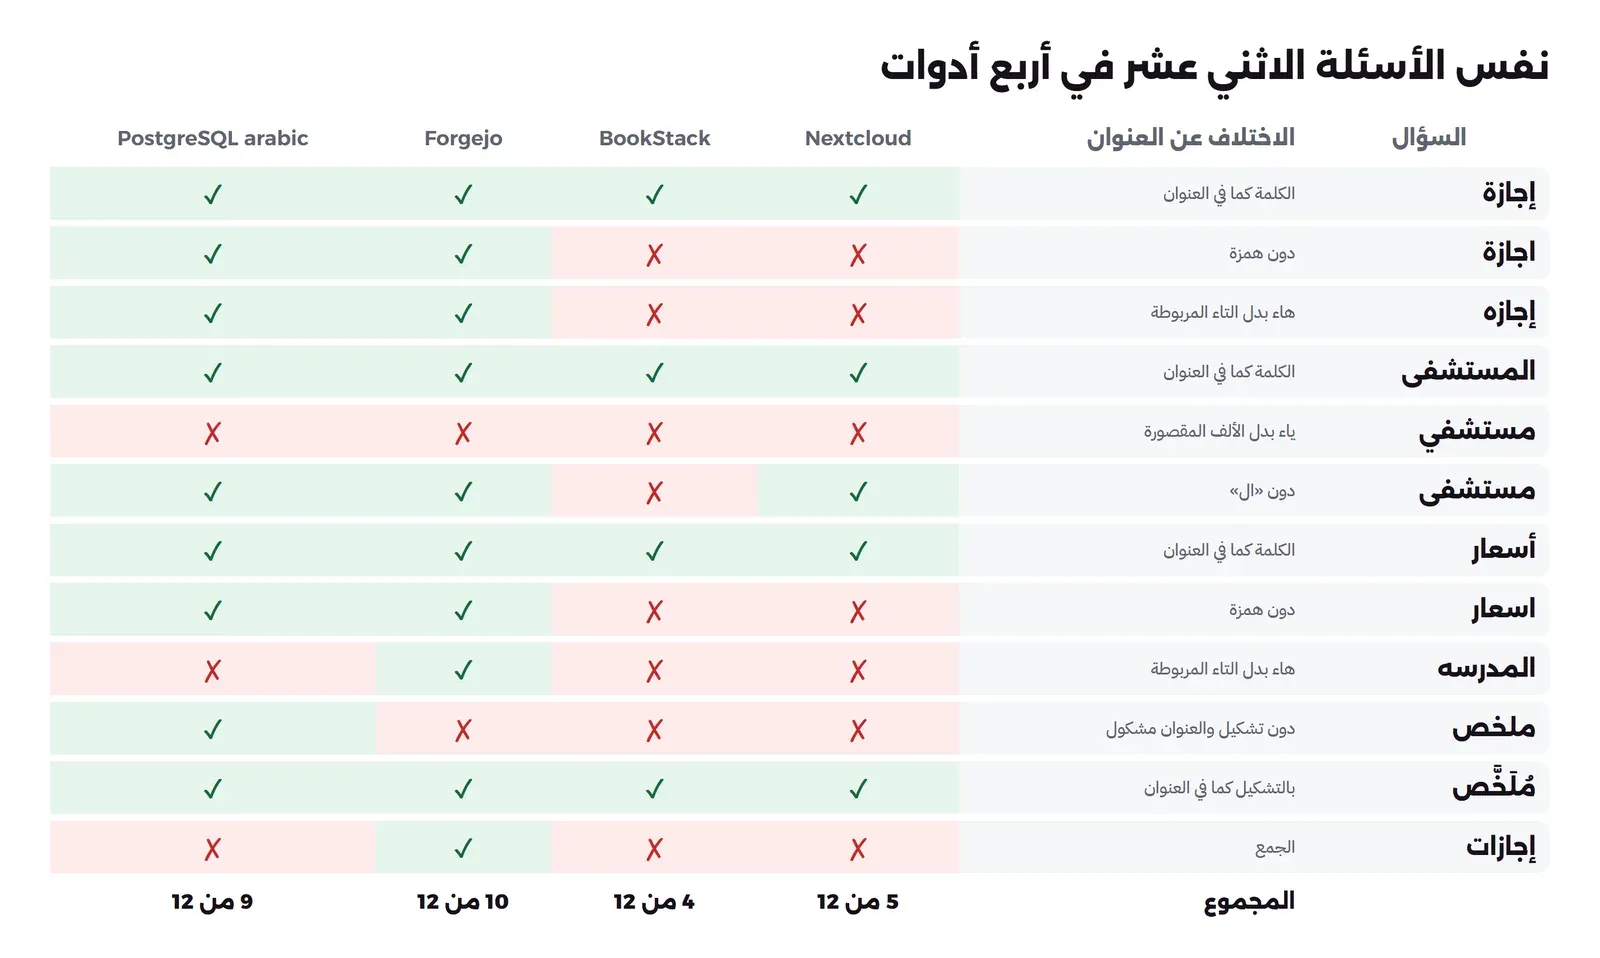
found nextcloud 5/12, bookstack 4/12, forgejo 10/12
في المخرج أعلاه لاحظ التالي:
- الأسئلة المطابقة حرفياً وجدتها الأدوات الثلاث: «إجازة» و«المستشفى» و«أسعار» والعنوان المشكول بتشكيله، وهذا الحد الأدنى الذي تقدمه أي أداة.
- Nextcloud وجد «مستشفى» دون «ال»: لأنه يبحث عن الحروف في أي مكان من اسم الملف، فالكلمة موجودة داخل «المستشفى»، لكنه لم يجد أي سؤال فيه همزة مختلفة أو هاء أو ياء.
- BookStack هو الأضعف هنا بأربعة أسئلة: فلم يجد حتى «مستشفى» دون «ال»، لأن بحثه يطابق بداية الكلمة المحفوظة، والكلمة المحفوظة «المستشفى».
- Forgejo وجد عشرة من اثني عشر: وجد الهمزات والهاء والجمع، لكن ليس لأنه يفهم العربية، فهو يحلل النص بتوحيد Unicode من نوع NFC وتحويل الحروف الصغيرة فقط، كما في كود فهرس المهام، ثم يبحث بتحمل الأخطاء التلقائي في Bleve. وهذا يقبل فرق حرفين إذا كان طول الكلمة أكثر من خمسة، وفي كود الدالة GetAutoFuzziness يحسب الطول بالبايت وليس بالحروف، والحرف العربي في UTF-8 بايتان، فكل كلمة عربية من ثلاثة حروف أو أكثر تأخذ أقصى تحمل وهو حرفان، بينما الكلمة الإنجليزية تحتاج ستة حروف. لذلك وجد «اجازة» و«إجازات» و«المدرسه»، ولم يجد «مستشفي» لأنها تختلف عن «المستشفى» بثلاثة حروف هي الألف واللام والياء، ولا «ملخص» لأن العنوان المشكول يزيد عليها أربع حركات.
- لا أداة وجدت «مستشفي» بالياء: وهو خطأ شائع جداً في الكتابة العربية على الجوال، وسوف نرى أن PostgreSQL نفسه يفشل فيه لسبب مختلف.
وتحمل الأخطاء الذي نجح في Forgejo له ثمن، فهو لا يفرق بين همزة ناقصة وكلمة مختلفة فعلاً، فكلمة من ستة حروف تطابق أي كلمة تختلف عنها بحرفين، ومع مستودع كبير فيه آلاف المهام سوف تظهر نتائج لا علاقة لها بالسؤال، وقد قسنا هذا الأثر في مقال البحث في النصوص العربية فوجدنا أن تحمل الأخطاء الدائم رفع نسبة ما وجده المحرك إلى 1.00 لكنه خفض الدقة إلى 0.82.
ماذا يحدث إذا وضعنا السؤال بين علامتي تنصيص في BookStack؟
عند قراءة كود البحث في BookStack داخل الـ Container وجدنا طريقين: البحث العادي يطابق بداية الكلمة كما رأينا، أما البحث الدقيق Exact Search، وهو عندما تكتب السؤال بين علامتي تنصيص كما في توثيق البحث في BookStack، فيبحث عن الحروف في أي مكان من النص بمقارنة LIKE '%x%'. فجربنا نفس الكلمة بالطريقتين من واجهة API:
const H = { authorization: 'Token labtokenid:labsecret123' };
for (const q of ['مستشفى', '"مستشفى"', '"موظفين"', '"اجازة"']) {
  const r = await fetch('http://localhost:9532/api/search?query=' + encodeURIComponent(q), { headers: H });
  const pages = (await r.json()).data.filter(x => x.type === 'page');
  console.log(q, pages.length, pages.map(x => x.name).join(' | '));
}
والمخرج سوف يكون كما يلي:
مستشفى 0
"مستشفى" 1 تقرير المستشفى السنوي
"موظفين" 1 إجازة الموظفين 2026
"اجازة" 0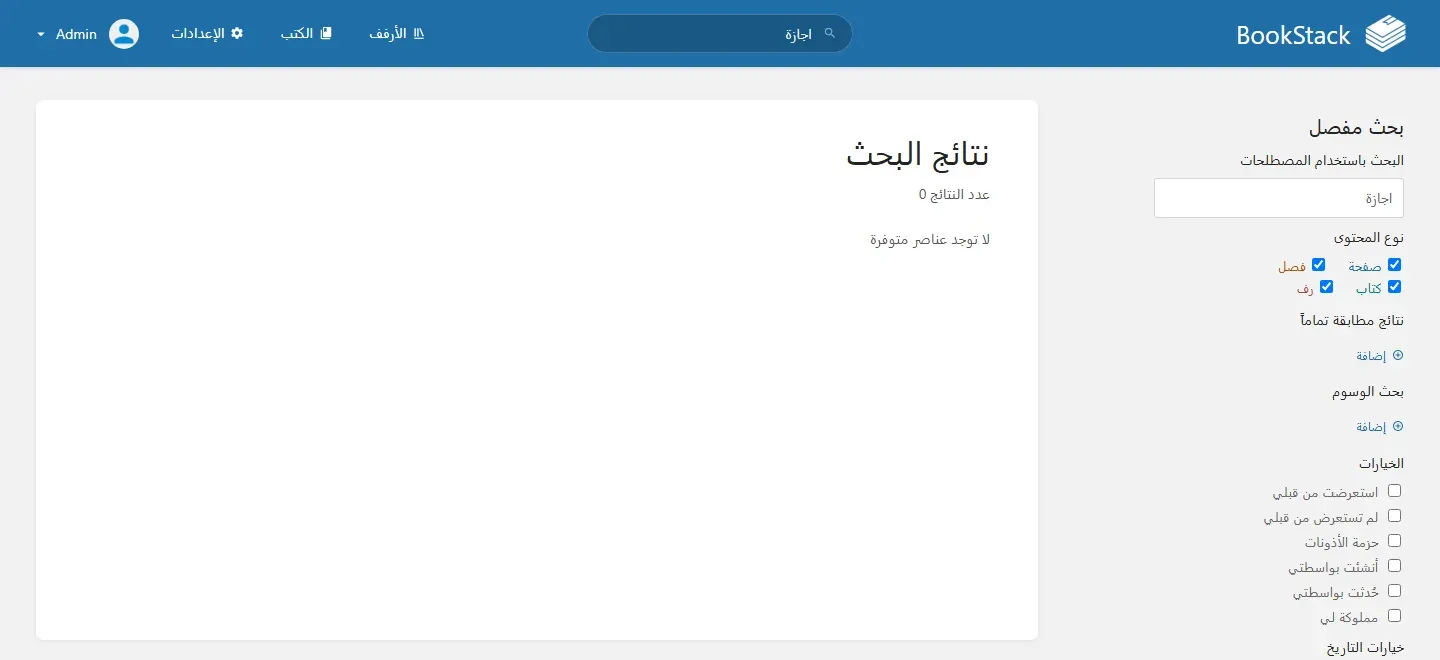
فعلامتا التنصيص حلتا مشكلة «ال»، فوجد «مستشفى» داخل «المستشفى» و«موظفين» داخل «الموظفين»، لكنهما لا تحلان مشكلة الهمزة، فما زال «اجازة» لا يجد «إجازة». وهذه معلومة تستحق أن تضعها في دليل الاستخدام لفريقك: إذا لم تجد الصفحة فضع الكلمة دون «ال» بين علامتي تنصيص، وجرب الهمزة بالشكلين.
البحث النصي في PostgreSQL بإعداد arabic
كثير من الأدوات تحفظ بياناتها في PostgreSQL، وفيه بحث نصي كامل Full-Text Search بإعدادات لغات جاهزة منها arabic، وهو يستخدم جذع Snowball العربي الموصوف في صفحة الخوارزمية، كما في توثيق قواميس البحث. ولنرى ما الذي يفعله بالعربية شغلنا Container من PostgreSQL 18، ونفذنا عليه الملف lab/pg-arabic.sql بنفس العناوين والأسئلة، مقارناً الإعداد simple الذي لا يعدل الكلمات بالإعداد arabic:
docker run -d --name oss7-pg --network oss7-net -e POSTGRES_PASSWORD=pgpw postgres:18-alpine
docker cp lab/pg-arabic.sql oss7-pg:/tmp/pg-arabic.sql
docker exec oss7-pg psql -U postgres -f /tmp/pg-arabic.sql
والملف فيه جدول صغير بالعناوين الأربعة، ثم استعلام يطبع الكلمات التي حفظها الإعداد arabic لكل عنوان، ثم استعلام يعد النتائج لكل سؤال بالإعدادين:
SELECT q AS query,
       plainto_tsquery('arabic', q) AS arabic_query,
       (SELECT count(*) FROM docs WHERE to_tsvector('simple', title) @@ plainto_tsquery('simple', q)) AS simple,
       (SELECT count(*) FROM docs WHERE to_tsvector('arabic', title) @@ plainto_tsquery('arabic', q)) AS arabic
FROM unnest(ARRAY['إجازة','اجازة','إجازه','المستشفى','مستشفي','مستشفى',
                  'أسعار','اسعار','المدرسه','ملخص','مُلَخَّص','إجازات']) AS q;
والمخرج سوف يكون كما يلي:
 id |         arabic_terms
----+------------------------------
  1 | '2026':3 'اجاز':1 'موظف':2
  2 | 'تقرير':1 'سنو':3 'مستشفي':2
  3 | 'اسعار':1 'جديد':3 'مدرس':2
  4 | 'اجتماع':2 'اول':3 'ملخص':1
(4 rows)

  query   | arabic_query | simple | arabic
----------+--------------+--------+--------
 إجازة    | 'اجاز'       |      1 |      1
 اجازة    | 'اجاز'       |      0 |      1
 إجازه    | 'اجاز'       |      0 |      1
 المستشفى | 'مستشفي'     |      1 |      1
 مستشفي   | 'مستشف'      |      0 |      0
 مستشفى   | 'مستشفي'     |      0 |      1
 أسعار    | 'اسعار'      |      1 |      1
 اسعار    | 'اسعار'      |      0 |      1
 المدرسه  | 'مدرسه'      |      0 |      0
 ملخص     | 'ملخص'       |      0 |      1
 مُلَخَّص     | 'ملخص'       |      1 |      1
 إجازات   | 'اجازا'      |      0 |      0
(12 rows)
في المخرج أعلاه لاحظ التالي:
- الجدول الأول يبين عمل الجذع: «إجازة» أصبحت
اجازبعد حذف الهمزة والتاء المربوطة، و«الموظفين» أصبحتموظف، و«الأول» أصبحتاول، والعنوان المشكول حذف تشكيله فأصبحملخص. - الإعداد simple وجد أربعة أسئلة فقط: وهي المطابقة حرفياً، مثل BookStack تماماً، وهذا ما تحصل عليه إذا بنت الأداة بحثها على PostgreSQL دون أن تحدد اللغة.
- الإعداد arabic وجد تسعة: الهمزات والهاء في «إجازه» والتشكيل و«ال»، وهي أفضل نتيجة لطريقة مصممة للعربية.
- فشل في ثلاثة: «مستشفي» و«المدرسه» و«إجازات»، والجمع متوقع لأن الجذع خفيف ولا يعرف أن «إجازات» جمع «إجازة»، أما الأولان فيحتاجان شرحاً.
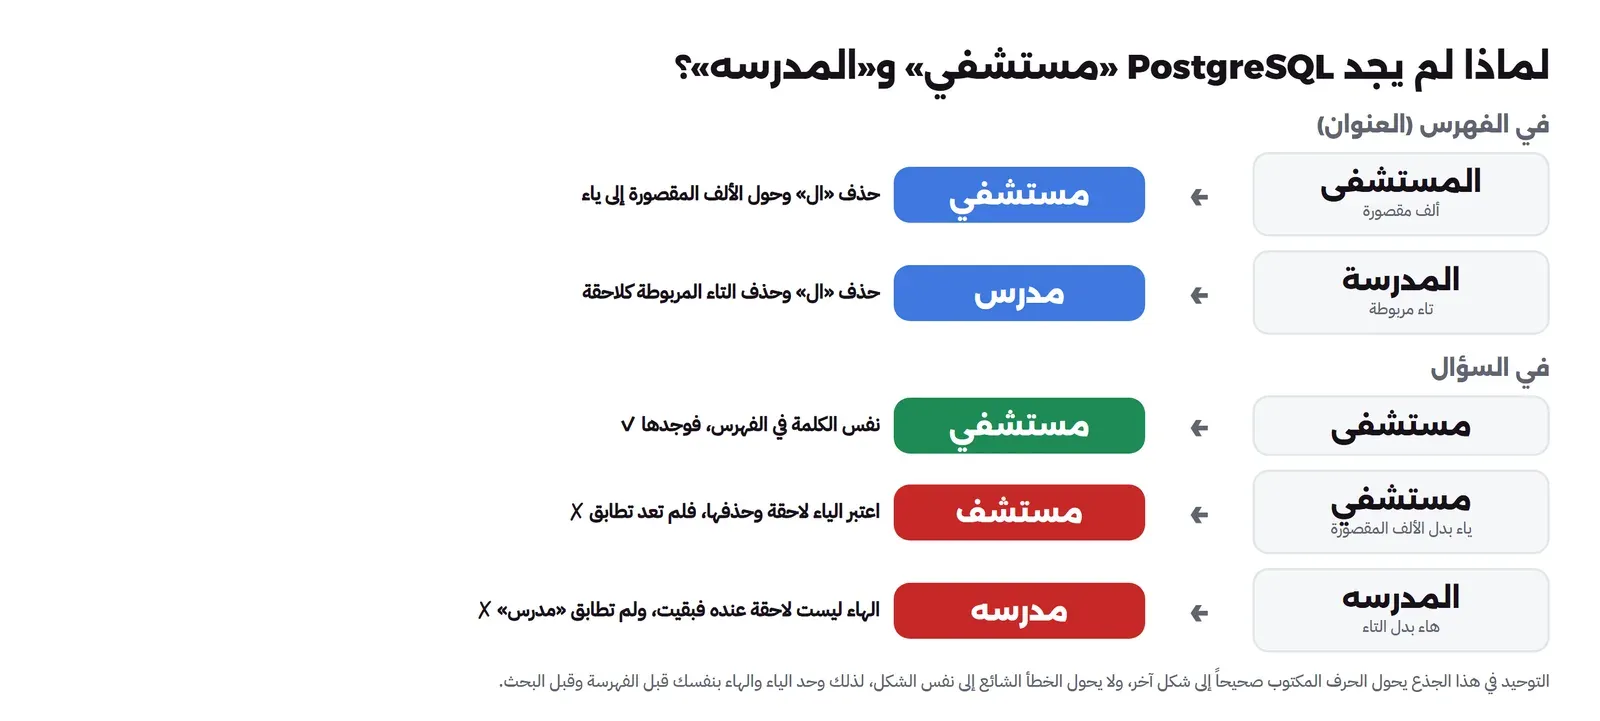
عندما يرى الجذع «المستشفى» بالألف المقصورة يحولها إلى ياء فيحفظ مستشفي، لكن عندما يكتب المستخدم «مستشفي» بالياء من البداية يعتبر الياء لاحقة مثل ياء النسبة فيحذفها ويبحث عن مستشف، فلا يطابق. ونفس الشيء في التاء المربوطة: يحذفها من «المدرسة» كلاحقة فيحفظ مدرس، أما الهاء في «المدرسه» فلا يعتبرها لاحقة فيبقيها، فيبحث عن مدرسه. أي أن التوحيد يحدث داخل الجذع في مرحلة متأخرة، ولا يحول الخطأ الشائع إلى نفس الشكل الذي يحول إليه الكتابة الصحيحة.
والحل أن توحد هذين الحرفين بنفسك قبل أن يرى الجذع النص، في الفهرسة وفي البحث معاً، والملف نفسه فيه هذا الاستعلام في آخره:
SELECT q AS query,
       (SELECT count(*) FROM docs
         WHERE to_tsvector('arabic', translate(title, 'ىة', 'يه'))
            @@ plainto_tsquery('arabic', translate(q, 'ىة', 'يه'))) AS arabic_fixed
FROM unnest(ARRAY['مستشفي','مستشفى','المدرسه','المدرسة']) AS q;
والمخرج سوف يكون كما يلي:
  query  | arabic_fixed
---------+--------------
 مستشفي  |            1
 مستشفى  |            1
 المدرسه |            1
 المدرسة |            1
(4 rows)
الدالة translate تحول كل ألف مقصورة إلى ياء وكل تاء مربوطة إلى هاء في العنوان والسؤال قبل الجذع، فأصبح الشكلان متطابقين ووجدت الأسئلة الأربعة. وفي تطبيق حقيقي تضع هذا التحويل في عمود محسوب Generated Column مع فهرس GIN حتى لا تحسبه في كل بحث، وقد شرحنا الطريقة في مقال PostgreSQL لكل شيء. لكن لاحظ أن هذا الحل لك إذا كنت تكتب الأداة، أما في أداة جاهزة مثل BookStack فلا تستطيع تغيير طريقة بحثها إلا بتعديل الكود أو ربط محرك خارجي.
جدول النتيجة: درجة لكل طبقة
الآن نجمع كل ما رأيناه في جدول واحد، ولكل طبقة درجة من 0 إلى 2: الدرجة 2 تعني أن المستخدم العربي لن يلاحظ مشكلة، و1 تعني أنها تعمل مع ملاحظات ظاهرة، و0 تعني أنها لا تعمل أو تحتاج تدخلاً من مدير النظام. وفي البحث أعطينا 2 لمن وجد تسعة أسئلة أو أكثر من اثني عشر، و1 من خمسة إلى ثمانية، و0 لأربعة أو أقل:
| الطبقة | Nextcloud 34.0.6 | BookStack v26.09.3 | Forgejo 17.0.1 |
|---|---|---|---|
| الترجمة | 1: جمل إنجليزية في البحث والقائمة والدخول | 2: 94.9% من الجمل | 1: 64.7% من الجمل |
| الاتجاه RTL | 2: تنعكس كاملة، مع خطأ في عرض الحجم | 2: تنعكس كاملة | 0: dir="ltr" مع اللغة العربية |
| البحث | 1: 5 من 12 | 0: 4 من 12 | 2: 10 من 12 بتحمل الأخطاء |
| الأرقام والتاريخ | 1: أرقام عربية هندية وغربية في نفس الصف | 2: متسقة | 2: متسقة |
| التفعيل | 2: من المتصفح أو occ | 2: من إعدادات المستخدم | 0: مخفية حتى تعدل app.ini |
| المجموع من 10 | 7 | 8 | 5 |
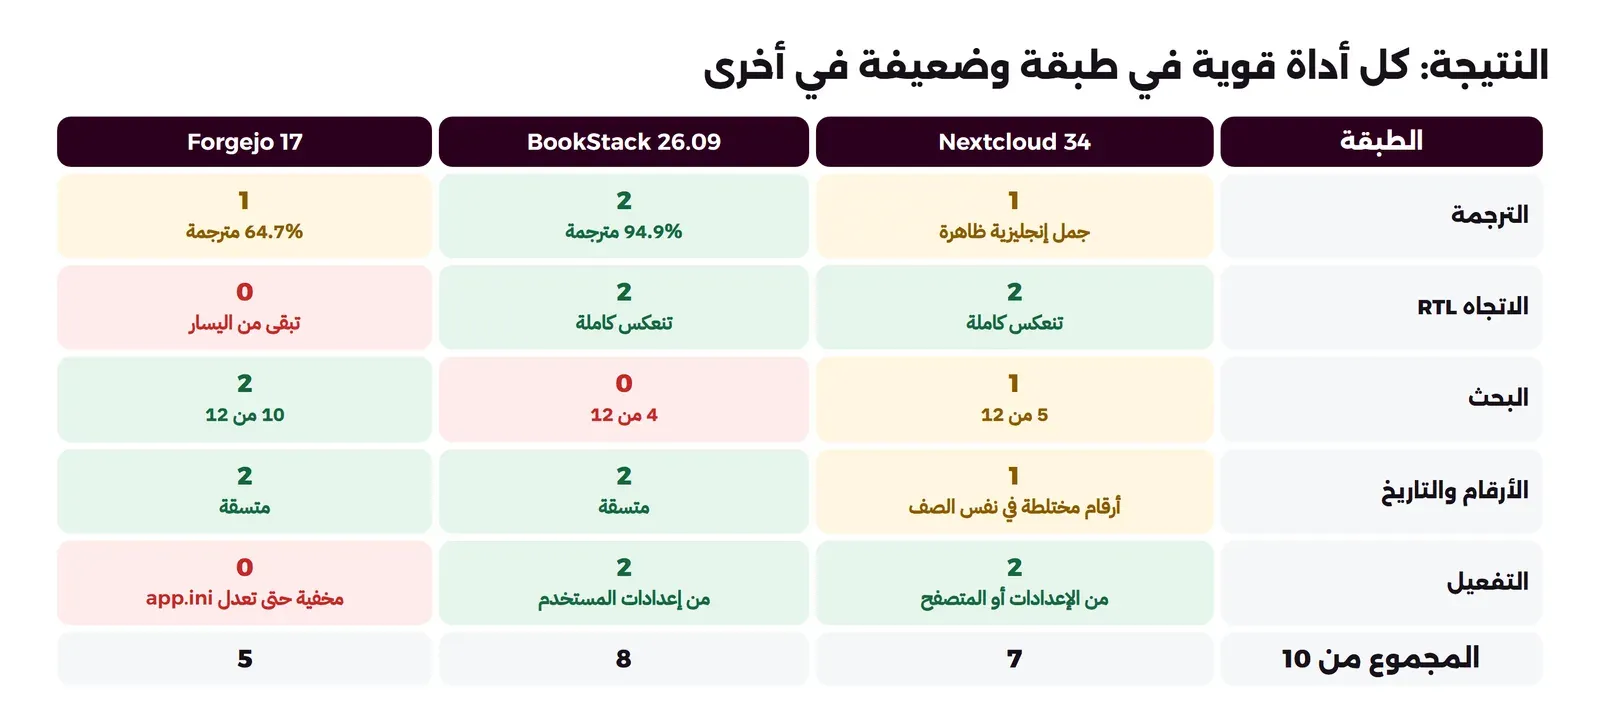
وليست هذه الأرقام حكماً عاماً على الأدوات، فهي ثلاثة إصدارات محددة وأسئلة كتبناها نحن، وإنما خذ منها الطريقة: كل أداة قوية في طبقة وضعيفة في أخرى، والقرار يعتمد على الطبقة الأهم لفريقك. ففريق يكتب وثائق ويبحث فيها كل يوم سيعاني مع بحث BookStack رغم أن واجهته الأفضل، وفريق برمجي يقرأ الإنجليزية لن يهمه أن Forgejo لا ينعكس.
وفي دليل Moodle ودليل Mattermost تجد أدوات أخرى يمكن أن تطبق عليها نفس الاختبار، وسكربت البحث سهل التعديل لأي أداة لها API للبحث.
حذف المختبر
الأوامر التالية تحذف الـ Containers الخمسة والشبكة، ثم الـ Images إذا لم تعد تحتاجها:
docker rm -f oss7-nc oss7-bs oss7-bsdb oss7-fj oss7-pg
docker network rm oss7-net
docker rmi nextcloud:34.0.6-apache lscr.io/linuxserver/bookstack:v26.09.3-ls297 mariadb:12.3.3 \
  codeberg.org/forgejo/forgejo:17.0.1-rootless postgres:18-alpine
كيف تحسن دعم العربية في أداة تستخدمها؟
إذا وجدت أداة مناسبة لفريقك لكن العربية فيها ناقصة، فهذا ليس سبباً كافياً لتركها، لأن المصادر المفتوحة تسمح لك أن تصلح ما ينقص، وكل طبقة لها طريق مختلف:
- الترجمة الناقصة: سجل في منصة الترجمة التي يستخدمها المشروع وترجم الجمل التي تراها في عملك اليومي أولاً، فمئة جملة في الصفحات الرئيسية أهم من ألف جملة في الإعدادات المتقدمة. وترجمتك تصل لكل مستخدم عربي في الإصدار التالي.
- اللغة المخفية: كما في Forgejo، فعلها في الإعداد، واكتب للمشروع أن العربية جاهزة بنسبة معينة، فبعض المشاريع تضيف اللغة للقائمة عندما ترى من يستخدمها.
- الاتجاه: افتح بلاغاً Issue مع صورة وخطوات واضحة، مثل «حجم الملف يظهر KB 1 > في الواجهة العربية»، فالمطورون غالباً لا يقرؤون العربية ولا يلاحظون هذه الأخطاء، وقد شرحنا أصول المساهمة والتواصل مع المشرفين في مقال حوكمة المشاريع مفتوحة المصدر.
- البحث: لا تنتظر أن يصلحه المشروع، فاربط محرك بحث خارجياً إذا كانت الأداة تسمح، أو علم فريقك طريقة البحث المناسبة، مثل علامات التنصيص في BookStack.
- الخطوط: ثبت خطاً عربياً على أجهزة الفريق، أو أضف قاعدة CSS مخصصة إذا كانت الأداة تسمح.
وإذا كنت مهتماً بقصة كيف وصل الحرف العربي إلى الحاسب أصلاً، من صفحات الترميز القديمة إلى Unicode، فستجدها في قصة الحرف العربي في الحاسب، وهي تفسر لماذا يوجد في Unicode أكثر من رمز لنفس الحرف، وهو أحد أسباب مشكلات البحث التي رأيناها.
أخطاء شائعة
- الحكم من صفحة الدخول: هي أكثر صفحة مترجمة في أي أداة، وحتى صفحة الدخول في Nextcloud فيها «Remember me» بالإنجليزية. افتح الصفحات التي سيستخدمها فريقك كل يوم.
- الوثوق بوجود ملف ar.json: الملف العربي في Bitwarden Web فيه نفس عدد المفاتيح الإنجليزية، لكن 85% منها نص إنجليزي منسوخ. عد الجمل التي فيها حروف عربية فعلاً.
- الاستنتاج من رمز لغة خاطئ: Forgejo قبل الرمز
ar-SAدون خطأ وبقيت الواجهة إنجليزية، فإذا لم تتغير اللغة فتأكد من الرمز في قائمة لغات الأداة قبل أن تحكم أن العربية غير موجودة. - اختبار البحث بكلمات مكتوبة صحيحة فقط: كل الأدوات تجد «إجازة» إذا كتبتها كما في المستند، والفرق يظهر في «اجازة» و«المدرسه» و«مستشفي»، فاختبر بما يكتبه الناس فعلاً.
- الخلط بين اللغة والمنطقة Locale: اللغة تغير النصوص، والمنطقة تغير الأرقام والتواريخ، وضبط أحدهما دون الآخر يعطي أرقاماً مختلطة كما في Nextcloud.
- توحيد الحروف في البحث دون الفهرسة: إذا حولت التاء المربوطة إلى هاء في السؤال فقط ستفشل كل الأسئلة الصحيحة، فالتحويل يجب أن يكون نفسه في الطرفين.
- اعتبار تحمل الأخطاء حلاً للعربية: نجح في Forgejo مع أربعة عناوين، لكنه يقبل أي كلمة تختلف بحرفين، ومع آلاف المستندات سيظهر نتائج خاطئة.
قائمة تحقق Checklist قبل اعتماد أداة لفريق عربي
| الطبقة | ماذا تفحص | كيف تفحص في دقائق |
|---|---|---|
| الترجمة | نسبة العربية، وهل الجمل منسوخة بالإنجليزية | صفحة المشروع في منصة الترجمة، أو مقارنة ملف اللغة العربي بالإنجليزي |
| التفعيل | هل تظهر العربية في قائمة اللغات دون تعديل | افتح قائمة اللغات في واجهة تجريبية |
| الاتجاه | هل تنعكس الصفحة كاملة | انظر لمكان القائمة الجانبية، أو اقرأ dir من أدوات المطور في المتصفح |
| النص المختلط | أسماء الملفات والأحجام والعلامات | ارفع ملفاً باسم عربي ينتهي بامتداد إنجليزي وانظر لعمود الحجم |
| البحث | الهمزات والتاء المربوطة والألف المقصورة و«ال» والتشكيل | أربعة عناوين واثنا عشر سؤالاً كما في التجربة |
| الأرقام والتاريخ | اتساق الأرقام وصحة التاريخ النسبي | صفحة فيها حجم ووقت في نفس الصف |
| البريد والإشعارات | لغة الرسائل التي ترسلها الأداة | أرسل دعوة لمستخدم جديد لغته العربية |
| الخط | شكل الحرف على أجهزة الفريق | افتح الأداة على Linux وWindows والجوال |
الخلاصة
- دعم العربية أربع طبقات مستقلة: الترجمة والاتجاه والبحث والخط مع الأرقام والتواريخ، وأداة واحدة قد تنجح في طبقة وتفشل في أخرى.
- الترجمة تصل عبر منصات مثل Weblate وCrowdin وTransifex، ونسبتها تختلف كثيراً: من 99.7% في Jellyfin إلى 2.7% في Mattermost، وBitwarden Web يبدو كاملاً وهو 14.9% فقط.
- Nextcloud 34 ينعكس بالكامل لكن فيه جمل إنجليزية وخطأ في عرض الحجم وأرقام مختلطة، وBookStack مترجم بنسبة 94.9% وينعكس لكن بحثه أضعف الثلاثة، وForgejo 17 يخفي العربية حتى تعدل
app.iniولا يغير الاتجاه، لكن بحثه وجد عشرة أسئلة من اثني عشر بتحمل الأخطاء. - أغلب الأدوات تبحث بمطابقة الحروف كما هي، وPostgreSQL بإعداد
arabicوجد تسعة أسئلة، وفشل في «مستشفي» و«المدرسه» حتى وحدنا الحرفين بالدالةtranslateفي الطرفين. - قبل اعتماد أداة لفريق عربي اختبر الطبقات الأربع بنفسك في ساعة واحدة، وساهم في إصلاح ما ينقص بدل البحث عن أداة كاملة غير موجودة.
 دليلكيف تقيم مشروعاً مفتوح المصدر Open Source قبل أن تعتمد عليه؟تسعة أبعاد وبطاقة تقييم بأوزان تقرر بها هل تعتمد على مشروع مفتوح المصدر، مطبقة على أرقام حقيقية لثلاثة مشاريع مشهورة.
 دليلالبحث في النصوص العربية مع OpenSearch وMeilisearchلماذا يرجع البحث صفحة فارغة لمن يكتب «مستشفي» أو «اجازه»، وكيف تضبط محركك حتى يجد الكلمة بكل أشكالها.
 دليلالتعريب i18n للمطورين: لماذا ينقلب النص العربي في الواجهة؟لماذا ينقلب النص المختلط في الواجهة العربية وكيف تعزله، وكيف تنسق الأرقام والتواريخ وصيغ الجمع العربية بأدوات المتصفح نفسها.
 دليلتصميم الواجهات العربية RTL: الانعكاس والخطوط والأرقامما الذي ينعكس في الواجهة العربية وما الذي يبقى، وكيف تختار الأرقام والخط وارتفاع السطر، وتمنع أخطاء النص المختلط قبل الإطلاق.
 دليلقصة الحرف العربي في الحاسب: من صخر إلى Unicodeكيف دخل الحرف العربي إلى الحاسب عبر جداول ترميز متضاربة حتى جمعه Unicode برقم واحد لكل حرف، وما الذي بقي على المطور اليوم.
سجل التحديثات
- 2026-11-16: كتابة المقال، وتشغيل Nextcloud 34.0.6 وBookStack v26.09.3 مع MariaDB 12.3.3 وForgejo 17.0.1 وPostgreSQL 18.6 في Docker، وأخذ صور الواجهات بالعربية من Chrome، واختبار اثني عشر سؤالاً، وعد الترجمة العربية في تسعة مشاريع.