


لنفرض أنك في شركة ناشئة صغيرة تبيع دورات تدريبية عبر الإنترنت، وكل ما تملكه سيرفر افتراضي VPS واحد عليه الموقع وقاعدة البيانات ومهمة النسخ الاحتياطي الليلية، ومطور واحد يكتب الكود ويدير السيرفر في الوقت نفسه. وفي إحدى الليالي بطؤ الموقع حتى أصبحت صفحة الدفع تأخذ عشرين ثانية، ثم عاد طبيعياً قبل الفجر، ولم يعرف أحد بذلك إلا في الصباح من رسائل العملاء. فدخل المطور إلى السيرفر وكتب top فوجد كل شيء هادئاً، لأن المشكلة انتهت قبل ساعات، ولم يكن هناك أي رسم بياني يقول له ماذا حدث في تلك الساعة: هل امتلأت الذاكرة؟ هل كان المعالج مشغولاً بالنسخ الاحتياطي؟ هل امتلأ القرص ثم فرغ؟
وقد بنينا في مقاييس السيرفرات مع Prometheus ولوحات Grafana نظام مراقبة كاملاً لفريق عنده أربعة سيرفرات، ولكن هذا المطور عنده سيرفر واحد ووقت قليل، والسؤال الذي يطرحه بصراحة: هل أحتاج ثلاثة برامج وملفات إعداد ولغة استعلام حتى أعرف ماذا حدث لسيرفري البارحة؟ وهذا هو موضوع المقال: أدوات المراقبة الخفيفة التي تعمل خلال دقائق على سيرفر واحد، وأشهرها Netdata وBeszel، ثم متى تكفيك ومتى يجب أن تنتقل إلى Prometheus مع Grafana. والمواضيع في السلسلة:
- مقاييس السيرفرات مع Prometheus ولوحات Grafana.
- ماذا تقيس في خدمتك؟ الإشارات الذهبية Golden Signals.
- مراقبة خفيفة لسيرفر واحد مع Netdata أو Beszel (الموضوع الحالي).
- فحص التوفر Uptime Checks مع Blackbox Exporter أو Uptime Kuma.
- التنبيهات Alerting: ماذا تنبه عليه، وكيف تتجنب تعب التنبيهات Alert Fatigue.
- بوابة مراقبة واحدة Monitoring Portal تجمع Grafana مع Wazuh.
وسوف نناقش في هذا المقال ما يلي:
- لماذا لا تبدأ دائماً بمجموعة Prometheus، وما الذي تدفعه في كل طريقة من طرق المراقبة.
- كيف يعمل Netdata من الداخل: الجمع كل ثانية وطبقات التخزين الثلاث وكشف الشذوذ ML.
- كيف يعمل Beszel: ال Hub وال Agent، والاتصال عبر SSH أو WebSocket.
- مختبر حقيقي يشغل الأداتين ومجموعة Prometheus على السيرفر نفسه، مع مشكلتين واجهتانا وحلهما.
- كم تستهلك كل أداة من الذاكرة والمعالج والقرص بأرقام قسناها، وماذا يحدث إذا خففنا Netdata.
- تجربة ضغط على المعالج: من ينبهك أولاً، ولماذا تأخر Netdata تسع دقائق، وماذا يحدث إذا توقف ال Agent.
- الرخصة وما المجاني في Netdata Cloud، ثم نقاط القوة ونقاط الضعف، ومتى تنتقل إلى Prometheus مع Grafana.
لماذا لا تبدأ دائماً بمجموعة Prometheus؟ تكلفة المراقبة Monitoring Cost
المراقبة ليست مجانية حتى عندما تكون الأداة مفتوحة المصدر، فأنت تدفع ثلاثة أشياء: موارد السيرفر التي تستهلكها الأداة نفسها، ووقت التثبيت والإعداد، ووقت الصيانة بعد ذلك من تحديثات ونسخ احتياطي للوحات وإصلاح ما يتعطل. وفي فريق عنده عشرة سيرفرات وشخص مسؤول عن التشغيل تكون هذه التكلفة صغيرة مقارنة بما توفره، أما المطور الوحيد في قصتنا فكل ساعة يقضيها في كتابة قواعد PromQL هي ساعة لم يكتب فيها كوداً للعملاء، وكل 300 ميجابايت يأخذها Grafana من ذاكرة سيرفر بحجم 4 GB هي ذاكرة أخذها من قاعدة البيانات.
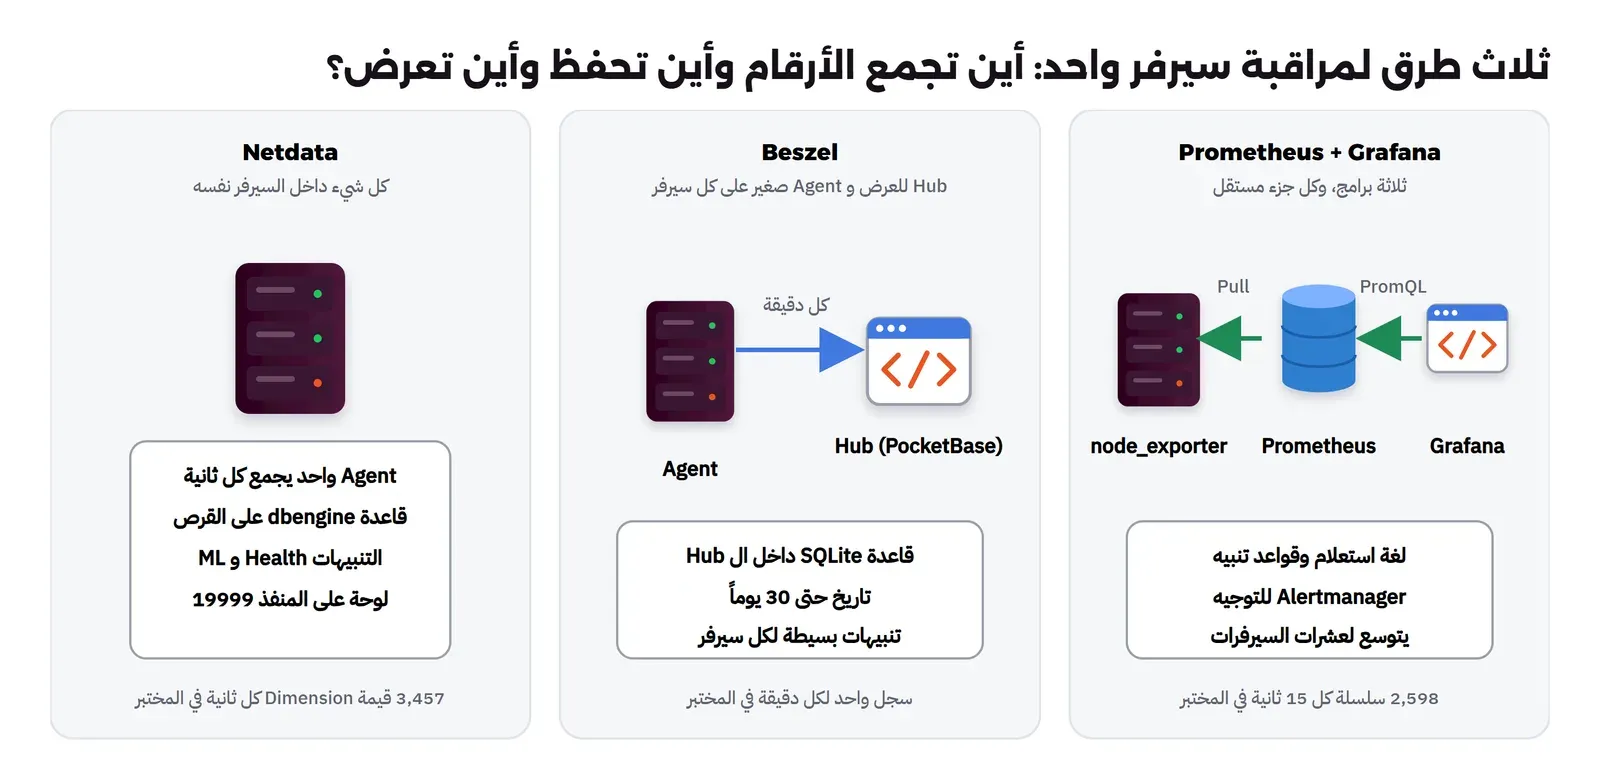
وفيما يلي الطرق الثلاث التي يختار منها صاحب السيرفر الواحد عادة، ولكل منها فكرة مختلفة في مكان جمع الأرقام ومكان حفظها ومكان عرضها:
- Netdata: برنامج واحد يعمل على السيرفر نفسه، يجمع آلاف القيم كل ثانية ويحفظها في قاعدة خاصة به على القرص، ويعرضها في لوحة جاهزة، ومعه مئات التنبيهات الجاهزة، فتثبته وتفتح المتصفح وتجد كل شيء.
- Beszel: قسمان: Agent صغير على كل سيرفر يقرأ الأرقام الأساسية، وHub واحد بواجهة ويب يحفظ الأرقام ويعرضها وينبهك، والفكرة أن تكون الأداة صغيرة جداً وتعرض ما يحتاجه أغلب الناس فقط.
- Prometheus مع Grafana: ثلاثة برامج على الأقل كما شرحنا في المقال الأول من السلسلة: node_exporter يعرض الأرقام، وPrometheus يسحبها ويخزنها ويقيم قواعد التنبيه، وGrafana يعرضها، ثم Alertmanager يوجه التنبيهات. وهي الأكثر مرونة والأكثر عملاً.
والصورة التالية تبين الفرق بين الطرق الثلاث بالأرقام التي رأيناها في المختبر:
وقد يتساءل البعض: إذا كان Netdata يجمع كل شيء كل ثانية، فلماذا يحتاج أحد إلى Prometheus أصلاً؟ والإجابة أن الأداتين تجيبان عن سؤالين مختلفين، فالأدوات الخفيفة تجيب عن سؤال «ماذا يحدث في هذا السيرفر الآن، وماذا حدث فيه البارحة؟»، أما Prometheus فيجيب عن سؤال «ماذا يحدث في خدمتي عبر كل السيرفرات، وما نسبة الطلبات الفاشلة في آخر شهر؟»، والسؤال الثاني يحتاج مقاييس من داخل تطبيقك كما شرحنا في الإشارات الذهبية، ولغة استعلام تجمعها، وتاريخاً طويلاً. وسوف نعود إلى هذا السؤال في آخر المقال بعلامات واضحة تقول لك متى حان وقت الانتقال.
كيف يعمل Netdata؟ الجمع كل ثانية Per-second مع طبقات التخزين Tiers
بدأ Netdata كمشروع مفتوح المصدر يعرض أرقام السيرفر كل ثانية في المتصفح، ثم أصبح شركة تقدم خدمة Netdata Cloud فوق ال Agent المفتوح. ويصف المستودع ال Agent بأنه نواة مفتوحة المصدر برخصة GPLv3 أو أحدث، ويذكر أن فيه أكثر من 800 تكامل Integration جاهز، أي أنه يعرف كيف يقرأ أرقام Nginx وPostgreSQL وRedis وDocker وغيرها دون أن تكتب شيئاً. والفكرة الأساسية فيه أن كل شيء يحدث على السيرفر نفسه: الجمع والتخزين والتنبيه والعرض، فلا يوجد سيرفر مركزي تحتاجه لتبدأ.
وال Agent من الداخل مجموعة من الجامعات Collectors، وكل جامع برنامج إضافي Plugin مسؤول عن نوع من البيانات: proc.plugin يقرأ المعالج والذاكرة والشبكة والأقراص من /proc، وapps.plugin يجمع العمليات Processes في مجموعات بحسب التطبيق، وcgroups.plugin يقرأ استهلاك كل Container، وgo.d.plugin فيه أغلب التكاملات مع التطبيقات. وكل هذه الأرقام تذهب إلى قاعدة بيانات خاصة اسمها dbengine، والصورة التالية تبين ذلك:
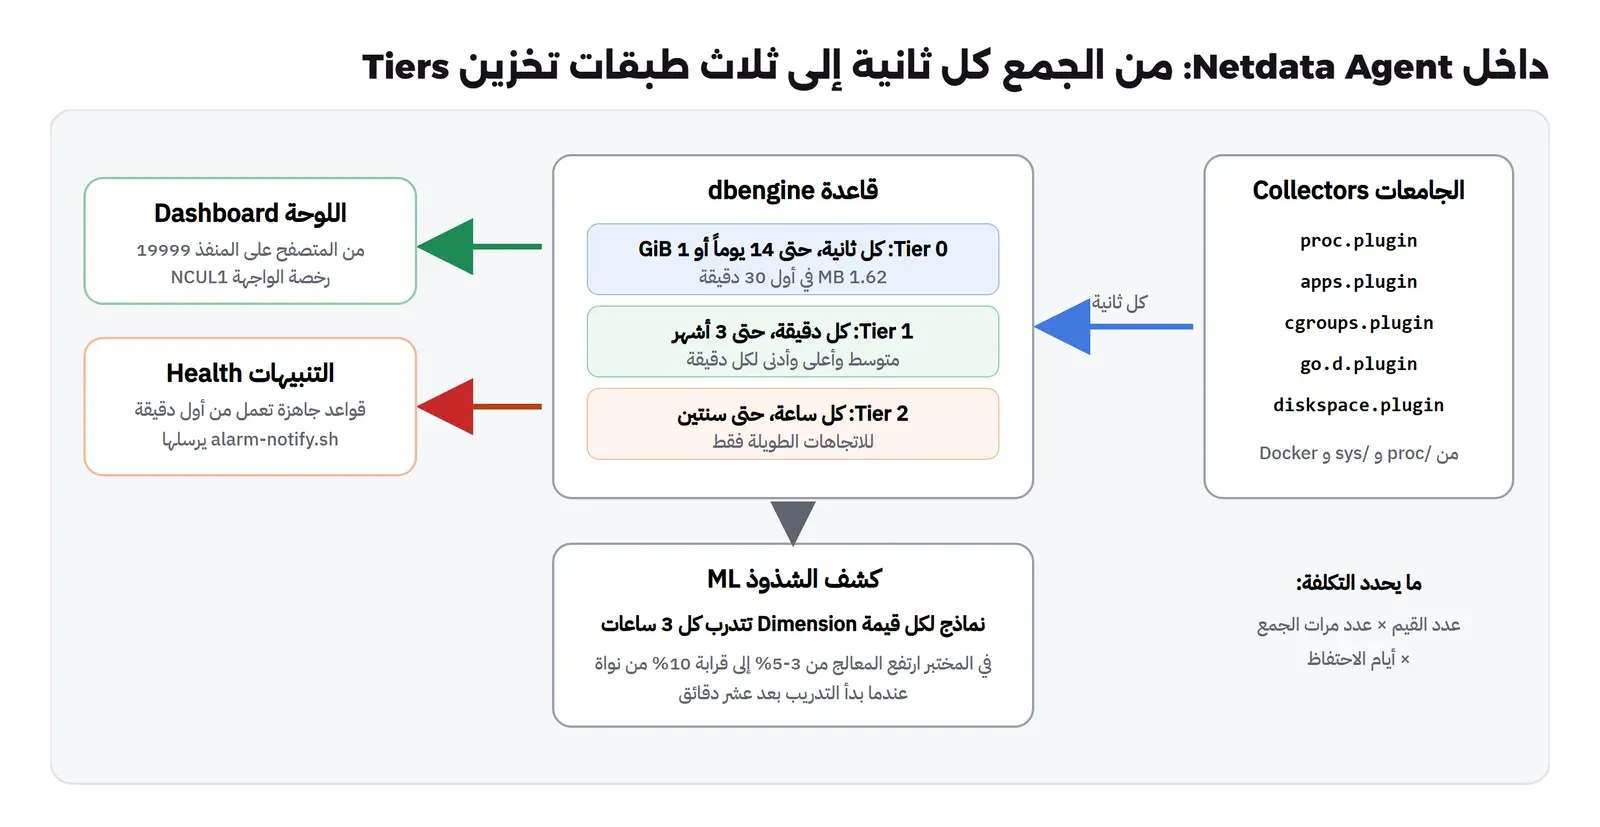
وأهم ما في الصورة هو طبقات التخزين، فبحسب توثيق قاعدة البيانات يحفظ Netdata افتراضياً ثلاث طبقات:
| الطبقة Tier | الدقة Resolution | حد الوقت الافتراضي | حد الحجم الافتراضي |
|---|---|---|---|
| 0 | كل ثانية | 14 يوماً | 1 GiB |
| 1 | كل دقيقة | 3 أشهر | 1 GiB |
| 2 | كل ساعة | سنتان | 1 GiB |
والطبقة تتوقف عند أول حد تصله، فإذا كان سيرفرك ينتج قيماً كثيرة امتلأ 1 GiB قبل 14 يوماً، وتنزل مدة الاحتفاظ الفعلية Effective Retention تلقائياً، وهذا ما سوف تراه في صفحة قاعدة البيانات في المختبر. والطبقتان الثانية والثالثة ليستا نسخة من الأولى، وإنما ملخص لكل دقيقة أو ساعة فيه المتوسط والأعلى والأدنى، فإذا رجعت إلى ما حدث قبل شهر فسوف ترى الدقيقة كاملة ولكن لن ترى الثانية التي ارتفع فيها المعالج.
والجزء الثاني الذي يميز Netdata هو كشف الشذوذ بتعلم الآلة Machine Learning، فبحسب ملف الإعداد الافتراضي يدرب ال Agent نماذج لكل قيمة يجمعها، ويعيد التدريب كل ثلاث ساعات على نافذة ست ساعات، ثم يعلم كل نقطة جديدة تختلف عن سلوك القيمة المعتاد. وهذه الخاصية مفيدة عندما لا تعرف ماذا تبحث عنه، ولكنها تكلف معالجاً، وسوف نرى في المختبر كم تكلف بالضبط.
والجزء الثالث هو التنبيهات Health، فال Agent يأتي بقواعد جاهزة لأغلب ما يجمعه، مثل استخدام المعالج والذاكرة والقرص وأخطاء الشبكة، وكل قاعدة مكتوبة في ملف نصي بلغة خاصة بسيطة، وسوف نقرأ واحدة منها في قسم التنبيهات، لأنها تفسر سلوكاً قد يفاجئك.
كيف يعمل Beszel؟ ال Hub مع ال Agent
Beszel مشروع أحدث بكثير برخصة MIT، وفكرته عكس فكرة Netdata تقريباً: بدل أن تجمع كل شيء، اجمع ما يحتاجه أغلب الناس فقط، أي المعالج والذاكرة والقرص والشبكة ومتوسط الضغط Load Average واستهلاك كل Container، مع الحرارة وصحة الأقراص S.M.A.R.T. إذا توفرت. ويتكون من قسمين كما يذكر توثيقه:
- ال Hub: تطبيق ويب مبني على PocketBase، وهو إطار يجمع قاعدة SQLite وواجهة برمجية API وواجهة إدارة في ملف تنفيذي واحد، ويحفظ ال Hub فيه الأنظمة والمستخدمين والأرقام والتنبيهات.
- ال Agent: برنامج صغير على كل سيرفر تريد مراقبته، يقرأ الأرقام من النظام ومن Docker، ويرسلها إلى ال Hub.
ولاحظ الفرق المهم هنا عن Netdata: ال Agent في Beszel لا يحفظ شيئاً ولا يعرض شيئاً، وإنما يجيب عن سؤال ال Hub كل دقيقة، وال Hub هو الذي يقرر ماذا يحفظ وكم يحفظ. وقد قرأنا كود الإصدار الذي اختبرناه لنعرف مدة الاحتفاظ، فوجدنا في ملف حذف السجلات القديمة خمسة أنواع من السجلات: سجل كل دقيقة يبقى ساعة، وسجل كل عشر دقائق يبقى 12 ساعة، وسجل كل عشرين دقيقة يبقى يوماً، وسجل كل ساعتين يبقى سبعة أيام، وسجل كل ثماني ساعات يبقى 30 يوماً. أي أن أقصى ما تراه في Beszel هو آخر شهر، وكلما رجعت في الوقت قلت الدقة، فما حدث البارحة تراه بنقطة كل عشرين دقيقة، وهذه معلومة مهمة لقصتنا سوف نعود إليها.
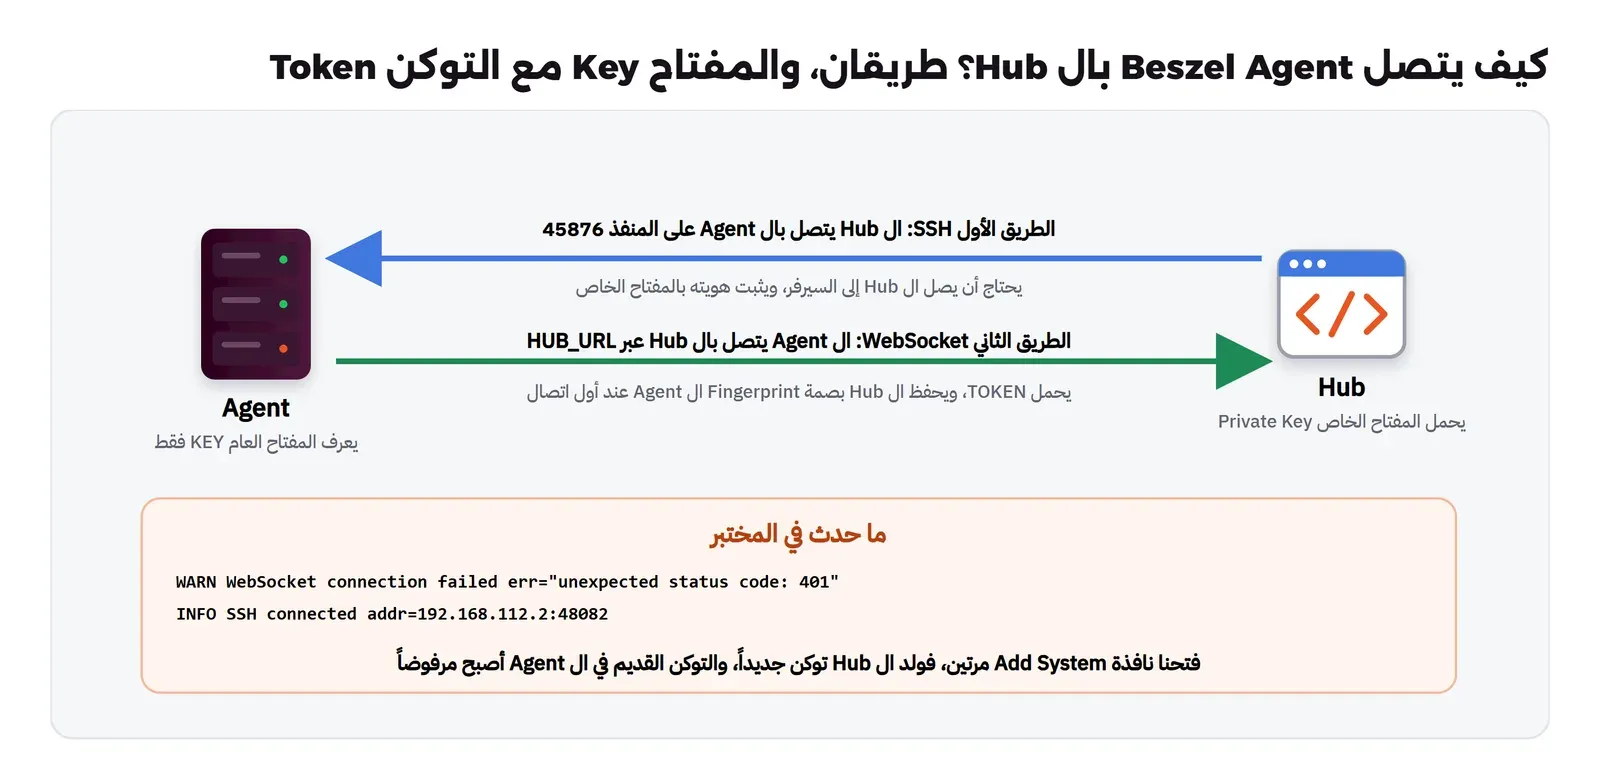
أما الاتصال بين ال Hub وال Agent فله طريقان، وهنا واجهتنا أول مشكلة في المختبر، لذلك نشرحهما قبل التشغيل:
- SSH: يشغل ال Agent سيرفر SSH صغيراً على المنفذ 45876، ويتصل به ال Hub ويثبت هويته بمفتاحه الخاص، وال Agent يعرف المفتاح العام فقط من المتغير
KEY، فلا يقبل الاتصال إلا من ال Hub الذي يملك المفتاح الخاص المطابق. وهذا الطريق يحتاج أن يصل ال Hub إلى السيرفر، أي أن يكون المنفذ مفتوحاً له. - WebSocket: يتصل ال Agent بنفسه بال Hub عبر الرابط
HUB_URLويحمل التوكنTOKEN، كما يذكر دليل تثبيت ال Agent، وهذا الطريق مناسب عندما يكون السيرفر خلف جدار ناري Firewall أو NAT لا يقبل اتصالاً من الخارج، لأن الاتصال يخرج من السيرفر.
المختبر Lab: سيرفر واحد مع ثلاث أدوات
سوف نشغل على سيرفر Linux واحد بثمانية معالجات وذاكرة 32 GB ثلاث مجموعات مراقبة جنباً إلى جنب: Netdata، ثم Beszel بال Hub وال Agent، ثم node_exporter مع Prometheus مع Grafana للمقارنة، وكلها في Containers أسماؤها تبدأ بـ dv2m- حتى نحذفها بأمر واحد في النهاية. والإصدارات المثبتة هي Netdata 2.12.2 وBeszel 0.21.1 وPrometheus 3.15.1 وnode_exporter 1.12.1 وGrafana 13.2.5 على Docker Engine 29.8.0. ولاحظ أن السيرفر كان يشغل في الوقت نفسه Containers أخرى، منها قاعدتا PostgreSQL وMySQL، وهذا مفيد لأنه يشبه السيرفر الحقيقي الذي ليس فارغاً، وسوف ترى كيف تعامل Netdata معهما.
تشغيل Netdata: مشكلة واجهتنا مع الربط rslave
بدأنا بالأمر الذي يقترحه دليل التثبيت عبر Docker كما هو، مع تغيير الاسم وال Volumes:
docker run -d --name=dv2m-netdata --pid=host --network=host \
  -v dv2m-ndconfig:/etc/netdata -v dv2m-ndlib:/var/lib/netdata -v dv2m-ndcache:/var/cache/netdata \
  -v /:/host/root:ro,rslave -v /etc/passwd:/host/etc/passwd:ro -v /etc/group:/host/etc/group:ro \
  -v /etc/localtime:/etc/localtime:ro -v /proc:/host/proc:ro -v /sys:/host/sys:ro \
  -v /etc/os-release:/host/etc/os-release:ro -v /var/log:/host/var/log:ro \
  -v /var/run/docker.sock:/var/run/docker.sock:ro -v /run/dbus:/run/dbus:ro \
  --restart unless-stopped --cap-add SYS_PTRACE --cap-add SYS_ADMIN --security-opt apparmor=unconfined \
  netdata/netdata:v2.12.2
والمخرج كان رفضاً من Docker قبل أن يبدأ ال Container:
docker: Error response from daemon: path / is mounted on / but it is not a shared or slave mountوالسبب في الخيار rslave على ربط قسم النظام الرئيسي Root Partition، فهذا الخيار يطلب أن تصل إلى ال Container أي أقراص تربط في السيرفر لاحقاً، حتى يراها Netdata دون إعادة تشغيل، وهو يحتاج أن يكون الربط الأصلي من نوع shared أو slave في السيرفر نفسه، وهذا غير متحقق في بيئتنا التي تشغل Docker داخل آلة افتراضية. والحل كان حذف ,rslave والإبقاء على ro فقط، وثمن ذلك أن القرص الذي تضيفه للسيرفر بعد تشغيل Netdata لن يظهر حتى تعيد تشغيل ال Container. وعلى سيرفر Linux عادي بنظام systemd يكون الربط shared افتراضياً، فغالباً لن تقابل هذا الخطأ، ولكن إذا قابلته فهذا سببه. وقد واجهنا المشكلة نفسها مع node_exporter في مقال Prometheus، فهي ليست خاصة بNetdata.
وبعد التشغيل الثاني قرأنا ما يعرفه ال Agent عن نفسه من واجهته البرمجية:
curl -s http://127.0.0.1:19999/api/v1/info | head -40
curl -s http://127.0.0.1:19999/api/v1/charts | python3 -c "import sys,json;d=json.load(sys.stdin);c=d['charts'];print('charts',len(c),'dims',sum(len(x['dimensions']) for x in c.values()),'update_every',d['update_every'])"
والمخرج كان كما يلي، مختصراً:
"version":"v2.12.2",
"alarms":{ "normal":519, "warning":2, "critical":0 },
"cores_total":"8",
"ram_total":"33592184832",
"container_os_name":"Debian GNU/Linux",
"virtualization":"microsoft",
charts 1353 dims 3457 update_every 1
في المخرج أعلاه لاحظ التالي:
- بعد دقيقة واحدة من التشغيل كان Netdata يجمع 1353 رسماً بيانياً Chart فيها 3457 قيمة Dimension، كل ثانية، أي قرابة 3500 رقم في الثانية من سيرفر واحد، دون أن نكتب سطر إعداد واحداً.
- هناك 521 تنبيهاً يعمل، منها اثنان في حالة تحذير Warning من أول دقيقة، وكلاهما على امتلاء أقراص التخزين التي يربطها هذا السيرفر، وكانا صادقين، فأحدهما ممتلئ بنسبة 97.9%. وهذا مثال جيد على قيمة التنبيهات الجاهزة: لم نطلب شيئاً ووصلنا تحذير صحيح.
- Netdata يعرف أنه يعمل داخل Container على نظام Debian، ويقرأ أرقام السيرفر من المسارات التي ربطناها تحت
/host.
الاكتشاف التلقائي Service Discovery يطرق أبواب قواعد البيانات
عندما قرأنا سجل ال Container في الدقيقة الأولى وجدنا سطوراً لم نتوقعها:
level=info msg="job configuration command completed" plugin=go.d ... resource=postgres_docker_arabmath-dev-postgres-1 command=enable state=accepted
level=error msg="check failed: error on pinging the Postgres database [postgres://netdata:[email protected]:5432/postgres]: ...
  failed SASL auth: FATAL: password authentication failed for user \"netdata\" (SQLSTATE 28P01)" plugin=go.d collector=postgres
level=error msg="PANIC panic runtime error: slice bounds out of range [:17] with capacity 5" plugin=go.d collector=mysql job=docker_arabroot-dev-db-1
والذي حدث أن Netdata قرأ قائمة ال Containers من docker.sock الذي ربطناه، فوجد Container يعمل على المنفذ 5432 فقرر أنه PostgreSQL، وحاول الدخول إليه بمستخدم اسمه netdata وكلمة مرور postgres، وهي القيم الافتراضية المكتوبة في ملف الاكتشاف نفسه:
docker exec dv2m-netdata grep -n -A5 'id: "postgres"' /usr/lib/netdata/conf.d/go.d/sd/docker.conf181: - id: "postgres"
182: match: '{{ or (eq .PrivatePort "5432") (match "sp" .Image "postgres postgres:* */postgres */postgres:* */postgresql */postgresql:*") }}'
183: config_template: |
184: module: postgres
185: name: docker_{{.Name}}
186: dsn: postgres://netdata:postgres@{{.Address}}/postgresوفي هذا درسان عمليان: الأول أن محاولة دخول فاشلة كل فترة على قاعدة البيانات سوف تظهر في سجلات PostgreSQL وفي أي أداة تراقب محاولات الدخول، فإذا كان عندك تنبيه على محاولات الدخول الفاشلة فسوف يطلق بسبب أداة المراقبة نفسها، وقد يضيع فريقك ساعة في البحث عن «مخترق» اسمه netdata. والثاني أن الاكتشاف التلقائي لا يعرف كلمات المرور، فإذا أردت أرقام PostgreSQL فعليك أن تنشئ مستخدماً للقراءة فقط بصلاحية pg_monitor وتكتب بياناته في ملف go.d/postgres.conf، وإذا لم تردها فأوقف الوحدة في go.d.conf بالسطر postgres: no حتى تتوقف المحاولات. أما السطر الثالث فهو خطأ برمجي في جامع MySQL مع هذا ال Container بالذات، ولم يوقف ال Agent، ولكنه تذكير بأن 800 تكامل تعني 800 مكاناً قد يخطئ فيه شيء، فاقرأ سجل Netdata بعد تثبيته مرة واحدة على الأقل.
اللوحة Dashboard: الدخول دون Netdata Cloud
عندما تفتح المنفذ 19999 في المتصفح تظهر لك صفحة فيها حالة قاعدة البيانات على اليسار، وطلب الدخول إلى Netdata Cloud على اليمين:
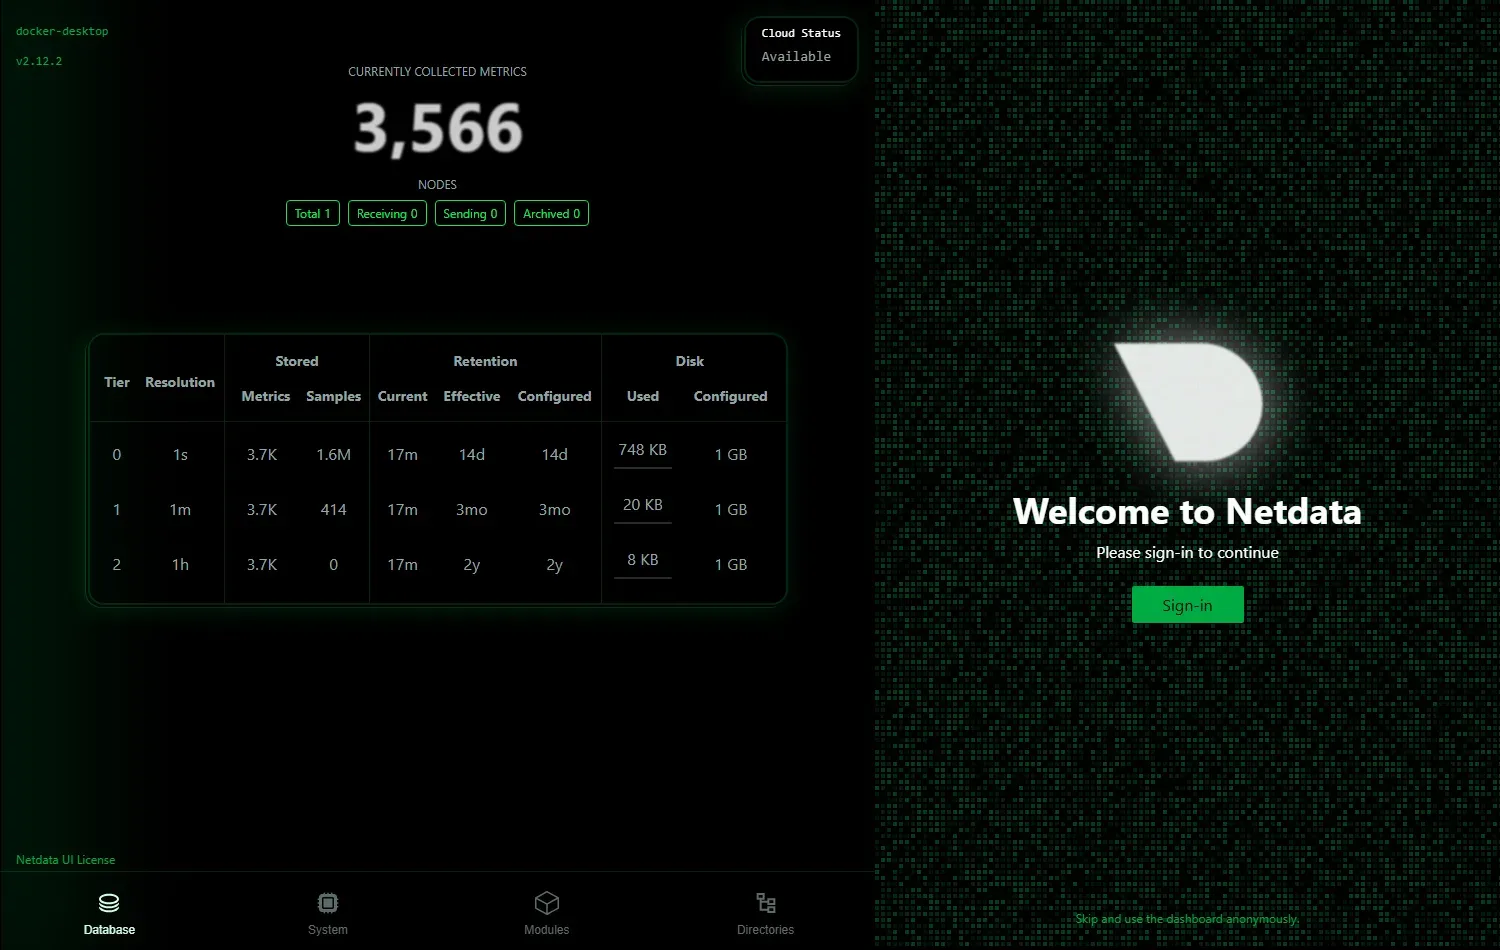
ولاحظ الرابط الصغير في أسفل الصفحة Skip and use the dashboard anonymously، فهو يفتح اللوحة دون حساب في Netdata Cloud، وكل الأرقام تبقى على سيرفرك. وبعد الضغط عليه تظهر اللوحة الكاملة:
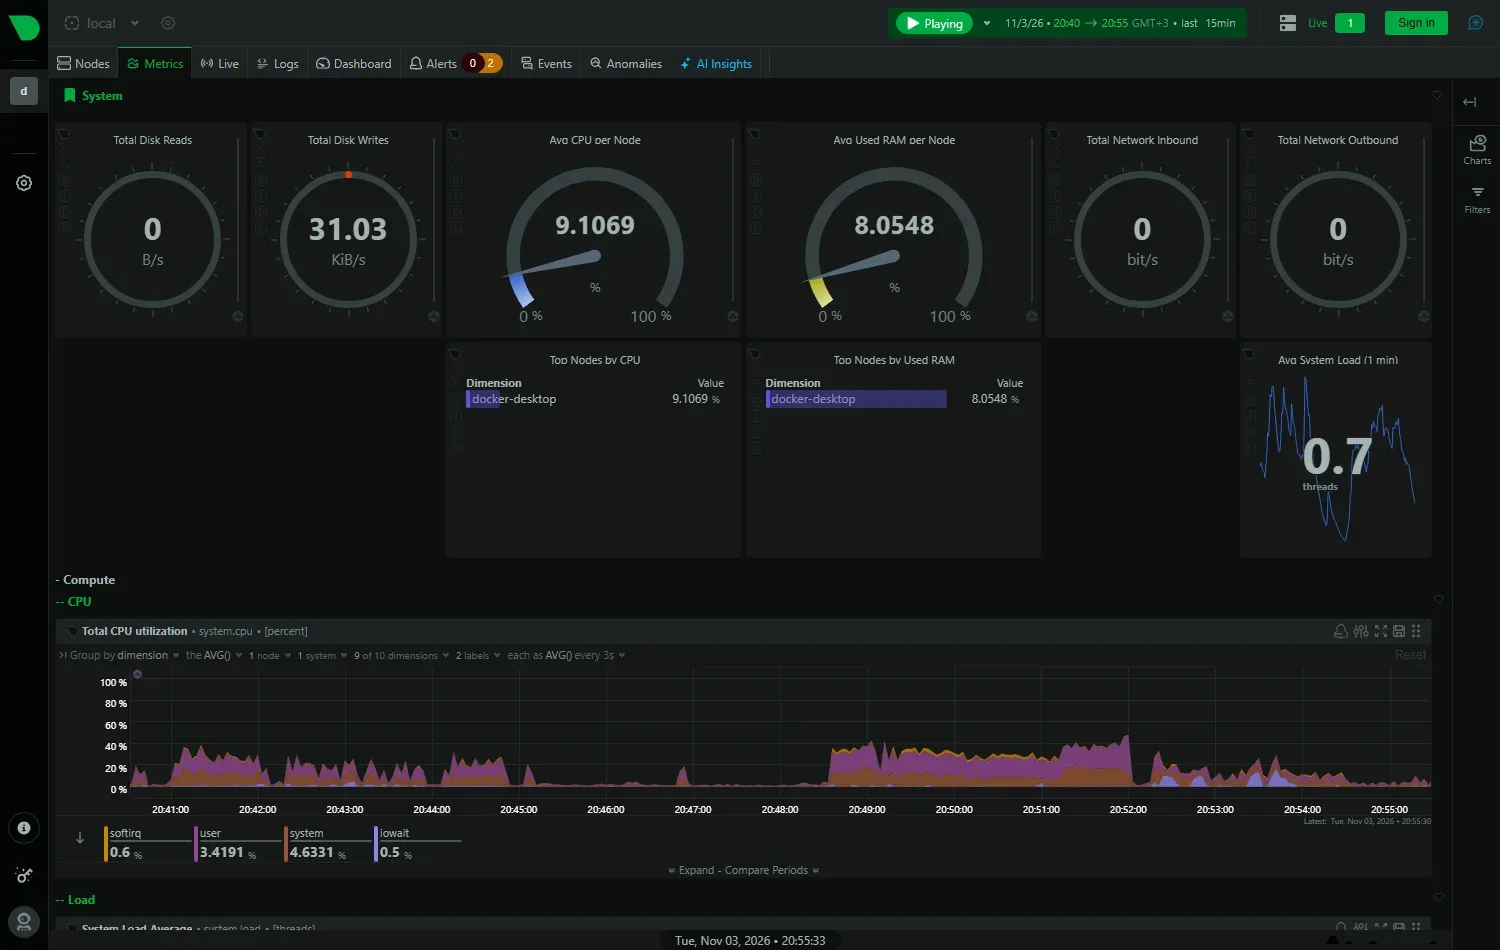
وهذه اللوحة هي أهم ما في Netdata لصاحب السيرفر الواحد، فهي تعرض كل شيء مرتباً بحسب النوع: المعالج ثم الذاكرة ثم الأقراص ثم الشبكة ثم التطبيقات وال Containers، وتستطيع أن تحدد فترة زمنية بالفأرة فتتحرك كل الرسوم معها. وفي قصتنا كان هذا يكفي المطور ليعرف ماذا حدث تلك الليلة: يرجع إلى الساعة الثالثة فجراً، فيجد أن رسم الذاكرة امتلأ في الدقيقة نفسها التي بدأت فيها مهمة النسخ الاحتياطي، ورسم ال Swap يرتفع معها. ولاحظ أن الأرقام بدقة الثانية تبقى 14 يوماً فقط في الإعداد الافتراضي، فإذا جاءت الشكوى بعد ثلاثة أسابيع رأيت المتوسط لكل دقيقة.
تشغيل Beszel مع إضافة السيرفر Add System
بدأنا بال Hub وحده، ووجهة المتصفح على 127.0.0.1 فقط:
docker run -d --name dv2m-beszel --network dv2m-net -p 127.0.0.1:18090:8090 \
  -e APP_URL=http://127.0.0.1:18090 -v dv2m-beszel-data:/beszel_data henrygd/beszel:0.21.1
وعند فتح الصفحة لأول مرة يطلب منك إنشاء حساب المدير Admin، ثم تضغط Add System فتظهر نافذة فيها اسم السيرفر وعنوانه والمنفذ 45876 والمفتاح العام والتوكن، ونسخنا منها القيمتين إلى أمر ال Agent:
docker run -d --name dv2m-beszel-agent --network host \
  -v /var/run/docker.sock:/var/run/docker.sock:ro -v dv2m-beszel-agent:/var/lib/beszel-agent \
  -e LISTEN=45876 -e "KEY=ssh-ed25519 AAAAC3NzaC1lZDI1NTE5AAAAIDwuSNkaNqkwo4DkHxY6ErS7HdHBJsa6Kh/WrUK+VegG" \
  -e TOKEN=b778e6e4-ea87-4fb5-8259-5fb606c3bc67 -e HUB_URL=http://127.0.0.1:18090 \
  henrygd/beszel-agent:0.21.1-alpine
في الأمر أعلاه لاحظ التالي:
- ال Agent يعمل بشبكة السيرفر
--network hostحتى يقرأ أرقام الشبكة الحقيقية وليس شبكة ال Container، وهذا ما يقترحه الدليل، ومعناه أن المنفذ 45876 مفتوح على السيرفر، فأغلقه في الجدار الناري لكل عنوان غير عنوان ال Hub. docker.sockمربوط للقراءة فقط:ro، ومنه يقرأ ال Agent استهلاك كل Container، وتذكر أن من يقرأ هذا الملف يعرف كل ما يعمل على السيرفر، فلا تربطه في أي Container لا تثق به.- ال Image بحجم 46 MB على القرص، مقابل 1.32 GB ل Image ال Netdata، وهذا وحده يعطيك فكرة عن الفرق في الحجم.
مشكلة واجهتنا: الرمز 401 من ال WebSocket
بعد التشغيل قرأنا سجل ال Agent فوجدنا:
INFO Detected disk name=sdc device=sdc mount=/etc/hostname io=sdc root=true
INFO Detected network interface name=eth0 sent=1005974101 recv=5676769167
WARN WebSocket connection failed err="unexpected status code: 401"
INFO Starting SSH server addr=:45876 network=tcp
ال Agent جرب WebSocket أولاً فرفضه ال Hub بالرمز 401 أي غير مصرح Unauthorized، فرجع إلى الطريق الأول وشغل سيرفر SSH ينتظر ال Hub. وفي البداية ظننا أن الرفض طبيعي لأننا لم نضف السيرفر في ال Hub بعد، فأضفناه من النافذة بعنوانه، وبعد ثوان ظهر في السجل:
WARN WebSocket connection failed err="unexpected status code: 401"
INFO SSH connected addr=192.168.112.2:48082
INFO SSH connection established
فالسيرفر أصبح يعمل في ال Hub عبر SSH، ولكن الرفض استمر حتى بعد الإضافة. فسألنا واجهة PocketBase البرمجية عن السجل الذي يحفظ فيه ال Hub توكن كل نظام:
curl -s "http://127.0.0.1:18090/api/collections/fingerprints/records" -H "Authorization: $T"{"items":[{"collectionName":"fingerprints","fingerprint":"","system":"6dwf59iuv7jy7t6",
"token":"fc58dd61-6482-48d3-96c7-161b8ae822b4","updated":"2026-11-03 17:42:09.177Z"}], ...}والتوكن المحفوظ fc58dd61… ليس التوكن الذي أعطيناه لل Agent b778e6e4…، والسبب أننا فتحنا نافذة Add System مرتين: مرة لنسخ المفتاح والتوكن، ومرة لإضافة السيرفر، والنافذة تولد توكن جديداً في كل مرة تفتح، والمحفوظ هو توكن المرة الأخيرة. والحل أن تنسخ القيم من النافذة نفسها التي تضغط فيها Add System، أو أن تستخدم التوكن العام Universal Token من الإعدادات كما يذكر الدليل. وبعد إعادة إنشاء ال Agent بالتوكن الصحيح ظهر في السجل:
INFO WebSocket connected host=127.0.0.1:18090وأصبح حقل البصمة fingerprint في السجل نفسه يحمل قيمة، أي أن ال Hub ربط هذا النظام بهذا ال Agent بالذات، فإذا سرق أحد التوكن وحاول الاتصال من جهاز آخر فلن تطابق البصمة. وقد يتساءل البعض: إذا كان SSH يعمل، فلماذا نهتم ب WebSocket؟ والإجابة أن SSH يحتاج أن يفتح السيرفر منفذاً يصل إليه ال Hub، أما WebSocket فالاتصال يخرج من السيرفر، فتستطيع أن تغلق المنفذ 45876 تماماً، وهذا هو الأنسب لسيرفر على الإنترنت، ولسيرفرات خلف NAT في مكتب أو فرع.
وهذه هي قائمة الأنظمة في ال Hub بعد الإضافة:
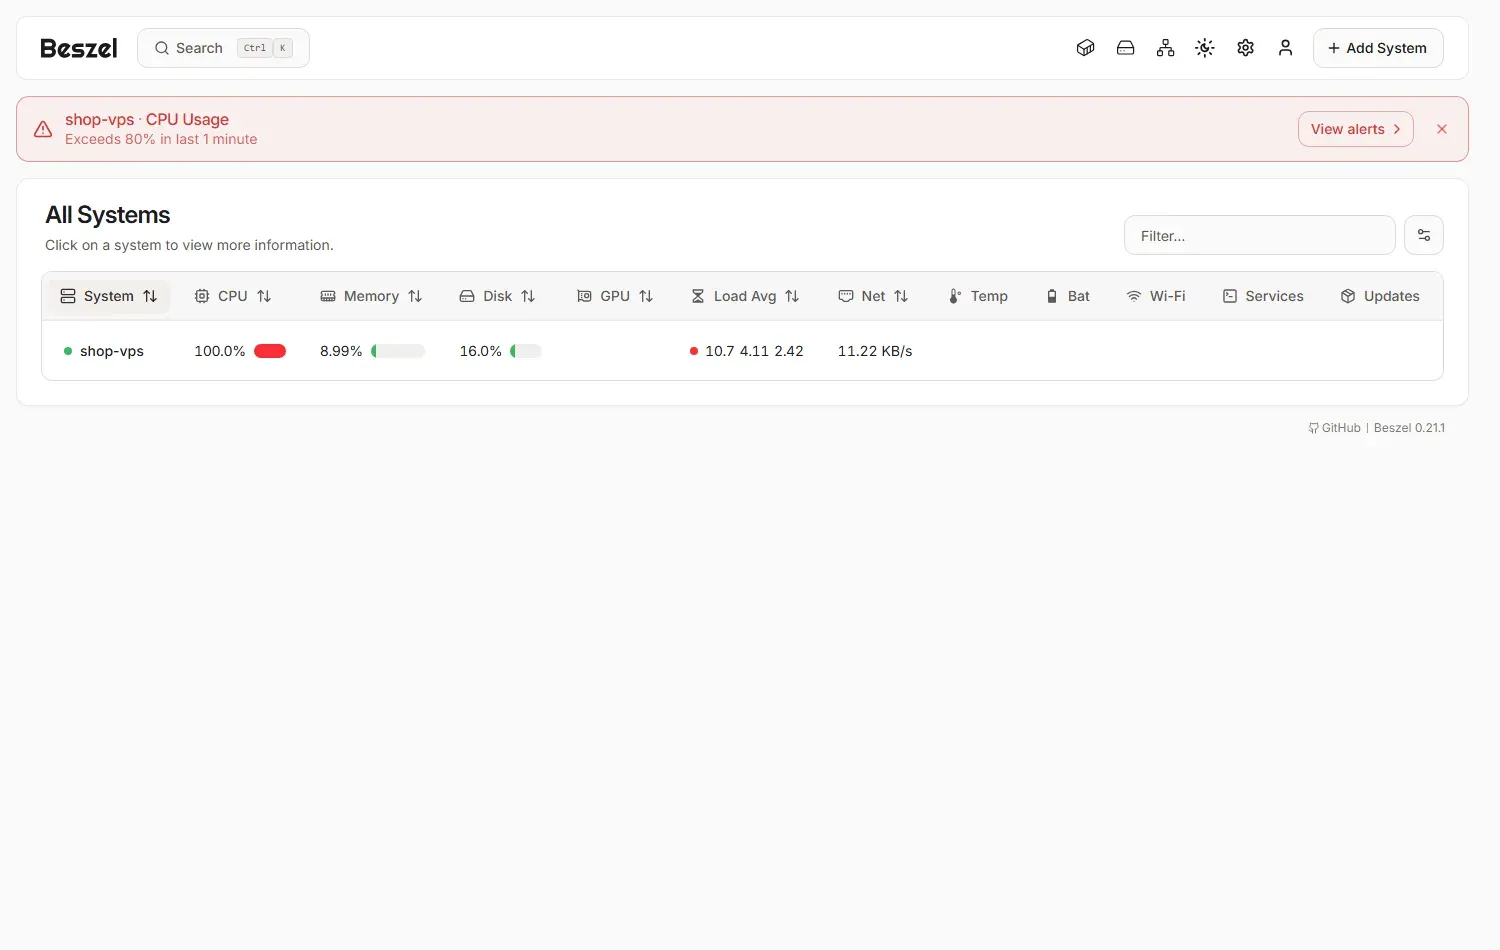
وفي صفحة السيرفر تجد رسوم المعالج والذاكرة للسيرفر كله ولكل Container، وسوف نعرضها في قسم التنبيهات مع تجربة الضغط. ولاحظ شيئاً في سجل ال Agent أعلاه: القرص الوحيد الذي اكتشفه هو القرص الرئيسي sdc، بينما وجد Netdata كل أقراص التخزين المربوطة في السيرفر ونبه على اثنين منها. فإذا كان عندك قرص بيانات منفصل، مثل قرص قاعدة البيانات أو النسخ الاحتياطي، فعليك أن تضيفه لل Agent صراحة: في Docker بربط مجلد منه تحت /extra-filesystems، وفي التثبيت المباشر بالمتغير EXTRA_FILESYSTEMS، كما يشرح توثيق الأقراص الإضافية، وإلا فلن يراه Beszel ولن ينبهك إذا امتلأ.
للمقارنة: node_exporter مع Prometheus مع Grafana
حتى تكون المقارنة عادلة شغلنا على السيرفر نفسه المجموعة التي بنيناها في المقال الأول من السلسلة، بأبسط إعداد ممكن: node_exporter يقرأ السيرفر، وPrometheus يسحب منه كل 15 ثانية وهي القيمة التي تستخدمها أغلب الأدلة، وGrafana دون لوحات:
# The "graduation" stack for the same server: node_exporter every 15 s (the default most guides use)
global:
  scrape_interval: 15s
scrape_configs:
  - job_name: node
    static_configs:
      - targets: ['192.168.112.1:9100']
وبعد التشغيل سألنا Prometheus كم سلسلة Series يسحب في كل مرة:
curl -s 'http://127.0.0.1:19090/api/v1/query?query=scrape_samples_scraped'{"status":"success","data":{"resultType":"vector","result":[{"metric":{"__name__":"scrape_samples_scraped",
"instance":"192.168.112.1:9100","job":"node"},"value":[1793728371.549,"2598"]}]}}أي 2598 قيمة كل 15 ثانية، مقابل قرابة 3500 قيمة كل ثانية في Netdata، ونحو عشرين رقماً أساسياً كل دقيقة في Beszel. وهذه الأرقام الثلاثة تفسر أغلب ما سوف تراه في قسم الموارد.
كم تستهلك كل أداة؟ الذاكرة RAM مع المعالج CPU، ثم القرص Disk
قسنا استهلاك كل Container بالأمر docker stats كل 25 ثانية تقريباً لمدة نصف ساعة، واستبعدنا الدقائق التي كان فيها ضغط مقصود على المعالج، والنسبة في عمود المعالج هي نسبة من نواة واحدة، فـ 100% تعني نواة كاملة من ثماني نوى:
while :; do docker stats --no-stream --format "$(date -u +%T) {{.Name}} {{.CPUPerc}} {{.MemUsage}}" \
  dv2m-netdata dv2m-beszel dv2m-beszel-agent; sleep 25; done
والنتيجة كانت كما يلي:
| الأداة | المعالج: الوسيط | المعالج: أعلى 10% | الذاكرة بعد نصف ساعة | القرص بعد نصف ساعة | حجم ال Image |
|---|---|---|---|---|---|
| Netdata (الإعداد الافتراضي) | 6.4% | 12.3% | 161 MiB | 21 MB | 1.32 GB |
| Beszel Hub | 0% | 0.16% | 24 MiB | 2.9 MB | 47.6 MB |
| Beszel Agent | 0% | 0.03% | 13 MiB | لا شيء | 46.3 MB |
| Prometheus | 0.5% | 1.2% | 46 MiB | 1.3 MB | 381 MB |
| node_exporter | 0% | 0% | 18 MiB | لا شيء | 41 MB |
| Grafana (دون لوحات ودون مستخدم) | 1.9% | 21.3% | 359 MiB | قاعدة SQLite صغيرة | 1.95 GB |
والصورة التالية تضع الأرقام نفسها جنباً إلى جنب:
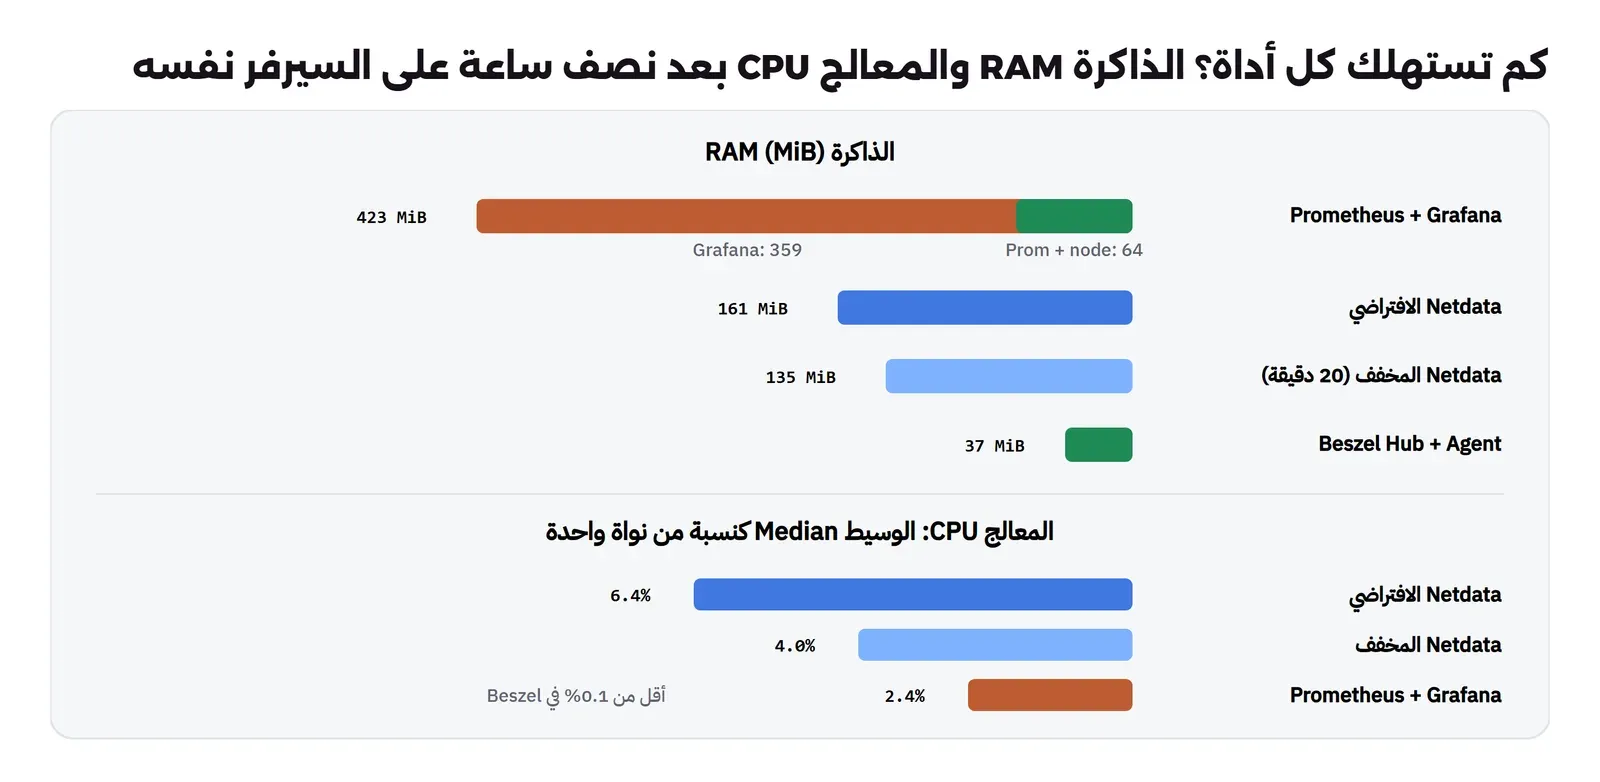
في الجدول أعلاه لاحظ التالي:
- Beszel هو الأخف بفارق كبير: ال Agent وال Hub معاً أقل من 40 MiB، والمعالج قريب من الصفر، والسبب بسيط: يجمع عشرات القيم كل دقيقة، لا آلاف القيم كل ثانية. وعلى سيرفر بذاكرة 1 GB فهذا هو الفرق بين أداة لا تشعر بها وأداة تأخذ سدس الذاكرة.
- Netdata في حدود ما يذكره توثيقه: صفحة استهلاك الموارد تذكر 100 إلى 200 MB على نظام فارغ، و1% إلى 5% من نواة في الإعداد الافتراضي، وقد رأينا 161 MiB، والمعالج بين 3% و5% في الدقائق العشر الأولى، ثم ارتفع إلى ما بين 4% و15% بعد ذلك، وسوف نعرف السبب في القسم التالي.
- أغلب تكلفة مجموعة Prometheus هي Grafana: Prometheus وnode_exporter معاً قرابة 64 MiB، أما Grafana فأخذ 359 MiB وهو لا يعرض شيئاً لأحد، وارتفع معالجه في بعض العينات إلى 21% من نواة بسبب أعماله الدورية. فإذا كان سيرفرك صغيراً وأردت Prometheus فضع Grafana على جهاز آخر، أو اكتف بواجهة Prometheus نفسها في البداية.
- حجم ال Image يهم عند التحديث: 1.32 GB لNetdata و1.95 GB لGrafana تنزل في كل تحديث، وعلى قرص بحجم 25 GB هذا ليس رقماً صغيراً.
أما القرص فلا تحكم عليه بأول نصف ساعة، لأن Netdata يحجز مساحة الطبقات تدريجياً، والأفضل أن تقرأ تقدير الأداة نفسها. ففي صفحة البداية بعد 30 دقيقة كانت الطبقة الأولى قد استخدمت 1.62 MB، وقدر Netdata المدة الفعلية لها بـ 13 يوماً و3 ساعات بدل 14 يوماً، أي أن سيرفرنا ينتج بدقة الثانية قرابة 78 MB في اليوم، وسوف يصل إلى حد 1 GiB قبل حد الأيام بقليل. وكل الطبقات الثلاث معاً حدها الافتراضي 3 GiB، ويذكر التوثيق قرابة 4 GiB مع البيانات الوصفية Metadata، فاحسب هذه المساحة من البداية على أي سيرفر صغير. أما Beszel فلا يتجاوز سجلات آخر شهر بالتلخيص الذي شرحناه، فيبقى حجمه صغيراً جداً، وPrometheus يعتمد على مدة الاحتفاظ Retention التي تحددها، وقد شرحنا حسابها في المقال الأول.
ماذا يحدث إذا خففنا Netdata؟ الجمع كل ثانيتين دون ML
عندما رسمنا عينات المعالج لNetdata بالترتيب لاحظنا أنها كانت بين 3% و5% من نواة حتى الدقيقة العاشرة تقريباً بعد التشغيل، ثم أصبحت ترتفع إلى 10% و15% بعد ذلك، وشككنا أن السبب بداية تدريب نماذج ML لكل واحدة من 3457 قيمة، لأن ال Agent لا يدرب النماذج حتى تتجمع عنده بيانات كافية بحسب الإعداد min training window، والتجربة التالية أثبتت ذلك. ويقترح التوثيق نفسه طريقتين لتخفيف ال Agent: الجمع كل ثانيتين بدل كل ثانية، وهو حسب التوثيق قد يقلل المعالج إلى النصف، وإيقاف ML. فجربنا الاثنين معاً بهذا الملف:
# Lighter Netdata for a small server: collect every 2 seconds instead of 1, and turn off ML anomaly detection
[db]
    update every = 2s
[ml]
    enabled = no
docker cp netdata.conf dv2m-netdata:/etc/netdata/netdata.conf
docker restart dv2m-netdataوبعد إعادة التشغيل أصبح ال Agent يجمع 3069 قيمة كل ثانيتين بدل 3457 كل ثانية، وقسنا 20 دقيقة أخرى بالطريقة نفسها، وقارنا الفترة نفسها من عمر ال Agent في التشغيلين حتى تكون المقارنة عادلة:
| الفترة من عمر ال Agent | الإعداد الافتراضي | كل ثانيتين دون ML |
|---|---|---|
| أول عشر دقائق (قبل تدريب ML) | المعالج 3.4% من نواة، والذاكرة 140 MiB | المعالج 3.9%، والذاكرة 129 MiB |
| من الدقيقة 10 إلى 19 | المعالج 7.4% من نواة، والذاكرة 154 MiB | المعالج 4.4%، والذاكرة 135 MiB |
في الجدول أعلاه لاحظ التالي:
- أغلب التوفير في المعالج جاء من إيقاف ML، فالارتفاع من 3.4% إلى 7.4% بعد الدقيقة العاشرة اختفت، وبقي المعالج حول 4% طوال الفترة.
- الجمع كل ثانيتين لم يقسم المعالج إلى النصف في سيرفرنا كما قد يفهم من التوثيق، لأن جزءاً من عمل ال Agent لا يتعلق بعدد مرات الجمع، مثل قراءة قائمة العمليات وال Containers والاكتشاف التلقائي، ولكنه يقلل حجم الطبقة الأولى على القرص تقريباً إلى النصف، لأن عدد العينات في اليوم نصف ما كان.
- الذاكرة نزلت قرابة 20 MiB، وهو فرق صغير على سيرفر بذاكرة 4 GB وملحوظ على سيرفر بذاكرة 1 GB.
والقرار هنا ليس تقنياً فقط: إذا كنت تعتمد على صفحة Anomalies في Netdata لتكتشف ما لا تعرف أن تبحث عنه فلا توقف ML، وإذا كنت تستخدم Netdata للرسوم والتنبيهات فقط على سيرفر صغير فإيقافه يوفر نصف استهلاك المعالج تقريباً.
التنبيهات Alerts: من يخبرك أولاً؟
الرسم البياني يفيدك في الصباح عندما تبحث عن السبب، أما في الليل فالذي يفيدك هو التنبيه، وفي قصتنا لم يعرف المطور بالمشكلة إلا من العملاء. والأداتان فيهما تنبيهات، ولكن بفلسفتين مختلفتين: Netdata يأتي بمئات القواعد الجاهزة ويرسلها عبر سكربت alarm-notify.sh أو عبر Netdata Cloud، وBeszel يأتي بقائمة قصيرة من التنبيهات تفعلها أنت لكل سيرفر: المعالج والذاكرة والقرص ودرجة الحرارة وحالة الاتصال وغيرها، وكل تنبيه له حد ومدة بالدقائق، ويرسلها إلى البريد أو إلى روابط Webhook بصيغة مكتبة Shoutrrr.
وحتى نرى التنبيهات تصل فعلاً شغلنا مستقبلاً صغيراً بلغة Python يطبع وقت كل طلب POST يصله ومحتواه:
# A tiny webhook receiver: prints the time and body of every POST, so we can see when each tool sent its alert.
import datetime, http.server
class H(http.server.BaseHTTPRequestHandler):
    def do_POST(self):
        body = self.rfile.read(int(self.headers.get("Content-Length", 0))).decode()
        print(datetime.datetime.now(datetime.UTC).strftime("%H:%M:%S"), self.path, body, flush=True)
        self.send_response(200); self.end_headers()
    def log_message(self, *a): pass
http.server.HTTPServer(("0.0.0.0", 8080), H).serve_forever()
ثم ضبطنا في Beszel رابط Webhook هو generic://dv2m-hook:8080/beszel?template=json&disabletls=yes، وفعلنا ثلاثة تنبيهات للسيرفر: المعالج فوق 80% لمدة دقيقة، والذاكرة فوق 80% لمدة دقيقة، وحالة الاتصال Status.
ماذا يحدث إذا امتلأ المعالج CPU؟ تجربة الضغط Stress Test
شغلنا Container يدير ثماني حلقات فارغة، واحدة لكل نواة، لمدة 11 دقيقة، أي أن المعالج امتلأ بالكامل وهو ما يحدث تقريباً عندما تعلق عملية في حلقة لا تنتهي:
date -u +%T
docker run -d --name dv2m-stress alpine:3.24 sh -c 'for i in 1 2 3 4 5 6 7 8; do timeout 660 sh -c "while :; do :; done" & done; wait'
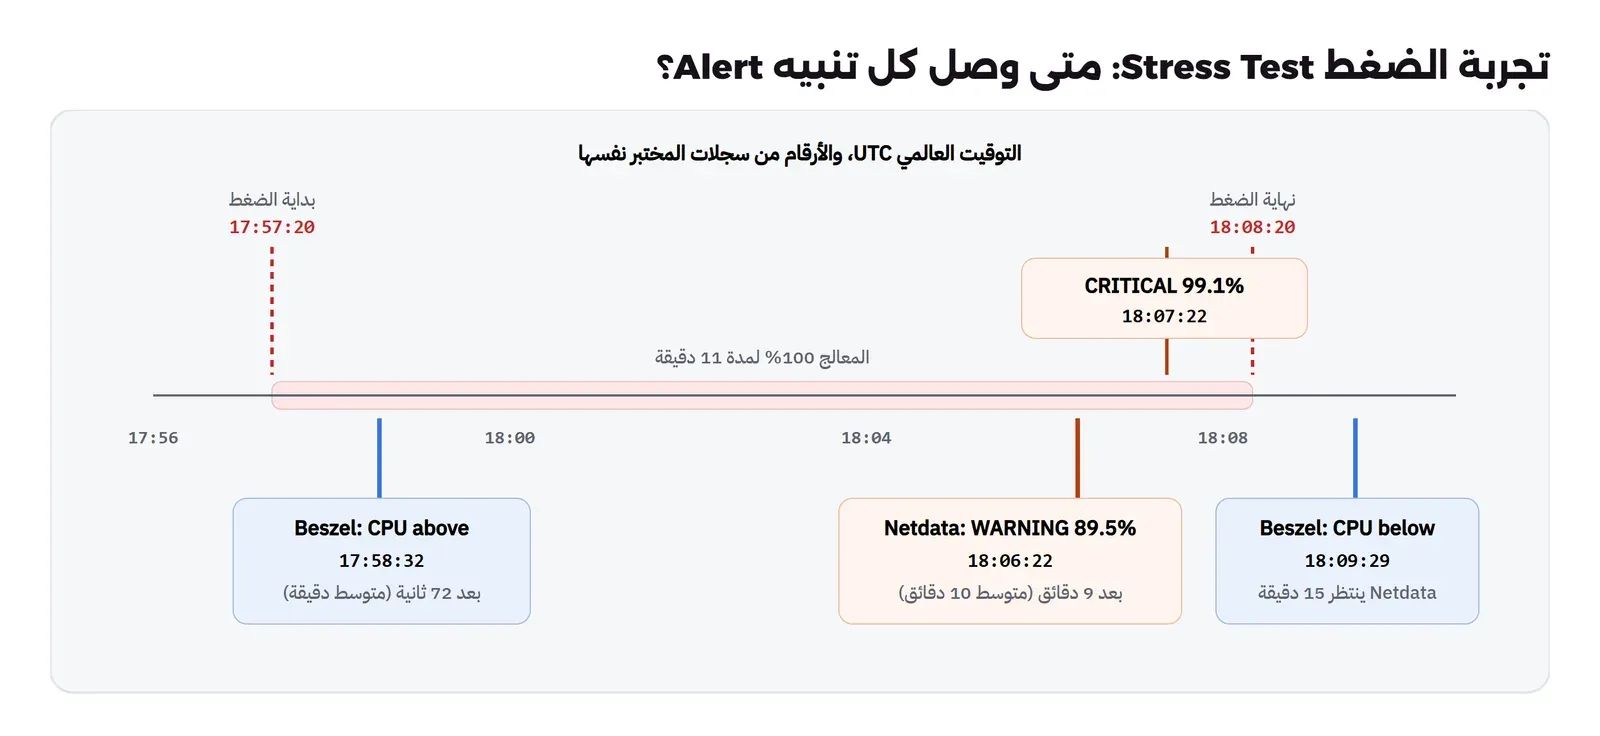
وبدأ الضغط في الساعة 17:57:20 بالتوقيت العالمي UTC، وبعد 72 ثانية وصل أول تنبيه:
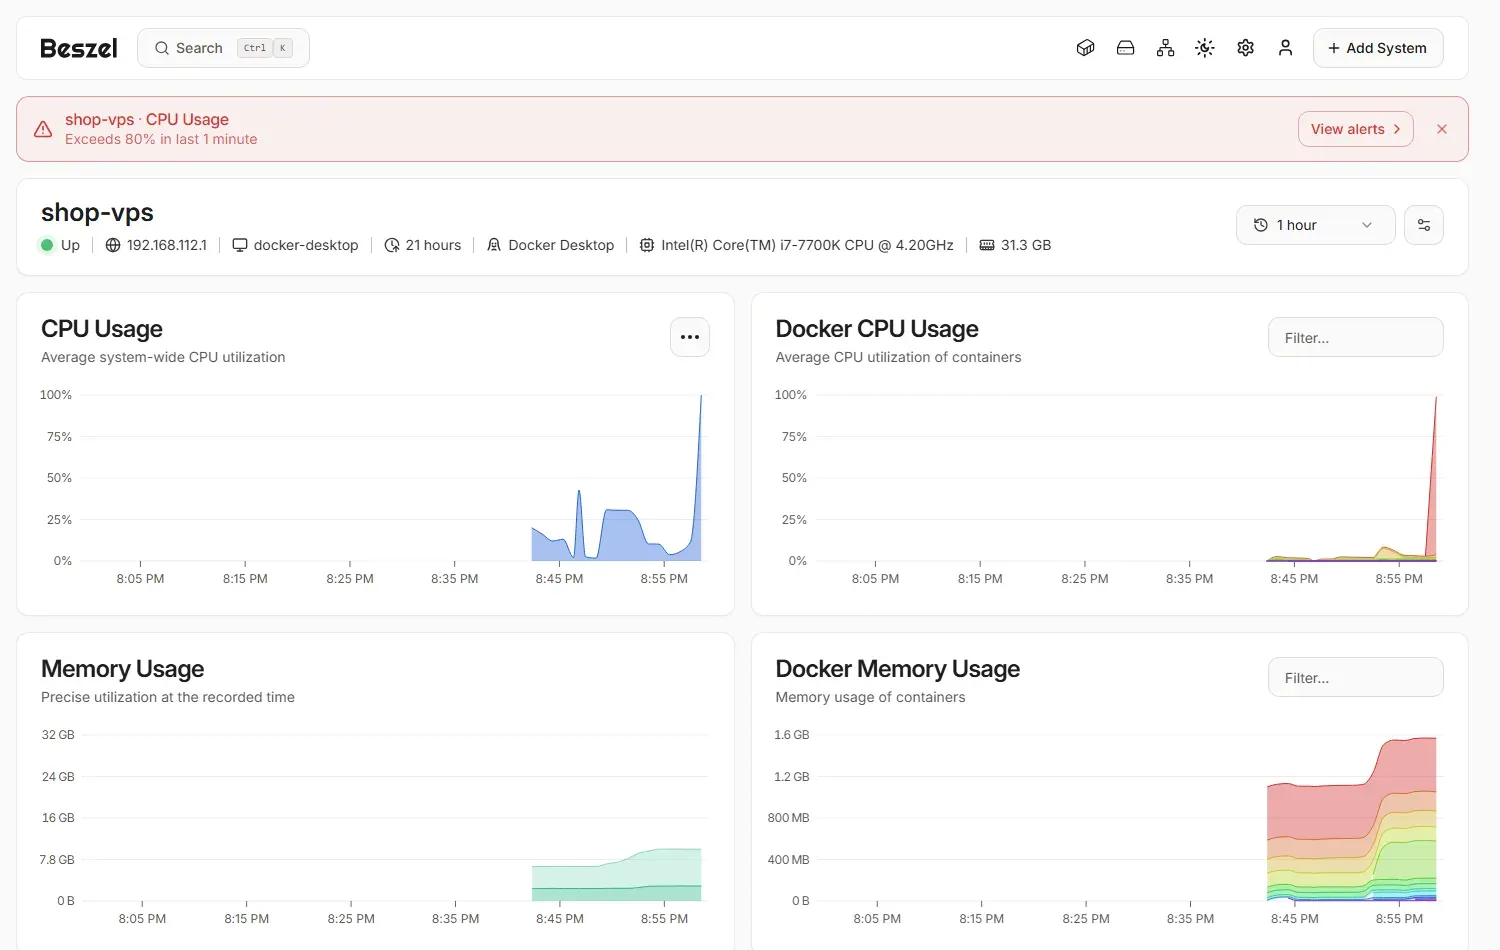
17:58:32 /beszel {"message":"CPU averaged 99.95% for the previous 1 minute.\n\nhttp://127.0.0.1:18090/system/6dwf59iuv7jy7t6","title":"shop-vps CPU above threshold"}وفي صفحة السيرفر في Beszel ظهر شريط التنبيه الأحمر فوق الرسوم، والارتفاع في رسم المعالج ورسم Docker معاً:
أما Netdata فلم يرسل شيئاً لمدة تسع دقائق، ثم سجل في سجل التنبيهات:
18:06:22 10min_cpu_usage CLEAR -> WARNING 89.5%
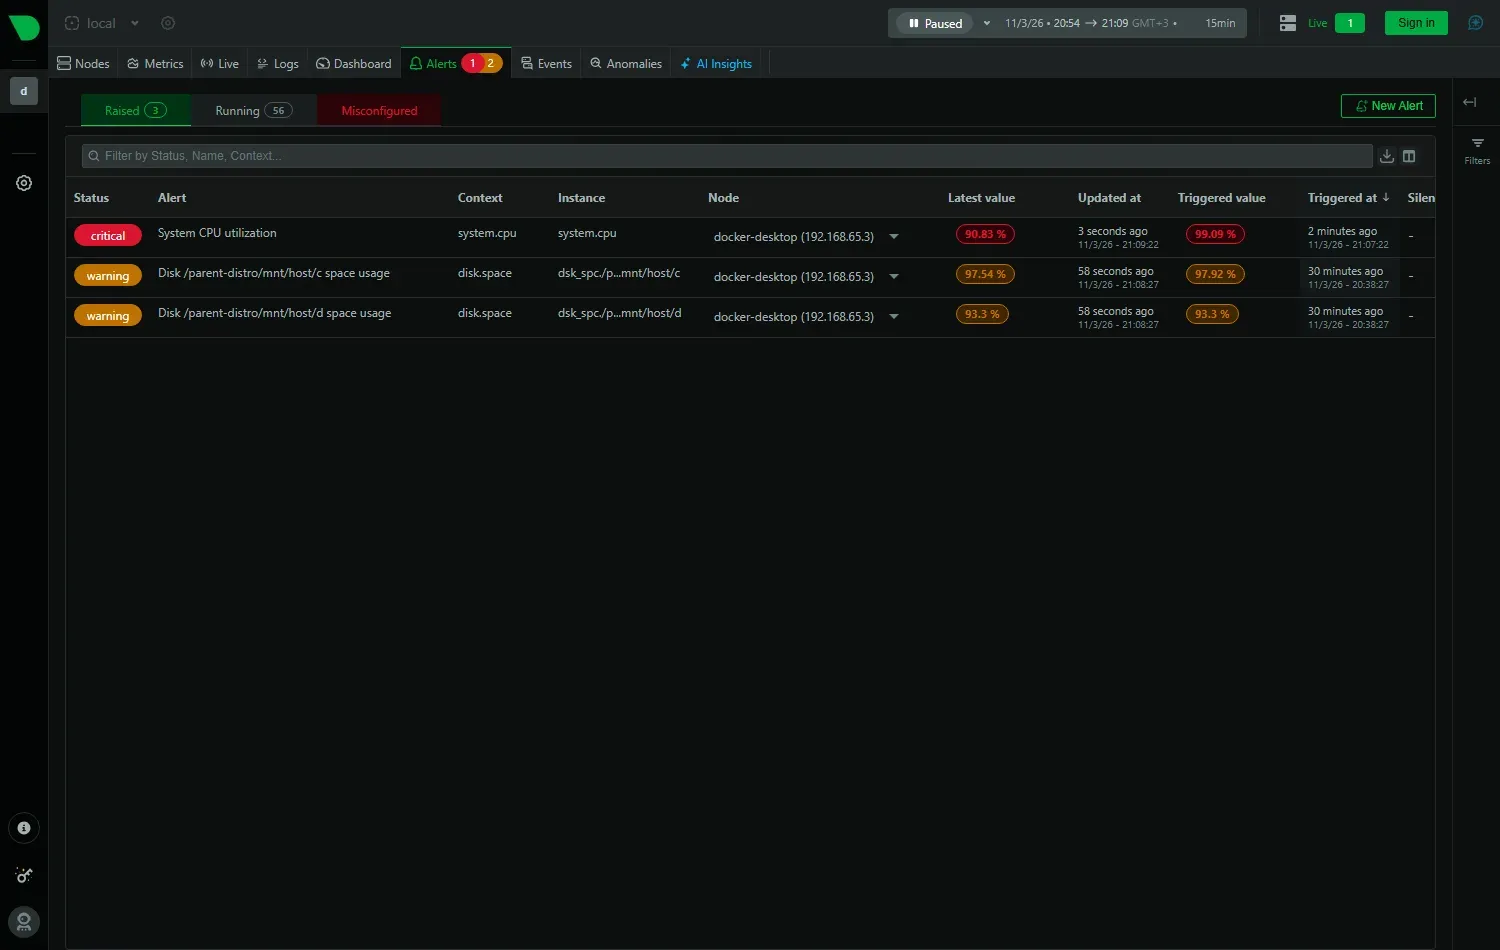
18:07:22 10min_cpu_usage WARNING -> CRITICAL 99.1%
وقد يتساءل البعض: كيف تتأخر الأداة التي تجمع كل ثانية تسع دقائق عن الأداة التي تجمع كل دقيقة؟ والإجابة في القاعدة نفسها، فقرأناها من ملفات ال Agent:
docker exec dv2m-netdata grep -n -A14 "template: 10min_cpu_usage" /usr/lib/netdata/conf.d/health.d/cpu.conf4: template: 10min_cpu_usage
5- on: system.cpu
10- lookup: average -10m unaligned of user,system,softirq,irq,guest
11- units: %
12- every: 1m
13- warn: $this > (($status >= $WARNING) ? (75) : (85))
14- crit: $this > (($status == $CRITICAL) ? (85) : (95))
15- delay: down 15m multiplier 1.5 max 1h
17- info: Average CPU utilization over the last 10 minutes (excluding iowait, nice and steal)في القاعدة أعلاه لاحظ التالي:
lookup: average -10m: القاعدة تحسب متوسط آخر عشر دقائق، لا القيمة الحالية، فمتوسط عشر دقائق يحتاج قرابة تسع دقائق من 100% حتى يتجاوز 85% إذا كان المعالج قبلها هادئاً، وهذا بالضبط ما رأيناه: 89.5% بعد تسع دقائق.warnوcritفيهما حدان: 85 للدخول في التحذير و75 للخروج منه، وهذا يسمى التخلف Hysteresis، والهدف ألا يتأرجح التنبيه بين الحالتين كلما كانت القيمة قريبة من الحد.delay: down 15m: عند النزول ينتظر 15 دقيقة قبل أن يرسل أن المشكلة انتهت، حتى لا تصلك رسالة «انتهت» ثم «عادت» كل دقيقتين.- القاعدة تستبعد
nice، فإذا شغلت النسخ الاحتياطي بالأمرniceكما ينصح كثيرون فلن يحسب في هذا التنبيه أصلاً.
وهذا ليس خطأ في Netdata وإنما اختيار، فالمعالج المرتفع لدقيقتين في سيرفر عادي ليس مشكلة تستحق أن توقظ أحداً، والمعالج المرتفع عشر دقائق مشكلة. والسؤال لك: أي سلوك تريد؟ وفي قصتنا كانت المشكلة ساعة كاملة، فكانت الأداتان سوف تنبهان. والصورة التالية تضع أوقات التجربة كلها على خط واحد:
وهذه صفحة التنبيهات في Netdata بعد دقيقتين من الحالة الحرجة:
فإذا أردت في Netdata تنبيهاً أسرع للمعالج فلا تعدل الملف الأصلي، وإنما انسخه بالأمر edit-config health.d/cpu.conf داخل مجلد الإعداد، وغير -10m إلى -3m مثلاً، والتعديل يبقى بعد التحديثات لأن النسخة في /etc/netdata تتقدم على الأصل في /usr/lib/netdata.
إرسال تنبيهات Netdata دون Cloud عبر Webhook
التنبيه الذي لا يصل إلى أحد لا قيمة له، وNetdata في ال Container لا يعرف كيف يرسل بريداً لأنه لا يوجد فيه برنامج إرسال بريد، فرأينا التحذيرات في السجل واللوحة فقط. ويرسل Netdata التنبيهات بطريقتين: عبر Netdata Cloud إذا ربطت ال Agent بحساب، أو عبر السكربت alarm-notify.sh الذي يقرأ ملف health_alarm_notify.conf، وفيه طرق كثيرة جاهزة مثل البريد وSlack وTelegram، وطريقة مخصصة Custom تكتب فيها الأمر بنفسك. فكتبنا هذا الملف ليرسل كل تنبيه إلى المستقبل نفسه:
# Netdata notifications without Netdata Cloud: send every alert to our webhook receiver
# (copied over /etc/netdata/health_alarm_notify.conf; the stock file lists email, Slack, Telegram and more)
SEND_EMAIL="NO"
SEND_CUSTOM="YES"
DEFAULT_RECIPIENT_CUSTOM="ops"
custom_sender() {
    local msg="${host} ${name} ${old_status} -> ${status} ${value_string}"
    if curl -s -X POST --data-raw "${msg}" "http://192.168.112.6:8080/netdata" >/dev/null; then
        info "sent custom notification ${msg}"; sent=$((sent + 1))
    else
        error "failed to send custom notification ${msg}"
    fi
}
ثم اختبرناه بالأمر الذي يوفره السكربت لهذا الغرض، وهو يرسل تنبيهاً تجريبياً بثلاث حالات:
docker cp health_alarm_notify.conf dv2m-netdata:/etc/netdata/health_alarm_notify.conf
docker exec -u netdata dv2m-netdata /usr/libexec/netdata/plugins.d/alarm-notify.sh test ops
ووصل إلى المستقبل:
18:12:12 /netdata docker-desktop test_alarm CLEAR -> WARNING new value
18:12:13 /netdata docker-desktop test_alarm WARNING -> CRITICAL new value
18:12:13 /netdata docker-desktop test_alarm CRITICAL -> CLEAR new value
ولاحظ أن الأمر يعمل بالمستخدم netdata وليس root، لأن ال Agent نفسه يشغل السكربت بهذا المستخدم، فإذا نجح الاختبار وأنت root وفشل في الواقع فغالباً المشكلة في صلاحيات ملف أو مسار. وفي الإنتاج غير الرابط إلى قناة فريقك في Slack أو Telegram بالطريقة الجاهزة لها في الملف نفسه، بدل أن تكتب طريقة مخصصة.
ماذا يحدث إذا توقف ال Agent؟
التنبيه الأهم ليس امتلاء المعالج، وإنما توقف السيرفر كله، لأن السيرفر المتوقف لا يرسل شيئاً. ففي Netdata يعمل كل شيء على السيرفر نفسه، فإذا توقف السيرفر توقف معه الذي يفترض أن يخبرك، ولن يصلك أي تنبيه إلا إذا كان ال Agent مربوطاً بNetdata Cloud الذي يلاحظ انقطاع الاتصال، أو كان عندك فحص من الخارج. أما Beszel فال Hub على جهاز آخر عادة، فيلاحظ غياب ال Agent. فجربنا ذلك بإيقاف ال Agent:
date -u +%T; docker stop dv2m-beszel-agent18:10:23
18:11:29 /beszel {"message":"Connection to shop-vps is down \n\nhttp://127.0.0.1:18090/system/6dwf59iuv7jy7t6","title":"Connection to shop-vps is down 🔴"}وصل التنبيه بعد 66 ثانية، وعندما أعدنا تشغيله وصل «up» في الثانية نفسها تقريباً لأن ال Agent اتصل فوراً عبر WebSocket:
18:11:48 /beszel {"message":"Connection to shop-vps is up \n\nhttp://127.0.0.1:18090/system/6dwf59iuv7jy7t6","title":"Connection to shop-vps is up ✅"}ولكن تذكر أن هذا يعمل فقط إذا كان ال Hub على سيرفر آخر، فإذا شغلت ال Hub وال Agent على السيرفر نفسه كما فعلنا في المختبر وتوقف السيرفر، توقف الاثنان معاً ولم يصلك شيء. وهذه هي مشكلة «من يراقب المراقب» التي شرحناها في فحص التوفر، والحل نفسه: فحص من الخارج على جهاز آخر أو خدمة مجانية، مهما كانت أداة المراقبة التي تختارها.
تنبيه يتكرر كل دقيقتين: مزامنة الساعة Clock Sync
عندما قرأنا سجل التنبيهات في Netdata بعد نصف ساعة وجدنا أن أكثر تنبيه تكرر ليس المعالج ولا القرص، وإنما هذا:
17:39:37 system_clock_sync_state CLEAR -> WARNING 0 synchronization state
17:39:47 system_clock_sync_state WARNING -> CLEAR 1 synchronization state
17:41:47 system_clock_sync_state CLEAR -> WARNING 0 synchronization state
17:41:57 system_clock_sync_state WARNING -> CLEAR 1 synchronization state
...
18:09:38 system_clock_sync_state CLEAR -> WARNING 0 synchronization state
18:09:48 system_clock_sync_state WARNING -> CLEAR 1 synchronization state
أكثر من 25 مرة في نصف ساعة، كل مرة عشر ثوان، والسبب أن السيرفر في المختبر آلة افتراضية لا تشغل برنامج مزامنة وقت NTP، والنواة تقول أحياناً إن الساعة غير متزامنة ثم تعود. وهذا التنبيه صادق من حيث المبدأ، فالساعة غير المتزامنة تفسد ترتيب السجلات وتفسد الشهادات أحياناً، ولكنه بهذا الشكل لا يفيد أحداً، وإذا أرسلته إلى هاتفك فسوف تتجاهل كل تنبيهات Netdata بعد يومين. وهذا هو تعب التنبيهات Alert Fatigue الذي نخصص له مقال التنبيهات. والحل الصحيح هو إصلاح السبب بتشغيل chrony أو systemd-timesyncd على السيرفر، وإذا لم يكن ذلك ممكناً كما في بعض الآلات الافتراضية فاجعل التنبيه صامتاً بنسخ ملفه بالأمر edit-config وتغيير to: sysadmin إلى to: silent، فيبقى في اللوحة ولا يرسل. والدرس العام: أول أسبوع مع أي أداة فيها مئات التنبيهات الجاهزة هو أسبوع تنظيف، فراجع ما يصلك وأسكت ما لا تفعل به شيئاً.
الرخصة License مع Netdata Cloud: ما المجاني وما المدفوع؟
هناك نقطة في Netdata يجب أن تعرفها قبل أن تعتمد عليه: ال Agent مفتوح المصدر برخصة GPLv3، أما الواجهة التي رأيتها في الصور أعلاه فليست كذلك. فبحسب مستودع المشروع الواجهة برخصة خاصة اسمها NCUL1، ويصفها المستودع بأنها مغلقة المصدر ولكنها مجانية الاستخدام مع ال Agent ومع Netdata Cloud، ولذلك ترى في أسفل صفحة البداية رابط Netdata UI License. وهذا لا يمنعك من استخدامها على سيرفرك، ولكنه يعني أن جزءاً مما تعتمد عليه يومياً تتحكم فيه شركة واحدة، وتستطيع أن تغير شروطه أو حدوده في إصدار قادم.
أما Netdata Cloud فهي خدمة الشركة التي تجمع أكثر من Agent في واجهة واحدة على الإنترنت، وترسل التنبيهات من خارج سيرفرك، وبحسب صفحة الأسعار عند مراجعتها في نوفمبر 2026 فإن الخطة المجانية Community تسمح بخمس عقد Nodes متصلة، مع لوحة مخصصة واحدة لكل غرفة Room، والخطة Business للبنية التحتية تبدأ من 7 دولارات لكل عقدة شهرياً بالدفع السنوي. وفي قصتنا سيرفر واحد، فالخطة المجانية تكفيه إذا أراد تنبيهاً يصل حتى عندما يتوقف السيرفر، بشرط أن يقبل خروج بيانات المراقبة الوصفية إلى خدمة خارجية، وهذا قرار يختلف من جهة إلى أخرى، خاصة إذا كانت عندك متطلبات لبقاء البيانات داخل المملكة.
وفي المقابل Beszel كله برخصة MIT، ال Hub وال Agent والواجهة، ولا توجد خدمة مدفوعة فوقه، فما تراه هو كل شيء.
Netdata أم Beszel؟ نقاط القوة مع نقاط الضعف
Netdata
نقاط القوة:
- يرى كل شيء من أول دقيقة: 3457 قيمة في سيرفرنا، منها كل Container وكل مجموعة عمليات وكل قرص، وتكاملات جاهزة لأغلب التطبيقات المعروفة.
- دقة الثانية لأسبوعين، وهي الدقة التي تحتاجها لفهم مشكلة استمرت دقيقة واحدة.
- مئات التنبيهات الجاهزة المكتوبة بعناية، مع التخلف Hysteresis والتأخير عند النزول، ونبهتنا على القرصين الممتلئين دون أن نطلب.
- كشف الشذوذ ML يدلك على القيم غير المعتادة عندما لا تعرف أين تبحث.
نقاط الضعف:
- الأثقل بين الأداتين: قرابة 160 MiB من الذاكرة و6% من نواة، و1.32 GB لل Image، ومساحة حتى 3 GiB تقريباً لقاعدة البيانات بالإعداد الافتراضي.
- الواجهة برخصة مغلقة، وبعض الخصائص مرتبطة بخطط Netdata Cloud.
- كل شيء على السيرفر نفسه، فإذا توقف السيرفر توقفت المراقبة معه.
- الاكتشاف التلقائي يحاول الدخول إلى قواعد بياناتك بقيم افتراضية، والتنبيهات الكثيرة تحتاج تنظيفاً في الأسبوع الأول.
Beszel
نقاط القوة:
- الأخف بفارق كبير: أقل من 40 MiB لل Hub وال Agent معاً، ومعالج قريب من الصفر.
- Hub واحد لعدة سيرفرات، والاتصال عبر WebSocket يخرج من السيرفر فلا تحتاج أن تفتح له منفذاً.
- تنبيهات بسيطة بالدقيقة تصلك بعد دقيقة، وتنبيه انقطاع الاتصال وصل بعد 66 ثانية.
- رخصة MIT كاملة، دون خدمة مدفوعة أو واجهة مغلقة.
نقاط الضعف:
- دقة الدقيقة فقط، وتاريخ لا يتجاوز 30 يوماً، وتقل الدقة كلما رجعت، فما حدث قبل أسبوع تراه بنقطة كل ساعتين.
- أرقام أساسية فقط: لا يعرف شيئاً عن Nginx أو PostgreSQL من الداخل، ولا توجد فيه لغة استعلام.
- يرى القرص الرئيسي فقط حتى تضيف الأقراص الأخرى بنفسك.
- مشروع أحدث وأصغر، وصيانته تعتمد على عدد قليل من المطورين.
والقاعدة العملية: إذا كان عندك سيرفر أو اثنان وتريد أن تفهم ماذا حدث بالتفصيل عندما تحدث مشكلة، فابدأ بNetdata. وإذا كان عندك عدة سيرفرات صغيرة، أو سيرفرات بذاكرة 1 أو 2 GB، وتريد شاشة واحدة تقول لك أيها يعاني وتنبيهاً عندما يتوقف أحدها، فابدأ بBeszel. وليس غريباً أن تجمع بينهما: Beszel لكل السيرفرات مع تنبيه الانقطاع، وNetdata على السيرفر المهم الذي تحتاج تفاصيله.
متى تنتقل إلى Prometheus مع Grafana؟ علامات التخرج Graduation
الأدوات الخفيفة ليست مرحلة تخجل منها، فكثير من الشركات الصغيرة تعمل بها سنوات دون مشكلة. ولكن هناك علامات واضحة تقول لك إن الوقت قد حان لتنتقل إلى ما بنيناه في المقال الأول من السلسلة، والصورة التالية تجمعها:
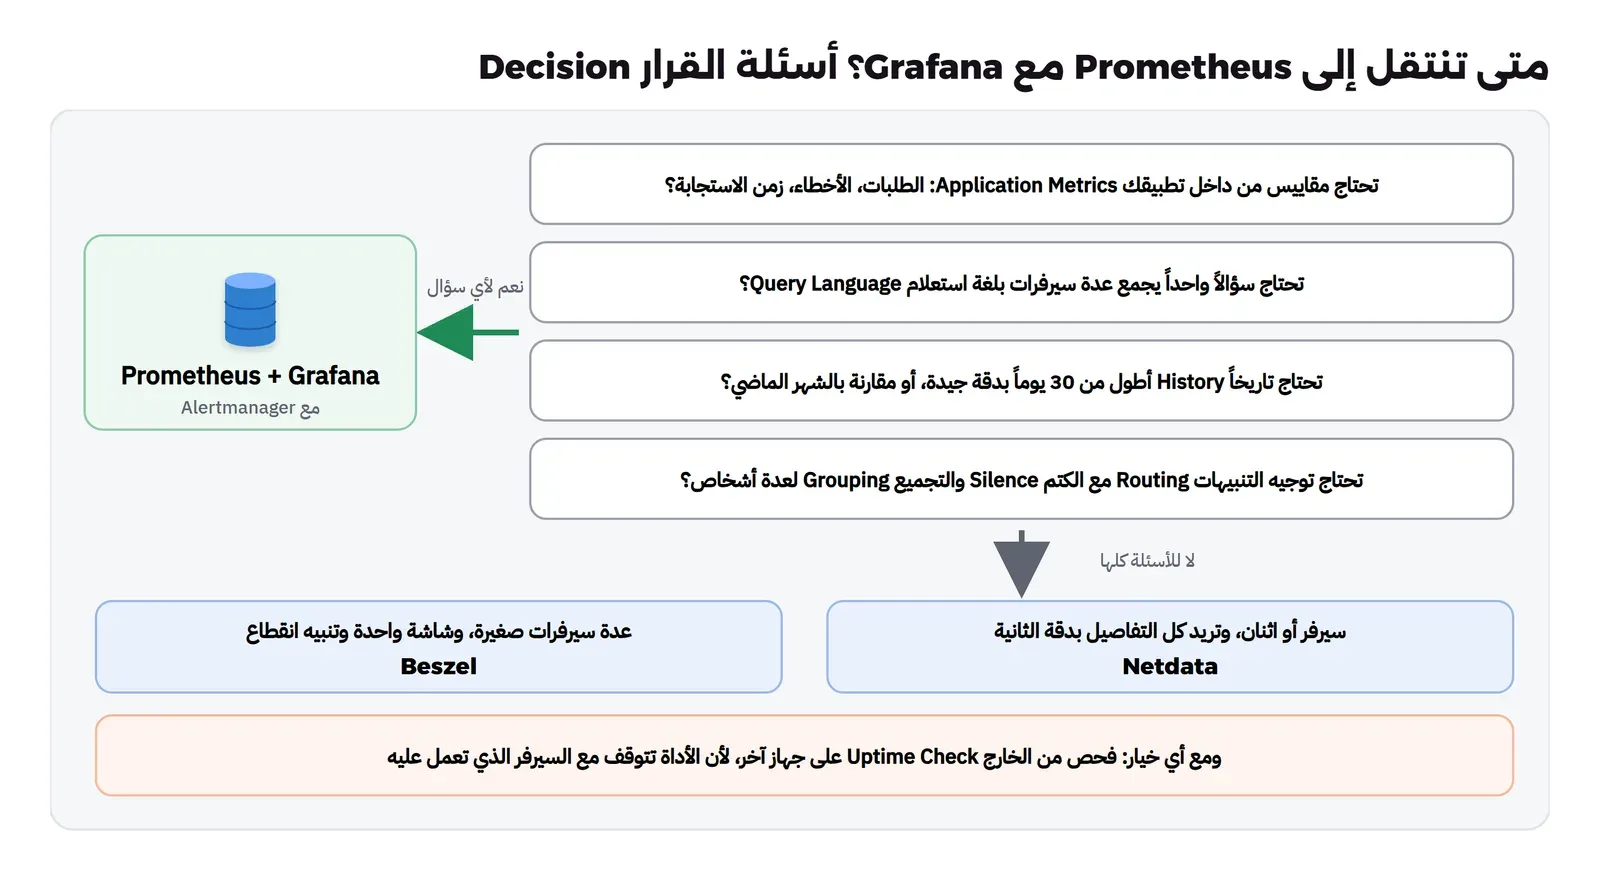
وفيما يلي العلامات بالتفصيل:
- مقاييس التطبيق Application Metrics: عندما تريد أن تعرف كم طلباً فشل في خدمة الدفع وكم أخذ أبطأ 1% من الطلبات، فهذه أرقام يكتبها كودك وليس النظام، وPrometheus مصمم لها. وNetdata يستطيع أن يقرأ مقاييس Prometheus من تطبيقك، ولكنك سوف تحتاج لغة PromQL لتسأل الأسئلة الصحيحة كما في الإشارات الذهبية.
- السؤال عبر السيرفرات: «ما متوسط زمن الاستجابة لخدمة الطلبات على السيرفرات الثلاثة معاً؟» سؤال واحد في PromQL، وفي الأدوات الخفيفة ثلاث شاشات تقارنها بعينك.
- التاريخ الطويل: عندما تريد أن تقارن هذا الشهر بالشهر الماضي، أو تحسب نسبة التوفر لعقد مع عميل، فثلاثون يوماً في Beszel لا تكفي، وطبقة الساعة في Netdata قد لا تكفي للدقة التي تحتاجها.
- توجيه التنبيهات: عندما يصبح عندك أكثر من شخص يستلم التنبيهات، وتريد أن يذهب تنبيه قاعدة البيانات لشخص والشبكة لآخر، مع الكتم أثناء الصيانة والتجميع، فهذا عمل Alertmanager كما في مقال التنبيهات.
- اللوحات ككود: عندما تريد أن تحفظ اللوحات في Git وتراجعها مثل الكود، وتنشئها لكل خدمة جديدة تلقائياً.
والانتقال لا يعني أن ترمي الأداة الخفيفة، فالطريق الذي نراه كثيراً في الفرق الصغيرة: Beszel أو Netdata للسيرفرات منذ اليوم الأول، ثم Prometheus لمقاييس التطبيق عندما يكبر المنتج، ثم تجمع كل شيء في بوابة واحدة كما في بوابة المراقبة. وإذا أردت الصورة الكاملة لما تراقبه في شركتك، من السيرفر إلى التطبيق إلى الأمن، فقد جمعناها في دليل المراقبة.
أخطاء شائعة Common Mistakes
- فتح المنفذ 19999 أو 45876 على الإنترنت: لوحة Netdata دون حساب لا تطلب كلمة مرور، ومنفذ ال Agent في Beszel لا يحتاج أن يكون مفتوحاً إذا استخدمت WebSocket.
- Hub الأداة على السيرفر الذي يراقبه: عندما يتوقف السيرفر يتوقف معه من يفترض أن يخبرك، فضع ال Hub أو فحصاً من الخارج على جهاز آخر.
- نسخ التوكن من نافذة ثم الإضافة من نافذة أخرى: رأينا الرمز 401 لأن كل فتح لنافذة Add System يولد توكن جديداً.
- توقع تنبيه المعالج بعد دقيقة من Netdata: القاعدة الافتراضية متوسط عشر دقائق، وأخذت تسع دقائق في المختبر.
- إرسال كل التنبيهات الجاهزة إلى الهاتف من اليوم الأول: تنبيه الساعة وحده تكرر أكثر من 25 مرة في نصف ساعة، فنظف أولاً.
- نسيان أقراص البيانات في Beszel: ال Agent يرى القرص الرئيسي فقط حتى تضيف الأقراص الأخرى.
- تجاهل سجل Netdata بعد التثبيت: الاكتشاف التلقائي حاول الدخول إلى PostgreSQL بمستخدم افتراضي، ومحاولات الدخول الفاشلة قد تطلق تنبيهات الأمن عندك.
- الحكم على حجم القرص بعد ساعة: اقرأ تقدير المدة الفعلية في صفحة قاعدة البيانات في Netdata، واحسب 3 إلى 4 GiB بالإعداد الافتراضي.
قائمة تحقق Checklist لمراقبة سيرفر واحد
| البند | كيف تتحقق منه |
|---|---|
| اللوحة لا تفتح من الإنترنت | المنفذ مربوط على 127.0.0.1 أو خلف Reverse Proxy بكلمة مرور، وفحص المنفذ من جهاز خارجي يفشل |
| التنبيهات تصل فعلاً | alarm-notify.sh test في Netdata، وتجربة ضغط قصيرة في Beszel، ورسالة حقيقية في قناة الفريق |
| تنبيه عند توقف السيرفر كله | Hub على جهاز آخر أو فحص من الخارج، وتجربة إيقاف حقيقية |
| كل الأقراص مراقبة | قائمة الأقراص في الأداة تطابق df -h على السيرفر |
| التنبيهات المزعجة مسكتة أو مصلحة | سجل التنبيهات لأسبوع لا يحتوي تنبيهاً يتكرر دون إجراء |
| مساحة القرص للمراقبة محسوبة | صفحة قاعدة البيانات في Netdata، أو حجم مجلد beszel_data |
| الإصدار مثبت ويحدث بقرار | رقم الإصدار في أمر التشغيل وليس latest |
| تعرف متى تنتقل | أسئلة قسم التخرج، ومراجعتها كل ثلاثة أشهر |
تدريب عملي Practice
- أنشئ في Netdata نسخة من قاعدة
10min_cpu_usageبالأمرedit-configواجعلها تحسب متوسط ثلاث دقائق، ثم أعد تجربة الضغط وقس الوقت حتى التحذير. - شغل ال Hub في Beszel على جهاز ثان، وأوقف السيرفر الأول كله وليس ال Agent فقط، وقس الوقت حتى يصلك تنبيه الانقطاع.
حذف المختبر Cleanup
docker rm -f dv2m-netdata dv2m-ndproxy dv2m-beszel dv2m-beszel-agent dv2m-hook dv2m-stress dv2m-prom dv2m-node dv2m-grafana
docker volume rm dv2m-ndconfig dv2m-ndlib dv2m-ndcache dv2m-beszel-data dv2m-beszel-agent dv2m-prom-data dv2m-grafana-data
docker network rm dv2m-net
docker rmi netdata/netdata:v2.12.2 henrygd/beszel:0.21.1 henrygd/beszel-agent:0.21.1-alpine
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- لسيرفر واحد لا تحتاج أن تبدأ بثلاثة برامج، فNetdata يعطيك كل شيء بدقة الثانية في دقائق، وBeszel يعطيك الأساسيات بأقل من 40 MiB من الذاكرة.
- في مختبرنا جمع Netdata 3457 قيمة كل ثانية بقرابة 160 MiB و6% من نواة، وجمع Beszel الأساسيات كل دقيقة بأقل من 40 MiB، وأخذ Grafana وحده 359 MiB في مجموعة Prometheus.
- Beszel نبه على المعالج بعد 72 ثانية، وNetdata بعد تسع دقائق لأن قاعدته تحسب متوسط عشر دقائق، فاقرأ القاعدة قبل أن تعتمد عليها.
- أي أداة تعمل على السيرفر الذي تراقبه تتوقف معه، فضع ال Hub أو فحصاً من الخارج على جهاز آخر.
- انتقل إلى Prometheus مع Grafana عندما تحتاج مقاييس من داخل تطبيقك، أو سؤالاً عبر عدة سيرفرات، أو تاريخاً أطول من شهر، أو توجيهاً للتنبيهات.
وفي المقال القادم من السلسلة بإذن الله نخرج من السيرفر وننظر إليه من الخارج كما يراه المستخدم، مع فحص التوفر وانتهاء الشهادات.
 دليلمقاييس السيرفرات Metrics: Prometheus مع لوحات Grafanaنجمع مقاييس المعالج والذاكرة والقرص والـ Containers مع Prometheus، ونتنبأ بموعد امتلاء القرص قبل أن يحدث، ونبني لوحة Grafana محفوظة ككود في Git.
 دليلالإشارات الذهبية Golden Signals: ماذا تقيس في خدمتك؟نضيف القياس إلى خدمة دفع حقيقية ونضغط عليها حتى تنهار، فنرى لماذا انتظر المستخدم ست ثوان والمعالج عند 5% دون خطأ واحد.
 دليلفحص التوفر Uptime Checks: من يراقب سيرفر المراقبة؟نفحص الموقع والشهادة وRedis من الخارج مع Blackbox Exporter وUptime Kuma، ونكشف النسخ الاحتياطي الذي توقف بصمت، ونتأكد أن أحداً يراقب سيرفر المراقبة نفسه.
 دليلدليل المراقبة Monitoring: ماذا تراقب في سيرفراتك وتطبيقاتك؟خريطة واحدة لكل ما يجب أن يراقبه الفريق على سيرفراته وتطبيقاته، من القرص والشهادات والنسخ الاحتياطي إلى الأحداث الأمنية والثغرات، مع الأداة والتنبيه لكل منطقة.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة الدليل وتنفيذ المختبر بإصدارات Netdata 2.12.2 وBeszel 0.21.1 وPrometheus 3.15.1 وnode_exporter 1.12.1 وGrafana 13.2.5 على Docker Engine 29.8.0، ومراجعة رخصة Netdata وأسعار Netdata Cloud من مصادرها.


