


لنفرض أنك المطور الوحيد في متجر صغير يبيع التمور والقهوة على الإنترنت، وصاحب المتجر يرسل لك كل صباح ملف الطلبات الذي يصدره من Excel بصيغة CSV، وأسماء المنتجات فيه بالعربية: «قهوة عربية»، «تمر سكري»، «خلاص». وطلبه بسيط جداً: سكربت صغير يقرأ الملف ويضيف الطلبات إلى النظام، وتقرير يومي يعد الأخطاء في ملف السجلات Logs. وفي اليوم الأول يتوقف السكربت برسالة UnicodeDecodeError لأن الملف جاء من نسخة قديمة من Excel، وفي اليوم الثاني يعمل السكربت ولكن عمود «رقم الطلب» لا يوجد في القاموس رغم أنك تراه بعينك في أول سطر، وبعد شهر يكبر ملف السجلات إلى 146 ميجابايت فيتوقف التقرير داخل Container ذاكرته 512 ميجابايت بكلمة واحدة: Killed، ثم ينقطع التيار عن السيرفر أثناء حفظ ملف الإعدادات فيرجع المتجر بملف config.json مقطوع من منتصفه.
وكل هذه المشاكل حقيقية، وقد ظهرت كلها في التجربة العملية لهذا المقال بالمخرج الذي سوف تراه، والسبب في كل واحدة منها ليس خطأ في المنطق وإنما في فهم شيء نعتبره بسيطاً: الملف File، وكيف يقرأه البرنامج ويكتب فيه. فالملف على القرص ليس نصاً وإنما بايتات Bytes، والنص الذي تراه هو نتيجة قرار اتخذه البرنامج عن الترميز Encoding، والكتابة لا تصل إلى القرص في اللحظة التي تكتب فيها السطر، والقراءة يمكن أن تكون دفعة واحدة أو تدفقاً Stream سطراً بعد سطر، والفرق بينهما في التجربة كان بين 684 ميجابايت و9 ميجابايت من الذاكرة للملف نفسه.
وسوف نناقش في هذا المقال ما يلي:
- ما هو الملف بالنسبة لبرنامجك، وما الذي ترجعه الدالة
open، ومعنى واصف الملف File Descriptor، وأوضاع الفتح Modes وأخطرها. - الفرق بين الملف النصي Text والملف الثنائي Binary، ولماذا يأخذ الحرف العربي بايتين في UTF-8.
- الترميز والنص العربي: الخطأ
UnicodeDecodeError، والنص المشوه Mojibake، وملفات Windows-1256 القديمة، والترميز الافتراضي في Windows. - علامة BOM التي يضيفها Excel، وقراءة CSV بشكل صحيح مع
newline=''، وكتابة JSON بالعربية، وصيغة JSON Lines للملفات الكبيرة. - إغلاق الملف Close والكلمة
with، وماذا يحدث إذا نسيت الإغلاق، والذاكرة المؤقتة Buffering مع قياس حقيقي. - قراءة ملف كبير كاملاً أو كتدفق Stream في Python وNode.js، مع قياس الذاكرة، وماذا يحدث إذا كبر الملف أو صغرت الذاكرة.
- الحفظ الآمن Atomic Write بملف مؤقت ثم استبدال، والأخطاء الشائعة، وجدول قرار تختار منه طريقتك.
تجهيز المختبر Lab
كل التجارب في هذا المقال تعمل داخل Containers من Docker Images رسمية، حتى تحصل على المخرج نفسه إذا كررتها، والملف الكبير يتم توليده داخل ال Container في المجلد /tmp ويختفي معه، فلا يبقى على جهازك شيء بعد التجربة. والجدول التالي يبين ما استخدمناه:
| الأداة | Docker Image | الإصدار في المختبر |
|---|---|---|
| Python | python:3.13.17-slim | Python 3.13.17 على Debian |
| Node.js | node:22-alpine | Node.js v22.23.4 |
| Python على Windows | بدون Docker | Python 3.13.3 على Windows 11، لتجربتين تخصان Windows فقط |
والسكربتات كلها في مجلد lab بجانب المقال، وكل تجربة تشغل بأمر مثل التالي من داخل هذا المجلد، حيث نربط المجلد للقراءة فقط :ro حتى لا يكتب أي سكربت شيئاً على جهازك، والخيار --rm يحذف ال Container بعد انتهاء الأمر:
docker run --rm --name scp2-io-py -v "$PWD:/lab:ro" python:3.13.17-slim python3 /lab/basics.py
docker run --rm --name scp2-io-node -v "$PWD:/lab:ro" node:22-alpine node /lab/basics.js
وفي المجلد أيضاً السكربت run.sh الذي يشغل كل التجارب بالترتيب ويحفظ مخرج كل واحدة في ملف .out، وهي نفس الملفات التي نقلنا منها المخرجات في هذا المقال.
ما هو الملف File بالنسبة لبرنامجك؟
الملف من وجهة نظر نظام التشغيل هو سلسلة من البايتات لها اسم ومكان في نظام الملفات File System، ولا يعرف نظام التشغيل شيئاً عن محتواها، فلا يعرف أنها نص عربي أو صورة أو جدول طلبات، وهذا المعنى يقرره برنامجك عند القراءة. وقد شرحنا في مقال نظام الملفات من الداخل أن الاسم نفسه شيء والبيانات شيء آخر يمثله ال Inode، أما هنا فنتحدث من الجهة الأخرى، أي من داخل الكود الذي تكتبه.
وعندما تكتب open("orders.csv") في Python أو fs.openSync("orders.csv") في Node.js، فإن البرنامج يطلب من النواة Kernel عبر استدعاء النظام System Call المسمى open أن تفتح الملف، وترجع النواة رقماً صغيراً اسمه واصف الملف File Descriptor، واختصاراً fd، وهو رقم في جدول تحتفظ به النواة لكل عملية Process، وكل قراءة أو كتابة بعد ذلك تتم بهذا الرقم وليس بالاسم. وقد شرحنا في مقال فضاء النواة وفضاء المستخدم ماذا يحدث عند كل استدعاء من هذه الاستدعاءات وكم يكلف، ولن نكرره هنا، ويكفي أن تعرف أن كل عبور إلى النواة له تكلفة، وأن لغتك تحاول أن تقلل عدد مرات العبور، كما سوف نرى في قسم الذاكرة المؤقتة.
والشيء الذي ترجعه open في Python ليس الرقم نفسه وإنما كائن Object يغلفه، ويسمى غالباً مقبض الملف File Handle أو كائن الملف File Object، وهو في الحقيقة ثلاث طبقات فوق بعضها كما في وثائق الوحدة io: طبقة سفلى تتعامل مع ال fd مباشرة بالبايتات، وفوقها طبقة الذاكرة المؤقتة Buffer التي تجمع البايتات قبل إرسالها للنواة، وفوقها طبقة النص التي تحول الحروف إلى بايتات والعكس حسب الترميز. والصورة التالية تبين أين تقف البيانات في كل لحظة بين سطر write في كودك والقرص نفسه:
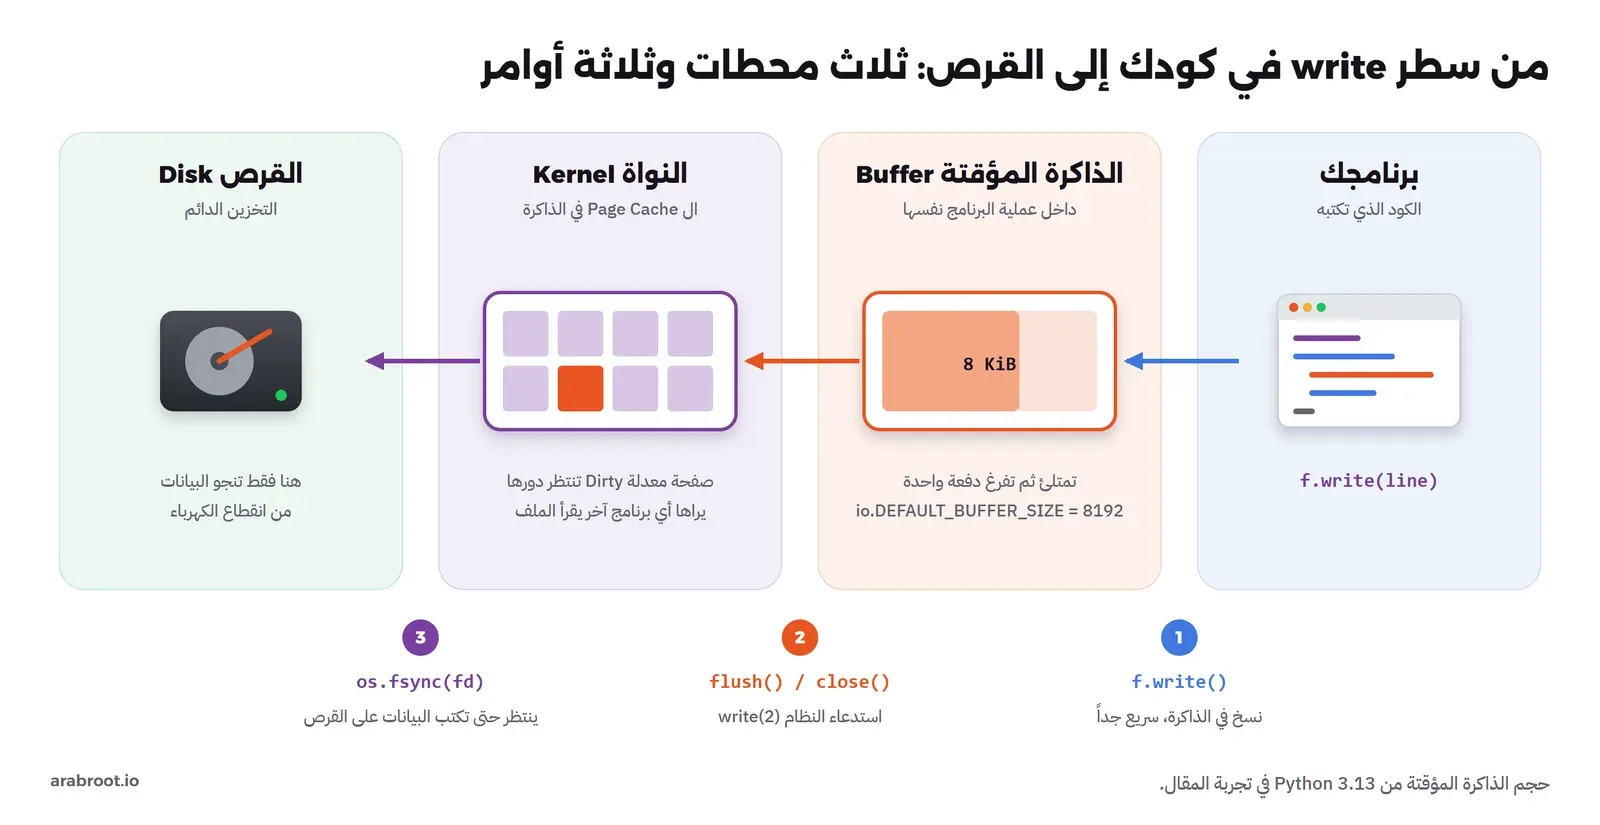
لاحظ في الصورة أن البيانات بعد write ما زالت داخل برنامجك، وأنها بعد flush وصلت إلى النواة فقط، وهذا يكفي لكي يراها أي برنامج آخر يقرأ الملف، ولكنه لا يكفي لكي تنجو من انقطاع الكهرباء، وهذا هو الفرق الذي سوف نرجع إليه في قسم الحفظ الآمن.
أوضاع الفتح Modes: القراءة والكتابة والإضافة
الحرف الثاني في open(path, "w") هو وضع الفتح Mode، وهو الذي يحدد ماذا تفعل النواة بالملف عند فتحه، والأوضاع الأساسية في Python كما في وثائق الدالة open هي التالية، ويقابلها في Node.js الخيار flag بنفس الحروف تقريباً:
| الوضع | المعنى | إذا كان الملف موجوداً | إذا لم يكن موجوداً |
|---|---|---|---|
"r" | قراءة فقط، وهو الافتراضي | يقرأ من أوله | خطأ FileNotFoundError |
"w" | كتابة | يفرغه فوراً ثم يكتب | ينشئه |
"a" | إضافة Append | يكتب في آخره دائماً | ينشئه |
"x" | إنشاء حصري Exclusive | خطأ FileExistsError | ينشئه |
"b" مع أي وضع | ثنائي Binary، مثل "rb" و"wb" | بايتات بدون ترميز وبدون تحويل نهاية السطر | |
"+" مع أي وضع | قراءة وكتابة معاً، مثل "r+" | نادراً ما تحتاجه في ملفات النص | |
وأخطر سطر في هذا الجدول هو "w"، فهذا الوضع يفرغ الملف القديم في لحظة الفتح، أي قبل أن تكتب أي شيء، والسبب أنه يرسل للنواة العلامة O_TRUNC كما في صفحة open(2)، وبالتالي إذا توقف البرنامج بعد الفتح وقبل انتهاء الكتابة فقد ضاع القديم والجديد معاً، وهذا بالضبط ما حدث لملف الإعدادات في قصة المتجر كما سوف نرى. أما الوضع "x" فهو مفيد عندما تريد أن تتأكد أنك لا تكتب فوق ملف موجود، مثل ملف تقرير يومي يجب ألا يتكرر.
أول ملف: الكتابة Write والقراءة Read في Python
نبدأ بأبسط شيء: نكتب سطراً عربياً واحداً من طلبات المتجر في ملف، ثم نقرأه مرة كنص ومرة كبايتات، ونطبع ما يحدث في كل خطوة. والسكربت التالي يبين ذلك:
# basics.py: write Arabic text to a file, read it back as text and as bytes, and look at the file object.
import os

with open("/tmp/note.txt", "w", encoding="utf-8") as f:
    print("object :", f)
    print("fd     :", f.fileno())
    n = f.write("طلب رقم 1001: قهوة عربية\n")
    print("write returned:", n, "characters")

print("size on disk:", os.path.getsize("/tmp/note.txt"), "bytes")

with open("/tmp/note.txt", encoding="utf-8") as f:
    text = f.read()
print("text   :", repr(text))
print("len    :", len(text), "characters")

with open("/tmp/note.txt", "rb") as f:
    data = f.read()
print("bytes  :", data[:12], "...")
print("len    :", len(data), "bytes")
print("first letter:", repr(text[0]), hex(ord(text[0])), "->", text[0].encode("utf-8").hex(" "))
والمخرج سوف يكون كما يلي:
object : <_io.TextIOWrapper name='/tmp/note.txt' mode='w' encoding='utf-8'>
fd     : 3
write returned: 25 characters
size on disk: 40 bytes
text   : 'طلب رقم 1001: قهوة عربية\n'
len    : 25 characters
bytes  : b'\xd8\xb7\xd9\x84\xd8\xa8 \xd8\xb1\xd9\x82\xd9' ...
len    : 40 bytes
first letter: 'ط' 0x637 -> d8 b7
في المخرج أعلاه لاحظ التالي:
- السطر الأول يبين أن
openرجعت كائناً من النوعTextIOWrapper، وهو طبقة النص التي ذكرناها، ومعه اسم الملف والوضعwوالترميزutf-8. - السطر الثاني هو رقم واصف الملف، وقيمته 3، والسبب أن كل عملية في Linux تبدأ بثلاثة أرقام محجوزة: 0 للمدخل القياسي stdin، و1 للمخرج القياسي stdout، و2 لمخرج الأخطاء stderr، فيكون أول ملف تفتحه هو الرقم 3.
- الدالة
writeرجعت 25، وهذا عدد الحروف وليس عدد البايتات، بينما حجم الملف على القرص 40 بايتاً، والفرق 15 بايتاً هو عدد الحروف العربية في السطر، لأن كل حرف عربي يأخذ بايتين وكل حرف إنجليزي أو رقم أو مسافة يأخذ بايتاً واحداً. - عندما قرأنا الملف بالوضع النصي رجع النص كما كتبناه، وطوله 25 حرفاً، وعندما قرأناه بالوضع
rbرجعت البايتات نفسها، وطولها 40، وأول بايتين هماd8 b7، وهما حرف الطاء الذي رقمه في Unicode هو0x637.
وهذا الفرق بين عدد الحروف وعدد البايتات هو أول ما يجب أن تتذكره عند التعامل مع النص العربي، فإذا كان عندك حقل في قاعدة البيانات أو في بروتوكول طوله محدود بالبايت، فالنص العربي يملؤه بنصف عدد الحروف تقريباً. وقد شرحنا ال Code Point وطريقة UTF-8 بالتفصيل في قسم مجموعة الحروف والترميز من مقال الترميز، ولذلك سوف نركز هنا على ما يعنيه ذلك عند قراءة الملفات.
الشيء نفسه في Node.js: النص String والبايتات Buffer
في Node.js الفرق بين النص والبايتات واضح أكثر، فالدالة fs.readFileSync بدون ترميز ترجع كائناً من النوع Buffer، أي بايتات، ومع ترميز ترجع نصاً من النوع string، كما في وثائق الوحدة fs. والسكربت التالي يكرر التجربة السابقة ويضيف إليها حالتين سوف نشرحهما في الأقسام القادمة، وهما علامة BOM والملف القديم بترميز Windows-1256:
// basics.js: the same steps in Node.js: Buffer vs string, a BOM, and an old windows-1256 file.
const fs = require('node:fs');
fs.writeFileSync('/tmp/note.txt', 'طلب رقم 1001: قهوة عربية\n');          // utf8 is the default when writing a string
const buf = fs.readFileSync('/tmp/note.txt');                            // no encoding: a Buffer of bytes
console.log('Buffer :', buf.subarray(0, 6), 'length', buf.length);
const text = fs.readFileSync('/tmp/note.txt', 'utf8');                    // with encoding: a string
console.log('string :', JSON.stringify(text), 'length', text.length);

const bom = Buffer.concat([Buffer.from([0xef, 0xbb, 0xbf]), Buffer.from('المنتج,الكمية\r\n')]);
fs.writeFileSync('/tmp/bom.csv', bom);
const header = fs.readFileSync('/tmp/bom.csv', 'utf8').split('\r\n')[0];
console.log('BOM    :', JSON.stringify(header), 'first code unit', header.charCodeAt(0).toString(16));
console.log('strip  :', JSON.stringify(header.replace(/^\uFEFF/, '')));
console.log('decoder:', JSON.stringify(new TextDecoder('utf-8').decode(bom).split('\r\n')[0]));

const old = Buffer.from([0xc7, 0xe1, 0xe3, 0xe4, 0xca, 0xcc]);          // «المنتج» in windows-1256
console.log('as utf8:', JSON.stringify(old.toString('utf8')));
console.log('1256   :', new TextDecoder('windows-1256').decode(old));
try { new TextDecoder('utf-8', { fatal: true }).decode(old); } catch (e) { console.log('fatal  :', e.name, e.code, e.message); }

const fd = fs.openSync('/tmp/note.txt', 'r');
console.log('fd     :', fd);
fs.closeSync(fd);
والمخرج سوف يكون كما يلي:
Buffer : <Buffer d8 b7 d9 84 d8 a8> length 40
string : "طلب رقم 1001: قهوة عربية\n" length 25
BOM    : "المنتج,الكمية" first code unit feff
strip  : "المنتج,الكمية"
decoder: "المنتج,الكمية"
as utf8: "������"
1256   : المنتج
fatal  : TypeError ERR_ENCODING_INVALID_ENCODED_DATA The encoded data was not valid for encoding utf-8
fd     : 18
في المخرج أعلاه لاحظ التالي:
- ال Buffer يطبع البايتات نفسها التي رأيناها في Python،
d8 b7 d9 84 d8 a8، وطوله 40، والنص طوله 25، فالملف واحد والفرق في طريقة القراءة فقط. - رقم واصف الملف هنا 18 وليس 3، والسبب أن Node.js تفتح عند التشغيل ملفات وقنوات داخلية خاصة بها، فلا تعتمد في كودك على رقم معين، فالرقم مجرد مفتاح في جدول النواة.
- بقية الأسطر عن ال BOM والملف القديم نرجع إليها في قسمي الترميز وعلامة BOM.
الملف النصي Text والملف الثنائي Binary: الفرق في طريقة الفتح فقط
قد يتساءل البعض: هل هناك ملفات نصية وملفات ثنائية على القرص؟ والإجابة لا، فكل الملفات على القرص بايتات، والفرق الوحيد هو كيف تفتحها أنت. فعندما تفتح الملف بالوضع النصي فأنت تطلب من اللغة أن تقوم بعملين إضافيين عند كل قراءة وكتابة: الأول فك الترميز Decoding، أي تحويل البايتات إلى حروف حسب الترميز الذي حددته، والعكس عند الكتابة، والثاني تحويل نهاية السطر Newline Translation، فتحول Python عند القراءة كل نهايات الأسطر، سواءً كانت \r\n بأسلوب Windows أو \n بأسلوب Linux، إلى \n واحدة، وهذا ما تسميه الوثائق الأسطر العامة Universal Newlines.
أما الوضع الثنائي فلا يفعل أياً من ذلك، فما في الملف هو ما تحصل عليه بالضبط. ولذلك فالقاعدة بسيطة:
- افتح بالوضع النصي عندما يكون الملف نصاً ستقرأه كحروف: CSV وJSON وملفات الإعدادات والسجلات، وحدد الترميز دائماً.
- افتح بالوضع الثنائي عندما يكون الملف صورة أو ملفاً مضغوطاً أو PDF، وعندما تنسخ ملفاً كما هو، وعندما تحسب له Hash، وعندما يهمك عدد البايتات بالضبط، وعندما تبحث في ملف ضخم عن نص إنجليزي ثابت وتريد السرعة، كما سوف نرى في تجربة الملف الكبير.
ولا تقم بفتح صورة أو ملف مضغوط بالوضع النصي، والسبب أن فك الترميز سوف يفشل عند أول بايت لا يمثل حرفاً صحيحاً، أو سوف ينجح بترميز يقبل أي بايت ثم يفسد البيانات عند الكتابة. وفي Node.js القاعدة نفسها: لا تمرر ترميزاً إلى readFileSync إذا كان الملف ثنائياً، واعمل على ال Buffer مباشرة.
الترميز Encoding والنص العربي: لماذا تظهر «ط§ظ„ظ…»؟
الترميز هو الاتفاق الذي يقول أي بايتات تمثل أي حرف، ولأن البايتات لا تحمل معها اسم الترميز الذي كتبت به، فالبرنامج الذي يقرأ الملف يجب أن يعرف الترميز من مكان آخر: من التوثيق، أو من اتفاق مع من أرسل الملف، أو بالتخمين. وإذا اختلف ترميز القارئ عن ترميز الكاتب فالنتيجة واحدة من اثنتين: خطأ صريح، أو نص مشوه بدون أي خطأ، والثانية أسوأ لأنها تمر بصمت إلى قاعدة البيانات. والصورة التالية تبين ما يحدث لكلمة «عرب» في الحالتين:
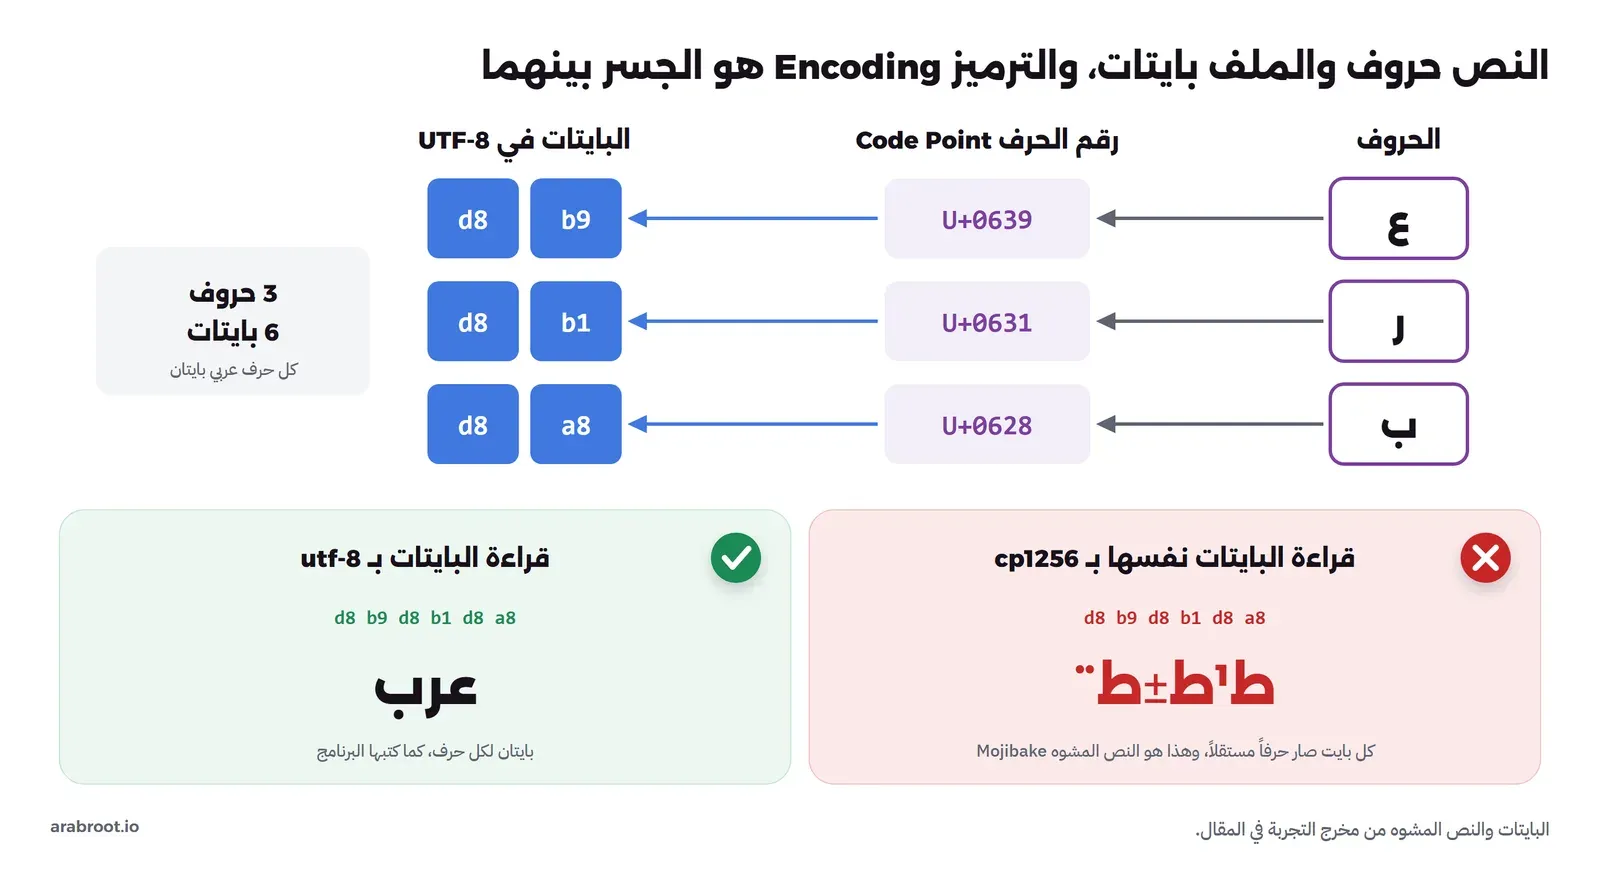
وحتى نرى ذلك على ملف الطلبات نفسه، يكتب السكربت التالي الجدول نفسه بثلاث طرق: UTF-8 العادي، وUTF-8 مع علامة BOM كما يفعل Excel، وWindows-1256 كما تفعل البرامج القديمة، ثم يقرأ كل ملف بترميز خاطئ ليرى ماذا يحدث:
# encoding.py: the same Arabic CSV saved three ways, and what happens when each is read with the wrong encoding.
rows = "المنتج,الكمية\r\nقهوة عربية,2\r\n"
open("/tmp/orders-utf8.csv", "wb").write(rows.encode("utf-8"))
open("/tmp/orders-bom.csv", "wb").write(rows.encode("utf-8-sig"))
open("/tmp/orders-1256.csv", "wb").write(rows.encode("cp1256"))

for name in ["utf8", "bom", "1256"]:
    raw = open(f"/tmp/orders-{name}.csv", "rb").read()
    print(f"{name:5} {len(raw):3} bytes, starts with:", raw[:8].hex(" "))

print("--- 1256 file read as utf-8")
try:
    open("/tmp/orders-1256.csv", encoding="utf-8").read()
except UnicodeDecodeError as e:
    print(type(e).__name__ + ":", e)

print("--- utf-8 file read as cp1256 (mojibake)")
print(open("/tmp/orders-utf8.csv", encoding="cp1256").readline().rstrip())

print("--- 1256 file read as cp1256")
print(open("/tmp/orders-1256.csv", encoding="cp1256").readline().rstrip())

print("--- utf-8 file read with errors='replace'")
print(open("/tmp/orders-1256.csv", encoding="utf-8", errors="replace").readline().rstrip())

print("--- BOM file read as utf-8 vs utf-8-sig")
print(repr(open("/tmp/orders-bom.csv", encoding="utf-8").readline()))
print(repr(open("/tmp/orders-bom.csv", encoding="utf-8-sig").readline()))
والمخرج سوف يكون كما يلي:
utf8   50 bytes, starts with: d8 a7 d9 84 d9 85 d9 86
bom    53 bytes, starts with: ef bb bf d8 a7 d9 84 d9
1256   29 bytes, starts with: c7 e1 e3 e4 ca cc 2c c7
--- 1256 file read as utf-8
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xc7 in position 0: invalid continuation byte
--- utf-8 file read as cp1256 (mojibake)
ط§ظ„ظ…ظ†طھط¬,ط§ظ„ظƒظ…ظٹط©
--- 1256 file read as cp1256
المنتج,الكمية
--- utf-8 file read with errors='replace'
������,������
--- BOM file read as utf-8 vs utf-8-sig
'\ufeffالمنتج,الكمية\n'
'المنتج,الكمية\n'
في المخرج أعلاه لاحظ التالي:
- الجدول نفسه أخذ 50 بايتاً في UTF-8، و53 مع BOM، و29 فقط في Windows-1256، والسبب أن Windows-1256 يضع كل حرف عربي في بايت واحد، فالملف يبدأ بـ
c7 e1 e3وهي الألف واللام والميم، بينما يبدأ في UTF-8 بـd8 a7 d9 84. - عندما قرأنا ملف Windows-1256 على أنه UTF-8 توقفت Python عند أول بايت برسالة
UnicodeDecodeError، والرسالة تقول بالضبط أين: البايت0xc7في الموضع 0، والسبب «invalid continuation byte»، أي أن0xc7في UTF-8 يعني بداية حرف من بايتين، والبايت الذي بعده0xe1لا يصلح أن يكون الجزء الثاني. وهذه أفضل نتيجة ممكنة لترميز خاطئ، لأنها تتوقف ولا تفسد شيئاً. - عندما قرأنا ملف UTF-8 على أنه Windows-1256 لم يحدث أي خطأ، وظهر السطر
ط§ظ„ظ…ظ†طھط¬، وهذا هو النص المشوه Mojibake، فكل حرف عربي من بايتين صار حرفين، وأغلبها طاء أو ظاء لأن البايت الأول من الحروف العربية في UTF-8 هوd8أوd9، وهذان في جدول Windows-1256 هما الطاء والظاء. وإذا رأيت يوماً نصاً مليئاً بـ «ط» و«ظ» في قاعدة بيانات أو بريد، فقد عرفت السبب: نص UTF-8 قرأه برنامج بترميز Windows-1256. - قراءة ملف Windows-1256 بترميزه الصحيح أعادت «المنتج,الكمية» كما هي، فالملف لم يكن فيه أي خطأ، والخطأ كان في افتراض القارئ.
- الخيار
errors="replace"لم يرم استثناء، ولكنه وضع علامة الاستبدال�مكان كل بايت لا يفهمه، فخرج سطر لا يمكن استرجاعه. ولا ينصح باستخدام هذا الخيار لإسكات الخطأ في بيانات مهمة مثل الطلبات، والسبب أنك تحول خطأً صريحاً تراه إلى بيانات فاسدة لا تراها.
ملفات Windows-1256 القديمة
قبل انتشار UTF-8 كانت كل لغة في Windows لها جدول من 256 حرفاً يسمى صفحة الترميز Code Page، والصفحة العربية رقمها 1256 واسمها windows-1256 كما في قائمة صفحات الترميز من Microsoft، وجدولها الكامل منشور في موقع Unicode. وما زالت هذه الملفات تصلك حتى اليوم من أنظمة محاسبة قديمة، ومن أجهزة نقاط البيع، ومن تصدير Excel في بعض الإعدادات عندما تختار «CSV» العادي بدلاً من «CSV UTF-8». وفي Python اسم هذا الترميز cp1256 أو windows-1256، والقائمة الكاملة للأسماء في جدول الترميزات القياسية، وفي Node.js تستطيع قراءته بـ TextDecoder كما رأيت في مخرج basics.js، حيث أعاد new TextDecoder('windows-1256') كلمة «المنتج» من البايتات c7 e1 e3 e4 ca cc، بينما أعادت toString('utf8') للبايتات نفسها ست علامات استبدال بدون أي خطأ، ورمى TextDecoder مع الخيار fatal: true الخطأ ERR_ENCODING_INVALID_ENCODED_DATA.
وقد يتساءل البعض: كيف أعرف ترميز ملف وصلني؟ والإجابة الصريحة أنه لا توجد طريقة مضمونة، فالملف لا يحمل اسم ترميزه، ولكن هناك قاعدة عملية تكفي في أغلب الحالات: جرب UTF-8 بالوضع الصارم أولاً، وهو الافتراضي في Python، فإذا نجح فالملف غالباً UTF-8، لأن احتمال أن يكون نص عربي بترميز آخر صالحاً كـ UTF-8 بالصدفة صغير جداً، وإذا فشل فجرب cp1256، وسجل في السجلات أي ترميز استخدمت لكل ملف حتى تعرف مصدر أي مشكلة لاحقاً. والحل الأفضل بكل تأكيد هو الاتفاق مع من يرسل الملف على UTF-8.
الترميز الافتراضي Default Encoding: مشكلة Windows
لاحظ أننا في كل الأمثلة السابقة كتبنا encoding="utf-8" صراحة، والسبب أن open في Python بدون هذا المعامل تستخدم ترميز النظام المحلي Locale، وهو في Linux غالباً UTF-8، أما في Windows فهو صفحة الترميز الخاصة بإعدادات اللغة. والسكربت التالي شغلناه على جهاز Windows 11 بـ Python 3.13.3 مباشرة، بدون Docker:
# default-encoding.py: open() with no encoding argument falls back to the locale (cp1252 on this Windows machine).
import locale, sys
print("platform:", sys.platform, "| locale encoding:", locale.getencoding(), "| utf8 mode:", sys.flags.utf8_mode)
try:
    with open("note.txt", "w") as f:
        f.write("طلب رقم 1001\n")
    print("written")
except UnicodeEncodeError as e:
    print("UnicodeEncodeError:", e)
وشغلناه ثلاث مرات: عادياً، ثم مع الخيار -X utf8، ثم مع الخيار -X warn_default_encoding:
python -I default-encoding.py
python -I -X utf8 default-encoding.py
python -I -X warn_default_encoding default-encoding.py
والمخرج سوف يكون كما يلي:
platform: win32 | locale encoding: cp1252 | utf8 mode: 0
UnicodeEncodeError: 'charmap' codec can't encode characters in position 0-2: character maps to <undefined>
platform: win32 | locale encoding: cp1252 | utf8 mode: 1
written
D:\Active_Projects\Cloud-Event\ArabRoot\content\articles\files-io-streams\lab\default-encoding.py:5: EncodingWarning: 'encoding' argument not specified
  with open("note.txt", "w") as f:
platform: win32 | locale encoding: cp1252 | utf8 mode: 0
UnicodeEncodeError: 'charmap' codec can't encode characters in position 0-2: character maps to <undefined>
في المخرج أعلاه لاحظ التالي:
- ترميز النظام على هذا الجهاز
cp1252، وهو صفحة الترميز الغربية، ولا يوجد فيها أي حرف عربي، فرمتwriteالخطأUnicodeEncodeErrorبمجرد أن حاولت كتابة «طلب». والكود نفسه يعمل بدون أي مشكلة على Linux، وهذا هو النوع الأسوأ من الأخطاء: يعمل عندك ويفشل عند غيرك. - مع الخيار
-X utf8يعمل Python بوضع UTF-8 Mode، فيصبح الترميز الافتراضي UTF-8 على أي نظام، ونجحت الكتابة. وبحسب PEP 686 سوف يصبح هذا الوضع هو الافتراضي من Python 3.15. - الخيار
-X warn_default_encodingيطبع تحذيرEncodingWarningعند كلopenبدون ترميز، ويخبرك بالملف والسطر، وهذه الميزة جاءت مع PEP 597، وهي طريقة سريعة لتجد كل الأماكن التي نسيت فيها الترميز في مشروع كامل.
والقاعدة التي تريحك من كل هذا: اكتب encoding="utf-8" في كل open لملف نصي، دائماً، حتى لو كنت تعمل على Linux فقط، والسبب أن الكود ينتقل، وأن السيرفر قد يعمل يوماً بإعدادات Locale مختلفة.
SyntaxError: encoding problem: uses. والسبب أن السطر الأول كان تعليقاً يقول «open() without encoding= uses…»، وPython يقرأ أول سطرين من أي ملف بحثاً عن إعلان ترميز الكود نفسه بالصيغة coding= أو coding: كما في PEP 263، فوجد الكلمة encoding= uses وظن أن الملف مكتوب بترميز اسمه uses. والحل كان تغيير صياغة التعليق، والدرس أن أول سطرين في ملفات Python لهما معنى خاص، فلا تضع فيهما عبارة تشبه coding=.علامة BOM: ثلاثة بايتات في أول الملف
رجعنا إلى مشكلة اليوم الثاني في قصة المتجر: السكربت قرأ الملف بدون أخطاء، ولكن row["رقم الطلب"] رمى KeyError. والسبب هو علامة ترتيب البايتات Byte Order Mark، واختصاراً BOM، وهي الحرف U+FEFF، ويكتب في UTF-8 بثلاثة بايتات ef bb bf في أول الملف، وقد رأيتها في مخرج encoding.py في أول ملف orders-bom.csv. وهذه العلامة لها معنى حقيقي في UTF-16، حيث تخبر القارئ هل البايتات بترتيب Big-Endian أو Little-Endian، أما في UTF-8 فلا يوجد ترتيب أصلاً، ولكن Excel وبعض برامج Windows تضيفها لكي تعرف عند فتح الملف أنه UTF-8، ولذلك تجد Microsoft تشرح في صفحة Opening CSV UTF-8 files correctly in Excel كيف تفتح هذه الملفات بشكل صحيح.
والمشكلة أن ترميز utf-8 في Python يعامل ال BOM كحرف عادي، فيصبح جزءاً من اسم العمود الأول، فاسم العمود في القاموس هو '\ufeffرقم الطلب' وليس 'رقم الطلب'، والحرف \ufeff لا يظهر عند الطباعة، فتنظر إلى المخرج وترى الاسم صحيحاً ولا تفهم لماذا لا يطابق. والحل هو الترميز utf-8-sig، فهذا يحذف ال BOM إذا وجدها في أول الملف ويقرأ الملف بشكل عادي إذا لم يجدها، كما في السطرين الأخيرين من مخرج encoding.py، ولذلك فهو الخيار الآمن لأي CSV يأتي من Excel.
وفي Node.js تتصرف الدالة readFileSync(path, 'utf8') مثل Python تماماً، فقد رجعت في مخرج basics.js أول حرف بالرقم feff، ولاحظ أن السطر المطبوع يبدو صحيحاً لأن الحرف غير مرئي، أما TextDecoder فيحذف ال BOM افتراضياً، وفي الحالتين تستطيع حذفها بنفسك بالتعبير replace(/^\ufeff/, ''). وعند الكتابة، لا تضف BOM إلى ملفات JSON، والسبب أن RFC 8259 يقول إن JSON الذي ينتقل بين الأنظمة يجب أن يكون UTF-8 وإن البرامج «MUST NOT add a byte order mark»، وأضفها فقط في CSV الذي تعرف أن إنساناً سوف يفتحه في Excel، حتى يظهر النص العربي صحيحاً عنده.
ملفات CSV: الفاصلة Comma والتنصيص Quoting ونهاية السطر Newline
صيغة CSV تبدو أبسط صيغة ممكنة: قيم تفصل بينها فواصل، وكل سجل في سطر، ولذلك يكتب كثير من المطورين قارئهم الخاص بـ line.split(",")، وهذه هي الطريقة البسيطة التي تعمل في أول يوم ثم تفشل في أول منتج اسمه «تمر, سكري». فالصيغة كما في RFC 4180 تسمح بأن تحتوي الخلية على فاصلة أو على سطر جديد بشرط أن تكون بين علامتي تنصيص، وتسمح بعلامة تنصيص داخل الخلية بتكرارها ""، وتستخدم \r\n نهاية للسطر. وملف Excel في قصة المتجر فيه المفاجآت الثلاث معاً، كما في الصورة التالية:
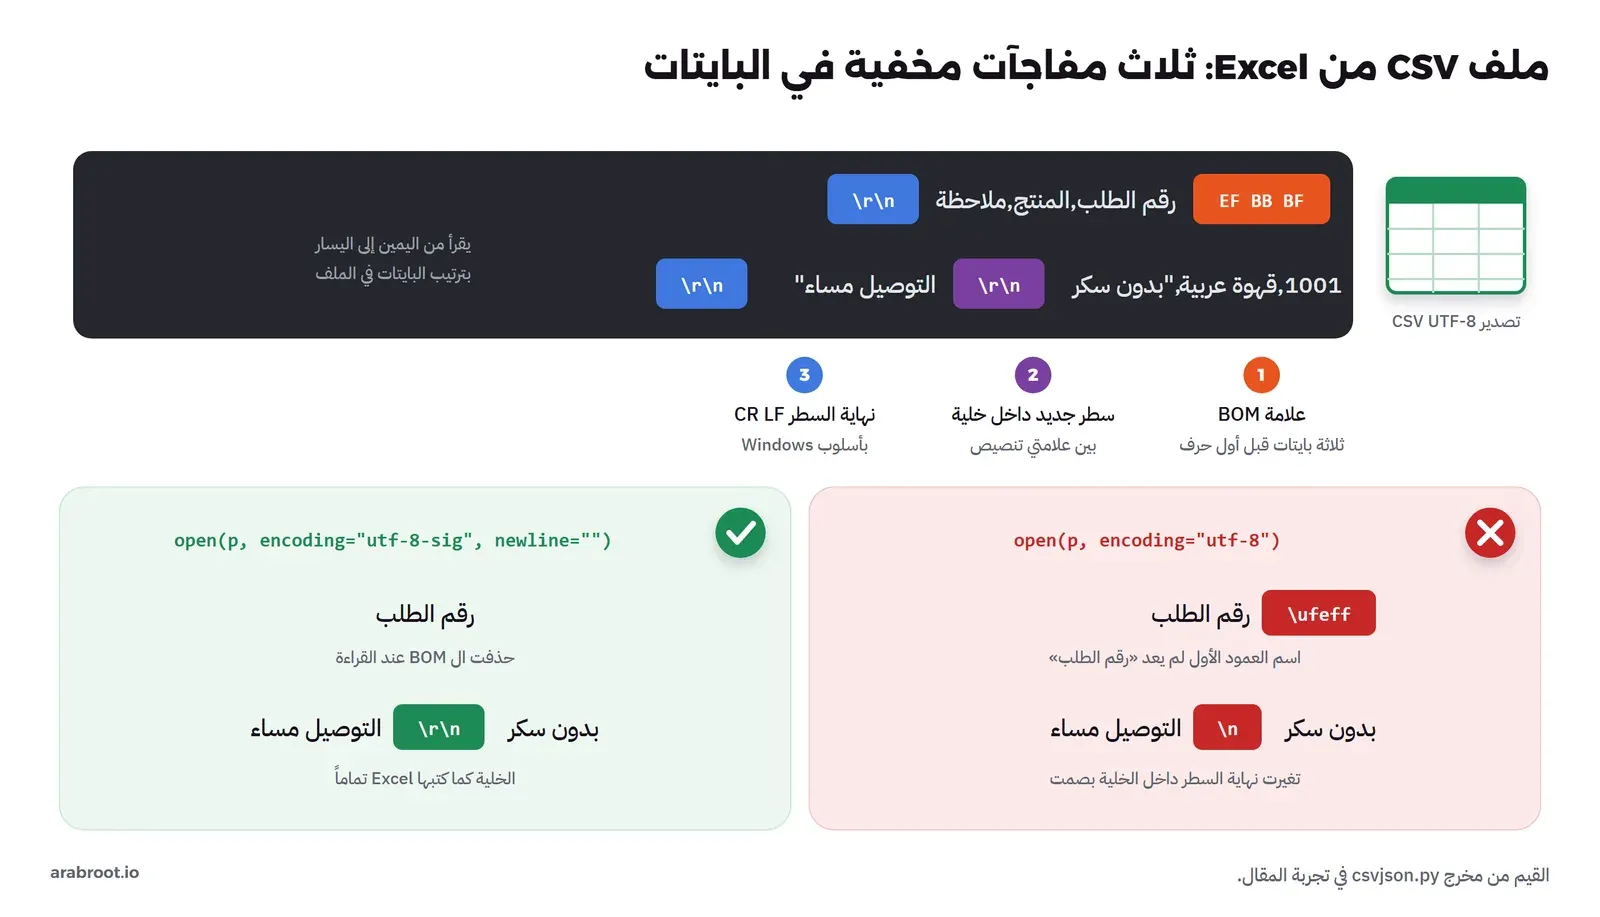
والسكربت التالي يكتب هذا الملف بالبايتات نفسها التي يكتبها Excel، ثم يقرؤه بالطريقة العادية وبالطريقة الصحيحة، ثم يحوله إلى JSON وإلى JSON Lines:
# csvjson.py: read an Excel-style CSV (BOM, CRLF, a quoted field with a line break), then write JSON and JSON Lines.
import csv, json, os

raw = '\ufeffرقم الطلب,المنتج,ملاحظة\r\n1001,قهوة عربية,"بدون سكر\r\nالتوصيل مساء"\r\n1002,"تمر, سكري",\r\n'
open("/tmp/excel.csv", "w", encoding="utf-8", newline="").write(raw)

print("--- csv.reader, utf-8, default newline")
with open("/tmp/excel.csv", encoding="utf-8") as f:
    rows = list(csv.reader(f))
print(rows[0])
print(repr(rows[1][2]))

print("--- csv.DictReader, utf-8-sig, newline=''")
with open("/tmp/excel.csv", encoding="utf-8-sig", newline="") as f:
    orders = list(csv.DictReader(f))
for o in orders:
    print(o)

print("--- json")
a = json.dumps(orders[0])
b = json.dumps(orders[0], ensure_ascii=False)
print(a)
print(b)
print("sizes in bytes:", len(a.encode()), len(b.encode()))

with open("/tmp/orders.json", "w", encoding="utf-8") as f:
    json.dump(orders, f, ensure_ascii=False, indent=2)
with open("/tmp/orders.jsonl", "w", encoding="utf-8") as f:
    for o in orders:
        f.write(json.dumps(o, ensure_ascii=False) + "\n")
print("orders.json :", os.path.getsize("/tmp/orders.json"), "bytes")
print("orders.jsonl:", os.path.getsize("/tmp/orders.jsonl"), "bytes")
print(open("/tmp/orders.jsonl", encoding="utf-8").read(), end="")
والمخرج سوف يكون كما يلي:
--- csv.reader, utf-8, default newline
['\ufeffرقم الطلب', 'المنتج', 'ملاحظة']
'بدون سكر\nالتوصيل مساء'
--- csv.DictReader, utf-8-sig, newline=''
{'رقم الطلب': '1001', 'المنتج': 'قهوة عربية', 'ملاحظة': 'بدون سكر\r\nالتوصيل مساء'}
{'رقم الطلب': '1002', 'المنتج': 'تمر, سكري', 'ملاحظة': ''}
--- json
{"\u0631\u0642\u0645 \u0627\u0644\u0637\u0644\u0628": "1001", "\u0627\u0644\u0645\u0646\u062a\u062c": "\u0642\u0647\u0648\u0629 \u0639\u0631\u0628\u064a\u0629", "\u0645\u0644\u0627\u062d\u0638\u0629": "\u0628\u062f\u0648\u0646 \u0633\u0643\u0631\r\n\u0627\u0644\u062a\u0648\u0635\u064a\u0644 \u0645\u0633\u0627\u0621"}
{"رقم الطلب": "1001", "المنتج": "قهوة عربية", "ملاحظة": "بدون سكر\r\nالتوصيل مساء"}
sizes in bytes: 318 130
orders.json : 257 bytes
orders.jsonl: 217 bytes
{"رقم الطلب": "1001", "المنتج": "قهوة عربية", "ملاحظة": "بدون سكر\r\nالتوصيل مساء"}
{"رقم الطلب": "1002", "المنتج": "تمر, سكري", "ملاحظة": ""}
في الجزء الأول من المخرج، أي القراءة بالطريقة العادية، لاحظ التالي:
- اسم العمود الأول
'\ufeffرقم الطلب'، فهذه مشكلة ال BOM التي شرحناها، وهذا سببKeyErrorفي اليوم الثاني. - الملاحظة
'بدون سكر\nالتوصيل مساء'، أي أن\r\nداخل الخلية صارت\n، والسبب أن الوضع النصي حول نهاية السطر قبل أن تصل البيانات إلى الوحدةcsv، فتغيرت البيانات داخل الخلية دون أي رسالة. وقد يبدو هذا فرقاً بسيطاً، ولكن تخيل أنك تحسب Hash للسجل أو تقارنه بالنسخة في قاعدة البيانات، فكل سجل فيه سطر جديد سوف يبدو معدلاً.
وفي الجزء الثاني، مع utf-8-sig وnewline=""، رجع اسم العمود صحيحاً، والملاحظة كما كتبها Excel بالضبط مع \r\n، والمنتج «تمر, سكري» في خلية واحدة رغم الفاصلة. ولهذا تقول وثائق الوحدة csv صراحة إن الملف يجب أن يفتح بـ newline=''، والمعنى أن تترك اللغة نهايات الأسطر كما هي وتترك الوحدة csv تفهمها بنفسها، لأنها الوحيدة التي تعرف هل السطر الجديد نهاية سجل أم جزء من خلية بين علامتي تنصيص.
واستخدمنا csv.DictReader بدلاً من csv.reader، والفرق أن الأول يعطيك كل سجل كقاموس أسماء أعمدته من السطر الأول، فتكتب row["المنتج"] بدلاً من row[1]، وهذا يحميك إذا أضاف صاحب المتجر عموداً جديداً في منتصف الملف، لأن الكود يعتمد على الاسم وليس على الموضع.
ماذا يحدث على Windows إذا نسيت newline=''؟
المشكلة الأخرى لهذا الخيار تظهر عند الكتابة على Windows تحديداً، ولذلك شغلنا السكربت التالي على Windows مباشرة، وهو يكتب الجدول نفسه مرة بدون newline='' ومرة معه، ثم يعد نهايات الأسطر في البايتات ويقرأ الملف مرة أخرى:
# csv-windows.py: run on Windows: csv.writer with and without newline='' and the bytes each one writes.
import csv, sys
rows = [["رقم الطلب", "المنتج"], ["1001", "قهوة عربية"]]
for name, nl in [("no-newline", None), ("newline-empty", "")]:
    with open(f"{name}.csv", "w", encoding="utf-8-sig", newline=nl) as f:
        csv.writer(f).writerows(rows)
    raw = open(f"{name}.csv", "rb").read()
    print(f"{name:14} {sys.platform} line endings:", raw.count(b"\r\r\n"), "x CR CR LF,", raw.count(b"\r\n") - raw.count(b"\r\r\n"), "x CR LF")
    print("   read back:", list(csv.reader(open(f"{name}.csv", encoding="utf-8-sig"))))
وعند تشغيله أول مرة بالأمر python -I csv-windows.py ظهرت المشكلة التي ذكرناها في قسم الترميز الافتراضي، ولكن هذه المرة في الطباعة وليس في الملف:
no-newline     win32 line endings: 2 x CR CR LF, 0 x CR LF
   read back: Traceback (most recent call last):
  File "D:\Active_Projects\Cloud-Event\ArabRoot\content\articles\files-io-streams\lab\csv-windows.py", line 9, in <module>
    print("   read back:", list(csv.reader(open(f"{name}.csv", encoding="utf-8-sig"))))
    ~~~~~^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
  File "C:\Python313\Lib\encodings\cp1252.py", line 19, in encode
    return codecs.charmap_encode(input,self.errors,encoding_table)[0]
           ~~~~~~~~~~~~~~~~~~~~~^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
UnicodeEncodeError: 'charmap' codec can't encode characters in position 3-5: character maps to <undefined>
فالملف نفسه كتب بـ utf-8-sig كما طلبنا، ولكن print تكتب إلى المخرج القياسي، وعندما يكون المخرج موجهاً إلى ملف أو إلى أمر آخر وليس إلى الطرفية Terminal، يستخدم Python على Windows ترميز النظام cp1252، فلم يستطع طباعة الحروف العربية. والحل كان الخيار -X utf8 نفسه، وهذا هو المخرج بعده:
no-newline     win32 line endings: 2 x CR CR LF, 0 x CR LF
   read back: [['رقم الطلب', 'المنتج'], [], ['1001', 'قهوة عربية'], []]
newline-empty  win32 line endings: 0 x CR CR LF, 2 x CR LF
   read back: [['رقم الطلب', 'المنتج'], ['1001', 'قهوة عربية']]
في المخرج أعلاه لاحظ التالي:
- بدون
newline=''كتب الملف نهايتين بالشكلCR CR LF، والسبب أن الوحدةcsvتكتب\r\nكما تقول RFC 4180، ثم يحول الوضع النصي في Windows كل\nإلى\r\n، فتصبح\r\r\n. - وعند قراءته رجع سجلان فارغان
[]بين السجلات الحقيقية، وفي Excel يظهر هذا كسطر فارغ بعد كل سطر، وهو من أشهر الأسئلة عن Python وCSV على Windows. - مع
newline=''كتب الملفCR LFمرتين فقط، ورجع السجلان كما هما.
ملفات JSON والنص العربي: الخيار ensure_ascii
بعد أن قرأنا الطلبات بشكل صحيح، حفظناها بصيغة JSON، ولاحظ في مخرج csvjson.py السطرين بعد --- json. فالدالة json.dumps بإعداداتها الافتراضية حولت كل حرف عربي إلى صيغة الهروب Escape مثل \u0631، والسبب أن الخيار ensure_ascii قيمته الافتراضية True كما في وثائق الوحدة json، فيكون الناتج حروف ASCII فقط، وهذا آمن لأي نظام قديم لا يفهم UTF-8. ولكن الثمن واضح في المخرج: السجل نفسه أخذ 318 بايتاً مع الهروب و130 بايتاً فقط مع ensure_ascii=False، أي أكثر من الضعف، لأن كل حرف عربي صار ستة بايتات بدلاً من اثنين، وفوق ذلك لا يستطيع أحد أن يقرأ الملف بعينه عند فتحه.
والقاعدة: عند الكتابة إلى ملف اكتب ensure_ascii=False وافتح الملف بـ encoding="utf-8"، فالاثنان معاً يعطيانك ملفاً صغيراً يقرؤه الإنسان، وكل مكتبات JSON الحديثة تقرأ الشكلين وتعطي النص نفسه. وفي Node.js لا توجد هذه المشكلة أصلاً، فالدالة JSON.stringify تترك الحروف العربية كما هي.
ولاحظ أيضاً أن indent=2 جعل الملف أكبر، 257 بايتاً لسجلين، وهذا مناسب لملفات الإعدادات التي يقرؤها الإنسان ويعدلها، وغير مناسب لملايين السجلات.
صيغة JSON Lines للملفات الكبيرة
المشكلة الحقيقية في JSON العادي ليست الحجم وإنما الشكل، فالملف كله قيمة واحدة، مصفوفة تبدأ بـ [ وتنتهي بـ ]، ولكي تقرأ أي سجل فيها يجب أن تقرأ الملف كله وتحلله، ولكي تضيف سجلاً يجب أن تعيد كتابة الملف كله، أو على الأقل آخره. والحل الذي انتشر للسجلات والبيانات الكبيرة هو JSON Lines، واختصاراً JSONL أو NDJSON، وفكرته بسيطة: كل سطر في الملف قيمة JSON كاملة مستقلة، كما في آخر سطرين من المخرج.
وبهذا الشكل تستطيع أن تضيف سجلاً بفتح الملف بالوضع "a" وكتابة سطر واحد، وتستطيع أن تقرأ الملف سطراً بعد سطر كتدفق كما سوف نرى في قسم الملف الكبير، وإذا انقطع البرنامج أثناء الكتابة فالذي يفسد هو السطر الأخير فقط وليس الملف كله. ولاحظ أن الملاحظة التي فيها سطر جديد بقيت في سطر واحد في ملف JSONL، لأن JSON يكتب السطر الجديد داخل النص بالهروب \r\n، وهذا ما يجعل الصيغة آمنة. وهذه الصيغة هي ما تستخدمه أغلب أدوات السجلات المنظمة Structured Logging كما شرحنا في مقال السجلات.
إغلاق الملف Close والكلمة with
كل ملف تفتحه يحجز شيئين: رقماً في جدول واصفات الملفات في النواة، وذاكرة مؤقتة داخل برنامجك قد تحتوي على بيانات لم تكتب بعد. والإغلاق close يفعل الأمرين معاً: يفرغ الذاكرة المؤقتة إلى النواة، ثم يعيد الرقم إلى النواة. وحتى نرى ماذا يحدث إذا لم يتم الإغلاق، كتبنا السكربت التالي بثلاث حالات، والحالات الأخرى فيه تخص الحفظ الآمن ونرجع إليها لاحقاً:
# lifecycle.py: what happens when a file is not closed, when handles leak, and when a crash hits a direct overwrite.
import json, os, resource, sys

case = sys.argv[1]
if case == "noclose":
    f = open("/tmp/sales.log", "w", encoding="utf-8")
    for i in range(100):
        f.write(f"sale {i} ok\n")
    os._exit(0)                                   # the process dies without close(): no flush either
elif case == "leak":
    resource.setrlimit(resource.RLIMIT_NOFILE, (64, 64))
    print("fd limit:", resource.getrlimit(resource.RLIMIT_NOFILE))
    kept = []
    for i in range(100):
        kept.append(open("/tmp/note.txt"))        # opened, kept, never closed
        if i % 20 == 0:
            print("open handles:", len(kept), "last fd:", kept[-1].fileno())
elif case == "direct":                            # overwrite the real file in place, crash half way
    cfg = {"store": "متجر التمور", "items": [{"sku": i, "name": f"تمر صنف {i}"} for i in range(400)]}
    with open("/tmp/config.json", "w", encoding="utf-8") as f:
        json.dump(cfg, f, ensure_ascii=False)
        f.flush()
        os.ftruncate(f.fileno(), 5000)            # simulate a crash after 5000 bytes reached the file
    os._exit(1)
elif case == "atomic":                            # write a temp file next to it, fsync, then rename over it
    cfg = {"store": "متجر التمور", "items": []}
    tmp = "/tmp/config.json.tmp"
    with open(tmp, "w", encoding="utf-8") as f:
        json.dump(cfg, f, ensure_ascii=False)
        f.flush()
        os.ftruncate(f.fileno(), 20)              # the same crash, but in the temp file
    os._exit(1)                                   # we never reach os.replace(tmp, "/tmp/config.json")
elif case == "load":
    try:
        with open("/tmp/config.json", encoding="utf-8") as f:
            cfg = json.load(f)
        print("loaded:", cfg["store"], "items:", len(cfg["items"]))
    except json.JSONDecodeError as e:
        print("JSONDecodeError:", e)
ونشغله بالسكربت run-lifecycle.sh كمستخدم عادي --user 1000:1000:
#!/bin/sh
# Runs the lifecycle cases in order inside one container.
echo "== noclose"; python3 /lab/lifecycle.py noclose; wc -c /tmp/sales.log
echo "== leak"; echo hi > /tmp/note.txt; python3 /lab/lifecycle.py leak
echo "== good config"; printf '{"store": "متجر التمور", "items": [{"sku": 1, "name": "سكري"}]}' > /tmp/config.json; python3 /lab/lifecycle.py load
echo "== atomic crash"; python3 /lab/lifecycle.py atomic; ls -l /tmp/config.json*; python3 /lab/lifecycle.py load
echo "== direct crash"; python3 /lab/lifecycle.py direct; ls -l /tmp/config.json; python3 /lab/lifecycle.py load
والمخرج سوف يكون كما يلي:
== noclose
0 /tmp/sales.log
== leak
fd limit: (64, 64)
open handles: 1 last fd: 3
open handles: 21 last fd: 23
open handles: 41 last fd: 43
open handles: 61 last fd: 63
Traceback (most recent call last):
  File "/lab/lifecycle.py", line 15, in <module>
OSError: [Errno 24] Too many open files: '/tmp/note.txt'
== good config
loaded: متجر التمور items: 1
== atomic crash
-rw-r--r-- 1 1000 1000 77 Oct 30 22:19 /tmp/config.json
-rw-r--r-- 1 1000 1000 20 Oct 30 22:19 /tmp/config.json.tmp
loaded: متجر التمور items: 1
== direct crash
-rw-r--r-- 1 1000 1000 5000 Oct 30 22:19 /tmp/config.json
JSONDecodeError: Unterminated string starting at: line 1 column 4269 (char 4268)
نبدأ بأول جزأين من المخرج، ولاحظ التالي:
- في الحالة
nocloseكتب البرنامج مئة سطر، ثم توقف بـos._exitبدون إغلاق، فكان حجم الملف 0 بايت. والسبب أن الأسطر المئة كلها، وحجمها أقل من 8 كيلوبايت، كانت في الذاكرة المؤقتة داخل البرنامج ولم تصل إلى النواة أصلاً. والدالةos._exitهنا تمثل أي توقف مفاجئ لا تنفذ فيه Python خطوات الإغلاق، مثل قتل العملية بالإشارةSIGKILLأو توقفها بسبب نفاد الذاكرة. - في الحالة
leakخفضنا حد الملفات المفتوحة للعملية إلى 64 بالدالةsetrlimit، وهو الحد الذي تشرحه صفحة getrlimit(2) باسمRLIMIT_NOFILE، ثم فتحنا الملف نفسه مرة بعد مرة واحتفظنا بكل كائن في قائمة. والأرقام زادت من 3 إلى 63، ثم رمت Python الخطأOSError: [Errno 24] Too many open filesعند المحاولة رقم 62. - ولاحظ شيئاً غريباً في ال Traceback: يظهر رقم السطر 15 ولكن لا يظهر نص السطر نفسه كما يحدث عادة. والسبب أن Python تحتاج أن تفتح ملف الكود
lifecycle.pyلكي تطبع السطر، ولم يبق للعملية أي رقم متاح لفتحه، فحتى رسالة الخطأ تأثرت بالتسريب. وإذا رأيت يوماً في السجلات Traceback بدون أسطر الكود، فهذه علامة يجب أن تجعلك تفكر في تسريب الملفات أو ال Sockets.
والحد الافتراضي في أغلب أنظمة Linux أكبر من 64 بكثير، ولكن السيرفر الذي يفتح ملفاً أو اتصالاً مع كل طلب HTTP ولا يغلقه سوف يصل إليه بعد ساعات أو أيام، ثم يتوقف عن قبول أي اتصال جديد، لأن الاتصال الشبكي نفسه يحتاج رقماً من الجدول نفسه.
والحل في Python هو الكلمة with، فكل الأمثلة في هذا المقال فتحت الملفات بها، وهي تضمن أن الملف يغلق عند الخروج من الكتلة، سواءً خرجت بشكل طبيعي أو بسبب استثناء، وهذا هو معنى مدير السياق Context Manager. وفي Node.js 22 لا توجد كلمة مماثلة تعمل في JavaScript العادية، فإذا فتحت الملف بـ fs.openSync فعليك أن تغلقه بـ fs.closeSync داخل finally، أو أن تستخدم الدوال التي تفتح وتغلق بنفسها مثل readFileSync وcreateReadStream، فهذه تغلق الملف عند انتهائها، وال Stream يغلق الملف عند انتهاء القراءة أو حدوث خطأ. وعن الطريقة الصحيحة لالتقاط الأخطاء نفسها وعدم ابتلاعها فقد خصصنا لها مقال كيف تتعامل لغات البرمجة مع الأخطاء.
الذاكرة المؤقتة Buffering: لماذا لا تكتب كل سطر وحده؟
رأينا أن الذاكرة المؤقتة قد تضيع بيانات إذا توقف البرنامج فجأة، فلماذا وضعتها اللغات أصلاً؟ والسبب هو التكلفة، فكل كتابة تصل إلى النواة هي استدعاء نظام، وكل استدعاء له تكلفة ثابتة مهما كان حجم البيانات صغيراً. وقد قسنا في قسم السجلات من مقال فضاء النواة أن Python كتبت مئة ألف سطر بـ 633 استدعاء write فقط بالذاكرة المؤقتة، و100001 استدعاء مع التفريغ بعد كل سطر، وعددنا الاستدعاءات هناك بالأداة strace. أما هنا فنقيس أخطاء أخرى يقع فيها المبتدئ كثيراً، وهي أن يفتح الملف ويغلقه مع كل سطر، أو أن يلغي الذاكرة المؤقتة. والسكربت التالي يكتب مئة ألف سطر سجل بثلاث طرق:
# writes.py: the same 100,000 lines from Python: open per line, unbuffered binary, and the default buffered file.
import io, time
N = 100000
line = lambda i: f"2026-10-30T10:00:00 INFO order={100000 + i} customer=عميل-{i % 997}\n"

t = time.perf_counter()
for i in range(N):
    with open("/tmp/a.log", "a", encoding="utf-8") as f:
        f.write(line(i))
print(f"open per line    : {(time.perf_counter() - t) * 1000:.0f} ms")

t = time.perf_counter()
with open("/tmp/b.log", "wb", buffering=0) as f:
    for i in range(N):
        f.write(line(i).encode("utf-8"))
print(f"buffering=0      : {(time.perf_counter() - t) * 1000:.0f} ms")

t = time.perf_counter()
with open("/tmp/c.log", "w", encoding="utf-8") as f:
    for i in range(N):
        f.write(line(i))
print(f"default buffered : {(time.perf_counter() - t) * 1000:.0f} ms")
print("io.DEFAULT_BUFFER_SIZE =", io.DEFAULT_BUFFER_SIZE)
والمخرج لتشغيلين متتاليين سوف يكون كما يلي:
open per line    : 8390 ms
buffering=0      : 818 ms
default buffered : 287 ms
io.DEFAULT_BUFFER_SIZE = 8192
open per line    : 9296 ms
buffering=0      : 849 ms
default buffered : 238 ms
io.DEFAULT_BUFFER_SIZE = 8192
في المخرج أعلاه لاحظ التالي:
- فتح الملف وإغلاقه لكل سطر أخذ بين 8.4 و9.3 ثانية، والسبب أن كل سطر صار ثلاثة استدعاءات نظام على الأقل،
openوwriteوclose، بالإضافة إلى إنشاء كائن الملف وطبقاته الثلاث في Python كل مرة. - الوضع الثنائي مع
buffering=0، أي بدون ذاكرة مؤقتة، أخذ حوالي 0.8 ثانية، لأن كل سطر صار استدعاءwriteواحداً. - الطريقة العادية، ملف واحد مفتوح بالذاكرة المؤقتة الافتراضية، أخذت ربع ثانية تقريباً، أي أسرع من الطريقة الأولى بما بين 29 و39 مرة في التشغيلين. والسطر الأخير يبين حجم الذاكرة المؤقتة الافتراضي في Python 3.13، وهو 8192 بايتاً.
والشيء نفسه في Node.js، حيث يكتب السكربت التالي الأسطر نفسها بالدالة appendFileSync التي تفتح الملف وتغلقه في كل مرة، ثم بـ writeSync على ملف مفتوح، ثم بـ createWriteStream:
// writes.js: write 100,000 log lines three ways and time each.
const fs = require('node:fs');
const N = 100000;
const line = (i) => `2026-10-30T10:00:00 INFO order=${100000 + i} customer=عميل-${i % 997}\n`;
const ms = (t) => (Number(process.hrtime.bigint() - t) / 1e6).toFixed(0);

let t = process.hrtime.bigint();
for (let i = 0; i < N; i++) fs.appendFileSync('/tmp/a.log', line(i));       // open + write + close every line
console.log(`appendFileSync per line : ${ms(t)} ms`);

t = process.hrtime.bigint();
const fd = fs.openSync('/tmp/b.log', 'w');
for (let i = 0; i < N; i++) fs.writeSync(fd, line(i));                       // one open, one write call per line
fs.closeSync(fd);
console.log(`writeSync per line      : ${ms(t)} ms`);

t = process.hrtime.bigint();
const out = fs.createWriteStream('/tmp/c.log');
let i = 0;
(function write() {
  while (i < N) { if (!out.write(line(i++))) return out.once('drain', write); }
  out.end(() => {
    console.log(`createWriteStream       : ${ms(t)} ms`);
    for (const f of ['a', 'b', 'c']) console.log(`/tmp/${f}.log`, fs.statSync(`/tmp/${f}.log`).size, 'bytes');
  });
})();
والمخرج لتشغيلين متتاليين سوف يكون كما يلي:
appendFileSync per line : 2331 ms
writeSync per line      : 1377 ms
createWriteStream       : 594 ms
/tmp/a.log 5988890 bytes
/tmp/b.log 5988890 bytes
/tmp/c.log 5988890 bytes
appendFileSync per line : 3637 ms
writeSync per line      : 1139 ms
createWriteStream       : 897 ms
/tmp/a.log 5988890 bytes
/tmp/b.log 5988890 bytes
/tmp/c.log 5988890 bytes
والنتيجة تشبه Python: appendFileSync لكل سطر هي الأبطأ بين 2.3 و3.6 ثانية، وwriteSync على ملف مفتوح أسرع منها بما بين مرتين وثلاث تقريباً، وال Stream هو الأسرع، والملفات الثلاثة بالحجم نفسه بالضبط، 5988890 بايتاً، أي أن الطرق الثلاث كتبت البيانات نفسها. ولاحظ أن الأرقام تختلف بين التشغيلين، وهذا طبيعي في أي قياس على جهاز يعمل عليه أشياء أخرى، والذي يهمك هو الترتيب والفرق الكبير، وليس الرقم الدقيق. والدالة appendFileSync مريحة جداً لسطر واحد كل فترة، مثل تسجيل حدث نادر، ولكن لا تقم باستخدامها داخل حلقة تكتب آلاف الأسطر.
التفريغ Flush والمزامنة fsync: ليسا الشيء نفسه
عندما تحتاج أن يصل سطر معين إلى الملف الآن، مثل سطر سجل قبل عملية خطيرة، فاستخدم f.flush()، وهذا ينقل ما في الذاكرة المؤقتة إلى النواة، فيراه أي برنامج آخر يقرأ الملف، مثل tail -f. ولكن flush لا يعني أن البيانات وصلت إلى القرص، فهي ما زالت في ال Page Cache في ذاكرة النواة، وإذا انقطعت الكهرباء قبل أن تكتبها النواة فسوف تضيع. ولكي تنتظر حتى تصل إلى القرص فعلاً تحتاج os.fsync(f.fileno()) في Python أو fs.fsyncSync(fd) في Node.js، وهذا أبطأ بكثير لأنه ينتظر القرص نفسه. وقد شرحنا في مقال نظام الملفات لماذا لا تعني الكتابة أن البيانات على القرص وكم يكلف fsync بقياسات حقيقية، فارجع إليهما إذا كانت بياناتك مهمة إلى هذه الدرجة. والقاعدة المختصرة: flush لكي يرى غيرك البيانات، وfsync لكي تنجو البيانات من انقطاع الكهرباء، وclose يفعل flush فقط وليس fsync.
قراءة ملف كبير: كله دفعة واحدة أم سطراً بعد سطر Streaming؟
نرجع إلى التقرير اليومي في قصة المتجر، فالمطلوب أن نعد أسطر ERROR في ملف السجلات. ولكي نجرب على حجم حقيقي ولا نرفع ملفاً كبيراً مع المقال، يولد السكربت التالي ملف سجلات من مليوني سطر داخل ال Container، وكل سطر عشرين فيه ERROR:
# gen.py: generate a large application log (default 2,000,000 lines) in /tmp; one line in 20 is an ERROR.
import sys
n = int(sys.argv[1]) if len(sys.argv) > 1 else 2_000_000
path = sys.argv[2] if len(sys.argv) > 2 else "/tmp/app.log"
with open(path, "w", encoding="utf-8") as f:
    for i in range(n):
        level = "ERROR" if i % 20 == 0 else "INFO"
        f.write(f"2026-10-30T10:{i // 60000 % 60:02d}:{i // 1000 % 60:02d} {level} order={100000 + i} "
                f"customer=عميل-{i % 997} total={(i % 500) + 0.5:.2f}\n")
print("written", n, "lines to", path)
ثم يعد السكربت التالي أسطر الخطأ بأربع طرق، وكل طريقة تعمل في عملية مستقلة حتى لا تؤثر ذاكرة واحدة على الأخرى، ويطبع الوقت وأعلى استهلاك للذاكرة Peak RSS من resource.getrusage كما في وثائق الوحدة resource:
# bigfile.py: count ERROR lines in a big log in one of four ways and report time and peak memory (ru_maxrss).
import resource, sys, time
mode, path = sys.argv[1], sys.argv[2] if len(sys.argv) > 2 else "/tmp/app.log"
t = time.perf_counter()
errors = 0
if mode == "read":                       # the whole file as one string
    with open(path, encoding="utf-8") as f:
        text = f.read()
    errors = sum(1 for line in text.splitlines() if " ERROR " in line)
elif mode == "readlines":                # the whole file as a list of strings
    with open(path, encoding="utf-8") as f:
        lines = f.readlines()
    errors = sum(1 for line in lines if " ERROR " in line)
elif mode == "stream":                   # one line at a time
    with open(path, encoding="utf-8") as f:
        for line in f:
            if " ERROR " in line:
                errors += 1
elif mode == "chunks":                   # fixed 1 MiB binary chunks
    with open(path, "rb") as f:
        tail = b""
        while chunk := f.read(1 << 20):
            chunk = tail + chunk
            errors += chunk.count(b" ERROR ")
            tail = chunk[-6:]
            errors -= tail.count(b" ERROR ")
elapsed = time.perf_counter() - t
peak = resource.getrusage(resource.RUSAGE_SELF).ru_maxrss / 1024
print(f"{mode:9} errors={errors} time={elapsed:.2f}s peak_rss={peak:.0f} MiB")
ونشغل التوليد ثم الطرق الأربع بالسكربت run-big.sh:
#!/bin/sh
# Generates the 2,000,000-line log inside the container, then runs every reading mode in its own process.
set -e
python3 /lab/gen.py 2000000 /tmp/app.log
ls -l /tmp/app.log
for m in read readlines stream chunks; do python3 /lab/bigfile.py $m; done
والمخرج سوف يكون كما يلي:
written 2000000 lines to /tmp/app.log
-rw-r--r-- 1 root root 146539312 Oct 30 22:11 /tmp/app.log
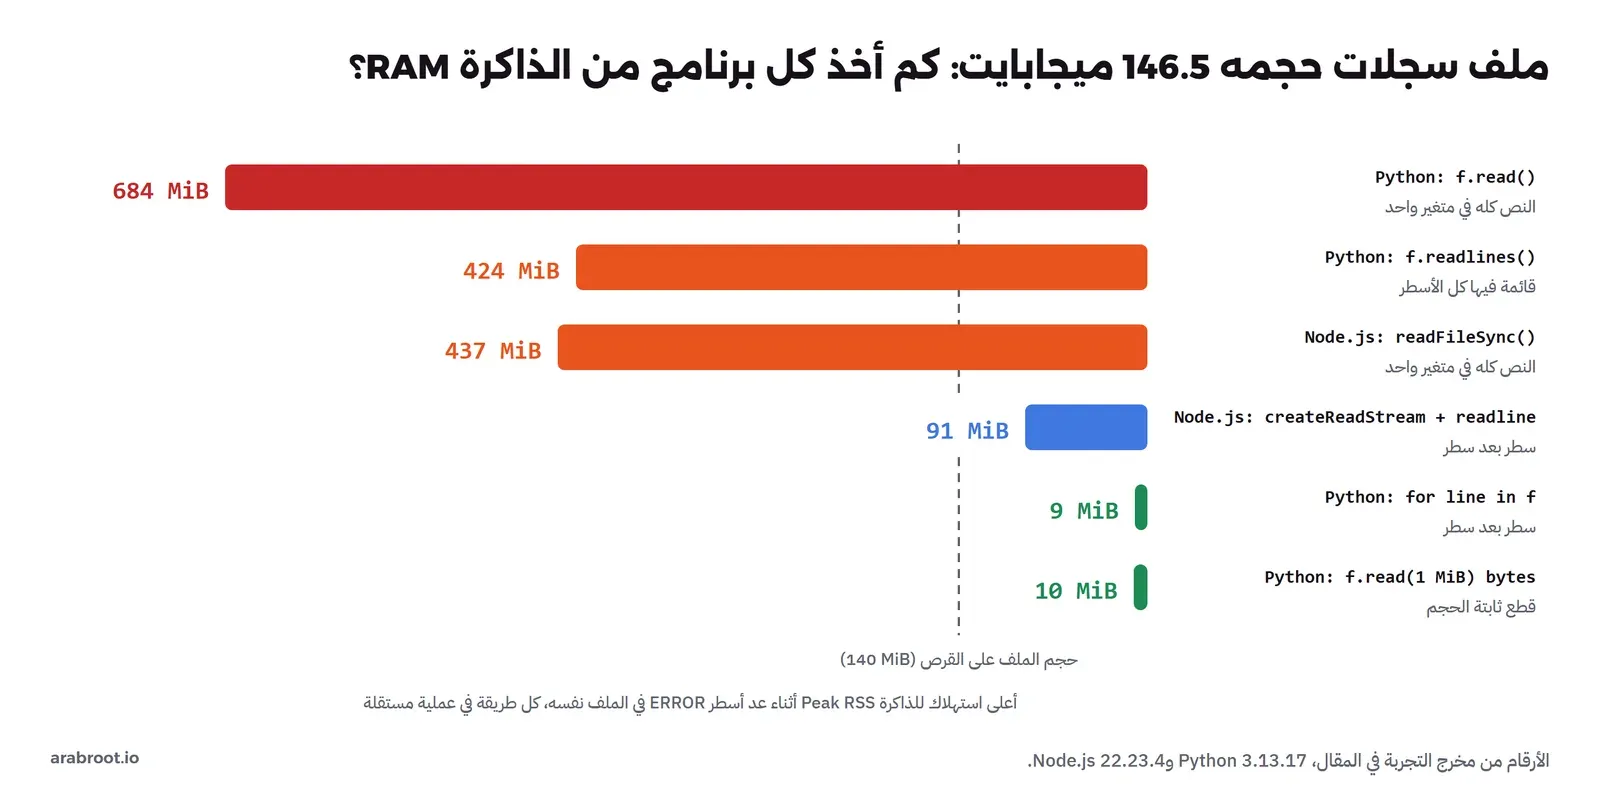
read      errors=100000 time=3.54s peak_rss=684 MiB
readlines errors=100000 time=2.10s peak_rss=424 MiB
stream    errors=100000 time=2.33s peak_rss=9 MiB
chunks    errors=100000 time=0.27s peak_rss=10 MiB
في المخرج أعلاه لاحظ التالي:
- حجم الملف 146,539,312 بايتاً، أي حوالي 146.5 ميجابايت أو 140 MiB، وكل الطرق وجدت العدد نفسه من الأخطاء، 100000 سطر، أي أن النتيجة صحيحة في الحالات الأربع.
- الطريقة
read، أي قراءة الملف كله في متغير واحد ثم تقسيمه إلى أسطر، وصل استهلاكها إلى 684 MiB، أي حوالي خمسة أضعاف حجم الملف. - الطريقة
readlines، أي قائمة فيها كل الأسطر، وصلت إلى 424 MiB، أي ثلاثة أضعاف حجم الملف. - الطريقة
stream، أيfor line in f، استهلكت 9 MiB فقط، وهذا تقريباً حجم مفسر Python نفسه، أي أن قراءة الملف لم تضف شيئاً يذكر، والسبب أن كل سطر يقرأ ويفحص ثم يترك ليحذفه جامع القمامة، فلا يوجد في الذاكرة في أي لحظة إلا سطر واحد والذاكرة المؤقتة للملف. - الطريقة
chunks، أي قراءة بايتات بقطع من 1 MiB والبحث فيها مباشرة بدون تحويلها إلى نص، استهلكت 10 MiB وكانت الأسرع بفرق كبير، 0.27 ثانية مقابل أكثر من ثانيتين للطرق الأخرى.
وقد يتساءل البعض: لماذا يأخذ ملف حجمه 140 MiB أكثر من ضعف حجمه في الذاكرة عندما نقرؤه كنص واحد؟ والإجابة في السكربت sizes.py الذي يطبع حجم الكائنات نفسها:
# sizes.py: why a 146 MB file takes several times more memory as Python objects.
import sys
path = "/tmp/app.log"
with open(path, encoding="utf-8") as f:
    text = f.read()
print("characters      :", len(text))
print("bytes on disk   :", len(text.encode("utf-8")))
print("str object (MiB):", round(sys.getsizeof(text) / 1048576))
lines = text.splitlines()
print("lines           :", len(lines))
print("one line        :", repr(lines[1]))
print("one line object :", sys.getsizeof(lines[1]), "bytes for", len(lines[1]), "characters")
print("ascii line      :", sys.getsizeof("x" * len(lines[1])), "bytes for the same length in ASCII")
print("list itself(MiB):", round(sys.getsizeof(lines) / 1048576))
والمخرج، ومعه تشغيل ثان للطرق الأربع، سوف يكون كما يلي:
characters      : 138539312
bytes on disk   : 146539312
str object (MiB): 264
lines           : 2000000
one line        : '2026-10-30T10:00:00 INFO order=100001 customer=عميل-1 total=1.50'
one line object : 186 bytes for 64 characters
ascii line      : 105 bytes for the same length in ASCII
list itself(MiB): 16
read      errors=100000 time=4.83s peak_rss=684 MiB
readlines errors=100000 time=3.39s peak_rss=424 MiB
stream    errors=100000 time=2.69s peak_rss=9 MiB
chunks    errors=100000 time=0.40s peak_rss=10 MiB
وفي هذا المخرج ثلاثة أسباب للفرق بين حجم الملف وحجمه في الذاكرة:
- النص الكامل أخذ 264 MiB بينما الملف 140 MiB، والسبب أن Python تخزن النص بحجم ثابت لكل حرف بحسب أكبر حرف فيه، كما في PEP 393، فالنص الذي كله ASCII يأخذ بايتاً لكل حرف، ولكن وجود حرف عربي واحد، ورقمه أكبر من 255، يجعل كل الحروف في النص بايتين، حتى الأرقام والحروف الإنجليزية. والملف فيه 138.5 مليون حرف، فيصبح النص حوالي 277 مليون بايت، أي 264 MiB.
- عند التقسيم إلى أسطر صار كل سطر كائناً مستقلاً، والسطر الذي فيه 64 حرفاً أخذ 186 بايتاً، منها 128 بايتاً للحروف نفسها والباقي ترويسة الكائن، بينما سطر ASCII بالطول نفسه يأخذ 105 بايتات فقط. ومليونا سطر بهذا الحجم تقريباً هي ال 424 MiB التي رأيناها في
readlines. - القائمة نفسها التي تحمل مليوني مرجع أخذت 16 MiB، وفي الطريقة
readيجتمع النص الكامل والقائمة وكل الأسطر في الذاكرة في اللحظة نفسها، ولذلك وصلت إلى 684 MiB.
وتلاحظ في التشغيل الثاني أن أرقام الذاكرة هي نفسها تماماً، 684 و424 و9 و10، بينما تغيرت الأوقات، وهذا متوقع، فالذاكرة تحددها البيانات والكود، والوقت يتأثر بكل ما يعمل على الجهاز. وقد شرحنا ال Heap وجامع القمامة وكيف تحجز اللغات الكائنات في مقال الذاكرة للمبرمجين، والصورة التالية تجمع أرقام Python وNode.js في مكان واحد:
التدفق Stream في Node.js مع readline
في Node.js الطريقتان المقابلتان هما readFileSync الذي يقرأ الملف كله، وfs.createReadStream الذي يقرأ الملف بقطع Chunks، حجم كل قطعة افتراضياً 64 KiB كما في وثائق الخيار highWaterMark، ومعه الوحدة readline التي تجمع القطع وتقسمها إلى أسطر، كما في مثال قراءة ملف سطراً بعد سطر في وثائق readline. والسكربت التالي يفعل الشيء نفسه، ويقيس أعلى RSS بأخذ عينة كل 20 ملي ثانية من process.memoryUsage():
// bigfile.js: count ERROR lines in a big log with readFileSync or with a stream + readline; report time and peak RSS.
const fs = require('node:fs');
const readline = require('node:readline');
const [mode, path = '/tmp/app.log'] = process.argv.slice(2);
let peak = 0;
const sample = () => { peak = Math.max(peak, process.memoryUsage().rss); };
const timer = setInterval(sample, 20);
const t = process.hrtime.bigint();
const done = (errors) => {
  sample(); clearInterval(timer);
  const ms = Number(process.hrtime.bigint() - t) / 1e6;
  console.log(`${mode.padEnd(8)} errors=${errors} time=${(ms / 1000).toFixed(2)}s peak_rss=${Math.round(peak / 1048576)} MiB`);
};
if (mode === 'whole') {
  const text = fs.readFileSync(path, 'utf8');
  sample();
  let errors = 0;
  for (const line of text.split('\n')) if (line.includes(' ERROR ')) errors++;
  done(errors);
} else if (mode === 'stream') {
  const rl = readline.createInterface({ input: fs.createReadStream(path, { encoding: 'utf8' }), crlfDelay: Infinity });
  let errors = 0;
  rl.on('line', (line) => { if (line.includes(' ERROR ')) errors++; });
  rl.on('close', () => done(errors));
}
ولأن صورة node:22-alpine لا تحتوي على Python، كتبنا مولداً مماثلاً بـ Node.js، والملفان متطابقان بالبايت، فبصمة md5sum للملف من المولدين هي نفسها 798bd71df92ed32826ad6aabc7c01c92:
// gen.js: the same log as gen.py, written with a WriteStream that respects back-pressure (drain).
const fs = require('node:fs');
const n = Number(process.argv[2] || 2000000);
const path = process.argv[3] || '/tmp/app.log';
const out = fs.createWriteStream(path, { encoding: 'utf8' });
const p2 = (x) => String(x).padStart(2, '0');
let i = 0;
function write() {
  while (i < n) {
    const level = i % 20 === 0 ? 'ERROR' : 'INFO';
    const line = `2026-10-30T10:${p2(Math.floor(i / 60000) % 60)}:${p2(Math.floor(i / 1000) % 60)} ${level} order=${100000 + i} ` +
      `customer=عميل-${i % 997} total=${((i % 500) + 0.5).toFixed(2)}\n`;
    i++;
    if (!out.write(line)) { out.once('drain', write); return; }
  }
  out.end(() => console.log('written', n, 'lines to', path));
}
write();
والمخرج للتوليد ثم تشغيلين لكل طريقة سوف يكون كما يلي:
written 2000000 lines to /tmp/app.log
-rw-r--r--    1 root     root     146539312 Oct 30 22:13 /tmp/app.log
798bd71df92ed32826ad6aabc7c01c92  /tmp/app.log
whole    errors=100000 time=4.58s peak_rss=437 MiB
stream   errors=100000 time=5.21s peak_rss=91 MiB
whole    errors=100000 time=4.03s peak_rss=437 MiB
stream   errors=100000 time=5.69s peak_rss=91 MiB
في المخرج أعلاه لاحظ التالي:
readFileSyncوصل إلى 437 MiB، والسبب أن V8 يخزن النص الذي فيه حروف عربية بترميز UTF-16، أي بايتين لكل حرف، تماماً مثل Python، ثم تنشئsplitمصفوفة من مليوني نص.- ال Stream مع
readlineوصل إلى 91 MiB، وهذا أكثر بكثير من 9 MiB في Python، والسبب أن Node.js نفسها تبدأ باستهلاك أكبر، وأن جامع القمامة في V8 لا يحذف الأسطر القديمة فوراً وإنما على دفعات. ولكن الرقم المهم أنه ثابت، وسوف نرى بعد قليل أنه لم يتغير تقريباً مع ملف أكبر بأربع مرات. - في هذه التجربة كان ال Stream أبطأ قليلاً من القراءة الكاملة، 5.2 و5.7 ثانية مقابل 4.6 و4.0، والسبب أن
readlineتطلق حدثاً Event لكل سطر من المليونين، وكل حدث له تكلفة. فال Stream لا يعني السرعة دائماً، وإنما يعني ذاكرة ثابتة.
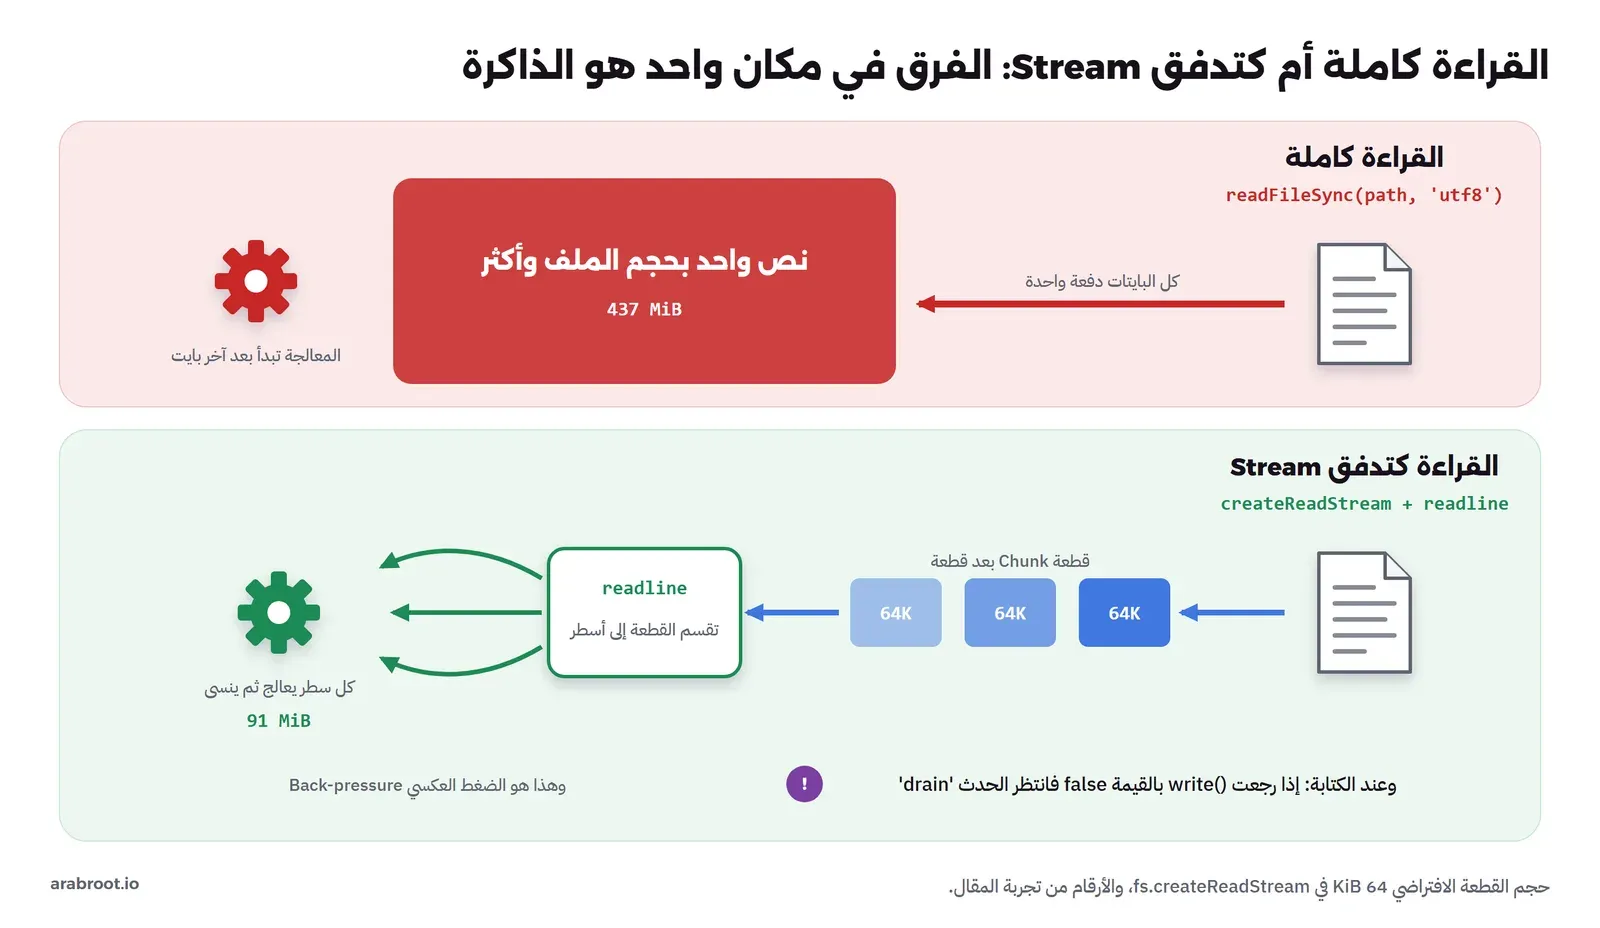
ولاحظ في المولد gen.js شيئاً مهماً عن الكتابة بال Stream: الدالة out.write ترجع false عندما تمتلئ الذاكرة الداخلية لل Stream، والمطلوب منك عندها أن تتوقف عن الكتابة وتنتظر الحدث 'drain'، وهذا ما يسمى الضغط العكسي Back-pressure كما في دليل Node.js عن Backpressuring in Streams. فإذا تجاهلت القيمة المرجعة وكتبت مليوني سطر في حلقة واحدة، فإن Node.js لن تفقد شيئاً، ولكنها سوف تحتفظ بكل الأسطر في الذاكرة حتى يلحق القرص بها، فتخسر الفائدة التي من أجلها استخدمت ال Stream أصلاً. وعندما تربط Stream للقراءة ب Stream للكتابة فاستخدم pipeline من الوحدة node:stream، فهي تدير الضغط العكسي وتغلق الطرفين عند الخطأ بنفسها.
ماذا يحدث إذا صغرت الذاكرة Memory أو كبر الملف؟
الآن نرجع إلى المشكلة الثالثة في قصة المتجر: التقرير الذي توقف بكلمة Killed. فقد شغلنا الطريقتين read وstream على الملف نفسه داخل Container حددنا ذاكرته بـ 512 ميجابايت بالخيارين --memory و--memory-swap، كما في وثائق Docker لحدود الموارد:
docker run --rm --name scp2-io-big --memory=512m --memory-swap=512m -v "$PWD:/lab:ro" python:3.13.17-slim \
  sh -c 'python3 /lab/gen.py >/dev/null; for m in read stream; do python3 /lab/bigfile.py $m; echo "exit=$?"; done'
والمخرج سوف يكون كما يلي:
Killed
exit=137
stream    errors=100000 time=3.77s peak_rss=9 MiB
exit=0
فالطريقة read احتاجت 684 MiB في التجربة السابقة، والحد 512، فقتلت النواة العملية عند تجاوز الحد، ولم تطبع Python أي رسالة خطأ ولا Traceback، فقط كلمة Killed من ال Shell ورمز الخروج 137، وهو 128 زائد رقم الإشارة SIGKILL وهو 9. وهذه الإشارة لا يمكن التقاطها، فلا يوجد except يحميك منها، ولن تجد في سجلات برنامجك أي أثر لما حدث، ولذلك إذا رأيت رمز الخروج 137 في Docker أو Kubernetes فابحث أولاً عن الذاكرة. أما الطريقة stream فعملت في ال Container نفسه ب 9 MiB كما كانت، وأعطت النتيجة الصحيحة.
والتجربة الثانية في الاتجاه الآخر: ملف أكبر بأربع مرات في Node.js، ثمانية ملايين سطر بحجم 588 ميجابايت، والذاكرة هذه المرة بدون حد:
written 8000000 lines to /tmp/big.log
-rw-r--r--    1 root     root     588857278 Oct 30 22:16 /tmp/big.log
node:fs:440
    return binding.readFileUtf8(path, stringToFlags(options.flag));
                   ^

Error: Cannot create a string longer than 0x1fffffe8 characters
    at Object.readFileSync (node:fs:440:20)
    at Object.<anonymous> (/lab/bigfile.js:15:19)
    at Module._compile (node:internal/modules/cjs/loader:1781:14)
    at Object..js (node:internal/modules/cjs/loader:1913:10)
    at Module.load (node:internal/modules/cjs/loader:1505:32)
    at Function._load (node:internal/modules/cjs/loader:1309:12)
    at wrapModuleLoad (node:internal/modules/cjs/loader:254:19)
    at Function.executeUserEntryPoint [as runMain] (node:internal/modules/run_main:171:5)
    at node:internal/main/run_main_module:36:49 {
  code: 'ERR_STRING_TOO_LONG'
}

Node.js v22.23.4
exit=1
stream   errors=400000 time=23.87s peak_rss=92 MiB
في المخرج أعلاه لاحظ التالي:
- القراءة الكاملة لم تصل إلى مشكلة الذاكرة أصلاً، وإنما توقفت قبلها بالخطأ
ERR_STRING_TOO_LONGوالرسالةCannot create a string longer than 0x1fffffe8 characters، فأطول نص يسمح به V8 في Node.js 22 هو0x1fffffe8، أي 536,870,888 حرفاً، وهذا الحد موثق في وثائق Buffer باسمbuffer.constants.MAX_STRING_LENGTH. والملف فيه أكثر من 550 مليون حرف، فلا يمكن أن يصبح نصاً واحداً مهما كانت ذاكرة الجهاز. - ولاحظ أن ال Stack Trace يشير إلى السطر 15 في
bigfile.jsوإلىreadFileUtf8داخلnode:fs، أي أن الخطأ وقع أثناء تحويل البايتات إلى نص وليس أثناء القراءة من القرص. - ال Stream قرأ الملف نفسه ووجد 400000 خطأ، أي أربعة أضعاف العدد السابق كما هو متوقع، وأعلى استهلاك للذاكرة 92 MiB، أي تقريباً نفس ال 91 MiB للملف الأصغر بأربع مرات، وهذا ما نعنيه بأن ذاكرة ال Stream ثابتة. والوقت 23.9 ثانية، أي حوالي أربعة أضعاف أيضاً، فالوقت يكبر مع الملف أما الذاكرة فلا.
وهذا هو الدرس الأهم في المقال: القراءة الكاملة لملف يكبر مع الوقت، مثل السجلات أو ملفات التصدير اليومية، هي قنبلة موقوتة، فهي تعمل اليوم والملف 10 ميجابايت، وتتوقف بعد سنة بخطأ لا علاقة له بالكود الذي غيرته. واقرأ الملف كاملاً فقط عندما تعرف أن حجمه صغير ومحدود، مثل ملف إعدادات.
القراءة بقطع ثنائية Chunks: الأسرع في التجربة
بقي سؤال: لماذا كانت الطريقة chunks في Python أسرع من الطرق الأخرى بثماني مرات تقريباً؟ والسبب أنها لا تحول البايتات إلى نص أصلاً، فلا يوجد فك ترميز لـ 146 مليون بايت، ولا يوجد إنشاء كائن لكل سطر من المليونين، وإنما تبحث الدالة bytes.count عن البايتات b" ERROR " داخل القطعة، وهذه دالة مكتوبة بلغة C وتعمل على الذاكرة مباشرة. ولكن لهذه الطريقة ثمن يجب أن تفهمه قبل أن تستخدمها، وهو حدود القطع: فالكلمة التي تبحث عنها قد تبدأ في آخر قطعة وتنتهي في أول التي بعدها، فلا تجدها أي قطعة منهما كاملة. ولذلك يحتفظ الكود بآخر 6 بايتات من كل قطعة في المتغير tail ويضيفها إلى أول القطعة التالية، ثم يطرح ما وجده داخل هذه البايتات الست حتى لا يعده مرتين. وهذا النوع من الكود سهل أن تخطئ فيه، لذلك استخدمه فقط عندما يكون الأداء مهماً فعلاً، وتحقق من نتيجته مقابل الطريقة البسيطة كما فعلنا هنا، حيث أعطت الطرق الأربع العدد نفسه. وطريقة القطع هذه هي أيضاً ما تحتاجه مع الملفات الثنائية التي ليس فيها أسطر أصلاً، مثل حساب Hash لملف فيديو، أو نسخ ملف ضخم من مكان إلى آخر.
الحفظ الآمن Atomic Write: ملف مؤقت ثم استبدال
بقيت المشكلة الأخيرة في قصة المتجر: ملف الإعدادات الذي توقف البرنامج أثناء حفظه. وقد رأيت في جدول أوضاع الفتح أن "w" يفرغ الملف في لحظة الفتح، فإذا توقف البرنامج بعد ذلك بأي سبب، انقطاع كهرباء أو نفاد ذاكرة أو قتل العملية، فإن الملف يبقى فارغاً أو ناقصاً. وفي التجربة مثلنا هذا التوقف في السكربت lifecycle.py بقطع الملف عند 5000 بايت بالدالة os.ftruncate ثم الخروج الفوري، وهذا ما يحدث فعلاً عندما يتوقف البرنامج بعد أن وصل جزء من البيانات فقط. والجزء الأخير من مخرج lifecycle.py أعلاه يبين النتيجتين:
- في الحالة
direct crashصار حجمconfig.jsonخمسة آلاف بايت بالضبط، وعند قراءته رمتjson.loadالخطأUnterminated string starting at: line 1 column 4269، أي أن الملف انتهى في منتصف نص. فالإعدادات القديمة ضاعت لأن"w"فرغ الملف، والجديدة ناقصة، والمتجر لن يعمل حتى يصلحه أحد بيده. - في الحالة
atomic crashتوقف البرنامج بالطريقة نفسها، ولكن في الملف المؤقتconfig.json.tmpالذي بقي بحجم 20 بايتاً، أماconfig.jsonالأصلي فلم يلمسه أحد، بحجمه 77 بايتاً، وقرأه البرنامج بنجاح:loaded: متجر التمور items: 1.
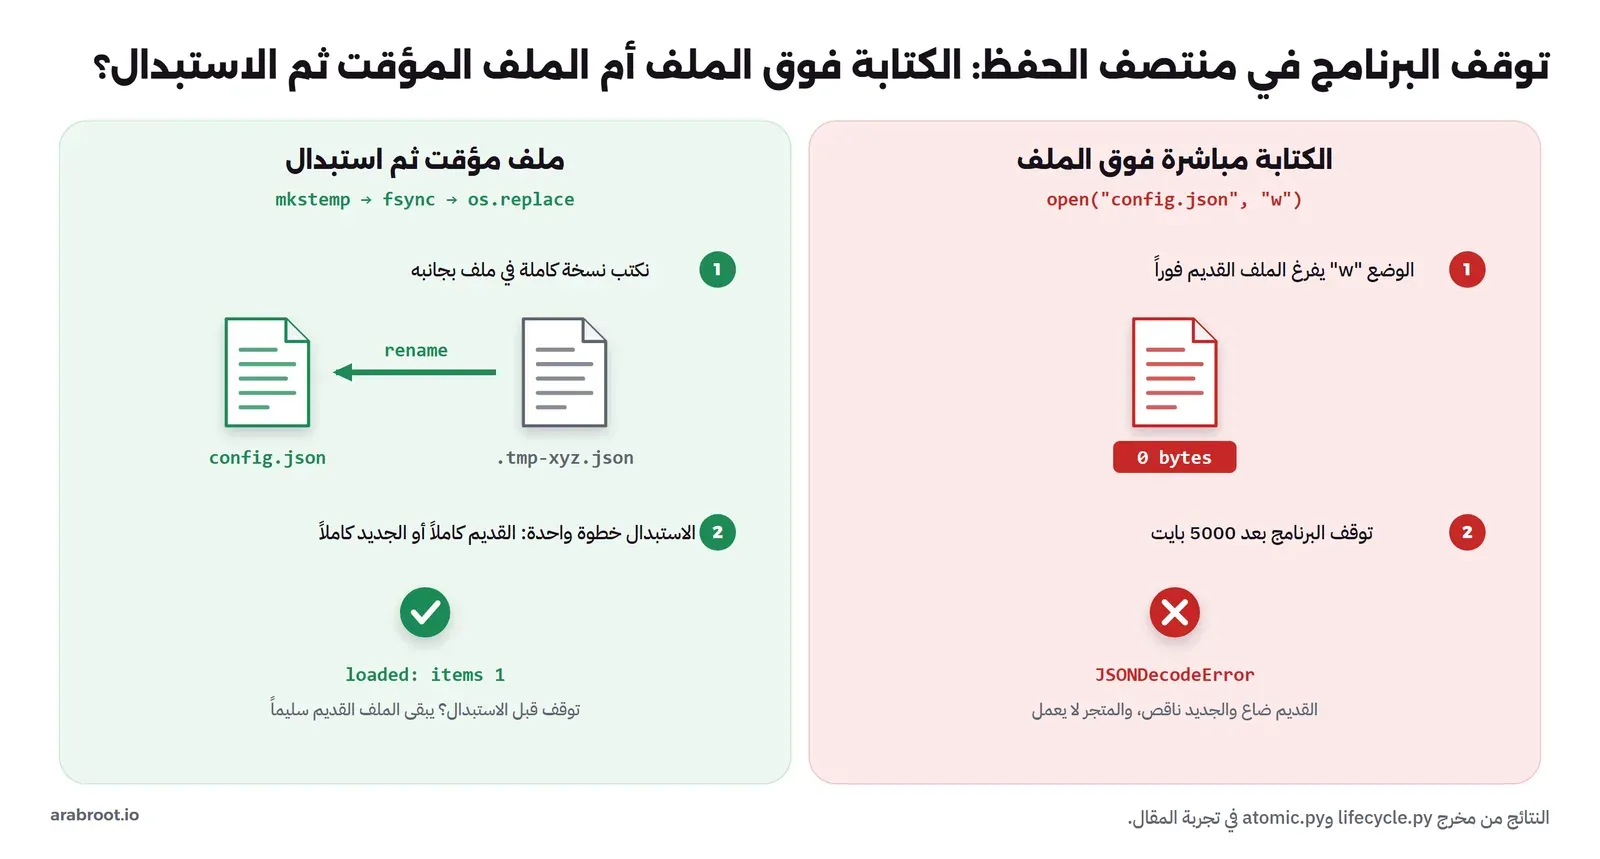
والفكرة التي جعلت الحالة الثانية آمنة هي أن نكتب الملف الجديد كاملاً باسم آخر في المجلد نفسه، ثم نستبدل به القديم بخطوة واحدة، وهذه الخطوة هي استدعاء النظام rename، وصفحة rename(2) تقول إنه إذا كان الاسم الجديد موجوداً فإنه يستبدل بشكل ذري Atomic، أي أن أي برنامج يفتح الملف في أي لحظة يجد إما القديم كاملاً أو الجديد كاملاً، ولا يوجد وقت بينهما. والدالة التالية هي الطريقة الكاملة في Python:
# atomic.py: the safe way to replace a file: write a temp file in the same folder, flush, fsync, then os.replace.
import json, os, tempfile

def atomic_write_json(path, data):
    folder = os.path.dirname(os.path.abspath(path))
    fd, tmp = tempfile.mkstemp(dir=folder, prefix=".tmp-", suffix=".json")
    try:
        with os.fdopen(fd, "w", encoding="utf-8") as f:
            json.dump(data, f, ensure_ascii=False, indent=2)
            f.flush()                    # Python's buffer -> kernel
            os.fsync(f.fileno())         # kernel -> disk
        os.replace(tmp, path)            # atomic rename on the same file system
    except BaseException:
        os.unlink(tmp)
        raise

before = os.stat("/tmp/config.json").st_ino
atomic_write_json("/tmp/config.json", {"store": "متجر التمور", "items": [{"sku": 1, "name": "سكري"}, {"sku": 2, "name": "خلاص"}]})
after = os.stat("/tmp/config.json").st_ino
print("inode before:", before, "after:", after)
print(open("/tmp/config.json", encoding="utf-8").read())
print("left in /tmp:", sorted(n for n in os.listdir("/tmp") if n.startswith(".tmp-")))
والمخرج سوف يكون كما يلي:
inode before: 939642 after: 939620
{
  "store": "متجر التمور",
  "items": [
    {
      "sku": 1,
      "name": "سكري"
    },
    {
      "sku": 2,
      "name": "خلاص"
    }
  ]
}
left in /tmp: []
في الإعداد أعلاه لاحظ التالي:
- الملف المؤقت ننشئه بـ
tempfile.mkstempفي المجلد نفسه الذي فيه الملف الأصلي، والسبب أنrenameيكون ذرياً فقط داخل نظام الملفات نفسه، فإذا كتبت الملف المؤقت في/tmpوكان ملفك على قسم آخر فسوف يفشل الاستبدال أو يتحول إلى نسخ عادي. والدالة mkstemp تعطيك اسماً لا يتكرر، فلا يتصادم برنامجان يحفظان في الوقت نفسه. - قبل الاستبدال نستدعي
flushثمos.fsync، حتى نتأكد أن الملف الجديد على القرص فعلاً قبل أن يحل محل القديم، وإلا فقد تحفظ النواة عملية الاستبدال قبل بيانات الملف بعد انقطاع الكهرباء، فتجد ملفاً فارغاً بالاسم الصحيح. وهذه المشكلة بالضبط، مشكلة الملفات الفارغة Zero-Length Files، شرحناها بتجربة حقيقية في قسم الاستبدال الآمن للملفات في مقال نظام الملفات، ومعها الخطوة الأخيرة لمن يريد ضماناً كاملاً، وهيfsyncللمجلد نفسه بعد الاستبدال. - الاستبدال يتم بـ
os.replaceوليسos.rename، والسبب أن os.replace تستبدل الملف الموجود على كل الأنظمة، أماos.renameفترمي خطأ في Windows إذا كان الاسم الجديد موجوداً. - رقم ال Inode تغير من 939642 إلى 939620، وهذا دليل على أن
config.jsonالآن ملف جديد تماماً وليس الملف القديم بعد تعديله، وأي برنامج كان قد فتح القديم قبل الاستبدال سوف يكمل قراءة النسخة القديمة كاملة. - في حالة الخطأ يحذف الكود الملف المؤقت، ولذلك لم يبق في المجلد أي ملف يبدأ بـ
.tmp-.
وفي Node.js الفكرة نفسها: fs.writeFileSync لملف مؤقت في المجلد نفسه، ثم fs.fsyncSync على واصفه إذا فتحته بنفسك، ثم fs.renameSync إلى الاسم النهائي، وrename في Node.js يستبدل الملف الموجود على كل الأنظمة.
ومتى تحتاج هذا كله؟ في كل ملف يقرؤه برنامجك عند التشغيل ويكتبه وهو يعمل: ملفات الإعدادات، وملفات الحالة State مثل آخر رقم طلب تمت معالجته، والملفات التي يقرؤها برنامج آخر في الوقت نفسه. أما ملفات السجلات وJSON Lines التي تضيف إليها بالوضع "a" فلا تحتاجه، لأن الإضافة لا تمس ما كتب من قبل، والذي يفسد في أسوأ الحالات هو آخر سطر فقط.
أخطاء شائعة Common Mistakes
- فتح ملف نصي بدون
encoding: يعمل على Linux ويفشل على Windows بـUnicodeEncodeErrorكما رأينا، أو يكتب الملف بترميز لا يتوقعه من يقرؤه. اكتبencoding="utf-8"دائماً، وشغل اختباراتك مرة مع-X warn_default_encoding. - إسكات خطأ الترميز بـ
errors="ignore"أو"replace": الخطأ يختفي والبيانات تفسد، والحل أن تعرف ترميز الملف الحقيقي، أو أن ترفضه برسالة واضحة. - قراءة CSV بـ
split(","): تفشل مع أول خلية فيها فاصلة أو سطر جديد. استخدم الوحدةcsvفي Python أو مكتبة معروفة في Node.js، وافتح الملف بـnewline=''. - نسيان ال BOM: عمود أول لا يطابق اسمه، و
KeyErrorلا تفهمه. استخدمutf-8-sigلكل ملف قد يأتي من Excel. - الوضع
"w"على ملف مهم: يفرغ الملف قبل أن تكتب، فأي توقف في المنتصف يضيع القديم والجديد. استخدم ملفاً مؤقتاً ثمos.replace. - ملف مفتوح لا يغلق: بيانات تضيع في الذاكرة المؤقتة، وأرقام تتسرب حتى
Too many open files. استخدمwithفي Python وfinallyفي Node.js. - فتح الملف وإغلاقه لكل سطر: أبطأ بحوالي 30 إلى 40 مرة في قياسنا. افتح الملف مرة واحدة واكتب فيه.
- قراءة ملف يكبر مع الوقت دفعة واحدة: يعمل اليوم ويتوقف بـ
KilledأوERR_STRING_TOO_LONGبعد أشهر. اقرأه سطراً بعد سطر من اليوم الأول. - اعتبار
flushضماناً:flushيوصل البيانات إلى النواة فقط، والضمان أمام انقطاع الكهرباء هوfsync. - تجاهل قيمة
writeفي Node.js Streams: الذاكرة تكبر بلا حد عندما تكون الكتابة أسرع من القرص. احترمfalseوانتظر'drain'، أو استخدمpipeline.
جدول القرار Decision Table: كيف تقرأ الملف وتكتبه؟
| الموقف | في Python | في Node.js | والسبب |
|---|---|---|---|
| ملف نصي صغير ومحدود الحجم، مثل الإعدادات | open(p, encoding="utf-8") ثم read() | readFileSync(p, 'utf8') | أبسط كود، والحجم لن يكبر |
| ملف يكبر مع الوقت، مثل السجلات والتصدير | for line in f | createReadStream مع readline | ذاكرة ثابتة مهما كبر الملف |
| CSV من Excel | encoding="utf-8-sig", newline="" مع csv.DictReader | حذف \ufeff ومكتبة CSV معروفة | ال BOM والسطر الجديد داخل الخلية |
| ملف من نظام قديم لا تعرف ترميزه | UTF-8 صارم أولاً ثم cp1256 | TextDecoder مع fatal: true ثم windows-1256 | خطأ صريح أفضل من نص مشوه |
| صورة أو ملف مضغوط أو Hash أو نسخ | الوضع "rb" مع read(1 << 20) | Buffer أو Stream بدون ترميز | البايتات كما هي، بدون فك ترميز |
| بحث سريع عن نص ثابت في ملف ضخم | قطع ثنائية مع معالجة الحدود | Stream بدون ترميز | الأسرع في قياسنا، ولكن انتبه لحدود القطع |
| كتابة سجلات أو بيانات كثيرة | ملف واحد مفتوح بالذاكرة المؤقتة الافتراضية | createWriteStream مع احترام 'drain' | أقل عدد من استدعاءات النظام |
| سجلات كثيرة بصيغة منظمة | JSON Lines بالوضع "a" وensure_ascii=False | JSON Lines مع JSON.stringify | إضافة سطر دون إعادة كتابة الملف |
| ملف إعدادات أو حالة يجب ألا يفسد | mkstemp ثم fsync ثم os.replace | ملف مؤقت ثم fsyncSync ثم renameSync | القديم كاملاً أو الجديد كاملاً |
تدريب عملي
- غير السكربت
bigfile.pyلكي يعد الأخطاء لكل عميل، أي قاموس من اسم العميل إلى عدد الأخطاء، بالطريقةstream، ثم شغله داخل Container بذاكرة 64 ميجابايت فقط، ولاحظ كم يأخذ القاموس من الذاكرة مقارنة بالملف. - اكتب دالة
atomic_write_jsonبلغة Node.js بالخطوات التي ذكرناها، ثم اختبرها بأن تقتل العملية بـprocess.exitقبلrenameSync، وتأكد أن الملف الأصلي بقي سليماً. - احفظ ملفاً من Excel بصيغة «CSV UTF-8» وآخر بصيغة «CSV» العادية، واطبع أول 8 بايتات من كل واحد بالوضع
"rb"، وحدد أيهما فيه BOM وأيهما بترميز آخر.
الخلاصة
- الملف على القرص بايتات فقط، والنص هو قرار تتخذه أنت عند الفتح، فحدد
encoding="utf-8"في كل ملف نصي، والحرف العربي يأخذ بايتين في UTF-8 وبايتاً واحداً في Windows-1256. - الترميز الخاطئ يعطيك إما
UnicodeDecodeErrorصريحاً، وهو الأفضل، أو نصاً مشوهاً مثل «ط§ظ„ظ…» بصمت، والترميز الافتراضي في Windows ليس UTF-8 حتى Python 3.15. - ملفات Excel تحمل BOM ونهايات أسطر
\r\nوأسطراً جديدة داخل الخلايا، والحلutf-8-sigوnewline=''والوحدةcsv. - اكتب JSON بـ
ensure_ascii=False، واستخدم JSON Lines للبيانات التي تكبر. - الملف الذي لا يغلق يضيع ما في ذاكرته المؤقتة ويستهلك أرقام الملفات حتى
Too many open files، وwithتحل المشكلتين. - الذاكرة المؤقتة جعلت الكتابة أسرع بحوالي 30 إلى 40 مرة من فتح الملف لكل سطر، و
flushيوصل البيانات إلى النواة فقط بينماfsyncيوصلها إلى القرص. - قراءة ملف 146.5 ميجابايت كاملاً أخذت 684 MiB في Python و437 MiB في Node.js، وكتدفق أخذت 9 MiB و91 MiB، والقراءة الكاملة توقفت بـ
Killedفي 512 ميجابايت وبـERR_STRING_TOO_LONGمع ملف 588 ميجابايت. - الحفظ الآمن ملف مؤقت في المجلد نفسه، ثم
fsync، ثمos.replace، فيبقى إما القديم كاملاً أو الجديد كاملاً.
وإذا أردت أن تكمل من هنا، فهذه مقالات مرتبطة بالموضوع:
 دليلفضاء النواة والمستخدم: كم يكلف استدعاء النظام System Call؟نعبر الحد بين برنامجك والنواة بأيدينا دون أي مكتبة، ونقيس كلفة كل عبور، ونرى لماذا يأخذ نسخ ملف ببايت واحد في كل طلب عشرات الثواني بدلاً من أقل من ملي ثانية.
 دليلنظام الملفات File System: Inodes والسجل Journal وfsyncنتابع الكتابة من برنامجك حتى القرص داخل ext4، ونقطع الكهرباء عن نظام ملفات يعمل لنرى ماذا يبقى فعلاً، ومتى تحتاج fsync وكم يكلف.
 دليلالترميز Encoding للمطورين: Base64 وأخواتهلماذا نحول البايتات إلى حروف حتى تمر في البريد والروابط، وكيف تفك أي سلسلة منها، ولماذا لا يحمي Base64 أي سر.
 دليلالتعريب i18n للمطورين: لماذا ينقلب النص العربي في الواجهة؟لماذا ينقلب النص المختلط في الواجهة العربية وكيف تعزله، وكيف تنسق الأرقام والتواريخ وصيغ الجمع العربية بأدوات المتصفح نفسها.
 دليلالذاكرة للمبرمجين: كيف تعمل ال Stack وال Heapلماذا تتغير قائمة لم تطلب تغييرها، وكيف تتسرب الذاكرة في لغة فيها جامع قمامة Garbage Collector، بأمثلة حقيقية من عدة لغات.
 دليلكيف تتعامل لغات البرمجة مع الأخطاء؟لماذا ترمي Java وPython الاستثناءات بينما ترجع Go وRust الخطأ كقيمة، وكيف تمنع الخطأ من أن يختفي بصمت في كودك.
 دليلقراءة ال Stack Trace وتصحيح الأخطاء Debugging للمبتدئينكيف تقرأ رسالة الخطأ في Python وJavaScript سطراً بسطر، ومتى تستخدم الطباعة أو نقاط التوقف في VS Code، وكيف يجد git bisect التعديل الذي أدخل الخطأ.
 دليلالاستدعاء الذاتي Recursion: كيف تفكر فيه ومتى تتجنبهكيف تكتب دالة تستدعي نفسها لشجرة تعليقات أو مجلدات، وما الذي يحدث في ال Stack، وإلى أي عمق تصل Python وNode.js بالقياس، ومتى تكون الحلقة هي الحل الأنسب.
سجل التحديثات
- أكتوبر 2026: كتابة المقال مع مختبر حقيقي في Python 3.13.17 وNode.js 22.23.4 داخل Docker، وتجربتين على Windows بـ Python 3.13.3، وقياس الذاكرة والوقت لقراءة ملف سجلات من مليوني سطر وثمانية ملايين سطر، وتجربة الحفظ الآمن، اعتماداً على وثائق Python وNode.js وRFC 4180 وRFC 8259 وصفحات Linux الرسمية.