


إذا كان لديك سيرفر واحد يعمل منذ سنة دون أن يتعطل، فهناك سؤال لا يحب أحد أن يسأله: ما الذي تغير عليه خلال هذه السنة دون أن تعرف؟ فالمراقبة تخبرك عندما يتوقف شيء فجأة، والتنبيه يرن عندما يمتلئ القرص أو تسقط الخدمة، ولكن أغلب ما يجعل السيرفر يتعطل في الشهر القادم لا يحدث فجأة، وإنما يتراكم بهدوء: شهادة تقترب من نهايتها وأنت تظن أن التجديد التلقائي يعمل، ومهمة نسخ احتياطي توقفت قبل ليلتين، وحزمة أمنية صدرت يوم الثلاثاء ولم يطبقها أحد، وزميل غادر الشركة قبل شهرين ومفتاحه ما زال في السيرفر. ولا واحدة من هذه تطلق تنبيهاً في يومها، ولكن كل واحدة منها قد تصبح حادثة.
والحل الذي تستخدمه الفرق الصغيرة منذ زمن بسيط جداً: موعد ثابت كل أسبوع يمر فيه شخص واحد على قائمة قصيرة بنفس الترتيب، ويسجل ما وجده. ولكن السؤال الذي يسأله كل من يدير السيرفرات بجانب عمله الأساسي، وهو حال أغلب المطورين في الشركات الناشئة، هو: كم يأخذ هذا من وقتي فعلاً؟ هل هو ساعة؟ نصف يوم؟ وهل يستحق؟ وفي هذا المقال سوف نجيب عن السؤال بالأرقام وليس بالتقدير، حيث نبني مختبراً صغيراً يشبه سيرفر متجر إلكتروني لشركة ناشئة: سيرفر Linux فيه حسابات ومفاتيح SSH، وقاعدة بيانات PostgreSQL مع نسخها الليلية، وموقع خلف Nginx بشهادة TLS، ثم نكتب سكربت الفحص الأسبوعي ونشغله ونقيس كل خطوة بالثواني، ونصلح ما وجده، ونشغله مرة ثانية.
وسوف نناقش في هذا المقال ما يلي:
- لماذا تحتاج روتيناً أسبوعياً إذا كانت لديك مراقبة وتنبيهات، وما الذي يكشفه الروتين ولا يكشفه التنبيه.
- ما يقوله كتاب Google SRE عن العمل الروتيني Toil، وكيف تحدد ما يدخل في الأسبوع وما يدخل في الشهر أو الربع.
- الخطوات الست: التحديثات، والقرص، والنسخ الاحتياطي مع اختبار الاستعادة، والشهادات، والسجلات، والمستخدمين والوصول.
- مختبر حقيقي: سكربت
weekly.shونتيجة التشغيل الأول سطراً سطراً، ثم الإصلاحات، ثم التشغيل الثاني، مع الوقت الحقيقي لكل خطوة. - المشكلات التي واجهتنا فعلاً: الأمر
lastlogغير موجود في Debian 13، واستعادة تفشل بسبب دور غير موجود، وقاعدةlastlog2الفارغة. - تجربة «ماذا لو» على سجلات Docker دون حد للحجم، ثم كم يحتاج السيرفر من وقتك في النهاية، وقائمة تحقق تبدأ بها.
لماذا روتين أسبوعي إذا كانت لديك مراقبة؟ Monitoring vs Maintenance
في دليل المراقبة رسمنا خريطة بثلاث عشرة منطقة يجب أن يراقبها الفريق، وفي مقال التنبيهات قلنا إن التنبيه الجيد هو الذي يحتاج تدخلاً من إنسان الآن. وهذا التعريف نفسه يترك مساحة كبيرة خارج التنبيهات: الأشياء التي تحتاج تدخلاً من إنسان، ولكن ليس الآن، وإنما هذا الأسبوع. فشهادة تنتهي بعد أحد عشر يوماً لا تستحق أن توقظ أحداً في الثالثة فجراً، ولكنها تستحق أن يراها شخص قبل نهاية الأسبوع. ومفتاح SSH لموظف غادر لا يطلق أي تنبيه أصلاً، لأنه لا يوجد مقياس اسمه «مفتاح لا يجب أن يكون هنا»، ولا يكتشفه إلا إنسان يقرأ قائمة المفاتيح ويعرف من في الفريق اليوم.
لذلك فالفرق بين المراقبة Monitoring والصيانة الدورية Maintenance ليس في الأدوات، وإنما في نوع السؤال. فالمراقبة تسأل «هل النظام يعمل الآن؟» وتجيب في كل دقيقة، والصيانة تسأل «هل سيبقى يعمل الشهر القادم؟» وتحتاج حكماً من إنسان يعرف السياق: هل هذا المستخدم ما زال يعمل معنا؟ هل هذا المسار في Nginx ما زال مستخدماً؟ هل هذا الدور في قاعدة البيانات لتطبيق حي أم لتجربة قديمة؟ وهذه أسئلة لا يستطيع Prometheus أن يجيب عنها مهما كانت قواعد التنبيه ذكية.
وهناك سبب ثان لا يقل أهمية، وهو أن المراقبة نفسها تحتاج من يراقبها. فقاعدة التنبيه التي تفحص عمر آخر نسخة احتياطية تعمل فقط إذا كانت مهمة الفحص تعمل، والبريد الذي يحمل رسالة الفشل يصل فقط إذا كان البريد يعمل. وفي مقال فحص التوفر ناقشنا سؤال «من يراقب سيرفر المراقبة؟»، والروتين الأسبوعي هو جزء من الإجابة: إنسان يفتح النتائج بنفسه مرة في الأسبوع، فيكتشف الصمت الذي لا يطلق تنبيهاً.
العمل الروتيني Toil: ماذا يقول كتاب SRE؟
يعرف فصل العمل الروتيني في كتاب Google SRE كلمة Toil بأنها العمل اليدوي المتكرر الذي يمكن أتمتته، ولا يضيف قيمة دائمة، ويكبر مع حجم الخدمة. ويقترح الفصل أن يبقى هذا العمل أقل من نصف وقت المهندس، والسبب أن الوقت الباقي هو الذي يحسن النظام ويقلل العمل الروتيني نفسه في المستقبل. والروتين الأسبوعي بهذا التعريف عمل روتيني بامتياز: نفس الخطوات كل أسبوع، ولا يبني شيئاً جديداً. فهل يعني ذلك أن نتخلص منه؟
الإجابة لا، وإنما أن نتعامل معه بالطريقة التي يقترحها الفصل نفسه: نقيسه أولاً، ثم نؤتمت الجزء الذي لا يحتاج حكماً، ونترك للإنسان الجزء الذي يحتاج حكماً فقط. ولذلك فالهدف من هذا المقال ليس قائمة طويلة تمر عليها يدوياً كل جمعة، وإنما سكربت يجمع كل المعلومات في دقيقة، ويطبع لكل بند سطراً واحداً يقول OK أو ACT، فيبقى للإنسان أن يقرأ السطور التي تقول ACT ويقرر. وكلما تكرر نفس السطر ACT أسبوعاً بعد أسبوع بنفس الإصلاح، فهذا السطر مرشح لأن ينتقل من الروتين إلى الأتمتة الكاملة أو إلى قاعدة تنبيه، كما شرحنا في مستويات دليل التشغيل Runbook.
وقد يتساءل البعض: لماذا لا نؤتمت كل شيء من البداية ونلغي الروتين؟ والإجابة أن الأتمتة الكاملة تحتاج أن تعرف كل الحالات مسبقاً، وأنت في الأسابيع الأولى لا تعرفها. فالسكربت الذي يحذف المفاتيح «غير المعروفة» تلقائياً قد يحذف مفتاح خط CI الذي ينشر الموقع، والسكربت الذي يطبق كل التحديثات ويعيد التشغيل تلقائياً قد يعيد تشغيل قاعدة البيانات في منتصف عملية الدفع. والروتين اليدوي المدعوم بسكربت فحص هو المرحلة التي تتعلم فيها هذه الحالات، ثم تنقل منها إلى الأتمتة ما ثبت أنه آمن.
ماذا يدخل في الأسبوع؟ Daily, Weekly, Monthly
ليس كل عمل صيانة مكانه الأسبوع. فبعض الأشياء يجب أن تحدث كل يوم أو كل ساعة، ومكانها الأتمتة والتنبيهات، وبعضها مكلف أو نادر التغير فيكفيه مرة في الشهر أو الربع. والقاعدة التي نستخدمها لاختيار الإيقاع Cadence بسيطة: كم يوماً يمكن أن تتأخر في اكتشاف المشكلة قبل أن تصبح حادثة؟ فإذا كان الجواب ساعات فهي تنبيه، وإذا كان أياماً فهي أسبوعية، وإذا كان أسابيع فهي شهرية. والجدول التالي يبين التقسيم الذي اعتمدناه للمتجر:
| الإيقاع | ما يدخل فيه | من يقوم به |
|---|---|---|
| كل دقيقة أو ساعة | توفر الموقع، امتلاء القرص فوق 90%، فشل النسخة الليلية، أخطاء 5xx فوق الحد | التنبيهات Alerts |
| كل ليلة | النسخة الاحتياطية، تحديثات الأمان التلقائية إن كانت مفعلة | مهام مجدولة Cron Jobs |
| كل أسبوع | الخطوات الست في هذا المقال، مع استعادة أحدث نسخة في Container مؤقت | شخص بالتناوب مع السكربت |
| كل شهر | تحديث ال Images بإصدار جديد، مراجعة قواعد التنبيه، استعادة كاملة على سيرفر آخر | الفريق في جلسة قصيرة |
| كل ربع سنة | يوم تجربة Game Day لدليل تشغيل، مراجعة الصلاحيات كاملة، تجربة خطة الطوارئ | الفريق مع صاحب القرار |
ولاحظ أن بعض البنود تظهر في أكثر من إيقاع بعمق مختلف، فالنسخة الاحتياطية لها تنبيه إذا فشلت الليلة، وفحص أسبوعي يستعيد أحدث نسخة ويطابق الأرقام، واستعادة شهرية كاملة على سيرفر آخر كما في مقال قاعدة 3-2-1. وكل طبقة تكشف نوعاً مختلفاً من الأخطاء: التنبيه يكشف الفشل الصريح، والفحص الأسبوعي يكشف النسخة التي «نجحت» ولكنها لا تستعاد كما يجب، والاستعادة الشهرية تكشف ما ينقص في خطة إعادة البناء من الصفر.
الخطوات الست Six Steps بالترتيب
الصورة التالية تبين الخطوات الست التي يمر عليها الروتين، وكل خطوة تجيب عن سؤال واحد:
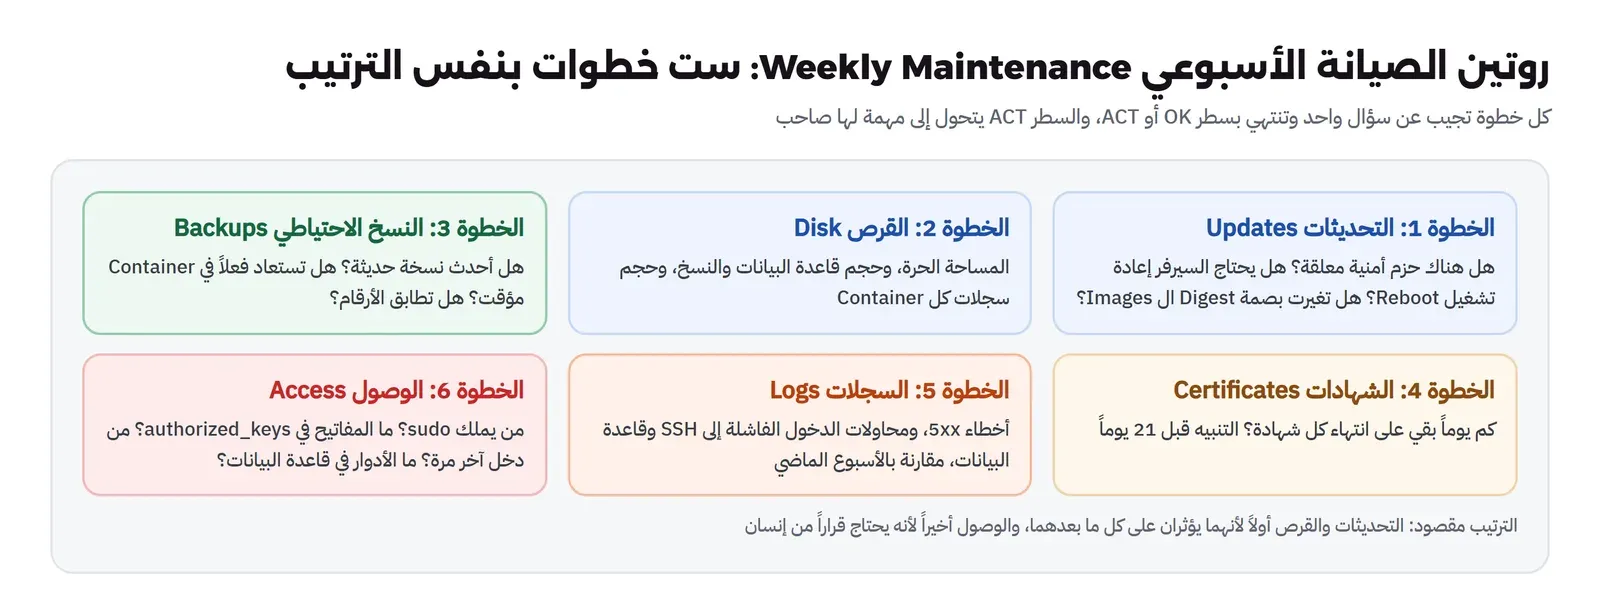
والترتيب ليس عشوائياً. فالتحديثات أولاً لأن الحزمة الأمنية المعلقة هي أكثر بند له موعد نهائي خارجي، فالثغرة منشورة والمهاجمون يقرؤون نفس النشرة التي تقرؤها. والقرص ثانياً لأن امتلاءه يفسد كل ما بعده، فلا نسخة احتياطية تكتب ولا سجل يحفظ. ثم النسخ الاحتياطي لأنه أهم ما تملك إذا حدث شيء، ثم الشهادات لأن لها تاريخاً معروفاً، ثم السجلات التي تحتاج قراءة ومقارنة، والوصول أخيراً لأنه البند الذي يحتاج أكثر حكم إنساني: من هؤلاء، وهل ما زال كل واحد منهم يحتاج ما يملكه؟
ولكل خطوة شرط يحولها من OK إلى ACT، ويجب أن يكون مكتوباً في السكربت وليس في رأس من يشغله. فالحد في المختبر للشهادات 21 يوماً، وللنسخة الاحتياطية 26 ساعة، أي ليلة واحدة مع هامش ساعتين لمهمة تأخرت. وسوف نشرح سبب كل رقم في خطوته.
المختبر Lab: سيرفر المتجر في ثلاثة Containers
الآن سوف نبني نسخة صغيرة من سيرفر المتجر على جهاز واحد، بثلاثة Containers على شبكة واحدة اسمها wr-dp-net: الأول wr-dp-host من Debian 13 ويمثل نظام التشغيل نفسه، فيه خدمة SSH وثلاثة حسابات هي ops وdeploy وintern، والثاني wr-dp-db من postgres:18-alpine وفيه قاعدة المتجر ونسخها، والثالث wr-dp-web من nginx:1.31.6-alpine ويخدم الموقع عبر HTTPS بشهادة تنتهي بعد 12 يوماً. وملف التعريف للسيرفر كما يلي:
# The small Linux server of the lab: sshd, sudo, a few accounts. Pinned base image, no upgrade at build time
# so the weekly check sees the updates that were published after the image was built.
FROM debian:trixie-slim@sha256:62bd423aeee912639ca8ee681c2b762cb3e25137e0a92b20be455898a9f034ad
RUN apt-get update && apt-get install -y --no-install-recommends openssh-server openssh-client sudo openssl ca-certificates procps \
 && rm -rf /var/lib/apt/lists/* && mkdir -p /run/sshd
RUN for u in ops deploy intern; do useradd -m -s /bin/bash $u; mkdir -p /home/$u/.ssh; done \
 && usermod -aG sudo ops && usermod -aG sudo intern \
 && ssh-keygen -q -t ed25519 -N '' -C 'ops@laptop' -f /tmp/k1 && ssh-keygen -q -t ed25519 -N '' -C 'ci@gitea-runner' -f /tmp/k2 \
 && ssh-keygen -q -t ed25519 -N '' -C 'intern@old-laptop' -f /tmp/k3 \
 && cp /tmp/k1.pub /home/ops/.ssh/authorized_keys && cp /tmp/k2.pub /home/deploy/.ssh/authorized_keys \
 && cat /tmp/k3.pub >> /home/ops/.ssh/authorized_keys && cp /tmp/k3.pub /home/intern/.ssh/authorized_keys && rm /tmp/k?
CMD ["/usr/sbin/sshd", "-D", "-E", "/var/log/auth.log"]
في الملف أعلاه لاحظ التالي:
- ال Image الأساسية مثبتة بالبصمة Digest، ولم نشغل
apt-get upgradeأثناء البناء عن قصد، والسبب أننا نريد أن يرى الفحص الأسبوعي التحديثات التي صدرت بعد بناء ال Image، كما يحدث على أي سيرفر لم يحدثه أحد منذ أسابيع. - الحساب
internيمثل متدرباً أنهى فترته وغادر، ولكن حسابه ما زال في مجموعةsudo، ومفتاحه موجود في حسابه، وموجود كذلك في حسابops، لأن أحد الزملاء أضافه هناك يوماً ما «مؤقتاً» لكي يساعده في مهمة. وهذه ليست مبالغة، فالمفتاح المضاف «مؤقتاً» إلى حساب مشترك من أكثر ما تجده في مراجعات الوصول. - كل مفتاح له تعليق Comment في آخر السطر مثل
ops@laptop، وهذا التعليق هو الشيء الوحيد الذي يقول لك لمن هذا المفتاح، فالسطر نفسه بدونه مجرد نص عشوائي. - خدمة SSH تكتب سجلها في
/var/log/auth.logعبر الخيار-E، لأن ال Container لا يحتوي systemd ولا خدمة Syslog.
وملف Compose يجمع الثلاثة:
name: wr-dp-wm
services:
  host:
    build: { context: ., dockerfile: Dockerfile.host }
    image: wr-dp-host:lab
    container_name: wr-dp-host
  db:
    image: postgres:18-alpine
    container_name: wr-dp-db
    environment: { POSTGRES_PASSWORD: lab-only-pass, POSTGRES_DB: shop }
    volumes: [ "wr-dp-pgdata:/var/lib/postgresql", "wr-dp-backups:/backups" ]
  web:
    image: nginx:1.31.6-alpine
    container_name: wr-dp-web
    volumes: [ "./web/default.conf:/etc/nginx/conf.d/default.conf:ro", "./web/tls:/etc/nginx/tls:ro" ]
volumes:
  wr-dp-pgdata: { name: wr-dp-pgdata }
  wr-dp-backups: { name: wr-dp-backups }
networks:
  default: { name: wr-dp-net }
وإعداد Nginx فيه مسار /api/ يشير إلى Container اسمه wr-dp-api لم يعد موجوداً، فقد نقل الفريق ال API إلى سيرفر آخر قبل أسابيع ونسي أن يحذف المسار:
server {
    listen 443 ssl;
    server_name shop.lab;
    ssl_certificate     /etc/nginx/tls/shop.crt;
    ssl_certificate_key /etc/nginx/tls/shop.key;
    location / { return 200 "shop ok\n"; }
    resolver 127.0.0.11 valid=30s;
    location /api/ { set $api http://wr-dp-api:8080; proxy_pass $api; }   # the API container was removed: every call fails
}
وهنا واجهنا أول مشكلة قبل أن نبدأ الفحص أصلاً: في النسخة الأولى من الإعداد كتبنا proxy_pass http://wr-dp-api:8080 مباشرة، فرفض Nginx أن يبدأ وخرج ال Container برمز 1 والرسالة host not found in upstream "wr-dp-api"، لأن Nginx يحل أسماء ال Upstream مرة واحدة عند البدء، فإذا لم يجد الاسم رفض الإعداد كله. ولذلك أضفنا resolver 127.0.0.11، وهو عنوان DNS الداخلي في شبكات Docker، ووضعنا العنوان في متغير، فيحل Nginx الاسم عند كل طلب بدلاً من البدء. وهذا مفيد لك خارج المختبر كذلك: إذا كان ال Upstream قد يختفي، فالإعداد المباشر يوقف الموقع كله عند أول إعادة تشغيل، وليس المسار وحده.
ثم شغلنا سكربت seed.sh الذي يصنع أسبوعاً من التاريخ: 50 ألف طلب في جدول orders، ودورين في قاعدة البيانات هما shop_app للتطبيق وintern_ro للمتدرب مع صلاحية القراءة على الجدول، وسبع نسخ ليلية بصيغة pg_dump -Fc من 29 أكتوبر إلى 4 نوفمبر، و300 زيارة للموقع و40 طلباً إلى /api/، وأربع محاولات دخول SSH بأسماء غير موجودة، وثلاث محاولات دخول إلى قاعدة البيانات بكلمة مرور خاطئة. ولاحظ أننا صنعنا النسخ السبع بأنفسنا وغيرنا تاريخها، ولم نصنع نسخة لليلة الخامس من نوفمبر، وهو يوم تشغيل الفحص، فهذه الليلة الناقصة تمثل مهمة مجدولة توقفت دون أن يلاحظ أحد.
وفي السكربت نفسه مشكلة صغيرة اكتشفناها عند كتابته، وتستحق أن تعرفها: محاولات الدخول الخاطئة إلى PostgreSQL من داخل ال Container نفسه نجحت كلها رغم أن كلمة المرور خاطئة، ولم يظهر في السجل أي سطر فشل. والسبب أن ال Image الرسمية تضبط ملف pg_hba.conf بحيث تكون الاتصالات من 127.0.0.1 داخل ال Container بطريقة trust، أي دون كلمة مرور أصلاً، أما الاتصالات من الشبكة فتحتاج scram-sha-256. ولذلك نفذنا المحاولات الخاطئة من Container آخر على الشبكة، فظهرت في السجل كما تظهر محاولات حقيقية من الخارج.
سكربت الفحص Weekly Script سطراً سطراً
السكربت يعمل من جهاز المسؤول عبر docker exec، ولكنه على سيرفر حقيقي سيكون نفس الأوامر عبر SSH أو على السيرفر نفسه. والقاعدة الأولى فيه أنه لا يغير شيئاً، ما عدا الخطوة الثالثة التي تنشئ Container مؤقتاً للاستعادة ثم تحذفه. فتستطيع أن تشغله في أي وقت دون أن تخاف، وأن تطلب من أحدث شخص في الفريق أن يشغله. والسكربت كاملاً كما يلي:
#!/bin/sh
# Weekly maintenance check for the lab stack (wr-dp-host, wr-dp-db, wr-dp-web).
# Read-only except step 3, which restores the newest dump into a throwaway container and removes it.
# Usage: sh weekly.sh            Prints each finding with OK / ACT and the seconds each step took.
export MSYS_NO_PATHCONV=1        # Git Bash on Windows: keep container paths as they are
H=wr-dp-host DB=wr-dp-db WEB=wr-dp-web NET=wr-dp-net
WARN_DAYS=21 MAX_DUMP_AGE_H=26
t0=$(date +%s.%N); last=$t0
el() { awk -v a="$1" -v b="$2" 'BEGIN{printf "%.1f", b-a}'; }
step() { now=$(date +%s.%N); [ -n "$name" ] && echo "   ($(el $last $now) s)"; last=$now; name=$1; echo "== $1"; }

step "1. updates"
docker exec $H sh -c 'apt-get update -qq 2>/dev/null; n=$(apt list --upgradable 2>/dev/null | grep -c upgradable);
  s=$(apt list --upgradable 2>/dev/null | grep -c -- -security); echo "   host packages: $n upgradable, $s from security"
  [ -f /var/run/reboot-required ] && echo "   ACT reboot required" || echo "   OK no reboot pending"'
for c in $DB $WEB; do
  img=$(docker inspect -f '{{.Config.Image}}' $c)
  local_digest=$(docker image inspect -f '{{index .RepoDigests 0}}' "$img" | cut -d@ -f2)
  remote=$(docker buildx imagetools inspect "$img" --format '{{json .Manifest.Digest}}' 2>/dev/null | tr -d '"')
  [ "$local_digest" = "$remote" ] && echo "   OK $c $img is current" || echo "   ACT $c $img: registry has ${remote#sha256:}" | cut -c1-90
done

step "2. disk"
docker exec $H df -h / | awk 'NR==2{print "   host /: "$5" used, "$4" free"}'
docker exec $DB du -sh /var/lib/postgresql /backups | sed 's/^/   /'
for c in $H $DB $WEB; do echo "   log of $c: $(docker logs $c 2>&1 | wc -c) bytes"; done

step "3. backups"
f=$(docker exec $DB sh -c 'ls -t /backups/*.dump | head -1')
age=$(docker exec $DB sh -c "echo \$(( (\$(date +%s) - \$(stat -c %Y $f)) / 3600 ))")
echo "   newest: $f, $age h old, $(docker exec $DB du -h $f | cut -f1)"
[ "$age" -le $MAX_DUMP_AGE_H ] && echo "   OK newest dump is fresh" || echo "   ACT newest dump is older than $MAX_DUMP_AGE_H h"
docker run -d --rm --name wr-dp-restore --network $NET -e POSTGRES_PASSWORD=x postgres:18-alpine >/dev/null
r=$(echo $f | sed 's/shop-\(.*\)\.dump/roles-\1.sql/')          # roles live outside pg_dump (see db-backups)
docker exec $DB sh -c "cat $r 2>/dev/null" | docker exec -i wr-dp-restore sh -c 'until pg_isready -q; do sleep 1; done
  cat > /tmp/roles.sql; if [ -s /tmp/roles.sql ]; then psql -q -U postgres -f /tmp/roles.sql 2>&1 | grep -v "already exists"
  echo "   roles restored"; else echo "   ACT no roles file next to the dump"; fi'
docker exec $DB cat $f | docker exec -i wr-dp-restore sh -c 'cat > /tmp/r.dump
  createdb -U postgres shop && pg_restore -U postgres -d shop --no-owner /tmp/r.dump; echo "   pg_restore exit $?"'
prod=$(docker exec $DB psql -U postgres -d shop -tAc 'select count(*), max(id) from orders')
rest=$(docker exec wr-dp-restore psql -U postgres -d shop -tAc 'select count(*), max(id) from orders')
echo "   orders prod: $prod  restored: $rest"
docker rm -f wr-dp-restore >/dev/null

step "4. certificates"
end=$(docker exec $H sh -c "echo | openssl s_client -connect $WEB:443 -servername shop.lab 2>/dev/null | openssl x509 -noout -enddate | cut -d= -f2")
left=$(docker exec $H sh -c "echo \$(( (\$(date -d '$end' +%s) - \$(date +%s)) / 86400 ))")
[ "$left" -ge $WARN_DAYS ] && echo "   OK shop.lab: $left days left" || echo "   ACT shop.lab expires $end ($left days left)"

step "5. logs (last 7 days)"
echo "   web 5xx: $(docker logs --since 168h $WEB 2>/dev/null | grep -cE '" 5[0-9][0-9] ')"
echo "   web errors: $(docker logs --since 168h $WEB 2>&1 >/dev/null | grep -c '\[error\]')"
echo "   db failed logins: $(docker logs --since 168h $DB 2>&1 | grep -c 'password authentication failed')"
echo "   ssh invalid users: $(docker exec $H grep -c 'Invalid user' /var/log/auth.log)"

step "6. users and access"
docker exec $H sh -c 'echo "   login shells: $(awk -F: "\$7 ~ /(ba)?sh\$/ {printf \"%s \", \$1}" /etc/passwd)"
  echo "   sudo: $(getent group sudo | cut -d: -f4)"
  for u in /home/*; do [ -f $u/.ssh/authorized_keys ] && awk -v u=${u#/home/} "{print \"   key \" u \": \" \$NF}" $u/.ssh/authorized_keys; done
  [ -f /var/lib/lastlog/lastlog2.db ] && lastlog2 | tail -n +2 | awk "{print \"   last login \" \$1\": \"\$(NF-5)\" \"\$(NF-4)\" \"\$(NF-3)\" \"\$(NF-2)}" || echo "   ACT no last-login records (lastlog2 missing or empty)"'
docker exec $DB psql -U postgres -tAc "select '   db login roles: '||string_agg(rolname, ' ') from pg_roles where rolcanlogin"

step "done"
echo "   total $(el $t0 $last) s"
في السكربت أعلاه لاحظ التالي:
- الدالة
stepتطبع اسم الخطوة، وعند بداية الخطوة التالية تطبع الثواني التي أخذتها السابقة، وهكذا نحصل على وقت كل خطوة دون أن نكتب أمر توقيت في كل مكان. والحساب عبرawkوليسbc، والسبب في المشكلات أدناه. - الحدود
WARN_DAYSوMAX_DUMP_AGE_Hفي أعلى الملف، فمن يريد أن يغيرها يجدها في مكان واحد ولا يبحث عنها داخل الأوامر. - في الخطوة الأولى نقارن بصمة ال Image المحلية بالبصمة في ال Registry عبر
docker buildx imagetools inspect، وهذا الأمر يسأل ال Registry عن ال Manifest فقط دون أن يسحب ال Image، كما في توثيق الأمر، فلا يستهلك القرص ولا الشبكة إلا قليلاً. - في الخطوة الثالثة لا نكتفي بوجود الملف، وإنما نستعيده فعلاً في Container مؤقت اسمه
wr-dp-restore، ونقارن عدد الطلبات وأكبر رقم طلب بين الإنتاج والنسخة المستعادة. - في الخطوة الخامسة نقرأ سجلات آخر سبعة أيام فقط عبر
--since 168h، لأن السؤال هو «ماذا حدث هذا الأسبوع؟»، وليس كل ما حدث منذ تشغيل ال Container. - كل سطر يحتاج عملاً يبدأ بالكلمة ACT، فتستطيع أن تبحث عنها في المخرج، أو أن تجعل السكربت يرسل المخرج إلى قناة الفريق إذا وجدها.
وفي أول تشغيل للسكربت ظهر في كل خطوة السطر bc: command not found بدلاً من الثواني، لأن Git Bash على Windows الذي شغلنا منه لا يحتوي الأداة bc، وهي غير موجودة كذلك في كثير من صور Linux الصغيرة. فاستبدلناها بسطر awk واحد، وawk موجود في كل مكان تقريباً. وهذه ملاحظة عامة لكل سكربت صيانة: اكتبه بأقل الأدوات افتراضاً، لأنه سيعمل في يوم ما على سيرفر لا تعرف ما ثبت عليه.
التشغيل الأول First Run: ماذا وجد السكربت؟
شغلنا السكربت صباح الخامس من نوفمبر بتوقيت UTC، والمخرج سوف يكون كما يلي:
== 1. updates
   host packages: 3 upgradable, 2 from security
   OK no reboot pending
   OK wr-dp-db postgres:18-alpine is current
   OK wr-dp-web nginx:1.31.6-alpine is current
   (25.7 s)
== 2. disk
   host /: 15% used, 817G free
   66.8M	/var/lib/postgresql
   1.9M	/backups
   log of wr-dp-host: 0 bytes
   log of wr-dp-db: 4455 bytes
   log of wr-dp-web: 39779 bytes
   (2.7 s)
== 3. backups
   newest: /backups/shop-2026-11-04.dump, 30 h old, 272.0K
   ACT newest dump is older than 26 h
pg_restore: error: could not execute query: ERROR:  role "intern_ro" does not exist
Command was: GRANT SELECT ON TABLE public.orders TO intern_ro;


pg_restore: warning: errors ignored on restore: 1
   pg_restore exit 1
   orders prod: 50000|50000  restored: 50000|50000
   (6.2 s)
== 4. certificates
   ACT shop.lab expires Nov 17 08:18:55 2026 GMT (11 days left)
   (0.9 s)
== 5. logs (last 7 days)
   web 5xx: 40
   web errors: 40
   db failed logins: 3
   ssh invalid users: 4
   (1.5 s)
== 6. users and access
   login shells: root ops deploy intern
   sudo: ops,intern
   key deploy: ci@gitea-runner
   key intern: intern@old-laptop
   key ops: ops@laptop
   key ops: intern@old-laptop
   ACT no lastlog2 on this server
   db login roles: postgres shop_app intern_ro
   (0.8 s)
== done
   total 37.8 s
والصورة التالية تلخص النتيجة في جدول واحد:
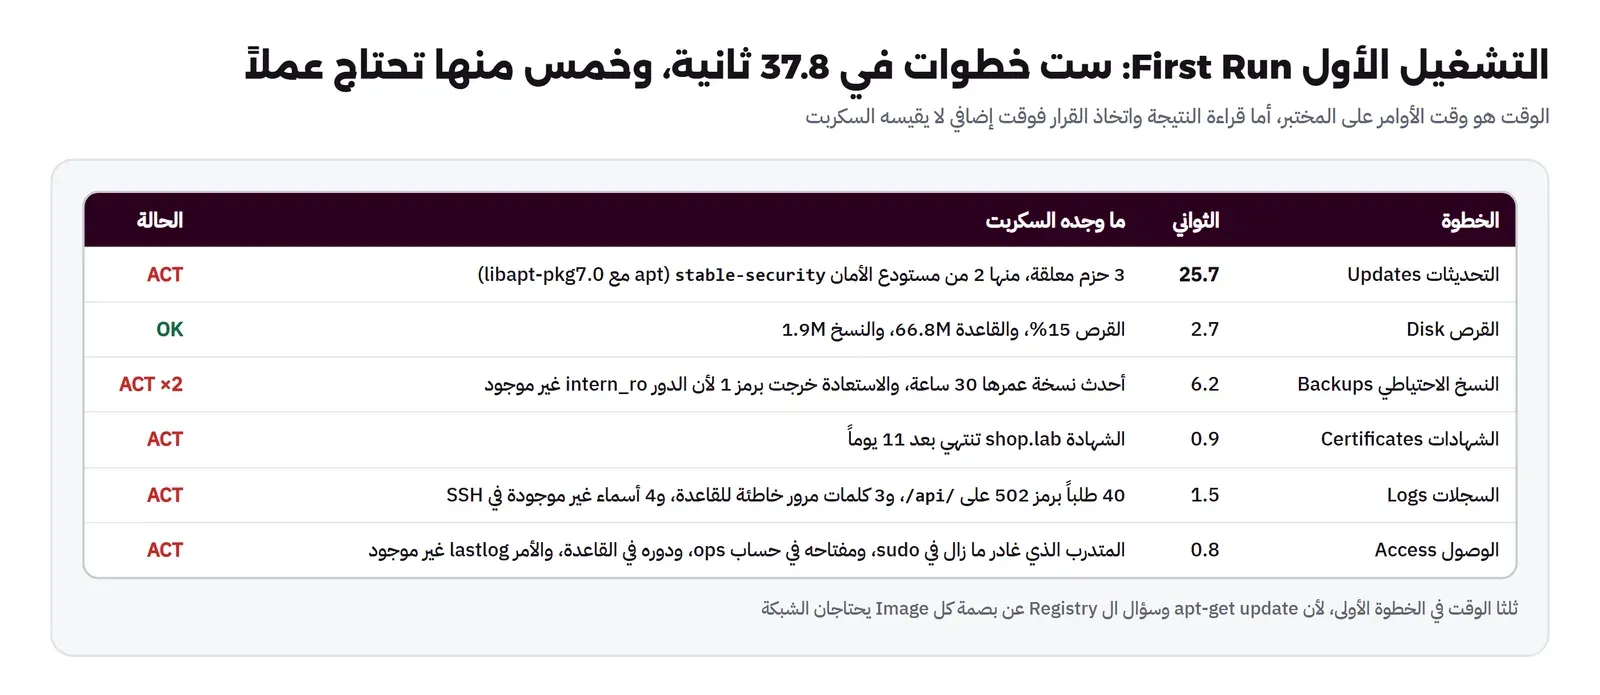
وقبل أن نمر على كل خطوة، لاحظ الرقم الأهم: الفحص كله أخذ 37.8 ثانية من وقت الأوامر، منها 25.7 ثانية في الخطوة الأولى وحدها. فالروتين الأسبوعي من جهة الآلة لا يأخذ شيئاً تقريباً، والوقت الحقيقي في مكان آخر، كما سنرى. والآن لنقرأ المخرج خطوة خطوة.
الخطوة الأولى: التحديثات Updates
السطر الأول يقول إن على السيرفر ثلاث حزم لها إصدار أحدث، منها اثنتان من مستودع الأمان. ولكي نرى ما هي، شغلنا الأمر apt list --upgradable على السيرفر:
Listing...
apt/stable-security 3.0.4 amd64 [upgradable from: 3.0.3]
libapt-pkg7.0/stable-security 3.0.4 amd64 [upgradable from: 3.0.3]
tzdata/stable-updates 2026f-0+deb13u1 all [upgradable from: 2026c-0+deb13u1]
والقراءة هنا مهمة: الحزمتان apt وlibapt-pkg7.0 جاءتا من stable-security، أي أن فريق الأمان في Debian أصدر لهما إصلاحاً، ومكان الإعلان عنه هو صفحة أمان Debian وقائمة إعلانات الأمان. أما tzdata فجاءت من stable-updates، وهي ليست ثغرة وإنما تحديث لقواعد المناطق الزمنية، ولكنها تستحق التطبيق كذلك، لأن أي تغيير في التوقيت الصيفي لدولة يتعامل معها نظامك يظهر في هذه الحزمة. وهذا التمييز هو ما يجعل الخطوة سريعة القرار: حزم الأمان تطبق هذا الأسبوع، وباقي التحديثات تجمع وتطبق في نافذة شهرية إلا إذا كان فيها ما يهمك. والتفاصيل الكاملة عن ترتيب الأولويات وتطبيق التحديثات دون إيقاف الخدمة في مقال إدارة التحديثات الأمنية Patch Management.
والسطر الثاني OK no reboot pending يفحص وجود الملف /var/run/reboot-required، وهو ملف تنشئه حزم Debian وUbuntu عندما يتطلب التحديث إعادة تشغيل، مثل تحديث النواة Kernel أو مكتبة C الأساسية. والفكرة أن السيرفر الذي طبق تحديث النواة ولم يعد التشغيل ما زال يعمل بالنواة القديمة، أي أن الثغرة ما زالت مفتوحة رغم أن apt يقول إن كل شيء محدث. ولذلك هذا السطر يستحق أن يكون في كل فحص أسبوعي، وإعادة التشغيل نفسها تجدول في وقت هادئ وليس في وقت الفحص.
والسطران الأخيران يقارنان بصمة ال Image لكل Container مع البصمة الحالية في Docker Hub، وكلاهما OK، أي أن postgres:18-alpine وnginx:1.31.6-alpine لم يتغيرا منذ سحبناهما. ولكن لاحظ أن الفحص يقارن الوسم Tag نفسه فقط، فإذا كان الوسم مثبتاً على إصدار دقيق مثل 1.31.6 فلن يقول لك الفحص إن هناك 1.31.7. وهذا قرار مقصود في المختبر، والطريقة الأفضل لمتابعة الإصدارات الجديدة هي أداة مثل Diun أو Renovate، كما شرحنا في مقال تحديث ال Containers بأمان. والخطوة الأسبوعية هنا هي التأكد أن تلك الأداة تعمل وأن طلبات الدمج التي تفتحها لا تتراكم دون مراجعة.
وأخذت هذه الخطوة 25.7 ثانية، وهي الأطول بفارق كبير، والسبب أنها الوحيدة التي تحتاج الشبكة: apt-get update ينزل فهارس المستودعات، وكل استدعاء لل Registry يحتاج طلب توكن ثم طلب Manifest. وعلى سيرفر في مركز بيانات قريب من المستودعات سيكون الرقم أقل، ولكن الخطوة ستبقى الأطول غالباً.
الخطوة الثانية: القرص Disk
الخطوة الثانية هي الوحيدة التي خرجت OK في التشغيل الأول: القرص مستخدم بنسبة 15%، وقاعدة البيانات 66.8 ميجابايت، والنسخ الاحتياطية 1.9 ميجابايت. ولاحظ أن رقم القرص هنا هو قرص الآلة الافتراضية التي يعمل عليها Docker Desktop، ولذلك المساحة الحرة كبيرة، أما على سيرفر حقيقي فهو قرص السيرفر نفسه.
وقد يتساءل البعض: إذا كانت لدينا قاعدة تنبيه عند 90%، فلماذا ننظر إلى القرص كل أسبوع؟ والإجابة أن التنبيه يقول لك متى امتلأ القرص تقريباً، والفحص الأسبوعي يقول لك كيف يتغير. فإذا سجلت الأرقام كل أسبوع، فالفرق بين أسبوعين هو معدل النمو، ومنه تعرف متى سيصل القرص إلى الحد قبل أن يصل. والطريقة الآلية لهذا الحساب هي الدالة predict_linear التي شرحناها في مقال Prometheus مع لوحات Grafana، ولكن حتى لو كانت لديك هذه الدالة، فالنظر الأسبوعي يجيب عن سؤال لا تجيب عنه: من الذي يكبر؟ هل هي قاعدة البيانات لأن المبيعات زادت، وهذا جيد، أم النسخ الاحتياطية لأن أحداً لم يضبط الاحتفاظ Retention، أم سجلات Container واحد أصابه خلل فأصبح يكتب نفس الخطأ ألف مرة في الثانية؟
ولذلك يطبع السكربت حجم سجل كل Container، وهو في التشغيل الأول صفر للسيرفر، لأن خدمة SSH تكتب في ملف داخله وليس في المخرج القياسي، ونحو 4 كيلوبايت لقاعدة البيانات، ونحو 40 كيلوبايت لل Web. وهذه أرقام صغيرة الآن، ولكن سجلات Docker في إعدادها الافتراضي ليس لها حد، كما سنرى في تجربة «ماذا لو» لاحقاً. ولاحظ أن docker logs | wc -c يقيس النص الذي يعيده Docker، وليس حجم الملف على القرص، لأن الملف بصيغة JSON يحمل مع كل سطر الوقت واسم المصدر، فحجمه أكبر من النص. ولكن المقارنة بين أسبوع وأسبوع تبقى صحيحة. وإذا كنت تريد أن تعرف أين يذهب القرص على مستوى نظام الملفات نفسه، فالأوامر df وdu والفرق بينهما في مقال الأقراص وأنظمة الملفات، وعلى سيرفر Docker حقيقي أضف إليها docker system df لترى حجم ال Images وال Volumes وما يمكن تحريره منها.
الخطوة الثالثة: النسخ الاحتياطي Backups
هنا وجد السكربت مشكلتين، وكلتاهما من النوع الذي لا يظهر لمن ينظر في مجلد النسخ فقط. فالمجلد فيه سبعة ملفات بنفس الحجم 272 كيلوبايت، وكلها تبدو سليمة، ومن يفتح المجلد سيقول إن النسخ تعمل. ولكن السطر الأول يقول إن أحدث نسخة عمرها 30 ساعة، والحد 26 ساعة، أي أن نسخة الليلة الماضية لم تحدث. وفي المختبر نعرف السبب لأننا لم نصنعها، أما على سيرفر حقيقي فالأسباب كثيرة: مهمة Cron عطلها تحديث، أو كلمة مرور تغيرت، أو القرص امتلأ في منتصف الليل ثم تحرر في الصباح. والحد 26 ساعة وليس 24، لأن النسخة تبدأ في الثانية فجراً وقد تتأخر قليلاً، ولا نريد سطر ACT كل أسبوع بسبب دقائق.
والمشكلة الثانية أخطر: الاستعادة في ال Container المؤقت انتهت برمز خروج 1، والرسالة تقول:
pg_restore: error: could not execute query: ERROR:  role "intern_ro" does not exist
Command was: GRANT SELECT ON TABLE public.orders TO intern_ro;
pg_restore: warning: errors ignored on restore: 1
ثم السطر الذي بعده يقول إن عدد الطلبات في النسخة المستعادة 50000 وأكبر رقم 50000، مثل الإنتاج تماماً. فهل الاستعادة ناجحة أم فاشلة؟ الإجابة أن البيانات رجعت كاملة، ولكن الصلاحيات لم ترجع، لأن pg_dump ينسخ قاعدة بيانات واحدة، والأدوار Roles في PostgreSQL تعيش على مستوى الخادم كله وليس داخل القاعدة، فلا يحفظها pg_dump أبداً. وهذه المرة كان الدور المفقود دور المتدرب، ولكن لو كان الدور المفقود shop_app الذي يتصل به التطبيق، فالاستعادة في يوم الكارثة ستعطيك قاعدة كاملة لا يستطيع التطبيق أن يتصل بها. وقد شرحنا هذه المشكلة بالتفصيل في مقال نسخ قواعد البيانات بشكل متسق، والحل أن تحفظ بجانب كل نسخة ملف الأدوار من الأمر pg_dumpall مع الخيار --roles-only.
والصورة التالية تبين لماذا نسمي هذه الخطوة «سلماً» من خمس درجات، وأين توقف كل تشغيل:
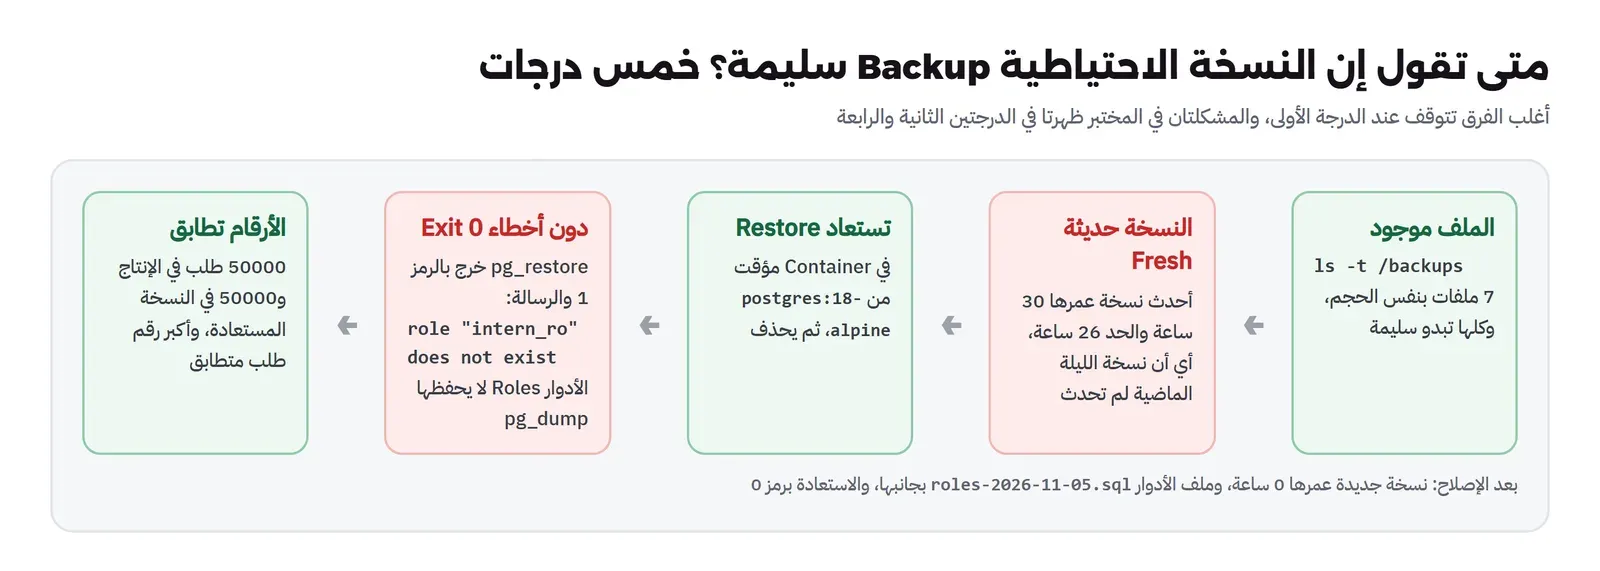
والسؤال الطبيعي هنا: لماذا نستعيد كل أسبوع والاستعادة تأخذ وقتاً؟ والإجابة أنها في المختبر أخذت 6.2 ثانية فقط لقاعدة فيها 50 ألف صف، وعلى قاعدة حقيقية بحجم عدة جيجابايت قد تأخذ دقائق، ولكنها تعمل في Container مؤقت لا يؤثر على الإنتاج، وتستطيع أن تجعلها تعمل في الليل وتقرأ نتيجتها في الصباح. والبديل، أي أن تكتشف أن النسخة لا تستعاد في يوم تحتاجها، هو بالضبط ما حدث لفريق GitLab في القصة أعلاه.
الخطوة الرابعة: الشهادات Certificates
السطر يقول إن شهادة shop.lab تنتهي في 17 نوفمبر، أي بعد 11 يوماً، والحد 21 يوماً. والفحص هنا من الخارج، أي أن السكربت يتصل بالموقع عبر openssl s_client كما يتصل المتصفح، ويقرأ تاريخ الانتهاء من الشهادة التي يقدمها الخادم فعلاً، وليس من ملف على القرص. وهذا الفرق مهم جداً: فقد يكون التجديد التلقائي نجح وكتب شهادة جديدة على القرص، ولكن Nginx لم يعد تحميل إعداده Reload، فما زال يقدم الشهادة القديمة للزوار. والفحص من الخارج يرى ما يراه المستخدم.
ولماذا 21 يوماً؟ لأن أغلب أدوات التجديد التلقائي، مثل Certbot وCaddy، تجدد شهادة Let's Encrypt قبل نحو 30 يوماً من نهايتها عندما تكون مدتها 90 يوماً، فإذا رأيت شهادة بقي عليها أقل من 21 يوماً فهذا يعني أن التجديد التلقائي حاول وفشل لأيام. وهذا الرقم سيتغير قريباً، فقد أعلنت Let's Encrypt في خطة تقليل مدة الشهادات أنها ستصدر شهادات بمدة 64 يوماً افتراضياً بدءاً من 10 فبراير 2027، ثم 45 يوماً بدءاً من 16 فبراير 2028. ومع شهادة مدتها 45 يوماً يصبح الحد 21 يوماً قريباً من نصف عمرها، وقد تحتاج أن تخفضه أو أن تجعل الفحص يحسب النسبة الباقية من عمر الشهادة بدلاً من عدد الأيام.
وهناك سبب آخر يجعل هذه الخطوة أهم من قبل: كانت Let's Encrypt ترسل بريداً قبل انتهاء الشهادة، وكثير من الفرق كانت تعتمد عليه دون أن تعرف، ولكنها أعلنت إيقاف هذه الرسائل بدءاً من 4 يونيو 2025، ونصحت بأن تستخدم خدمة مراقبة. أي أن «البريد سيخبرنا» لم يعد خطة. والطريقة الآلية لهذا الفحص هي Blackbox Exporter مع قاعدة تنبيه، كما في مقال فحص التوفر، والفحص الأسبوعي يبقى ليتأكد أن قائمة الشهادات المراقبة تشمل كل النطاقات، بما فيها النطاق الفرعي الذي أضافه أحدهم الشهر الماضي.
الخطوة الخامسة: السجلات Logs
السجلات في الفحص الأسبوعي ليست للبحث عن مشكلة معينة، وإنما لقراءة أربعة أرقام ومقارنتها بالأسبوع الماضي. ففي التشغيل الأول وجد السكربت 40 طلباً برمز 502 في سجل Nginx، و40 سطر [error] في سجل الأخطاء، وثلاث محاولات دخول فاشلة إلى قاعدة البيانات، وأربعة أسماء مستخدمين غير موجودة في محاولات SSH. والسؤال لكل رقم ليس «هل هو كبير؟»، وإنما «هل تغير، ولماذا؟».
فالطلبات برمز 502 كلها على المسار /api/، وسجل الأخطاء يقول السبب بوضوح:
[error] 24#24: *631 wr-dp-api could not be resolved (3: Host not found), client: 172.20.0.2, server: shop.lab, request: "GET /api/orders HTTP/1.1", host: "wr-dp-web"أي أن هناك من ما زال يطلب ال API القديم على هذا السيرفر، وهو غالباً نسخة قديمة من تطبيق الجوال أو سكربت عند أحد العملاء، والإعداد ما زال يقبل الطلب ثم يفشل. وهذا النوع من البقايا Leftovers لا يطلق تنبيهاً عادة، لأن نسبة الأخطاء من كل الطلبات صغيرة، ولكنه يقول لك شيئين: أن هناك مستخدماً لا يعرف أن العنوان تغير، وأن في الإعداد مساراً لا يملكه أحد. والقرار هنا يحتاج إنساناً: هل نحذف المسار فيرجع 404 واضحاً، أم نحوله Redirect إلى السيرفر الجديد لفترة؟
ومحاولات الدخول الفاشلة إلى قاعدة البيانات الثلاث كانت باسم intern_ro، أي أن هناك عميلاً ما زال يحاول الاتصال بحساب المتدرب بكلمة مرور قديمة، وهذا يربط هذه الخطوة بالخطوة السادسة. أما محاولات SSH بأسماء مثل admin وoracle وtest فهي ما يراه كل سيرفر مفتوح على الإنترنت يومياً من الماسحات الآلية، والرقم المهم فيها ليس العدد، وإنما أن تكون كلها باسم غير موجود أو مرفوضة بالمفتاح. فإذا رأيت محاولات فاشلة باسم حساب حقيقي مثل ops، فهذا مختلف ويستحق أن تنظر فيه. والقراءة الأعمق للسجلات، وكيف تكتب سجلاً يساعدك فعلاً، في مقال السجلات التي تساعدك فعلاً، وجمعها من كل السيرفرات في مكان واحد في مقال Grafana Loki.
الخطوة السادسة: المستخدمون والوصول Access
هذه الخطوة هي التي لا يستطيع أي نظام مراقبة أن يقوم بها نيابة عنك، لأن الخطأ فيها ليس في السيرفر وإنما في الفرق بين السيرفر والواقع. فالسيرفر يقول إن هناك أربعة حسابات لها صدفة Shell يمكن الدخول بها، هي root وops وdeploy وintern، وإن مجموعة sudo فيها ops وintern، وإن هناك أربعة مفاتيح. والواقع أن المتدرب غادر قبل أسابيع. والصورة التالية تبين أين بقي وصوله:
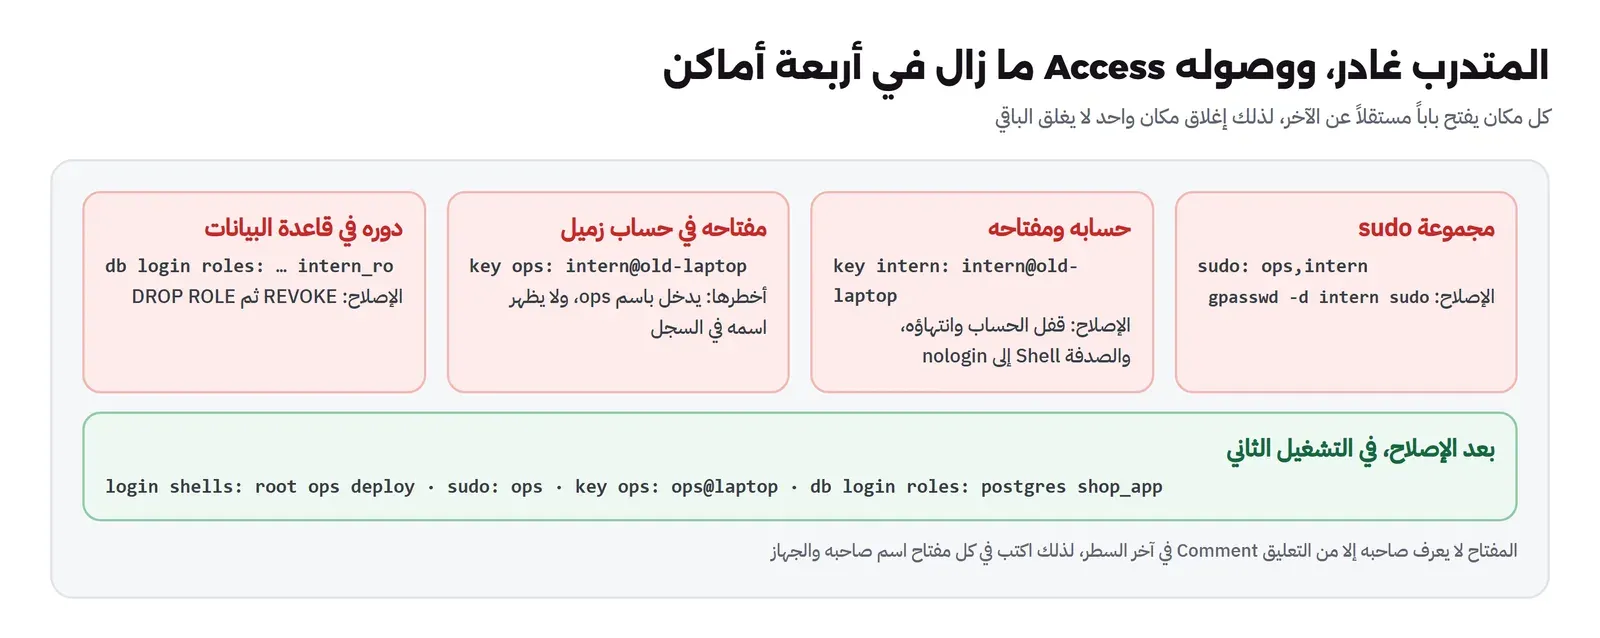
وأخطر الأماكن الأربعة هو المفتاح الموجود في حساب ops، والسبب أن صاحبه يستطيع الدخول باسم ops، فيظهر في السجل أن ops هو من دخل، ولا يظهر اسم المتدرب في أي مكان. ولو قام الفريق بحذف حساب intern فقط، وهو ما يفعله أغلب الناس عند مغادرة موظف، لبقي هذا الباب مفتوحاً. والطريقة الوحيدة لاكتشافه هي أن تقرأ كل ملف authorized_keys في كل حساب، وأن يكون لكل مفتاح تعليق يقول لمن هو، ولذلك يطبع السكربت التعليق فقط، فتقرأ القائمة كأسماء أشخاص وأجهزة وليس كنصوص طويلة.
ثم وصلنا إلى سطر لم نتوقعه: sh: 4: lastlog: not found. فقد أردنا أن نعرف متى دخل كل حساب آخر مرة، وهو سؤال مهم في مراجعة الوصول، لأن الحساب الذي لم يدخل منذ ستة أشهر مرشح للإغلاق. والأمر التقليدي لهذا السؤال هو lastlog، ولكنه غير موجود في Debian 13. والسبب كما في ملاحظات إصدار Debian 13 أن الأوامر last وlastb وlastlog حذفت، لأن الملفات التي تقرؤها تخزن وقت الدخول بطريقة لن تعمل بعد عام 2038، والبديل المباشر هو lastlog2 مع الحزمة libpam-lastlog2 التي تسجل الدخول، وwtmpdb بدلاً من last، أو الأمر lslogins من util-linux. وهذه مشكلة ستواجهها في سكربتاتك القديمة عند ترقية أي سيرفر من Debian 12: السكربت لا يفشل بصوت عال، وإنما يطبع سطر خطأ في وسط المخرج، وإذا لم يقرأه أحد فستظن أن الخطوة تعمل.
وآخر سطر في الخطوة يعرض أدوار قاعدة البيانات التي تستطيع الدخول، وفيها intern_ro. وهذا هو المكان الرابع، وهو نفسه الدور الذي أفشل الاستعادة في الخطوة الثالثة، والذي ظهرت محاولات الدخول به في الخطوة الخامسة. ولاحظ كيف ربطت ثلاث خطوات مستقلة نفس القصة من ثلاث جهات، وهذه فائدة أن تمر على كل الخطوات في جلسة واحدة بدلاً من أن تكون كل واحدة في أداة مختلفة يراها شخص مختلف. ومراجعة الصلاحيات الكاملة على مستوى المؤسسة، ومن يوافق على من، موضوع مقال إدارة الهوية والوصول IAM.
الإصلاحات Fixes: من سطر ACT إلى أمر
بعد أن قرأنا النتيجة، كتبنا الإصلاحات في سكربت ثان، كل كتلة فيه تقابل سطر ACT واحداً، ومع كل كتلة توقيتها. والفصل بين سكربت الفحص وسكربت الإصلاح مقصود، فالفحص يجب أن يبقى آمناً للتشغيل في أي وقت، والإصلاح يحتاج قراراً قبله. والسكربت كما يلي:
#!/bin/sh
# The fixes that the first weekly run asked for, one block per ACT line, each timed.
export MSYS_NO_PATHCONV=1
H=wr-dp-host DB=wr-dp-db WEB=wr-dp-web
el() { awk -v a="$1" -v b="$2" 'BEGIN{printf "%.1f", b-a}'; }
t0=$(date +%s.%N); last=$t0
fix() { now=$(date +%s.%N); [ -n "$name" ] && echo "   ($(el $last $now) s)"; last=$now; name=$1; echo "== $1"; }

fix "a. security updates"
docker exec $H sh -c 'DEBIAN_FRONTEND=noninteractive apt-get -y -qq upgrade >/tmp/up.log 2>&1; echo "   apt exit $?";
  grep -E "^(Unpacking|Setting up) " /tmp/up.log | sed "s/^/   /"; [ -f /var/run/reboot-required ] && echo "   reboot required" || echo "   no reboot required"'

fix "b. tonight's dump, plus the roles it needs"
docker exec $DB sh -c 'd=$(date +%F); pg_dump -U postgres -d shop -Fc -f /backups/shop-$d.dump &&
  pg_dumpall -U postgres --roles-only -f /backups/roles-$d.sql && ls -l /backups | tail -2 | sed "s/^/   /"'

fix "c. certificate"
docker run --rm -v "$(pwd -W 2>/dev/null || pwd)/web/tls:/t" alpine:3.24 sh -c 'apk add -q openssl >/dev/null
  openssl req -x509 -newkey ec -pkeyopt ec_paramgen_curve:prime256v1 -nodes -days 90 -subj /CN=shop.lab \
    -addext subjectAltName=DNS:shop.lab,DNS:wr-dp-web -keyout /t/shop.key -out /t/shop.crt 2>/dev/null; chmod 644 /t/*'
docker exec $WEB sh -c 'nginx -t 2>&1 | tail -1 | sed "s/^/   /"; nginx -s reload 2>&1'

fix "d. stale /api/ route"
sed -i '/resolver 127.0.0.11/d; /location \/api\//d' web/default.conf
docker exec $WEB sh -c 'nginx -t 2>&1 | tail -1 | sed "s/^/   /"; nginx -s reload 2>&1'

fix "e. the intern who left"
docker exec $H sh -c 'gpasswd -d intern sudo; usermod -L -e 1 -s /usr/sbin/nologin intern;
  sed -i "/intern@old-laptop/d" /home/ops/.ssh/authorized_keys /home/intern/.ssh/authorized_keys;
  chage -l intern | grep "Account expires" | sed "s/^/   /"'
docker exec $DB psql -U postgres -d shop -c 'revoke all on orders from intern_ro' -c 'drop role intern_ro' 2>&1 | sed 's/^/   /'

fix "f. last-login tool for Debian 13"
docker exec $H sh -c 'apt-get install -y -qq lastlog2 libpam-lastlog2 >/dev/null 2>&1; echo "   install exit $?"; lastlog2 --version'

fix "done"
echo "   total $(el $t0 $last) s"
والمخرج سوف يكون كما يلي:
== a. security updates
   apt exit 0
   Unpacking libapt-pkg7.0:amd64 (3.0.4) over (3.0.3) ...
   Setting up libapt-pkg7.0:amd64 (3.0.4) ...
   Unpacking apt (3.0.4) over (3.0.3) ...
   Setting up apt (3.0.4) ...
   Unpacking tzdata (2026f-0+deb13u1) over (2026c-0+deb13u1) ...
   Setting up tzdata (2026f-0+deb13u1) ...
   no reboot required
   (20.7 s)
== b. tonight's dump, plus the roles it needs
   -rw-r--r--    1 root     root        277163 Nov  4 02:00 shop-2026-11-04.dump
   -rw-r--r--    1 root     root        277163 Nov  5 08:35 shop-2026-11-05.dump
   (1.5 s)
== c. certificate
   nginx: configuration file /etc/nginx/nginx.conf test is successful
2026/11/05 08:35:08 [notice] 29#29: signal process started
   (7.5 s)
== d. stale /api/ route
   nginx: configuration file /etc/nginx/nginx.conf test is successful
2026/11/05 08:35:09 [notice] 46#46: signal process started
   (0.9 s)
== e. the intern who left
Removing user intern from group sudo
   Account expires						: Jan 02, 1970
   REVOKE
   DROP ROLE
   (1.1 s)
== f. last-login tool for Debian 13
   install exit 0
lastlog2 from util-linux 2.41.5
   (24.7 s)
== done
   total 56.4 s
في المخرج أعلاه لاحظ التالي:
- تحديثات الأمان: أخذت 20.7 ثانية، وطبقت الحزم الثلاث، ولم تطلب إعادة تشغيل لأنها لا تمس النواة. وعلى سيرفر حقيقي فيه خدمات تستخدم مكتبة محدثة، مثل OpenSSL، فقد تحتاج إعادة تشغيل الخدمة نفسها حتى لو لم يحتج السيرفر إعادة تشغيل، والأداة
needrestartتقول لك أي الخدمات تستخدم نسخة قديمة من مكتبة في الذاكرة. - نسخة الليلة مع الأدوار: أخذت 1.5 ثانية، وصنعت نسخة جديدة وملف الأدوار
roles-2026-11-05.sqlبجانبها. والإصلاح الحقيقي ليس هذه النسخة اليدوية، وإنما أن تضيفpg_dumpall --roles-onlyإلى المهمة الليلية نفسها، وأن تعرف لماذا لم تعمل الليلة الماضية. - الشهادة: أخذت 7.5 ثانية لأن ال Container الذي يصنعها يثبت
opensslأولاً. ولاحظ الترتيب:nginx -tيفحص الإعداد قبلnginx -s reload، فإذا كان في الإعداد خطأ فلن يحمل Nginx الإعداد الجديد ويستمر بالقديم، بدلاً من أن يتوقف الموقع. وفي الإنتاج هذه الخطوة يقوم بها Certbot أو Caddy، والإصلاح الحقيقي أن تعرف لماذا لم يجدد التجديد التلقائي. - المسار القديم: حذفنا السطرين من الإعداد وأعدنا التحميل في أقل من ثانية، وقررنا أن يرجع 404 بدلاً من 502، لأن ال 404 يقول للعميل القديم بوضوح إن العنوان لم يعد هنا.
- المتدرب: أخرجناه من
sudo، وقفلنا حسابه مع تاريخ انتهاء في الماضي، وغيرنا صدفته إلىnologin، وحذفنا مفتاحه من الحسابين، ثم سحبنا صلاحيته في قاعدة البيانات وحذفنا الدور. ولاحظ أننا لم نحذف الحساب نفسه من النظام، والسبب أن ملفاته ومجلده قد تكون مطلوبة لمراجعة لاحقة، والحساب المقفول لا يستطيع الدخول. والسطرAccount expires: Jan 02, 1970هو نتيجةusermod -e 1، أي يوم واحد بعد بداية تاريخ Unix، وهو تاريخ في الماضي يجعل الحساب منتهياً فوراً. - أداة آخر دخول: ثبتنا
lastlog2وlibpam-lastlog2، وأخذ التثبيت 24.7 ثانية لأنه ينزل الحزم، وهو أطول إصلاح رغم أنه أقلها أهمية، وهذا تذكير بأن وقت الأوامر لا يقول شيئاً عن أهمية البند.
ومجموع وقت الإصلاحات 56.4 ثانية من وقت الأوامر. ولكن قبل كل كتلة كان هناك قرار: هل نطبق التحديث الآن أم ننتظر النافذة؟ هل المتدرب غادر فعلاً أم في إجازة؟ هل نحذف المسار أم نحوله؟ وهذه القرارات هي الوقت الحقيقي للروتين، وسوف نعود إليها في الحساب النهائي.
مشكلة واجهتنا: lastlog2 بلا قاعدة بيانات
بعد التثبيت شغلنا الفحص مرة ثانية، فظهر في الخطوة السادسة سطران جديدان بدلاً من النتيجة:
lastlog2: Couldn't read entries for all users
lastlog2: Cannot open database (/var/lib/lastlog/lastlog2.db): unable to open database file
والسبب أن lastlog2 لا يقرأ تاريخاً قديماً، وإنما يبدأ التسجيل من لحظة تثبيت الوحدة pam_lastlog2 في إعداد PAM، وقاعدة بياناته، وهي ملف SQLite في /var/lib/lastlog/lastlog2.db، لا تنشأ إلا عند أول دخول بعد التثبيت. وتأكدنا أن التثبيت أضاف الوحدة إلى /etc/pam.d/common-session، ثم دخلنا بحساب ops مرة واحدة، فأنشئت القاعدة وظهر السطر:
Username         Port     From                                       Latest
ops                                                                  Thu Nov  5 08:37:05 +0000 2026
والدرس هنا يتجاوز هذه الأداة: أي أداة تسجيل تثبتها اليوم لن تعرف شيئاً عما حدث قبل اليوم. فإذا كنت ستحتاج سؤال «من دخل في الأشهر الثلاثة الماضية؟» فعليك أن تثبت الأداة قبل ثلاثة أشهر من السؤال، وليس يوم تحتاجه. ولذلك عدلنا السكربت ليفحص وجود الملف قبل أن يشغل الأمر، ويطبع سطر ACT واضحاً إذا لم يجده، بدلاً من رسالة الخطأ الخام. وكذلك عدلنا الخطوة الثالثة لكي تستعيد ملف الأدوار قبل النسخة، وكانت أول محاولة لهذا التعديل خاطئة: فحصنا وجود البيانات بالشرط [ -s /dev/stdin ]، وهو لا يعمل مع أنبوب Pipe لأن حجمه صفر دائماً، فحفظنا المدخل في ملف مؤقت أولاً ثم فحصناه.
التشغيل الثاني Second Run
بعد الإصلاحات وتعديل السكربت شغلناه مرة ثانية، والمخرج كما يلي:
== 1. updates
   host packages: 0 upgradable, 0 from security
   OK no reboot pending
   OK wr-dp-db postgres:18-alpine is current
   OK wr-dp-web nginx:1.31.6-alpine is current
   (22.1 s)
== 2. disk
   host /: 15% used, 816G free
   66.8M	/var/lib/postgresql
   2.1M	/backups
   log of wr-dp-host: 0 bytes
   log of wr-dp-db: 4829 bytes
   log of wr-dp-web: 46208 bytes
   (2.7 s)
== 3. backups
   newest: /backups/shop-2026-11-05.dump, 0 h old, 272.0K
   OK newest dump is fresh
   roles restored
   pg_restore exit 0
   orders prod: 50000|50000  restored: 50000|50000
   (21.2 s)
== 4. certificates
   OK shop.lab: 89 days left
   (1.2 s)
== 5. logs (last 7 days)
   web 5xx: 40
   web errors: 40
   db failed logins: 3
   ssh invalid users: 4
   (1.7 s)
== 6. users and access
   login shells: root ops deploy
   sudo: ops
   key deploy: ci@gitea-runner
   key ops: ops@laptop
   last login ops: Thu Nov 5 08:37:05
   db login roles: postgres shop_app
   (1.2 s)
== done
   total 50.2 s
كل السطور التي كانت ACT أصبحت OK، ما عدا أرقام السجلات التي بقيت كما هي: 40 طلباً برمز 502، وثلاث محاولات فاشلة، وأربعة أسماء غير موجودة. وهذا صحيح وليس خطأ، لأن الخطوة تقرأ آخر سبعة أيام، والأحداث حدثت خلالها فعلاً، والإصلاح يمنع تكرارها ولا يمحو تاريخها. ولذلك الرقم الذي يهمك في الأسبوع القادم هو الفرق: فإذا رأيت 502 جديدة بعد حذف المسار فهذا يعني أن هناك مساراً آخر، وإذا رأيت محاولات جديدة باسم intern_ro فهناك عميل يجب أن تبحث عنه وتعرف من يملكه.
ولاحظ كذلك أن خطوة النسخ الاحتياطي أخذت 21.2 ثانية في التشغيل الثاني مقابل 6.2 ثانية في الأول، على نفس الجهاز ونفس حجم البيانات. فالخطوة أصبحت تستعيد ملف الأدوار قبل النسخة، ولكن هذا لا يفسر الفرق كله، والجزء الأكبر من وقتها هو انتظار ال Container المؤقت حتى ينشئ قاعدته الأولى ويصبح جاهزاً، وهذا الانتظار يتغير بحسب انشغال الجهاز وقت التشغيل. والدرس العملي أن تقيس الخطوة عدة أسابيع قبل أن تضع لها حداً زمنياً، وألا تستنتج من تشغيل واحد.
ماذا لو لم تضع حداً لسجلات Docker؟ What If
في الخطوة الثانية رأينا أن سجل ال Web حجمه نحو 40 كيلوبايت بعد 340 طلباً، وهذا رقم صغير. ولكن ماذا يحدث لسيرفر لا يمر عليه أحد شهوراً، وفيه Container يكتب كثيراً؟ يقول توثيق Docker عن إعداد السجلات إن المشغل الافتراضي للسجلات هو json-file، وإنه بشكل افتراضي لا يقوم بأي تدوير Rotation للسجلات، ويقول توثيق المشغل json-file إن القيمة الافتراضية للخيار max-size هي -1، أي دون حد. وتأكدنا من ذلك على ال Web في المختبر:
docker info --format '{{.LoggingDriver}}'
docker inspect wr-dp-web --format '{{json .HostConfig.LogConfig}}'
json-file
{"Type":"json-file","Config":{}}والآن لنجرب. شغلنا اثنين من ال Containers يكتب كل واحد منهما نفس 50 ألف سطر، كل سطر يشبه سطراً في سجل وصول، والأول بالإعداد الافتراضي، والثاني مع خيارين: max-size=1m أي أن الملف لا يتجاوز ميجابايت واحداً، وmax-file=2 أي أن Docker يحتفظ بملفين فقط ويحذف الأقدم:
S='i=0; while [ $i -lt 50000 ]; do echo "$(date +%T) GET /product/$i 200 0.012 Mozilla/5.0 (X11; Linux x86_64) padding-padding-padding"; i=$((i+1)); done'
docker run --name wr-dp-noisy-a alpine:3.24 sh -c "$S" >/dev/null
docker run --name wr-dp-noisy-b --log-opt max-size=1m --log-opt max-file=2 alpine:3.24 sh -c "$S" >/dev/null
for c in wr-dp-noisy-a wr-dp-noisy-b; do
  echo "$c: $(docker logs $c 2>&1 | wc -c) bytes, $(docker logs $c 2>&1 | wc -l) lines, first: $(docker logs $c 2>&1 | head -1 | cut -c1-30)"
done
wr-dp-noisy-a: 4688890 bytes, 50000 lines, first: 08:38:46 GET /product/0 200 0.
wr-dp-noisy-b: 678492 bytes, 7218 lines, first: 08:41:10 GET /product/42782 20
{"Type":"json-file","Config":{"max-file":"2","max-size":"1m"}}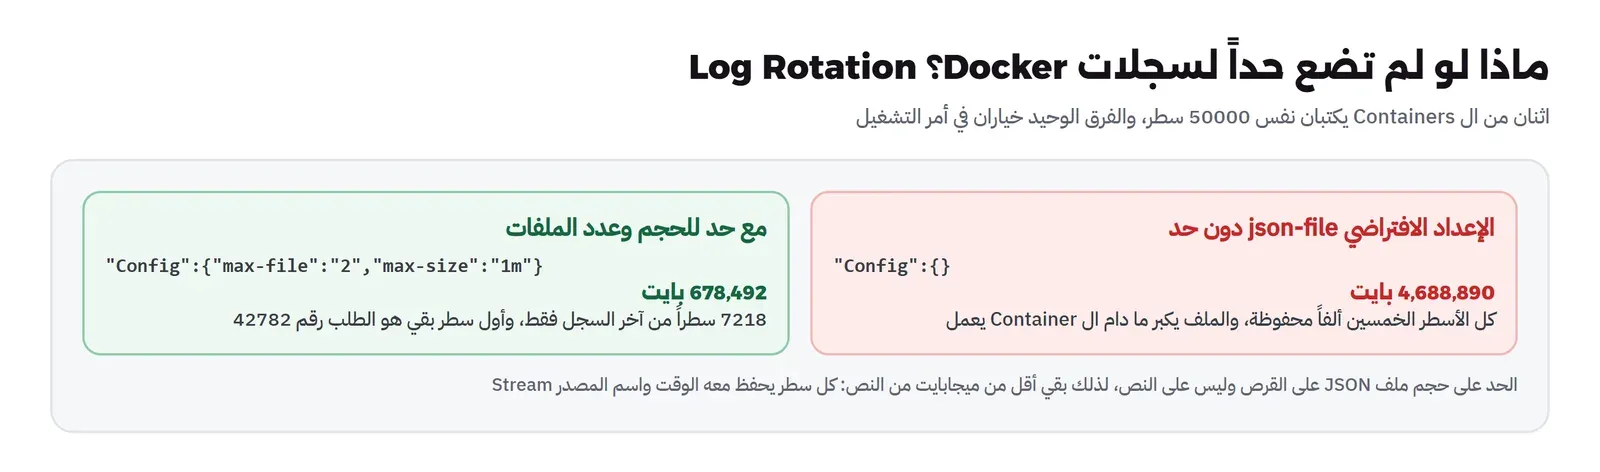
في المخرج أعلاه لاحظ التالي:
- ال Container الأول احتفظ بكل الأسطر الخمسين ألفاً، أي نحو 4.7 ميجابايت من النص، وهذا الرقم سيستمر في الزيادة ما دام ال Container يعمل، ولن يتوقف إلا عند حذف ال Container أو امتلاء القرص.
- ال Container الثاني احتفظ بآخر 7218 سطراً فقط، وأول سطر بقي هو الطلب رقم 42782، أي أن كل ما قبله حذف تلقائياً. وهذا ما تريده لسجلات ال Containers على السيرفر، لأن السجلات المهمة يجب أن تذهب إلى نظام سجلات مركزي، وليس أن تبقى في ملف على نفس القرص.
- النص الباقي أقل من ميجابايت رغم أن الحد ميجابايتان، والسبب أن الحد على حجم ملف JSON على القرص وليس على النص، وكل سطر في الملف يحفظ معه الوقت بدقة النانوثانية واسم المصدر
stdout، فالملف أكبر من النص بشكل واضح، والملف الحالي قد لا يكون ممتلئاً لحظة القراءة.
والآن لنحسب ما يعنيه هذا على سيرفر المتجر الحقيقي. ففي المختبر كتب Nginx نحو 46 ألف بايت من السجل لنحو 340 طلباً، أي أكثر من 130 بايتاً لكل طلب تقريباً بين سجل الوصول وسجل الأخطاء. فإذا كان المتجر يستقبل مليون طلب في اليوم، وهو رقم ليس كبيراً لمتجر فيه صور ومنتجات كثيرة لأن كل صورة طلب مستقل، فهذا أكثر من 130 ميجابايت من النص يومياً، وأكثر من ذلك على القرص بصيغة JSON، أي عدة جيجابايت في الشهر من Container واحد. ومع قرص صغير على سيرفر افتراضي فهذا هو العطل الذي يحدث بعد ستة أشهر من التشغيل «دون مشاكل».
والإصلاح ليس في الفحص الأسبوعي، وإنما في الإعداد: ضع الحد في ملف daemon.json لكل ال Containers، أو استخدم المشغل local الذي ينصح به التوثيق نفسه لمنع امتلاء القرص، لأنه يقوم بالتدوير افتراضياً ويخزن السجلات بصيغة أصغر. ولاحظ أن التوثيق يقول إن التغيير في daemon.json يطبق فقط على ال Containers التي تنشأ بعد إعادة تشغيل خدمة Docker، أما الموجودة فتحتفظ بإعدادها حتى تعيد إنشاءها. ولذلك أضفنا إلى قائمة الفحص الأسبوعي سؤالاً واحداً: هل هناك Container إعداد سجله "Config":{}؟
إذن كم يحتاج السيرفر من وقتك؟ Time Budget
الآن نستطيع أن نجيب عن سؤال المقال بالأرقام التي قسناها، والصورة التالية تجمعها:
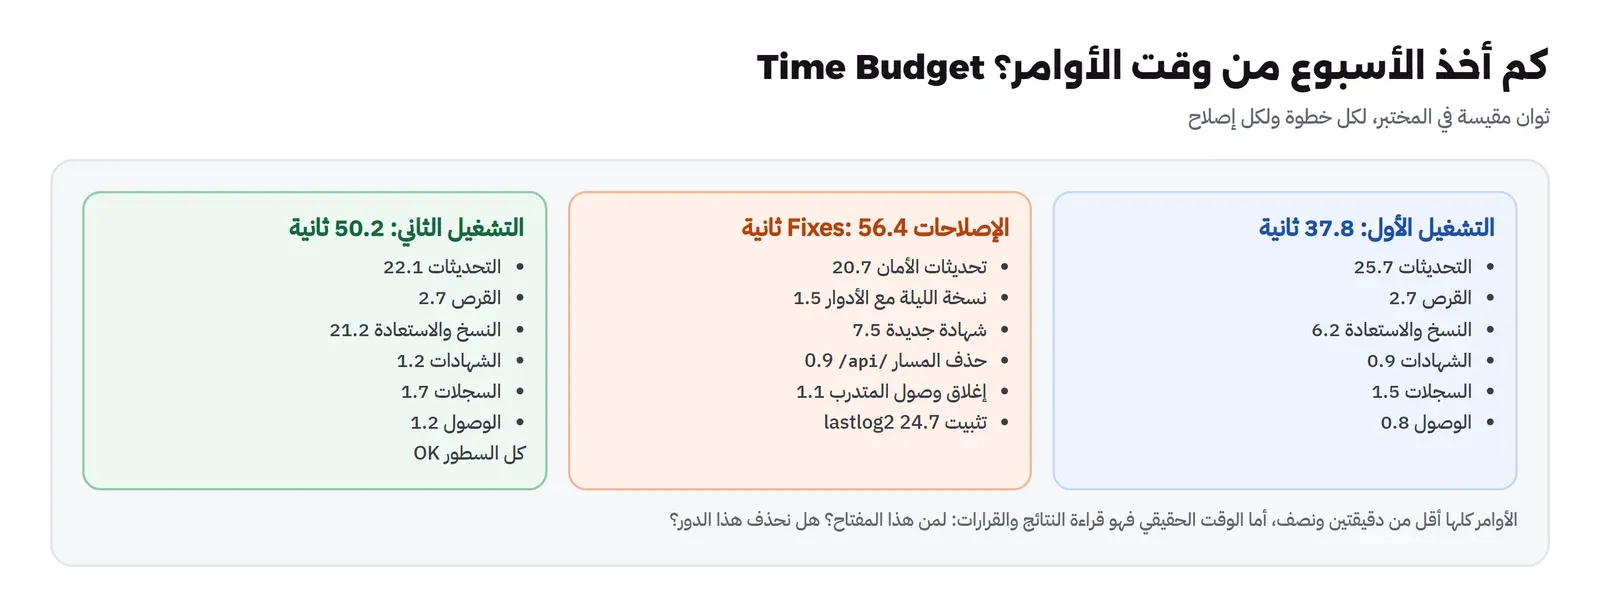
فالأوامر كلها، أي الفحص مرتين والإصلاحات، أخذت 144.4 ثانية، أي أقل من دقيقتين ونصف. وهذا الرقم يقول شيئاً واحداً مهماً: الآلة ليست هي المشكلة، ولا يوجد سبب تقني لتأجيل الروتين. أما الوقت الحقيقي فهو في ثلاثة أشياء لا يقيسها السكربت، ولا نستطيع أن نعطيك رقماً لها من المختبر لأنها تعتمد على فريقك:
- القراءة Reading: أن تقرأ ثلاثين سطراً وتفهم كل سطر ACT، وتقارنه بالأسبوع الماضي. وهذا سريع إذا كان المخرج قصيراً وثابت الشكل، وبطيء جداً إذا كان المخرج صفحات من الأوامر الخام.
- القرار Decision: أن تعرف من صاحب المفتاح، وهل المسار ما زال مستخدماً، وهل يجوز تطبيق التحديث الآن. وهذا يحتاج أحياناً رسالة إلى زميل وانتظار رده، وهو الجزء الذي يجعل الروتين يمتد من دقائق إلى أيام إذا لم يكن له صاحب.
- الإصلاح الحقيقي Root Fix: أن تعرف لماذا لم تعمل النسخة الليلية، ولماذا لم يجدد التجديد التلقائي، وتصلح السبب وليس العرض. وهذا قد يكون خمس دقائق وقد يكون مهمة لنصف يوم، ومكانه تذكرة في نظام المهام وليس جلسة الفحص نفسها.
ولذلك النصيحة التي نعطيها لفريق المتجر وأمثاله: خصص للروتين وقتاً ثابتاً قصيراً في نفس اليوم كل أسبوع، يكفي للفحص والقراءة والإصلاحات السريعة، وكل ما يحتاج أكثر من ذلك يتحول إلى تذكرة لها صاحب وموعد. وإذا وجدت أن الوقت لا يكفي أسبوعاً بعد أسبوع، فهذا ليس دليلاً على أن الروتين طويل، وإنما على أن هناك سطور ACT تتكرر ولم ينقلها أحد إلى الأتمتة. والوقت يكبر مع عدد السيرفرات، ولكن ليس بنفس النسبة، فالسكربت نفسه يعمل على عشرة سيرفرات عبر Ansible كما في مقال Ansible للمبتدئين، والقراءة تصبح أسرع عندما يكون المخرج جدولاً بسطر لكل سيرفر.
من الروتين إلى التنبيه Routine to Alerts
الروتين الجيد يقصر مع الوقت، لأن كل بند يتكرر بنفس الإصلاح ينتقل إلى مكان آخر. وبعد أسابيع قليلة من التشغيل في المتجر، هذا ما نقترح أن ينتقل من سكربت الأسبوع إلى الأتمتة والتنبيهات:
| البند في الروتين | إلى أين ينتقل | ما يبقى للأسبوع |
|---|---|---|
| عمر أحدث نسخة احتياطية | مفتاح الرجل الميت Dead Man's Switch يطلق تنبيهاً إذا لم تصل إشارة النسخة الليلية | الاستعادة في Container مؤقت ومطابقة الأرقام |
| أيام الشهادة الباقية | Blackbox Exporter مع قاعدة تنبيه قبل 14 يوماً | التأكد أن كل النطاقات في قائمة الفحص |
| تحديثات الأمان | unattended-upgrades لحزم الأمان فقط | ملف reboot-required والخدمات التي تحتاج إعادة تشغيل |
| امتلاء القرص | predict_linear في Prometheus | من الذي يكبر، ولماذا |
| حدود سجلات Docker | daemon.json مع المشغل local | Containers أنشئت قبل التغيير |
| المفاتيح والحسابات | لا ينتقل، يحتاج إنساناً | القائمة كاملة مقابل قائمة الفريق اليوم |
ولاحظ أن العمود الأخير لا يصبح فارغاً أبداً. فحتى بعد أن تنتقل كل الفحوص الآلية إلى التنبيهات، يبقى للإنسان سؤال «هل ما يراه النظام يطابق الواقع؟»، وهذا ما لا يستطيع أي تنبيه أن يسأله. ومفتاح الرجل الميت وطريقة بنائه مشروحة في مقال فحص التوفر، والتحديث التلقائي ومتى تحذر منه في مقال Patch Management.
من يملك الروتين؟ Ownership مع سجل الصيانة
أكثر ما يقتل الروتين الأسبوعي ليس صعوبته، وإنما أنه مسؤولية «الجميع»، أي لا أحد. ففي الأسبوع الأول يقوم به الشخص الذي اقترحه، وفي الأسبوع الثالث يكون مشغولاً بإطلاق ميزة، وفي الأسبوع السادس لا يتذكره أحد. والحل الذي يعمل مع الفرق الصغيرة هو التناوب Rotation: اسم واحد مكتوب لكل أسبوع، ويفضل أن يكون نفس جدول المناوبة On-call، لأن من سيستيقظ ليلاً هذا الأسبوع له مصلحة مباشرة في أن يكون السيرفر نظيفاً. وفي مقال ضغط المناوبة تجد كيف تحمي هذا الشخص من أن يصبح الروتين عبئاً إضافياً عليه دون وقت مخصص.
والشيء الثاني هو السجل Maintenance Log: احفظ مخرج كل تشغيل في مكان واحد، مثل ملف في مستودع Git باسم التاريخ، أو تعليق في تذكرة أسبوعية ثابتة. والفائدة ليست الأرشيف، وإنما المقارنة: فالرقم 40 في سجل 502 لا يعني شيئاً وحده، ويعني الكثير إذا كان الأسبوع الماضي صفراً. وحجم قاعدة البيانات 66.8 ميجابايت لا يعني شيئاً، ويعني الكثير إذا كان قبل شهر 30. والسجل كذلك هو دليلك عند أي مراجعة امتثال أو تدقيق، لأنه يثبت أن الصيانة حدثت فعلاً في تاريخ معين ومن قام بها، وليس فقط أن هناك سياسة مكتوبة تقول إنها يجب أن تحدث.
والشيء الثالث أن يكون لكل سطر ACT نهاية واضحة: إما أن يصلح في نفس الجلسة، أو يتحول إلى تذكرة لها صاحب، أو يقرر الفريق أن يقبله ويعدل السكربت ليقول OK. فالسطر ACT الذي يظهر كل أسبوع ولا يفعل أحد شيئاً هو أسوأ من عدم الفحص، لأنه يعلم الفريق أن يتجاهل ACT، وعندها سيتجاهل كذلك السطر الجديد الذي يهم.
أخطاء شائعة Common Mistakes
- الاكتفاء بوجود ملف النسخة: الملفات السبعة في المختبر كانت كلها موجودة وبنفس الحجم، وأحدثها عمره 30 ساعة، والاستعادة منه تفشل في الصلاحيات.
- فحص الشهادة من الملف وليس من الخادم: التجديد قد ينجح على القرص ويبقى الخادم يقدم القديمة حتى يعاد التحميل.
- حذف حساب الموظف فقط: مفتاحه في حساب زميل، ودوره في قاعدة البيانات، وكلمات مرور الخدمات التي كان يعرفها، كلها تبقى.
- مفاتيح دون تعليق: قائمة
authorized_keysبلا أسماء لا يستطيع أحد أن يراجعها. - سكربت يخفي أخطاءه: سطر
lastlog: not foundفي وسط المخرج يمر دون أن يقرأه أحد، والسكربت الجيد يحول كل خطأ إلى سطر ACT واضح. - الاعتماد على بريد التنبيه من جهة خارجية: بريد انتهاء الشهادات توقف، وبريد المهام المجدولة قد يرفض، كما في حادثة GitLab.
- سجلات Docker دون حد: الإعداد الافتراضي لا يدور السجلات، والقرص يمتلئ بعد شهور.
- الإصلاح في نفس سكربت الفحص: فيصبح الفحص خطيراً، ويتوقف الناس عن تشغيله.
- روتين بلا صاحب ولا سجل: يتوقف بعد أسابيع، ولا أحد يعرف متى كان آخر تشغيل.
- سطور ACT تتكرر دون قرار: تعلم الفريق أن يتجاهل الفحص كله.
قائمة تحقق Checklist للأسبوع
| البند | كيف تتحقق منه | متى يكون ACT |
|---|---|---|
| حزم الأمان المعلقة | apt list --upgradable مع -security | أي حزمة أمنية |
| إعادة تشغيل معلقة | الملف /var/run/reboot-required | الملف موجود |
| بصمة ال Images | docker buildx imagetools inspect | البصمة تغيرت أو أداة التحديث متوقفة |
| القرص ومن يكبر | df وdu وحجم سجل كل Container | نمو غير متوقع مقارنة بالأسبوع الماضي |
| إعداد سجلات Docker | docker inspect على LogConfig | "Config":{} مع المشغل json-file |
| حداثة النسخة | عمر أحدث ملف بالساعات | أكثر من 26 ساعة لنسخة ليلية |
| الاستعادة | Container مؤقت، رمز الخروج، مطابقة الأرقام | رمز غير صفر أو أرقام مختلفة |
| الأدوار بجانب النسخة | ملف pg_dumpall --roles-only | الملف غير موجود |
| الشهادات | openssl s_client من الخارج | أقل من 21 يوماً |
| أخطاء الخادم | عدد 5xx في سبعة أيام | رقم جديد أو مسار لا يملكه أحد |
| محاولات الدخول | SSH وقاعدة البيانات | محاولات باسم حساب حقيقي |
| الحسابات والمفاتيح | الصدفة، sudo، تعليقات المفاتيح، آخر دخول | اسم ليس في قائمة الفريق اليوم |
| أدوار قاعدة البيانات | pg_roles مع rolcanlogin | دور لا يعرف أحد صاحبه |
| السجل والصاحب | مخرج التشغيل محفوظ باسم التاريخ | أسبوع بلا سجل |
تدريب عملي Practice
- شغل سكربت المختبر على سيرفر تجريبي عندك، وأضف إليه خطوة سابعة تفحص كل Container إعداد سجله دون حد، وتطبع سطر ACT باسمه.
- اجعل السكربت يحفظ مخرجه في ملف باسم التاريخ، ثم يطبع في آخره الفرق بين أرقام السجلات هذا الأسبوع والأسبوع الماضي.
- اكتب قائمة الفريق الحالية في ملف نصي، واجعل الخطوة السادسة تقارن تعليقات المفاتيح وأسماء الحسابات بهذه القائمة، وتطبع ACT لكل اسم غير موجود فيها.
حذف المختبر Cleanup
docker compose -f lab/compose.yaml down -v
docker rm -f wr-dp-noisy-a wr-dp-noisy-b wr-dp-restore 2>/dev/null
docker rmi wr-dp-host:lab
rm -f lab/web/tls/shop.key lab/web/tls/shop.crt
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- المراقبة تسأل «هل يعمل الآن؟»، والروتين الأسبوعي يسأل «هل سيبقى يعمل الشهر القادم؟»، وأغلب ما يكشفه الروتين لا يطلق تنبيهاً أبداً، مثل مفتاح موظف غادر.
- الخطوات الست بالترتيب: التحديثات، والقرص، والنسخ الاحتياطي مع استعادة حقيقية، والشهادات من الخارج، والسجلات مقارنة بالأسبوع الماضي، والوصول.
- في المختبر وجد التشغيل الأول خمس خطوات من ست تحتاج عملاً في 37.8 ثانية: حزمتان أمنيتان، ونسخة عمرها 30 ساعة، واستعادة تفشل بسبب دور مفقود، وشهادة بقي عليها 11 يوماً، ومسار قديم يرجع 502، ومتدرب غادر ووصوله في أربعة أماكن.
- الأوامر كلها، أي الفحص مرتين والإصلاحات، أخذت 144.4 ثانية، والوقت الحقيقي في القراءة والقرار والإصلاح الجذري، ولذلك يحتاج الروتين صاحباً ووقتاً ثابتاً وسجلاً.
- في Debian 13 لم يعد
lastlogموجوداً، والبديلlastlog2لا يعرف شيئاً قبل تثبيته، فثبت أدوات التسجيل قبل أن تحتاجها. - سجلات Docker دون حد احتفظت بكل الأسطر الخمسين ألفاً، ومع
max-sizeوmax-fileبقي آخرها فقط، والإعداد الافتراضي لا يدور السجلات. - كل سطر ACT يتكرر بنفس الإصلاح ينتقل إلى الأتمتة أو التنبيه، فيقصر الروتين مع الوقت، ويبقى للإنسان سؤال واحد: هل ما يراه النظام يطابق الواقع؟
وفي المقال القادم بإذن الله ننتقل من الصيانة الهادئة إلى أسوأ لحظاتها: كتابة دليل التشغيل لما يحدث عندما يفشل أحد هذه البنود في منتصف الليل.
 دليلدليل التشغيل Runbook: وثق الإجراء قبل أن تحتاجهنكتب دليل تشغيل لقاعدة بيانات امتلأ قرصها، ثم ننفذه بالثواني في يوم تجربة، فنكتشف فيه خطأين لم يظهرا إلا عند التنفيذ.
 دليلالتحديثات الأمنية Patch Management: ماذا تحدث ومتى؟أغلب الاختراقات تستغل ثغرة لها إصلاح منشور لم يطبق. كيف تعرف تحديثاتك المعلقة وترتبها وتطبقها بأمان، مع سكربت فحص حالة حقيقي.
 دليلتحديث ال Containers بأمان: Watchtower أم Diun أم Renovate؟ثلاث طرق لتحديث ال Images على سيرفرك، ووضع كل مشروع اليوم، ولماذا تثبت بالبصمة وكيف تتراجع، مع تجربة سجل فيها Watchtower نجاحاً لتطبيق متوقف وثبت فيها Renovate البناء الخاطئ.
 دليلنسخ قواعد البيانات بشكل متسق: pg_dump أو mysqldumpلماذا ينجح نسخ مجلد قاعدة البيانات أحياناً ثم يعطيك قاعدة تتوقف عند أول استعلام، وكيف تأخذ نسخة متسقة من PostgreSQL وMySQL وتثبت أنها تستعاد قبل أن تحتاجها.
 دليلفحص التوفر Uptime Checks: من يراقب سيرفر المراقبة؟نفحص الموقع والشهادة وRedis من الخارج مع Blackbox Exporter وUptime Kuma، ونكشف النسخ الاحتياطي الذي توقف بصمت، ونتأكد أن أحداً يراقب سيرفر المراقبة نفسه.
 دليلدليل المراقبة Monitoring: ماذا تراقب في سيرفراتك وتطبيقاتك؟خريطة واحدة لكل ما يجب أن يراقبه الفريق على سيرفراته وتطبيقاته، من القرص والشهادات والنسخ الاحتياطي إلى الأحداث الأمنية والثغرات، مع الأداة والتنبيه لكل منطقة.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة المقال وتنفيذ المختبر على Debian 13.7 وPostgreSQL 18.6 من postgres:18-alpine وnginx:1.31.6-alpine وDocker Engine 29.8.0.


