إذا كانت أجهزتك الافتراضية Virtual Machines تعمل اليوم على ثلاثة سيرفرات أو أكثر، وكل أقراصها في مصفوفة تخزين Storage Array واحدة تتصل بها السيرفرات عبر شبكة تخزين SAN، فأنت تعرف هذا المشهد جيداً: عقد دعم المصفوفة يقترب من نهايته، والعرض الجديد من المورد أغلى من السابق، والمصفوفة نفسها نقطة واحدة إذا تعطلت توقفت كل الأجهزة مهما كان عدد السيرفرات فوقها. وفي هذا الوقت بالذات يسمع الفريق كلمة الحوسبة المتقاربة Hyperconverged Infrastructure، واختصاراً HCI، من أكثر من جهة: من يقترح Proxmox VE مع Ceph، ومن يقترح Harvester لأنه «مبني على Kubernetes»، ومن يقترح أن تبقى على المصفوفة لأنها تعمل.
وفكرة HCI بسيطة في جملة واحدة: بدل أن تشتري سيرفرات للمعالجة ومصفوفة للتخزين وشبكة خاصة بينهما، تضع الأقراص داخل نفس السيرفرات التي تشغل الأجهزة، ويجمع برنامج التخزين أقراص كل السيرفرات في مخزن موزع Distributed Storage واحد، يحفظ كل قرص افتراضي في أكثر من سيرفر. ولكن هذه الجملة البسيطة تخفي قرارات كثيرة: كم سيرفراً تحتاج، وكم تخسر من مساحة الأقراص بسبب النسخ Replication، وما الذي يحدث عندما تطفئ سيرفراً للصيانة، ومن في فريقك سوف يفهم طبقة التخزين عندما تتعطل في منتصف الليل.
وسوف نناقش في هذا المقال ما يلي:
- ما معنى الحوسبة المتقاربة HCI، وما الذي تكسبه منها وما الذي تدفعه، بالأرقام.
- Proxmox VE مع Ceph كأشهر طريقة مفتوحة المصدر Open Source لبناء HCI، باختصار وبروابط للأدلة المفصلة.
- Harvester من الداخل: نظام التشغيل، وRKE2، وKubeVirt، وLonghorn، والشبكات Networking، وRancher، ومتطلبات العتاد Hardware كما في التوثيق الرسمي.
- مختبر حقيقي Lab بنفس المكونات التي يقوم عليها Harvester: عنقود k3s مع KubeVirt وCDI، وجهاز افتراضي من قرص DataVolume، ثم ننظر داخل الـ Pod الذي يعمل فيه الجهاز.
- ماذا يحدث لو حذفنا الـ Pod الذي يشغل الجهاز، أو طلبنا ذاكرة أكثر مما تملك العقدة؟
- مقارنة Harvester مع Proxmox VE وCeph، بنقاط القوة ونقاط الضعف، وجدول قرار وأخطاء شائعة وقائمة تحقق.
وهذا المقال من مرحلة السحابة الخاصة مفتوحة المصدر Private Cloud في مسار الحوسبة السحابية وبدائلها. والمواضيع في هذه المرحلة:
- السحابة الخاصة Private Cloud: متى تبنيها وماذا تحتاج قبلها
- OpenStack من الداخل: Nova وNeutron وCinder وKeystone
- سحابة OpenStack صغيرة بيدك: من التثبيت إلى أول جهاز افتراضي
- Apache CloudStack وOpenNebula: بدائل أخف من OpenStack
- Harvester وعنقود Proxmox: الحوسبة المتقاربة HCI (الموضوع الحالي)
- OpenStack أم CloudStack أم OpenNebula أم Proxmox؟ قرار مبني على الفريق والحجم
 دليلالسحابة الخاصة Private Cloud: متى تبنيها وماذا تحتاجمتى تحتاج مؤسستك سحابة خاصة بدل عنقود أجهزة افتراضية، وما الذي تجهزه من فريق وعتاد وعمليات وميزانية قبل أن تبدأ.
 دليلOpenStack من الداخل: Nova وNeutron وCinder وKeystoneماذا تفعل كل خدمة في OpenStack، وكيف يمر طلب إنشاء جهاز افتراضي بين Keystone وNova وPlacement وNeutron وCinder، مع مخرجات حقيقية من سحابة 2026.2.
 دليلسحابة OpenStack صغيرة بيدك: من التثبيت إلى أول جهازبنينا OpenStack 2026.2 بـ DevStack في جهاز افتراضي واحد، ثم أنشأنا مشروعاً وشبكة وجهازاً بعنوان عائم وقرصاً، ومعها المشكلات الحقيقية التي ظهرت وما حدث بعد إعادة التشغيل.
 دليلApache CloudStack وOpenNebula: بدائل أخف من OpenStackكيف يعمل CloudStack وOpenNebula من الداخل، ومختبر حقيقي على OpenNebula 7.4 بحصص وجدولة، ومتى تختار كلاً منهما بدل OpenStack.
 دليلOpenStack أم CloudStack أم OpenNebula أم Proxmox؟قرار السحابة الخاصة مبني على فريقك وحجمك وحاجتك إلى تعدد المستأجرين، مع معايير المقارنة وأسعار الدعم المنشورة وشجرة قرار ومثال لتكلفة سنة.
ما هي الحوسبة المتقاربة HCI؟
لكي تفهم HCI يجب أن تبدأ من البنية التي جاءت لتحل محلها، وهي البنية ذات الطبقات الثلاث Three-tier Architecture. ففي هذه البنية لكل وظيفة عتاد مستقل: سيرفرات للمعالجة Compute فيها معالجات وذاكرة وقرص صغير للنظام فقط، ومصفوفة تخزين فيها كل أقراص البيانات، وشبكة تخزين SAN بينهما، سواءً كانت Fibre Channel أو iSCSI على شبكة Ethernet، وقد شرحنا الفرق بين هذه البروتوكولات في مشاركة التخزين عبر الشبكة SMB وNFS وiSCSI. والميزة الكبيرة لهذه البنية أن كل سيرفر يرى نفس الأقراص، فإذا سقط سيرفر شغلت أجهزته على سيرفر آخر فوراً، لأن أقراصها لم تكن عليه أصلاً.
ولكن لهذه البنية ثمن تعرفه كل جهة تملكها: ثلاثة أنواع من العتاد، ولكل نوع مورد وعقد دعم وخبرة، والمصفوفة نفسها غالية ومغلقة، وتكبر بخطوات كبيرة، فإذا امتلأت اشتريت درجاً Shelf كاملاً من الأقراص حتى لو كنت تحتاج القليل. والأهم أن المصفوفة، مهما كان فيها من وحدات تحكم Controllers مزدوجة، تبقى نظاماً واحداً، وتحديث برنامجها أو عطل فيه يمس كل الأجهزة.
والحوسبة المتقاربة HCI تجمع هذه الطبقات في نوع واحد من السيرفرات، كما تبين الصورة التالية: كل سيرفر فيه معالجات وذاكرة وأقراص بيانات محلية، ويعمل على كل السيرفرات برنامج تخزين موزع يجمع هذه الأقراص في مخزن واحد، ويحفظ كل قرص افتراضي في أكثر من سيرفر، فإذا سقط سيرفر بقيت نسخ البيانات Replicas على غيره، وعمل الجهاز من هناك.
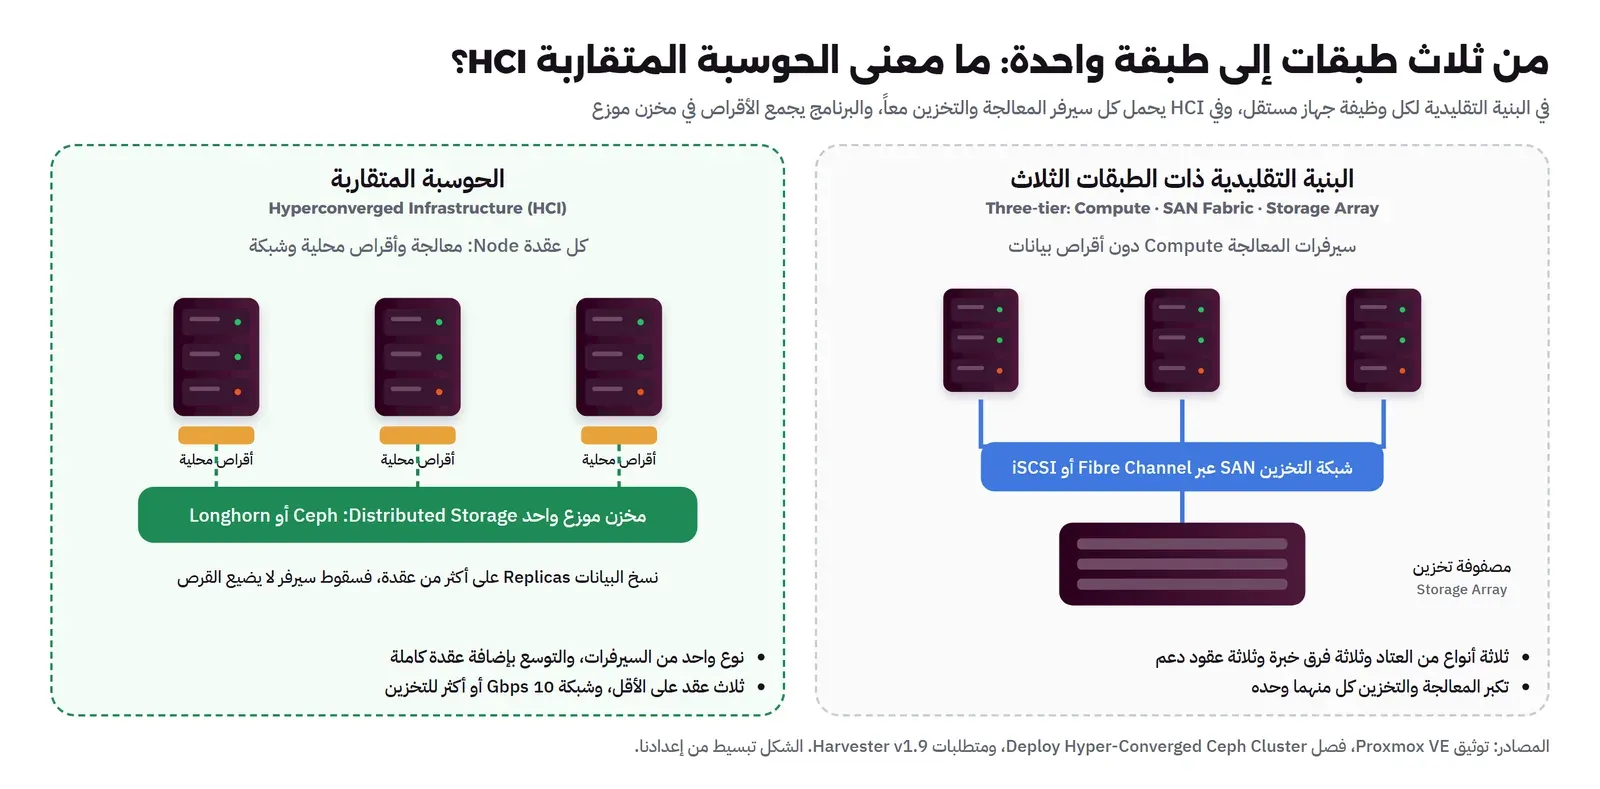
وقد يتساءل البعض: إذا كانت الأقراص في السيرفرات، فما الفرق بين HCI وبين سيرفرات Proxmox عادية كل منها بأقراصه المحلية؟ والإجابة أن القرص المحلي وحده لا يعطيك شيئاً عند سقوط السيرفر، فالجهاز وقرصه محبوسان فيه حتى يعود. أما في HCI فالمخزن الموزع يجعل قرص الجهاز متاحاً من كل العقد، كأنه على مصفوفة، وهذا هو الشرط الذي يحتاجه النقل الحي Live Migration والتوفر العالي High Availability دون أن تنسخ القرص كله في كل مرة. وهناك حل وسط رأيناه في عنقود Proxmox VE من ثلاث عقد، وهو النسخ المتماثل Replication بـ ZFS كل بضع دقائق، ولكنه يعني أنك تخسر ما كتب بعد آخر نسخة إذا سقط السيرفر، أما المخزن الموزع فيكتب في كل النسخ قبل أن يقول للجهاز إن الكتابة تمت.
ماذا تدفع مقابل HCI؟ المساحة والشبكة والصيانة
صفحات التسويق تتحدث عن البساطة، ولكن هناك ثلاثة أثمان يجب أن تحسبها قبل أن تقرر، وكلها تأتي من نفس السبب: البيانات محفوظة عدة مرات على سيرفرات مختلفة.
- المساحة الصافية Usable Capacity: إذا حفظت ثلاث نسخ من كل قرص، وهو الافتراضي في Ceph وفي Longhorn داخل Harvester، فالمساحة الصافية ثلث المساحة الخام Raw Capacity. فثلاثة سيرفرات في كل منها أربعة أقراص NVMe بسعة 3.84 TB تعطيك نحو 46 TB خاماً، وأقل من 15.4 TB صافية، ويجب أن تترك منها هامشاً فارغاً حتى يجد المخزن مكاناً يعيد فيه بناء النسخ إذا سقط قرص.
- الشبكة بين العقد East-West Traffic: كل كتابة من الجهاز تذهب إلى عقدتين أخريين قبل أن تكتمل، وإعادة بناء قرص سقط تنقل التيرابايتات بين السيرفرات. لذلك يوصي توثيق Ceph في Proxmox VE بشبكة 10 Gbps على الأقل، ويقول إن قرص NVMe واحد قد يملأ 10 Gbps وحده، وإن الإعداد عالي الأداء يحتاج 25 Gbps أو أكثر، وثلاث شبكات منفصلة إذا لم تكن متأكداً.
- الصيانة Maintenance: في البنية التقليدية تطفئ سيرفر معالجة دون أن يتأثر التخزين. أما في HCI فإطفاء سيرفر يعني أن ثلث نسخ البيانات غائب، والمخزن يعمل بنسختين حتى يعود السيرفر، فإذا سقط سيرفر آخر في هذا الوقت أصبحت بعض الأقراص بنسخة واحدة. لذلك يحتاج أي تحديث خطة: سيرفر واحد في كل مرة، وانتظار أن يعود المخزن سليماً تماماً قبل السيرفر التالي.
وهناك ثمن رابع لا يظهر في الفاتورة، وهو أن الذاكرة والمعالج في كل سيرفر مقسومة الآن بين الأجهزة الافتراضية وبين برنامج التخزين نفسه. فتوثيق Proxmox يوصي بـ 8 GiB من الذاكرة لكل OSD، أي لكل قرص في Ceph، فالسيرفر الذي فيه أربعة أقراص يخصص 32 GiB للتخزين قبل أن يعمل أول جهاز. وهذا ليس عيباً في HCI، وإنما هو المكان الذي ذهبت إليه المصفوفة، فالمعالجات التي كانت في وحدات تحكمها أصبحت الآن معالجات سيرفراتك.
Proxmox VE مع Ceph: الطريقة المعروفة لبناء HCI مفتوحة
أقدم طريقة مفتوحة المصدر لبناء HCI وأكثرها انتشاراً في الجهات الصغيرة والمتوسطة هي Proxmox VE مع Ceph، فالتوثيق الرسمي فيه فصل كامل اسمه «نشر عنقود Ceph متقارب» Deploy Hyper-Converged Ceph Cluster، والواجهة Web UI نفسها تثبت Ceph وتنشئ الأقراص والـ Pools دون أن تخرج إلى سطر الأوامر. وقد شرحنا هذه الطبقات في أدلة مستقلة، فلن نكررها هنا: العنقود Cluster والنصاب Quorum والتوفر العالي في عنقود Proxmox VE من ثلاث عقد، وخيارات التخزين ومتى يستحق Ceph تعقيده في التخزين في Proxmox، وكيف يوزع Ceph البيانات وكيف يتعافى من سقوط قرص في Ceph للمبتدئين، والمقارنة بينه وبين GlusterFS في Ceph أم GlusterFS.
وما يهمنا هنا من هذه الطريقة ثلاث قواعد من توثيق Proxmox، لأنها نفس القواعد التي سوف نراها في Harvester بأسماء أخرى:
- ثلاثة سيرفرات متماثلة على الأقل: يقول التوثيق «يجب أن تستخدم ثلاثة سيرفرات على الأقل، ويفضل أن تكون متماثلة». والسبب نصاب Ceph Monitors الذي يحتاج ثلاثة، ونصاب Corosync في العنقود نفسه، والنسخ الثلاث التي يجب أن تكون كل منها على سيرفر مختلف.
- اثنا عشر قرصاً موزعة بالتساوي: يوصي التوثيق بعنقود Ceph من ثلاث عقد على الأقل و12 OSD على الأقل، موزعة بالتساوي بين العقد، والسبب أن Ceph يوزع إعادة البناء على كل الأقراص، فكلما زاد عددها قصر وقت الخطر بعد سقوط قرص.
- شبكة مخصصة للتخزين: كما ذكرنا، 10 Gbps على الأقل، و25 Gbps للأقراص السريعة، ويفضل فصل شبكة Ceph الداخلية عن شبكة الأجهزة وشبكة Corosync.
وبهذا الشكل يصبح عندك HCI حقيقية: الأجهزة الافتراضية تعمل بـ KVM على كل عقدة، وأقراصها في Ceph RBD على أقراص نفس العقد، والعنقود ينقلها وهي تعمل أو يعيد تشغيلها إذا سقط سيرفرها. وهذه هي المنصة التي سوف نقارن بها Harvester في نهاية المقال، لأن الفكرة واحدة والطبقات مختلفة تماماً.
Harvester: الحوسبة المتقاربة HCI فوق Kubernetes
Harvester مشروع مفتوح المصدر بترخيص Apache 2.0 من SUSE، بدأ مستودعه على GitHub في يوليو 2020، وصدر أول إصدار مستقر v1.0.0 في 21 ديسمبر 2021، وآخر إصدار عند كتابة هذا المقال v1.9.1 في 10 نوفمبر 2026. ويصف التوثيق الرسمي المشروع بأنه حل HCI مبني على Kubernetes، يعمل على السيرفرات مباشرة Bare Metal، ويعطيك المحاكاة الافتراضية Virtualization والتخزين الموزع معاً، ويستخدم الأقراص المحلية المتصلة بالسيرفر بدل شبكات SAN الخارجية المعقدة. وتبيع SUSE الدعم Support التجاري للمنصة تحت اسم SUSE Virtualization. وقد ذكرنا Harvester باختصار بين بدائل VMware بعد Broadcom، وهنا سوف ندخل في طبقاته واحدة واحدة.
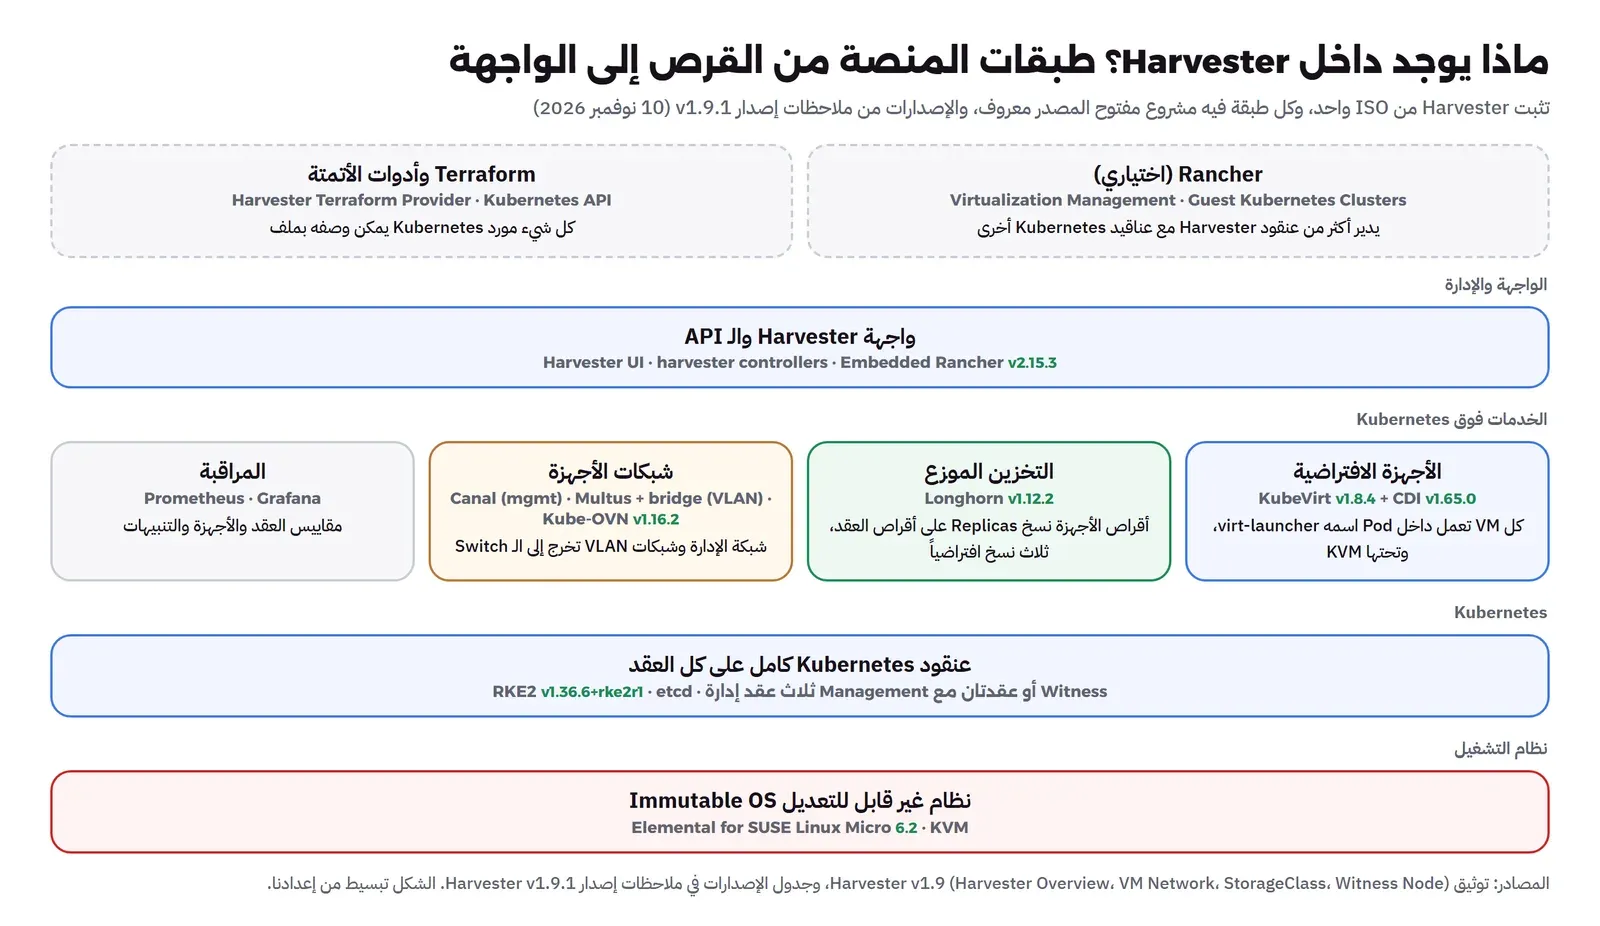
والفكرة الأساسية التي يجب أن تفهمها قبل أي تفصيل أن Harvester ليس برنامجاً تثبته على Linux، وإنما نظام كامل Appliance تثبته من ISO على السيرفر الفارغ، ويأتي معه كل شيء: نظام التشغيل، وعنقود Kubernetes، وطبقة الأجهزة الافتراضية، والتخزين، والشبكات، والواجهة. وكل طبقة منها مشروع مفتوح المصدر معروف له مجتمعه وتوثيقه، كما تبين الصورة التالية:
نظام التشغيل: Elemental مع SUSE Linux Micro
في أسفل المنصة نظام تشغيل اسمه SUSE Linux Micro، بالإصدار 6.2 في Harvester v1.9، تبنيه وتديره أداة Elemental. ويصفه التوثيق بأنه توزيعة Linux غير قابلة للتعديل Immutable، صممت لتزيل أكبر قدر ممكن من صيانة نظام التشغيل Operating System في عنقود Kubernetes. ومعنى غير قابل للتعديل أن قسم النظام يقرأ فقط، فلا تثبت عليه حزماً بـ zypper كما تفعل في سيرفر عادي، ولا تعدل ملفاته وتنتظر أن تبقى بعد التحديث، وإنما يأتي النظام كله كصورة واحدة، ويستبدل كاملاً عند الترقية Upgrade.
ولماذا يهمك هذا؟ لأنه يغير طريقة عمل مدير النظام. ففي Proxmox VE أنت على Debian كامل، تستطيع أن تثبت أداة مراقبة Monitoring أو تعدل إعداد الشبكة يدوياً، وهذه مرونة كبيرة، وهي أيضاً سبب أن سيرفرين في نفس العنقود قد يختلفان بعد سنة لأن كل واحد عدله شخص مختلف. أما في Harvester فالإعداد يمر عبر المنصة نفسها، بملف إعداد Configuration عند التثبيت أو بموارد Kubernetes بعده، وكل العقد تبقى متماثلة. والثمن أن ما لا تدعمه المنصة لا تستطيع أن تضيفه بسهولة، فإذا احتجت برنامج تشغيل Driver لبطاقة شبكة غير مدعومة فلا يكفي أن تثبته، لذلك يوصي التوثيق باستخدام عتاد معتمد YES-certified لـ SUSE Linux Micro 6.2.
RKE2 مع etcd: أين النصاب Quorum في Harvester؟
فوق النظام يعمل عنقود Kubernetes كامل بتوزيعة RKE2، بالإصدار v1.36.6+rke2r1 في Harvester v1.9.1. وكل ما تعرفه عن Kubernetes ينطبق هنا: الـ API، والـ Pods، والـ DaemonSets، والجدولة Scheduling، وقاعدة البيانات etcd التي يحفظ فيها العنقود كل حالته، وقد شرحنا هذه الأجزاء في كيف يعمل Kubernetes من الداخل.
وهنا أول مقابلة مع Proxmox. ففي Proxmox يحفظ إعداد العنقود في pmxcfs، ويقرر Corosync من الحاضر ومن الغائب بالأصوات. أما في Harvester فالإعداد كله موارد Kubernetes في etcd، والنصاب نصاب etcd. ويقول توثيق عقدة الشاهد Witness Node إن العنقود المعتاد من ثلاث عقد فيه ثلاث عقد إدارة Management، في كل منها مكونات مستوى الإدارة Control Plane كاملة، وإن عدد عقد etcd يجب أن يكون فردياً دائماً، والافتراضي في Harvester ثلاثة. ومنذ الإصدار v1.3.0 يمكنك أن تبني عنقوداً من عقدتي إدارة وعقدة شاهد واحدة، والشاهد عضو في etcd فقط، لا يشغل أجهزة ولا يحفظ بيانات، ولكن يجب أن يكون قرصه سريعاً بما يكفي لـ etcd. وهذا يشبه الـ QDevice في Proxmox من حيث الفكرة: صوت ثالث رخيص يرجح بين عقدتين.
ويقول دليل العنقود عالي التوفر إن مزايا العقد المتعددة مثل التوفر العالي تحتاج ثلاث عقد أو أكثر، وإن العنقود من عقدة واحدة يدعم أغلب المزايا عدا التوفر العالي والنسخ المتعددة Multi-replica والنقل الحي. وتحتاج لكل عقدة عنواناً ثابتاً، وعنواناً افتراضياً VIP للعنقود كله تتصل به العقد عند الانضمام ويتصل به المدير بعد ذلك.
KubeVirt: الجهاز الافتراضي داخل Pod
الطبقة التي تشغل الأجهزة الافتراضية هي KubeVirt، بالإصدار v1.8.4 في Harvester v1.9.1، وهو مشروع في مؤسسة CNCF قبل في سبتمبر 2019، وأصبح مشروعاً متخرجاً Graduated في 4 نوفمبر 2026 كما تقول صفحته في CNCF. وفكرته أن الجهاز الافتراضي يصبح مورداً في Kubernetes مثل الـ Deployment، تصفه بملف YAML، وتنشئه بـ kubectl، ويعمل في النهاية داخل Pod عادي اسمه virt-launcher، وفي داخل هذا الـ Pod عملية QEMU تستخدم KVM كما في أي سيرفر Linux. وقد شرحنا KVM وQEMU وlibvirt على سيرفر عادي في KVM على سيرفر Linux، وKubeVirt يستخدم نفس الأدوات، ولكنه يضعها داخل Pod لكل جهاز.
ويتكون KubeVirt من أربع خدمات، وكل منها يراقب الموارد ويقوم بدوره، دون برنامج مركزي واحد يأمر الجميع:
- virt-api: يستقبل طلبات الأجهزة ويتحقق منها Validation، ويقدم العمليات الخاصة بالأجهزة مثل الـ Console والإيقاف المؤقت Pause.
- virt-controller: يرى المورد الجديد، فينشئ له Pod اسمه virt-launcher، ويترك لـ Kubernetes أن يختار العقدة.
- virt-handler: يعمل على كل عقدة كـ DaemonSet، فإذا وصل جهاز إلى عقدته طلب تشغيله من virtqemud داخل الـ Pod، وراقبه بعد ذلك.
- virt-launcher: الـ Pod الذي يعيش فيه الجهاز، وفيه virtqemud وعملية QEMU نفسها، ويبقى الـ Pod حياً ما دام الجهاز يعمل.
والصورة التالية تبين ما يحدث من لحظة kubectl apply إلى أن يعمل الجهاز، وهو نفس التسلسل الذي سوف نراه في المختبر بأسماء حقيقية:
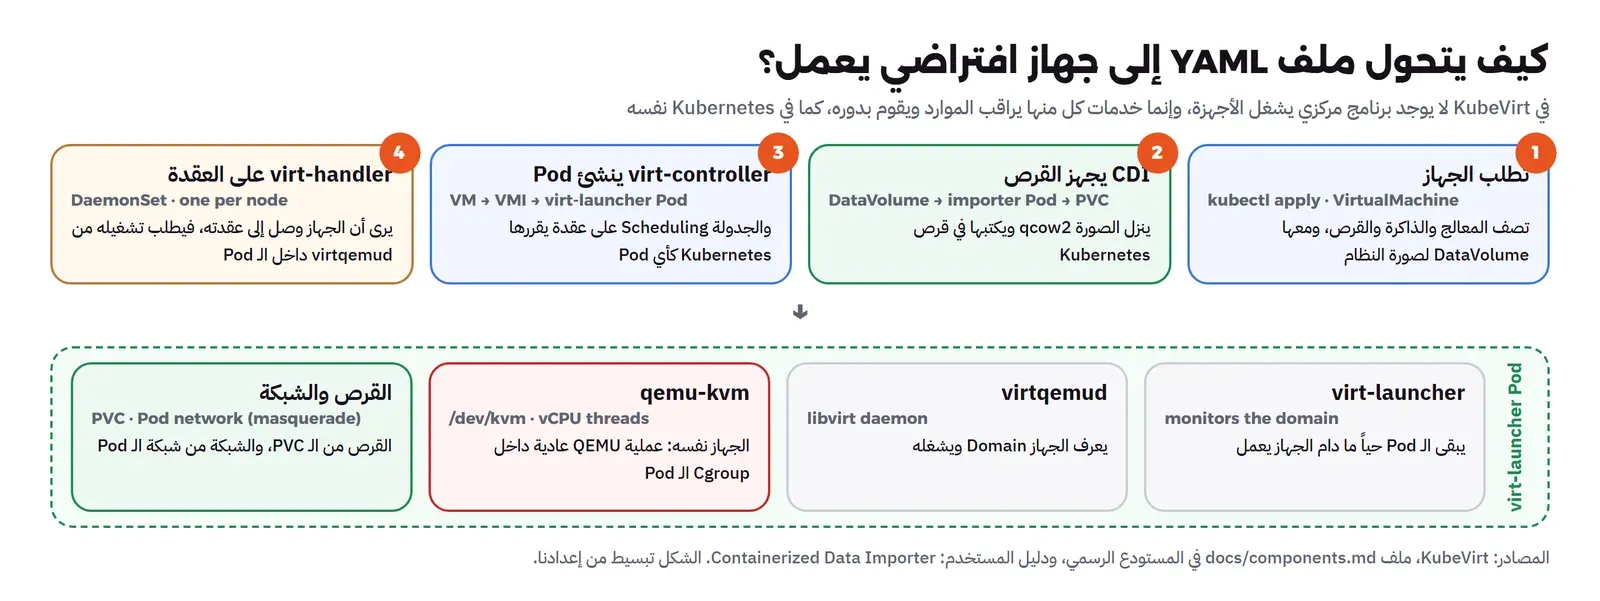
وهنا فرق مهم بين ثلاثة موارد قد تخلط بينها: المورد VirtualMachine واختصاراً VM هو الوصف الدائم للجهاز، ويبقى موجوداً حتى لو كان الجهاز مطفأً، أما VirtualMachineInstance واختصاراً VMI فهو الجهاز وهو يعمل، ينشأ عند التشغيل ويحذف عند الإيقاف، والـ Pod هو المكان الذي يعمل فيه الـ VMI على العقدة. وهذا يشبه العلاقة بين Deployment وPod: الـ VM يقول «أريد جهازاً بهذه المواصفات يعمل دائماً»، والـ VMI هو التنفيذ الحالي لهذه الرغبة.
CDI: كيف تصل صورة النظام إلى قرص الجهاز؟
الجهاز يحتاج قرصاً فيه نظام تشغيل، وKubernetes لا يعرف شيئاً عن صور الأقراص qcow2 أو ISO. وهذا دور Containerized Data Importer واختصاراً CDI، بالإصدار v1.65.0 في Harvester v1.9.1. فأنت تنشئ مورداً اسمه DataVolume تقول فيه «أريد قرصاً بحجم كذا، وفيه هذه الصورة من هذا الرابط»، فينشئ CDI طلب قرص PersistentVolumeClaim واختصاراً PVC، ثم يشغل Pod مؤقتاً اسمه importer ينزل الصورة ويحولها ويكتبها في القرص، ثم يختفي. وفي Harvester تقوم صفحة الصور Images في الواجهة بهذا الدور، فأنت ترفع صورة أو تعطيها رابطاً، والمنصة تحفظها في Longhorn وتنسخ منها أقراص الأجهزة.
Longhorn: التخزين الموزع في Harvester
التخزين في Harvester هو Longhorn، بالإصدار v1.12.2، وهو مشروع في CNCF أيضاً، في مستوى الحضانة Incubating منذ نوفمبر 2021. وLonghorn يختلف عن Ceph في طريقة بنائه: ففي Ceph عنقود تخزين واحد كبير يوزع كل الكائنات على كل الأقراص بخوارزمية CRUSH، أما Longhorn فيعطي كل قرص افتراضي Volume محركاً Engine خاصاً به، ويحفظ له نسخاً Replicas على عقد مختلفة، فالعطل في قرص لا يمس إلا الأقراص الافتراضية التي لها نسخة عليه.
ويقول توثيق StorageClass في Harvester إن فئة التخزين الافتراضية harvester-longhorn تحفظ ثلاث نسخ لكل قرص من أجل التوفر العالي، وإنك إذا استخدمتها في عنقود من عقدة واحدة فلن يستطيع Longhorn أن ينشئ النسخ الثلاث، وسوف تظهر الأقراص في الواجهة بحالة متدهورة Degraded، والحل أن تجعل عدد النسخ واحداً في ملف الإعداد، أو تنشئ فئة جديدة بنسخة واحدة وتجعلها الافتراضية. ولاحظ أيضاً أن أغلب إعدادات الفئة لا تتغير بعد إنشائها، فعدد النسخ وسياسة توزيعها قرار تأخذه مرة لكل فئة، وإذا أردت سياسة أخرى أنشأت فئة أخرى. ويدعم Harvester كذلك مخازن خارجية عبر واجهة CSI لمن يملك مصفوفة يريد أن يبقي عليها، وهذا يعني أنك لست مجبراً على Longhorn إذا لم يناسبك.
الشبكات Networking: Canal مع Multus وشبكات VLAN
للأجهزة الافتراضية في Harvester ثلاثة أنواع من الشبكات حسب توثيق شبكات الأجهزة: شبكة الإدارة Management Network، وشبكة VLAN، والشبكة دون علامات Untagged Network. وشبكة الإدارة هي شبكة Kubernetes نفسها بـ Canal، أي Calico مع Flannel، وهي مناسبة للأجهزة التي تتكلم داخل العنقود فقط، ولها ملاحظتان يذكرهما التوثيق: عنوان الجهاز عليها لا يصل إليه أحد من خارج العقد إلا عبر مورد Service في Kubernetes، والعنوان يتغير بعد إعادة تشغيل الجهاز، وهذا غريب على من تعود أن يكون للجهاز عنوان ثابت. والملاحظة الثانية أن واجهة الجهاز على شبكة الإدارة تعمل بـ MTU قيمته 1450 بدل 1500، لأن الشبكة الداخلية تضيف 50 بايتاً لكل حزمة.
أما الأجهزة التي يجب أن تظهر على شبكة المؤسسة بعناوين ثابتة، كما تعودت في VMware أو Proxmox، فتستخدم شبكة VLAN، ويبنيها Harvester بـ Multus مع إضافة الجسر bridge، فيصل الجهاز إلى بطاقة شبكة السيرفر مباشرة، ومنها إلى الـ Switch الذي يجب أن يكون منفذه Trunk يحمل الـ VLANs. وهذا يقابل Linux Bridge مع VLAN الذي شرحناه في الشبكات في Proxmox. ويضيف Harvester v1.9 مكون Kube-OVN بالإصدار v1.16.2 للشبكات الافتراضية المعزولة، وهي طبقة أحدث تحتاج تجربة قبل أن تعتمد عليها.
Rancher: إدارة عدة عناقيد وعناقيد Kubernetes ضيفة
Harvester يعمل وحده بواجهته، ولكن قوته الحقيقية لمن يعمل بـ Kubernetes تظهر مع Rancher. فحسب توثيق التكامل مع Rancher يدمج Rancher منصة Harvester افتراضياً منذ الإصدار v2.6.1، فتستورد عدة عناقيد Harvester وتديرها من صفحة Virtualization Management، مع المصادقة Authentication والصلاحيات RBAC في Rancher لتعدد المستأجرين Multi-tenancy. والأهم أن Rancher يستطيع أن ينشئ عناقيد Kubernetes ضيفة Guest Clusters على أجهزة Harvester الافتراضية، فيصبح Harvester مزود بنية Infrastructure Provider لعناقيدك، كما تفعل AWS مع EKS. ويحذر التوثيق من أن Rancher في بيئة الإنتاج Production يحتاج عنقوداً مخصصاً عالي التوفر من ثلاث عقد، وأن تثبيته بـ Docker للتجربة فقط.
متطلبات العتاد Hardware Requirements بالأرقام
هذا هو الجزء الذي يفاجئ أغلب من يقرأ عن Harvester لأول مرة، فالمنصة تشغل Kubernetes كاملاً وLonghorn ومراقبة وRancher داخلياً قبل أن يعمل أول جهاز. والجدول التالي من صفحة المتطلبات للإصدار v1.9 كما قرأناها في 19 نوفمبر 2026:
| البند | التطوير والتجربة Development/Testing | الإنتاج Production |
|---|---|---|
| المعالج CPU | x86_64 أو ARM64 مع دعم المحاكاة في المعالج، 8 أنوية على الأقل | 16 نواة على الأقل |
| الذاكرة RAM | 32 GB على الأقل | 64 GB على الأقل |
| مساحة القرص | 250 GB على الأقل، و180 GB لعقدة الشاهد | 500 GB على الأقل، وينصح بـ 1 TB أو أكثر |
| أداء القرص | أكثر من 5,000 عملية عشوائية في الثانية IOPS لكل قرص SSD أو NVMe | نفس الشرط، مع أقراص محلية أو RAID عتادي فقط |
| بطاقات الشبكة NIC | بطاقة لشبكة الإدارة وبطاقة لشبكة الأجهزة، وينصح باثنتين لكل منهما | نفس العدد |
| سرعة الشبكة | 1 Gbps على الأقل | 10 Gbps على الأقل |
| الـ Switch | منافذ Trunk لدعم VLAN | نفس الشرط |
وفي نفس الصفحة ثلاث ملاحظات يجب أن تقرأها قبل شراء أي عتاد: الأولى أن التثبيت الجديد منذ v1.8.0 لا يعمل إلا على أنظمة UEFI، والإقلاع Boot القديم Legacy BIOS خرج. والثانية أن الحواسيب المحمولة والمحاكاة المتداخلة Nested Virtualization غير مدعومة، أي أن Harvester يريد سيرفرات حقيقية. والثالثة أن النقل الحي لا يعمل بشكل صحيح إلا إذا كانت معالجات كل السيرفرات بنفس المواصفات، لأن KubeVirt يتحقق من تطابق قدرات المعالج بين المصدر والهدف ويرفض النقل إذا اختلفت، وهذا ما ذكرناه عن تطابق المعالجات في دعم المعالج للأجهزة الافتراضية. لذلك عندما توسع العنقود بعد سنتين، فإن السيرفر الجديد بمعالج أحدث قد يمنع النقل الحي إليه، فخطط للشراء على دفعات متماثلة.
الترقيات Upgrades: كل أربعة أشهر، ولا رجوع
يقول توثيق الترقية إن Harvester يصدر إصداراً فرعياً Minor Release كل أربعة أشهر، في أبريل وأغسطس وديسمبر، وإصدار تصحيح Patch كل شهرين قدر الإمكان، وإنك ترقي من إصدار فرعي إلى الذي يليه فقط، ولا يدعم الرجوع إلى إصدار أقدم Downgrade. والسبب أن كل إصدار فرعي يرفع كل المكونات تحته درجة واحدة، فالجدول في نفس الصفحة يبين أن Harvester v1.8 كان على KubeVirt v1.7 وLonghorn v1.11 وRKE2 v1.35، وأن v1.9 على KubeVirt v1.8 وLonghorn v1.12 وRKE2 v1.36. وهذا يعني أن ترقية Harvester ترقية لنظام التشغيل وKubernetes والتخزين والمحاكاة معاً، وأن عنقوداً تأخر عن ثلاثة إصدارات يحتاج ثلاث ترقيات متتالية. فإذا كان فريقك يؤجل التحديثات سنة كاملة، فهذه المنصة سوف تعاقبه أكثر من Proxmox.
المختبر Lab: نفس مكونات Harvester على عقدة واحدة
الطريقة الصحيحة لتفهم أي منصة HCI أن ترى الجهاز الافتراضي من الداخل: أين يعيش، ومن يشغله، وماذا يحدث عندما يختفي شيء من تحته. ولذلك بنينا في هذا المختبر نفس الطبقات التي يقوم عليها Harvester، ولكن بحجم يناسب جهازاً واحداً: جهاز افتراضي بنظام Ubuntu 24.04 يعمل بـ QEMU وKVM، بثلاثة معالجات افتراضية vCPU و6 GB من الذاكرة، وفيه k3s كتوزيعة Kubernetes خفيفة بدل RKE2، ثم KubeVirt وCDI بنفس الطريقة التي يستخدمهما بها Harvester. والصورة التالية تبين أي مكون في المختبر يقابل أي مكون في المنصة:
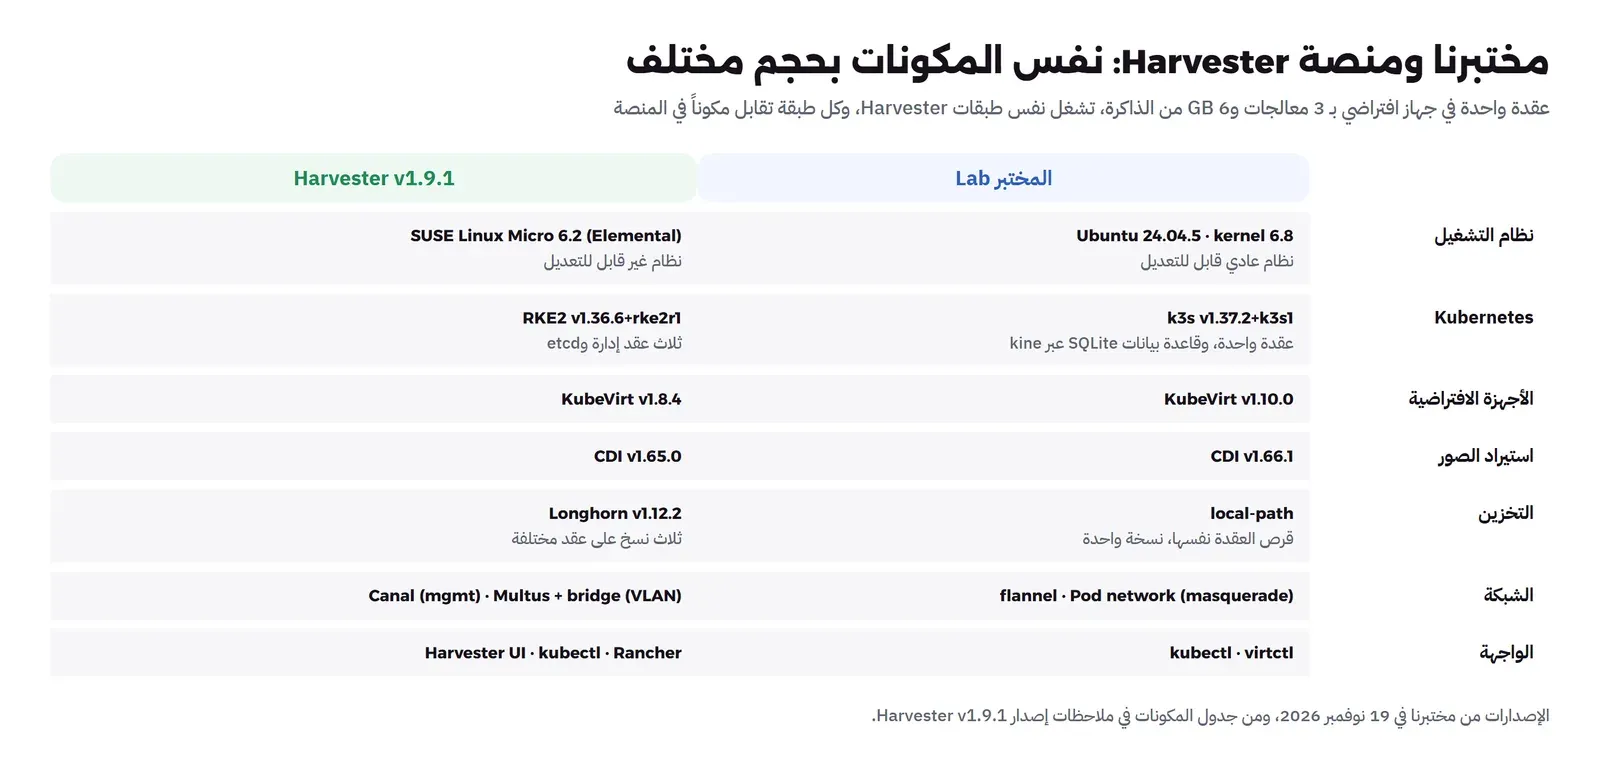
ولاحظ في الجدول قرار التخزين. فالمختبر عقدة واحدة، والتخزين الموزع في عقدة واحدة لا يوزع شيئاً، فـ Longhorn بنسخة واحدة على قرص واحد يعطيك نفس ما يعطيك local-path، أي قرصاً على العقدة نفسها، مع طبقة إضافية من المحركات والـ Pods تستهلك المعالج والذاكرة. لذلك استخدمنا local-path الذي يأتي مع k3s، والهدف هنا أن نرى الجهاز الافتراضي وقرصه ومسار الطلب بينهما، أما توزيع النسخ على العقد وسلوكها عند سقوط سيرفر فقد قسناه في مختبر Ceph للمبتدئين، والمبدأ نفسه في Longhorn. وسوف نرى أن هذا القرار له أثر واضح على ميزة واحدة بالذات، وهي الـ Snapshots.
الخطوة 1: عنقود k3s بعقدة واحدة
نثبت k3s بإصدار محدد، حتى يكون المختبر قابلاً للتكرار، ونعطل Traefik لأننا لا نحتاج Ingress هنا:
curl -sfL https://get.k3s.io | sudo INSTALL_K3S_VERSION="v1.37.2+k3s1" K3S_KUBECONFIG_MODE=644 sh -s - --disable traefik
kubectl get nodes -o wide
والمخرج سوف يكون كما يلي:
NAME   STATUS   ROLES           AGE   VERSION        INTERNAL-IP   EXTERNAL-IP   OS-IMAGE             KERNEL-VERSION              CONTAINER-RUNTIME
kv     Ready    control-plane   24s   v1.37.2+k3s1   10.0.2.15     <none>        Ubuntu 24.04.5 LTS   6.8.0-147-generic (amd64)   containerd://2.3.7-k3s1
في المخرج أعلاه لاحظ التالي:
- العقدة الوحيدة kv جاهزة Ready بعد 24 ثانية، ودورها control-plane، أي أنها تشغل مستوى الإدارة والأجهزة معاً، وهذا ما يفعله Harvester أيضاً في العنقود الصغير، فعقد الإدارة الثلاث تشغل الأجهزة أيضاً.
- بيئة التشغيل containerd 2.3.7، وهي التي سوف تشغل الـ Pod الذي يعيش فيه الجهاز الافتراضي.
- k3s بعقدة واحدة يحفظ حالته في SQLite عبر طبقة اسمها kine بدل etcd، وهذا تبسيط مناسب للمختبر، أما في الإنتاج فالحالة في etcd بثلاث نسخ كما في Harvester.
وقبل أن ننتقل نتأكد أن الجهاز الافتراضي الذي يعمل فيه k3s يرى /dev/kvm، لأن KubeVirt يحتاجه حتى يشغل الأجهزة بالمعالج مباشرة:
ls -la /dev/kvmcrw-rw---- 1 root kvm 10, 232 Nov 19 13:15 /dev/kvmولو لم يكن الملف موجوداً، لأن السيرفر لا يدعم المحاكاة في المعالج أو لأنها معطلة في الـ BIOS، فإن virt-handler لا يعلن العقدة قادرة على تشغيل الأجهزة، ويبقى الجهاز في حالة Scheduling دون أن يجد عقدة، وعندها يمكنك أن تفعل خيار المحاكاة البرمجية useEmulation في مورد KubeVirt، وهو بطيء جداً ولا يصلح إلا للتجربة.
الخطوة 2: تثبيت KubeVirt بالـ Operator
يثبت KubeVirt بطريقة الـ Operator: ملف ينشئ برنامجاً اسمه virt-operator، ثم مورد واحد من نوع KubeVirt تقول فيه «أريد KubeVirt»، فيقوم الـ Operator بإنشاء كل المكونات الأخرى ويراقبها ويرقيها. وهذه نفس الطريقة التي يستخدمها Harvester داخلياً، فكل مكون في المنصة له Operator أو Controller يحافظ على حالته:
V=v1.10.0
kubectl create -f https://github.com/kubevirt/kubevirt/releases/download/$V/kubevirt-operator.yaml
kubectl create -f https://github.com/kubevirt/kubevirt/releases/download/$V/kubevirt-cr.yaml
kubectl -n kubevirt wait kv kubevirt --for condition=Available --timeout=15m
وهنا ظهرت أول مشكلة حقيقية، وهي من أكثر المشكلات تعليماً في هذا المقال. فبعد 15 دقيقة انتهى الانتظار بالخطأ error: timed out waiting for the condition on kubevirts/kubevirt، وكانت الـ Pods كما يلي:
NAME                             READY   STATUS    RESTARTS      AGE
virt-operator-6d4dd9c5c5-5kch2   0/1     Running   4 (28s ago)   4m22s
virt-operator-6d4dd9c5c5-mhp4w   0/1     Running   4 (26s ago)   4m21s
والـ Operator نفسه يعاد تشغيله كل نصف دقيقة. وعندما قرأنا الأحداث Events وجدنا السبب:
kubectl -n kubevirt get events --sort-by=.lastTimestamp | tail -4Warning Unhealthy pod/virt-operator-6d4dd9c5c5-5kch2 Readiness probe failed: Get "https://10.42.0.6:8443/metrics": dial tcp 10.42.0.6:8443: connect: connection refused
Warning Unhealthy pod/virt-operator-6d4dd9c5c5-5kch2 Liveness probe failed: Get "https://10.42.0.6:8443/metrics": dial tcp 10.42.0.6:8443: connect: connection refused
Normal Killing pod/virt-operator-6d4dd9c5c5-5kch2 Container virt-operator failed liveness probe, will be restarted
Normal Killing pod/virt-operator-6d4dd9c5c5-mhp4w Container virt-operator failed liveness probe, will be restartedأي أن Kubernetes يقتل الـ Operator قبل أن يكمل بدايته. والفحص Liveness Probe في ملف التثبيت يبدأ بعد 5 ثوان، ويفحص كل 10 ثوان، ويقتل الـ Container بعد ثلاثة فشلات متتالية، أي بعد نحو 35 ثانية من البداية:
{"failureThreshold":3,"httpGet":{"path":"/metrics","port":8443,"scheme":"HTTPS"},"initialDelaySeconds":5,"periodSeconds":10,"successThreshold":1,"timeoutSeconds":10}وكان الـ Operator يستهلك 85% من معالج كامل في بدايته، والعقدة كلها تحت ضغط Load Average بقيمة 7.42 على ثلاثة معالجات، وعندما فحصنا المعالج بـ vmstat وجدنا أن وقت السرقة Steal Time بين 18% و68%، أي أن الجهاز الافتراضي الذي يعمل فيه k3s كان ينتظر دوره على معالجات السيرفر المضيف التي تتقاسمها أجهزة أخرى:
procs -----------memory---------- ---swap-- -----io---- -system-- -------cpu-------
 r  b   swpd   free   buff  cache   si   so    bi    bo   in   cs us sy id wa st gu
 7 16      0 1033616  54912 3353720    0    0     0     0 3830 5620 63 17  0  2 18  0
17  0      0 1001900  54920 3365104    0    0     0    13 2176 3117 34 12  1  0 52  0
16  0      0 987044  54920 3374088    0    0     0    72 1489 2075 19 10  4  0 68  0
ولاحظ في هذا المخرج العمود st، وهو النسبة من الوقت التي أراد فيها المعالج الافتراضي أن يعمل ولم يعطه المضيف Host فرصة، وقد شرحنا وقت السرقة في دعم المعالج للأجهزة الافتراضية. وهذا هو الدرس الأول للـ HCI: مستوى الإدارة نفسه يعمل على نفس المعالجات التي تشغل الأجهزة، فإذا حملت العقد فوق طاقتها، فإن أول ما يتأثر ليس الأجهزة، وإنما الفحوص والمهل في Kubernetes، فتبدأ المكونات تقتل بعضها وتعيد تشغيل نفسها، وتصبح المشكلة أصعب في الفهم من سببها الحقيقي.
والحل الذي استخدمناه أن نخفض عدد نسخ الـ Operator إلى واحدة، ونعطيه وقتاً أطول قبل أول فحص:
kubectl -n kubevirt scale deploy virt-operator --replicas=1
kubectl -n kubevirt patch deploy virt-operator --type=json \
  -p '[{"op":"replace","path":"/spec/template/spec/containers/0/livenessProbe/initialDelaySeconds","value":300}]'
وبعد دقيقتين ونصف أصبح الـ Operator جاهزاً 1/1، وبدأ يكتب في سجله أنه ينتظر خطة التثبيت Install Strategy من Job أنشأه بنفسه، ثم بدأ ينشئ بقية المكونات:
NAME                                         READY   STATUS    RESTARTS   AGE
virt-operator-7bddc65bd5-89gp7               1/1     Running   0          2m32s
virt-operator-install-strategy-ld957-qwf8g   1/1     Running   0          71s
ولا تقم بهذا التعديل في الإنتاج على أنه حل دائم، والسبب أن فحص الحياة موجود ليكتشف Operator معلقاً، وتأخيره خمس دقائق يعني أن العطل الحقيقي ينتظر خمس دقائق قبل أن يعالج. والحل الصحيح في الإنتاج أن تعطي العقد ما يكفيها من المعالجات، وأن تحجز جزءاً منها لمستوى الإدارة، وهذا ما تفعله المنصات الجاهزة مثل Harvester عندما تشترط 16 نواة لكل عقدة للإنتاج: جزء كبير منها ليس للأجهزة أصلاً.
الخطوة 3: CDI لاستيراد صور الأقراص
نثبت CDI بنفس طريقة الـ Operator، ملف للـ Operator ثم مورد واحد من نوع CDI:
V=v1.66.1
kubectl create -f https://github.com/kubevirt/containerized-data-importer/releases/download/$V/cdi-operator.yaml
kubectl create -f https://github.com/kubevirt/containerized-data-importer/releases/download/$V/cdi-cr.yaml
kubectl wait cdi cdi --for condition=Available --timeout=140s
وفي المحاولة الأولى انقطع أمر kubectl create الأول بسبب بطء الـ API، فرفض الأمر الثاني المورد بالخطأ التالي:
error: resource mapping not found for name: "cdi" namespace: "" from "https://github.com/kubevirt/containerized-data-importer/releases/download/v1.66.1/cdi-cr.yaml": no matches for kind "CDI" in version "cdi.kubevirt.io/v1beta1"
ensure CRDs are installed first
ومعنى الخطأ أن تعريف المورد CDI نفسه، أي الـ CRD، لم يصل إلى العنقود، لأن الملف الأول توقف في منتصفه. والحل أن تعيد تطبيق الملف الأول بـ kubectl apply --server-side، فهو يكمل ما نقص ولا يشتكي مما أنشئ سابقاً، ثم تنشئ المورد CDI. وبعدها اكتمل التثبيت في دقيقتين و22 ثانية، وأصبحت مكونات CDI أربعة:
NAME                               READY   STATUS    RESTARTS        AGE
cdi-apiserver-6dcb68889f-jdsdl     1/1     Running   0               118s
cdi-deployment-89cd679fd-d9xnc     1/1     Running   0               116s
cdi-operator-95678d877-9v9zr       1/1     Running   5 (4m24s ago)   19m
cdi-uploadproxy-6f6d588574-sbw42   1/1     Running   0               110s
NAME                   PROVISIONER             RECLAIMPOLICY   VOLUMEBINDINGMODE      ALLOWVOLUMEEXPANSION   AGE
local-path (default)   rancher.io/local-path   Delete          WaitForFirstConsumer   false                  92m
في المخرج أعلاه لاحظ التالي:
cdi-deploymentهو الـ Controller الذي ينفذ الاستيراد Import والنسخ، وcdi-uploadproxyيستقبل الصور التي ترفعها من جهازك بـvirtctl image-upload، وهو ما تفعله صفحة الصور في Harvester عندما ترفع ملف ISO من المتصفح.- فئة التخزين local-path تعمل بوضع
WaitForFirstConsumer، أي أنها لا تنشئ القرص حتى يطلبه Pod، لأن القرص محلي ويجب أن يكون على نفس العقدة التي يعمل فيها الـ Pod. وهذا التفصيل سوف يظهر بعد قليل بطريقة مثيرة. - الـ Operator أعيد تشغيله خمس مرات، وهو نفس أثر الضغط على المعالجات الذي رأيناه مع KubeVirt.
ونثبت أيضاً أداة virtctl بنفس إصدار KubeVirt، وهي الأداة التي تشغل الأجهزة وتوقفها وتفتح الـ Console، لأن kubectl وحده لا يعرف هذه العمليات:
curl -sL -o /tmp/virtctl https://github.com/kubevirt/kubevirt/releases/download/v1.10.0/virtctl-v1.10.0-linux-amd64
sudo install -m 755 /tmp/virtctl /usr/local/bin/virtctl
virtctl version
وإذا ظهر لك الخطأ dial tcp 127.0.0.1:8080: connect: connection refused فالسبب أن virtctl لا يجد ملف الاتصال بالعنقود، وفي k3s هذا الملف في /etc/rancher/k3s/k3s.yaml، فانسخه إلى ~/.kube/config أو اضبط المتغير KUBECONFIG.
الخطوة 4: أول جهاز افتراضي من DataVolume
الآن نصف الجهاز في ملف واحد: مورد VirtualMachine فيه قالب DataVolume ينزل صورة CirrOS، وهو نظام صغير جداً مخصص للتجربة في السحابات، ثم مواصفات الجهاز نفسه. والملف الكامل كما يلي:
apiVersion: kubevirt.io/v1
kind: VirtualMachine
metadata:
  name: cirros1
spec:
  runStrategy: Always
  dataVolumeTemplates:
  - metadata:
      name: cirros1-disk
    spec:
      storage:
        storageClassName: local-path
        accessModes: ["ReadWriteOnce"]
        resources:
          requests:
            storage: 1Gi
      source:
        http:
          url: https://download.cirros-cloud.net/0.6.3/cirros-0.6.3-x86_64-disk.img
  template:
    metadata:
      labels:
        app: cirros1
    spec:
      domain:
        cpu:
          cores: 1
        memory:
          guest: 256Mi
        devices:
          disks:
          - name: root
            disk: {bus: virtio}
          interfaces:
          - name: default
            masquerade: {}
      networks:
      - name: default
        pod: {}
      volumes:
      - name: root
        dataVolume:
          name: cirros1-disk
في الملف أعلاه لاحظ التالي:
runStrategy: Alwaysيعني أن KubeVirt يحافظ على الجهاز يعمل دائماً، فإذا توقف أعاد تشغيله، وهو ما يقابل في Proxmox أن تضع الجهاز تحت إدارة HA. وهناك قيم أخرى مثلManualوHaltedوRerunOnFailure.dataVolumeTemplatesيجعل القرص جزءاً من دورة حياة الجهاز، فإذا حذفت الجهاز حذف القرص معه، كما يحدث في Harvester عندما تحذف جهازاً وتختار حذف أقراصه.masqueradeمعpod: {}يعني أن الجهاز يتصل بشبكة الـ Pod عبر NAT، فيأخذ الجهاز عنواناً داخلياً ثابتاً، ويخرج إلى الشبكة بعنوان الـ Pod، وهذا يشبه شبكة الإدارة في Harvester تماماً.
ثم نطبق الملف ونراقب الموارد كل نصف دقيقة:
kubectl apply -f vm-cirros.yaml
kubectl get vm,vmi,dv,pvc,pods
وهنا رأينا كل مراحل الطلب التي رسمناها في الصورة الثالثة بأسماء حقيقية. وهذه أهم اللقطات من المراقبة، مختصرة:
14:54:52
virtualmachine.kubevirt.io/cirros1   3m13s   WaitingForVolumeBinding   False
datavolume.cdi.kubevirt.io/cirros1-disk   WaitForFirstConsumer   N/A         11s
persistentvolumeclaim/cirros1-disk   Pending                     local-path   <unset>   11s
pod/virt-launcher-cirros1-pfhrb   0/2   Pending   0     10s
14:56:53
virtualmachine.kubevirt.io/cirros1   5m15s   Provisioning   False
datavolume.cdi.kubevirt.io/cirros1-disk   ImportScheduled   N/A         2m13s
persistentvolumeclaim/cirros1-disk   Bound   pvc-2adcc9c1-80b0-4231-a08d-72ad480d013d   1138166334   RWO   local-path   <unset>   2m13s
pod/importer-cirros1-disk   0/1   ContainerCreating   0     57s
14:58:31
datavolume.cdi.kubevirt.io/cirros1-disk   ImportScheduled   N/A         4m10s
persistentvolumeclaim/cirros1-disk-scratch   Pending                                                                 local-path   <unset>   41s
pod/importer-cirros1-disk   0/1   Pending   0     42s
15:00:16
datavolume.cdi.kubevirt.io/cirros1-disk   ImportInProgress   100.00%         5m42s
pod/importer-cirros1-disk   0/1   Completed   0     2m12s
15:02:19
virtualmachine.kubevirt.io/cirros1   10m   Running   True
virtualmachineinstance.kubevirt.io/cirros1   7m58s   Running   10.42.0.30   kv    True   False
pod/virt-launcher-cirros1-554rc   2/2   Running   0     76s   10.42.0.30   kv    <none>   1/1
ولكي تفهم ما حدث نقرأ الأحداث Events بالترتيب، وفيها ثلاث لقطات تستحق الوقوف عندها:
Normal    SuccessfulDelete        virtualmachineinstance/cirros1   Deleted WaitForFirstConsumer temporary pod virt-launcher-cirros1-pfhrb
Normal    ProvisioningSucceeded   persistentvolumeclaim/cirros1-disk   Successfully provisioned volume pvc-2adcc9c1-80b0-4231-a08d-72ad480d013d
Normal    Pulled                  pod/importer-cirros1-disk   Successfully pulled image "quay.io/kubevirt/cdi-importer:v1.66.1" in 1m43.963s (1m43.965s including waiting). Image size: 231263350 bytes.
Warning   Unschedulable           datavolume/cirros1-disk     Importer pod cannot be scheduled
Normal    CreatingScratchSpace    datavolume/cirros1-disk     Creating scratch space
Normal    ImportSucceeded         datavolume/cirros1-disk     Successfully imported into PVC cirros1-disk
Normal    SuccessfulCreate        virtualmachineinstance/cirros1   Created virtual machine pod virt-launcher-cirros1-554rc
في الأحداث أعلاه لاحظ التالي:
- الـ Pod المؤقت Temporary Pod: لأن local-path لا ينشئ القرص حتى يطلبه Pod، والجهاز لا يستطيع أن يعمل قبل أن يكون قرصه جاهزاً، فقد أنشأ KubeVirt أول virt-launcher كـ Pod مؤقت، وظيفته الوحيدة أن يجبر فئة التخزين على اختيار العقدة وإنشاء القرص، ثم حذفه. وهذه مشكلة «البيضة والدجاجة» في التخزين المحلي، وحلها KubeVirt بهذه الحيلة.
- مساحة مؤقتة Scratch Space: بعد أن بدأ الاستيراد، احتاج CDI إلى قرص مؤقت ثان اسمه
cirros1-disk-scratch، ينزل فيه الصورة ويحولها من qcow2 إلى raw قبل أن يكتبها في القرص الحقيقي، ثم يحذفه. فإذا كانت صورتك 10 GB فخطط لمساحة مؤقتة بنفس الحجم أثناء الاستيراد. - الحجم الحقيقي للقرص: طلبنا 1Gi، وأنشأ CDI قرصاً بحجم 1138166334 بايت، أي أكبر بنحو 6%، والسبب أن CDI يضيف هامشاً لنظام الملفات Filesystem Overhead الذي يحمل ملف القرص
disk.img، حتى يبقى للجهاز الحجم الذي طلبته كاملاً. - الوقت: من
kubectl applyفي 14:51:39 إلى أن أصبح الجهاز Running في 15:02:19 مرت نحو 11 دقيقة، منها دقيقة و44 ثانية لتنزيل Image المستورد بحجم 231 MB أول مرة. وفي Harvester تحدث نفس الخطوات عندما تنشئ جهازاً من صورة، ولكن الصورة تكون محفوظة مسبقاً في Longhorn، فيصبح النسخ منها أسرع بكثير.
الخطوة 5: ماذا يوجد داخل virt-launcher؟
هذا هو الجزء الذي يفسر Harvester كله: الجهاز الافتراضي مجرد عملية في Pod. ننظر أولاً إلى ما يطلبه الـ Pod من العقدة:
P=$(kubectl get pod -l kubevirt.io/created-by -o name | head -1)
kubectl get $P -o jsonpath='{range .spec.containers[*]}{.name}{" "}{.resources.requests}{"\n"}{end}'
compute {"cpu":"100m","devices.kubevirt.io/kvm":"1","devices.kubevirt.io/tun":"1","devices.kubevirt.io/vhost-net":"1","ephemeral-storage":"50M","memory":"521Mi"}في المخرج أعلاه لاحظ التالي:
- طلبنا للجهاز 256Mi من الذاكرة، والـ Pod يطلب 521Mi، والفرق 265Mi هو ذاكرة QEMU وlibvirt والـ virt-launcher نفسه، وهذا ما يسمى Overhead، ويجب أن تحسبه عندما تخطط لعدد الأجهزة على كل عقدة.
devices.kubevirt.io/kvmمورد يعلنه virt-handler على كل عقدة فيها/dev/kvm، فالجدولة لا ترسل جهازاً افتراضياً إلا إلى عقدة تستطيع تشغيله، وvhost-netوtunللشبكة السريعة.- طلب المعالج 100m فقط، أي عشر نواة، لأن KubeVirt افتراضياً لا يحجز للجهاز نواة كاملة، ويترك المعالجات مشتركة كما في أي Hypervisor.
ثم ننظر إلى العمليات داخل الـ Container الذي اسمه compute:
kubectl exec $P -c compute -- ps -eo pid,user,rss,args --width 220 PID USER RSS COMMAND
1 qemu 808 /usr/bin/virt-launcher-monitor --qemu-timeout 321s --name cirros1 --uid 971dfc9f-d044-4654-9449-1c428a556279 --namespace default ...
7 qemu 68892 /usr/bin/virt-launcher --qemu-timeout 321s --name cirros1 --uid 971dfc9f-d044-4654-9449-1c428a556279 --namespace default ...
14 qemu 16088 /usr/sbin/virtlogd -f /etc/libvirt/virtlogd.conf
15 qemu 33128 /usr/sbin/virtqemud -f /var/run/libvirt/virtqemud.conf
76 qemu 194392 /usr/libexec/qemu-kvm -name guest=default_cirros1,debug-threads=on -S -object {"qom-type":"secret",...هذه هي المكونات التي رسمناها في الصورة الثالثة، كلها في Pod واحد: virt-launcher-monitor هو العملية الأولى PID 1 التي تبقي الـ Container حياً، وvirt-launcher يتكلم مع virt-handler، وvirtqemud هو libvirt الذي يعرف الجهاز ويشغله، وqemu-kvm هو الجهاز نفسه بذاكرة 194 MB تقريباً. فكل جهاز افتراضي في KubeVirt له نسخة libvirt خاصة به، وليس هناك libvirt واحد للعقدة كما في Proxmox أو في KVM العادي.
والآن ننظر إلى نفس العملية من العقدة، خارج الـ Pod، ونقرأ أهم معاملاتها:
Q=$(pgrep -f "^/usr/libexec/qemu-kvm -name guest=default_cirros1")
sudo tr '\0' '\n' < /proc/$Q/cmdline | grep -A1 -E '^-(machine|accel|cpu|m|smp|blockdev|netdev)$'
sudo cat /proc/$Q/cgroup
sudo ls -la /proc/$Q/fd | grep -E 'kvm|vhost'
-machine
pc-q35-rhel9.8.0,usb=off,vmport=off,dump-guest-core=off,memory-backend=pc.ram,acpi=on
-accel
kvm
-cpu
Skylake-Client-IBRS,vmx=on,pdcm=on,hypervisor=on,ss=on,tsc-adjust=on,...
-m
size=262144k
-smp
1,sockets=1,dies=1,clusters=1,cores=1,threads=1
-blockdev
{"driver":"file","filename":"/var/run/kubevirt-private/vmi-disks/root/disk.img","node-name":"libvirt-1-storage","read-only":false,"discard":"unmap","cache":{"direct":true,"no-flush":false}}
-netdev
{"type":"tap","fd":"21","vhost":true,"vhostfd":"23","id":"hostua-default"}
0::/kubepods.slice/kubepods-burstable.slice/kubepods-burstable-podaa3d8d4c_a1d3_4251_9b7c_1e2c654463d3.slice/cri-containerd-3776c9ab874b66913bba96e63970f3d6c7e70343d2dab5774e412296dcaa982b.scope
lrwx------ 1 tcpdump rdma 64 Nov 19 15:02 11 -> /dev/kvm
lrwx------ 1 tcpdump rdma 64 Nov 19 15:02 12 -> anon_inode:kvm-vm
lrwx------ 1 tcpdump rdma 64 Nov 19 15:02 23 -> /dev/vhost-net
lrwx------ 1 tcpdump rdma 64 Nov 19 15:02 25 -> anon_inode:kvm-vcpu:0في المخرج أعلاه لاحظ التالي:
-accel kvmمع/dev/kvmوkvm-vcpu:0في الملفات المفتوحة: الجهاز يعمل على المعالج مباشرة بـ KVM، كما في أي سيرفر Linux، ولا توجد محاكاة برمجية. والمعالج الافتراضي Skylake-Client-IBRS هو نموذج يطابق معالج العقدة، وهذا ما يجعل النقل الحي يحتاج معالجات متماثلة كما ذكرنا.- القرص ملف
disk.imgعلى الـ PVC، بإعدادcache.direct=true، أي أن QEMU يتجاوز ذاكرة الصفحات Page Cache في العقدة ويكتب مباشرة، وdiscard=unmapحتى يعيد الجهاز المساحة المحذوفة إلى التخزين. - الـ Cgroup هو cgroup الـ Pod، أي أن حدود الذاكرة والمعالج في Kubernetes تطبق على الجهاز الافتراضي مثل أي Container، وهذه هي الفكرة الأساسية في Harvester: طبقة الموارد واحدة للأجهزة والـ Containers.
- العملية تظهر في العقدة باسم المستخدم
tcpdump! والسبب أن QEMU داخل الـ Container يعمل بالمستخدم qemu ورقمه 107، وفي Ubuntu الرقم 107 مخصص لمستخدم اسمه tcpdump، والأسماء فيpsتأتي من ملف المستخدمين في العقدة لا في الـ Container. فإذا رأيت هذا في سيرفرك فلا تبحث عن مخترق.
الخطوة 6: الدخول إلى الجهاز بالـ Console وSSH
يفتح virtctl console المنفذ التسلسلي Serial Console للجهاز عبر virt-api، دون أي شبكة إلى الجهاز، وهذا ما تفعله نافذة الـ Console في واجهة Harvester:
virtctl console cirros1Successfully connected to cirros1 console. Press Ctrl+] or Ctrl+5 to exit console.
login as 'cirros' user. default password: 'gocubsgo'. use 'sudo' for root.
cirros login:وللدخول بـ SSH نستخدم عنوان الـ Pod الذي ظهر في kubectl get vmi، لأن وضع masquerade يوجه المنافذ من عنوان الـ Pod إلى الجهاز:
ssh [email protected] 'uname -a; ip -4 addr show eth0 | grep inet; ip route; free -m; df -h /; ping -c2 -W3 1.1.1.1'Linux cirros 5.15.0-117-generic #127-Ubuntu SMP Fri Jul 5 20:13:28 UTC 2024 x86_64 GNU/Linux
inet 10.0.2.2/24 brd 10.0.2.255 scope global dynamic noprefixroute eth0
default via 10.0.2.1 dev eth0 src 10.0.2.2 metric 1002
10.0.2.0/24 dev eth0 scope link src 10.0.2.2 metric 1002
total used free shared buff/cache available
Mem: 203 31 132 0 40 164
Filesystem Size Used Available Use% Mounted on
/dev/vda1 960.8M 43.9M 885.3M 5% /
64 bytes from 1.1.1.1: icmp_seq=1 ttl=253 time=100 ms
64 bytes from 1.1.1.1: icmp_seq=2 ttl=253 time=50.2 msفي المخرج أعلاه لاحظ التالي:
- الجهاز نفسه يرى العنوان
10.0.2.2وبوابة10.0.2.1، وهي شبكة داخلية ثابتة يصنعها وضع masquerade داخل الـ Pod، أما العالم الخارجي فيرى عنوان الـ Pod10.42.0.30. - القرص
/dev/vda1حجمه 960.8M، أي أن صورة CirrOS الصغيرة وسعت قسمها تلقائياً إلى حجم الـ PVC الذي طلبناه. - الذاكرة التي يراها الجهاز 203 MB من 256Mi، والباقي تحجزه النواة نفسها.
الخطوة 7: الإيقاف والتشغيل Stop/Start، ولماذا تغير العنوان؟
نوقف الجهاز ونشغله ونقيس الوقت:
virtctl stop cirros1
virtctl start cirros1
kubectl get vm,vmi,pods -o wide
15:11:19
VM cirros1 was scheduled to stop
15:11:44 vm=Stopping pods=1
15:11:55 vm=Stopped pods=0
15:11:57
VM cirros1 was scheduled to start
15:12:04 vmi=Scheduling
15:12:12 vmi=Scheduled
15:12:18 vmi=Running
NAME AGE PHASE IP NODENAME READY LIVE-MIGRATABLE PAUSED
virtualmachineinstance.kubevirt.io/cirros1 21s Running 10.42.0.32 kv True Falseفي المخرج أعلاه لاحظ التالي:
- عند الإيقاف حذف KubeVirt الـ VMI والـ Pod معاً، فعدد الـ Pods أصبح صفراً، أما الـ VM فبقي بحالة Stopped، وهذا هو الفرق بين الموردين الذي ذكرناه: الوصف يبقى، والتنفيذ يختفي.
- التشغيل أخذ 21 ثانية من الأمر إلى Running، لأن القرص جاهز هذه المرة، فلا استيراد ولا Pod مؤقت.
- العنوان تغير من
10.42.0.30إلى10.42.0.32، لأن كل تشغيل يعني Pod جديداً بعنوان جديد من شبكة الـ Pods. وهذا بالضبط ما يحذر منه توثيق Harvester عن شبكة الإدارة: العنوان يتغير بعد إعادة التشغيل، والحل مورد Service أمام الجهاز، أو شبكة VLAN بعنوان ثابت للأجهزة التي يجب أن يعرف الناس عنوانها.
ماذا عن النقل الحي Live Migration؟
لاحظ العمود LIVE-MIGRATABLE بقيمة False في المخرج السابق. ولكي نعرف السبب نقرأ حالة الـ VMI، ثم نحاول النقل:
kubectl get vmi cirros1 -o jsonpath='{range .status.conditions[*]}{.type}={.status} {.reason}: {.message}{"\n"}{end}'
virtctl migrate cirros1
Ready=True :
DataVolumesReady=True AllDVsReady: All of the VMI's DVs are bound and ready
LiveMigratable=False DisksNotLiveMigratable: cannot migrate VMI: PVC cirros1-disk is not shared, live migration requires that all PVCs must be shared (using ReadWriteMany access mode)
StorageLiveMigratable=True :
Error migrating VirtualMachine Internal error occurred: admission webhook "migration-create-validator.kubevirt.io" denied the request: Cannot migrate VMI, Reason: DisksNotLiveMigratable, Message: cannot migrate VMI: PVC cirros1-disk is not shared, live migration requires that all PVCs must be shared (using ReadWriteMany access mode)وهذه الرسالة تلخص لماذا تحتاج HCI إلى تخزين موزع. فالنقل الحي في KubeVirt يحتاج أن يكون القرص مشتركاً بنمط ReadWriteMany، أي أن العقدة الهدف تستطيع أن تفتح نفس القرص بينما ما زال الجهاز يعمل على العقدة المصدر. والقرص المحلي في local-path لا يراه إلا سيرفره، فرفض virt-api الطلب قبل أن يبدأ. أما في Harvester فأقراص Longhorn تنشأ بطريقة تسمح بفتحها من عقدتين أثناء النقل، وهذا هو الشرط الذي يجعل النقل الحي ووضع الصيانة Maintenance Mode ممكنين. ولاحظ أيضاً الشرط StorageLiveMigratable=True، وهو يعني أن KubeVirt يستطيع أن ينقل القرص نفسه إلى مخزن آخر، وهذه ميزة مختلفة عن نقل الجهاز بين العقد.
ماذا لو حذفنا الـ Pod الذي يعيش فيه الجهاز؟ What-if
في Kubernetes تعودنا أن حذف Pod لا يضر، لأن الـ Deployment ينشئ غيره. فهل الجهاز الافتراضي مثله؟ نحذف الـ virt-launcher ونراقب كل عشر ثوان تقريباً حالة الـ VM والـ VMI والـ Pods:
kubectl delete pod virt-launcher-cirros1-rvgrm --wait=false15:13:23
pod "virt-launcher-cirros1-rvgrm" deleted from default namespace
15:13:32 Running | cirros1 97s Running 10.42.0.32 | virt-launcher-cirros1-rvgrm Terminating
15:13:57 Running | cirros1 2m2s Failed kv | virt-launcher-cirros1-rvgrm Terminating
15:14:06 Running | cirros1 2m10s Failed kv |
15:15:58 Running | cirros1 4m4s Failed kv |
15:16:30 Starting | cirros1 22s Scheduled kv | virt-launcher-cirros1-kpmzl Running
15:17:02 Running | cirros1 67s Running 10.42.0.33 | virt-launcher-cirros1-kpmzl Runningوالأحداث بنفس الترتيب:
Warning   Stopped            virtualmachineinstance/cirros1   The VirtualMachineInstance crashed.
Normal    SuccessfulDelete   virtualmachine/cirros1           Stopped the virtual machine by deleting the virtual machine instance 988f6451-3668-44b2-ae17-a1ef3999c30b
Normal    SuccessfulCreate   virtualmachine/cirros1           Started the virtual machine by creating the new virtual machine instance cirros1
Normal    Created            virtualmachineinstance/cirros1   VirtualMachineInstance defined.
Normal    Started            virtualmachineinstance/cirros1   VirtualMachineInstance started.
في المخرج أعلاه لاحظ التالي:
- حذف الـ Pod قتل عملية QEMU معه، فالجهاز توقف فجأة كأنك فصلت الكهرباء عنه، وسجل KubeVirt ذلك بعبارة
The VirtualMachineInstance crashed. فالـ Pod هنا ليس نسخة يمكن استبدالها، وإنما هو الجهاز نفسه. - بقي الـ VMI بحالة Failed أكثر من دقيقتين، بينما الـ VM يقول Running، ثم أنشأ KubeVirt VMI جديداً بسبب
runStrategy: Always، وعاد الجهاز للعمل بعد نحو 3 دقائق و40 ثانية من الحذف، وبعنوان جديد مرة ثالثة10.42.0.33. - ما عاد هو إعادة تشغيل كاملة، وليس استمراراً، فكل ما كان في ذاكرة الجهاز ضاع، وهذا ما يفعله التوفر العالي في Harvester أيضاً عندما تسقط عقدة: يعيد تشغيل الجهاز على عقدة أخرى من قرصه في Longhorn، تماماً كما رأينا في Proxmox HA.
والدرس العملي: لا تقم بحذف Pods الأجهزة الافتراضية لتصلح مشكلة كما تفعل مع Pods التطبيقات، والسبب أنك تطفئ الجهاز فجأة. وإذا احتجت أن تفرغ عقدة من الأجهزة فاستخدم وضع الصيانة الذي ينقلها نقلاً حياً، أو أوقفها بـ virtctl stop حتى يطفئها نظامها بشكل صحيح.
ماذا لو طلبنا ذاكرة أكثر مما تملك العقدة؟ What-if
العقدة فيها نحو 5.8 GiB من الذاكرة، فنطلب جهازاً بذاكرة 16Gi:
apiVersion: kubevirt.io/v1
kind: VirtualMachine
metadata:
  name: too-big
spec:
  runStrategy: Always
  template:
    spec:
      domain:
        memory:
          guest: 16Gi
        devices:
          disks:
          - name: scratch
            disk: {bus: virtio}
      volumes:
      - name: scratch
        emptyDisk:
          capacity: 1Gi
NAME AGE STATUS READY
virtualmachine.kubevirt.io/too-big 40s ErrorUnschedulable False
virtualmachineinstance.kubevirt.io/too-big 40s Scheduling False
pod/virt-launcher-too-big-wkq4t 0/2 Pending 0 40s
memory: 16649Mi
Warning FailedScheduling 41s default-scheduler 0/1 nodes are available: 1 Insufficient memory. preemption: 0/1 nodes are available: 1 Preemption is not helpful for scheduling.في المخرج أعلاه لاحظ التالي:
- الرفض جاء من مجدول Kubernetes نفسه
default-scheduler، وليس من KubeVirt، لأن الجهاز في النهاية Pod يطلب 16649Mi، أي 16Gi مع Overhead قيمته 265Mi كما رأينا في الجهاز الصغير. فقواعد Kubernetes كلها، الطلبات Requests والحدود Limits والحصص ResourceQuota، تطبق على الأجهزة الافتراضية دون أي إعداد خاص. - حالة الـ VM
ErrorUnschedulableواضحة، والجهاز لا يبدأ أصلاً، وهذا أفضل من Hypervisor يشغل الجهاز ثم يبدأ يستخدم الـ Swap. - KubeVirt وحده لا يحمل الذاكرة فوق طاقتها Overcommit، فالذاكرة التي تطلبها للجهاز تحجز كاملة من العقدة. أما Harvester فيضيف فوقه إعداداً اسمه
overcommit-config، وقيمته الافتراضية حسب صفحة الإعدادات هي 1000% للمعالج و150% للذاكرة و100% للتخزين، أي أن المنصة تطلب من المجدول Scheduler ثلثي الذاكرة التي أعطيتها للجهاز فقط، فتقبل أجهزة مجموع ذاكرتها مرة ونصف ذاكرة العقدة. وهذا يزيد عدد الأجهزة، ولكنه يعني أن العقدة قد تنفد ذاكرتها فعلاً إذا استخدمت الأجهزة ما أعطيتها، فإذا كانت أجهزتك قواعد بيانات تستخدم كل ذاكرتها فاخفض النسبة إلى 100%.
الـ Snapshot على قرص محلي: نجاح خادع
نطلب Snapshot للجهاز بمورد VirtualMachineSnapshot:
apiVersion: snapshot.kubevirt.io/v1beta1
kind: VirtualMachineSnapshot
metadata:
  name: cirros1-snap1
spec:
  source:
    apiGroup: kubevirt.io
    kind: VirtualMachine
    name: cirros1
NAME SOURCEKIND SOURCENAME PHASE READYTOUSE CREATIONTIME ERROR
cirros1-snap1 VirtualMachine cirros1 Succeeded true 41s
Progressing=False Operation complete
Ready=True Ready
["NoGuestAgent","Online","PartialSnapshot"]
Succeeded
error: the server doesn't have a resource type "volumesnapshotclass"
{"excludedVolumes":["root"]}والنتيجة تبدو ناجحة: Succeeded وREADYTOUSE true. ولكن اقرأ السطرين الأخيرين جيداً، فالـ Snapshot وصف نفسه بأنه جزئي PartialSnapshot، والقرص الوحيد في الجهاز root موجود في قائمة الأقراص المستبعدة excludedVolumes. والسبب أن Snapshot القرص في Kubernetes تنفذه طبقة التخزين عبر CSI ومورد VolumeSnapshotClass، وlocal-path لا يدعم ذلك، بل إن نوع المورد نفسه غير موجود في العنقود. فالذي حفظه KubeVirt هو وصف الجهاز فقط، دون أي بيانات من قرصه.
ولاحظ أيضاً المؤشر NoGuestAgent، ومعناه أن الجهاز لا يشغل QEMU Guest Agent، فلا يستطيع KubeVirt أن يطلب من النظام داخل الجهاز أن يكتب ما في ذاكرته إلى القرص قبل الـ Snapshot، وحتى مع تخزين يدعم الـ Snapshots يكون الـ Snapshot في هذه الحالة كأنك فصلت الكهرباء في تلك اللحظة. وهذه الحالة سبب كاف لقاعدة واضحة: لا تعتمد على كلمة Succeeded في أي Snapshot حتى تتحقق من قائمة الأقراص التي دخلت فيه فعلاً، وجرب الاستعادة مرة على الأقل. وفي Harvester يدعم Longhorn الـ Snapshots عبر CSI، فيحفظ الأقراص فعلاً، وهذا من الأشياء التي تدفع ثمنها في طبقة التخزين.
نسخ القرص Clone: لماذا انتظر 15 دقيقة؟
بعد ذلك ننسخ قرص الجهاز الأول إلى قرص جديد بمورد DataVolume مصدره الـ PVC:
apiVersion: cdi.kubevirt.io/v1beta1
kind: DataVolume
metadata:
  name: cirros2-disk
spec:
  source:
    pvc:
      namespace: default
      name: cirros1-disk
  storage:
    storageClassName: local-path
    accessModes: ["ReadWriteOnce"]
    resources:
      requests:
        storage: 1Gi
وبعد ثماني دقائق كان القرص الجديد ما زال بهذه الحالة:
datavolume.cdi.kubevirt.io/cirros2-disk   WaitForFirstConsumer   N/A                   8m31s
persistentvolumeclaim/cirros2-disk   Pending                                                                          local-path     <unset>                 3m55s
وهذه نفس مشكلة البيضة والدجاجة: local-path لا ينشئ القرص حتى يطلبه Pod، والـ DataVolume وحده ليس له مستهلك. فأنشأنا جهازاً ثانياً cirros2 يستخدم هذا القرص، فبدأ النسخ، ثم توقف مرة أخرى، وهذه المرة كانت الأحداث واضحة:
Normal    CloneInProgress    datavolume/cirros2-disk             Cloning from default/cirros1-disk into default/cirros2-disk in progress
Warning   CloneSourceInUse   persistentvolumeclaim/cirros2-disk  pod default/virt-launcher-cirros1-kpmzl using PersistentVolumeClaim cirros1-disk
أي أن CDI يرفض أن ينسخ قرصاً يكتب فيه جهاز يعمل، والسبب أن النسخ هنا نسخ بالملفات Host-assisted Clone، يقرأ القرص من بدايته إلى نهايته، فإذا كتب الجهاز أثناء القراءة خرجت نسخة لا تطابق أي لحظة حقيقية. وعندما أوقفنا الجهاز الأول ظهر Pod المصدر 52ddca1a-...-source-pod وقرأ القرص، ثم اكتمل النسخ:
15:38:02
VM cirros1 was scheduled to stop
15:39:39 cirros2-disk   CloneInProgress   N/A         17m | cirros1 Stopped cirros2 Provisioning  | 52ddca1a-0dfc-4243-858d-08b6cd119154-source-pod Running cdi-upload-cirros2-disk Running
15:41:18 cirros2-disk   CloneInProgress   79.14%   1     18m
15:43:01 cirros2-disk   Succeeded   100.0%   1     20m
15:45:04 cirros2   13m   Running   10.42.0.39   kv    True
ثم دخلنا إلى الجهاز الجديد بعد أن أكمل إقلاعه:
cirros
 15:48:56 up 2 min,  0 users,  load average: 0.41, 0.33, 0.13
/dev/vda1               960.8M     43.9M    885.2M   5% /
في المخرج أعلاه لاحظ التالي:
- اسم الجهاز الجديد
cirrosمثل الأصل، لأن النسخ نسخ القرص كما هو، بالاسم والمفاتيح وكل ما فيه. وهذا سبب أن القوالب Templates في Harvester وProxmox تعتمد على cloud-init، حتى يأخذ كل جهاز جديد اسمه ومفاتيحه عند أول إقلاع، كما شرحنا في قوالب Proxmox مع cloud-init. - العمود
RESTARTSبقيمة 1، أي أن عملية النسخ أعيدت مرة، ثم نجحت. - في التخزين الذي يدعم CSI، مثل Longhorn وCeph RBD، ينفذ النسخ داخل طبقة التخزين نفسها Smart Clone، فيكون أسرع بكثير ولا يحتاج أن يقرأ القرص بالكامل، ولا يحتاج أن توقف الجهاز المصدر بالضرورة.
ماذا تعلمنا من المختبر عن Harvester؟
بعد هذه الخطوات تستطيع أن تقرأ Harvester بعين مختلفة، فكل ميزة في واجهته هي أحد الأشياء التي رأيناها هنا:
| ما رأيناه في المختبر | ما يقابله في Harvester |
|---|---|
| الجهاز عملية qemu-kvm داخل Pod اسمه virt-launcher، في Cgroup الـ Pod | كل جهاز في الواجهة Pod في Namespace، وحدوده حدود Kubernetes |
| الجهاز يطلب ذاكرته كاملة مع Overhead قيمته 265Mi، ويرفضه المجدول إذا لم تكف العقدة | Harvester يسمح افتراضياً بـ 150% من الذاكرة، فراجع النسبة واترك مكاناً لأجهزة عقدة غائبة |
| العنوان يتغير مع كل تشغيل على شبكة الـ Pods | شبكة الإدارة للأجهزة الداخلية، وشبكة VLAN للعناوين الثابتة |
| النقل الحي مرفوض لأن القرص ليس ReadWriteMany | Longhorn يعطي الأقراص التي يحتاجها النقل الحي ووضع الصيانة |
| الـ Snapshot حفظ الوصف فقط دون القرص | Longhorn مع CSI يحفظ الأقراص فعلاً، والـ Guest Agent يحسن جودتها |
| النسخ انتظر توقف المصدر وقرأ القرص كاملاً | النسخ داخل طبقة التخزين أسرع، والقوالب تعتمد على cloud-init |
| الضغط على المعالجات أسقط فحوص الـ Operators وانتخاب القائد Leader Election | عقد الإنتاج 16 نواة على الأقل، وجزء منها لمستوى الإدارة |
والنقطة الأخيرة تحتاج كلمة أخيرة، لأنها تكررت أكثر من أي مشكلة أخرى. فأثناء المختبر رأينا Controllers في KubeVirt وCDI تعيد تشغيل نفسها برسالة leader election lost، وk3s نفسه توقف ثلاث مرات برسالة Transaction commit failed من قاعدة بياناته، وكلها لنفس السبب: الطلبات إلى الـ API تأخرت أكثر من المهلة لأن المعالجات مشغولة. وكل Controller في Kubernetes يحتفظ بقفل Lease يجدده كل بضع ثوان، فإذا لم يستطع تجديده في الوقت أوقف نفسه حتى لا يعمل اثنان في نفس الوقت. وهذا تصميم صحيح، ولكنه يعني أن عقدة HCI مزدحمة لا تبطئ فقط، وإنما تبدأ مكوناتها تخرج وتعود، ولذلك لا تقم بتشغيل عقد Harvester أو Proxmox مع Ceph قريباً من 100% من معالجاتها، والسبب أن مستوى الإدارة والتخزين يعملان على نفس المعالجات، وهما أول من يتأثر.
Harvester أم Proxmox VE مع Ceph؟
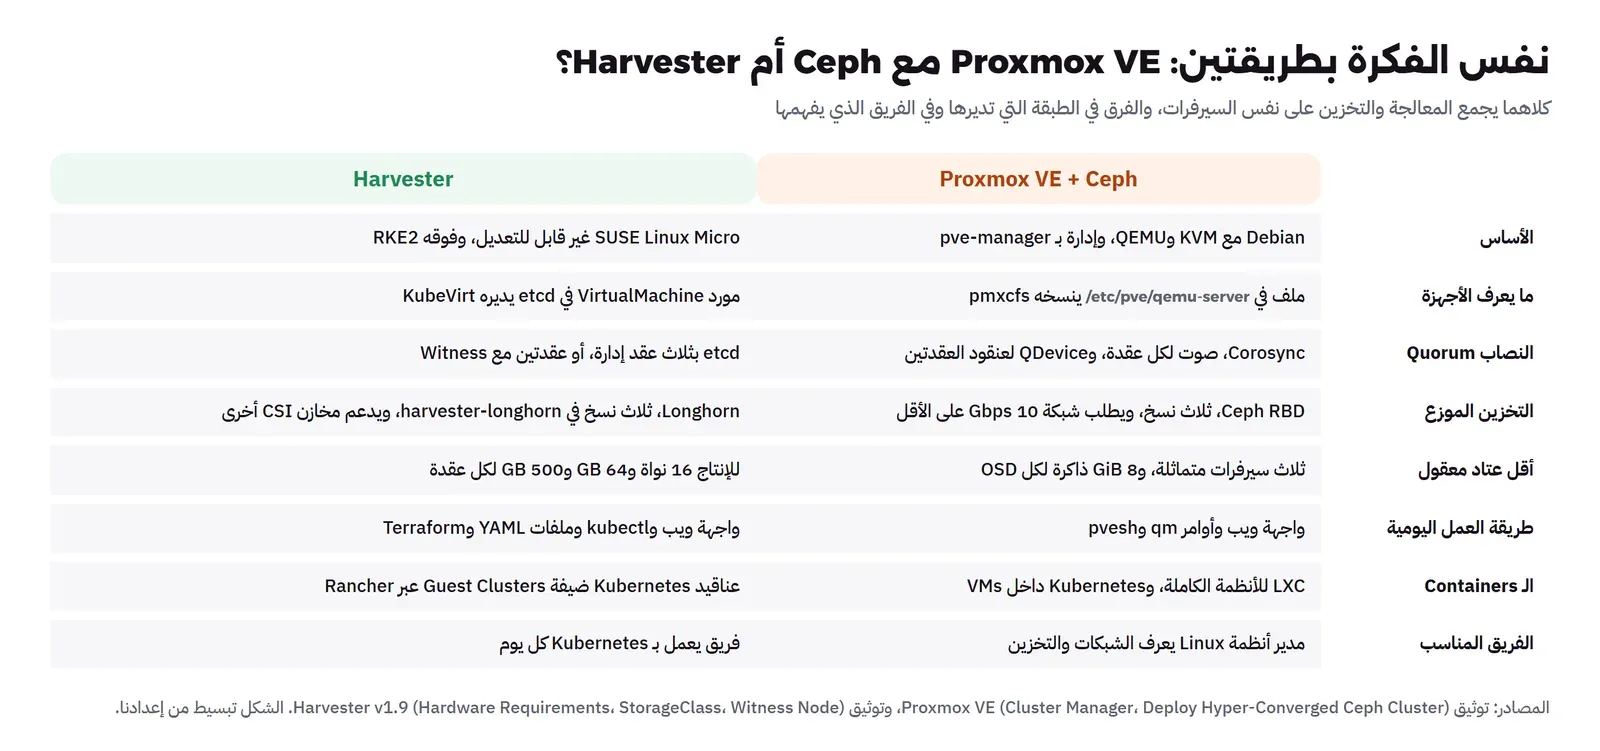
بعد أن رأيت الطبقات من الداخل، تستطيع أن ترى أن المنصتين تحلان نفس المشكلة بطريقتين مختلفتين جداً. فكلاهما يضع الأجهزة والتخزين على نفس السيرفرات، وكلاهما يستخدم KVM تحت الأجهزة، وكلاهما يحفظ ثلاث نسخ من كل قرص افتراضياً، ولكن الطبقة التي تديرها كل يوم مختلفة: في Proxmox أنت تدير Debian وملفات إعداد وأوامر qm وpvesh، وفي Harvester أنت تدير Kubernetes وموارد YAML. والصورة التالية تضع الفرق في بنود القرار:
Proxmox VE مع Ceph: نقاط القوة ونقاط الضعف
نقاط القوة:
- الأقرب لطريقة عمل فريق vSphere: جهاز افتراضي له قرص وشبكة وزر تشغيل، وواجهة تشبه ما تعودوا عليه، والانتقال موثق كما في الانتقال من VMware إلى Proxmox VE.
- متطلبات أقل، فعنقود من ثلاثة سيرفرات متوسطة يعمل جيداً، وتبدأ بسيرفر واحد بـ ZFS ثم تضيف Ceph عندما تحتاجه.
- Debian كامل تحت يدك، فتثبت أدوات المراقبة والنسخ الاحتياطي Backup وبرامج تشغيل العتاد كما تريد.
- Ceph ناضج ومستخدم في أحجام كبيرة جداً، ويعطيك تخزين كتل Block وملفات CephFS وكائنات من نفس العنقود.
- LXC للأنظمة الخفيفة بجانب الأجهزة الافتراضية، كما في LXC في Proxmox.
نقاط الضعف:
- Ceph نظام كبير له مفاهيمه الخاصة، وعندما يدخل في حالة HEALTH_WARN يحتاج من يفهمه، لا من يعرف الواجهة فقط.
- المرونة في Debian سلاح بحدين، فالسيرفرات تختلف مع الوقت إذا لم تدرها بأداة مثل Ansible.
- الأتمتة Automation ممكنة بالـ API وTerraform، ولكنها ليست الطريقة الأصلية للعمل كما في Kubernetes.
- تشغيل Kubernetes للفرق يعني أن تبني عناقيده داخل الأجهزة وتديرها كطبقة منفصلة.
Harvester: نقاط القوة ونقاط الضعف
نقاط القوة:
- كل شيء مورد Kubernetes، فالأجهزة والصور والشبكات توصف بملفات YAML، وتدار بنفس GitOps والأدوات التي يستخدمها الفريق للتطبيقات.
- العقد متماثلة دائماً بفضل النظام غير القابل للتعديل، والترقية تشمل كل الطبقات معاً بمسار واحد موثق.
- التكامل مع Rancher يجعل Harvester مزوداً لعناقيد Kubernetes الضيفة، ويعطيك المصادقة والصلاحيات وتعدد المستأجرين من مكان واحد.
- Longhorn أبسط في الفهم من Ceph لأن كل قرص افتراضي مستقل بمحركه ونسخه، وتراه في الواجهة قرصاً قرصاً.
- مخازن CSI خارجية مدعومة، فلست مجبراً على Longhorn إذا كان عندك تخزين جيد.
نقاط الضعف:
- متطلبات أعلى بوضوح: 16 نواة و64 GB لكل عقدة للإنتاج، لأن Kubernetes والتخزين والمراقبة وRancher الداخلي تعمل قبل أول جهاز.
- طبقات أكثر بين المشكلة وسببها: عطل في etcd أو في Longhorn أو في الـ CNI يظهر لك جهازاً افتراضياً لا يعمل، وتحتاج من يقرأ أحداث Kubernetes Events ليعرف السبب، كما سوف ترى في المختبر.
- الترقية كل أربعة أشهر، ولا رجوع عنها، ولا تقفز أكثر من إصدار فرعي واحد، فالتأخير يتراكم.
- فريق VMware التقليدي يحتاج وقتاً حتى يتقن Kubernetes، ولا يكفي أن يتعلم الواجهة.
- النظام مغلق أمام التعديل اليدوي، فبرنامج تشغيل عتاد غير مدعوم مشكلة حقيقية، لذلك تختار العتاد من قائمة معتمدة.
جدول القرار Decision Table
القرار هنا ليس بين منصة جيدة وأخرى سيئة، وإنما بين منصة تناسب فريقك وحجمك وأخرى لا تناسبهما. والجدول التالي يطبق ذلك على حالات شائعة:
| حالتك | الأنسب | والسبب |
|---|---|---|
| سيرفر واحد أو سيرفران، وعشرات الأجهزة | Proxmox VE بتخزين محلي ZFS ونسخ احتياطي | HCI تحتاج ثلاث عقد، وأقل من ذلك يعطيك تعقيد التخزين الموزع دون حمايته |
| ثلاثة سيرفرات أو أكثر، وفريق قادم من VMware، وأنظمة Windows وLinux تقليدية | Proxmox VE مع Ceph | نفس طريقة العمل، ومتطلبات أقل، وطريق انتقال موثق |
| فريق يدير عناقيد Kubernetes كل يوم، ويريد الأجهزة والـ Containers بنفس الأدوات | Harvester | الأجهزة تصبح موارد Kubernetes، وRancher يدير الكل |
| عنقود Kubernetes موجود بتخزين وشبكة جيدين، وأجهزة افتراضية قليلة | KubeVirt مباشرة على العنقود | لا تحتاج منصة HCI كاملة لتشغيل عشرة أجهزة بجانب التطبيقات |
| مواقع طرفية Edge صغيرة كثيرة تدار مركزياً | Harvester مع Rancher، أو Proxmox بعقدة واحدة لكل موقع | يعتمد على حجم العقدة، فمتطلبات Harvester قد تكون أكبر من الموقع |
| عشرات الفرق تحتاج حصصاً Quotas ومشاريع وفوترة داخلية | منصة سحابة خاصة فوق العقد | هذا دور OpenStack أو OpenNebula، وليس دور طبقة HCI وحدها |
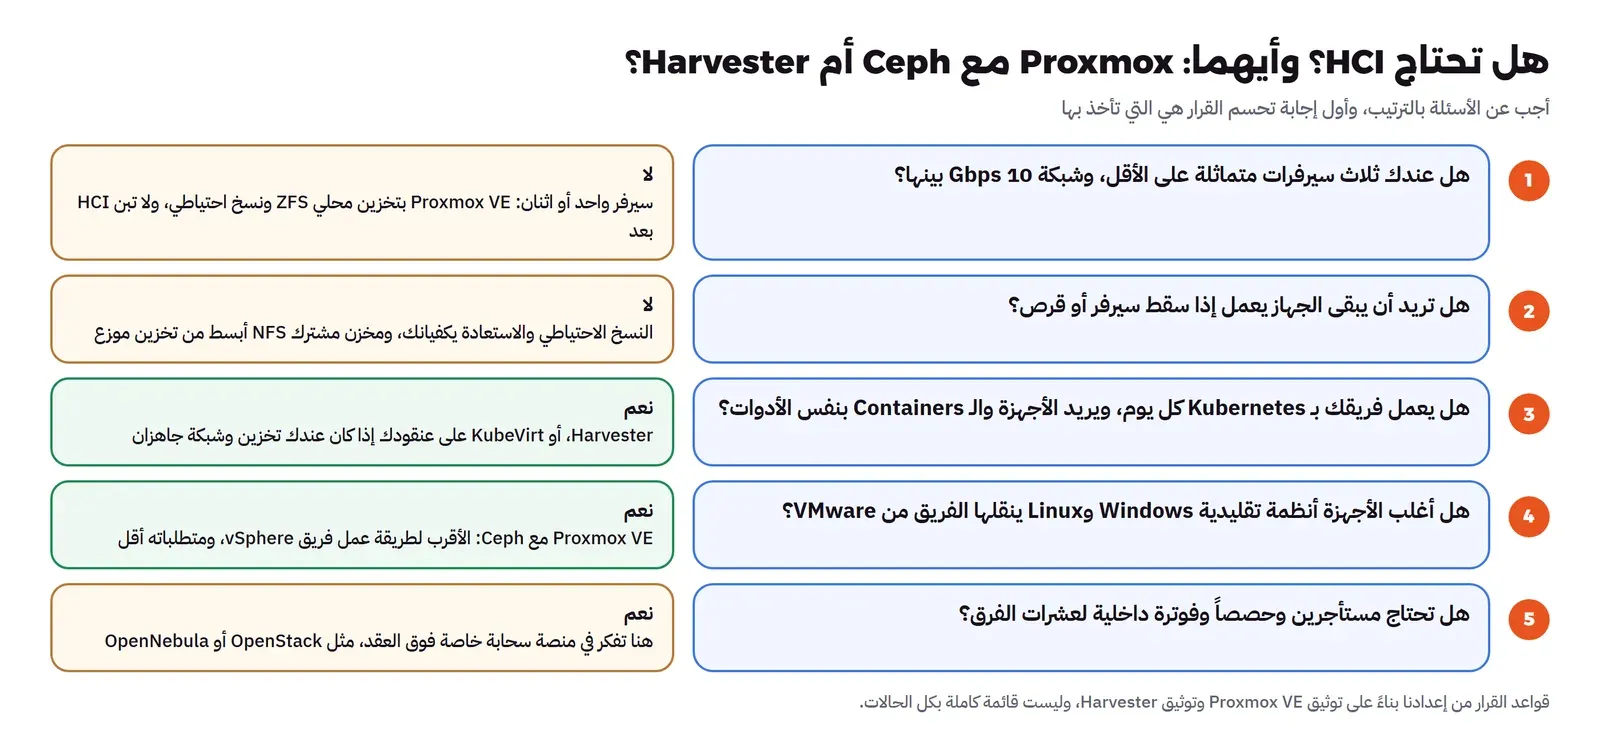
والصورة التالية تضع نفس القرار في أسئلة بالترتيب، وأول إجابة تحسم الأمر هي التي تأخذ بها:
أخطاء شائعة Common Mistakes
- HCI بسيرفرين: سيرفران لا يحملان ثلاث نسخ، ولا نصاباً موثوقاً، فإذا أردت HCI فابدأ بثلاثة، أو بسيرفرين مع شاهد كما يسمح Harvester وكما يفعل الـ QDevice في Proxmox.
- حساب المساحة الخام بدل الصافية: 46 TB من الأقراص بثلاث نسخ تعطيك أقل من 15.4 TB، وتحتاج هامشاً فارغاً لإعادة البناء، فاحسب الصافي قبل أن تعد به أحداً.
- شبكة 1 Gbps للتخزين: كل كتابة تذهب إلى عقدتين أخريين، وإعادة بناء قرص سقط تملأ الشبكة ساعات، فالتخزين الموزع على 1 Gbps يجعل كل الأجهزة بطيئة.
- اختيار Harvester لأنه «حديث»: إذا لم يكن في فريقك من يقرأ أحداث Kubernetes ويفهم etcd، فكل عطل صغير يصبح لغزاً، وProxmox مع Ceph أصعب من أن تستهين به أيضاً، ولكنه طبقة أقل.
- سيرفرات بمعالجات مختلفة: النقل الحي يرفض النقل بين معالجات بقدرات مختلفة، فالسيرفر الأحدث الذي أضفته بعد سنتين قد يصبح جزيرة، فاشتر على دفعات متماثلة.
- إهمال الترقيات: في Harvester ترقي إصداراً فرعياً واحداً في كل مرة، ولا رجوع، فعنقود متأخر سنة يحتاج ثلاث ترقيات متتالية بكل مخاطرها.
- إطفاء عقدتين للصيانة معاً: مع ثلاث نسخ على ثلاث عقد، عقدتان غائبتان تعنيان أن بعض الأقراص بنسخة واحدة أو دون نسخة متاحة، فسيرفر واحد في كل مرة، وانتظر حتى يعود التخزين سليماً.
- اعتبار HCI نسخة احتياطية: النسخ الثلاث تحميك من سقوط قرص أو سيرفر، لا من حذف ملف أو برنامج فدية Ransomware، لأن الحذف يصل إلى النسخ الثلاث في نفس اللحظة، لذلك تبقى النسخ الاحتياطية خارج العنقود.
قائمة تحقق Checklist قبل أن تبني HCI
- عندي ثلاث سيرفرات متماثلة على الأقل، بنفس المعالج ونفس الأقراص، أو عقدتان مع شاهد.
- حسبت المساحة الصافية بعد النسخ الثلاث، وتركت هامشاً فارغاً لإعادة البناء.
- شبكة التخزين 10 Gbps على الأقل، ومنفصلة عن شبكة الأجهزة، والـ Switch يدعم Trunk للـ VLANs.
- الذاكرة في كل سيرفر تكفي الأجهزة وبرنامج التخزين معاً، مع مكان لأجهزة سيرفر غائب.
- الأقراص SSD أو NVMe بأكثر من 5,000 IOPS، ومتصلة مباشرة دون RAID برمجي.
- العتاد مدعوم: UEFI لـ Harvester، وبطاقات شبكة وأقراص لها برامج تشغيل في النظام.
- في الفريق شخصان على الأقل يفهمان طبقة التخزين، Ceph أو Longhorn، وطبقة الإدارة، Corosync أو etcd.
- كتبت خطة الصيانة: عقدة واحدة في كل مرة، وكيف تتحقق أن التخزين عاد سليماً قبل العقدة التالية.
- عندي جدول ترقيات يناسب دورة المنصة، كل أربعة أشهر في Harvester.
- النسخ الاحتياطية خارج العنقود، وجربت استعادة جهاز منها مرة على الأقل.
- جربت المنصة على عتاد قريب من الإنتاج قبل أن أنقل إليها أي نظام حقيقي.
تدريب عملي Practice
- غير
runStrategyفي جهاز المختبر إلىManual، ثم احذف الـ virt-launcher كما فعلنا، ولاحظ أن الجهاز لا يعود هذه المرة، واشرح السبب. - أضف إلى الجهاز قرصاً ثانياً فارغاً بـ
emptyDisk، ثم ادخل إليه وابحث عن القرص بـlsblk، وأعد التشغيل وتحقق هل بقيت بياناته، ثم اقرأ في توثيق KubeVirt لماذا.
حذف المختبر Cleanup
kubectl delete vm cirros1 cirros2
kubectl delete dv cirros2-disk --ignore-not-found
kubectl delete vmsnapshot cirros1-snap1
kubectl delete -f https://github.com/kubevirt/containerized-data-importer/releases/download/v1.66.1/cdi-cr.yaml
kubectl delete -f https://github.com/kubevirt/kubevirt/releases/download/v1.10.0/kubevirt-cr.yaml
/usr/local/bin/k3s-uninstall.sh
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الحوسبة المتقاربة HCI تضع المعالجة والتخزين في نفس السيرفرات، وتحتاج ثلاث عقد متماثلة على الأقل وشبكة تخزين 10 Gbps أو أسرع، وتخسر فيها ثلثي المساحة الخام بثلاث نسخ.
- Proxmox VE مع Ceph هو الطريق الأقرب لفريق يأتي من VMware، بمتطلبات أقل وطبقات أقل، وقد شرحنا طبقاته في أدلته المستقلة.
- Harvester نظام كامل من ISO: SUSE Linux Micro غير قابل للتعديل، وRKE2، وKubeVirt، وLonghorn، وCanal مع Multus، وRancher، والإصدار الحالي v1.9.1 بتاريخ 10 نوفمبر 2026، ويطلب للإنتاج 16 نواة و64 GB و500 GB لكل عقدة.
- في المختبر رأينا أن الجهاز الافتراضي عملية qemu-kvm داخل Pod اسمه virt-launcher، بذاكرة إضافية 265Mi، وفي Cgroup الـ Pod، وأن حذف الـ Pod يطفئ الجهاز فجأة ويعيد تشغيله بعد نحو 3 دقائق و40 ثانية.
- القرص المحلي يمنع النقل الحي لأنه ليس ReadWriteMany، والـ Snapshot عليه يحفظ الوصف فقط، والنسخ ينتظر توقف المصدر، وكلها أسباب تجعل طبقة التخزين الموزع جزءاً أساسياً من HCI.
- الضغط على المعالجات يظهر أولاً في مستوى الإدارة: فحوص تفشل وانتخاب قائد يضيع، فلا تشغل عقد HCI قريباً من حدها.
- اختر Harvester إذا كان فريقك يعمل بـ Kubernetes كل يوم، وProxmox مع Ceph إذا كانت أغلب أجهزتك أنظمة تقليدية وفريقك قادم من VMware.
وفي المقال التالي بإذن الله نضع OpenStack وCloudStack وOpenNebula وProxmox في قرار واحد مبني على حجم الفريق وحجم البنية. وأقرب المقالات إلى هذا المقال:
 دليلعنقود Proxmox VE من ثلاث عقد: Quorum مع التوفر العالي HAبنينا عنقود Proxmox VE من ثلاث عقد، وقسنا النقل الحي والتوفر العالي بالثواني، ثم قطعنا الشبكة عن عقدة لنرى كيف يمنع النصاب الـ Split-brain.
 دليلالتخزين في Proxmox: ZFS أو LVM-thin أو NFS، ومتى Ceph؟بنينا أربعة مخازن على سيرفر Proxmox واحد وقسنا ما يأخذه القرص والـ Snapshot من كل منها، ثم ملأنا مخزناً رقيقاً عمداً لنرى ما يحدث للأجهزة عندما نعدها بأكثر مما نملك.
 دليلCeph للمبتدئين: تخزين موزع يتحمل تعطل السيرفراتكيف يوزع Ceph البيانات على عدة سيرفرات ويعيد نسخها وحده عندما يتعطل قرص، ومتى يكون أكبر من حاجتك.
 دليلبدائل VMware بعد Broadcom: أي منصة Virtualization تختار؟قارنا Proxmox VE وXCP-ng وIncus وOpenNebula وHarvester وHyper-V بالترخيص والتكلفة والنسخ الاحتياطي والتوفر العالي، ونقلنا جهازاً فعلياً من Proxmox VE إلى Incus لنرى كلفة الخروج.دليلOpenStack أم CloudStack أم OpenNebula أم Proxmox؟قرار السحابة الخاصة مبني على فريقك وحجمك وحاجتك إلى تعدد المستأجرين، مع معايير المقارنة وأسعار الدعم المنشورة وشجرة قرار ومثال لتكلفة سنة.
سجل التحديثات Changelog
- 2026-11-19: كتابة المقال، وتنفيذ المختبر على k3s v1.37.2+k3s1 مع KubeVirt v1.10.0 وCDI v1.66.1 وتخزين local-path في جهاز افتراضي Ubuntu 24.04، ومراجعة توثيق Harvester v1.9 وملاحظات إصدار v1.9.1 وتوثيق Proxmox VE في 19 نوفمبر 2026.