يطلب منك مدير القسم في اجتماع قصير أن تصمم نظام تتبع الشحنات للشركة: المندوب يمسح الشحنة في كل محطة، والعميل يكتب رقم التتبع فيرى أين شحنته، والمتاجر الكبيرة تريد أن تعرف الحالة من نظامها، و«نريد التصميم الأسبوع القادم». وتفتح ملفاً فارغاً أو تقف أمام سبورة بيضاء، وأول ما يخطر لك أسماء أدوات: Kafka للأحداث، وRedis للتخزين المؤقت، وربما Cassandra لأن البيانات «كبيرة». وبعد ساعة يكون عندك رسم جميل فيه عشرة صناديق وأسهم بينها، ولا تستطيع أن تجيب عن سؤال واحد بسيط: كم شحنة في اليوم؟ وهل تكفي قاعدة بيانات واحدة أم لا؟ ولماذا Kafka بالذات؟ ونفس الموقف يحدث في مقابلة تصميم الأنظمة System Design Interview، حيث يبدأ كثير من المتقدمين برسم الصناديق في الدقيقة الأولى، فيقضون الوقت كله في الدفاع عن قرارات لم يسألوا قبلها عن شيء.
والمشكلة هنا ليست في معرفة الأدوات، وإنما في غياب طريقة ثابتة تفكر بها، طريقة تبدأ من السؤال الصحيح وتنتهي بقرار تستطيع أن تشرح سببه بالأرقام. وقد رأينا في مدخل تصميم الأنظمة كيف ينمو التطبيق من سيرفر واحد إلى ملايين المستخدمين، وفي آخره قائمة قصيرة بخطوات أي تصميم، وهذا المقال يأخذ تلك القائمة ويحولها إلى طريقة كاملة من سبع خطوات، ثم يطبقها على نظام واحد من أول سؤال إلى آخر قرار، وهو نظام تتبع الشحنات نفسه، ثم يبني نموذجاً صغيراً Prototype على PostgreSQL ليتحقق من رقمين في التقدير قبل أن يبنى عليهما التصميم. وهذه نفس الطريقة التي سوف نستخدمها في كل دراسات الحالة القادمة، بدءاً من خدمة تقصير الروابط.
وسوف نناقش في هذا المقال ما يلي:
- لماذا تحتاج طريقة ثابتة، ومن أين جاءت الخطوات السبع.
- الخطوة الأولى: المتطلبات الوظيفية وغير الوظيفية Requirements والأسئلة التي تسألها قبل أي رسم.
- الخطوة الثانية: التقدير السريع Back-of-the-envelope Estimation بافتراضات مكتوبة، وبرنامج صغير يعيد الحساب.
- الخطوات الثالثة والرابعة والخامسة: الواجهة API ونموذج البيانات Data Model والتصميم عالي المستوى High-level Design.
- الخطوة السادسة: التعمق Deep Dives في النقاط الصعبة فقط.
- الخطوة السابعة: المفاضلات Trade-offs وكيف تكتبها حتى لا تنسى أسبابها.
- تجربة عملية تقيس حجم السجل الواحد على القرص وعدد الطلبات التي يتحملها PostgreSQL واحد بأداة pgbench، وتقارنها بالتقدير.
- قالب لوثيقة التصميم، وأخطاء شائعة، وقائمة تحقق.
لماذا تحتاج طريقة ثابتة للتصميم؟
التصميم الجيد ليس موهبة يملكها بعض المهندسين دون غيرهم، وإنما سلسلة من الأسئلة بترتيب صحيح، وكل سؤال يضيق الخيارات للسؤال الذي بعده. فإذا عرفت أن النظام يستقبل مئة كتابة في الثانية فقد استبعدت كثيراً من الحلول المعقدة قبل أن ترسم أي شيء، وإذا عرفت أن العميل يحتمل أن يرى حالة شحنته متأخرة دقيقة فقد فتحت الباب للتخزين المؤقت Caching والنسخ المتماثلة. والترتيب مهم لأن كل خطوة تبنى على ما قبلها، فلا معنى لاختيار قاعدة البيانات قبل أن تعرف نموذج البيانات، ولا لنموذج البيانات قبل أن تعرف ما الذي يسأل عنه المستخدم.
وهذه الخطوات ليست اختراعاً جديداً، فأغلب المراجع المعروفة تتفق عليها بأسماء مختلفة. فالكتاب الذي يعتمد عليه أغلب من يستعد للمقابلات اليوم، وهو System Design Interview لـ Alex Xu، يقسم الإجابة إلى أربع مراحل: فهم المشكلة وتحديد النطاق، ثم اقتراح تصميم عالي المستوى والاتفاق عليه، ثم التعمق في التصميم، ثم الختام بالمفاضلات والتحسينات. وكتاب Designing Data-Intensive Applications لـ Martin Kleppmann، الذي تجد صفحته في موقع الكتاب، يبدأ فصله الأول بتعريف الصفات الثلاث التي يقاس بها أي تصميم: الموثوقية Reliability، وقابلية التوسع Scalability، وسهولة الصيانة Maintainability، ويصر على أن تصف الضغط على نظامك بمعاملات محددة Load Parameters مثل الطلبات في الثانية ونسبة القراءة إلى الكتابة، وأن تقيس الأداء بالنسب المئوية Percentiles وليس بالمتوسط. أما فريق SRE في Google فقد خصص فصلاً كاملاً في كتابه الثاني The Site Reliability Workbook لما سماه تصميم الأنظمة الكبيرة غير المجرد Non-Abstract Large System Design، وفكرته أن التصميم لا يكتمل حتى تحسب كم سيرفراً وكم قرصاً وكم شبكة يحتاج، لأن التصميم الذي لا يمكن تحويله إلى قائمة مشتريات يبقى رسماً جميلاً لا أكثر.
والطريقة في هذا المقال تجمع هذه المصادر في سبع خطوات، والصورة التالية تبينها مع ما يخرج من كل خطوة:
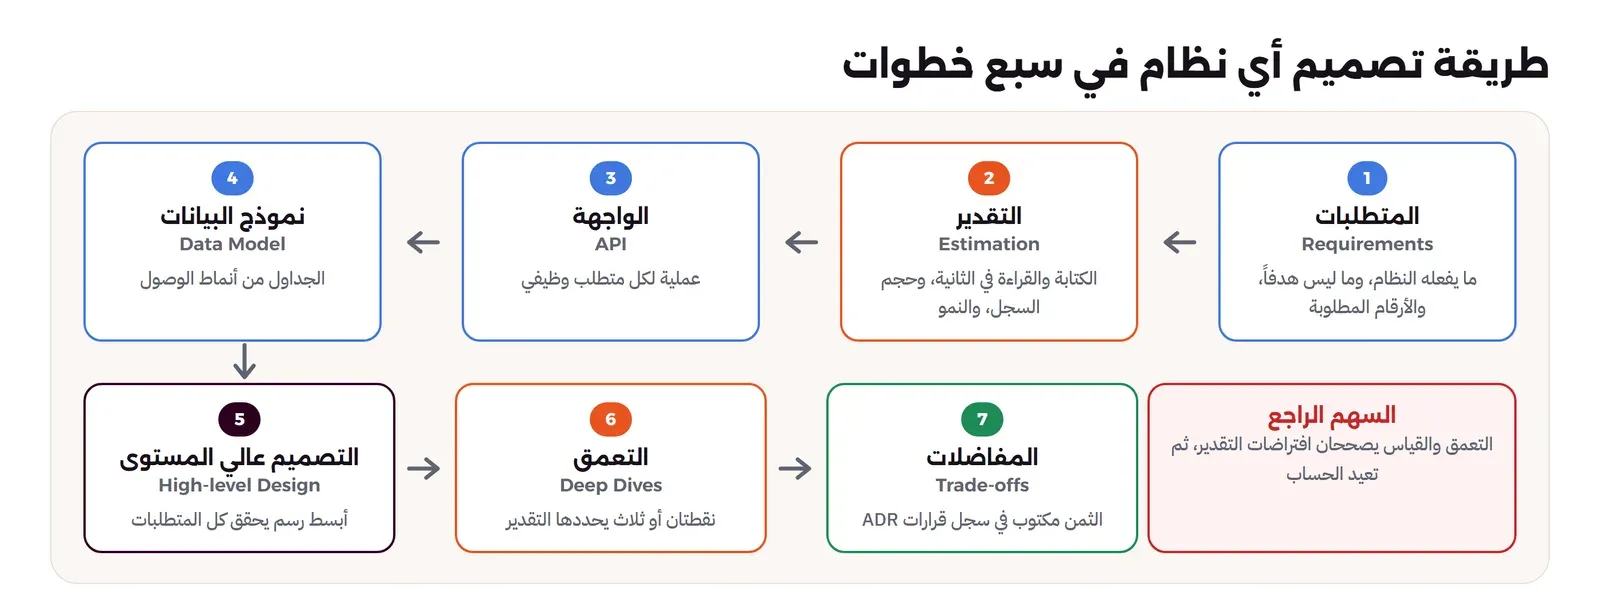
ولاحظ السهم الذي يعود من التعمق إلى التقدير، فالطريقة ليست خطاً مستقيماً تمشي فيه مرة واحدة، وإنما دورة صغيرة، وهذا ما يسميه فصل Google بالتكرار: تبدأ بتصميم يعمل على جهاز واحد بغض النظر عن الحجم، ثم تسأل هل يمكن أن يكون أفضل، ثم هل يمكن تنفيذه بالأرقام الحقيقية، ثم هل يصمد أمام الأعطال، وفي كل مرة تعود إلى الأرقام.
الخطوة الأولى: المتطلبات Requirements
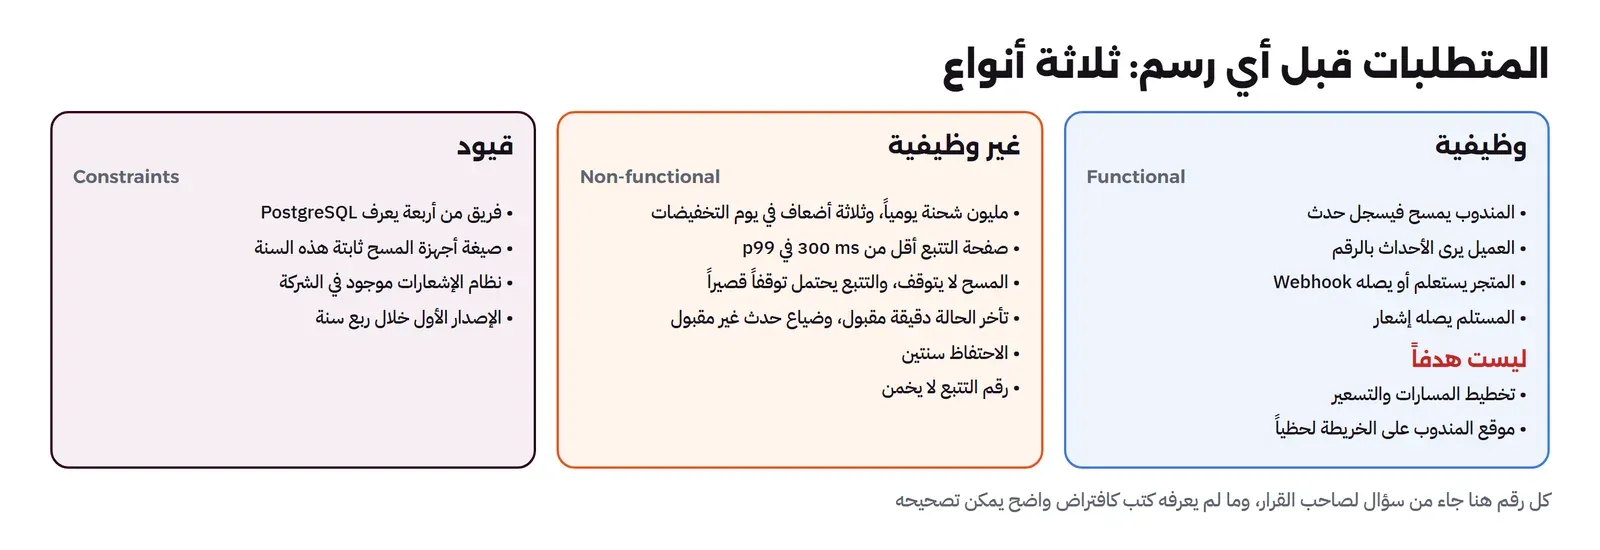
المتطلبات هي الخطوة التي يتجاوزها أغلب الناس لأنها تبدو بديهية، وهي في الحقيقة أهم خطوة، والسبب أن كل قرار لاحق يعتمد على إجابة سؤال هنا. وتنقسم إلى ثلاثة أنواع: المتطلبات الوظيفية Functional Requirements، أي ما يفعله النظام، والمتطلبات غير الوظيفية Non-functional Requirements، أي كيف يجب أن يفعله من حيث السرعة والتوفر والحجم، والقيود Constraints، أي ما لا تستطيع أن تغيره مثل الفريق والميزانية والأنظمة الموجودة.
المتطلبات الوظيفية Functional: ماذا يفعل النظام بالضبط؟
اكتبها جملاً قصيرة يبدأ كل منها بالمستخدم وينتهي بفعل يمكن اختباره، ثم اكتب بنفس الوضوح ما ليس في النطاق الآن. وفي نظام تتبع الشحنات خرجنا من الاجتماع الأول بالقائمة التالية:
- المندوب أو موظف المحطة يمسح الشحنة بجهاز المسح، فيسجل النظام حدثاً فيه الحالة والمحطة والوقت.
- العميل يكتب رقم التتبع في الموقع أو التطبيق، فيرى كل الأحداث مرتبة وآخر حالة.
- المتجر الكبير يستعلم عن حالة شحناته عبر API، أو يستقبل إشعاراً عندما تتغير الحالة.
- المستلم يصله إشعار عندما تخرج الشحنة للتوصيل وعندما تسلم.
- خارج النطاق الآن: تخطيط مسارات المندوبين، والتسعير، والفواتير، وتتبع موقع المندوب على الخريطة لحظة بلحظة.
والسطر الأخير مهم بقدر الأسطر التي قبله، لأن تتبع موقع المندوب على الخريطة يبدو قريباً من تتبع الشحنة، ولكنه نظام مختلف تماماً في حجمه وطبيعته، فهو آلاف التحديثات في الثانية لمواقع تتغير كل ثوان، وقد شرحناه في مقال الموقع اللحظي. ولو لم تكتبه خارج النطاق لوجدت نفسك تصمم النظامين معاً دون أن تقصد.
المتطلبات غير الوظيفية Non-functional: الأرقام التي تحدد التصميم
هنا تسأل الأسئلة التي تحدد شكل التصميم فعلاً، وكل سؤال منها يجب أن ينتهي برقم أو بقرار واضح:
- الحجم Scale: كم شحنة في اليوم الآن، وكم بعد سنتين، وما أكبر يوم في السنة؟ قالت الإدارة إنها مليون شحنة في اليوم، وإن يوم التخفيضات الوطني يصل إلى ثلاثة أضعاف.
- زمن الاستجابة Latency: صفحة التتبع يجب أن تفتح في أقل من 300 ملي ثانية في 99% من الطلبات، أي أن المقياس p99 وليس المتوسط.
- التوفر Availability: المسح لا يجب أن يتوقف أبداً، لأن المندوب لا يستطيع أن ينتظر، أما صفحة التتبع فتحتمل توقفاً قصيراً. وهذا الفرق وحده سوف يغير التصميم كما سوف نرى.
- الاتساق Consistency: هل يحتمل العميل أن يرى الحالة متأخرة؟ نعم، دقيقة أو دقيقتان لا تضر. هل يحتمل أن يضيع حدث مسح؟ لا، إطلاقاً، لأن الحدث هو الدليل على أن الشحنة سلمت.
- الاحتفاظ Retention: كم سنة نحفظ سجل الأحداث؟ قسم الشكاوى يحتاج سنتين على الأقل.
- الأمن والخصوصية: رقم التتبع يكفي لرؤية الحالة دون تسجيل دخول، لذلك لا يجب أن تظهر في الصفحة بيانات المستلم الشخصية، ولا يجب أن يكون رقم التتبع سهل التخمين.
ولاحظ أن كل رقم هنا جاء من سؤال لصاحب القرار، وليس من افتراضك أنت. وإذا لم يعرف صاحب القرار الإجابة، وهذا يحدث كثيراً، فاقترح رقماً واكتبه كافتراض واضح، مثل «نفترض أن العميل يفتح صفحة التتبع ست مرات للشحنة الواحدة»، حتى يستطيع أي شخص أن يصححه لاحقاً. وفي المقابلة يحدث نفس الشيء، فالمقيم ينتظر منك أن تسأل، وأن تقترح رقماً معقولاً عندما لا يعطيك رقماً، وأن تكتبه على السبورة.
القيود Constraints
القيود هي ما يجعل التصميم واقعياً، وأشهرها ثلاثة. الفريق: كم مهندساً سوف يبني النظام ويشغله، وما الذي يعرفونه، ففريق من أربعة يعرفون PostgreSQL جيداً سوف يشغل PostgreSQL أفضل كثيراً من Cassandra لم يشغله أحد منهم. والأنظمة الموجودة: أجهزة المسح ترسل البيانات بصيغة محددة لا يمكن تغييرها هذه السنة، ونظام الإشعارات موجود في الشركة. والمال والوقت: الميزانية والموعد الذي يجب أن يعمل فيه الإصدار الأول. وقد ناقشنا في مقال Monolith أم Microservices كيف يحدد حجم الفريق شكل المعمارية قبل أي اعتبار تقني، وهذا ينطبق هنا تماماً.
الخطوة الثانية: التقدير السريع Back-of-the-envelope
شرحنا فكرة التقدير السريع بمثال متجر في قسم التقدير في مدخل تصميم الأنظمة، وهنا نطبقها بطريقة أكثر انضباطاً: نكتب كل افتراض في سطر، ونحسب منه أربعة أرقام فقط، هي الكتابة في الثانية، والقراءة في الثانية، وحجم السجل الواحد، والنمو في اليوم. والسبب أن هذه الأربعة تكفي لتعرف أين تقع المشكلة الصعبة في أغلب الأنظمة، وأي رقم إضافي في هذه المرحلة غالباً تفاصيل لا تغير القرار. ولكي يعاد الحساب بسهولة عندما يتغير افتراض، كتبناه برنامجاً صغيراً بدلاً من ورقة:
# Back-of-the-envelope numbers for the parcel tracking service. Change an assumption and run it again.
DAY = 86_400
parcels_per_day   = 1_000_000   # parcels the company accepts per day
scans_per_parcel  = 8           # pickup, hubs, out for delivery, delivered...
views_per_parcel  = 6           # sender and receiver open the tracking page
api_per_parcel    = 4           # big senders poll our API for status
peak_factor       = 5           # busiest hour compared to the daily average
sale_day_factor   = 3           # a national sale day compared to a normal day
retention_days    = 365 * 2     # how long we keep scan history online

# bytes for one scan row in PostgreSQL, by hand:
#   tuple header 23 -> 24, data: id 8 + parcel_id 8 + status 2 (+2 pad) + hub_id 4 + courier_id 4 + at 8 = 36 -> 40
#   line pointer 4 in the page; then two B-tree entries: pkey (8 header + 8 key) and (parcel_id, at) (8 + 16)
row_bytes = 24 + 40 + 4
index_bytes = (8 + 8) + (8 + 16) + 2 * 4     # index tuples + their line pointers
scan_bytes = row_bytes + index_bytes

writes = parcels_per_day * scans_per_parcel
reads = parcels_per_day * (views_per_parcel + api_per_parcel)
print(f"scan writes per day      {writes:>14,}")
print(f"tracking reads per day   {reads:>14,}")
print(f"writes/s average, peak   {writes / DAY:>8.0f} {writes / DAY * peak_factor:>6.0f}   sale day peak {writes / DAY * peak_factor * sale_day_factor:.0f}")
print(f"reads/s  average, peak   {reads / DAY:>8.0f} {reads / DAY * peak_factor:>6.0f}   sale day peak {reads / DAY * peak_factor * sale_day_factor:.0f}")
print(f"bytes per scan (guess)   {scan_bytes:>14}   (row {row_bytes} + indexes {index_bytes})")
print(f"growth per day           {writes * scan_bytes / 1e9:>13.2f} GB")
print(f"after {retention_days} days         {writes * scan_bytes * retention_days / 1e12:>13.2f} TB")
وعند تشغيله:
docker run --rm -v "$PWD":/lab -w /lab python:3.13.18-slim python estimate.pyوالمخرج سوف يكون كما يلي:
scan writes per day           8,000,000
tracking reads per day       10,000,000
writes/s average, peak         93    463   sale day peak 1389
reads/s  average, peak        116    579   sale day peak 1736
bytes per scan (guess)              116   (row 68 + indexes 48)
growth per day                    0.93 GB
after 730 days                  0.68 TB
في المخرج أعلاه لاحظ التالي:
- مليون شحنة في اليوم رقم يبدو كبيراً، ولكنه يعني 93 كتابة في الثانية في المتوسط، و463 في ساعة الذروة، و1389 في ذروة يوم التخفيضات، وكل هذه الأرقام في حدود ما يتحمله سيرفر PostgreSQL واحد جيد كما سوف نتحقق في التجربة.
- القراءة قريبة من الكتابة هنا، وليست أضعافها كما في أغلب مواقع الويب، والسبب أن كل شحنة تمسح ثماني مرات ولا يفتحها أصحابها إلا عشر مرات تقريباً. وهذه معلومة تغير التصميم، لأن التخزين المؤقت وحده لا يحل نظاماً نصف ضغطه كتابة.
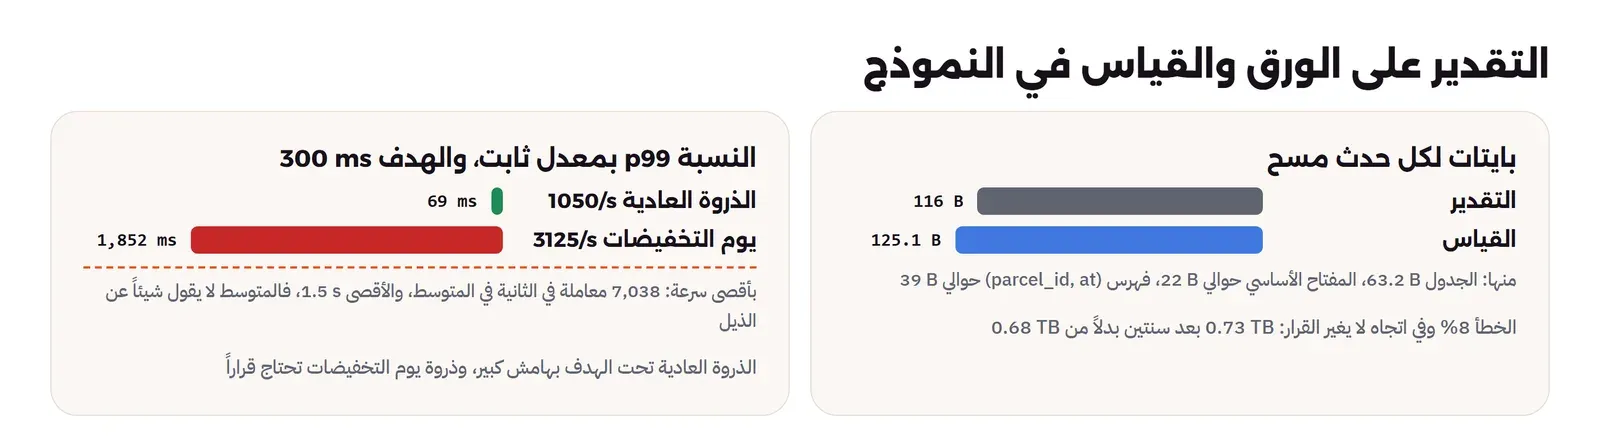
- حجم السجل الواحد حسبناه بيدنا من حجم كل عمود وترويسة الصف في PostgreSQL والفهرسين، فوصلنا إلى 116 بايتاً، وهذا الرقم هو أضعف رقم في الورقة، لأننا لم نحسب مساحة الصفحة الفارغة ولا تفاصيل الفهرس، ولذلك سوف نقيسه في التجربة.
- حوالي جيجابايت واحد في اليوم و0.68 تيرابايت بعد سنتين، أي أن سجل الأحداث هو الجزء الذي ينمو، وجدول الشحنات نفسه صغير بجانبه، وهذا يحدد أين تحتاج التقسيم Partitioning لاحقاً.
وقد يتساءل البعض: لماذا نحسب الذروة بخمسة أضعاف وليس بضعفين أو عشرة؟ والإجابة أن هذا افتراض، وأفضل مصدر له هو بيانات النظام الحالي إن وجد، مثل سجلات الخادم Logs أو لوحة المراقبة التي تبين الطلبات في كل ساعة، وإذا لم يوجد فخذ رقماً معقولاً واكتبه، فالمهم أن تكون الافتراضات مكتوبة في مكان يراه الجميع، لأن التقدير الذي لا تعرف افتراضاته لا يمكن مراجعته. ولاحظ أيضاً أن التقدير يجيب عن سؤال الحجم وليس سؤال الأداء، فهو يقول لك إن المشكلة مئات الطلبات في الثانية وليست مئات الآلاف، أما هل يتحمل سيرفرك هذه المئات فعلاً فهذا ما يجيب عنه القياس، وقد شرحنا كيف تخطط السعة من القياسات في مقال تخطيط السعة.
الخطوة الثالثة: الواجهة API
بعد أن تعرف ماذا يفعل النظام وكم مرة، تكتب الواجهة التي يدخل منها كل متطلب وظيفي، وكل سطر في قائمة المتطلبات يجب أن يقابله طلب في الواجهة. والهدف في هذه المرحلة أن تتفق على العمليات ومدخلاتها ومخرجاتها، وليس أن تكتب ملف OpenAPI كاملاً، وقد شرحنا تفاصيل التصميم الجيد للواجهات في مقال تصميم واجهات API. وفي نظام التتبع خرجت الواجهة كما يلي:
| العملية | الطلب | من يستدعيها | ملاحظة |
|---|---|---|---|
| تسجيل مسح | POST /v1/scans | أجهزة المسح | مع مفتاح Idempotency-Key لأن الجهاز يعيد الإرسال عندما تضعف الشبكة |
| صفحة التتبع | GET /v1/track/{tracking_no} | الموقع والتطبيق | لا تحتاج تسجيل دخول، وترجع الأحداث وآخر حالة فقط |
| حالة شحنات المتجر | GET /v1/parcels?sender=…&updated_since=… | أنظمة المتاجر | تقسيم بالمؤشر Cursor، ومفتاح API لكل متجر |
| إشعار تغير الحالة | Webhook إلى عنوان المتجر | نظامنا | بدلاً من أن يسأل المتجر كل دقيقة |
وفي الجدول أعلاه لاحظ أن الواجهة كشفت مشكلتين لم تظهرا في المتطلبات. الأولى أن أجهزة المسح تعمل في مستودعات وطرق شبكتها ضعيفة، فهي تعيد إرسال نفس المسح عندما لا يصلها الرد، لذلك يجب أن تكون عملية المسح آمنة عند التكرار، وهذا قرار في الواجهة قبل أن يكون في الكود. والثانية أن المتاجر الكبيرة إذا سألت عن حالة كل شحناتها كل دقيقة فسوف تضيف ضغطاً من القراءة لم نحسبه في التقدير، لذلك أضفنا الإشعار، ولهذا السبب افتراض api_per_parcel في البرنامج أربعة استعلامات للشحنة فقط وليس استعلاماً كل دقيقة. وهذا مثال على السهم الراجع في الطريقة: خطوة لاحقة تصحح افتراضاً في خطوة سابقة.
الخطوة الرابعة: نموذج البيانات Data Model
نموذج البيانات يجيب عن سؤالين: ما الكيانات التي يحفظها النظام وعلاقاتها، وما الاستعلامات التي يجب أن تكون سريعة. والسؤال الثاني هو الذي يحدد الفهارس وطريقة التقسيم وأحياناً نوع قاعدة البيانات، لذلك ابدأ دائماً من أنماط الوصول Access Patterns وليس من الجداول. وفي نظام التتبع نمطان فقط يمثلان أغلب الضغط: إضافة حدث مسح لشحنة، وقراءة كل أحداث شحنة واحدة مرتبة بالوقت. وكلاهما يبدأ من شحنة واحدة، ولا يوجد استعلام يجمع بين الشحنات في المسار السريع، وهذه أهم معلومة في النموذج كله، لأنها تعني أن البيانات يمكن تقسيمها حسب الشحنة إذا احتجنا ذلك يوماً دون أن يتعطل أي استعلام. والمخطط التالي هو ما خرجنا به:
-- Parcel tracking: one row per parcel, one row per scan
CREATE TABLE parcels (
    id            bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    tracking_no   text        NOT NULL UNIQUE,          -- what the customer types, e.g. AR4821937SA
    sender_id     bigint      NOT NULL,
    dest_city     smallint    NOT NULL,
    created_at    timestamptz NOT NULL DEFAULT now(),
    last_status   smallint    NOT NULL DEFAULT 0
);

CREATE TABLE scan_events (
    id         bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    parcel_id  bigint      NOT NULL,
    status     smallint    NOT NULL,                     -- 1 picked up, 2 at hub, 3 out for delivery, 4 delivered...
    hub_id     integer     NOT NULL,
    courier_id integer,
    at         timestamptz NOT NULL DEFAULT now()
);
CREATE INDEX scan_events_parcel_at ON scan_events (parcel_id, at);
في المخطط أعلاه لاحظ التالي:
- رقم التتبع الذي يراه العميل منفصل عن المفتاح الداخلي
id، فالمفتاح الداخلي رقم متسلسل صغير وسريع في الفهارس، ورقم التتبع نص بصيغة يحددها العمل، وقد شرحنا هذا الاختيار وأسبابه في مقال المعرفات الفريدة. - الفهرس
(parcel_id, at)يخدم استعلام صفحة التتبع كاملاً: يجد أحداث الشحنة ويعطيها مرتبة بالوقت دون عملية ترتيب إضافية، كما شرحنا في مقال الفهارس. - العمود
last_statusفي جدول الشحنات تكرار مقصود لمعلومة موجودة في الأحداث، والسبب أن قائمة شحنات المتجر تحتاج آخر حالة لآلاف الشحنات، وحسابها من الأحداث في كل طلب مكلف. وهذا التكرار له ثمن، فيجب أن يتغير مع كل حدث في نفس المعاملة Transaction. - الحالة رقم صغير
smallintوليست نصاً، لأن الجدول سوف يحمل مليارات الصفوف، وكل بايت يتكرر في كل صف.
وقد يتساءل البعض: لماذا لم نختر قاعدة بيانات للسلاسل الزمنية Time-series أو قاعدة NoSQL ما دامت البيانات أحداثاً متتالية؟ والإجابة أن الأرقام لم تطلب ذلك بعد، فمئات الكتابات في الثانية و0.68 تيرابايت بعد سنتين في حدود PostgreSQL مع التقسيم حسب الشهر، والفريق يعرفه، والجداول الأخرى في الشركة فيه. وهذا هو الفرق بين قرار مبني على الأرقام وقرار مبني على أن «الأحداث تذهب إلى Cassandra».
الخطوة الخامسة: التصميم عالي المستوى High-level Design
الآن فقط ترسم الصناديق، والقاعدة هنا أن ترسم أبسط تصميم يحقق كل المتطلبات الوظيفية، ثم تتأكد أن لكل متطلب مساراً واضحاً في الرسم، وتترك التحسينات للخطوة التالية. وفي نظام التتبع بدأنا بتطبيق واحد وقاعدة بيانات واحدة، ثم أضفنا ما فرضته المتطلبات غير الوظيفية فقط، فخرج التصميم كما في الصورة التالية:
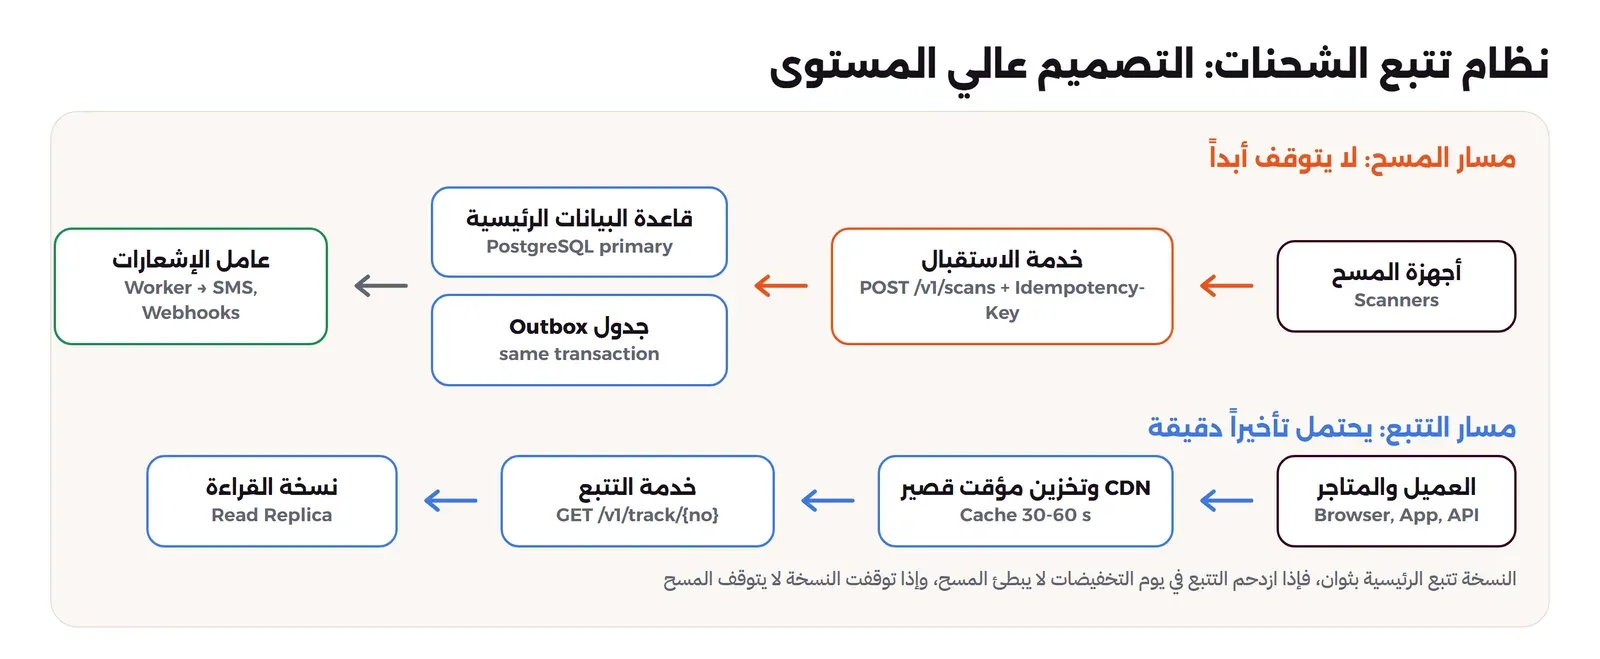
وفي التصميم أعلاه ثلاثة قرارات، وكل منها يعود إلى سطر في المتطلبات:
- فصل مسار المسح عن مسار التتبع: لأن المسح لا يجب أن يتوقف والتتبع يحتمل التوقف، فإذا ازدحمت صفحة التتبع في يوم التخفيضات فيجب ألا تبطئ المسح. لذلك المسح يكتب في القاعدة الرئيسية، والتتبع يقرأ من نسخة قراءة Read Replica مع تخزين مؤقت قصير، وهذا مقبول لأن العميل يحتمل تأخيراً دقيقة.
- الإشعارات خارج الطلب: إرسال الرسالة النصية وطلب Webhook للمتجر قد يتأخر ثوان أو يفشل، فلا يجب أن ينتظره جهاز المسح. لذلك يكتب المسح حدثاً في جدول Outbox في نفس المعاملة، ويرسله عامل Worker منفصل، وقد شرحنا هذا النمط في مقال Saga وOutbox.
- لا توجد خدمات مصغرة: خدمة الاستقبال وخدمة التتبع يمكن أن تكونا نفس التطبيق بمسارين مختلفين في البداية، والفصل في الرسم فصل في المسؤولية وليس بالضرورة في النشر.
الخطوة السادسة: التعمق Deep Dives
لا تتعمق في كل صندوق، وإنما في نقطتين أو ثلاث هي أصعب ما في النظام، والتقدير هو الذي يخبرك أين هي. والسؤال الذي تسأله لكل صندوق: ما أول ما يتعطل هنا إذا تضاعف الضغط عشر مرات؟ وما الذي يحدث إذا توقف هذا الصندوق تماماً؟ وفي نظام التتبع خرجت ثلاث نقاط:
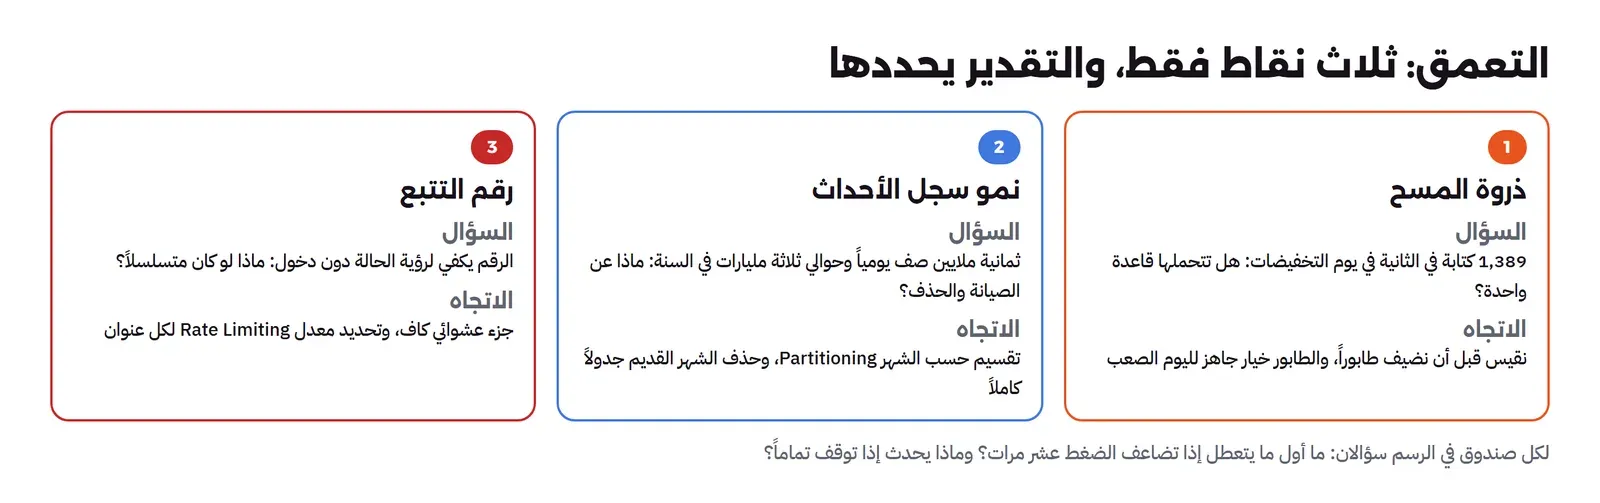
النقطة الأولى: ذروة المسح Peak في يوم التخفيضات
1389 كتابة في الثانية في الذروة، وكل كتابة معاملة فيها إدراج حدث وتعديل آخر حالة. وهنا خياران: أن تكتب مباشرة في قاعدة البيانات وتتأكد أنها تتحمل، أو أن تضع طابوراً Queue بين أجهزة المسح والقاعدة يمتص الذروة. والطابور يضيف نظاماً يجب أن تشغله ويجعل الحدث يتأخر قبل أن يظهر، لذلك لا تضعه إلا إذا قال القياس إن القاعدة لا تتحمل، وهذا بالضبط ما سوف نقيسه في التجربة.
النقطة الثانية: نمو سجل الأحداث
جدول يضاف إليه ثمانية ملايين صف في اليوم يصبح بعد سنة حوالي ثلاثة مليارات صف، والمشكلة ليست في الاستعلام عن شحنة واحدة، فالفهرس يجدها بسرعة مهما كبر الجدول، وإنما في الصيانة: VACUUM على جدول ضخم، والنسخ الاحتياطي، وحذف البيانات القديمة بعد سنتين. والحل المعروف هو تقسيم الجدول حسب الشهر Partitioning، فيصبح حذف شهر قديم حذفاً لجدول صغير بدلاً من مليارات أوامر DELETE، وقد شرحنا ذلك في مقال التقسيم Partitioning وSharding وفي مقال الجداول الضخمة في PostgreSQL.
النقطة الثالثة: رقم التتبع الذي يمكن تخمينه
رقم التتبع يكفي لرؤية الحالة دون تسجيل دخول، فإذا كان متسلسلاً يستطيع أي شخص أن يكتب برنامجاً يمر على كل الأرقام ويعرف عدد شحنات الشركة في اليوم ومواعيد التوصيل لكل مدينة. لذلك يجب أن يحمل رقم التتبع جزءاً عشوائياً كافياً، وأن تحد عدد الطلبات من كل عنوان Rate Limiting كما شرحنا في مقال تحديد معدل الطلبات. وسوف نرى نفس المشكلة بالأرقام في دراسة حالة خدمة تقصير الروابط.
ماذا يحدث عندما يتوقف كل صندوق؟ Failure Modes
آخر سؤال في التعمق هو السؤال الذي يسميه فصل Google بالصمود Resilience: مر على كل صندوق في الرسم، وافترض أنه توقف الآن، واكتب ما يحدث للمستخدم وما الذي يحميه. وهذا التمرين يكشف غالباً نقاط فشل واحدة Single Points of Failure لم ينتبه لها أحد، لأن الرسم يبين ما يحدث عندما يعمل كل شيء، ولا يبين ما يحدث عندما يتوقف شيء. وفي نظام التتبع خرج الجدول التالي:
| ما الذي توقف | ماذا يرى المستخدم | ما الذي يحميه |
|---|---|---|
| نسخة من خدمة الاستقبال | لا شيء، يعيد الجهاز الإرسال إلى نسخة أخرى | نسختان على الأقل خلف موزع الطلبات، ومفتاح Idempotency يمنع تكرار الحدث |
| القاعدة الرئيسية | المسح يفشل حتى تنتقل الرئيسية إلى النسخة الأخرى، وصفحة التتبع تعمل بحالة متأخرة | انتقال تلقائي Failover خلال أقل من دقيقة، والأجهزة تحفظ المسح محلياً وتعيد إرساله |
| نسخة القراءة | صفحة التتبع أبطأ قليلاً | التتبع ينتقل إلى الرئيسية مع حد أعلى لعدد الطلبات حتى لا يزاحم المسح |
| عامل الإشعارات | الرسالة النصية تتأخر | الأحداث باقية في جدول Outbox، ويرسلها العامل عندما يعود |
| مزود الرسائل النصية | الرسالة لا تصل في وقتها | إعادة المحاولة بانتظار متزايد، ومزود ثان عند الفشل الطويل |
| الشبكة في المستودع | لا شيء في اللحظة نفسها | الجهاز يحفظ المسح بوقته الحقيقي ويرسله لاحقاً، لذلك العمود at وقت المسح وليس وقت الوصول |
ولاحظ السطر الأخير، فهو قرار في نموذج البيانات خرج من سؤال عن الأعطال: إذا كان الجهاز قد يرسل المسح بعد ساعة، فيجب أن يحمل الحدث وقت المسح الحقيقي من الجهاز، وأن ترتب صفحة التتبع بهذا الوقت، وإلا ظهرت الشحنة «في الطريق» بعد أن «سلمت». وهذا مثال آخر على أن التعمق يعود إلى الخطوات السابقة ويصححها، وأن أسئلة الأعطال ليست مرحلة منفصلة بعد التصميم، وإنما جزء منه. ولكل سطر في الجدول ثمن، فالانتقال التلقائي يحتاج أداة مثل Patroni ومراقبة، والمزود الثاني للرسائل عقد ومال، لذلك قرر لكل سطر بحسب تكلفة التوقف الفعلية، كما شرحنا في مقال هل تحتاج التوفر العالي فعلاً.
الخطوة السابعة: المفاضلات Trade-offs
كل قرار في التصميم له ثمن، والمهندس الخبير ليس من يعرف الحل الصحيح، وإنما من يعرف ثمن كل حل ويقول لماذا يقبله. والمفاضلات التي تتكرر في كل تصميم تقريباً قليلة، وفيما يلي أشهرها مع القرار الذي اتخذناه في نظام التتبع:
| المفاضلة | ما نكسبه | ما ندفعه | قرارنا في نظام التتبع |
|---|---|---|---|
| الاتساق Consistency أم التوفر Availability | العميل يرى أحدث حالة دائماً | القراءة تتوقف عندما تتوقف القاعدة الرئيسية | التتبع يقرأ من نسخة متأخرة ثوان، والمسح يكتب في الرئيسية فقط |
| زمن الاستجابة Latency أم الإنتاجية Throughput | تجميع الكتابات في دفعات يرفع الإنتاجية | كل حدث ينتظر حتى تمتلئ الدفعة | كتابة مباشرة لكل مسح، لأن الأرقام لا تحتاج التجميع |
| البساطة أم المرونة | طابور بين المسح والقاعدة يمتص أي ذروة | نظام إضافي يشغل ويراقب، وتأخير قبل ظهور الحدث | بدون طابور الآن، ونضيفه إذا قال القياس ذلك |
| تكرار البيانات Denormalization أم التطبيع | قائمة المتجر سريعة من عمود واحد | يجب أن يبقى last_status متسقاً مع الأحداث | نكرر آخر حالة، ونغيرها في نفس المعاملة |
| البناء أم الشراء | تحكم كامل وتكلفة ثابتة | وقت الفريق في التشغيل | PostgreSQL على سيرفراتنا، والرسائل النصية عبر مزود خارجي |
والمهم ألا تبقى هذه القرارات في رأسك أو في محضر الاجتماع، والسبب أن من يأتي بعد سنة سوف يرى الطابور غير موجود فيظن أنكم نسيتموه، أو يرى العمود المكرر فيحذفه. لذلك اكتب كل قرار كبير في سجل قرارات المعمارية Architecture Decision Record واختصاراً ADR، فيه السياق والقرار والبدائل والثمن، كما شرحنا في مقال توثيق المعمارية.
تجربة عملية Lab: نتحقق من التقدير بنموذج صغير
في التقدير رقمان بني عليهما أغلب التصميم: 116 بايتاً لكل حدث مسح، وهو الرقم الذي يحدد حجم البيانات بعد سنتين، وأن سيرفر PostgreSQL واحداً يتحمل 463 كتابة و579 قراءة في الثانية في الذروة العادية، وهو الرقم الذي جعلنا نؤجل الطابور. وكلا الرقمين يمكن قياسه في أقل من ساعة، وهذا ما يسميه فصل Google بالانتقال من التصميم المجرد إلى غير المجرد: لا تبني نظاماً على رقم يمكنك أن تقيسه اليوم. والنموذج هنا ليس النظام، وإنما الجداول نفسها في قاعدة بيانات حقيقية، مع بيانات بحجم قريب من الواقع، واستعلامات بنفس شكل الاستعلامات الحقيقية.
ملفات التجربة
المخطط هو نفس الملف schema.sql الذي رأيته في خطوة نموذج البيانات، والملف load.sql يملأ الجدولين بمليون شحنة وثمانية ملايين حدث مسح، أي ما يعادل يوماً كاملاً من الأحداث:
-- 1,000,000 parcels and 8 scans for each one (8,000,000 rows)
INSERT INTO parcels (tracking_no, sender_id, dest_city, created_at)
SELECT 'AR' || lpad(g::text, 9, '0') || 'SA', 1 + g % 5000, 1 + g % 120, now() - interval '30 days' * random()
FROM generate_series(1, 1000000) g;

INSERT INTO scan_events (parcel_id, status, hub_id, courier_id, at)
SELECT p, s, 1 + (p * s) % 300, CASE WHEN s >= 6 THEN 1 + p % 9000 END, now() - interval '30 days' + interval '3 hours' * s
FROM generate_series(1, 1000000) p, generate_series(1, 8) s;

VACUUM ANALYZE parcels;
VACUUM ANALYZE scan_events;
والملف measure.sql يحسب الحجم الفعلي للجدول وكل فهرس، والبايتات لكل صف بالدالتين pg_relation_size وpg_total_relation_size الموثقتين في دوال الإدارة في PostgreSQL:
-- bytes per scan row: table only, each index, and everything together
SELECT count(*)                                                        AS rows,
       pg_size_pretty(pg_relation_size('scan_events'))                 AS heap,
       pg_size_pretty(pg_relation_size('scan_events_pkey'))            AS pkey,
       pg_size_pretty(pg_relation_size('scan_events_parcel_at'))       AS idx_parcel_at,
       round(pg_relation_size('scan_events')::numeric / count(*), 1)             AS heap_b_per_row,
       round(pg_total_relation_size('scan_events')::numeric / count(*), 1)       AS total_b_per_row
FROM scan_events;
والسكربت run.sh يشغل PostgreSQL 18 ويحمل البيانات ويقيس:
#!/usr/bin/env bash
# run.sh [ram]: starts PostgreSQL, loads 1,000,000 parcels and 8,000,000 scans, then measures bytes per row.
# With "ram" the data directory lives in memory (tmpfs), so every fsync returns at once.
set -e
EXTRA=""; [ "$1" = ram ] && EXTRA="--tmpfs /var/lib/postgresql:rw,size=8g"
docker run -d --name sw5-sdm-db -e POSTGRES_PASSWORD=lab -v "${LAB_DIR:-$PWD}":/lab:ro $EXTRA \
  postgres:18-alpine -c shared_buffers=512MB -c max_connections=200
until docker exec sw5-sdm-db pg_isready -U postgres -q; do sleep 1; done
sleep 2
docker exec sw5-sdm-db psql -U postgres -q -f /lab/schema.sql
time docker exec sw5-sdm-db psql -U postgres -q -f /lab/load.sql
docker exec sw5-sdm-db psql -U postgres -x -f /lab/measure.sql
ولقياس الطلبات في الثانية نستخدم أداة pgbench التي تأتي مع PostgreSQL، فهي لا تقيس جداولها الافتراضية فقط، وإنما تشغل أي سكربت SQL تكتبه، وتختار بينها بأوزان، وتستطيع أن ترسل الطلبات بمعدل ثابت كما يفعل المستخدمون الحقيقيون، كما يشرح توثيق pgbench. السكربت الأول scan.sql يمثل مسح المندوب، والثاني track.sql يمثل فتح صفحة التتبع:
-- a courier scans a parcel: add the event and update the parcel
\set p random(1, 1000000)
\set s random(1, 8)
BEGIN;
INSERT INTO scan_events (parcel_id, status, hub_id) VALUES (:p, :s, 1 + :p % 300);
UPDATE parcels SET last_status = :s WHERE id = :p;
COMMIT;
-- a customer opens the tracking page
\set n random(1, 1000000)
SELECT e.status, e.hub_id, e.at
FROM parcels p JOIN scan_events e ON e.parcel_id = p.id
WHERE p.tracking_no = 'AR' || lpad(:n::text, 9, '0') || 'SA'
ORDER BY e.at;والسكربت bench.sh يشغلهما معاً بنسبة أربعة مسوح لكل خمس زيارات، وهي نسبة الكتابة إلى القراءة من التقدير، ثم يحسب الوسيط p50 والنسبة p99 لكل سكربت من سجل pgbench لكل معاملة، لأن ملخص pgbench يعطي المتوسط فقط، والمتوسط كما يقول Kleppmann في فصله الأول يخفي ما يشعر به أبطأ المستخدمين:
#!/usr/bin/env bash
# bench.sh RATE CLIENTS: 4 scans for every 5 tracking views, at a fixed rate (0 = as fast as possible), 60 seconds.
# Prints pgbench's summary, then p50/p99 per script from the per-transaction log.
R=$1; C=$2
docker exec sw5-sdm-db sh -c "rm -f /tmp/pgb*; cd /tmp && pgbench -U postgres -n -M prepared -T 60 -c $C -j 4 \
  $( [ "$R" != 0 ] && echo "-R $R" ) -l --log-prefix=pgb -f /lab/scan.sql@4 -f /lab/track.sql@5 postgres" \
  | grep -E '^(number of tr|number of failed|latency average|rate limit|tps)'
for s in 0 1; do
  docker exec sw5-sdm-db sh -c "cat /tmp/pgb* | awk '\$4 == $s {print \$3}' | sort -n | awk -v s=$s '
    {a[NR] = \$1} END {printf \"%s  n=%d  p50=%.1fms  p99=%.1fms  max=%.1fms\n\",
      (s == 0 ? \"scan \" : \"track\"), NR, a[int(NR * .5)] / 1000, a[int(NR * .99)] / 1000, a[NR] / 1000}'"
done
الرقم الأول: كم بايتاً يأخذ حدث المسح؟
bash run.sh51423d7961de98927b6fd80d06213b1347a48fa88be2dade816f63678b1a8755
real 2m1.039s
user 0m0.075s
sys 0m0.107s
-[ RECORD 1 ]---+--------
rows | 8000000
heap | 483 MB
pkey | 171 MB
idx_parcel_at | 300 MB
heap_b_per_row | 63.2
total_b_per_row | 125.1في المخرج أعلاه لاحظ التالي:
- الجدول نفسه 63.2 بايتاً لكل صف، وكان تقديرنا 68، والفرق أن العمود
courier_idفارغ NULL في خمسة من كل ثمانية أحداث، وPostgreSQL لا يحجز مكاناً للقيمة الفارغة وإنما يسجلها في خريطة صغيرة في ترويسة الصف، كما يشرح توثيق شكل الصفحة. - الفهارس أكبر مما حسبنا: المفتاح الأساسي 171 ميجابايت أي حوالي 22 بايتاً لكل صف، والفهرس
(parcel_id, at)300 ميجابايت أي حوالي 39 بايتاً، وكنا قد حسبنا الاثنين معاً 48 بايتاً. والسبب أننا حسبنا حجم مدخل الفهرس ونسينا أن صفحات الفهرس لا تمتلئ كاملة، فهناك مساحة تتركها عمداً للإدراجات القادمة. - المجموع 125.1 بايتاً لكل حدث بدلاً من 116، أي أن التقدير أخطأ بحوالي 8%. وهذا خطأ جيد، لأنه في الاتجاه الذي لا يغير القرار: 125 بايتاً في ثمانية ملايين حدث يومياً تعني حوالي 1 جيجابايت في اليوم و0.73 تيرابايت بعد سنتين بدلاً من 0.68، وما زالت على سيرفر واحد مع التقسيم.
- لاحظ أن الفهرس الذي يخدم صفحة التتبع وحده أكبر من نصف حجم الجدول، فكل فهرس تضيفه لاحقاً «لأنه قد يفيد» له ثمن في المساحة وفي كل كتابة.
عدل الرقم في estimate.py إلى 125 وأعد التشغيل، فهذه هي الدورة الصغيرة التي تحدثنا عنها: القياس يصحح التقدير، والتقدير المصحح يتحقق منه القرار.
مشكلة واجهتنا: 24 معاملة في الثانية
أول تشغيل لأداة القياس بالمعدل المطلوب في الذروة العادية، 1050 معاملة في الثانية، أعطى هذه النتيجة:
number of transactions actually processed: 1612
number of failed transactions: 0 (0.000%)
latency average = 11465.219 ms
latency stddev = 16887.765 ms
rate limit schedule lag: avg 10823.831 (max 57807.837) ms
initial connection time = 89.103 ms
tps = 24.385571 (without initial connection time)
24 معاملة في الثانية بدلاً من 1050، والمتوسط 11 ثانية، والنتيجة لو صدقناها أن التصميم كله خطأ ونحتاج قاعدة بيانات موزعة. ولكن قبل أن تحكم على قاعدة البيانات اسأل: أين يذهب الوقت؟ ومعاملة المسح تنتهي بـ COMMIT، وPostgreSQL لا يؤكد COMMIT حتى يكتب سجل WAL على القرص ويطلب من نظام التشغيل أن يثبته بالأمر fsync، فإذا كان fsync بطيئاً فكل كتابة بطيئة مهما كانت قاعدة البيانات سريعة. والأداة pg_test_fsync التي تأتي مع PostgreSQL تقيس ذلك مباشرة على نفس المجلد:
docker exec sw5-sdm-db sh -c 'cd /var/lib/postgresql && pg_test_fsync -s 2'Compare file sync methods using one 8kB write:
(in "wal_sync_method" preference order, except fdatasync is Linux's default)
open_datasync 59.537 ops/sec 16796 usecs/op
fdatasync 71.484 ops/sec 13989 usecs/op
fsync 243.363 ops/sec 4109 usecs/op
fsync_writethrough n/aالطريقة التي يستخدمها PostgreSQL على Linux افتراضياً هي fdatasync، وكانت 71 عملية في الثانية فقط، أي 14 ملي ثانية لكل تثبيت. وأقراص NVMe في السيرفرات التي فيها حماية من انقطاع الكهرباء Power Loss Protection تعطي آلاف العمليات في الثانية، لأنها تؤكد الكتابة من ذاكرتها المحمية دون انتظار الخلايا. والدرس هنا أكبر من هذا الجهاز: رقم الكتابة في أي نموذج لا معنى له قبل أن تعرف fsync القرص الذي يعمل عليه، لذلك شغل pg_test_fsync على سيرفر الإنتاج المرشح قبل أي قياس.
ولكي نقيس حدود PostgreSQL نفسه دون القرص، شغلناه مرة ثانية ومجلد البيانات في الذاكرة tmpfs، وهو ما يفعله run.sh ram، فأصبح fsync كما يلي:
Compare file sync methods using one 8kB write:
(in "wal_sync_method" preference order, except fdatasync is Linux's default)
        open_datasync                                  n/a*
        fdatasync                        205826.472 ops/sec       5 usecs/op
        fsync                            168878.305 ops/sec       6 usecs/op
        fsync_writethrough                              n/a
تثبيت في 5 ميكروثانية، وهذا أسرع من أي قرص حقيقي، فما نقيسه بعد ذلك هو الحد الأعلى للمعالج والذاكرة، وليس رقماً تعده للإنتاج. ولا تستخدم tmpfs لقاعدة بيانات حقيقية، فكل البيانات تضيع مع أول إعادة تشغيل.
الرقم الثاني: هل يتحمل سيرفر واحد الذروة؟
bash run.sh ram
bash bench.sh 1050 16    # normal peak: 463 scans + 579 views per second
bash bench.sh 3125 32    # sale day peak: three times more
bash bench.sh 0 32       # as fast as possible
### bash bench.sh 1050 16
number of transactions actually processed: 63000
number of failed transactions: 0 (0.000%)
latency average = 4.338 ms
rate limit schedule lag: avg 2.249 (max 177.649) ms
tps = 1050.233624 (without initial connection time)
scan n=28160 p50=1.0ms p99=69.1ms max=202.6ms
track n=34840 p50=0.6ms p99=62.3ms max=271.9ms
### bash bench.sh 3125 32
number of transactions actually processed: 187405
number of failed transactions: 0 (0.000%)
latency average = 136.780 ms
rate limit schedule lag: avg 132.219 (max 2471.859) ms
tps = 3113.791056 (without initial connection time)
scan n=83479 p50=4.4ms p99=1851.8ms max=2523.6ms
track n=103926 p50=2.3ms p99=1857.7ms max=2497.9ms
### bash bench.sh 0 32
number of transactions actually processed: 423375
number of failed transactions: 0 (0.000%)
latency average = 4.547 ms
tps = 7037.917281 (without initial connection time)
scan n=188075 p50=2.4ms p99=60.3ms max=1525.5ms
track n=235300 p50=0.7ms p99=25.3ms max=1533.7msفي المخرج أعلاه لاحظ التالي:
- في الذروة العادية خدم PostgreSQL المعدل المطلوب كاملاً، 1050 معاملة في الثانية، والوسيط 1 ملي ثانية للمسح و0.6 للتتبع، والنسبة p99 حوالي 69 و62 ملي ثانية، وهي أقل كثيراً من هدف 300 ملي ثانية. وهذا يؤكد قرار البدء دون طابور.
- في ذروة يوم التخفيضات وصل المعدل تقريباً إلى المطلوب، 3114 من 3125، والوسيط ما زال بضع ملي ثوان، ولكن النسبة p99 قفزت إلى 1.85 ثانية. أي أن واحداً من كل مئة مندوب ينتظر قرابة ثانيتين، وهذا مخالف للهدف.
- بأقصى سرعة وصل إلى 7038 معاملة في الثانية في المتوسط، وهو رقم يغريك بأن تقول إن السيرفر يتحمل ضعف ذروة يوم التخفيضات، ولكن لاحظ أن الأقصى في هذا التشغيل 1.5 ثانية.
وقد يتساءل البعض: كيف يتحمل السيرفر 7000 معاملة في الثانية ويفشل في هدف زمن الاستجابة عند 3125؟ والإجابة أن الرقمين يقيسان شيئين مختلفين. فالتشغيل بأقصى سرعة يقيس كم معاملة تنتهي في المتوسط، والكلاينتات فيه تنتظر بعضها، فإذا توقف السيرفر ثانية فإنها تتوقف معه ولا تضيف طلبات جديدة. أما التشغيل بمعدل ثابت فيشبه المستخدمين الحقيقيين الذين لا ينتظرون بعضهم، فإذا توقف السيرفر ثانية تراكمت خلفه 3000 معاملة، وكل معاملة بعدها تنتظر حتى ينتهي هذا الطابور. ولهذا السبب لا تحكم على السعة من أقصى إنتاجية Throughput، وإنما من المعدل الذي تبقى فيه p99 تحت الهدف، كما شرحنا في مقال تخطيط السعة.
وكان أول ما شككنا فيه نقاط الحفظ Checkpoints، لأن سجل PostgreSQL أظهر نقطة حفظ كل بضع ثوان بالسبب checkpoint starting: wal، أي أن الإعداد max_wal_size بقيمته الافتراضية 1GB يمتلئ بسرعة مع هذا المعدل من الكتابة:
2026-11-18 12:23:27.466 UTC [74] LOG:  checkpoint complete: wrote 26859 buffers (41.0%), wrote 0 SLRU buffers; 0 WAL file(s) added, 0 removed, 33 recycled; write=13.231 s, sync=0.001 s, total=13.235 s; sync files=8, longest=0.001 s, average=0.001 s; distance=536100 kB, estimate=545174 kB; lsn=0/A2D68CC8, redo lsn=0/85177048
2026-11-18 12:23:29.745 UTC [74] LOG:  checkpoint starting: wal
2026-11-18 12:23:33.907 UTC [74] LOG:  checkpoint complete: wrote 45894 buffers (70.0%), wrote 1 SLRU buffers; 0 WAL file(s) added, 0 removed, 33 recycled; write=4.157 s, sync=0.001 s, total=4.163 s; sync files=13, longest=0.001 s, average=0.001 s; distance=542516 kB, estimate=544908 kB; lsn=0/C495CF70, redo lsn=0/A6344418
2026-11-18 12:23:34.091 UTC [74] LOG:  checkpoint starting: wal
فرفعنا max_wal_size إلى 4GB وcheckpoint_timeout إلى 15 دقيقة وأعدنا القياس، والجزء المهم من النتيجة قبل التغيير وبعده:
docker exec sw5-sdm-db psql -U postgres -c "ALTER SYSTEM SET max_wal_size = '4GB'" \
  -c "ALTER SYSTEM SET checkpoint_timeout = '15min'" -c "SELECT pg_reload_conf()" -c "CHECKPOINT"
bash bench.sh 3125 32
### before: max_wal_size = 1GB, checkpoint_timeout = 5min
number of transactions actually processed: 186795
number of failed transactions: 0 (0.000%)
latency average = 136.283 ms
rate limit schedule lag: avg 130.621 (max 1917.088) ms
tps = 3111.333211 (without initial connection time)
scan n=83079 p50=17.1ms p99=1492.3ms max=1922.7ms
track n=103716 p50=10.9ms p99=1478.6ms max=1921.6ms
### after: max_wal_size = 4GB, checkpoint_timeout = 15min
number of transactions actually processed: 182332
number of failed transactions: 0 (0.000%)
latency average = 1228.939 ms
rate limit schedule lag: avg 1219.964 (max 4754.751) ms
tps = 3041.837579 (without initial connection time)
scan n=81120 p50=670.4ms p99=4602.1ms max=4885.5ms
track n=101212 p50=663.0ms p99=4595.6ms max=4794.6msلم يتحسن الذيل، بل كان أسوأ في هذا التشغيل، وفي خمسة تشغيلات بمعدل 3125 كانت النسبة p99 بين 0.76 و4.6 ثانية. أي أن نقاط الحفظ لم تكن السبب الرئيسي، وأن هذا المعدل قريب من حد هذا الجهاز بحيث يكفي أي توقف قصير لصنع طابور طويل. وهذه نتيجة مفيدة للتصميم أكثر من أي رقم دقيق، لأنها تقول إن ذروة يوم التخفيضات هي المكان الذي يحتاج قراراً، وإن القرار يجب أن يقاس على السيرفر المرشح للإنتاج قبل أن يتخذ.
ماذا غيرت التجربة في التصميم؟
هذا هو السهم الراجع في الطريقة بالأرقام، فبعد ساعة من القياس تغيرت ثلاثة أشياء في وثيقة التصميم:
- حجم الحدث في التقدير أصبح 125 بايتاً، والفهارس مكتوبة كجزء من حساب المساحة وليست تفصيلاً.
- قرار «بدون طابور» أصبح «بدون طابور في الأيام العادية، وخطة ليوم التخفيضات»: إما أن تكتب أجهزة المسح في طابور يمتص الذروة ثم يكتب في قاعدة البيانات بدفعات، أو سيرفر أكبر نقيسه بنفس الأداة قبل الموسم. واخترنا أن نبني مسار الطابور كخيار يفعل بإعداد، لأن تكلفته أقل من سيرفر أكبر طوال السنة لأجل يوم واحد.
- أضفنا إلى قائمة التحقق قبل الإنتاج: قياس
pg_test_fsyncعلى السيرفر المرشح، وتشغيلbench.sh 3125عليه بعد تعبئة بيانات سنة.
حذف المختبر Cleanup
docker rm -f sw5-sdm-dbقالب وثيقة التصميم Design Doc
الطريقة تخرج في النهاية وثيقة واحدة يقرؤها الفريق ويعلق عليها قبل أن يكتب أحد سطر كود، وكثير من الشركات تسميها وثيقة التصميم Design Doc أو طلب التعليقات RFC. والقالب التالي يتبع الخطوات السبع نفسها، وطوله في نظام بحجم نظام التتبع بين خمس وعشر صفحات:
- السياق والمشكلة: فقرة واحدة تقول لماذا نبني هذا الآن، ومن يستفيد.
- الأهداف وما ليس هدفاً Goals and Non-goals: المتطلبات الوظيفية، وقائمة صريحة بما هو خارج النطاق.
- المتطلبات غير الوظيفية: الأرقام المتفق عليها لزمن الاستجابة والتوفر والاتساق والاحتفاظ، ومن وافق عليها.
- التقدير: الافتراضات سطراً سطراً، والأرقام الأربعة، ورابط البرنامج الذي يعيد الحساب.
- الواجهة ونموذج البيانات: جدول العمليات، والمخطط، وأنماط الوصول التي بني عليها.
- التصميم عالي المستوى: رسم واحد، ولكل صندوق جملة تقول لماذا هو موجود.
- التعمق: النقاط الصعبة فقط، ولكل نقطة البدائل التي درستها.
- المفاضلات والبدائل المرفوضة: لماذا لم نختر Cassandra، ولماذا لا يوجد طابور الآن، بأسباب مكتوبة.
- التحقق: ما الذي قسناه في النموذج، وما الذي يجب قياسه قبل الإنتاج.
- التشغيل: المراقبة والتنبيهات، والنسخ الاحتياطي، والنشر، وماذا يحدث عندما يتوقف كل جزء.
- الأسئلة المفتوحة: ما لم نقرره بعد، ومن سوف يقرره، ومتى.
وأهم قسم في القالب ليس الرسم كما يظن كثيرون، وإنما قسم ما ليس هدفاً وقسم البدائل المرفوضة، لأنهما ما يمنع الفريق من إعادة نفس النقاش بعد ستة أشهر، ولأن المراجع الذي يقرأ الوثيقة يجد فيهما بسرعة الافتراض الذي لا يوافق عليه.
ونفس الطريقة في مقابلة تصميم الأنظمة System Design Interview
المقابلة نسخة مضغوطة من نفس الطريقة في 45 دقيقة تقريباً، والفرق أن صاحب القرار هو المقيم، والسبورة هي الوثيقة. وتوزيع الوقت الذي يعمل عند أغلب الناس: خمس دقائق للمتطلبات بالأسئلة، وخمس للتقدير بأرقام مقربة على السبورة، وعشر للواجهة ونموذج البيانات والرسم، وعشرون للتعمق في نقطتين يختارهما المقيم أو تقترحهما أنت، وخمس للمفاضلات وما تفعله لو تضاعف الحجم. والخطأ الأشهر أن تتجاوز الدقائق العشر الأولى لتصل إلى الرسم بسرعة، فتقضي الوقت الباقي في تصميم نظام لم يطلبه أحد. وسوف نفصل طريقة التفكير بصوت عال في المقابلة في مقال مستقل.
أخطاء شائعة Common Mistakes
- البدء بالأدوات: «نستخدم Kafka» قبل أن تعرف كم حدثاً في الثانية، والقرار الصحيح يأتي من الأرقام وليس من الأسماء.
- متطلبات بلا أرقام: «سريع» و«متاح دائماً» لا يمكن تصميمها ولا قياسها، و«300 ملي ثانية في p99» يمكن.
- نسيان ما ليس هدفاً: فتجد نفسك تصمم تتبع موقع المندوب لحظياً داخل نظام تتبع الشحنات.
- افتراضات غير مكتوبة: التقدير الذي لا تعرف افتراضاته لا يمكن مراجعته ولا تصحيحه.
- التعمق في كل شيء: الوقت محدود، والنقاط الصعبة اثنتان أو ثلاث يحددها التقدير.
- معاملة نفس النظام كجزء واحد: المسح لا يتوقف أبداً والتتبع يحتمل التوقف، وفصل المسارين كان أهم قرار في التصميم.
- الحكم على السعة من أقصى إنتاجية: 7000 معاملة في الثانية بأقصى سرعة لم تمنع p99 من تجاوز ثانية عند 3125 بمعدل ثابت.
- قياس الكتابة دون معرفة القرص: 24 معاملة في الثانية كانت نتيجة fsync بطيء، وليست حداً لقاعدة البيانات.
- قرارات بلا سجل: من يأتي بعدك سوف يحذف العمود المكرر أو يضيف الطابور الذي رفضته، لأنه لا يعرف لماذا.
قائمة تحقق Checklist
- المتطلبات الوظيفية جمل قابلة للاختبار، ومعها قائمة ما ليس هدفاً.
- كل متطلب غير وظيفي رقم، ومعه اسم من وافق عليه.
- التقدير برنامج أو جدول بافتراضات مكتوبة: الكتابة والقراءة في الثانية في المتوسط والذروة، وحجم السجل، والنمو.
- لكل متطلب وظيفي عملية في الواجهة، ولكل عملية مسار في الرسم.
- نموذج البيانات مبني على أنماط الوصول، وكل استعلام في المسار السريع له فهرس.
- التعمق في النقاط التي يقول التقدير إنها صعبة، مع البدائل.
- أهم رقمين في التقدير مقيسان بنموذج صغير على عتاد يشبه الإنتاج.
- المفاضلات مكتوبة في سجل قرارات ADR.
- الوثيقة فيها قسم للتشغيل وقسم للأسئلة المفتوحة.
ماذا تقرأ بعد ذلك؟ Next Steps
هذه الطريقة هي الأساس لكل دراسات الحالة في هذا القسم، وأول تطبيق كامل لها هو خدمة تقصير الروابط، ثم الأنظمة الأكبر التي تجد فيها نفس الخطوات بمشكلات أصعب:
 دليلكيف تبني خدمة تقصير الروابط URL Shortener؟أول دراسة حالة كاملة: من المتطلبات والتقدير وتوليد الرمز إلى خدمة تعمل على PostgreSQL وValkey، نختبرها بأداة k6 ونصلح فيها ثغرة تعداد الرموز.
 دليلكيف بنى Stack Overflow موقعه بسيرفرات قليلة؟كيف خدم Stack Overflow أكثر من مئتي مليون طلب يومياً بعدد قليل من السيرفرات، وما الدروس التي تأخذها منه لمشروعك.
 دليلكيف تبني نظام إشعارات يصل إلى ملايين المستخدمينكيف تصل الرسالة الصحيحة إلى المستخدم مرة واحدة وفي وقتها عبر الإشعار والرسائل والبريد، حتى عندما يتعطل المزود.
 دليلكيف تبني نظام حجز تذاكر يتحمل لحظة فتح البيعكيف تمنع بيع المقعد الواحد مرتين، وكيف يصمد نظام الحجز عندما يدخل الجميع في الدقيقة نفسها لشراء التذاكر.
 دليلالمحفظة الرقمية من الداخل: دفتر القيد المزدوج Ledgerكيف تبني محفظة رقمية لا يضيع فيها ريال ولا يخصم مرتين، بالقيد المزدوج والمعاملات والمطابقة مع مزود الدفع.
 دليلكيف يختار تطبيق التوصيل المندوب؟ محرك التوزيع Dispatchكيف تختار تطبيقات التوصيل المندوب لكل طلب، ولماذا يكون التوزيع على دفعات أفضل من إعطاء كل طلب أقرب مندوب.
وإذا أردت أن تقوي الأساس الذي تقف عليه الطريقة، فهذه المقالات تشرح الأرقام وأدوات القياس التي استخدمناها:
 دليلمدخل إلى تصميم الأنظمة: من سيرفر واحد إلى ملايين المستخدمينكيف يكبر متجر إلكتروني من سيرفر واحد إلى نظام يخدم ملايين المستخدمين، وما الثمن الذي تدفعه في كل خطوة.
 دليلزمن الاستجابة Latency والإنتاجية Throughput بالأرقامالأرقام التي يحتاجها كل تصميم من الذاكرة إلى القارات، مقاسة على جهاز واحد، مع الذيل Tail Latency وقانون Little واختبار k6 يبين أين تنهار الخدمة.
 دليلتخطيط السعة Capacity Planning: متى تحتاج سيرفراً أكبر؟نقيس سعة متجر حقيقي باختبار ضغط، فنرى لماذا لم يضاعف المعالج الثاني السعة، ونحسب بالأشهر متى تنفد قبل أن تأتي الحملة.
 دليلتوثيق المعمارية: مخططات C4 وسجلات القرارات المعمارية ADRكيف ترسم نظامك بمخططات C4 يفهمها المطور الجديد، وتحفظ سبب كل قرار مهم في سجل ADR داخل المستودع.
 دليلضبط أداء PostgreSQL بالقياس وليس بالتخمينكيف تضبط ذاكرة PostgreSQL ونقاط التفتيش وال autovacuum، وتقيس أثر كل إعداد على نفس الضغط قبل أن تعتمده.
 دليلتقسيم الجداول Partitioning وتوزيعها على السيرفرات Shardingمتى تقسم الجدول داخل سيرفر واحد، ومتى توزع البيانات على عدة سيرفرات، وكيف تضيف سيرفراً وتتعامل مع العميل الضخم.
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- التصميم سلسلة أسئلة بترتيب ثابت: المتطلبات، ثم التقدير، ثم الواجهة، ثم نموذج البيانات، ثم التصميم عالي المستوى، ثم التعمق، ثم المفاضلات، وكل خطوة تنتج شيئاً مكتوباً تبني عليه التالية.
- الطريقة دورة وليست خطاً، فالواجهة صححت افتراضاً في التقدير، والقياس صحح رقمين وغير قراراً.
- أربعة أرقام تكفي في التقدير غالباً: الكتابة والقراءة في الثانية، وحجم السجل، والنمو، ويجب أن تكون افتراضاتها مكتوبة.
- في نظام التتبع قاس النموذج 125 بايتاً للحدث بدلاً من 116، وأكد أن سيرفراً واحداً يخدم الذروة العادية بنسبة p99 حوالي 69 ملي ثانية، وكشف أن ذروة يوم التخفيضات تحتاج خطة.
- لا تحكم على السعة من أقصى إنتاجية، وإنما من المعدل الذي تبقى فيه p99 تحت الهدف، ولا تثق برقم كتابة قبل أن تعرف fsync القرص.
- اكتب كل شيء في وثيقة تصميم، والمفاضلات في سجل قرارات، حتى يعرف من بعدك لماذا وليس فقط ماذا.
سجل التحديثات Changelog
- 18 نوفمبر 2026: كتابة المقال، وتنفيذ التجربة على Docker Engine 29.8.0 مع PostgreSQL 18.6 (postgres:18-alpine) وpgbench 18.6 وPython 3.13.18.