


لو كنت في فريق DevOps أو فريق تقنية المعلومات IT في شركة أو جهة حكومية، فغالباً عندك اليوم عدد من السيرفرات Servers، وعليها تطبيقات مكتوبة بلغات مختلفة: موقع بـ PHP، ونظام داخلي بـ .NET، وواجهة برمجية API بـ Node.js، وقاعدة بيانات أو اثنتان، وبعض الخدمات داخل Containers. ولكل تطبيق نطاق Domain وشهادة TLS لها تاريخ انتهاء، ونسخ احتياطية Backups تعمل كل ليلة، ومهام مجدولة Cron Jobs لا يتذكرها أحد إلا عندما تتوقف.
والمشكلة أن هذا كله يتغير كل أسبوع: تعلن ثغرة Vulnerability جديدة في مكتبة يستخدمها أحد تطبيقاتك، وتصدر تحديثات للنظام وللغات وللأطر، وتظهر محاولات دخول وفحص من عناوين لم ترها من قبل، ويمتلئ قرص لأن السجلات Logs كبرت أسرع من المتوقع. ومع خمسة سيرفرات أو خمسين، لا يستطيع أي فريق أن يفتح كل سيرفر كل صباح ويتحقق يدوياً: هل التطبيق يعمل؟ هل القرص فيه مساحة؟ هل الشهادة ستنتهي قريباً؟ هل نجحت نسخة البارحة؟ هل هناك ثغرة معلنة في نسخة PHP أو .NET التي عندنا؟ هل حاول أحد الدخول بكلمات مرور كثيرة الليلة الماضية؟ فتكون النتيجة المعتادة أن العميل يكتشف العطل قبل الفريق، والشهادة تنتهي يوم الإجازة، والنسخة الاحتياطية لا يعرف أحد أنها متوقفة إلا يوم يحتاجها.
وهذا لا يحدث للفرق الصغيرة فقط. ففي يناير 2017 احتاجت GitLab إلى نسخها الاحتياطية بعد حذف قاعدة بياناتها الرئيسية بالخطأ، فوجدت أن النسخة اليومية كانت تفشل منذ مدة لأن أداة pg_dump فيها أقدم من إصدار قاعدة البيانات، ورسائل الفشل كانت ترسل بالبريد فيرفضها السيرفر المستقبل، كما في تقرير الحادثة الذي نشرته GitLab. وفي العام نفسه دخل مهاجمون إلى Equifax من ثغرة في Apache Struts لم يحدثها أحد لأن قائمة من يستلم تنبيهات الثغرات كانت قديمة، ثم بقوا قرابة 76 يوماً دون أن يراهم أحد لأن جهاز فحص الحركة المشفرة كانت شهادته منتهية منذ قرابة عشرة أشهر، كما في تقرير مكتب المحاسبة الحكومي الأمريكي GAO. والشركتان لم تكن تنقصهما الأدوات، وإنما توقف شيء بصمت ولم يكن هناك ما يراقب أنه يعمل.
والحل ليس أن تتحقق يدوياً بشكل أكثر، وإنما أن تجعل كل هذه الأسئلة تجيب عن نفسها: أدوات تجمع المقاييس Metrics والسجلات والأحداث الأمنية من كل سيرفر، وتفحص التطبيقات من الخارج، وتقارن ما عندك بالثغرات المعلنة، ثم ترسل لك تنبيهاً Alert عندما يحتاج شيء إلى إنسان، ولا ترسل شيئاً عندما يكون كل شيء سليماً.
هذا المقال كتبناه ليكون رابطاً واحداً ترسله لأي مهندس DevOps أو فريق في شركة أو جهة حكومية، ويجيب عن سؤال واحد: ماذا يجب أن تراقب على سيرفراتك وتطبيقاتك؟ وهو دليل يجمع ما كتبناه في سلسلة المراقبة وما حولها، فلكل منطقة نذكر ماذا تراقب ولماذا، وحدوداً وتنبيهات تبدأ بها، والأداة مفتوحة المصدر مع لقطة شاشة حقيقية من مختبراتنا، ثم الرابط إلى المقال الذي يشرحها بالتفصيل. وسوف نتابع فيه فريقاً صغيراً نسميه فريق المنصة: أربعة مهندسين يشغلون منصة حجوزات على ستة سيرفرات، ولديهم Grafana ثبته أحدهم قبل سنة، وتنبيهات تصل إلى بريد لا يقرؤه أحد، ويريدون أن يعرفوا من أين يبدؤون.
وسوف نناقش في هذا المقال ما يلي:
- لماذا يكتشف العميل العطل قبل الفريق، والأعطال الصامتة الست التي تتكرر في كل مكان.
- خريطة المراقبة Monitoring Map: ثلاث عشرة منطقة في ثلاث طبقات، وكيف تقرأ كل قسم.
- جرد الأصول Asset Inventory قبل أي أداة، وتتبع التغطية، مع قالب جرد تطبعه.
- كل منطقة على حدة: سعة السيرفر، والتطبيقات، والتوفر من الخارج، والسجلات، والتتبع والأخطاء، والـ Containers، وقواعد البيانات، والشهادات وDNS، والنسخ الاحتياطي والمهام المجدولة، والأحداث الأمنية، والثغرات والتحديثات، والتنبيهات، والبوابة الواحدة.
- قائمة تحقق قابلة للطباعة، وخطة لأسبوع واحد لفريق صغير.
- البدائل المدفوعة والمستضافة لكل منطقة، ومتى تكون منطقية، وكيف تسعر كل منها.
- السياق السعودي: ما تطلبه الضوابط الأساسية للأمن السيبراني ECC في المراقبة، ومكان حفظ البيانات.
لماذا يكتشف العميل العطل قبل الفريق؟ Silent Failures
عندما سألنا أنفسنا لماذا يتكرر هذا المشهد في فرق مختلفة، وجدنا أن السبب في الغالب واحد من ثلاثة. الأول أن الفريق يراقب ما هو سهل القياس وليس ما يهم العميل، فلديه رسم جميل للمعالج CPU، ولكن لا شيء يقول له إن صفحة الدفع ترجع خطأ لكل عاشر طلب. والثاني أن المراقبة تعمل من داخل السيرفر نفسه، فإذا توقف السيرفر توقفت معه المراقبة وتنبيهاتها، ولم يصل شيء. والثالث، وهو الأخطر، أن هناك أشياء لا تشتكي حين تفشل: مهمة مجدولة Cron Job لم تعمل لا تكتب خطأ في أي مكان، وشهادة تقترب من نهايتها تعمل بشكل طبيعي حتى آخر ثانية، ونسخة احتياطية فارغة تنجح من وجهة نظر السكربت الذي أنشأها.
والجدول التالي يجمع الأعطال الست التي ذكرناها في المقدمة، ولكل منها الإشارة التي كانت ستكشفها مبكراً، والمنطقة التي تشرحها في هذا الدليل:
| العطل | لماذا لا يراه أحد | الإشارة التي تكشفه مبكراً | المنطقة |
|---|---|---|---|
| العميل يكتشف توقف الموقع | المراقبة على السيرفر نفسه، أو لا يوجد فحص من الخارج | فحص HTTP من خارج الشبكة كل دقيقة | التوفر من الخارج |
| القرص يمتلئ | التنبيه عند 90% يأتي متأخراً إذا كانت الكتابة سريعة | توقع وقت الامتلاء من اتجاه الكتابة | سعة السيرفر |
| الشهادة تنتهي | تعمل طبيعياً حتى آخر لحظة | عدد الأيام المتبقية من فحص TLS | الشهادات وDNS |
| النسخة الاحتياطية لا تعمل | الفشل الصامت لا يكتب شيئاً | غياب نبضة النجاح Heartbeat في موعدها | النسخ والمهام |
| اختراق يكتشف بعد أشهر | السجلات موجودة ولا أحد يقرؤها | قواعد كشف على السجلات الأمنية، وسلامة الملفات | الأحداث الأمنية |
| ثغرة معلنة لم تصلح | لا أحد يعرف ماذا يعمل على كل سيرفر | فحص يومي لما هو منشور فعلاً، وطلبات تحديث تلقائية | الثغرات والتحديثات |
ولاحظ أن نصف هذه الأعطال لا علاقة له بالأداء، ولهذا لا يكفي أن تثبت أداة لرسم المقاييس وتظن أنك تراقب. فالمراقبة Monitoring في معناها العملي أن تسأل عن كل شيء يمكن أن يتوقف: كيف سأعرف أنه توقف، ومن سيعرف، وكم من الوقت سيمر قبل أن يعرف؟ وإذا كان الجواب «سيعرف العميل» أو «لن يعرف أحد» فهذه منطقة تحتاج مراقبة. وقد شرحنا الفرق بين المقاييس Metrics والسجلات Logs والتتبع Traces، وبين المراقبة والملاحظة Observability، في مفاهيم المراقبة Observability، وهنا نركز على السؤال العملي: ماذا تراقب بالضبط.
خريطة المراقبة Monitoring Map: ثلاث عشرة منطقة
قسمنا كل ما يجب أن يراقبه فريق يشغل سيرفرات وتطبيقات إلى ثلاث عشرة منطقة، وجمعناها في ثلاث طبقات بحسب طريقة فشلها، ثم طبقة التشغيل التي تجمع كل شيء، كما في الصورة التالية:
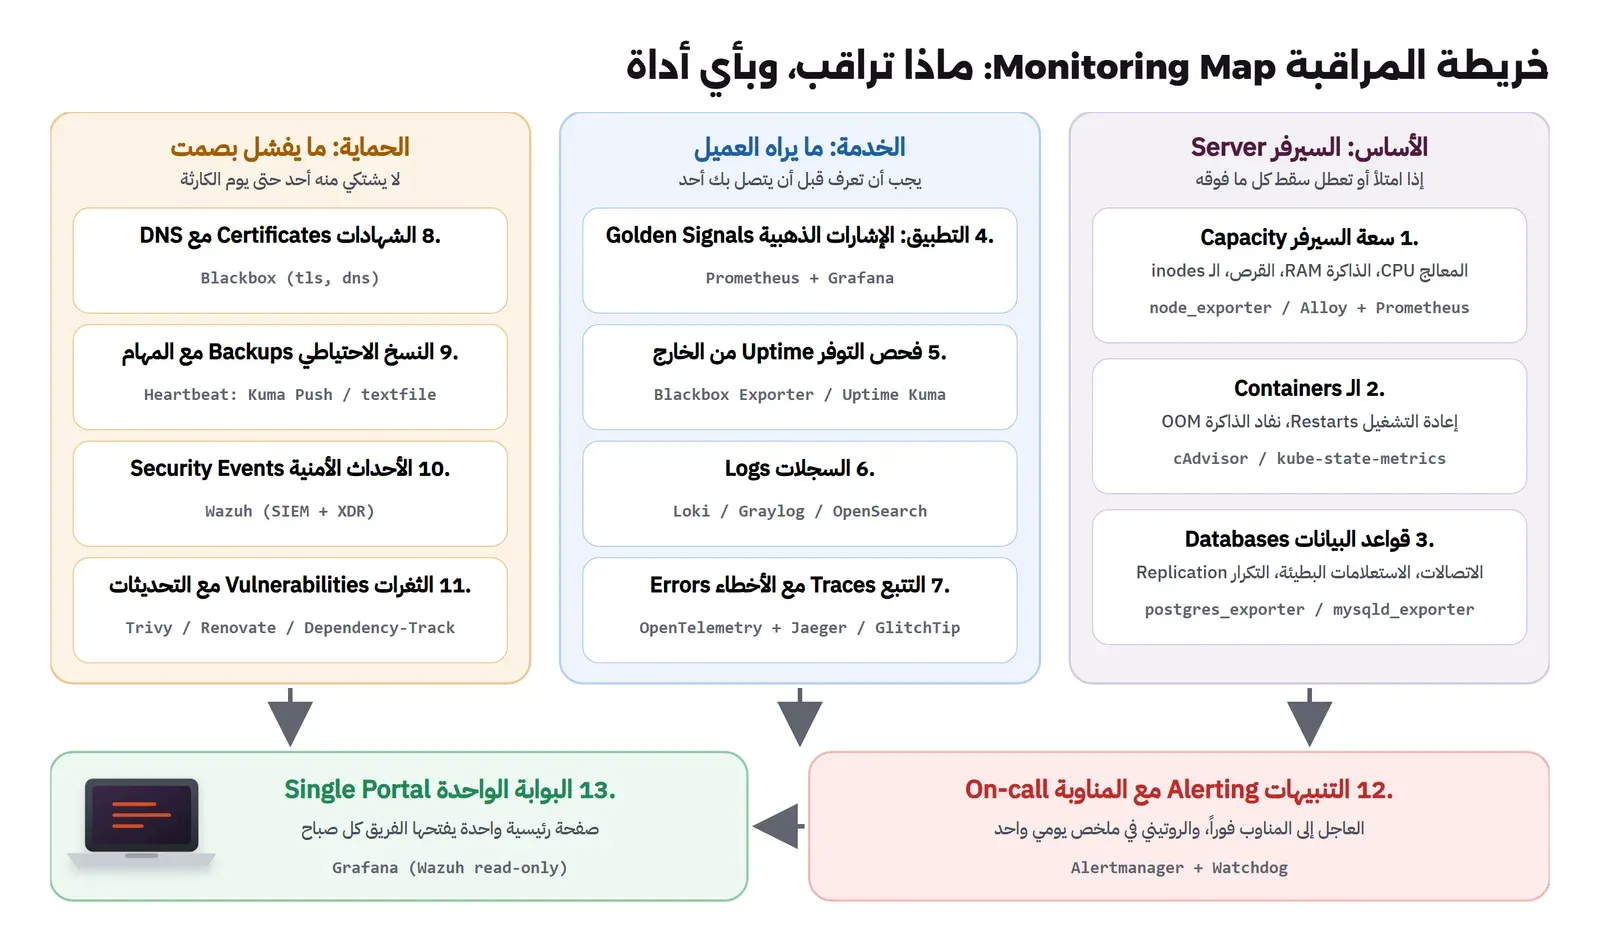
- الأساس، أي السيرفر: سعة السيرفر، والـ Containers، وقواعد البيانات. وهذه إذا تعطلت سقط كل ما فوقها، ومقاييسها سهلة الجمع، ولذلك تبدأ بها كل الفرق.
- الخدمة، أي ما يراه العميل: التطبيق وإشاراته الذهبية، والتوفر من الخارج، والسجلات، والتتبع والأخطاء. وهذه تجيب عن سؤال واحد: هل يعمل ما يدفع العميل من أجله؟
- الحماية، أي ما يفشل بصمت: الشهادات وDNS، والنسخ الاحتياطي والمهام المجدولة، والأحداث الأمنية، والثغرات والتحديثات. وهذه لا يشتكي منها أحد حتى يوم الكارثة، وهي التي أسقطت GitLab وEquifax.
- التشغيل: التنبيهات والمناوبة، والبوابة الواحدة التي يفتحها الفريق كل صباح.
وكل قسم في هذا الدليل يتبع الترتيب نفسه: ماذا تراقب ولماذا، ثم حدود وتنبيهات تبدأ بها، ثم الأداة مفتوحة المصدر مع لقطة من مختبراتنا وشرح ما فيها، ثم المقالات التي تشرح المنطقة بالتفصيل. والحدود التي نذكرها نقاط بداية معقولة لفريق صغير وليست أرقاماً مقدسة، فبعد أسبوعين من البيانات الحقيقية سوف تعرف أن سيرفر قاعدة البيانات عندك يعمل طبيعياً عند 70% من الذاكرة، وأن سيرفر الويب لا يتجاوز 20%، وتعدل الحدود بحسب ذلك.
قبل كل شيء: جرد الأصول Asset Inventory
أول ما فعله فريق المنصة عندما بدأ هو السؤال الذي يبدو بسيطاً: كم سيرفراً لدينا؟ وكانت الإجابة ستة، ثم اكتشفوا سابعاً يشغل خدمة إرسال البريد ولا يعرف أحد كلمة مروره، ونطاقاً فرعياً لصفحة تسويق قديمة ما زالت تعمل بشهادة لا يجددها أحد، ومهمة مجدولة على سيرفر قاعدة البيانات كتبها موظف غادر قبل سنة. ولم يكن أي من هذه الأشياء الثلاثة مراقباً، لأن أحداً لم يكن يعرف أنه موجود. وهذه هي القاعدة التي تسبق كل المناطق الثلاث عشرة: لا يمكنك أن تراقب ما لم تكتبه في قائمة. ولو عدت إلى حادثة Equifax لوجدت أن الثغرة لم تصلح لأن لا أحد ربط السيرفر المصاب بمن يجب أن يحدثه، أي أن المشكلة كانت مشكلة جرد قبل أن تكون مشكلة مراقبة.
ماذا تكتب عن كل أصل؟ Asset Fields
الأصل Asset هنا كل شيء يمكن أن يتوقف ويحتاج أحداً يعرف به: سيرفر، أو جهاز افتراضي، أو خدمة، أو قاعدة بيانات، أو نطاق، أو شهادة، أو مهمة مجدولة، أو حساب في خدمة سحابية. ولكل أصل تكتب أسطراً قليلة تجيب عن أسئلة المناوب في الثالثة فجراً:
- الاسم والدور Role:
db-1قاعدة البيانات الرئيسية للحجوزات، وليس مجرد عنوان IP. - المالك Owner: الشخص أو الفريق الذي يقرر بشأنه، ويتصل به المناوب إذا تعطل.
- البيئة Environment: إنتاج أو اختبار أو تطوير، لأن تنبيه سيرفر الاختبار لا يوقظ أحداً.
- المنافذ المكشوفة Exposed Ports: ما الذي يصل إليه الإنترنت، وهو أول ما يحتاج فحصاً من الخارج ومراقبة أمنية.
- ما الذي يراقبه: المقاييس، والسجلات، والفحص الخارجي، ووكيل الأمن، كل منها نعم أو لا.
- النسخ الاحتياطي: هل ينسخ، وأين، ومتى آخر استعادة تجريبية.
- الشهادات والنطاقات: تاريخ انتهاء كل شهادة يقدمها، والنطاق الذي يخدمه وتاريخ تجديده.
تتبع التغطية Coverage Tracking
القائمة وحدها لا تكفي، فقيمتها أن تتحول إلى سؤال يتكرر: هل كل سطر فيها مربوط بفحص في كل منطقة تنطبق عليه؟ فسيرفر الإنتاج يجب أن يكون له مقياس في Prometheus، وسجلات في Loki، ووكيل في Wazuh، ونسخة لها نبضة، وإذا كان مكشوفاً فله فحص من الخارج وشهادة مراقبة. وأي خانة فارغة في هذا الربط هي فراغ في المراقبة، وهي ما تعمل عليه أولاً. والطريقة العملية أن تقارن القائمة بما تراه الأدوات فعلاً، وليس بما يتذكره الفريق: قائمة الأهداف في صفحة /targets في Prometheus، وقائمة الوكلاء في Wazuh، وقائمة الفحوص في Blackbox وKuma. وكل سيرفر في الجرد وغائب عن إحداها يظهر في تقرير أسبوعي، وكل هدف في الأدوات وغائب عن الجرد يعني أن الجرد ناقص. وقد بنينا جدول تدقيق تغطية كاملاً بهذه الطريقة في مقال البوابة الواحدة.
أين تحفظ الجرد؟ Inventory Tools
لفريق بعشرة سيرفرات يكفي جدول واحد في مستودع Git بجانب إعدادات المراقبة، لأن مراجعته تمر بطلب دمج مثل أي تغيير آخر، ويمكن أن تبني منه ملفات الأهداف في Prometheus وBlackbox تلقائياً فلا يختلف الجرد عن الواقع. وعندما يكبر العدد تحتاج نظاماً: Snipe-IT لسجل الأجهزة والرخص ومن يحملها، وقد شرحنا دورة حياة الأصل من الشراء إلى الإتلاف في إدارة أصول تقنية المعلومات IT Asset Management، وأنظمة التذاكر التي فيها قاعدة بيانات الإعدادات CMDB في مقارنة أنظمة التذاكر ITSM. وللبنية نفسها، أي السيرفرات والشبكات والعناوين والأجهزة الافتراضية، فالمرجع مفتوح المصدر الأشهر NetBox، وله توثيق وواجهة API تستطيع أن تقرأ منها قائمة الأهداف للمراقبة. والقالب التالي هو ما نقترحه لبداية أي فريق، اطبعه أو انسخه إلى جدول:
| الأصل | الدور | المالك | البيئة | المنافذ المكشوفة | المقاييس | السجلات | الفحص الخارجي | الأمن | النسخ وآخر استعادة | انتهاء الشهادة |
|---|---|---|---|---|---|---|---|---|---|---|
web-1 | الواجهة والـ Reverse Proxy | فريق المنصة | إنتاج | 443، 80 | نعم | نعم | نعم | وكيل Wazuh | الإعدادات في Git | من الفحص |
db-1 | قاعدة البيانات الرئيسية | فريق المنصة | إنتاج | لا شيء | نعم مع postgres_exporter | نعم | لا ينطبق | وكيل Wazuh | يومي، استعادة الشهر الماضي | شهادة داخلية |
mail-1 | إرسال البريد | اكتب اسماً | إنتاج | 25، 587 | لا | لا | لا | لا | لا | غير معروف |
booking.example.com | النطاق الرئيسي | الإدارة | إنتاج | لا ينطبق | لا ينطبق | لا ينطبق | DNS مع HTTP | لا ينطبق | لا ينطبق | تسجيل النطاق وتاريخه |
| نسخ قاعدة البيانات | مهمة مجدولة 02:00 | فريق المنصة | إنتاج | لا ينطبق | نبضة | نعم | لا ينطبق | لا ينطبق | هي النسخ نفسها | لا ينطبق |
والسطر الثالث هو ما يجب أن تبحث عنه: أصل في الإنتاج، ليس له مالك، ولا يراقبه شيء. ففي فريق المنصة كان هذا سيرفر البريد، وفي فرق أخرى يكون سيرفر VPN أو جهاز تخزين أو حساباً سحابياً فتحه أحد للتجربة ونسيه.
المنطقة الأولى: سعة السيرفر Server Capacity
بعد الجرد يأتي أول سؤال عن كل سيرفر: هل لديه مساحة ومعالج وذاكرة تكفي لما يعمل عليه الآن وفي الأسابيع القادمة؟ وهذه هي مراقبة السعة Capacity، وتبدأ بجامع مقاييس على كل سيرفر في الجرد دون استثناء.
ماذا تراقب على كل سيرفر؟ Server Metrics
- هل السيرفر يرسل أصلاً: المقياس
upفي Prometheus، أو «آخر بيانات من السيرفر». وهذا أهم مقياس على الإطلاق، لأن السيرفر الذي توقف عن الإرسال لا يطلق أي تنبيه آخر. - المعالج CPU: نسبة الانشغال، ووقت الانتظار على القرص iowait، ووقت السرقة Steal Time على الأجهزة الافتراضية، وهو الوقت الذي أخذه سيرفر آخر على المضيف نفسه.
- الذاكرة RAM: الذاكرة المتاحة
MemAvailableوليس الذاكرة الحرة، لأن Linux يستخدم الذاكرة الحرة للتخزين المؤقت Cache ويعيدها عند الحاجة، ومعها استخدام مساحة التبديل Swap. - القرص Disk: المساحة المتاحة على كل نظام ملفات، ومعها توقع وقت الامتلاء، وسرعة القرص IOPS وزمن الانتظار.
- الـ inodes: عدد الملفات التي يستطيع نظام الملفات أن يحملها. فالقرص قد يكون نصفه فارغاً ويرفض إنشاء أي ملف جديد لأن مجلداً فيه ملايين الملفات الصغيرة، مثل ملفات الجلسات أو الصور المصغرة، استهلك كل الـ inodes.
- الشبكة Network: الأخطاء والحزم المسقطة، وعدد الاتصالات في حالة TIME_WAIT إذا كان السيرفر يتصل بخدمات كثيرة.
لماذا توقع الامتلاء أهم من النسبة؟ Disk-Full Forecast
الخطأ الشائع أن تضع تنبيهاً على 90% من القرص. فإذا كان القرص 2 TB فإن 10% منه 200 GB، وقد تبقى أسابيع، فيصبح التنبيه إزعاجاً يتجاهله الجميع، وإذا كان القرص 20 GB وسجل تطبيق بدأ يكتب بسرعة، فقد تمر المسافة من 90% إلى 100% في دقائق قبل أن يقرأ أحد التنبيه. والسؤال الصحيح ليس كم بقي، وإنما متى سيمتلئ بهذه السرعة. ولهذا يوفر Prometheus الدالة predict_linear التي ترسم خطاً مستقيماً من القيم الأخيرة وتقول لك أين سيصل بعد مدة تحددها:
predict_linear(node_filesystem_avail_bytes{fstype=~"ext4|xfs"}[6h], 24*3600) < 0ومعنى هذا السطر: انظر إلى المساحة المتاحة في آخر ست ساعات، وإذا استمر الاتجاه نفسه فهل ستصبح أقل من صفر بعد 24 ساعة؟ وفي مقال مقاييس السيرفرات مع Prometheus ملأنا قرصاً حقيقياً بسرعة ثابتة وراقبنا التوقع وهو يقترب من الواقع:
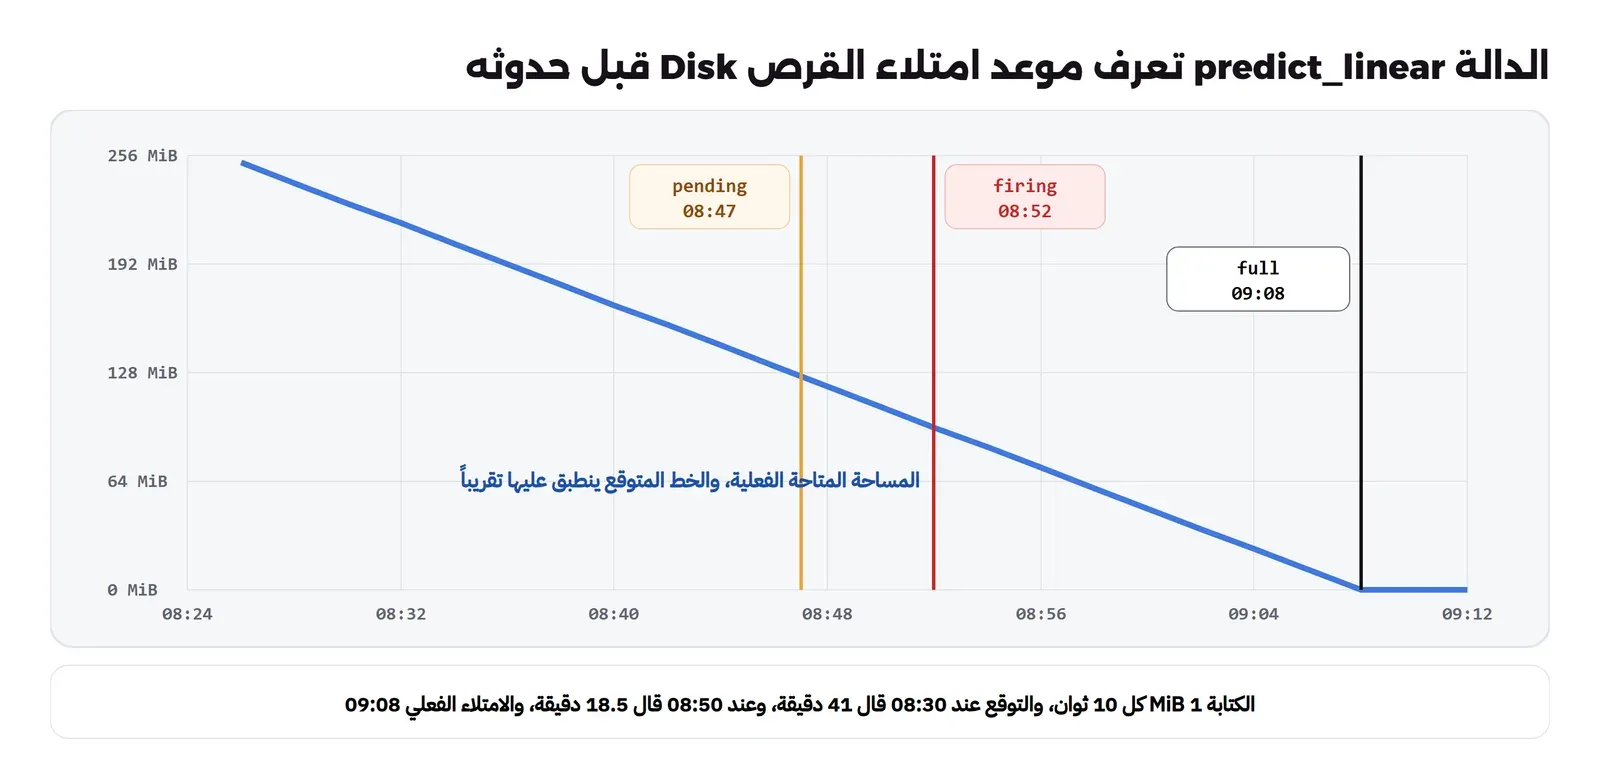
في الصورة المساحة المتاحة تنزل في خط مستقيم من 252 MiB إلى الصفر، والخط البرتقالي هو اللحظة التي تحقق فيها شرط التنبيه وبدأ ينتظر مدة for، والأحمر لحظة إطلاقه، والأسود لحظة الامتلاء الفعلي. والفرق بين الأحمر والأسود هو الوقت الذي يملكه المناوب ليتصرف. وفي سيرفر حقيقي تستخدم نافذة أطول، ست ساعات مثلاً، حتى لا يطلق التنبيه بسبب ملف كبير مؤقت كتب ثم حذف، وتجعل له مستويين: الامتلاء خلال 24 ساعة يذهب إلى الملخص اليومي، والامتلاء خلال 4 ساعات يوقظ المناوب.
الأداة: node_exporter مع Prometheus، ثم لوحة Grafana
الطريقة المعتادة في الأدوات مفتوحة المصدر أن تثبت node_exporter على كل سيرفر، أو Grafana Alloy الذي يضم المكون نفسه ويجمع السجلات أيضاً، ثم يسحب Prometheus المقاييس منها كل 15 أو 30 ثانية، وتعرضها لوحة Grafana. والصورة التالية من لوحة بنيناها كملف JSON في Git:
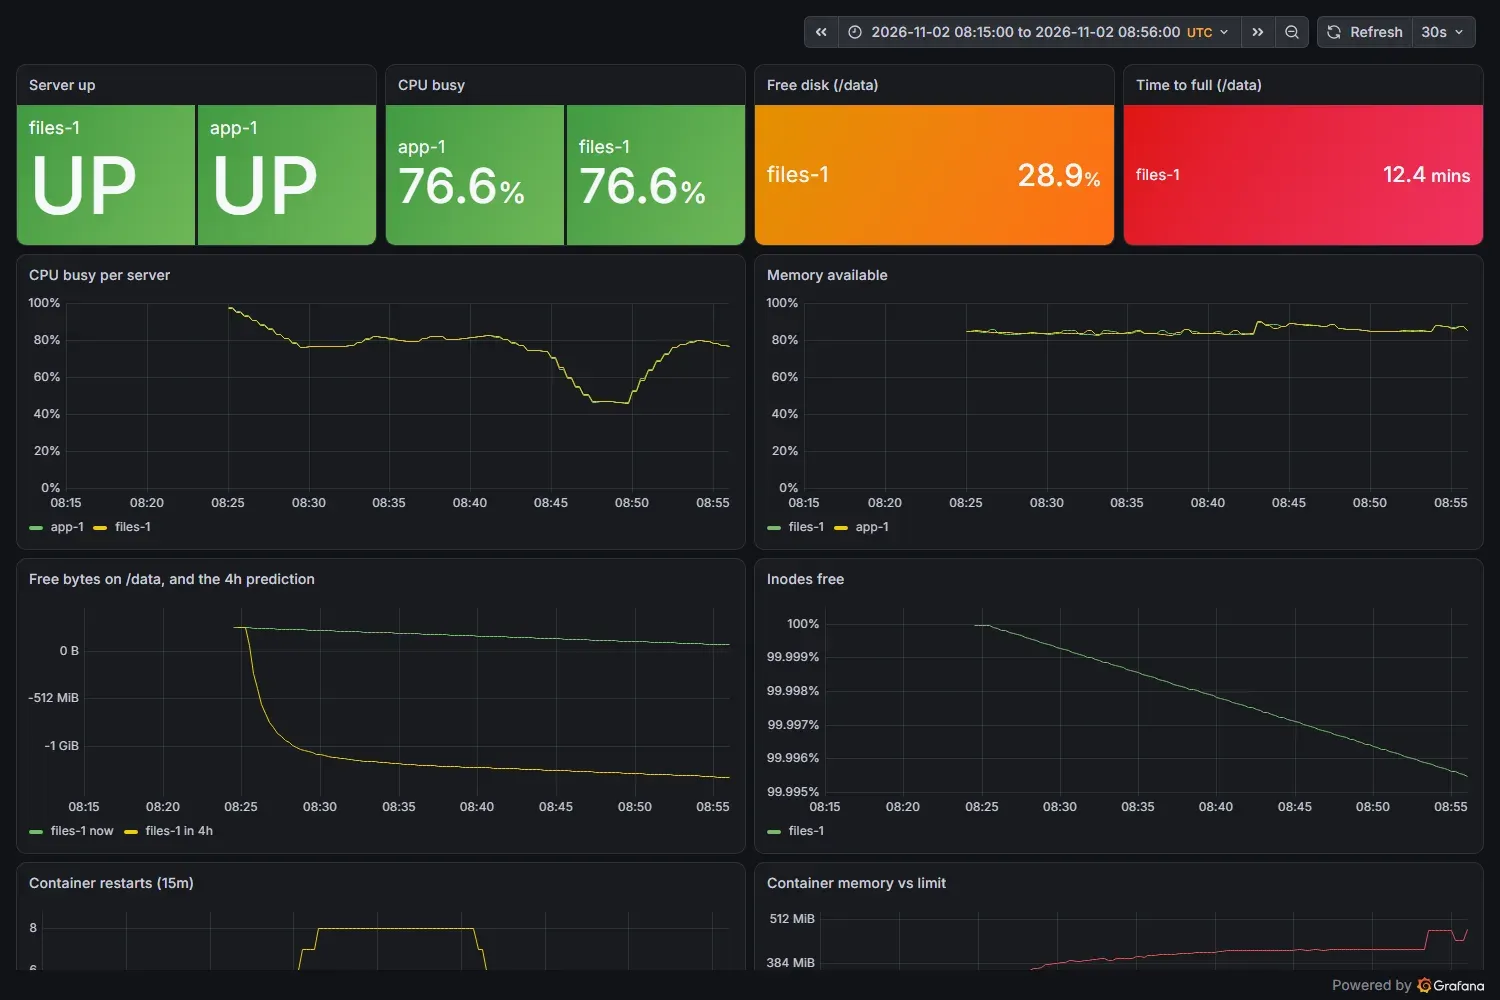
انظر إلى الصف الأول: المساحة الحرة على /data تقول 28.9% باللون البرتقالي، ولو كان هذا هو الرقم الوحيد لما قلق أحد، ولكن اللوح المجاور يقول إن القرص سيمتلئ خلال 12.4 دقيقة بالسرعة الحالية، وهو باللون الأحمر. وتحت ذلك رسم الـ inodes ينزل ببطء، وهو رسم لا يضعه أغلب الناس في لوحاتهم حتى يقعوا في المشكلة مرة. وللتعمق في قراءة هذه المقاييس على سيرفر حي، ومعنى كل عمود في vmstat وiostat، اقرأ تحليل أداء سيرفر Linux في 60 ثانية.
| التنبيه | الشرط المقترح للبداية | المستوى |
|---|---|---|
| السيرفر لا يرسل | up == 0 لمدة دقيقتين | عاجل |
| القرص يمتلئ قريباً | predict_linear على 6 ساعات، الامتلاء خلال 4 ساعات | عاجل |
| القرص يمتلئ خلال يوم | الشرط نفسه بـ 24 ساعة، لمدة 30 دقيقة | ملخص يومي |
| الـ inodes تنفد | أقل من 10% متاح | ملخص يومي |
| الذاكرة المتاحة منخفضة | أقل من 10% لمدة 15 دقيقة، مع استخدام Swap يزيد | ملخص يومي، وعاجل إذا بدأ قتل العمليات OOM |
| المعالج مشغول | فوق 90% لمدة 30 دقيقة | لوحة فقط، إلا إذا صاحبه بطء في الخدمة |
المنطقة الثانية: التطبيقات والإشارات الذهبية Golden Signals
في الأسبوع الذي ركب فيه فريق المنصة لوحة السيرفرات، اتصل عميل يقول إن تأكيد الحجز يأخذ نصف دقيقة. ونظر الفريق إلى اللوحة فوجد المعالج عند 30% والذاكرة طبيعية، وكل شيء أخضر. والسبب أن السيرفر لم يكن مشغولاً، وإنما كان التطبيق ينتظر اتصالاً بقاعدة البيانات من مجمع اتصالات Connection Pool امتلأ. وهذا هو الدرس الذي جعل Google تكتب في كتاب SRE أن أهم ما تراقبه في أي خدمة أربع إشارات، سمتها الإشارات الذهبية:
- زمن الاستجابة Latency: كم يأخذ الطلب، ويقاس بالمئين Percentile مثل p95 وp99 وليس بالمتوسط، لأن المتوسط يخفي العملاء الذين ينتظرون عشر ثوان. وافصل زمن الطلبات الناجحة عن الفاشلة، فالخطأ السريع يجعل المتوسط يبدو أفضل.
- حجم الطلبات Traffic: كم طلباً في الثانية، لأن الصفر أحياناً أخطر من الكثير: إذا نزلت الطلبات فجأة إلى الصفر في وقت ذروة فقد يكون الـ Load Balancer أو DNS هو المعطل.
- الأخطاء Errors: نسبة الطلبات الفاشلة، أي ردود 5xx، والطلبات التي ترجع 200 بمحتوى خاطئ إن كنت تستطيع قياسها.
- التشبع Saturation: كم بقي قبل أن تمتلئ أضيق نقطة في الخدمة، وهي غالباً ليست المعالج وإنما مجمع الاتصالات أو طابور الطلبات أو عدد العمليات Workers.
وفي مقال الإشارات الذهبية Golden Signals بنينا خدمة صغيرة بمجمع اتصالات محدود، ثم رفعنا الطلبات عليها على مراحل، والصورة التالية هي اللوحة الحقيقية من تلك التجربة:
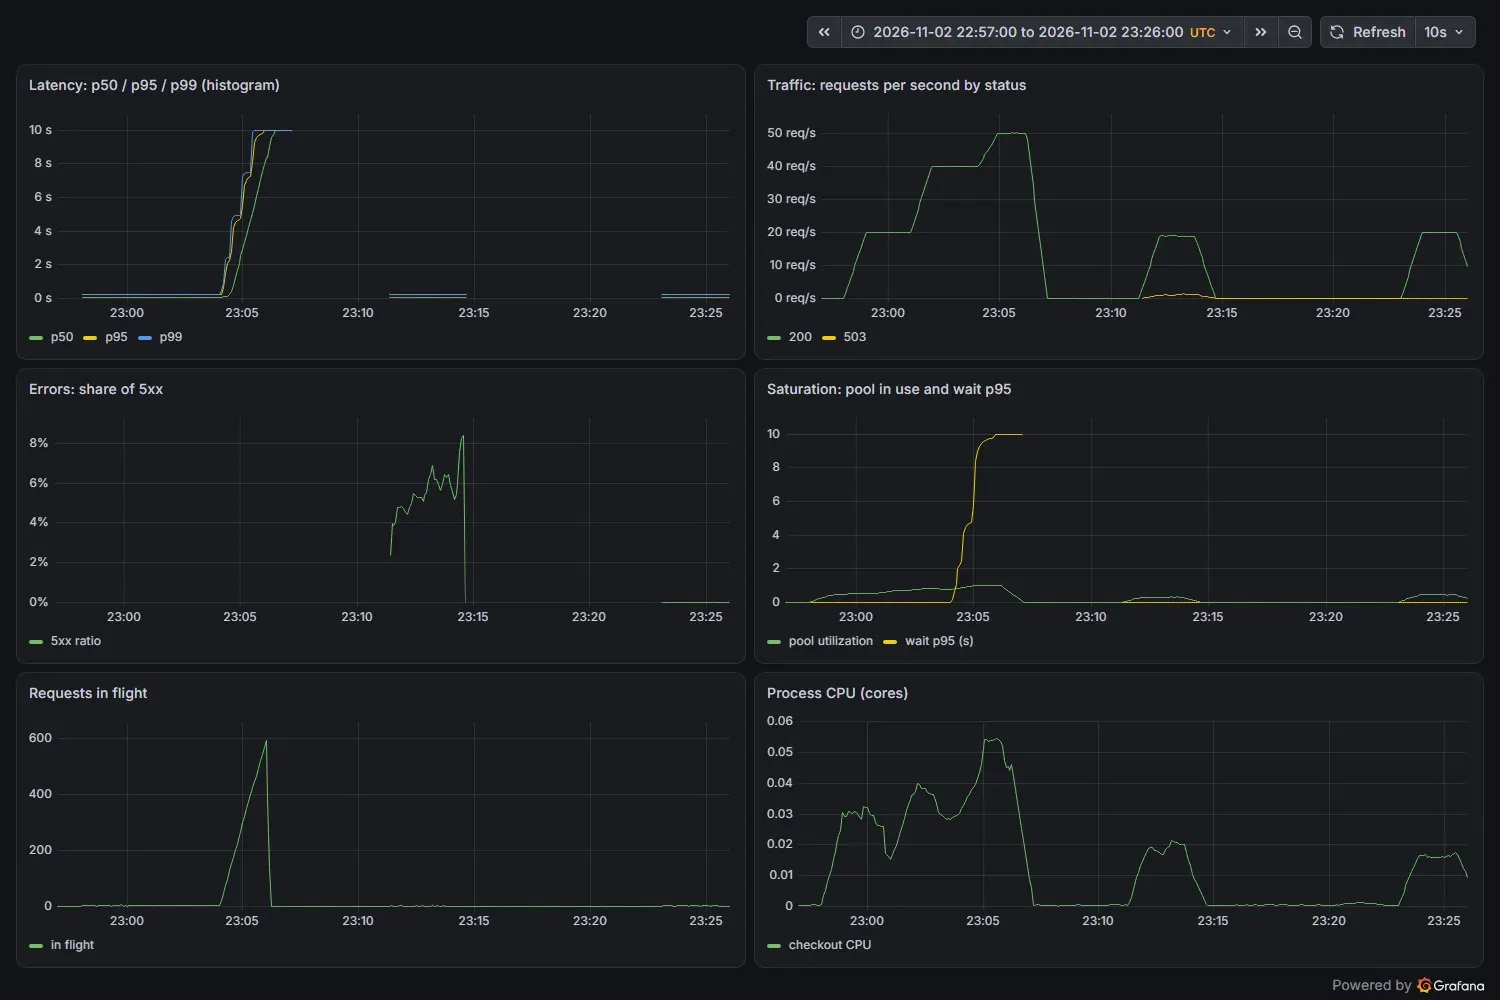
اقرأ الصورة من الأسفل: المعالج بين 0.02 و0.055 نواة طوال التجربة، أي أن لوحة السيرفر كانت ستقول إن كل شيء بخير. ولكن رسم التشبع يبين أن استخدام مجمع الاتصالات وصل إلى 1، أي امتلأ تماماً، وفي اللحظة نفسها ارتفع زمن الانتظار على المجمع إلى عشر ثوان، وارتفع p99 في رسم زمن الاستجابة إلى السقف نفسه، ثم ظهرت أخطاء 503 بنسبة بين 2% و8%. وهذه بالضبط قصة فريق المنصة: الخدمة ممتلئة والسيرفر مرتاح.
والطريقتان المختصرتان اللتان ستسمع عنهما هما RED للخدمات، أي Rate وErrors وDuration، وUSE للموارد، أي Utilization وSaturation وErrors، وقد شرحناهما مع الأمثلة في مقال الإشارات الذهبية. والأداة هنا هي مكتبة Prometheus للغة تطبيقك، أو OpenTelemetry، تضيف عداداً للطلبات بحسب المسار والرمز، ورسماً بيانياً Histogram لزمن الاستجابة، وتعرضها على المسار /metrics. وإذا لم تستطع أن تعدل الكود، فسجلات الـ Reverse Proxy مثل Nginx فيها الرمز والزمن لكل طلب، ويمكن أن تحسب منها الإشارات نفسها في Loki.
| التنبيه | الشرط المقترح للبداية | المستوى |
|---|---|---|
| نسبة الأخطاء | أكثر من 5% من الطلبات 5xx لمدة 5 دقائق، مع حد أدنى لعدد الطلبات | عاجل |
| زمن الاستجابة | p95 أعلى من الهدف المتفق عليه لمدة 10 دقائق، 1 ثانية مثلاً لصفحة الدفع | عاجل للمسارات الحرجة، ملخص للباقي |
| الطلبات اختفت | معدل الطلبات صفر في ساعات العمل لمدة 5 دقائق | عاجل |
| التشبع | مجمع الاتصالات فوق 80% لمدة 10 دقائق | ملخص يومي |
والحد الأدنى لعدد الطلبات في الشرط الأول مهم: فخطأ واحد من طلبين في الثالثة فجراً نسبته 50%، ولا يستحق أن يوقظ أحداً. وإذا أردت أن تنتقل من الحدود الثابتة إلى أهداف مستوى الخدمة SLO وميزانية الأخطاء Error Budget ومعدل استهلاكها Burn Rate، فقد شرحناها في مفاهيم المراقبة.
المنطقة الثالثة: فحص التوفر من الخارج Uptime Checks
كل ما سبق يعمل من داخل الشبكة، وله نقطة عمياء واحدة: إذا توقف سيرفر المراقبة، أو انقطعت الشبكة كلها، أو انتهى تسجيل النطاق، فلن يرى أحد شيئاً، لأن الأداة التي يفترض أن ترى هي نفسها خارج الخدمة. ولذلك تحتاج كل خدمة يستخدمها الناس فحصاً من الخارج، يفتح الصفحة كما يفتحها العميل، من مكان لا يشارك سيرفراتك في شيء، ويتأكد أن الرد جاء، وأن الرمز 200، وأن الصفحة تحتوي كلمة متوقعة، وأن الشهادة صالحة. ثم تسأل السؤال الذي يتجاهله أغلب الناس: من يراقب سيرفر المراقبة نفسه؟
والأداتان اللتان قارنا بينهما في فحص التوفر Uptime Checks هما Blackbox Exporter، الذي يعمل مع Prometheus ويفحص HTTP وTCP وICMP وDNS والشهادات، وUptime Kuma، وهو تطبيق مستقل بواجهة بسيطة وتنبيهات مدمجة. والتوزيع الذي نقترحه أن يعمل Blackbox على سيرفر المراقبة لأن نتائجه تدخل في لوحات Grafana نفسها، وأن يعمل Kuma أو خدمة خارجية على سيرفر آخر تماماً، ليفحص الموقع وسيرفر المراقبة معاً. والصورة التالية من التجربة التي أوقفنا فيها Prometheus عمداً:
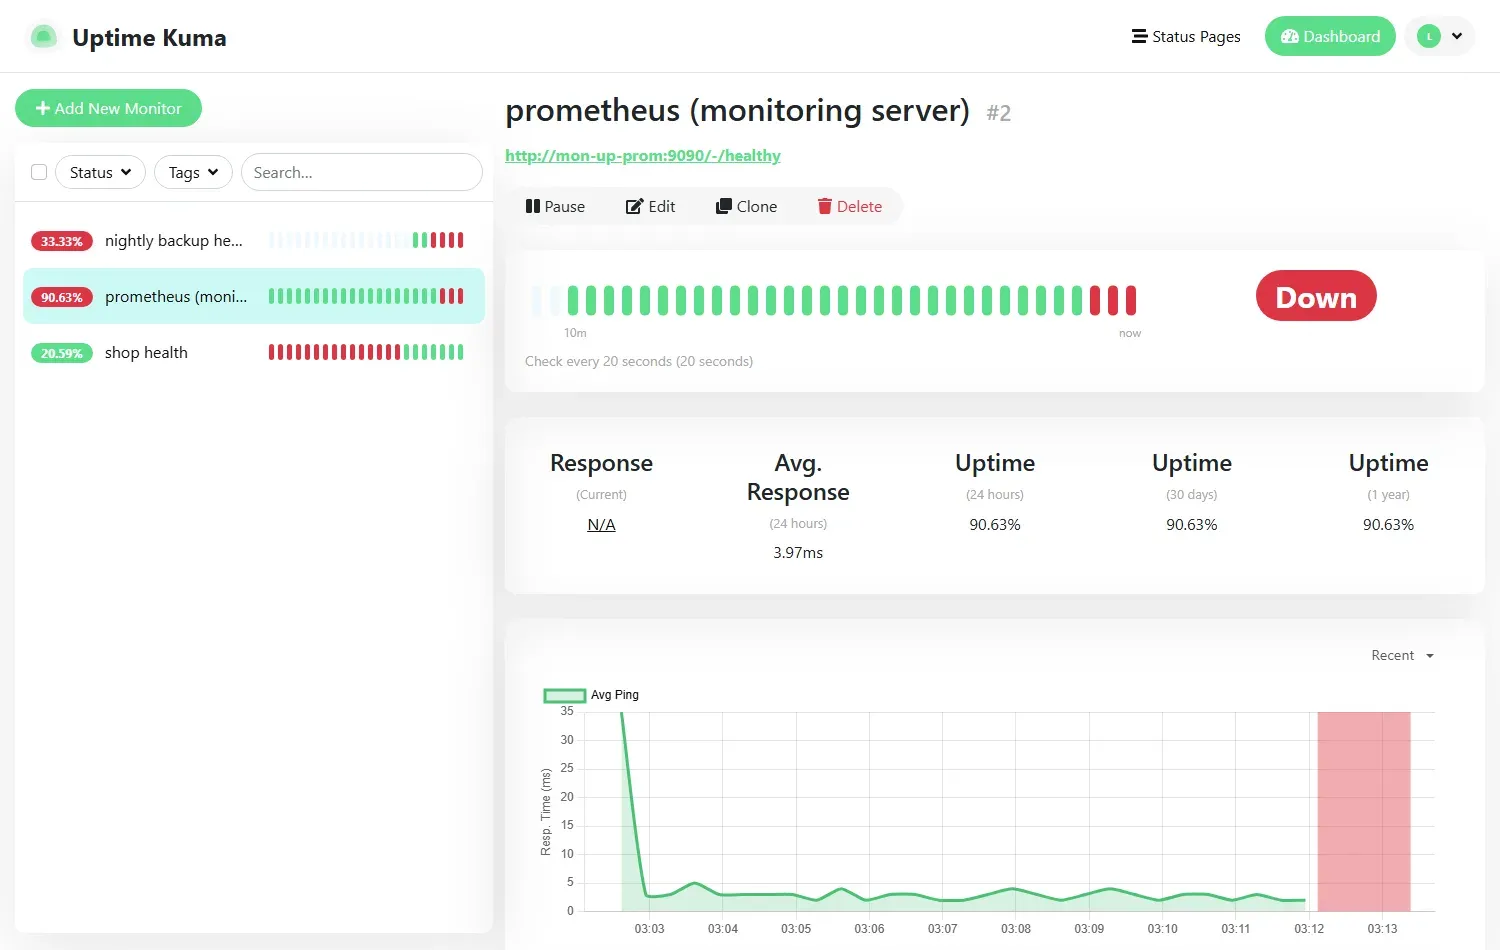
في الصورة ثلاثة فحوص على اليسار، والمفتوح منها يفحص المسار /-/healthy في Prometheus كل 20 ثانية، وحالته Down باللون الأحمر، والمنطقة الحمراء في آخر رسم زمن الرد هي لحظة إيقافه. ولو كان التنبيه الوحيد على توقف Prometheus يأتي من Prometheus نفسه، لما وصل شيء، لأن الميت لا يبلغ عن موته. ولاحظ أيضاً الفحص الثالث shop health بنسبة 20.59%، وكانت أغلب أشرطته حمراء في البداية لأن الكلمة المتوقعة في الصفحة كانت خاطئة، وهذا سبب آخر لتجرب كل فحص بإيقاف ما يفحصه مرة واحدة على الأقل.
| التنبيه | الشرط المقترح للبداية | المستوى |
|---|---|---|
| الموقع لا يرد | probe_success == 0 لمدة دقيقة، ومن موقعين إن أمكن | عاجل |
| الرد بطيء من الخارج | probe_duration_seconds أعلى من 3 ثوان لمدة 10 دقائق | ملخص يومي |
| سيرفر المراقبة متوقف | فحص خارجي على Prometheus وAlertmanager وGrafana | عاجل، ومن خارج سيرفر المراقبة |
المنطقة الرابعة: السجلات Logs
المقاييس تقول لك إن شيئاً حدث، والسجلات تقول لك ماذا حدث. فعندما يطلق تنبيه نسبة الأخطاء، فإن أول ما يفعله المناوب أن يفتح السجلات ويبحث عن الخطأ في تلك الدقائق. وإذا كانت السجلات موزعة على ستة سيرفرات، ويحتاج للدخول بـ SSH إلى كل منها ثم البحث بـ grep، فقد ضاعت نصف ساعة قبل أن يبدأ التحقيق، وقد يكون الـ Container الذي فيه السجل حذف وأعيد إنشاؤه. ولذلك تحتاج كل بيئة فيها أكثر من سيرفرين نظاماً مركزياً للسجلات.
ماذا تجمع، وكم تحتفظ؟ Log Retention
- سجلات التطبيق: منظمة Structured بصيغة JSON، وفيها مستوى السجل Level ومعرف الطلب Request ID، حتى تتبع الطلب من الـ Proxy إلى التطبيق إلى قاعدة البيانات. وقد شرحنا ماذا تكتب وماذا لا تكتب في السجلات Logging للمطورين.
- سجلات الـ Reverse Proxy: فيها الرمز والزمن وعنوان العميل لكل طلب، وهي أسهل طريق لحساب الإشارات الذهبية دون تعديل الكود.
- سجلات النظام: journald وسجل الدخول، وهذه أيضاً مصدر للأحداث الأمنية كما سنرى.
- مدة الاحتفاظ Retention: اكتبها من اليوم الأول. ففي مختبر البوابة كتب متجر صغير قرابة 148 MB من السجلات في اليوم، وهذا رقم يتضاعف بسرعة مع سطر DEBUG واحد نسيه أحد. وأغلب الفرق يكفيها 14 إلى 30 يوماً لسجلات التطبيق، بينما السجلات الأمنية لها متطلبات أطول نذكرها في القسم السعودي.
الأداة: Loki أو Graylog أو OpenSearch
اختيارنا الافتراضي لفريق صغير هو Grafana Loki، لأنه لا يفهرس نص السجل وإنما التسميات Labels فقط، فيحتاج مساحة وذاكرة أقل بكثير، ويظهر في Grafana نفسه بجانب المقاييس. والصورة التالية من مقال جمع السجلات مركزياً مع Grafana Loki:
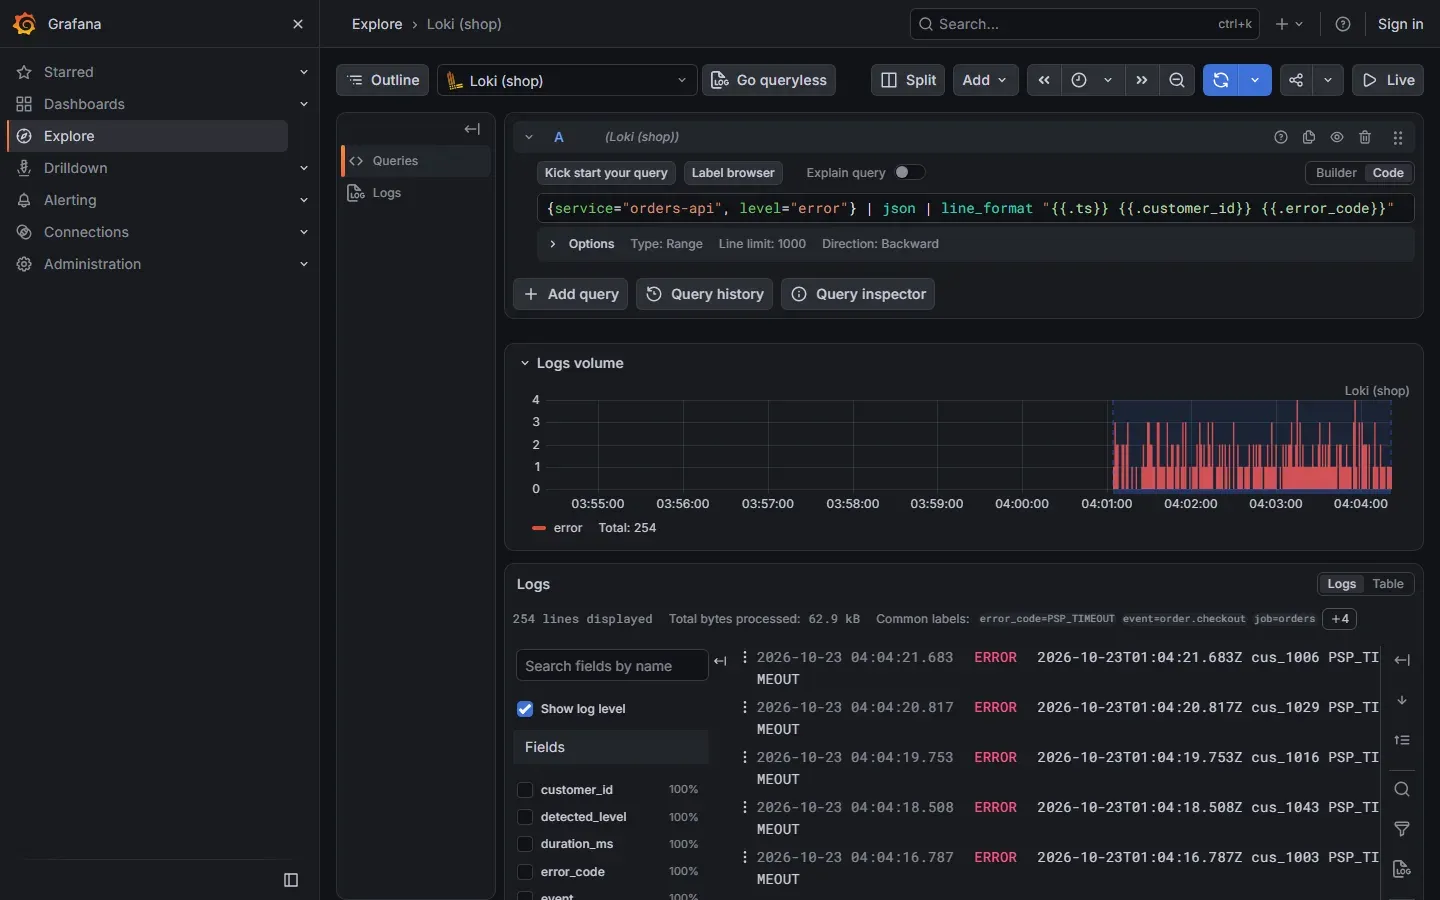
الاستعلام في أعلى الصورة يختار سجلات الخدمة orders-api بمستوى error فقط، ثم يحلل كل سطر كـ JSON، ثم يعيد تنسيقه. والرسم الأحمر تحته يبين متى بدأت الأخطاء، فقد بدأت بعد دقيقتين من تشغيل التطبيق، ومجموعها 254 سطراً، وفي السطور نفسها الرمز PSP_TIMEOUT الذي يقول إن بوابة الدفع هي التي تأخرت. وهذا هو الطريق الذي يجب أن يكون قصيراً: من التنبيه إلى السطر الذي يشرحه في أقل من دقيقة.
وإذا كان فريقك يحتاج بحثاً نصياً كاملاً في كل كلمة، أو تنبيهات معقدة على السجلات، أو كان لديك فريق أمن يريد واجهة بحث خاصة، فقارن مع Graylog وOpenSearch وVictoriaLogs في مقارنة أدوات السجلات المركزية بالأرقام، واقرأ كيف يمر السجل من التطبيق إلى البحث، وكيف تحجب البيانات الشخصية في الطريق، في مسار السجل Log Pipeline.
| التنبيه | الشرط المقترح للبداية | المستوى |
|---|---|---|
| ارتفاع أسطر الخطأ | عدد أسطر level="error" في 5 دقائق أعلى من ثلاثة أضعاف المعتاد | ملخص، وعاجل إذا صاحبه ارتفاع 5xx |
| خطأ محدد خطير | ظهور نص مثل OutOfMemoryError أو FATAL | عاجل |
| السجلات توقفت | لا أسطر من خدمة معروفة لمدة 15 دقيقة | ملخص يومي |
المنطقة الخامسة: التتبع Traces مع الأخطاء Errors
عندما كبرت منصة الحجوزات وصارت ثلاث خدمات، خدمة الويب وخدمة الدفع وخدمة الإشعارات، ظهرت مشكلة لا تحلها المقاييس ولا السجلات وحدها: الطلب بطيء، ولكن أين؟ فالطلب الواحد يمر بثلاث خدمات وقاعدتي بيانات وبوابة دفع خارجية، وكل خدمة تقول إن زمنها طبيعي. وهنا يأتي التتبع الموزع Distributed Tracing، الذي يعطي كل طلب معرفاً يمر معه في كل خدمة، ويسجل كل خطوة فيه كجزء Span له بداية ونهاية، ثم يرسمها على خط زمني واحد.
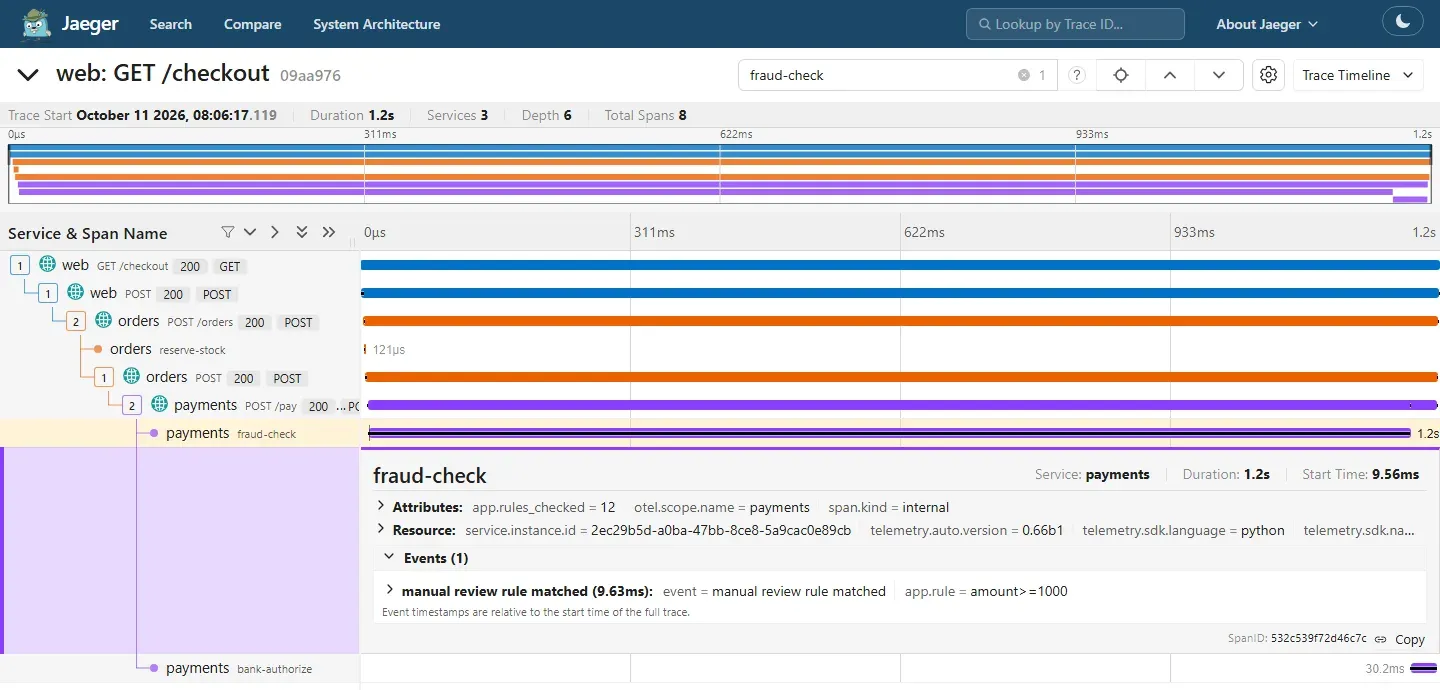
في الصورة طلب الدفع GET /checkout أخذ 1.2 ثانية، ومر بثلاث خدمات في ثمانية Spans. والشريط الطويل هو فحص الاحتيال fraud-check في خدمة الدفع، ومعه حدث يقول إن قاعدة المراجعة اليدوية انطبقت لأن المبلغ 1000 أو أكثر، بينما تفويض البنك نفسه أخذ 30.2 ميلي ثانية فقط. أي أن البطء في قاعدة عمل داخلية وليس في البنك كما ظن الجميع. والأدوات هنا OpenTelemetry لجمع التتبع من التطبيق، وJaeger أو Grafana Tempo لحفظه وعرضه، والتفاصيل في التتبع الموزع Distributed Tracing مع OpenTelemetry.
والوجه الآخر لهذه المنطقة تتبع الأخطاء Error Tracking. فسجل الخطأ يقول إن استثناء Exception حدث، ولكن أداة تتبع الأخطاء تجمع كل الأحداث المتشابهة في مشكلة واحدة Issue، وتعدها، وتعرض معها الـ Stack Trace وإصدار التطبيق وسطور الكود، وتخبرك عندما يظهر خطأ جديد لم يحدث من قبل، أو عندما يعود خطأ أغلقته. والصورة التالية من GlitchTip، البديل مفتوح المصدر المتوافق مع Sentry SDK:
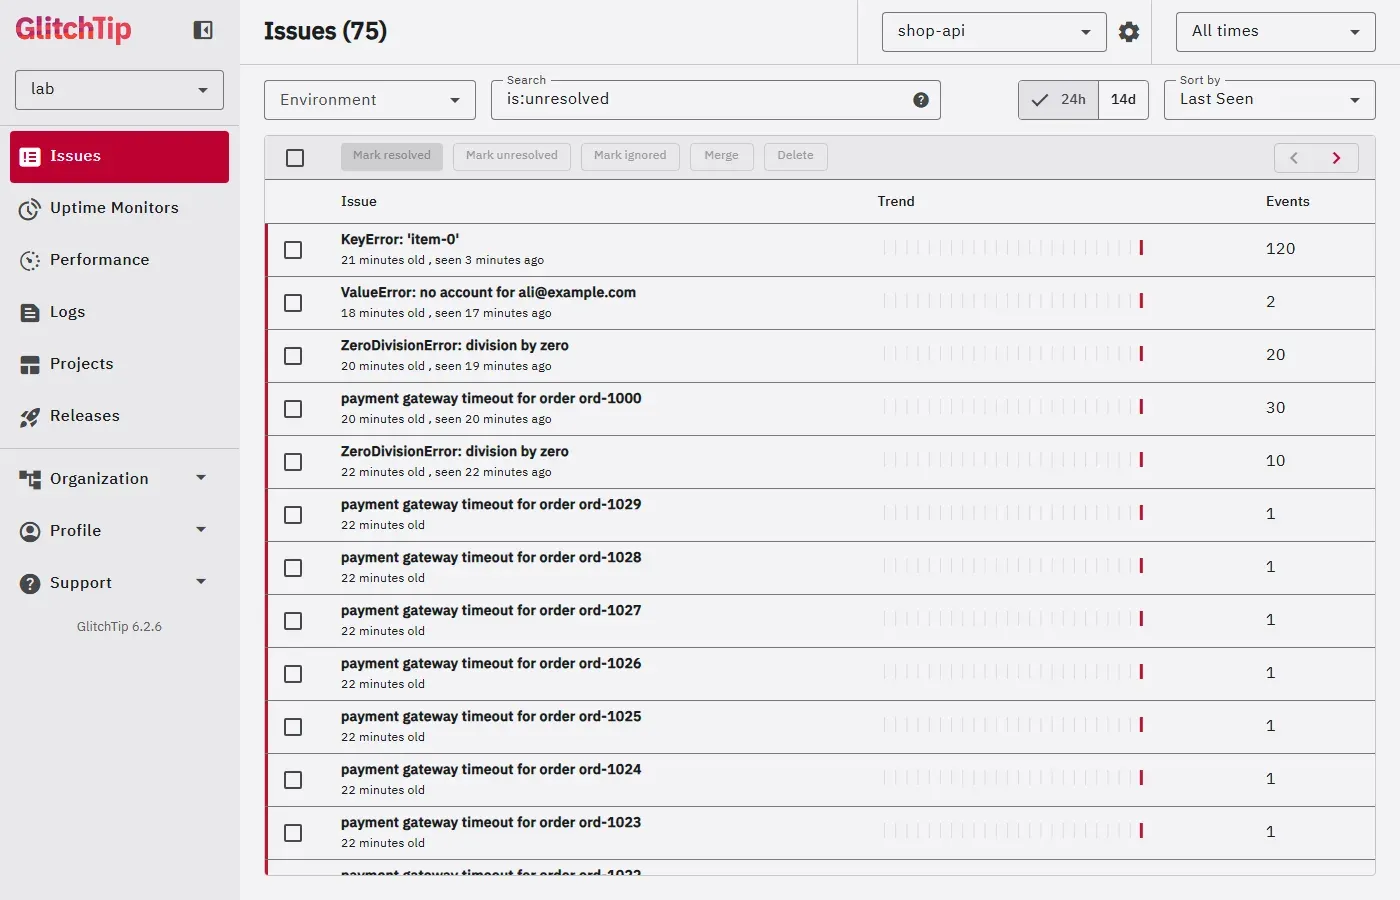
في أعلى القائمة الخطأ KeyError بعدد 120 حدثاً في مشكلة واحدة، وهذا ما تريده: سطر واحد تقرر بشأنه. ولكن في أسفلها مشكلات payment gateway timeout لكل طلب على حدة، لأن رقم الطلب كان جزءاً من رسالة الخطأ، فظنت الأداة أن كل رسالة خطأ مختلف. ولاحظ أيضاً البريد الذي ظهر في رسالة أحد الأخطاء، وهذا سبب لتحجب البيانات الشخصية قبل أن ترسل الأحداث، كما شرحنا في تتبع الأخطاء Error Tracking مع GlitchTip. والتنبيه المفيد هنا ليس على كل خطأ، وإنما على المشكلة الجديدة بعد كل إصدار، وعلى المشكلة التي يرتفع عدد أحداثها فجأة.
المنطقة السادسة: الـ Containers
أغلب التطبيقات اليوم تعمل في Containers، وهذه تضيف نوعاً من الأعطال لا تراه مقاييس السيرفر: الـ Container الذي يموت ويعاد تشغيله تلقائياً. فإذا كان لديك restart: unless-stopped في Docker Compose، أو كنت على Kubernetes، فإن التطبيق الذي يتجاوز حد الذاكرة يقتله النظام بسبب نفاد الذاكرة OOM Kill، ثم يعاد تشغيله في ثوان، والفحص من الخارج قد لا يلاحظ شيئاً، والعميل الذي كان طلبه في تلك اللحظة يرى خطأ. وإذا تكرر ذلك كل ساعة فلديك مشكلة حقيقية مخفية خلف آلية الإصلاح الذاتي.
- إعادة التشغيل Restarts: عدد مرات إعادة تشغيل كل Container في آخر 15 دقيقة.
- القتل بسبب نفاد الذاكرة OOM: عداد أحداث OOM لكل Container، والذاكرة المستخدمة مقابل الحد المسموح Limit.
- المعالج مقابل الحد: التقييد Throttling إذا كان للـ Container حد معالج، لأنه يبطئ التطبيق دون أي خطأ.
- الحالة: هل كل Container متوقع يعمل، وهل فحص الصحة Healthcheck فيه ناجح.
والأداة على Docker هي cAdvisor، أو المكون المدمج نفسه في Grafana Alloy، وعلى Kubernetes تضيف kube-state-metrics الذي يعرض حالة كل Pod وعدد إعادة تشغيله. ولكن انتبه لما وجدناه في المختبر، والصورة التالية تشرحه:
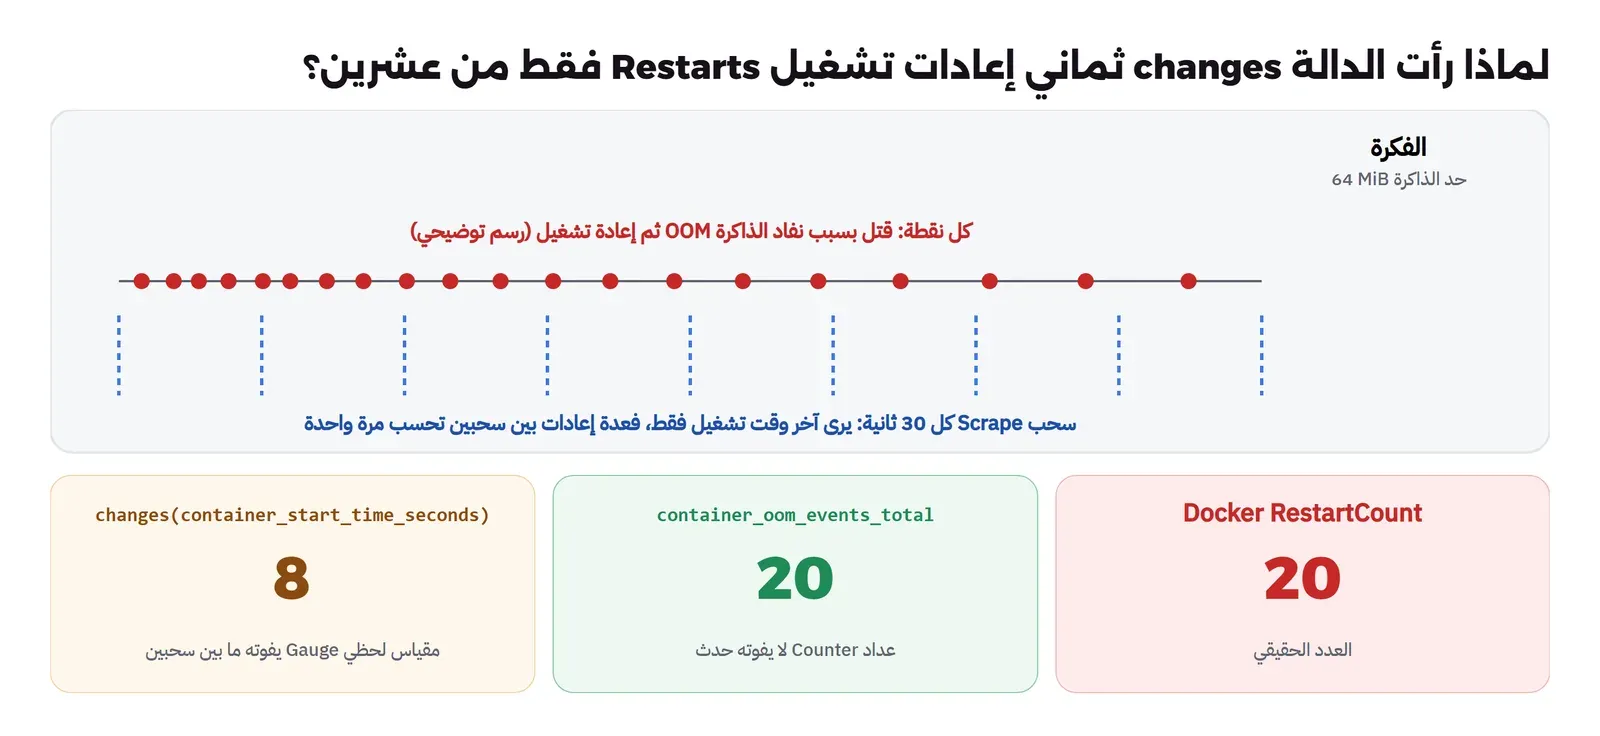
في التجربة قتل Container عشرين مرة، وDocker نفسه يقول 20، وعداد أحداث OOM يقول 20، ولكن الطريقة التي ستجدها في أغلب الأمثلة على الإنترنت، أي عد التغيرات في وقت بدء التشغيل، قالت 8 فقط. والسبب أن Prometheus يسحب كل 30 ثانية، فإذا أعيد تشغيل الـ Container مرتين بين سحبين فلن يرى إلا الأخيرة. ولهذا اعتمد على العدادات Counters كلما وجدتها، وجرب كل تنبيه بحدث حقيقي قبل أن تثق به، فقد رأينا في مقال البوابة الواحدة عداداً في مكون مدمج يقول صفراً بعد خمس مرات قتل حقيقية.
| التنبيه | الشرط المقترح للبداية | المستوى |
|---|---|---|
| قتل بسبب نفاد الذاكرة | increase(container_oom_events_total[15m]) > 0 | ملخص، وعاجل إذا تكرر في خدمة حرجة |
| إعادة تشغيل متكررة | أكثر من مرتين في 15 دقيقة | عاجل للخدمات الحرجة |
| الذاكرة قريبة من الحد | فوق 90% من الحد لمدة 15 دقيقة | ملخص يومي |
وإذا كنت تفكر في الانتقال إلى Kubernetes بسبب المراقبة أو إعادة التشغيل، فاقرأ أولاً هل تحتاج Kubernetes فعلاً؟، لأن أغلب ما في هذا القسم يعمل على Docker Compose كما هو.
المنطقة السابعة: قواعد البيانات Databases
قاعدة البيانات هي المكان الذي تنتهي إليه أغلب مشاكل الأداء، وهي أيضاً المكان الذي يصعب فيه الإصلاح السريع. فلا تستطيع أن تعيد تشغيلها كما تعيد تشغيل Container، ولا أن تضيف نسخة منها في دقيقة. ولذلك تحتاج قاعدة البيانات مراقبة خاصة بها فوق مراقبة السيرفر، ومقاييسها تأتي من داخلها وليس من نظام التشغيل. وفي حالة PostgreSQL، وهي الأكثر استخداماً عند الفرق التي نكتب لها، هذه أهم الأسئلة:
- الاتصالات Connections: كم اتصالاً مفتوحاً مقابل الحد
max_connections، وكم منها في حالةidle in transaction، لأن هذه تمسك أقفالاً Locks وتمنع التنظيف. - الاستعلامات البطيئة Slow Queries: من الامتداد
pg_stat_statements، أي الاستعلامات التي تأخذ أكثر وقت إجمالي، وليس فقط الأبطأ في المرة الواحدة. - التكرار Replication: كم تتأخر النسخة الثانوية Replica عن الرئيسية، لأن التأخر الكبير يعني أن التحويل إليها يفقد بيانات.
- الصفوف الميتة Dead Tuples: هل يلحق التنظيف التلقائي Autovacuum بالتحديثات والحذف، أم أن الجداول تنتفخ.
- الأقفال Locks والتعارض Deadlocks: عدد الاستعلامات المنتظرة على قفل، وعدد حالات التعارض.
- نمو القرص Disk Growth: حجم قاعدة البيانات وأكبر الجداول والفهارس يوماً بيوم، وحجم مجلد WAL، لأن قاعدة البيانات هي غالباً أسرع ما يملأ قرص سيرفرها، وهنا يعمل توقع الامتلاء من المنطقة الأولى على مجلد البيانات تحديداً.
- أرشفة WAL: هل تنجح أرشفة ملفات WAL إلى مكان النسخ، لأنها أساس الاستعادة إلى لحظة محددة.
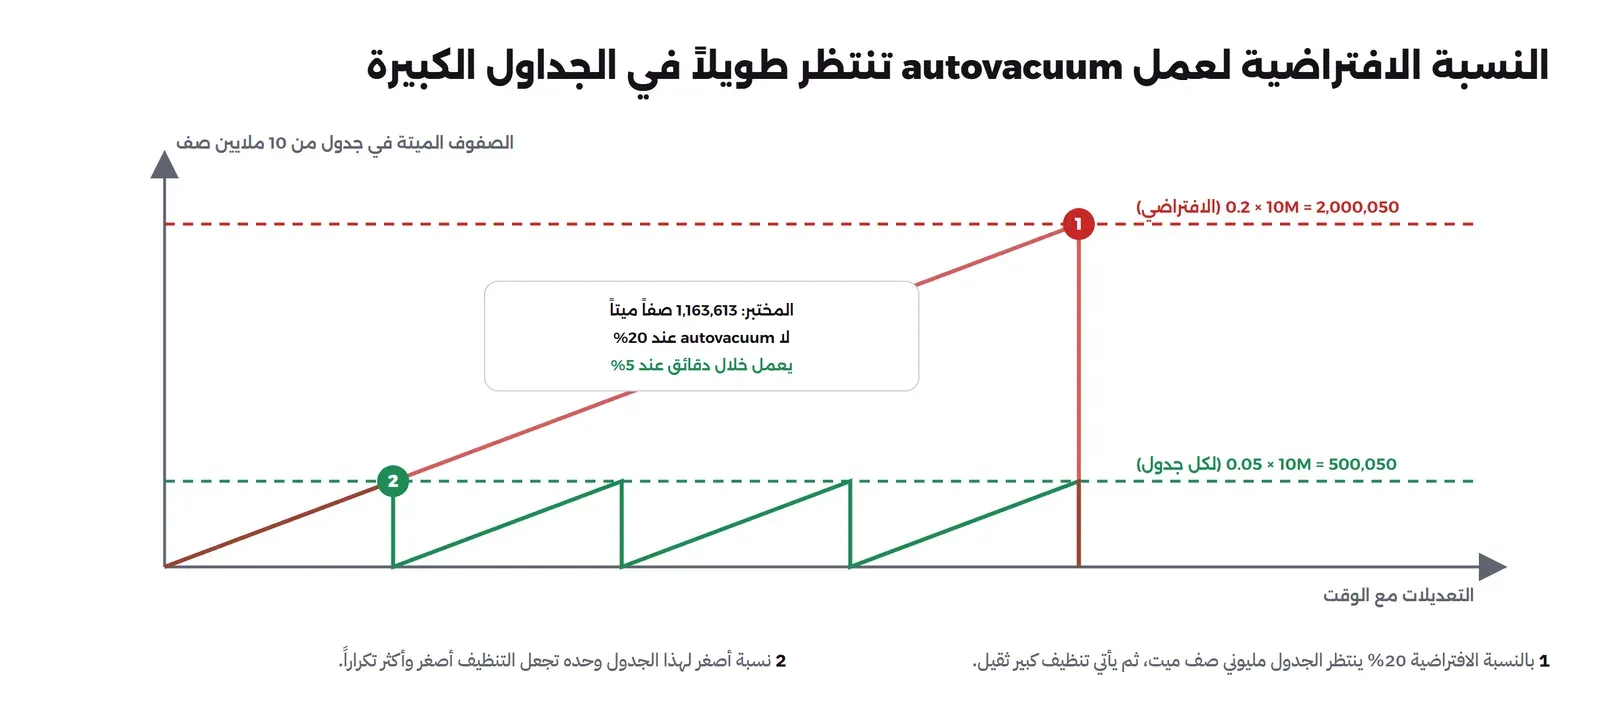
الرسم يبين لماذا تراقب الصفوف الميتة: بالإعداد الافتراضي ينتظر التنظيف التلقائي حتى يصبح 20% من الجدول صفوفاً ميتة، وفي جدول بعشرة ملايين صف هذا يعني مليوني صف، وفي المختبر وصلنا إلى 1,163,613 صفاً ميتاً ولم يبدأ التنظيف بعد. وعندما خفضنا النسبة إلى 5% لهذا الجدول صار التنظيف يعمل كل دقائق بكميات صغيرة. والأداة لجمع هذه المقاييس في Prometheus هي postgres_exporter، ولـ MySQL وMariaDB mysqld_exporter. وطريقة القياس قبل تعديل أي إعداد في ضبط أداء PostgreSQL بالقياس، وكيف تتبع طلباً بطيئاً حتى الاستعلام الذي سببه في تتبع الطلب البطيء من المتصفح إلى قاعدة البيانات.
| التنبيه | الشرط المقترح للبداية | المستوى |
|---|---|---|
| قاعدة البيانات لا ترد | pg_up == 0 لمدة دقيقة | عاجل |
| الاتصالات قريبة من الحد | فوق 80% من max_connections لمدة 10 دقائق | عاجل إذا تجاوز 95% |
| تأخر النسخة الثانوية | أكثر من 60 ثانية لمدة 5 دقائق | ملخص، وعاجل إذا كانت للتحويل التلقائي |
| فشل أرشفة WAL | عدد مرات الفشل يزيد | عاجل، لأن الاستعادة إلى لحظة محددة متوقفة |
| معاملة مفتوحة طويلاً | أقدم معاملة أكثر من ساعة | ملخص يومي |
المنطقة الثامنة: الشهادات Certificates مع DNS
الشهادة المنتهية هي أكثر عطل نعرفه يمكن توقعه بالضبط، ومع ذلك يتكرر. فتاريخ انتهائها مكتوب فيها منذ يوم صدورها، ومع ذلك تنتهي في يوم ما ويتوقف الموقع أو التطبيق أو الاتصال بين خدمتين، وقد رأينا في حالة Equifax أن شهادة منتهية على جهاز فحص أوقفت الكشف عشرة أشهر دون أن يتوقف شيء ظاهر. والسبب أن التجديد التلقائي يعطي إحساساً بالأمان: Certbot يجدد كل شيء، حتى اليوم الذي تغير فيه إعداد DNS أو أغلق فيه المنفذ 80 فيفشل التجديد بصمت.
وهذا سيصبح أهم في السنوات القادمة. فقد أقر منتدى CA/Browser Forum في 2025 جدولاً لتقصير مدة الشهادات يبدأ في مارس 2026 وينتهي في مارس 2029، تنخفض فيه أطول مدة للشهادة من 398 يوماً إلى 47 يوماً، أي أن التجديد اليدوي لن يكون خياراً. وفي الوقت نفسه أوقفت Let's Encrypt رسائل التذكير بانتهاء الشهادات بالبريد ابتداءً من 4 يونيو 2025، فإذا كنت تعتمد على تلك الرسائل فلم يعد يصلك شيء.
- الأيام المتبقية لكل شهادة: من الفحص الخارجي، لأن ما يهم هو الشهادة التي يقدمها السيرفر فعلاً وليس الملف على القرص. والمقياس في Blackbox هو
probe_ssl_earliest_cert_expiry، وهو تاريخ انتهاء أقرب شهادة في السلسلة، بما فيها الوسيطة. - الشهادات الداخلية: بين الخدمات، وشهادات قواعد البيانات، وشهادات أجهزة الشبكة والـ VPN، وهذه لا يفحصها أحد من الخارج، فأضفها إلى قائمة الفحص الداخلي.
- DNS: هل يرد النطاق بالعنوان الصحيح، من خلال وحدة
dnsفي Blackbox، لأن تغييراً خاطئاً في سجل واحد يوقف كل شيء ولا يظهر في أي مقياس على السيرفر. - تسجيل النطاق: تاريخ انتهاء تسجيل النطاق نفسه عند المسجل Registrar. فعل التجديد التلقائي، واقرأ التاريخ دورياً عبر بروتوكول RDAP بسكربت صغير إن أردت تنبيهاً.
وقد شرحنا كيف تبنى الشهادة وسلسلتها وصيغ ملفاتها في الشهادات الرقمية TLS وX.509، وكيف يخدم سيرفر واحد نطاقات كثيرة في SNI وشهادة SAN، وسجلات DNS في شرح DNS وسجلاته. وفي لقطة البوابة في آخر هذا الدليل ستجد لوح «Certificate days left» لنطاقين، وهو بالضبط ما نقصده هنا.
| التنبيه | الشرط المقترح للبداية | المستوى |
|---|---|---|
| الشهادة تقترب من الانتهاء | أقل من 14 يوماً | ملخص يومي |
| الشهادة على وشك الانتهاء | أقل من 3 أيام | عاجل |
| DNS لا يرد أو يرد بعنوان خاطئ | فشل فحص dns لمدة 5 دقائق | عاجل |
| تسجيل النطاق يقترب من الانتهاء | أقل من 30 يوماً من قراءة RDAP | ملخص يومي |
ولماذا 14 يوماً؟ لأن Certbot من الإصدار 4.0.0 يجدد الشهادة عندما يبقى أقل من ثلث مدتها، أي قرابة 30 يوماً لشهادة مدتها 90 يوماً، فإذا وصلت الشهادة إلى 14 يوماً فهذا يعني أن التجديد يفشل منذ أسبوعين. ومع تقصير مدة الشهادات راجع هذا الحد بحسب مدة شهاداتك، فشهادة مدتها 47 يوماً تجدد قبل الانتهاء بقرابة 15 يوماً، والحد المناسب لها أقصر.
المنطقة التاسعة: النسخ الاحتياطي Backups مع المهام المجدولة Cron Jobs
هذه المنطقة هي التي أسقطت GitLab، وهي الأصعب في المراقبة، لأن المشكلة فيها غياب حدث وليس حدوثه. فالخطأ الذي يحدث يمكن أن تبحث عنه في السجلات، ولكن المهمة التي لم تعمل أصلاً، لأن السيرفر أعيد تشغيله وضاع جدول crontab، أو لأن السكربت علق ولم ينته، لا تكتب شيئاً في أي مكان. وفي حالة GitLab كان التنبيه موجوداً، ولكنه كان يرسل بالبريد، والبريد كان يرفض، فلم يصل شيء ولم ينتبه أحد لغياب الرسائل.
الحل: مفتاح الرجل الميت Dead Man's Switch
الفكرة أن تقلب السؤال: بدل أن تنبه عند الفشل، تنبه عند غياب النجاح. فكل مهمة، عندما تنجح فقط، ترسل نبضة Heartbeat إلى مكان ما، وأداة المراقبة تتوقع النبضة في موعدها، فإذا لم تصل خلال المدة المحددة أطلقت التنبيه. وبهذا يغطي تنبيه واحد كل أسباب الفشل: السكربت أخطأ، أو علق، أو لم يبدأ، أو السيرفر متوقف، أو الشبكة مقطوعة. وطريقتان لتطبيقها:
- رابط Push: في Uptime Kuma أو Healthchecks مفتوح المصدر، تنشئ فحصاً من نوع Push، فتعطيك الأداة رابطاً تستدعيه المهمة بـ
curlفي آخر سطر بعد النجاح. - ملف textfile: المهمة تكتب في آخرها وقت النجاح كمقياس في ملف، ويقرؤه node_exporter أو Alloy، ثم تنبه Prometheus إذا كان الوقت أقدم من المتوقع.
time() - backup_last_success_timestamp_seconds > 26*3600هذا السطر يقول: إذا مر على آخر نسخة ناجحة أكثر من 26 ساعة، والنسخة يومية، فهناك مشكلة. والساعتان الإضافيتان هامش لأن النسخة لا تنتهي في الدقيقة نفسها كل يوم. ولا تنس تنبيهاً ثانياً على غياب المقياس نفسه absent(...)، لأن السيرفر الذي لم يرسل المقياس أبداً لا يطلق التنبيه الأول. والصورة التالية من مقال فحص التوفر:
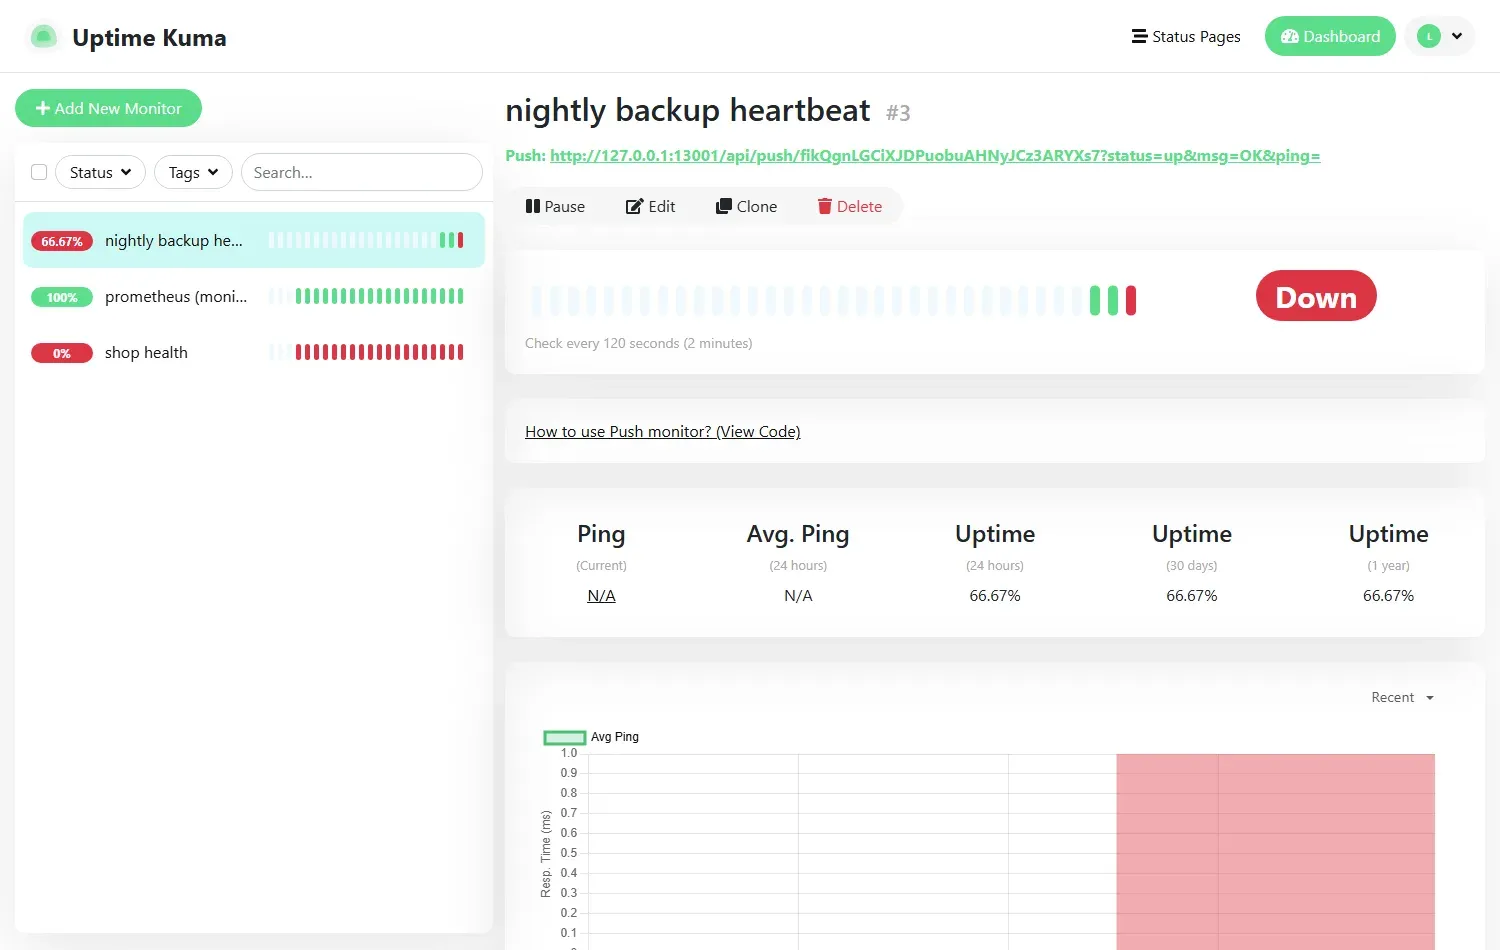
في الصورة فحص من نوع Push اسمه nightly backup heartbeat، ورابطه في الأعلى ينتهي بـ status=up&msg=OK، وهو ما يستدعيه سكربت النسخ بعد النجاح. والأشرطة في الأسفل اثنان أخضران، أي نبضتان وصلتا، ثم أحمر لأن النبضة الثالثة لم تصل في موعدها، فتحولت الحالة إلى Down دون أن يكتب السكربت أي خطأ.
نجاح المهمة لا يعني أن النسخة صالحة Restore Test
والنبضة تقول إن المهمة انتهت بنجاح، ولكنها لا تقول إن النسخة صالحة. فنسخة GitLab كانت ستنتهي بنجاح لو كتبت ملفاً فارغاً. ولذلك أضف إلى المقياس حجم النسخة وعدد الملفات، ونبه إذا نزل الحجم فجأة عن المعتاد، وراقب عمر آخر نسخة في المستودع نفسه وليس فقط في السكربت. والصورة التالية من Kopia تبين ما نقصده:
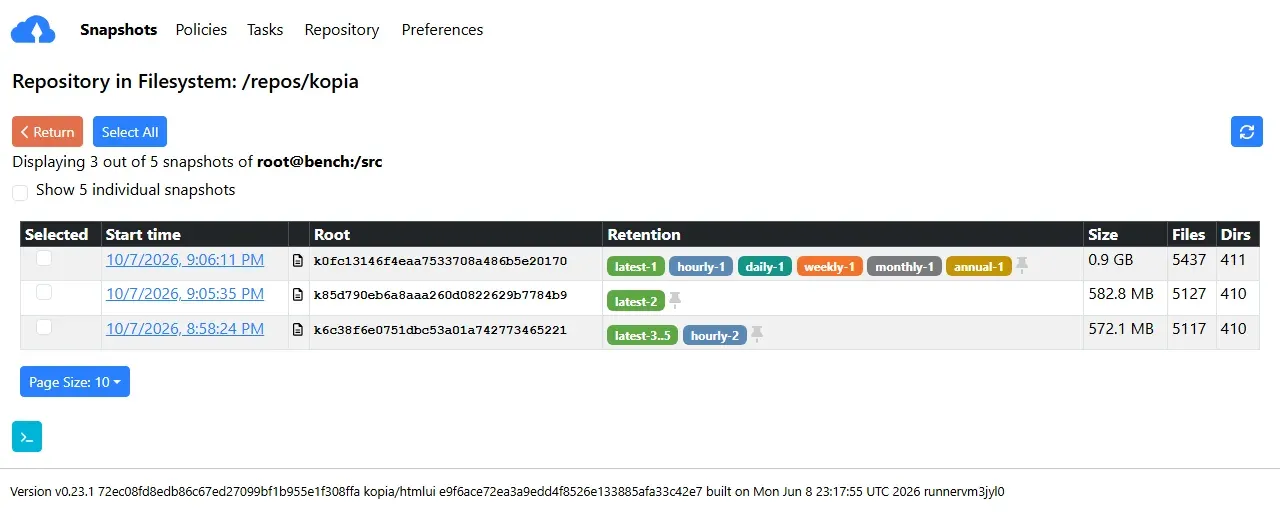
لكل نسخة في الصورة حجم وعدد ملفات، وهذان رقمان يمكن أن تنبه عليهما: إذا كانت النسخ اليومية بين 570 و900 MB ثم جاءت نسخة بحجم 3 MB، فهي نجحت من وجهة نظر الأداة وفشلت من وجهة نظرك. وبجانب كل نسخة وسوم الاحتفاظ التي تقول لماذا ما زالت موجودة. ولكن الاختبار الوحيد الذي يثبت أن النسخة صالحة هو الاستعادة، فاجعل استعادة تجريبية مجدولة كل شهر إلى سيرفر مؤقت، ونبه على نتيجتها بالنبضة نفسها. والقاعدة كاملة في النسخ الاحتياطي بقاعدة 3-2-1 واختبار الاستعادة، والاستعادة إلى لحظة محددة لـ PostgreSQL في استعادة PostgreSQL مع pgBackRest.
| التنبيه | الشرط المقترح للبداية | المستوى |
|---|---|---|
| النسخة لم تنجح في موعدها | آخر نجاح أقدم من الدورة مع هامش، 26 ساعة للنسخة اليومية | ملخص يومي، وعاجل بعد يومين |
| المقياس غائب | absent() لمدة 30 دقيقة | ملخص يومي |
| حجم النسخة غير طبيعي | أقل من نصف متوسط آخر سبع نسخ | ملخص يومي |
| الاستعادة التجريبية فشلت | غياب نبضة الاستعادة الشهرية | ملخص يومي |
| أي مهمة مجدولة مهمة | نبضة لكل مهمة بمدة دورتها | بحسب أهمية المهمة |
المنطقة العاشرة: الأحداث الأمنية Security Events
كل ما سبق يسأل هل الخدمة تعمل، وهذا القسم يسأل سؤالاً آخر: هل يحاول أحد أن يدخل، وهل نجح؟ ففي حالة Equifax كان المهاجمون يشغلون أوامر على السيرفر ويخرجون البيانات قرابة 76 يوماً، وكل ذلك كان في السجلات وحركة الشبكة، ولكن لا أحد كان يقرأ. والسجلات الأمنية Security Logs لها طبيعة مختلفة عن سجلات التطبيق: الحدث الواحد المهم يضيع بين ملايين الأحداث العادية، والمهاجم الجيد يحاول أن يبدو كحركة طبيعية، والقيمة تأتي من الربط بين أحداث متفرقة، مثل محاولات دخول فاشلة كثيرة ثم دخول ناجح من العنوان نفسه.
- الدخول Authentication: محاولات الدخول الفاشلة، والدخول الناجح لحسابات المديرين، والدخول من عناوين أو أوقات غير معتادة، واستخدام
sudo. - سلامة الملفات File Integrity: أي تغيير في ملفات الإعداد، أو في
authorized_keys، أو ملفات جديدة في مجلدات التطبيق، وهو أوضح علامة على أن أحداً دخل وترك باباً خلفياً. - هجمات الويب: محاولات حقن SQL وفحص المسارات المعروفة في سجلات الـ Proxy.
- تغيرات النظام: مستخدمون جدد، وخدمات جديدة، ومنافذ جديدة مفتوحة.
- الإعدادات Configuration Assessment: هل السيرفر ما زال مطابقاً لمعيار التقوية Hardening الذي اعتمدته.
والأداة مفتوحة المصدر التي نوصي بها للفرق الصغيرة والمتوسطة هي Wazuh، وهي تجمع نظام إدارة الأحداث الأمنية SIEM مع وكيل على كل سيرفر يراقب السجلات وسلامة الملفات والإعدادات والثغرات. والصورة التالية من مختبر Wazuh:
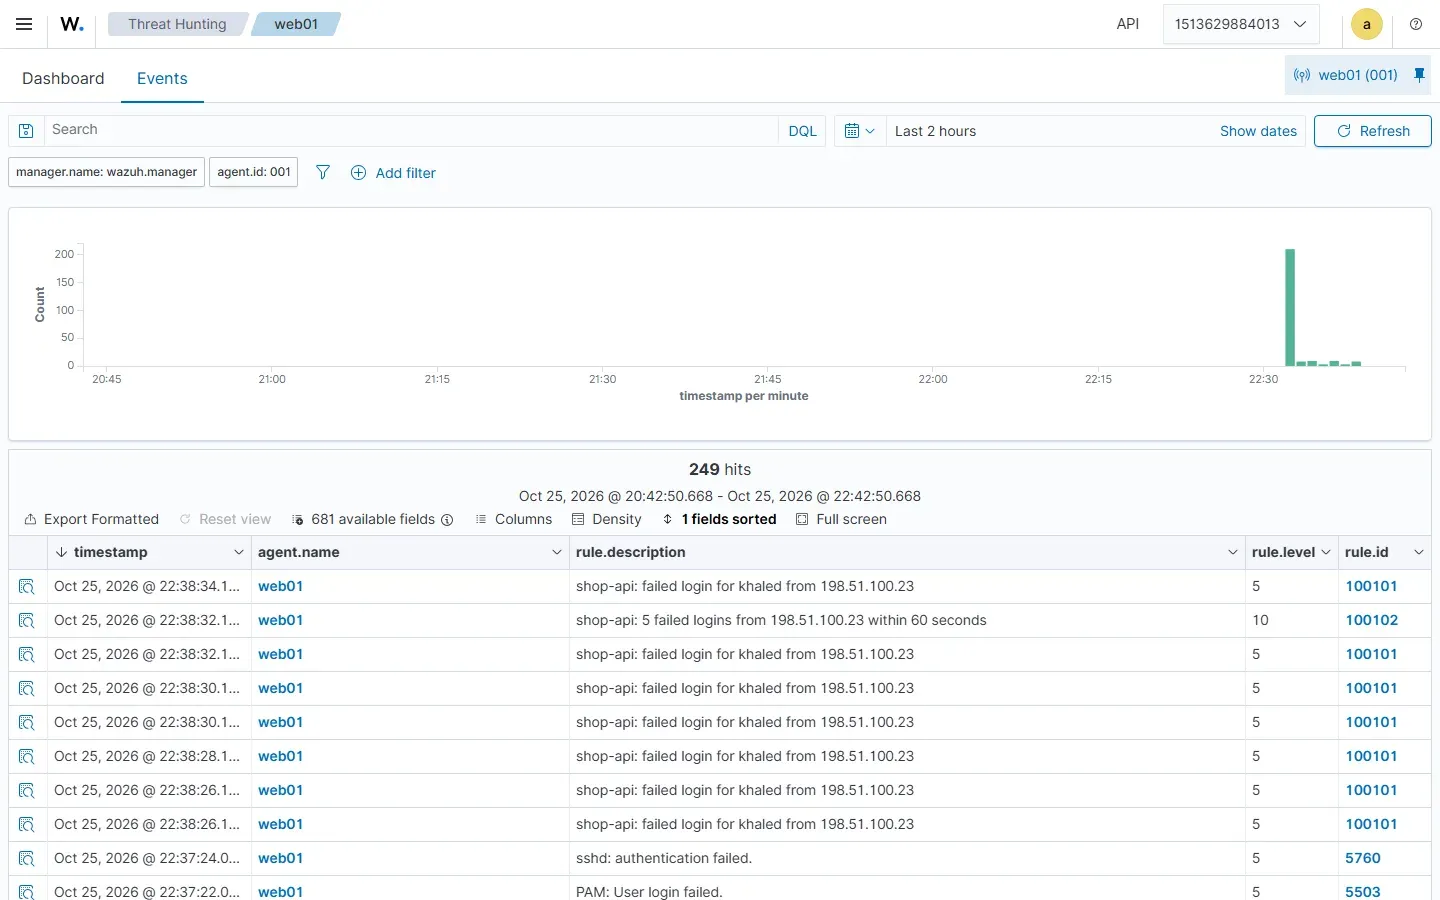
في الصورة صفحة Threat Hunting لسيرفر واحد، وفيها أحداث التطبيق بالمستوى 5، وهي أحداث تسجل ولا تحتاج أحداً، وبينها تنبيه من قاعدة محلية كتبناها برقم 100102 بالمستوى 10، وهو الذي يستحق أن يرسل. ومستويات Wazuh من 0 إلى 15، والفكرة أن تختار حداً، المستوى 10 مثلاً، فوقه يذهب التنبيه إلى المناوب، وتحته يبقى في اللوحة والملخص. وفي المختبر نفسه رفعنا مستوى أي تغيير في authorized_keys أو ملفات PHP في مجلد الموقع إلى 12، لأنه من النوع الذي لا يحدث في يوم عادي. والتفاصيل في مراقبة السيرفرات مع Wazuh، وماذا تجمع من السجلات الأمنية ومن أين في السجلات الأمنية Logs، والمقارنة مع Security Onion إذا كنت تحتاج مراقبة الشبكة نفسها في Wazuh أم Security Onion؟
ونقطة تصميم واحدة مهمة: اجعل Wazuh على سيرفره المستقل، ولا تضع عليه سجلات التطبيقات العادية. فالسجلات المركزية تستهلك القرص بسرعة لا يتوقعها أحد، وإذا امتلأ قرص Wazuh توقف استقبال الأحداث الأمنية في اللحظة التي قد تحتاجها فيها، وهذا هو السبب الذي جعلنا نفصل المراقبة عن الأمن في البوابة الواحدة.
| التنبيه | الشرط المقترح للبداية | المستوى |
|---|---|---|
| تنبيه Wazuh عالي | المستوى 10 أو أعلى | عاجل |
| تغيير في ملفات حساسة | FIM على authorized_keys و/etc ومجلد التطبيق | عاجل خارج نافذة النشر |
| تخمين كلمات المرور | محاولات فاشلة كثيرة ثم نجاح من العنوان نفسه | عاجل |
| الوكيل لا يتصل | وكيل Wazuh منقطع أكثر من 30 دقيقة | ملخص يومي |
والسطر الأخير يكرر درس Equifax: أداة الأمن التي توقفت عن العمل لا تطلق أي تنبيه أمني، ولذلك راقب الأداة نفسها كما تراقب السيرفرات.
المنطقة الحادية عشرة: الثغرات Vulnerabilities مع التحديثات Updates
في حالة Equifax لم يكن ينقص الشركة تنبيه بالثغرة، فقد وصلها من الجهة الرسمية، ولكنه ذهب إلى قائمة بريد قديمة، ثم فحصت الشبكة بعد أسبوع ولم يكتشف الفحص السيرفر المصاب. أي أن المشكلة كانت في معرفة ماذا يعمل أين، وهذا ما تجيب عنه مراقبة الثغرات: لكل سيرفر ولكل Image ولكل مستودع كود، ما المكونات وإصداراتها، وما الثغرات المعروفة فيها، وأي منها يحتاج إصلاحاً الآن.
- حزم نظام التشغيل: على كل سيرفر، ويغطيها وكيل Wazuh بخاصية كشف الثغرات Vulnerability Detection.
- الـ Images المنشورة فعلاً: وليس فقط ما في خط CI/CD، لأن ثغرات جديدة تعلن كل يوم في Images بنيتها قبل شهر. والأداة Trivy بفحص ليلي لكل Image يعمل الآن.
- اعتماديات الكود Dependencies: المكتبات التي يستخدمها تطبيقك وما تستخدمه هي، ويغطيها فحص الاعتماديات SCA، مع قائمة المكونات SBOM التي ينتجها Trivy بصيغة CycloneDX أو SPDX ويقرؤها Dependency-Track.
- تحديثات النظام المعلقة Pending Updates: عدد الحزم التي لها تحديث أمني ولم تثبت، وهل يحتاج السيرفر إعادة تشغيل بعد تحديث النواة Kernel. ويمكن أن يكتبها سكربت يومي في ملف textfile كمقياس، فيظهر في اللوحة أي سيرفر تأخر، والسياسة كاملة، أي ماذا تحدث ومتى وكيف تختبر قبل الإنتاج، في التحديثات الأمنية Patch Management.
- التحديثات المتأخرة: كم إصداراً تأخرت كل مكتبة، وهو ما يغطيه Renovate بطلبات تحديث Pull Requests تلقائية.
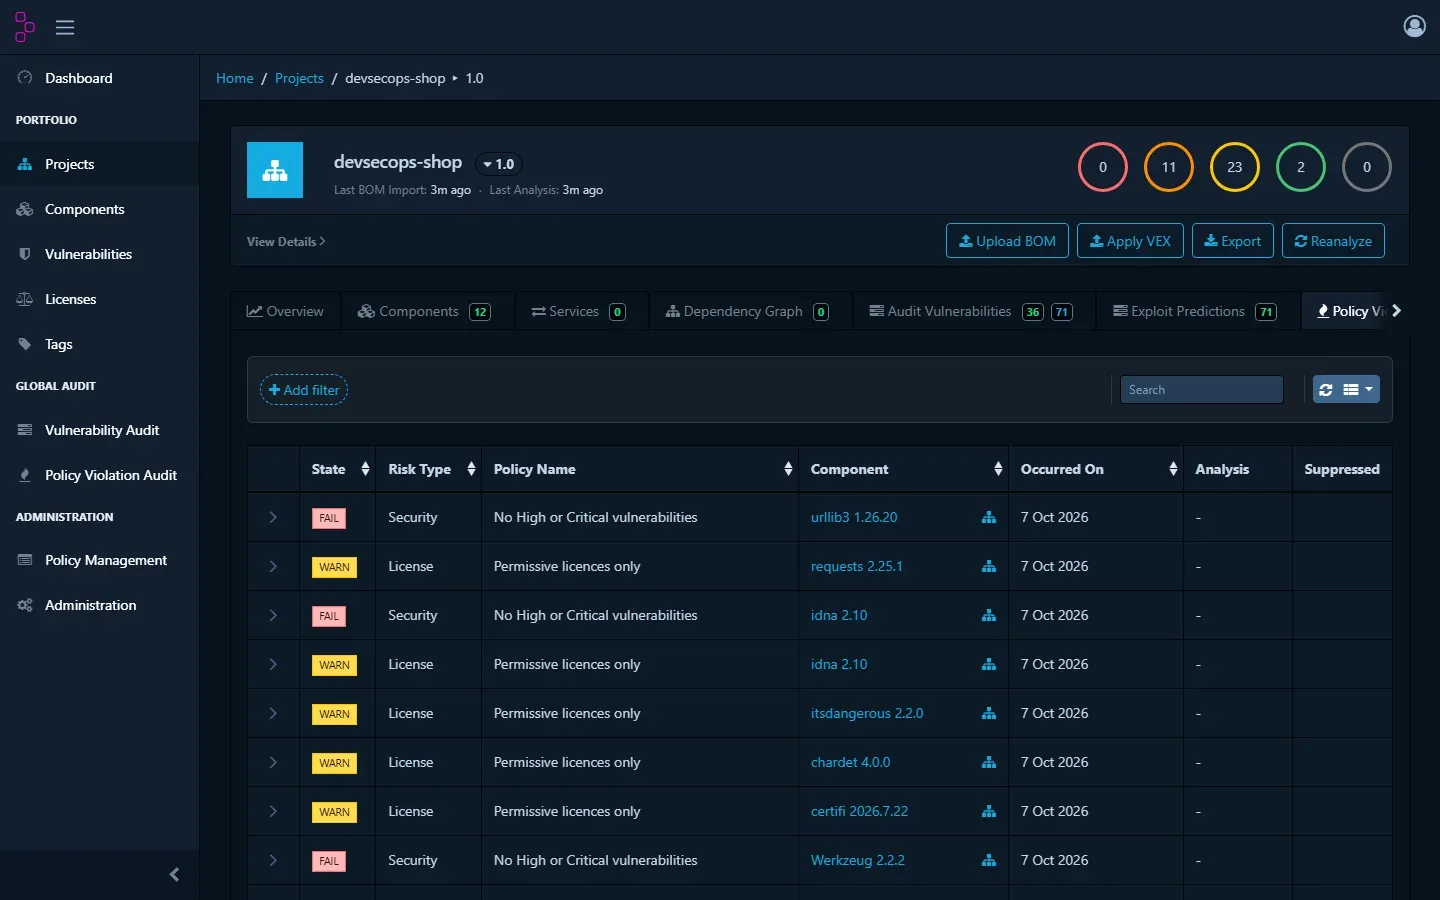
في الصورة سياستان: الأولى تقول لا ثغرات عالية أو حرجة، وخالفتها ثلاث مكتبات منها urllib3 وWerkzeug فظهرت FAIL، والثانية عن التراخيص، وخالفتها خمس مكتبات فظهرت WARN. والقيمة هنا أن Dependency-Track يعيد تقييم قائمة المكونات كل يوم، فإذا أعلنت ثغرة جديدة في مكتبة تستخدمها ظهرت هنا دون أن يعيد أحد بناء شيء. والوجه الآخر هو الإصلاح، والصورة التالية من Renovate:
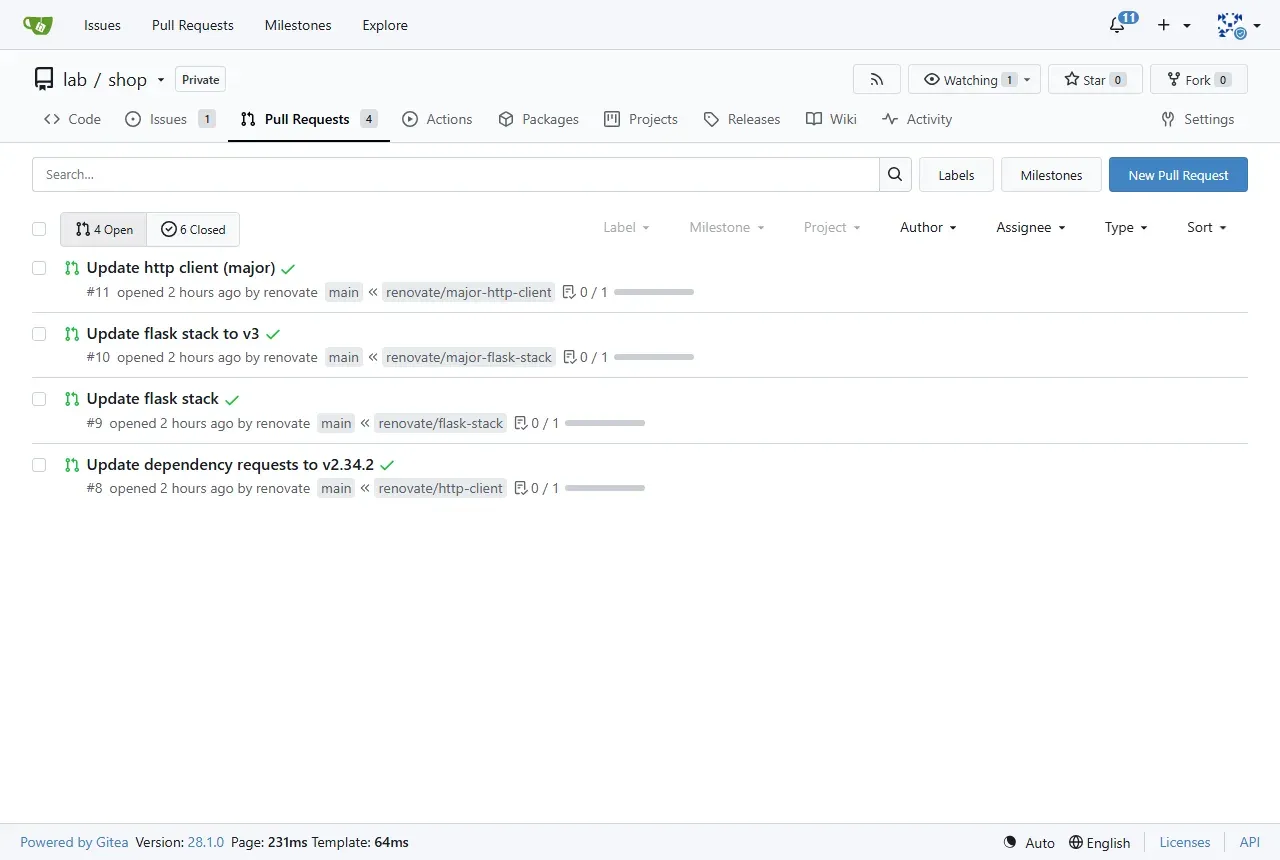
أربعة طلبات مفتوحة، كل منها يجمع مكتبات مرتبطة، والتحديثات الكبيرة Major في طلبات منفصلة لأنها قد تغير السلوك. وهذا هو الفرق بين فريق يحدث كل أسبوع بطلبات صغيرة يراجعها في دقائق، وفريق يحدث مرة في السنة بطلب ضخم يخاف الجميع من دمجه.
أي ثغرة تستحق أن توقظ أحداً؟ Vulnerability Triage
هنا يقع أغلب الفرق في الإزعاج. ففي مختبر البوابة وجد Trivy خمسين ثغرة عالية في Image رسمية لـ Python، منها 45 ليس لها إصلاح أصلاً. فلو نبهت على كل ثغرة عالية لأطلق التنبيه كل يوم دون أن يستطيع أحد أن يفعل شيئاً، ثم كتمه الجميع، ثم جاءت الثغرة الحقيقية فلم يرها أحد. والقاعدة التي نقترحها:
- عاجل: ثغرة حرجة لها إصلاح في شيء منشور، أو أي ثغرة في قائمة الثغرات المستغلة فعلاً KEV من CISA، على خدمة معرضة للإنترنت.
- ملخص يومي: الثغرات العالية التي لها إصلاح، والحرجة على خدمات داخلية.
- اللوحة فقط: ما ليس له إصلاح، مع مراجعة شهرية لأن الإصلاح قد يصدر في أي يوم.
والترتيب الكامل باستخدام CVSS واحتمال الاستغلال EPSS وقائمة KEV في أي ثغرة تصلح أولاً؟، ودورة إدارة الثغرات كاملة في إدارة الثغرات Vulnerability Management، وفحص الـ Images والبنية ككود في فحص الحاويات مع Trivy، ومقارنة الأدوات في أدوات إدارة الثغرات مفتوحة المصدر، ومتى تحدث وكيف في التحديثات الأمنية Patch Management. ولا تنس الأسرار المسربة في الكود، فهي ثغرة من نوع آخر شرحناها في Secrets Scanning.
المنطقة الثانية عشرة: التنبيهات Alerting مع المناوبة On-call
إذا طبقت كل ما سبق فلديك الآن عشرات القواعد، وهنا تبدأ المشكلة التي تقتل المراقبة في أغلب الفرق: إرهاق التنبيهات Alert Fatigue. ففريق المنصة في بدايته كان يرسل كل تنبيه إلى قناة واحدة في تطبيق المحادثة، وبعد أسبوعين وصل فيها مئتا رسالة في اليوم، فكتمها الجميع، وعندما توقف الموقع فعلاً كانت رسالة التوقف بين ثلاثين رسالة عن المعالج. والتنبيه الذي لا يقرؤه أحد أسوأ من عدم وجود تنبيه، لأنه يعطي إحساساً كاذباً بأن هناك من يراقب.
والقاعدة التي نقترحها أن يخرج كل تنبيه من أحد ثلاثة أبواب، كما في الصورة التالية:
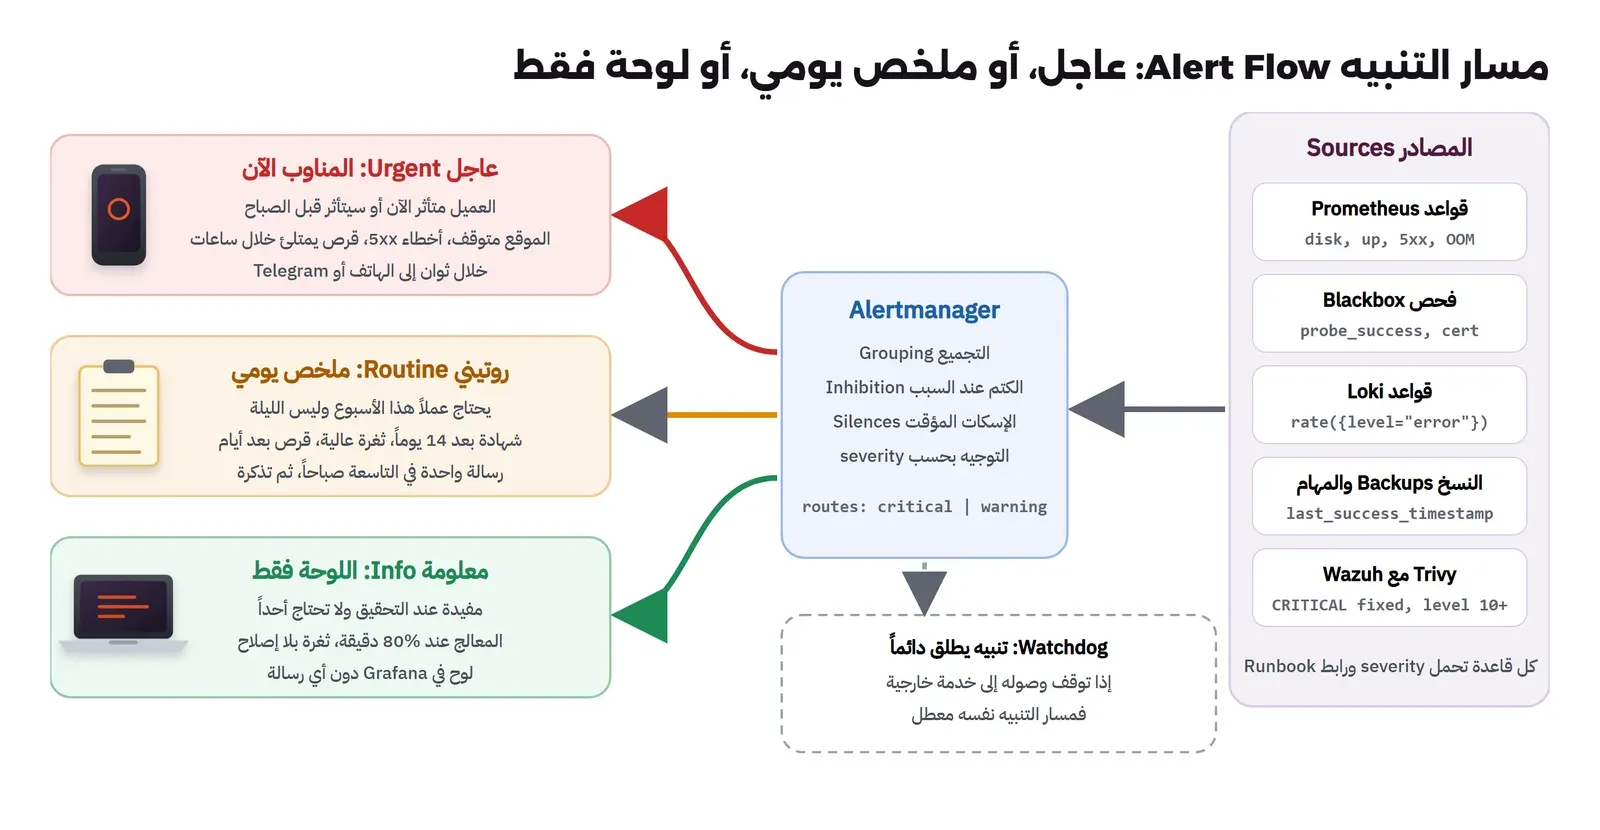
- عاجل Urgent: العميل متأثر الآن، أو سيتأثر قبل أن يبدأ الدوام. يصل إلى المناوب خلال ثوان، بالهاتف أو تطبيق يرن، وليس بالبريد. والسؤال الذي يقرر: هل يجب أن يترك أحد ما يفعله الآن؟
- روتيني Routine: يحتاج عملاً هذا الأسبوع وليس الليلة، مثل شهادة بعد 14 يوماً أو ثغرة عالية. يجمع في رسالة واحدة كل صباح، ويتحول إلى تذكرة لها صاحب.
- معلومة Info: مفيد عند التحقيق ولا يحتاج أحداً، فيبقى في اللوحة دون أي رسالة.
والأداة التي تفعل ذلك في عالم Prometheus هي Alertmanager، وهي تجمع التنبيهات المتشابهة في رسالة واحدة Grouping، وتكتم التنبيهات الناتجة عن سبب أكبر Inhibition، فإذا توقف السيرفر لا تصلك معه عشرون رسالة عن كل خدمة عليه، وتسمح بالإسكات المؤقت Silences أثناء الصيانة، ثم توجه كل تنبيه بحسب تسمية severity. ومن الإعدادات التي يجب أن تعرفها أن القيم الافتراضية هي 30 ثانية انتظار قبل أول رسالة في المجموعة group_wait، و5 دقائق بين تحديثات المجموعة group_interval، و4 ساعات قبل تكرار التنبيه نفسه repeat_interval. ويرسل Alertmanager إلى البريد وSlack وTelegram وMattermost وMicrosoft Teams وPagerDuty وأي Webhook. والصورة التالية من التجربة الحقيقية في مقال التنبيهات:
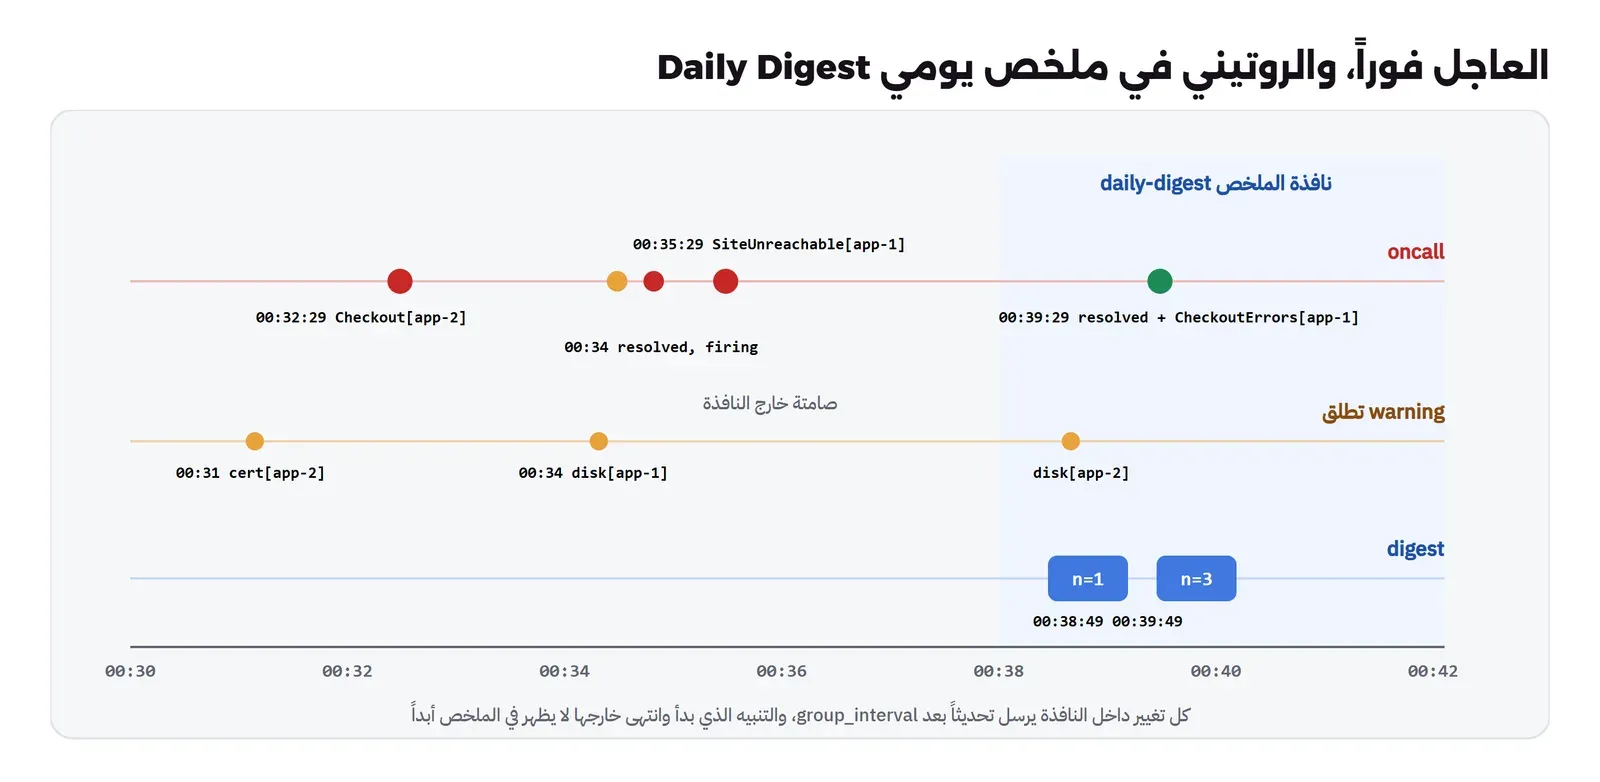
المسار العلوي في الصورة هو المناوب، ووصلته رسائل أخطاء الدفع وتوقف الموقع في ثوان من إطلاقها. والمسار الأوسط تنبيهات روتينية عن شهادة وقرصين، أطلقت في أوقات مختلفة ولم يصل منها شيء، ثم جاءت كلها في المسار السفلي داخل نافذة الملخص. ولاحظ الملاحظة في الأسفل: التنبيه الروتيني الذي بدأ وانتهى خارج النافذة لا يظهر في الملخص أبداً، وهذا مقبول للروتيني، ولكنه سبب آخر لئلا تضع أي شيء مهم في هذا المسار.
قواعد لكل تنبيه Alert Rules
- رابط دليل التشغيل Runbook: كل تنبيه يحمل رابطاً إلى صفحة تقول ماذا يعني، وكيف تتحقق، وما أول خطوة. فالمناوب في الثالثة فجراً لا يجب أن يخمن.
- مدة
for: لا تطلق على قراءة واحدة، فالشبكة تتأخر والمقاييس تهتز، ودقيقة إلى خمس دقائق تكفي أغلب الحالات. - Watchdog: تنبيه يطلق دائماً ويرسل إلى خدمة خارجية، فإذا توقف وصوله عرفت أن Prometheus أو Alertmanager أو الطريق بينهما معطل. وهذا هو الحل لمشكلة GitLab: غياب الرسائل نفسه يصبح تنبيهاً.
- مراجعة شهرية: كل تنبيه أطلق ولم يفعل أحد شيئاً بسببه، إما أن يحذف أو يغير مستواه.
- اختبار المسار: أرسل تنبيهاً تجريبياً لكل مسار مرة في الشهر، وتأكد أنه وصل إلى الشخص الصحيح.
وفي المناوبة نفسها، أي من يستقبل العاجل ومتى ومن يحل محله، فإن Alertmanager يرسل ولكنه لا يدير جداول مناوبة ولا تصعيداً Escalation. والمشروع مفتوح المصدر الذي كان يستخدم لذلك، Grafana OnCall OSS، يقول مستودعه الرسمي إنه دخل وضع الصيانة في مارس 2025 ثم أرشف، ولذلك فالفرق الصغيرة غالباً تبدأ بقناة هاتف واحدة يحملها المناوب بالتناوب، ثم تنتقل إلى خدمة مناوبة مستضافة مثل التي في جدول البدائل أدناه. والجانب الإنساني للمناوبة، وكيف لا تحرق فريقك، في ضغط المناوبة On-call والحوادث.
المنطقة الثالثة عشرة: البوابة الواحدة Single Portal
بعد أن تجمع كل هذه المناطق يأتي سؤال المدير البسيط: أين أنظر كل صباح لأعرف أن كل شيء بخير؟ وإذا كان الجواب خمس أدوات بخمس كلمات مرور، فلن ينظر أحد. ولذلك بنينا في مقال بوابة مراقبة واحدة Monitoring Portal صفحة رئيسية واحدة في Grafana تجمع ما سبق، ويبقى Wazuh على سيرفره ويقرأ منه Grafana ملخصات بمستخدم للقراءة فقط:
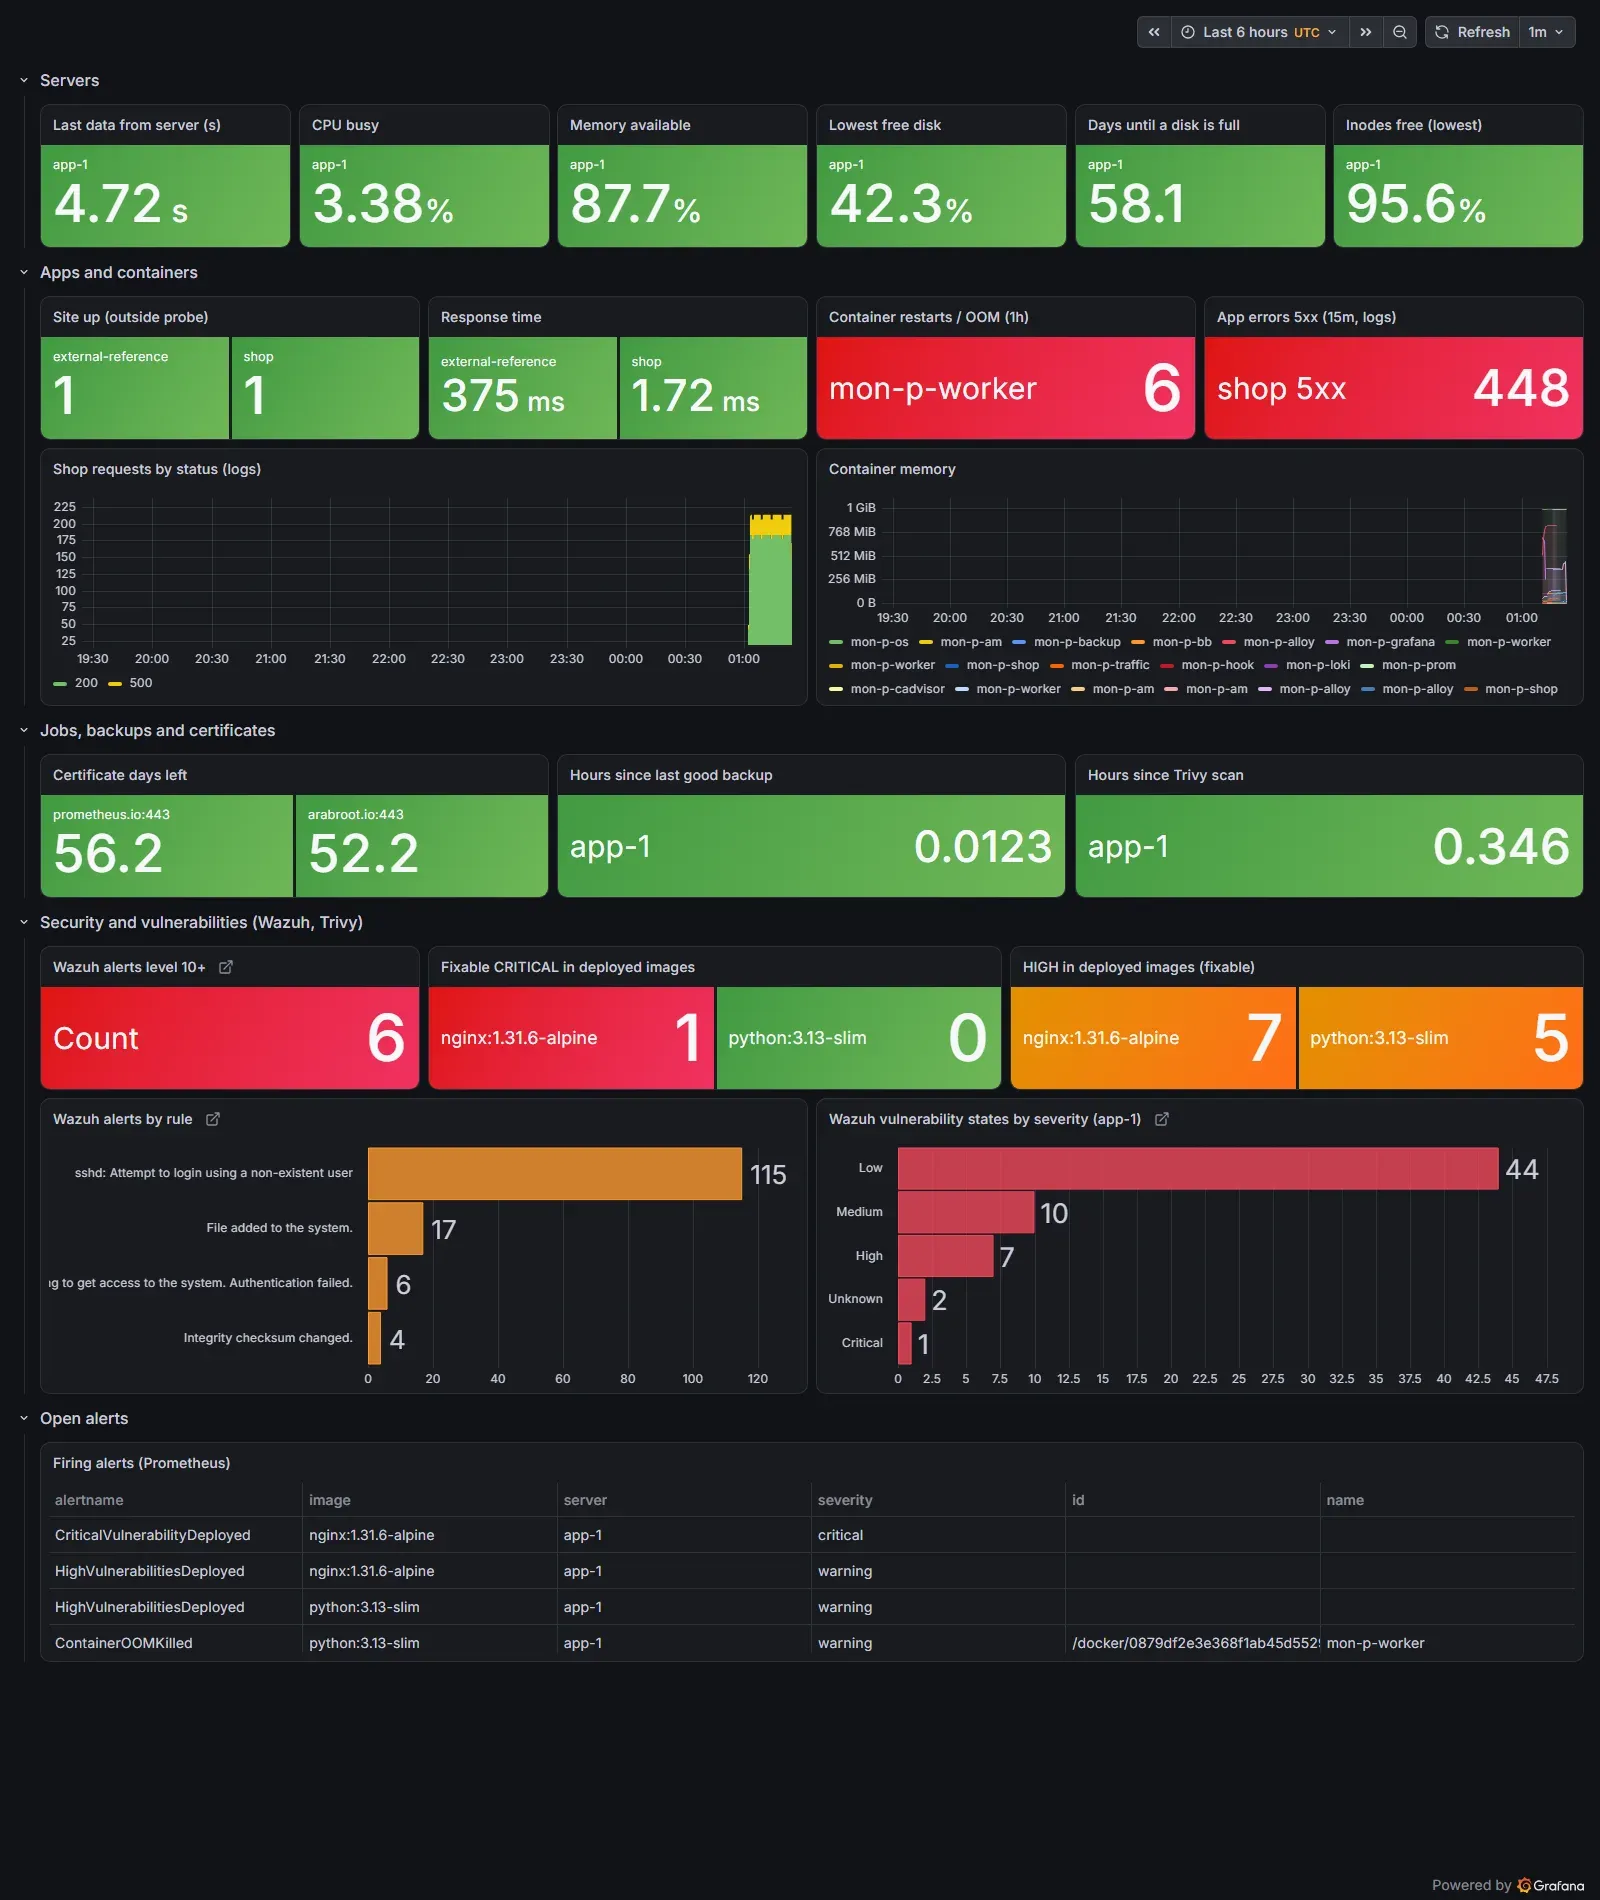
اقرأ الصفحة صفاً صفاً وستجد فيها أغلب مناطق هذا الدليل. الصف الأول للسيرفرات، وفيه آخر بيانات وصلت قبل 4.72 ثانية، والأيام حتى امتلاء القرص 58.1، والـ inodes المتاحة 95.6%. والثاني للتطبيقات والـ Containers، وفيه الموقع يعمل من الفحص الخارجي، ولكن بجانبه بالأحمر ست مرات إعادة تشغيل أو قتل بسبب الذاكرة لـ Container العامل، و448 خطأ 5xx في السجلات خلال ربع ساعة، وهذا مثال واضح على أن الفحص من الخارج وحده لا يكفي. والثالث للمهام والنسخ والشهادات: 56.2 و52.2 يوماً للشهادتين، وآخر نسخة ناجحة قبل دقائق، وآخر فحص Trivy قبل أقل من ساعة. والرابع للأمن والثغرات من Wazuh وTrivy، وفيه 115 محاولة دخول بمستخدم غير موجود، وثغرة حرجة قابلة للإصلاح في Image الـ nginx. والأخير جدول التنبيهات المطلقة الآن.
والقرارات التي تجعل هذه البوابة تعمل، وكلها مشروحة بالتفصيل في المقال: سيرفر مراقبة مستقل بقرصه، وميزانية تخزين من اليوم الأول، فقد قسنا قرابة 3,000 سلسلة Series لكل سيرفر، ولا تكرر كل سجل في نظامين، ومستخدم قراءة فقط لمصدر Wazuh، وفحص مستقل خارج البوابة يراقبها هي نفسها. والبوابة للملخص والرابط، أما التحقيق الكامل في حادثة أمنية فيبقى في Wazuh.
قائمة تحقق قابلة للطباعة Printable Checklist
هذا الجدول هو الدليل كله في صفحة، اطبعه وضعه أمام الفريق، ومر عليه سطراً سطراً: هل هذا مراقب عندنا، وبأي أداة، وإلى أين يذهب تنبيهه؟
| المنطقة | ماذا تراقب | الأداة | التنبيه | مقالنا |
|---|---|---|---|---|
| جرد الأصول | كل سيرفر وخدمة ونطاق وشهادة ومهمة، بمالك وبيئة ومنافذ، وربط كل سطر بفحوصه | جدول في Git، Snipe-IT، NetBox | تقرير أسبوعي بكل أصل غائب عن أداة مراقبة | Snipe-IT، إدارة الأصول |
| سعة السيرفر | آخر بيانات، المعالج، الذاكرة المتاحة، القرص، الـ inodes | node_exporter أو Alloy، Prometheus | up == 0 عاجل، الامتلاء خلال 4 ساعات عاجل، خلال 24 ساعة ملخص | Prometheus مع Grafana |
| التطبيقات | زمن الاستجابة p95، الطلبات، نسبة 5xx، التشبع | مكتبة Prometheus أو OpenTelemetry | 5xx فوق 5% لمدة 5 دقائق عاجل | الإشارات الذهبية |
| التوفر من الخارج | HTTP والكلمة المتوقعة، وسيرفر المراقبة نفسه | Blackbox، Uptime Kuma على سيرفر آخر | فشل الفحص لمدة دقيقة عاجل | فحص التوفر |
| السجلات | التطبيق والـ Proxy والنظام، بمدة احتفاظ مكتوبة | Loki، أو Graylog أو OpenSearch | ارتفاع أسطر الخطأ ملخص، الأخطاء القاتلة عاجل | Loki |
| التتبع والأخطاء | مسار الطلب بين الخدمات، المشكلات الجديدة بعد كل إصدار | OpenTelemetry مع Jaeger، GlitchTip | مشكلة جديدة أو ارتفاع مفاجئ ملخص | التتبع الموزع، تتبع الأخطاء |
| الـ Containers | إعادة التشغيل، OOM، الذاكرة مقابل الحد | cAdvisor أو Alloy، kube-state-metrics | OOM ملخص، إعادة تشغيل متكررة لخدمة حرجة عاجل | Prometheus مع Grafana |
| قواعد البيانات | الاتصالات، الاستعلامات البطيئة، التكرار، WAL | postgres_exporter، mysqld_exporter | القاعدة لا ترد عاجل، فشل أرشفة WAL عاجل، توقع امتلاء مجلد البيانات | ضبط أداء PostgreSQL |
| الشهادات وDNS | الأيام المتبقية، الشهادات الداخلية، ردود DNS، تسجيل النطاق | Blackbox (tls، dns)، RDAP | أقل من 14 يوماً ملخص، أقل من 3 أيام عاجل، النطاق قبل 30 يوماً | الشهادات الرقمية، DNS |
| النسخ والمهام | آخر نجاح، حجم النسخة، الاستعادة التجريبية | نبضة Push، أو textfile | غياب النبضة بعد الدورة مع هامش | قاعدة 3-2-1 |
| الأحداث الأمنية | الدخول، سلامة الملفات، هجمات الويب، الإعدادات | Wazuh | المستوى 10 فما فوق عاجل، الوكيل منقطع ملخص | مختبر Wazuh |
| الثغرات والتحديثات | حزم النظام، الـ Images المنشورة، الاعتماديات، SBOM | Wazuh، Trivy، Renovate، Dependency-Track | حرج قابل للإصلاح أو في KEV عاجل، العالي ملخص، تحديثات متأخرة في الملخص | Patch Management، SCA، Trivy |
| التنبيهات | مسار عاجل ومسار ملخص، Runbook، Watchdog | Alertmanager | غياب Watchdog من خدمة خارجية | التنبيهات |
| البوابة | صفحة رئيسية واحدة، وفحص مستقل لها | Grafana، وWazuh للقراءة فقط | توقف سيرفر المراقبة من فحص خارجي | البوابة الواحدة |
ابدأ في أسبوع واحد One-Week Plan
الجدول السابق قد يبدو كثيراً لفريق من أربعة أشخاص عندهم عمل آخر، ولكن ترتيب البدء هو الذي يصنع الفرق. فالقاعدة أن تبدأ بما يكشف أكبر الأعطال بأقل جهد، وأن تنتهي كل يوم بشيء يعمل وليس بنصف شيء. والصورة التالية خطة فريق المنصة:
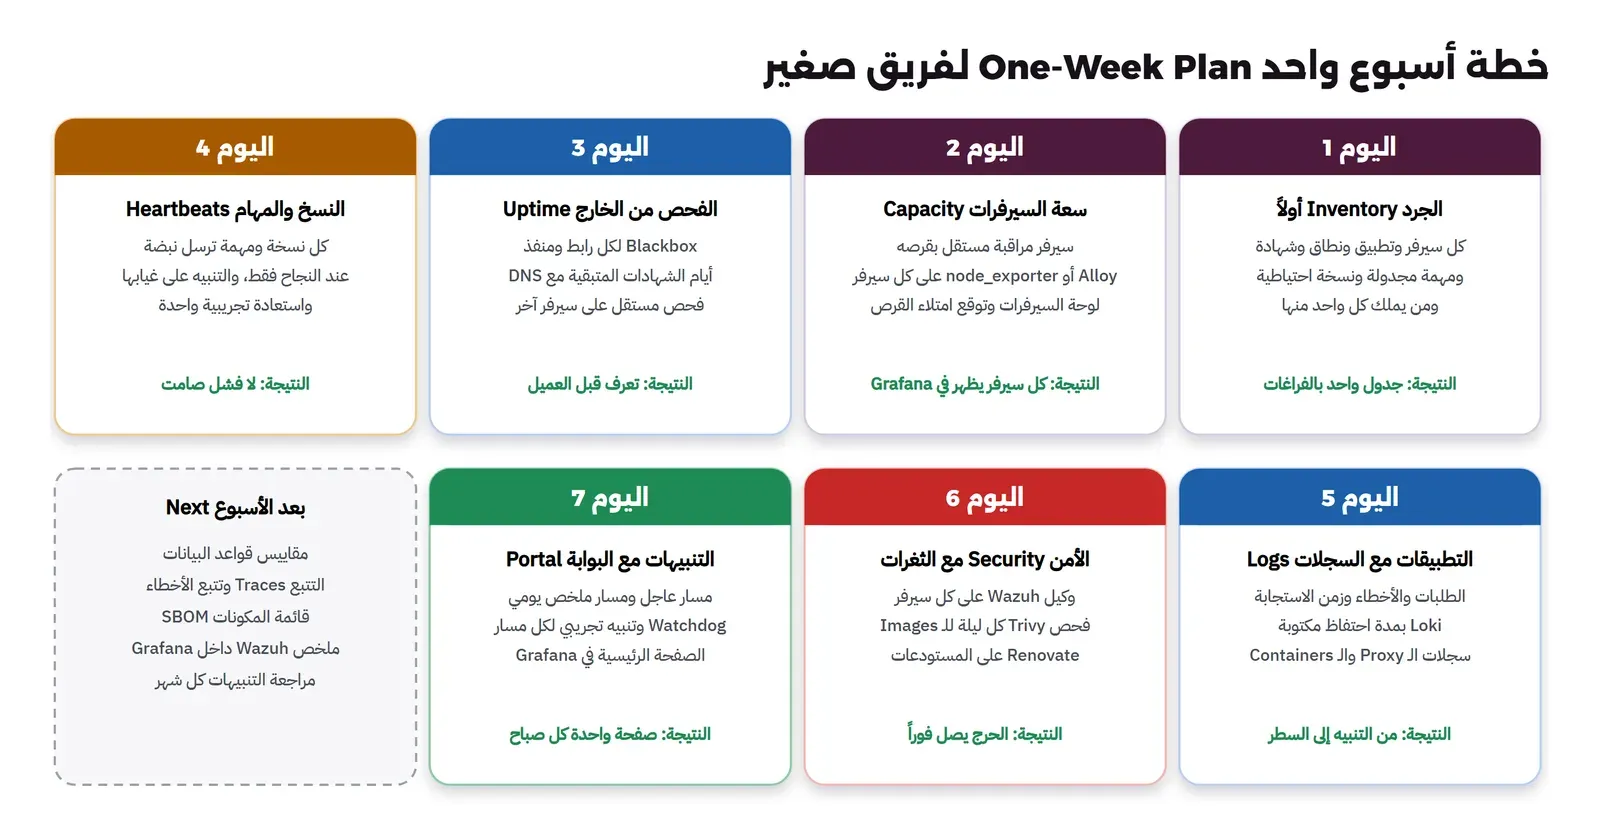
- اليوم 1، الجرد: قبل أن تثبت أي شيء، اكتب قائمة بكل سيرفر وتطبيق ونطاق وشهادة ومهمة مجدولة ونسخة احتياطية، ومن يملكها، وماذا يراقبها الآن. وإذا كانت لديك أدوات موجودة فطبق جدول تدقيق التغطية Coverage Audit من مقال البوابة. والنتيجة قائمة فراغات هي خطة بقية الأسبوع.
- اليوم 2، السيرفرات: سيرفر مراقبة مستقل، أو تحقق من سعة سيرفر موجود قبل أن تشتري آخر، ثم Prometheus وGrafana عليه، وجامع على كل سيرفر، ولوحة فيها آخر بيانات وتوقع امتلاء القرص. واكتب مدة الاحتفاظ وحدها الأقصى من الآن.
- اليوم 3، الفحص من الخارج: Blackbox لكل رابط عام ولكل شهادة، وفحص مستقل على سيرفر آخر أو خدمة خارجية يراقب الموقع وسيرفر المراقبة. وفي آخر اليوم أوقف شيئاً عمداً وتأكد أن الفحص رآه.
- اليوم 4، النسخ والمهام: أضف سطر النبضة إلى آخر كل سكربت نسخ ومهمة مجدولة مهمة، ونفذ استعادة تجريبية واحدة لأهم قاعدة بيانات. وهذا اليوم وحده كان سيمنع حادثة GitLab.
- اليوم 5، التطبيقات والسجلات: Loki بمدة احتفاظ مكتوبة، وسجلات الـ Proxy والـ Containers، وإذا أمكن مقاييس الطلبات من التطبيق، وإلا فاحسب الإشارات الذهبية من سجل الـ Proxy.
- اليوم 6، الأمن والثغرات: وكيل Wazuh على كل سيرفر، وفحص Trivy ليلي للـ Images المنشورة، وRenovate على المستودعات الرئيسية.
- اليوم 7، التنبيهات والبوابة: مسار عاجل إلى هاتف المناوب، ومسار ملخص صباحي، وWatchdog إلى خدمة خارجية، وتنبيه تجريبي لكل مسار، ثم الصفحة الرئيسية في Grafana.
وبعد الأسبوع تأتي مقاييس قواعد البيانات، والتتبع وتتبع الأخطاء، وقوائم المكونات SBOM، وملخص Wazuh داخل Grafana. ولكن الأهم من كل ذلك موعد شهري ثابت لمراجعة التنبيهات: ما الذي أطلق ولم يفعل أحد شيئاً، وما الذي حدث ولم يطلق أي تنبيه. فالمراقبة ليست مشروعاً ينتهي، وإنما عادة يحافظ عليها الفريق.
البدائل المدفوعة والمستضافة Managed Alternatives
كل ما في هذا الدليل يعمل بأدوات مفتوحة المصدر على سيرفراتك، ولكن هذا ليس الخيار الصحيح لكل فريق. فالأداة المجانية تكلف وقت من يشغلها ويحدثها ويصلحها عندما تتعطل، والفريق المكون من شخصين قد يكون وقته أغلى من الاشتراك. والجدول التالي يضع لكل منطقة أشهر البدائل التجارية، ونموذج التسعير كما في صفحة الأسعار الرسمية لكل منها، ومتى تكون منطقية. ولم نشغل أياً منها، ولذلك لا نضع لها لقطات شاشة، وإنما الرابط إلى صفحتها الرسمية.
| المنطقة | الخدمة | نموذج التسعير من الصفحة الرسمية | متى تكون منطقية |
|---|---|---|---|
| كل المناطق تقريباً | Datadog | لكل منتج عداده: البنية لكل سيرفر شهرياً، خطة Pro من 15 دولاراً بالدفع السنوي، والسجلات 0.10 دولار لكل GB مدخل ثم الفهرسة لكل مليون سجل، ومجاني حتى 5 سيرفرات بحفظ يوم واحد | فريق يريد كل شيء في منصة واحدة دون تشغيل، ويستطيع ضبط ما يفهرس |
| كل المناطق تقريباً | New Relic | أول 100 GB شهرياً مجانية ثم 0.40 دولار لكل GB، ورسوم للمستخدم الكامل، مثل 349 دولاراً في خطة Pro بالالتزام السنوي، والمستخدم الأساسي مجاني | فريق صغير العدد بيانات كثيرة، لأن الفاتورة تكبر مع عدد المستخدمين |
| كل المناطق تقريباً | Dynatrace | التزام إنفاق سنوي يستهلك منه بحسب الوحدات: المراقبة الكاملة 0.01 دولار لكل GiB ذاكرة في الساعة، أي 58 دولاراً شهرياً لسيرفر 8 GiB، والبنية 29 دولاراً للسيرفر، والمستخدمون دون حد | مؤسسات كبيرة بعقود سنوية وفريق تشغيل يريد تحليلاً تلقائياً |
| المقاييس والسجلات والتتبع والمناوبة | Grafana Cloud | خطة مجانية دائمة: 10 آلاف سلسلة، و50 GB سجلات، و3 مستخدمين، و3 مستخدمي مناوبة IRM. وخطة Pro برسوم 19 دولاراً شهرياً ثم الاستهلاك، مثل 6.50 دولار لكل ألف سلسلة و20 دولاراً لكل مستخدم مناوبة بعد الثلاثة | فريق يستخدم أدوات هذا الدليل نفسها ولا يريد تشغيلها، وينتقل منها وإليها بسهولة |
| السجلات والبحث والأمن | Elastic Cloud | المستضاف بحسب الموارد، والنسخة Serverless بحسب الاستهلاك: في Observability الإدخال من 0.09 دولار لكل GB للسجلات في مستوى Complete، ثم الحفظ لكل GB شهرياً | فريق يحتاج بحثاً نصياً كاملاً في سجلات كثيرة، أو يستخدم Elastic Security |
| السجلات والأمن SIEM | Splunk | Splunk Cloud وEnterprise Security بنماذج الاستهلاك Workload أو الإدخال Ingest أو النشاط، والسعر بعرض من المبيعات. وObservability Cloud من 15 دولاراً للسيرفر شهرياً بالدفع السنوي | جهات كبيرة لديها مركز عمليات أمنية SOC وفريق يعرف Splunk |
| التوفر والمناوبة والسجلات | Better Stack | مجاني حتى 10 فحوص ونبضات، ورخصة المناوب Responder بـ 29 دولاراً شهرياً بالدفع السنوي، وحزم فحوص إضافية، والسجلات لكل GB بسعر يختلف بحسب منطقة الحفظ | فريق صغير يريد الفحص والمناوبة وصفحة الحالة في مكان واحد |
| التوفر | UptimeRobot | مجاني لـ 50 فحصاً كل 5 دقائق ويسمح بالاستخدام التجاري، وخطة Solo من 9 دولارات شهرياً بفحص كل 60 ثانية، وTeam من 30 دولاراً بفحص كل 30 ثانية | الفحص المستقل من الخارج لأي فريق، حتى لو كان كل شيء آخر مستضافاً ذاتياً |
| التوفر | Pingdom | مستويات بحسب عدد الفحوص، من 10 إلى 30 ألف فحص، ومراقبة المستخدم الحقيقي RUM بحسب عدد الصفحات المعروضة، وتجربة مجانية | فريق يريد فحوصاً من مواقع كثيرة في العالم وتقارير جاهزة |
| المناوبة والتصعيد | PagerDuty | مجاني حتى 5 مستخدمين بجدول مناوبة واحد، وخطة Professional بـ 21 دولاراً للمستخدم شهرياً بالدفع السنوي أو 25 بالشهري | عندما يكون هناك أكثر من مناوب وجدول تناوب وتصعيد حقيقي |
| الأخطاء | Sentry | خطة Developer مجانية لمستخدم واحد و5 آلاف خطأ، وTeam من 26 دولاراً شهرياً بالدفع السنوي، وBusiness من 80 دولاراً، ثم الزيادة لكل حدث، وكل خطة تشمل فحص توفر واحداً وفحص مهمة مجدولة واحداً | معظم الفرق، لأن الإعداد دقائق، وGlitchTip هو البديل المستضاف ذاتياً |
| المهام المجدولة | Healthchecks.io | مجاني لـ 20 مهمة، وBusiness بـ 20 دولاراً شهرياً لـ 100 مهمة، والمشروع نفسه مفتوح المصدر ويمكن تشغيله ذاتياً | نبضات النسخ والمهام من خارج بنيتك، فلا تتوقف مع توقفها |
| الثغرات والاعتماديات | Snyk | خطة مجانية بعدد محدود من الفحوص، وTeam من 25 دولاراً شهرياً لفريق حتى 10 مطورين، وEnterprise بنظام أرصدة Credits بعرض من المبيعات | فريق تطوير يريد الفحص داخل المستودع وطلبات الإصلاح دون تشغيل أدوات |
| حماية الأجهزة EDR | CrowdStrike Falcon | لكل جهاز سنوياً: Falcon Go بـ 59.99 دولار بحد 100 جهاز، وPro بـ 99.99، وEnterprise بـ 184.99، وFalcon Complete المدار بالكامل بعرض سعر | عندما تحتاج كشفاً واستجابة على الأجهزة والسيرفرات أقوى من وكيل Wazuh، أو مراقبة على مدار الساعة لا يستطيع فريقك توفيرها |
| أمن السحابة CNAPP | Wiz | الصفحة لا تذكر أسعاراً، والتسعير بعرض مخصص من المبيعات | بنية كبيرة على AWS أو Azure أو Google Cloud بحسابات كثيرة |
وكيف تختار؟ هذه الأسئلة الثلاثة تحسم أغلب الحالات:
- حجم الفريق: فريق من شخص أو اثنين يستفيد غالباً من خدمة مستضافة لما يصعب تشغيله، مثل الفحص الخارجي والمناوبة وتتبع الأخطاء، ويبقي المقاييس والسجلات على سيرفر واحد. والفريق الذي فيه مهندس منصة متفرغ يستطيع أن يشغل كل شيء.
- التكلفة مع النمو: الفاتورة في المنصات التجارية تكبر مع عدد السيرفرات أو حجم السجلات أو عدد المستخدمين بحسب نموذج كل منها، وقد حسبنا فاتورة شركة نموذجية في خمس منصات، مع فخاخ الفوترة المعروفة، في كم تكلف منصات المراقبة؟
- الامتثال ومكان البيانات: وهذا يقودنا إلى القسم التالي.
ولاحظ أن الخيار ليس كل شيء أو لا شيء. فالتوزيع الذي نراه كثيراً عند الفرق الصغيرة: المقاييس والسجلات والأمن على سيرفراتها، والفحص الخارجي ونبضات المهام في خدمة مستضافة رخيصة، لأن هذين بالذات يجب أن يكونا خارج بنيتك حتى يعملا عندما تتوقف.
السياق السعودي: ضوابط ECC مع مكان البيانات Data Residency
إذا كانت جهتك حكومية، أو شركة تابعة لجهة حكومية، أو تملك أو تشغل بنية تحتية وطنية حساسة، فإن الضوابط الأساسية للأمن السيبراني ECC من الهيئة الوطنية للأمن السيبراني تنطبق عليك، كما يقول نطاق العمل في وثيقة ECC-2:2024، والهيئة تشجع بقية الجهات على تطبيقها. وفي هذه الوثيقة ثلاثة ضوابط فرعية لها علاقة مباشرة بهذا الدليل:
- 2-12 إدارة سجلات الأحداث ومراقبة الأمن السيبراني: تفعيل سجلات الأحداث للأصول الحساسة، وللحسابات ذات الصلاحيات الهامة، ولأحداث الدخول عن بعد، وتحديد تقنيات SIEM لجمع السجلات، والمراقبة المستمرة لها، ومدة احتفاظ لا تقل عن 12 شهراً، وهو الضابط 2-12-3-5. وهذا يعني أن مدة احتفاظ Wazuh أو أي SIEM تستخدمه تخطط من اليوم الأول لسنة على الأقل، وهو سبب إضافي لئلا يشارك قرصه سجلات التطبيقات.
- 2-10 إدارة الثغرات: فحص دوري للثغرات واكتشافها، وتصنيفها بحسب خطورتها، ومعالجتها بحسب التصنيف والمخاطر، وإدارة التحديثات مع التحقق منها في بيئة غير بيئة الإنتاج قبل تطبيقها، والاشتراك في مصادر موثوقة للثغرات الجديدة. وهذا بالضبط ما تغطيه المنطقة الحادية عشرة.
- 2-9 إدارة النسخ الاحتياطية: ومنها الفحص الدوري لفعالية استعادة النسخ، وهو الضابط 2-9-3-3، أي أن الاستعادة التجريبية التي ذكرناها في المنطقة التاسعة متطلب وليست نصيحة فقط.
وقد شرحنا الضوابط بلغة بسيطة في الضوابط الأساسية للأمن السيبراني NCA ECC، وكيف تحقق كثيراً منها بأدوات مفتوحة المصدر في تحقيق ضوابط ECC بأدوات مفتوحة المصدر.
وأما مكان حفظ البيانات، فهو سؤال يجب أن يطرح قبل أي خدمة مراقبة مستضافة. فالسجلات والتتبع تحمل غالباً بيانات شخصية دون أن يقصد أحد: عنوان IP، والبريد في رسالة خطأ كما رأينا في لقطة GlitchTip، ومعرف المستخدم في الطلب. وعندما راجعنا صفحات المناطق الرسمية في مقال تكلفة المراقبة لم نجد منطقة حفظ داخل المملكة عند أي من المنصات الخمس التي قارناها، وبعضها لديه منطقة في الإمارات. وإذا كانت السجلات تحمل بيانات شخصية فإن نظام حماية البيانات الشخصية ولائحة نقل البيانات خارج المملكة يضعان شروطاً على نقلها، وقد شرحنا ذلك للخدمات المستضافة في حماية البيانات الشخصية PDPL. ولا نقدم هنا رأياً قانونياً، وإنما نقول للفريق التقني: قبل أن ترسل السجلات إلى منصة خارج المملكة اعرض المسألة على مسؤول حماية البيانات في جهتك، واحجب البيانات الشخصية قبل أن تغادر شبكتك وليس بعد وصولها، وإذا كانت الجهة حكومية فالغالب أن الجواب مراقبة مستضافة داخل المملكة، وهو ما يجعل الأدوات مفتوحة المصدر في هذا الدليل خياراً عملياً وليس فقط خياراً أرخص.
أخطاء شائعة Common Mistakes
- مراقبة ما هو سهل بدل ما يهم: رسوم جميلة للمعالج، ولا شيء عن نسبة أخطاء صفحة الدفع.
- المراقبة على السيرفر الذي تراقبه: إذا توقف، توقف معه كل شيء ولم يصل أي تنبيه.
- التنبيه على النسبة بدل الاتجاه: 90% من القرص قد تعني أسابيع أو دقائق.
- التنبيه عند الفشل فقط: المهمة التي لم تعمل لا تفشل، فنبه على غياب النجاح.
- كل التنبيهات في قناة واحدة: تكتم في أسبوعين، ويضيع فيها العاجل.
- التنبيه على كل ثغرة عالية: أغلبها بلا إصلاح، فيصبح التنبيه ضجيجاً يومياً.
- الثقة في تنبيه لم يجرب: رأينا عداداً يقول 8 بعد 20 حدثاً، وآخر يقول صفراً بعد خمسة.
- بلا مدة احتفاظ مكتوبة: القرص يمتلئ بالسجلات، وغالباً على سيرفر الأمن.
- لا أحد يراقب أدوات المراقبة: وكيل Wazuh منقطع، أو شهادة جهاز الفحص منتهية، ولا يعرف أحد.
- تثبيت أداة جديدة قبل الجرد: الفراغات لا تظهر إلا عندما تكتب القائمة كاملة.
الخلاصة Summary
- أغلب الأعطال الكبيرة سببها شيء توقف بصمت ولم يراقبه أحد، وليس نقص الأدوات، كما في حادثتي GitLab وEquifax.
- المراقبة ثلاث عشرة منطقة في ثلاث طبقات: السيرفر، وما يراه العميل، وما يفشل بصمت، ثم التنبيهات والبوابة.
- راقب الاتجاه وليس النسبة، وغياب النجاح وليس الفشل فقط، والأداة نفسها وليس فقط ما تراقبه.
- فحص مستقل من الخارج يراقب الخدمة وسيرفر المراقبة نفسه، وWatchdog يراقب مسار التنبيه.
- كل تنبيه يخرج من أحد ثلاثة أبواب: عاجل للمناوب الآن، أو ملخص يومي، أو لوحة فقط، ومعه رابط Runbook.
- ابدأ بالجرد في اليوم الأول، وفي أسبوع واحد يستطيع فريق صغير أن يغطي أغلب المناطق بأدوات مفتوحة المصدر.
- البدائل المستضافة منطقية للفرق الصغيرة في الفحص الخارجي والمناوبة وتتبع الأخطاء، ومكان حفظ البيانات وضوابط ECC جزء من القرار.
 دليلمفاهيم المراقبة Observability: من الإشارة إلى التنبيهما الذي تجيب عنه المقاييس والسجلات والتتبع، وكيف تبني تنبيهاً على ما يشعر به المستخدم وعلى ميزانية الأخطاء بدل كل رقم.
 دليلمقاييس السيرفرات Metrics: Prometheus مع لوحات Grafanaنجمع مقاييس المعالج والذاكرة والقرص والـ Containers مع Prometheus، ونتنبأ بموعد امتلاء القرص قبل أن يحدث، ونبني لوحة Grafana محفوظة ككود في Git.
 دليلالإشارات الذهبية Golden Signals: ماذا تقيس في خدمتك؟نضيف القياس إلى خدمة دفع حقيقية ونضغط عليها حتى تنهار، فنرى لماذا انتظر المستخدم ست ثوان والمعالج عند 5% دون خطأ واحد.
 دليلفحص التوفر Uptime Checks: من يراقب سيرفر المراقبة؟نفحص الموقع والشهادة وRedis من الخارج مع Blackbox Exporter وUptime Kuma، ونكشف النسخ الاحتياطي الذي توقف بصمت، ونتأكد أن أحداً يراقب سيرفر المراقبة نفسه.
 دليلالتنبيهات Alerting: ماذا تنبه عليه ومتى توقظ أحداً؟نبني مع Alertmanager تنبيهات تصل فيها المشكلة الواحدة في رسالة واحدة، والعاجل فوراً والروتيني في ملخص صباحي، ونجرب كل قرار بالثواني.
 دليلبوابة مراقبة واحدة Monitoring Portal: Grafana مع Wazuhنجمع السيرفرات والتطبيقات والسجلات والتنبيهات والثغرات في صفحة Grafana واحدة، ويبقى Wazuh على سيرفره ويقرأ منه Grafana بمستخدم للقراءة فقط.
 دليلجمع السجلات Logs مركزياً مع Grafana Lokiكيف تشغل Grafana Loki مع Alloy وGrafana، وتختار التسميات Labels التي لا توقف الإدخال، ثم تبحث وتنبه وتحذف بلغة LogQL.
 دليلمراقبة السيرفرات مع Wazuh: من السجل Log إلى حظر المهاجمشغلنا Wazuh مع وكيل على سيرفر تجريبي، فكشف تخمين كلمات مرور SSH وحظر المهاجم تلقائياً، ونبه على ملف PHP دخيل خلال ثانية.
 دليلأي ثغرة تصلح أولاً؟ ترتيب الأولوية Prioritization بلغة بسيطةفحصنا ثلاث Containers فظهرت 5025 نتيجة، فرتبناها بالتقييم CVSS واحتمال الاستغلال EPSS وقائمة KEV لنعرف ما يصلح هذا الأسبوع.
 دليلكم تكلف منصات المراقبة Observability؟ مقارنة بالأرقامحسبنا بسكربت مفتوح فاتورة المراقبة لشركة بعشرين سيرفراً على Datadog والمنصات المنافسة، وقارناها بتشغيل SigNoz على سيرفرك.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة الدليل، وجمع لقطات الشاشة من مختبرات سلسلة المراقبة والمقالات المرتبطة، ومراجعة صفحات الأسعار الرسمية للبدائل المستضافة بتاريخ 3 نوفمبر 2026، ومراجعة ضوابط ECC-2:2024.


