


في آخر محاضرة من مادة مقدمة مشروع التخرج يقول لكم المشرف إنه يريد من كل فريق ثلاث أفكار مكتوبة في الأسبوع القادم، لكل فكرة صفحة واحدة فيها المشكلة ومن يستفيد منها وكيف ستقيسون النجاح، ثم يضيف جملة يعرفها كل من سبقك: «ولا أريد نظام حضور وغياب آخر». تجلس مع زملائك الأربعة في المساء، فيقترح أحدكم متجراً إلكترونياً، ويقترح الثاني تطبيقاً للجامعة يجيب عن أسئلة الطلاب، ويقترح الثالث فكرة رآها في مقطع قصير عن الذكاء الاصطناعي، وتنتهي الجلسة بثلاث أفكار تعرف في داخلك أن المشرف رأى مثلها عشرات المرات. والمشكلة هنا ليست في قلة الأفكار، وإنما في أن طالب علوم الحاسب Computer Science لا يعرف ما الذي يجعل الفكرة مشروعاً في تخصصه هو، لا في تخصص نظم المعلومات أو هندسة البرمجيات، ولا يعرف من أين يأتي بالبيانات، ولا كيف يثبت للجنة أن الفكرة قابلة للتنفيذ قبل أن يلتزم بها سنة كاملة.
وقد شرحنا في دليل تخصص علوم الحاسب ما يدرسه الطالب في هذا التخصص بحسب منهج CS2023، من الخوارزميات والأنظمة إلى لغات البرمجة والأسس الرياضية، وهذا المقال يكمل ذلك الدليل من الجهة العملية، حيث يأخذ هذه المجالات ويحولها إلى أفكار مشاريع تخرج للبكالوريوس وموضوعات بحث للماجستير، ولكل فكرة مصدر بيانات حقيقي فتحناه بأنفسنا وطريقة تقييم يمكن أن تدافع عنها أمام اللجنة. وسوف نتابع الفريق الذي بدأنا به إلى نهاية المقال، فنختار معه، ونستبعد، ثم نبني نموذجاً أولياً Spike لإحدى الأفكار ونقيس نتيجته، لأن هذا ما سوف يفرق بين صفحتكم وصفحات الفرق الأخرى عندما يقرؤها المشرف.
وسوف نناقش في هذا المقال ما يلي:
- ماذا تنتظر اللجنة من مشروع البكالوريوس، وماذا تنتظر من رسالة الماجستير، ولماذا لا تصلح فكرة واحدة للاثنين دون تعديل.
- كيف تقرأ بطاقة الفكرة: المشكلة، والمستخدم، والنطاق، والأدوات، والبيانات، والتقييم، والصعوبة، والخطر الذي يقتل المشروع، وما يميزه.
- ثماني أفكار للبكالوريوس وست أفكار للماجستير في الخوارزميات والأنظمة ولغات البرمجة والنص العربي وأنظمة التعلم الآلي.
- الأفكار المستهلكة التي مل منها المشرفون، وكيف تحول واحدة منها إلى مشروع علوم حاسب حقيقي.
- جدول مقارنة لكل الأفكار بالمستوى والصعوبة وتوفر البيانات والمهارات.
- تجربة عملية Lab: نموذج أولي لمقترح التصحيح الإملائي العربي على قائمة كلمات حقيقية، بثلاث خوارزميات، مع قراءة المخرج سطراً بسطر.
- كيف يختار الفريق فكرة واحدة من الثلاث، وأخطاء شائعة، وقائمة تحقق Checklist.
ماذا تنتظر اللجنة من مشروع البكالوريوس Bachelor ومن رسالة الماجستير Master؟
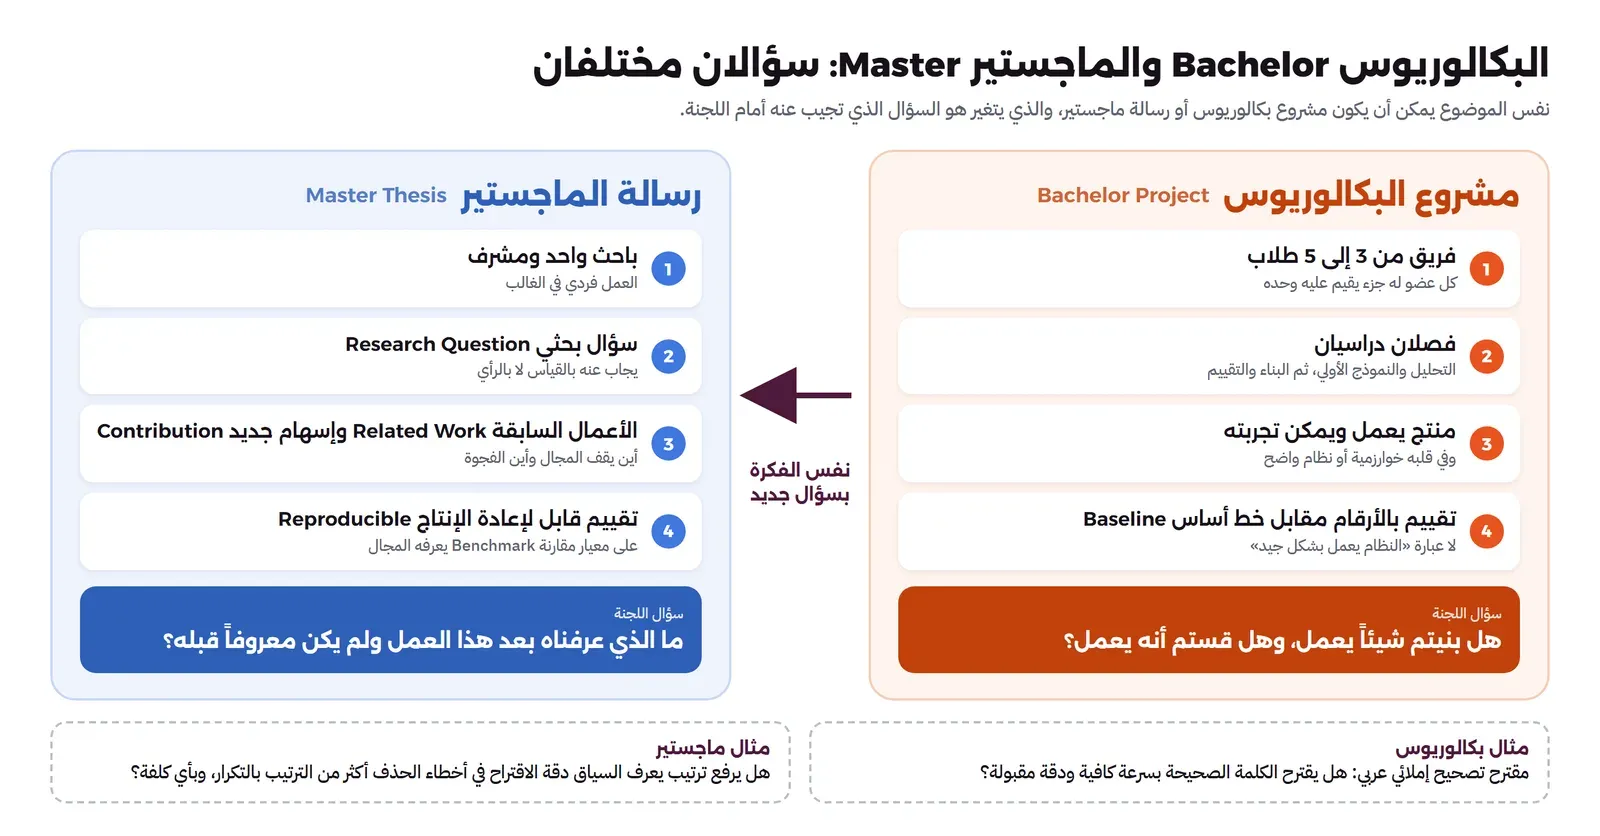
مشروع البكالوريوس في أغلب أقسام علوم الحاسب عمل فريق من ثلاثة إلى خمسة طلاب يمتد فصلين دراسيين، الأول للتحليل والتصميم والنموذج الأولي، والثاني للبناء والاختبار والتقييم، وتقرير مكتوب ومناقشة في النهاية. والسؤال الذي تسأله اللجنة في هذا المستوى هو: هل بنيتم شيئاً يعمل، وهل قستم أنه يعمل؟ فهي لا تنتظر منكم أن تكتشفوا شيئاً لم يعرفه أحد، وإنما تنتظر أن تطبقوا ما درستموه على مشكلة حقيقية بحجم مناسب، وأن تتخذوا قرارات تقنية تستطيعون شرح أسبابها، وأن تقدموا أرقاماً من تقييم حقيقي بدل عبارة «النظام يعمل بشكل جيد». ولهذا السبب تنجح في البكالوريوس الفكرة التي فيها جزء خوارزمي واضح أو جزء أنظمة واضح داخل منتج يمكن تجربته، وتفشل الفكرة التي هي مجموعة شاشات تقرأ وتكتب في قاعدة بيانات، لأن هذه لا تظهر ما يميز طالب علوم الحاسب عن غيره.
أما رسالة الماجستير فعمل فرد واحد في الغالب، وسؤالها مختلف تماماً: ما الذي تعرفه بعد هذا العمل ولم يكن معروفاً قبله؟ لذلك تبدأ الرسالة بسؤال بحثي Research Question محدد يمكن الإجابة عنه بالقياس، ثم مراجعة للأعمال السابقة Related Work تثبت أنك تعرف أين يقف المجال وأين الفجوة، ثم إسهام Contribution جديد ولو كان صغيراً، ثم تقييم قابل للقياس Measurable Evaluation على بيانات أو معايير مقارنة Benchmarks يعرفها المجال، بحيث يستطيع باحث آخر أن يعيد تجربتك ويصل إلى نفس الأرقام. ولا تحتاج الرسالة إلى منتج كامل، وكثير من رسائل الماجستير الجيدة نموذج أولي صغير ومحاكاة وتجارب مرتبة، لأن ما يقيم فيها هو صحة السؤال وصرامة التجربة، لا عدد الشاشات.
وقد يتساءل البعض: هل يمكن أن آخذ فكرة من أفكار البكالوريوس وأجعلها رسالة ماجستير؟ والإجابة نعم، بشرط أن تغير السؤال، فمشروع البكالوريوس الذي يبني مقترحاً للتصحيح الإملائي يسأل «هل يعمل الاقتراح بسرعة كافية ودقة مقبولة؟»، أما الرسالة التي تنطلق من نفس الموضوع فتسأل مثلاً «هل يرفع نموذج لغة صغير يعرف السياق دقة الاقتراح للكلمات القصيرة أكثر مما يرفعها ترتيب التكرار، وبأي كلفة في الزمن؟»، ثم تقيس ذلك على مجموعة اختبار منشورة. وسوف ترى هذا الفرق في التجربة العملية بالأرقام، لأن النموذج الأولي الذي سوف نبنيه يكشف بالضبط أين يقف الحل البسيط وأين يبدأ سؤال البحث.
وهناك فرق ثالث يغفل عنه كثير من الطلاب، وهو أن لجنة علوم الحاسب تختلف عن لجنة نظم المعلومات وعن لجنة هندسة البرمجيات في ما تبحث عنه. فلجنة نظم المعلومات تهتم بالعملية التي يخدمها النظام داخل المؤسسة، ولجنة هندسة البرمجيات تهتم بالمتطلبات والتصميم والاختبار وإدارة المشروع، أما لجنة علوم الحاسب فتسأل عن الخوارزمية التي اخترتها ولماذا، وعن تعقيدها Complexity، وعن سلوك النظام عندما تكبر البيانات عشر مرات، وعن الحالة التي يفشل فيها حلك. ولذلك فإن كل فكرة في هذا المقال فيها سؤال من هذا النوع في قلبها، وإذا وجدت أن ما يشدك هو المتطلبات والعملية أكثر من الخوارزمية، فاقرأ دليل هندسة البرمجيات قبل أن تختار.
كيف تقرأ بطاقة الفكرة Idea Card؟
الصفحة الواحدة التي طلبها المشرف هي في الحقيقة بطاقة فكرة، وقد كتبنا كل فكرة في هذا المقال بنفس الحقول حتى تقارن بينها بسرعة، وحتى تنقل الحقول نفسها إلى صفحتك. وفيما يلي معنى كل حقل ولماذا وضعناه:
- المشكلة Problem: جملة أو جملتان عن ألم حقيقي عند شخص حقيقي، وليس وصفاً للتقنية. فعبارة «نظام يستخدم خوارزمية BK-tree» ليست مشكلة، أما «مربع البحث في البوابة لا يجد الخدمة إذا كتبت اسمها دون همزة» فهي مشكلة.
- المستخدم Users: من سوف يجرب النظام، وهذا مهم لأنه يحدد من ستقابل في دراسة المستخدمين User Study، فإذا لم تستطع الوصول إلى المستخدم فأنت لا تستطيع تقييم المشروع.
- النطاق Scope: ما الذي يبنيه فريق من ثلاثة إلى خمسة في فصلين، وما الذي يبقى خارج المشروع. وأغلب المشاريع التي تتعثر في الفصل الثاني تتعثر لأن هذا الحقل كان فارغاً في الفصل الأول.
- الأدوات Stack: اقتراح وليس إلزاماً، ويكفي أن تعرف لماذا اخترت اللغة أو المكتبة، لأن اللجنة سوف تسأل.
- البيانات Data: مصدر حقيقي فتحناه وتأكدنا من وجوده، مع الترخيص إن وجد. والفكرة التي تحتاج بيانات لن تحصل عليها هي فكرة ميتة مهما كانت جميلة.
- التقييم Evaluation: المقياس Metric الذي سوف تقيسه، وعلى أي بيانات، ومقابل أي خط أساس Baseline. وبدون خط أساس يبقى الرقم بلا معنى، فدقة 80% قد تكون ممتازة أو سيئة بحسب ما يحققه الحل البسيط.
- الصعوبة Difficulty: متوسطة أو مرتفعة أو مرتفعة جداً، بحسب ما رأيناه في المصادر وفي حجم ما يلزم بناؤه.
- الخطر الذي يقتل المشروع Killer Risk: الشيء الواحد الذي إذا حدث توقف المشروع، مثل بيانات لا تصل أو جهاز لا يتوفر أو نطاق لا ينتهي، ومعه طريقة تخفيفه.
- ما يميزه Standout: الإضافة التي تجعل المشروع يستحق أن يكون أول سطر في سيرتك الذاتية، وغالباً تكون قياساً لم يقم به غيرك أو مساهمة في مشروع مفتوح المصدر Open Source.
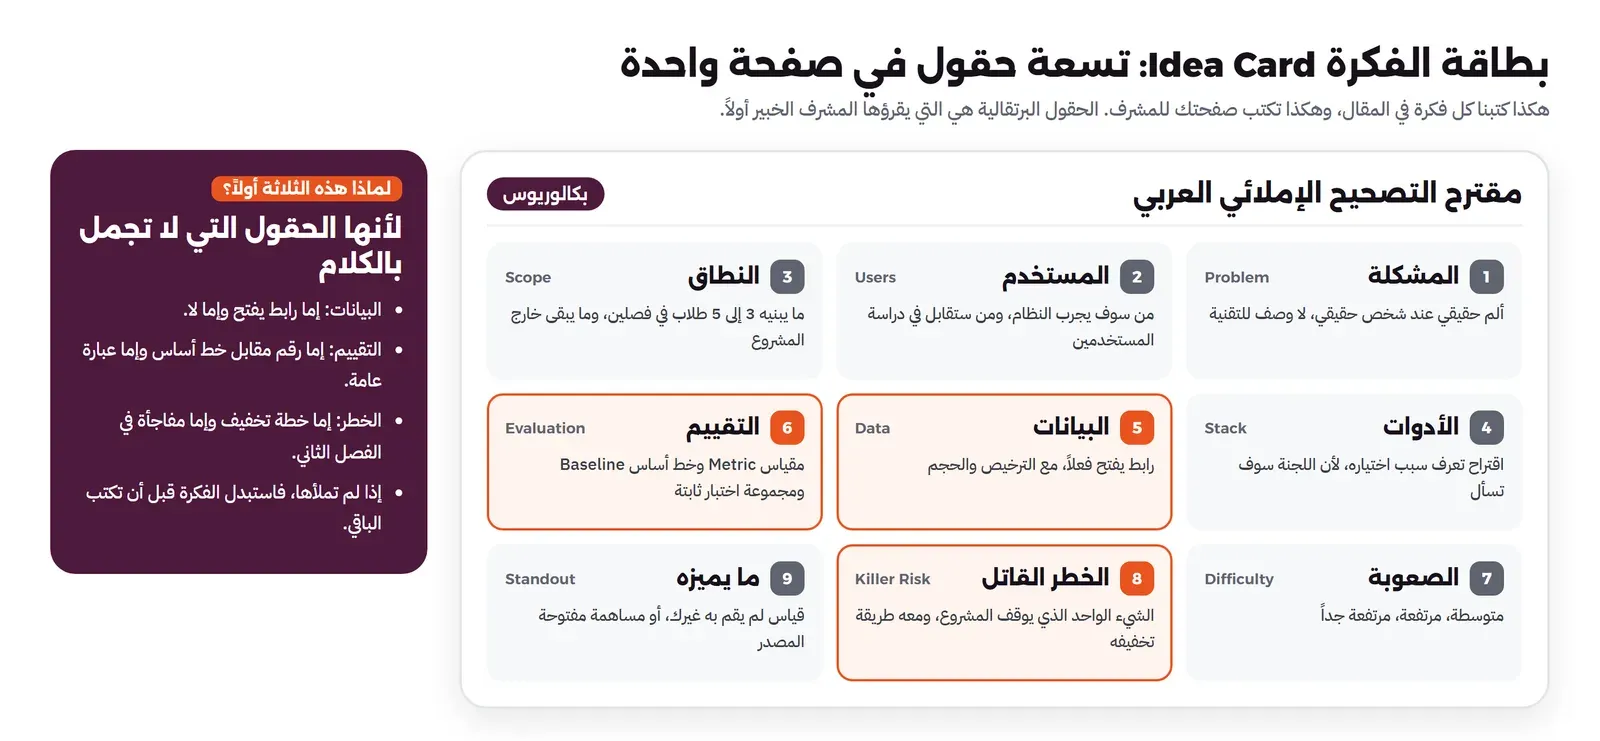
ولاحظ أن ثلاثة حقول من التسعة هي التي يقرؤها المشرف الخبير أولاً، وهي البيانات والتقييم والخطر، والسبب أنها الحقول التي لا يستطيع الطالب أن يجملها بالكلام. فوصف المشكلة يمكن أن يكتب بأسلوب جذاب، أما سؤال «من أين ستأتي بالبيانات؟» فإجابته إما رابط يفتح وإما لا، وسؤال «كيف ستعرف أن نظامك أفضل؟» إجابته إما مقياس وخط أساس وإما عبارة عامة. ولذلك عندما تكتب صفحتك، ابدأ بهذه الحقول الثلاثة، وإذا لم تستطع ملأها فاستبدل الفكرة قبل أن تضيع أسبوعاً في صياغة الباقي.
خريطة الأفكار Project Map على مجالات علوم الحاسب
وزعنا الأفكار الأربع عشرة على خمسة مجالات من مجالات التخصص التي تميزه، وهي الخوارزميات Algorithms، والأنظمة Systems بما فيها الأنظمة الموزعة Distributed Systems وقواعد البيانات، ولغات البرمجة Programming Languages، ومعالجة النص العربي بالخوارزميات لا بالنماذج الكبيرة، وأنظمة التعلم الآلي ML Systems أي الجانب الأنظمي من تشغيل النماذج لا تدريبها. وتركنا الأفكار التي قلبها تعلم الآلة وتحليل البيانات لمقال أفكار علم البيانات والذكاء الاصطناعي، والأفكار الأمنية لمقال الأمن السيبراني، لأن لكل تخصص مقاله في هذه المرحلة، ولأن مشروع علوم الحاسب الذي يكون كله تدريب نموذج على بيانات جاهزة يفقد ما يميزه أمام اللجنة.
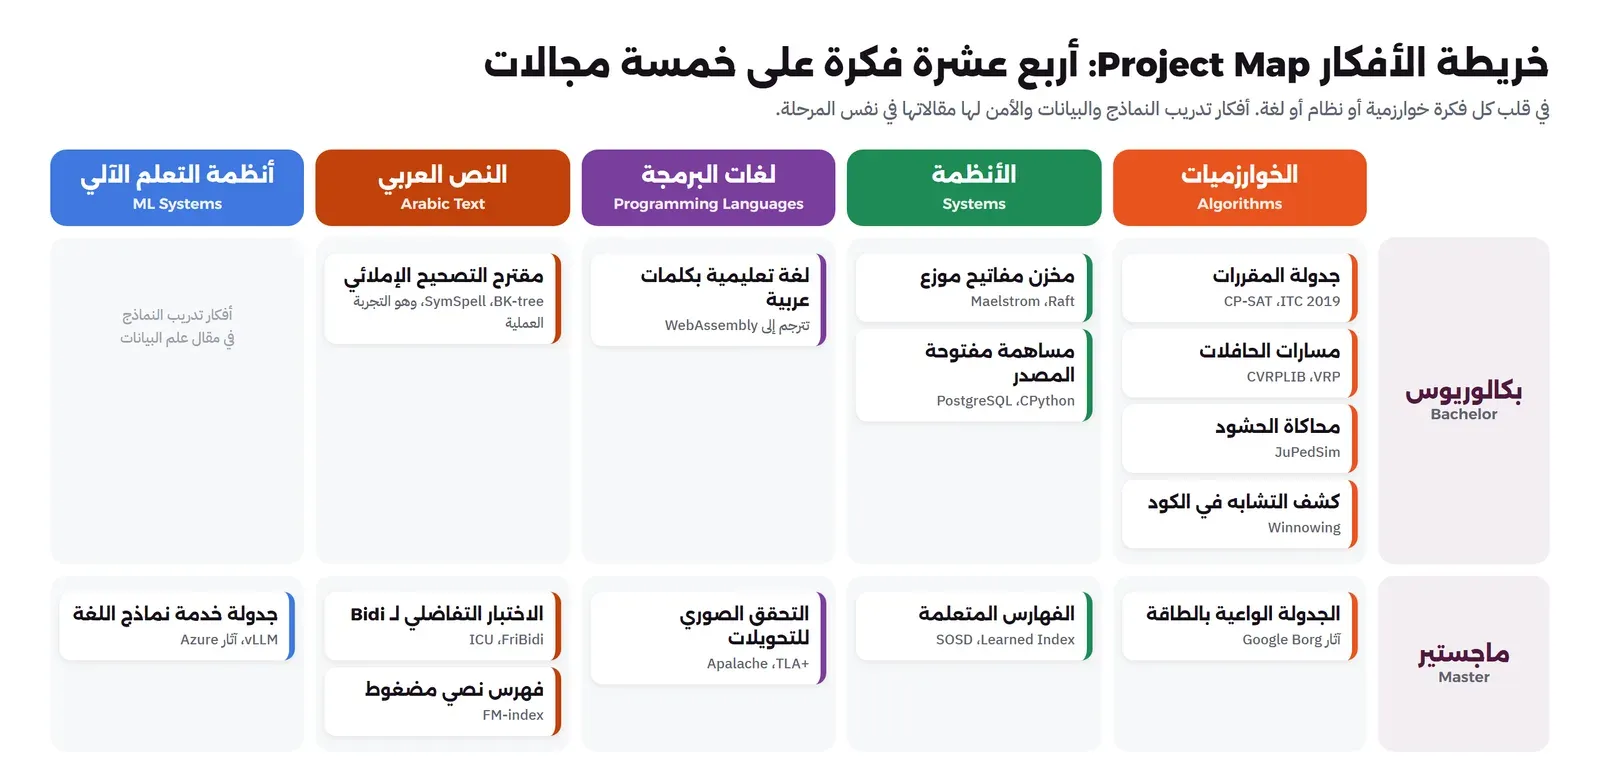
وقبل أن تقرأ البطاقات، تذكر أن الصعوبة في هذه الأفكار لا تأتي من غرابة الموضوع وإنما من التقييم، فبناء مخزن مفاتيح يعمل على جهاز واحد عمل أسبوع، أما إثبات أنه يبقى صحيحاً عندما تنقطع الشبكة بين نصف الأجهزة فهو عمل فصل كامل، وهذا الفصل هو المشروع.
أفكار البكالوريوس Bachelor Projects
الأفكار الثماني التالية مصممة لفريق من ثلاثة إلى خمسة طلاب وفصلين دراسيين، وفي كل منها منتج يمكن تجربته وجزء خوارزمي أو أنظمي يمكن قياسه. ورتبناها من الأقرب إلى المستخدم العادي إلى الأقرب إلى البنية التحتية.
مقترح التصحيح الإملائي العربي Arabic Spelling Suggester
Project title: Arabic Spelling Suggester
عندما تكتب في مربع البحث في بوابة خدمات أو في متجر أو في فهرس مكتبة كلمة «الاسعاف» بدل «الإسعاف»، أو «مدرسه» بدل «مدرسة»، أو تقلب حرفين وأنت تكتب بسرعة على الجوال، فإن كثيراً من محركات البحث تعيد لك صفحة فارغة، ولا تقترح عليك «هل تقصد…؟». وهذه مشكلة خوارزمية في أصلها: كيف تجد من بين عشرات الآلاف من الكلمات أقربها إلى ما كتبه المستخدم، خلال جزء صغير من الثانية، ثم ترتب المرشحين بحيث يكون الأول هو المقصود. وهي الفكرة التي اخترناها للتجربة العملية في آخر المقال، وسوف ترى هناك أرقامها.
- المشكلة: البحث العربي يفشل مع الأخطاء الإملائية الشائعة، وأشهرها الهمزات والتاء المربوطة والألف المقصورة وقلب الحروف.
- المستخدم: أي مربع بحث عربي، مثل بوابات الخدمات الحكومية وفهارس المكتبات الجامعية والمتاجر، ويمكن أن تجربه على محرك بحث الجامعة نفسها.
- النطاق: وحدة تطبيع Normalization للنص العربي، وتوليد المرشحين بخوارزمية مثل BK-tree أو فكرة الحذف المتماثل Symmetric Delete التي يقوم عليها SymSpell، وترتيب يجمع التكرار والسياق، وخدمة API صغيرة، وإضافة لمحرك بحث مثل Meilisearch أو OpenSearch، ومجموعة اختبار من أخطاء حقيقية.
- الأدوات: Python للنموذج الأولي، ثم Go أو Rust للخدمة إذا أردتم زمن استجابة Latency منخفضاً، وقد شرحنا تطبيع النص العربي في المحركين في البحث في النصوص العربية.
- البيانات: قائمة FrequencyWords العربية المأخوذة من ترجمات الأفلام OpenSubtitles بترخيص CC BY-SA 4.0، ونسخ ويكيبيديا العربية لمفردات أكثر رسمية، وفهرس مصادر Masader للبحث عن مدونات Corpora عربية أخرى.
- التقييم: دقة المرشح الأول Top-1 Accuracy ووجود الكلمة الصحيحة بين أول خمسة Top-5، على مجموعتين، الأولى أخطاء مولدة والثانية أخطاء حقيقية جمعتموها، وزمن الاستجابة لكل استعلام والذاكرة، ومقارنة بخط أساس هو البحث الخطي Linear Scan.
- الصعوبة: متوسطة.
- الخطر الذي يقتله: الاكتفاء بالأخطاء المولدة، فالنتيجة عليها لا تقول شيئاً عن المستخدم الحقيقي. والتخفيف أن تجمعوا من الأسبوع الأول ما يكتبه المستخدمون فعلاً، بإذن الجهة وبعد حذف ما يعرف بالشخص.
- ما يميزه: كلفة تحرير مبنية على لوحة المفاتيح العربية، فالخطأ بين حرفين متجاورين على اللوحة أرجح من الخطأ بين حرفين متباعدين، ونشر مجموعة الاختبار نفسها مفتوحة ليستخدمها غيركم.
جدولة المقررات الجامعية Course Timetabling
Project title: University Course Timetabling
كل فصل يبني قسم الجدولة في الكلية جدول المحاضرات والقاعات، وفيه قيود كثيرة: أستاذ لا يدرس في وقتين، وقاعة لا تتسع لأكثر من عدد معين، وطالب في السنة الثالثة لا يجب أن تتعارض مادتاه الإجباريتان، ومختبر لا يتوفر إلا في أيام محددة. وهذه مسألة تحقيق قيود Constraint Satisfaction وتحسين Optimization معروفة بصعوبتها، وتحويلها إلى مشروع يجعل «نظام الجامعة» الذي مل منه المشرف مسألة خوارزمية حقيقية. والجميل فيها أن لها معياراً دولياً، حيث نشرت مسابقة الجدولة الدولية ITC 2019 ثلاثين حالة Instances من مسائل جدولة حقيقية لمؤسسات مختلفة جمعت من نظام UniTime، كما يصف بحث المسابقة في مجلة Journal of Scheduling، ويجمع فيها توزيع الطلاب على الشعب Student Sectioning مع توزيع الأوقات والقاعات.
- المشكلة: الجدول يبنى يدوياً أو بأداة لا تشرح لماذا فشلت، والتعارضات تظهر بعد التسجيل.
- المستخدم: قسم الجدولة في الكلية، ورؤساء الأقسام، والطلاب بشكل غير مباشر.
- النطاق: قارئ لصيغة XML الخاصة بالمسابقة، ونموذج قيود لجزء منها في الفصل الأول، ثم الباقي في الثاني، ومقارنة بين حل دقيق Exact بأداة CP-SAT وحل تقريبي Metaheuristic مثل المحاكاة الحرارية Simulated Annealing، وواجهة تشرح القيد الذي منع وضع مادة في وقت معين.
- الأدوات: Python مع Google OR-Tools، أو Java، والمهم أن تفهموا لماذا يكون نموذج القيود صغيراً أو ضخماً.
- البيانات: حالات ITC 2019 المنشورة على موقع المسابقة، وإذا وافقت الكلية فبيانات جدول حقيقي بعد حذف الأسماء.
- التقييم: نتيجة الحل بحسب دالة التقييم الرسمية للمسابقة مقارنة بأفضل النتائج المنشورة، والزمن اللازم، وعدد القيود المخالفة، ثم تجربة مع موظف الجدولة على حالة من الكلية.
- الصعوبة: مرتفعة.
- الخطر الذي يقتله: محاولة نمذجة كل القيود من اليوم الأول، فيمضي الفصل الأول في قراءة الصيغة. والتخفيف أن تبدؤوا بأصغر حالة وبالقيود الصارمة Hard Constraints وحدها.
- ما يميزه: شرح سبب الفشل للمستخدم، فأغلب الأدوات تقول «لا يوجد حل» ولا تقول أي قيدين متعارضان، وهذا يحول الأداة من صندوق أسود إلى مساعد.
محاكاة حركة الحشود Crowd Simulation في التجمعات الكبيرة
Project title: Crowd Simulation for Mass Gatherings
في مواسم الحج والعمرة وفي المباريات والمعارض الكبيرة يتحرك عشرات الآلاف عبر ممرات وبوابات محدودة، ويحتاج من يخطط لها أن يعرف قبل الحدث ماذا يحدث إذا أغلقت بوابة، أو تغير اتجاه السير في ممر، أو وصل الناس في نصف ساعة بدل ساعة. ومحاكاة المشاة Pedestrian Dynamics مجال في علوم الحاسب له نماذجه وبياناته، والمشروع هنا هو بناء أداة محاكاة لمخطط حقيقي ومعايرتها على تجارب مقاسة، لا رسم نقاط تتحرك على الشاشة.
- المشكلة: قرارات البوابات والممرات تؤخذ بالخبرة، ولا توجد أداة بسيطة تعرض أثر القرار على كثافة الحشد وزمن الإخلاء.
- المستخدم: فرق تنظيم الفعاليات الكبيرة، وإدارات المرافق في الجامعة نفسها لمخارج الطوارئ في قاعة كبيرة.
- النطاق: قراءة مخطط المكان من خريطة، ومحرك محاكاة بنموذج معروف، وسيناريوهات قابلة للتغيير، وعرض لكثافة الحشد في كل نقطة، وتقرير مقارنة بين السيناريوهات.
- الأدوات: JuPedSim مفتوحة المصدر ولها واجهة Python، أو بناء نموذج القوة الاجتماعية Social Force Model بأنفسكم إذا أردتم الجزء الخوارزمي كاملاً، ومكتبة لرسم الخرائط.
- البيانات: أرشيف تجارب حركة المشاة في مركز Jülich وفيه مسارات مقاسة من تجارب حقيقية، وهندسة المكان من OpenStreetMap عبر Overpass API.
- التقييم: مقارنة العلاقة بين الكثافة والسرعة في محاكاتكم بما في بيانات التجارب، وزمن الإخلاء في عدة سيناريوهات، وزمن تشغيل المحاكاة مع زيادة عدد المشاة.
- الصعوبة: مرتفعة.
- الخطر الذي يقتله: تقديم نتائج المحاكاة كأنها توصيات سلامة، وهذا خطأ مهني لأن المحاكاة غير المعايرة لا تصلح لقرار حقيقي. والتخفيف أن يكون التقييم على بيانات تجارب منشورة، وأن تكتبوا حدود النموذج بوضوح.
- ما يميزه: المعايرة على بيانات مقاسة، وإسهام في JuPedSim نفسها إذا وجدتم نقصاً، وتقرير يبين أين يختلف النموذج عن الواقع.
تخطيط مسارات الحافلات Vehicle Routing بخرائط حقيقية
Project title: Bus Route Optimization Using Real Road Maps
حافلات النقل المدرسي وسيارات التوصيل وفرق الصيانة كلها تواجه نفس السؤال كل صباح: بأي ترتيب تزور النقاط، وكم مركبة تحتاج، بحيث لا تتجاوز سعة أي مركبة ولا يتأخر أحد عن وقته. وهذه مسألة توجيه المركبات Vehicle Routing Problem، واختصاراً VRP، وهي من أشهر مسائل التحسين التوافقي Combinatorial Optimization، ولها مكتبة معايير منشورة هي CVRPLIB فيها حالات ونتائج أفضل الحلول المعروفة، وهذا يعطيكم شيئاً نادراً في مشاريع التخرج، وهو مقارنة مباشرة بأفضل ما وصل إليه الباحثون.
- المشكلة: المسارات تبنى يدوياً، فتطول وتستهلك وقوداً أكثر، ولا تتغير عندما ينتقل طالب أو يضاف عميل.
- المستخدم: مدرسة أهلية أو شركة نقل صغيرة أو فريق صيانة، ويمكن أن تبدؤوا بحافلات الجامعة نفسها.
- النطاق: حساب مصفوفة المسافات على الطرق الحقيقية لا بخط مستقيم، وحل VRP بسعة المركبة ونوافذ زمنية Time Windows، وواجهة تعرض المسارات على خريطة، وإعادة حساب عند تغير نقطة.
- الأدوات: OR-Tools لحل المسألة، وOSRM لحساب المسافات على شبكة الطرق من OpenStreetMap، وقد شرحنا الخوارزميات التي تقوم عليها في خوارزميات الرسم البياني.
- البيانات: حالات CVRPLIB للمقارنة، وشبكة الطرق من OpenStreetMap، ونقاط افتراضية في أحياء حقيقية بدل عناوين الطلاب، وابحث في منصة البيانات المفتوحة عن مواقع المدارس أو المرافق قبل أن تفترضها.
- التقييم: الفجوة Gap بين حلكم وأفضل حل معروف في CVRPLIB بالنسبة المئوية، والزمن، ثم مقارنة المسافة الكلية بمسار يدوي حقيقي إذا حصلتم عليه.
- الصعوبة: متوسطة إلى مرتفعة.
- الخطر الذي يقتله: عناوين الطلاب الحقيقية، فهي بيانات شخصية لا يجب أن تخرج من المدرسة. والتخفيف أن تعملوا على نقاط مقربة إلى مستوى الحي، أو على نقاط مولدة بنفس التوزيع.
- ما يميزه: قيود من الواقع المحلي، مثل تجنب ساعات الظهيرة في الصيف أو فصل مسارات البنين والبنات، مع قياس كلفة كل قيد على المسافة الكلية.
لغة برمجة تعليمية بكلمات عربية تترجم إلى WebAssembly
Project title: An Arabic-Keyword Educational Programming Language Compiled to WebAssembly
هذه فكرة لمن أحب مادة المترجمات Compilers، أو لمن خاف منها ويريد أن يفهمها مرة واحدة. المطلوب لغة صغيرة بكلمات مفتاحية عربية مثل «إذا» و«كرر» و«دالة»، يكتب بها طالب في المرحلة المتوسطة برنامجه في المتصفح، فيترجمه المترجم إلى WebAssembly ويشغله مباشرة. وفي هذا المشروع تمر على كل مراحل المترجم التي شرحناها في كيف يعمل المترجم، من التحليل اللفظي Lexing إلى توليد الكود، وتتعلم لماذا اختارت المتصفحات WebAssembly كما شرحنا في المترجم والمفسر وJIT.
- المشكلة: الطالب الصغير يتعلم البرمجة ومفاهيمها وكلماتها الإنجليزية في نفس الوقت، ورسائل الخطأ بالإنجليزية تزيد الحاجز.
- المستخدم: معلمو الحاسب في المدارس وطلابهم، ويمكن أن تجربوها مع نادي برمجة في مدرسة قريبة.
- النطاق: تعريف لغة صغيرة فيها متغيرات وشروط وحلقات ودوال ومصفوفات، ومحلل لفظي ومحلل نحوي Parser بطريقة النزول التكراري Recursive Descent، وفاحص أنواع Type Checker، وتوليد WAT ثم تحويله إلى ملف wasm، ومحرر في المتصفح برسائل خطأ عربية.
- الأدوات: TypeScript أو Rust للمترجم، وWABT أو Binaryen للتحويل والتحسين.
- البيانات: لا تحتاج بيانات خارجية، وإنما مجموعة اختبارات Test Suite من مئات البرامج الصغيرة مع مخرجاتها المتوقعة، وهذه تكتبونها أنتم.
- التقييم: نسبة نجاح مجموعة الاختبارات، وزمن الترجمة، وسرعة البرنامج المترجم مقارنة بمفسر بسيط Interpreter كتبتموه للمقارنة، ثم دراسة صغيرة مع طلاب على فهم رسائل الخطأ، بموافقة المدرسة وأولياء الأمور.
- الصعوبة: مرتفعة.
- الخطر الذي يقتله: لغة كبيرة من البداية، فيمضي المشروع في التصميم. والتخفيف أن تحددوا قواعد اللغة Grammar في صفحة واحدة في الأسبوع الثالث وتجمدوها، ومشكلة ثانية هي عرض النص المختلط في المحرر، وقد شرحنا أسبابها في التعريب والنص ثنائي الاتجاه.
- ما يميزه: رسائل خطأ عربية مدروسة مع مستخدمين حقيقيين، ودعم بروتوكول خادم اللغة Language Server Protocol حتى تعمل اللغة في محررات معروفة.
مخزن مفاتيح موزع Distributed Key-Value Store بخوارزمية Raft
Project title: Distributed Key-Value Store Using the Raft Consensus Algorithm
كل قاعدة بيانات موزعة تواجه نفس السؤال: إذا كانت البيانات على خمسة سيرفرات وتعطل أحدها أو انقطعت الشبكة بين اثنين منها، فكيف تبقى كل السيرفرات متفقة على القيمة الصحيحة؟ والإجابة في أنظمة كثيرة اليوم هي خوارزمية الإجماع Consensus المسماة Raft، وقد شرحنا الإجماع والاتساق Consistency في الأنظمة الموزعة للمبتدئين. والمشروع هنا بناء مخزن مفاتيح صغير فوق Raft، وإثبات صحته تحت الأعطال بأداة اختبار حقيقية، لا بتشغيله على جهاز واحد والقول إنه يعمل.
- المشكلة: أغلب الطلاب يستخدمون الأنظمة الموزعة ولا يعرفون كيف تفشل، والمشروع يبني هذه المعرفة بالقياس.
- المستخدم: مطورون يحتاجون مخزن إعدادات صغير موثوق، والأهم أن المشروع يقيم على صحته لا على مستخدميه.
- النطاق: انتخاب القائد Leader Election، ونسخ السجل Log Replication، والحفظ على القرص Persistence، واللقطات Snapshots، وواجهة مفاتيح وقيم، ثم اختبارات أعطال تقطع الشبكة وتعيد تشغيل السيرفرات.
- الأدوات: Go أو Rust، وMaelstrom من Jepsen، وهي بيئة تشغل خوادمكم وترسل لها الطلبات عبر شبكة محاكاة وتفحص أن ما يراه الكلاينت صحيح، ومعها اختبار جاهز لمخزن مفاتيح قابل للخطية Linearizable.
- البيانات: لا تحتاج بيانات، والطلبات يولدها Maelstrom، والمرجع الدراسي مختبرات مادة MIT 6.5840 للأنظمة الموزعة.
- التقييم: نجاح فاحص الخطية في Maelstrom تحت انقطاع الشبكة Network Partition وتأخير الرسائل، وزمن انتخاب قائد جديد بعد سقوط القديم، والإنتاجية Throughput وزمن الاستجابة مع زيادة عدد العقد Nodes.
- الصعوبة: مرتفعة جداً.
- الخطر الذي يقتله: الأخطاء غير الحتمية Nondeterministic التي تظهر مرة في مئة تشغيل وتأكل أسابيع. والتخفيف أن تسجلوا كل رسالة وأن تكتبوا الاختبارات من الأسبوع الأول، ولا تقوموا بنسخ حلول المختبرات المنشورة، فهي مخالفة أكاديمية واضحة وتعرفها اللجان.
- ما يميزه: تقرير أعطال يعرض حالة اكتشفها الفاحص فعلاً، وكيف أصلحتموها، ومخطط يبين ما يحدث للزمن أثناء الانقطاع.
كشف التشابه في كود الطلاب Code Similarity Detection
Project title: Code Similarity Detection for Student Assignments
أستاذ مادة البرمجة 1 يصحح مئتي واجب، ويريد أن يعرف أي الواجبات متشابهة بدرجة تستحق أن ينظر فيها بنفسه، حتى لو غير الطالب أسماء المتغيرات وأعاد ترتيب الدوال. والخوارزمية المعروفة لهذا هي البصمات بطريقة Winnowing، حيث يحول الكود إلى رموز Tokens ثم إلى مقاطع متتالية k-grams ثم يختار منها بصمات بطريقة تضمن أن أي تطابق بطول كاف سوف يظهر، وهي الفكرة التي يقوم عليها نظام MOSS المعروف في الجامعات. والمشروع بناء هذه الأداة وتقييمها على مجموعة بيانات منشورة صممت لهذا الغرض بالضبط.
- المشكلة: فحص التشابه يدوياً مستحيل مع الأعداد الكبيرة، والأدوات الخارجية ترسل كود الطلاب إلى خارج الجامعة.
- المستخدم: أساتذة مواد البرمجة ومساعدوهم.
- النطاق: محلل رموز لـ Java وPython، وتطبيع الأسماء والقيم، وبصمات Winnowing، ومقارنة بالأشجار النحوية AST للتعديلات الأعمق، وواجهة تعرض المقاطع المتطابقة جنباً إلى جنب.
- الأدوات: Python أو Java، وJPlag مفتوحة المصدر خطاً أساسياً للمقارنة.
- البيانات: مجموعة Karnalim لتشابه الكود، وفيها 467 ملف Java في سبعة واجبات تمهيدية، مقسمة إلى أصلي وغير منقول ومنقول بستة مستويات من التعديل، ووصفها في بحثها المنشور.
- التقييم: الدقة Precision والاستدعاء Recall عند كل عتبة تشابه، لكل مستوى من مستويات التعديل الستة، ومقارنة بـ JPlag على نفس الملفات.
- الصعوبة: متوسطة.
- الخطر الذي يقتله: أن تقدم الأداة على أنها تحكم بالغش، فالتشابه دليل يحتاج نظر إنسان، والاتهام الخاطئ يضر طالباً بريئاً. والتخفيف أن تكون الواجهة أداة مساعدة تعرض الدليل ولا تصدر حكماً، وأن تبقى البيانات داخل الجامعة.
- ما يميزه: النتائج لكل مستوى تعديل على حدة، فأغلب الأدوات تنجح مع النسخ المباشر وتسقط مع إعادة الكتابة، وتقريركم يبين أين بالضبط.
المساهمة في مشروع مفتوح المصدر Open Source Contribution كمشروع تخرج
Project title: Open Source Contribution as a Graduation Project
هذه الفكرة مختلفة عن غيرها، لأن المنتج هنا ليس نظاماً تبنيه من الصفر، وإنما مجموعة مساهمات مقبولة في مشروع يستخدمه ملايين، مثل CPython أو PostgreSQL أو محرر نصوص أو مكتبة عرض نصوص. وقيمتها في السيرة الذاتية أعلى من أغلب المشاريع، لأن من يقرأ سيرتك يستطيع أن يفتح طلبات الدمج Pull Requests ويرى الكود والمراجعة بنفسه. وقد شرحنا التراخيص وما تعنيه للمساهم في البرمجيات مفتوحة المصدر وتراخيصها، وأساسيات Git في إدارة النسخ وGit.
- المشكلة: مشاريع كبيرة فيها أخطاء معروفة لا يجد أحد وقتاً لإصلاحها، وكثير منها في دعم العربية والنص من اليمين إلى اليسار.
- المستخدم: مستخدمو المشروع حول العالم، والمشرفون عليه Maintainers الذين يراجعون عملكم.
- النطاق: اختيار مشروع ومجال فيه، وقراءة دليل المساهمين، وإصلاح من خمسة إلى عشرة أخطاء متدرجة الصعوبة، ثم ميزة صغيرة واحدة، مع اختبارات لكل مساهمة.
- الأدوات: ما يستخدمه المشروع نفسه، فدليل مطوري CPython يشرح البناء والاختبار والمراجعة، وصفحة تقديم التعديلات في PostgreSQL تشرح طريقتهم المختلفة بالبريد.
- البيانات: سجل المشكلات Issues في المشروع نفسه، وبرنامج Google Summer of Code إطار جاهز إذا أردتم مرشداً من المشروع.
- التقييم: عدد المساهمات المقبولة، وعدد جولات المراجعة لكل منها، والاختبارات المضافة، وقياس أداء قبل وبعد إذا كانت المساهمة في السرعة.
- الصعوبة: متوسطة إلى مرتفعة بحسب المشروع.
- الخطر الذي يقتله: أن لا يقبل القسم هذا النوع من المشاريع، أو أن تتأخر المراجعة أسابيع. والتخفيف أن تتفقوا مع المشرف قبل البدء على أن التقييم بالعمل المقدم وجودته لا بالقبول وحده، وأن تختاروا مشروعاً نشطاً في مراجعة الطلبات.
- ما يميزه: اختيار أخطاء العربية في مشروع مشهور، فأنتم أقدر عليها من غيركم، وأثرها مباشر على كل مستخدم عربي.
أفكار الماجستير Master Research
الأفكار الست التالية مكتوبة بصيغة سؤال بحثي، ولكل منها أعمال سابقة يمكن أن تبدأ منها، ومعيار مقارنة أو بيانات منشورة، وزاوية جديدة يمكن أن تكون إسهامك. وقبل أن تختار، اقرأ كيف تجد الفجوة البحثية في الأدبيات العلمية، لأن الزاوية الجديدة التي نقترحها هنا قد يكون غيرك نشرها بعد كتابة هذا المقال، ولا يعرف ذلك إلا من بحث.
الفهارس المتعلمة Learned Indexes مقابل B-Tree
Project title: Learned Indexes Versus B-Trees
اقترح بحث The Case for Learned Index Structures في 2017 أن الفهرس في قاعدة البيانات هو في الحقيقة نموذج يتنبأ بموقع المفتاح في مصفوفة مرتبة، وأن نموذجاً صغيراً يتعلم توزيع المفاتيح قد يكون أسرع وأصغر من شجرة B-Tree. وبعده ظهر معيار المقارنة SOSD الذي يقارن الفهارس المتعلمة والتقليدية على بيانات حقيقية، كل مجموعة فيها من 200 إلى 800 مليون مفتاح. وإذا كنت قد قرأت الفهارس وقراءة EXPLAIN وكيف تخزن قاعدة البيانات بياناتك، فأنت تعرف لماذا يهم هذا السؤال لكل من يشغل قاعدة بيانات كبيرة.
- السؤال البحثي: متى يتفوق الفهرس المتعلم على B+Tree عندما تكون هناك عمليات إضافة مستمرة Updates، أو عندما يكون الفهرس على القرص لا في الذاكرة؟
- الأعمال السابقة: البحث الأصلي، ومعيار SOSD، وتنفيذ RMI المرجعي، والأعمال التي تلتها على الفهارس القابلة للتحديث.
- الزاوية الجديدة: مفاتيح نصية عربية، مثل أسماء أو عناوين مرتبة، فأغلب الأعمال على أعداد صحيحة، والنص يغير شكل التوزيع.
- البيانات: مجموعات SOSD، واحذر من حجمها لأن كل مجموعة عدة غيغابايتات، فابدأ بعينة منها.
- التقييم: زمن البحث بالمتوسط والمئين Percentile، وحجم الفهرس، وزمن البناء، وأثر نسبة التحديث، على نفس الجهاز ونفس إعدادات الترجمة.
- الصعوبة: مرتفعة.
- الخطر الذي يقتله: الضجيج في القياس Measurement Noise على جهاز مشترك. والتخفيف أن تثبت تردد المعالج وتكرر القياس وتنشر الإعدادات كاملة، وقد شرحنا ذلك في البحث القابل لإعادة الإنتاج.
جدولة طلبات خدمة نماذج اللغة LLM Serving Scheduling
Project title: Request Scheduling for LLM Serving
خدمة نموذج لغة على عدد محدود من بطاقات GPU مسألة جدولة قبل أن تكون مسألة ذكاء اصطناعي، فالطلبات تصل بأطوال مختلفة، وكل طلب يحجز ذاكرة لذاكرة المفاتيح والقيم KV Cache تكبر مع كل كلمة ينتجها، والسؤال هو أي الطلبات تدخل الدفعة Batch التالية وأيها تنتظر. وقد غير بحث PagedAttention الذي يقوم عليه vLLM طريقة إدارة هذه الذاكرة، وشرحنا ما يحدث داخل النموذج نفسه في كيف تعمل نماذج اللغة الكبيرة. وهذه فكرة أنظمة لا تحتاج أن تدرب نموذجاً واحداً.
- السؤال البحثي: هل تقلل جدولة تعرف الطول المتوقع للإجابة زمن أول كلمة Time To First Token في المئين 99 تحت حركة حقيقية، دون أن تخفض الإنتاجية؟
- الأعمال السابقة: PagedAttention وvLLM، وبحث Splitwise الذي يفصل مرحلة قراءة الطلب عن مرحلة التوليد.
- البيانات: آثار Azure لخدمات نماذج اللغة 2023 بترخيص CC-BY، وفيها توقيت الطلبات وعدد الرموز Tokens في المدخل والمخرج.
- الطريقة: محاكي أحداث متقطعة Discrete Event Simulator يعيد تشغيل الآثار، ثم التحقق من المحاكي بتجربة صغيرة على vLLM وبطاقة واحدة.
- التقييم: زمن أول كلمة وزمن كل كلمة بعدها، والإنتاجية، واستخدام الذاكرة، في عدة سياسات جدولة.
- الصعوبة: مرتفعة.
- الخطر الذي يقتله: عدم توفر GPU للتحقق، أو محاكي لا يشبه الواقع. والتخفيف أن تحجز وقتاً على أجهزة الجامعة من الفصل الأول، وأن تقارن المحاكي بالتجربة الحقيقية قبل أي استنتاج.
الاختبار التفاضلي Differential Testing لخوارزمية Bidi في النص العربي
Project title: Differential Testing of Bidi Algorithm Implementations on Arabic Text
كل برنامج يعرض نصاً عربياً فيه أرقام أو كلمات إنجليزية أو روابط يطبق خوارزمية النص ثنائي الاتجاه التي يصفها معيار UAX #9، وكل مطور عربي رأى رقماً ينتقل إلى مكان خاطئ في جملة أو رابطاً انقلب ترتيبه. والسؤال البحثي هنا: هل تتفق التطبيقات المشهورة لهذه الخوارزمية فيما بينها ومع المعيار؟ والطريقة المعروفة لذلك هي الاختبار التفاضلي، أي أن تعطي نفس المدخل لعدة تطبيقات وتبحث عن الحالات التي تختلف فيها مخرجاتها، وقد شرحنا أساس الترميز في ترميز النصوص وUnicode.
- السؤال البحثي: ما أنواع الاختلاف بين FriBidi وICU ومحركات المتصفحات على نصوص عربية مختلطة حقيقية، وما الذي لا تغطيه اختبارات المعيار الرسمية؟
- البيانات: ملف BidiCharacterTest.txt الرسمي، ونسخته الحالية 18.0.0 فيها أكثر من 94 ألف سطر اختبار، ونصوص عربية حقيقية من ويكيبيديا فيها أرقام وروابط.
- الطريقة: أداة تشغل كل تطبيق على نفس المدخل، ومولد نصوص من قواعد Grammar-based Fuzzing يركز على الحالات العربية، وتقليص الحالة المختلفة إلى أصغر مثال Minimization.
- التقييم: عدد الاختلافات الفريدة بعد التقليص، وتصنيفها، وكم منها أخطاء حقيقية اعترف بها أصحاب المشاريع بعد إبلاغهم.
- الصعوبة: مرتفعة.
- الخطر الذي يقتله: أن لا تجد اختلافاً، فالمكتبات الكبيرة ناضجة. والتخفيف أن توسع الدائرة إلى المحررات والطرفيات Terminals ومكتبات واجهات الجوال، حيث الاختلاف أكثر احتمالاً، وأن يكون غياب الاختلاف نفسه نتيجة تكتبها.
التحقق الصوري Formal Verification لعمليات التحويل المالي بـ TLA+
Project title: Formal Verification of Financial Transfer Operations with TLA+
شركات التقنية المالية الناشئة التي تعمل تحت البيئة التجريبية التشريعية Regulatory Sandbox لدى البنك المركزي السعودي تبني عمليات تحويل فيها إعادة محاولة Retry ومفاتيح عدم التكرار Idempotency Keys ومهلات Timeouts بين عدة خدمات، والخطأ في ترتيب هذه الخطوات قد يحول المبلغ مرتين أو لا يحوله ويخبر العميل أنه حوله. والاختبارات العادية لا تجرب كل ترتيبات الرسائل الممكنة، أما المواصفة الصورية Formal Specification بلغة TLA+ فيفحصها فاحص النماذج Model Checker على كل الحالات في نطاق محدد.
- السؤال البحثي: كم من الأخطاء المزروعة Seeded Bugs في مواصفة تحويل مالي يكتشفها فاحص النماذج ولا تكتشفها الاختبارات القائمة على الخصائص Property-based Testing، وبأي كلفة في الوقت والجهد؟
- الأدوات: أدوات TLA+ والفاحص TLC، وApalache للفحص الرمزي Symbolic.
- البيانات: لا تحتاج بيانات، وإنما مواصفة لعملية تحويل مكتوبة من وثائق API منشورة لبنوك أو شركات مدفوعات، وتنفيذ مرجعي صغير.
- التقييم: نسبة الأخطاء المكتشفة من كل طريقة، وحجم فضاء الحالات State Space، والزمن، ومقارنة بساعات العمل اللازمة لكل طريقة.
- الصعوبة: مرتفعة جداً.
- الخطر الذي يقتله: انفصال المواصفة عن الكود، فتثبت صحة شيء لا يعمل في الواقع. والتخفيف أن تكتب اختباراً يقارن آثار التنفيذ Execution Traces بالمواصفة.
الجدولة الواعية بالطاقة Energy-Aware Scheduling بآثار Google
Project title: Energy-Aware Scheduling Using Google Cluster Traces
مراكز البيانات تستهلك كهرباء كثيرة، وجزء من المهام التي تشغلها مهام دفعية Batch Jobs يمكن أن تتأخر ساعة أو ساعتين دون أن يلاحظ أحد، والسؤال هو كم من الطاقة أو من كلفة الكهرباء يمكن توفيره إذا نقلت هذه المهام إلى أوقات أرخص أو أخف على الشبكة، دون أن تخالف التزامات مستوى الخدمة SLO. وقد شرحنا كيف يجدول نظام التشغيل العمليات على المعالج في العمليات وجدولة المعالج في Linux، وهنا نفس الفكرة على مستوى مركز بيانات كامل.
- السؤال البحثي: ما نسبة الطاقة التي يمكن نقلها زمنياً تحت قيود مستوى خدمة واقعية، وما أثر دقة التنبؤ بمدة المهمة على هذه النسبة؟
- البيانات: آثار عناقيد Google المنشورة من نظام Borg، ومنها آثار 2019 لعدة عناقيد.
- الطريقة: محاكي جدولة يعيد تشغيل الآثار مع نموذج استهلاك طاقة لكل جهاز، وسياسات جدولة مختلفة، ثم تحليل حساسية Sensitivity Analysis لكل افتراض.
- التقييم: الطاقة أو الكلفة المحسوبة، ونسبة المهام التي تجاوزت التزامها، وزمن الانتظار الإضافي.
- الصعوبة: مرتفعة.
- الخطر الذي يقتله: حجم الآثار، فهي كبيرة جداً ومتاحة عبر خدمات سحابية، والتخفيف أن تعمل على عينة زمنية من عنقود واحد وتذكر ذلك بوضوح.
فهرس نصي مضغوط Compressed Full-Text Index للنص العربي
Project title: Compressed Full-Text Index for Arabic Text
الفهرس المعكوس Inverted Index الذي شرحناه في كيف يعمل البحث يقسم النص إلى كلمات، والعربية لغة اشتقاقية تلتصق فيها الحروف بالكلمة، فـ «وبالكتاب» و«كتابهم» و«الكتب» كلمات مختلفة في الفهرس، لذلك يحتاج المحرك إلى تجذيع Stemming يخطئ أحياناً. أما الفهارس المبنية على مصفوفة اللواحق Suffix Array، مثل FM-index، فتسمح بالبحث عن أي جزء من النص دون تقسيمه إلى كلمات، وتضغط النص نفسه في نفس الوقت.
- السؤال البحثي: كيف يقارن FM-index بالفهرس المعكوس مع التجذيع على نص عربي في الحجم والسرعة والاستدعاء، خاصة لاستعلامات جزء الكلمة؟
- الأدوات: مكتبة sdsl-lite لهياكل البيانات المضغوطة Succinct Data Structures، ومحرك بحث معروف للمقارنة.
- البيانات: نسخ ويكيبيديا العربية، مع مجموعة استعلامات تكتبها وتحدد إجاباتها الصحيحة.
- التقييم: نسبة حجم الفهرس إلى حجم النص، وزمن الاستعلام، والاستدعاء مقارنة بالتجذيع.
- الصعوبة: مرتفعة جداً.
- الخطر الذي يقتله: الذاكرة اللازمة لبناء مصفوفة اللواحق لنص كبير، والتخفيف أن تبدأ بشريحة من النص وتقيس كيف يتغير كل رقم مع الحجم.
الأفكار المستهلكة Overused Ideas وكيف تحولها إلى مشروع حقيقي
عندما قال المشرف «لا أريد نظام حضور وغياب آخر»، فهو لا يكره الحضور والغياب، وإنما يكره أن يرى نفس الشاشات ونفس قاعدة البيانات ونفس التقرير كل سنة، دون سؤال واحد يحتاج طالب علوم الحاسب ليجيب عنه. والأفكار المستهلكة في هذا التخصص معروفة، وأشهرها ثلاث: نظام الحضور والغياب، والمتجر الإلكتروني العام، و«روبوت المحادثة للجامعة» Chatbot. والقاعدة في تحويل أي منها أن تبحث داخلها عن السؤال الصعب، ثم تجعل المشروع كله عن هذا السؤال، والباقي واجهة لتجربته.
- نظام الحضور Attendance System: السؤال الصعب فيه ليس تسجيل الحضور، وإنما منع الحضور بالنيابة. فرمز QR يتغير كل عشر ثوان ويوقع رقمياً، ويتحقق منه السيرفر بزمن قصير، ثم تقيسون كم طالباً يستطيع التسجيل خلال دقيقة في قاعة فيها 300 طالب، وما يحدث إذا صور أحدهم الرمز وأرسله لزميله خارج القاعة. هنا أصبح المشروع عن التوقيع والزمن والسعة، لا عن الشاشات.
- المتجر الإلكتروني E-commerce: السؤال الصعب فيه البحث، فأسماء المنتجات العربية مكتوبة بأشكال مختلفة، والمستخدم يكتب بأخطاء، والترتيب يحدد ما يشتريه. اجعلوا المشروع محرك بحث للمنتجات العربية بالتطبيع والتصحيح الإملائي والترتيب، وقيسوا الدقة على استعلامات حقيقية، أو اجعلوه عن الاتساق Consistency عندما يشتري مئة شخص آخر قطعة في نفس اللحظة.
- روبوت المحادثة للجامعة University Chatbot: السؤال الصعب فيه ليس الاتصال بنموذج لغة، وإنما أن تعرف هل الإجابة صحيحة. ابنوا مجموعة أسئلة حقيقية من لائحة الجامعة مع إجاباتها الصحيحة ومواضعها في اللائحة، ثم قيسوا كم مرة يجيب النظام بشيء غير موجود في اللائحة، وهذا التقييم هو المشروع، أما النموذج فأداة يمكن تبديلها.
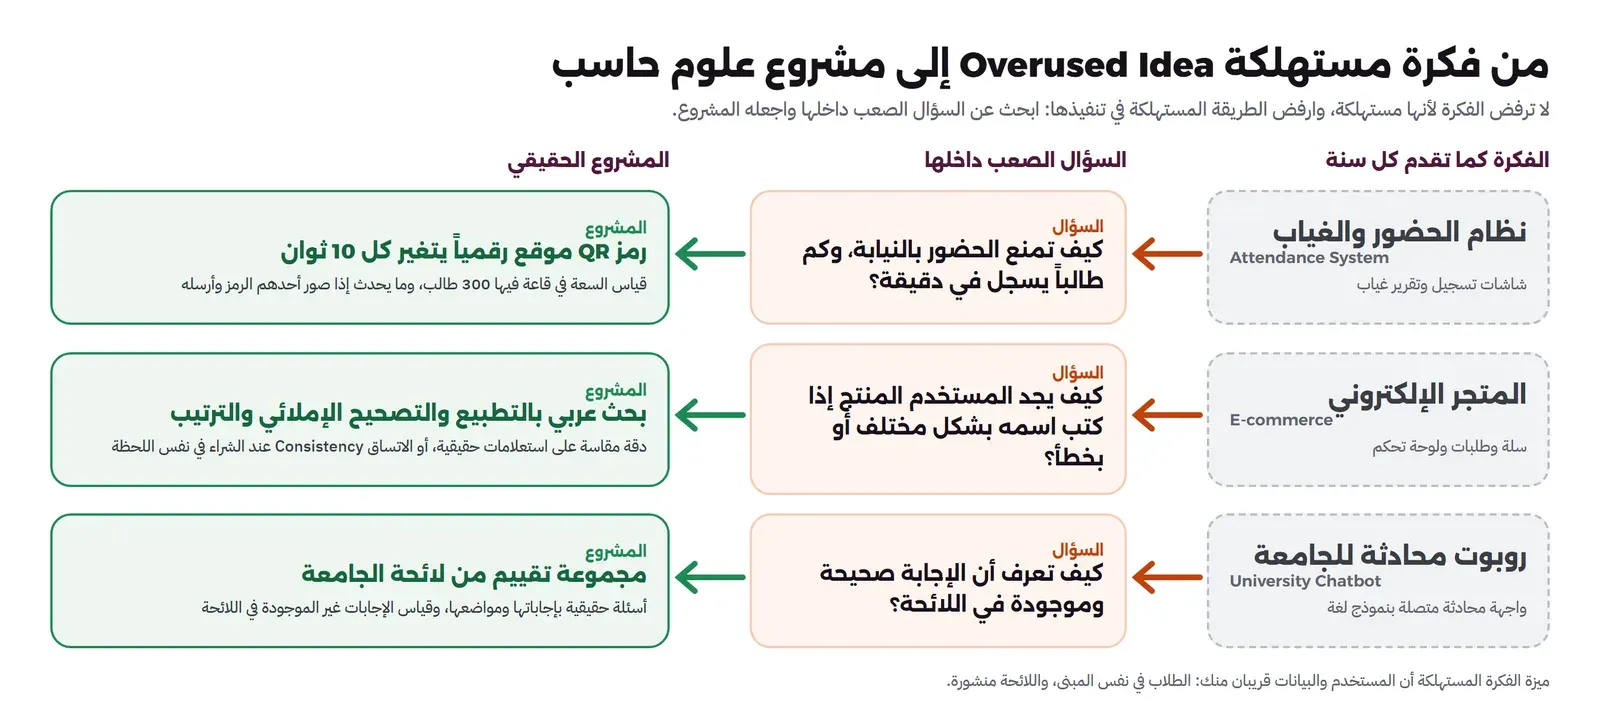
وقد يتساءل البعض: إذا كان المشرف سوف يقبل الفكرة بعد هذا التحويل، فلماذا لا نختار فكرة جديدة من البداية؟ والإجابة أن الفكرة المستهلكة لها ميزة حقيقية، وهي أن المستخدم موجود حولك والبيانات قريبة منك، فطلاب القاعة وأساتذتها في نفس المبنى، ولائحة الجامعة منشورة، وهذا يحل أصعب حقلين في بطاقة الفكرة، وهما المستخدم والبيانات. لذلك لا تقم برفض الفكرة لأنها مستهلكة، وإنما ارفض الطريقة المستهلكة في تنفيذها.
جدول المقارنة Comparison Table بين الأفكار
الجدول التالي يجمع الأفكار الأربع عشرة، وتوفر البيانات فيه يعني ما وجدناه فعلاً عند كتابة المقال: «منشورة» أي أن هناك بيانات أو معياراً جاهزاً للتحميل، و«تولدها» أي أن المشروع لا يحتاج بيانات خارجية ويصنع مدخلاته أو اختباراته بنفسه، و«تجمعها» أي أن جزءاً أساسياً منها يجمعه الفريق من مستخدمين.
| الفكرة | المستوى | الصعوبة | البيانات | المهارات التي تتعلمها |
|---|---|---|---|---|
| مقترح التصحيح الإملائي العربي Arabic Spelling Suggester | بكالوريوس | متوسطة | منشورة وتجمعها | مسافة التحرير، BK-tree، التطبيع، بناء API، التقييم بالدقة والزمن |
| جدولة المقررات ITC 2019 University Course Timetabling | بكالوريوس | مرتفعة | منشورة | نمذجة القيود، CP-SAT، المحاكاة الحرارية |
| محاكاة الحشود Crowd Simulation for Mass Gatherings | بكالوريوس | مرتفعة | منشورة | نماذج المشاة، المعايرة، الخرائط |
| مسارات الحافلات VRP Bus Route Optimization Using Real Road Maps | بكالوريوس | متوسطة إلى مرتفعة | منشورة | التحسين التوافقي، OSRM، الرسم البياني |
| لغة تعليمية إلى WebAssembly An Arabic-Keyword Educational Programming Language Compiled to WebAssembly | بكالوريوس | مرتفعة | تولدها | المترجمات، الأنواع، WebAssembly، Bidi في المحرر |
| مخزن مفاتيح بـ Raft Distributed Key-Value Store Using the Raft Consensus Algorithm | بكالوريوس | مرتفعة جداً | تولدها | الإجماع، الخطية، اختبار الأعطال |
| كشف التشابه في الكود Code Similarity Detection for Student Assignments | بكالوريوس | متوسطة | منشورة | Winnowing، الأشجار النحوية، الدقة والاستدعاء |
| مساهمة مفتوحة المصدر Open Source Contribution as a Graduation Project | بكالوريوس | متوسطة إلى مرتفعة | في المشروع | قراءة كود كبير، المراجعة، الاختبارات |
| الفهارس المتعلمة Learned Indexes Versus B-Trees | ماجستير | مرتفعة | منشورة وكبيرة | هياكل الفهارس، القياس الدقيق |
| جدولة خدمة نماذج اللغة Request Scheduling for LLM Serving | ماجستير | مرتفعة | منشورة | المحاكاة بالأحداث، الجدولة، ذاكرة GPU |
| الاختبار التفاضلي لـ Bidi Differential Testing of Bidi Algorithm Implementations on Arabic Text | ماجستير | مرتفعة | منشورة | Unicode، Fuzzing، تقليص الحالات |
| التحقق الصوري بـ TLA+ Formal Verification of Financial Transfer Operations with TLA+ | ماجستير | مرتفعة جداً | تولدها | المواصفات الصورية، فحص النماذج |
| الجدولة الواعية بالطاقة Energy-Aware Scheduling Using Google Cluster Traces | ماجستير | مرتفعة | منشورة وكبيرة | تحليل الآثار، المحاكاة، الحساسية |
| فهرس نصي مضغوط للعربية Compressed Full-Text Index for Arabic Text | ماجستير | مرتفعة جداً | منشورة | مصفوفة اللواحق، الضغط، التقييم بالاستدعاء |
ولاحظ أننا لم نضع في الجدول أي فكرة صعوبتها «منخفضة»، والسبب أن مشروع التخرج في علوم الحاسب الذي يكون سهلاً في كل أجزائه لا يعطي اللجنة ما تقيمه، فالسهولة المناسبة هي أن تكون الواجهة والبنية سهلة، وأن يكون في القلب جزء واحد صعب تعرفون من البداية أين هو.
تجربة عملية Lab: نموذج أولي Spike لمقترح التصحيح الإملائي
عاد الفريق إلى المشرف بثلاث أفكار، فاختار منها مقترح التصحيح الإملائي، لكنه سأل السؤال المتوقع: كيف تعرفون أن هذا ممكن بأدوات الطلاب وفي وقت معقول، وما الرقم الذي سوف تحاولون تحسينه؟ والإجابة الصحيحة على هذا السؤال ليست فقرة في المقترح، وإنما نموذج أولي صغير Spike يعمل في يومين، يأخذ بيانات حقيقية ويحسب خط أساس، فيخرج الفريق منه بأرقام يكتبها في المقترح، وبالجزء الصعب الذي سوف يكون قلب المشروع. وهذا ما سوف نقوم به الآن.
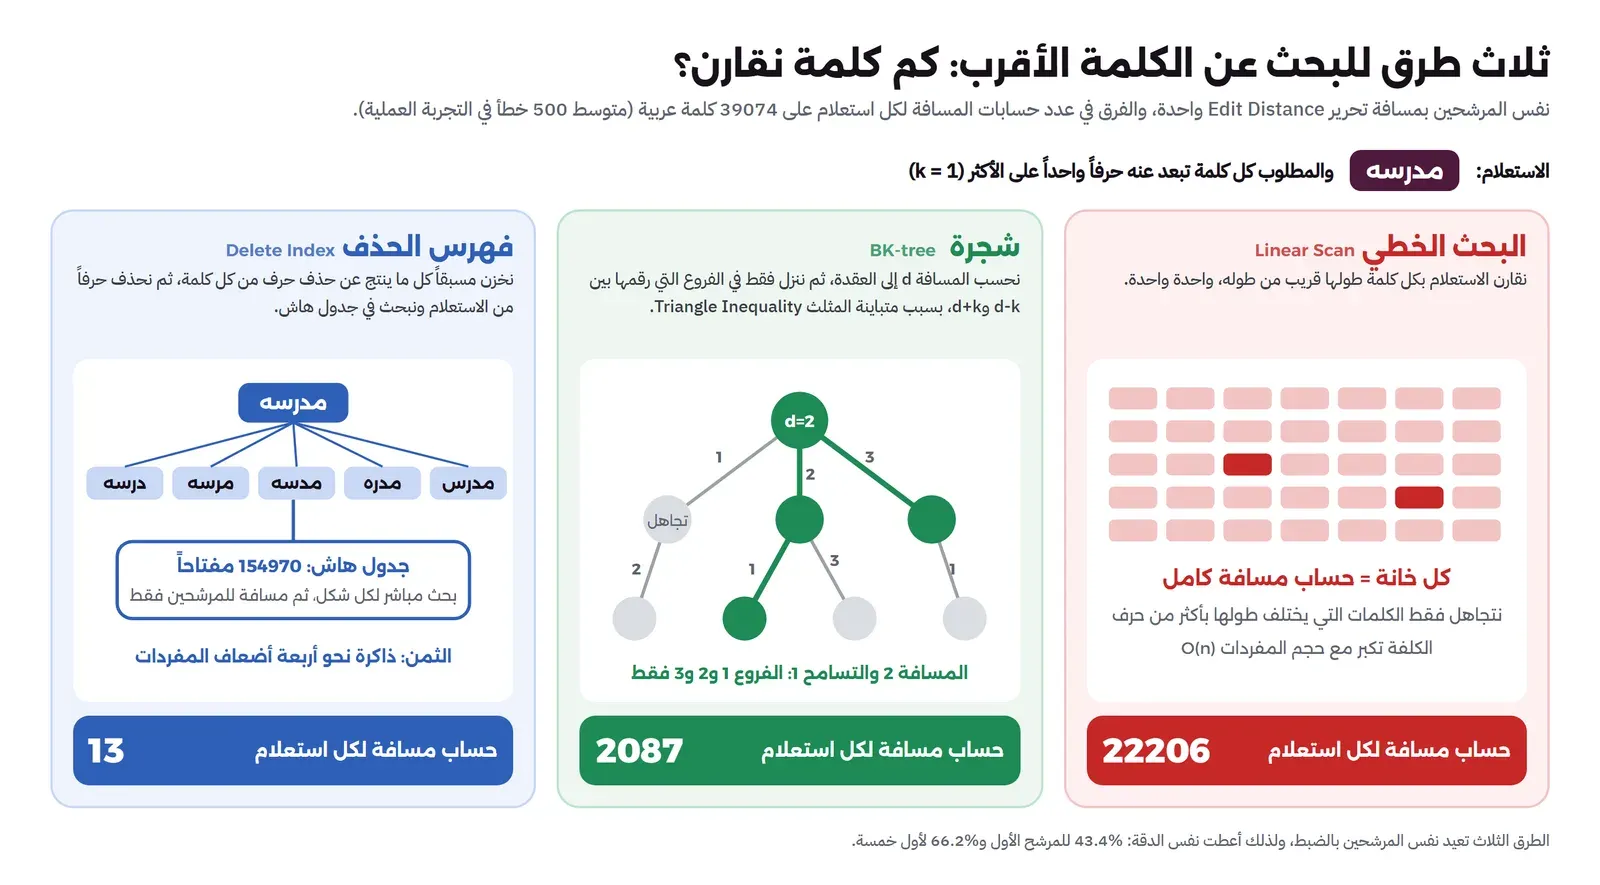
والبرنامج التالي يقوم بأربعة أشياء: يحمل قائمة FrequencyWords العربية، ويطبع حجم المفردات قبل التطبيع وبعده، ثم يبني فهرسين، الأول شجرة BK-tree التي تستفيد من متباينة المثلث Triangle Inequality في مسافة التحرير Edit Distance لتتجاهل أغلب الكلمات دون مقارنتها، والثاني فهرس الحذف الذي يقوم عليه SymSpell، حيث نخزن لكل كلمة كل الكلمات التي تنتج عنها بحذف حرف واحد، فيصبح البحث عن الأخطاء القريبة بحثاً في جدول هاش. ثم يولد 500 خطأ إملائي صناعي من كلمات حقيقية بحذف حرف أو إضافة حرف أو استبداله أو قلب حرفين متجاورين، ويقيس كل طريقة بالزمن وعدد حسابات المسافة والدقة. وفي النهاية يجرب ما يحدث إذا تركنا التطبيع. وكل ذلك بمكتبة Python القياسية وحدها.
وقد شرحنا جداول الهاش التي يقوم عليها الفهرس الثاني في جداول الهاش، وتعقيد الخوارزميات الذي سوف نقرؤه في الأرقام في الخوارزميات وتعقيد Big O.
البرنامج spell_spike.py
البرنامج كاملاً كما يلي:
# Feasibility spike for one graduation idea: an Arabic spelling suggester ("did you mean?").
# Data: hermitdave/FrequencyWords, ar_50k.txt (OpenSubtitles 2018, CC BY-SA 4.0), fetched on first run.
#   python spell_spike.py [path-to-ar_50k.txt]
# Python 3.13, standard library only.
import random, re, sys, time, urllib.request
sys.stdout.reconfigure(encoding="utf-8")  # the Windows console is cp1252 by default
from collections import defaultdict
from pathlib import Path

URL = "https://raw.githubusercontent.com/hermitdave/FrequencyWords/master/content/2018/ar/ar_50k.txt"
SRC = Path(sys.argv[1]) if len(sys.argv) > 1 else Path(__file__).with_name("ar_50k.txt")
if not SRC.exists():
    urllib.request.urlretrieve(URL, SRC)

ARABIC = re.compile(r"^[ء-يً-ْـ]+$")
TASHKEEL = re.compile(r"[ً-ْـ]")          # harakat + tatweel
LETTERS = "ابتثجحخدذرزسشصضطظعغفقكلمنهوي" + "ءأإآةىؤئ"

def normalize(w, on=True):
    w = TASHKEEL.sub("", w)
    if not on:
        return w
    w = re.sub("[أإآ]", "ا", w)
    return w.replace("ى", "ي").replace("ة", "ه")

def lev(a, b, counter):
    counter[0] += 1
    if len(a) < len(b):
        a, b = b, a
    prev = list(range(len(b) + 1))
    for i, ca in enumerate(a, 1):
        cur = [i]
        for j, cb in enumerate(b, 1):
            cur.append(min(prev[j] + 1, cur[j - 1] + 1, prev[j - 1] + (ca != cb)))
        prev = cur
    return prev[-1]

class BKTree:
    def __init__(self, words, counter):
        it = iter(words)
        self.root = (next(it), {})
        self.c = counter
        for w in it:
            node = self.root
            while True:
                d = lev(w, node[0], self.c)
                if d == 0:
                    break
                if d in node[1]:
                    node = node[1][d]
                else:
                    node[1][d] = (w, {})
                    break
    def depth(self):
        best, stack = 0, [(self.root, 1)]
        while stack:
            (w, kids), d = stack.pop()
            best = max(best, d)
            stack.extend((k, d + 1) for k in kids.values())
        return best
    def search(self, q, k):
        out, stack = [], [self.root]
        while stack:
            w, kids = stack.pop()
            d = lev(q, w, self.c)
            if d <= k:
                out.append((d, w))
            for dist, child in kids.items():
                if d - k <= dist <= d + k:
                    stack.append(child)
        return out

def deletes1(w):
    return {w[:i] + w[i + 1:] for i in range(len(w))}

# ---------------------------------------------------------------- 1) load and normalise
raw = [l.rsplit(" ", 1) for l in SRC.read_text(encoding="utf-8").splitlines() if " " in l]
arabic = [(w, int(c)) for w, c in raw if ARABIC.match(w)]
def build_vocab(on):
    freq = defaultdict(int)
    for w, c in arabic:
        freq[normalize(w, on)] += c
    return dict(freq)
vocab = build_vocab(True)
print("== 1) vocabulary ==")
print(f"lines in file            {len(raw):>7}")
print(f"arabic-only tokens       {len(arabic):>7}")
print(f"unique after normalising {len(vocab):>7}  (merged {len(arabic) - len(vocab)} spellings)")
lens = [len(w) for w in vocab]
print(f"word length: mean {sum(lens)/len(lens):.2f}, max {max(lens)}")

# ---------------------------------------------------------------- 2) build the indexes
words = sorted(vocab, key=lambda w: -vocab[w])
cnt = [0]; t = time.perf_counter(); bk = BKTree(words, cnt); t_bk = time.perf_counter() - t
t = time.perf_counter()
del_index = defaultdict(set)
for w in words:
    del_index[w].add(w)
    for d in deletes1(w):
        del_index[d].add(w)
t_del = time.perf_counter() - t
print("\n== 2) index build ==")
print(f"BK-tree        {t_bk:6.2f} s, {cnt[0]} distance calls, depth {bk.depth()}")
print(f"delete-index   {t_del:6.2f} s, {len(del_index)} keys (SymSpell idea, edit distance 1)")

# ---------------------------------------------------------------- 3) synthetic typos
rng = random.Random(2026)
def typo(w):
    i = rng.randrange(len(w)); op = rng.choice("dist")
    if op == "d" and len(w) > 2: return "delete", w[:i] + w[i + 1:]
    if op == "i": return "insert", w[:i] + rng.choice(LETTERS) + w[i:]
    if op == "t" and i < len(w) - 1: return "transpose", w[:i] + w[i + 1] + w[i] + w[i + 2:]
    return "substitute", w[:i] + rng.choice([c for c in LETTERS if c != w[i]]) + w[i + 1:]

pool = [w for w in words[1000:20000] if len(w) >= 4]
tests, kinds = [], []
while len(tests) < 500:
    w = rng.choice(pool); kind, q = typo(w); q = normalize(q)
    if q != w:
        tests.append((q, w)); kinds.append(kind)

def rank(cands):
    return [w for d, w in sorted(cands, key=lambda x: (x[0], -vocab[x[1]]))]

def evaluate(name, fn):
    c0 = cnt[0]; top1 = top5 = 0; t = time.perf_counter()
    for q, gold in tests:
        r = rank(fn(q)); top1 += bool(r) and r[0] == gold; top5 += gold in r[:5]
    ms = (time.perf_counter() - t) * 1000 / len(tests)
    print(f"{name:<24} {ms:8.2f} ms/q {(cnt[0]-c0)/len(tests):9.0f} dist/q   top1 {top1/len(tests):5.1%}  top5 {top5/len(tests):5.1%}")

def linear(k):
    return lambda q: [(d, w) for w in words if abs(len(w) - len(q)) <= k and (d := lev(q, w, cnt)) <= k]
def by_deletes(q):
    cands = set()
    for key in deletes1(q) | {q}:
        cands |= del_index.get(key, set())
    return [(d, w) for w in cands if (d := lev(q, w, cnt)) <= 1]

print(f"\n== 3) 500 synthetic one-edit typos from ranks 1000-20000 (seed 2026) ==")
evaluate("linear scan, k=1", linear(1))
evaluate("BK-tree, k=1", lambda q: bk.search(q, 1))
evaluate("delete-index, k=1", by_deletes)
evaluate("BK-tree, k=2", lambda q: bk.search(q, 2))

real = [(q, g) for q, g in tests if q in vocab]
print(f"typos that are themselves real words: {len(real)} of {len(tests)} ({len(real)/len(tests):.1%})")
rest = [(q, g) for q, g in tests if q not in vocab]
ok = sum(1 for q, g in rest if (r := rank(by_deletes(q))) and r[0] == g)
print(f"top1 on the other {len(rest)} typos (delete-index, k=1): {ok/len(rest):.1%}")
print("by kind of typo (delete-index, k=1):")
for kind in ("delete", "insert", "substitute", "transpose"):
    sub = [(q, g) for (q, g), k in zip(tests, kinds) if k == kind]
    res = [rank(by_deletes(q)) for q, g in sub]
    t1 = sum(bool(r) and r[0] == g for r, (q, g) in zip(res, sub))
    t5 = sum(g in r[:5] for r, (q, g) in zip(res, sub))
    nc = sum(len(r) for r in res) / len(sub)
    print(f"  {kind:<11} {len(sub):>3} typos  top1 {t1/len(sub):5.1%}  top5 {t5/len(sub):5.1%}  {nc:4.1f} candidates/q")

# ---------------------------------------------------------------- 4) what if: no letter normalisation
print("\n== 4) what if we skip normalisation? hamza / alef maqsura / taa marbuta slips ==")
raw_vocab = build_vocab(False)
slips = []
for w, c in sorted(arabic, key=lambda x: -x[1])[1000:20000]:
    w = normalize(w, False)
    if re.search("[أإآىة]", w) and len(w) >= 4:
        s = re.sub("[أإآ]", "ا", w).replace("ى", "ي").replace("ة", "ه")
        if s != w and s not in raw_vocab:
            slips.append((s, w))
    if len(slips) == 300:
        break
c = [0]
dist = defaultdict(int)
for s_, w in slips:
    dist[lev(s_, w, c)] += 1
print(f"{len(slips)} words typed without hamza, taa marbuta or alef maqsura (none of them is in the raw list)")
print("edit distance to the intended word, raw vocabulary:", dict(sorted(dist.items())))
print(f"found at distance 0 after normalising both sides: {sum(normalize(s_) == normalize(w) for s_, w in slips)}")
في البرنامج أعلاه لاحظ التالي:
- دالة
normalizeتحذف التشكيل والتطويل دائماً، ثم توحد أشكال الألف المهموزة إلى ألف، والألف المقصورة إلى ياء، والتاء المربوطة إلى هاء، وهذا نفس ما تفعله محركات البحث مع العربية، والمعاملonيسمح لنا بإيقاف الجزء الثاني في التجربة الأخيرة. - دالة
levهي مسافة Levenshtein المعروفة بالبرمجة الديناميكية Dynamic Programming، وتعد كل استدعاء لها فيcounter، لأن عدد حسابات المسافة مقياس لا يتأثر بسرعة الجهاز، بعكس الزمن. - في
BKTree.searchالسطر المهم هو شرطd - k <= dist <= d + k، فإذا كانت مسافة الاستعلام عن العقدة الحاليةd، فإن متباينة المثلث تضمن أن الكلمات التي تبعد عن العقدة مسافة خارج هذا المدى لا يمكن أن تكون قريبة من الاستعلام، فنتجاهل فروعها كاملة دون مقارنة. - فهرس الحذف
del_indexيخزن الكلمة نفسها وكل ما ينتج عنها بحذف حرف واحد، وعند البحث نحذف حرفاً واحداً من الاستعلام بكل الطرق ونبحث في الجدول، فكل كلمة على مسافة 1 من الاستعلام سوف تلتقي معه في مفتاح واحد على الأقل. - دالة
rankترتب المرشحين بالمسافة أولاً ثم بالتكرار في القائمة، وهذا خط الأساس البسيط الذي يريد المشروع أن يتجاوزه. - البذرة
random.Random(2026)ثابتة، حتى يعيد أي شخص نفس الأخطاء الخمسمئة ويصل إلى نفس الأرقام، وهذا ما تطلبه اللجنة عندما تسأل عن إعادة الإنتاج.
وللتشغيل من مجلد lab يكفي الأمر التالي، والبرنامج يحمل الملف بنفسه في التشغيل الأول إذا لم يجده، وحجمه نحو 800 كيلوبايت:
python spell_spike.py > spell_spike.outالمخرج الأول: حجم المفردات Vocabulary بعد التطبيع
والمخرج سوف يكون كما يلي:
== 1) vocabulary ==
lines in file              50000
arabic-only tokens         49784
unique after normalising   39074  (merged 10710 spellings)
word length: mean 5.41, max 15
في المخرج أعلاه لاحظ التالي:
- الملف فيه 50000 سطر، منها 49784 كلمة عربية الحروف، والباقي علامات ترقيم مثل الفاصلة العربية التي جاءت أولى في القائمة، وأرقام وكلمات لاتينية.
- بعد التطبيع بقيت 39074 كلمة فريدة، أي أن 10710 أشكال اندمجت في غيرها، وهذا أكثر من خمس القائمة. ومعنى ذلك أن الكلمة الواحدة تظهر في نص حقيقي بأشكال كثيرة، بهمزة ودونها، وبتاء مربوطة وبهاء، وهذا وحده سبب كاف لأن يكون التطبيع أول وحدة في المشروع.
- متوسط طول الكلمة 5.41 حرف، وهذا رقم سوف نعود إليه، لأن الكلمات القصيرة تعني أن كلمات حقيقية كثيرة تقع على مسافة حرف واحد من بعضها.
المخرج الثاني: بناء الفهارس Index Build
== 2) index build ==
BK-tree          4.53 s, 355702 distance calls, depth 28
delete-index     0.40 s, 154970 keys (SymSpell idea, edit distance 1)
في المخرج أعلاه لاحظ التالي:
- بناء BK-tree احتاج 355702 حساب مسافة لكلمات عددها 39074، أي نحو تسع مقارنات لكل كلمة في المتوسط، وهذا عدد الحواف التي نزلها كل إدخال حتى وجد مكانه. وعمق الشجرة 28، لأن الشجرة لا تتوازن من نفسها، وترتيب الإدخال بالتكرار هو الذي حدد شكلها.
- فهرس الحذف بني في أقل من نصف ثانية، وفيه 154970 مفتاحاً، أي نحو أربعة أضعاف عدد الكلمات. وهذا هو الثمن المعروف لهذه الطريقة: ذاكرة أكثر مقابل بحث أسرع بكثير، والثمن يكبر بسرعة إذا أردت مسافة 2، لأن عدد ما ينتج عن حذف حرفين يقارب مربع طول الكلمة.
المخرج الثالث: الدقة Accuracy والسرعة على 500 خطأ
== 3) 500 synthetic one-edit typos from ranks 1000-20000 (seed 2026) ==
linear scan, k=1           231.15 ms/q     22206 dist/q   top1 43.4%  top5 66.2%
BK-tree, k=1                30.25 ms/q      2087 dist/q   top1 43.4%  top5 66.2%
delete-index, k=1            0.11 ms/q        13 dist/q   top1 43.4%  top5 66.2%
BK-tree, k=2               158.14 ms/q     10986 dist/q   top1 45.2%  top5 73.0%
typos that are themselves real words: 47 of 500 (9.4%)
top1 on the other 453 typos (delete-index, k=1): 47.9%
by kind of typo (delete-index, k=1):
  delete      127 typos  top1 18.9%  top5 55.1%  13.6 candidates/q
  insert      116 typos  top1 90.5%  top5 100.0%   1.3 candidates/q
  substitute  152 typos  top1 57.9%  top5 95.4%   4.0 candidates/q
  transpose   105 typos  top1  0.0%  top5  0.0%   2.7 candidates/q
هذا هو المخرج الأهم في التجربة، وفيه نتيجتان مختلفتان تماماً، الأولى عن السرعة والثانية عن الدقة، ولاحظ التالي:
- الطرق الثلاث بمسافة 1 أعطت نفس الدقة بالضبط، 43.4% للمرشح الأول و66.2% لأول خمسة، وهذا متوقع وهو أيضاً اختبار لصحة الكود، لأن الثلاث تبحث عن نفس مجموعة الكلمات بطرق مختلفة، فإذا اختلفت دقتها فهناك خطأ في إحداها.
- الفرق كله في الكلفة: البحث الخطي حسب 22206 مسافة لكل استعلام، رغم أننا نتجاهل الكلمات التي يختلف طولها بأكثر من 1، وBK-tree حسب 2087 أي أقل بعشر مرات تقريباً، وفهرس الحذف حسب 13 فقط. وبالزمن على نفس الجهاز، من نحو ربع ثانية لكل استعلام إلى عشر جزء من الألف من الثانية تقريباً، وهذا الفرق هو ما يجعل الاقتراح ممكناً أثناء الكتابة في مربع البحث.
- عندما رفعنا المسافة إلى 2 في BK-tree ارتفع عدد حسابات المسافة خمس مرات إلى 10986، وارتفعت الدقة قليلاً فقط، من 43.4% إلى 45.2% للأول ومن 66.2% إلى 73.0% لأول خمسة. أي أن مضاعفة التسامح تكلف كثيراً وتعطي قليلاً، وسوف نعرف السبب بعد سطرين.
- 47 خطأ من 500، أي 9.4%، نتج عنها كلمة حقيقية موجودة في القائمة. فإذا حذفت حرفاً من كلمة أو استبدلته فقد تحصل على كلمة صحيحة أخرى، والمقترح الذي لا يعرف السياق سوف يقول إن الكلمة صحيحة ولا يقترح شيئاً. وهذه الأخطاء لا يمكن أن يصلحها أي ترتيب يعتمد على الكلمة وحدها.
أما التفصيل بحسب نوع الخطأ فهو الذي يكشف أين المشكلة الحقيقية:
- الإضافة Insert: دقة 90.5% للأول و100% لأول خمسة، مع 1.3 مرشح فقط لكل استعلام، لأن الكلمة بعد إضافة حرف غريب لا تشبه إلا الكلمة الأصلية في الغالب.
- الاستبدال Substitute: 57.9% للأول و95.4% لأول خمسة، مع 4 مرشحين في المتوسط، أي أن الكلمة الصحيحة موجودة تقريباً دائماً، لكن الترتيب بالتكرار يضع قبلها كلمة أشهر منها.
- الحذف Delete: 18.9% فقط للأول و55.1% لأول خمسة، مع 13.6 مرشحاً لكل استعلام. فعندما تحذف حرفاً من كلمة عربية من خمسة أحرف، تحصل على كلمة من أربعة أحرف، وحولها عشرات الكلمات الحقيقية التي تبعد عنها حرفاً واحداً بالإضافة، وهذا ما قصدناه بأن متوسط الطول القصير يجعل المفردات العربية متقاربة.
- قلب حرفين Transpose: صفر في الحالتين. والسبب أن مسافة Levenshtein تحسب قلب حرفين متجاورين عمليتين، حذفاً وإضافة أو استبدالين، فلا تجد الكلمة الصحيحة أبداً بمسافة 1، وهذا خطأ شائع جداً في الكتابة على الجوال.
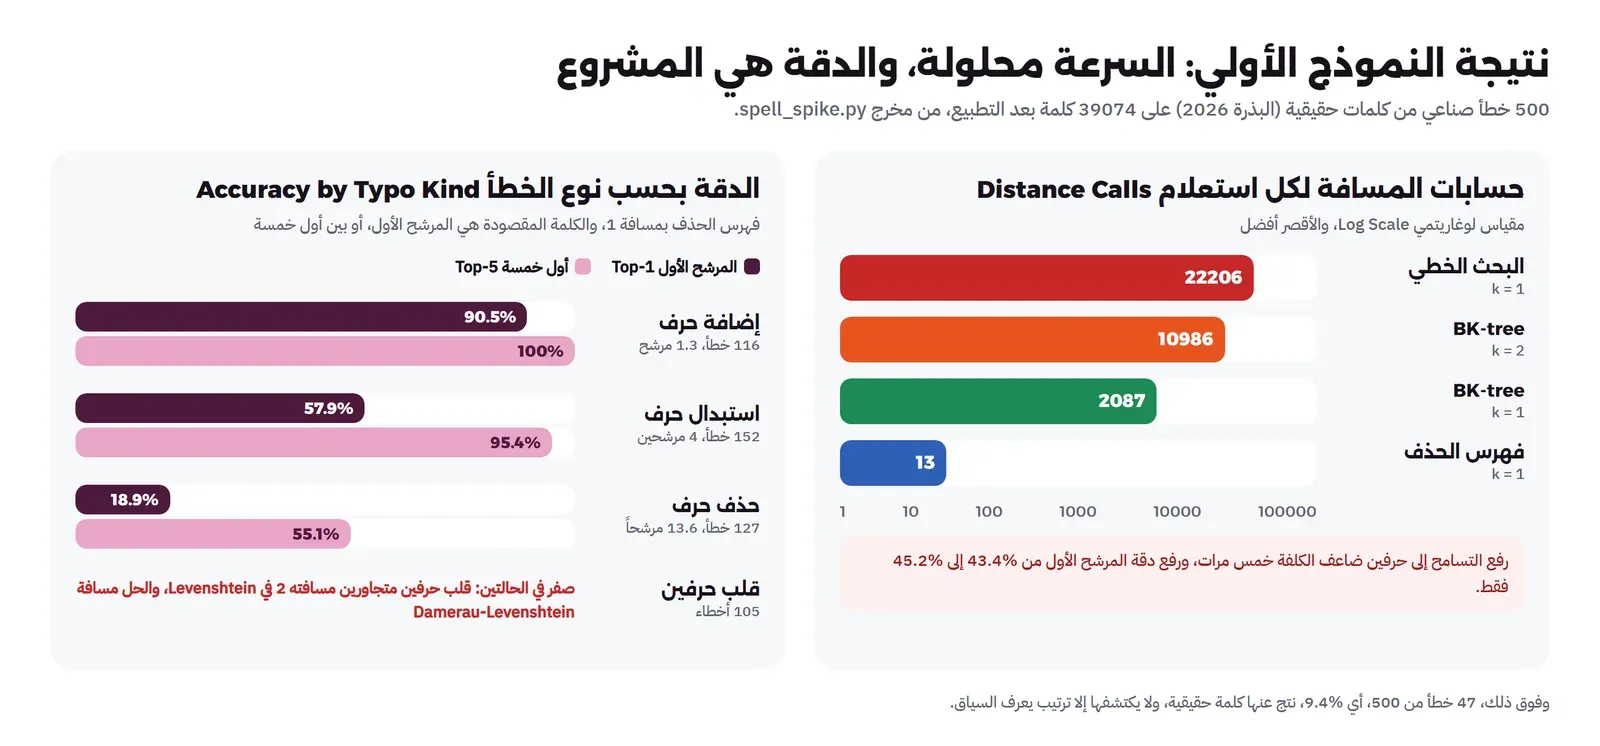
وهنا خرج الفريق بما يحتاجه المقترح بالضبط. فالسرعة مشكلة محلولة بفهرس الحذف، ولا تحتاج فصلاً كاملاً، أما الدقة فهي قلب المشروع، وفيها ثلاثة أعمال واضحة: مسافة Damerau-Levenshtein التي تحسب قلب الحرفين عملية واحدة، فترفع الربع الذي كان صفراً، وترتيب يستخدم السياق، أي الكلمة السابقة واللاحقة، حتى يختار بين المرشحين الكثيرين في أخطاء الحذف ويكتشف الأخطاء التي نتج عنها كلمة حقيقية، وكلفة تحرير مبنية على لوحة المفاتيح. ولكل عمل منها رقم قبل ورقم بعد، وهذا هو التقييم الذي تريده اللجنة.
مشكلات حقيقية ظهرت في التشغيل Problems
لم يخرج هذا المخرج من التشغيل الأول، وما يلي ما ظهر فعلاً وكيف تعاملنا معه، لأن نفس الأشياء سوف تظهر لكم:
- توقف البرنامج في التشغيل الأول على Windows عند أول سطر يطبع حرفاً عربياً بالخطأ
UnicodeEncodeError: 'charmap' codec can't encode character 'ة'، والسبب أن الطرفية في Windows تستخدم الترميز cp1252 افتراضياً، وهو لا يعرف الحروف العربية. والحل السطرsys.stdout.reconfigure(encoding="utf-8")في أول البرنامج، أو متغير البيئةPYTHONIOENCODING=utf-8، ولاحظ أن الخطأ ظهر بعد ثلاث دقائق من التشغيل، لأن الأقسام الأولى لا تطبع إلا أرقاماً وحروفاً لاتينية. - هذه الدقائق الثلاث نفسها مشكلة ثانية، فالبحث الخطي على 500 استعلام أخذ نحو دقيقتين، وهذا وحده يبين لماذا نحتاج الفهرس. وفي النموذج الأولي تركناه لأنه خط الأساس الذي نقارن به، لكن في المشروع لا تقم بتشغيله في كل تجربة، وشغله مرة واحدة واحفظ نتيجته.
- في التشغيل الأول كانت النتيجة 43.4% فقط دون تفصيل، ولم نعرف لماذا، فأضفنا تفصيل الدقة بحسب نوع الخطأ، ومنه ظهر الصفر في قلب الحرفين. وهذا درس في التقييم نفسه: الرقم الإجمالي يخفي المشكلة، والتفصيل بحسب الفئة يظهرها.
- القائمة مأخوذة من ترجمات الأفلام، فهي قريبة من لغة الحوار، وفيها كلمات بالتشكيل وأخرى بأخطاء المترجمين أنفسهم، وبعضها بشكل عامي. وهذا مقبول في النموذج الأولي، أما في المشروع فاجمعوا مفردات من نصوص الجهة التي سوف تستخدم المقترح، لأن مفردات بوابة خدمات تختلف عن مفردات فيلم.
ماذا يحدث إذا ألغينا التطبيع Normalization؟
القسم الأخير من البرنامج يجيب عن سؤال قد يسأله المشرف: هل نحتاج التطبيع فعلاً، أم يكفي أن نبحث بمسافة التحرير؟ فأخذنا 300 كلمة من القائمة فيها همزة أو تاء مربوطة أو ألف مقصورة، وكتبناها كما يكتبها مستخدم مستعجل، دون همزة وبهاء وبياء، واخترنا فقط الحالات التي لا يوجد شكلها المكتوب في القائمة الأصلية:
== 4) what if we skip normalisation? hamza / alef maqsura / taa marbuta slips ==
300 words typed without hamza, taa marbuta or alef maqsura (none of them is in the raw list)
edit distance to the intended word, raw vocabulary: {1: 244, 2: 56}
found at distance 0 after normalising both sides: 300
في المخرج أعلاه لاحظ التالي:
- دون تطبيع، 244 كلمة من 300 تبعد عن الكلمة المقصودة حرفاً واحداً، فيجدها البحث بمسافة 1، لكنها تنافس كل الكلمات الأخرى القريبة، وقد رأينا في المخرج الثالث كيف يضيع الترتيب بينها.
- 56 كلمة تبعد حرفين، مثل كلمة فيها همزة وتاء مربوطة معاً، وهذه لا يجدها البحث بمسافة 1 أبداً، ونحتاج لها مسافة 2 بكلفتها الكبيرة.
- بعد تطبيع الطرفين، الكلمات الثلاثمئة كلها على مسافة صفر، أي أنها تطابق مباشر في جدول هاش، دون أي حساب مسافة ودون منافسة.
ومعنى ذلك أن التطبيع ليس تحسيناً صغيراً، وإنما يحول أكثر الأخطاء العربية شيوعاً من مسألة بحث تقريبي مكلفة إلى مطابقة مباشرة، ويترك مسافة التحرير للأخطاء التي تستحقها. لكن للتطبيع ثمن يجب أن يكتب في التقرير أيضاً، فهو يجمع كلمات مختلفة في شكل واحد، مثل «مدرسة» و«مدرسه» أي «معلمه»، وهذا جزء من الكلمات العشرة آلاف التي اندمجت في المخرج الأول، وتمييزها يحتاج السياق مرة أخرى.
كيف تكتب نتيجة النموذج الأولي في المقترح Proposal؟
النموذج الأولي لا يذهب إلى المقترح كما هو، وإنما تكتب منه فقرة قصيرة وجدولاً، والفقرة تقول ثلاثة أشياء: إن البيانات موجودة وحجمها كذا وترخيصها كذا، وإن خط الأساس على 500 خطأ صناعي بالترتيب بالتكرار يعطي 43.4% للمرشح الأول بزمن أقل من جزء من الألف من الثانية، وإن الفريق سوف يعمل على ثلاثة تحسينات لكل منها هدف رقمي، هو قلب الحرفين ثم السياق ثم لوحة المفاتيح، ويقيسها على مجموعة أخطاء حقيقية يجمعها. وقد شرحنا بنية المقترح في كيف تكتب مقترح البحث، وهو مكتوب للباحثين لكن نفس المنطق يصلح لمقترح مشروع التخرج.
ولاحظ أن الأرقام هنا تخدم غرضاً آخر غير الإقناع، فهي تحميكم في المناقشة. فإذا وصلتم في النهاية إلى 70% للمرشح الأول، فإن اللجنة سوف ترى أنكم بدأتم من 43.4% وأنكم تعرفون مصدر كل نقطة تحسن، أما الفريق الذي يقدم 70% دون خط أساس فسوف يسأل «70% مقارنة بماذا؟» ولن يجد إجابة.
كيف يختار الفريق فكرة واحدة من ثلاث Decision Checklist؟
بعد أن يكتب الفريق بطاقات أفكاره الثلاث، يأتي القرار، وأسوأ طريقة لاتخاذه هي التصويت على الفكرة الأجمل. والطريقة الأنسب أن تمر كل فكرة على الأسئلة التالية بالترتيب، وأن تستبعد الفكرة عند أول سؤال لا تجد له إجابة:
- هل فتحتم رابط البيانات فعلاً وحملتم جزءاً منها؟ وإذا كانت البيانات ستجمع من مستخدمين، فهل وافقت الجهة كتابة؟
- هل تعرفون خط الأساس الذي سوف تقارنون به، وهل حسبتموه ولو بشكل تقريبي في نموذج أولي؟
- هل الجزء الصعب في المشروع واضح، وهل هو جزء من علوم الحاسب، أي خوارزمية أو نظام أو لغة، لا واجهة أو تقارير؟
- هل يستطيع كل عضو في الفريق أن يأخذ جزءاً مستقلاً يمكن تقييمه وحده؟ فاللجنة تسأل كل عضو عن عمله، والمشروع الذي يقوم على شخص واحد يظهر ذلك في المناقشة.
- هل يمكن أن تنتهي نسخة تعمل من المشروع قبل منتصف الفصل الثاني، بحيث يبقى وقت للتقييم؟ فأغلب المشاريع التي تقدم دون تقييم حقيقي هي مشاريع انتهى بناؤها في الأسبوع الأخير.
- هل يهتم بها أحد في الفريق فعلاً؟ فسنة كاملة مع فكرة لا تحبها أطول مما تتوقع.
وإذا مرت فكرتان من كل الأسئلة، فاختر التي خطرها القاتل أسهل في التخفيف، لا التي نتيجتها المتوقعة أكبر. والسبب أن المشروع الذي ينجح بنتيجة متوسطة مقاسة بدقة أفضل في التقييم وفي السيرة الذاتية من مشروع طموح توقف في منتصفه.
أخطاء شائعة Common Mistakes في اختيار مشروع علوم الحاسب
- اختيار الأداة قبل المشكلة: «نريد مشروعاً بـ Blockchain» أو «بالذكاء الاصطناعي» ثم البحث عن مشكلة تناسبها، فتأتي المشكلة مصطنعة وتظهر كذلك أمام اللجنة.
- بيانات موعودة: «سوف نحصل على البيانات من المستشفى»، ثم لا تصل البيانات في الفصل الأول ولا في الثاني. فلا تقم بالالتزام بفكرة بياناتها غير موجودة بين يديك أو في رابط منشور.
- تقييم بالانطباع: «جربنا النظام وكان سريعاً»، والصحيح رقم وخط أساس ومجموعة اختبار ثابتة، كما في التجربة أعلاه.
- الرقم الإجمالي وحده: كما رأينا، 43.4% تخفي صفراً كاملاً في نوع من الأخطاء، والتفصيل بحسب الفئة يكشف ما يجب العمل عليه.
- نطاق بلا حدود: كل أسبوع ميزة جديدة، ولا يوجد سطر في المقترح يقول ما الذي لن يبنيه المشروع.
- تجاهل البيانات الشخصية: عناوين طلاب أو سجلات مرضى أو كود طلاب، دون موافقة ودون حذف ما يعرف بالشخص، وقد شرحنا أساس ذلك في أخلاقيات البحث على البشر.
- نسخ مشروع منشور: مشاريع التخرج القديمة ومستودعات GitHub متاحة للجميع، ولجان التقييم تعرفها، والبناء على عمل منشور مقبول بشرط أن تذكره وتبين ما أضفته.
- كتابة رسالة الماجستير كمشروع بكالوريوس كبير: منتج كامل بشاشات كثيرة ولا يوجد سؤال بحثي ولا مقارنة بعمل سابق، فتسأل اللجنة «ما الإسهام؟» ولا توجد إجابة.
قائمة تحقق Checklist قبل أن تسلم الأفكار للمشرف
- لكل فكرة بطاقة من تسعة حقول، والبيانات والتقييم والخطر مكتوبة أولاً.
- كل رابط بيانات فتحه أحد أعضاء الفريق، وحمل منه عينة، وعرف ترخيصه.
- لكل فكرة مقياس وخط أساس واضحان، ولفكرة واحدة على الأقل نموذج أولي بأرقام حقيقية.
- الجزء الصعب في كل فكرة مكتوب في جملة واحدة، وهو من علوم الحاسب.
- الفكرة ليست من الأفكار المستهلكة، أو هي منها لكن السؤال الصعب داخلها هو المشروع.
- لطالب الماجستير: سؤال بحثي يجاب بالقياس، وثلاثة أعمال سابقة على الأقل قرأتها فعلاً، ومعيار مقارنة معروف في المجال.
- لا توجد بيانات شخصية دون موافقة مكتوبة وخطة لحذف ما يعرف بالشخص.
- كل عضو في الفريق يعرف الجزء الذي سوف يقيم عليه.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- مشروع البكالوريوس في علوم الحاسب يسأل هل بنيتم شيئاً يعمل وقستموه، ورسالة الماجستير تسأل ما الذي أضفته إلى ما يعرفه المجال، والفكرة الواحدة تنتقل من الأول إلى الثاني بتغيير السؤال.
- بطاقة الفكرة تسعة حقول، وأهمها البيانات والتقييم والخطر الذي يقتل المشروع، لأنها لا تجمل بالكلام.
- ثماني أفكار للبكالوريوس وست للماجستير، لكل منها مصدر بيانات أو معيار مقارنة فتحناه، وفي قلب كل منها خوارزمية أو نظام أو لغة.
- الأفكار المستهلكة تتحول إلى مشاريع حقيقية عندما تجعل السؤال الصعب داخلها هو المشروع، وميزتها أن المستخدم والبيانات قريبان منك.
- النموذج الأولي لمقترح التصحيح الإملائي على 39074 كلمة عربية بين أن السرعة محلولة بفهرس الحذف بـ 13 حساب مسافة بدل 22206، وأن الدقة 43.4% للمرشح الأول تسقط إلى 18.9% في أخطاء الحذف وإلى صفر في قلب الحرفين، وأن التطبيع يحول أخطاء الهمزات والتاء المربوطة كلها إلى مطابقة مباشرة. وهذه الأرقام هي ما يكتب في المقترح.
وإذا كنت لم تختر تخصصك بعد فابدأ من أي تخصص تقني تختار؟، وإذا كنت في علوم الحاسب فارجع إلى دليل التخصص لترى المجال الذي تنتمي إليه فكرتك. وأقرب المقالات إلى هذا الموضوع على الموقع:
 دليلتخصص علوم الحاسب Computer Science: منهج CS2023 ومواد الجامعةلماذا وضعت كل مادة في خطة علوم الحاسب بحسب منهج CS2023، وأين تقصر خطط الجامعات السعودية، وكيف تكمل ما ينقصك بنفسك.
 دليلأي تخصص تقني تختار؟ ما تدرسه فعلاً وأين تعمل بعدهماذا تدرس فعلاً في كل تخصص تقني بحسب الخطط الدراسية السعودية، وأين يعمل خريجوه، ومتى يهم اسم التخصص ومتى تهم المهارة.
 دليلBig-O للمبتدئين: لماذا يبطؤ كودك عندما تكبر البياناتلماذا يعمل الكود بسرعة على مئة صف ثم يتوقف على مئة ألف، وكيف تقرأ Big-O وتكتشف الخوارزمية البطيئة في كودك.
 دليلجداول الهاش Hash Tables: كيف يجد القاموس قيمتك فوراًماذا يحدث داخل القاموس من دالة الهاش إلى التصادم والتكبير، ولماذا يبقى البحث فيه خطوة أو اثنتين، بأرقام من تجربة حقيقية في Python.
 دليلخوارزميات الرسم البياني Graph: من BFS إلى Dijkstraكيف يمشي apt على اعتماديات الحزم وكيف يجد تطبيق الخرائط أقصر طريق، بخوارزميات BFS وDFS والترتيب الطوبولوجي وDijkstra مجربة على بيانات حقيقية.
 دليلداخل المترجم Compiler: من الكود إلى IR وكود الآلةنفتح GCC وClang على ملف C صغير ونقرأ كل مرحلة يمر بها، من الشجرة إلى SSA والتحسينات وكود الآلة، ونرى كيف حذف المترجم فحصاً بسبب سلوك غير معرف.
 دليلالأنظمة الموزعة للمبتدئين: ماذا يحدث عندما تنقطع الشبكةلماذا تتصرف الأنظمة الموزعة بشكل غريب عند انقطاع الشبكة، وكيف تتفق السيرفرات على قرار واحد رغم ذلك.
 دليلالبحث في النصوص العربية مع OpenSearch وMeilisearchلماذا يرجع البحث صفحة فارغة لمن يكتب «مستشفي» أو «اجازه»، وكيف تضبط محركك حتى يجد الكلمة بكل أشكالها.
 دليلكيف تجد الفجوة البحثية Research Gap في الأدبيات العلمية؟أين تبحث عن الأبحاث المنشورة، وكيف ترسم خريطة موضوعك بالأرقام عبر OpenAlex وSemantic Scholar، ثم تتحقق من الفجوة قبل أن تبني عليها.
 دليلكيف تكتب مقترح البحث Research Proposal الذي يقنع الممول؟أقسام المقترح البحثي وكيف يقيمه الممولون، وأين تتقدم للتمويل في السعودية، مع قالب جاهز وسكربت يفحص ميزانيتك.
سجل التحديثات
- نوفمبر 2026: كتابة المقال، والتحقق من كل مصادر البيانات والمعايير المذكورة، وتشغيل النموذج الأولي spell_spike.py على Python 3.13 على قائمة FrequencyWords العربية (نسخة 2018).


